十一期的故事在这里分类
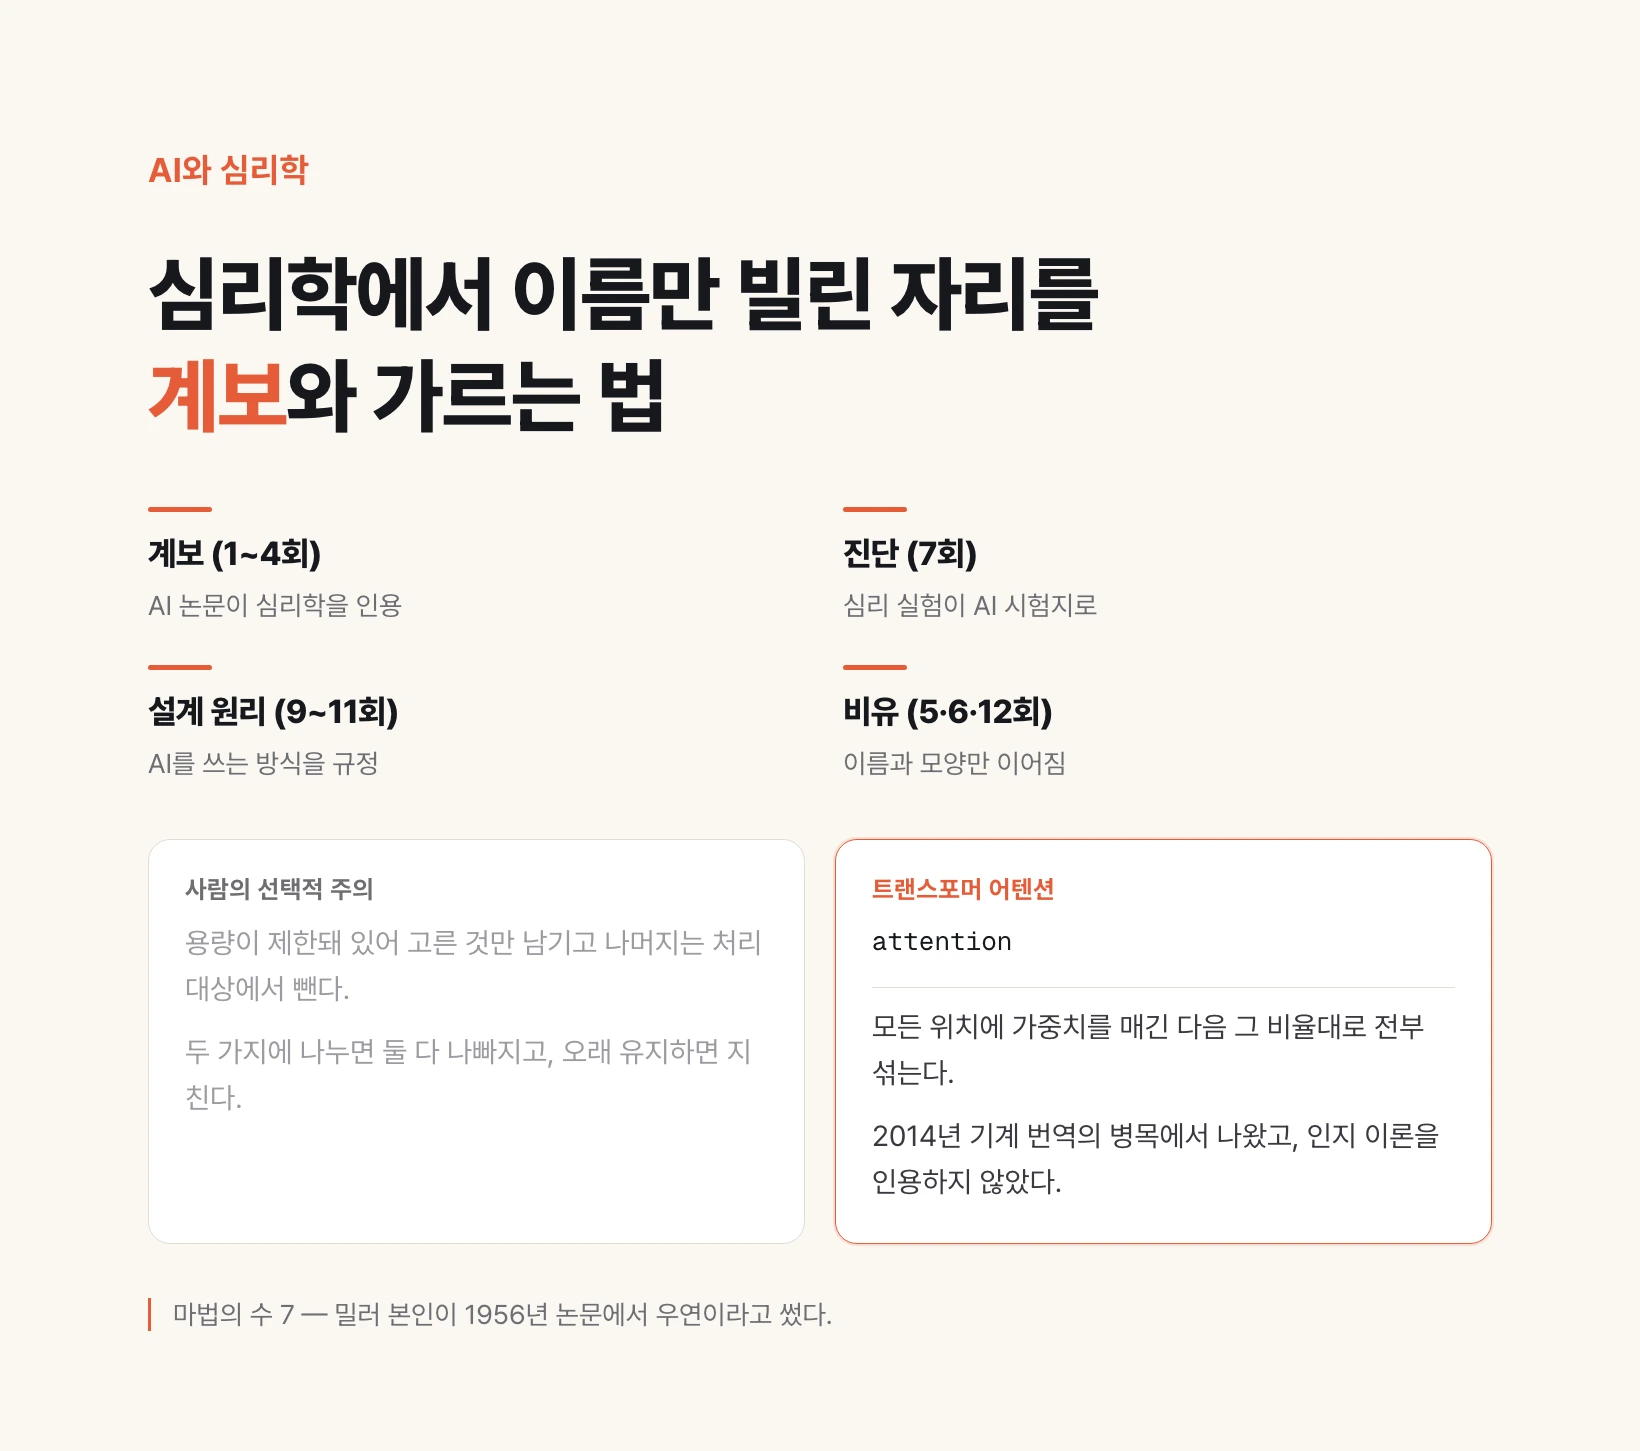
过去十一篇讲了不同种类的故事。有可以顺着引用追下去的谱系:从巴甫洛夫到强化学习,从猫的视觉皮层到卷积网络,从赫布到PDP,从巴德利到外部记忆。
也有心理学的实验设计变成测量AI的尺子的情形,锚定就是。还有心理学与人因知识规定的不是AI技术而是使用AI的方式的情形:拟人化、自动化的反讽、使用方式的四分类。
还有帮助理解的比喻:阿希的从众与奉承,巴特利特的记忆与幻觉。
每一期都贴标签的理由,就在这一期。在AI报道里看到心理学术语时,要问它是谱系还是名字。下面用三个案例整理这个分辨法,并把整个系列按等级收尾。
注意力——只有名字相同
如今语言模型的核心装置是注意力。可它与这个系列讲过的任何谱系都不同。
它出自2014年的机器翻译。当时主流的循环网络从头一个一个读,边读边更新状态,句子一长开头就淡了——因为要把一整个长句压进一个固定长度的向量里。
于是有了这样的解法:让解码器每生成一个输出词时都能回看输入的任意位置,每次重新计算输入的哪些部分与这个词相关。最早提出这个装置的论文,是把它当作对齐问题来解的——翻译里那个老问题:哪个原文词对应哪个译文词。
也就是说,起点是工程上的瓶颈,而不是认知理论。它不是引用布罗德本特的过滤器模型或鸡尾酒会效应设计出来的。注意力这个名字之所以被安上,是因为用它来描述这个计算在做什么很方便,之后才固化为标准术语。
它与人的注意有何不同
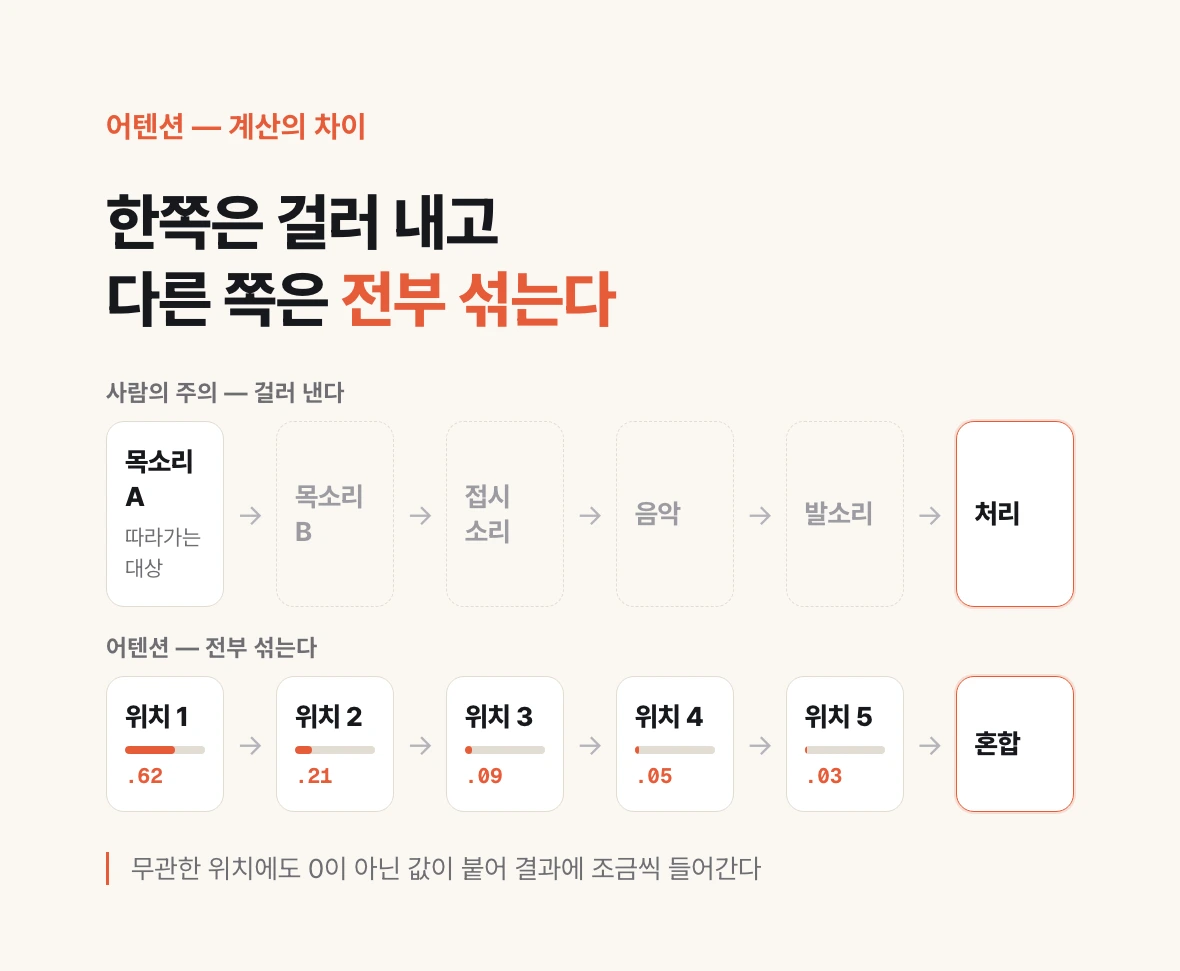
名字一样,似乎计算也该一样,可实际做的事不同。差别一句话就够:人的注意是过滤掉,Transformer的注意力是分配权重。
选择性注意理论的核心是舍弃。在嘈杂的派对上跟着一个人的声音时,其余的声音大部分被排除在加工之外。容量有限所以必须挑,没被挑中的大体就进不来。
注意力恰恰相反。它给每个位置都打上权重,然后按这个权重把全部混合起来。无关的位置也会拿到非零的值,那些值会一点点进入结果。它不是过滤器,而是决定配比的装置。
这个差别并不琐碎。我们对人的注意所知的性质,多数都源自容量限制:同时专注两件事两件都变差,长时间维持注意会累,经过训练对特定对象的选择会变快。把这些性质照搬到注意力上,全都是错的。
所以说AI在集中注意力是比喻,不是心理学现象的实现。名字取得好,所以误解才长久。
上下文窗口——与七加减二毫无关系
经常看到有人在AI的记忆容量这个说法旁边引用米勒的神奇数字七加减二。这个引用错了两重。
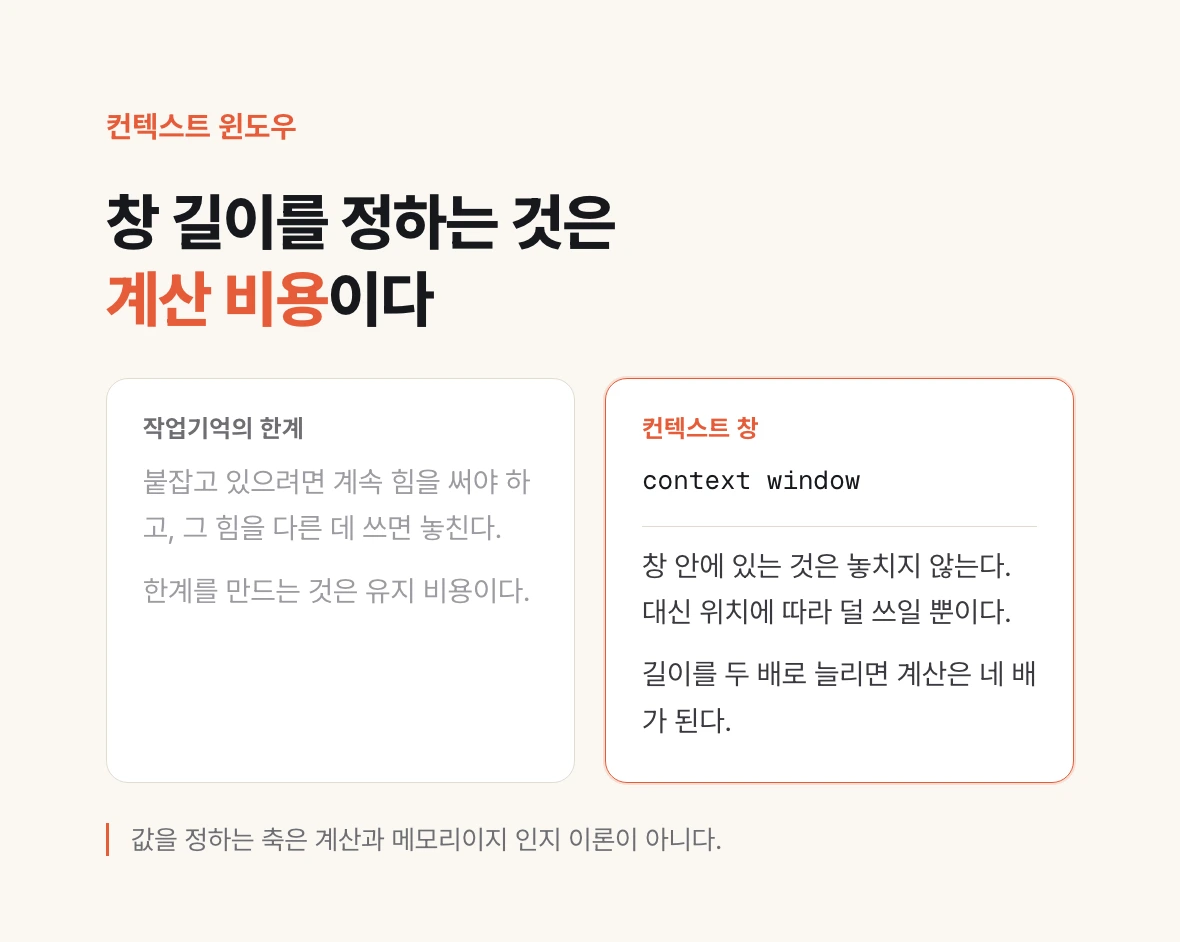
第一,决定上下文窗口长度的是计算成本。因为注意力要看所有位置对,计算量随长度的平方增长——长度翻倍,计算就是四倍。降低这个成本的技术不断出现,窗口也随之变宽,但决定这个数值的轴依然是算力与显存,而不是认知理论。
第二,两个概念本来测的就不是一回事。工作记忆的限制如第四期所见是维持成本的问题:要一直抓着就得一直用力,把这份力用到别处就会掉。上下文窗口不是那样。窗口里的东西不会掉,只是按位置被用得多或少。
当然在实务上两条线有交汇之处。如第四期所见,窗口宽不等于用得好,所以需要清理工作台的功夫。但那并不是因为容量是七。
米勒本人否认过那个数字
更有意思的是原论文那边。神奇数字七从来没有被以人们引用的那种方式主张过。
在1956年论文的结尾处,米勒写道:这些七的背后也许有某种深刻而玄妙的东西,但我怀疑那只是一个有害的毕达哥拉斯式巧合。这句话跟在世界七大奇迹、七大洋、七宗罪的罗列之后。作者是在直接告诉读者别把这个数字神秘化。
1989年他说得更明白:那篇论文涉及两条不同的研究线索,而七这个数字是把它们缝进一场讲演的修辞装置。不是被发现的常数,而是叙述的接缝。
另外常被附带的所以电话号码是七位这个说法也没有根据。只是时期重合,没有支持因果的记录。
这个系列反复强调的教训在这里又出现了:越有名的数字越要去核原文。被广泛引用不等于被广泛读过。
幻觉这个词也不准确
第六期讲了幻觉,而这个名字本身就是这一期的材料。
在临床上,幻觉是知觉的问题:看到或听到并不存在的东西。可模型编造出不存在的论文并不是知觉问题,而是记忆与陈述的问题。如第六期所见,更准确的对应是虚构:在没有自觉的情况下填补空缺,并把它当作事实深信不疑。
这个名字进来的路径也不是从心理学直接进口的。这个词早先在AI内部以另一种意思被使用:给低分辨率图像造出并不存在的细节,这项工作有一个名字,那种用法后来移到了语言这边。也就是说,不是借来一个心理学概念,而是领域内部的行话被扩展了。
所以研究者之间也有人指出这个术语并不恰当。一个理由是刚说的准确性问题,另一个是这个词会让人联想到病理。叫它幻觉,听起来像是平时好好的、偶尔出点毛病,而实际上它处在正常运作的延长线上。
尽管如此,这个系列仍继续使用这个词,因为它是通行的词。不同之处在于,使用时知道自己知道什么。
幻觉与奉承——比喻有用,原因不同
第六期和第五期的比喻在这里回收。
幻觉与虚构症在形状上像得惊人:察觉不到空缺,对填进去的东西深信不疑,在被指出之前都很从容。但原因不是受损的记忆回路,而是按概率挑下一个词的结构、训练数据的缝隙,以及不给弃权分数的评分方式。
奉承与阿希的从众在结果上相同:压力一来就退。但原因不是群体压力,而是人的偏好数据给迎合的回答打了更高分的历史。
继续使用这两个比喻的理由很清楚:它们会改变处方。当作说谎看就会去要求诚实,当作填空看就会去供给材料;当作性格软弱看就会叫它说得果断些,当作评分表的产物看就会不再先说出自己的意见。
好的比喻不是原因的解释,而是改变行为的工具。这个系列里比喻等级的几期给出的实用条目最多,并非偶然。
那么到哪一步是真的
把这个系列讲过的东西整理一下,是四个等级。最初分了三个,可那样第九到第十一期无处安放。那三期讲的不是心理学造出了AI技术,而是规定了使用AI的方式,所以要单立一格。
第一,算法谱系:AI论文引用心理学文献做出了技术。强化学习从巴甫洛夫与雷斯科拉-瓦格纳到萨顿与巴托,卷积网络从休伯尔与维泽尔经福岛到勒昆,联结主义从赫布到PDP,外部记忆从巴德利到神经图灵机。第一到第四期。
第二,诊断:心理学的实验设计被用作测量AI的尺子。以锚定为代表的认知偏差清单原样成了考卷。第七期。
第三,设计原理:心理学与人因知识规定的不是技术而是运用方式。拟人化、自动化的反讽、使用方式四分类。说是谱系吧,它不是任何AI算法的祖先;说是比喻吧,它可以直接套用。第九到第十一期。
第四,比喻:只有名字或形状接了过来。注意力、上下文窗口、幻觉、奉承。第五、第六期和这一期。
第八期在一期之内就分了岔。系统一与系统二是AI研究真的采纳了的,接近第一类;而出声思考法与思维链的关系属于第四类。所以它的标签是部分谱系。
名字被安上的那一刻会发生什么
可是名字稍微不合适又怎么样呢?能沟通不就行了吗。
问题在于名字不会独自到来。借用一个概念的名字,附着在那个概念上的其他性质也会毫无根据地一并进来。
叫它注意力,人们就会假定它是有限资源、假定分散了就变差、假定训练能提升。叫它记忆容量,人们就会假定它像人的记忆一样随时间淡去、假定接近上限时性能会陡降。这些没有一条被确认过。
在组织里这会变成真实成本的地方是:当这个工具像人一样运作、所以照对人的方式处理就行这个结论进入引入决策的时候。第九期看到的把语气读成能力的习惯也是同一个根。
反方向也有风险:因为有些名字不合适,就连真正的谱系也一并否定。强化学习引用了巴甫洛夫是事实,神经图灵机引用了巴德利也是事实。把一切都归为比喻同样是错的。
那么明天该改变什么
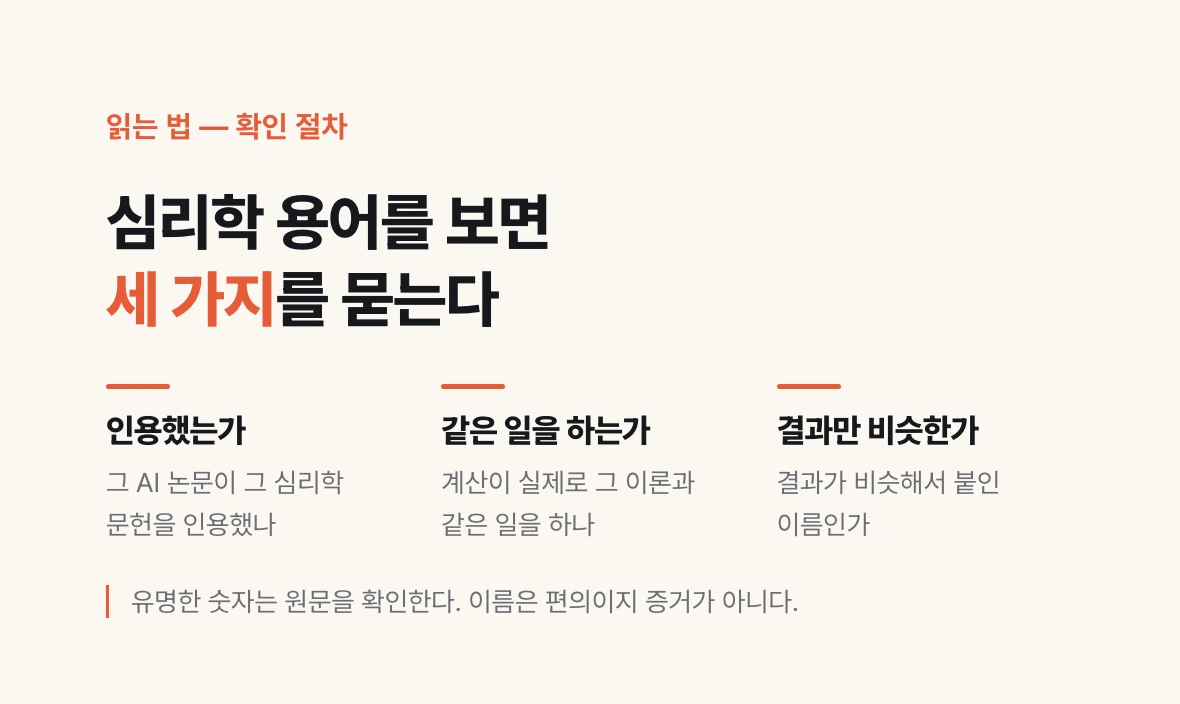
在AI报道里看到心理学术语时,问三件事:那篇AI论文引用了那份心理学文献吗?它的计算是否真的在做与那个理论相同的事?还是因为结果相似而安上的名字?光是把它归进三者之一,读那篇报道的方式就会不同。
不要把术语相同折成性质相同。从AI在集中注意力去推断人的注意的性质是错的,从AI的记忆容量把人的记忆的限制搬过来也是错的。名字是方便,不是证据。
有名的数字要去核原文。七加减二就是最好的例子。被广泛引用的和作者主张的可以不同。在这个系列里,实际上不止一次如此。
但仍然不要丢掉比喻。这个系列的结论不是别用比喻,而是知道它是比喻地去用。知道就是工具,不知道就是误解。
如果说有一句话贯穿这十二篇,那就是:对理解AI最有用的心理学,不是解释AI的心的那种心理学,而是告诉你在它面前自己的判断会怎样走偏的那种心理学。