열한 번의 이야기를 여기서 나눈다
지난 열한 편에서 서로 다른 종류의 이야기를 했다. 문헌으로 이어지는 계보가 있었다. 파블로프에서 강화학습으로, 고양이 시각피질에서 CNN으로, 헵에서 PDP로, 배들리에서 외부 메모리로.
심리학 실험 설계가 AI를 재는 자가 된 경우도 있었다. 앵커링이 그것이다. 심리학과 인간요인 지식이 AI 기법이 아니라 AI를 쓰는 방식을 규정한 경우도 있었다. 의인화, 자동화의 아이러니, 사용 방식 4분류다.
그리고 이해를 돕는 비유가 있었다. 아쉬의 동조와 아부, 바틀렛의 기억과 환각.
회차마다 배지를 달아 둔 이유가 이 회차다. AI 기사에서 심리학 용어를 보면 그것이 계보인지 이름인지 물어야 한다. 그 구분법을 세 사례로 정리하고, 시리즈 전체를 등급으로 묶어 마무리한다.
어텐션 — 이름만 같다
지금 쓰는 언어 모델의 핵심 장치가 어텐션이다. 그런데 이것은 이 시리즈가 다룬 어떤 계보와도 다르다.
이 장치가 나온 자리는 2014년 기계 번역이다. 당시 주류였던 순환신경망은 문장을 앞에서부터 하나씩 읽으며 상태를 갱신했는데, 문장이 길어지면 앞부분이 흐려졌다. 긴 문장을 통째로 고정 길이 벡터 하나에 밀어 넣어야 했기 때문이다.
그래서 나온 해법이 디코더가 출력 단어를 만들 때마다 입력의 어느 위치든 되돌아볼 수 있게 하는 것이었다. 이 단어를 낼 때 입력의 어느 부분이 관련 있는가를 매번 계산하게 한 것이다. 처음 이 장치를 낸 논문은 이것을 정렬 문제로 놓고 풀었다. 번역에서 어느 원문 단어가 어느 번역 단어에 대응하는가라는 오래된 문제다.
즉 출발점이 인지 이론이 아니라 공학적 병목이었다. 브로드벤트의 필터 모형이나 칵테일 파티 효과 같은 선택적 주의 이론을 인용해 설계한 게 아니다. 어텐션이라는 이름은 그 계산이 하는 일을 설명하기에 편해서 붙었고, 그 뒤에 표준 용어로 굳었다.
사람의 주의와 무엇이 다른가
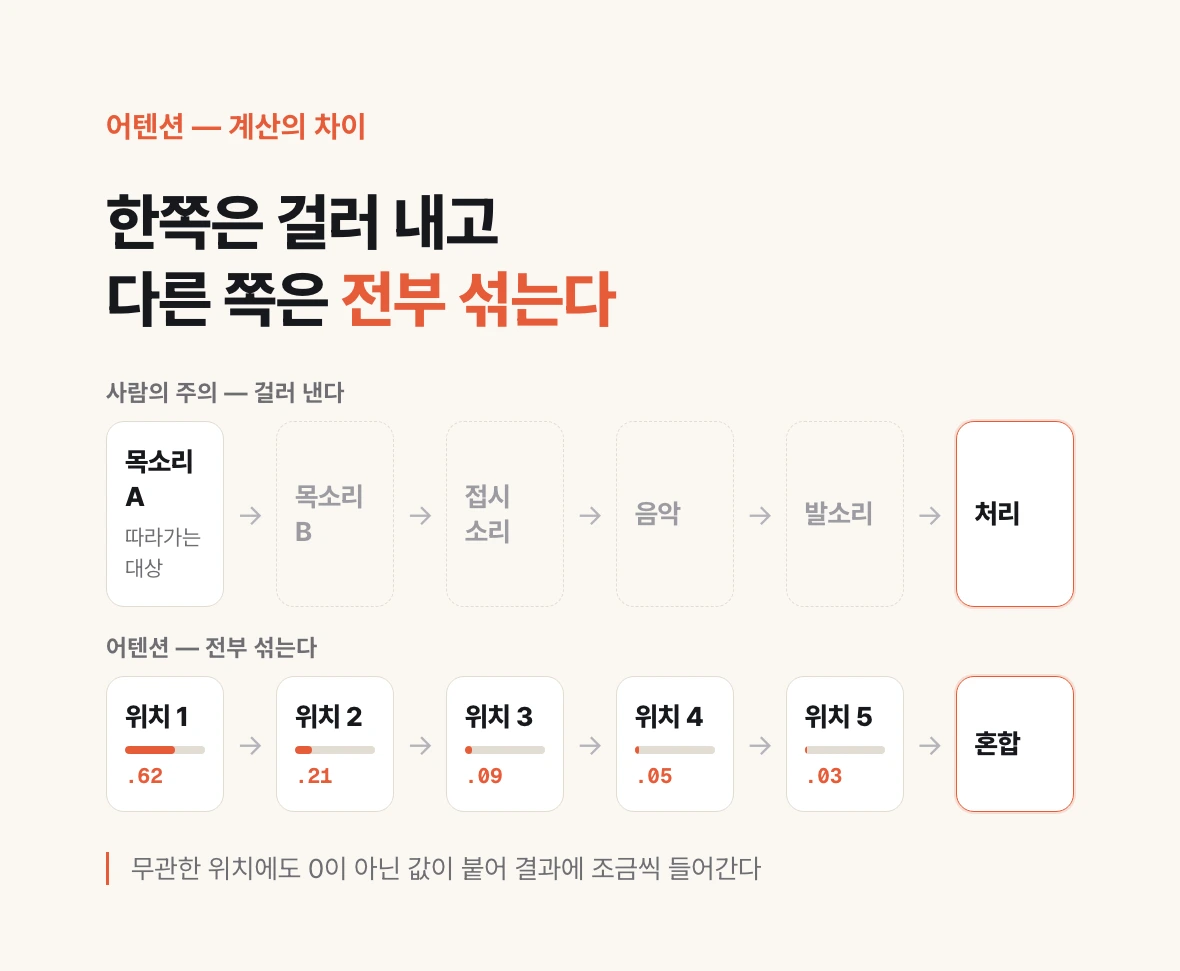
이름이 같으니 계산도 같을 것 같지만, 실제로 하는 일이 다르다. 차이가 한 문장으로 정리된다. 사람의 주의는 걸러 내고, 트랜스포머의 어텐션은 비중을 둔다.
선택적 주의 이론의 핵심은 버리는 것이다. 시끄러운 파티장에서 한 사람의 목소리를 따라갈 때, 나머지 소리는 처리 대상에서 상당 부분 빠진다. 용량이 제한돼 있으니 골라야 하고, 고르지 않은 것은 대체로 들어오지 않는다.
어텐션은 반대다. 모든 위치에 가중치를 매긴 다음 그 가중치대로 전부 섞는다. 관련 없는 위치에도 0이 아닌 값이 붙고, 그 값이 결과에 조금씩 들어간다. 걸러 내는 장치가 아니라 배합 비율을 정하는 장치다.
이 차이가 사소하지 않은 이유가 있다. 사람의 주의에서 우리가 아는 성질들은 대부분 용량 제한에서 나온다. 두 가지에 동시에 집중하면 둘 다 나빠지고, 주의를 오래 유지하면 지치고, 훈련하면 특정 대상에 대한 선택이 빨라진다. 이 성질들을 어텐션에 그대로 옮기면 전부 틀린다.
그러니 AI가 주의를 기울인다는 말은 은유이지 심리학 현상의 구현이 아니다. 이름은 잘 지어졌고, 그래서 오해가 오래간다.
컨텍스트 윈도우 — 7 플러스마이너스 2와 아무 상관이 없다
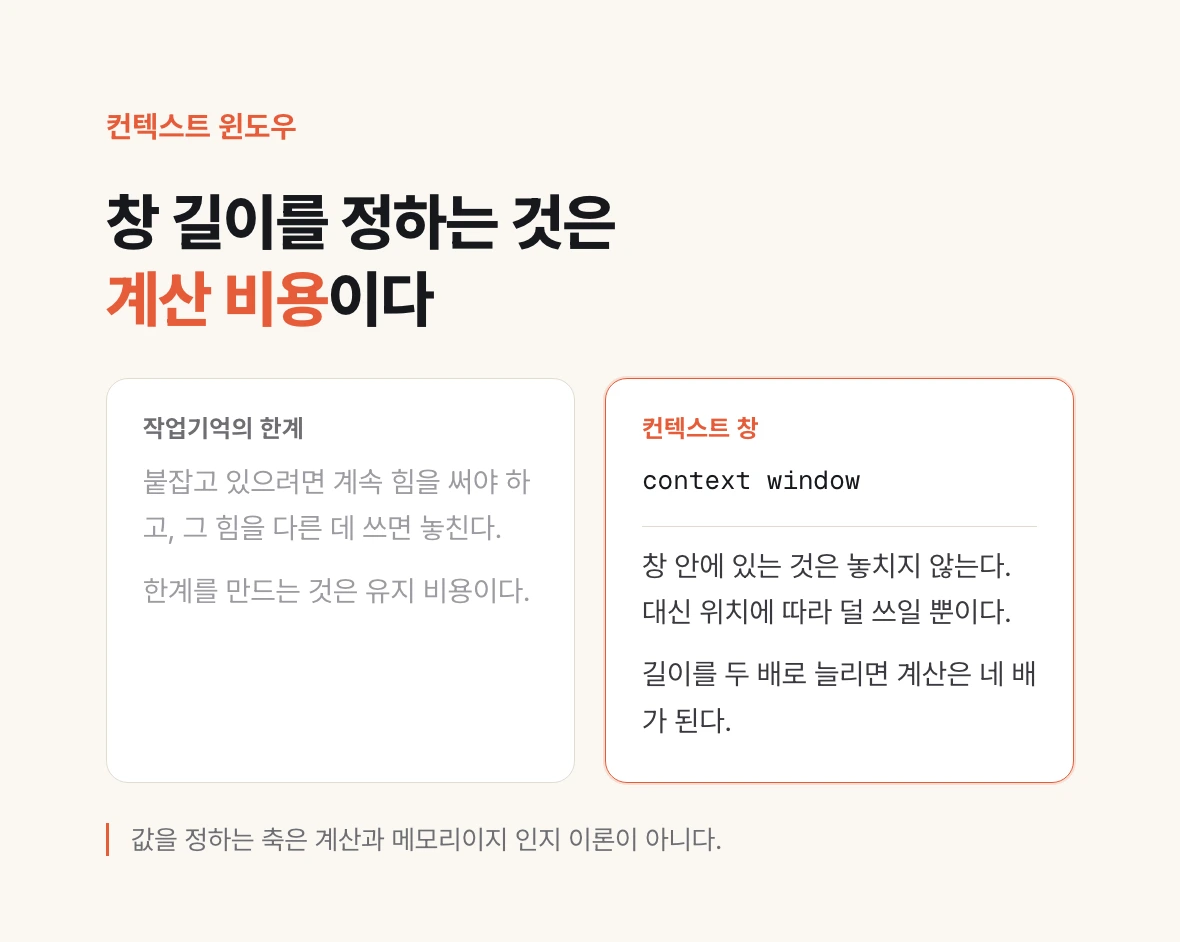
AI의 기억 용량이라는 표현과 함께 밀러의 마법의 수 7 플러스마이너스 2가 인용되는 걸 자주 본다. 두 번 틀린 인용이다.
첫째, 컨텍스트 윈도우의 길이를 정하는 것은 계산 비용이다. 어텐션이 모든 위치 쌍을 보기 때문에 계산량이 길이의 제곱으로 늘어난다. 길이를 두 배로 늘리면 계산이 네 배가 된다는 뜻이다. 이 비용을 줄이는 기법들이 계속 나오면서 창이 넓어져 왔지만, 값을 정하는 축은 여전히 계산과 메모리이지 인지 이론이 아니다.
둘째, 애초에 두 개념이 재는 것이 다르다. 작업기억의 한계는 4회차에서 봤듯 유지 비용의 문제다. 붙잡고 있으려면 계속 힘을 써야 하고, 그 힘을 다른 데 쓰면 놓친다. 컨텍스트 창은 그런 게 아니다. 창 안에 있는 것은 놓치지 않는다. 대신 위치에 따라 덜 쓰일 뿐이다.
물론 실무적으로는 두 이야기가 만나는 지점이 있다. 4회차에서 본 대로 창이 넓다고 잘 쓰이는 건 아니고, 그래서 작업대를 치우는 요령이 필요하다. 다만 그것은 용량이 7이라서가 아니다.
밀러 본인이 그 숫자를 부인했다
더 재미있는 것은 원 논문 쪽이다. 마법의 수 7은 인용되는 방식대로 주장된 적이 없다.
1956년 논문의 마지막 대목에서 밀러는 이렇게 쓴다. 이 모든 7 뒤에 깊고 심오한 무언가가 있을지도 모르지만, 나는 그것이 해로운 피타고라스적 우연이라고 의심한다. 세계 7대 불가사의, 칠대양, 일곱 가지 죄악을 나란히 늘어놓은 다음에 나오는 문장이다. 저자가 그 숫자를 신비화하지 말라고 직접 말한 것이다.
1989년에는 더 분명하게 밝혔다. 그 논문은 서로 다른 두 갈래의 연구를 다루고 있었고, 7이라는 숫자는 그 둘을 하나의 강연으로 묶기 위한 수사적 장치였다는 것이다. 발견된 상수가 아니라 이야기의 이음매였다.
덧붙여 자주 따라붙는 그래서 전화번호가 7자리라는 설명도 근거가 없다. 시기가 겹칠 뿐 인과를 뒷받침하는 기록이 없다.
여기서 이 시리즈가 반복해 온 교훈이 다시 나온다. 유명한 숫자일수록 원문을 확인해야 한다. 널리 인용된다는 것은 널리 읽혔다는 뜻이 아니다.
환각이라는 말도 정확하지 않다
6회차에서 환각을 다뤘는데, 그 이름 자체가 이 회차의 소재다.
임상에서 환각은 감각의 문제다. 없는 것이 보이거나 들리는 것이다. 그런데 모델이 없는 논문을 만들어 내는 것은 감각의 문제가 아니라 기억과 진술의 문제다. 6회차에서 봤듯 더 정확한 짝은 작화다. 빈칸을 자각 없이 메우고 그것을 확신하는 것.
이름이 이렇게 붙은 경로도 심리학에서 직수입된 게 아니다. 이 말은 AI 안에서 먼저 다른 뜻으로 쓰이고 있었다. 저해상도 사진에서 없는 세부를 그럴듯하게 만들어 내는 작업을 부르는 이름이 있었고, 그 용법이 언어 쪽으로 옮겨 왔다. 즉 심리학 개념을 가져온 게 아니라 분야 안의 관용어가 확장된 것이다.
그래서 연구자들 사이에서도 이 용어가 적절하지 않다는 지적이 나온다. 하나는 방금 말한 정확성 문제이고, 다른 하나는 이 말이 병리를 연상시킨다는 점이다. 환각이라고 부르면 평소에는 멀쩡한데 가끔 이상해지는 것처럼 들리는데, 실제로는 정상 작동의 연장선에 있다.
그럼에도 이 시리즈가 환각이라는 말을 계속 쓴 이유는 통용되는 말이기 때문이다. 다만 쓰면서 무엇을 아는지가 다르다.
환각과 아부 — 비유는 유용하고, 원인은 다르다
6회차와 5회차의 비유를 여기서 회수한다.
환각은 작화증과 모양이 놀랍도록 닮았다. 빈칸을 자각하지 못하고, 메운 결과를 확신하고, 지적당하기 전까지 태연하다. 그러나 원인은 손상된 기억 회로가 아니라 다음 말을 확률로 고르는 구조, 학습 데이터의 빈틈, 그리고 기권에 점수를 주지 않는 채점 방식이다.
아부는 아쉬의 동조와 결과가 같다. 압력이 오면 물러선다. 그러나 원인은 집단 압력이 아니라 사람 선호 데이터가 동의하는 답에 높은 점수를 준 이력이다.
두 비유를 계속 쓸 이유는 분명하다. 처방이 달라지기 때문이다. 거짓말로 보면 정직성을 요구하게 되지만 빈칸 메우기로 보면 재료를 대게 된다. 성격이 무르다고 보면 단호하게 말하라고 하게 되지만 채점표의 결과로 보면 내 의견을 먼저 말하지 않게 된다.
좋은 비유는 원인 설명이 아니라 행동을 바꾸는 도구다. 이 시리즈에서 비유 등급의 회차들이 실용 항목을 가장 많이 낸 것도 우연이 아니다.
그러면 어디까지가 진짜였나
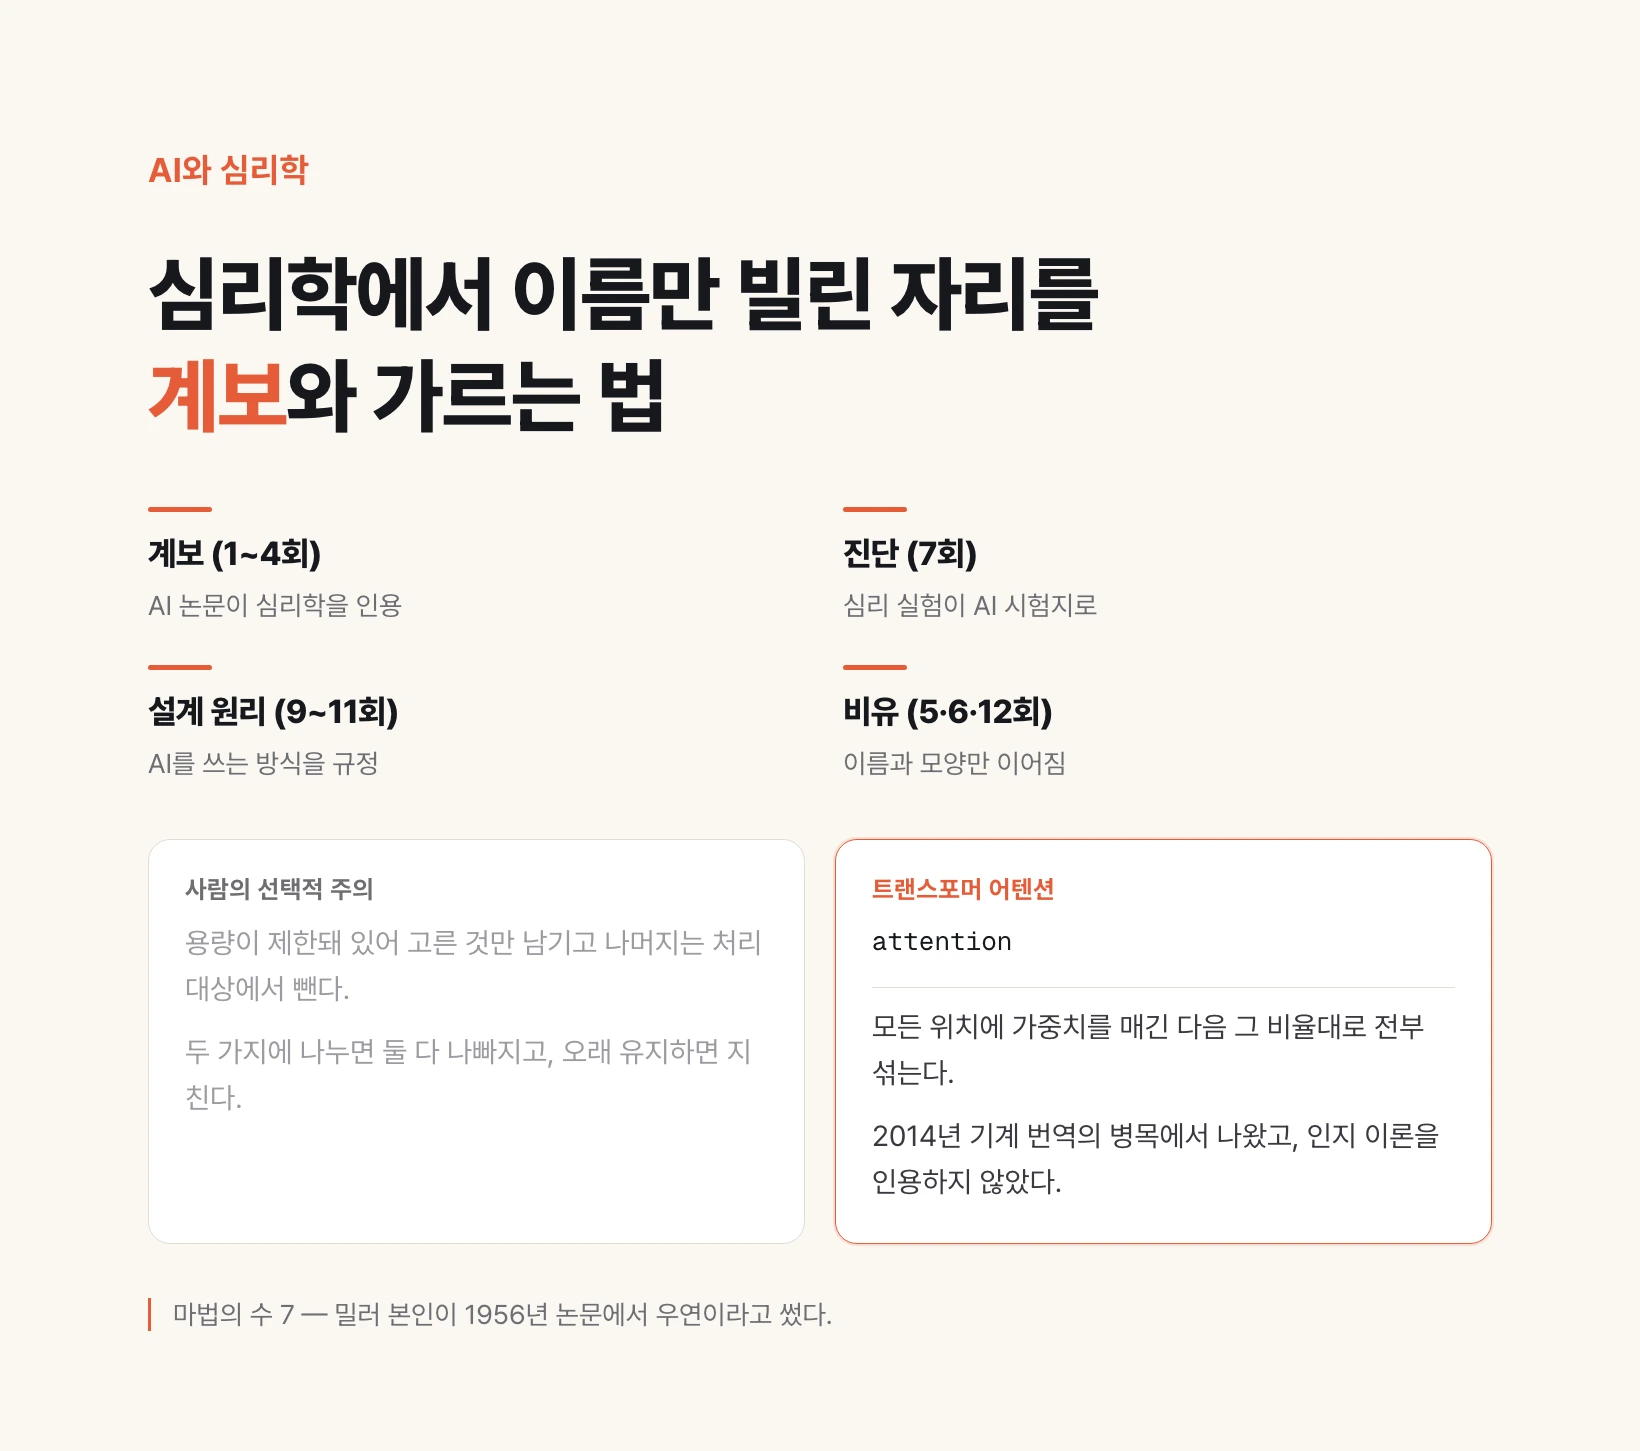
이 시리즈에서 다룬 것들을 네 등급으로 정리하면 이렇다. 처음엔 셋으로 나눴는데, 그러면 9회에서 11회가 갈 곳이 없었다. 그 셋은 심리학이 AI 기법을 만든 게 아니라 AI를 쓰는 방식을 규정한 경우라 따로 세워야 한다.
첫째, 알고리즘 계보. AI 논문이 심리학 문헌을 인용해 기법을 만든 것이다. 강화학습은 파블로프와 레스콜라·와그너에서 서턴·바토로, CNN은 허블·비셀에서 후쿠시마를 거쳐 르쿤으로, 연결주의는 헵에서 PDP로, 외부 메모리는 배들리에서 신경 튜링 기계로 이어진다. 1회에서 4회다.
둘째, 진단. 심리학 실험 설계가 AI를 재는 자로 쓰이는 것이다. 앵커링을 비롯한 인지 편향 목록이 그대로 시험지가 됐다. 7회다.
셋째, 설계 원리. 심리학과 인간요인 지식이 AI 기법이 아니라 운용 방식을 규정하는 것이다. 의인화, 자동화의 아이러니, 사용 방식 4분류. 계보라 부르기엔 AI 알고리즘의 조상이 아니고, 비유라 부르기엔 그대로 적용된다. 9회에서 11회다.
넷째, 비유. 이름이나 모양만 이어진 것이다. 어텐션, 컨텍스트 윈도우, 환각, 아부. 5회, 6회, 그리고 이번 회차다.
8회는 한 회 안에서 갈린다. 시스템 1과 2는 AI 연구가 실제로 채택했으니 첫째에 가깝지만, 발화사고법과 생각의 사슬의 관계는 넷째다. 그래서 배지가 부분 계보였다.
이름이 붙는 순간 무슨 일이 생기나
그런데 이름이 좀 안 맞는 게 왜 문제인가. 통하면 되는 것 아닌가.
문제는 이름이 혼자 오지 않는다는 데 있다. 어떤 개념의 이름을 빌리면 그 개념에 딸린 다른 성질들까지 근거 없이 따라 들어온다.
주의라고 부르면 사람들은 그것이 제한된 자원이라고 가정하고, 분산되면 나빠진다고 가정하고, 훈련으로 좋아진다고 가정한다. 기억 용량이라고 부르면 사람의 기억처럼 시간이 지나면 흐려진다고 가정하고, 용량 근처에서 성능이 급격히 떨어진다고 가정한다. 어느 것도 확인된 적이 없다.
이게 조직에서 실제 비용이 되는 자리가 있다. 이 도구는 사람처럼 작동하니 사람 다루듯 하면 된다는 결론이 도구 도입 결정에 들어갈 때다. 9회차에서 본 어조를 능력으로 읽는 습관도 같은 뿌리다.
반대 방향의 위험도 있다. 이름이 안 맞는다는 이유로 진짜 계보까지 부정하는 것이다. 강화학습이 파블로프를 인용한 것은 사실이고, 신경 튜링 기계가 배들리를 인용한 것도 사실이다. 전부 비유라고 접으면 그것도 틀린다.
그래서 내일 뭘 바꾸나
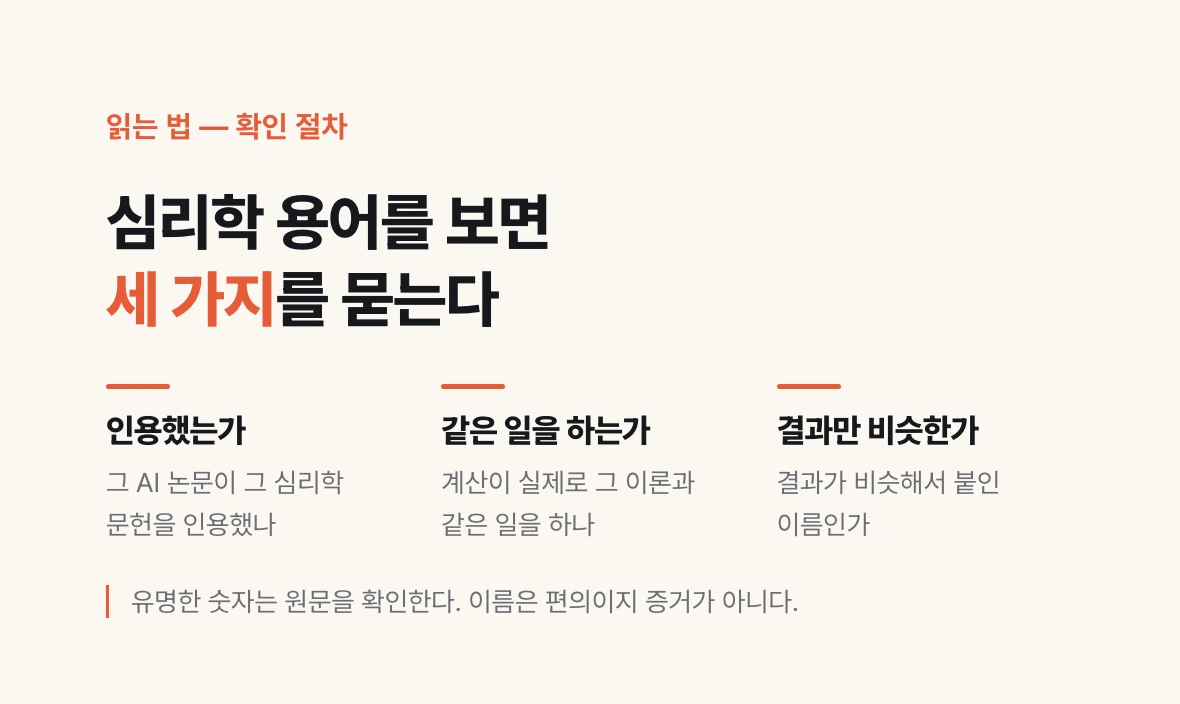
AI 기사에서 심리학 용어를 보면 세 가지를 묻는다. 그 AI 논문이 그 심리학 문헌을 인용했는가. 계산이 실제로 그 이론과 같은 일을 하는가. 아니면 결과가 비슷해서 붙인 이름인가. 셋 중 어디에 해당하는지만 정해도 그 기사를 읽는 방식이 달라진다.
용어가 같다고 성질이 같다고 접지 않는다. AI가 주의를 기울인다에서 사람의 주의 성질을 추론하면 틀리고, AI의 기억 용량에서 사람 기억의 한계를 가져오면 틀린다. 이름은 편의이지 증거가 아니다.
유명한 숫자는 원문을 확인한다. 7 플러스마이너스 2가 가장 좋은 예다. 널리 인용된 것과 저자가 주장한 것이 다를 수 있다. 이 시리즈에서 실제로 여러 번 그랬다.
그래도 비유는 버리지 않는다. 이 시리즈의 결론은 비유를 쓰지 말라가 아니라 비유인 줄 알고 쓰라는 것이다. 알고 쓰면 도구이고, 모르고 쓰면 오해다.
그리고 이 열두 편을 관통한 한 문장이 있다면 이것이다. AI를 이해하는 데 가장 쓸모 있는 심리학은 AI의 마음을 설명해 주는 심리학이 아니라, AI를 마주한 내 판단이 어떻게 어긋나는지 알려 주는 심리학이었다.