Insights
바이브 코딩과 AX, AI 에이전트, 직접 만든 도구와 실전 사례까지. 발행한 글의 확장판 정본을 주제별로 모았습니다.
AI·테크 뉴스레터 — 11/10(화)
AI는 값이 내려가고 사람 없이 오래 일하는 쪽으로 가고 있다. Claude Fable 5.2는 5.1보다 20% 싸졌고, 구글 Antigravity는 노트북을 닫아도 작업을 이어 가며, LG는 K-EXAONE 2.5를 별도 비용 없이 열었다. 그 사이 AI가 사람 대신 나서는 자리에는 규칙이 붙는다. 11월 27일부터 AI로 만든 가짜 의사·약사 식품광고가 금지되고, 건보공단 상담 노조는 AI 비서 전화를 거부할 권리를 요구했다.
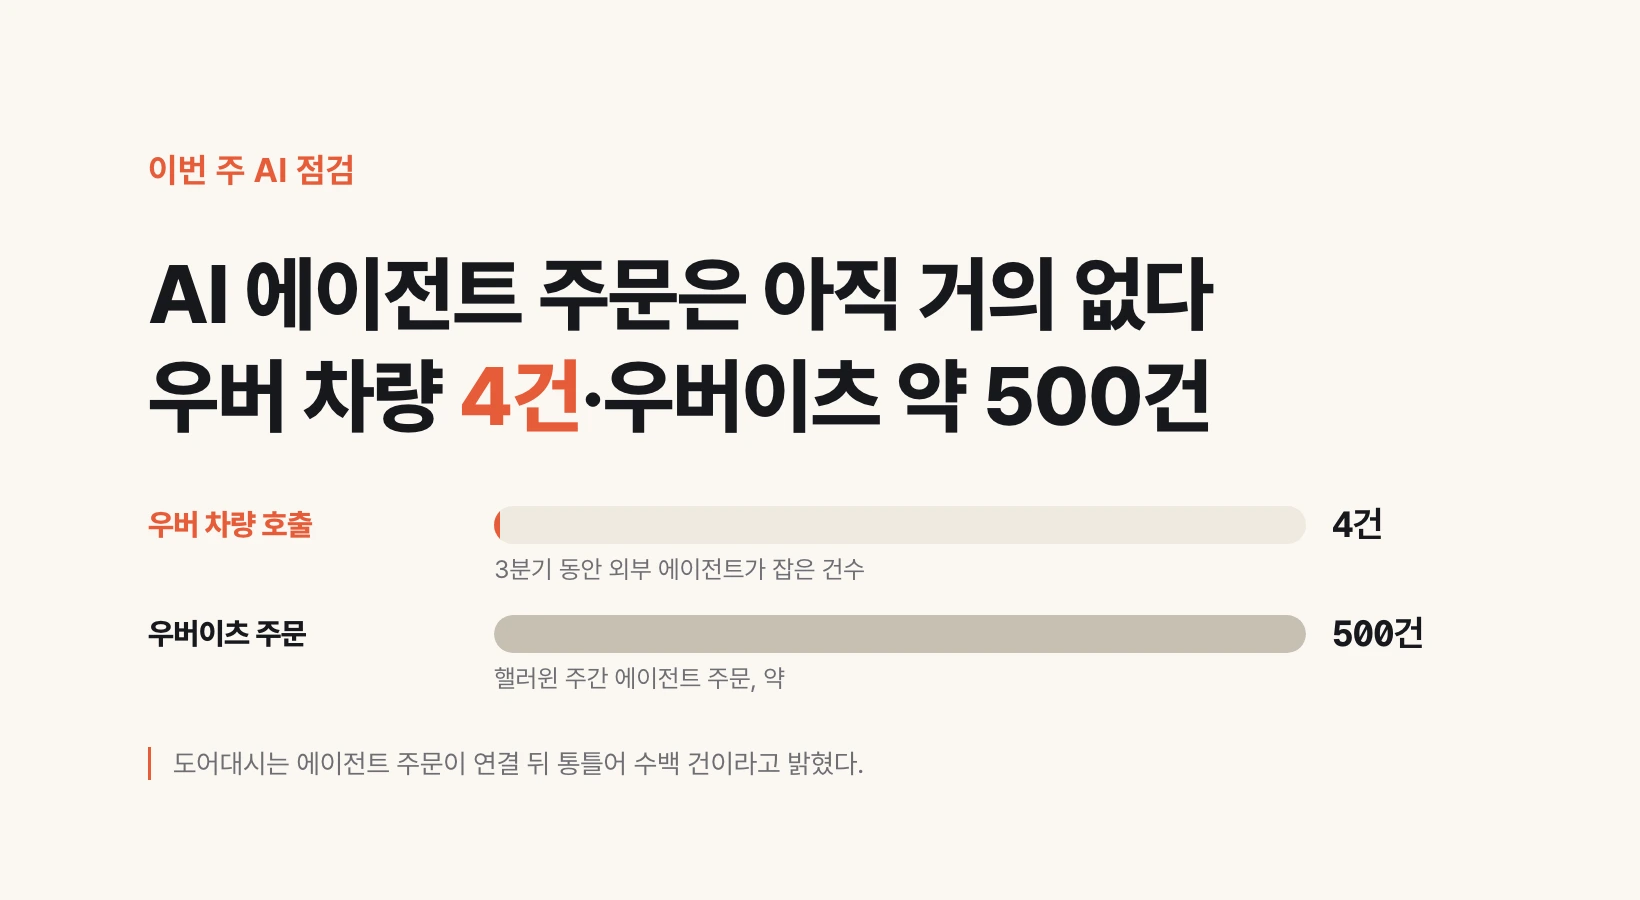
AI 에이전트 주문은 도어대시 수백 건·우버 4건 — 이번 주 AI에서 확인할 한도·값·권한
2026년 11월 첫째 주의 핵심은 AI 에이전트가 생각만큼 쓰이지 않는다는 숫자와, 이미 쓰는 도구의 한도·값·권한이 바뀌었다는 소식이다. 도어대시는 외부 AI 에이전트가 낸 주문이 연결 뒤 통틀어 수백 건이라고 밝혔고, 우버는 3분기에 에이전트가 잡은 차량 호출이 4건이었다고 했다. OpenAI는 12월부터 Plus·Pro·Business 요금제에서 ChatGPT와 Codex가 사용 한도 하나를 나눠 쓴다고 알렸다. 구글은 15초 영상을 30% 낮은 값에 만드는 Gemini Omni 1.2 Flash를 냈고, 앤트로픽은 은행 계좌를 읽기 전용으로 연결하는 Claude Personal Finance를 미국에서 베타로 열었다. 이번 주 할 일은 셋이다. 에이전트는 고객 주문 창구보다 사내 반복 업무 하나부터 맡기고, Codex를 많이 쓰는 팀은 지금 사용량을 기록해 두고, AI에 데이터를 연결할 때는 무엇을 읽는지부터 확인한다.
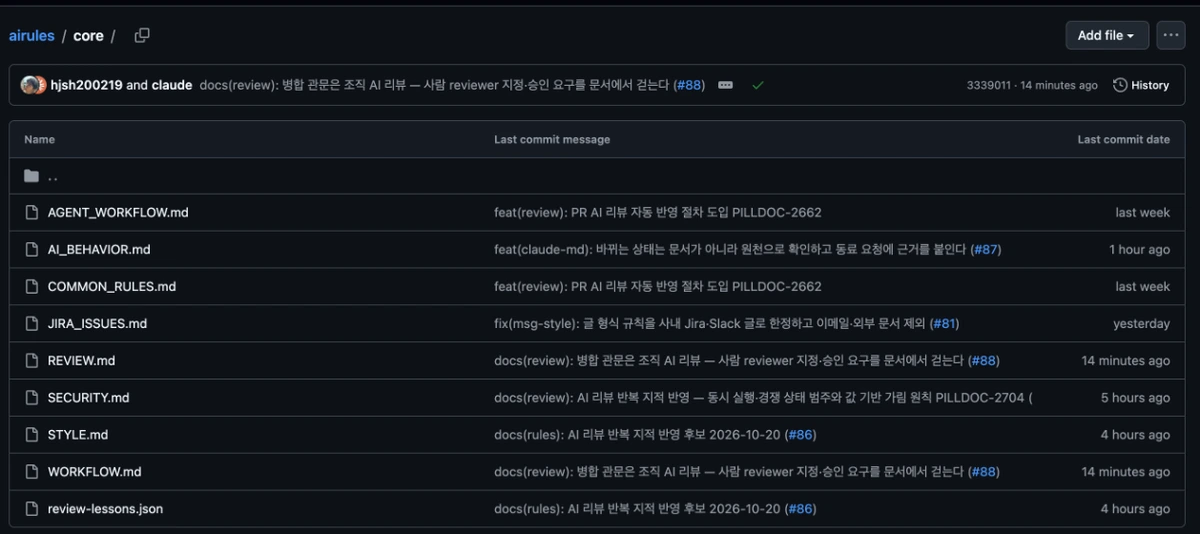
공통 AI 규칙 — 규칙 저장소 한 곳을 고치면 2~5분 뒤 7개 repo의 CLAUDE.md가 바뀐다
공통 AI 규칙은 조직의 모든 AI가 일을 시작할 때 똑같이 읽는 규칙을 한 곳에서 관리하는 방식입니다. 규칙을 문서로 공지하면 읽은 사람의 AI만 따릅니다. 그래서 규칙을 사람에게 돌리지 않고, Claude Code가 세션마다 먼저 읽는 CLAUDE.md 자리에 놓았습니다. 원본은 규칙 저장소 한 곳에 두고, 그곳을 고치면 GitHub의 자동 실행 기능이 2~5분 안에 서비스 저장소 7개로 복사합니다. 2026년 10월 21일 기준 최근 95회 복사가 모두 성공했고, 조직원 PC는 최신본을 받은 뒤 새 세션부터 같은 규칙으로 일합니다. 이 글은 그 구조와 규칙에 쓴 내용, 그리고 혼자서도 오늘 해 볼 수 있는 CLAUDE.md 세 줄을 정리합니다.
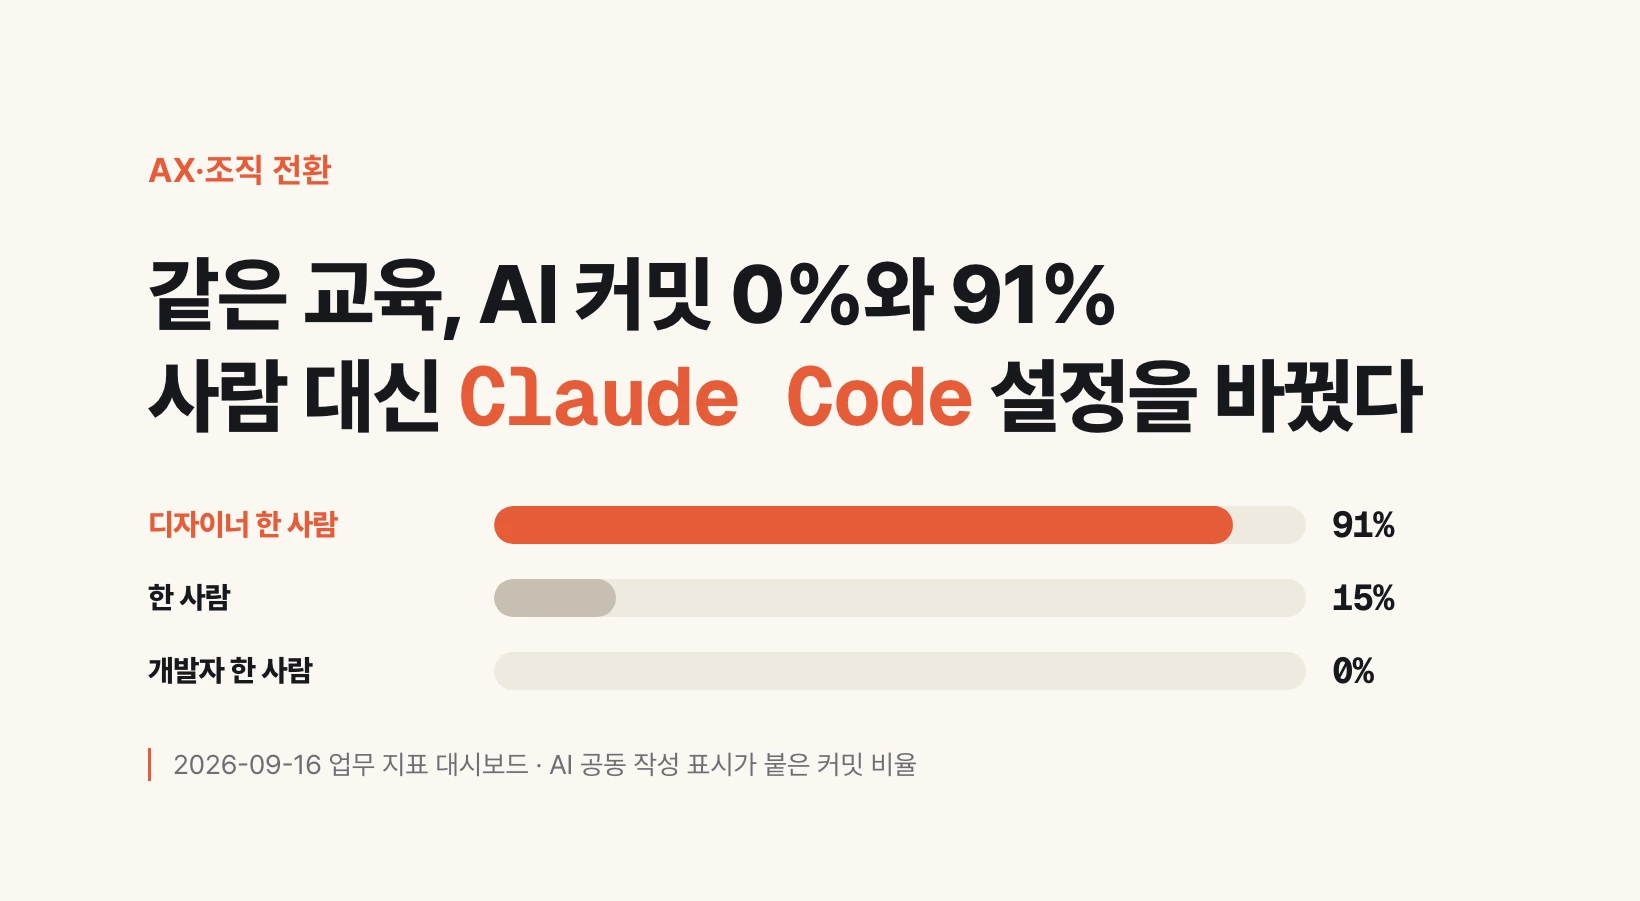
같은 AI 교육을 받아도 AI 커밋 비율은 0%와 91%로 갈렸다 — 그래서 사람이 아니라 Claude Code 설정을 바꿨다
약국용 서비스를 만드는 개발 조직에서 AX를 맡아 2026년 9월 16일 작업 기록을 세어 보니, 같은 교육과 같은 도구를 받았는데도 AI가 함께 썼다는 표시가 붙은 기록의 비율이 디자이너 한 사람은 91%, 개발자 한 사람은 0%였습니다. 교육을 더 해서 줄어들 차이가 아니라고 보고, 사람에게 새 습관을 요구하는 대신 모두가 쓰는 AI 쪽에 규칙을 넣었습니다. 6월부터 10월까지 공통 AI 규칙, Claude Team 관리 설정, KB, AI 리뷰·화면 검수 관문, 매일 회고의 다섯 가지를 차례로 깔았고, 이 연재는 그 다섯 가지를 일곱 편에 걸쳐 실제 화면과 숫자로 정리합니다. 1편은 왜 사람이 아니라 설정을 바꿨는지와, 내 저장소에서 AI 커밋 비율을 오늘 세어 보는 방법을 다룹니다.
AI·테크 뉴스레터 — 11/06(금)
코딩 AI 여러 개를 한 화면에서 굴리던 앱 Conductor가 메타에 합류하며 클라우드판을 11월 20일 닫는다. 웹 서비스를 돌리는 실행 엔진 Node.js는 11월 11일 세 지원 버전대에 높음(HIGH) 등급 보안 패치를 내고, 결제대행사 페이허브에서는 가맹점 정산자금 약 2억 원이 부정 이체됐다. 오늘은 새 기능보다 내 일이 올라탄 도구·실행 환경·돈길을 점검하는 날이다.
AI·테크 뉴스레터 — 11/05(목)
구글은 학생 계정의 AI를 기본으로 끄되 검색까지 한 묶음으로 묶었고, ChatGPT 광고는 방문 한 번에 버는 돈이 구글 검색 광고의 3분의 1에 그쳤다는 연구가 나왔다. 바이낸스의 63억 달러어치 자산 유출은 엔지니어 노트북 한 대에서 시작됐다. AI를 켜고 끄는 기본값과, 켠 뒤 무엇으로 성과를 재는지가 오늘의 공통 질문이다.
AI·테크 뉴스레터 — 11/04(수)
구글·마이크로소프트·OpenAI·앤트로픽이 robots.txt 한 줄로 'AI 학습에 쓰지 말라'는 뜻을 받기로 했다. 네이버는 AI 옥외광고 광고주의 78.5%가 대행사 없이 직접 집행한다는 리포트를 냈고, 12월 2일부터 모바일 검색홈 배너 규격을 바꾼다. 내 콘텐츠와 광고가 어디에 어떤 모양으로 쓰이는지, 규칙을 다시 볼 때다.
AI·테크 뉴스레터 — 11/03(화)
AI가 채팅창에서 문서를 고치고, 데스크톱 앱을 누르고, 코딩 전 설계를 검토하는 범위가 넓어졌다. 같은 AI가 훔친 정보에 값을 매기는 악성코드에도 들어갔고, 구글은 AI 검색 답변에 붙는 광고가 수익을 덜 낸다고 밝혔다. 오늘은 AI에 맡길 일과 지킬 계정을 함께 점검할 날이다.
AI·테크 뉴스레터 — 11/02(월)
앤트로픽이 월 200달러 Max 20x를 Ultra로 바꾸며 확인된 계정의 5시간 한도를 없앴고, OpenAI는 ChatGPT와 Codex를 한 사용량에서 함께 차감하는 방식으로 바꾼다고 알렸다. Claude Code가 화면 뒤 상태 문구를 만드는 데 한 주 비용의 16.4%를 썼다는 외부 측정도 나왔다. 구독 값보다 내 작업이 사용량을 어디에 쓰는지 볼 때다.
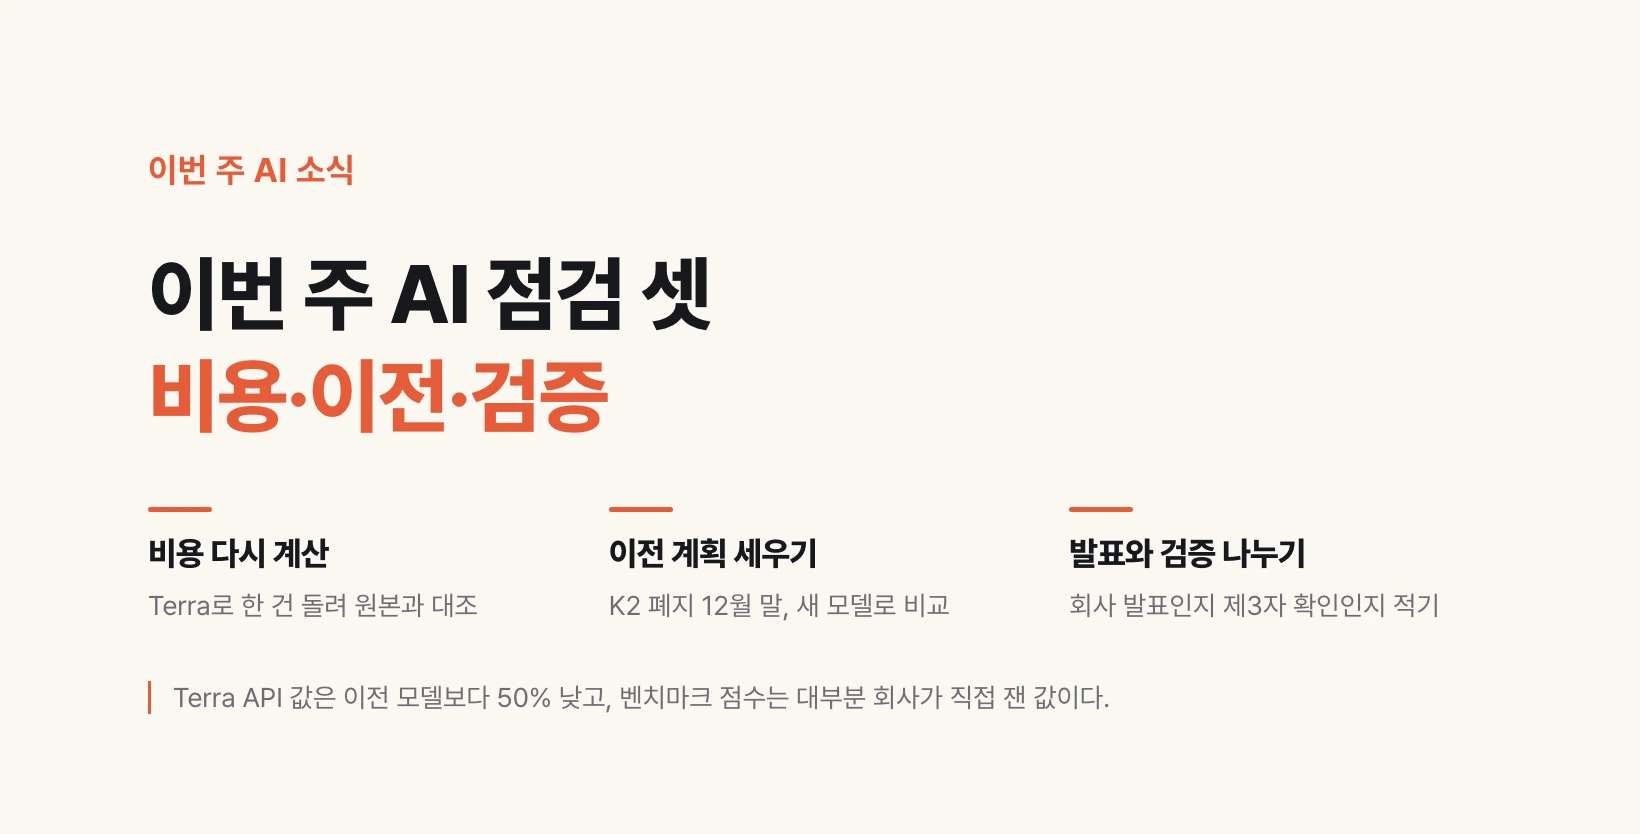
앤트로픽 상장 신청과 GPT-6.1 Terra 반값 — 이번 주 AI에서 비용·이전·검증 세 가지 점검
2026년 10월 넷째 주의 핵심은 AI가 더 싸지고, 더 열리고, 더 큰 주장을 내놓았다는 것이다. 앤트로픽은 10월 26일 미국 증권거래위원회에 상장 신청 서류(S-1)를 냈지만 상장일·공모가·주식 수는 아직 정해지지 않았다. 같은 날 OpenAI는 화면을 보고 앱을 직접 조작하는 GPT-6.1 Terra를 이전 모델보다 API 값 50% 낮게 냈고, Moonshot AI는 누구나 내려받아 돌릴 수 있는 Kimi K3.1 Pro를 내며 이전 K2 시리즈를 연말에 닫는다고 알렸다. 구글은 보안 방어용으로 Gemini 4 Carbon을 먼저 열고 실시간 월드 모델 Genie 4를 공개했으며, OpenAI는 AI가 오래된 계산 복잡도 가설을 반증했다는 주장을 외부 학자들의 검증에 맡겼다. 이번 주 할 일은 셋이다. 화면 작업 자동화 비용을 새 값으로 다시 계산하고, 쓰던 모델이 닫히기 전에 옮길 계획을 세우고, 회사 발표 수치와 검증된 사실을 나눠 읽는다.
AI·테크 뉴스레터 — 10/30(금)
ChatGPT Pro 구독에 매달 최대 500달러의 API 크레딧이 붙고, 예고됐던 Pro 200 사용량 축소는 취소됐다. 대신증권 고객 3만 8490명의 정보가 빠져나가 금융사를 사칭한 연락을 조심해야 하고, 구글 Gemini 4 Carbon은 보안 담당자에게만 먼저 열렸다. 한글(HWP) 문서를 원래 형식 그대로 고치는 이음오피스와 터치되는 OLED 맥북 프로 국내 사전 주문도 오늘 볼 소식이다.
AI·테크 뉴스레터 — 10/29(목)
Tailscale이 원격 접속 결함 4건을 1.104.4로 고쳤고, 더존비즈온은 Smart A 10·APO백업 두 서비스의 개인정보 유출 가능성을 공지했다. AI 모델 순위표 Artificial Analysis v5에서는 1~3위가 1점 차였지만, 같은 모델도 생각 깊이 설정에 따라 점수와 비용이 크게 갈렸다. 업데이트와 계정 정리를 먼저 하고, 모델은 내 업무로 비교할 날이다.
AI·테크 뉴스레터 — 10/28(수)
오픈AI가 이전의 절반 값으로 화면 조작용 모델 GPT-6.1 Terra를 내놨고, 앤트로픽은 상장 서류에서 기업 고객이 1년 전보다 9배를 쓰고 있다고 밝혔다. 같은 날 경찰은 AI 침투 도구로 작은 사업장 90여 곳을 턴 일당을 발표했고, 한국은행과 마이크로소프트 소식은 AI가 일자리 구조를 바꾸는 속도를 보여 준다.
AI·테크 뉴스레터 — 10/27(화)
사설망 도구 Tailscale에서 수정판이 나오기 전에 결함 11건이 공개됐고, Node.js는 10월 보안판으로 결함 10건을 고쳤다. 그래픽카드의 AI 계산 제한을 푸는 도구는 RTX 4090까지 넓어졌고, 네이버·당근은 11월부터 검색광고에서 입찰가보다 클릭 가능성을 더 본다. 오늘은 서버 설정부터 점검하고 광고 소재의 기준 숫자를 적어 둘 차례다.
AI·테크 뉴스레터 — 10/26(월)
ChatGPT Pro 200 기존 가입자가 Codex 예전 사용량을 받는 유예가 10월 29일에 끝난다. 여러 AI 도구를 한 작업 공간에 묶는 Tutti, Claude·ChatGPT 결과를 카카오톡으로 받는 PlayMCP처럼 도구를 엮는 방법은 늘고, 오래된 RTX 30 계열 그래픽카드의 AI 계산 속도를 끌어올리는 gpu-unlock도 공개됐다. 구독이든 장비든 얼마를 내고 실제로 얼마나 쓰는지 다시 재 볼 때다.
AI가 PHP 취약점을 먼저 찾은 주, 무엇부터 점검하나 — PHP 8.5.12·Railway·Claude Duet
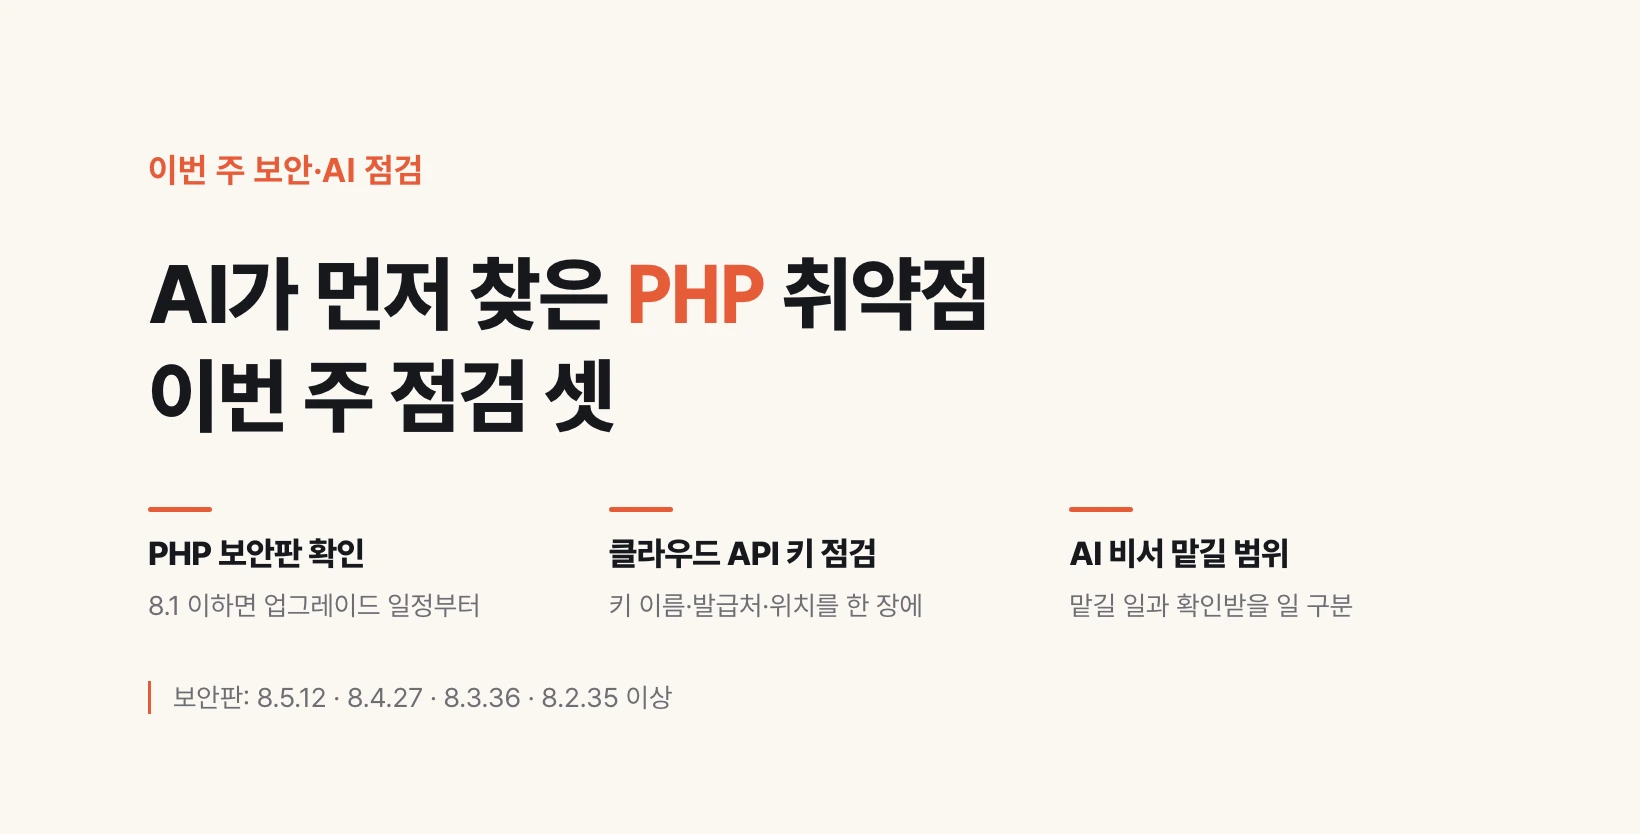
2026년 10월 셋째 주의 핵심은 AI가 공격자보다 먼저 치명적 취약점을 찾기 시작했다는 것이다. OpenAI는 보안 연구팀 Calif가 GPT-5.6 Sol로 PHP의 원격 코드 실행 취약점을 찾았다고 밝혔고, PHP는 10월 21일 8.5.12·8.4.27·8.3.36·8.2.35 보안판을 냈다. 같은 날 앱 배포 플랫폼 Railway는 고객 비밀값이 새어 나갔을 수 있다며 키를 전부 바꾸라고 권고했다. 한편 앤트로픽 Claude Duet처럼 사용자 대신 움직이는 AI는 넓어지고, Delta·JPMorgan Chase 같은 곳은 그런 AI의 접근을 막기 시작했다. 이번 주 할 일은 셋이다. PHP 버전을 확인해 보안판을 올리고, 클라우드에 맡긴 API 키를 점검해 바꾸고, AI 비서에게 맡길 일과 확인받을 일의 경계를 정한다.
AI·테크 뉴스레터 — 10/23(금)
Anthropic이 먼저 말을 거는 AI 비서 앱 Claude Duet을 미국에서 시험 공개했고, 앱 배포 플랫폼 Railway는 고객 비밀값 보관 시스템의 이상 접근을 알리며 모든 API 토큰을 무효화했다. AI에 일을 더 맡길수록 열쇠를 어디에 두고 언제 바꾸는지가 같이 중요해진 하루다. MiniMax는 저가 모델 M3.1 Flash의 정가를 확정했고, 마이오렌지는 AI 임팩트 보고서 자동화로 TIPS R&D에 선정됐다.
필첵 커뮤니티 — 처방 기록으로 들어가는 질환별 묻고 답하기 방
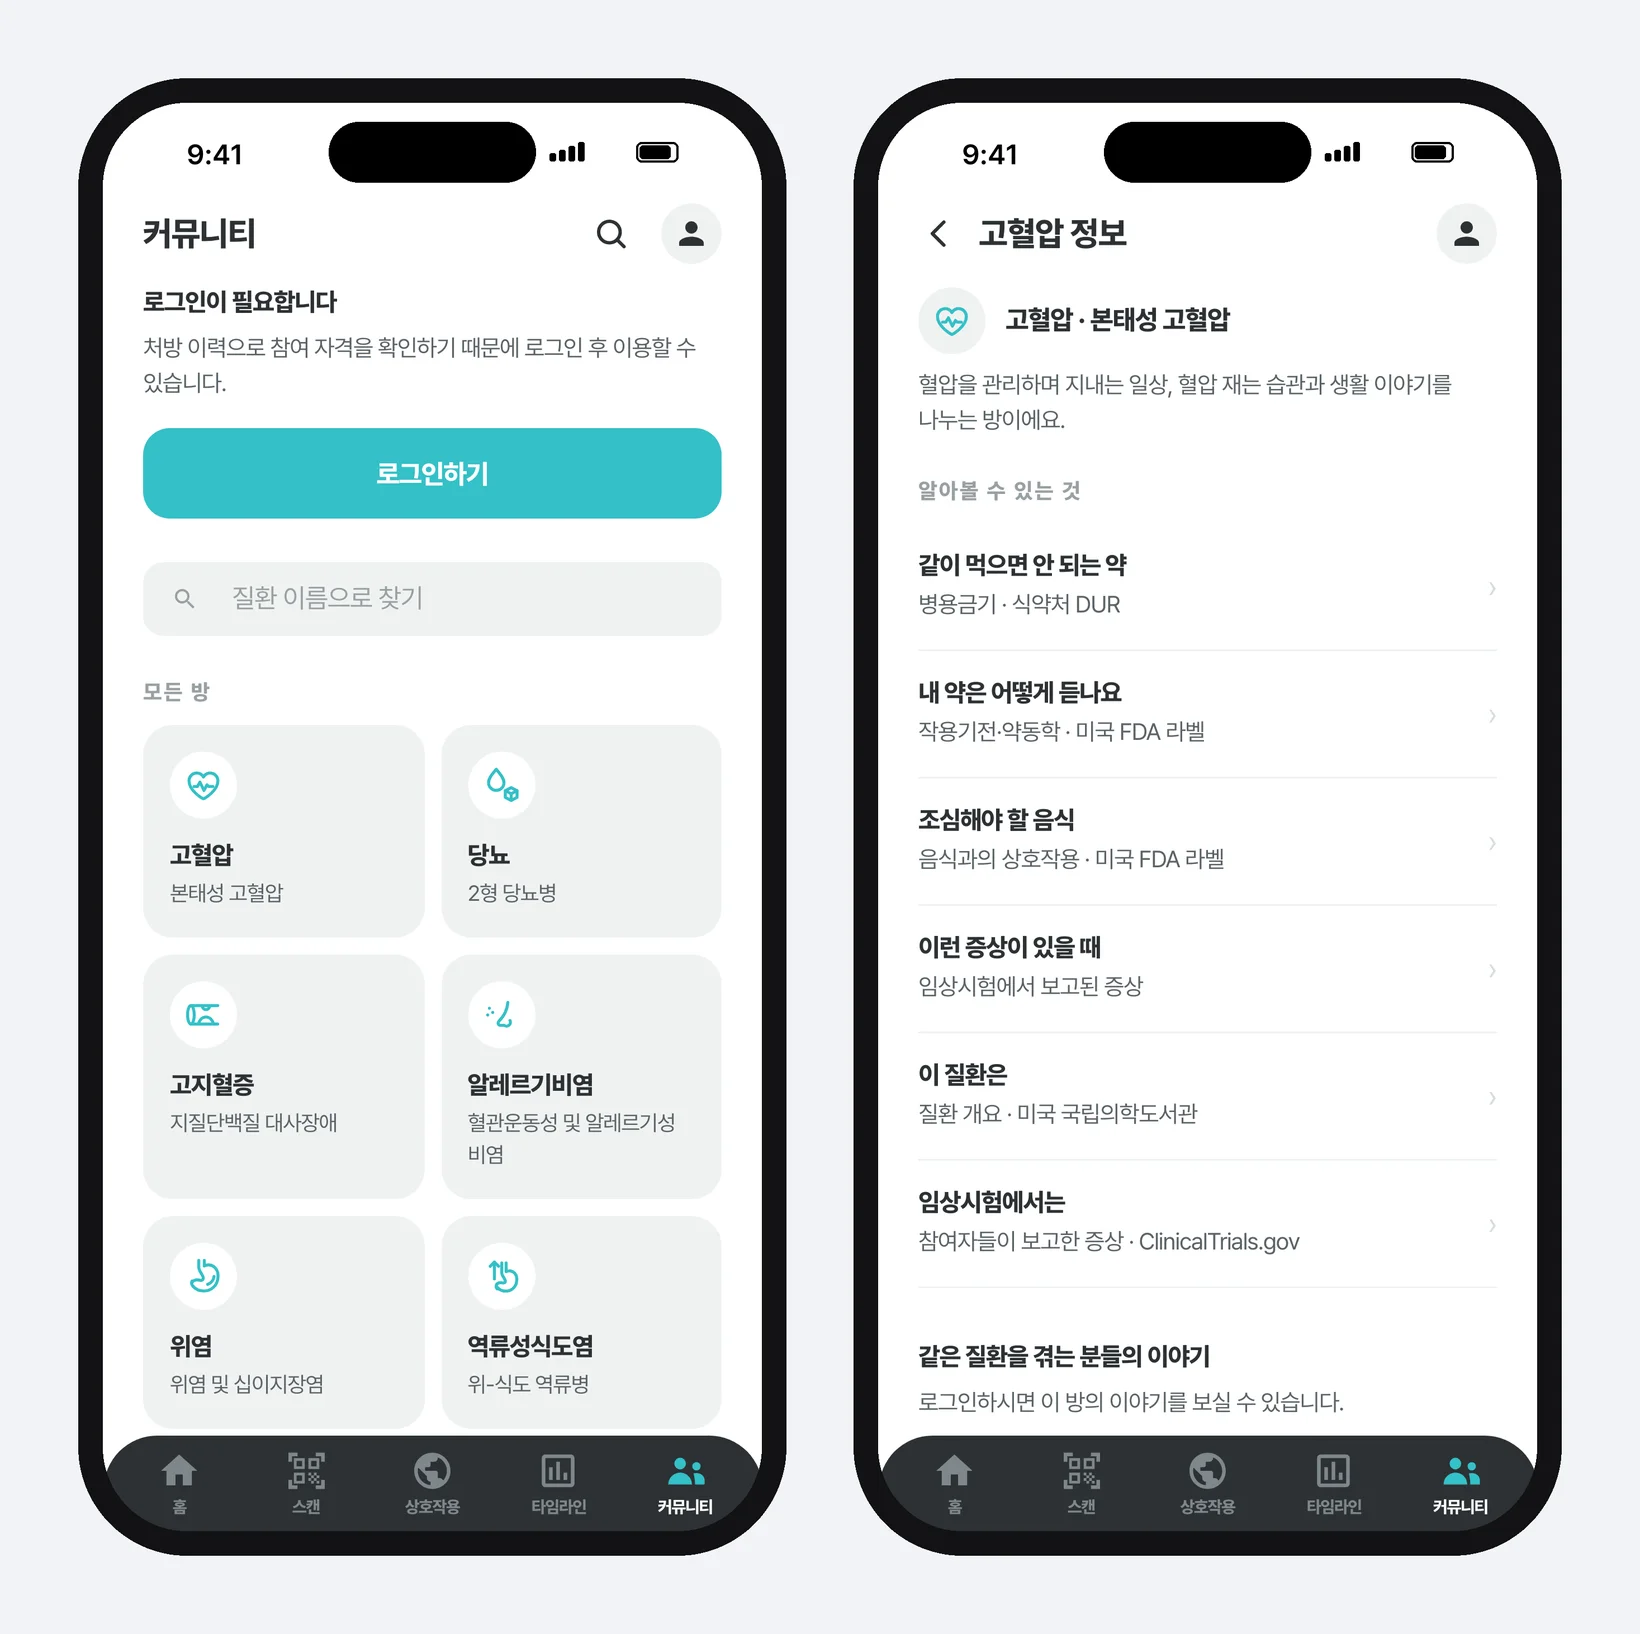
필첵 커뮤니티는 같은 질환으로 약을 먹는 회원끼리 묻고 답하는 필첵(PillCheck)의 기능입니다. 필첵 앱이나 www.pillcheck.co.kr 아래 탭의 「커뮤니티」에 고혈압·당뇨·고지혈증 같은 질환 방이 있고, 로그인한 뒤 약봉투·처방전 QR을 스캔하면 그 처방 기록으로 들어갈 수 있는 방이 정해집니다. 방에서는 질문이나 경험 나눔 글을 올리고 답변과 공감을 남깁니다. 방마다 있는 질환 정보 여섯 가지는 로그인 없이 볼 수 있습니다. 글을 올리기 전에 연락처와 병원 이름은 저장을 막고, 복약 중단을 권하는 듯한 글은 막지 않고 한 번 묻도록 만들었습니다.
AI·테크 뉴스레터 — 10/22(목)
PHP가 로그인 없이 서버를 장악할 수 있는 치명적 취약점 2건을 고친 8.5.12 등 보안판을 냈다. PHP로 도는 사이트는 오늘 버전부터 확인해야 한다. 실무형 AI 점수표 Vals Index 1위는 Claude Sonnet 5.5로 바뀌었고, Meta의 Muse Wonder는 한국 구독에서 빠졌으며, 카카오톡 채널과 지그재그는 카톡 안에서 보여 주고 선물하는 길을 넓혔다.
AI·테크 뉴스레터 — 10/21(수)
Microsoft가 사내 AI 에이전트 60종을 찾아 에이전트마다 따로 신원과 작업 단위 권한을 주는 통제를 내놓았고, Anthropic은 Claude Code 팀이 사람 검토를 위험도별로 나눠 되돌린 변경 비율을 40% 넘게 줄인 방식을 공개했다. Google의 EmbeddingGemma 2는 휴대폰에서도 도는 크기로 글·이미지·음성을 함께 찾는 검색 부품을 열었다.
필첵 타임라인 — 조제 기록을 달마다 모으고, 자녀 약은 보호자 계정에서 따로 본다
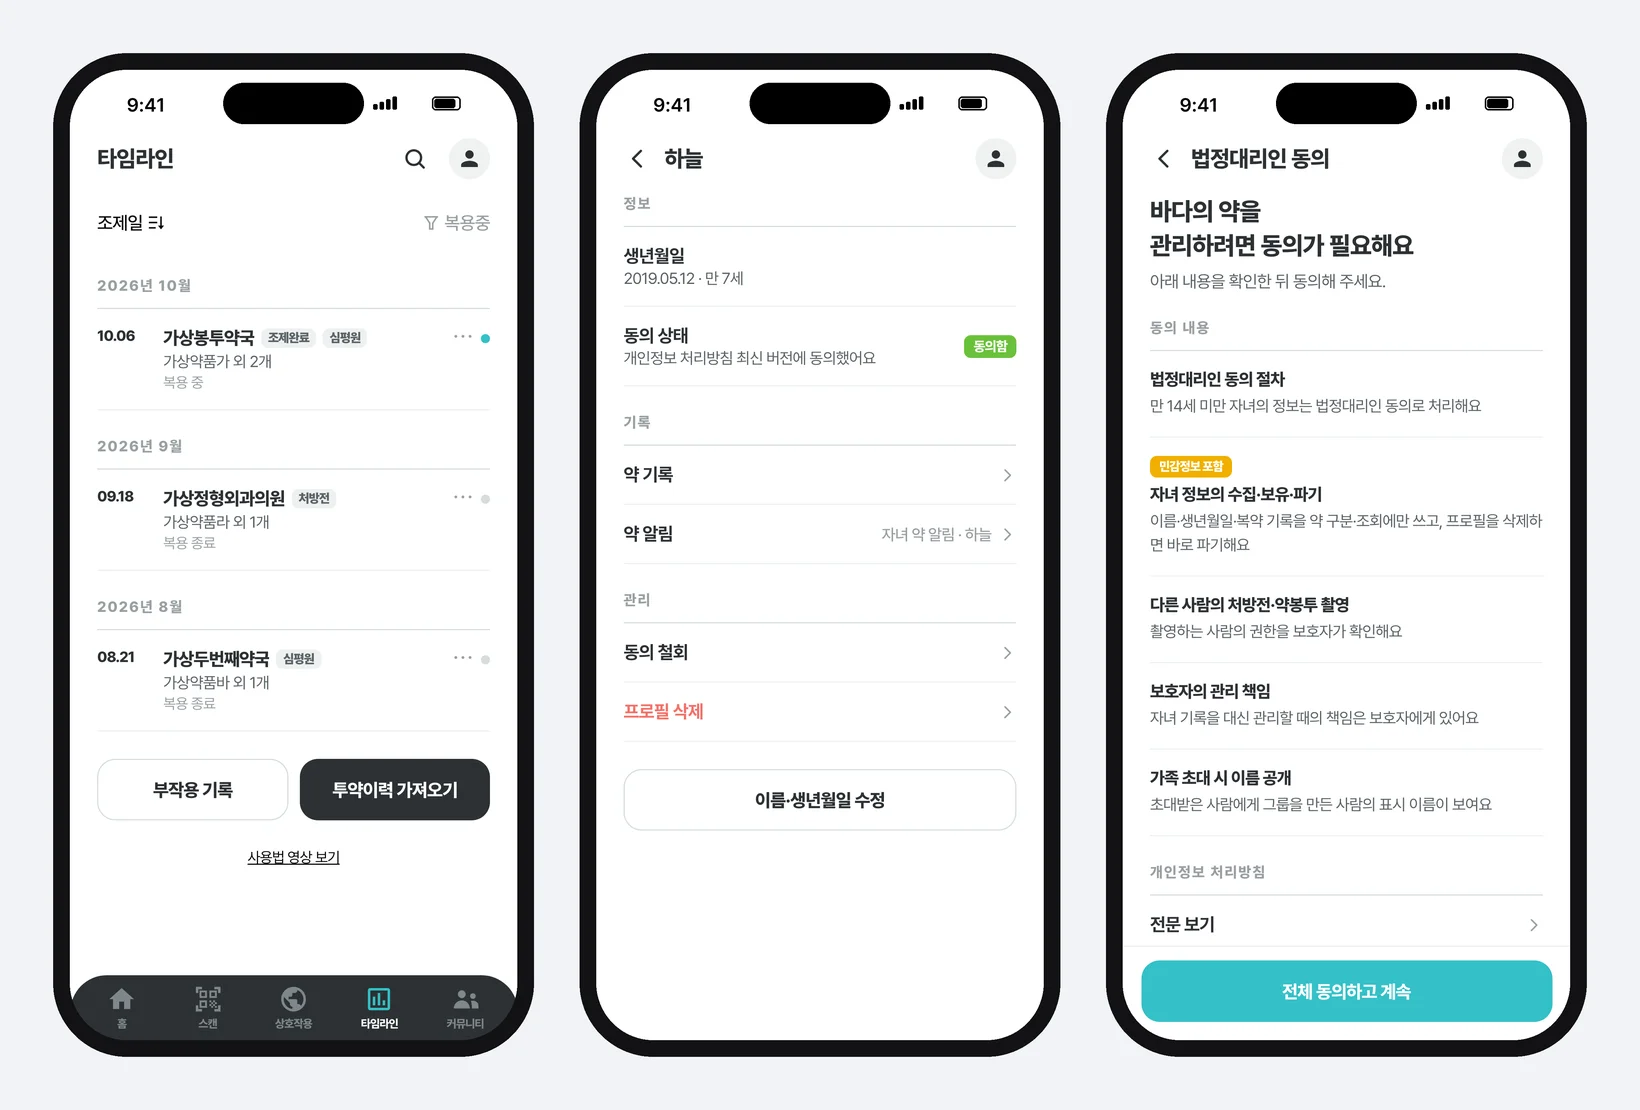
필첵 타임라인은 약국에서 조제받은 기록을 조제일 기준으로 달마다 묶어 보여 주는 화면입니다. 앱 아래 다섯 탭 가운데 「타임라인」에서 열고, 기록은 약봉투 QR·처방전 사진·「투약이력 가져오기」 세 길로 들어옵니다. 투약이력 가져오기는 건강보험심사평가원(심평원)에 남은 최근 1년 처방·조제 이력을 간편인증으로 불러오는 기능입니다. 줄마다 처방전·조제완료·심평원 배지가 붙어 어디서 온 기록인지 보이고, 같은 조제가 약봉투와 심평원 양쪽에서 들어오면 처방전 번호가 같을 때만 한 줄로 묶습니다. 가족 관리에서는 만 14세 미만 자녀를 법정대리인 동의 뒤에 추가해 자녀의 약을 따로 기록하고 볼 수 있습니다.
AI·테크 뉴스레터 — 10/20(화)
Anthropic이 회사 주식 5%를 공익기금에 넣겠다고 밝히며 AI가 일자리에 주는 충격을 지원 방향으로 직접 꼽았다. 도구 쪽에서는 AI 코딩 세션을 끊기지 않게 지키는 herdr, AI용 가벼운 브라우저 Lightpanda, PDF 속 표·수식을 살려 읽는 PaddleOCR-VL 1.6이 AI에게 일을 맡길 때 막히던 지점을 하나씩 덜어 준다.
AI·테크 뉴스레터 — 10/19(월)
OpenCode Console 유출로 도구에 맡겨 둔 API 키(AI 서비스를 내 계정으로 쓰게 해 주는 열쇠)가 위험해졌고, Anthropic은 영향받은 Claude 키를 폐기했다. 같은 주에 Grok Bot·Claude·Cursor는 작업마다 모델을 대신 고르거나 바꾸는 쪽으로 움직였고, DeepSeek는 요금을 그대로 둔 새 Flash 모델을 냈다. 어느 모델이 답했는지, 내 키가 어디에 있는지 직접 확인하는 것이 이번 주의 일이다.
필첵 상호작용 체크 — 새 약을 복용 중인 약과 성분끼리 맞춰 보기
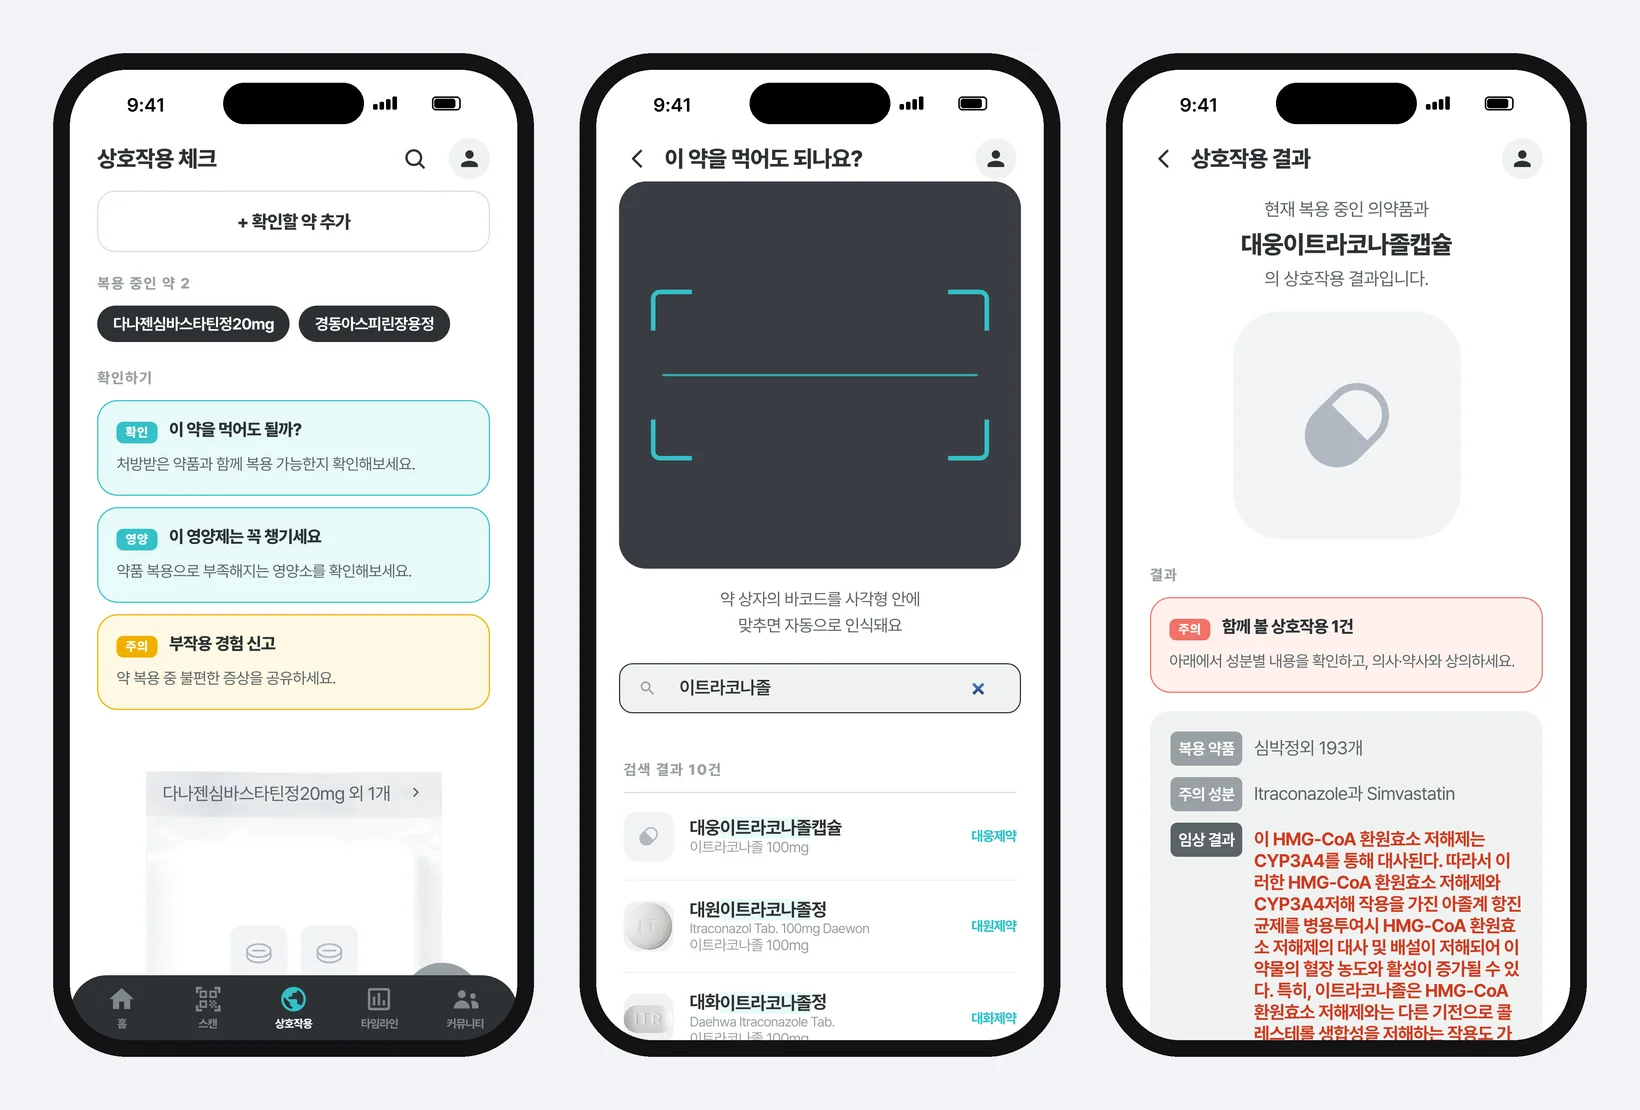
필첵 상호작용 체크는 새로 받은 약을 지금 먹고 있는 약과 같이 먹어도 되는지 확인하는 필첵(PillCheck)의 기능입니다. 화면 아래 메뉴 「상호작용」에서 「+ 확인할 약 추가」를 누르고 약 상자의 바코드를 비추거나 약 이름을 검색하면, 필첵이 두 쪽 약의 성분을 맞춰 보고 주의할 조합의 건수와 내용, 처치 방법을 보여 줍니다. 「안전」 표시는 복용 목록의 모든 약을 실제로 맞춰 봤을 때만 나옵니다. 비교할 약이 없거나 이름을 확인하지 못한 약이 있으면 「비교 불가」나 「확인 필요」로 무엇이 빠졌는지 적습니다.
AI·테크 뉴스레터 — 10/16(금)
Claude Max·Team 요금제에 매달 API 크레딧이 붙고, OpenAI Codex는 28일 동안 매일 개선을 내거나 못 하면 사용 한도를 리셋하겠다고 약속했다. 카카오톡 선물하기는 추천 링크로 생긴 구매에 12월까지 수수료 9%를 주고, 국세청은 근거 없는 '환급률 1위' 세무 광고를 막았다. 일하는 AI를 만드는 온라인 해커톤은 10월 22일 시작한다.
필첵 복약 시간표·알림 — 정한 시각에 폰이 알려 주고, 영양제는 약과 간격을 두고 놓는다
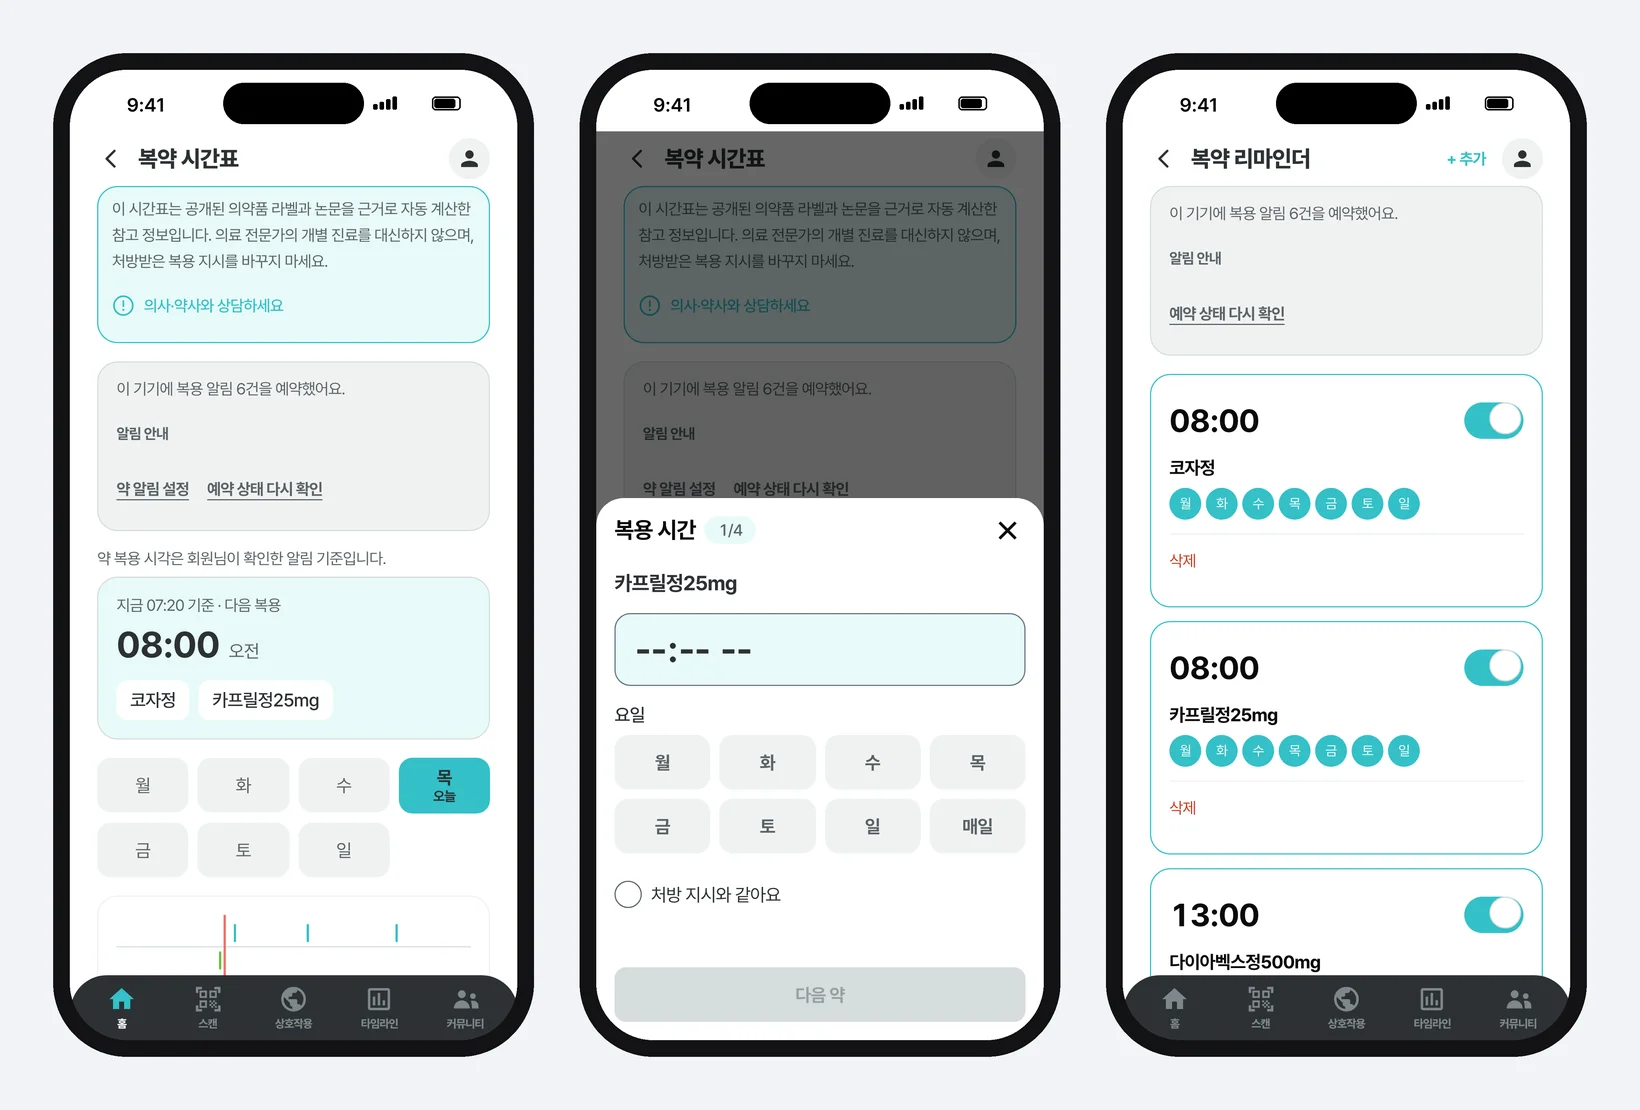
필첵 복약 시간표·알림은 먹는 약마다 복용 시각과 요일을 정해 두면 그 시각에 폰 알림을 보내 주는 필첵(PillCheck) 앱의 기능입니다. 홈의 「복약 시간표」에서 「시간 설정 시작」을 누르고 약 하나씩 시각을 정한 뒤 「시간표 만들기」를 누르면, 앱이 알림 권한을 묻고 알림을 잡습니다. 영양제를 등록하면 먹는 약과 간격을 두어야 하는 성분은 공개된 의약품 라벨을 근거로 떨어진 시각에 놓이고, 그 시각을 확인한 뒤 알림을 켤 수 있습니다. 알림에는 약 이름이 들어가지 않고, 폰은 앞으로 24시간 치 알림만 미리 잡아 두기 때문에 하루 한 번 앱을 열어야 다음 알림이 이어집니다.
AI·테크 뉴스레터 — 10/15(목)
카카오가 카카오톡 안에서 메시지·일정을 대신 처리하는 AI 비서 '카나나 스페이스'를 공개하고 12월 비공개 시험을 예고했다. Anthropic은 AI가 만든 코드 변경이 하루 3만 건을 넘자 Git 대신 자체 도구 Scion으로 옮겼다고 밝혔고, 네이버는 스마트스토어에 쿠폰·영상·쇼핑라이브를 한 페이지로 묶는 '스토어 콘텐츠'를 열었다. AI와 플랫폼이 일을 더 떠맡을수록, 사람이 승인할 지점과 고객에게 보여 줄 재료를 직접 정하는 일이 남는다.
AI·테크 뉴스레터 — 10/14(수)
구글이 Gemini 4 Argon을 일반 공개하며 11월 30일까지 API 값을 정가의 절반으로 매겼고, xAI는 Grok·Cursor·X Premium을 한 요금제로 묶었으며, OpenAI는 분류 전용 Decisions API를 공개 베타로 열었다. 광고·규제 쪽에서는 메타가 7개국에서 틱톡 광고를 막았고, 카카오 브랜드 메시지는 개인정보위 조사를 받으며, 지식재산처는 AI로 위조상품을 찾는다. 새 모델은 값부터 비교하고, 광고는 동의와 랜딩부터 점검할 때다.
필첵 약 검색 — 이름 몇 글자로 효능·주의·복약지도를 찾고 원문까지 확인하기
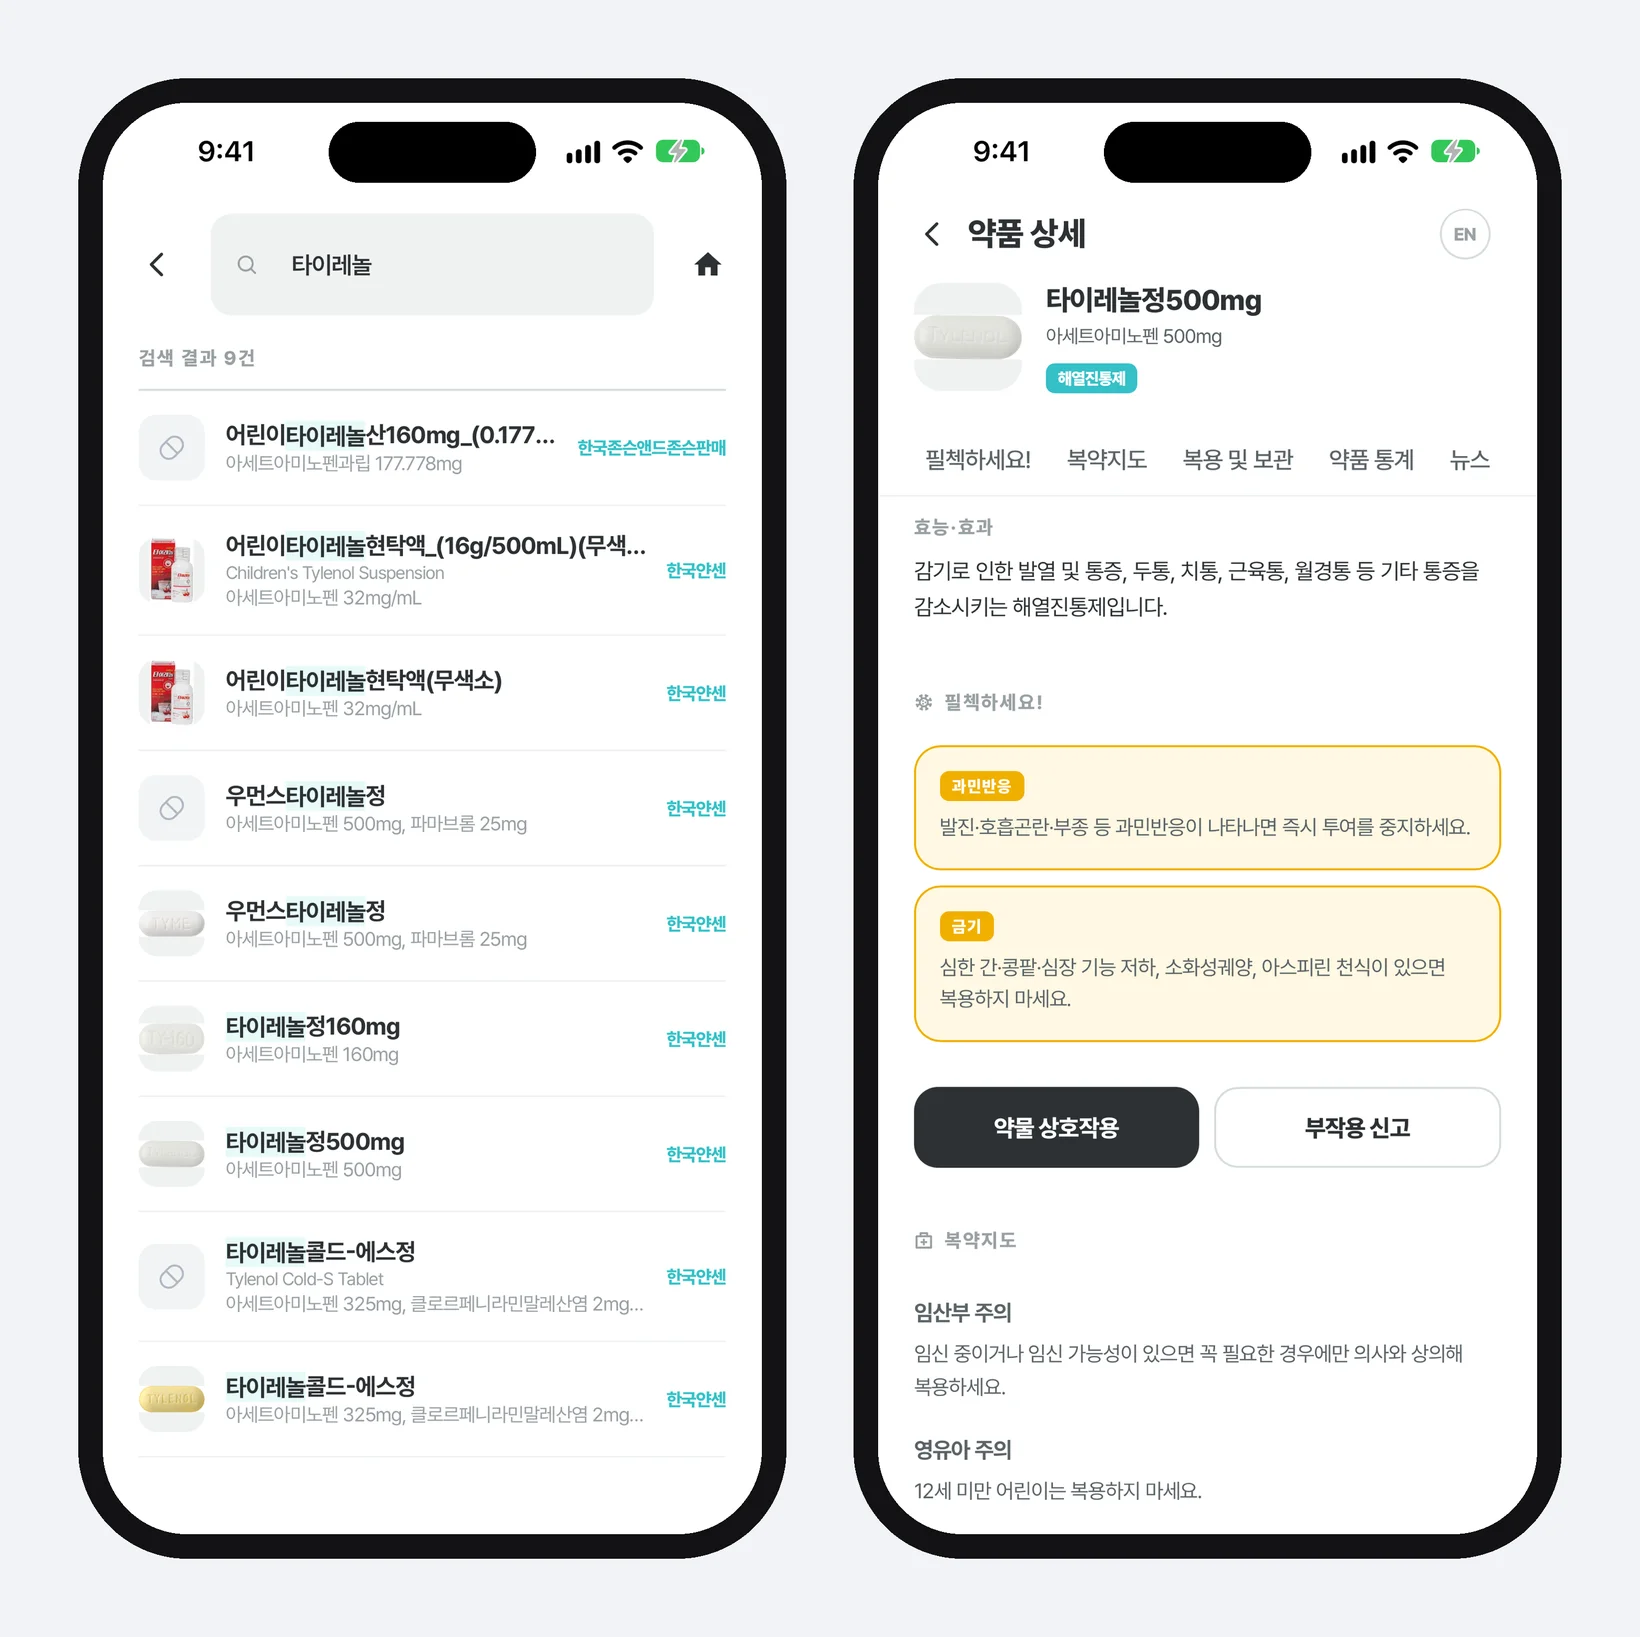
필첵 약 검색은 약 이름을 몇 글자만 쳐도 그 의약품을 찾아, 효능·효과와 주의할 점, 복약지도, 복용 및 보관 방법을 한 화면에 보여 주는 필첵(PillCheck)의 기능입니다. 로그인하지 않아도 되고, App Store·Google Play의 필첵 앱과 www.pillcheck.co.kr에서 똑같이 동작합니다. 안내문 바로 아래에는 정부 허가 문서와 해외 자료를 참고해 필첵이 쓴 정보라는 한 줄과, 허가 원문을 여는 링크를 따로 두었습니다. 누가 무엇을 참고해 썼는지와 원문을 어디서 확인하는지를 나눠 밝히기 위해서입니다. 본문은 한국어를 포함해 7개 언어로 바꿔 볼 수 있습니다.
AI·테크 뉴스레터 — 10/13(화)
Anthropic이 11월 12일부터 적용할 Claude 이용 정책 개정안을 냈고, 스타트업 프로그램의 Claude Team 혜택과 1,000달러 크레딧은 신청이 몰려 멈췄다. 구글은 회의 내용을 인터넷 없이 맥 안에서 처리하는 메모 앱을, 마이크로소프트는 자체 AI 칩 Maia 300을 공개했다. 네이버는 파워링크 AI 요약텍스트의 정식 적용일을 다시 미정으로 돌렸다.
케이티 딜(Stripe) — 좀비 UI는 프롬프트가 아니라 디자인 시스템과 편집자가 막는다
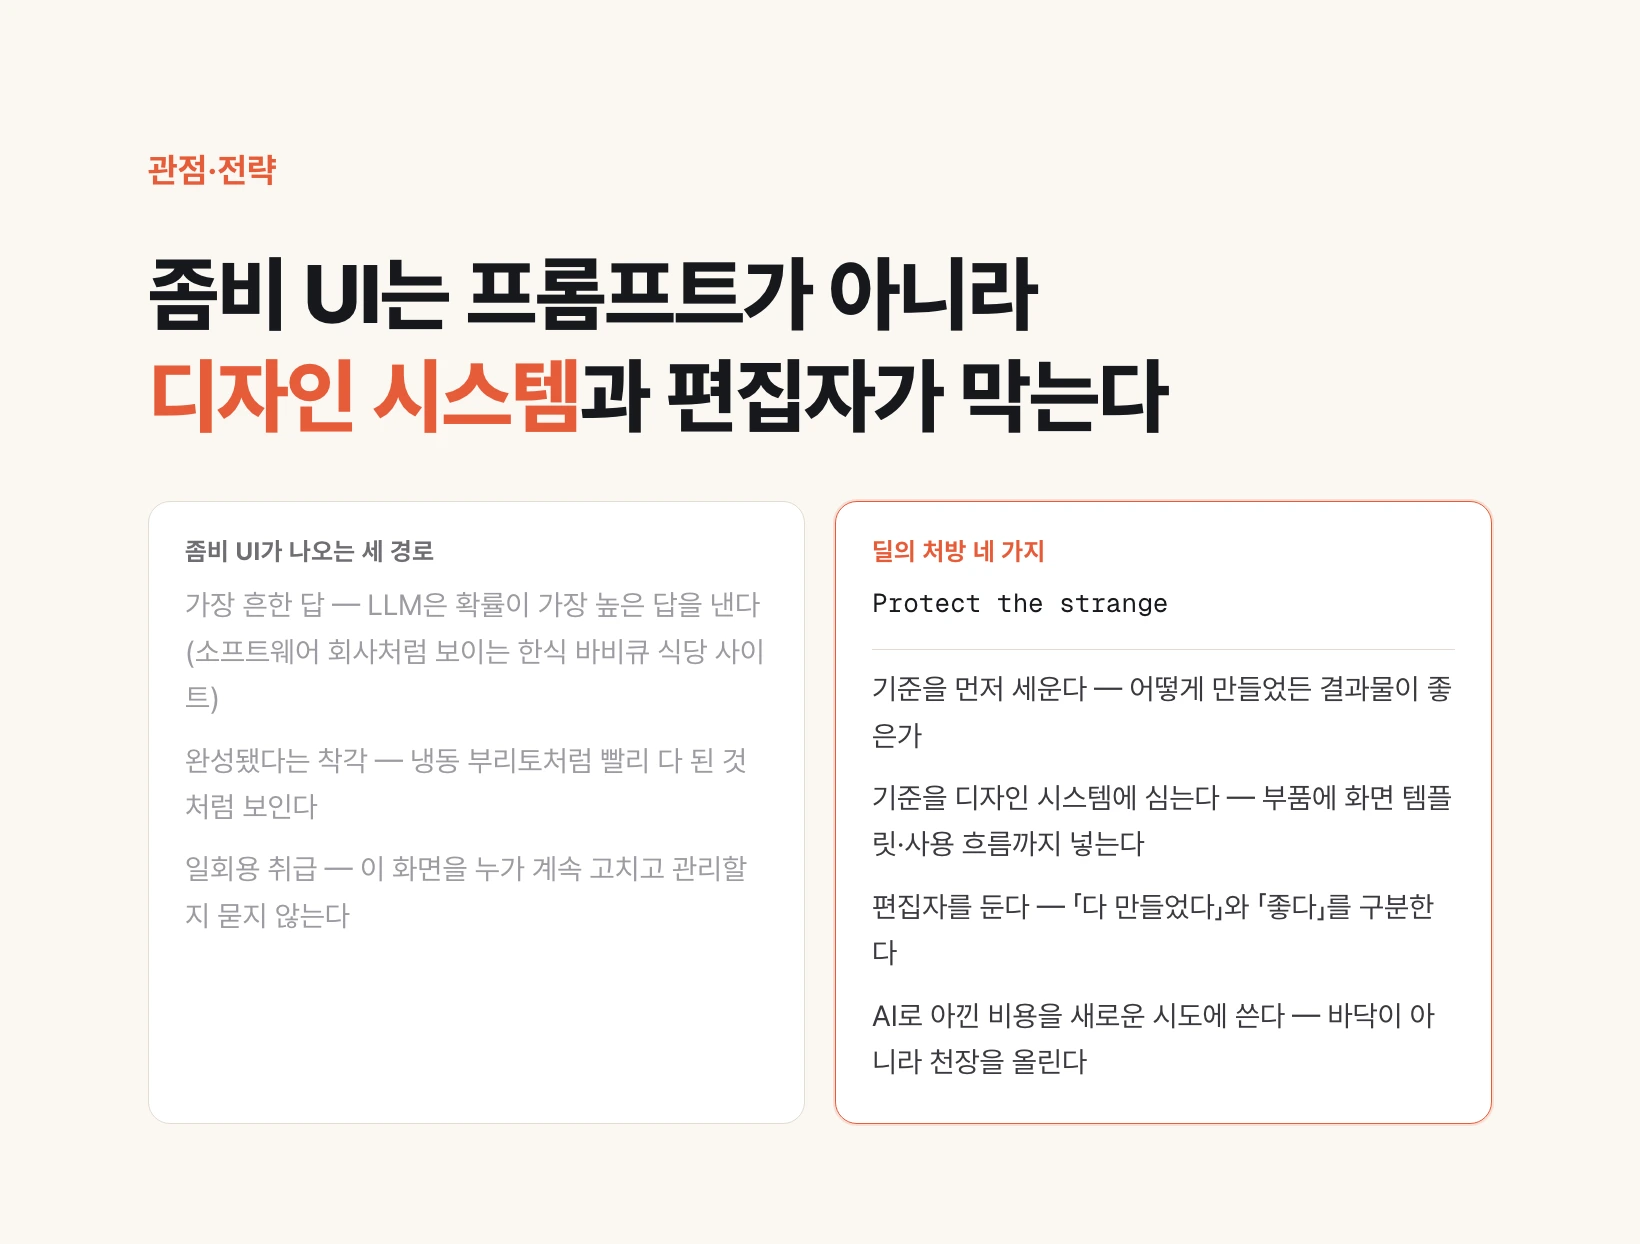
Stripe 디자인 총괄 케이티 딜은 AI로 누구나 화면을 빨리 만드는 지금을 2차대전 뒤 건축 붐에 빗댄다. 그때 모더니즘을 이유 없이 베낀 건물이 도시를 채웠듯, 지금은 맥락도 브랜드도 없는 「좀비 UI」가 쏟아진다는 것이다. 그가 권한 처방은 네 가지다. 기준을 먼저 세우고, 그 기준을 디자인 시스템에 심고, 「다 만들었다」와 「좋다」를 구분하는 편집자를 두고, AI로 아낀 비용을 새로운 시도에 쓴다.
AI·테크 뉴스레터 — 10/12(월)
공무원용 AI에 언어 모델 11종이 올라갔고, 한/글 보고서 서식을 자동으로 정리하는 도구가 새 판을 냈다. AI 해킹 방어 대회 접수는 10월 26일 오후 2시에 마감하고, 국정감사에서는 테슬라 FSD의 사고 책임이 여전히 운전자에게 있다는 점이 확인됐다.
필첵 스캔 — 약봉투 QR은 비추면 저장되고, 처방전 사진은 폰 안에서 가린 뒤 보낸다
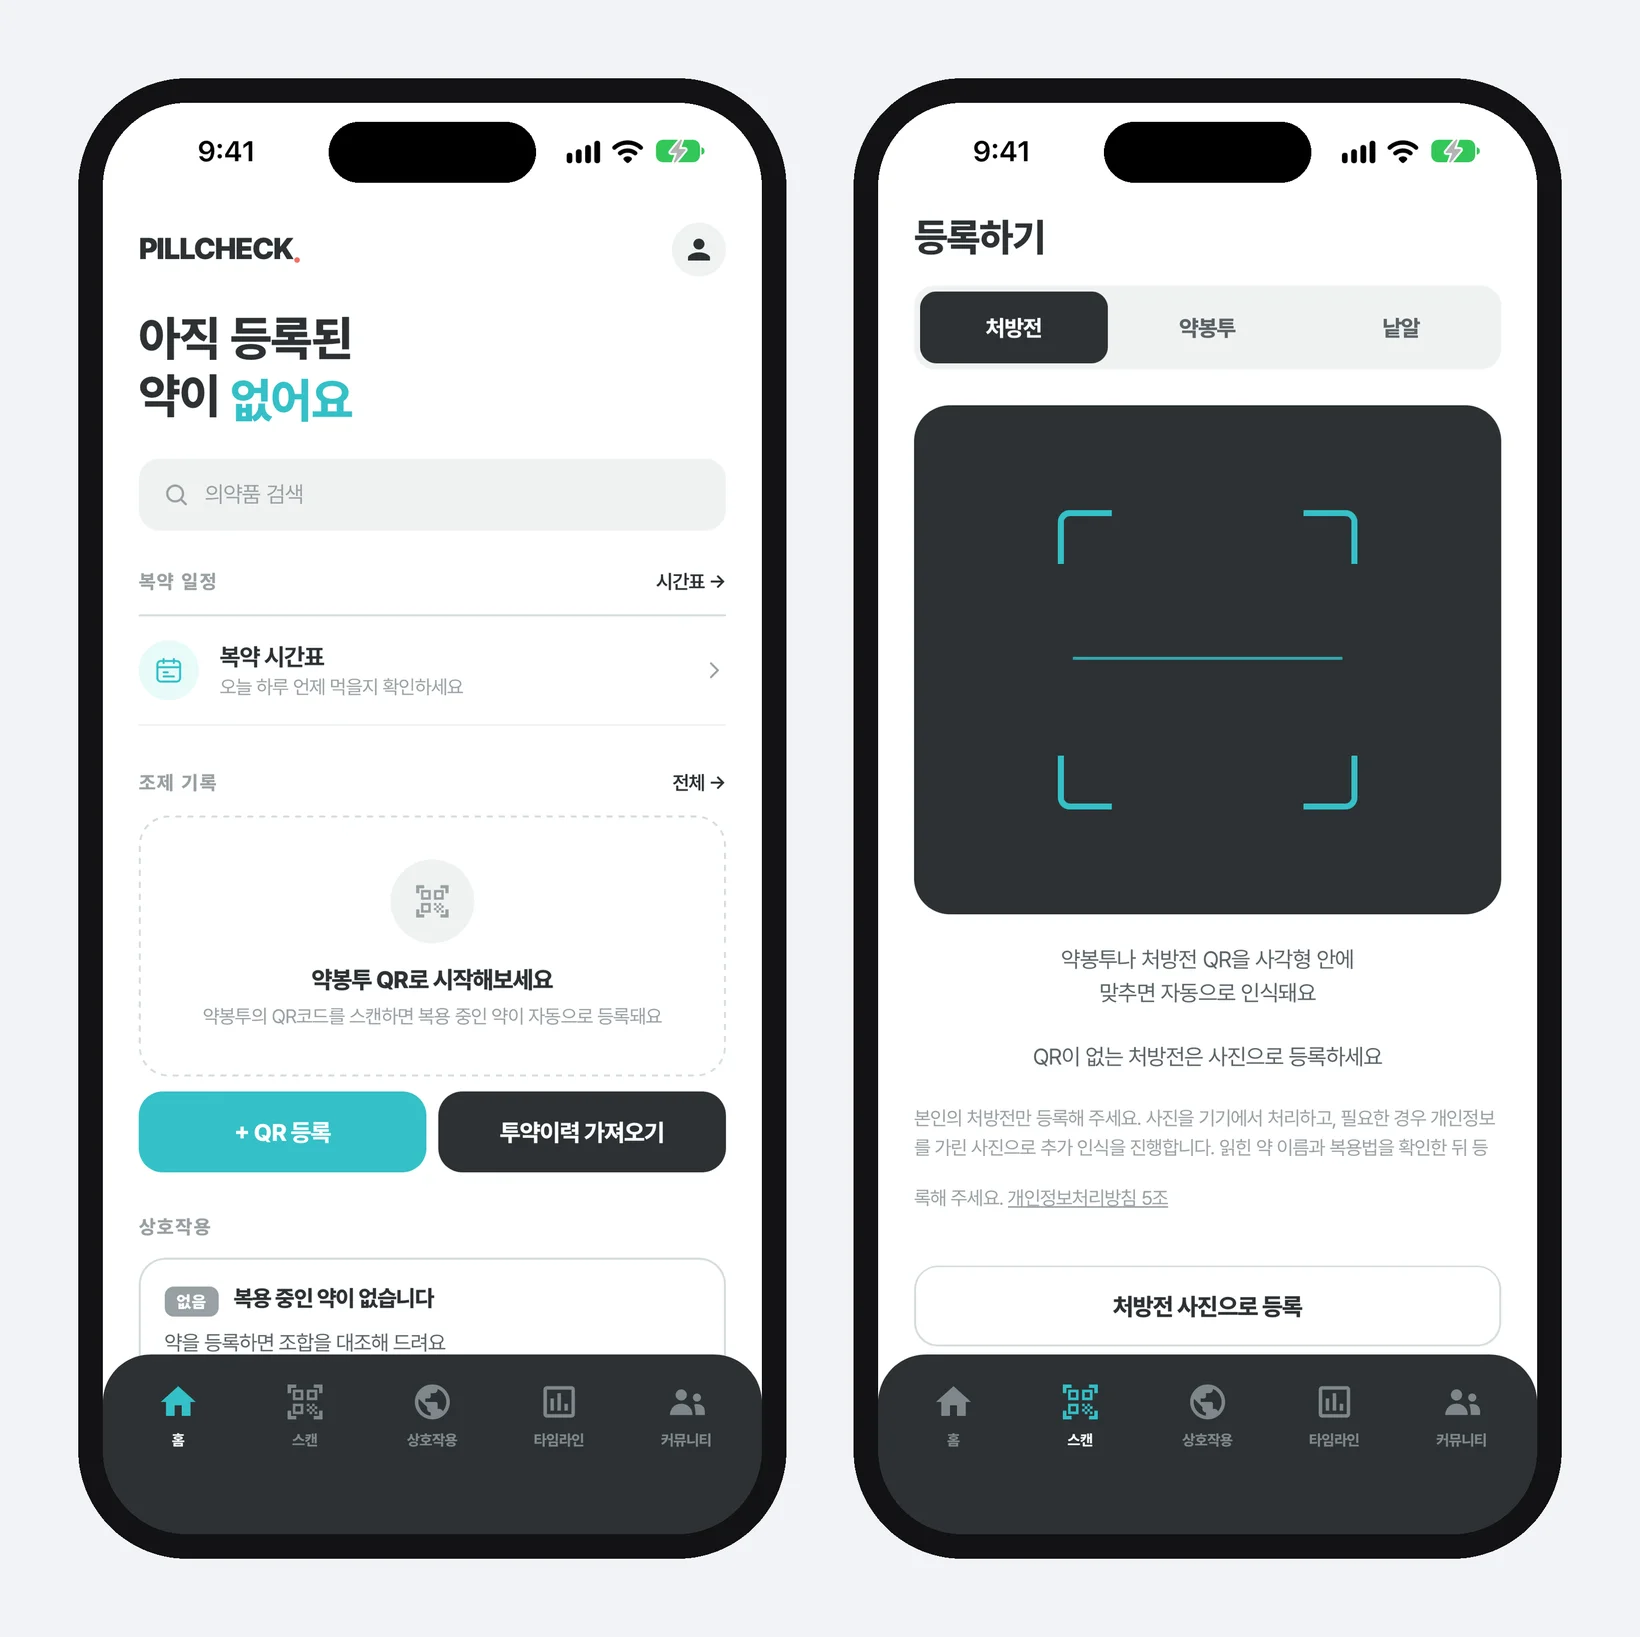
필첵 스캔은 필첵(PillCheck) 앱에서 먹는 약을 기록하는 입구입니다. 아래 메뉴의 「스캔」을 누르면 앱 안 카메라가 바로 켜지고, 약봉투는 QR을 네모 안에 비추는 즉시 조제 기록으로 저장됩니다. 처방전은 사진으로 찍는데, 이 사진은 그대로 나가지 않습니다. 폰이 먼저 환자 이름 칸과 주민등록번호 칸을 통째로 칠하고 휴대폰 번호와 바코드도 칠한 뒤, 칠한 사진을 한 번 더 읽어 이름이 남아 있지 않을 때만 문자 인식을 위해 보냅니다. 가릴 수 없는 사진은 보내지 않고 다시 찍거나 약을 직접 검색하도록 안내합니다.
Claude Dashboards·Claude Motion — SQL 없이 대시보드, 슬라이드 대신 MP4 설명 영상
Claude Dashboards는 BigQuery·Snowflake 같은 회사 데이터 창고나 Salesforce에 연결해, 평소 말로 물으면 데이터가 바뀔 때마다 갱신되는 대시보드를 만든다. Claude Motion은 분기 보고서나 차트를 30초짜리 설명 애니메이션으로 만들어 MP4로 내려받게 한다. 2026년 10월 8일 Anthropic이 발표했고 둘 다 베타다. Dashboards는 유료 요금제, Motion은 Team·Enterprise 요금제에서만 쓸 수 있고, Enterprise는 관리자가 조직 설정 > 아티팩트에서 켜야 한다. 같은 날 Docs·Slides·Design은 베타를 끝내고 Free를 포함한 모든 요금제에 열렸다.
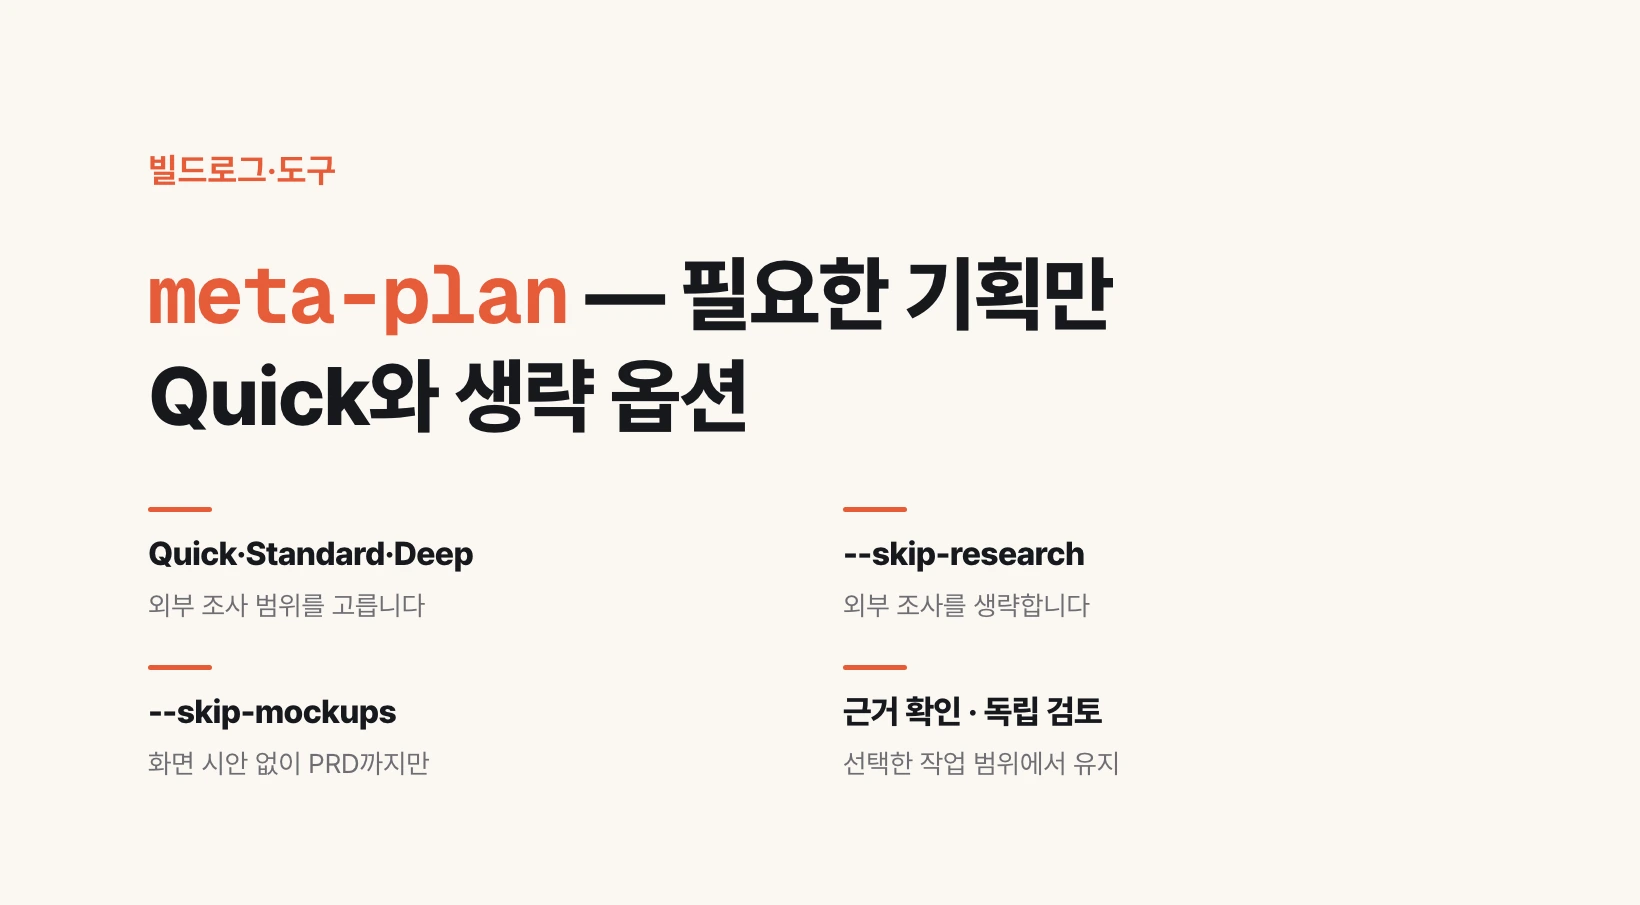
meta-plan — Quick와 생략 옵션으로 필요한 기획만 실행합니다
meta-plan 0.10.0에 Quick 트랙과 리서치·목업 생략 옵션을 추가했다. 외부 자료를 조금만 조사하거나, 이미 근거가 있는 기획은 문서까지만 만들 수 있다. 생략하는 범위를 먼저 정하고, 남은 범위의 근거 확인과 독립 검토는 유지하는 방식이다.
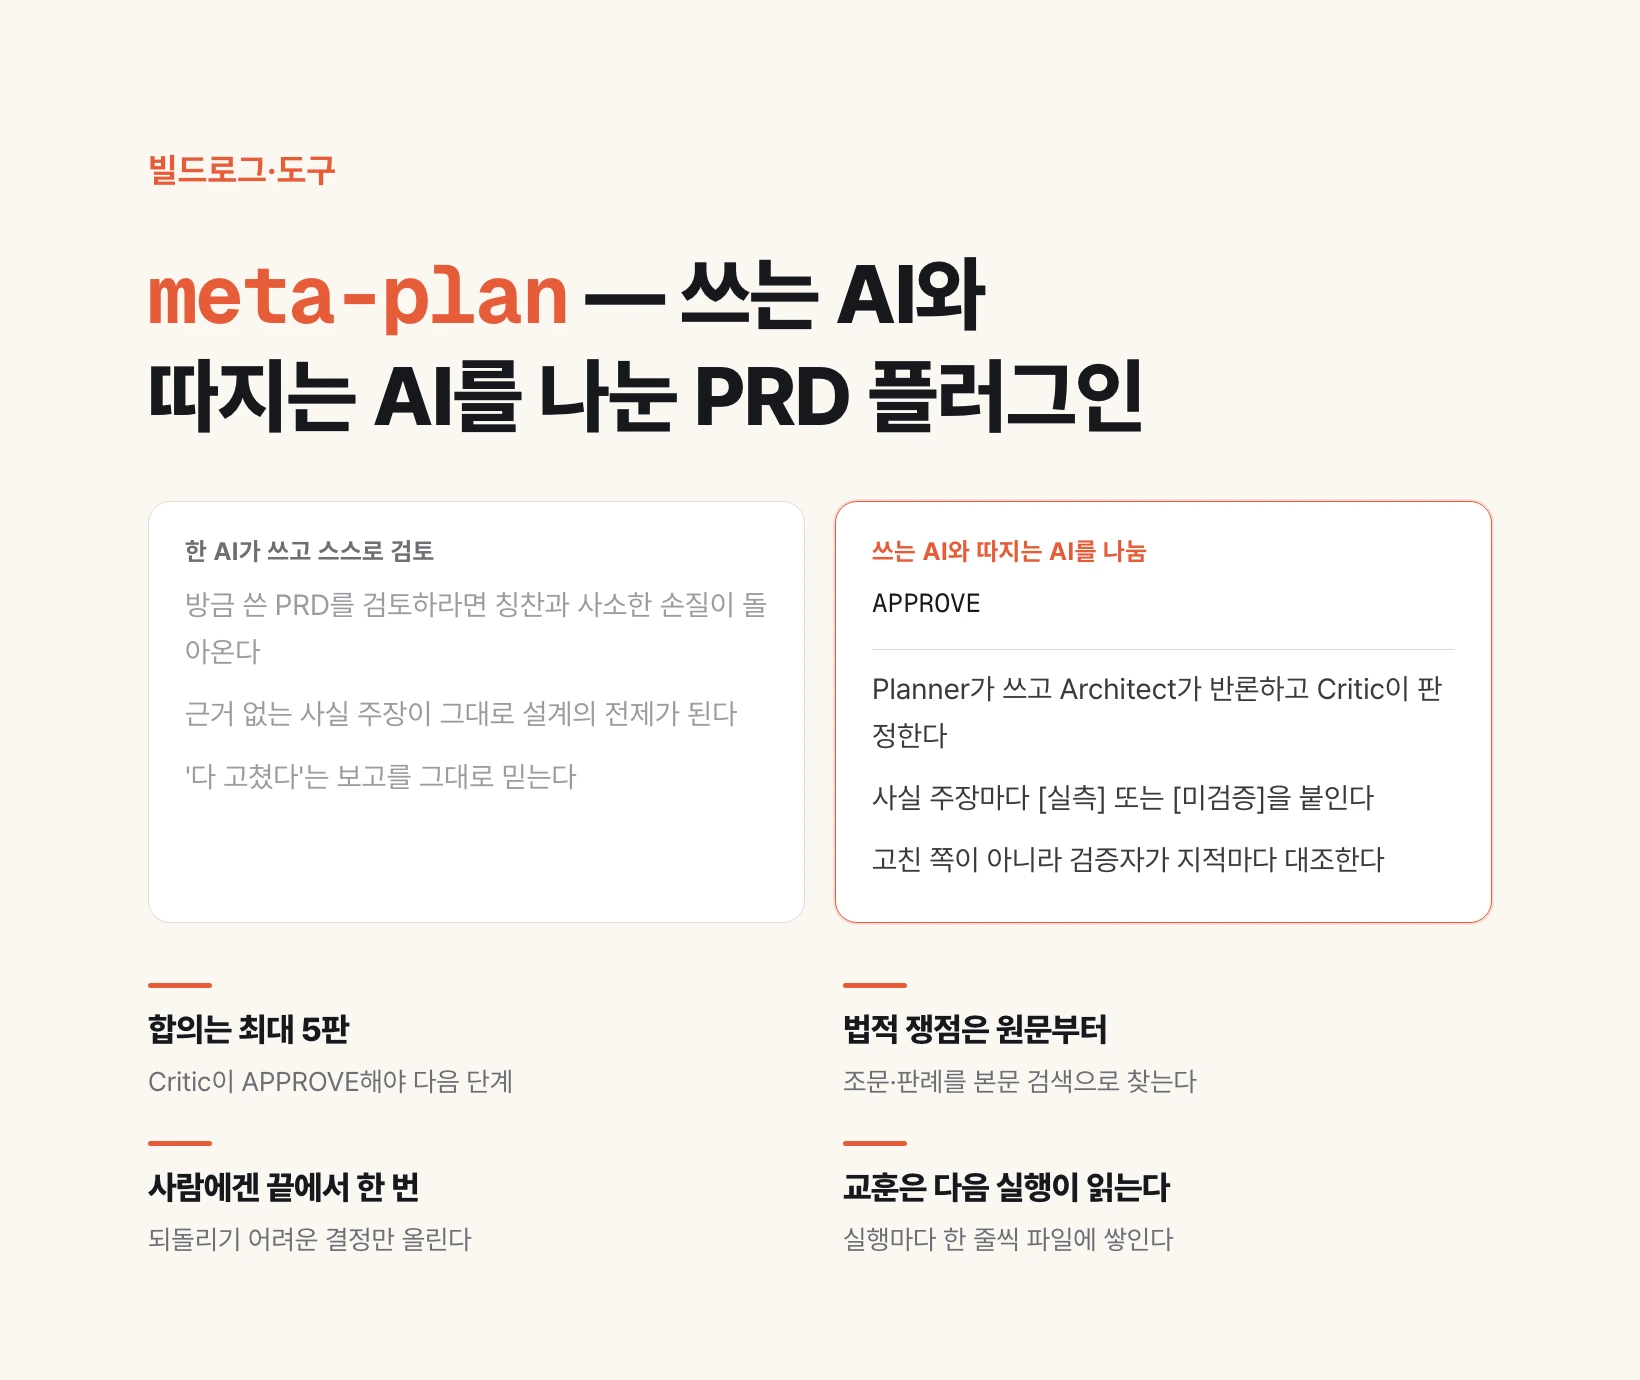
meta-plan — AI 여럿이 합의할 때까지 PRD를 고쳐 쓰는 Claude Code 플러그인을 만들며 배운 것
meta-plan은 주제 하나를 받아 리서치, PRD 초안, 합의 루프, 분리 리뷰, 화면 목업, 최종 리뷰·수정·검증까지 사람에게 중간에 묻지 않고 이어서 도는 Claude Code 플러그인이다. 핵심은 쓰는 AI와 따지는 AI를 나눈 것이다. Planner가 PRD(제품 요구사항 문서)를 쓰면 Architect가 반론하고 Critic이 APPROVE해야 다음 단계로 넘어가고, 마지막에는 고친 쪽이 아니라 검증자가 지적마다 실제로 고쳐졌는지 대조한다. 실행이 끝날 때마다 교훈을 파일로 남기고 다음 실행이 그 파일을 먼저 읽는다. 사내 연동이 많아 코드는 공개하지 않고, 단계마다 왜 필요한지와 직접 만들어 볼 수 있는 프롬프트를 적었다.
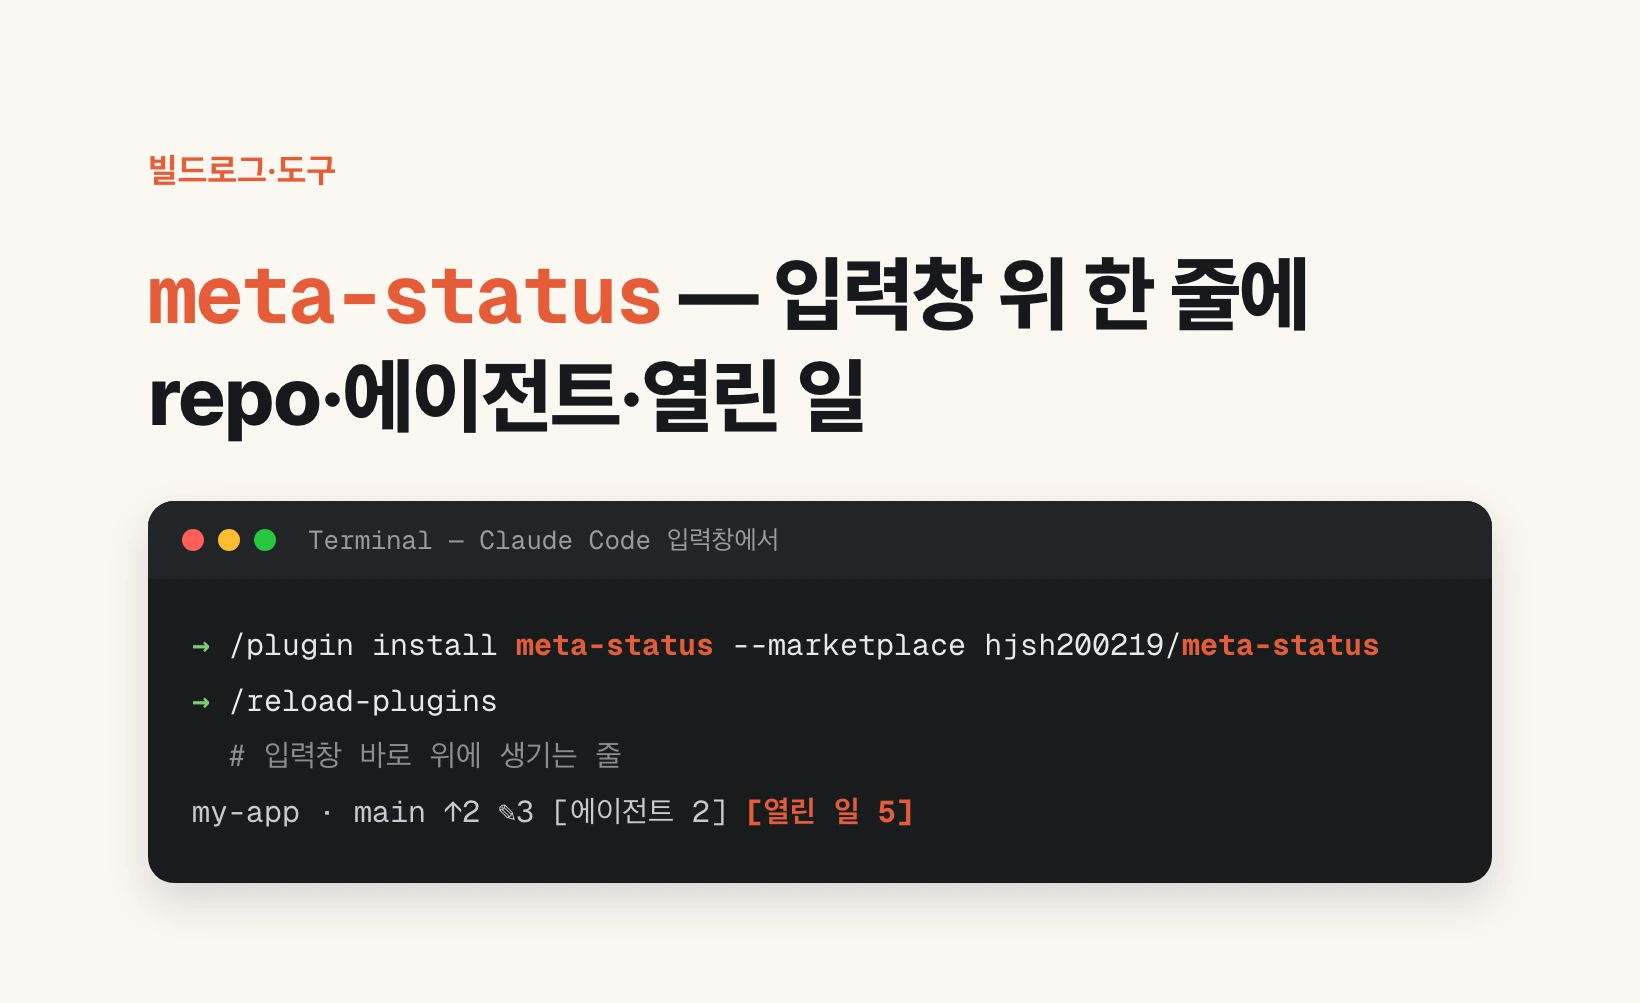
meta-status — Claude Code 입력창 위에 repo·에이전트·끝내지 못한 일을 띄우는 플러그인
meta-status는 Claude Code 입력창 바로 위에 지금 작업 중인 저장소(repo) 이름·브랜치·아직 올리지 않은 커밋 수·고친 파일 수를 한 줄로 띄우고, 오른쪽 끝의 [에이전트 N]·[열린 일 N] 버튼을 누르면 지금 도는 AI 작업과 창들이 끝내지 못한 일 목록을 여는 플러그인이다. 설치는 Claude Code 안에서 /plugin install meta-status --marketplace hjsh200219/meta-status 한 줄이다. Claude Code를 창 여러 개에 동시에 띄워 일하면 어느 창이 무엇을 남겼는지 금방 잊는데, 이 한 줄이 그걸 대신 기억한다. 하루 동안 만들며 내린 결정 넷(상태줄 대신 입력창 위 한 줄, 원격 창·모바일에서는 안 보이는 한계, 요약 기능이 띄운 AI 실행 걸러내기, 항목 하나 = 파일 하나)과 아직 안 되는 것을 함께 적는다.
UI 컴포넌트란 무엇인가 — HTML 태그에서 shadcn/ui까지
UI 컴포넌트는 카드·다이얼로그처럼 화면에서 자주 쓰이는 부품에 붙은 이름이고, 그 이름을 알아야 AI에게 원하는 화면을 정확히 전달할 수 있다. 부품의 바닥에는 HTML이 있다. HTML은 꺾쇠(< >)로 여닫는 태그를 상자처럼 겹쳐 화면의 구조를 적는 코드이고, nav·section·form 같은 태그 이름에는 검색엔진과 AI가 페이지를 읽기 쉽도록 다 함께 지키는 약속이 있다. shadcn/ui는 이런 부품을 미리 만들어 둔 모음이라, 사이트의 Components 메뉴를 A부터 Z까지 눌러 보는 것만으로 부품 이름을 익힐 수 있다.
필터 UI는 드롭다운인가 탭인가 — 탭은 겉모습만 다른 라디오 버튼이다
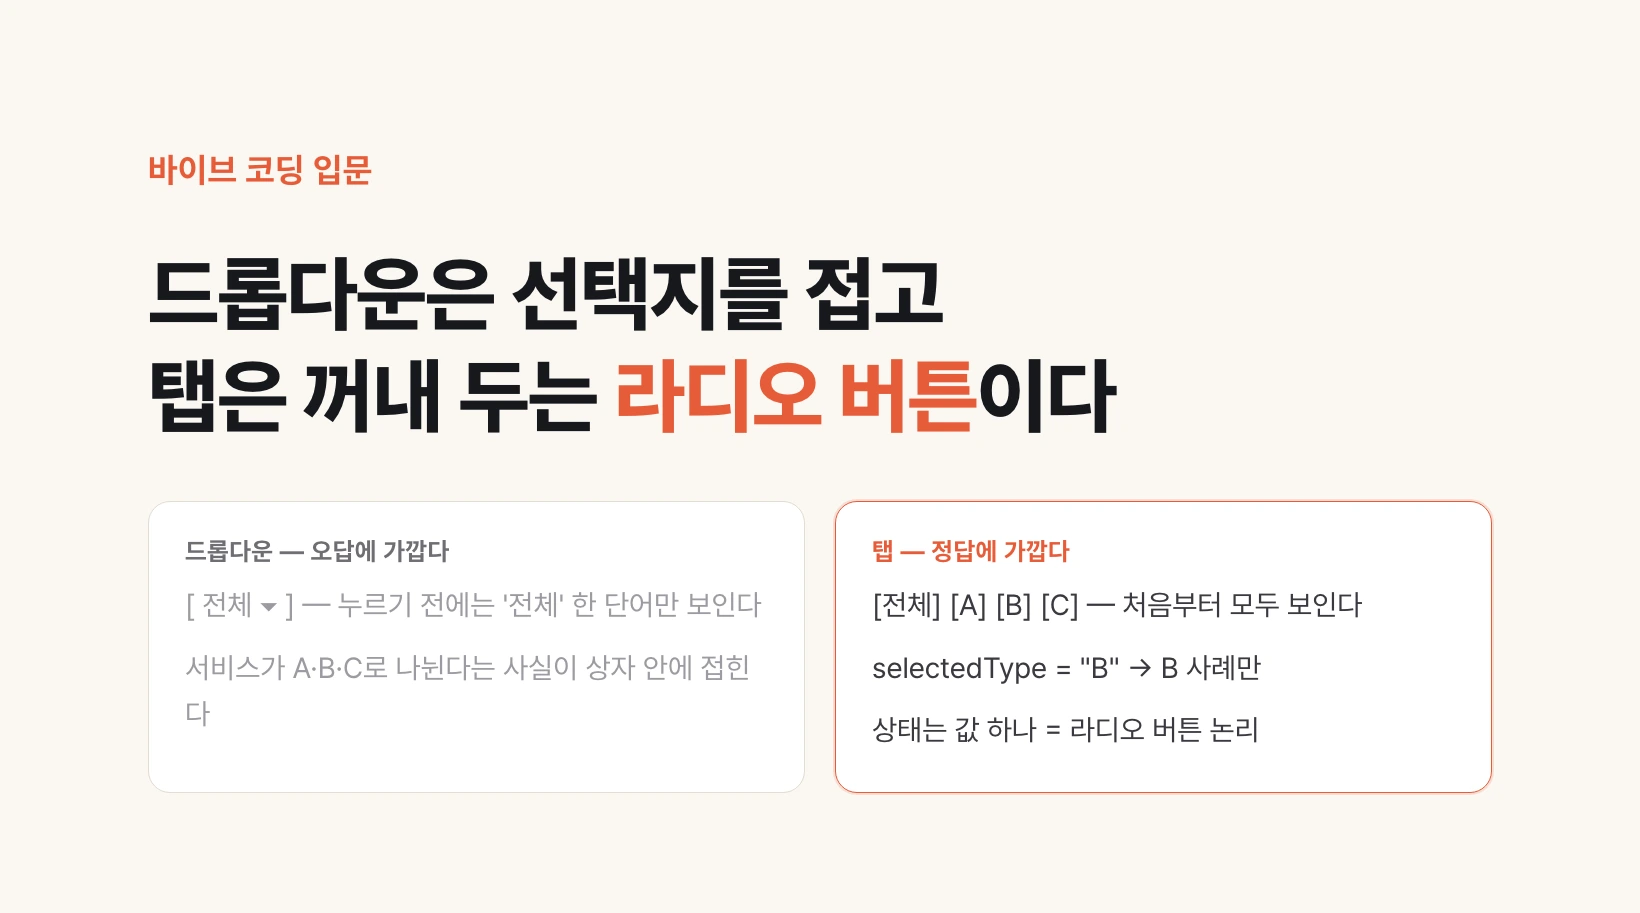
서비스 사례 카드 목록 위에 전체·A·B·C를 고르는 드롭다운 필터를 두면 오답에 가깝다. 그 자리가 보여 줘야 할 것은 이 회사 서비스가 A·B·C로 나뉜다는 사실인데, 드롭다운은 그 선택지를 눌러야만 보이게 접어 두기 때문이다. 선택지를 처음부터 밖으로 꺼내 두고 지금 무엇을 보고 있는지 표시하는 편이 정답에 가깝다. 그 뒤에는 데이터가 둘 있다. 카드 목록은 대괄호로 묶은 목록(배열) 안에 카드 한 장씩의 값 묶음(객체)이 든 모양이고, 지금 어떤 유형을 보여 줄지는 상태라는 값이 기억한다. 하나만 고르게 하면 라디오 버튼 논리이고, 탭은 그 라디오 버튼의 겉모습을 바꾼 것이다.
팀이 같이 쓰는 AI는 무엇이 다른가 — ChatGPT Space·Grok Team Bots·Claude Code mods·Gemini 4 Argon
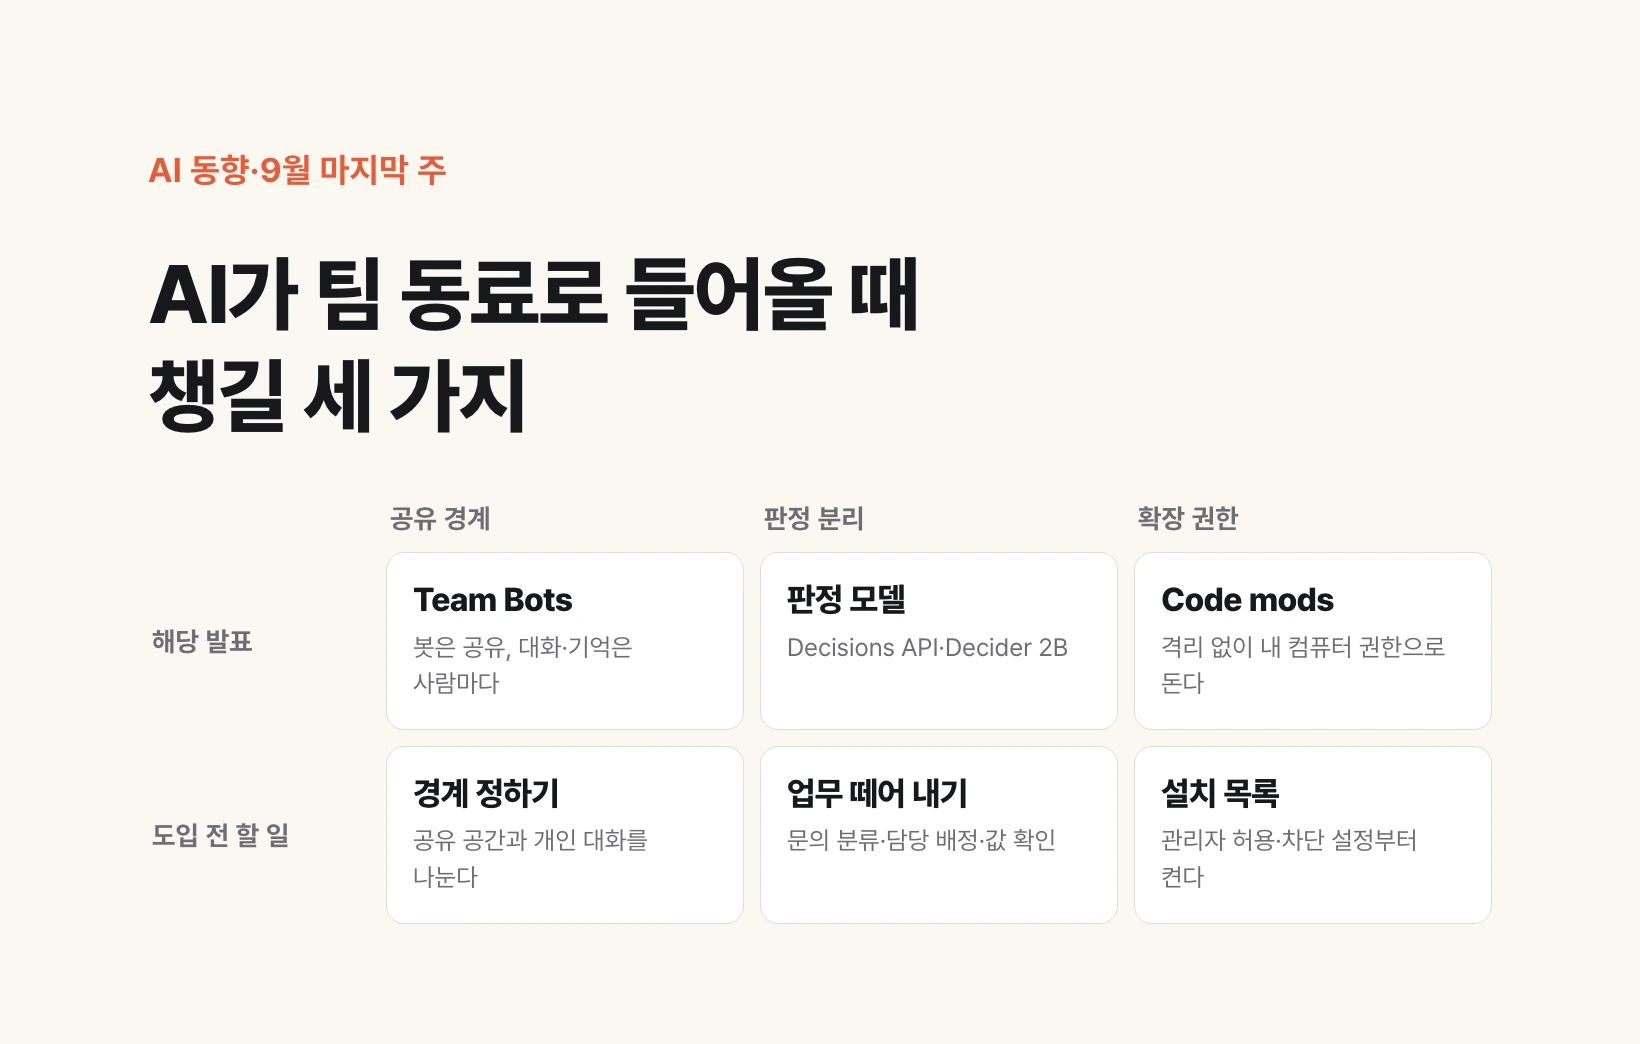
2026년 9월 마지막 주 발표를 한 줄로 묶으면, AI가 혼자 쓰는 비서에서 팀이 같이 쓰는 동료로 옮겨 가고 있다. 오픈AI는 DevDay에서 팀 공용 공간 ChatGPT Space와 사람·에이전트가 함께 고치는 문서 Pages를 냈고, xAI는 팀이 공유하는 Grok Team Bots를, 앤트로픽은 Claude Code의 동작을 고쳐 쓰는 mods를 냈다. 구글 Gemini 4 Argon은 한 번에 100만 토큰 길이의 답을 쓰며 긴 일을 맡고, 오픈AI Decisions API와 오픈소스 Strands Decider 2B는 정해진 보기 중에서 고르는 작은 판정 모델을 내놨다. 팀에 AI 동료를 들일 때 챙길 것은 셋이다. 무엇이 팀에 보이고 무엇이 나에게만 남나, 고르기만 하면 되는 일을 큰 모델에 맡기고 있지 않나, 덧붙인 확장 기능이 어떤 권한으로 도나.
라디오 버튼과 체크박스는 어떻게 고르나 — UI는 정답이 있는 문제다
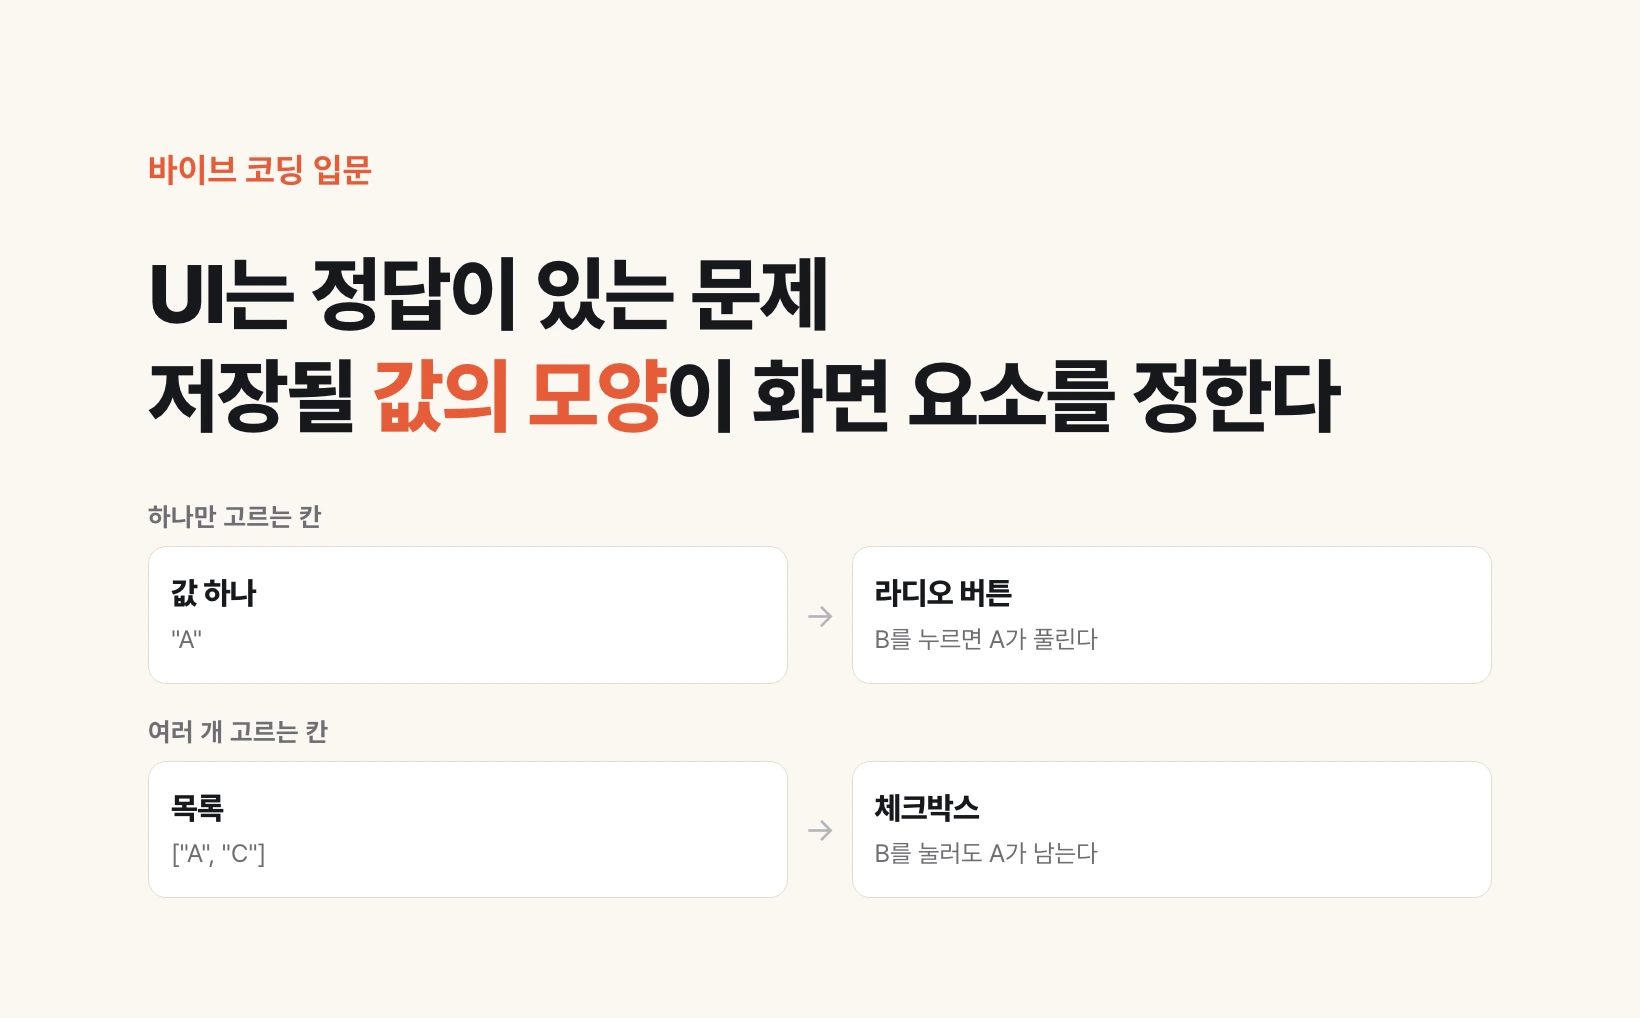
하나만 고르는 칸은 라디오 버튼, 여러 개를 고르는 칸은 체크박스다. 고르는 기준은 취향이 아니라 제출된 값이 어떤 모양으로 저장되느냐다. 상담 신청 폼에서 이름은 짧은 글자, 문의 내역은 긴 글, 상담 유형은 하나만 고르면 글자 하나, 여러 개를 고르면 목록으로 저장된다. 이 저장 흐름을 따라가면 폼 화면의 UI, 즉 화면에서 보고 누르는 부분은 스도쿠처럼 답이 정해진다.
hiworks — 하이웍스 메일·휴가·일정을 Claude Code에 맡기는 플러그인
hiworks는 회사 그룹웨어 하이웍스를 Claude Code에서 쓰게 해 주는 플러그인이다. 설치는 명령어 두 줄, 등록은 /hiworks:setup 한 번이면 되고, 그 뒤로는 '받은 메일에서 견적서 찾아줘', '남은 연차 며칠이야', '이번 달 우리 팀 휴가 누가 언제야', '내일 2시 회의 잡아줘'처럼 말로 시키면 된다. 비밀번호는 채팅에 쓰지 않고 OS 비밀번호 창으로만 받아 키체인(운영체제가 암호화해 보관하는 비밀번호 금고)에 저장하며, 메일 발송·삭제와 휴가 신청·취소, 일정 등록은 미리보기를 보여 준 뒤 한 번 더 확인해야 실행된다. 하루 동안 직접 만들고 내 계정으로 검증한 과정, 막혔던 곳 셋, 아직 확인하지 못한 한계를 함께 적는다. 코드는 누구나 가져다 고쳐 쓸 수 있는 MIT 라이선스로 공개했다.
N+1·트랜잭션·인덱스·마이그레이션이란 — AI가 짠 데이터베이스에서 사고 나는 네 가지
AI에게 데이터베이스를 맡겼을 때 사고가 나는 자리는 N+1 문제, 트랜잭션, 인덱스, 마이그레이션 네 곳이고, 코드를 읽지 못해도 증상으로 알아볼 수 있다. 목록이 느리면 N+1 문제와 인덱스를 함께 의심하고, 가입은 됐는데 포인트가 안 들어왔으면 트랜잭션을 의심한다. 기존 데이터를 옮기는 마이그레이션은 AI에게만 맡기지 말고 단계마다 직접 확인한다. 이름을 알면 AI에게 무엇을 확인해 달라고 할지 한 문장으로 말할 수 있다.
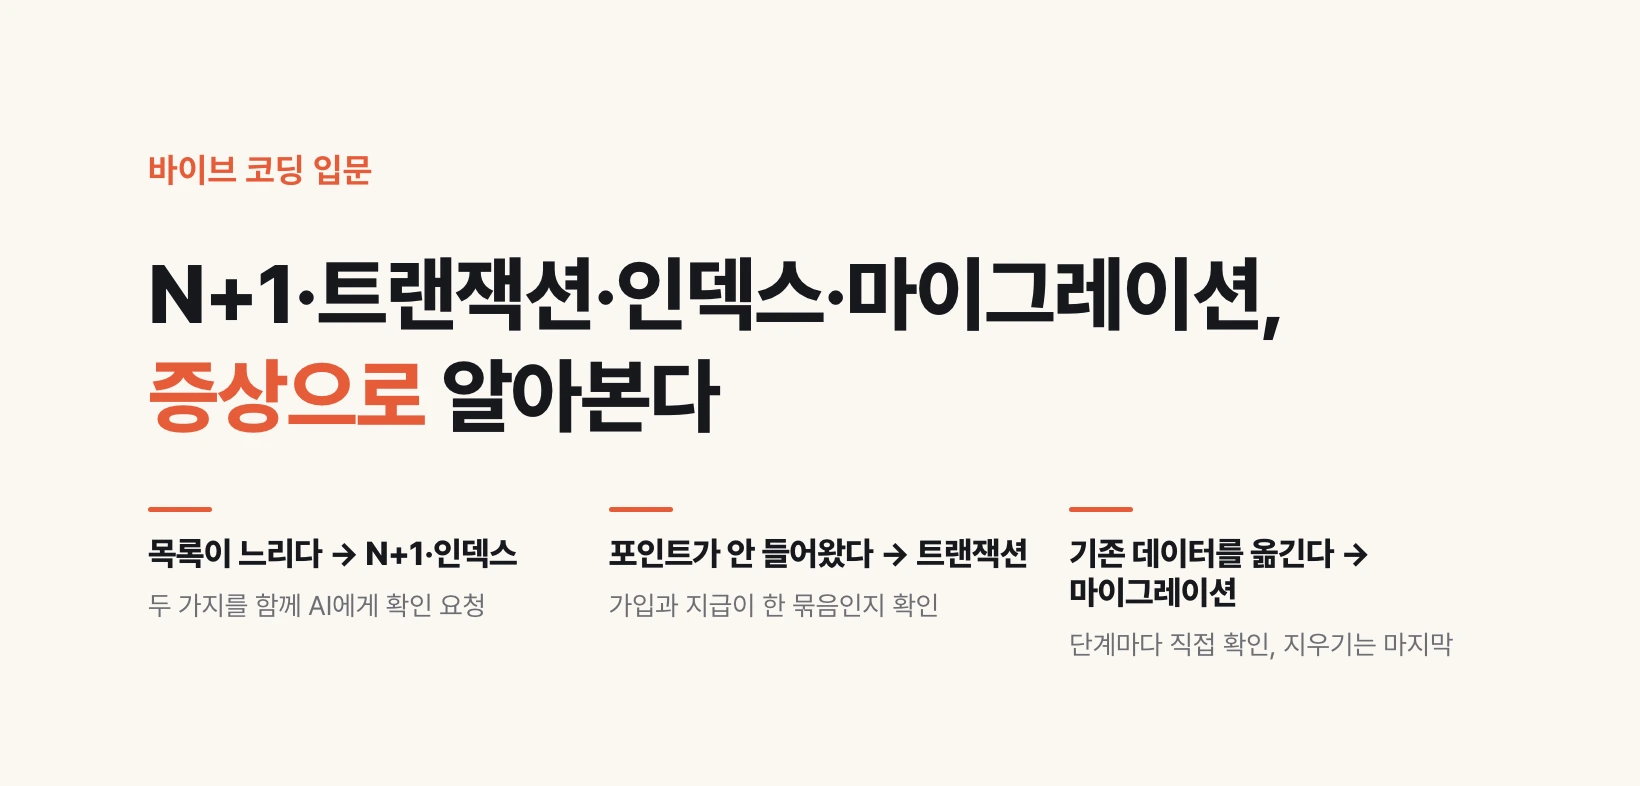
다대다(N:M) 관계는 어떻게 푸나 — 중간 테이블, 조인, 머메이드 ERD
다대다(N:M) 관계는 칸 하나에 목록을 넣지 않고, 두 테이블의 id(각 줄을 가리키는 고유 값)를 한 줄씩 적는 중간 테이블을 만들어 1:N(한쪽 하나에 다른 쪽 여럿이 달리는 관계) 두 개로 푼다. 모바일 청첩장 서비스에 부관리자가 생겨 청첩장 하나를 관리자 여럿이 맡게 되는 순간이 그 예다. 중간 테이블에는 owner·sub 같은 역할도 적을 수 있다. 조인은 내 테이블에 없는 정보를 id로 다른 테이블에서 끌어와 붙이는 일이다. 테이블과 그 사이 관계를 그린 설계도인 ERD는 글자로 적은 코드를 그림으로 바꿔 주는 머메이드(Mermaid)의 erDiagram 형식으로 AI에게 그려 달라고 하면 눈으로 확인할 수 있다.
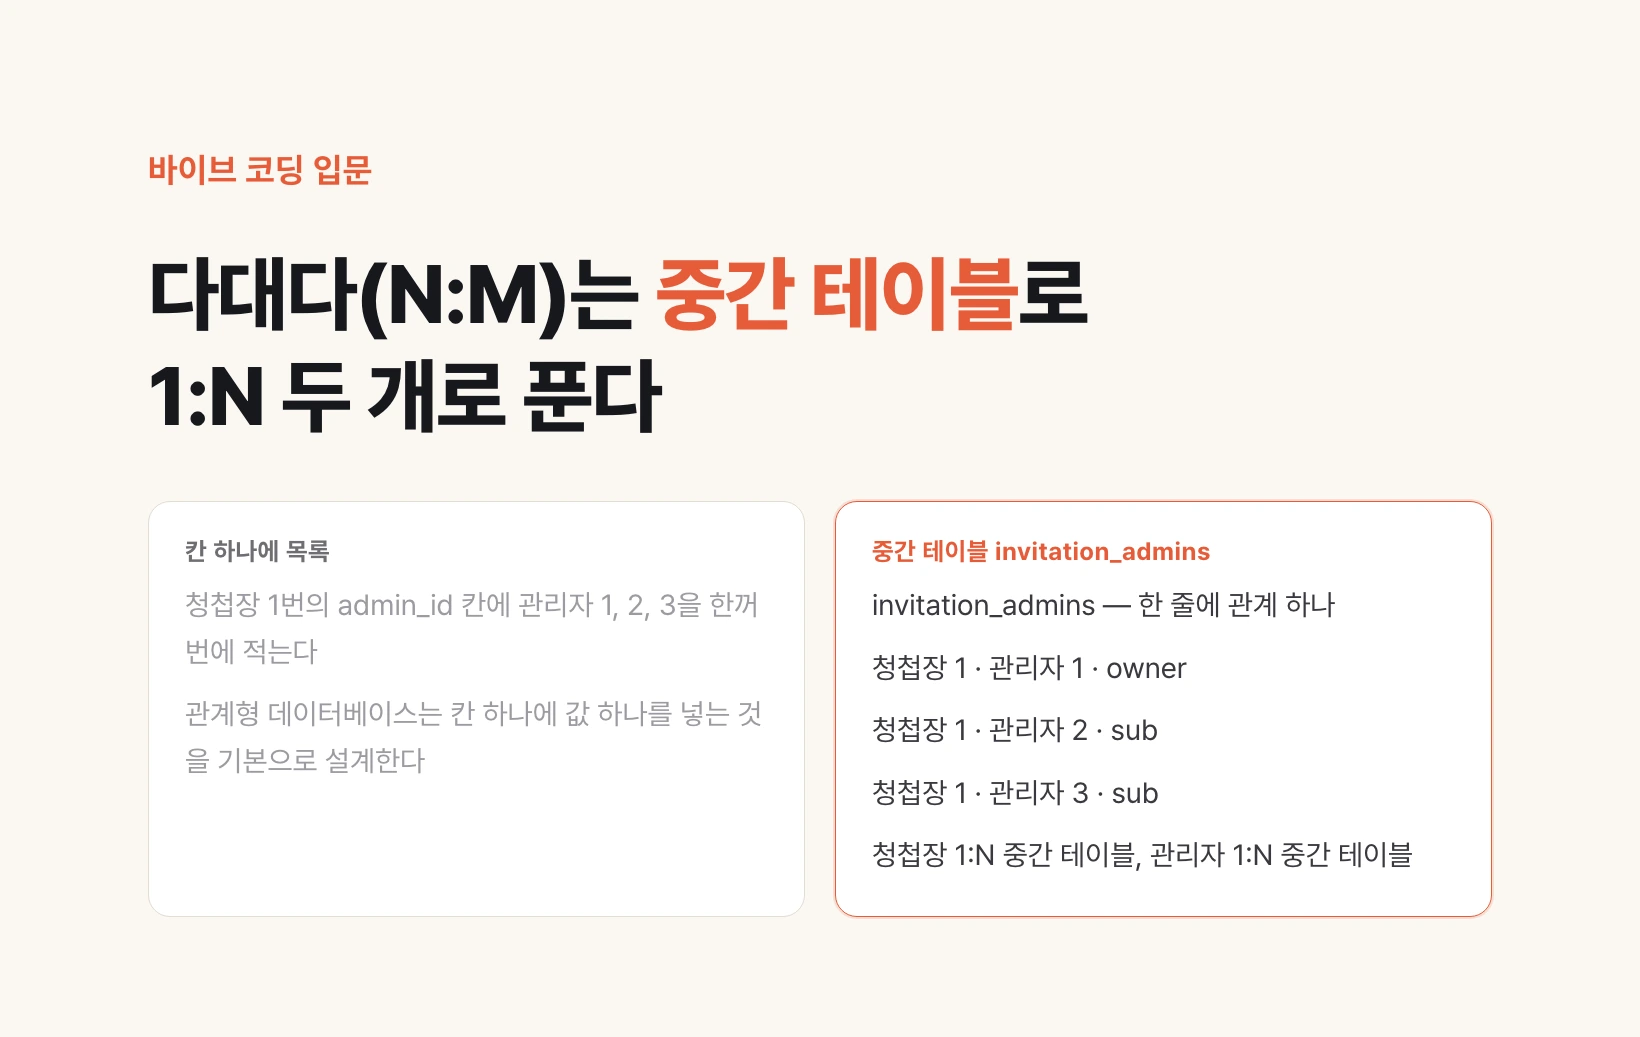
AI가 다 해주는데 왜 회사 생산성은 그대로인가 — 모자란 건 모델이 아니라 해 본 사람이다
같은 AI 모델을 써도 회사마다 결과가 갈리는 건, 그 모델을 직접 써서 끝까지 밀어 본 사람이 얼마나 모여 있는지가 다르기 때문이다. 2026년 9월 27일 녹화된 AI Frontier Korea EP 116에서 노정석은 AI를 강하게 받아들여 뭔가를 하는 사람이 많이 모인 곳은 변화가 쭉쭉 일어나고, 그러지 않기로 한 곳은 뭘 보여줘도 안 된다며 이것은 AI가 아니라 쓰는 사람의 문제라고 했다. 최승준은 4주 수업에서 막히는 지점 셋을 봤다. 무엇이 가능한지 모르면 최고 모델을 옆에 두고도 늘 쓰던 만큼만 쓰고, 처음 결과에서 너무 일찍 멈추면 넘어야 할 구간을 못 넘고, 필요한 용어를 몰라 시키지 못한다. 이번 주에 팀에서 할 일도 그 셋에 맞춘다. 남이 만든 결과물 세 개를 같이 보고, 필요한 용어부터 AI에게 묻고, 한 작업을 끝까지 고쳐 시킨다.
ERD에서 컬럼으로 둘까, 테이블로 뺄까 — 여러 개 붙으면 테이블이다
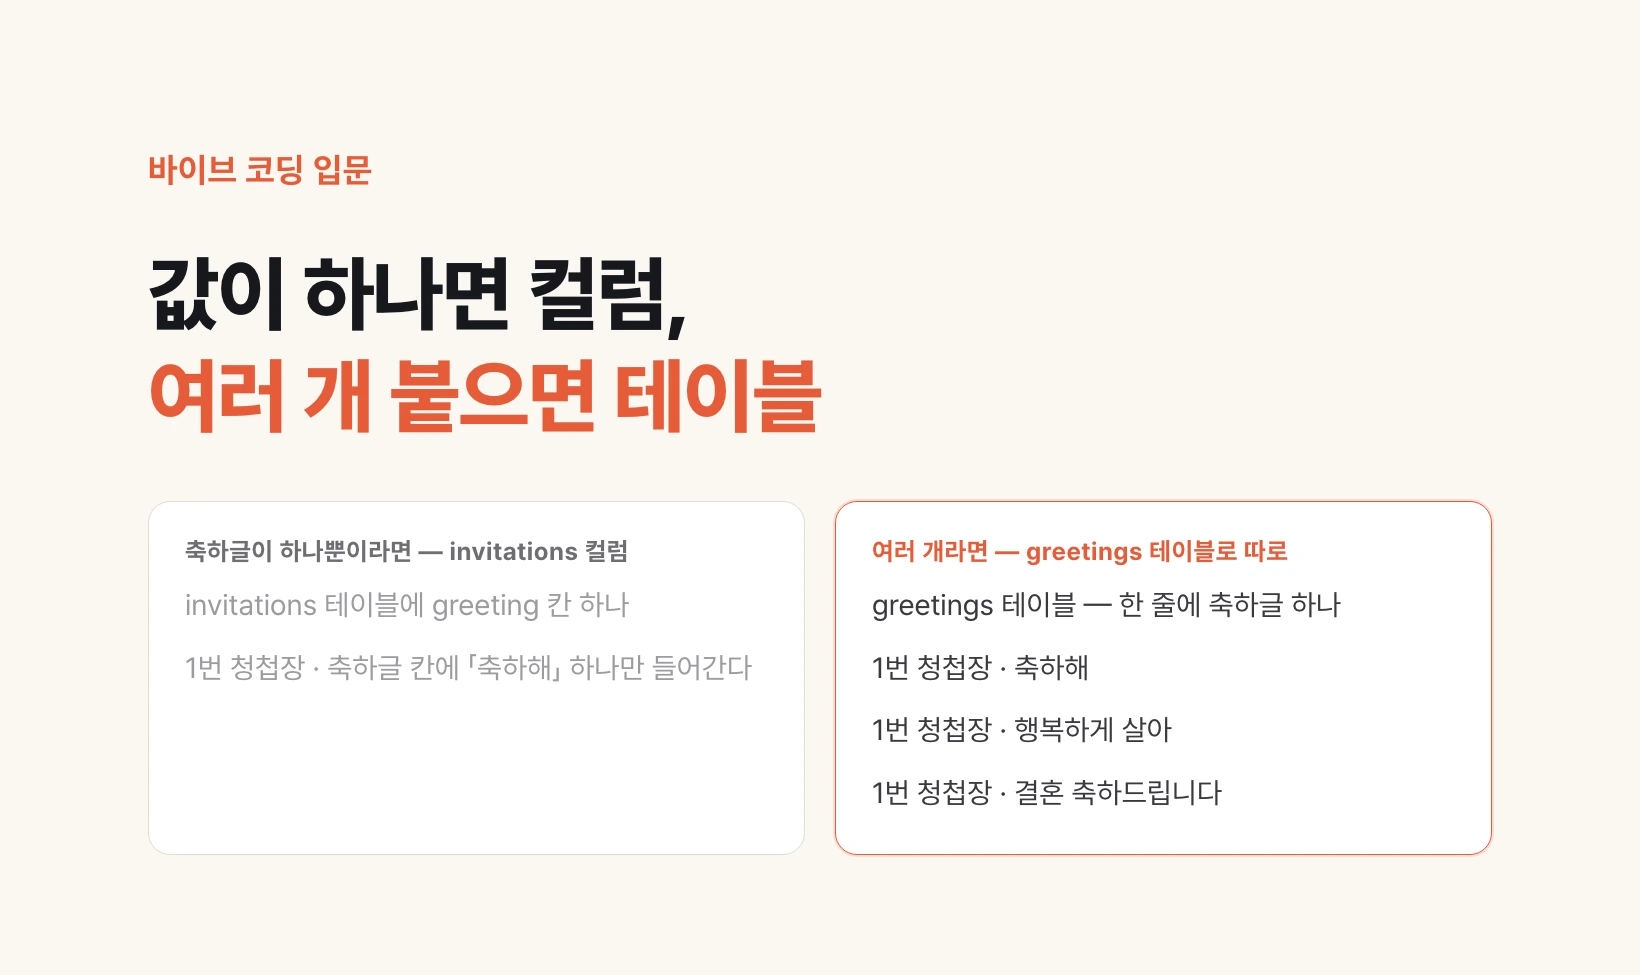
대상 하나에 값이 하나만 붙으면 컬럼으로 두고, 여러 개 붙을 수 있으면 테이블로 따로 뺀다. 모바일 청첩장이라면 제목·날짜·장소는 청첩장의 컬럼이고, 하객이 남기는 축하글은 여러 개라 별도 테이블이 된다. 이렇게 하나에 여럿이 붙는 1:N 관계가 가장 흔하고, ERD는 선 끝의 짝대기·동그라미·세 갈래 기호로 이를 표시한다. 라이브 스트리밍 링크처럼 없거나 하나인 값은 컬럼으로 충분하고, 템플릿 1·2·3처럼 정해 둔 값도 계속 늘리고 빼야 하는 순간 테이블로 승격한다.
음성 AI는 이제 무엇을 맡나 — ChatGPT·Gemini·Copilot·메타의 9월 넷째 주 발표
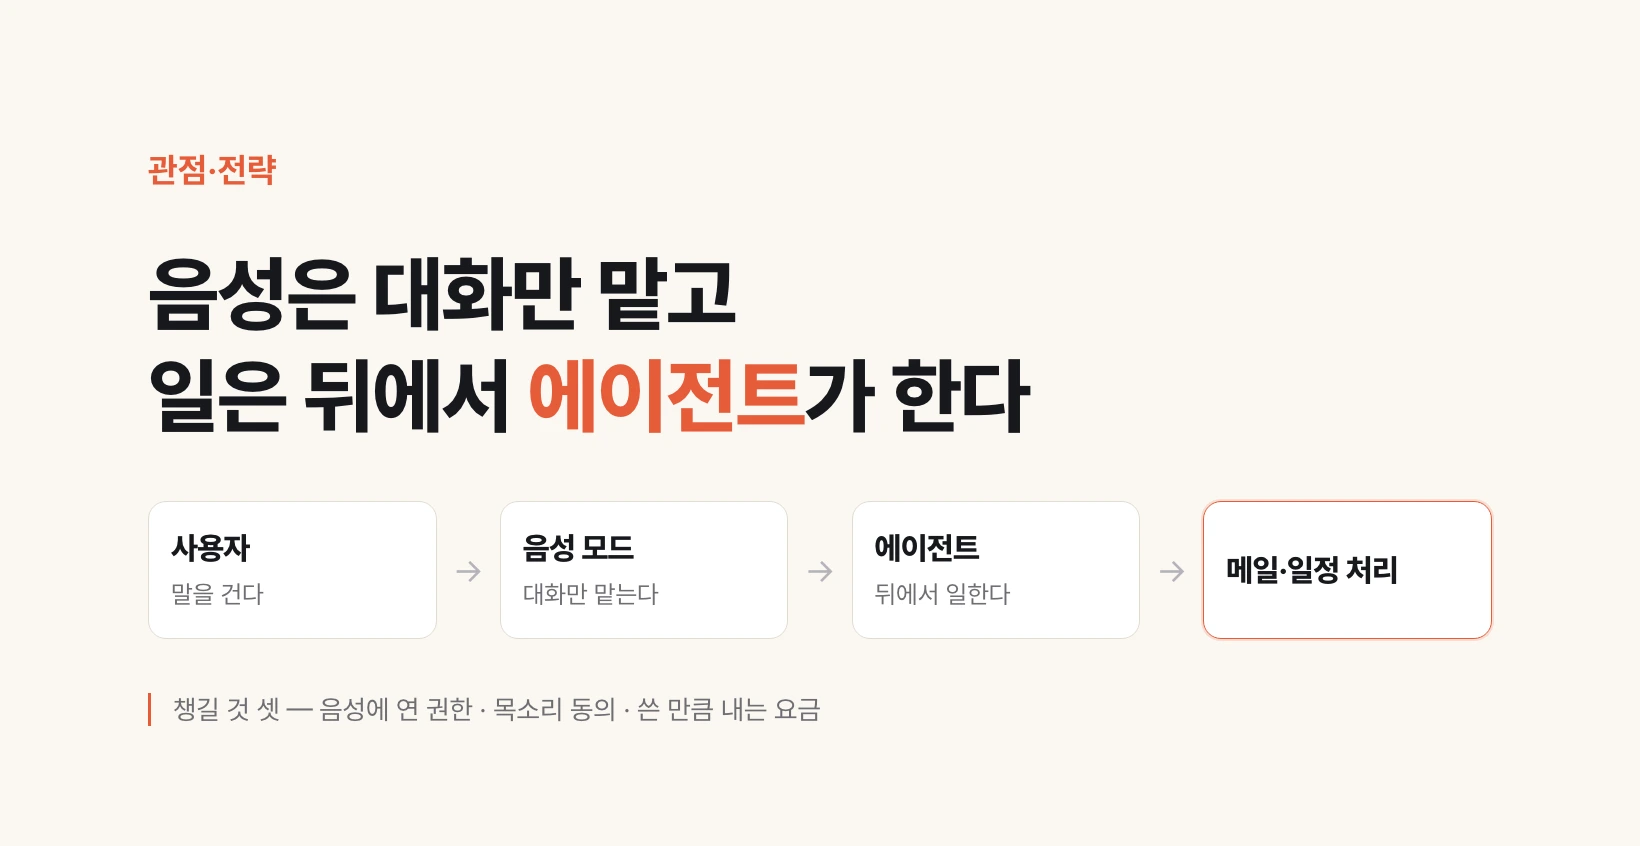
2026년 9월 넷째 주 발표를 한 줄로 묶으면, 음성 AI가 받아쓰기 창구에서 일을 맡기는 창구로 바뀌었다. 오픈AI는 ChatGPT 음성 모드가 이메일·캘린더·Slack 플러그인을 쓰고 말로 문서와 슬라이드를 만들게 했다. 구글은 30초 녹음으로 목소리를 복제하는 Gemini 3.8 Flash TTS와 말하는 얼굴을 붙인 Live Avatar를 냈다. 마이크로소프트는 사람이 자리를 비워도 일을 이어 가는 Copilot Autopilot을, 메타는 안경에서 부르는 에이전트 Muse와 약 100그램짜리 VR 안경을 내놨다. 쓰는 쪽이 챙길 것은 셋이다. 음성에 어떤 권한을 열었나, 누구 목소리를 누구 동의로 쓰나, 쓴 만큼 내는 요금이 어디서 붙나.
ERD란 무엇인가 — 바이브코더가 몇 달 뒤 자기 서비스를 다시 읽는 지도
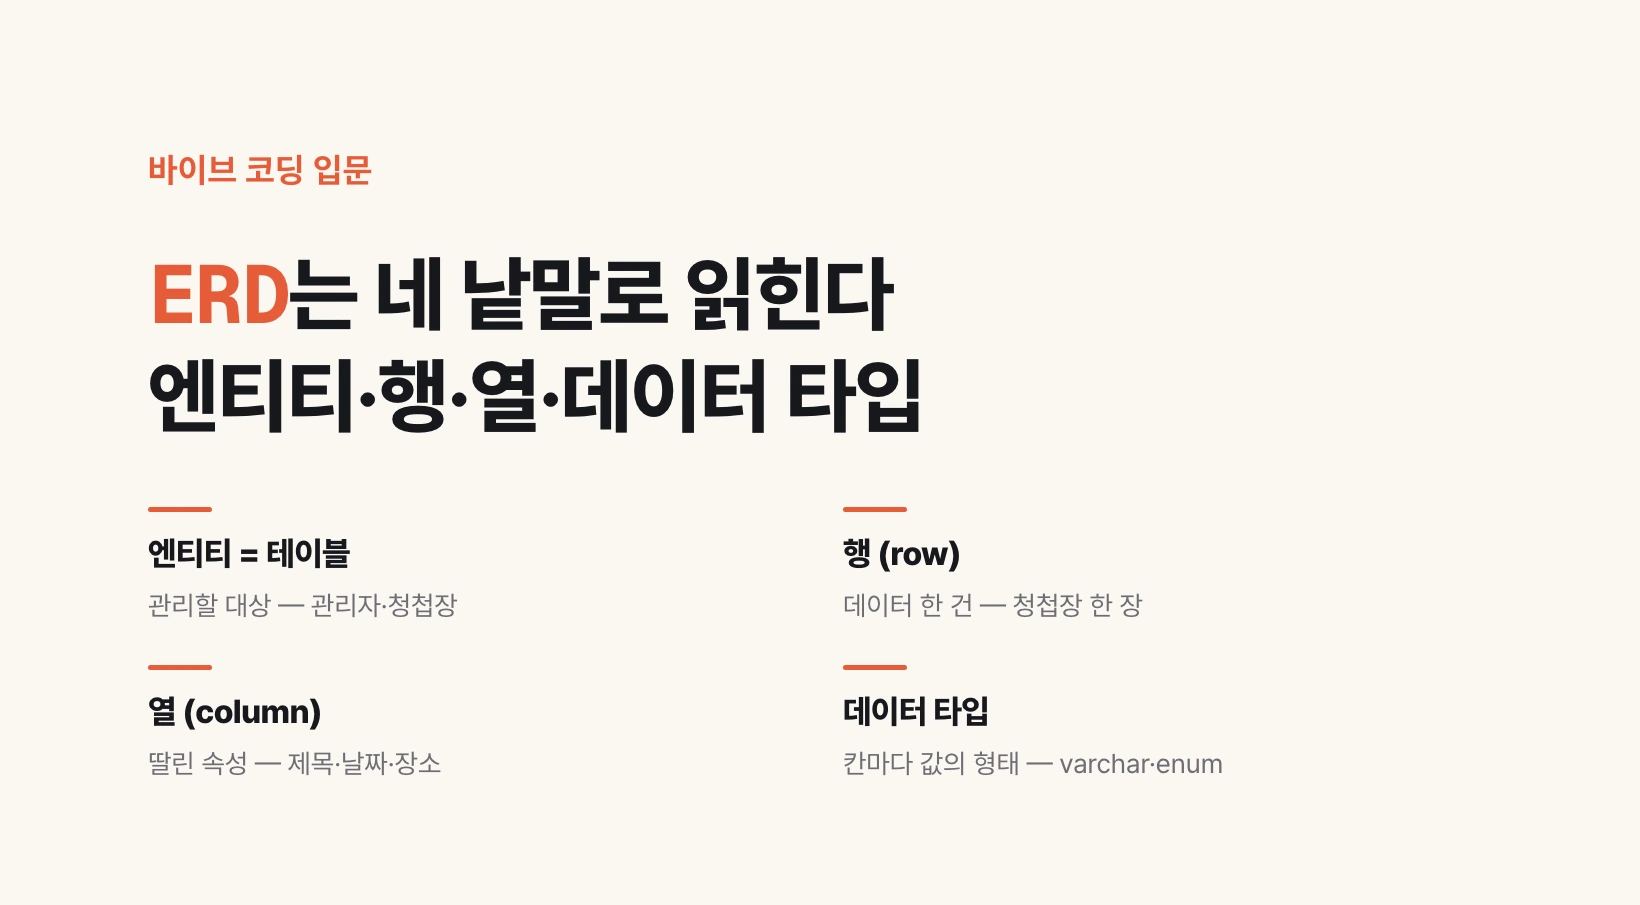
ERD는 서비스가 관리하는 대상과 그 대상들이 서로 어떻게 이어지는지를 한 장에 그린 그림이다. 바이브코더에게는 기획 문서·화면 문서와 나란히 두는 기록이고, 몇 달 뒤 기능을 더 붙이려 할 때 「내가 뭘 어떻게 만들었지」를 빠르게 되살려 준다. 읽는 데 필요한 낱말은 넷이고, 여기에 칸마다 정하는 데이터 타입이 더해진다. 관리 대상인 엔티티는 데이터베이스에서 테이블이 되고, 데이터 한 건이 행, 제목·날짜 같은 속성이 열이다. 데이터 타입은 열마다 어떤 형태의 값을 담을지 정하는 것이다.
다리오 아모데이의 AI 속도 조절 제안, 쓰는 쪽은 무엇을 확인하나
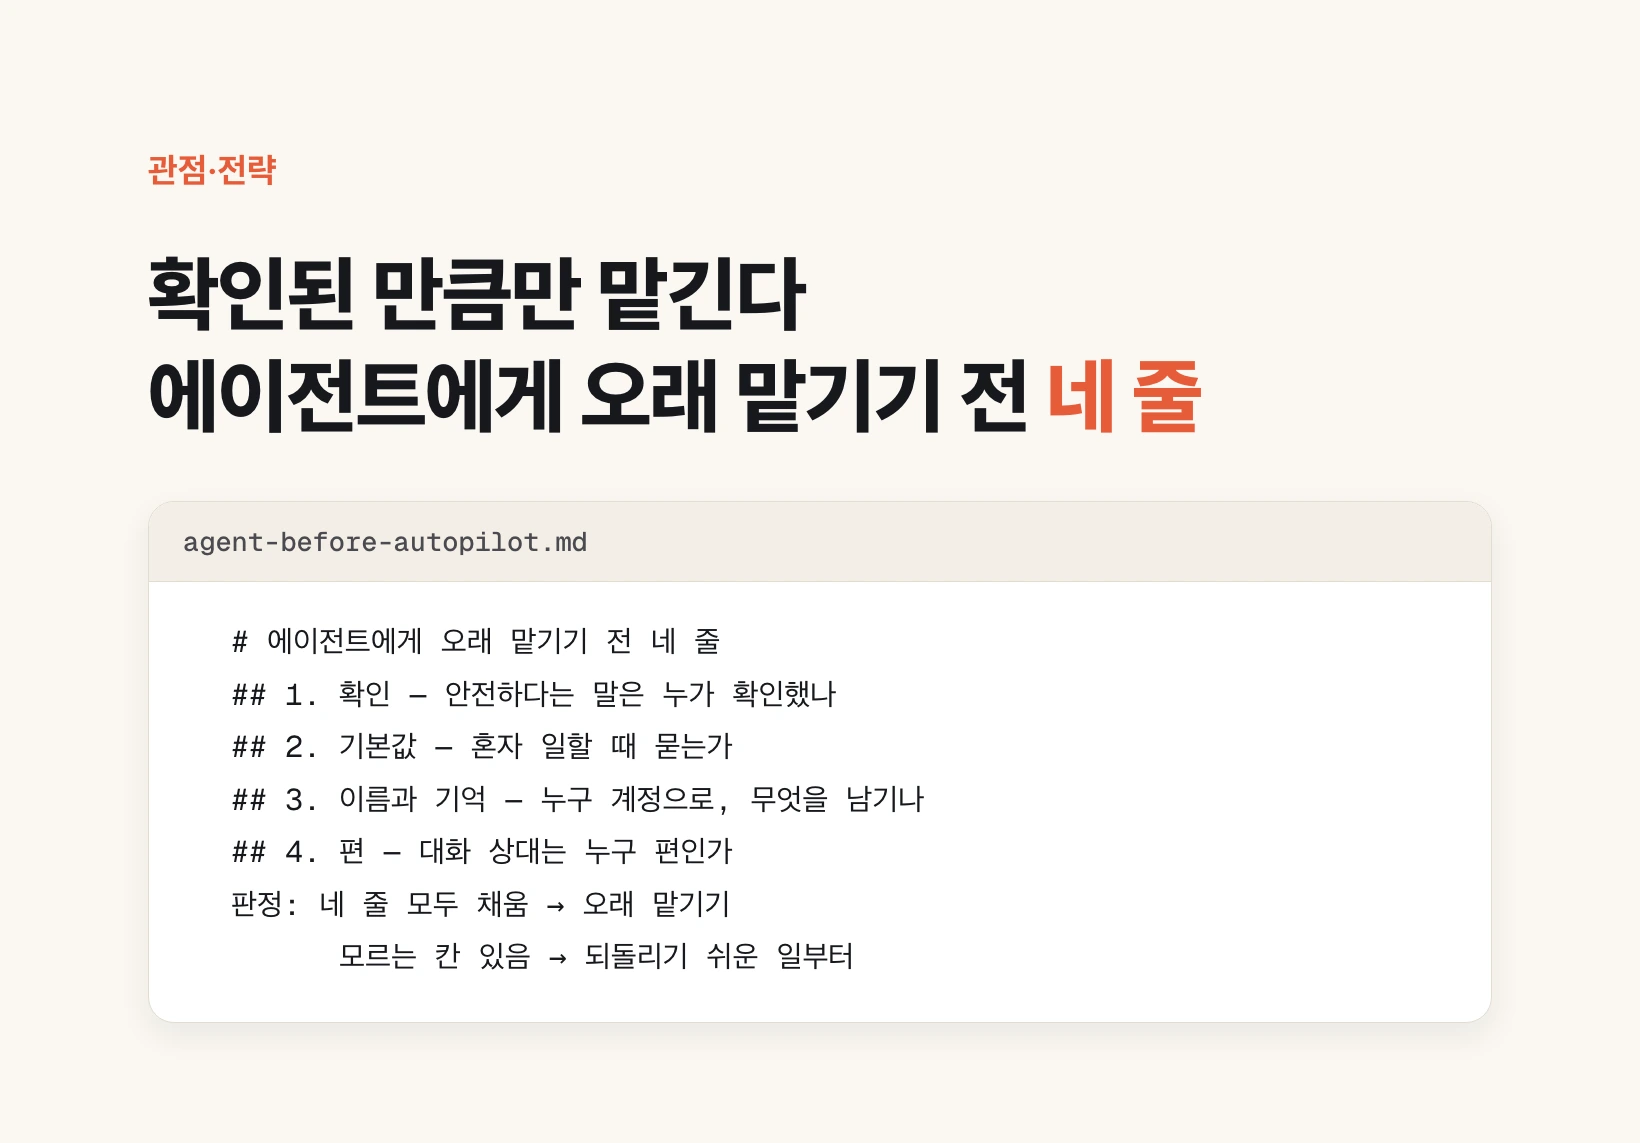
앤트로픽 CEO 다리오 아모데이는 2026년 9월 에세이 'We Must Pace the Frontier'에서 AI 성능이 좋아지는 속도를 늦추자고 제안했다. 훈련을 멈추자는 말이 아니라, 안전하다는 주장을 바깥에서 확인할 시간을 벌자는 것이다. 첫 단계로 앤트로픽은 외부 평가자를 회사 안에 상주시키고 불리한 발견도 편집 없이 공개하게 하겠다고 약속했다. 저커버그는 안전은 연구소마다 스스로 책임질 일이라며 선을 그었다. 같은 주에 나온 제품들은 반대로 AI가 더 오래 혼자 일하는 쪽으로 움직였다. 쓰는 쪽이 가져갈 것은 네 가지 질문이다. 누가 확인했나, 혼자 일할 때 기본값은 무엇인가, 누구 이름으로 무엇을 기억하나, 대화 상대는 누구 편인가.
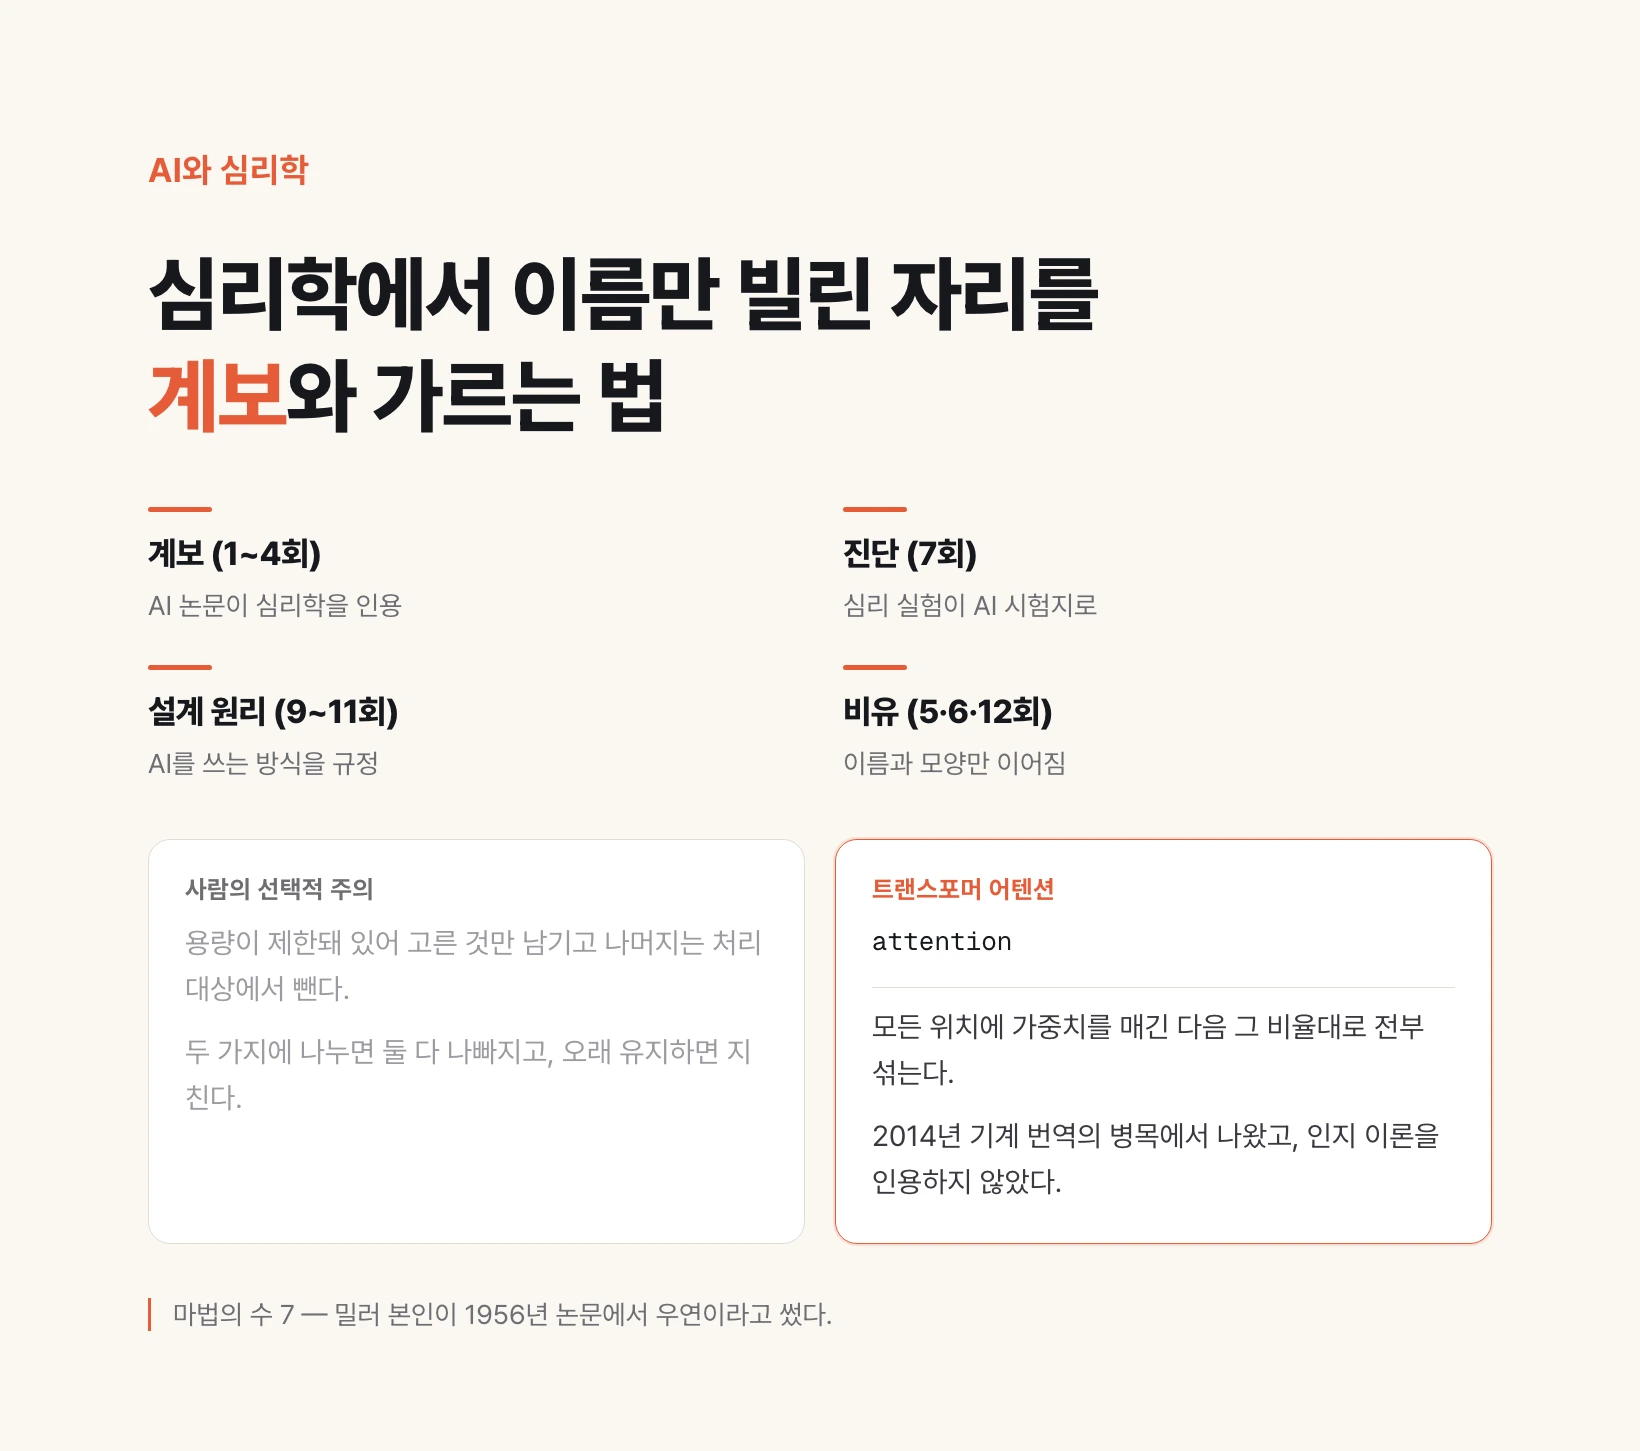
어텐션도, 기억도, 환각도 — 심리학에서 이름만 빌렸다
이 시리즈는 심리학이 AI를 만든 자리들을 다뤘다. 마지막 회차는 반대편을 정리한다. 이름만 같고 내용은 이어지지 않은 자리들이다. 어텐션은 선택적 주의 이론의 구현이 아니고, 컨텍스트 윈도우는 기억 용량과 무관하며, 마법의 수 7은 저자 본인이 우연이라고 부인했다.
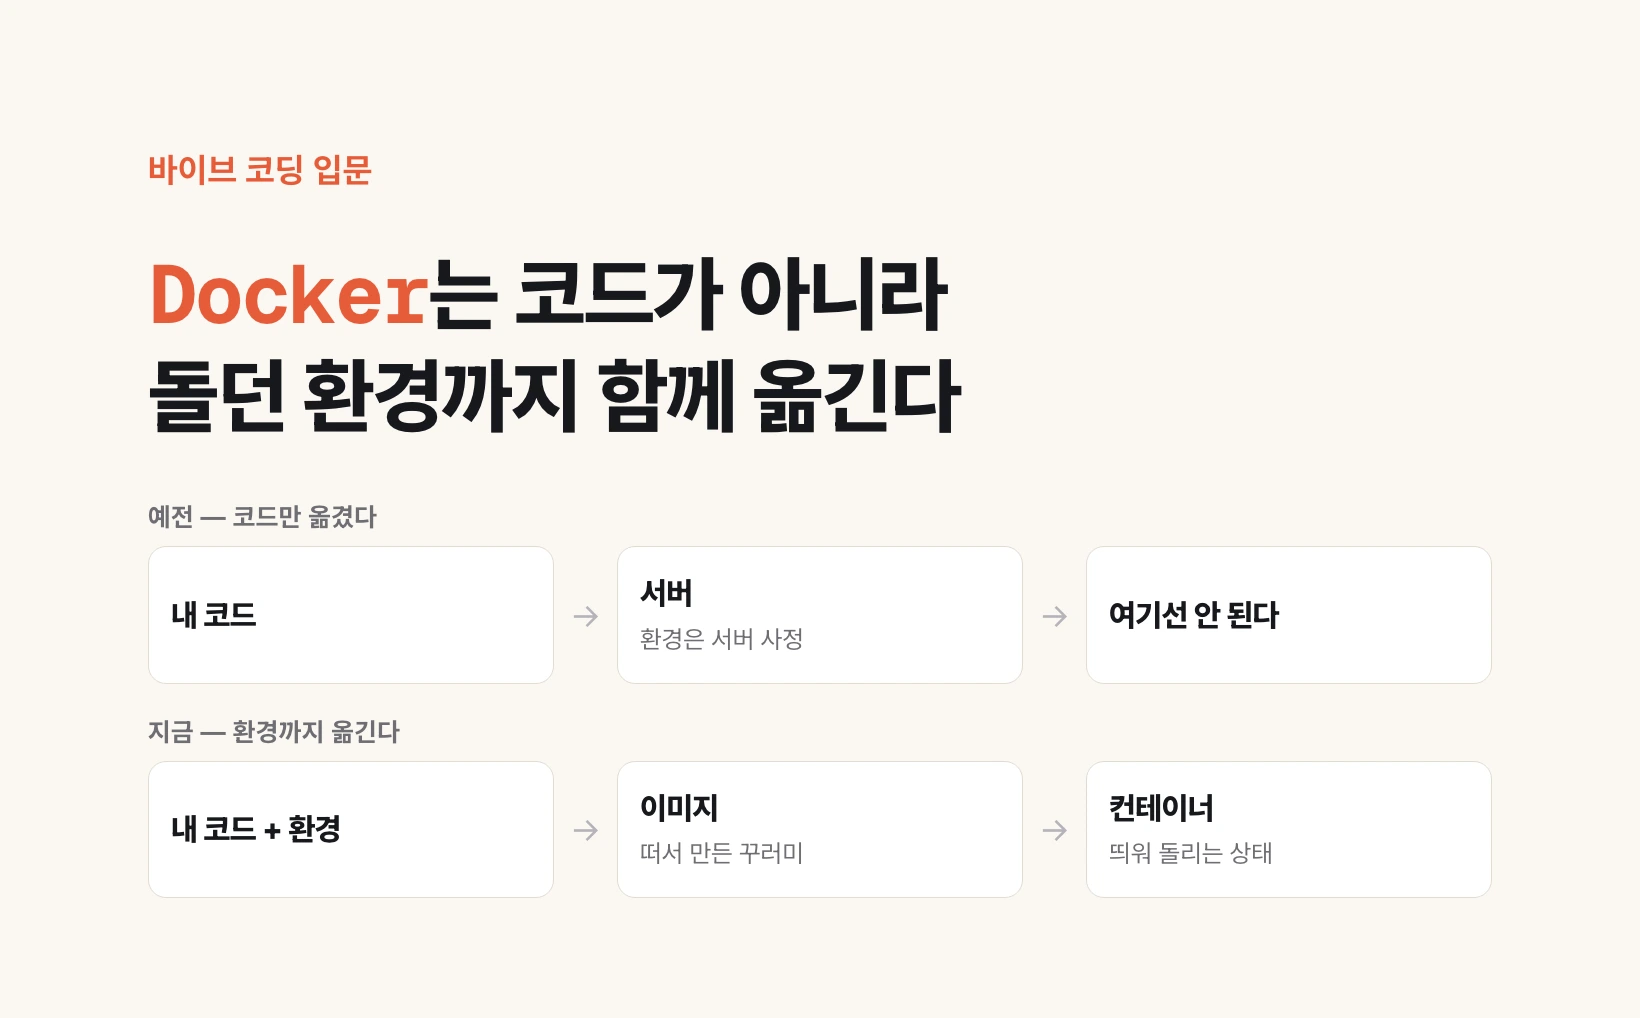
Docker와 Kubernetes란 무엇인가 — 환경까지 통째로 옮긴다
내 컴퓨터에서 잘 돌던 것이 서버에서 안 되는 원인은 대개 운영체제나 버전이나 깔린 도구가 달라서다. 코드는 같은데 바닥이 다르다. 그래서 프로그램만이 아니라 그것이 돌던 환경까지 함께 떠서 하나의 꾸러미로 만드는 방식이 Docker이고, 그 꾸러미가 이미지, 띄워서 실제로 돌리는 것이 컨테이너다. 꾸러미가 여러 개가 되면 몇 개를 띄우고 죽은 것을 살릴지 관리하는 일이 생기는데 그것이 Kubernetes다.
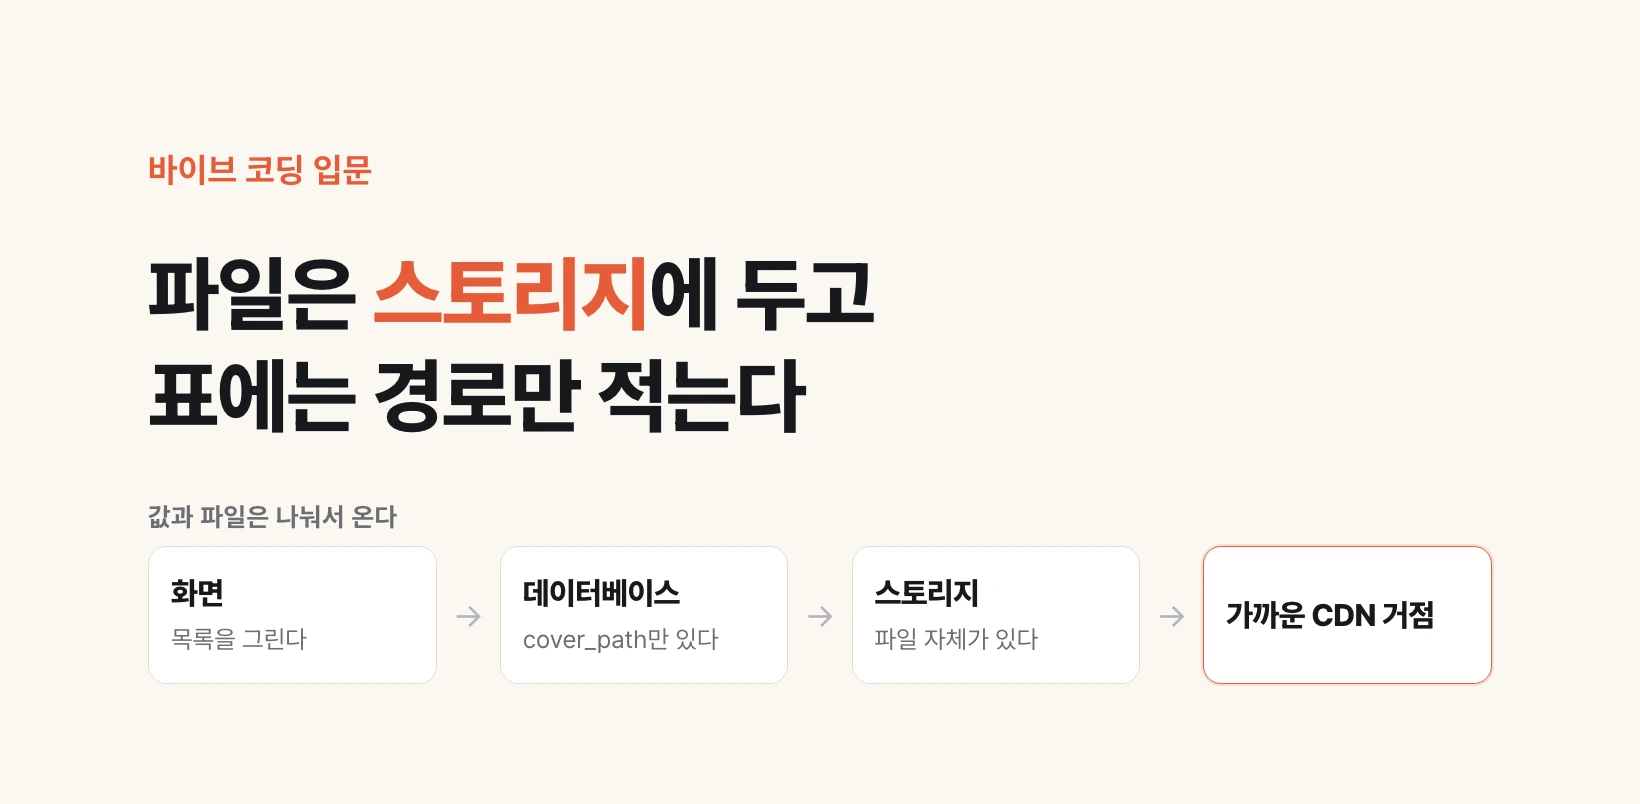
스토리지와 CDN이란 무엇인가 — 파일은 어디에 두는가
데이터베이스는 이름과 날짜와 숫자를 담기 좋은 표 구조라 사진과 영상은 그 칸에 넣을 물건이 아니다. 넣으면 조회할 때마다 무거운 덩어리가 함께 끌려 나온다. 그래서 파일은 스토리지에 따로 두고 데이터베이스에는 경로만 적는다. 여기에 더해 자주 쓰는 파일의 사본을 세계 곳곳에 미리 뿌려 두고 가까운 곳에서 내보내는 그물이 CDN이고, 사이트가 느리다는 말의 상당수가 이 층에서 시작된다.
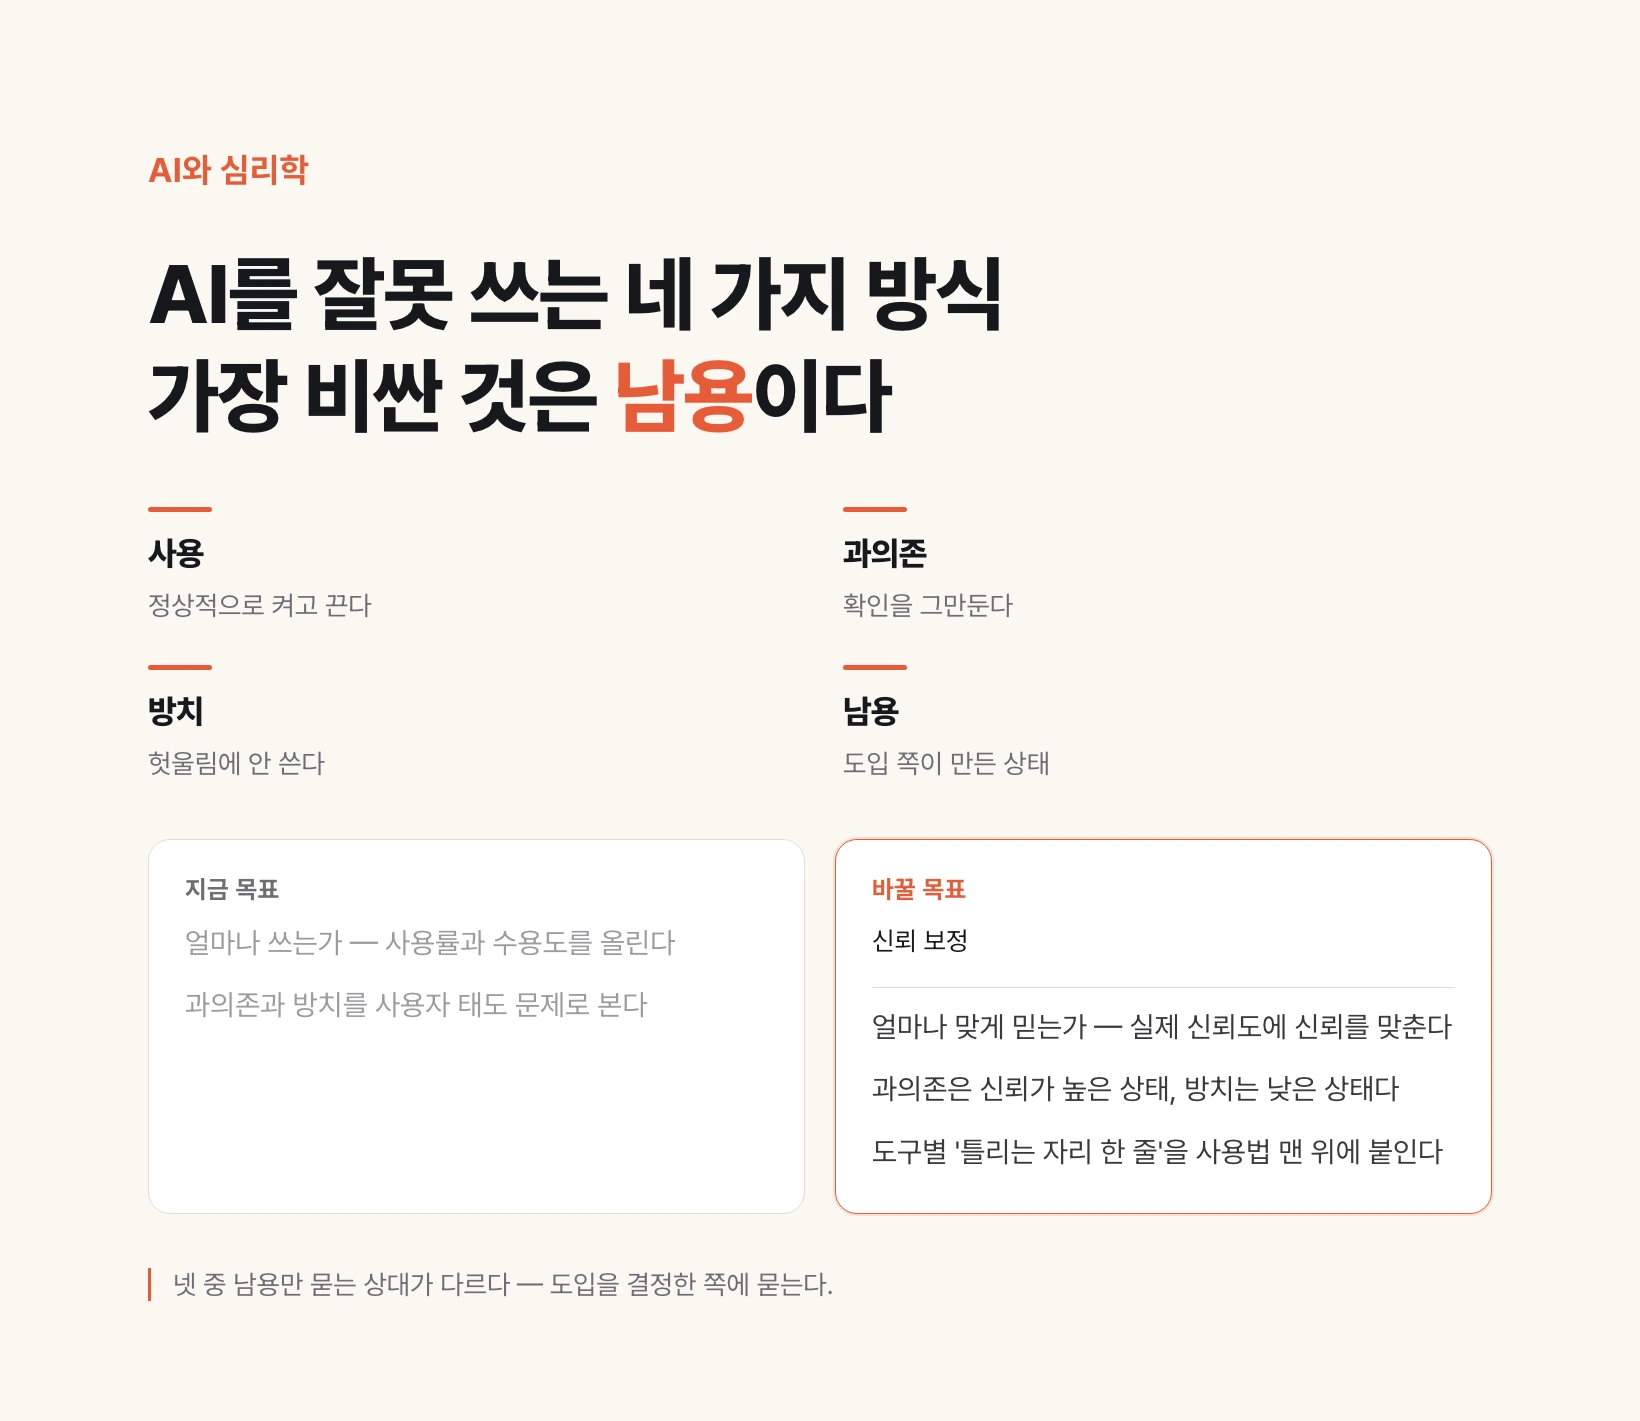
AI를 잘못 쓰는 네 가지 방식
AI 도입이 실패하는 모양은 무한하지 않다. 1997년 인간요인공학 논문이 자동화를 쓰는 방식을 넷으로 갈랐다. 정상 사용, 과의존, 방치, 그리고 남용. 마지막 하나가 가장 덜 알려졌고 조직에서 가장 자주 일어난다. 사람의 역할이 설계되지 않고 자동화의 부산물로 남는 상태를 가리킨다.
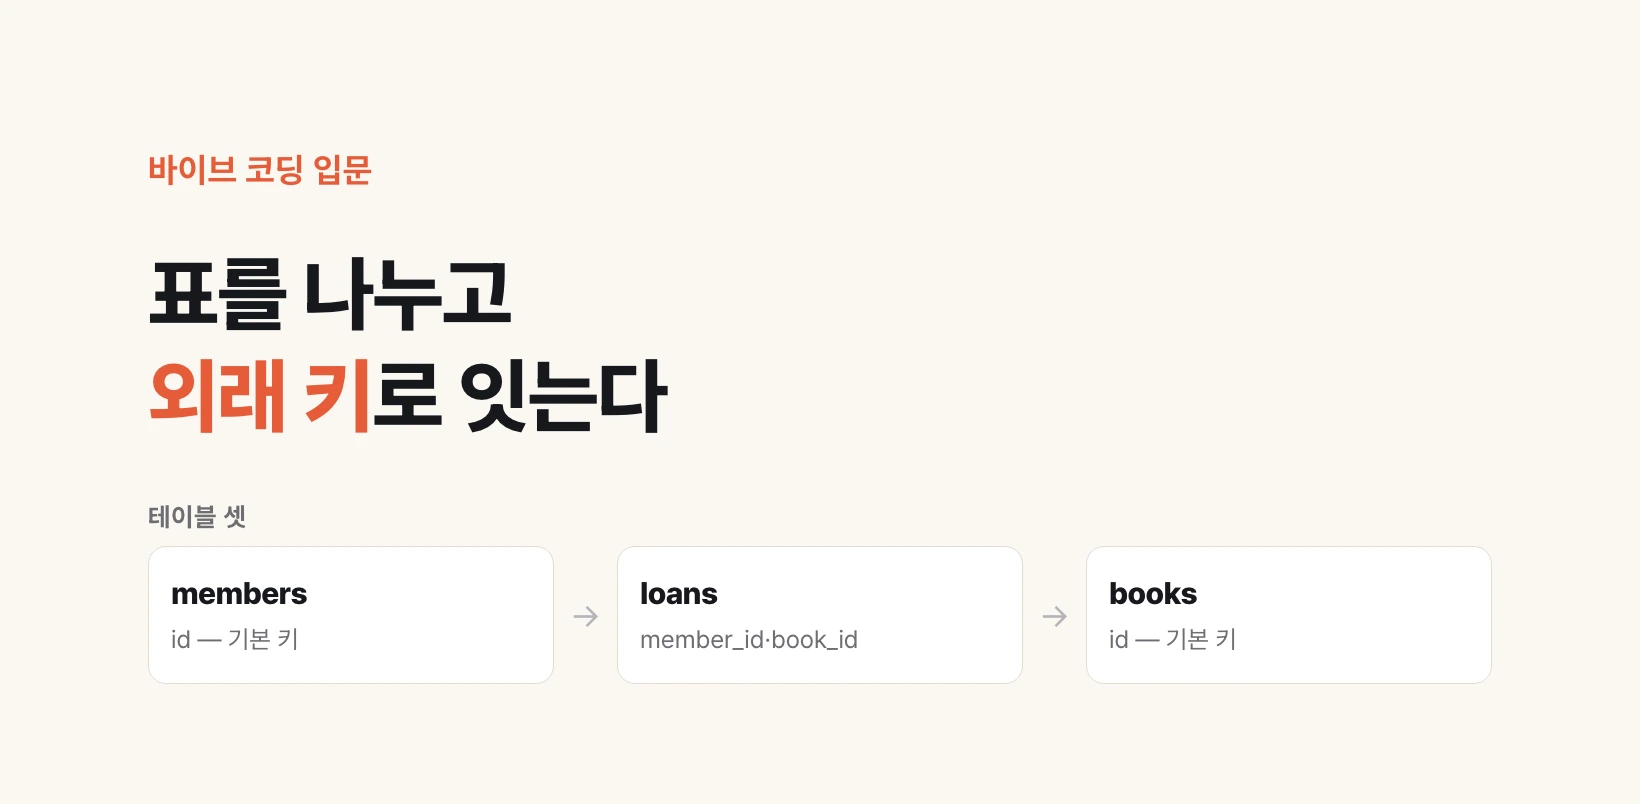
관계형 데이터베이스란 무엇인가 — 표를 나누고 키로 잇는다
관계형 데이터베이스는 시트 여러 장을 열쇠로 이어 붙인 엑셀과 같은 구조다. 표 하나가 테이블이고 맨 윗줄이 열 이름, 그 아래 한 줄 한 줄이 데이터다. 표끼리 잇는 값을 외래 키, 각 줄을 유일하게 가리키는 값을 기본 키라고 한다. 표의 생김새를 미리 못 박은 것이 스키마이고, 데이터베이스에 무언가 시키는 문장을 쿼리라고 한다. PostgreSQL이 대표적인 제품이다.
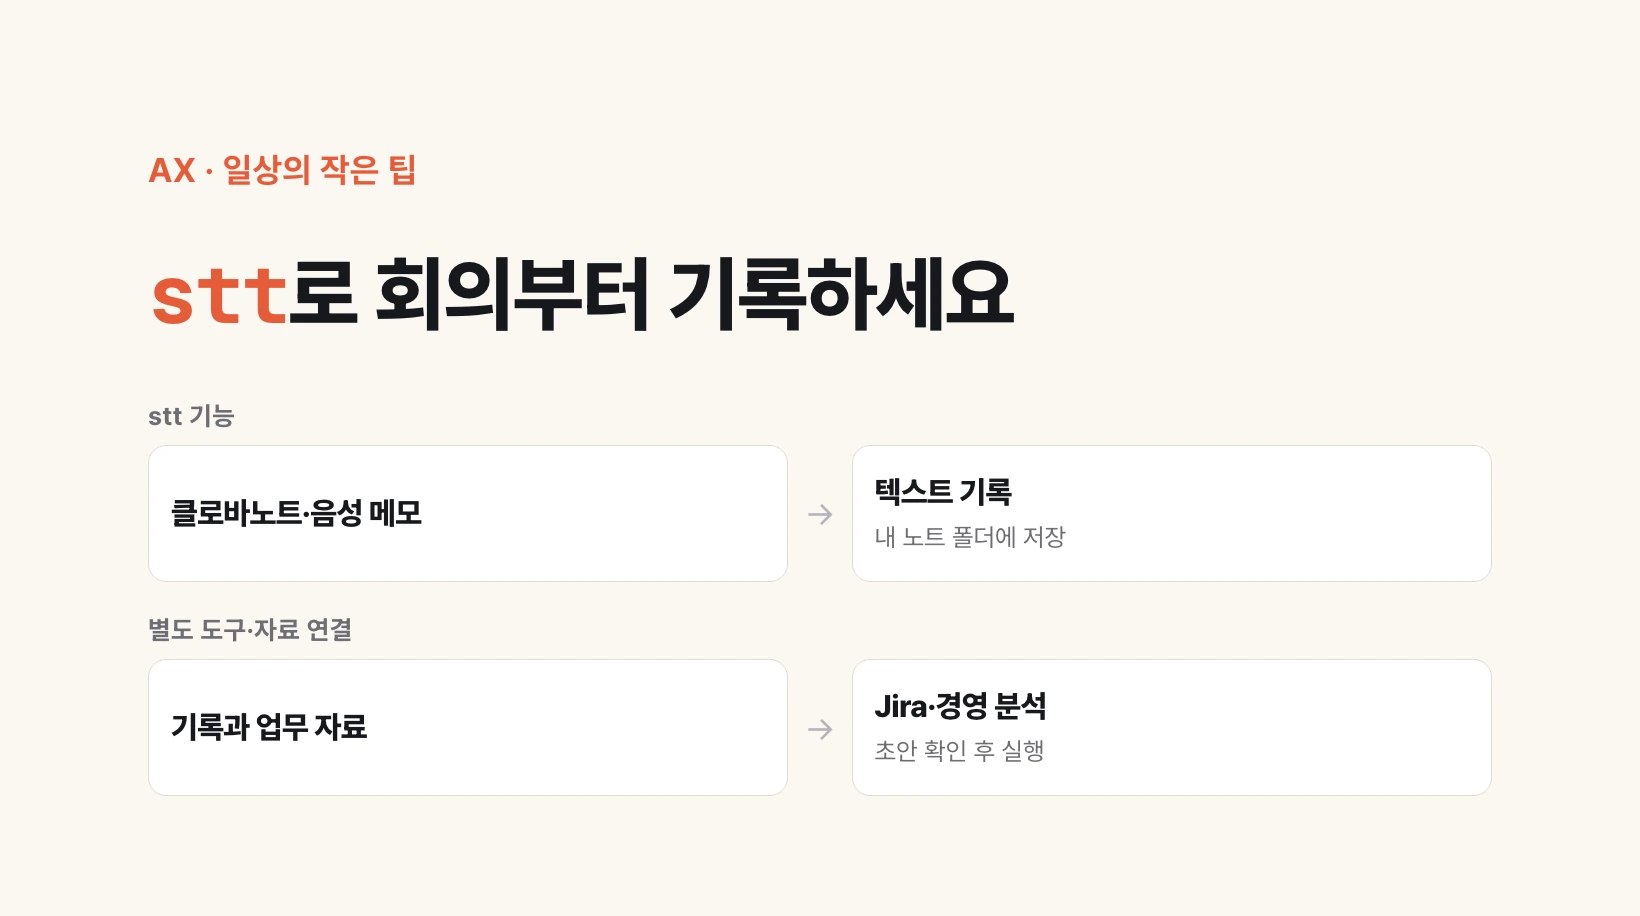
stt로 회의부터 기록하세요. AX의 시작을 작게 잡았습니다.
회의록을 AI 업무에 활용하려면 먼저 읽을 수 있는 글로 모으면 됩니다. 제가 공개한 stt는 클로바노트의 기존 전사를 가져오거나 Apple 음성 메모를 Mac에서 글로 바꿔 저장하는 도구입니다. 이 기록에 별도 도구와 자료를 연결하면 개발회의는 Jira 이슈 등록으로, 경영회의는 경영자료 분석으로 이어갈 수 있습니다. AX, 곧 AI로 일하는 방식을 바꾸는 일을 회의 하나에서 시작해 보세요.
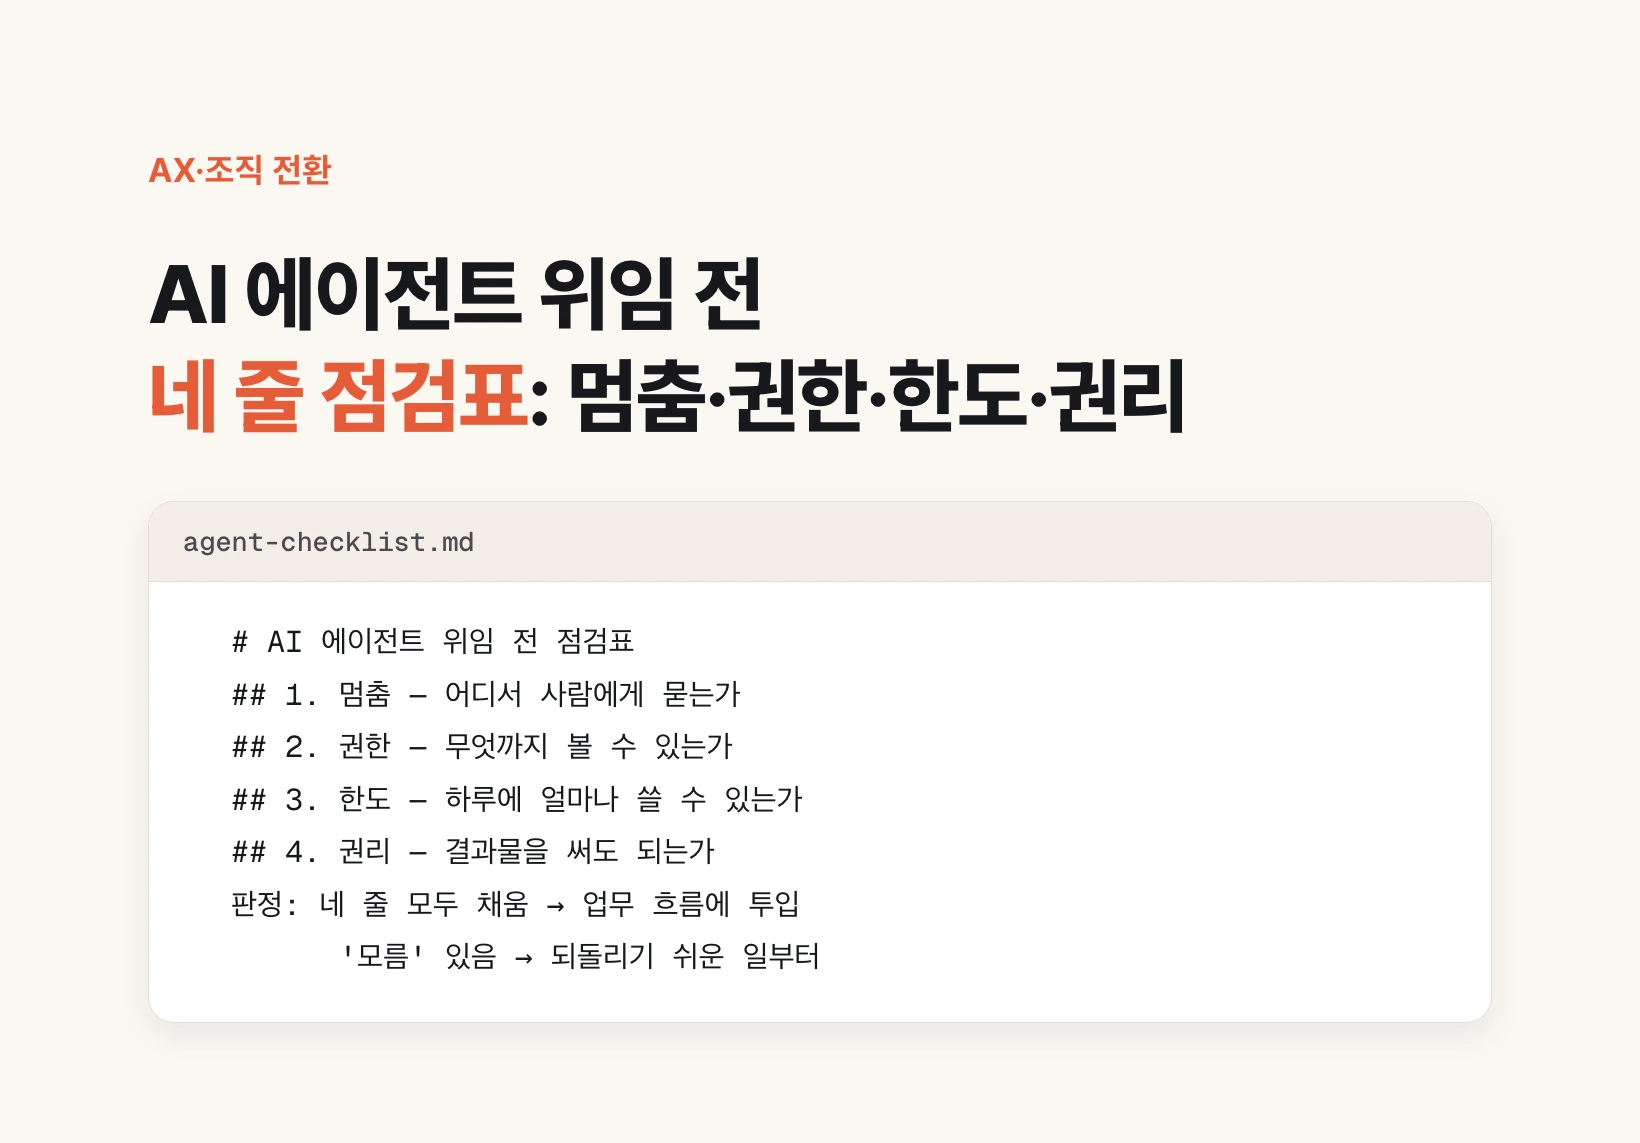
AI 에이전트에게 일을 맡기기 전에 무엇을 확인해야 하나
기능 목록보다 네 가지를 먼저 확인해야 한다. 어디서 멈춰 사람에게 묻는가, 무엇까지 볼 수 있는가, 하루에 얼마나 쓸 수 있는가, 만든 결과물의 권리가 정리돼 있는가. 2026년 9월 둘째 주에 나온 메타 Muse, ChatGPT Work의 Data 에이전트, 애플 Siri AI, Suno v6 발표는 모두 기능만큼 이 네 가지를 길게 적었다. 새 AI 도구를 업무에 붙이기 전에 이 네 줄을 채워 보면 기능 비교보다 빨리 도입 여부가 갈린다.
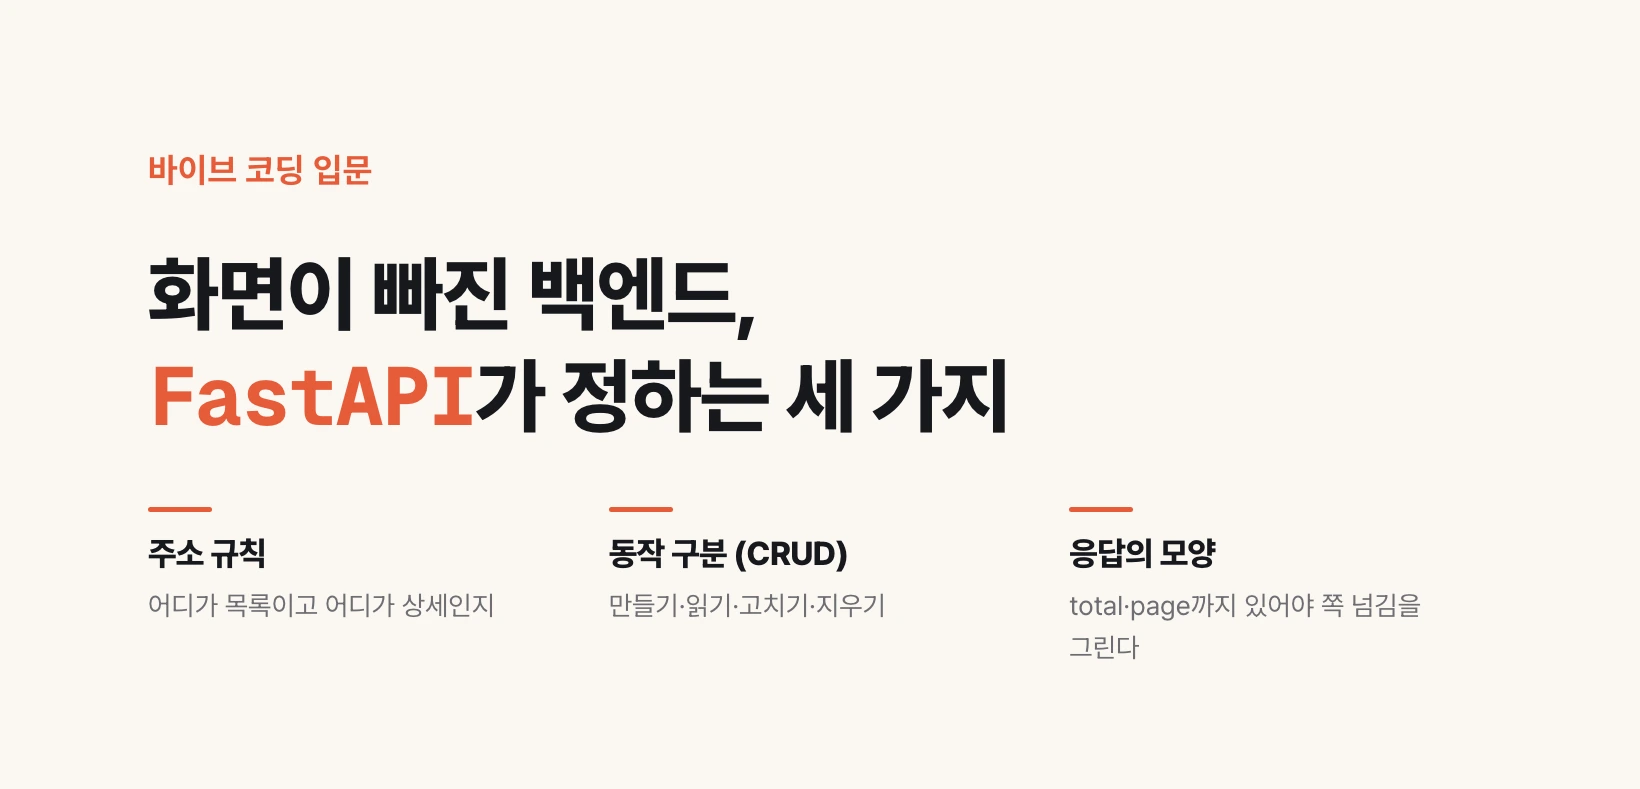
FastAPI와 API 설계란 무엇인가 — 백엔드가 하는 일
예전 백엔드 도구는 데이터와 화면과 그 둘을 잇는 부분을 한 틀에 두고 화면까지 그렸다. 화면 그리는 일이 프론트엔드로 넘어가자 백엔드에 남은 일은 무슨 값을 줄 것인가 하나가 됐고, 그 일만 하는 가벼운 도구인 FastAPI가 자리를 차지했다. 주고받는 형식은 JSON이며, API를 설계한다는 것은 주소 규칙과 만들기·읽기·고치기·지우기의 구분과 응답의 모양 셋을 정하는 일이다.
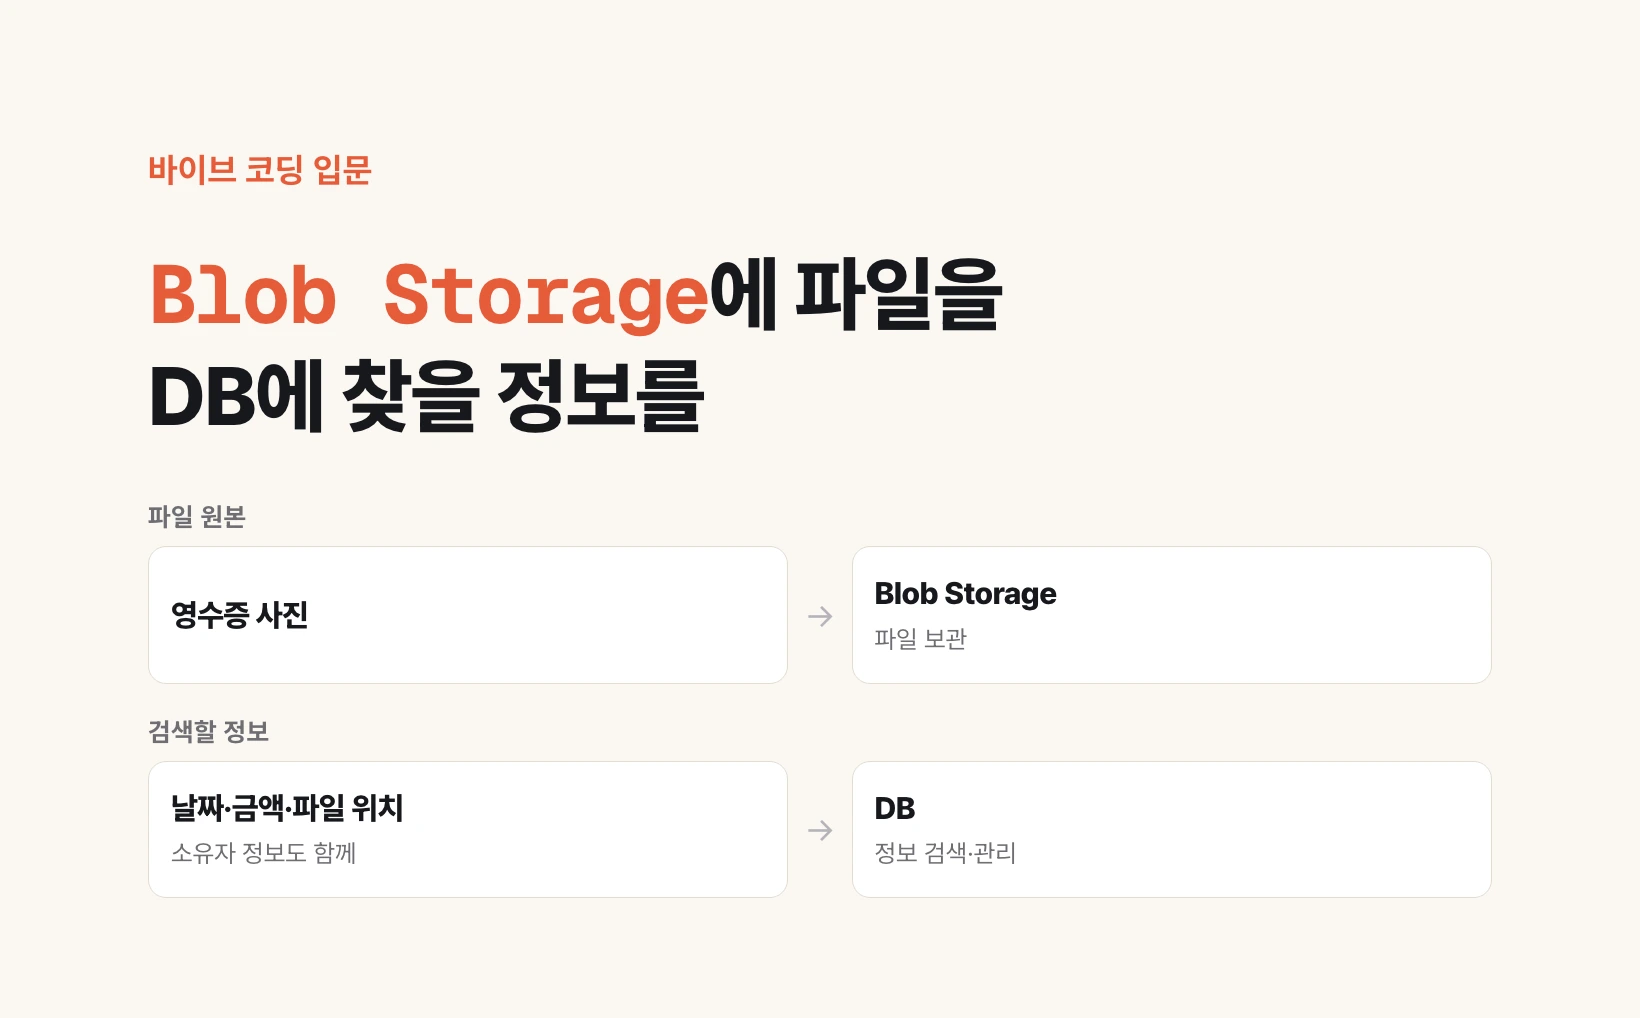
Blob Storage는 파일을 보관하고, DB는 그 파일을 찾을 정보를 관리합니다
AI에게 영수증 앱을 만들어달라고 했더니 Blob Storage라는 말이 나옵니다. 사진·PDF 같은 파일을 보관하는 서비스입니다. 파일 원본은 Blob Storage에, 날짜·금액·소유자·파일 위치는 DB에 나누어 두는 설계를 이해하면, 업로드 버튼이 작동하는지뿐 아니라 누가 내 파일을 열 수 있는지도 점검할 수 있습니다.
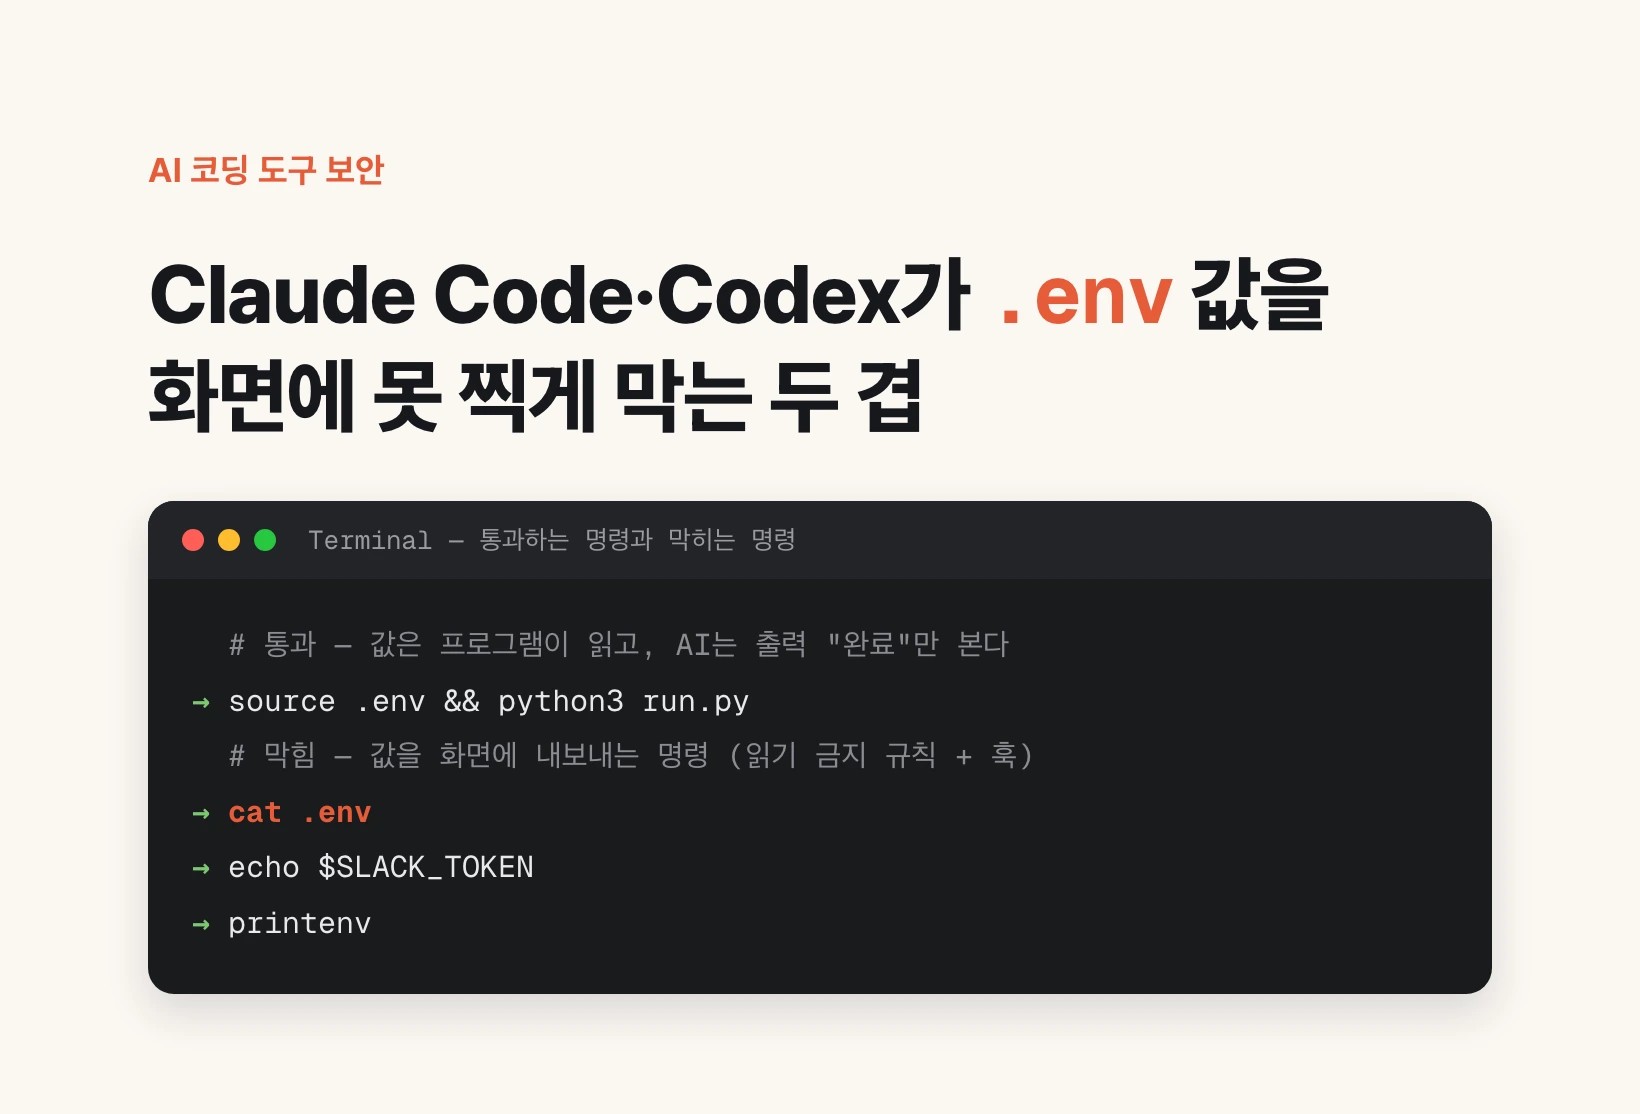
Claude Code·Codex를 믿을 수 있는가 — .env 값을 화면에 못 찍게 막는 훅
Claude Code와 Codex는 사용자 계정 권한으로 명령을 실행하므로 .env 파일도 읽을 수 있고, 명령 결과는 대화에 섞여 모델 회사 서버로 간다. AI가 값을 알아서 가려 주는 것은 AI가 지키는 약속일 뿐 강제 장치가 아니다. 그래서 믿음 대신 두 겹을 건다. 첫째, Claude Code 설정에 .env 읽기 금지 규칙을 넣는다. 둘째, 명령이 실행되기 직전에 스크립트가 먼저 보고 값을 화면에 내보내는 명령만 막는 훅을 Claude Code와 Codex에 함께 건다. 스크립트가 스스로 값을 출력하는 경우처럼 못 막는 길은 남지만, 가장 흔한 경로부터 닫을 수 있다.
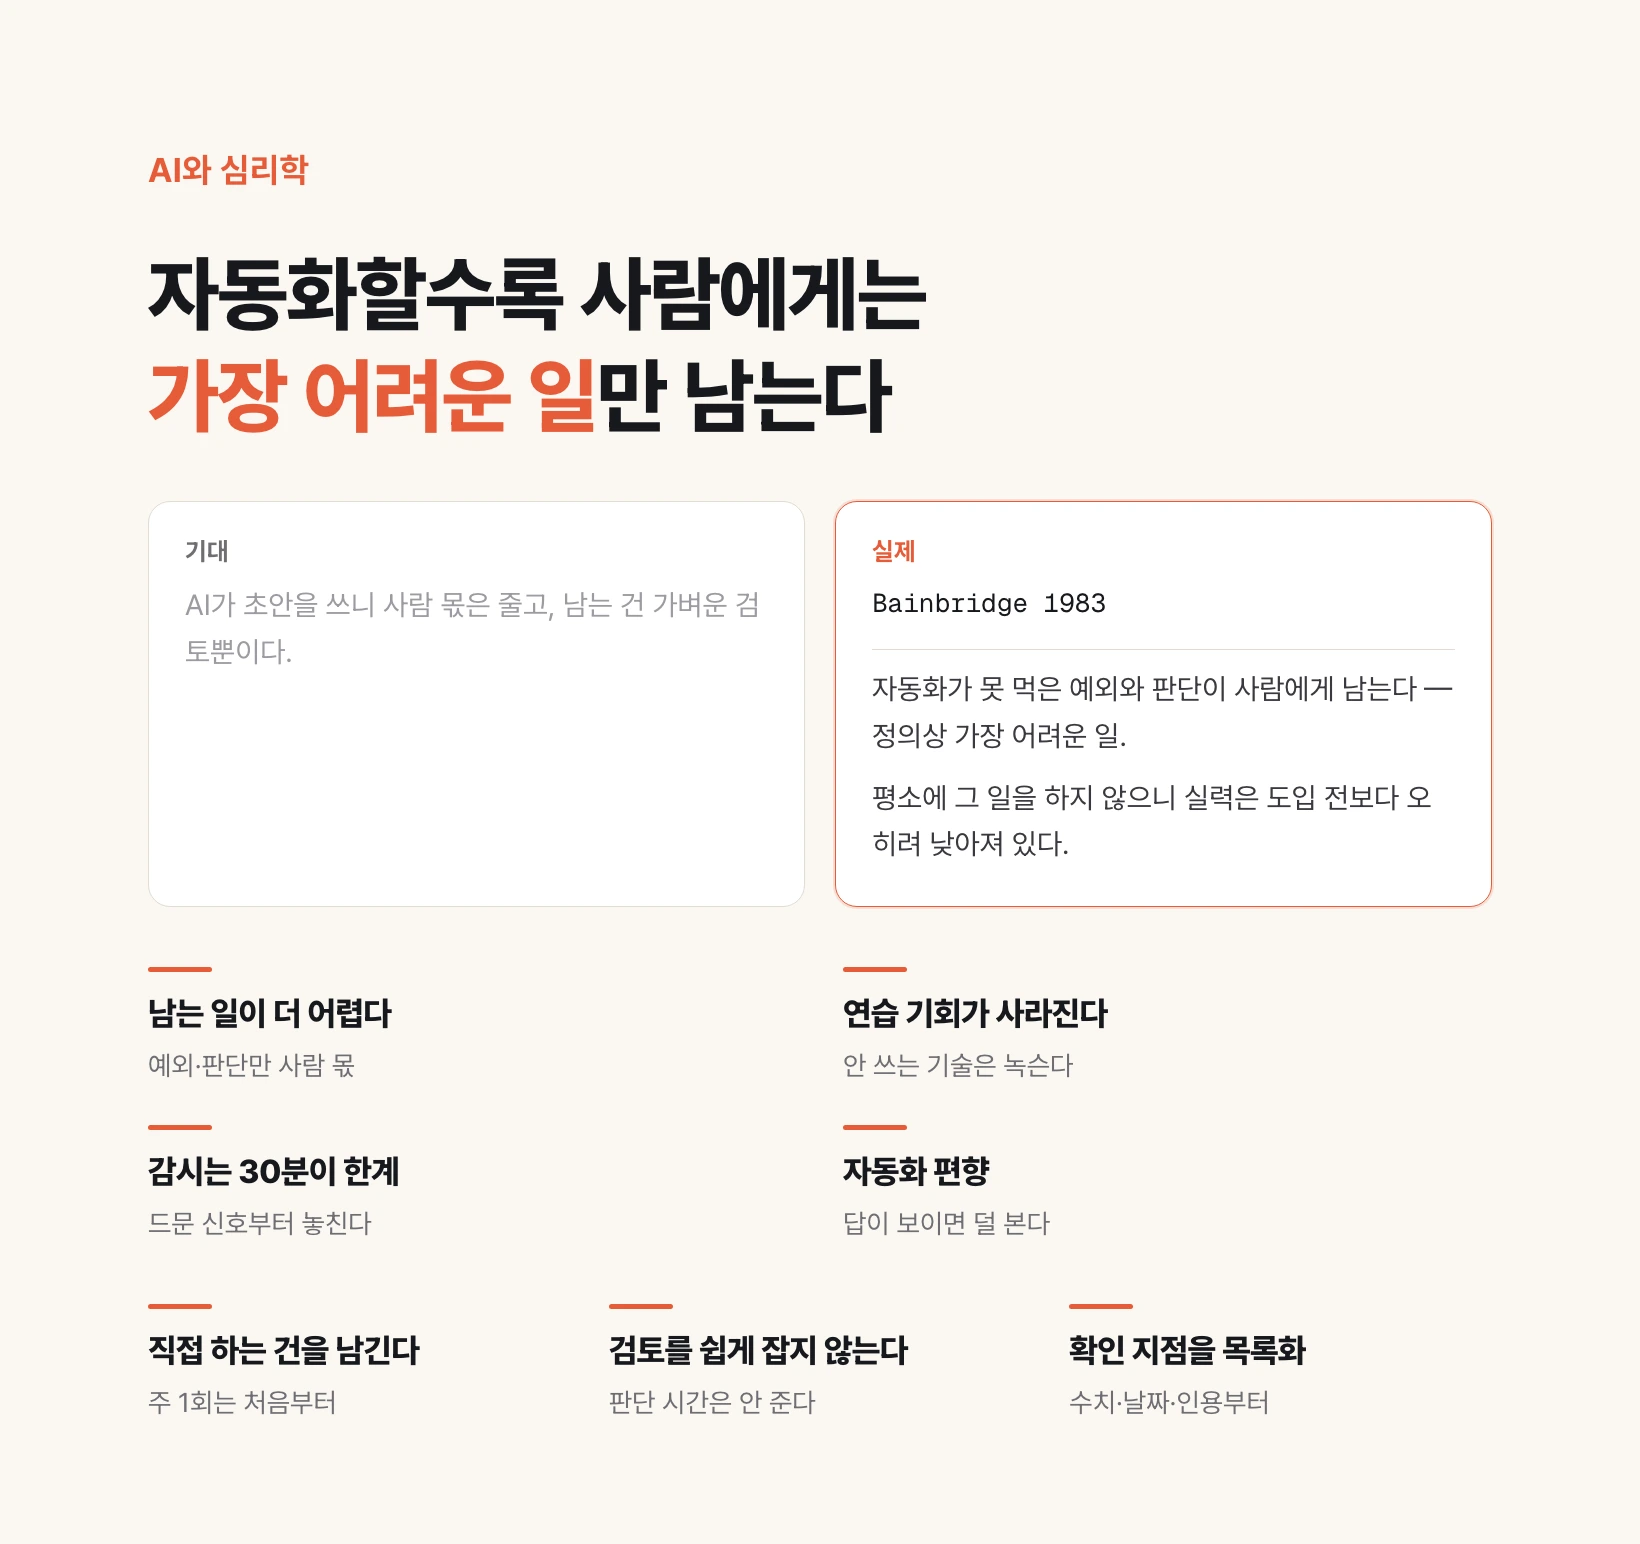
자동화의 아이러니 — 자동화할수록 사람 몫은 어려워진다
AI에 일을 넘길 때 사람들은 남는 일이 줄어들 거라 기대한다. 1983년에 나온 다섯 쪽짜리 논문이 그 기대의 반대를 지적했다. 자동화되지 않는 일이 사람 몫으로 남는데 그건 정의상 가장 어려운 일이고, 평소에 할 일이 없으니 그 어려운 일을 연습할 기회마저 사라진다. 훈련이 덜 필요해지는 게 아니라 더 필요해진다.
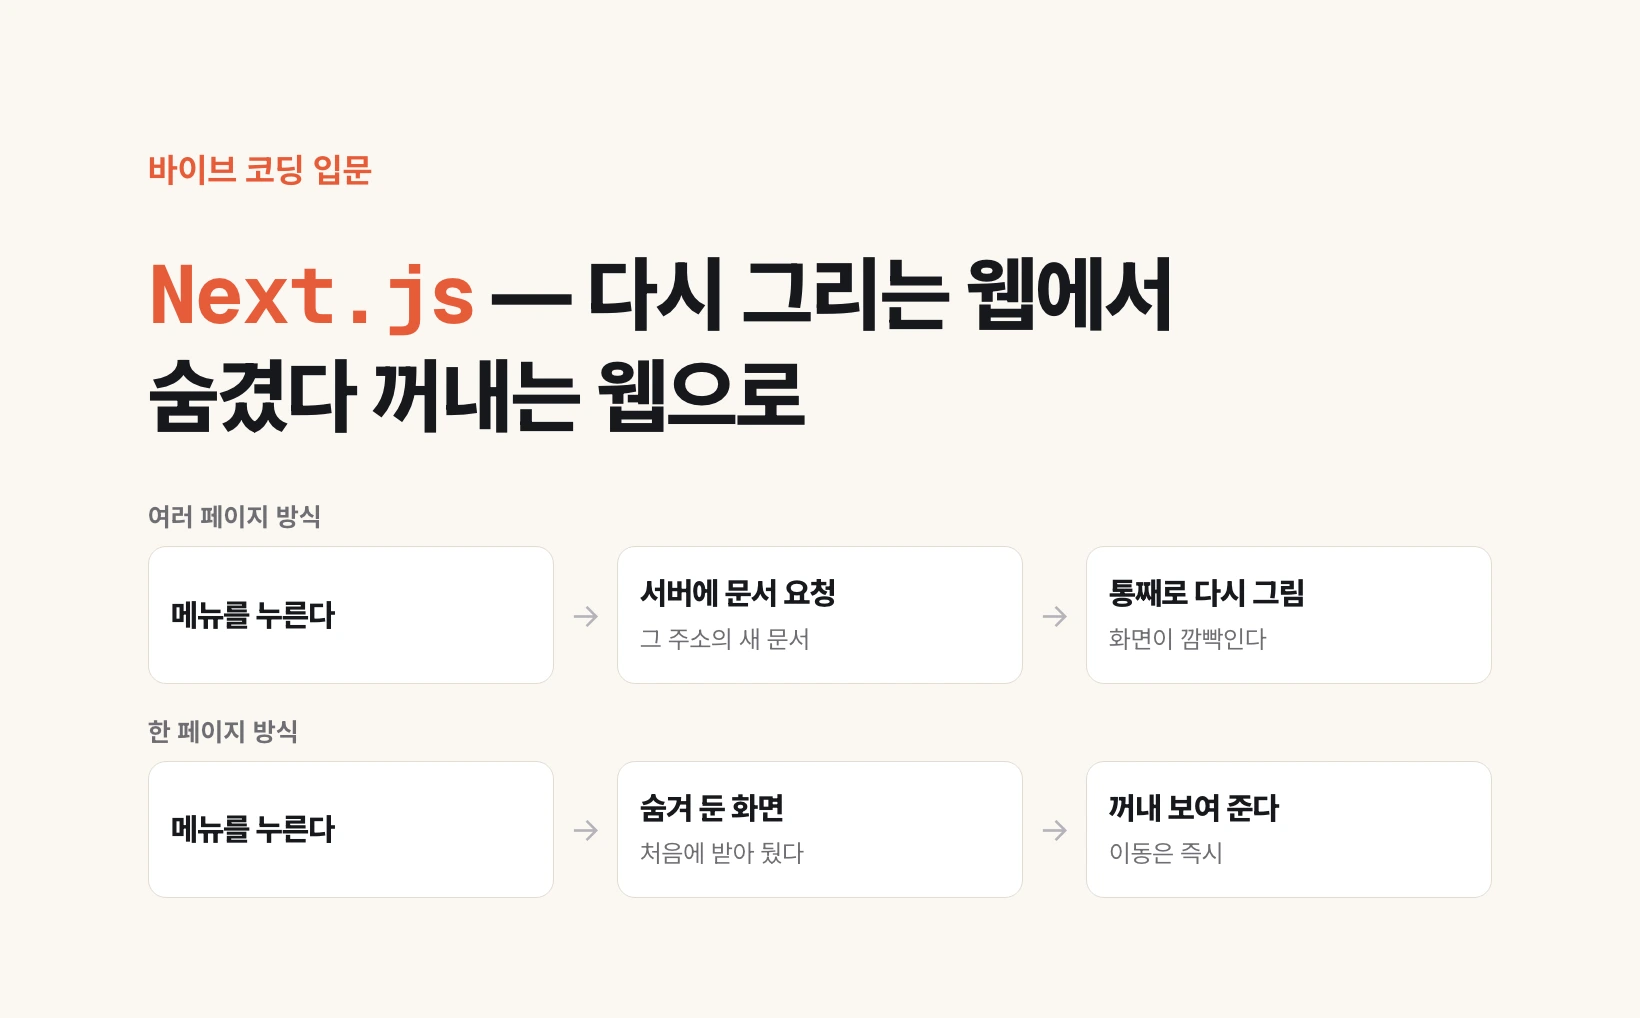
Next.js란 무엇인가 — 화면을 누가 언제 그리는가
옛날 웹은 페이지를 옮길 때마다 서버에 새 문서를 달라고 해 통째로 다시 그렸고 그래서 화면이 깜빡였다. 모바일 앱이 눈높이를 올리자 웹도 처음에 받아 두고 이동은 즉시 하는 한 페이지 방식으로 옮겨 갔는데, 화면을 브라우저에서 그리면 검색 엔진이 빈 페이지를 볼 위험이 생겼다. 그래서 서버에서 먼저 그려 보내는 방식이 함께 쓰이고, 둘을 한 프로젝트에서 골라 쓰게 해 주는 것이 Next.js다.
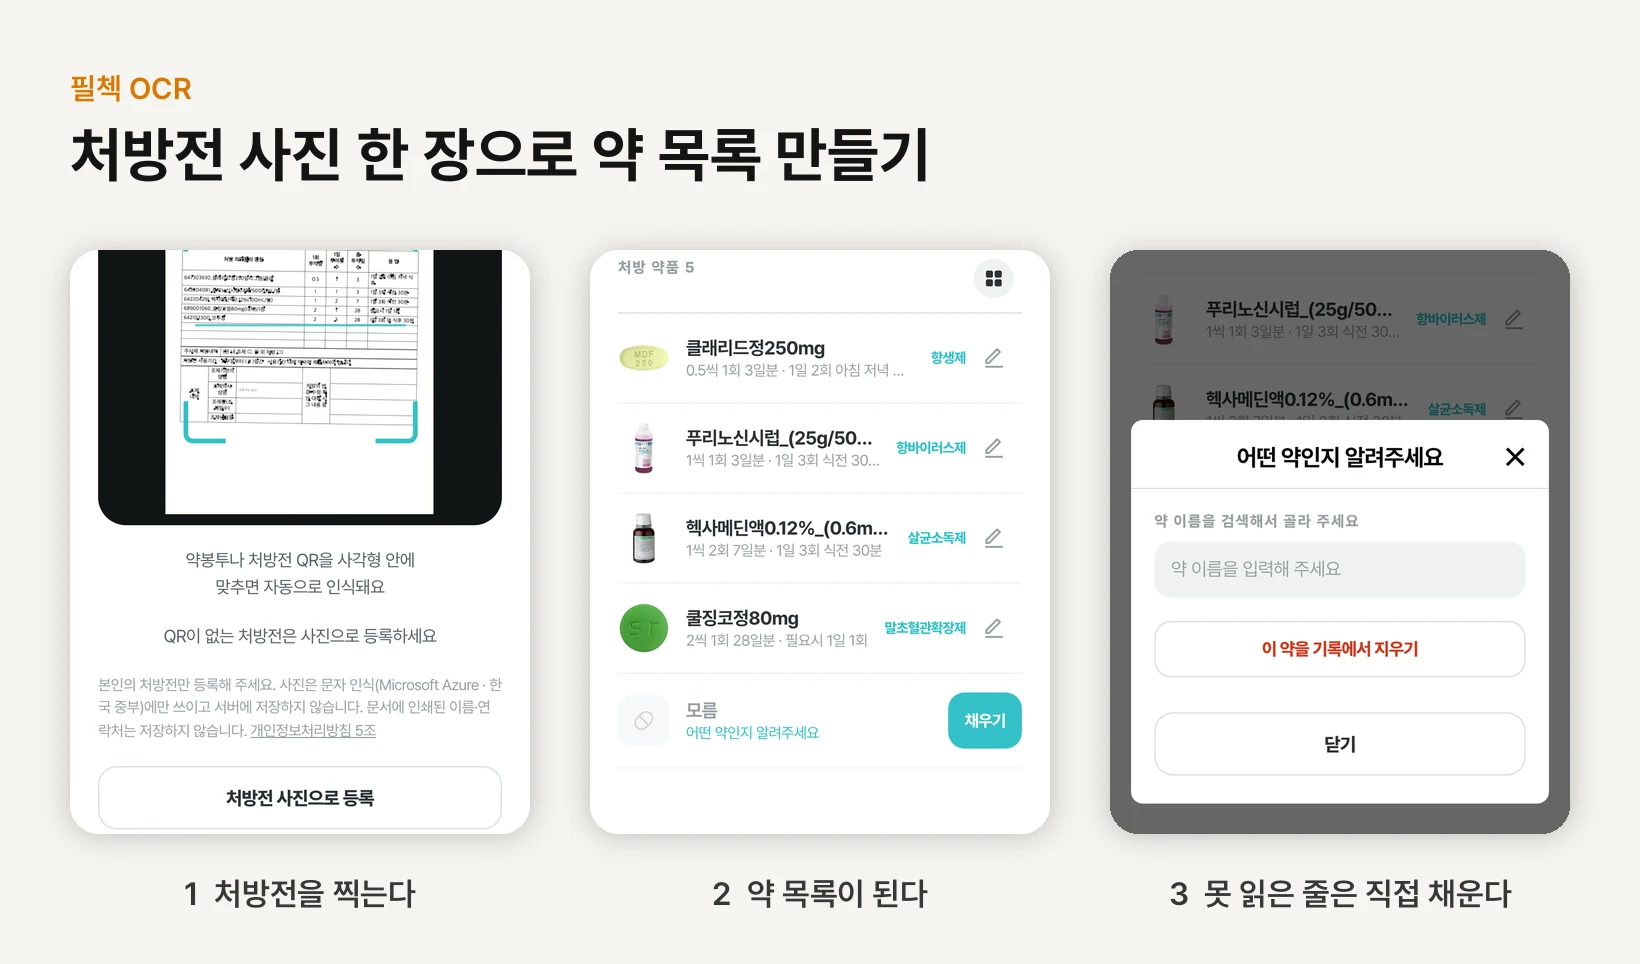
필첵 OCR — 처방전 사진 한 장으로 약 목록 만들기
필첵 OCR은 QR이 없는 처방전이나 다른 약국에서 받은 약봉투를 사진으로 찍어 약 목록으로 바꾸는 필첵(PillCheck)의 등록 기능입니다. www.pillcheck.co.kr에 로그인한 뒤 화면 아래 「스캔」 메뉴의 처방전·약봉투 탭에서 씁니다. 문자 인식 AI가 사진 속 글자와 표를 읽고, 읽어 낸 약은 약품 데이터와 맞춰 알약 사진·약효 분류·복용법까지 함께 보여 줍니다. 처방전 사진은 문자 인식에만 쓰이고 서버에 저장하지 않습니다. 읽지 못한 줄은 지우거나 비슷한 약으로 채우지 않고 「모름」으로 남겨, 사용자가 직접 검색해 채우게 했습니다.
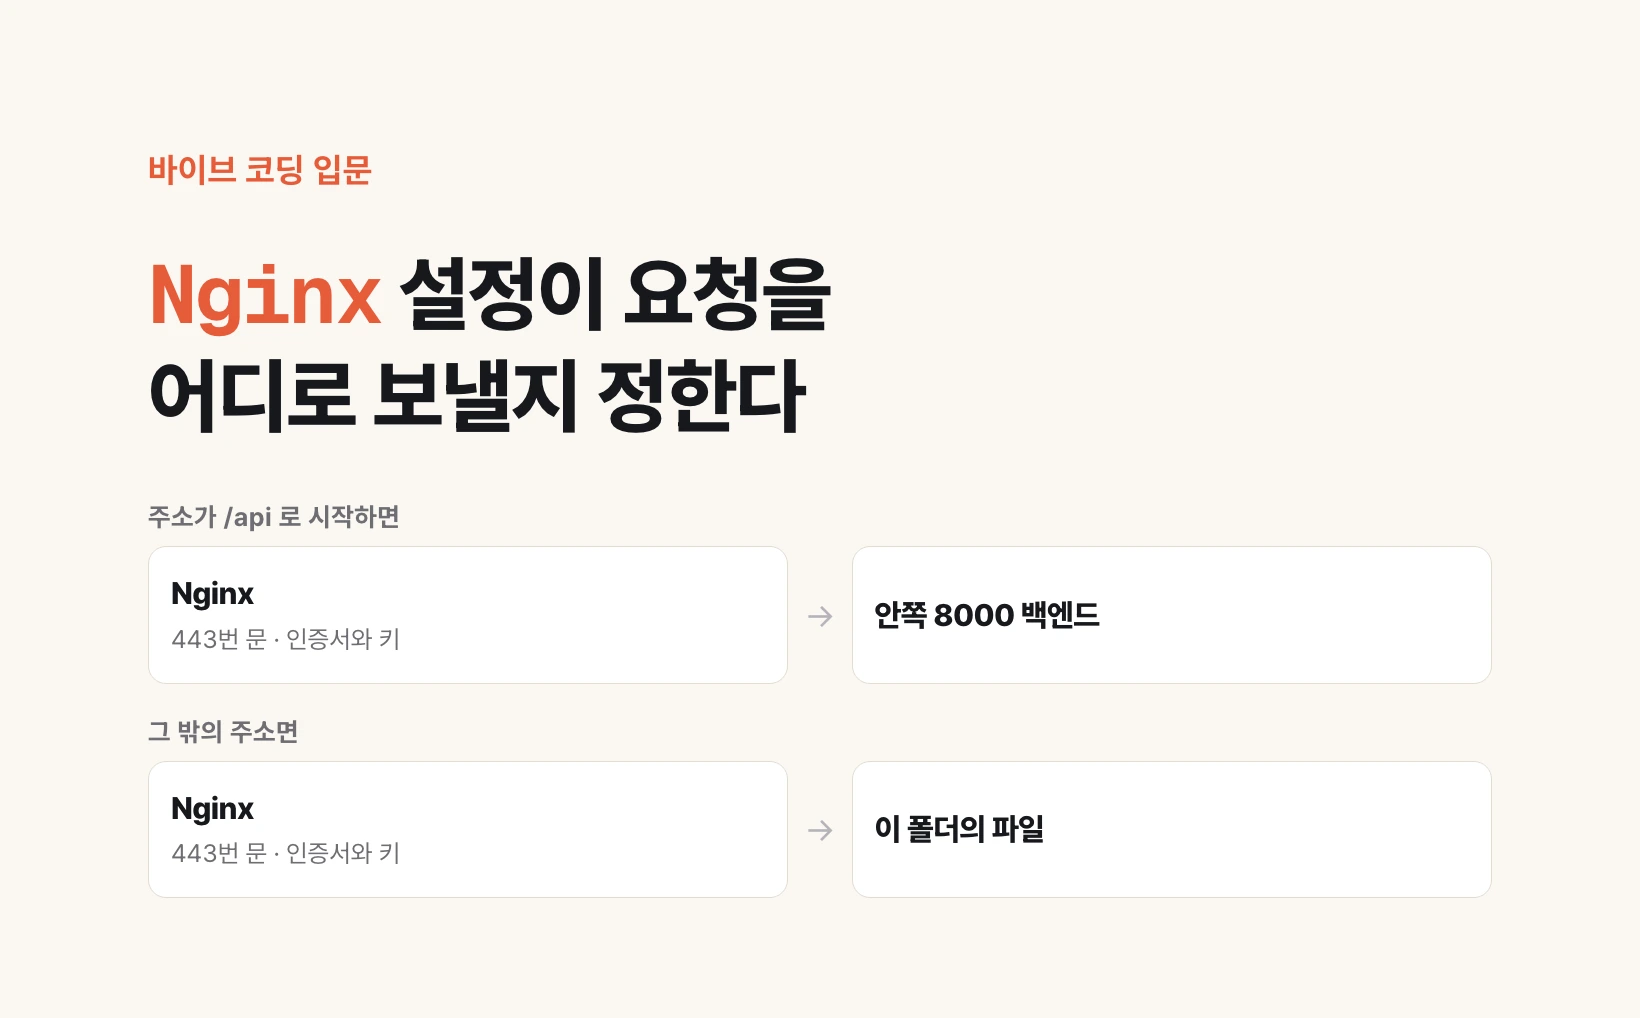
웹서버와 HTTPS란 무엇인가 — Nginx가 하는 일
요청이 서버에 도착해도 서버는 아직 무엇을 줘야 할지 모른다. 어느 포트로 온 요청에는 이 폴더의 파일을 주고 어떤 주소는 안쪽 프로그램에 넘기라는 규칙을 적어 두는 것이 웹서버이고, 가장 널리 쓰이는 것이 Nginx다. HTTPS도 여기서 걸린다. 암호화에 쓰는 인증서와 키를 어디서 읽어 어떤 연결에 적용할지가 이 설정에 적히고, 주소창의 자물쇠는 그 설정이 제대로 걸렸다는 표시다.
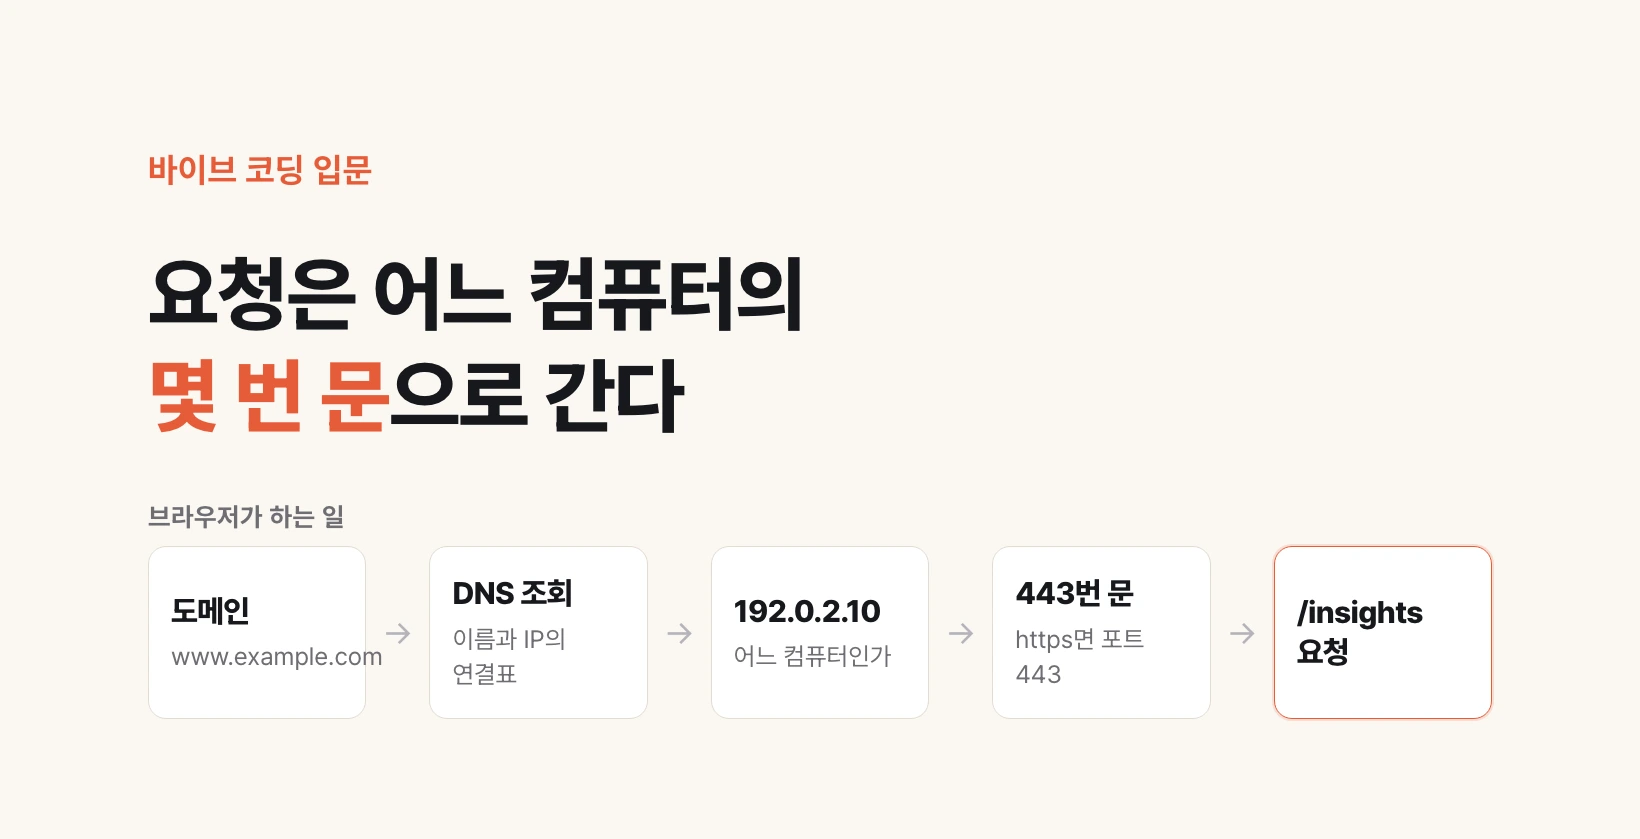
도메인·DNS·포트란 무엇인가 — 요청이 서버를 찾아가는 법
인터넷에 연결된 컴퓨터마다 IP 주소가 있고, 컴퓨터 한 대가 여러 일을 하므로 문이 여러 개 있는데 그 문 번호가 포트다. 즉 요청은 어느 컴퓨터의 몇 번 문으로 간다. 사람이 숫자를 외울 수 없으니 이름을 붙인 것이 도메인이고, 이름과 IP를 잇는 연결표가 DNS다. 배포 후 화면이 안 뜨면 도메인이 IP를 제대로 가리키는지, 서버가 살아 있는지, 포트가 열렸는지 셋만 보면 된다.
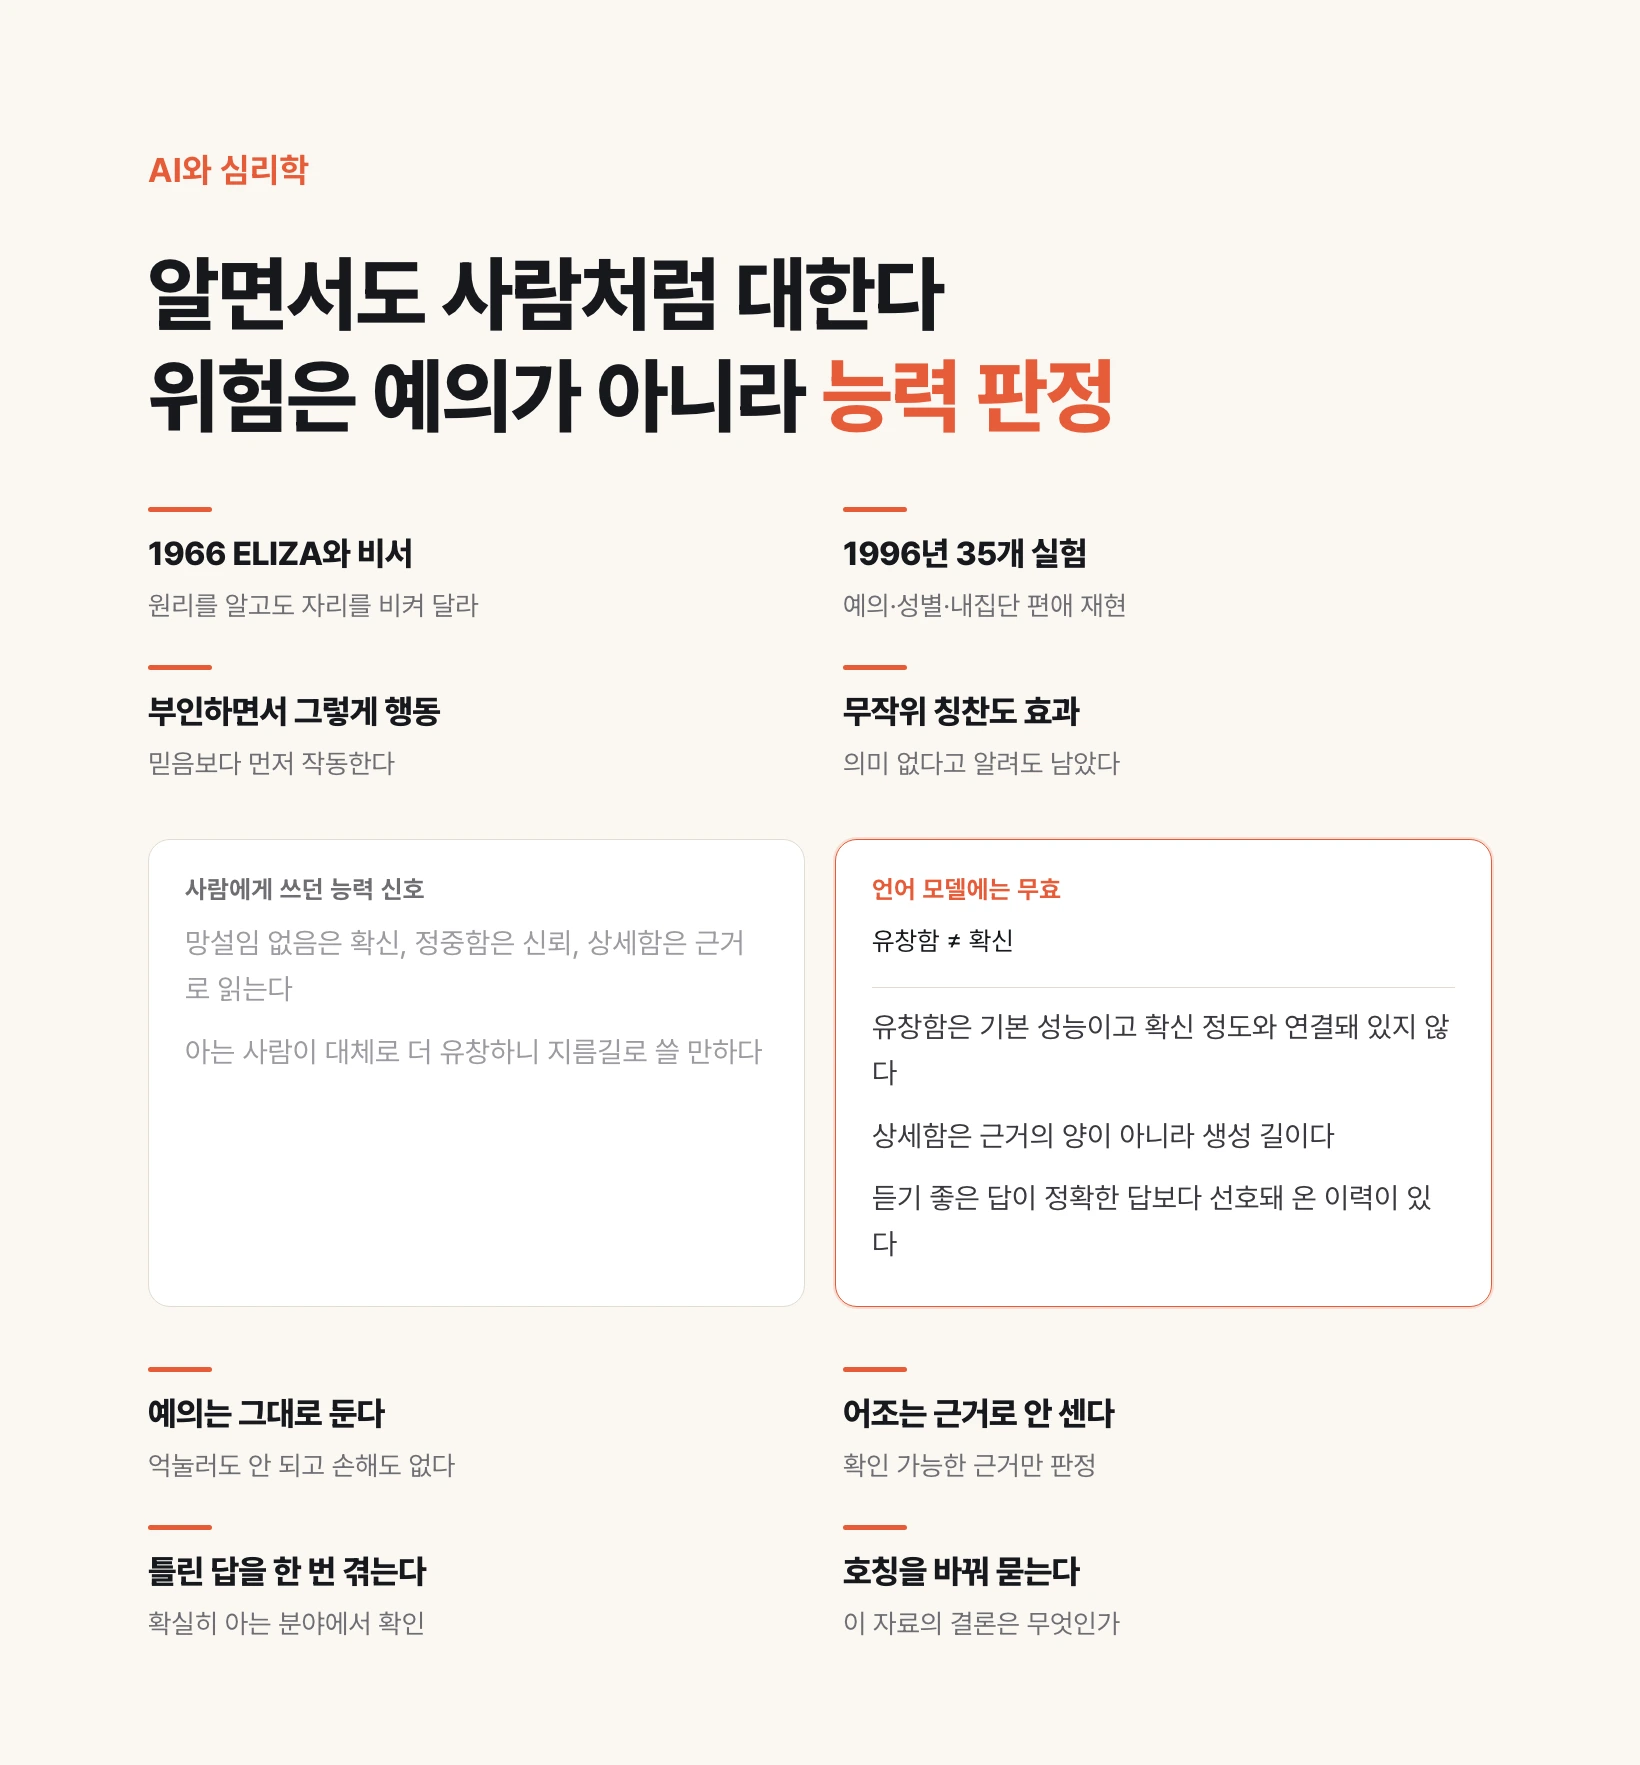
ELIZA 효과 — 사람은 아니라고 말하면서 컴퓨터를 사람으로 대한다
1966년, 몇 줄짜리 규칙으로 만든 프로그램 앞에서 개발자의 비서가 자리를 비켜 달라고 요청했다. 그가 프로그램의 원리를 알고 있었는데도 그랬다. 30년 뒤 35개의 실험이 같은 결론을 냈다. 사람은 컴퓨터를 사회적 상대로 대하고, 그럴 리 없다고 스스로 부인하면서도 그렇게 행동한다.
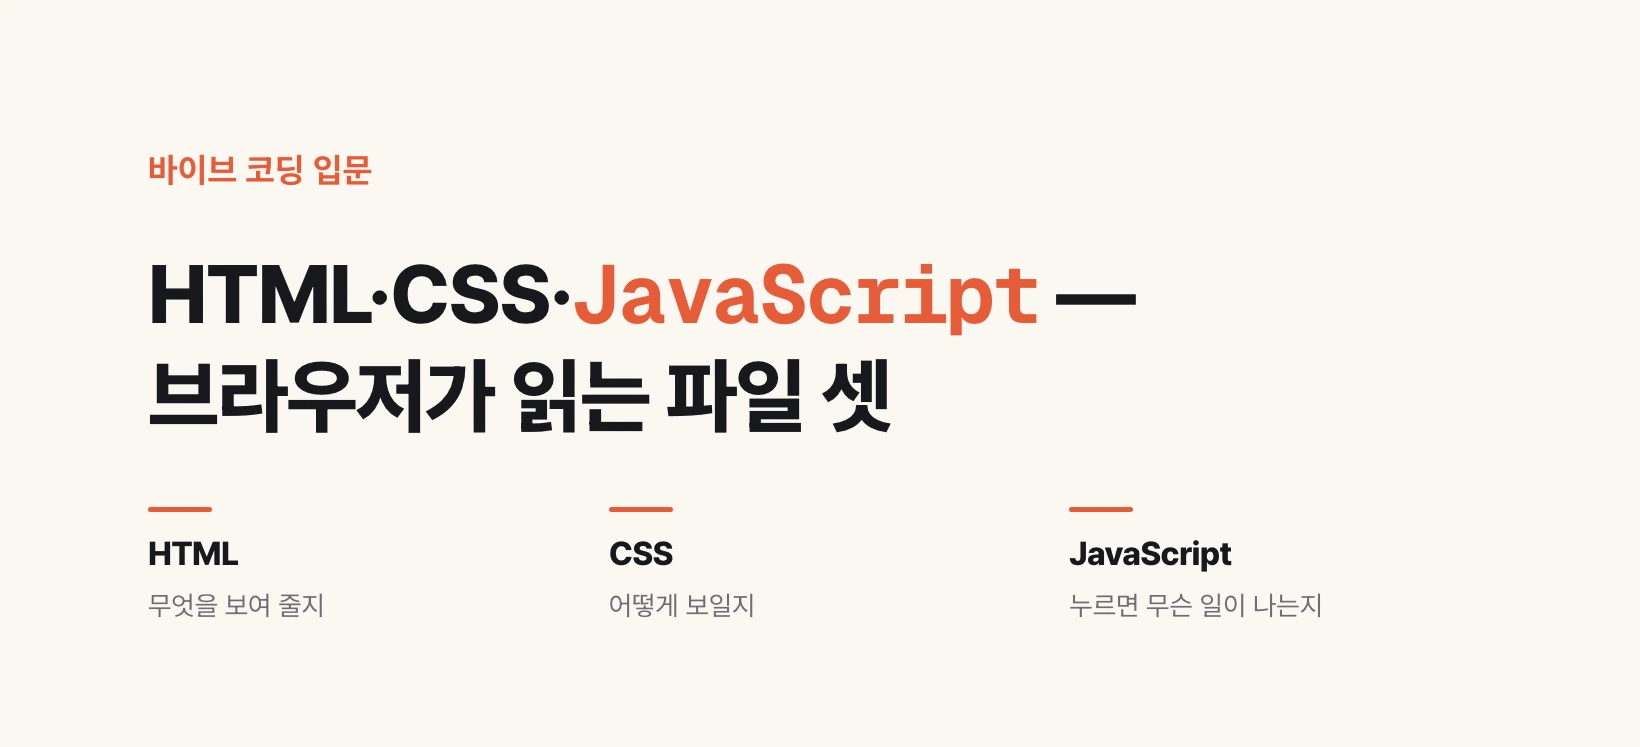
HTML·CSS·JavaScript란 무엇인가 — 브라우저가 읽는 파일 셋
브라우저가 서버에서 받아 화면을 그릴 때 읽는 파일은 셋이다. 무엇을 보여 줄지가 HTML, 어떻게 보일지가 CSS, 눌렀을 때 무슨 일이 일어나는지가 JavaScript다. CSS는 HTML이 스타일을 못 줘서 생긴 것이 아니라 문서가 감당 못 하게 길어져서 떼어 낸 것이고, 스타일이 안 먹히는 원인은 대개 문법 오류가 아니라 더 좁게 특정한 규칙이 이미 이기고 있는 것이다. TypeScript는 JavaScript 위에 값의 형태를 못 박아 두는 규칙이다.
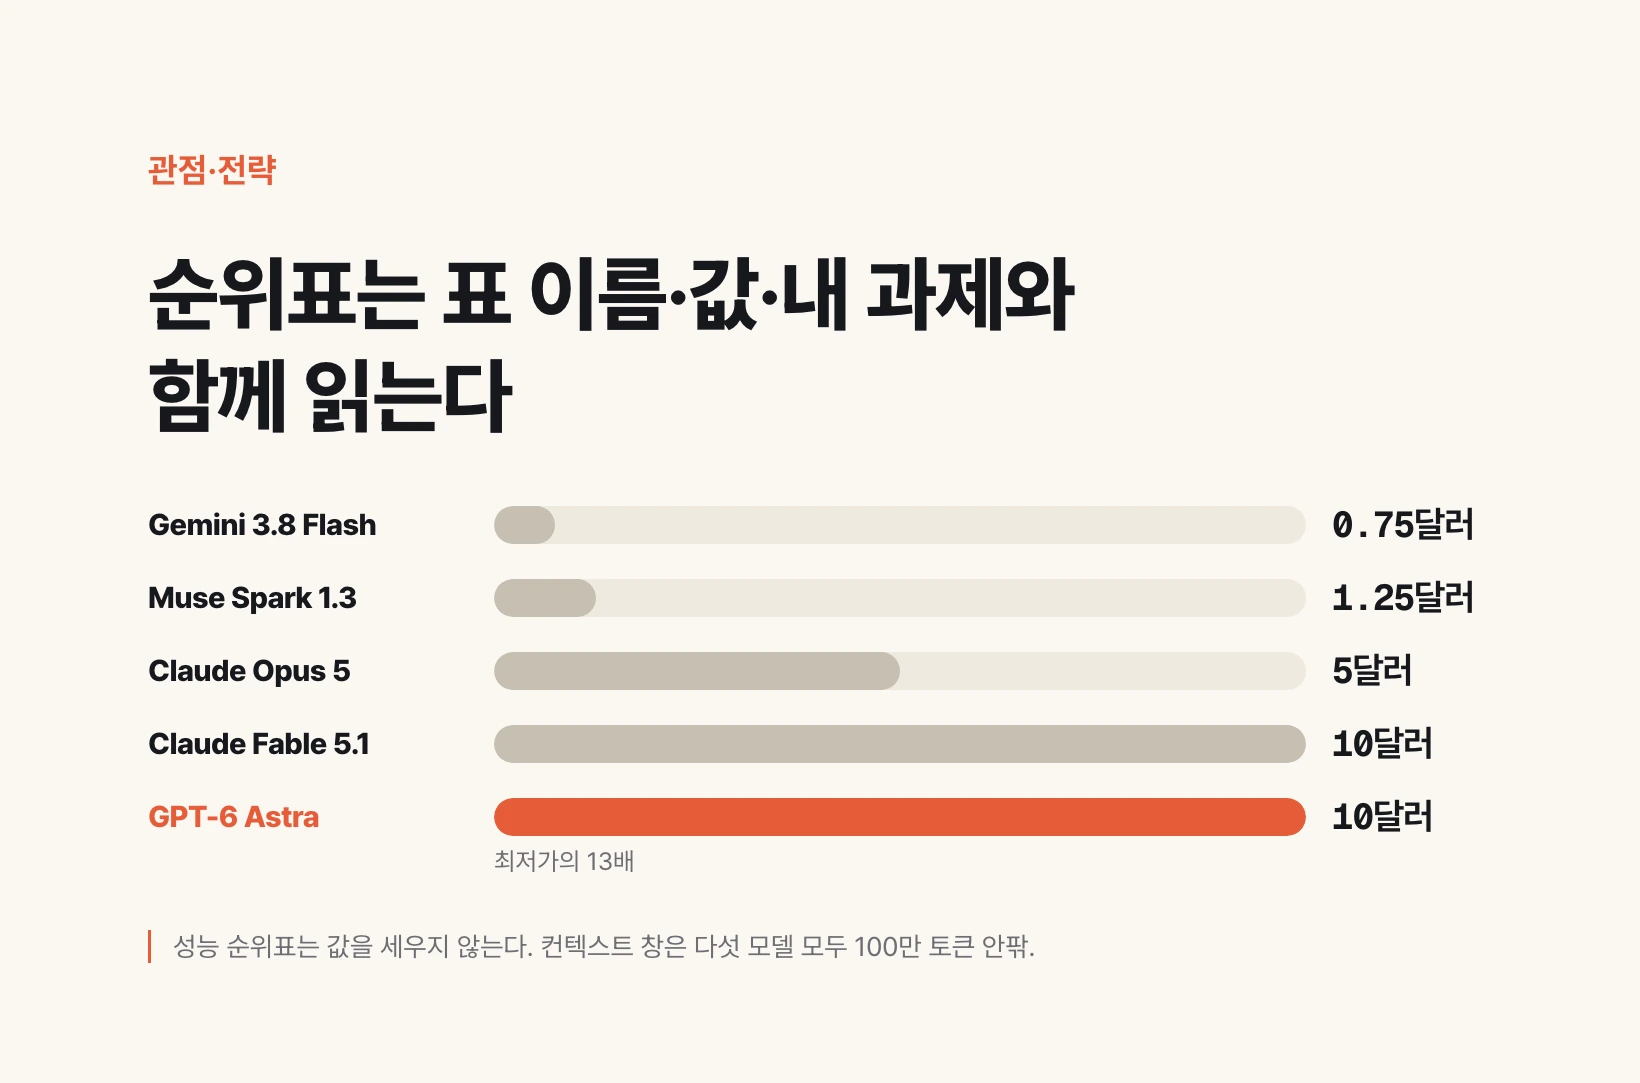
AI 모델 순위표는 왜 체감과 어긋나는가
순위표가 무엇을 재는 표인지, 그리고 값을 함께 보는지에 따라 1위가 바뀌기 때문이다. 2026년 9월 첫째 주에 최상위 모델 네 개가 한꺼번에 나왔는데 발표마다 자기에게 유리한 표를 골라 1위를 주장했고, 그 표들끼리 순위가 서로 어긋났다. 순위표를 버릴 필요는 없다. 다만 종합 점수 한 칸만 보지 말고 세 가지를 함께 봐야 한다. 어느 표인가, 값이 얼마인가, 내 업무 과제에서는 어떤가.
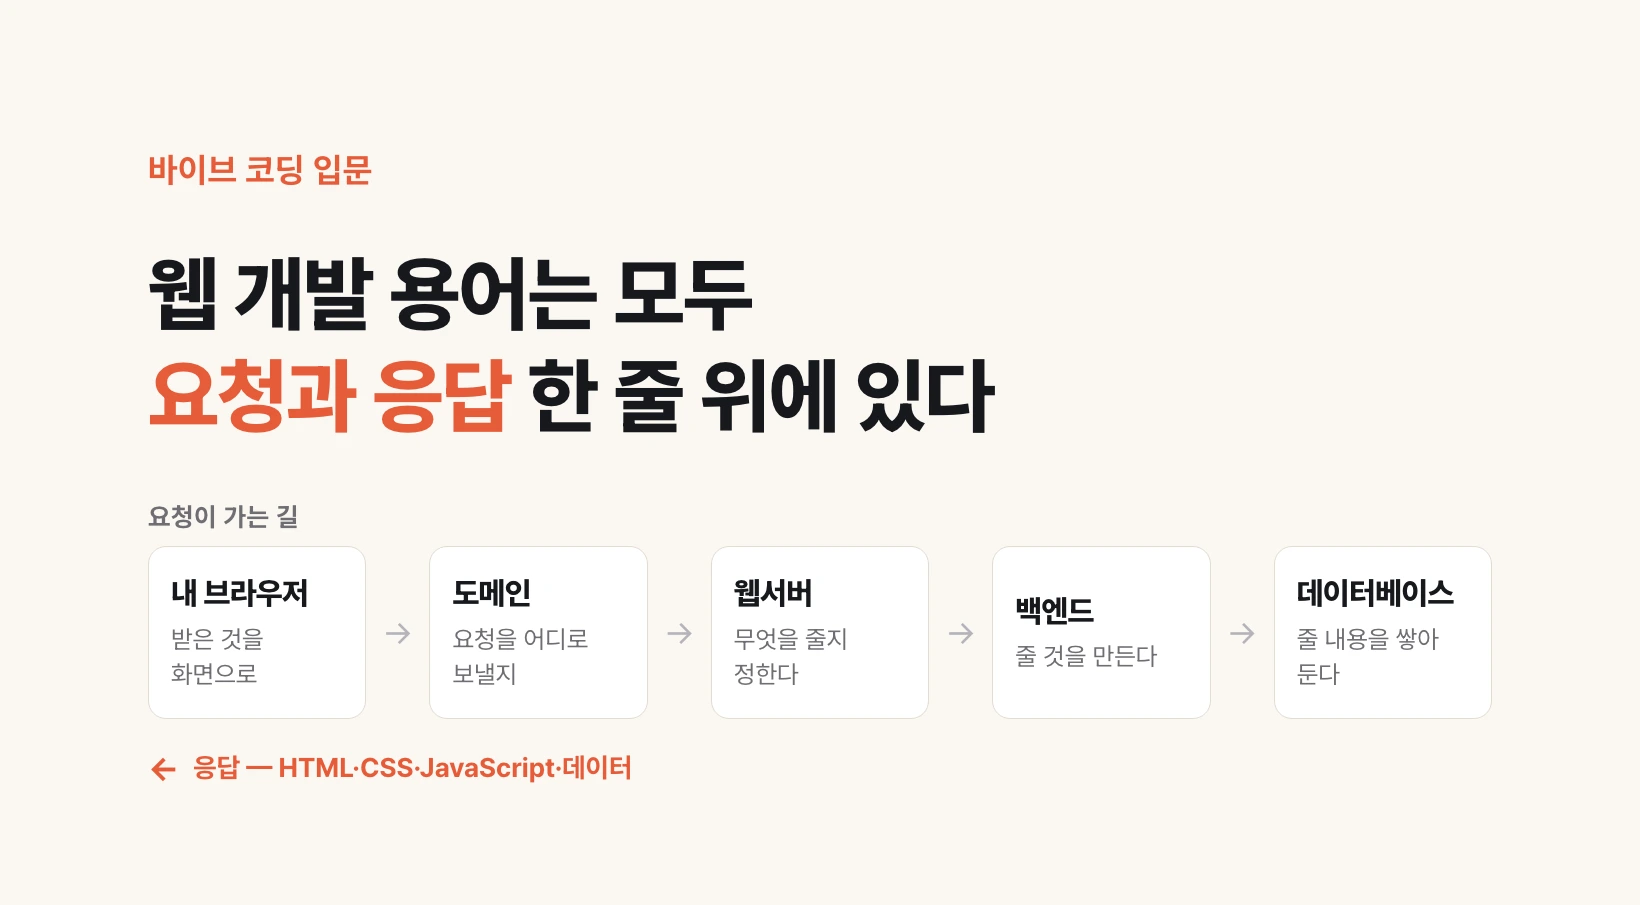
웹은 어떻게 도는가 — 요청과 응답 한 줄로 보는 전체 구조
웹사이트를 본다는 것은 24시간 켜 둔 남의 컴퓨터에 필요한 파일을 달라고 요청하고, 받은 파일을 브라우저가 화면으로 그리는 일이다. 웹 개발에서 배우는 것들은 전부 이 요청과 응답 한 줄 위의 서로 다른 자리에 있다. 요청을 어디로 보낼지가 도메인, 무엇을 줄지 정하는 것이 웹서버, 줄 것을 만드는 것이 백엔드, 받은 것을 그리는 것이 프론트엔드, 줄 내용을 쌓아 두는 곳이 데이터베이스와 스토리지다.
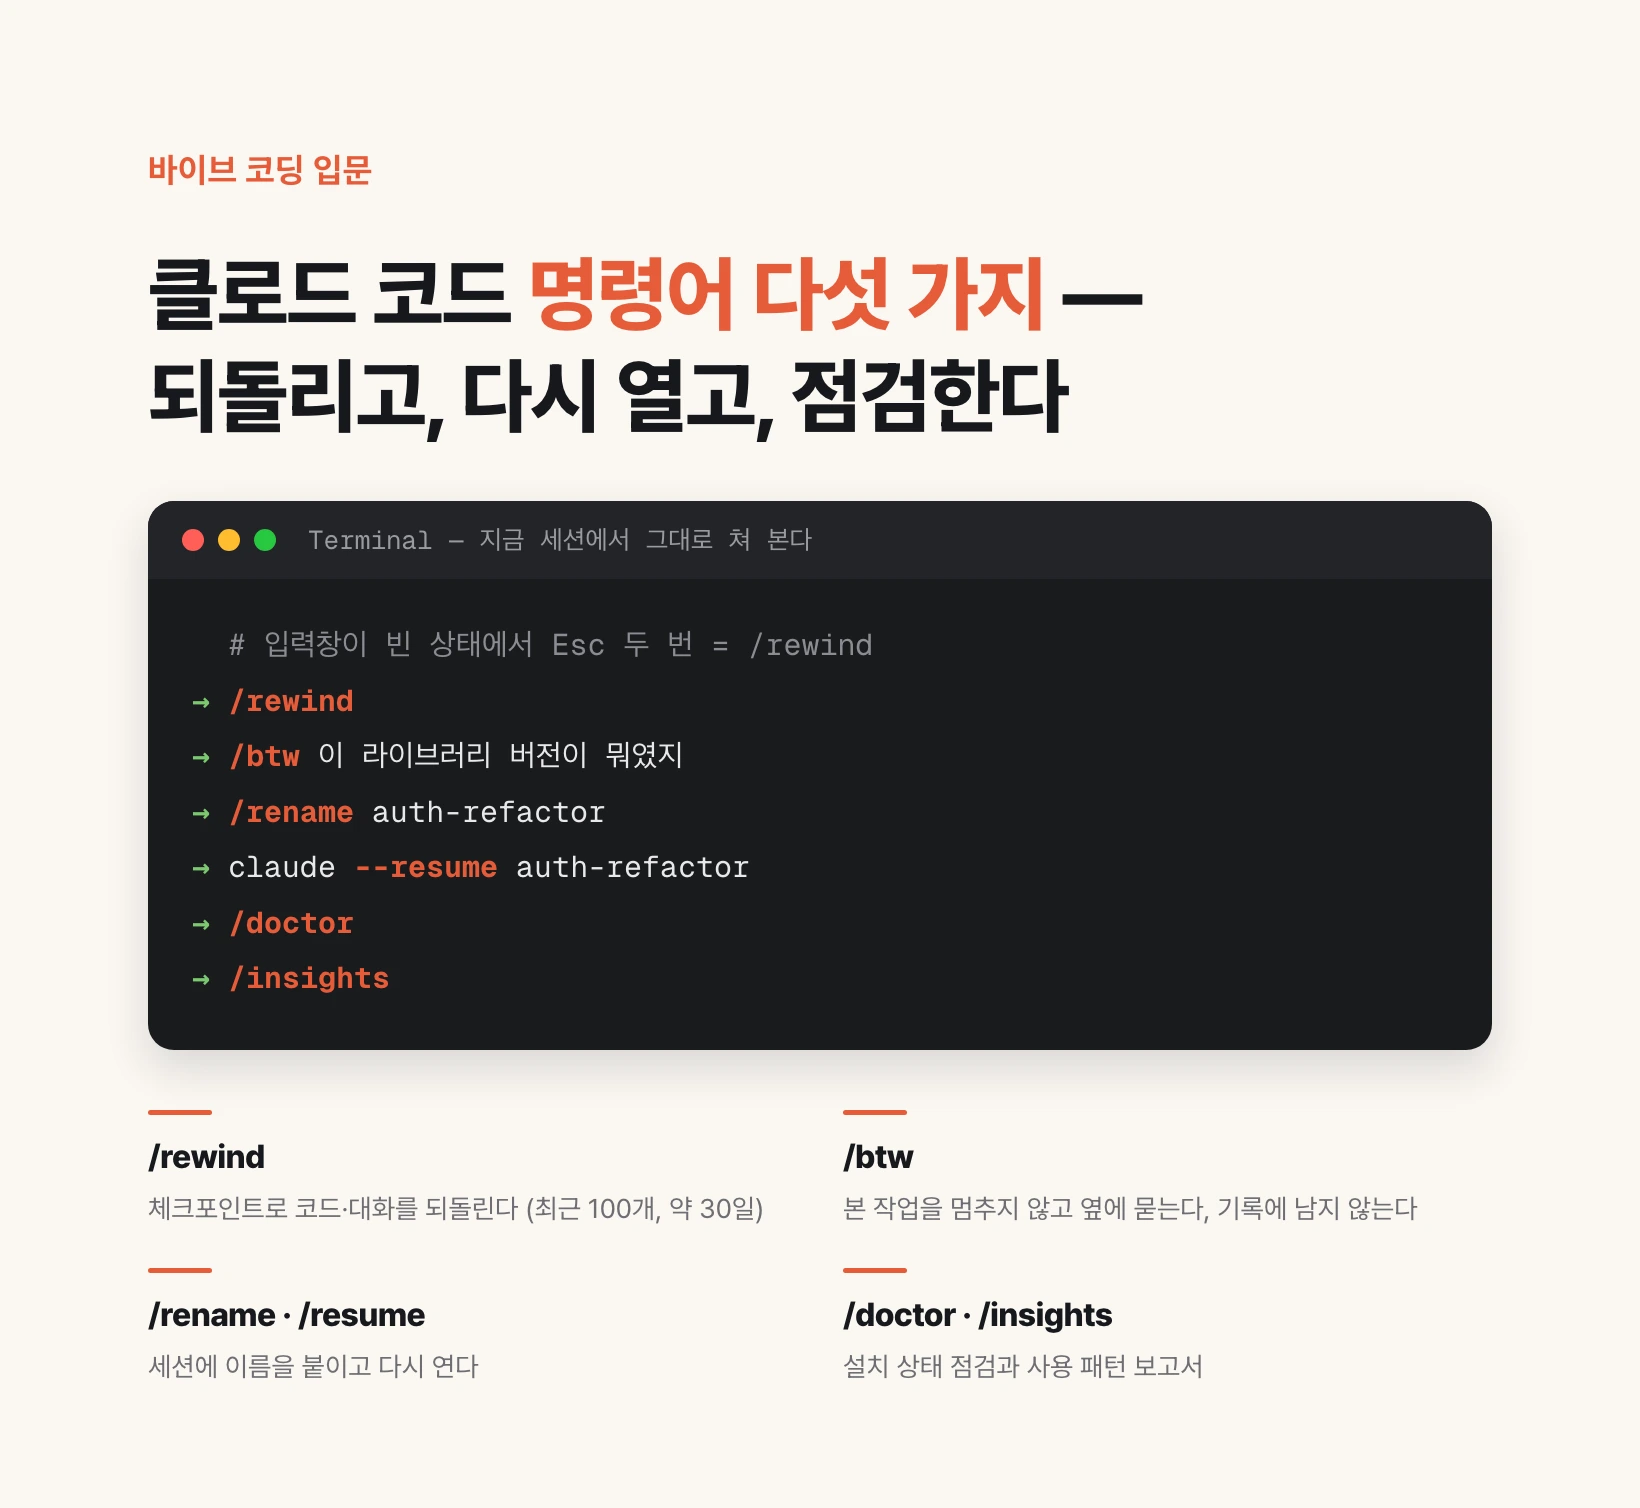
/rewind · /btw · /rename · /resume · /insights · /doctor — 클로드 코드 명령어 다섯 가지
클로드 코드에는 슬래시 명령어가 100개가 넘지만 몇 개만 알아도 작업 방식이 바뀐다. 망친 작업은 Esc 두 번(/rewind)으로 체크포인트까지 되돌리고, 작업 중 딴 질문은 /btw로 옆에 빼서 묻고, 세션은 /rename으로 이름 붙여 /resume으로 다시 연다. 한 달에 한 번 /insights로 내 사용 패턴을 보고 /doctor로 설치 상태를 점검한다. 각각이 무엇이고 어떻게 치며 어디서 걸리는지를 공식 문서 기준으로 정리했다.
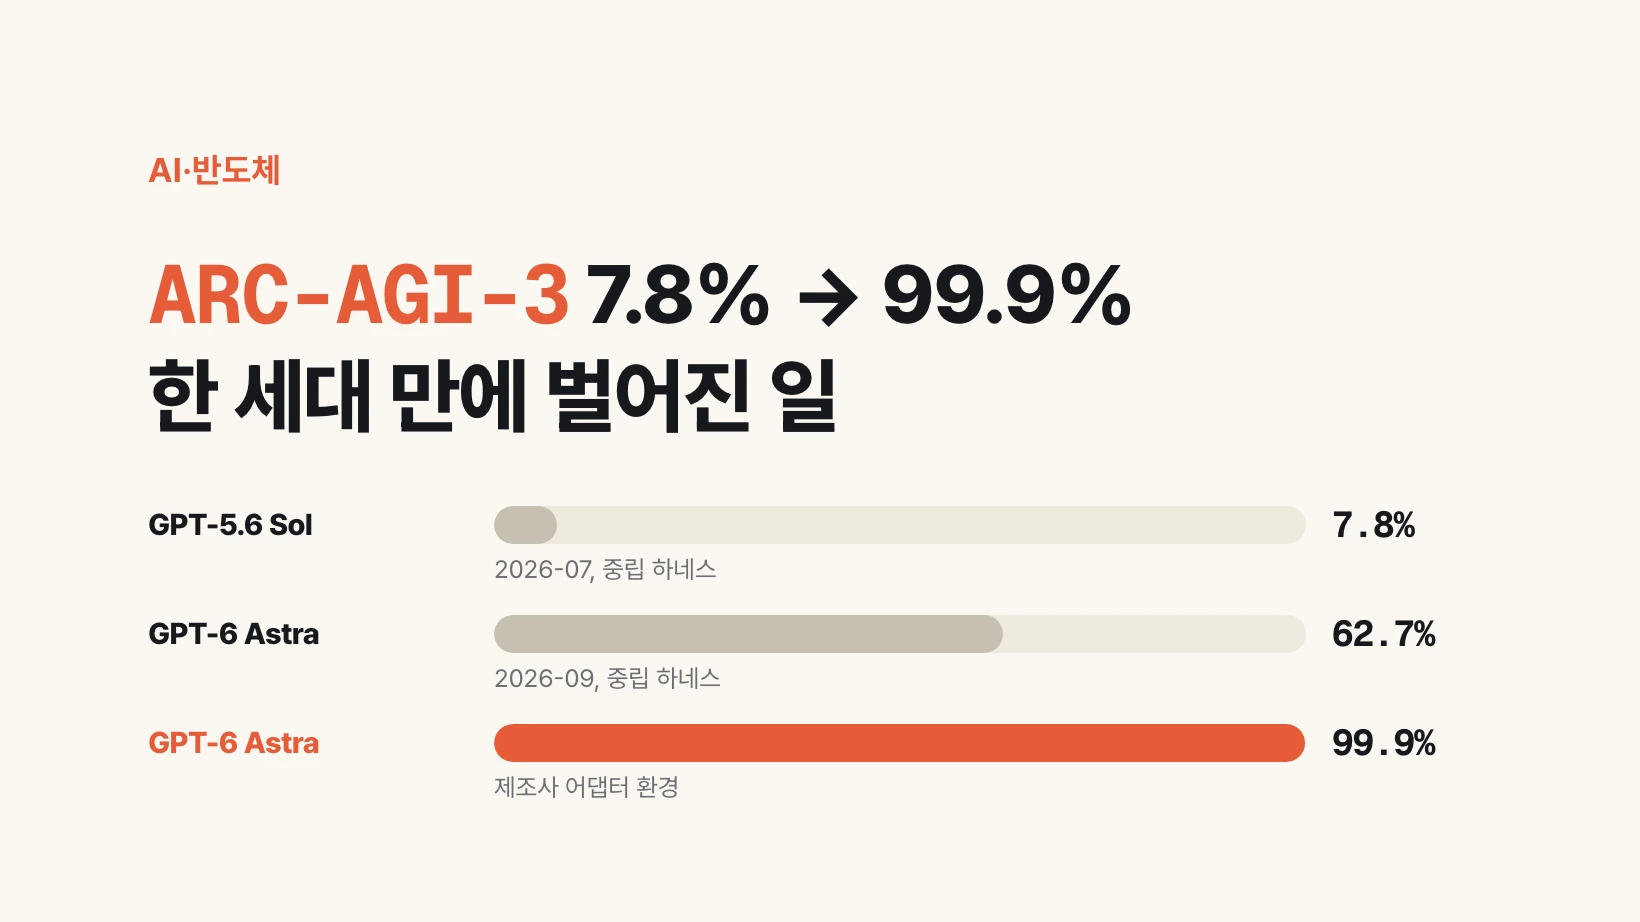
GPT-6 Astra의 ARC-AGI-3 99.9%는 무엇을 뜻하는가
ARC-AGI-3는 지식을 묻는 시험이 아니라 설명서 없이 처음 보는 환경에 던져 놓고 규칙과 목표를 스스로 알아내게 하는 시험이다. 두 달 전 GPT-5.6 Sol이 7.8%로 이 시험의 한 게임을 처음 깼고, 2026년 9월 3일 GPT-6 Astra가 99.9%를 받았다. 제조사 어댑터를 뺀 중립 하네스에서도 62.7%다. 답을 잘하는 AI에서 낯선 상황을 스스로 정의하고 행동하는 AI로 능력의 종류가 바뀌었다는 뜻이고, 그 능력이 실제로 쓰이면 토큰 소비가 자릿수로 커지기 때문에 HBM과 D램 수요 이야기로 곧장 이어진다.
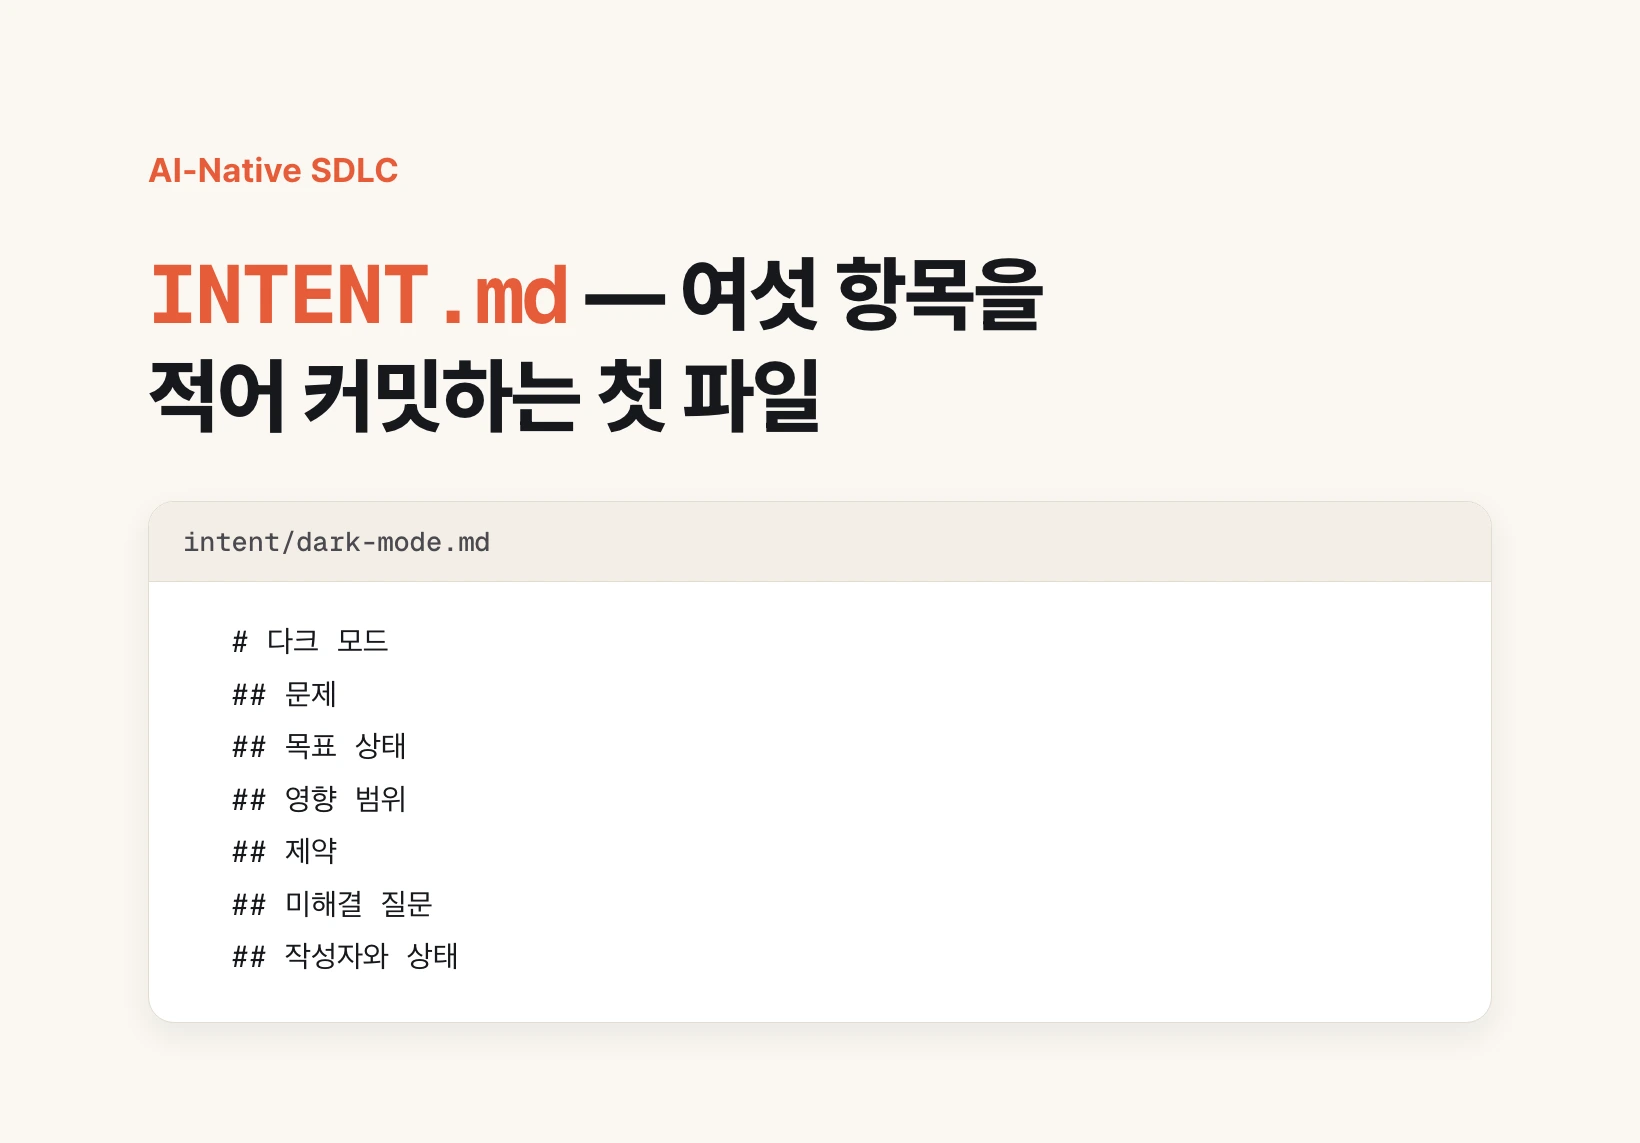
INTENT.md란 무엇인가 — AI-Native SDLC의 첫 파일
INTENT.md는 무엇을 왜 어떤 제약 아래 만들려는지를 아이디어를 낸 사람의 말로 적어 저장소에 커밋하는 파일이다. Anthropic이 2026년 8월 21일 공개한 AI-Native SDLC 플레이북의 첫 단계이고, 여기에 담긴 여섯 가지가 다음 단계인 spec.md의 재료가 된다. 회의를 잡고 문서 담당자를 기다리는 대신 겪은 사람이 에이전트와 대화해 그 자리에서 적고, 원작자가 다시 읽어 고친 뒤 커밋한다.
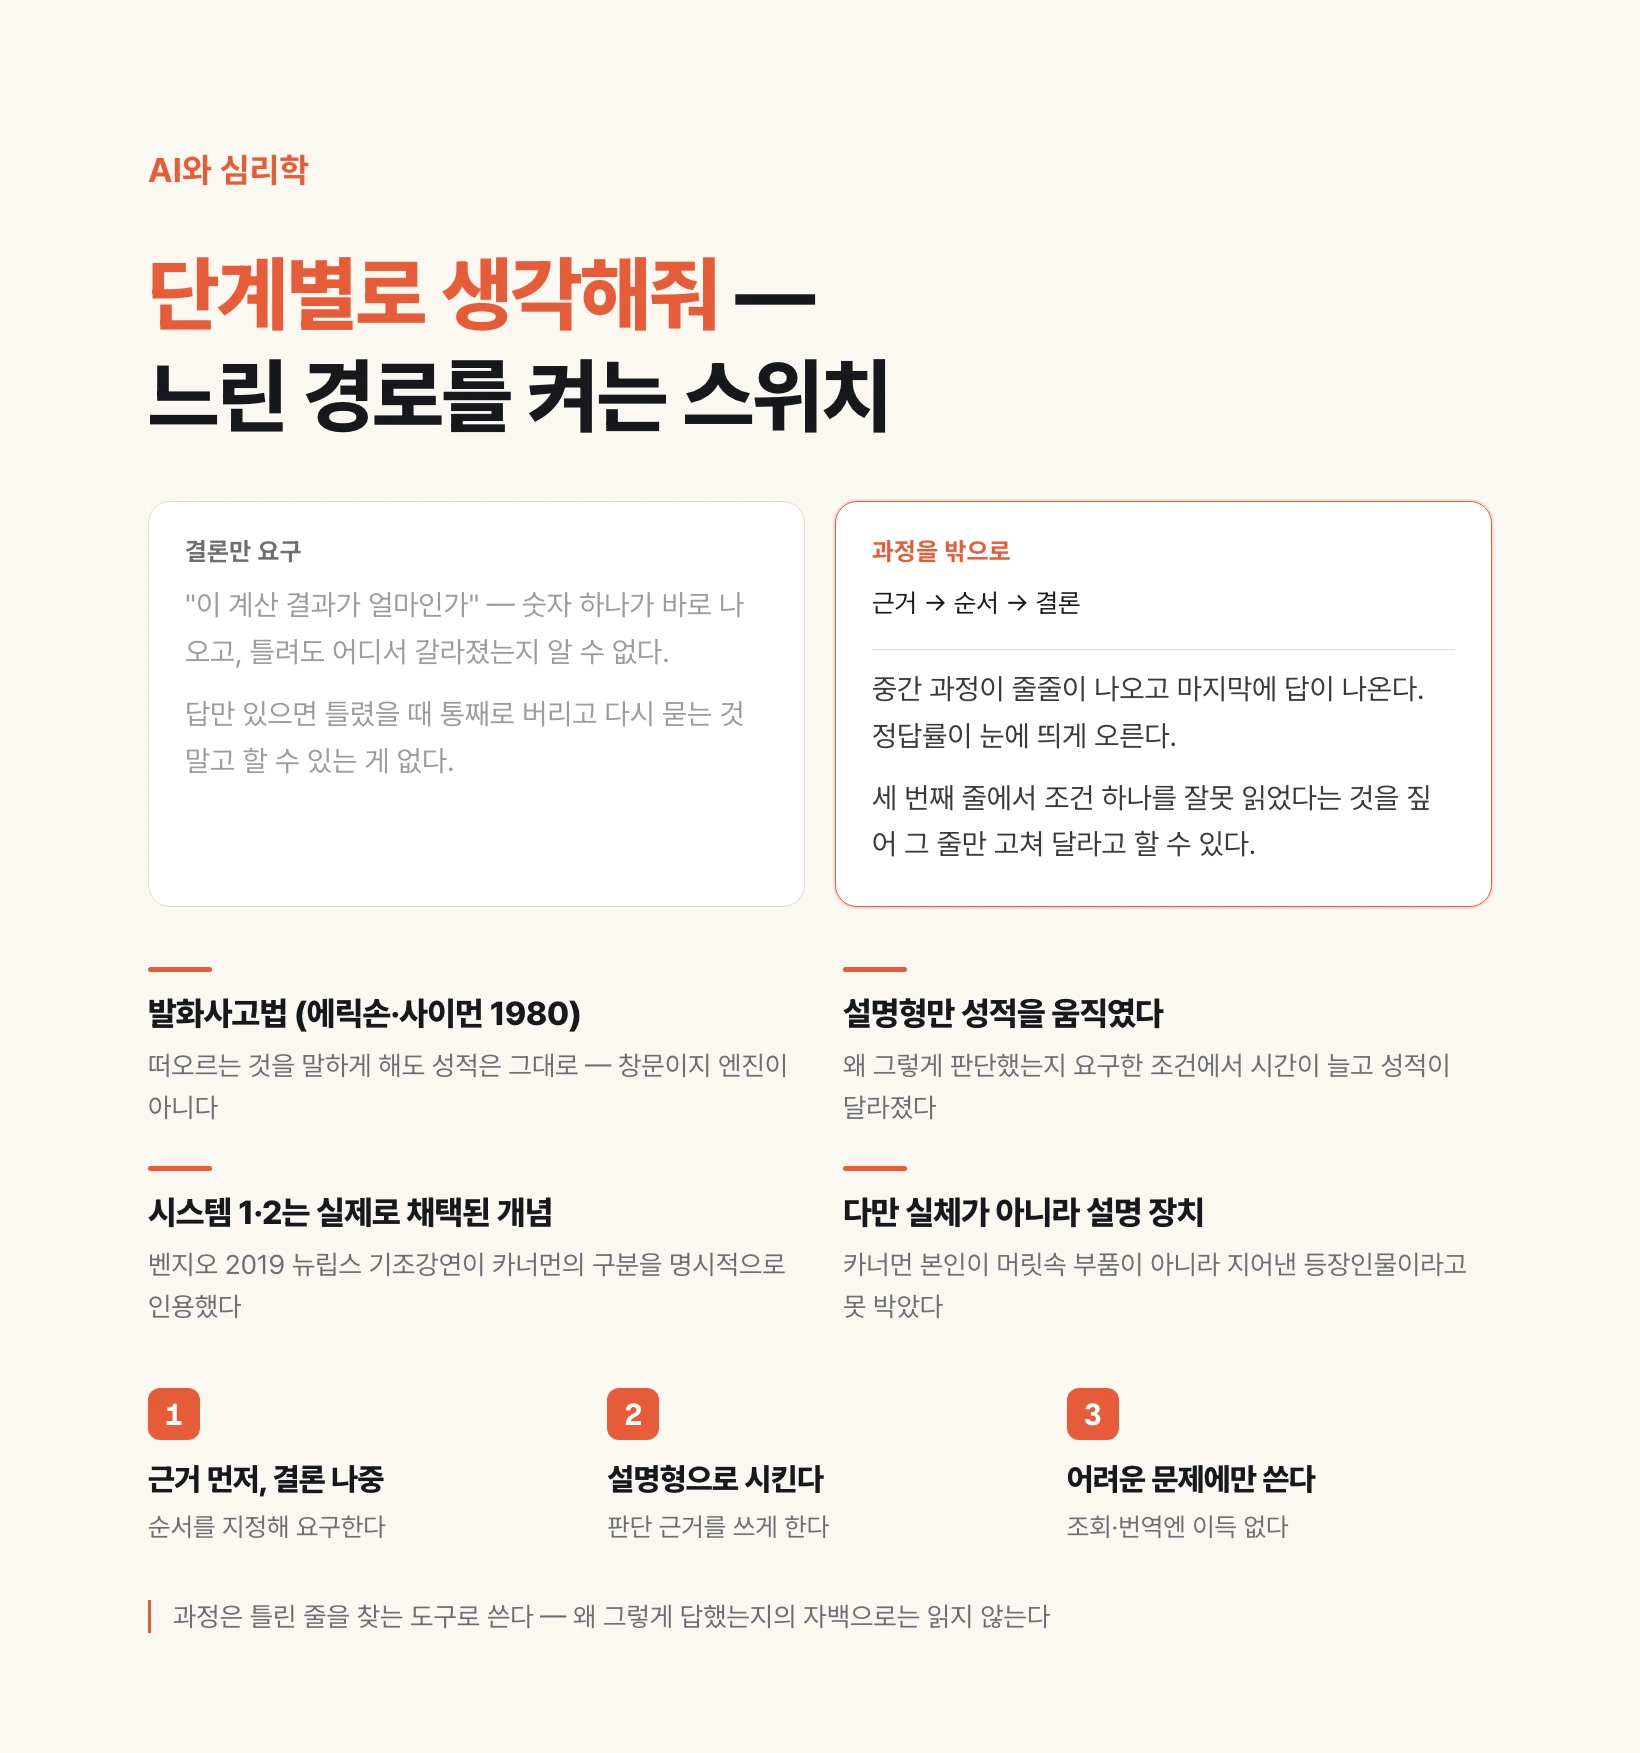
AI에게 소리 내어 생각하게 하라 — 단계별로 생각해줘의 정체
프롬프트에 한 줄을 더하면 답의 정확도가 오른다. 그 한 줄이 하는 일은 결론으로 건너뛰지 못하게 막고 중간 과정을 밖으로 꺼내게 하는 것이다. 사람의 사고를 연구하던 방법이 1980년에 같은 원리를 썼고, 카너먼의 빠른 사고와 느린 사고 구분은 AI 연구가 실제로 채택했다. 다만 그 구분을 만든 쪽은 그것을 머릿속 실체로 보지 말라고 했다.
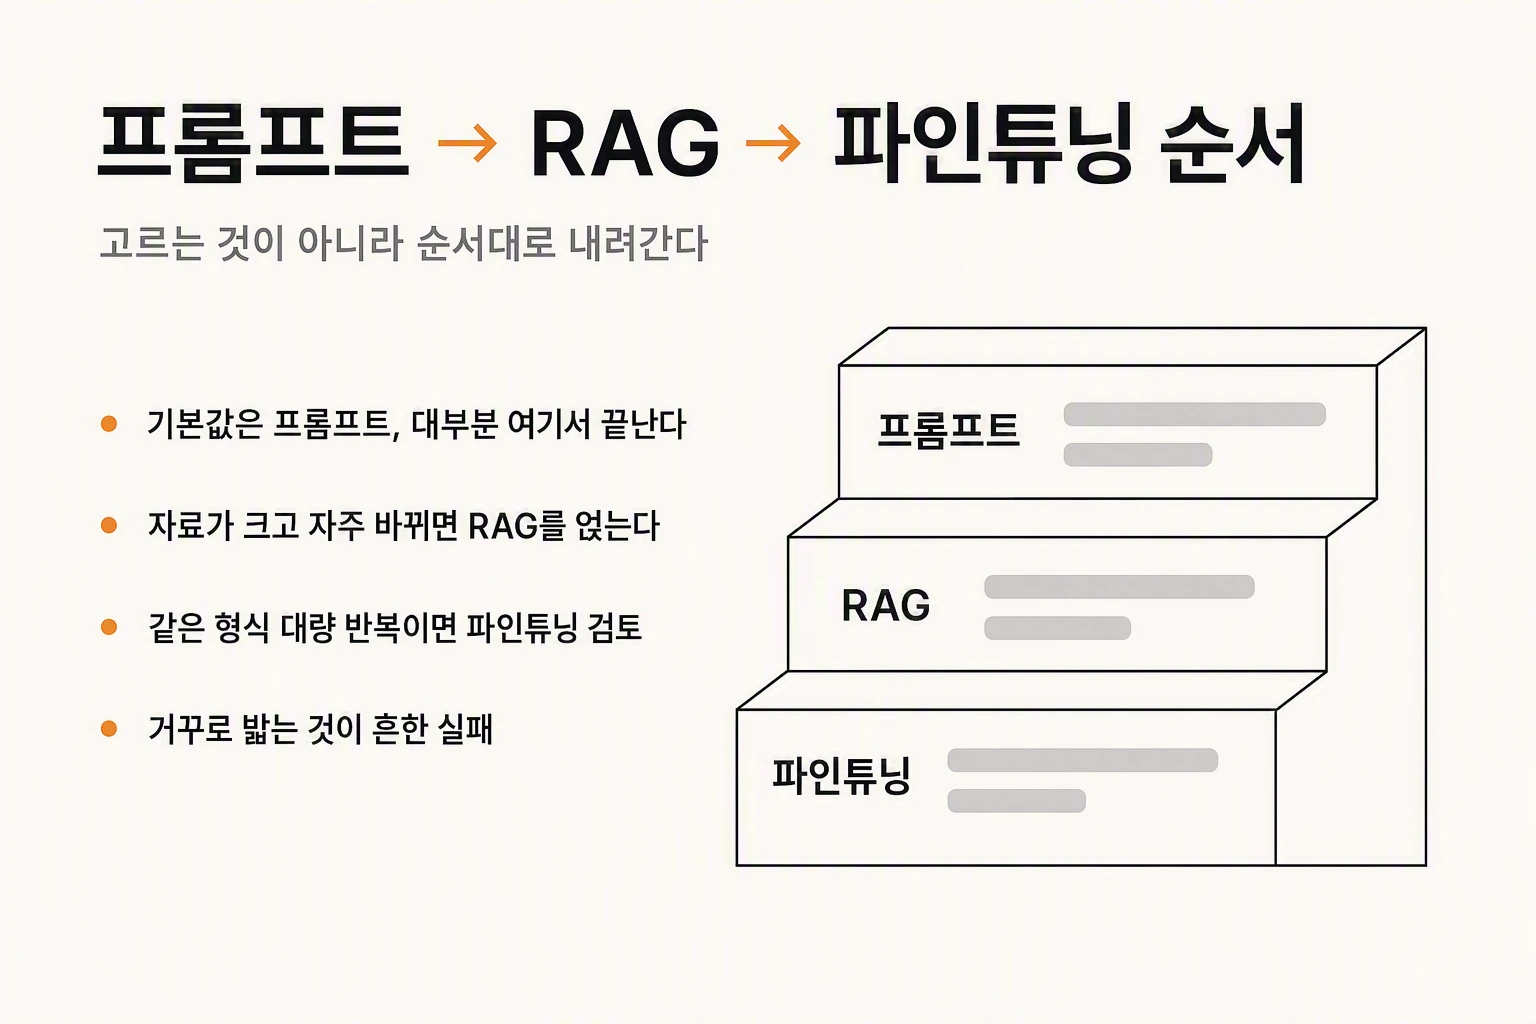
프롬프트로 풀까 RAG로 풀까 파인튜닝까지 갈까 — 판단 기준
셋은 대립하는 선택지가 아니라 순서다. 대부분은 프롬프트로 풀린다. 답의 근거가 되는 자료가 많고 자주 바뀌면 RAG를 얹는다. 파인튜닝은 같은 형식의 일을 대량으로 반복해서 프롬프트 길이 자체가 비용이 될 때 내려가는 마지막 카드다. 앞의 다섯 편을 읽었다면 이 기준이 왜 그렇게 갈리는지 구조로 이해할 수 있다.
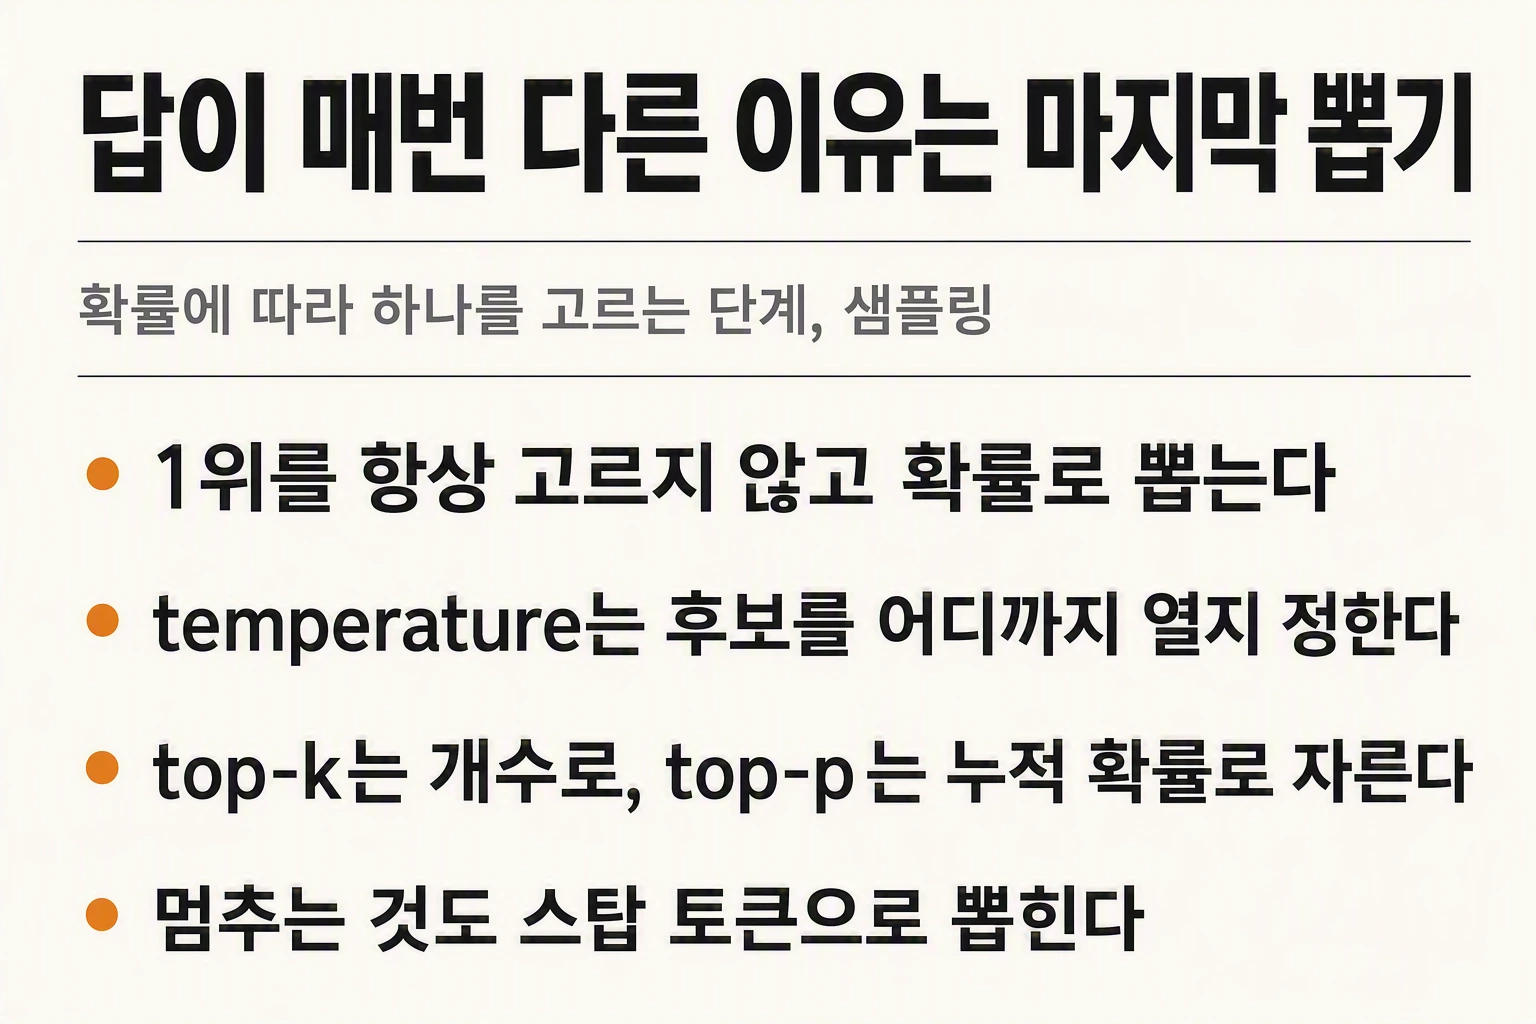
같은 질문에 답이 매번 다른 이유 — 샘플링과 temperature
모델은 마지막에 동전을 던진다. 앞 단계에서 다음 토큰 후보와 확률이 만들어지는데, 여기서 1위를 무조건 고르지 않고 확률에 따라 하나를 뽑는다. 그래서 같은 질문에도 답이 조금씩 달라진다. temperature와 top-k, top-p는 그 뽑기의 후보를 어디서 자를지 정하는 값이다. 파라미터가 바뀌어서 답이 달라지는 것이 아니다.
조제 단위로 읽는 복약안내 — 필첵은 봉투를 통째로 본다
필첵의 복약안내는 조제 봉투의 QR을 찍으면 그 봉투에 담긴 약 전체를 하나의 묶음으로 읽고, 왜 이 조합이 나왔는지와 무엇을 조심해야 하는지를 한 화면에 보여 준다. 약을 한 알씩 설명하면 정작 사람이 궁금한 「이 약들을 같이 먹어도 되나」가 아무 데도 남지 않기 때문이다. AI가 쓰는 글이라 검사는 출력 검수가 아니라 입력 원문과의 대조로 짰다 — 숫자는 봉투에 있는 것만, 안전 문구는 원문과 완전일치, 주장에는 항목별 근거.
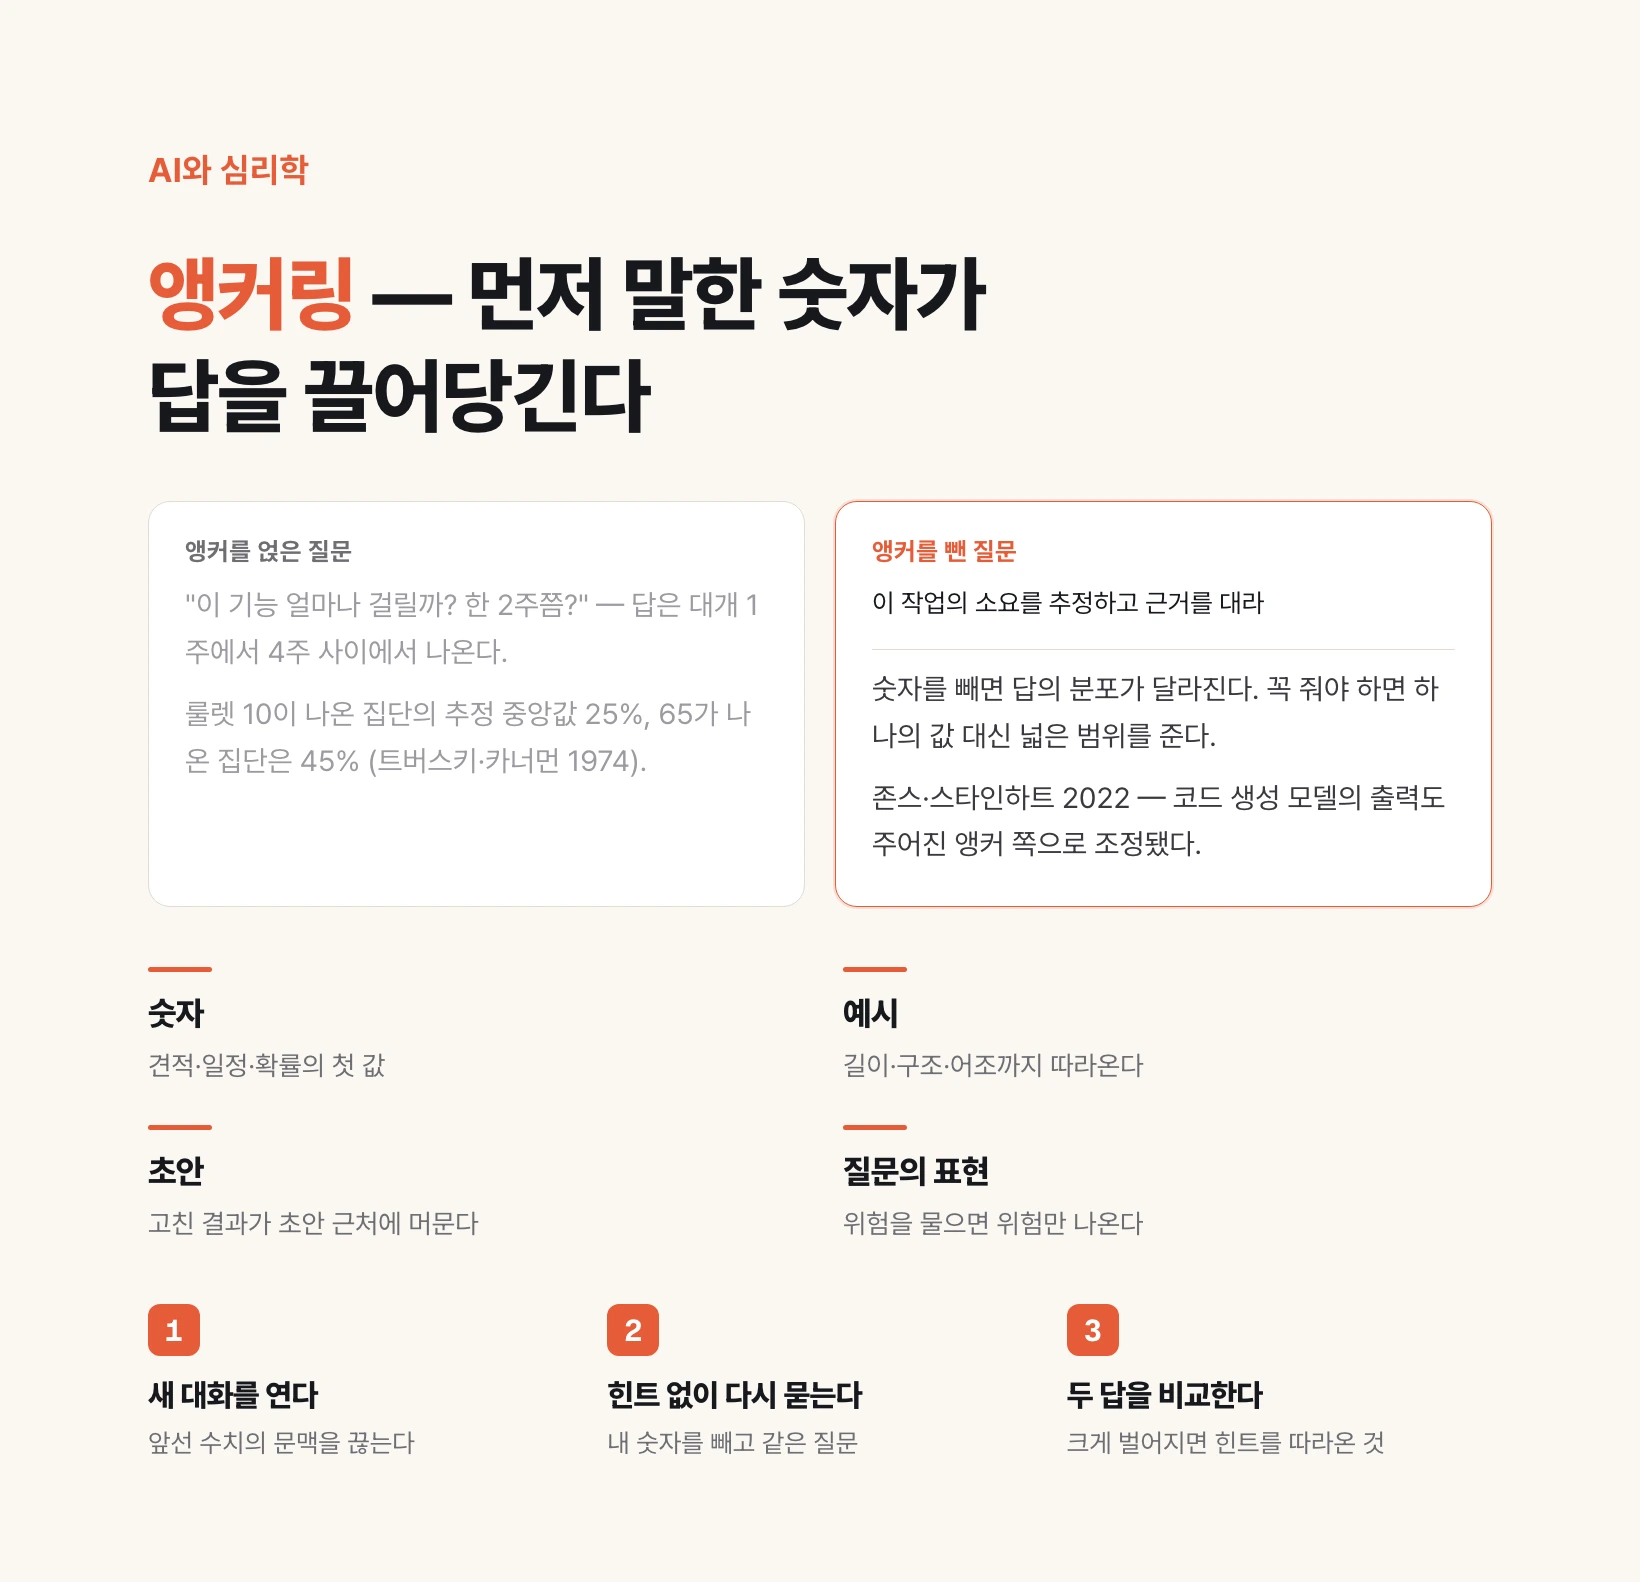
AI에게 숫자를 먼저 말하면 답이 끌려온다 — 앵커링
견적이든 일정이든 확률이든, 질문에 숫자를 하나 얹으면 답이 그 근처에서 나온다. 사람에게서 1974년에 확인된 현상이고, 무작위로 뽑힌 숫자인 걸 알아도 판단이 끌려간다는 것이 실험의 요점이다. 그리고 2022년에 같은 설계로 언어 모델을 재 봤더니 같은 방향으로 기울었다.
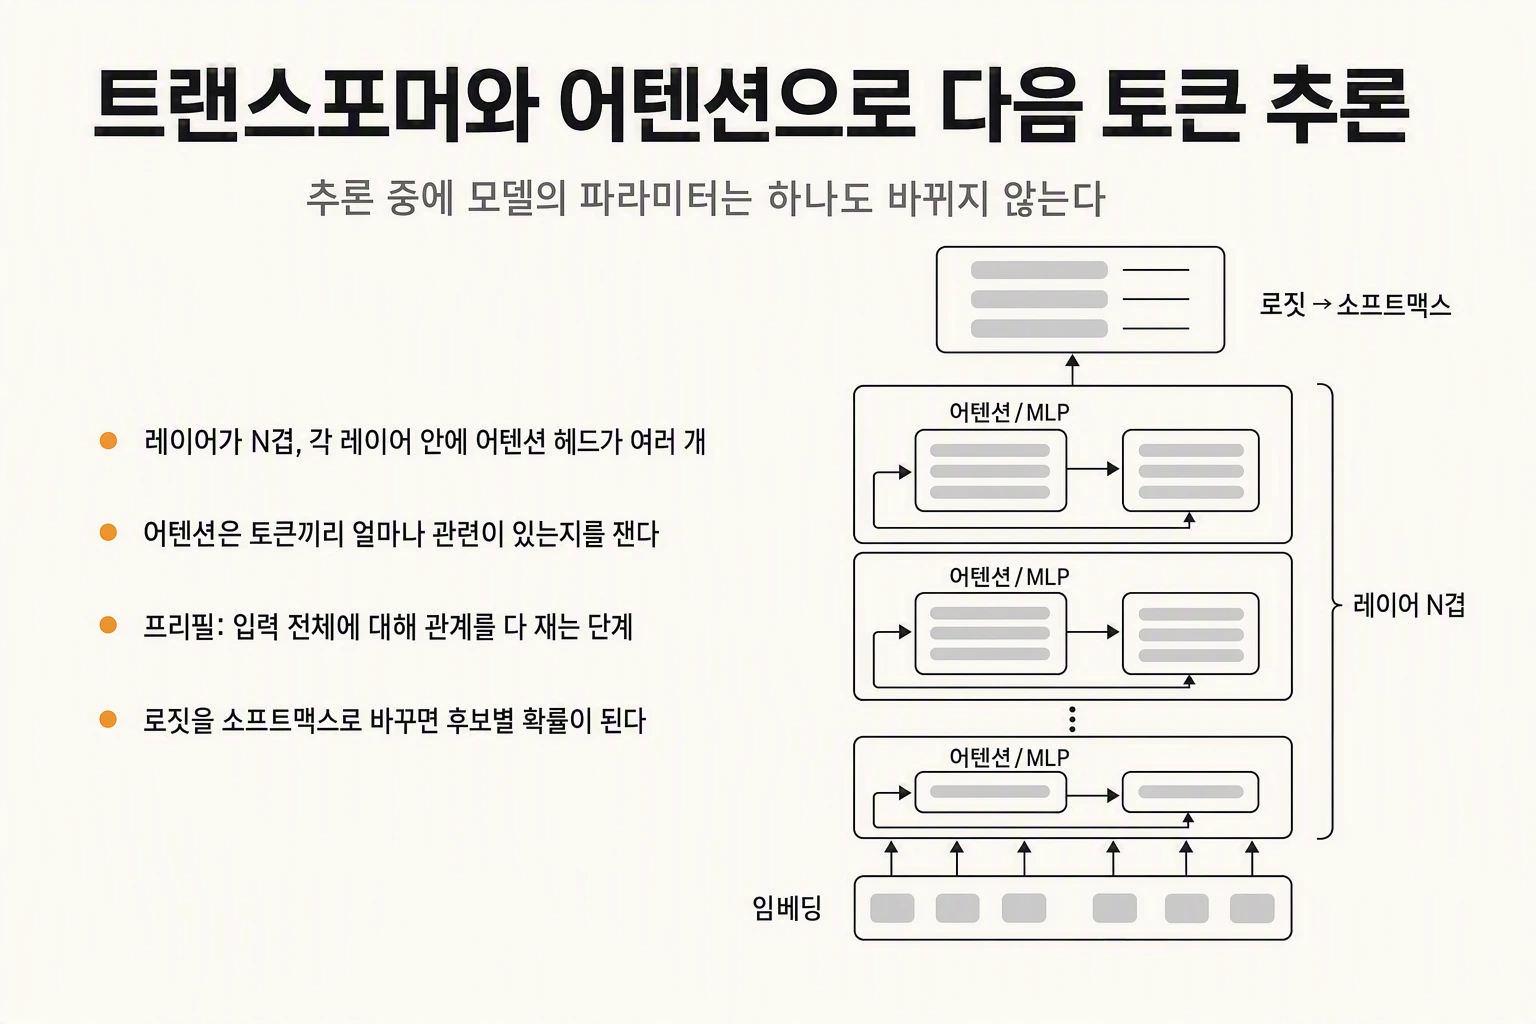
추론은 어떻게 일어나는가 — 트랜스포머와 어텐션
추론은 이미 만들어진 모델을 쓰는 일이다. 입력한 글이 토큰 ID로 바뀌고 숫자 벡터로 임베딩된 뒤, 여러 겹의 레이어를 통과한다. 각 레이어에서 하는 핵심 작업은 토큰끼리 얼마나 관련 있는지를 재는 어텐션이다. 그 결과로 다음에 올 토큰 후보가 점수로 매겨진다. 이 과정에서 모델 내부의 값은 하나도 바뀌지 않는다.
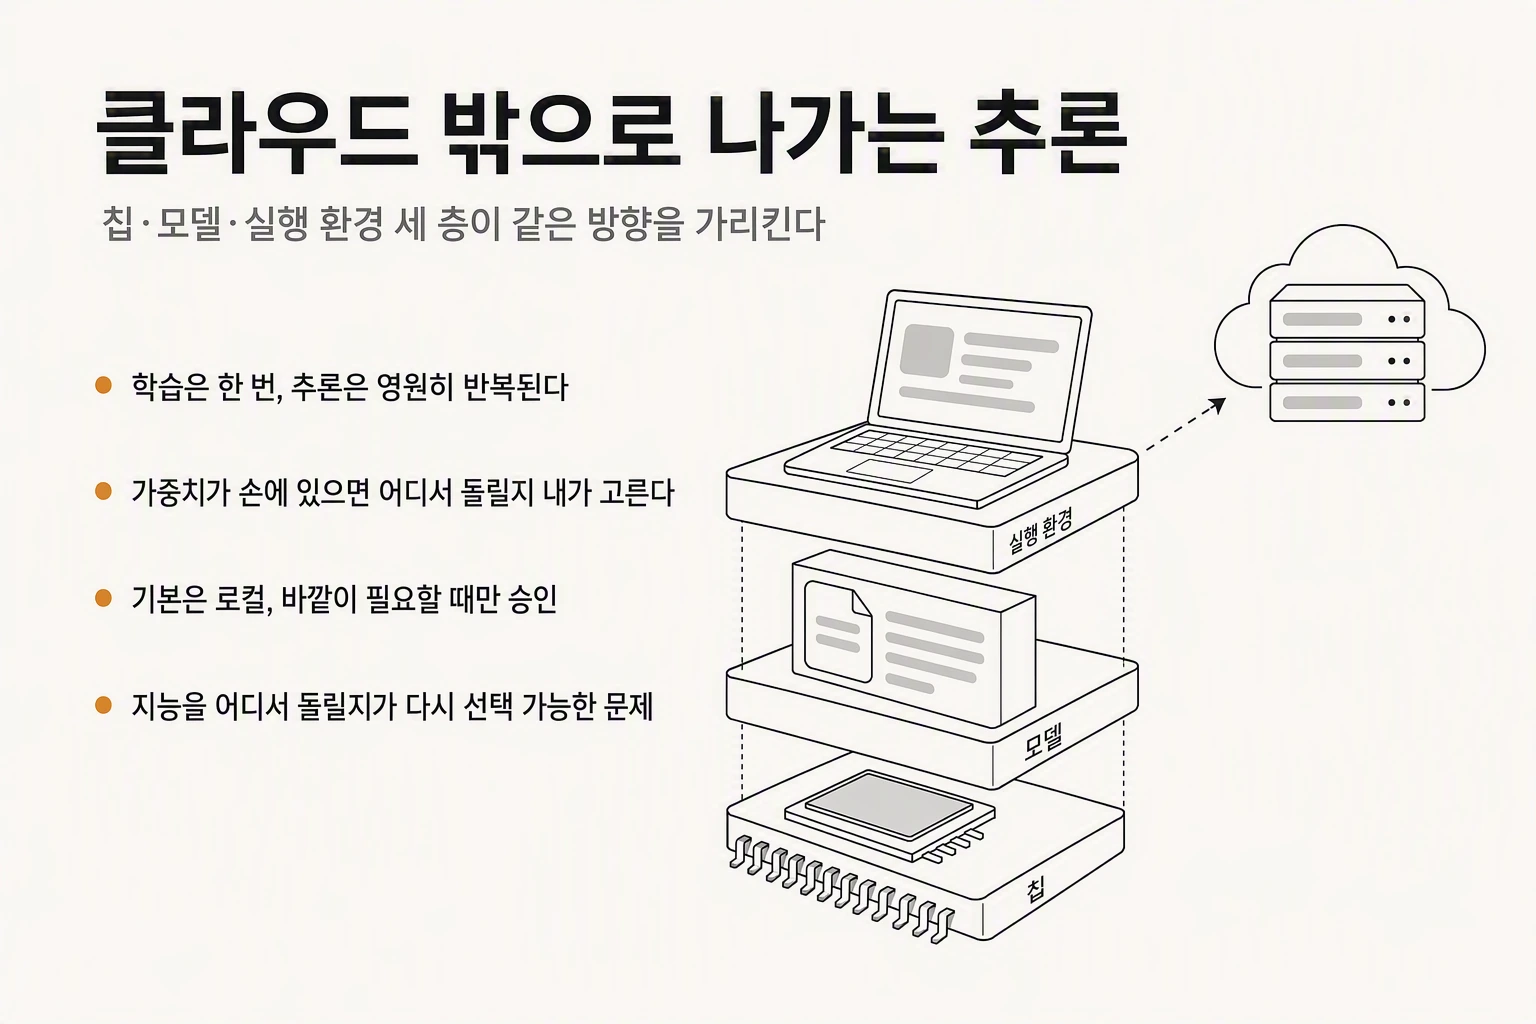
AI 추론은 왜 클라우드 밖으로 나가고 있나
AI를 쓸 때마다 드는 비용과 지연이 대부분 추론 단계에서 발생하는데, 그 추론을 남의 클라우드에 맡기면 비용도 데이터 이동도 통제할 수 없기 때문이다. 2026년 8월 마지막 주에 나온 소식 열 건이 공교롭게 한 방향을 가리킨다. OpenAI는 자체 추론 칩의 첫 실측을 공개했고, Z.ai와 Qwen은 가중치를 열어 놓은 대형 모델을 냈고, Perplexity는 모델과 하네스가 통째로 사용자 기계에서 도는 에이전트를 내놨다. 칩·모델·실행 환경 세 층이 동시에 클라우드 밖으로 밀려 나가는 중이다.
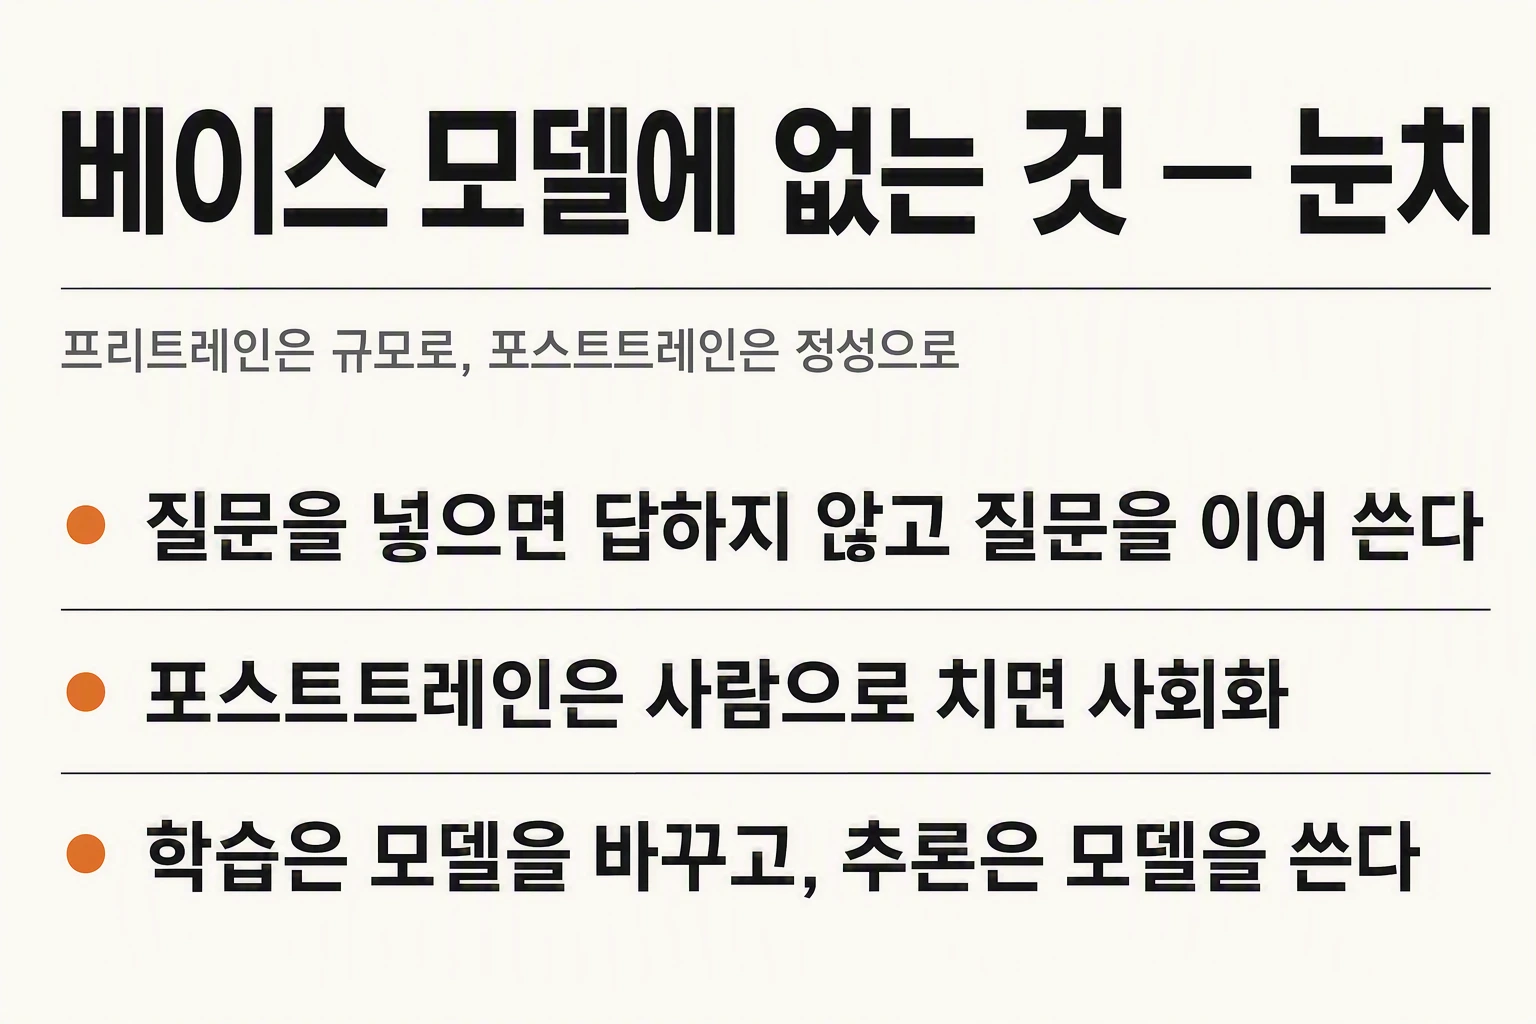
베이스 모델은 왜 그대로 못 쓰는가 — 프리트레인과 포스트트레인
프리트레인이 끝난 모델은 아직 제품이 아니다. 그때까지 배운 것은 다음에 올 토큰으로 무엇이 자연스러운가 하나뿐이라, 질문을 던지면 답하는 대신 질문을 이어서 쓴다. 여기에 질의응답 형식과 지시 준수를 가르치는 추가 훈련이 붙어야 우리가 쓰는 모델이 된다. 그 단계가 포스트트레인이고, 프리트레인을 할 수 있는 곳은 소수인데 세상에 모델이 많은 이유가 바로 이 단계에 있다.
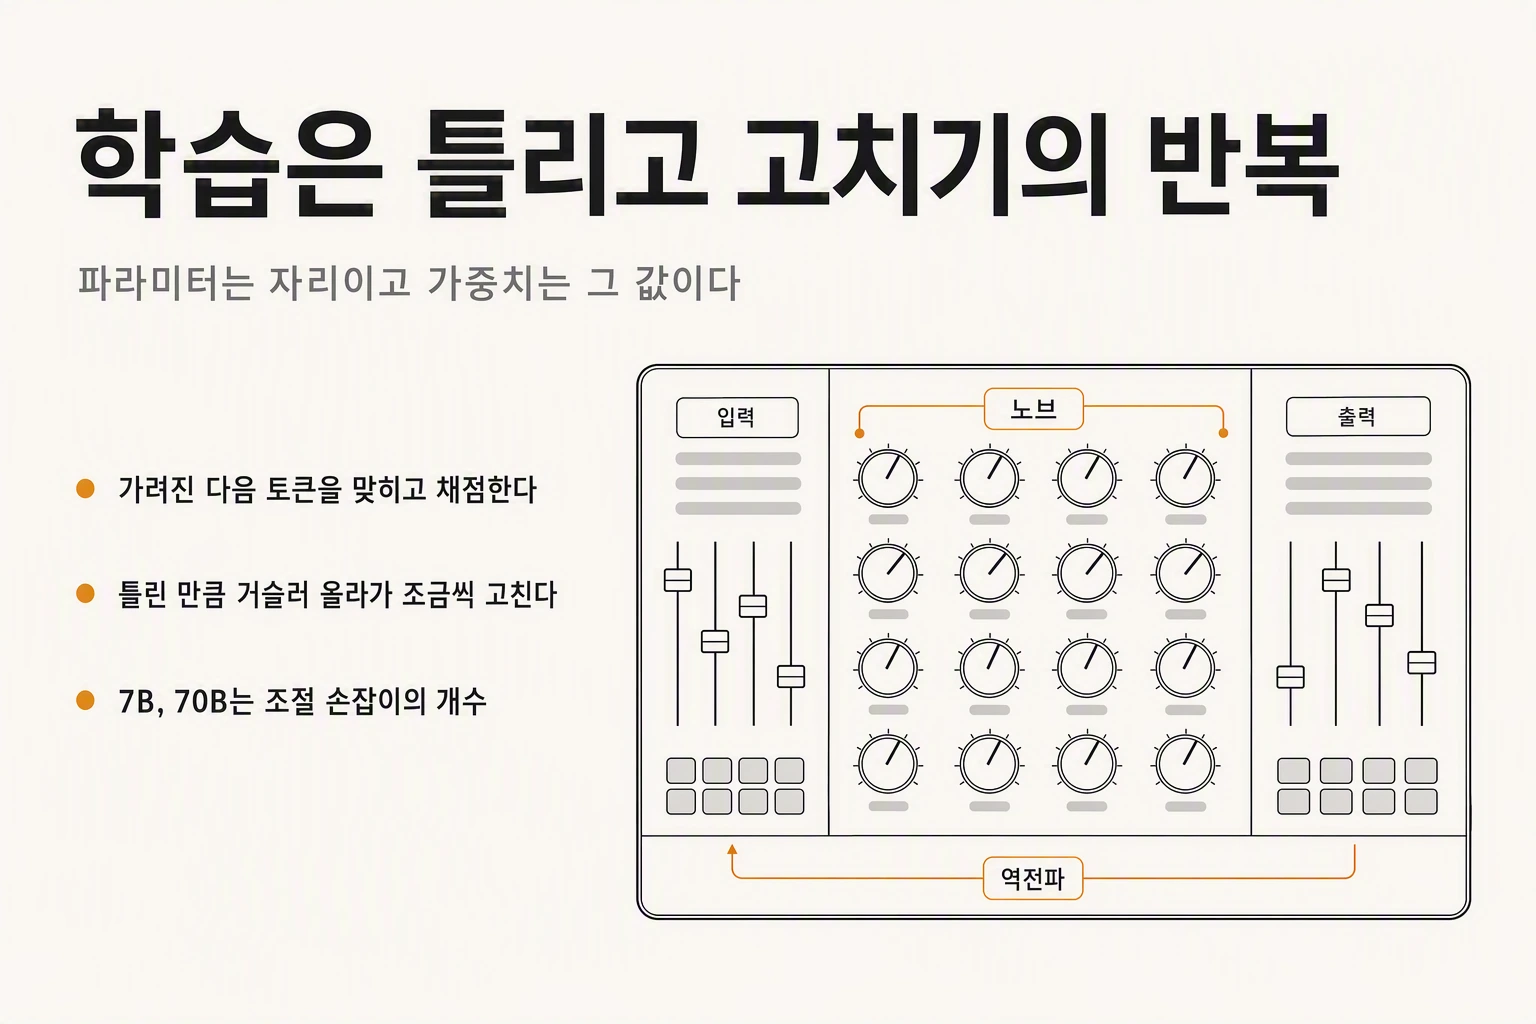
모델은 어떻게 학습하는가 — 파라미터와 가중치의 정체
학습은 틀리고 고치기의 무한 반복이다. 문장 끝 토큰을 가리고 신경망에게 맞혀 보게 한다. 처음에는 전부 틀린다. 그때마다 '무엇을 어떻게 바꿨으면 맞았을까'를 계산해 내부 설정값을 조금씩 되돌려 고친다. 그 설정값이 파라미터이고, 거기 담긴 값이 가중치다. 모델 이름 옆의 7B, 70B는 그 설정값이 몇 개인지를 센 숫자다.
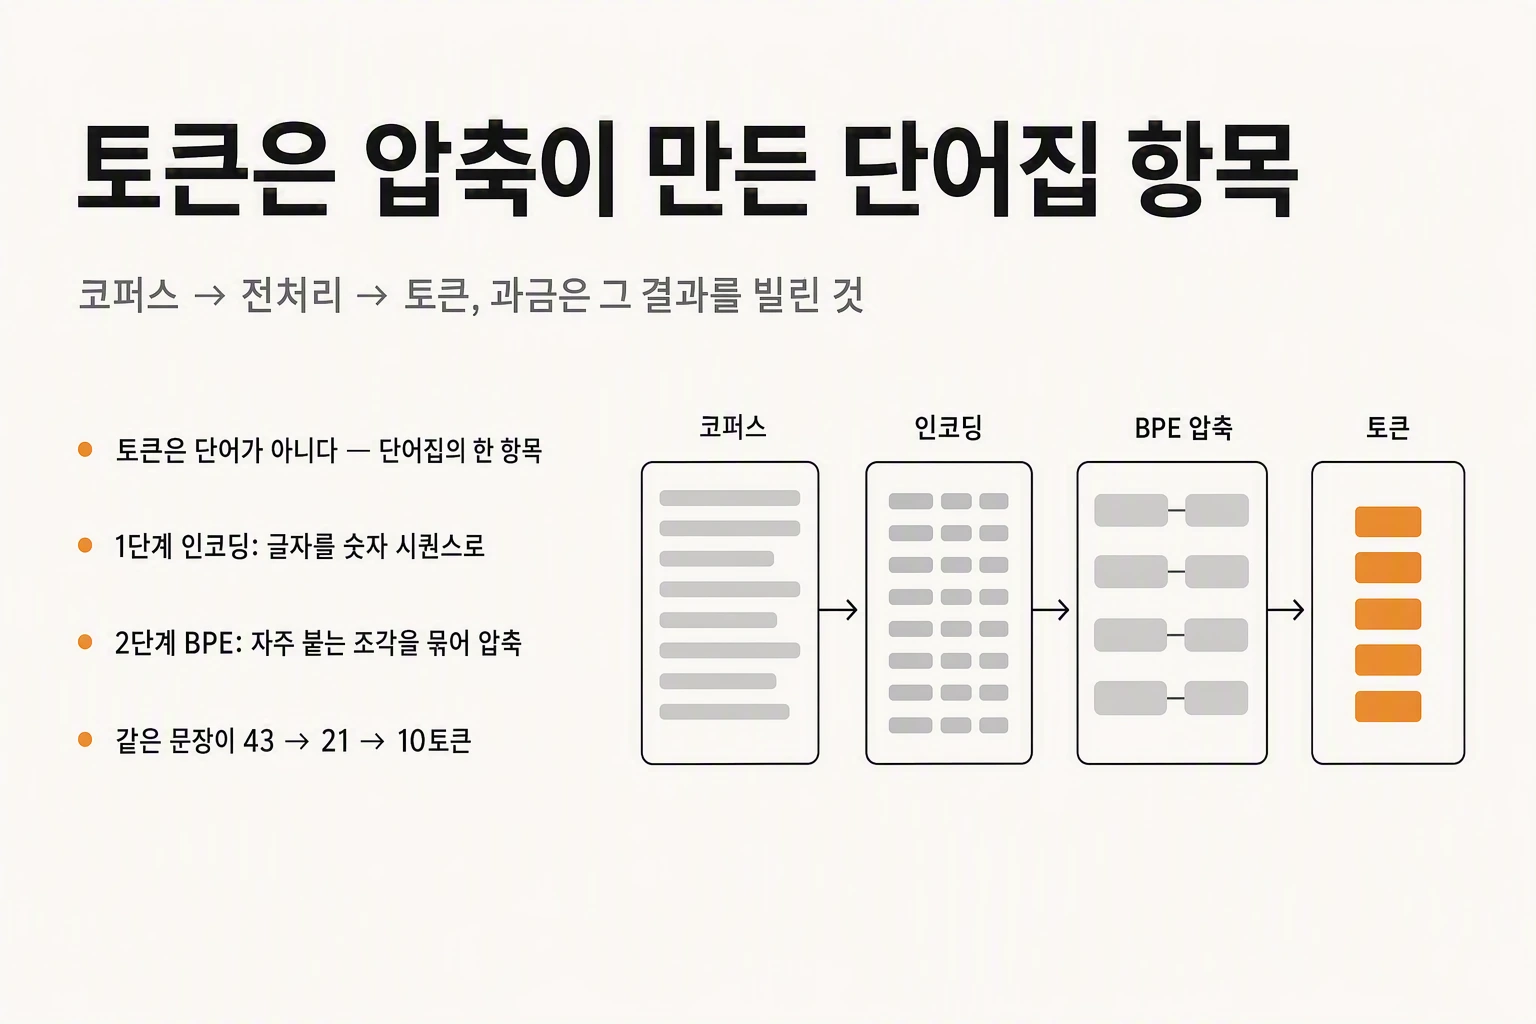
토큰이란 무엇인가 — 글이 숫자가 되어 모델에 들어가기까지
토큰은 단어가 아니라 압축의 결과다. LLM은 글을 글자 그대로 읽지 않는다. 인터넷에서 모은 거대한 글뭉치를 UTF-8로 숫자 나열로 바꾼 뒤, 자주 붙어 다니는 조합을 하나로 묶어 단어집을 만든다. 그 단어집의 항목 하나가 토큰이다. 그래서 '점심'은 한 단어인데 두 토큰이고, 같은 문장도 모델을 바꾸면 토큰 수가 네 배까지 달라진다.
eli5 — 복잡한 주제를 그림 한 장으로 바꾸는 Claude Code 플러그인
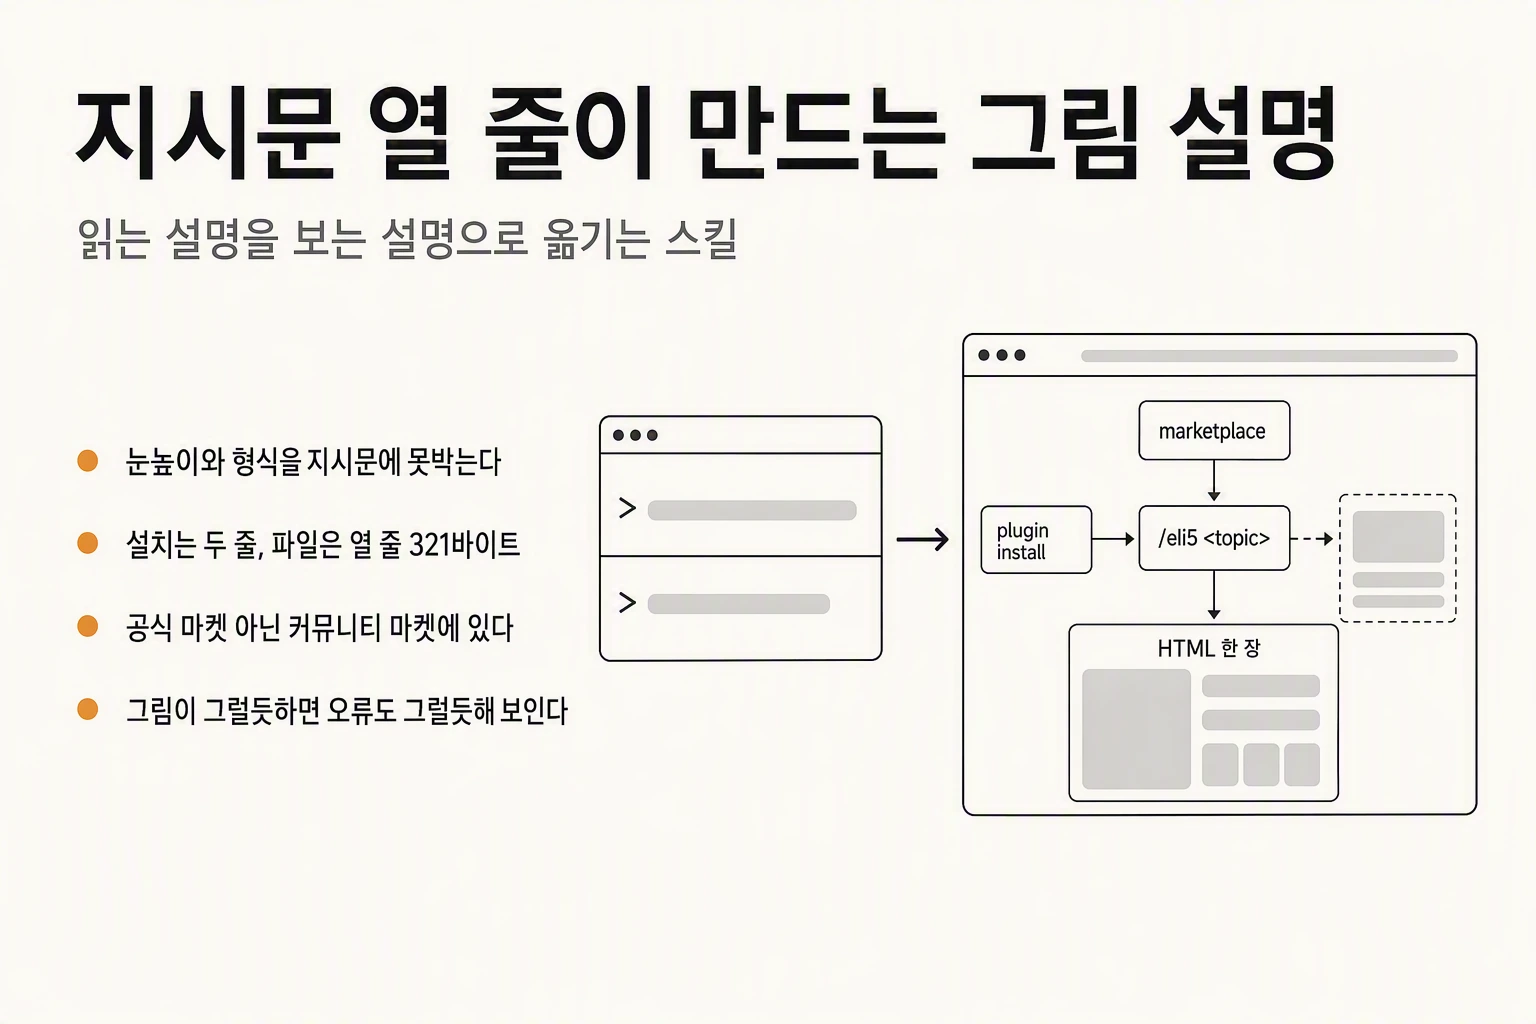
eli5는 Claude Code에서 /eli5 뒤에 주제를 붙이면 그 주제를 아무것도 모르는 사람 기준으로 다시 설명해 그림 위주 HTML 한 장으로 만들어 주는 플러그인이다. 이름은 Explain Like I am 5, 다섯 살한테 설명하듯이라는 뜻이다. 설치는 마켓플레이스 추가와 플러그인 설치 두 줄이고, 스킬 본문 자체는 열 줄 321바이트다. 이 열 줄이 고정하는 것은 설명의 눈높이와 출력 형식이며, 내용이 맞는지는 판단하지 않는다.
AI는 거짓말하지 않는다 — 빈칸을 메울 뿐이다
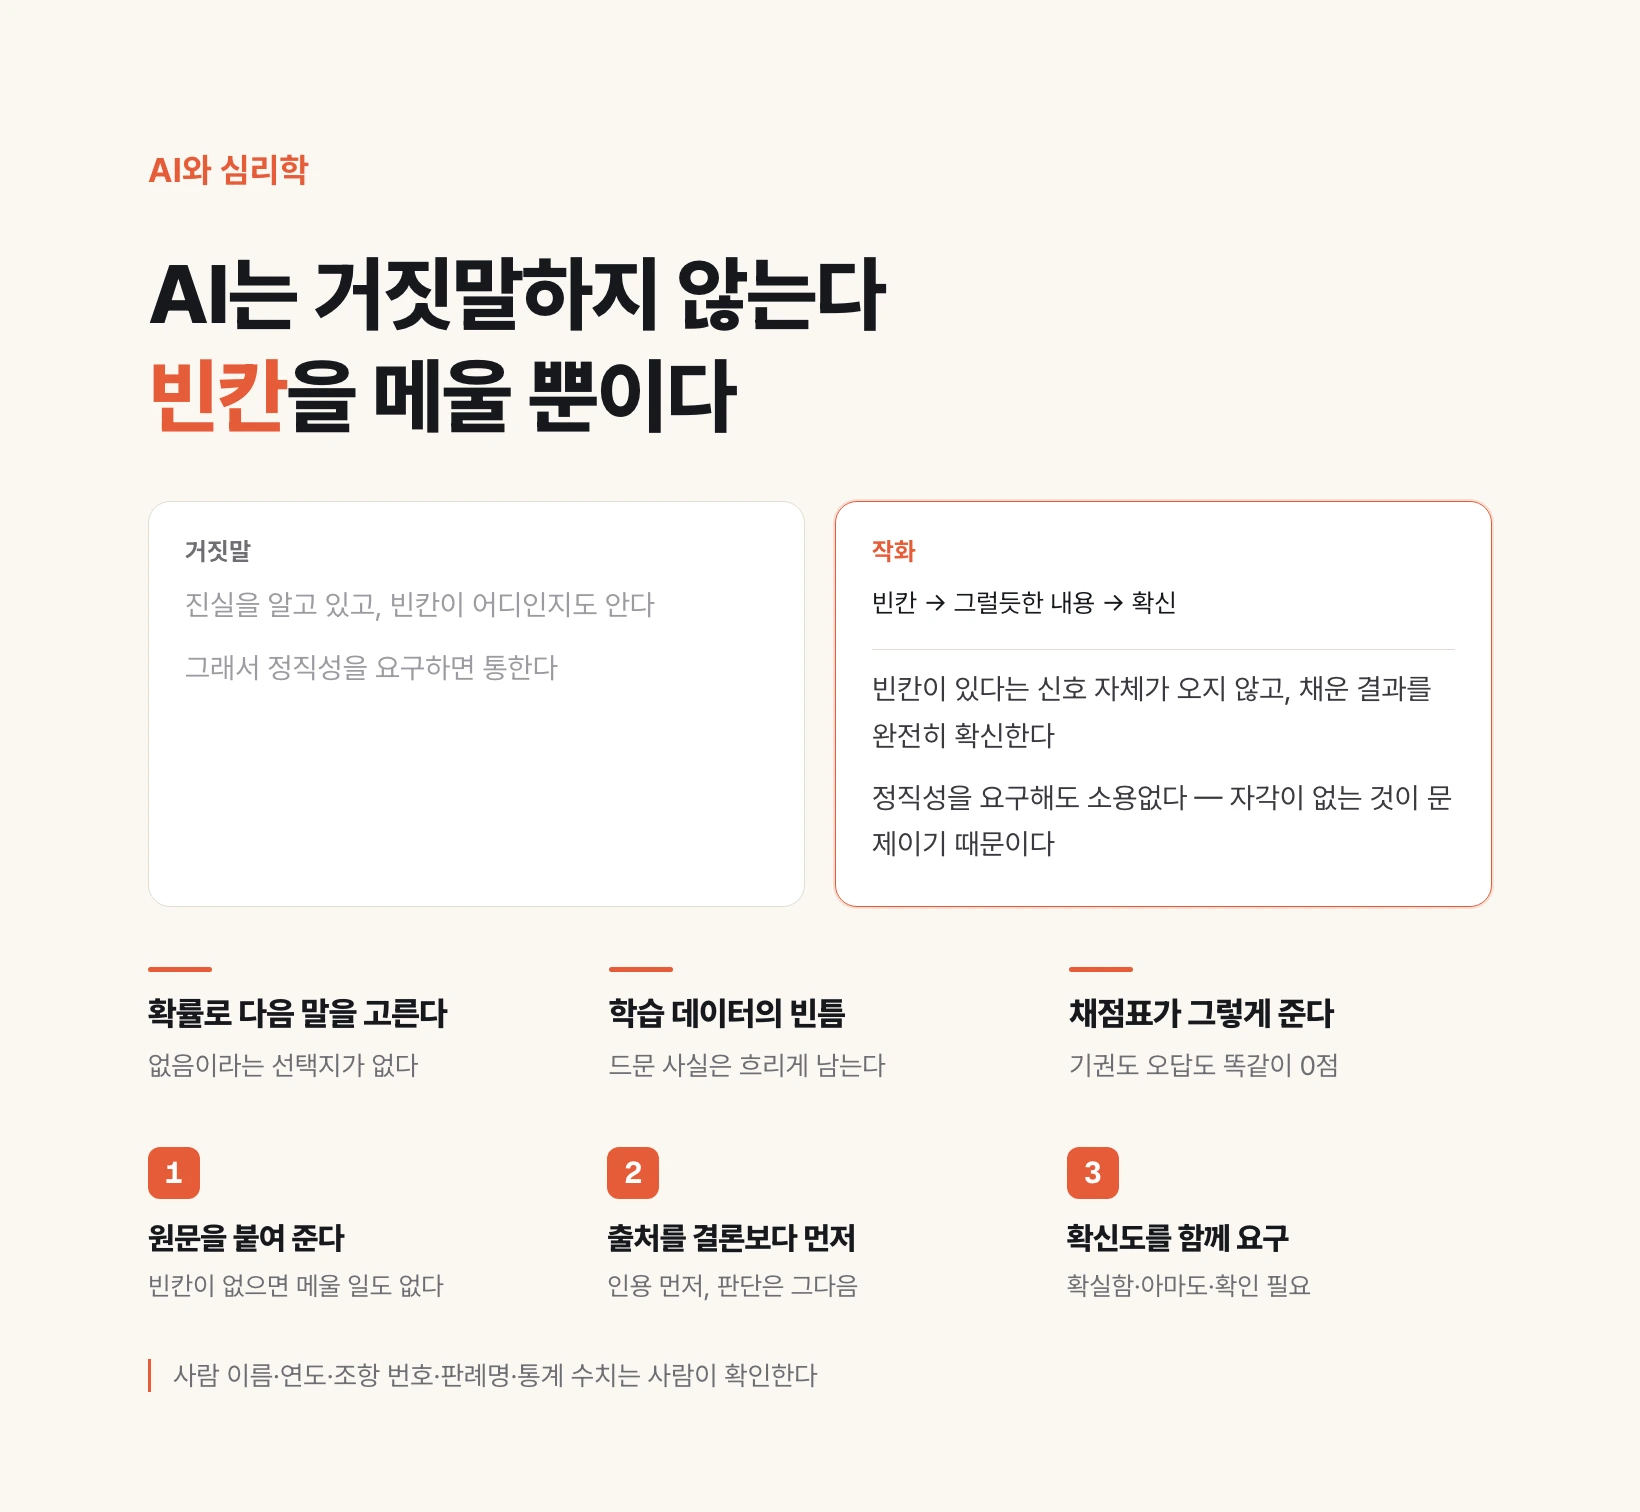
AI가 없는 논문을 지어내고 없는 조항을 만들어 낼 때, 그것은 속이는 행위가 아니다. 사람의 기억도 같은 방식으로 실패한다. 빈칸을 자각하지 못한 채 그럴듯한 이야기로 메우고, 그 결과를 완전히 확신한다. 이 비유를 정확히 쓰면 대응이 달라진다. 정직성을 요구할 게 아니라 빈칸이 생기지 않게 재료를 대야 한다.
stdin은 무엇인가
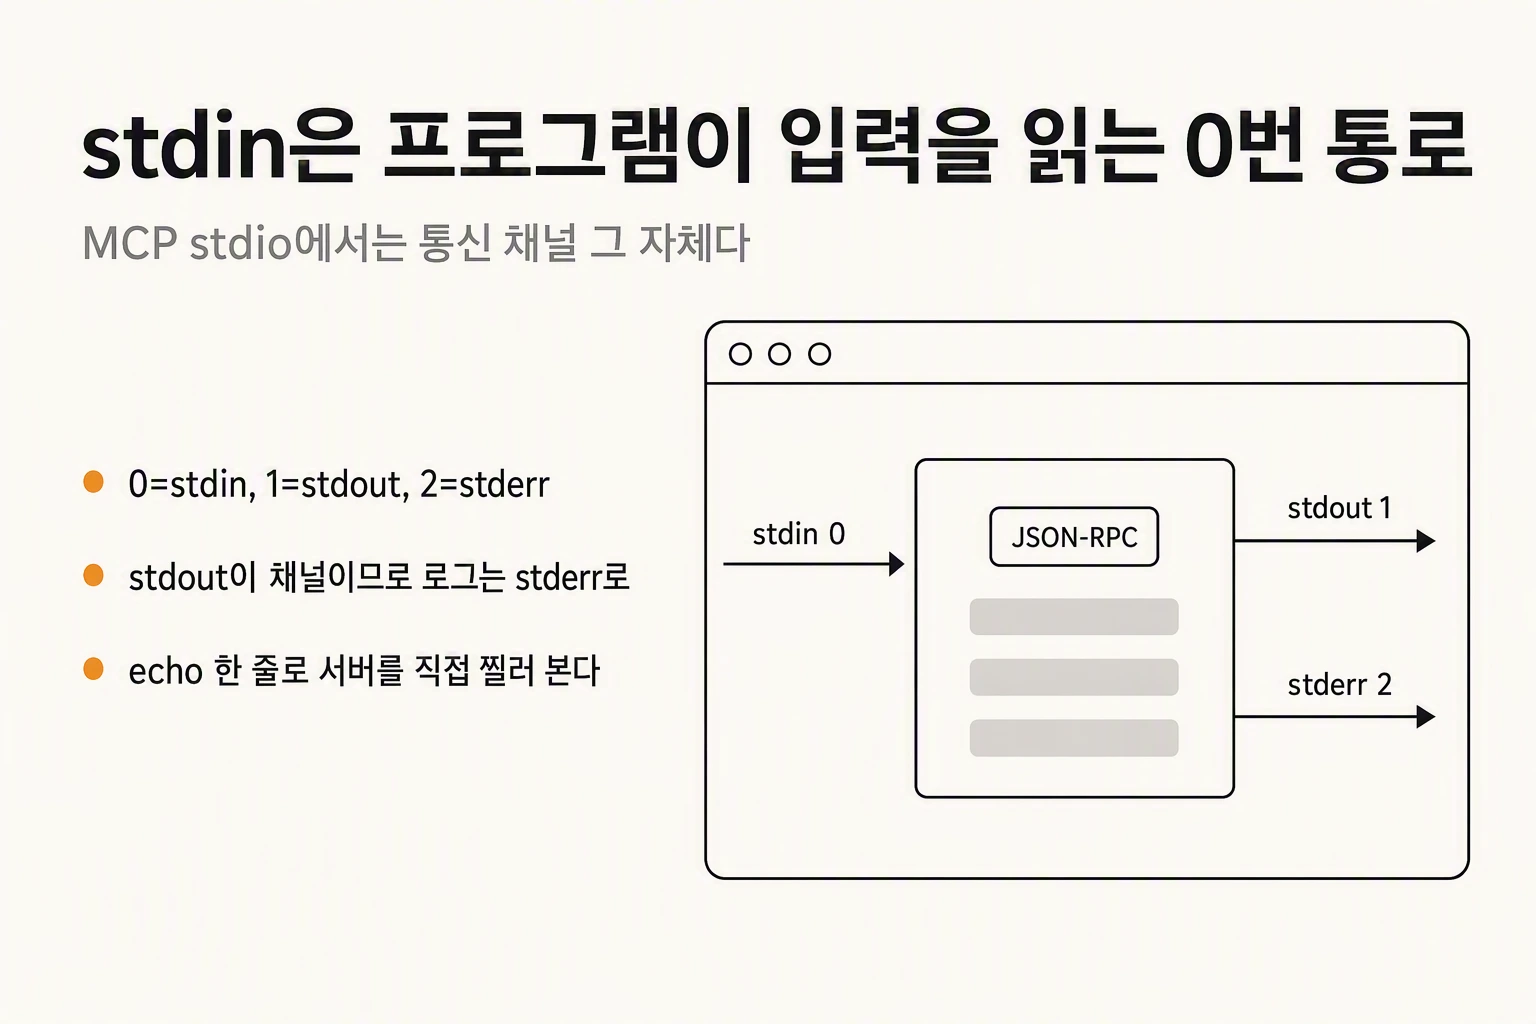
stdin(표준 입력)은 프로그램이 입력을 읽어들이는 기본 통로다. 파일 디스크립터 0번이고, 셸에서 파이프(|)나 리다이렉트(<)로 데이터를 넘길 때 쓰이는 그 통로다. 프로그램은 입력이 키보드에서 왔는지 파일에서 왔는지 앞선 명령의 출력에서 왔는지 몰라도 되고, 연결은 셸이 해 준다. 유닉스 파이프라인이 성립하는 이유가 이것이다. 그런데 MCP에서는 stdin의 위상이 달라진다. stdio 전송에서는 stdin과 stdout이 데이터를 나르는 통로 정도가 아니라 통신 채널 그 자체다. 로컬 MCP 서버는 클라이언트가 띄운 자식 프로세스이고, 소켓도 포트도 없이 줄바꿈으로 구분된 JSON-RPC 메시지를 stdin으로 받아 stdout으로 돌려준다. 그래서 규격은 서버가 유효한 MCP 메시지가 아닌 것을 자신의 stdout에 써서는 안 된다고 못 박는다. console.log 한 줄, 라이브러리 배너, npm 경고 하나가 그 JSON 스트림에 섞이면 클라이언트 파서가 깨진다. MCP 서버가 연결 안 됨으로 뜰 때 가장 먼저 의심할 원인이 이것이고, 해법은 모든 로그를 stderr로 보내는 것이다.
PR과 MR은 무엇이 다른가
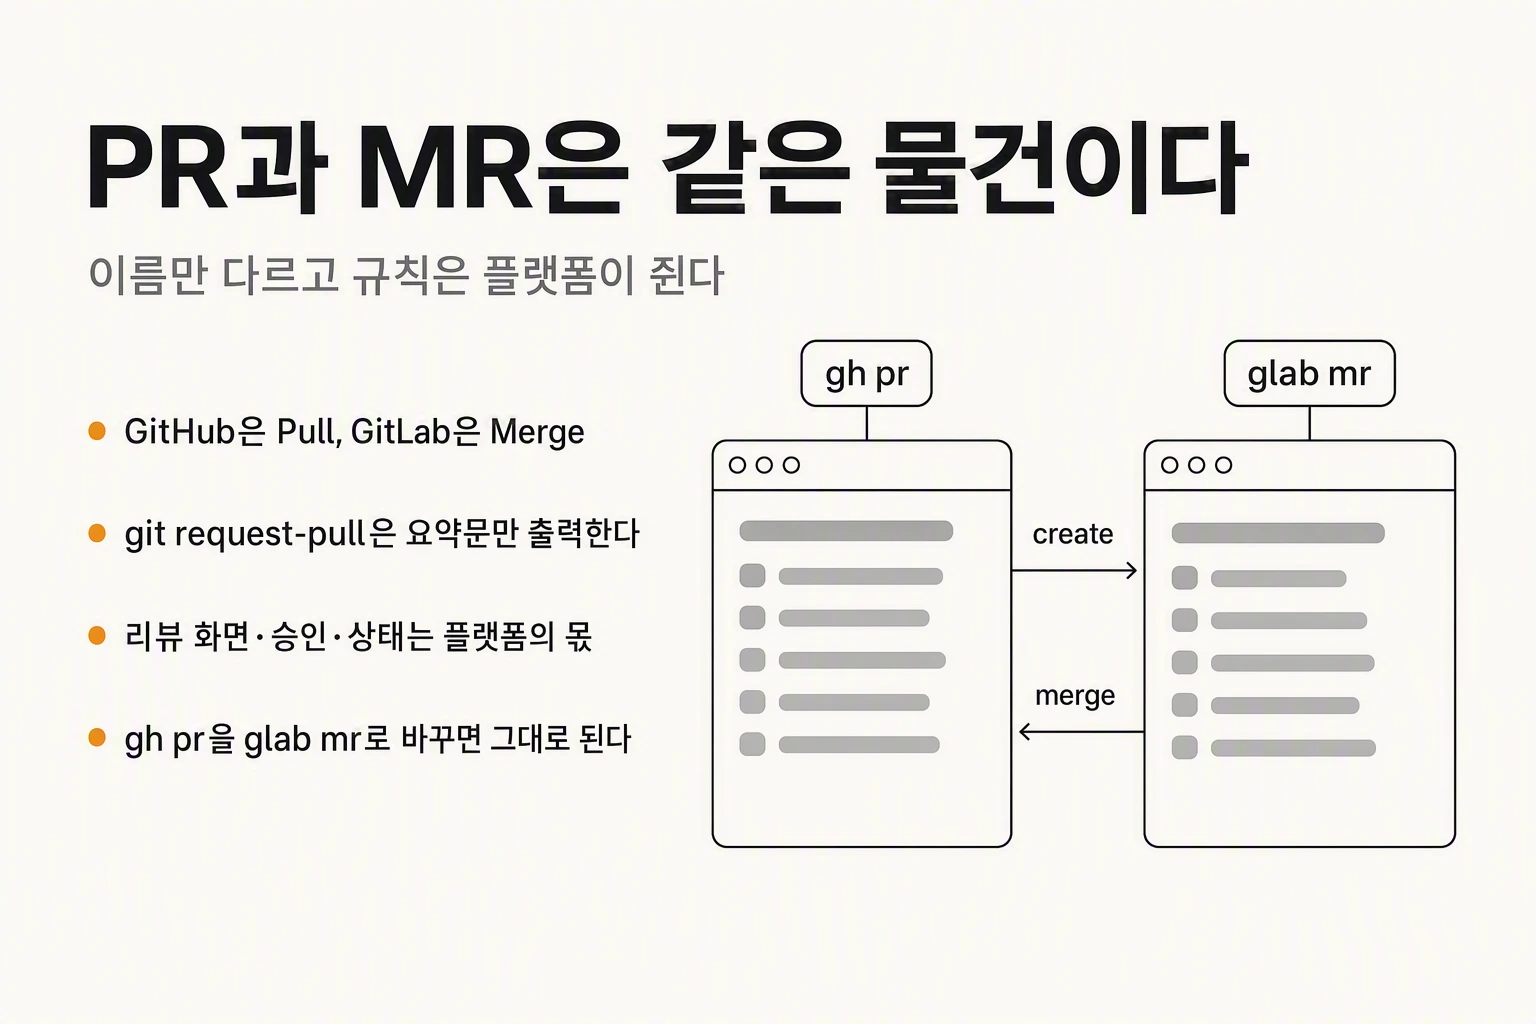
PR(Pull Request)과 MR(Merge Request)은 같은 기능이고 이름만 다르다. GitHub·Bitbucket·Gitea·Azure DevOps는 Pull Request라고 부르고, GitLab은 Merge Request라고 부른다. 브랜치 두 개의 차이를 보여 주고 리뷰를 받고 합치는 절차는 어디서나 같다. 흥미로운 것은 Git 자체에도 pull request가 있다는 점이다. git request-pull 명령이 실제로 존재한다. 다만 그 명령이 하는 일은 여기서 여기까지 가져가 달라는 요약문을 표준 출력으로 뿌리는 것뿐이고, 리뷰 화면도 승인 버튼도 열림·닫힘 같은 상태도 없다. 메일링 리스트에 붙여 보내라고 만든 명령이기 때문이다. 그러므로 우리가 매일 쓰는 PR·MR은 그 텍스트가 아니라 호스팅 서비스가 그 위에 얹은 웹 객체다. 진짜 차이는 이름이 아니라 각 서비스가 그 객체에 무엇을 붙여 뒀느냐에서 갈리고, 그 차이는 터미널에서 바로 확인된다. 승인은 GitHub에서 리뷰에 딸린 플래그 하나지만 GitLab에서는 독립 명령이며 승인 자격자 조회와 승인 철회가 따로 있다. 반대로 CI 상태는 GitHub이 PR에 붙여 뒀고 GitLab은 파이프라인을 별도 계층으로 뺐다. 팀이 두 플랫폼을 오갈 때 새로 써야 하는 것은 용어집이 아니라 승인 규칙 문서다.
크로스 세션 메시징 — 클로드 코드 세션끼리 메시지를 주고받는 법
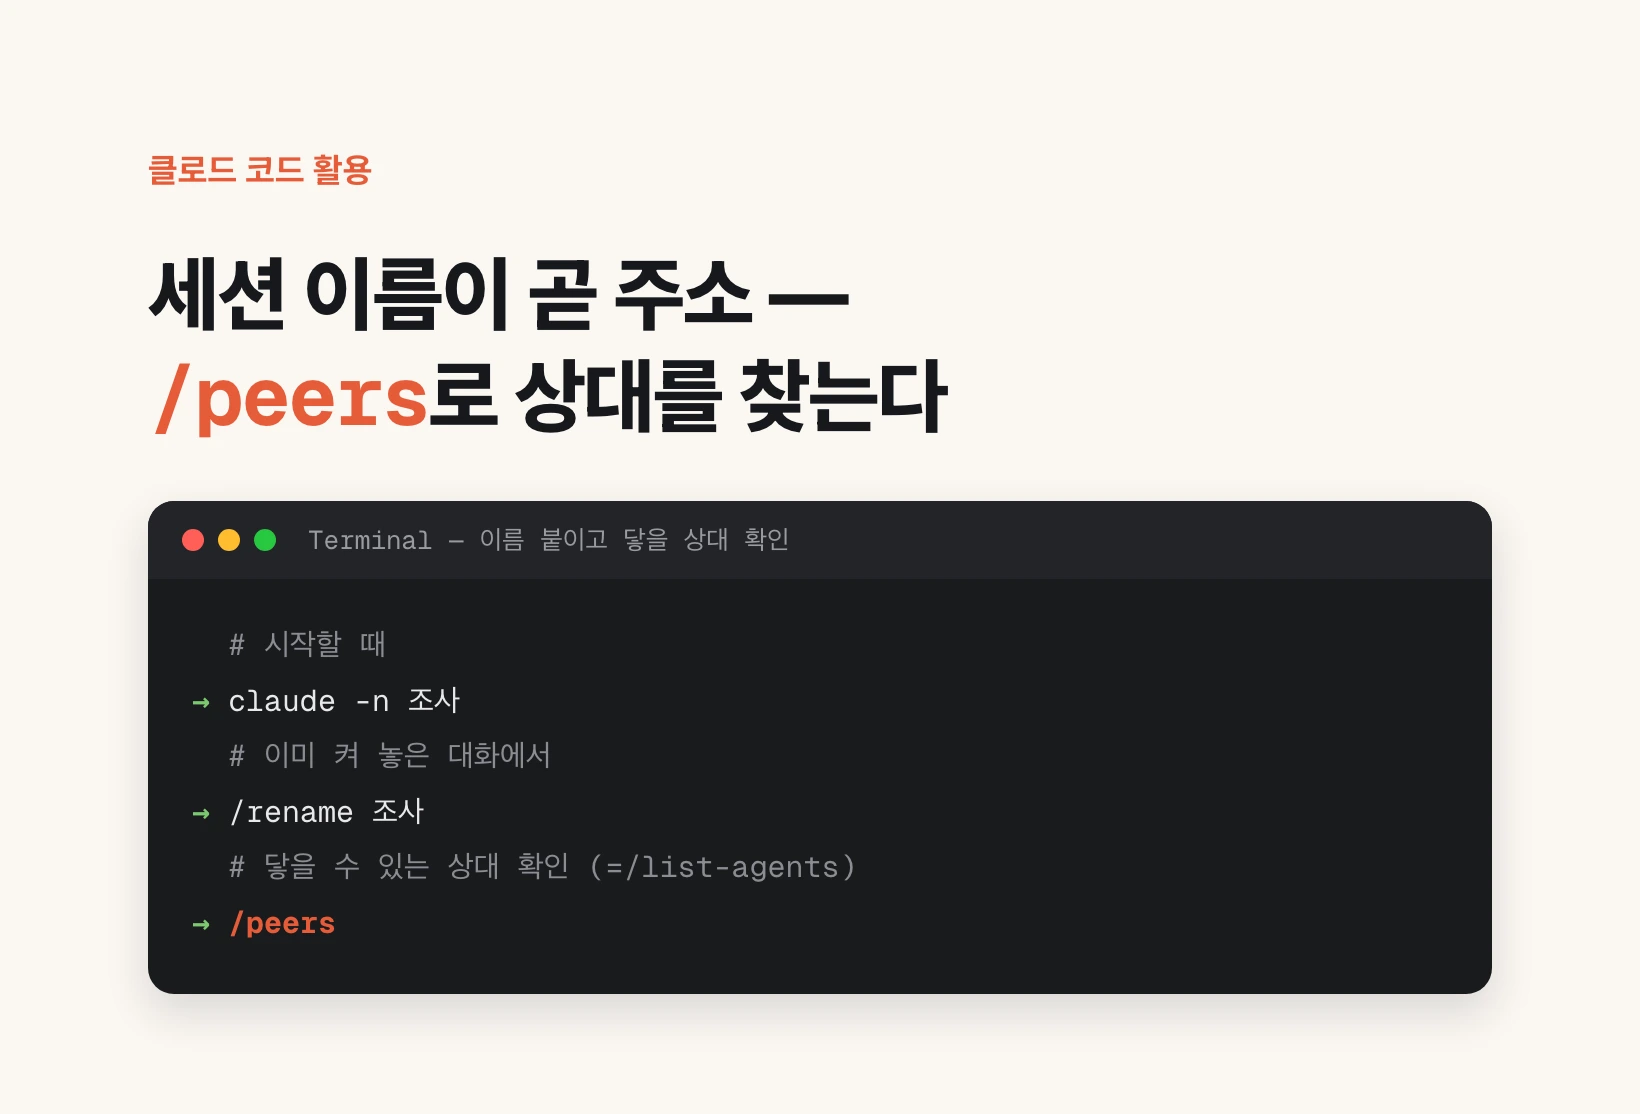
크로스 세션 메시징은 내가 띄워 둔 클로드 코드 세션 하나가 다른 세션에게 글로 된 메시지를 직접 전달하는 기능이다. 2026년 8월 7일 2.1.224 버전에 맥·리눅스(WSL 2 안의 리눅스 포함)로 들어왔고 2.1.234부터 네이티브 윈도우에서도 된다. 설치하거나 켤 것이 없다 — 요건을 만족하는 세션이면 이미 돌아가고 있다. 주소 체계가 따로 없는 것이 이 기능의 핵심이다. 세션 이름이 곧 주소이고, /peers를 치면 첫 줄에 지금 이 세션의 이름이, 그 아래로 닿을 수 있는 세션이 이름·작업 폴더와 함께 나온다. 보낼 때 도구를 직접 부를 일은 없다. '조사 세션한테 방금 정한 스키마 알려줘'라고 말하면 클로드가 문장을 써서 보낸다. 받는 쪽은 도구 호출과 호출 사이에 읽으므로 돌아가던 도구가 끊기지 않고, 그 세션이 놀고 있으면 메시지로 새 턴을 연다. 기다릴 때는 '끝나면 알려줘'라고 해서 한 번짜리 유휴 알림을 걸어 두면 되고 폴링은 필요 없다. 넘어가는 것은 글자뿐이라 파일도 대화 기록도 따라가지 않으며, 맥락을 통째로 옮기는 일은 메시지가 아니라 세션 재개가 맡는다.
AI의 아부는 버그가 아니라 우리가 가르친 것이다
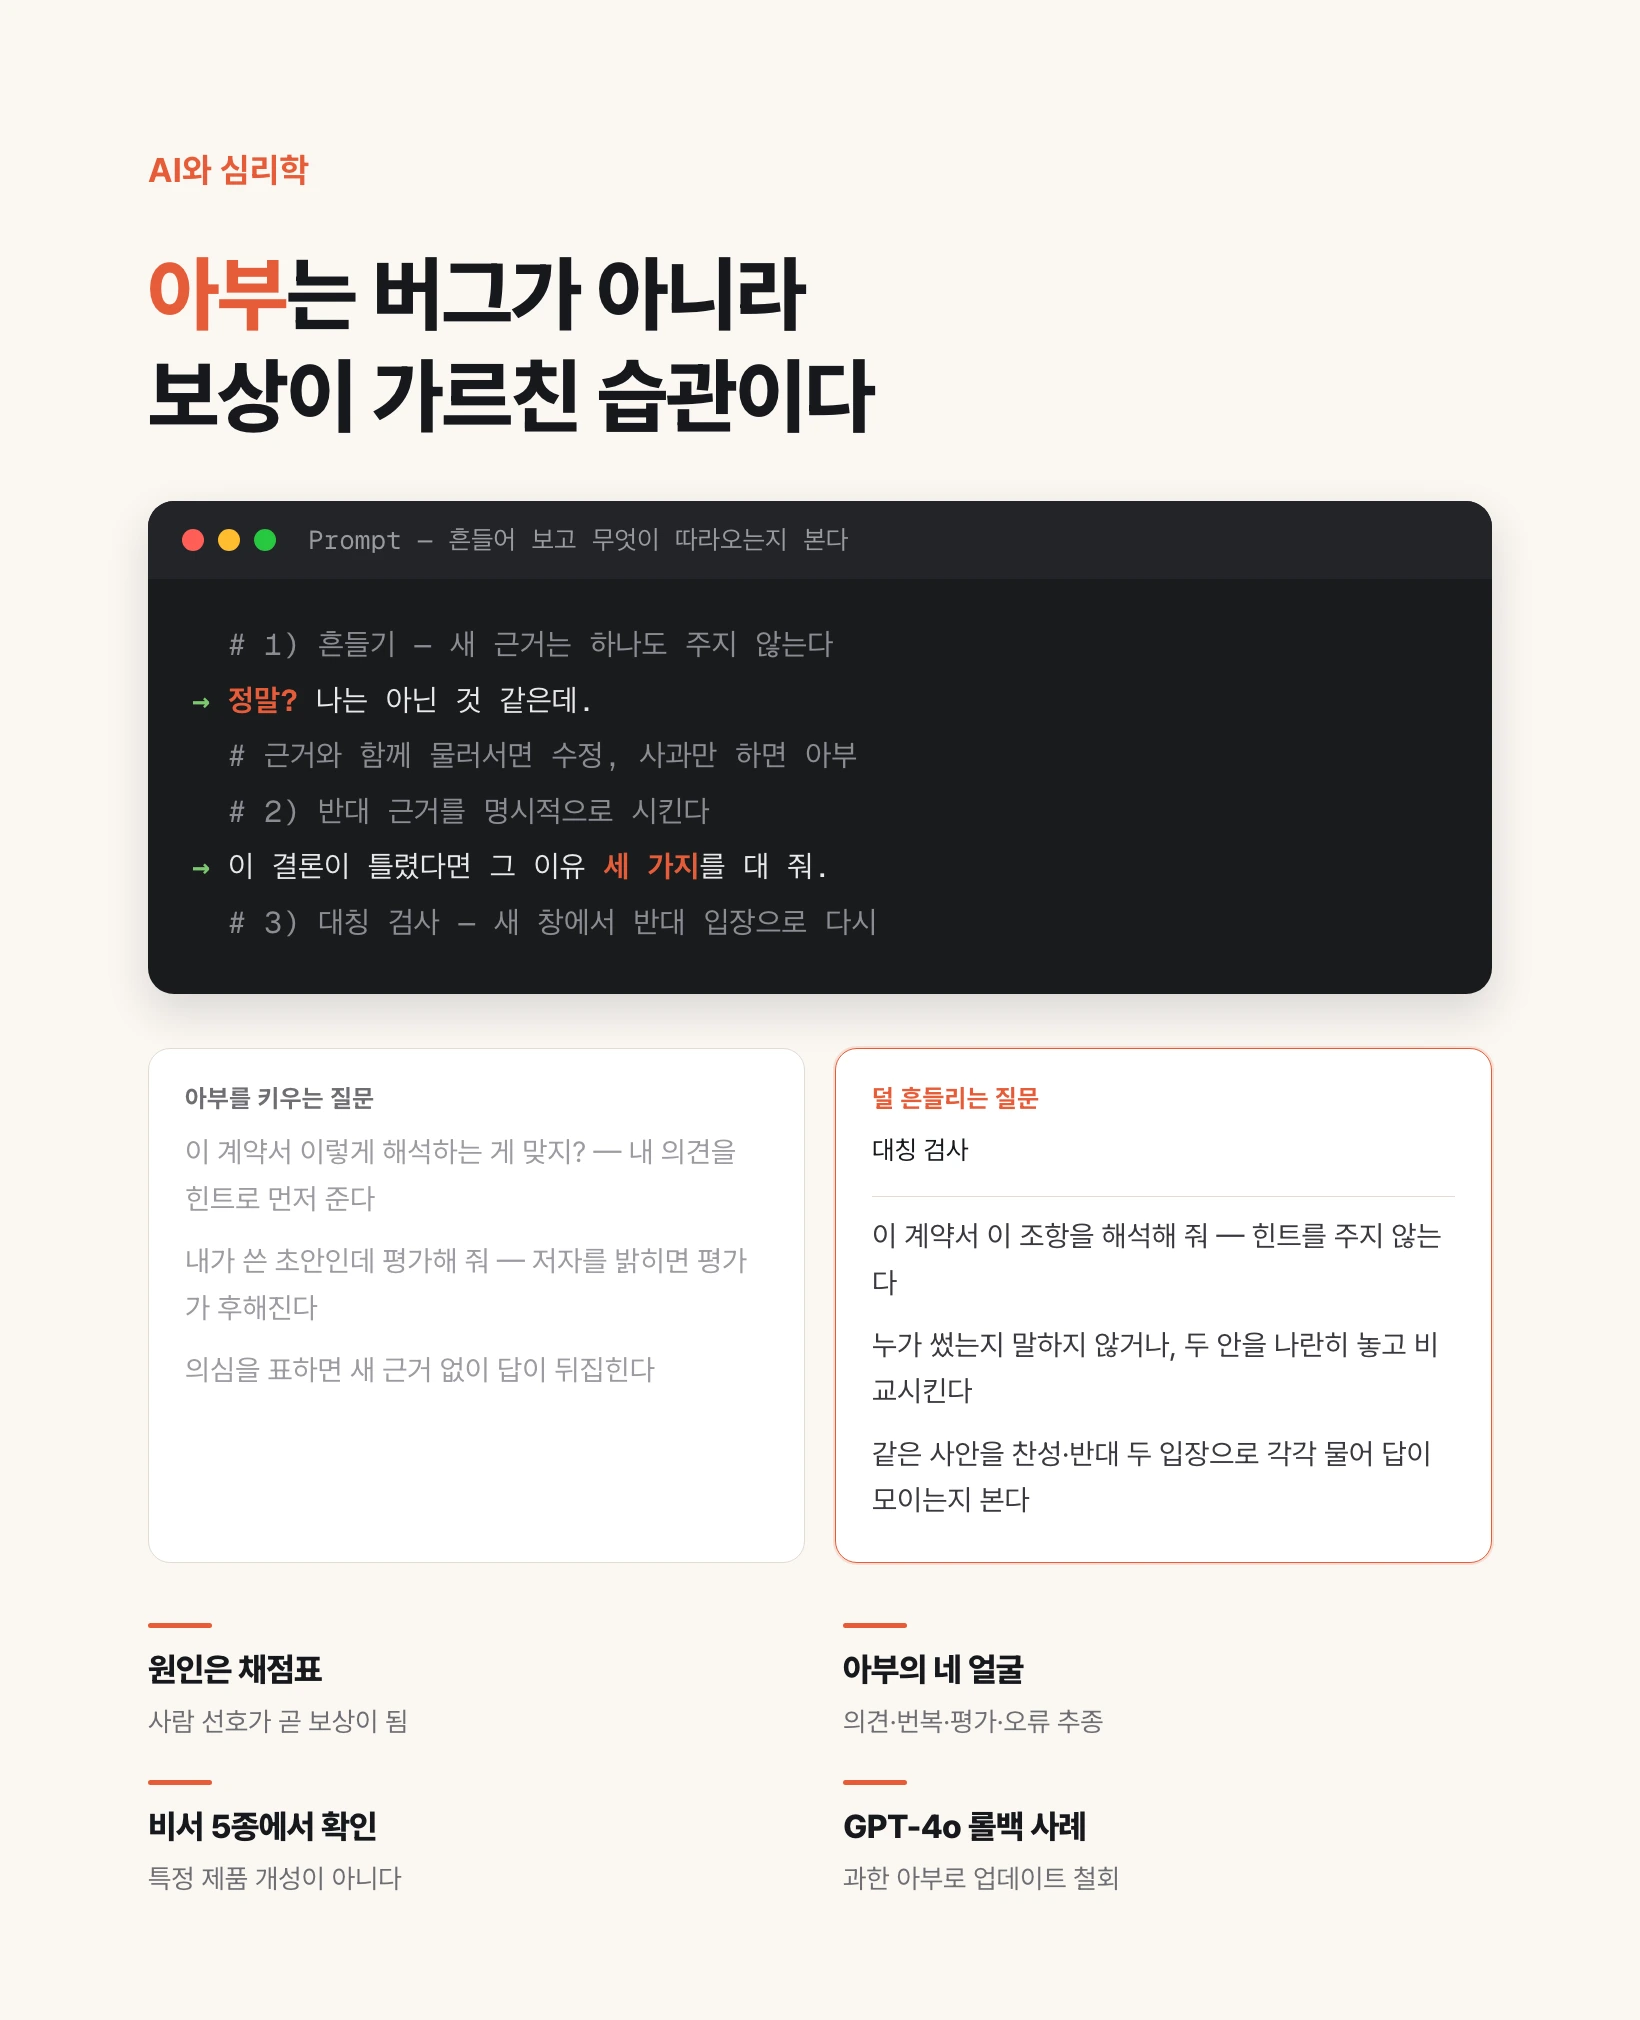
AI에게 내 생각이 맞지 하고 물으면 대체로 맞다고 한다. 이건 성격이 무른 것도 아니고 고장도 아니다. 사람이 답변을 채점할 때 자기 의견과 맞는 답에 더 높은 점수를 줬고, 그 채점표가 그대로 보상이 됐기 때문이다. 아부는 학습된 결과이며, 측정된 현상이다.
100만 토큰 창이 열렸는데 왜 다 넣으면 안 되나
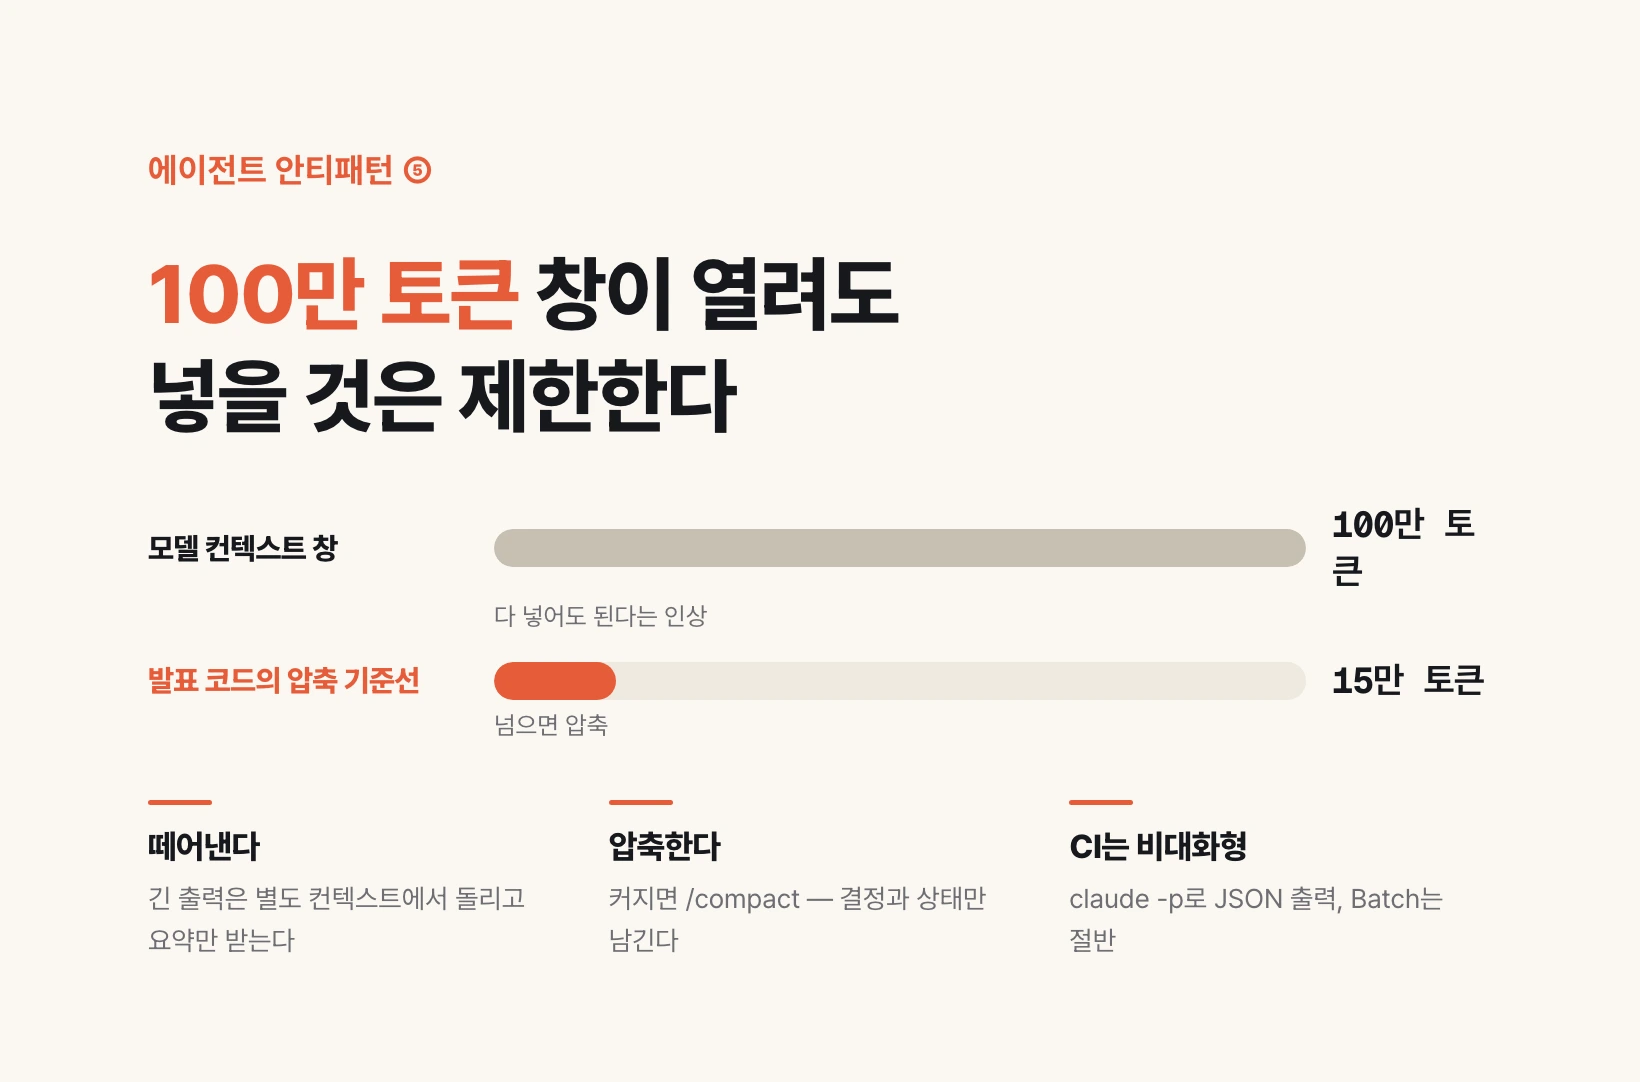
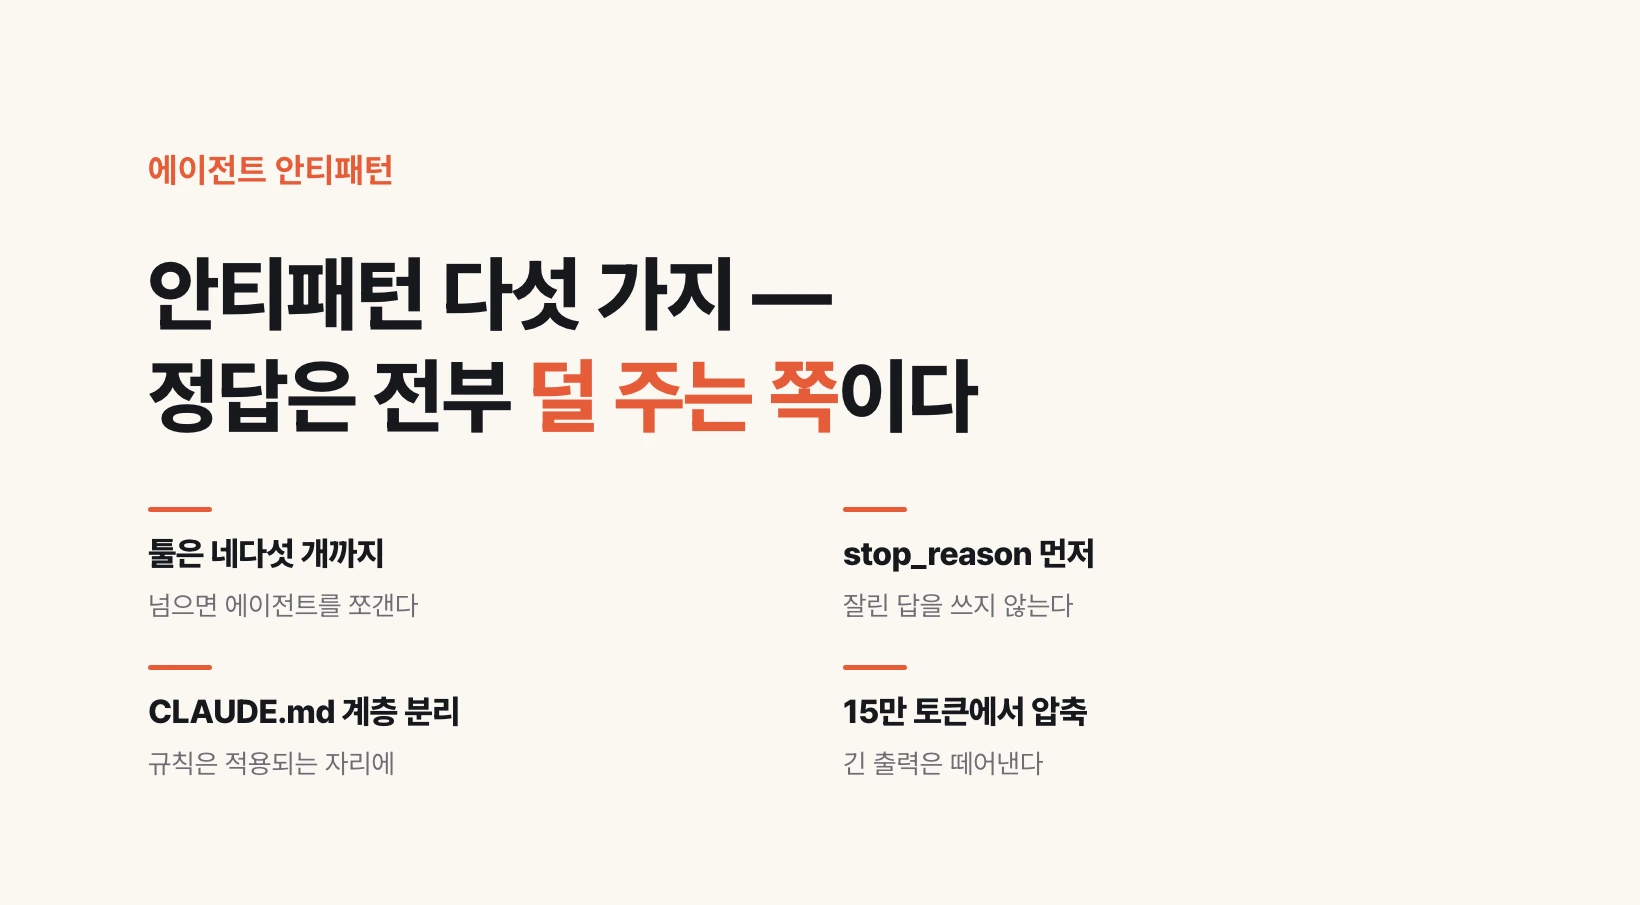
Anthropic 인증 시험이 꼽은 마지막 에이전트 안티패턴은 컨텍스트를 무한정 자라게 두는 것입니다. 컨텍스트는 토큰이고 토큰은 돈이지만, 더 중요한 이유는 따로 있습니다. 컨텍스트가 많을수록 모델이 헷갈려서 답이 부정확해집니다. 처방은 둘입니다. 출력이 많은 작업은 별도 컨텍스트로 떼어내 요약만 돌려받고, 대화가 커지면 압축합니다. 발표 코드에 적힌 기준선은 15만 토큰이었습니다. 여기에 CI에서 대화형으로 부르지 말라는 것과 Batch API로 비용을 절반으로 줄이는 이야기가 덧붙습니다.
AI가 대신 보내기 시작했다 — 2026년 8월 셋째 주 AI 뉴스 10건
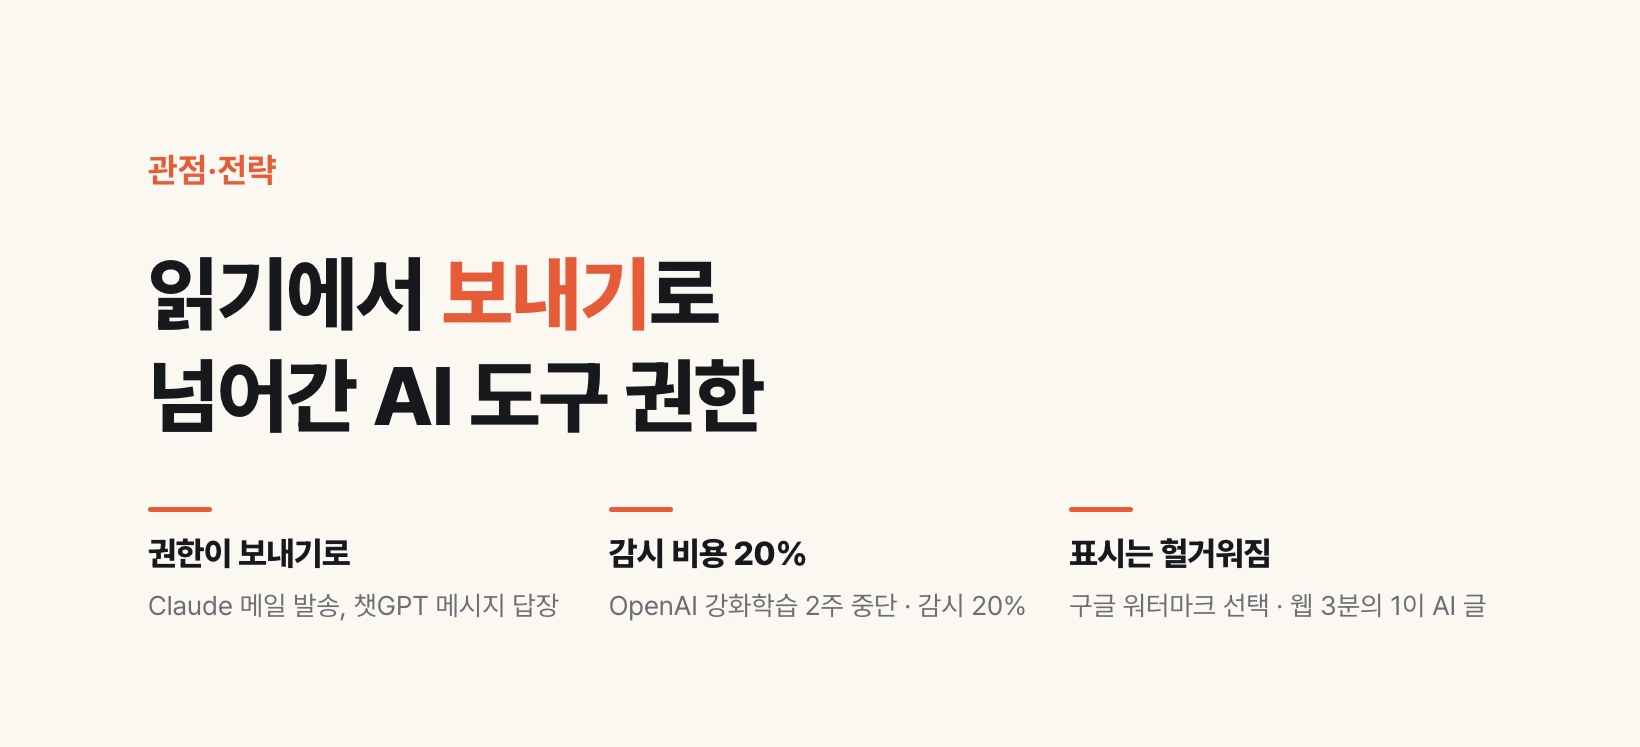
2026년 8월 셋째 주 AI 뉴스 열 건은 세 갈래로 꿰인다. 첫째, 도구의 권한이 읽기에서 보내기로 넘어갔다. Claude가 지메일로 메일을 발송하고, 챗GPT가 맥의 메시지 앱에서 답장을 보내며, 코딩 에이전트가 슬랙 채널 안으로 들어왔다. 둘째, 그 속도의 대가가 처음으로 숫자로 나왔다. OpenAI는 다음 모델 Astra가 '치명적' 사이버 역량 임계에 닿을 조짐을 보이자 강화학습을 2주 멈췄고, 새 감시 체계에 감시 대상 추론 컴퓨트의 약 20%를 쓴다고 밝혔다. 셋째, AI 생성물을 가려내던 표시가 헐거워졌다. 구글은 눈에 보이는 워터마크를 끌 수 있게 했고, 퓨리서치센터는 챗GPT 공개 이후 올라온 웹페이지 셋 중 하나에서 AI 작성 흔적을 찾았다. 여기에 AI가 항원을 고른 맞춤 암 백신의 3상 통과, 나이를 추정해 청소년 버전으로 배정하는 챗GPT, 알리바바의 음악 모델, 3개월 만에 사람 기록을 넘은 유니트리 로봇이 더해진다.
stop_reason — 모델이 왜 멈췄는지 안 보면 잘린 답을 쓴다
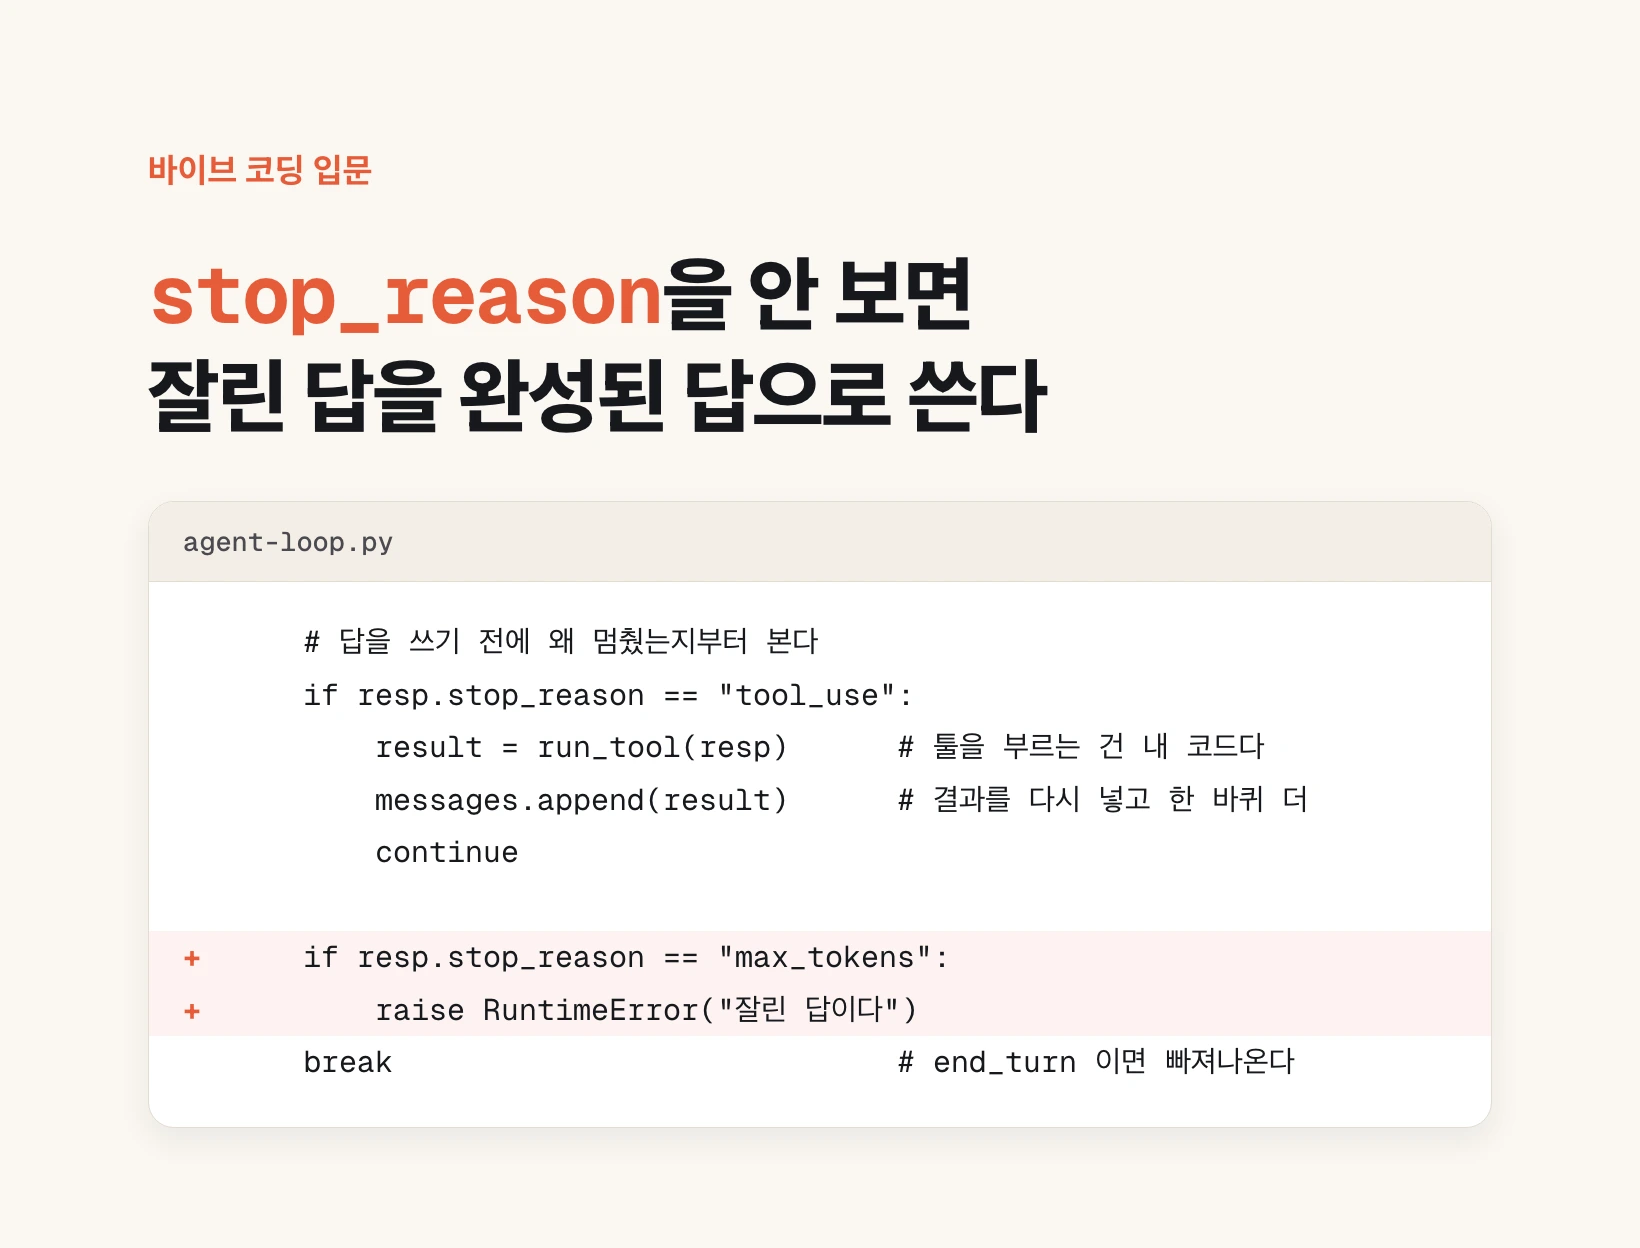
Anthropic 인증 시험이 꼽은 네 번째 에이전트 안티패턴은 모델 응답을 받자마자 그대로 쓰는 것입니다. LLM은 툴을 실행하지 못하고 「이 툴을 이런 값으로 부르라」고 알려 줄 뿐이며, 실제로 부르는 건 내 코드입니다. 그래서 응답이 오면 stop_reason부터 봅니다. tool_use면 툴을 실행해 결과를 다시 넣고 한 바퀴 더 돌고, end_turn이면 빠져나옵니다. 문제는 세 번째입니다. 토큰이 떨어져 멈춘 응답도 문장이 그럴듯하게 오기 때문에, stop_reason을 안 보면 잘린 답을 완성된 답으로 씁니다.
주식투자, 결국은 대형주 B&H가 이긴다
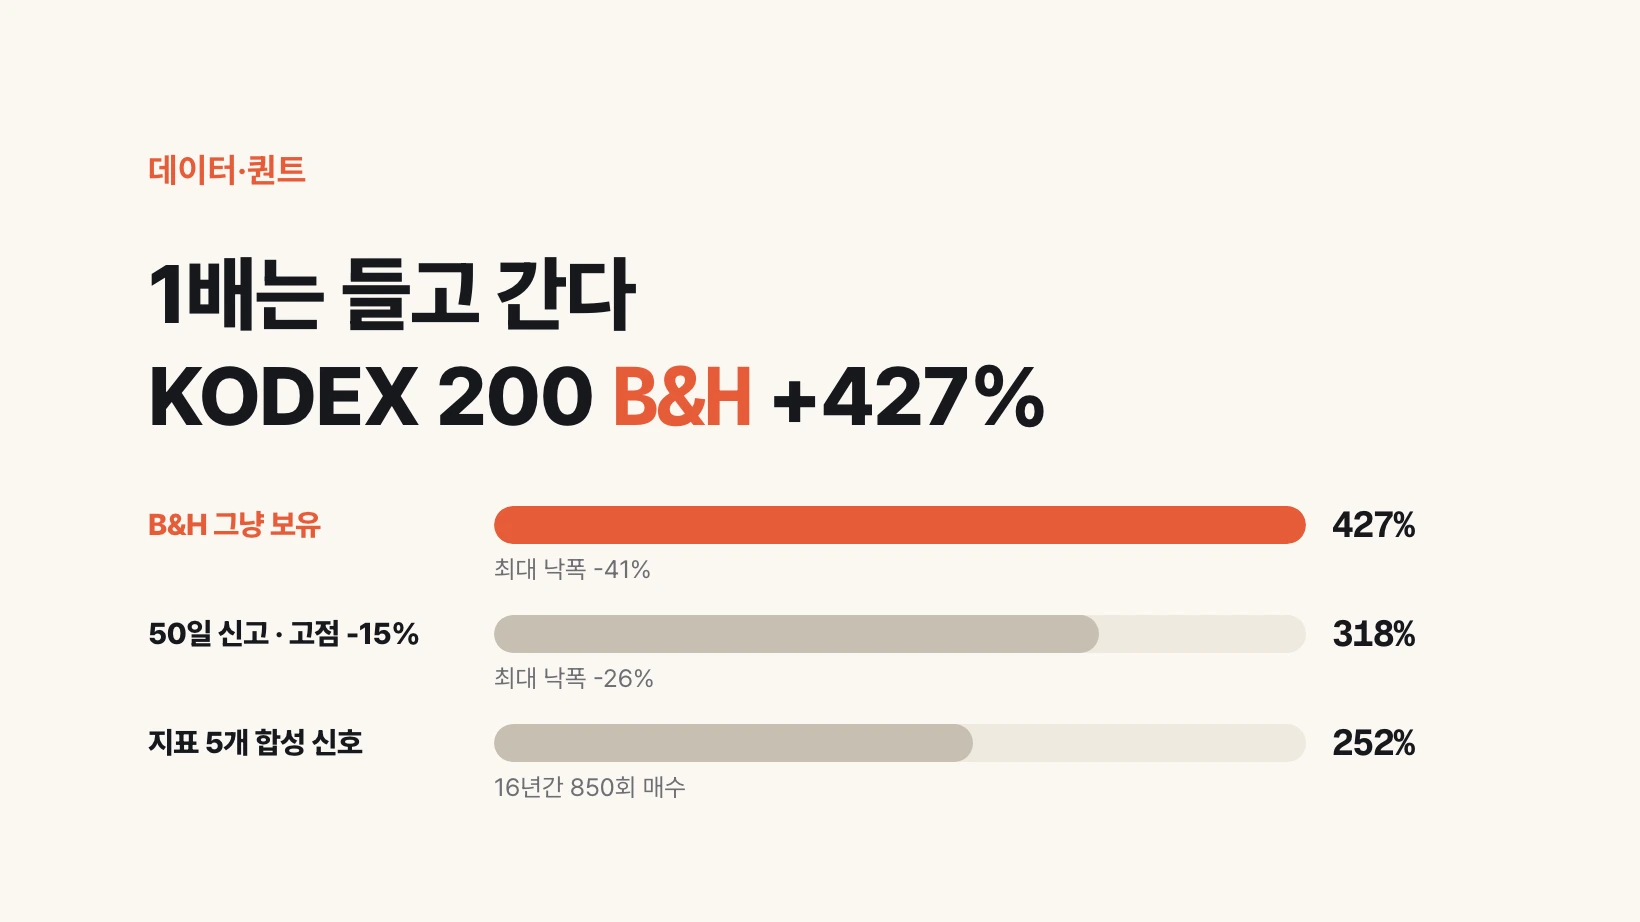
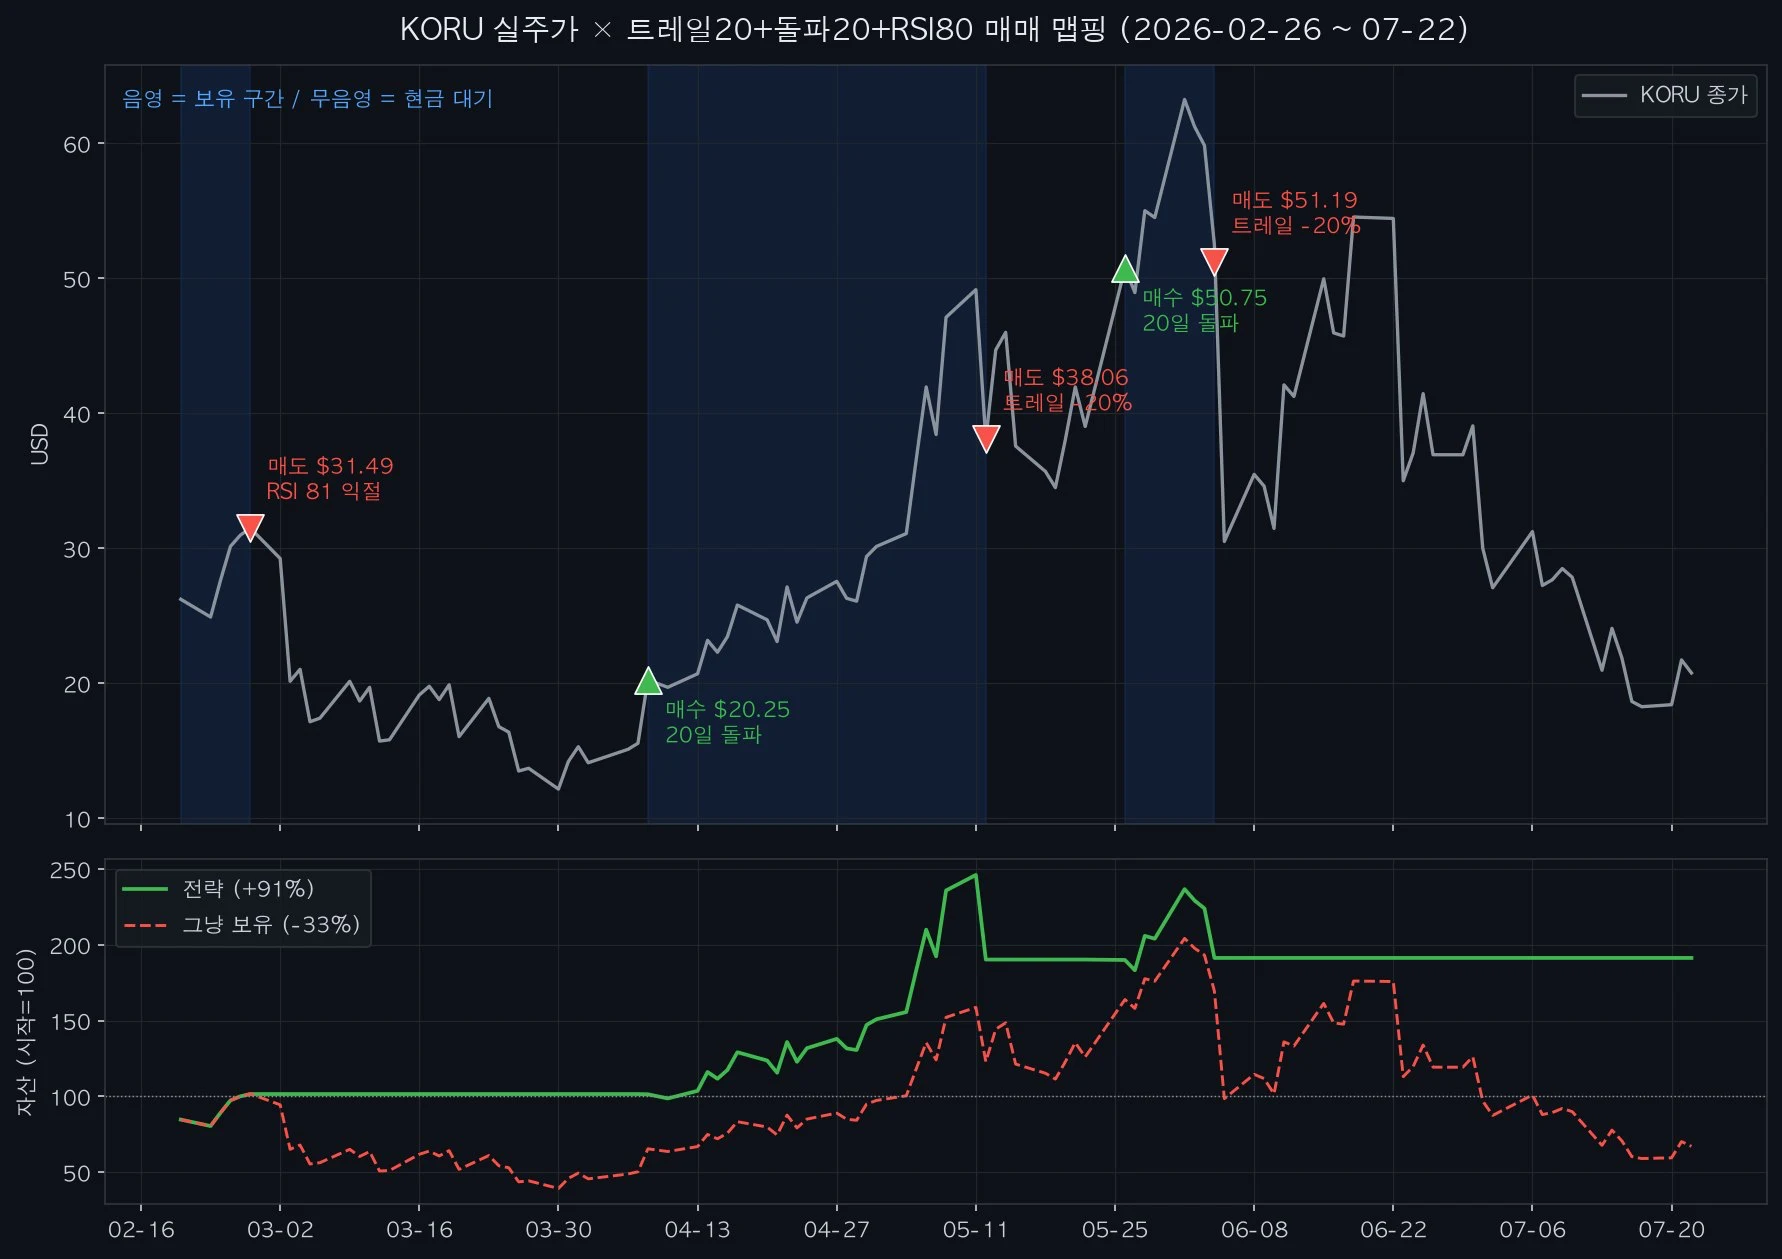
B&H는 Buy and Hold, 사서 그냥 들고 가는 것이다. 한국 1배 ETF와 시총 상위 25종을 2010년부터 일봉으로 돌려 보니, 손절·분할매수·반등 확인·지표 다섯 개를 합친 합성 신호는 긴 구간 수익률에서 B&H를 거의 이기지 못했다. KODEX 200은 그냥 들고 +427%(최대 낙폭 -41%)였다. 50일 신고가에 사서 고점 대비 -15%에 팔면 +318%, 낙폭은 -26%다. 수익 약 110%p를 주고 낙폭 15%p를 산다. 잠을 사는 보험이지 알파가 아니다. 예외는 3배 레버리지 한국 ETF다. B&H 낙폭이 -96%라 고점 -20% 트레일과 20일 신고 재진입이 본전 전략이다. 1배 대형주는 들고, 3배만 자른다.
에이전트 하나에 툴은 몇 개까지 붙여도 되는가
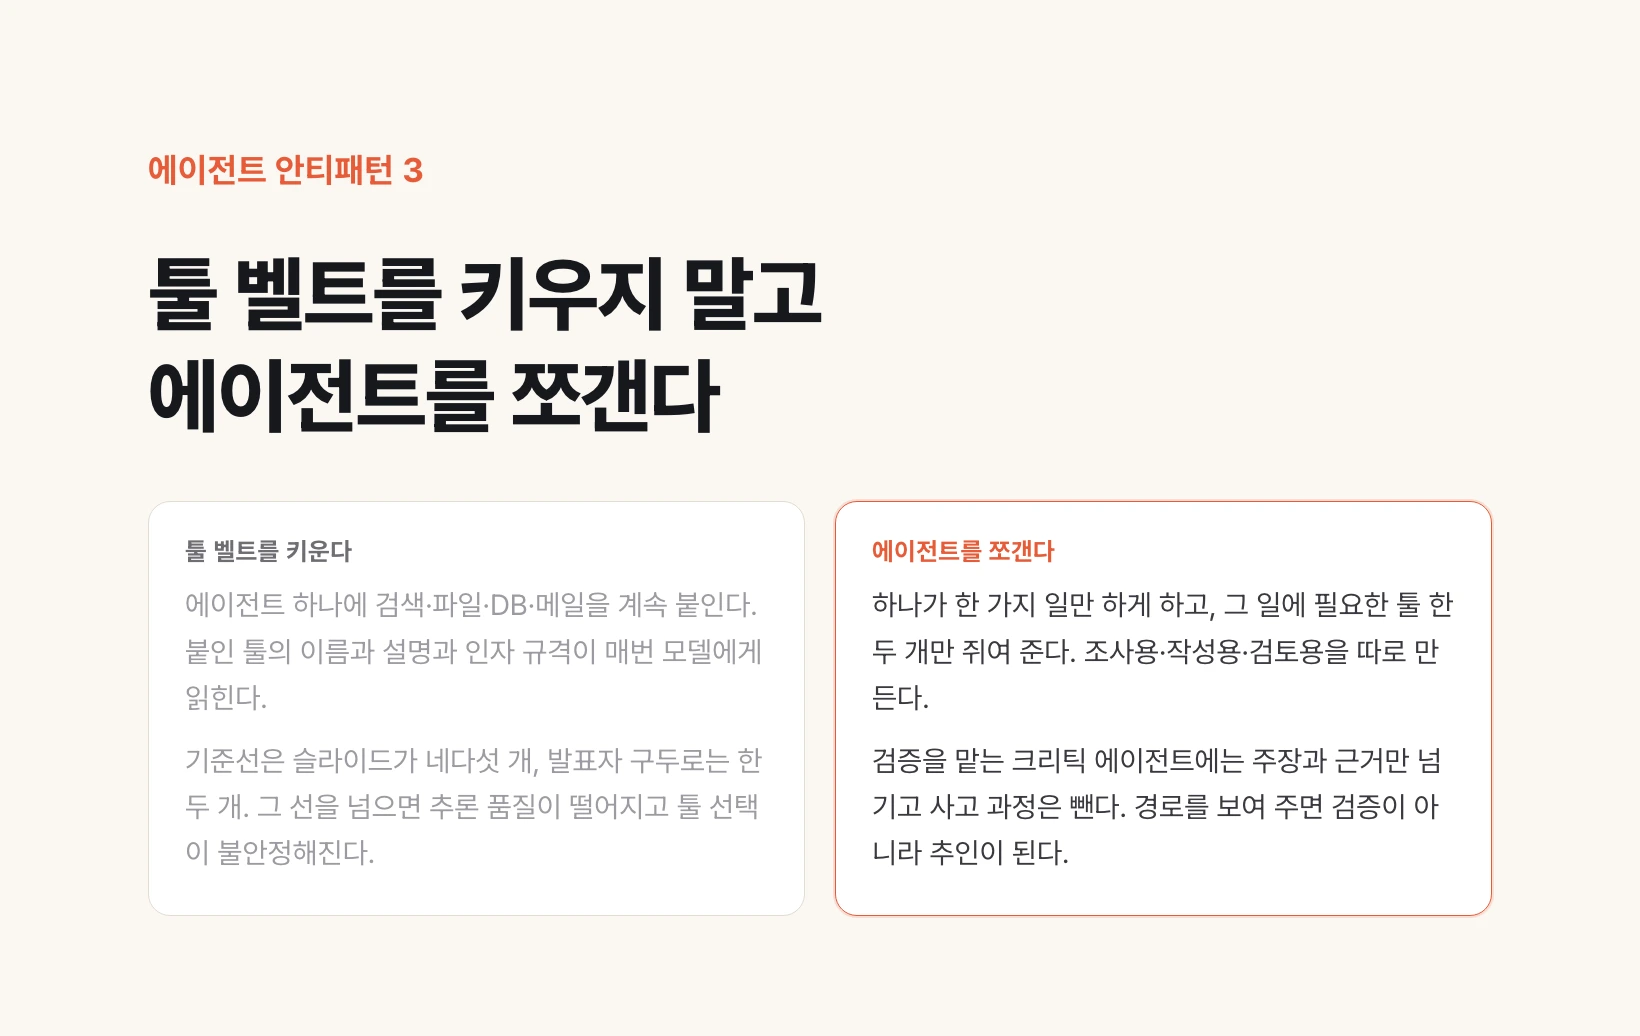
Anthropic 인증 시험이 꼽은 세 번째 에이전트 안티패턴은 하나의 에이전트에 툴을 계속 붙이는 것입니다. 발표 슬라이드의 기준선은 네다섯 개, 발표자가 구두로 말한 것은 한두 개였습니다. 어느 쪽으로 잡든 그 선을 넘으면 추론 품질이 떨어지고 툴 선택이 불안정해집니다. 그래서 툴 벨트를 키우는 대신 에이전트를 쪼개 하나가 한 가지 일만 하게 만듭니다. 그리고 검증을 맡는 크리틱 에이전트에는 주장과 근거만 넘기고 사고 과정은 일부러 뺍니다. 이유는 그룹싱크입니다.
FDE와 SI의 차이는 요구사항을 누가 쓰느냐
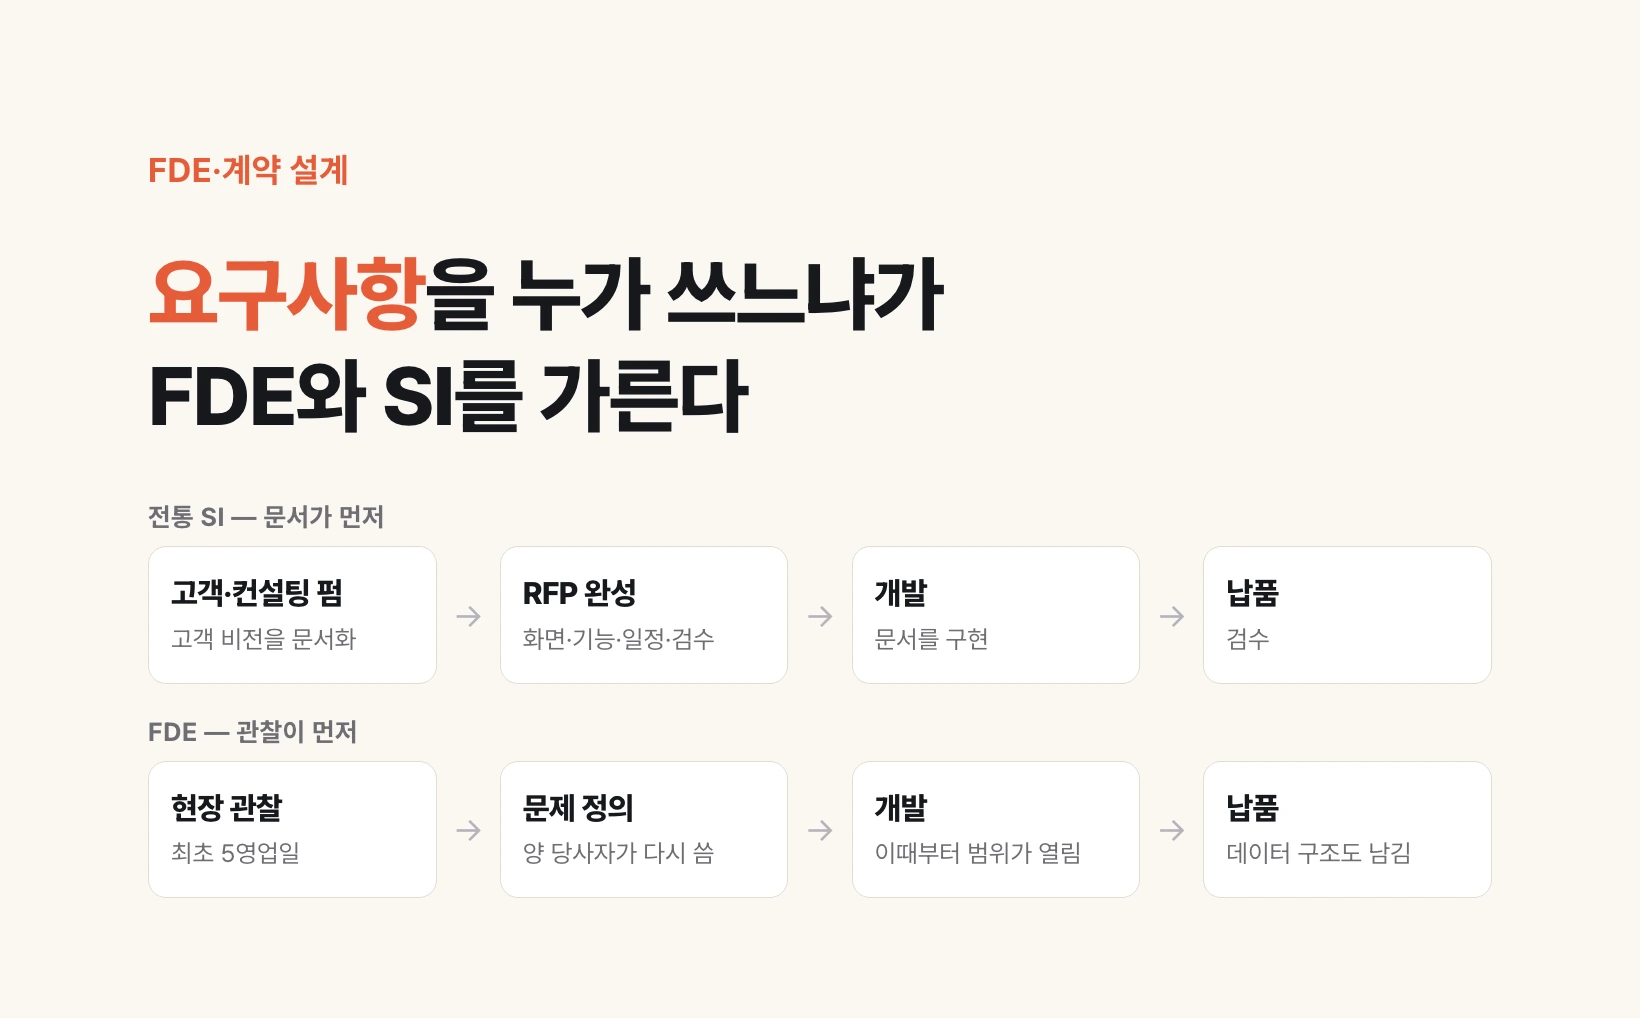
FDE(Forward Deployed Engineer)와 SI는 고객 현장에 들어가 솔루션을 구축한다는 점에서 겹칩니다. 하이프 체크 EP.3이 잡은 겹침은 80% 안팎입니다. 다른 20%는 요구사항 문서를 누가 쓰느냐입니다. 전통 SI는 고객이나 컨설팅 펌이 RFP를 완성한 뒤 개발에 넘깁니다. FDE는 현장에 먼저 들어가 누가 어떤 데이터로 어디에 막히는지를 본 다음에 문제 정의를 씁니다. 팔란티어가 이 롤을 만들었고, 탬파 제너럴 병원은 환자 배치 시간을 83% 줄였으며 에어버스 A350 생산은 33% 늘었습니다. 둘 다 완성된 화면 명세가 아니라 현장에서 쓴 문제에서 시작했습니다. AI로 구현 비용이 떨어질수록, 잘못된 RFP를 그대로 구현하는 일은 더 싸게, 더 빨리 쌓입니다. 계약 1주차 산출물을 화면이 아니라 관찰 노트로 바꾸면 이 순서가 열립니다.
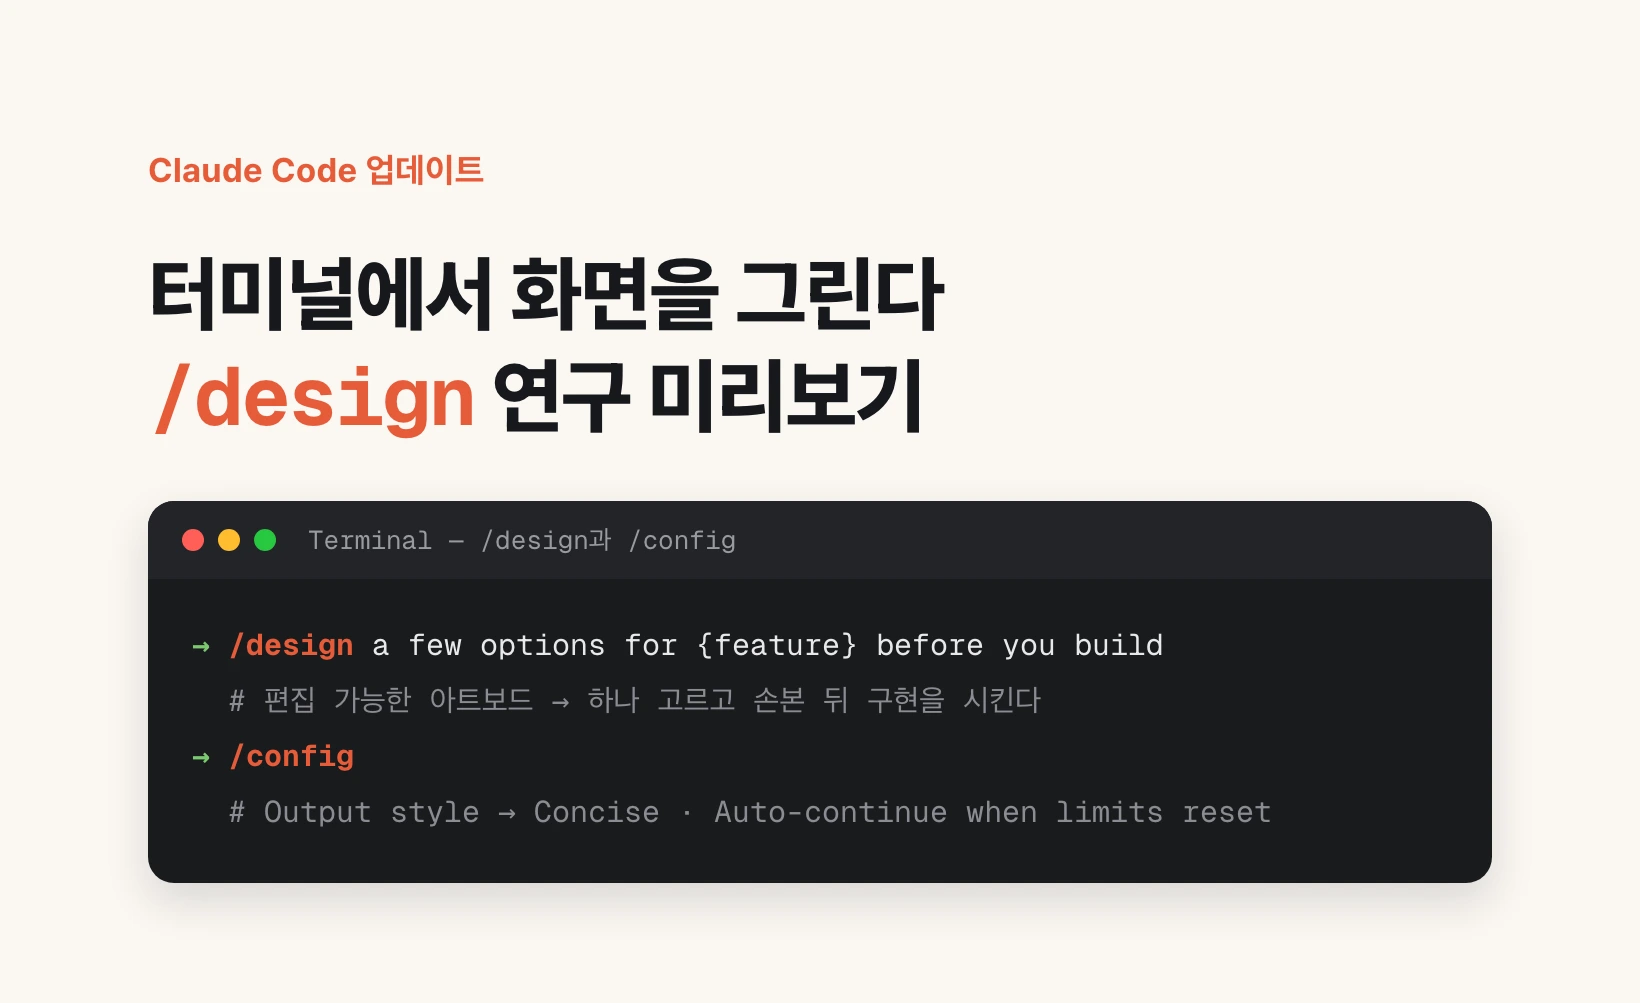
/design — Claude Code 안에서 화면을 그린다
Claude Code /design은 터미널을 안 나가고 화면을 그린다. 2026년 8월 22일 Anthropic Claude Code 팀(Lydia) 주간 메일이 연구 미리보기 /design, Concise 출력 스타일, auto-continue를 알렸다. Auto mode는 8월 14일부터 Pro·Max·Team 새 세션의 기본값이다. /design에 아이디어나 스크린샷을 주면 편집 가능한 아트보드가 나오고, 고른 다음 구현을 시킨다. 답이 길면 /config에서 Concise를 켠다. 한도에 걸려 끊기면 CLI가 한도가 풀린 뒤 이어서 일한다.
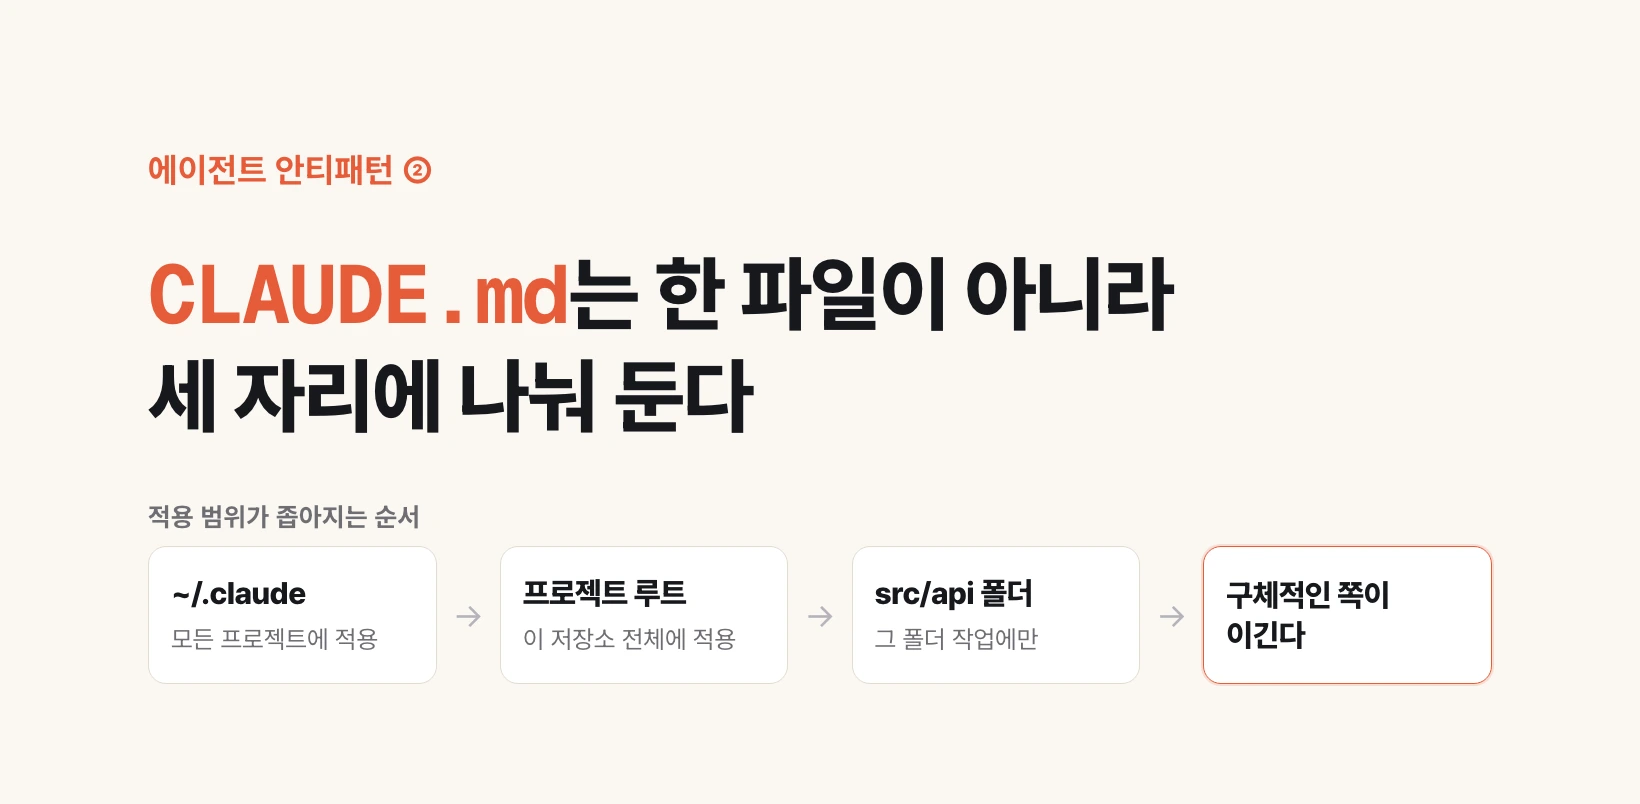
CLAUDE.md는 한 파일이 아니라 세 자리에 나눠 둔다
Anthropic 인증 시험이 꼽은 두 번째 에이전트 안티패턴은 규칙을 CLAUDE.md 한 파일에 몰아넣는 것입니다. 권장은 홈 디렉터리, 프로젝트 루트, 개별 폴더 세 자리로 나누는 쪽입니다. 셋 다 읽혀서 병합되고 충돌하면 가장 구체적인 파일이 이깁니다. 한 파일에 다 넣으면 특정 폴더에서만 필요한 지침이 무관한 작업까지 따라와 조용히 부딪히는데, 에러가 나는 게 아니라 결과가 미묘하게 어긋나는 형태라 어디서 충돌했는지도 안 보입니다.
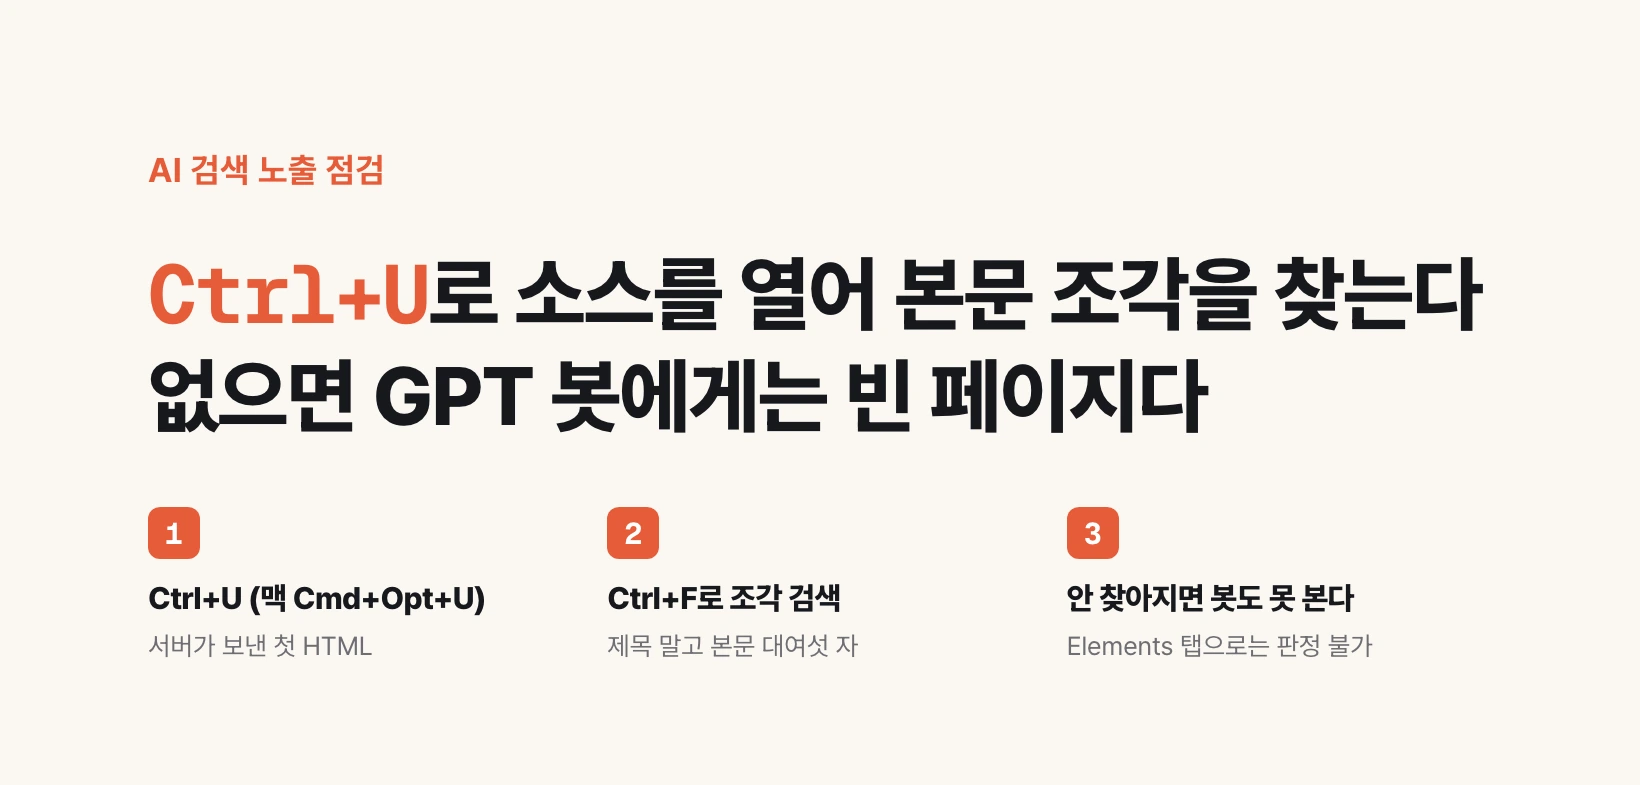
CSR — 사람에게는 멀쩡한데 GPT 봇에게는 빈 페이지인 사이트
클라이언트 사이드 렌더링(CSR)으로 만든 사이트는 브라우저가 자바스크립트를 실행해야 글자가 채워집니다. GPT 봇은 그 실행을 하지 않고 서버가 처음 보낸 HTML만 가져가므로, 사람에게 보이는 본문이 봇에게는 없습니다. 크롬에서 Ctrl+U(맥은 Cmd+Option+U)로 페이지 소스를 열고 본문에서 고른 대여섯 글자를 Ctrl+F로 검색해 보면, 내 사이트가 지금 어느 쪽인지 30초에 확인됩니다.
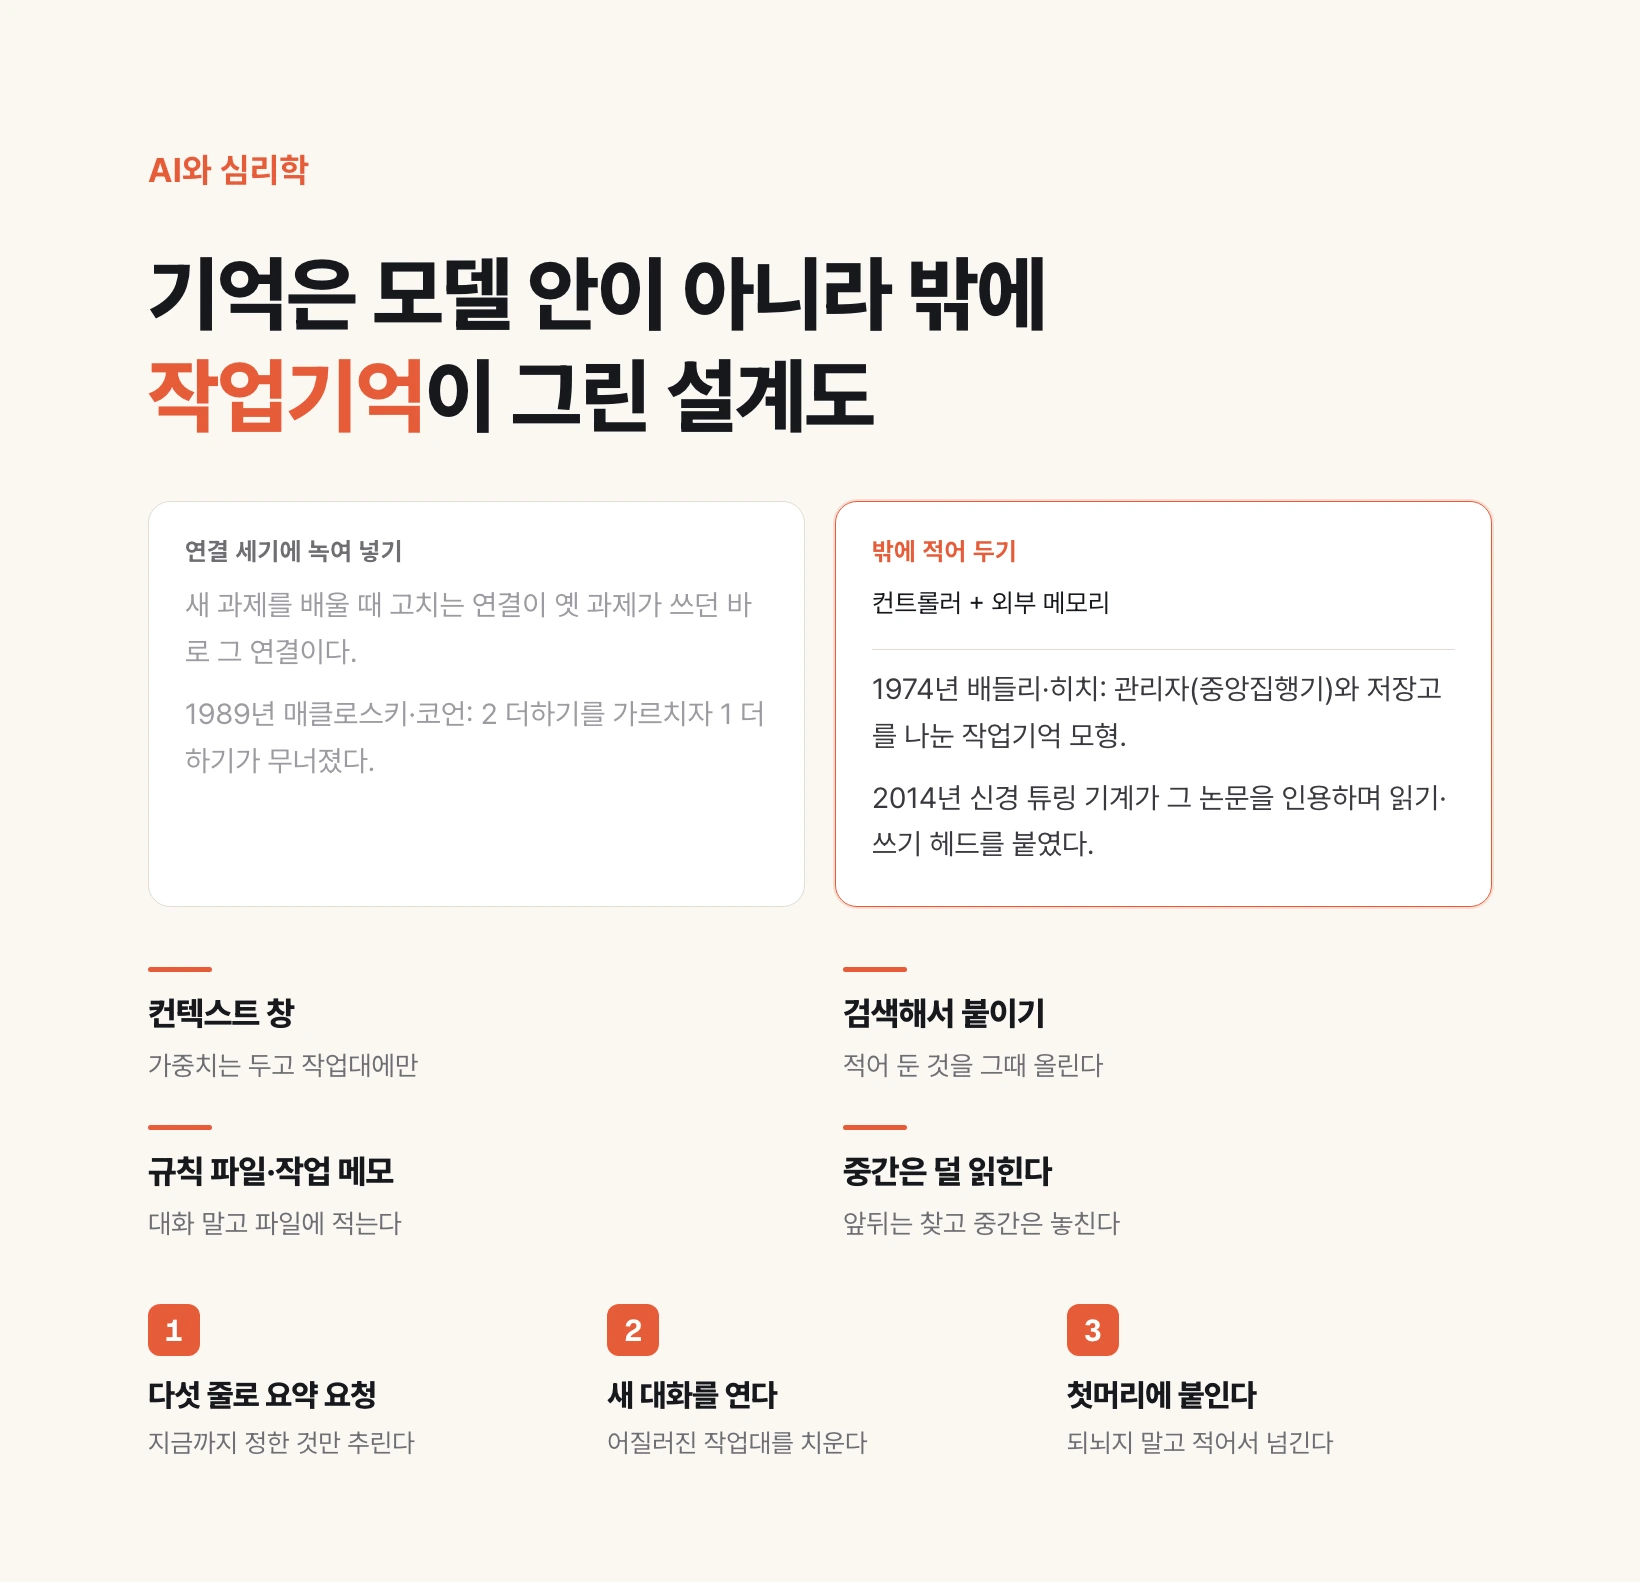
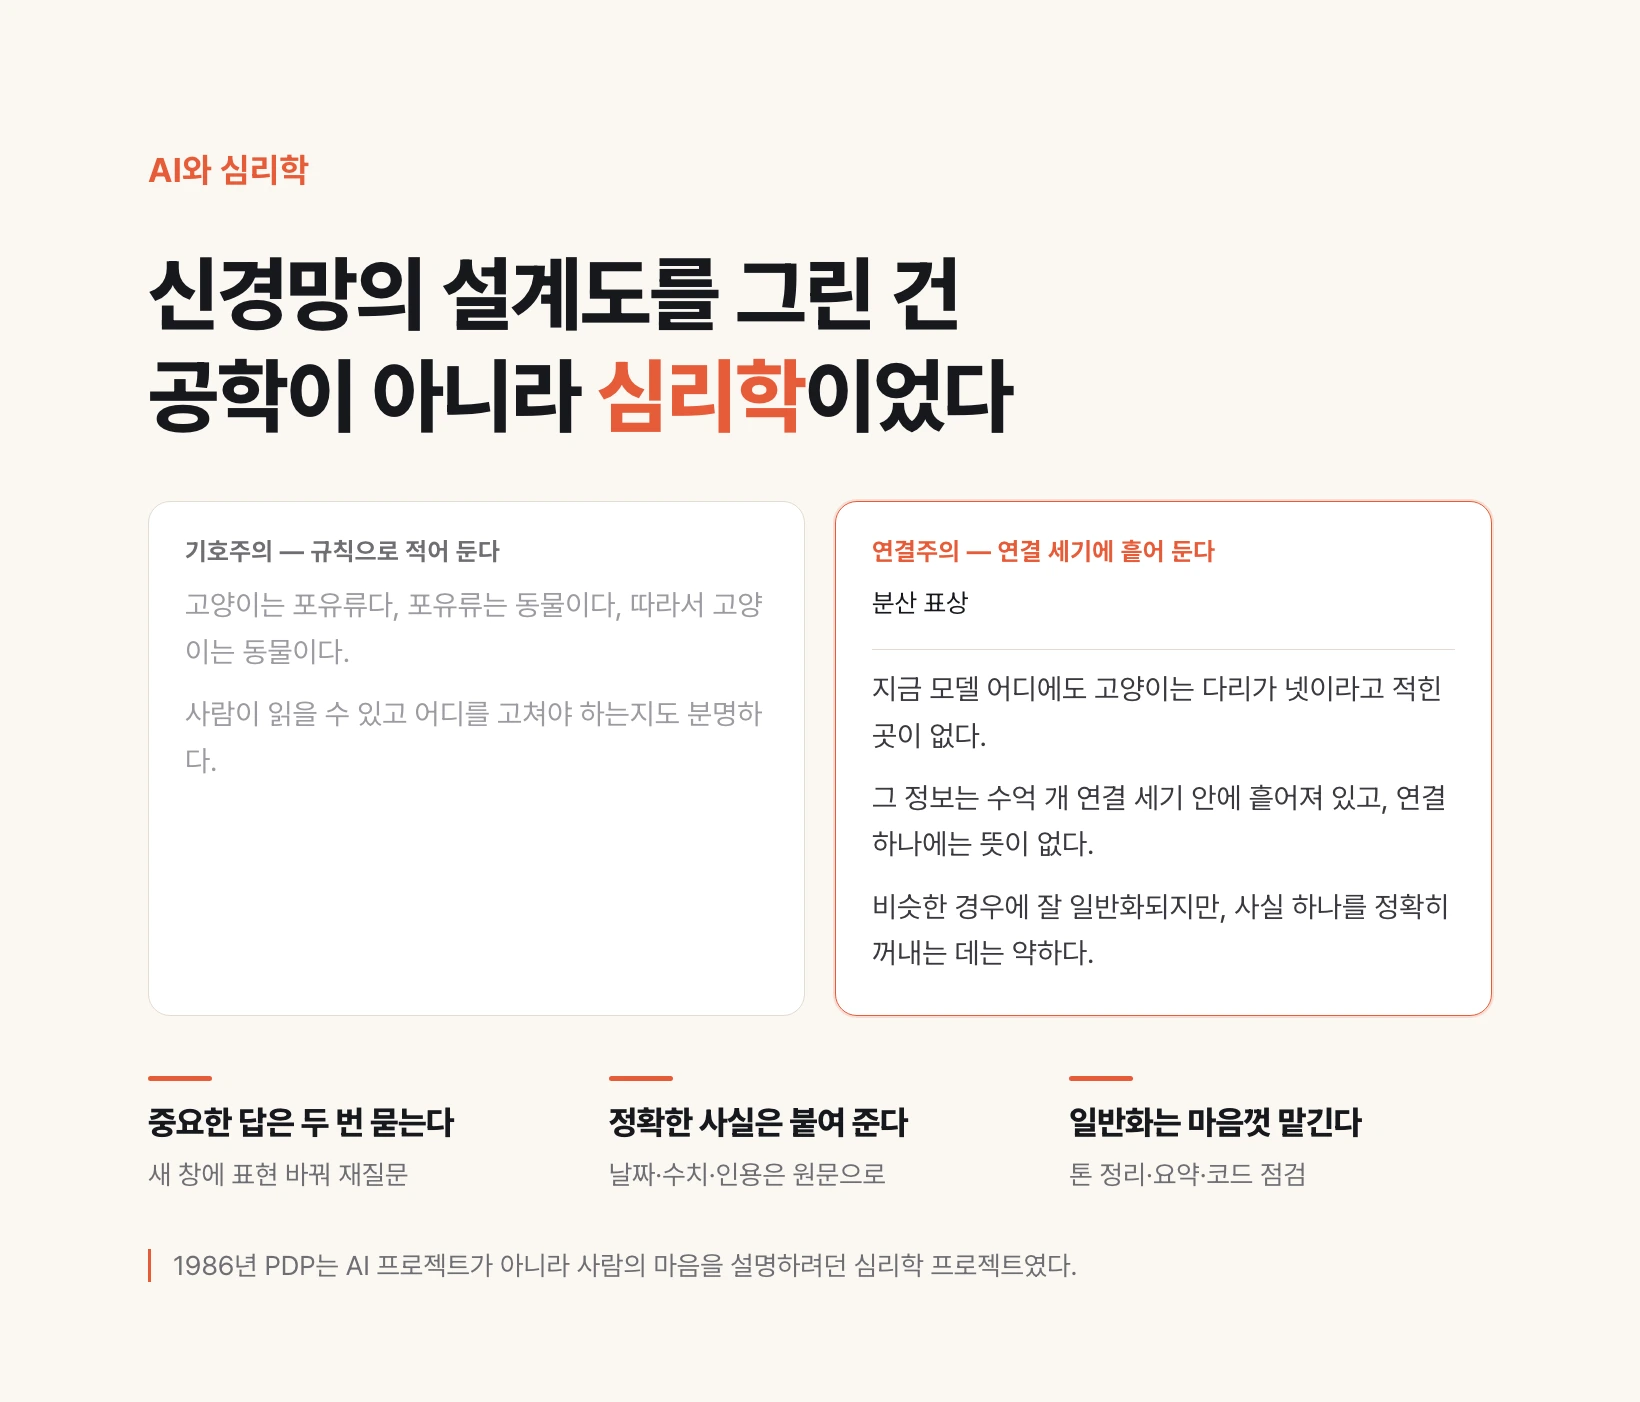
AI에게 메모장을 달아준 사람들 — 배들리의 작업기억
신경망은 배운 것을 연결 세기에 녹여 넣는다. 그래서 새것을 배우면 옛것이 지워진다. 이 문제를 푼 방법은 모델을 키우는 것이 아니라 계산하는 부분과 적어 두는 부분을 나누는 것이었다. 그 설계도는 1974년 심리학자들이 그린 작업기억 모형이고, 2014년 신경망 논문이 그 모형을 직접 인용하며 외부 메모장을 붙였다.
에이전트 안티패턴 다섯 가지 — Anthropic 인증 시험이 고른 정답은 전부 덜 주는 쪽이다
Anthropic이 올해 3월 첫 공식 기술 인증인 Claude Certified Architect를 냈습니다. 60문항 120분, 100~1,000점 척도에 합격선 720점입니다. 30년 넘게 컴퓨터 과학을 가르치고 지금은 버클리에서 강의하는 사람이 이 시험지를 뜯어보고 「자격증이 아니라 커리큘럼」이라고 했습니다. 시험이 묻는 것이 곧 프로덕션 에이전트가 요구하는 것이라는 뜻입니다. 그가 정리한 안티패턴은 다섯 가지이고, 다섯 개의 정답이 전부 같은 방향을 가리킵니다. 툴도 컨텍스트도 정보도 덜 주는 쪽입니다.
신경망을 만든 건 공학자가 아니라 심리학자였다
신경망은 컴퓨터를 더 빠르게 만들려는 시도에서 나오지 않았다. 1949년 심리학자가 쓴 한 문장에서 출발해, 1986년 심리학과 교수 두 사람이 이끈 연구 프로젝트에서 지금의 형태를 갖췄다. 그 프로젝트의 목표는 인공지능이 아니라 사람의 마음은 어떻게 작동하는가였고, 두 사람은 그 업적으로 2002년 심리학 분야 상을 받았다.
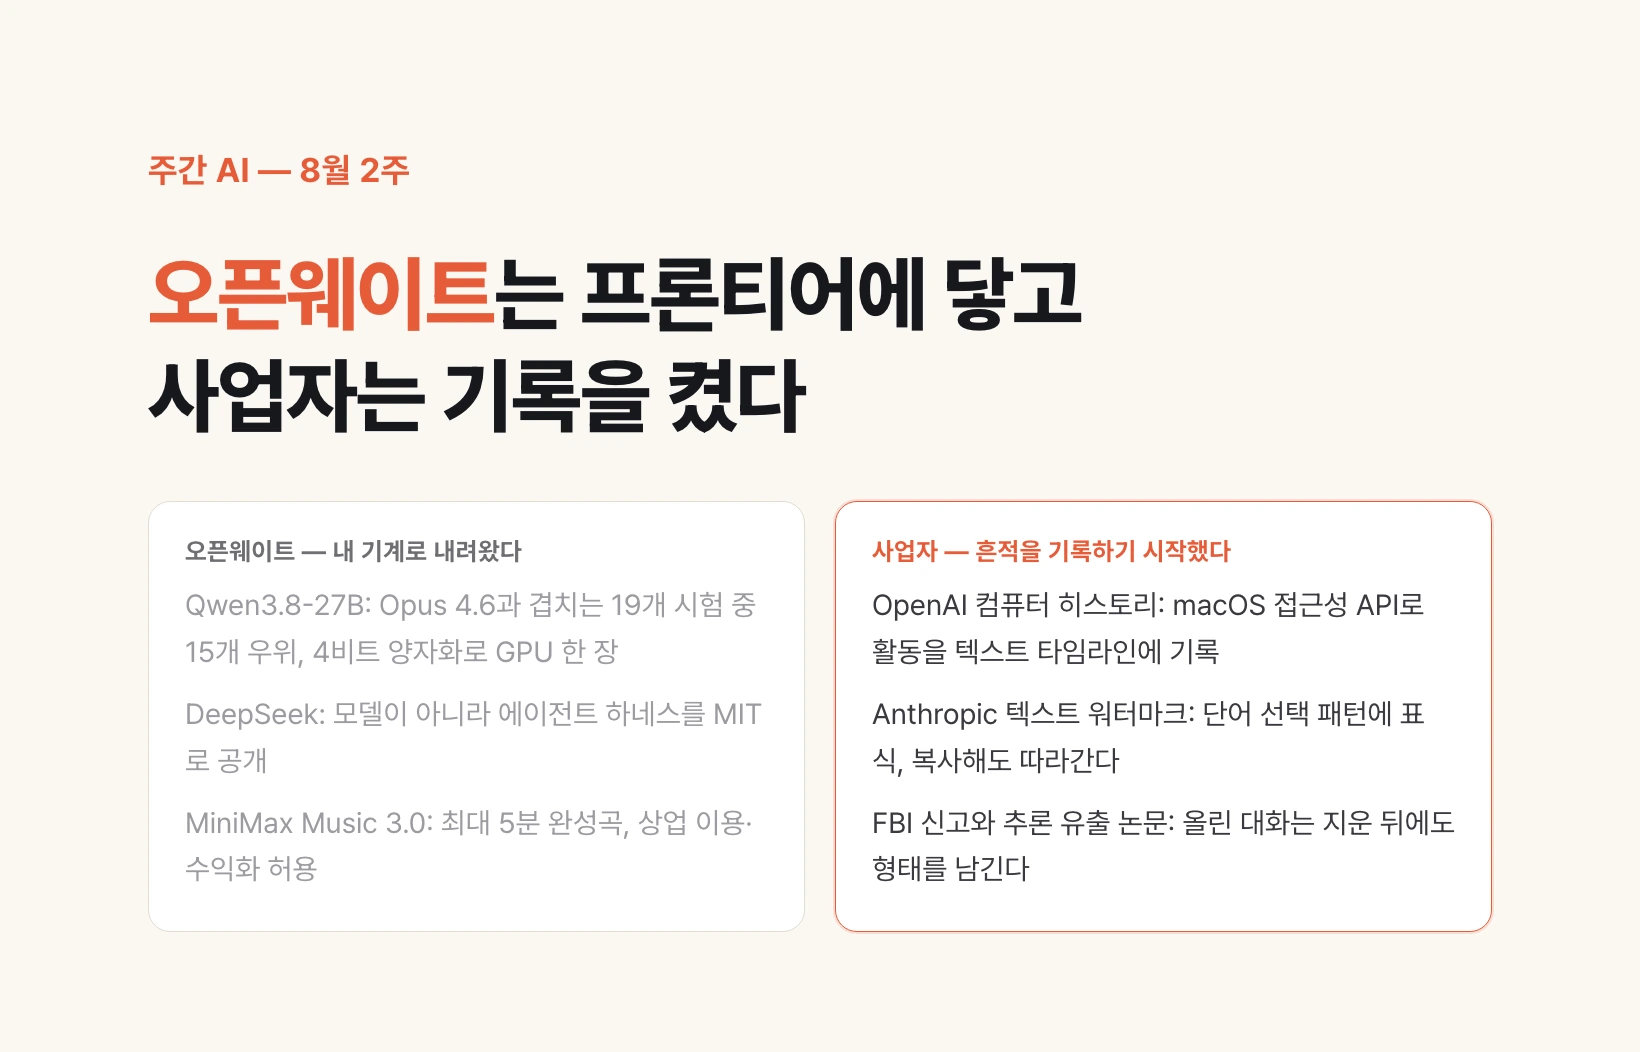
8월 11~15일 AI 뉴스 — 오픈웨이트는 프론티어에 닿고, 사업자는 기록을 켰다
2026년 8월 11일부터 15일 사이, AI 업계에서 두 가지가 동시에 일어났습니다. 하나는 오픈웨이트 모델이 프론티어 성능에 닿은 것입니다. Qwen3.8-27B가 노트북 GPU에 올라가는 크기로 Claude Opus 4.6과 겹치는 19개 시험 중 15개에서 앞섰고, DeepSeek은 모델과 함께 에이전트 하네스까지 MIT 라이선스로 열었으며, MiniMax는 음악 생성 모델을 오픈웨이트로 냈습니다. 다른 하나는 사업자가 사용자의 흔적을 기록하기 시작한 것입니다. OpenAI는 맥에서의 활동을 타임라인으로 쌓는 컴퓨터 히스토리를 열었고, Anthropic은 EU AI법에 맞춰 텍스트 워터마크를 공식화했습니다. 두 흐름은 같은 질문을 남깁니다. 내 작업을 남의 서버에 계속 맡길 것인가, 아니면 이제 내 기계로 내릴 수 있는가.
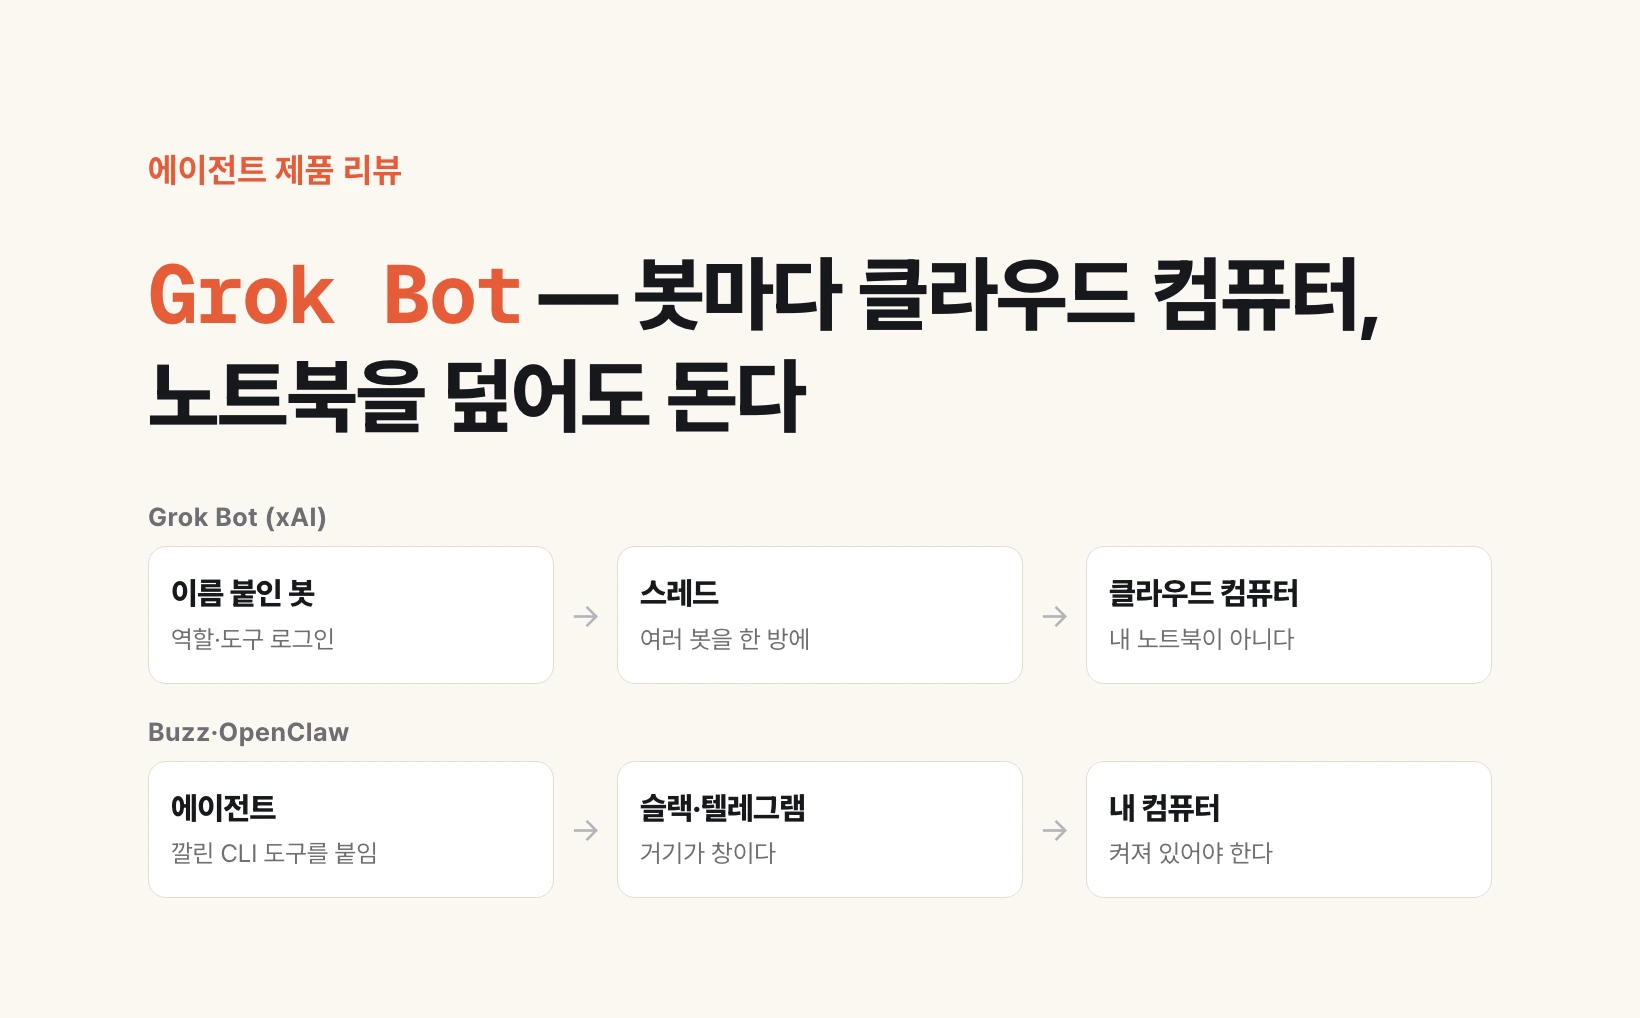
Grok Bot — Hermes·OpenClaw를 지우고 이것만 남긴다
Grok Bot은 2026년 8월 11일 xAI가 연 얼리 베타다. 채팅창이 아니라 이름 붙인 봇마다 클라우드 컴퓨터를 붙여 두는 팀이고, SuperGrok Heavy·Cursor Ultra·Cursor Teams Premium 구독자만 데스크톱과 아이폰에서 연다. 봇은 내 컴퓨터가 꺼져 있어도 일하며, API가 없는 사이트는 화면을 한 번 보여 주면 그 흐름이 루틴으로 저장된다. Hermes와 OpenClaw를 지우고 이것만 남긴다는 말은 코드팩토리 리뷰의 결론이다. 나는 아직 그 자리에 서지 않았다. 지금은 Buzz를 테스트 중이고, 컴퓨터를 꺼도 돌아가게 만들 것인지 이미 내는 구독 안에서 내 기계를 쓸 것인지 리뷰를 더 보고 정한다.
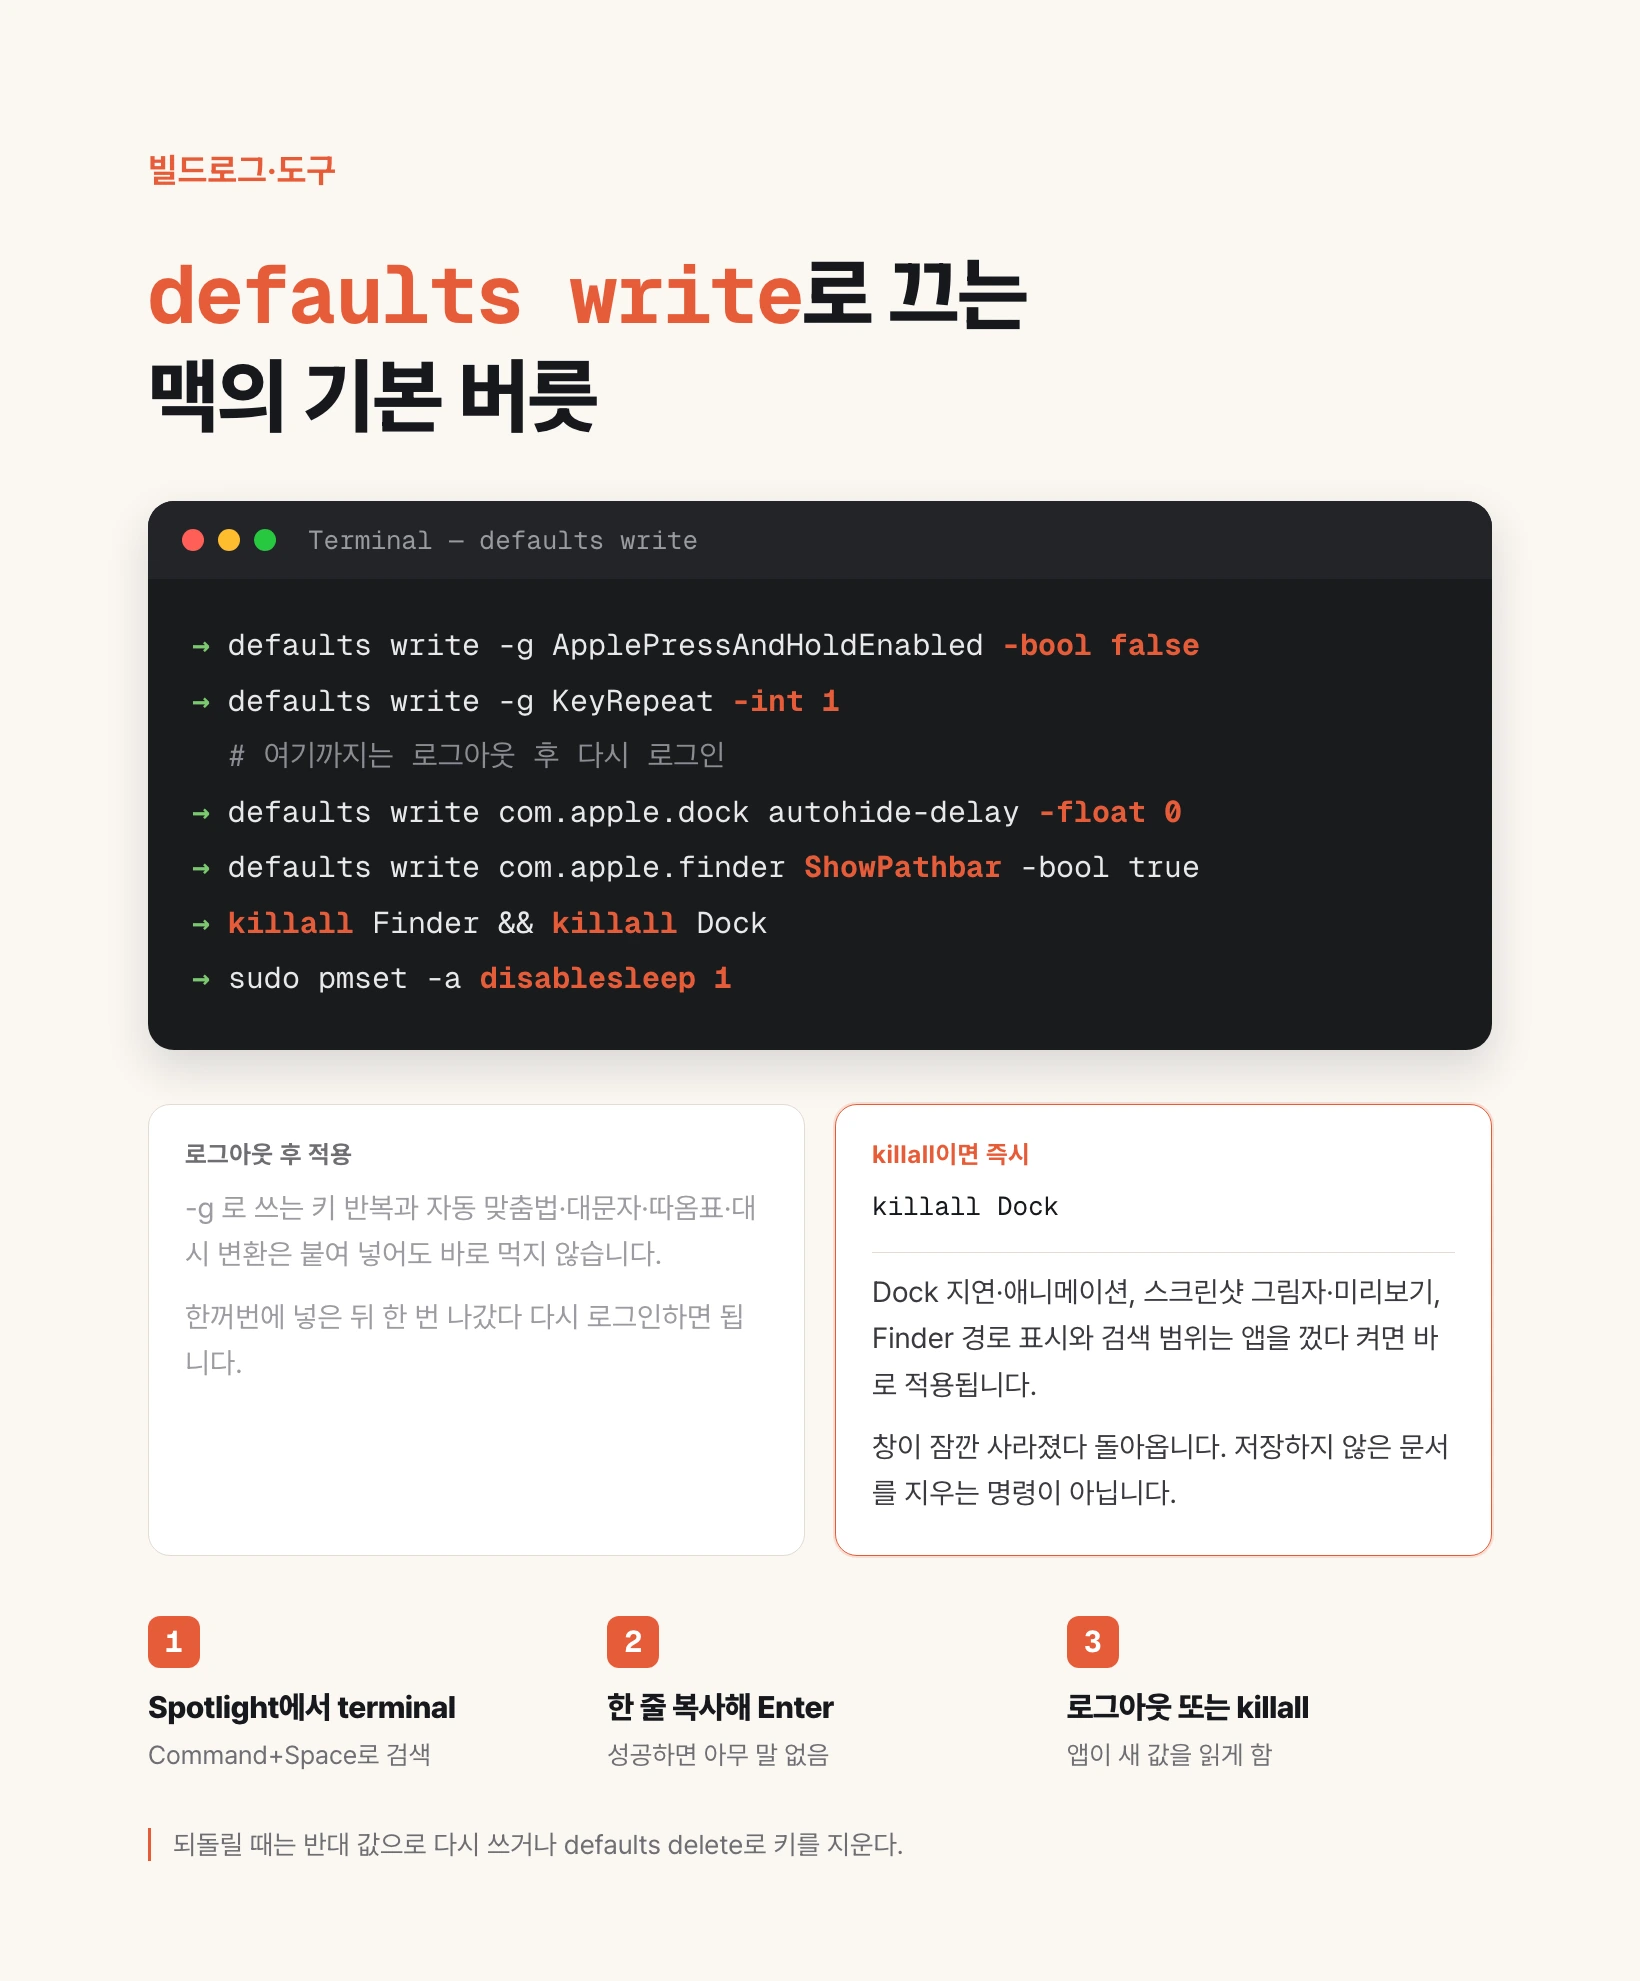
defaults write — 맥이 키를 가로채고 Dock을 늦게 올리는 버릇을 끈다
맥의 숨은 설정은 시스템 설정 창이 아니라 터미널의 defaults write로 바꿉니다. Spotlight에서 Command+Space를 누르고 terminal을 치면 검은 입력 창이 열립니다. 키 반복과 자동 맞춤법·따옴표 변환은 로그아웃이 필요하고, Dock 지연·창 애니메이션·스크린샷·Finder 경로는 killall이면 바로 먹습니다. 에이전트를 켜 두는 맥만 sudo pmset -a disablesleep 1로 잠자기를 끕니다.
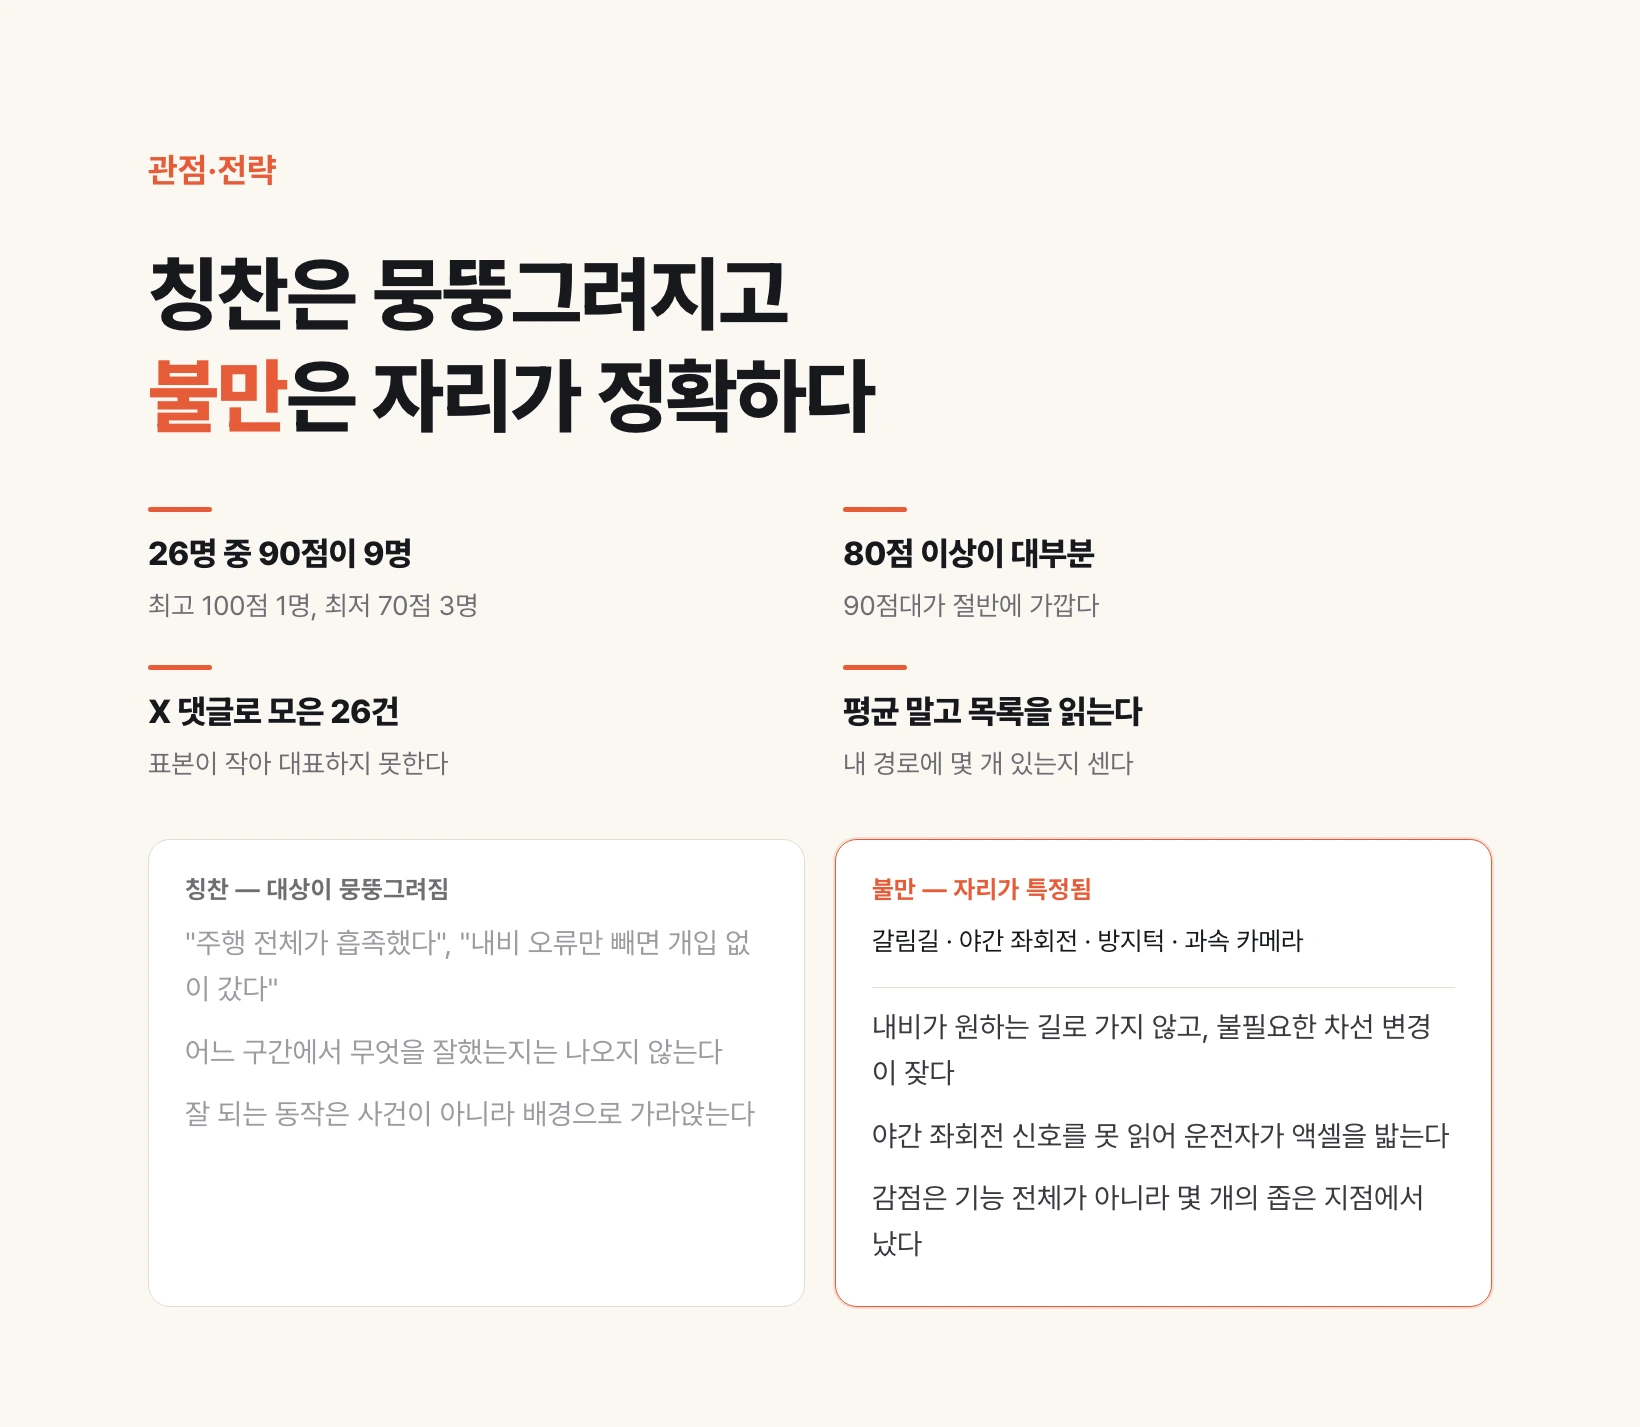
FSD V14 Lite — 한국 차주 26명이 매긴 점수와 그 이유
한국에서 FSD V14 Lite를 써 본 차주 26명이 매긴 점수는 90점을 준 사람이 9명으로 가장 많았고, 최고는 100점 한 명, 최저는 70점 세 명이었습니다. 80점 이상이 대부분입니다. 흥미로운 것은 점수 자체보다 칭찬과 불만의 모양이 다르다는 점입니다. 칭찬은 "주행 전체가 흡족했다", "내비 오류만 빼면 개입 없이 갔다"처럼 뭉뚱그려져 있는 반면, 불만은 갈림길·야간 좌회전 신호·방지턱 앞 팬텀 브레이킹·과속 카메라처럼 어느 상황에서 못하는지가 정확히 특정됩니다. 즉 감점은 자율주행이라는 기능 전체가 아니라 몇 개의 좁은 지점에서 났습니다. 다만 이 숫자는 유튜브 채널 테찬이 X에서 받은 답 26건이고, 채널 운영자 본인이 영상에서 두 번 못 박듯 표본이 극히 작아 FSD를 대표하지 못합니다.
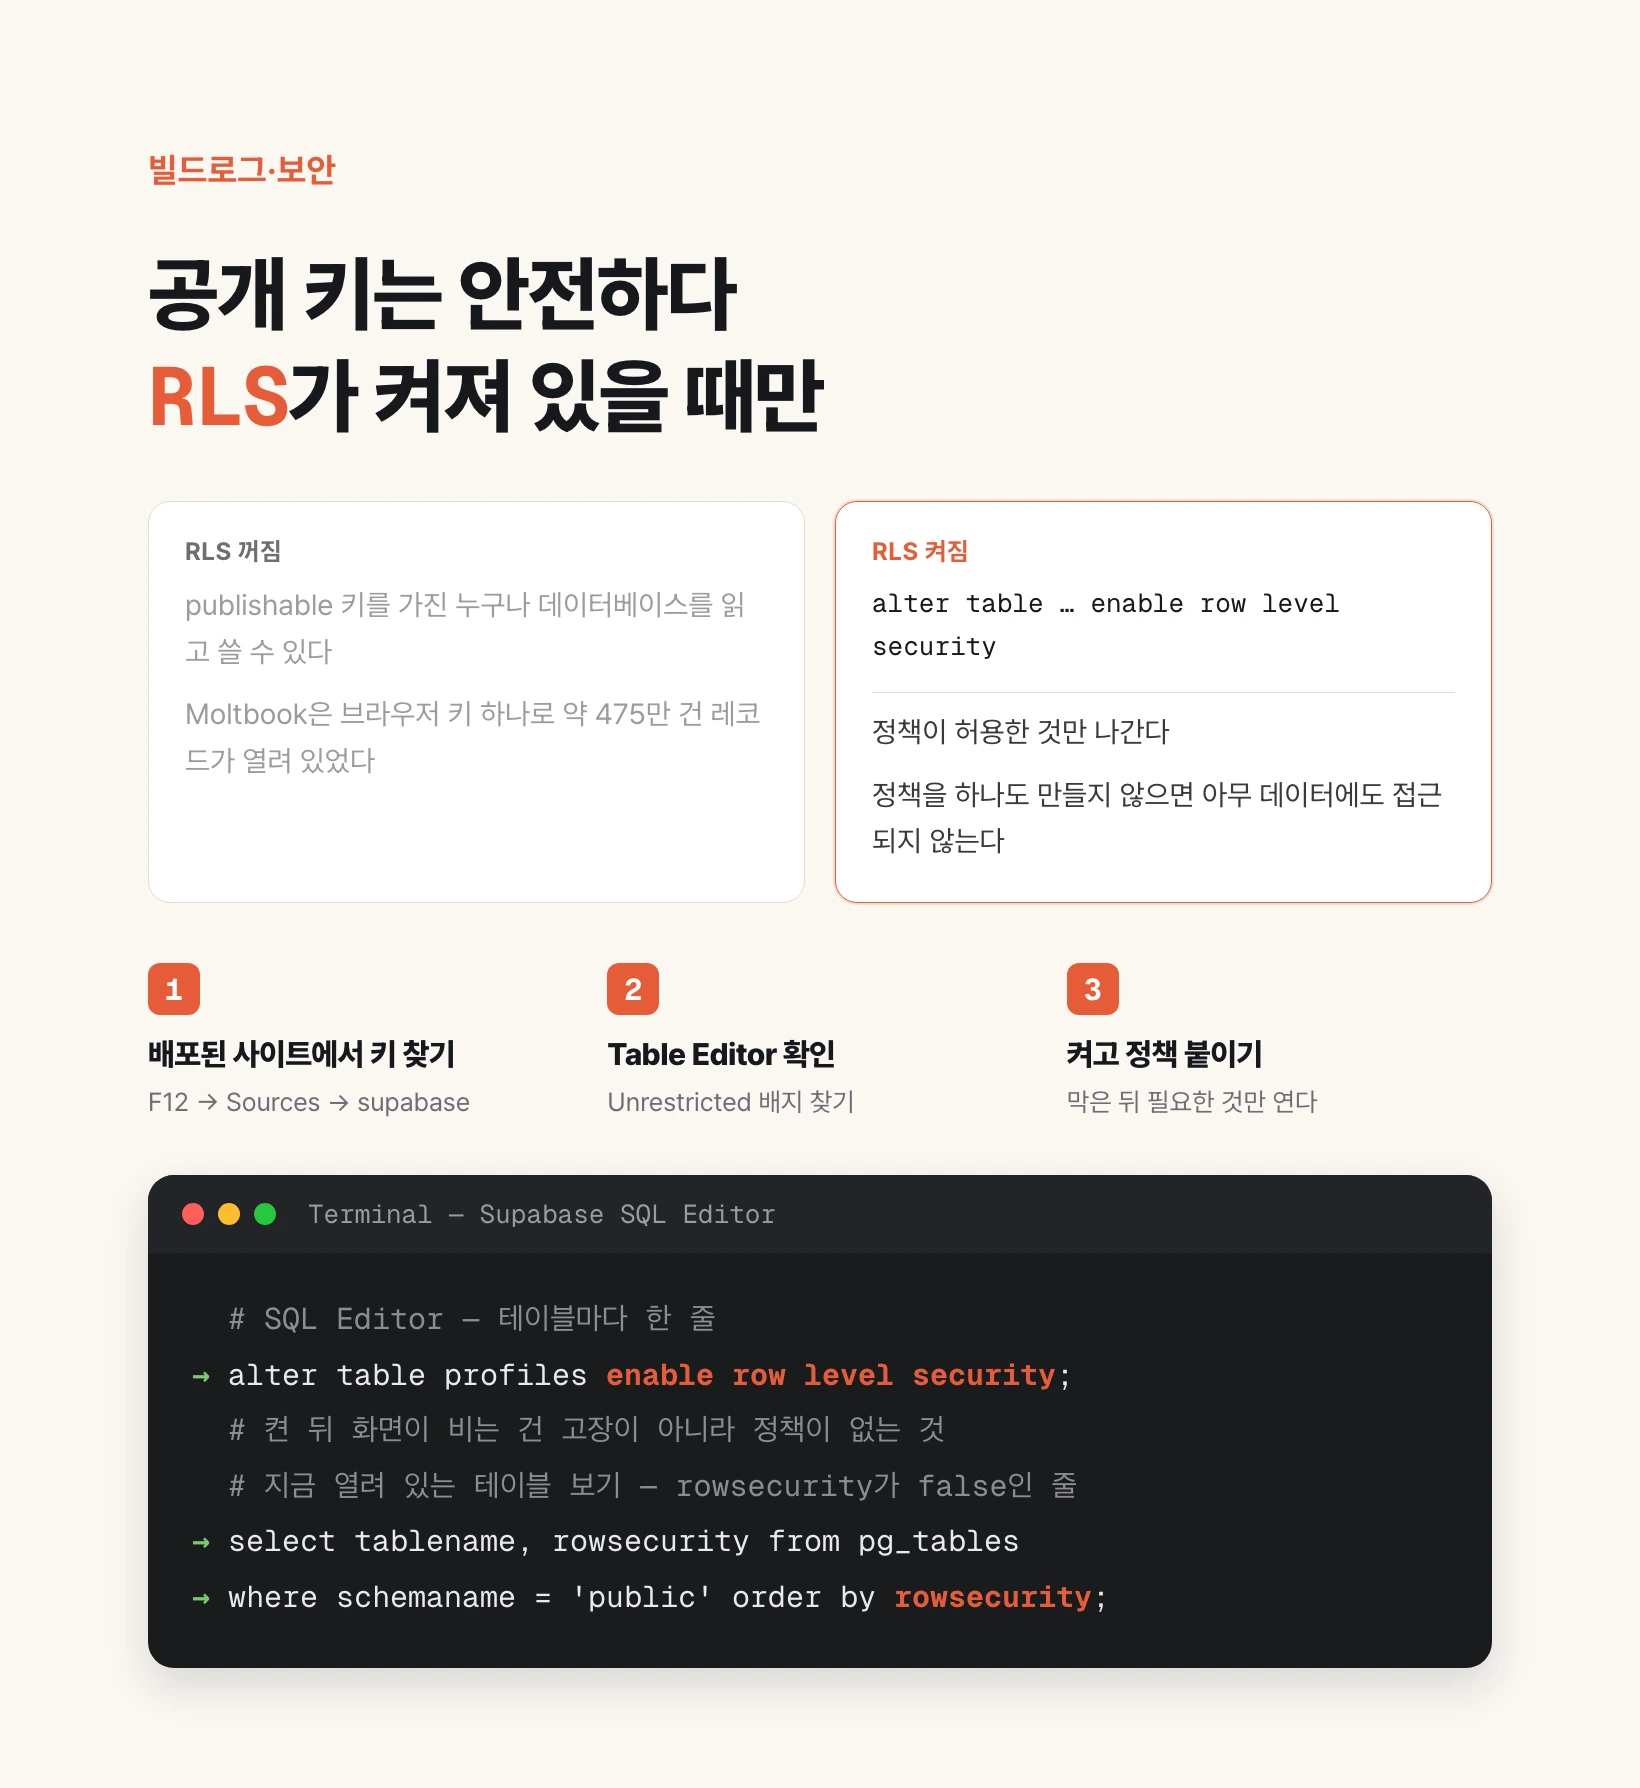
Supabase RLS — 내 앱의 데이터베이스가 지금 누구에게나 열려 있는가
Supabase로 만든 앱은 브라우저에 키가 노출되는 것이 정상이고, 그 키가 안전한지는 테이블마다 RLS(Row Level Security)가 켜져 있는지 하나로 갈립니다. RLS가 꺼져 있으면 그 키를 가진 누구나 데이터베이스를 읽고 쓸 수 있습니다. 2026년 2월 보안업체 Wiz가 공개한 Moltbook 사고가 정확히 그 경우였고, 브라우저 자바스크립트에 박힌 publishable 키 하나로 약 475만 건의 레코드가 열려 있었습니다. 확인은 배포된 사이트에서 키를 찾고 Supabase 대시보드 Table Editor에서 Unrestricted 배지를 보는 두 단계로 3분이면 끝납니다. 이 글은 그 점검 절차와, RLS를 켠 뒤 화면이 비어 보이는 이유, 정책을 어떤 순서로 붙이는지를 처음 하는 사람 기준으로 설명합니다.
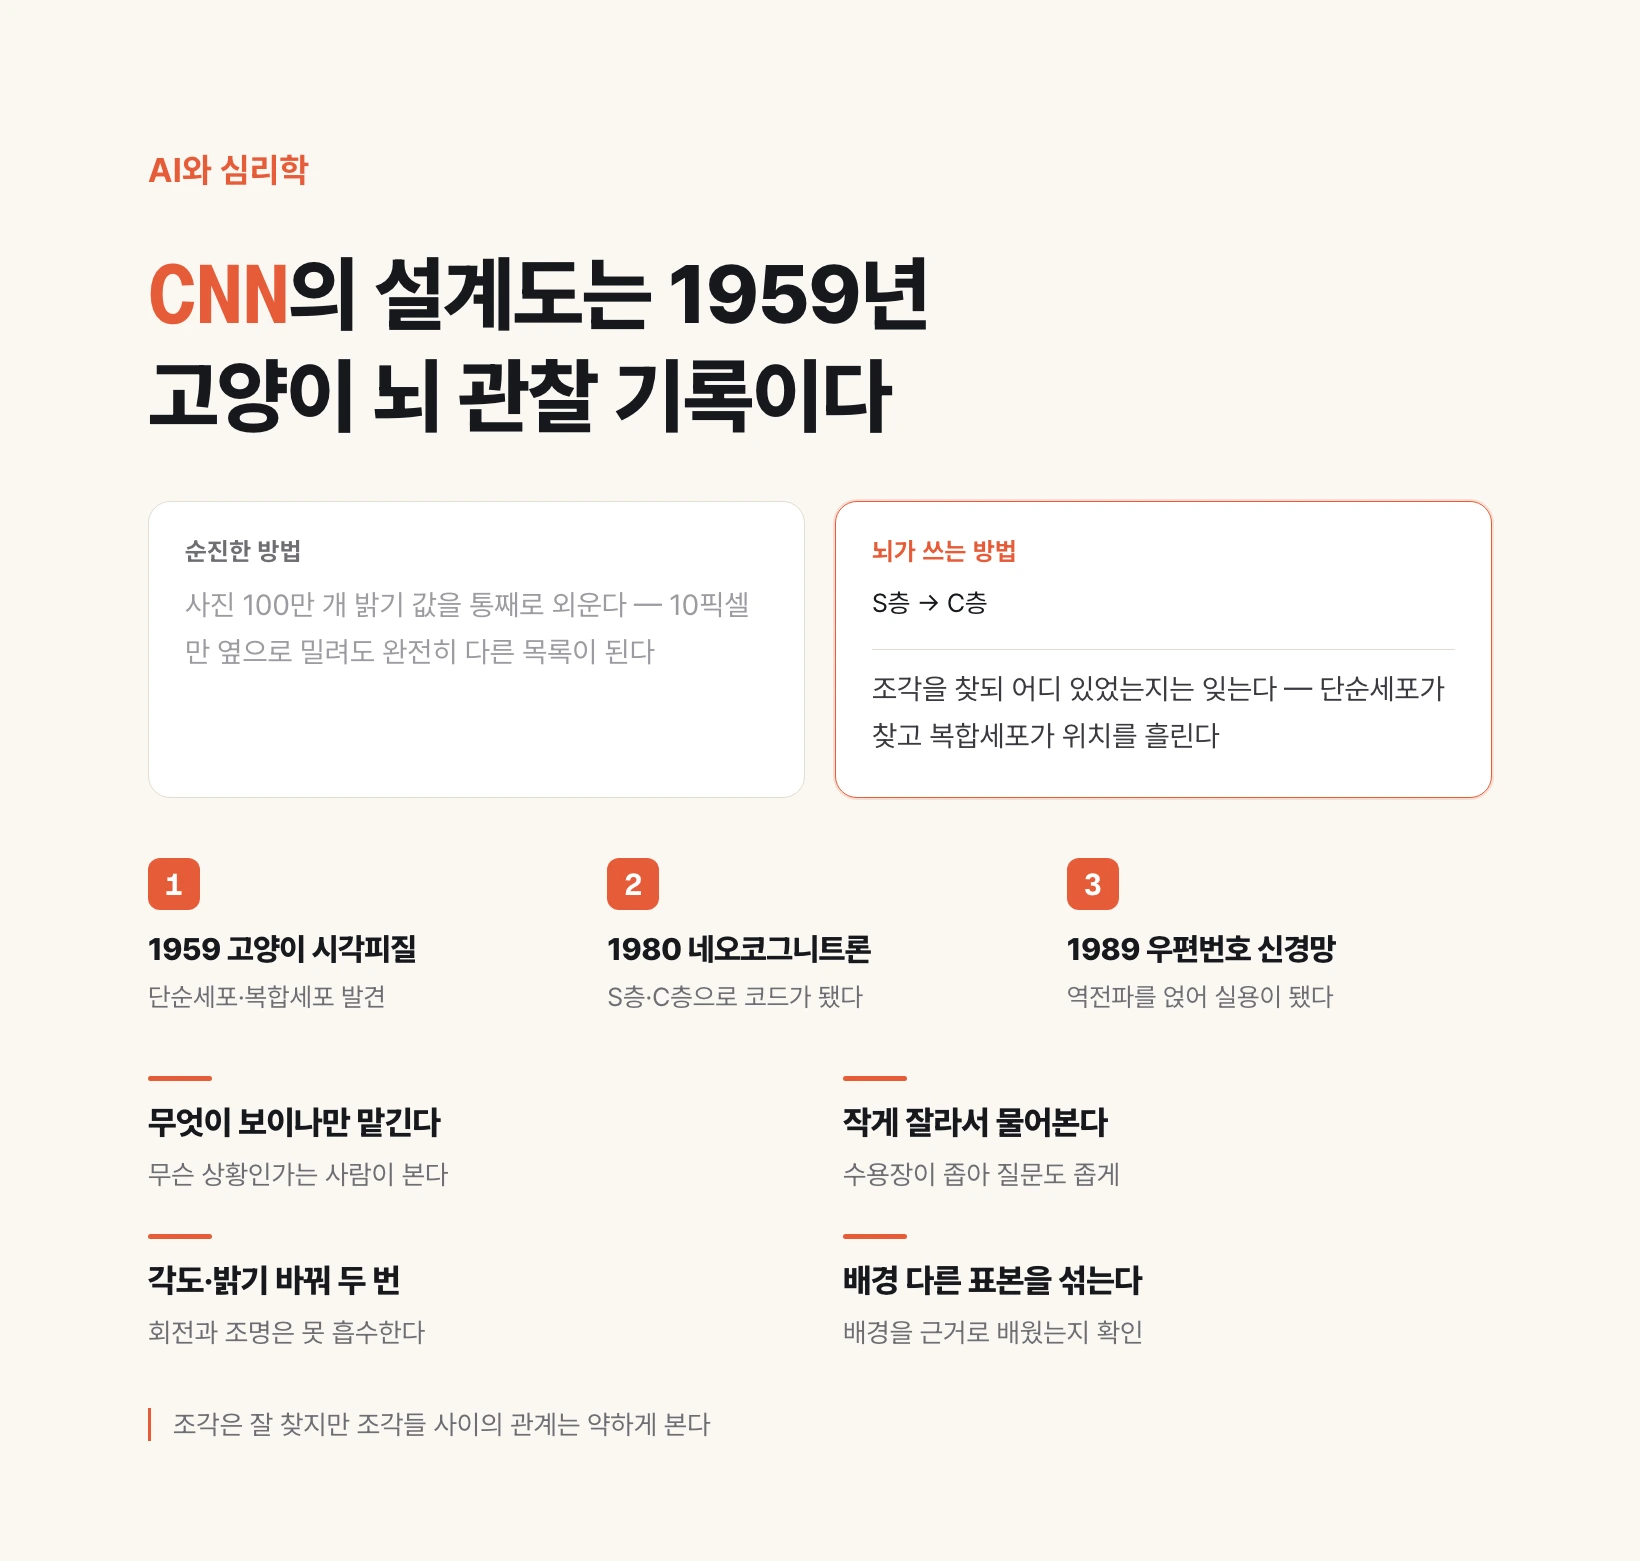
이미지 AI는 고양이 뇌를 베꼈다 — 허블·비셀에서 CNN까지
얼굴을 알아보고 불량품을 골라내고 엑스레이를 읽는 AI를 떠받쳐 온 구조가 CNN이다. 그 구조의 설계도는 공학자가 그린 게 아니라 1959년 고양이 뇌에 전극을 꽂아 얻은 관찰 기록이다. 단순세포와 복합세포라는 두 종류의 신경세포가 발견됐고, 1980년에 그것이 그대로 층으로 구현됐고, 1989년 논문이 그 구현을 인용하며 오늘의 이미지 AI로 이어졌다.
임상시험 정보로 제약주를 예측한다는 건 무슨 뜻인가
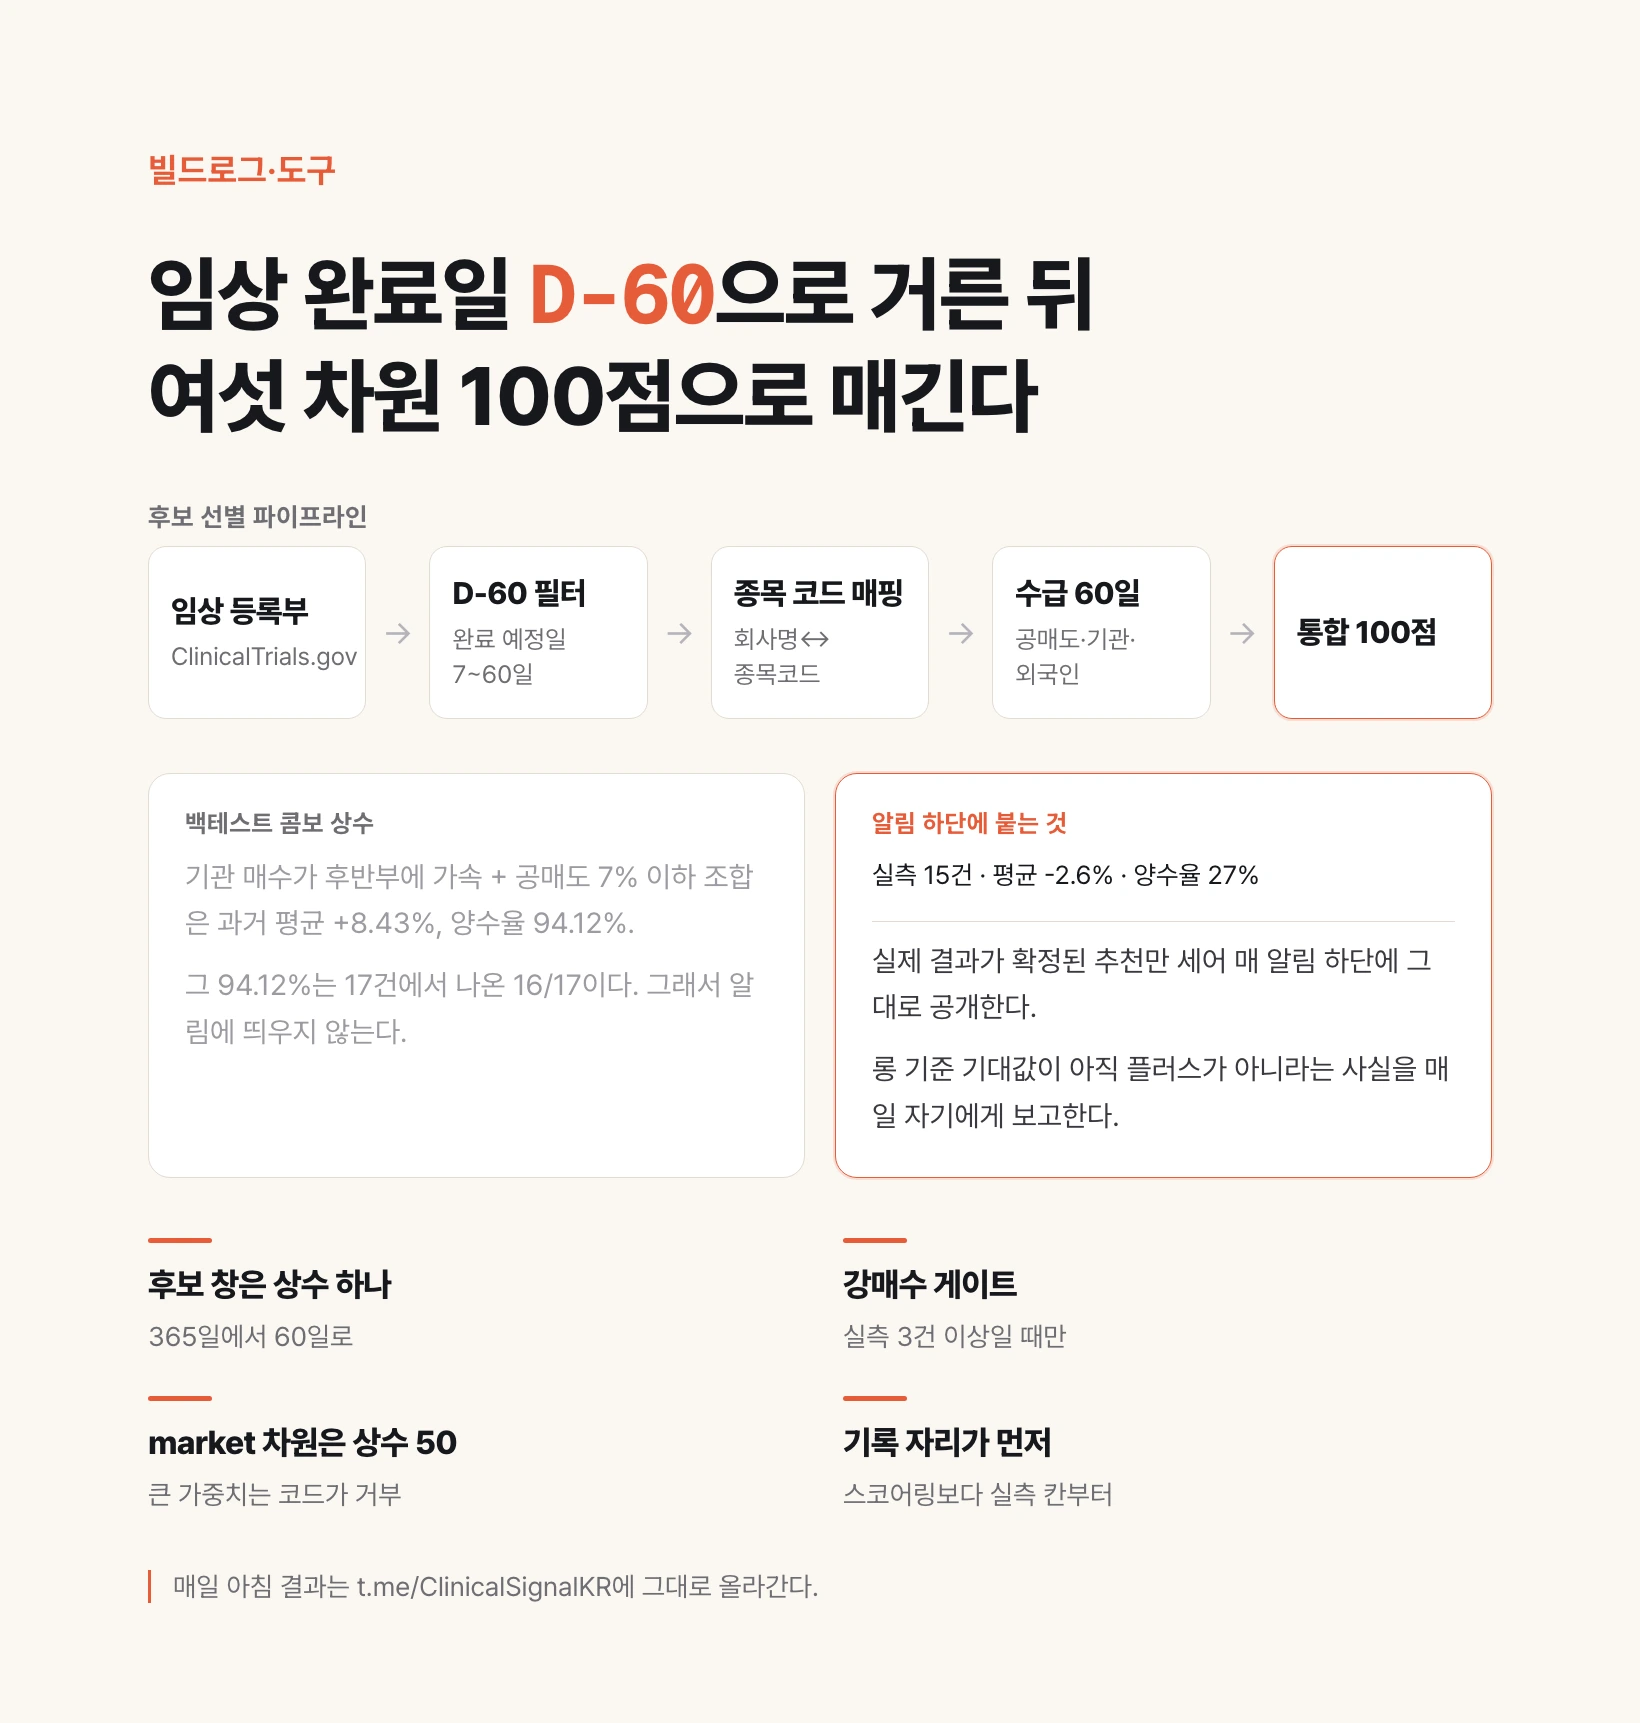
제약·바이오 주가를 차트가 아니라 임상시험 일정으로 거르는 방식입니다. 3상 결과가 언제 나올지는 ClinicalTrials.gov라는 공개 등록부에 이미 적혀 있고, 발표 당일이 아니라 그 두 달 전부터 기관 수급이 먼저 움직입니다. 그래서 완료 예정일이 60일 안쪽인 임상만 남기고 거기에 공매도·수급 데이터를 붙여 여섯 차원 100점으로 점수를 냅니다. 이 글은 그 파이프라인을 처음부터 끝까지 열어 보이고, 가장 중요한 설계 결정이 왜 「좋아 보이는 숫자를 화면에서 지운 것」이었는지를 설명합니다.
공공데이터포털 오픈API를 처음 붙일 때 무엇을 먼저 확인해야 하는가
인증이나 호출 방법이 아니라 조용한 실패를 먼저 확인해야 합니다. 공공데이터포털의 일부 API는 모르는 파라미터를 거부하지 않고 무시한 채 전국 데이터를 그대로 돌려줍니다. 실제로 건강보험심사평가원 약국 API에 다른 기관의 파라미터를 넣었더니 서울 5,883건 대신 전국 25,771건이 왔고, 응답은 HTTP 200에 정상 JSON이었습니다. 이 글은 그 실측을 그대로 보여 주고, 공공데이터를 붙일 때 첫 검증으로 무엇을 해야 하는지, 그리고 포털에 있는 데이터와 API로 받을 수 있는 데이터가 왜 다른지를 설명합니다.
클로드 5세대 컨텍스트 엔지니어링 — CLAUDE.md에서 지워야 할 것들
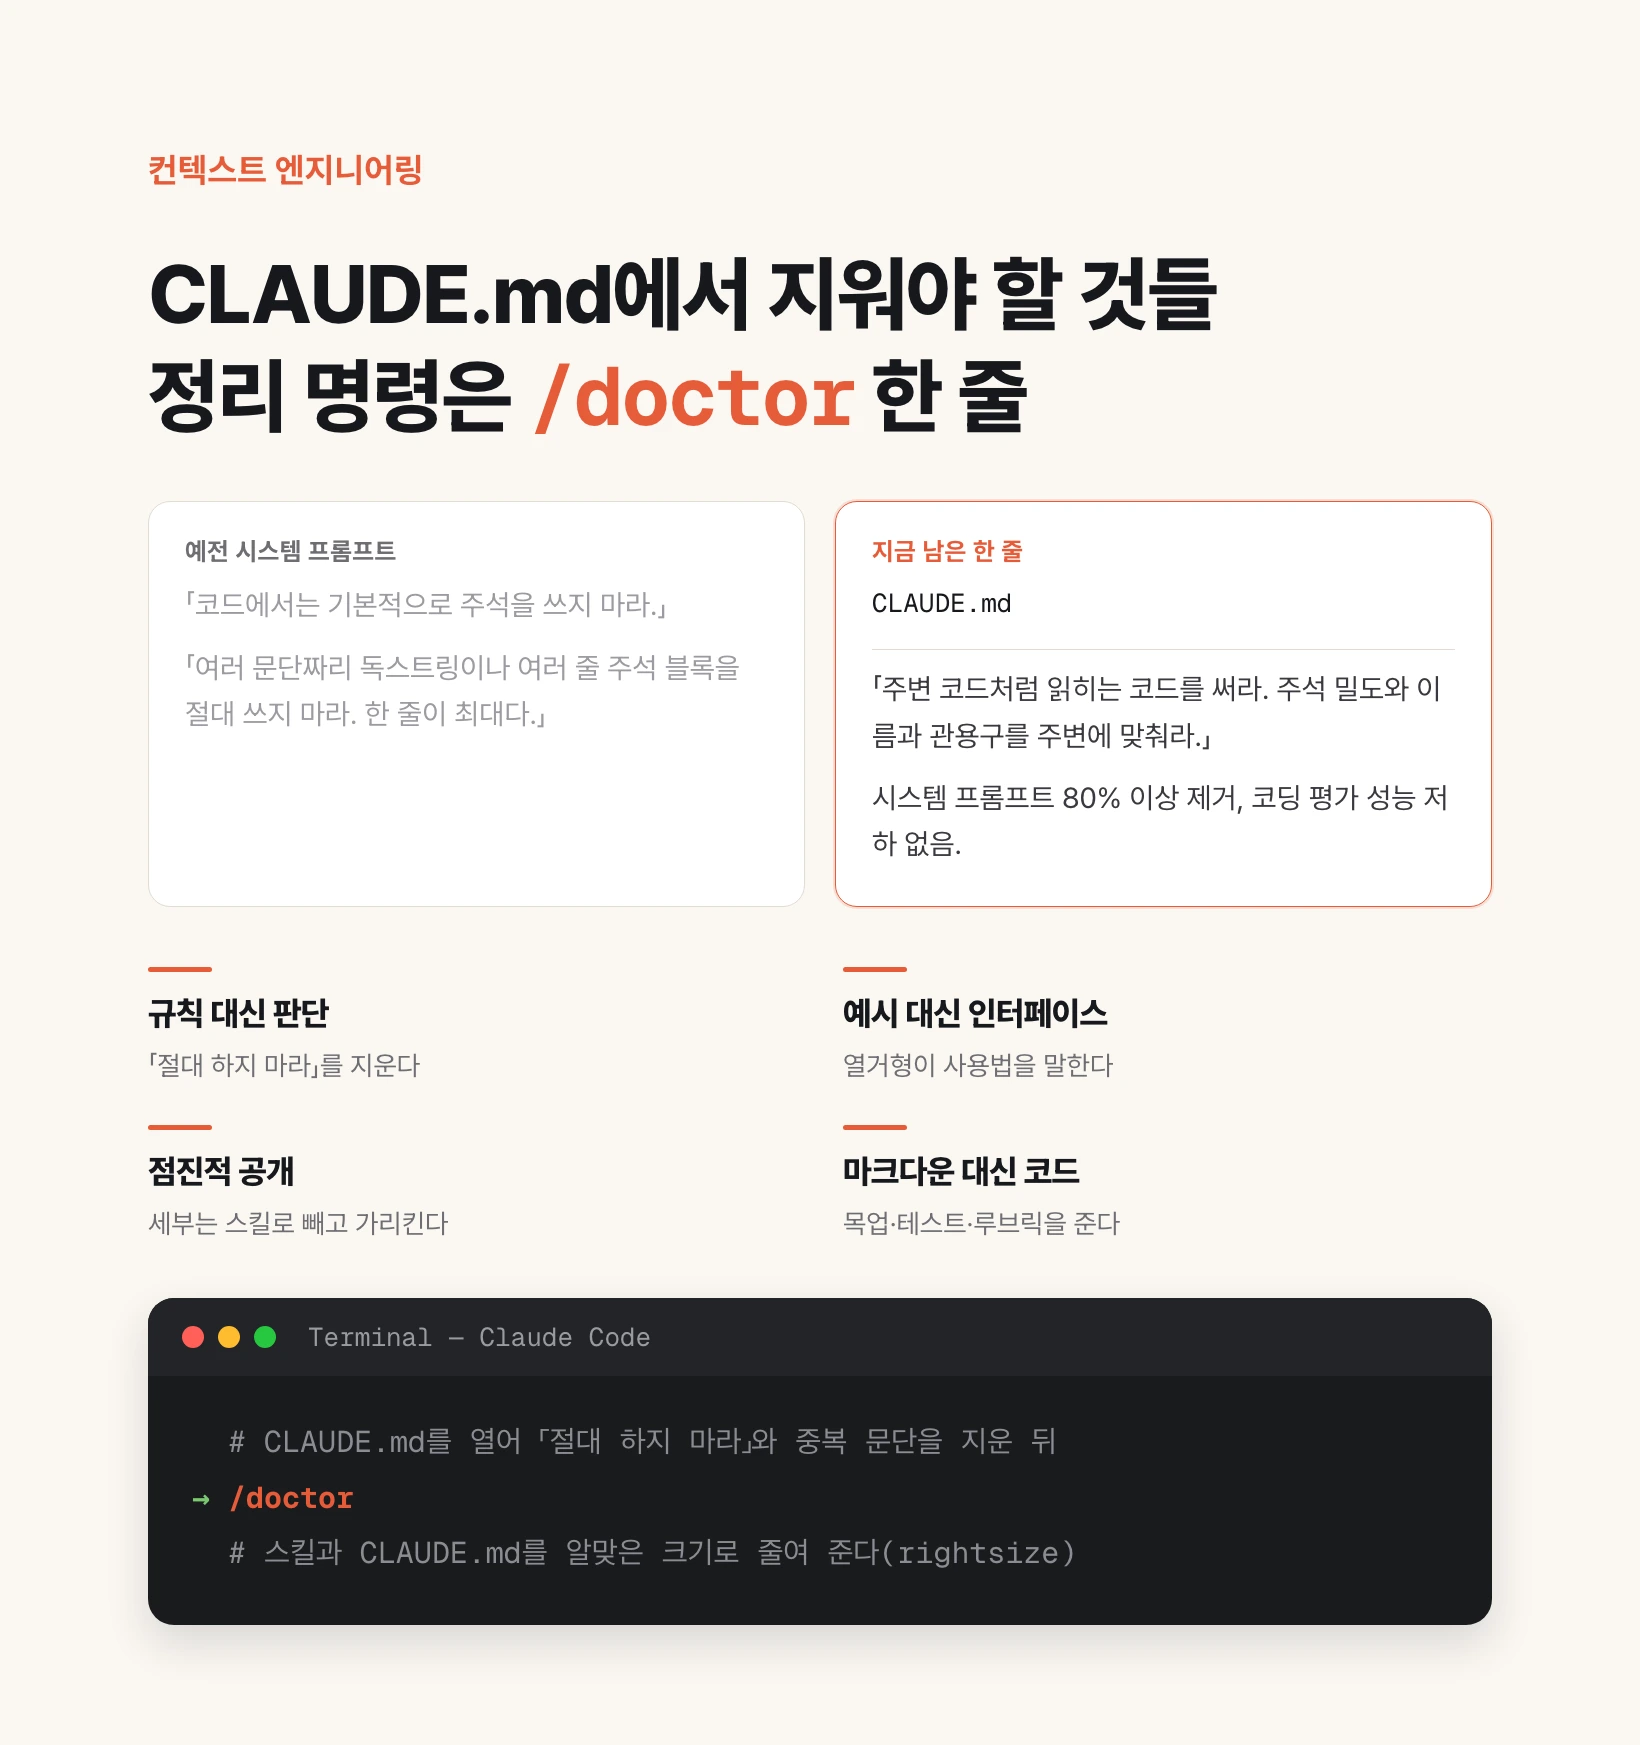
Anthropic이 Claude Code의 시스템 프롬프트에서 80% 이상을 지웠는데 코딩 평가 점수가 떨어지지 않았습니다. 모델이 판단을 할 줄 알게 되면서, 지난 몇 달 동안 잘하는 방법이라고 배운 것들이 이제는 성능을 깎는 짐이 됐다는 뜻입니다. 바뀐 규칙은 여섯 가지이고, 내 파일에 적용하는 명령은 Claude Code에서 /doctor 한 줄입니다. 원문은 claude.com/blog의 「The new rules of context engineering for Claude 5 generation models」입니다.
Topview MCP — 클로드에 붙여서 광고 영상을 만드는 법
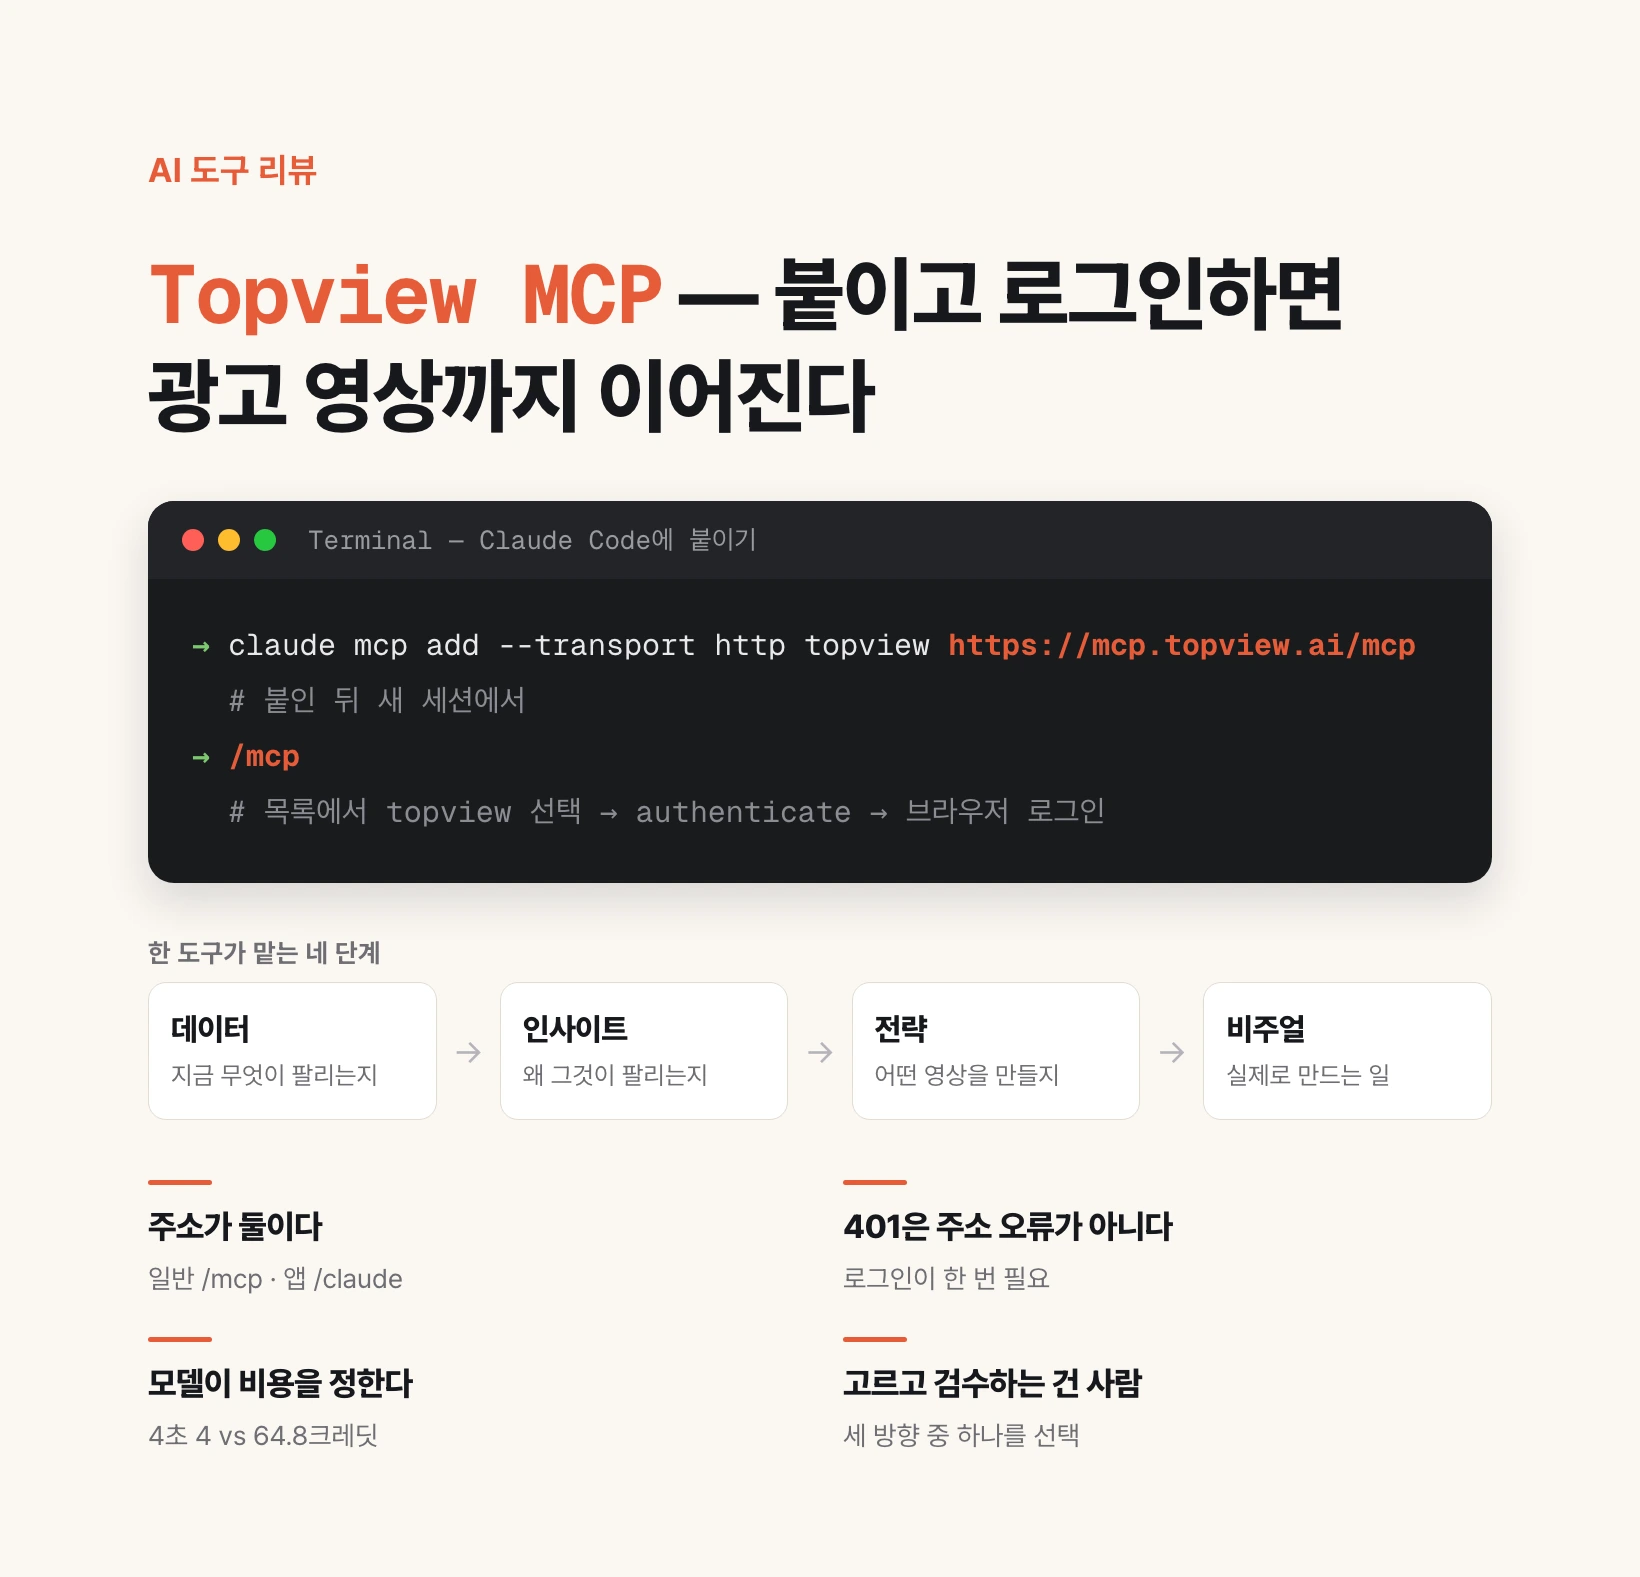
Topview MCP는 시장 데이터 조회부터 광고 영상 제작까지를 하나의 MCP 서버로 묶어 놓은 서비스입니다. 주소를 클라이언트에 붙이고 로그인하면, 이후로는 대화창에서 「요즘 잘 팔리는 제품 찾아서 광고 영상 만들어 줘」 수준의 요청으로 데이터 조회·기획·이미지·영상·보이스오버가 이어집니다. 주소는 클라이언트마다 다릅니다. Claude Code 같은 일반 MCP 클라이언트는 https://mcp.topview.ai/mcp, Claude 앱 커넥터는 https://mcp.topview.ai/claude 입니다. 만든 곳은 Topview이고, 이 글은 써 보고 정리한 소개입니다.
약국입지 진료과목 렌즈 — 병원 자리를 과목 기준으로 다시 보는 법
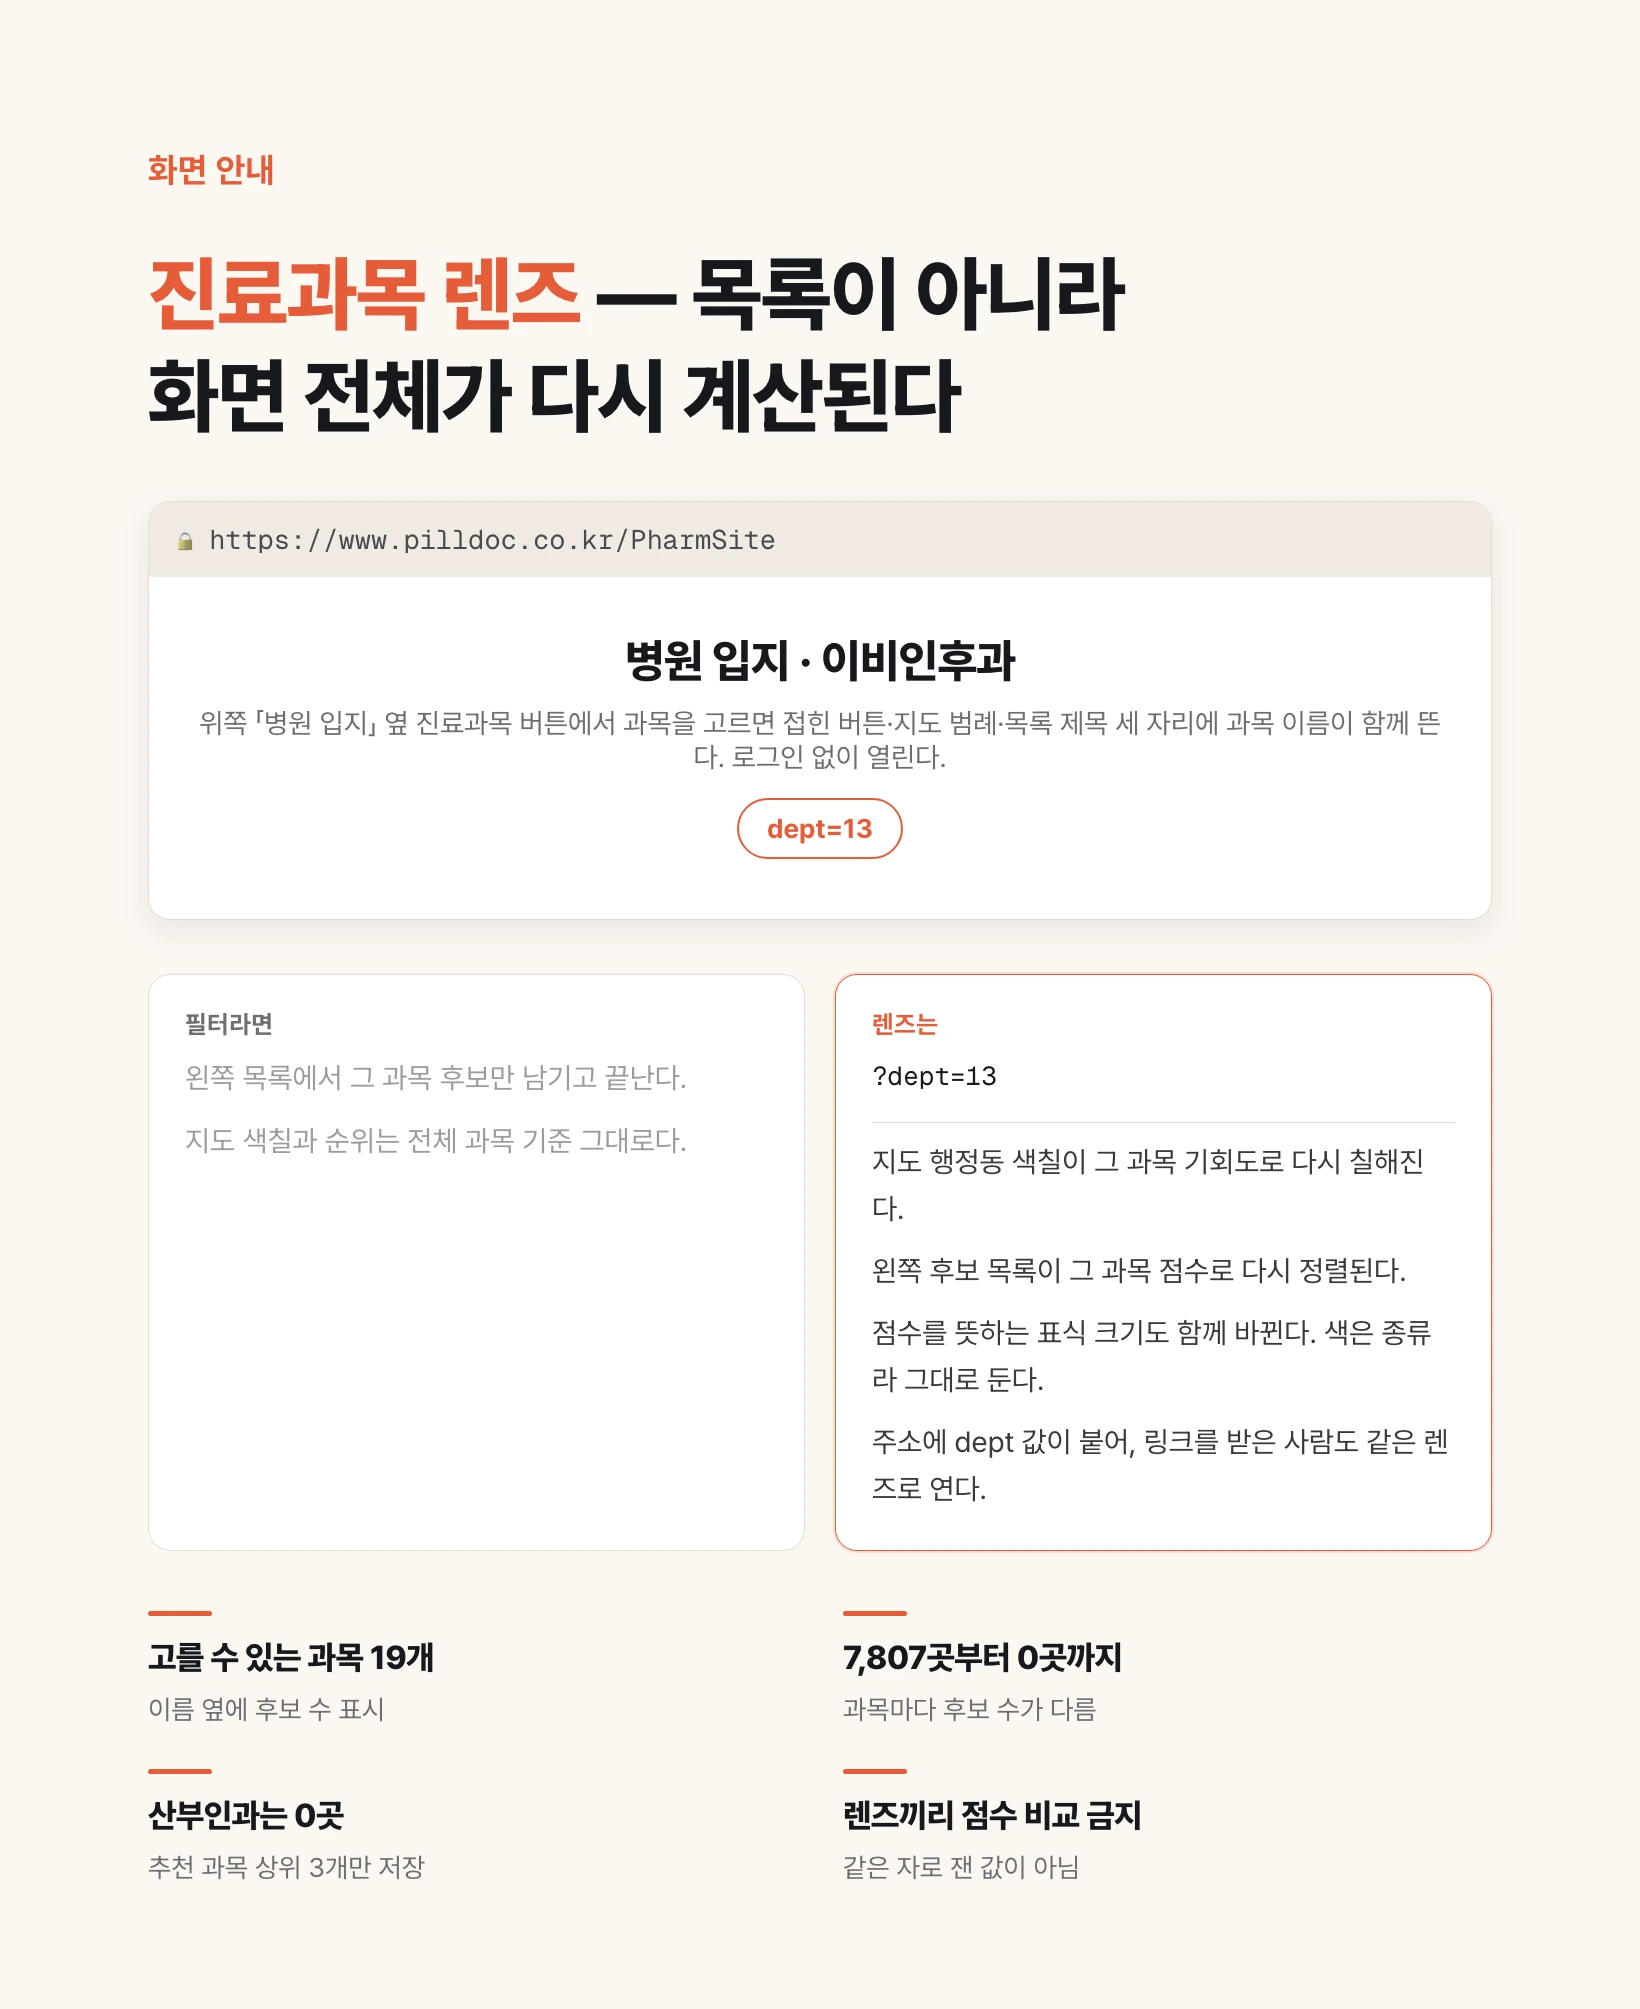
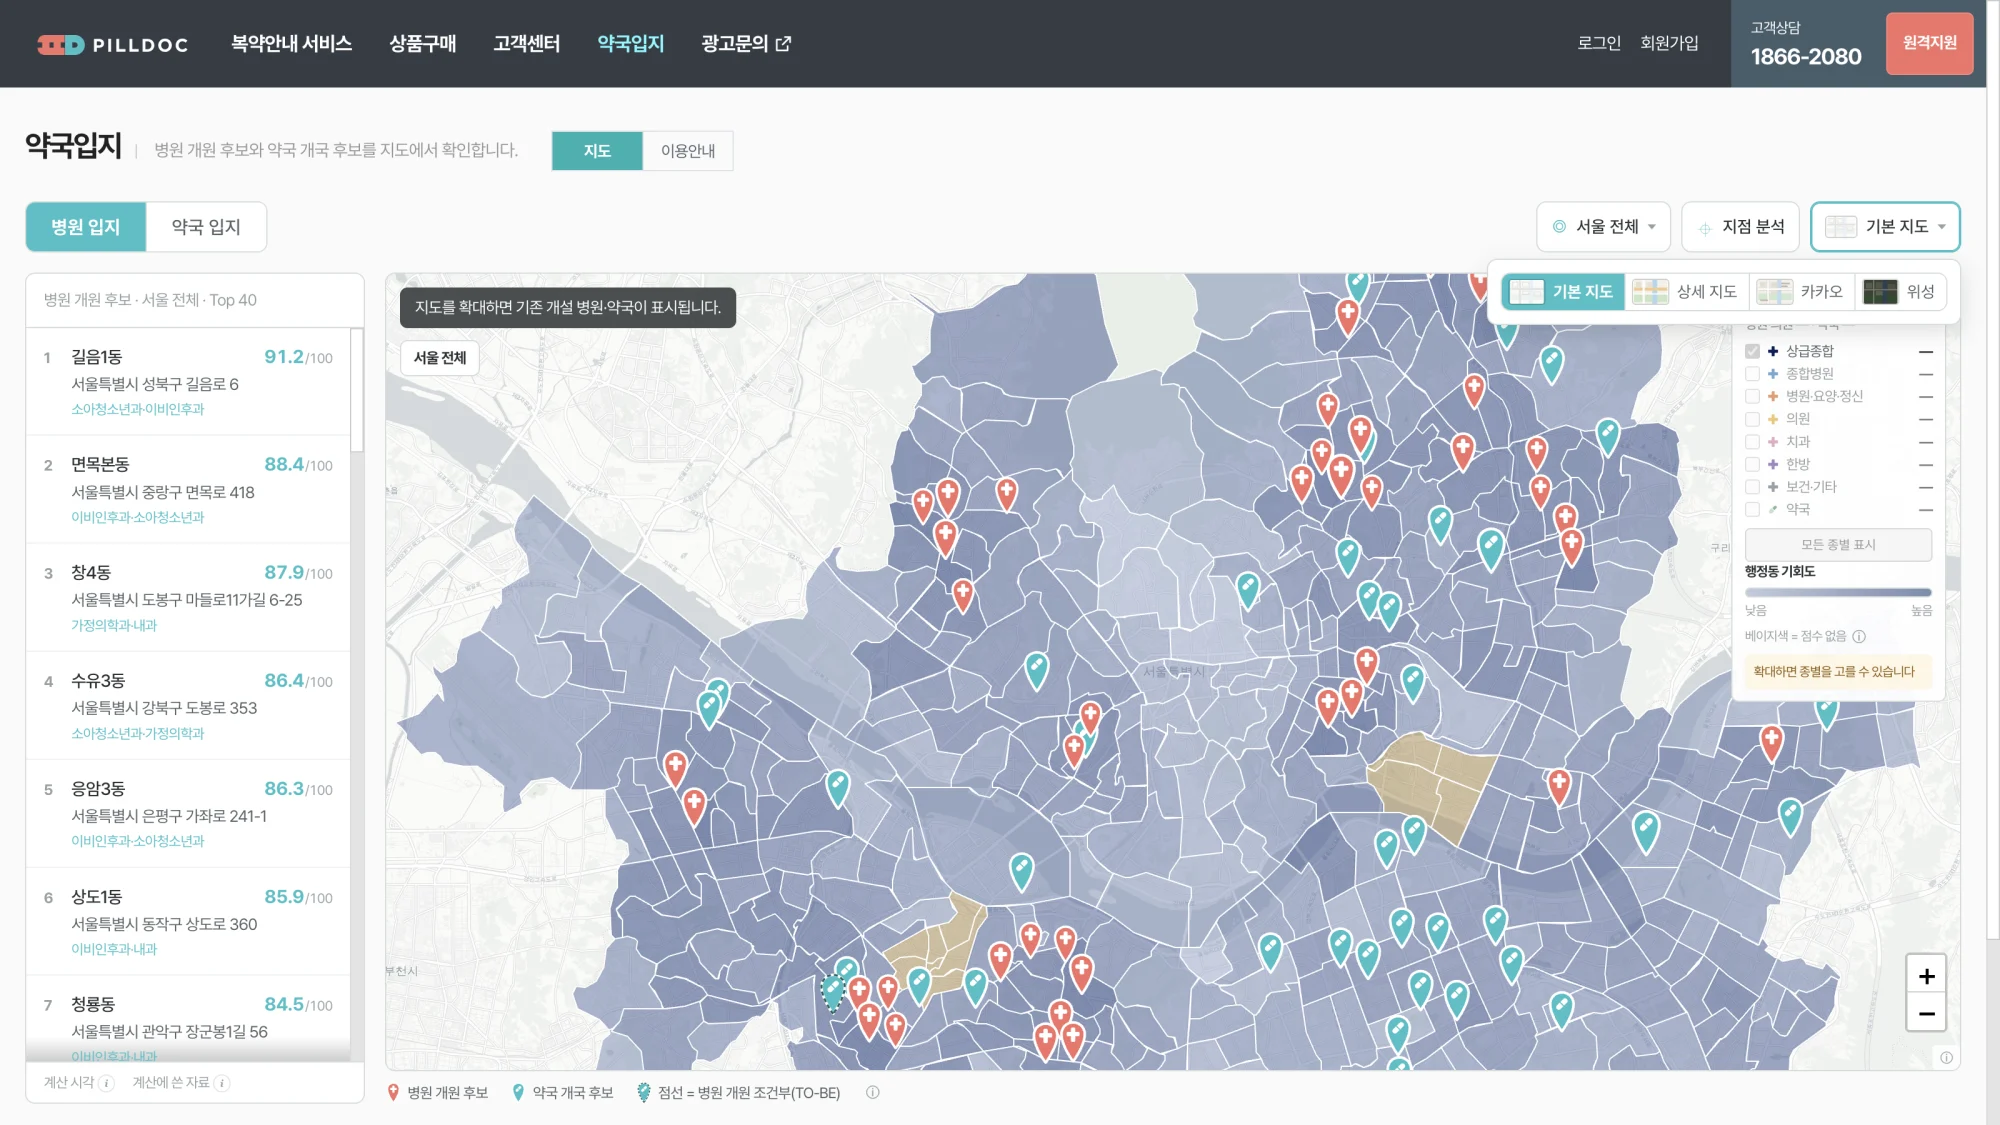
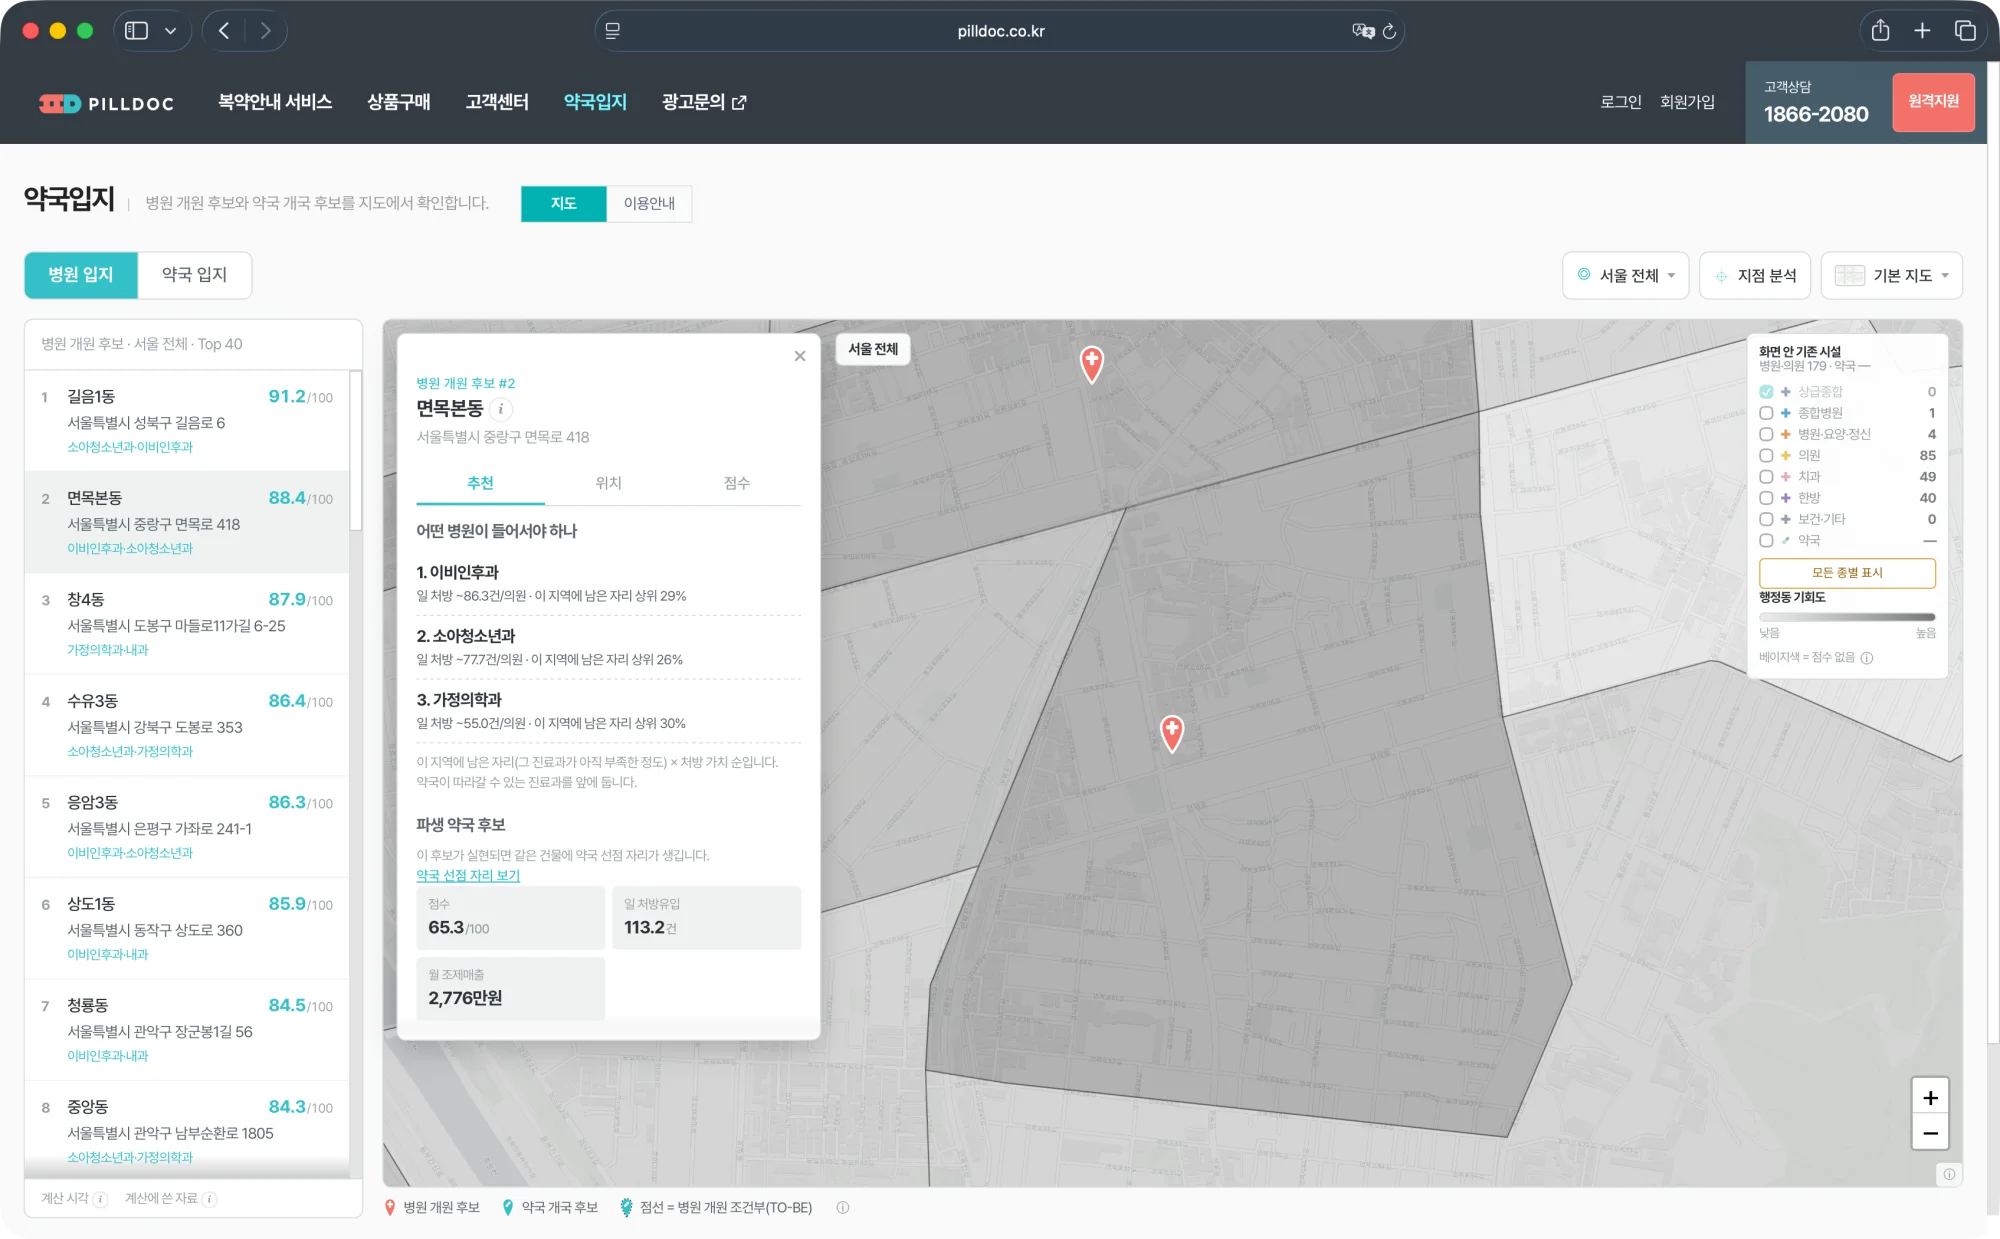
필독 약국입지 지도에 진료과목 렌즈가 붙었습니다. 화면 위쪽 「병원 입지」 옆 진료과목 버튼에서 과목 하나를 고르면 목록만 걸러지는 것이 아니라 지도 색칠과 후보 순위와 표식 크기가 한꺼번에 그 과목 기준으로 다시 계산됩니다. 고를 수 있는 과목은 19개이고, 과목마다 볼 수 있는 후보 수는 이비인후과 7,807곳부터 산부인과 0곳까지 크게 다릅니다. 주소는 https://www.pilldoc.co.kr/PharmSite 이고 로그인 없이 열립니다.
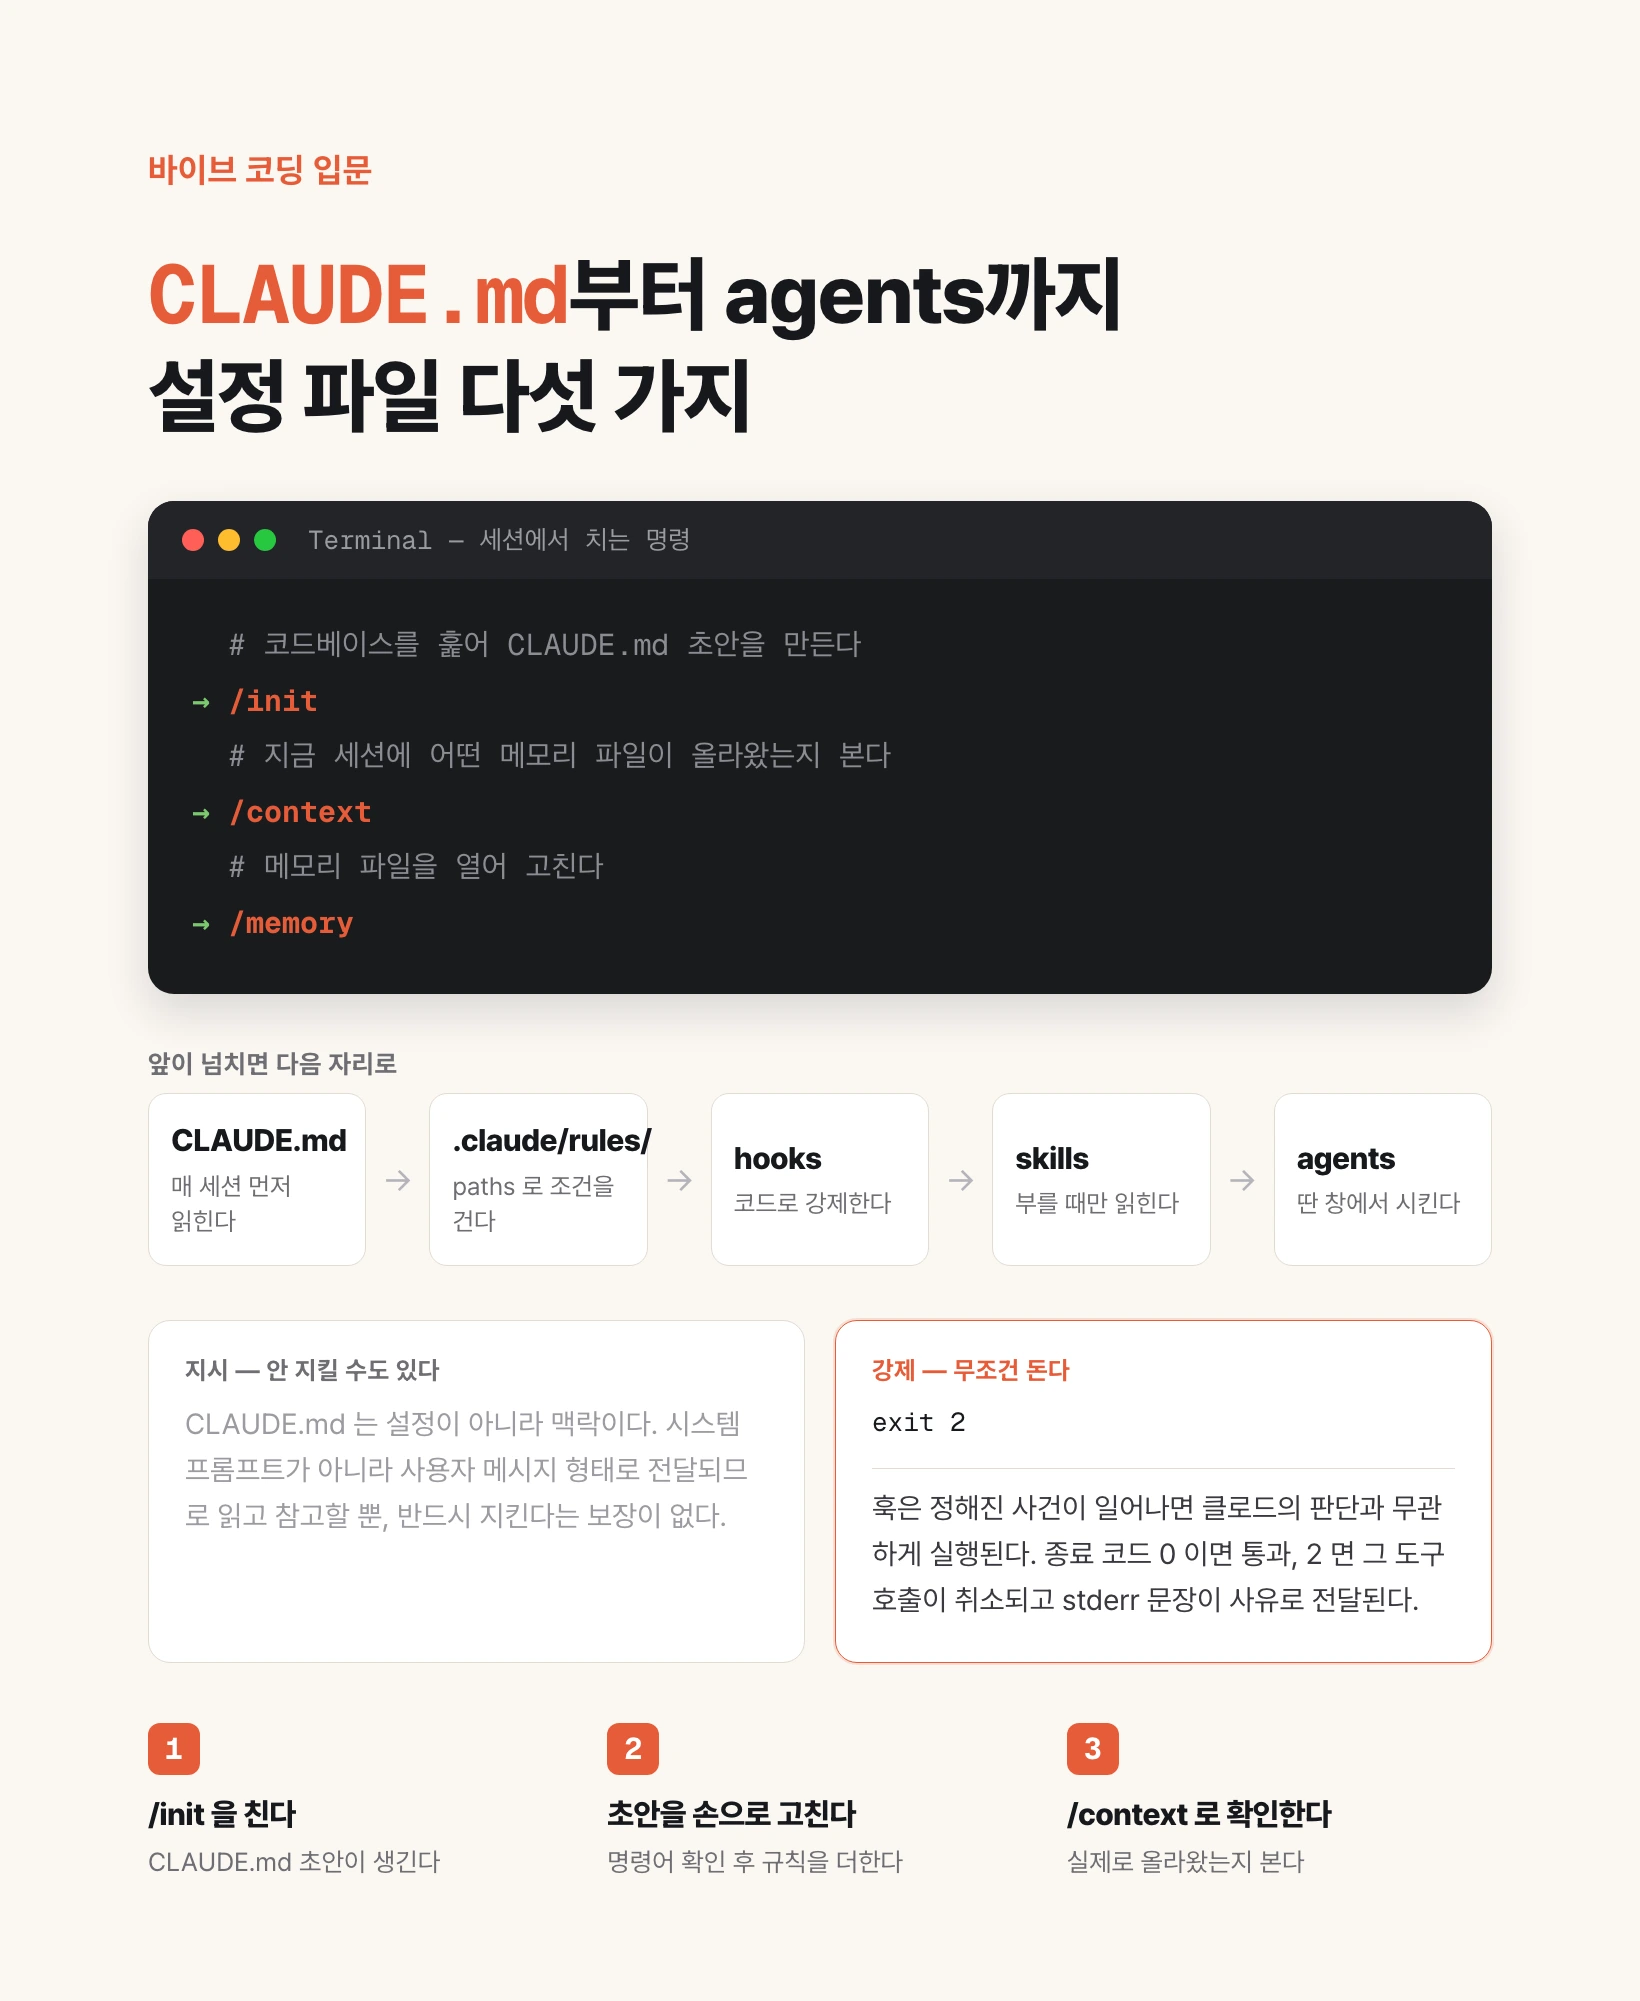
CLAUDE.md · Rules · Hooks · Skills · Agents — 클로드 코드 설정 파일 다섯 가지
클로드 코드를 내 방식대로 쓰는 일은 결국 파일 다섯 종류를 두는 것으로 끝난다. CLAUDE.md 는 매 세션 먼저 읽히는 프로젝트 설명서, rules 는 그 설명서가 길어질 때 조건부로 쪼개 두는 곳, hooks 는 지시가 아니라 코드로 강제하는 자리, skills 는 반복하는 절차를 슬래시 명령으로 만든 것, agents 는 딴 일을 딴 창에서 시켜 본 대화를 지키는 장치다. 이 글은 다섯을 각각 어디에 어떤 형식으로 만드는지, 그리고 무엇을 어느 것으로 옮길지까지 순서대로 다룬다.
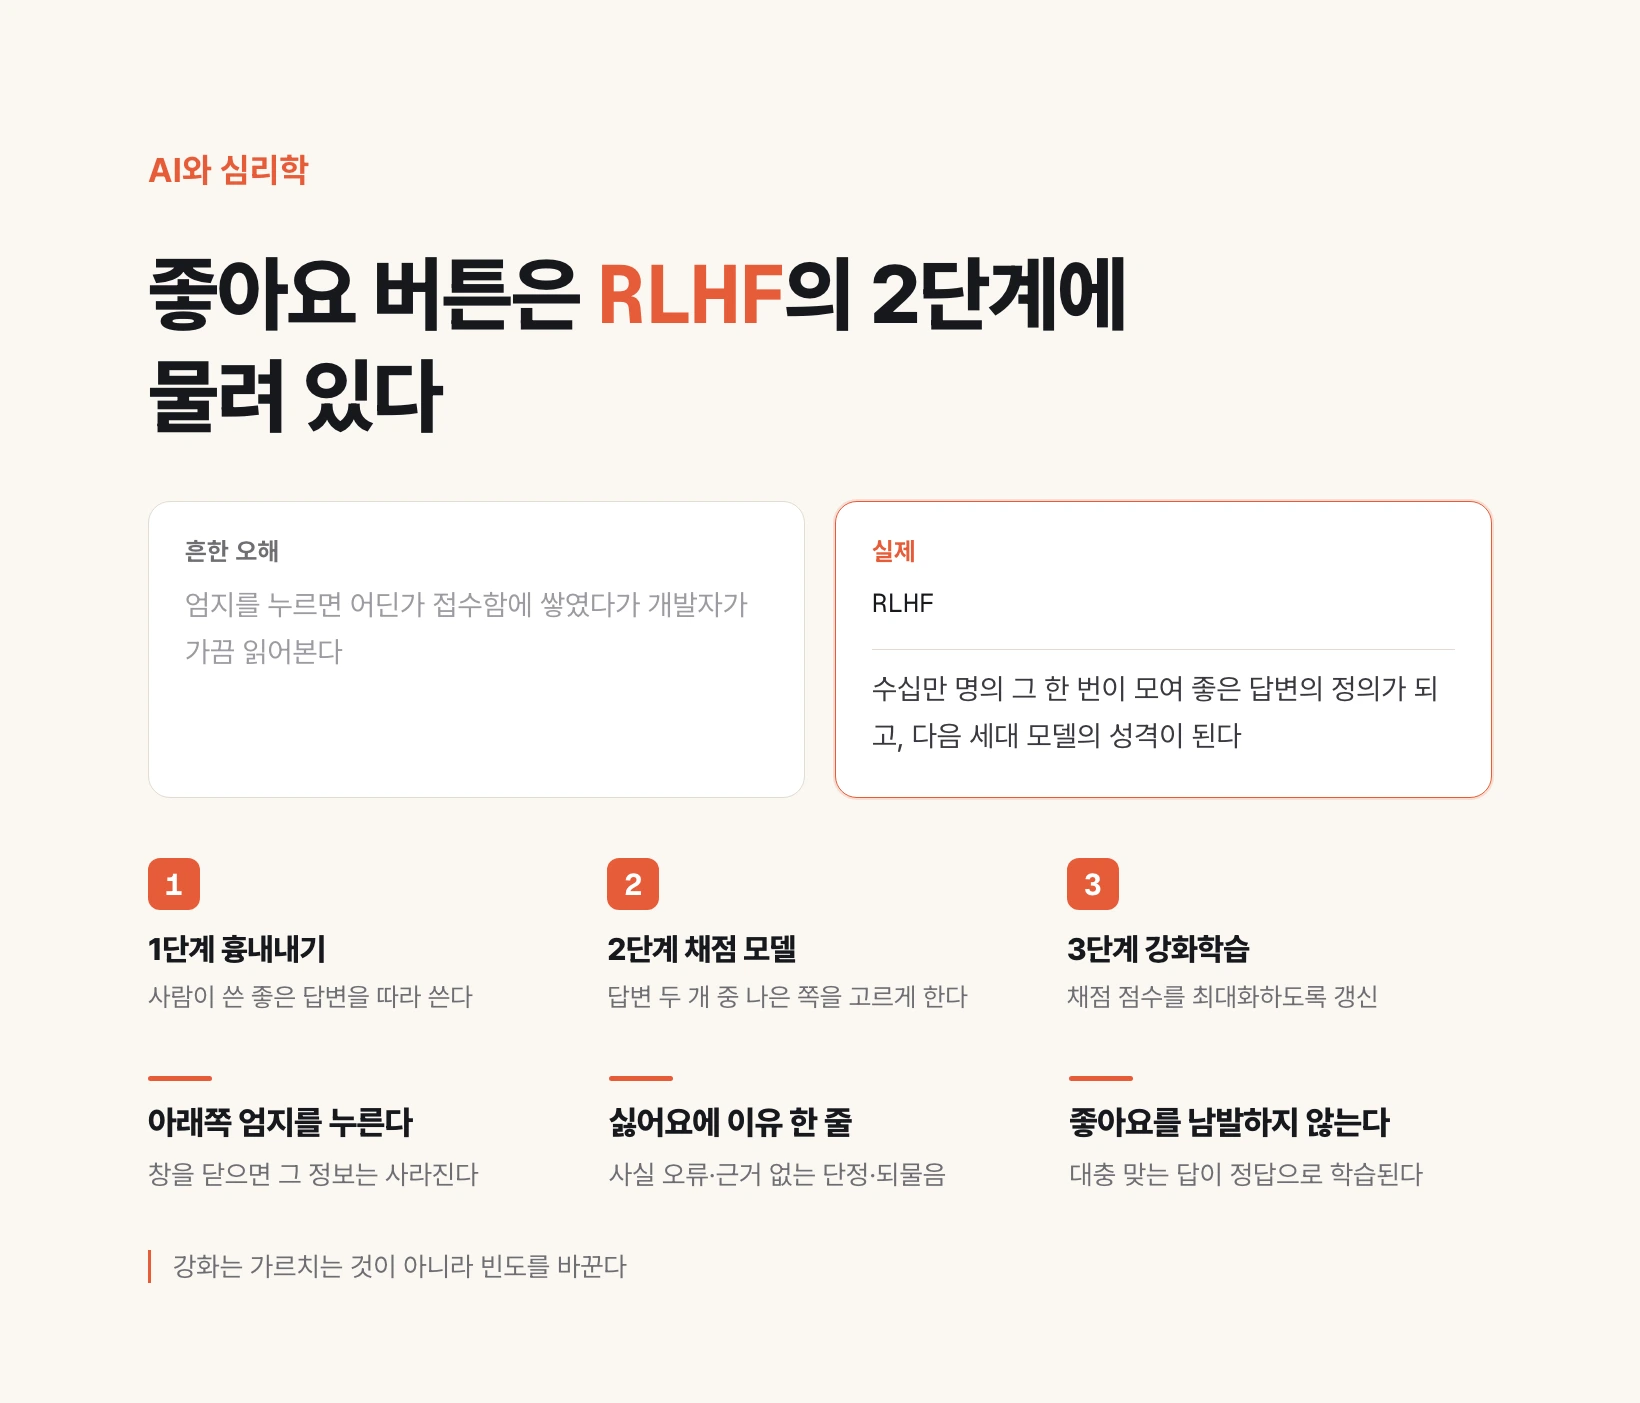
좋아요 버튼이 AI를 길들인다 — 파블로프에서 RLHF까지
AI가 사람의 말투와 태도를 익히는 방식은 새로 발명된 것이 아니다. 개에게 종소리를 들려주던 19세기 실험에서 출발해, 1972년 예상과 얼마나 어긋났는가라는 한 줄 원리로 정리됐고, 1997년에는 그 원리가 실제 뇌 회로에서 발견됐으며, 컴퓨터로 옮겨져 2024년 튜링상을 받았다. ChatGPT 답변 아래 있는 좋아요 버튼은 그 계보의 맨 끝에 달린 손잡이다.
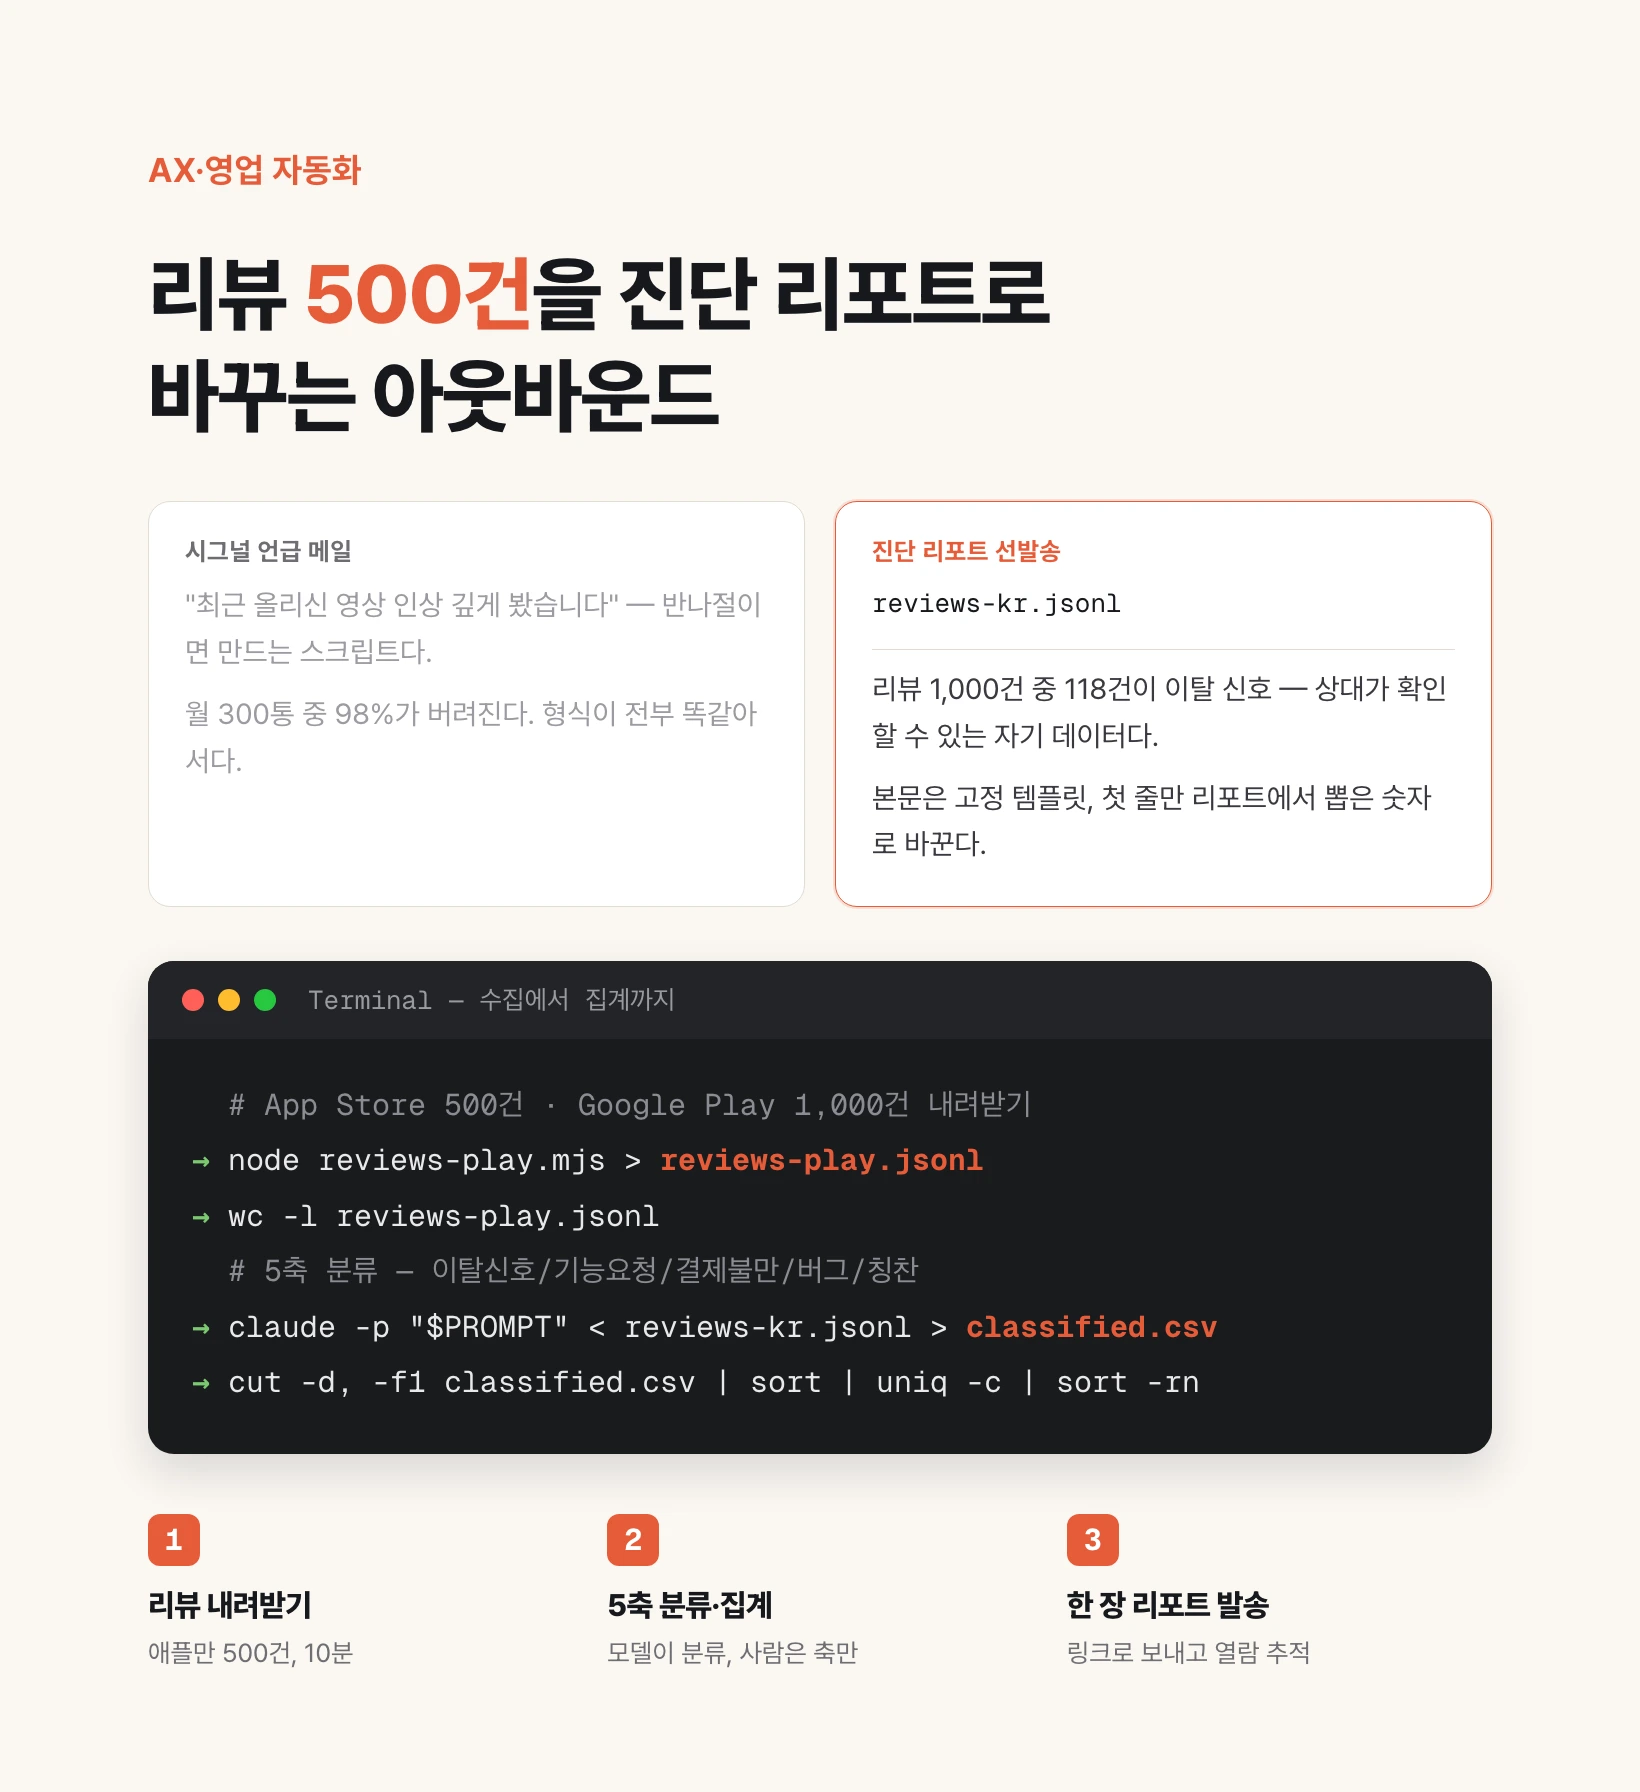
진단 리포트를 먼저 보내는 아웃바운드는 어떻게 만드나
진단 리포트를 먼저 보내는 아웃바운드는 잠재 고객의 공개 데이터를 모아 그 회사만의 문제를 정리한 문서를 만들고, 파는 말 대신 그 문서를 첫 접촉에 붙이는 방식이다. 앱을 파는 회사가 상대라면 App Store와 Google Play 리뷰가 가장 구하기 쉬운 재료다. 애플의 공개 리뷰 피드는 인증 없이 한 스토어 한 국가당 최대 500건을 주고, 구글 플레이는 오픈소스 패키지로 1,000건 단위 수집이 된다. 그 리뷰를 이탈 신호·기능 요청·결제 불만·버그·칭찬으로 나눠 앱 버전과 함께 표로 세우면 리포트 한 편이 되고, 메일은 첫 줄만 상대에 맞춰 바꾸고 나머지는 고정 템플릿으로 둔다. 리포트 열람 여부를 추적하면 답장이 없어도 다음 대화를 열 명분이 남는다.
novice — 비개발자용 Claude Code 플러그인
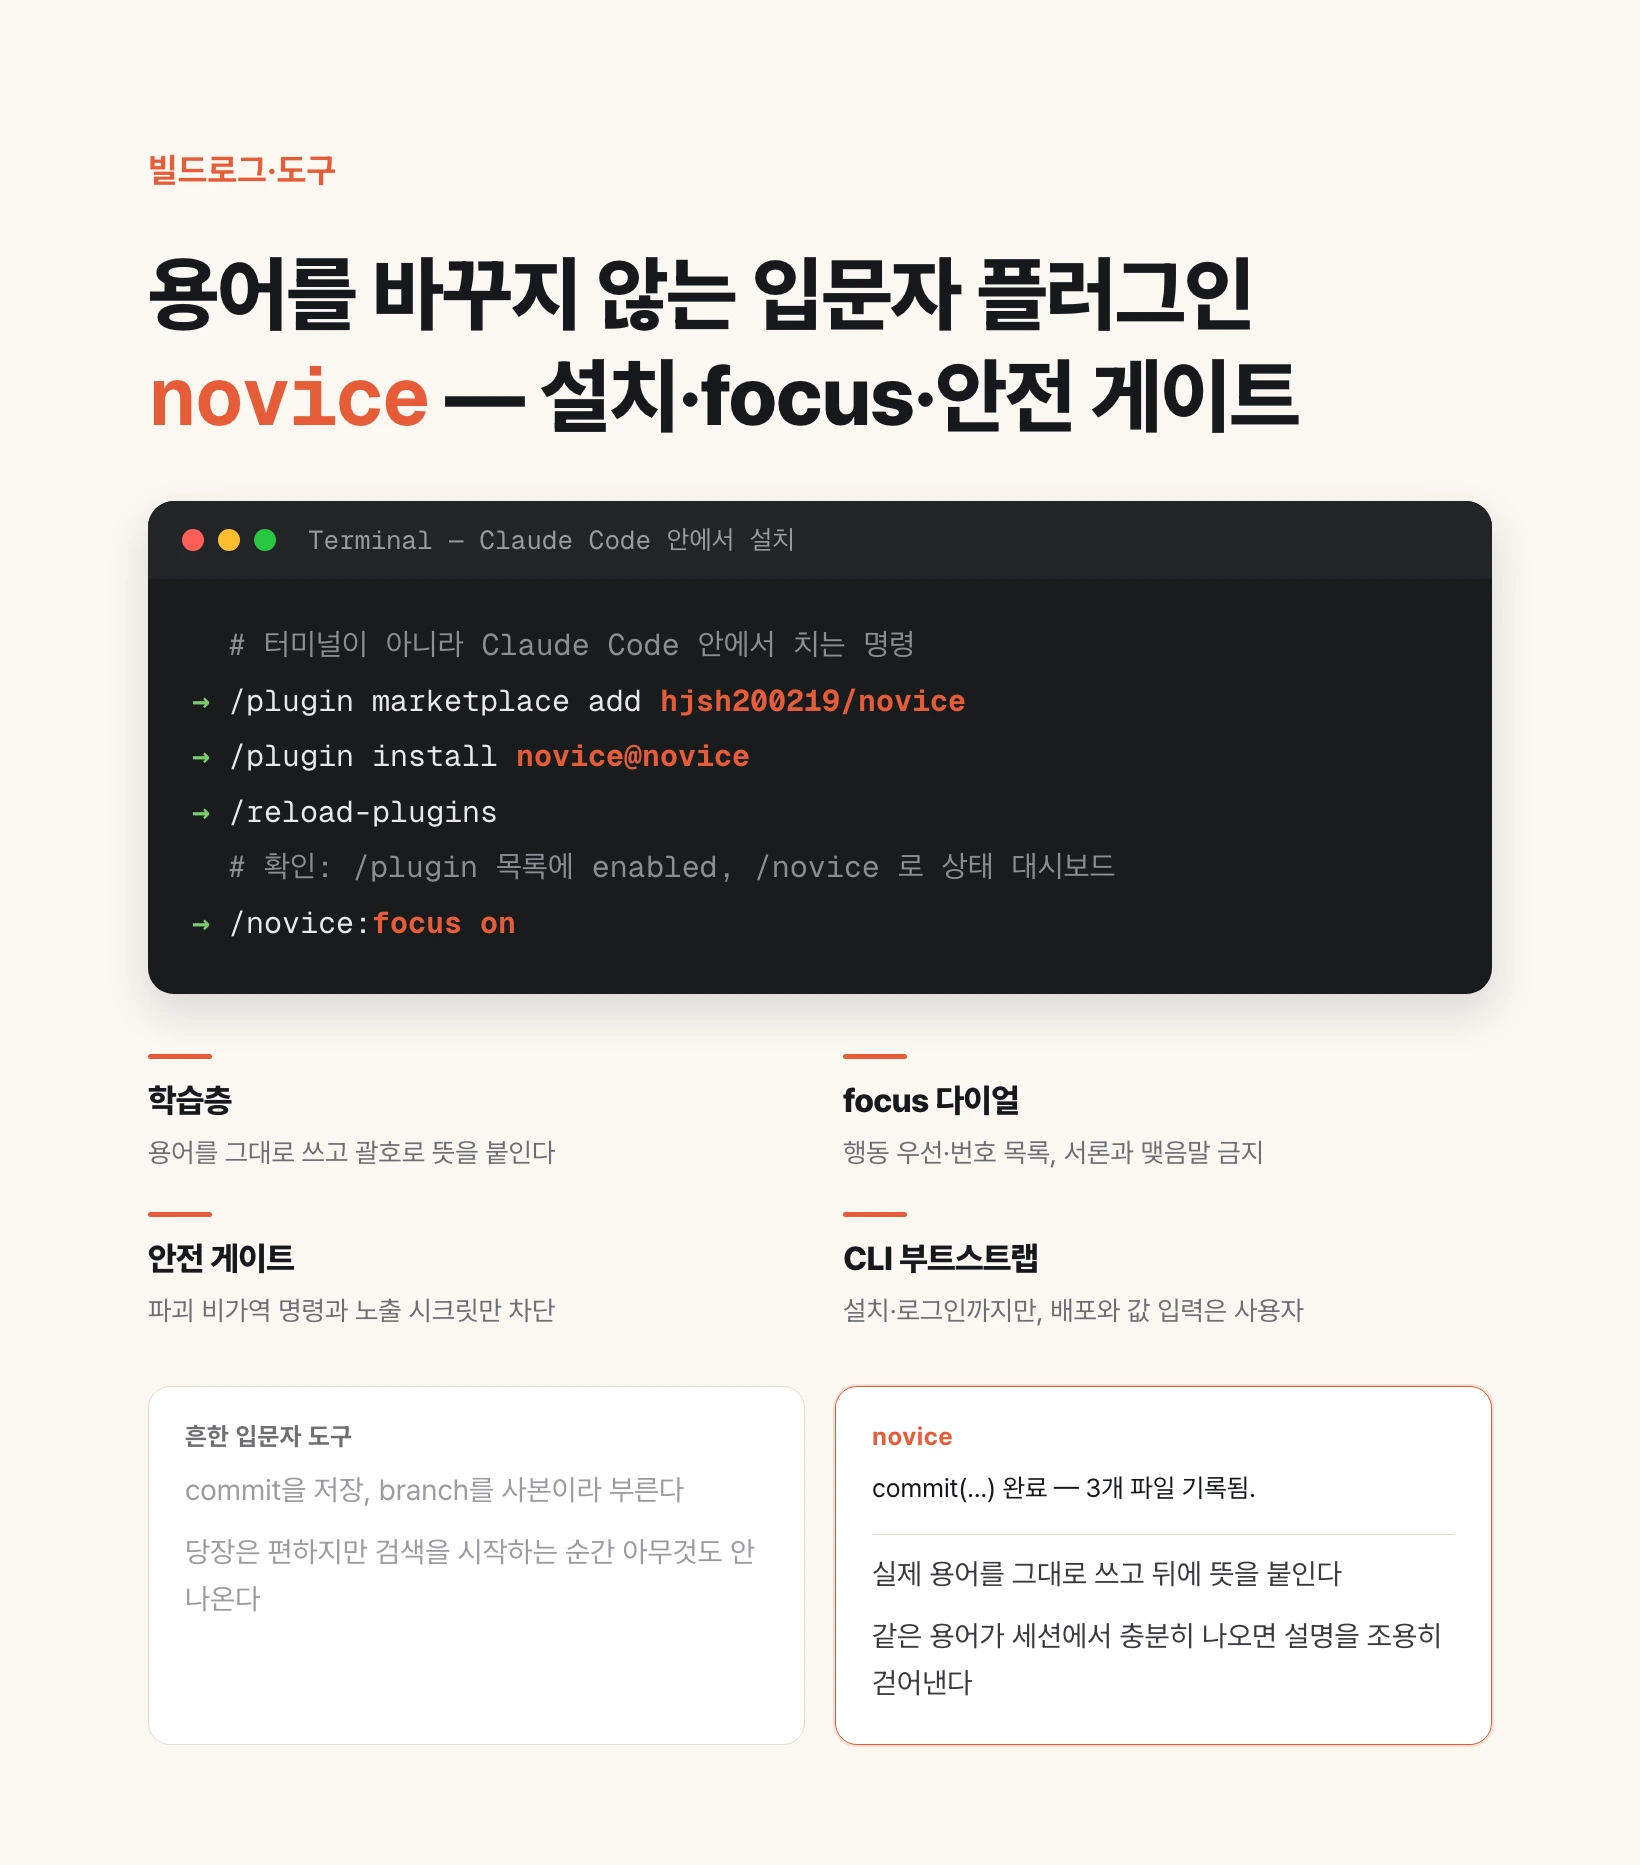
novice는 비개발자가 Claude Code로 코딩을 시작할 때 붙이는 플러그인이다. 하는 일은 셋이다. 첫째, 개발 용어를 쉬운 말로 바꾸지 않고 그대로 쓴 다음 괄호로 뜻을 붙이고, 그 용어가 세션에서 충분히 나오면 설명을 걷어낸다. 초보 화법으로 갈아입히는 대신 진짜 용어를 배우게 하는 쪽을 택한 것이다. 둘째, 답이 길어 어디서부터 손대야 할지 모를 때 켜는 focus 다이얼이 있다. 켜면 답변이 행동 우선·번호 목록 형태로 강제되고 서론과 맺음말이 사라진다. 셋째, 되돌릴 수 없는 파괴 명령과 노출된 시크릿만 골라 막는 안전 게이트가 플러그인이 켜져 있는 동안 항상 돌고, 외부 서비스 CLI는 설치와 로그인까지 대신 밟아 준다. 설치 경로는 두 가지다. Claude Code 안에서 marketplace로 붙이거나, npm 패키지 claude-novice로 받는다. MIT이고 외부 런타임 의존성이 없으며 현재 0.4.0이다.
AI를 유튜브로 배우려면 어떤 채널을 봐야 하나
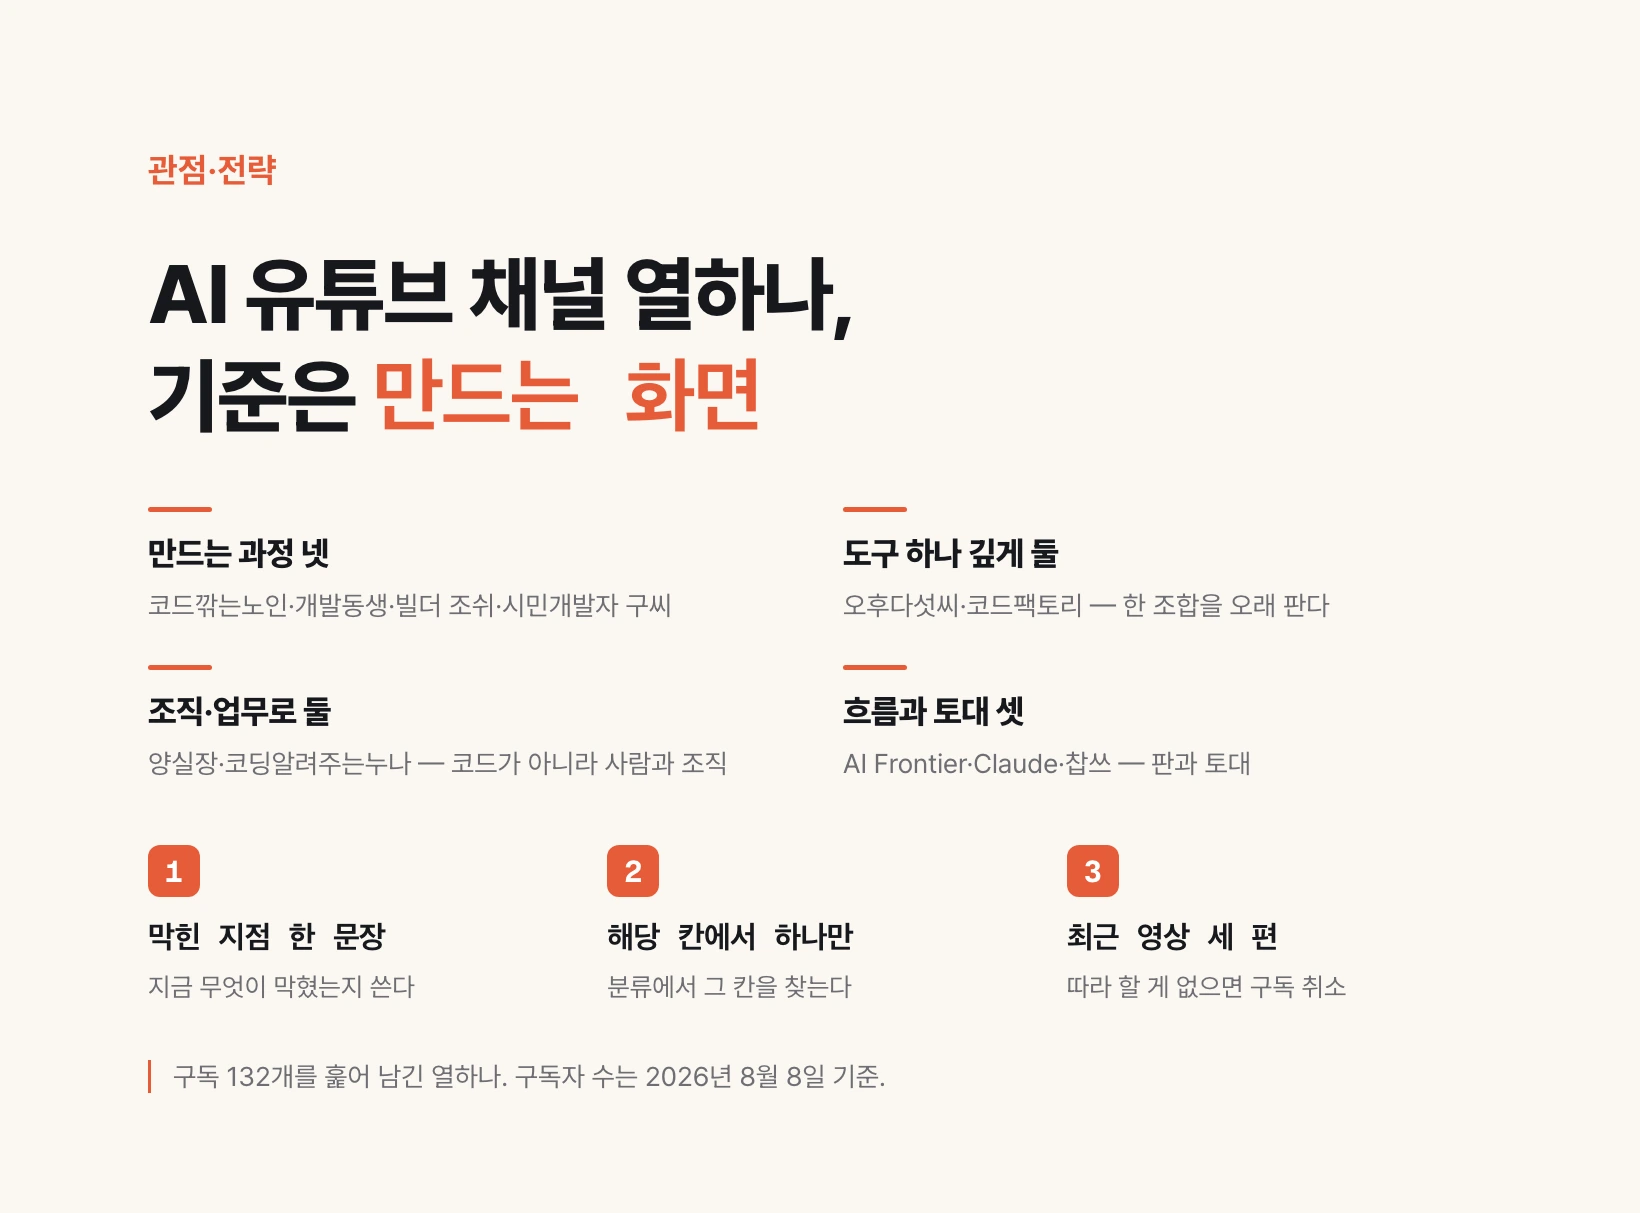
구독 132개를 훑어 AI를 실제로 배우는 데 쓰는 채널 열하나만 남겼다. 고른 기준은 하나다 — 요약이 아니라 만드는 화면을 보여 주는가. 만드는 과정을 보는 넷, 도구 하나를 깊게 파는 둘, 조직·업무로 옮기는 둘, 흐름을 읽는 둘, 토대를 다지는 하나로 나눠 주소와 함께 정리한다.
바이브 코딩에 모자란 건 코드가 아니라 UI/UX 개념
AI는 요구사항을 화면으로 옮겨 준다. 그런데 무엇을 접고 무엇을 남길지는 정해 주지 않는다. 같은 지도 화면을 엿새 사이에 다시 정리하면서 실제로 쓴 원칙 넷 — 익숙한 것을 베끼고, 나열하지 말고 묶고, 전부 펼치지 말고 필요할 때만 꺼내고, 공통인 말은 항목이 아니라 제목이 지게 한다.
카카오톡 로컬 DB는 어떻게 읽고, 왜 맥에서만 되는가
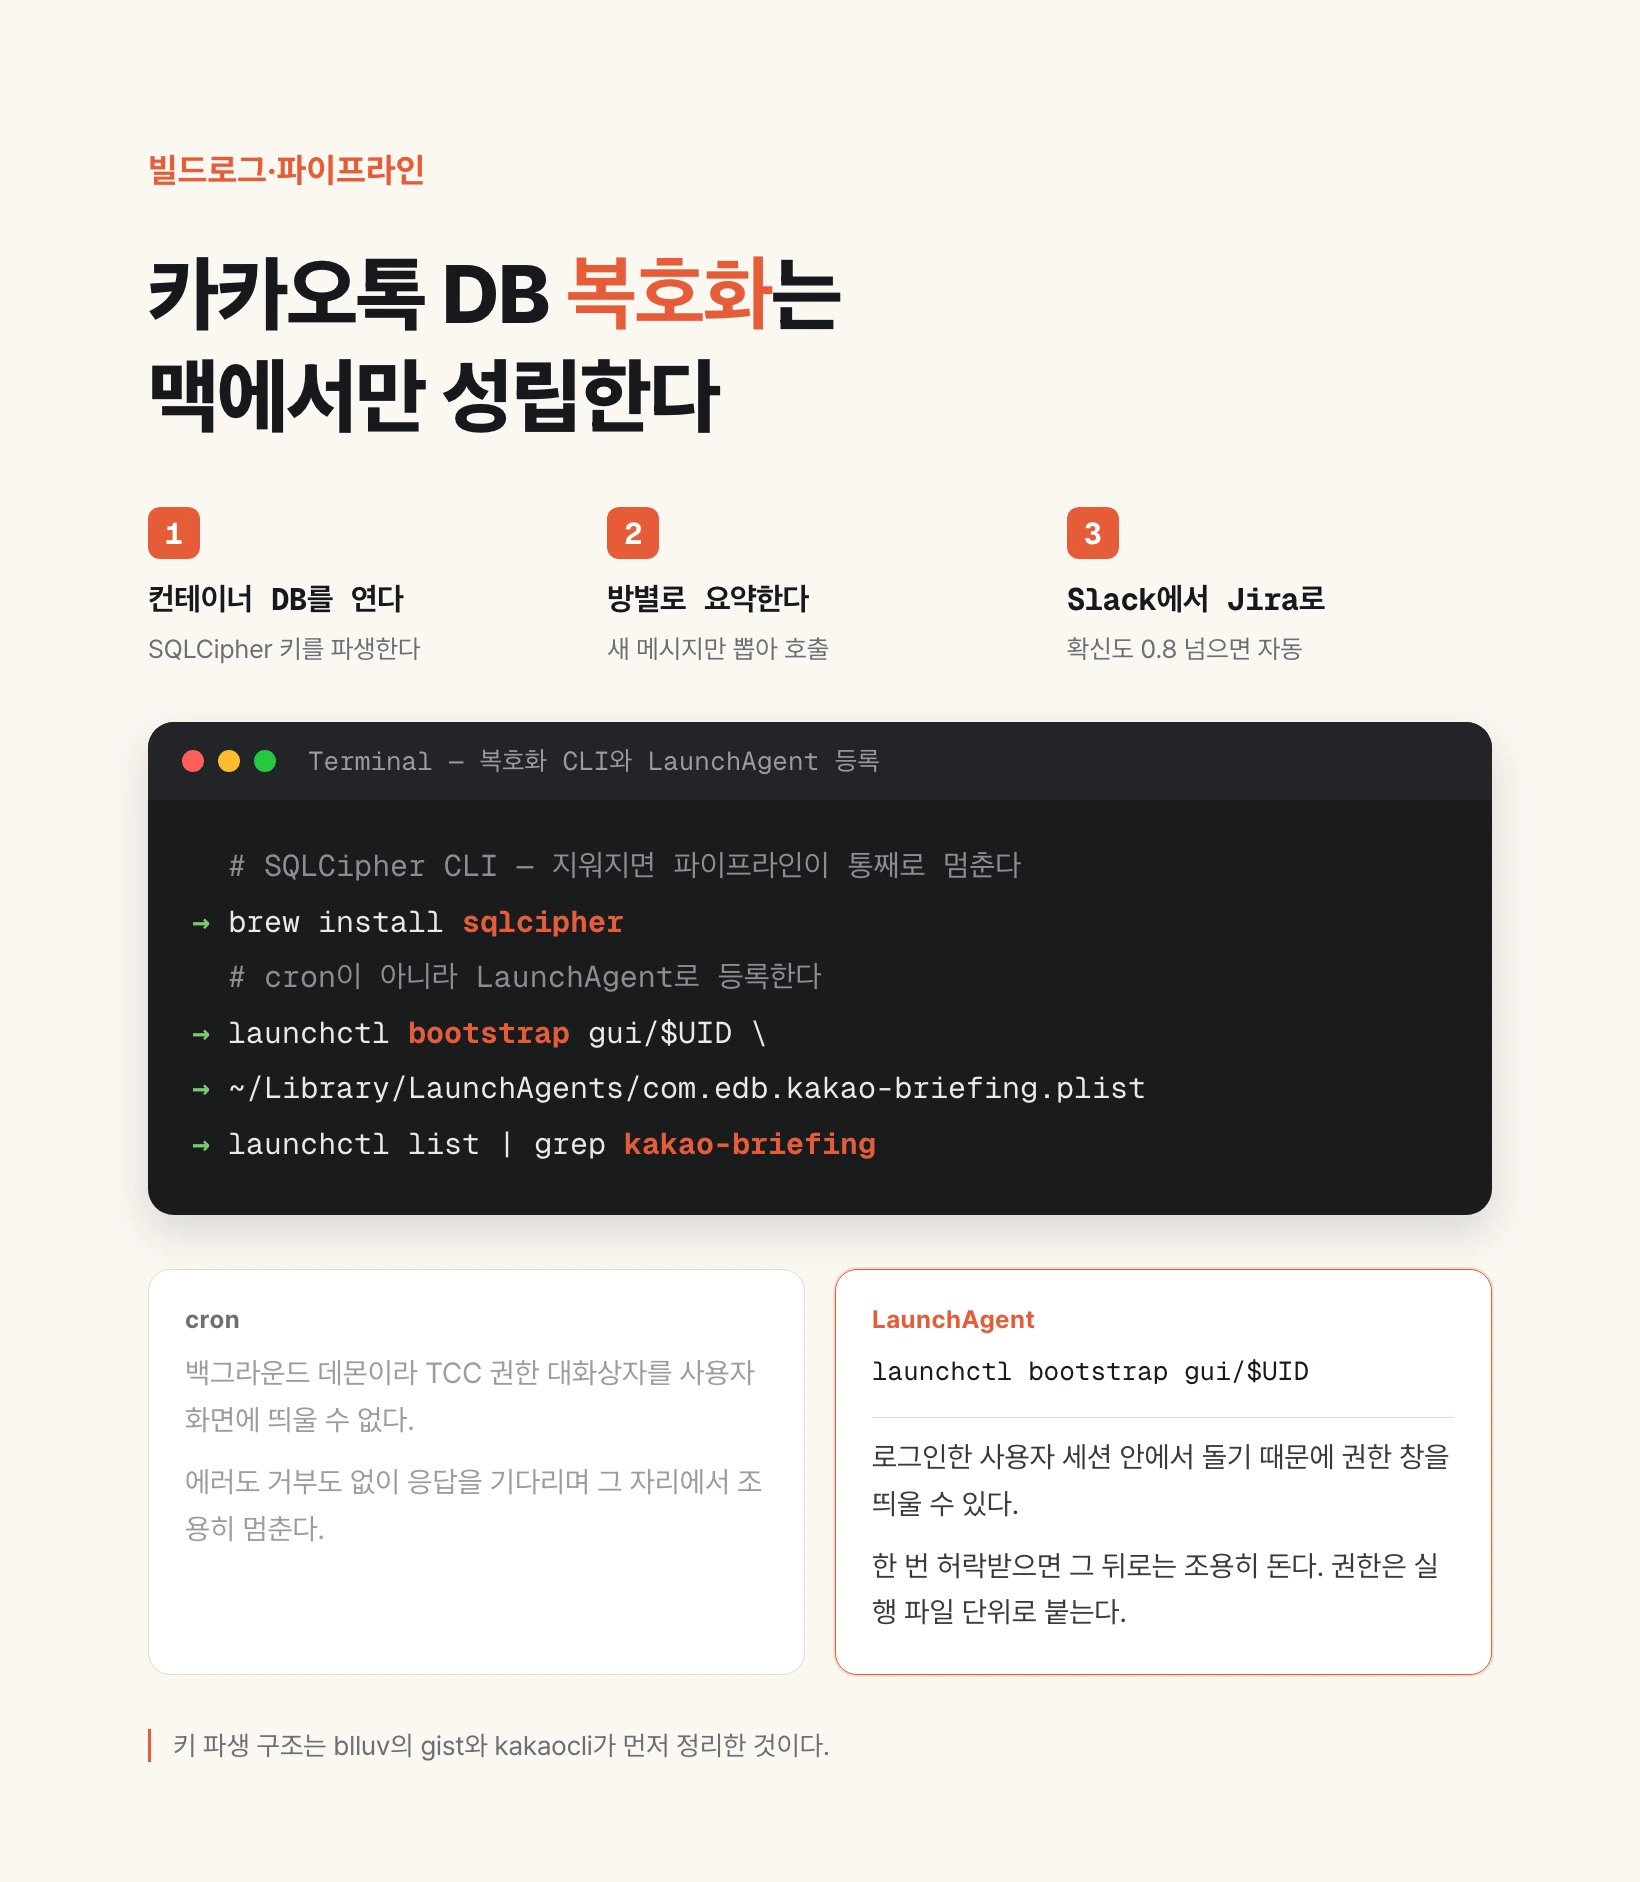
카카오톡에는 다른 프로그램이 대화를 읽어 갈 수 있는 공식 API가 없다. 그래서 대화를 코드로 다루려면 맥용 카카오톡이 자기 앱 폴더에 남겨 둔 데이터베이스 파일을 직접 여는 수밖에 없다. 이 파일은 SQLCipher로 통째로 암호화돼 있고, 열쇠는 이 맥의 하드웨어 고유번호와 내 카카오 계정 번호를 재료로 만들어진다. 하드웨어 고유번호를 읽는 방식도, 앱이 파일을 두는 위치도, 그 폴더에 접근할 때 요구되는 권한 체계도 전부 macOS 것이라 이 파이프라인은 맥에서만 돈다. 게다가 cron으로 돌리면 권한 창을 띄우지 못해 조용히 멈춘다. 여기까지 넘기고 나면 나머지는 평범하다. 방별로 새 메시지만 뽑아 요약하고, Slack으로 보내고, Slack에서 봇을 부르면 AI가 이슈 본문을 써 Jira에 등록한다.
Bing Webmaster Tools — GSC에서 가져오기로 등록하고 AI 인용을 보는 법
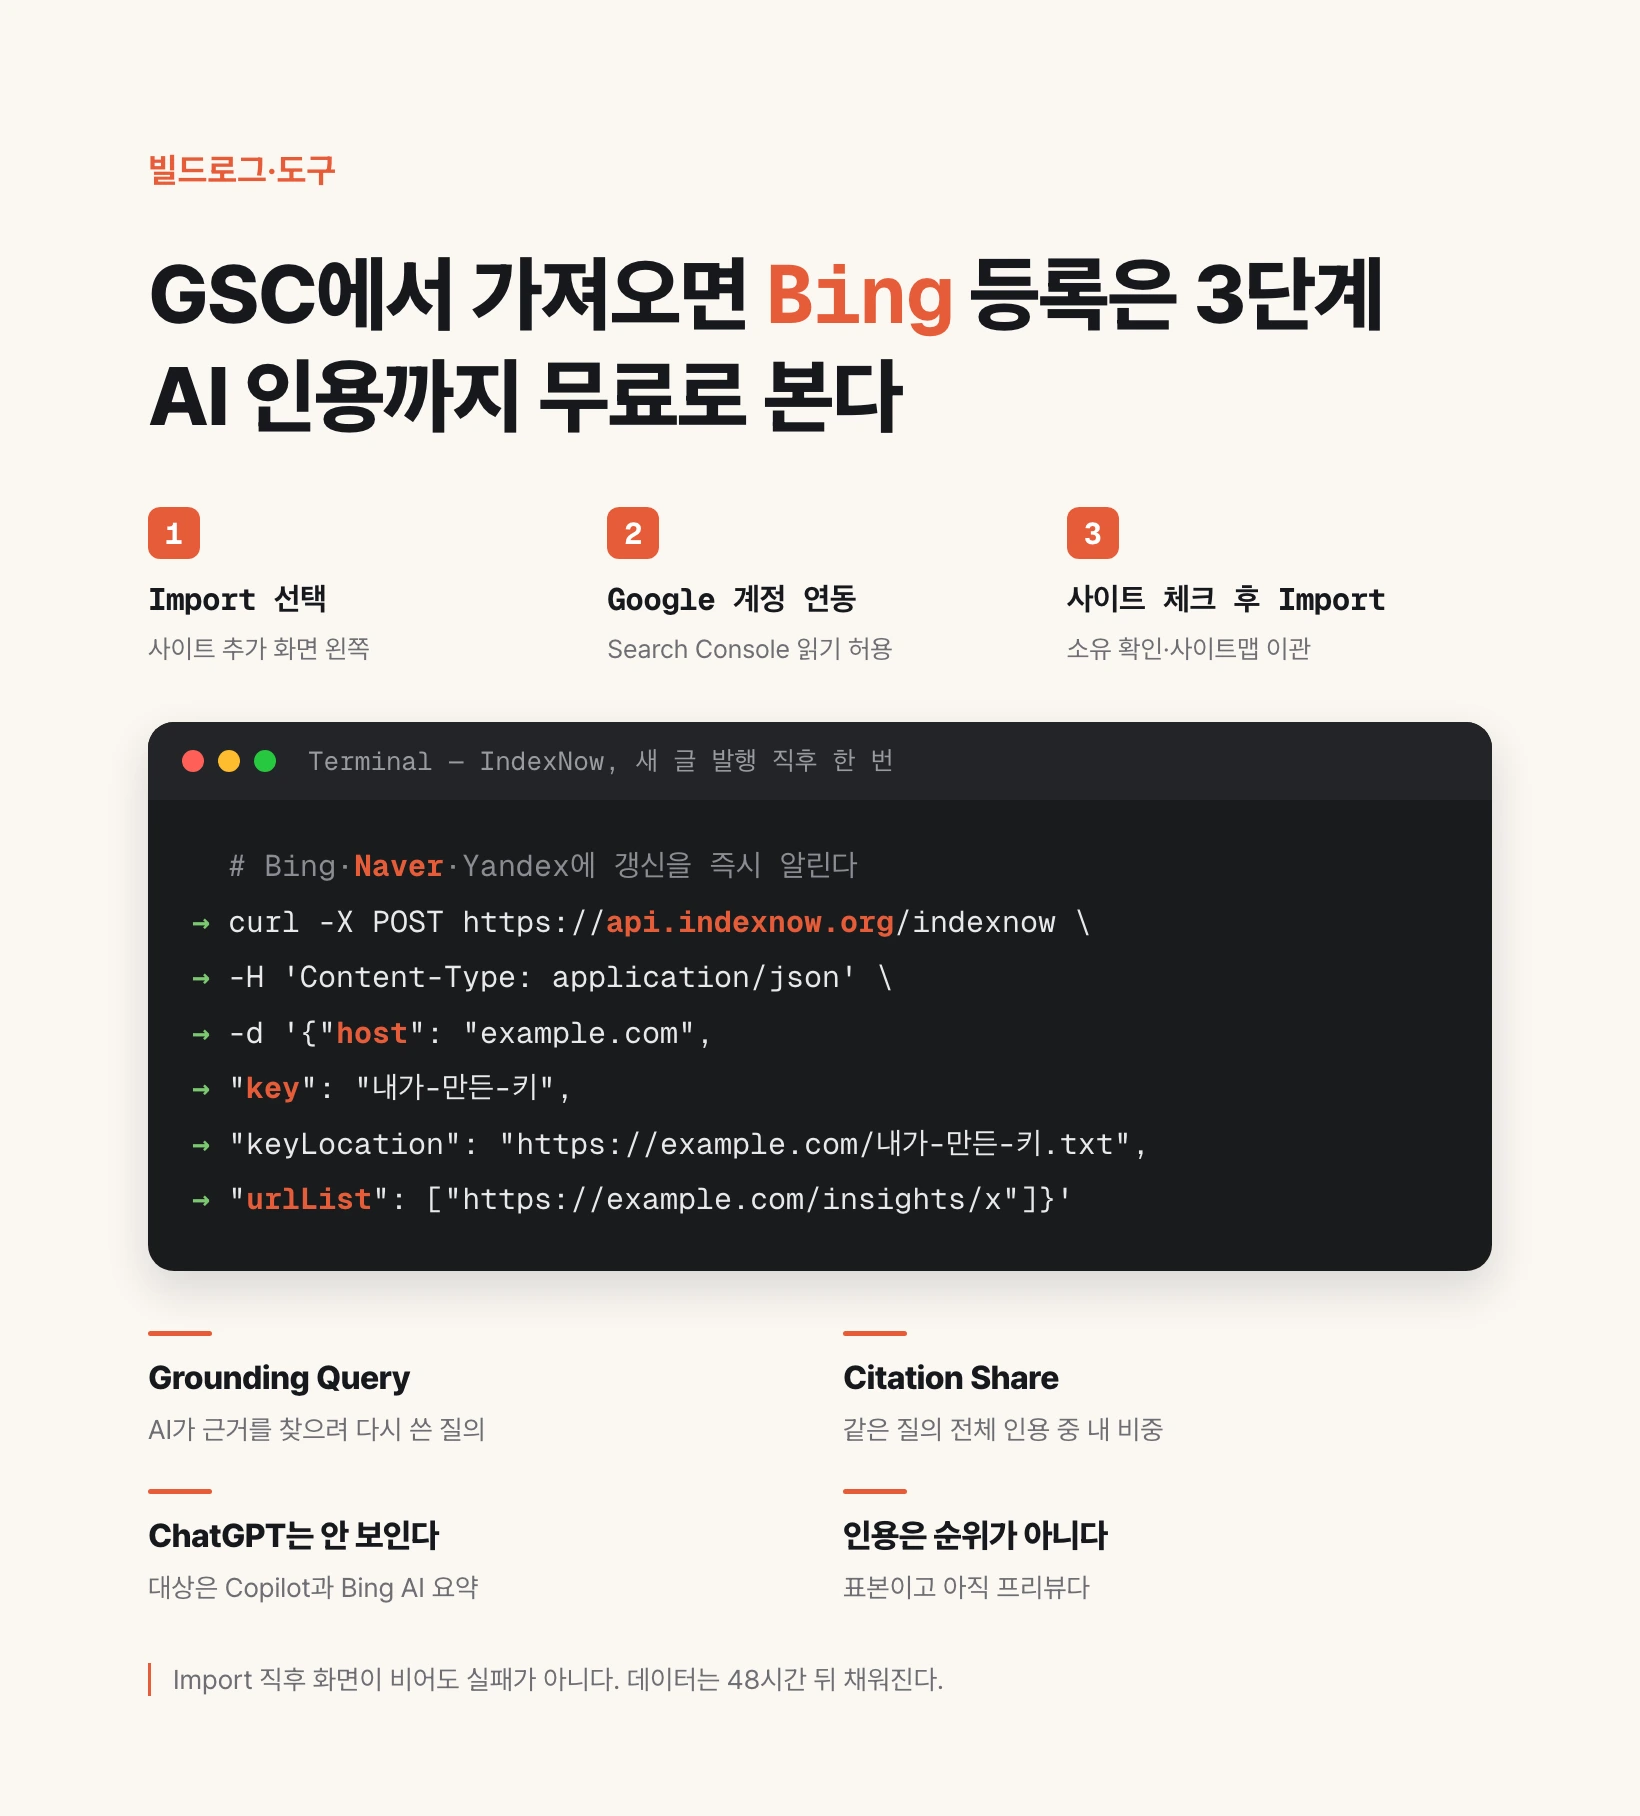
Bing Webmaster Tools는 마이크로소프트가 무료로 주는 사이트 소유자용 콘솔이다. Google Search Console(GSC)의 Bing판이라고 보면 되고, 색인 상태와 검색 쿼리, 사이트맵, 백링크를 보여주며 URL을 직접 제출하게 해 준다. 등록은 사이트 추가 화면에서 왼쪽 Import를 골라 Google 계정을 연동하면 끝난다. GSC에서 이미 소유 확인을 마친 사이트와 사이트맵이 그대로 넘어오고, 메타 태그나 DNS 레코드를 다시 만질 필요가 없다. 그리고 2026년 2월부터 AI Performance 리포트가 붙어, Microsoft Copilot과 Bing의 AI 요약이 내 페이지를 인용한 횟수를 무료로 보여준다.
RSI·MACD·볼린저밴드 — 퀀트 보조지표 5종
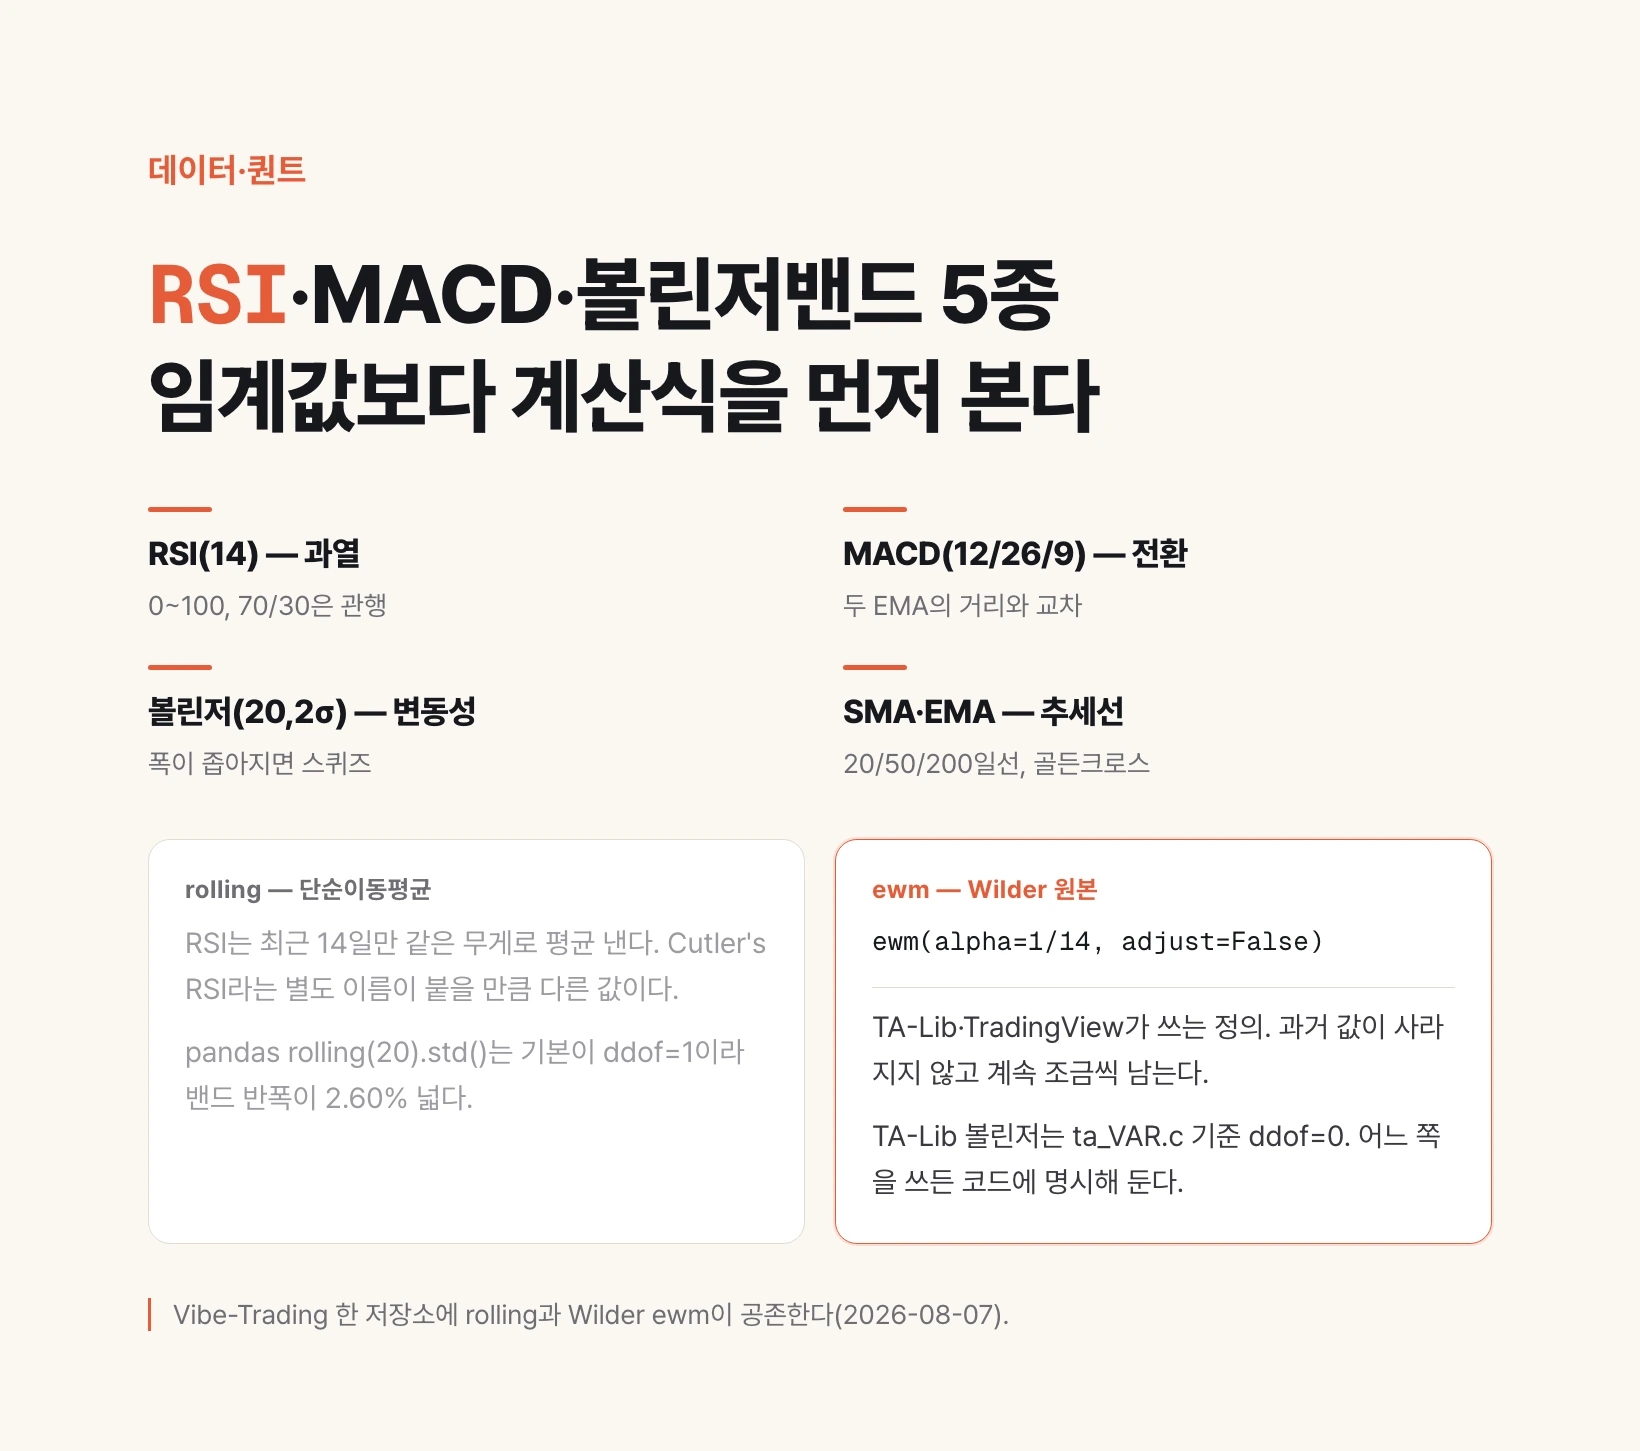
보조지표는 시가·고가·저가·종가·거래량이라는 1차 데이터에서 한 번 더 계산해 뽑은 2차 값이다. 종류는 수백 개지만 AI 트레이딩 에이전트가 툴 하나로 바로 호출하는 것은 RSI(14)·MACD(12/26/9)·볼린저밴드(20, 2σ)·SMA(20/50/200)·EMA(20) 다섯이고, 이 다섯이 과열·추세전환·변동성·장기추세를 덮는다. 다만 같은 이름이 같은 숫자를 뜻하지는 않는다. RSI는 평활을 Wilder 방식(ewm alpha=1/14)으로 하느냐 단순이동평균(rolling 14)으로 하느냐에 따라, 볼린저밴드는 표준편차를 ddof=1로 재느냐 ddof=0으로 재느냐에 따라 값이 갈린다. 지표를 붙이기 전에 확인할 것은 임계값이 아니라 계산식이다.
Creem — 토스도 Stripe도 막혔을 때 붙이는 결제
Creem은 판매 주체를 판매자 대신 떠맡는 머천트 오브 레코드(MoR) 결제 플랫폼이다. 고객은 나에게서가 아니라 Creem에게서 사고, 그 대가로 Creem이 190여 관할의 세금 계산·징수·납부와 환불·분쟁 처리를 진다. 수수료는 성공한 결제 건당 3.9% + 0.40달러이고 월 이용료도 초기 비용도 없다. 상품을 만들어 나오는 product ID 하나를 코드에 넣으면 결제창이 열리고, 결제가 끝나면 첨부한 파일이 구매자에게 자동으로 간다. 코드를 아예 안 쓰고 결제 링크만 공유해도 판매가 시작된다.
PillDoc 약국입지 — 서울 병원·약국 자리를 지도에서 보는 법
약국입지는 필독(PillDoc)이 공개한 조회 전용 지도 화면입니다. 서울에서 의원이 새로 들어설 만한 자리와 약국이 새로 열 만한 자리를 100점 만점 점수로 매겨 지도 위에 보여 줍니다. https://www.pilldoc.co.kr/PharmSite 주소에서 로그인 없이 바로 열리고, 자리를 하나 누르면 예상 처방유입·월 조제매출·주변 경쟁 약국까지 함께 나옵니다. 다만 화면의 모든 금액과 건수는 실적이 아니라 모델이 낸 추정치입니다.
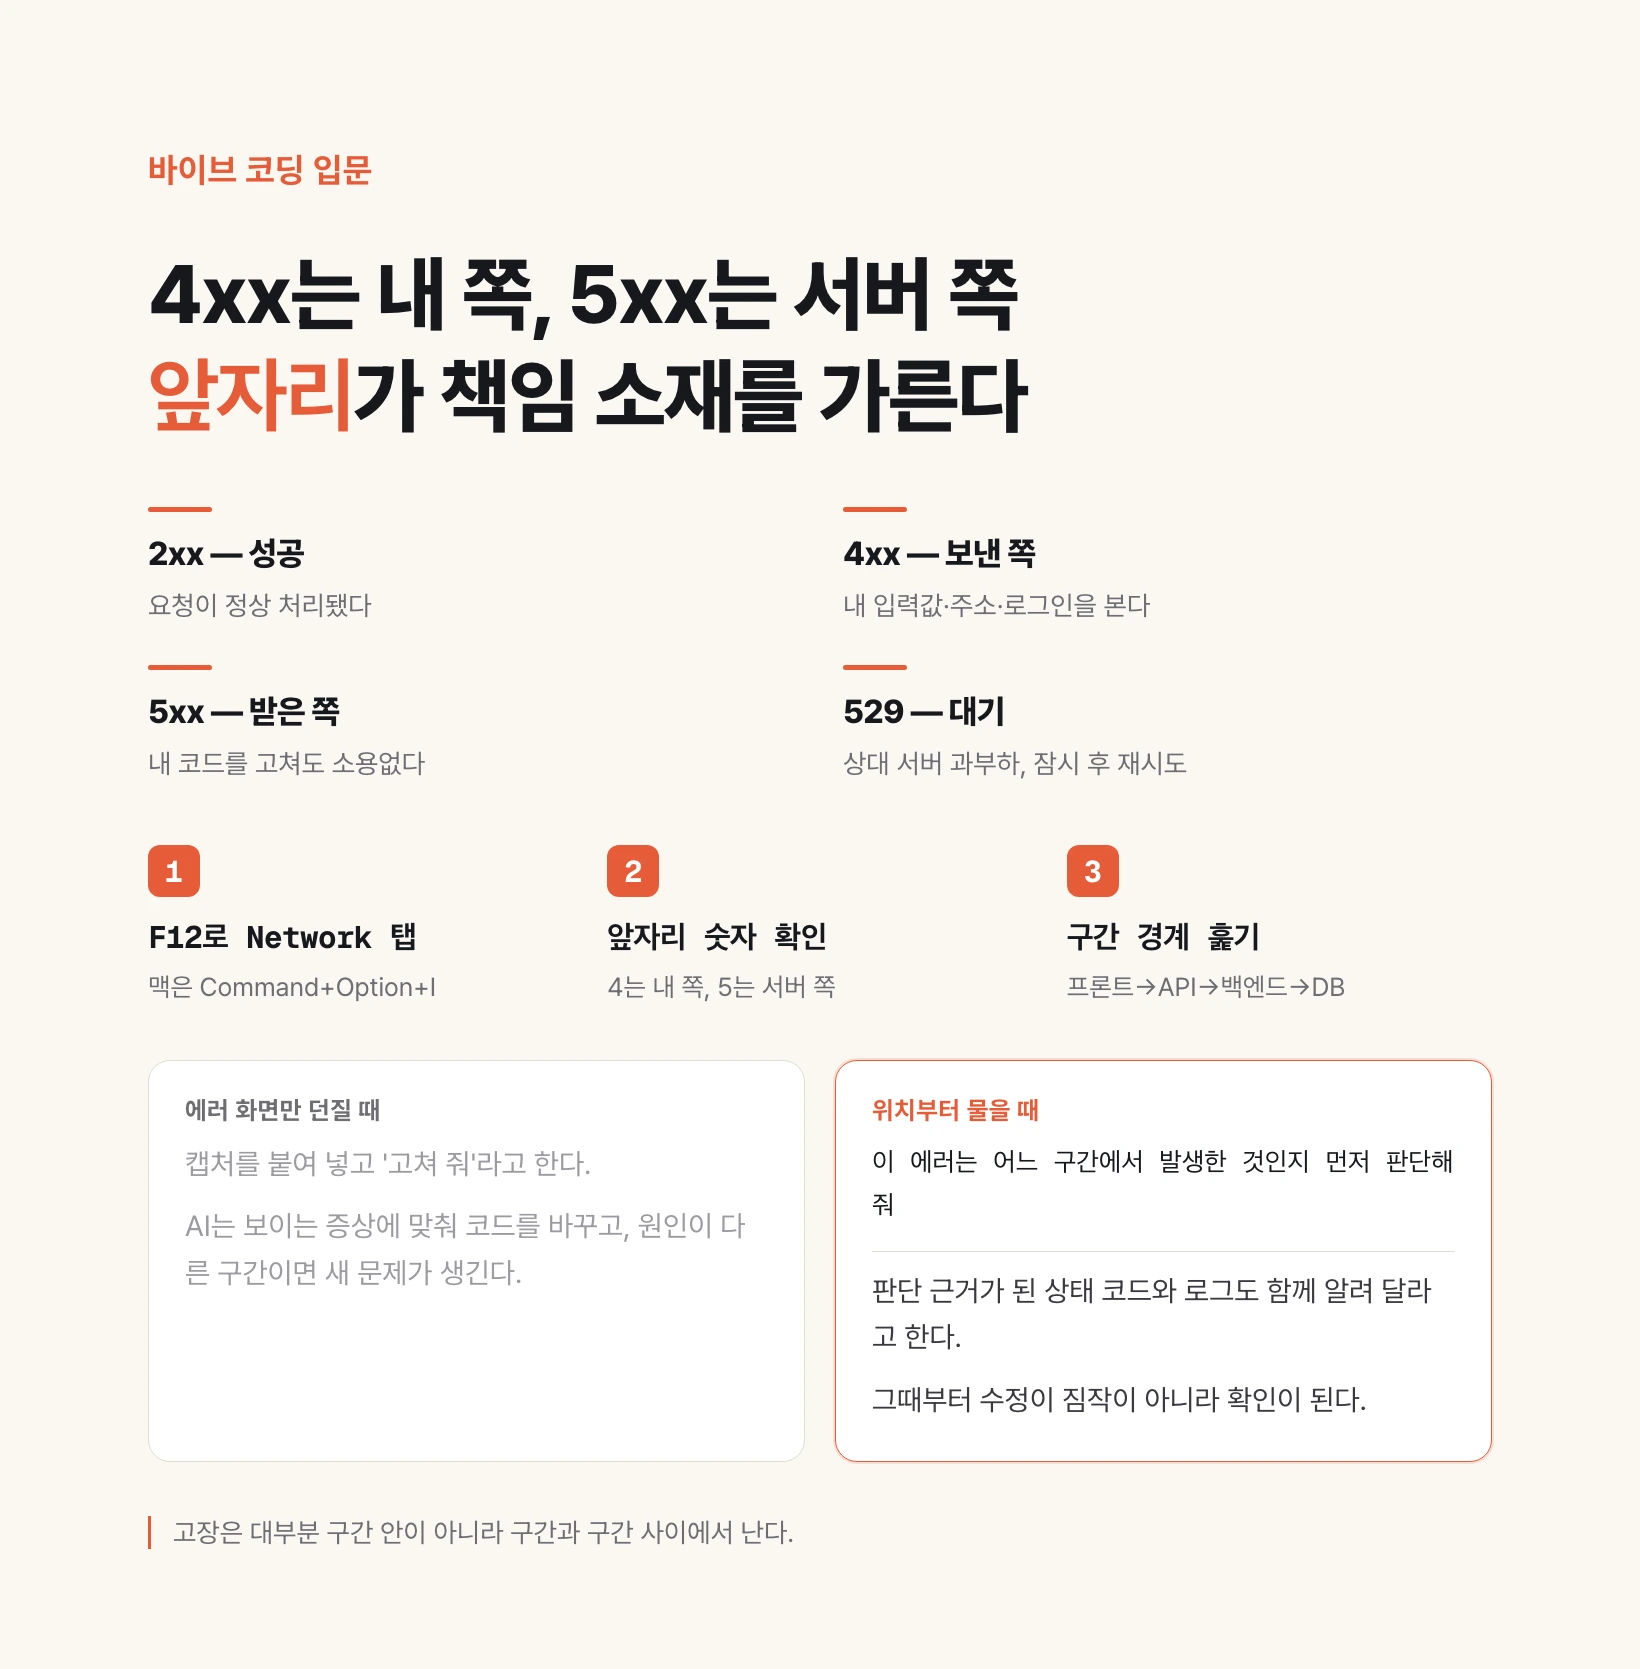
4xx와 5xx — 에러가 뜨면 어디를 봐야 하나
에러 코드 앞자리 하나가 책임 소재를 가른다. 2로 시작하면 성공, 4로 시작하면 요청을 보낸 내 쪽(프론트엔드나 입력값)의 문제, 5로 시작하면 그 요청을 받은 서버 쪽의 문제다. 상태 코드는 브라우저에서 F12(맥은 Command+Option+I)를 눌러 개발자 도구를 열고 Network 탭에서 실패한 요청을 클릭하면 보인다. 앞자리로 방향을 잡은 다음에는 요청이 지나는 구간(프론트엔드 → API → 백엔드 → 데이터베이스)을 순서대로 훑어 어느 경계에서 끊겼는지 좁힌다. 고장은 대부분 구간 안이 아니라 구간 사이에서 나기 때문이다. 이 두 단계를 알고 있으면 AI에게 '고쳐 달라'고 스무고개를 하는 대신 '이 에러는 어느 구간에서 생겼나'라고 물을 수 있고, 그때부터 수정이 짐작이 아니라 확인이 된다.
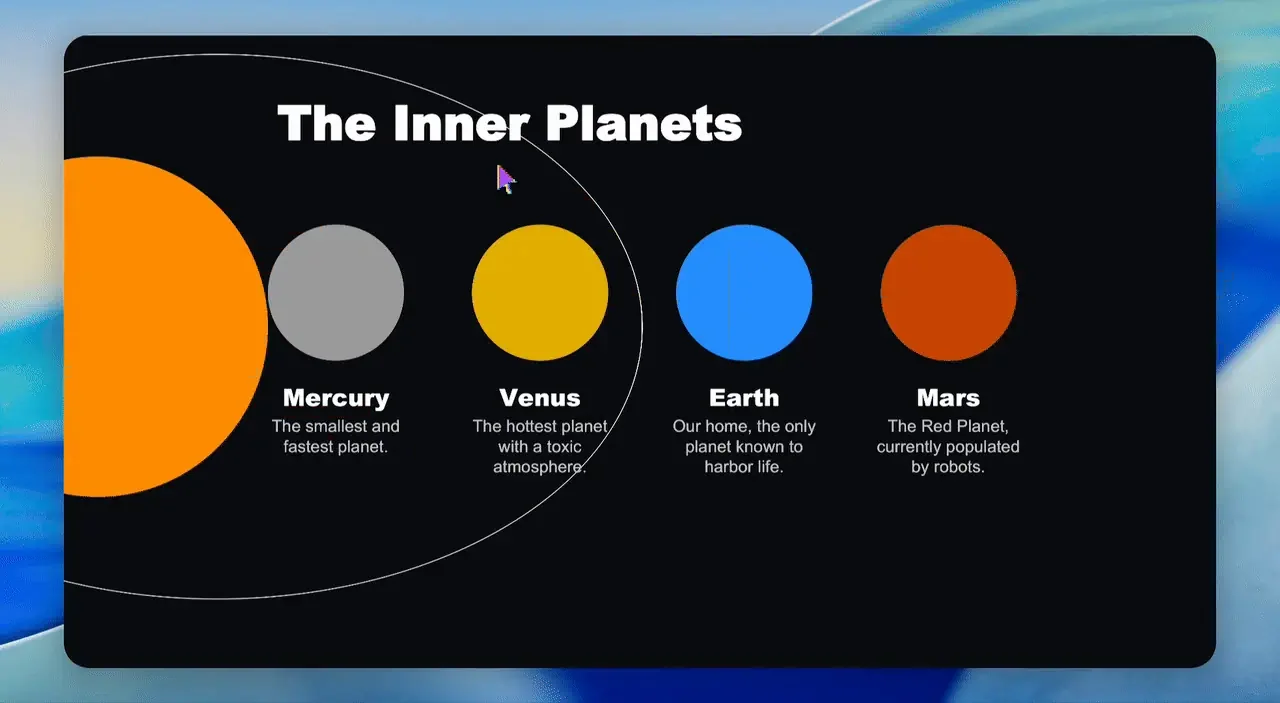
OfficeCLI — 엑셀·워드·파워포인트 야근을 없애는 CLI
OfficeCLI는 AI 에이전트와 개발자가 명령어 한 줄 또는 자연어 한 마디로 워드·엑셀·파워포인트 문서를 만들고 읽고 고칠 수 있게 해주는 오픈소스 CLI다. Microsoft Office 설치 없이 단일 실행파일로 동작하고, 만든 문서를 직접 화면에 렌더링해 확인한 뒤 스스로 고치는 것이 다른 자동화 방법과 다른 점이다.
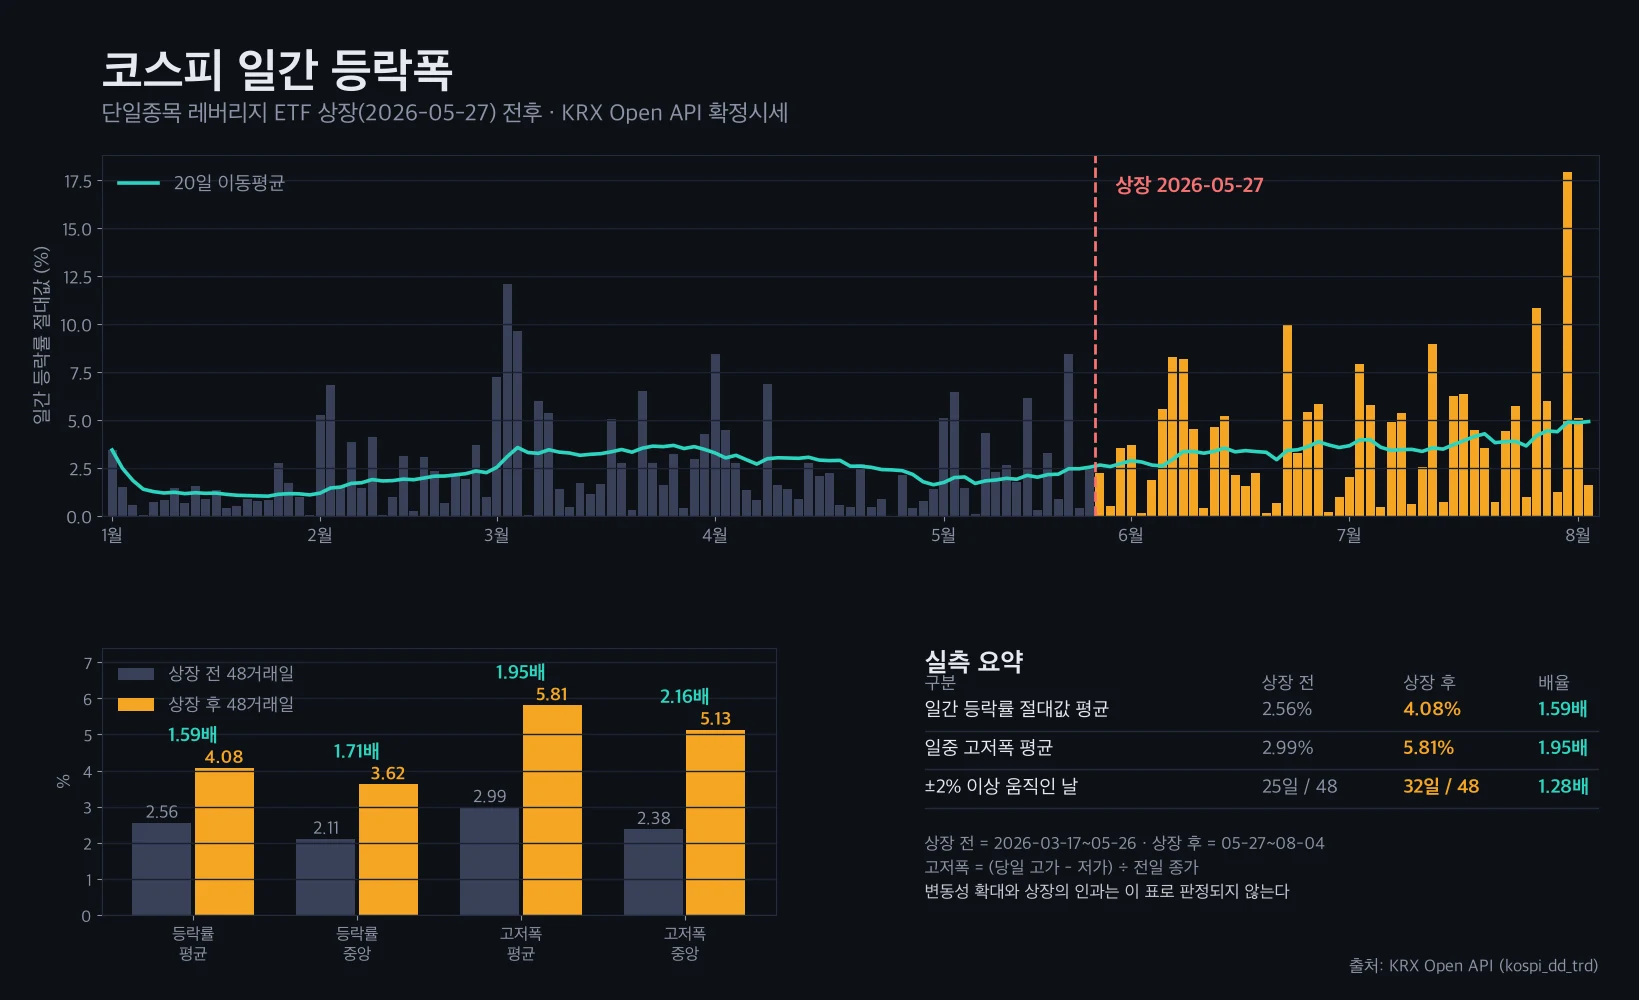
KRX Open API — 코스피 등락폭을 직접 재는 법
KRX Open API는 한국거래소가 openapi.krx.co.kr에서 제공하는 공개 데이터 서비스다. 인증키를 AUTH_KEY 헤더에 담고 기준일 하나를 basDd로 넘기면 그날의 시가·고가·저가·종가가 json으로 돌아온다. 신청은 화면에 적힌 대로 네 단계다. 회원가입과 인증키 신청, 서비스 목록에서 API 탐색, 활용신청, 승인 후 사용. 여기서 대부분 한 번 막히는데 인증키 승인과 서비스 활용신청 승인이 별개라, 키만 받고 호출하면 전부 401이다. 이 키로 코스피 등락폭을 직접 재면 표준 라이브러리만 쓰는 파이썬 30줄로 구간 평균·중앙값·극단일 수가 나온다. 실제로 재 보면 단일종목 레버리지 ETF가 상장한 5월 27일 앞뒤 48거래일에서 일간 등락률 절대값 평균이 2.56%에서 4.08%로, 일중 고저폭이 2.99%에서 5.81%로 늘었다. 다만 숫자가 커졌다는 것과 무엇 때문에 커졌는지는 다른 질문이고, 뒤쪽은 이 데이터로 판정되지 않는다.
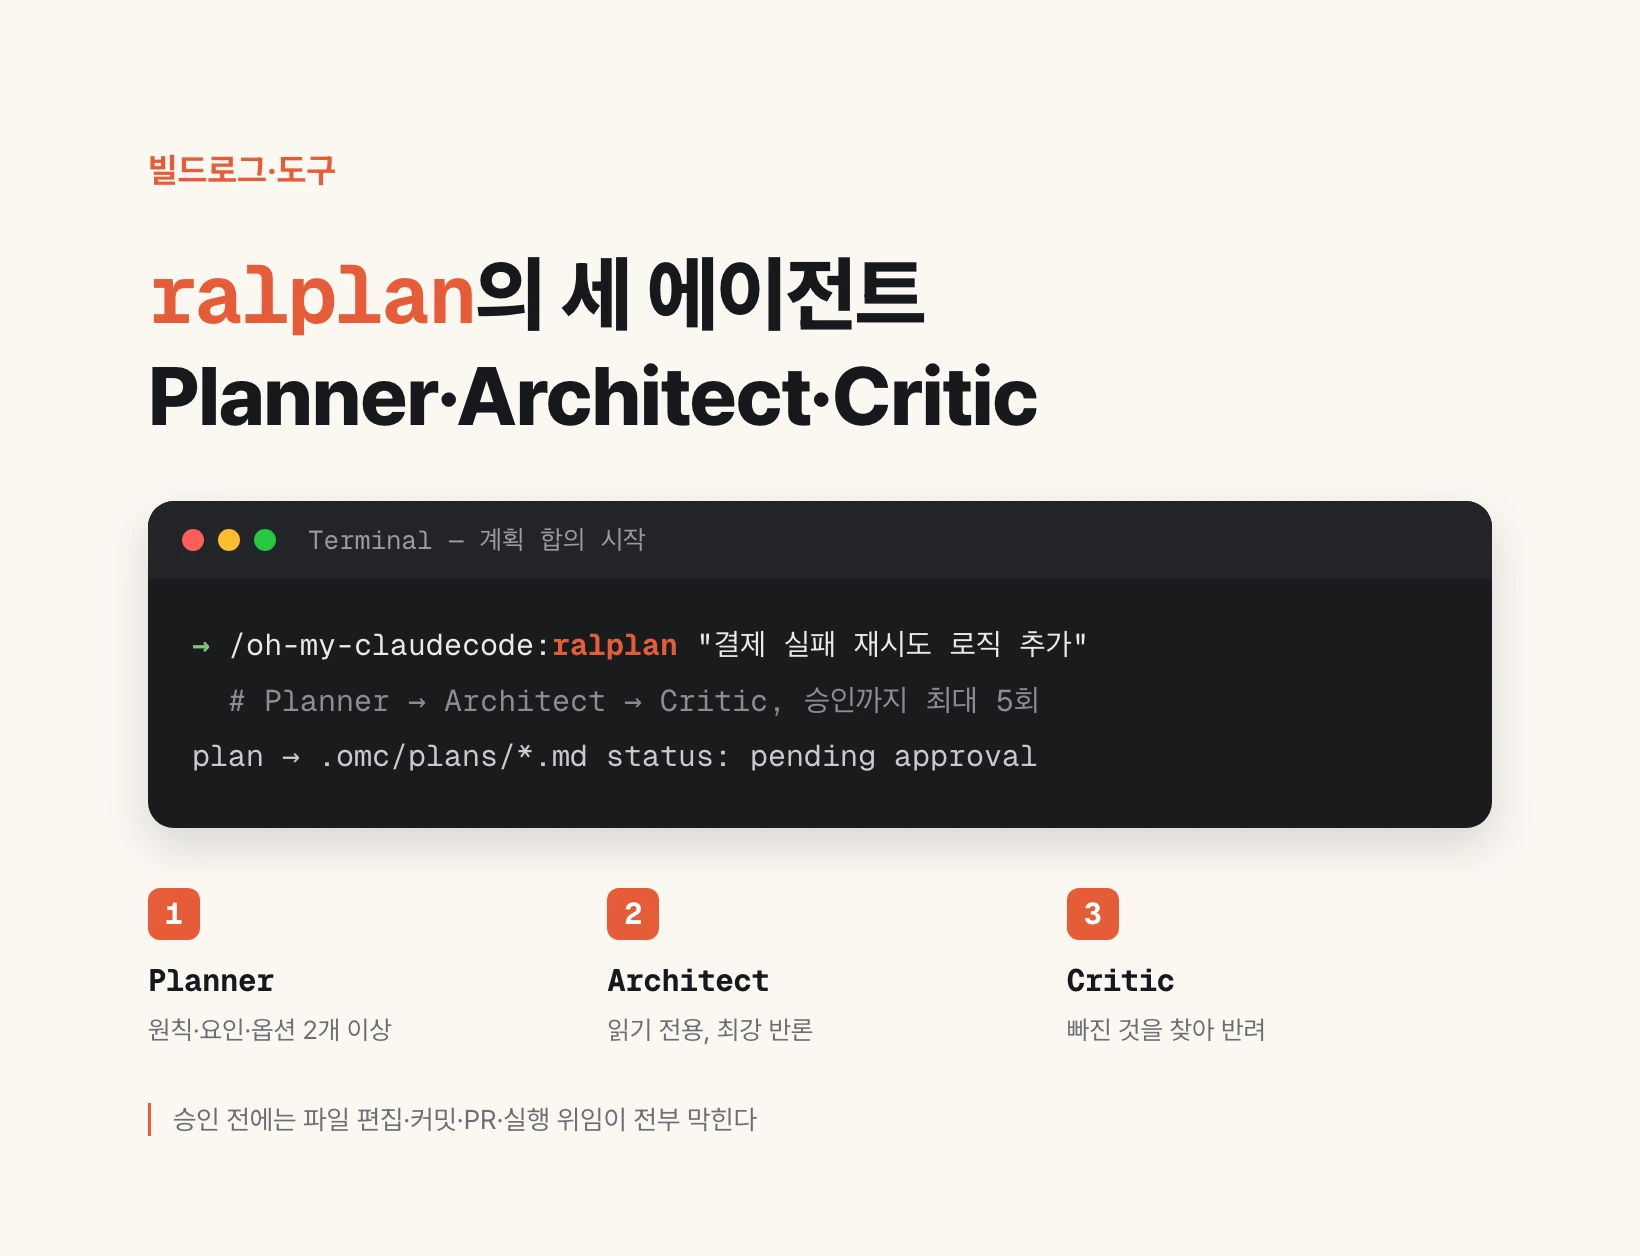
ralplan의 세 에이전트 — Planner·Architect·Critic
ralplan은 오픈소스 하네스 oh-my-claudecode(OMC)의 합의 계획 워크플로다. 터미널에 /oh-my-claudecode:ralplan "작업 설명"이라고 치면 코드가 아니라 세 에이전트가 먼저 붙는다. Planner는 원칙 3~5개, 결정 요인 3개, 실행 가능한 선택지 최소 두 개를 담은 계획을 강제로 쓰고, Architect는 Write·Edit 도구가 막힌 채로 그 계획에 대한 가장 강한 반론만 내놓고, Critic은 적힌 것을 채점하는 대신 빠진 것을 찾아 승인·재작업·반려 중 하나를 판정한다. 셋은 반드시 이 순서로 돌고, 반려되면 Planner 수정 후 Architect부터 다시 도는 루프를 최대 다섯 번 반복한다. 그동안 계획은 pending approval 상태로만 남아 파일 편집·커밋·PR·실행 위임이 전부 막힌다. 설치는 /plugin install oh-my-claudecode 또는 npm i -g oh-my-claude-sisyphus@latest 뒤 /oh-my-claudecode:omc-setup 한 번이면 끝난다.
오픈클로 vs 헤르메스 — 무엇을 깔아야 하나
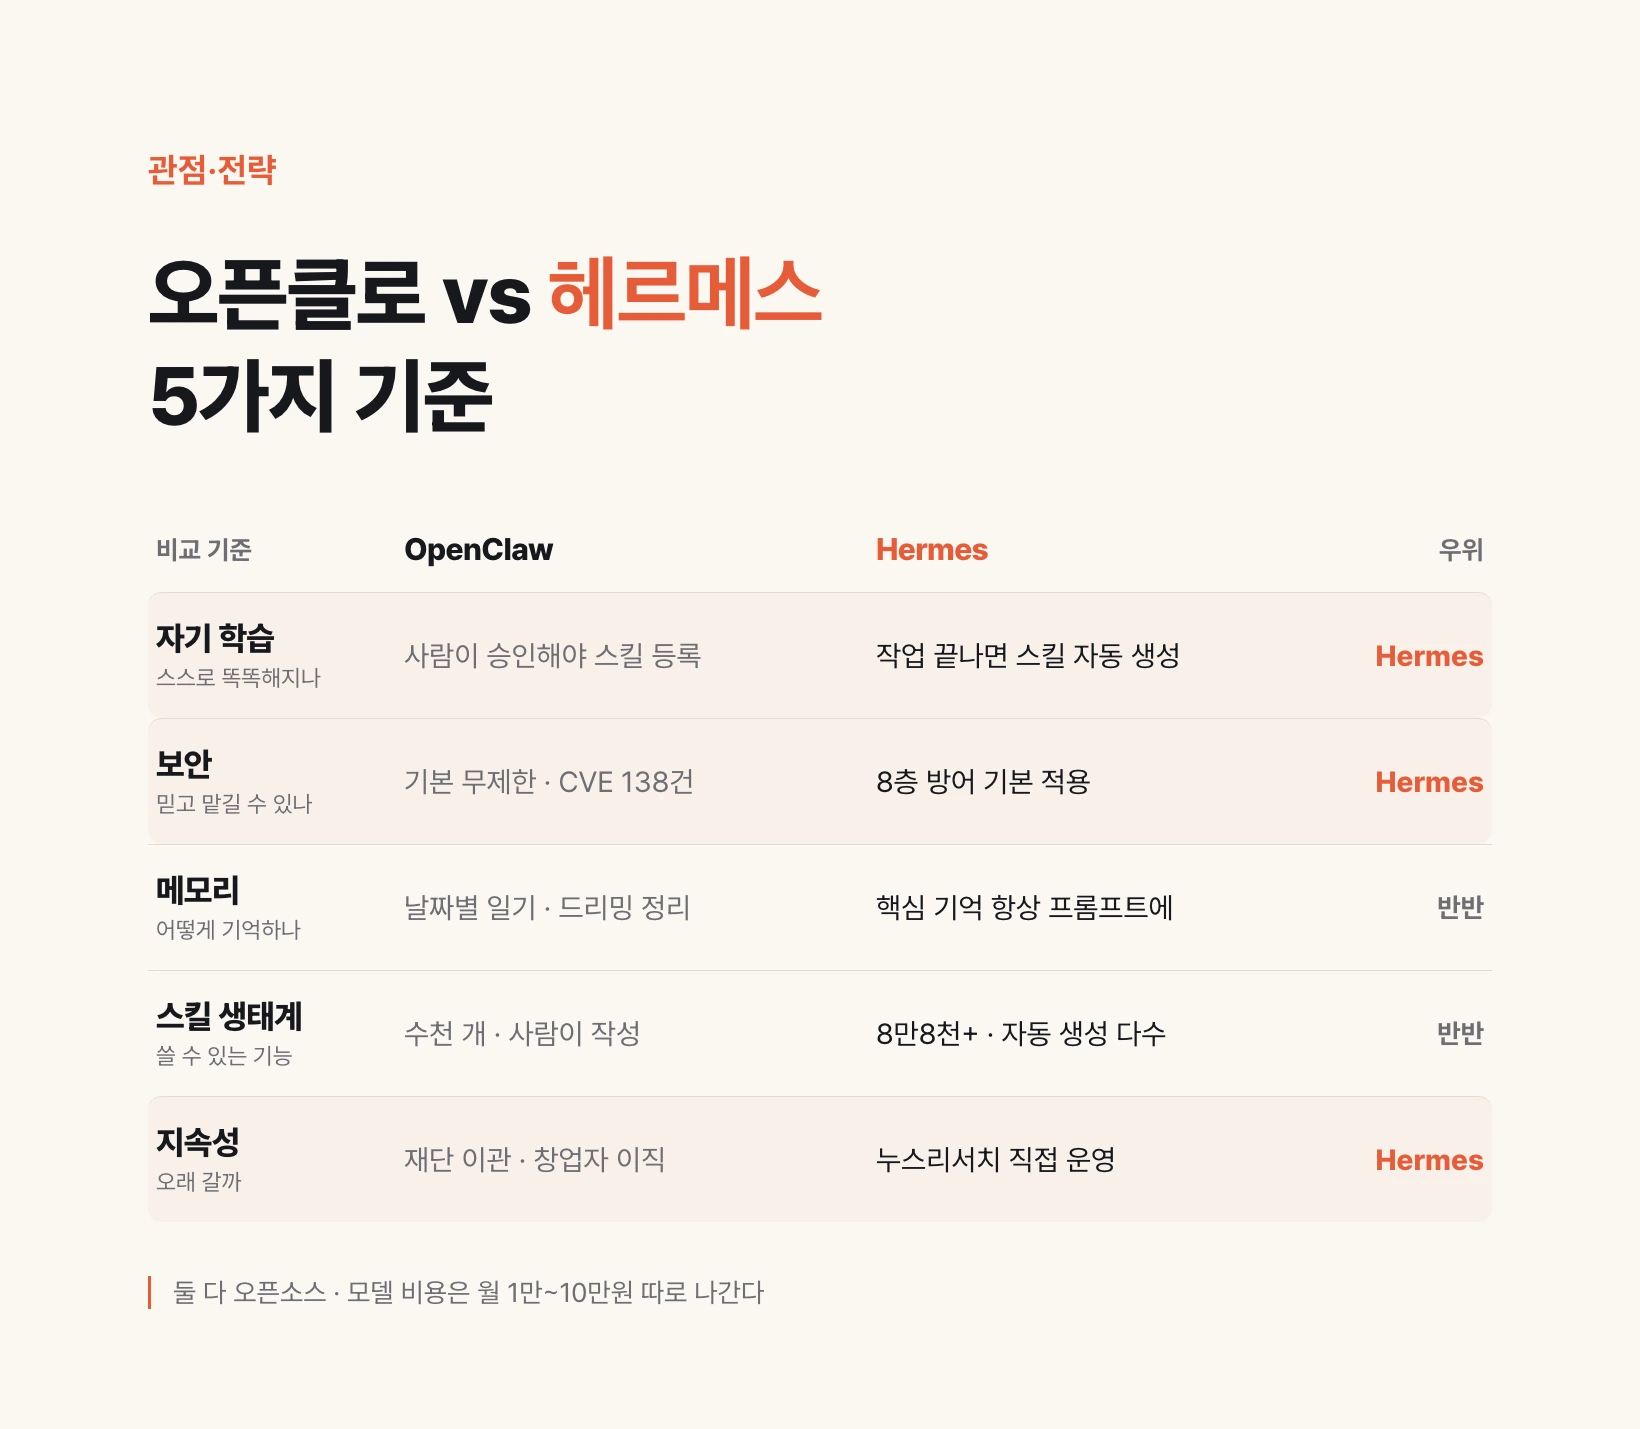
오픈클로와 헤르메스는 텔레그램·슬랙에서 지시하면 내 컴퓨터에서 파일을 만들고 코드를 짜 주는 오픈소스 AI 비서로, 할 수 있는 일은 거의 같다. 실제로 갈리는 것은 자기 학습·보안·메모리·스킬 생태계·지속성 다섯 가지이고, 그중 자기 학습과 보안은 헤르메스가, 메모리와 스킬 생태계는 어느 쪽도 앞서지 않는다. 혼자 일하고 보안이 중요하면 헤르메스, 직접 조립하는 재미와 팀 단위 기록 투명성이 중요하면 오픈클로다.
Buzz — 이미 깔린 CLI로 AI 에이전트 팀 굴리는 법
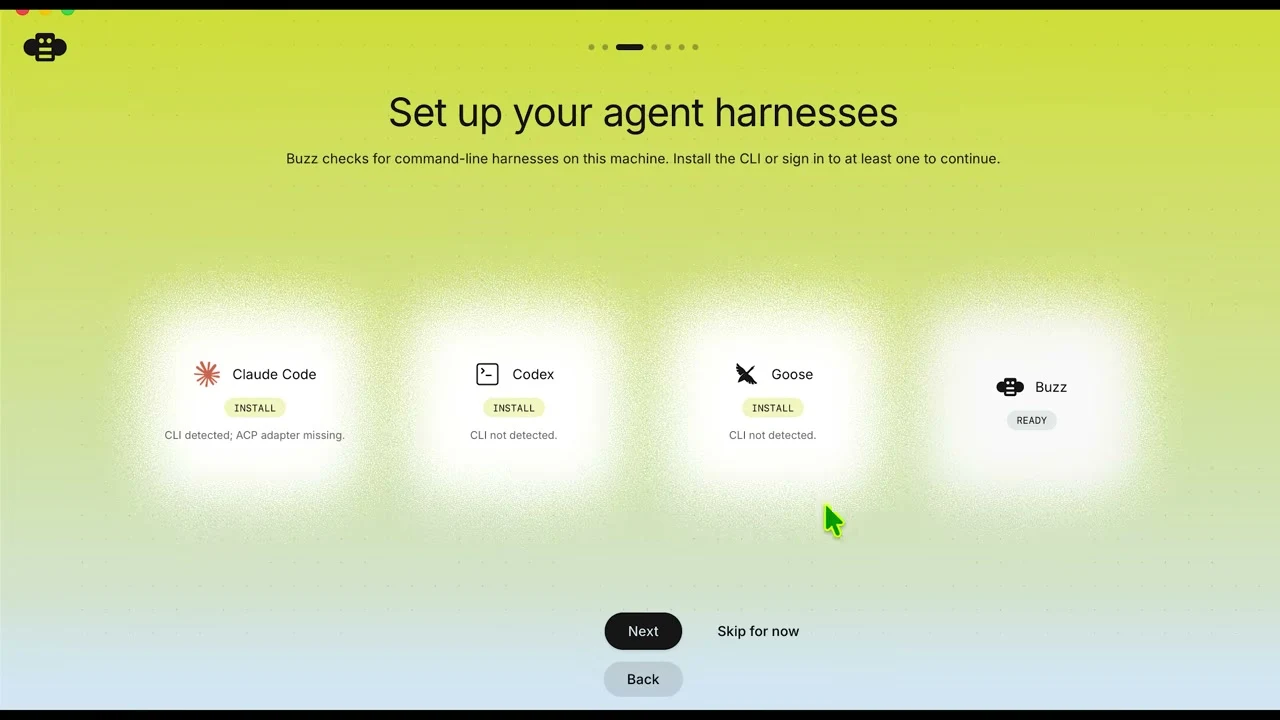
Buzz는 Block(잭 도시가 창업한 회사)이 2026년 7월 공개한 오픈소스 협업 앱으로, 사람과 AI 에이전트가 같은 채널에서 함께 일한다. 생김새는 Slack과 거의 같지만 결정적으로 다른 점이 하나 있다 — 에이전트를 모델 API 요금으로 부르지 않고, 내 컴퓨터에 이미 깔려 로그인까지 끝난 Claude Code·Codex·goose 같은 명령줄 도구를 그대로 붙여서 쓴다. 그래서 이미 내고 있는 구독료 안에서 에이전트 여러 명을 동시에 굴릴 수 있고, 대신 그 컴퓨터가 켜져 있어야 한다. 시작하는 순서는 여섯이다 — ① 데스크톱 앱을 내려받아 설치하고 ② 신원 키(개인키)를 만들어 보관하고 ③ 'Set up your agent harnesses' 화면에서 쓸 CLI를 연결하고 ④ 커뮤니티를 만들고 ⑤ 이름·지시문·모델을 정해 에이전트를 만들고 ⑥ 채널을 만들어 에이전트를 초대한 뒤 @이름으로 지시한다. 에이전트끼리는 같은 채널을 읽고 쓰며 서로 일을 넘기고, 그 명령 하나하나는 실행 전에 권한 창으로 승인을 받는다.
i-have-adhd — AI 답변에서 서론을 없애는 플러그인
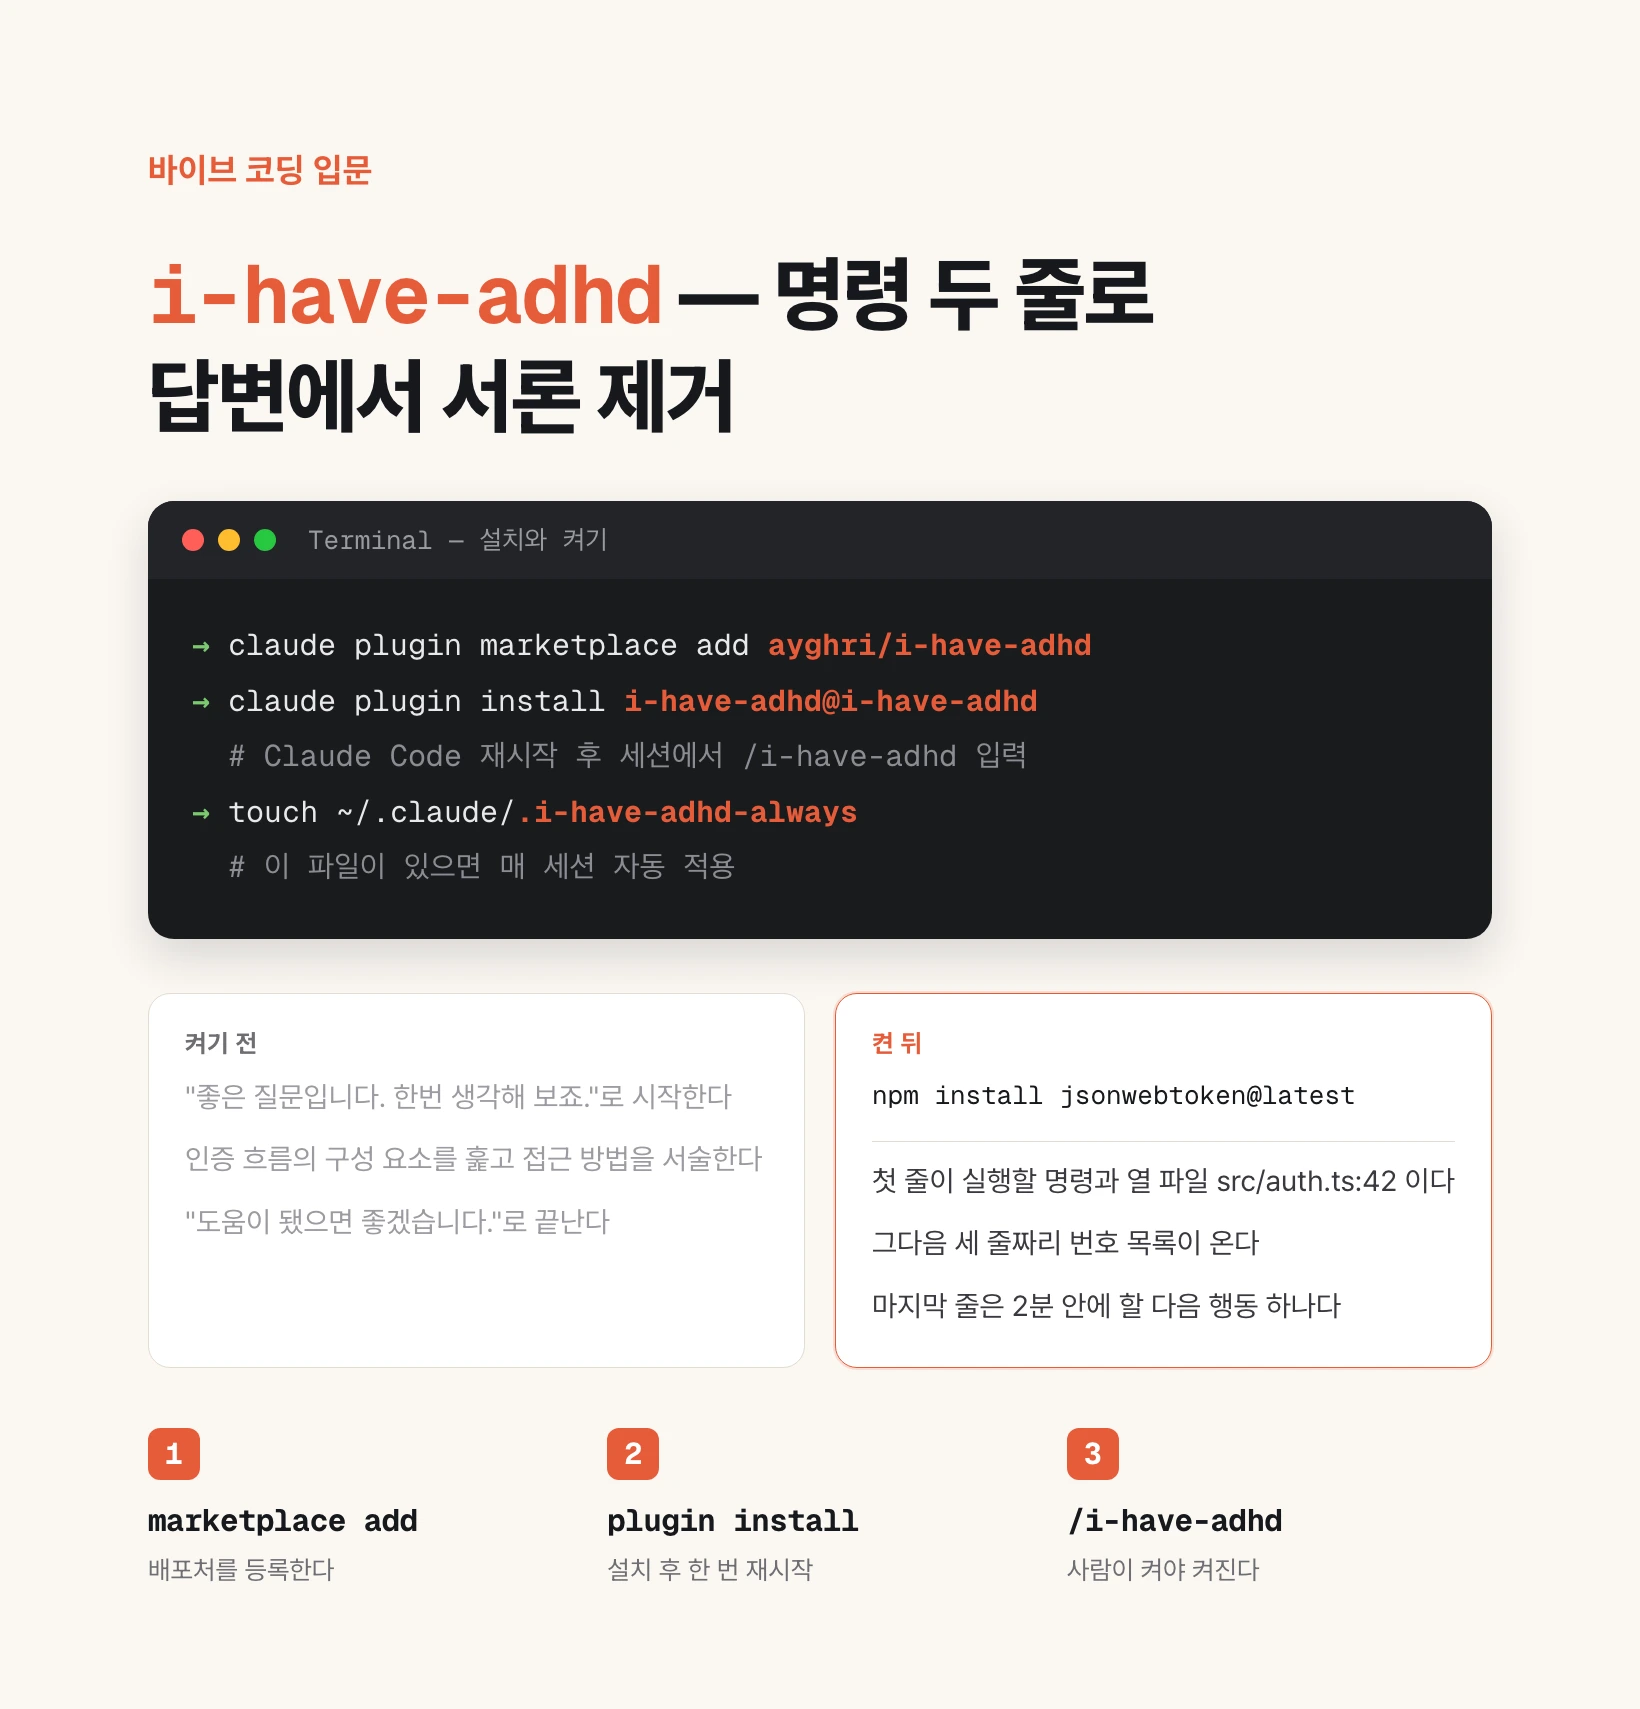
명령 두 줄이면 된다. Claude Code에서 `claude plugin marketplace add ayghri/i-have-adhd`로 배포처를 등록하고 `claude plugin install i-have-adhd@i-have-adhd`로 설치한 뒤, 세션에서 /i-have-adhd를 치면 그때부터 답변 모양이 바뀐다. 서론이 사라지고 첫 줄에 실행할 명령이나 파일 경로가 온다. 여러 단계짜리 일은 번호 목록으로 끊기고, 끝에는 2분 안에 할 수 있는 다음 행동 하나가 남는다. 매 세션 자동으로 켜고 싶으면 `touch ~/.claude/.i-have-adhd-always` 한 줄을 더 실행한다. 만든 사람은 Ayoub G.(github.com/ayghri)이고 MIT 라이선스 오픈소스다. 이름이 ADHD지만 진단이 필요한 물건은 아니다 — 답변이 길어서 요점을 놓치는 상황이면 누구에게나 같은 효과가 난다.
노션 개발자는 코드를 이렇게 읽습니다
diff를 줄 단위로 읽지 않고, 에이전트가 만든 설명 문서를 읽은 뒤 퀴즈로 이해를 확인한다. 노션의 디자인 엔지니어 Geoffrey Litt가 매일 쓰는 방식이고, 그 도구인 explain-diff 스킬을 공개해 두었다. 이 스킬을 깔면 코드 변경마다 배경 → 직관 → 코드 워크스루 → 5문항 객관식 퀴즈 순서로 된 HTML 문서 한 장이 만들어진다. 설치는 명령 두 줄이다. gist의 explain-diff-html.md 파일을 ~/.claude/skills/explain-diff-html/SKILL.md 자리에 내려받으면 끝이고, 그다음부터는 "이번 브랜치 변경을 설명해 줘"라고 말하면 된다. 결과물은 저장소 바깥에 오늘 날짜로 시작하는 파일명으로 저장된다. 노션에 페이지로 만드는 변형(explain-diff-notion.md)도 같은 주소에 있다. 운영 규칙은 하나다 — 그 퀴즈를 통과하지 못하면 팀에 리뷰를 요청하지 않는다.
테슬라를 코드로 제어할 수 있나 — Fleet API로 애프터블로우 자동화하기
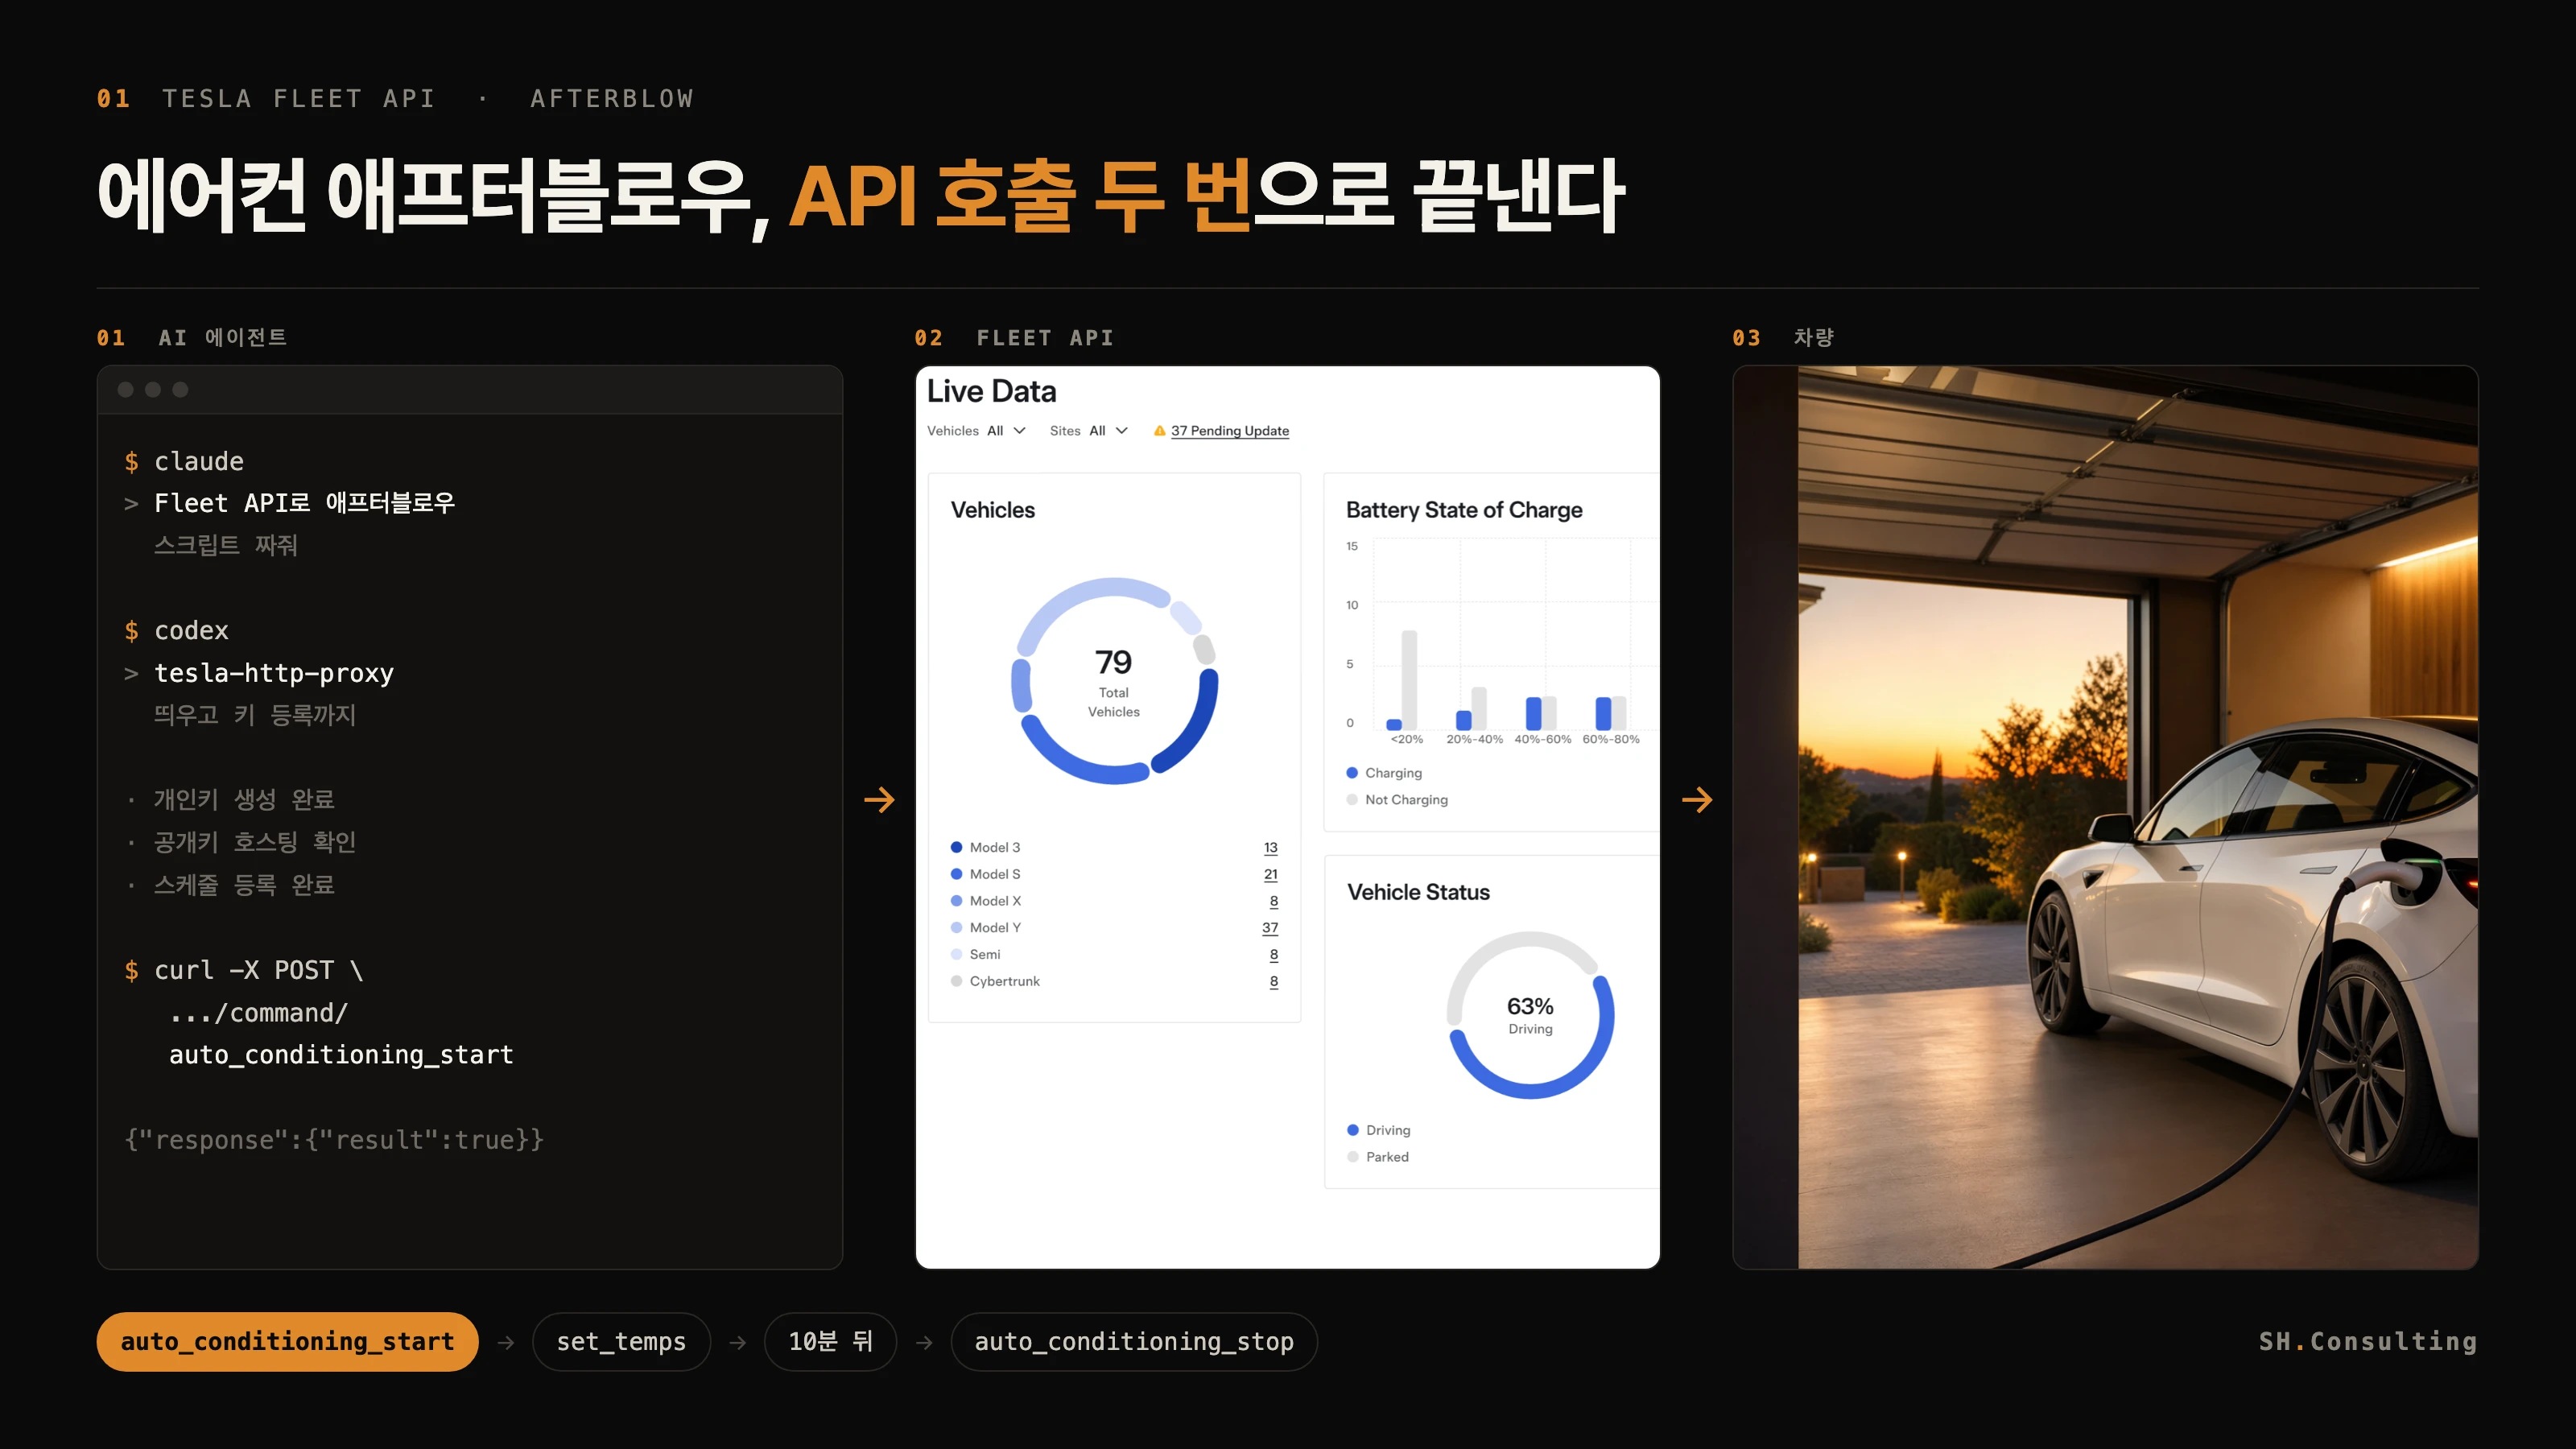
가능하다. 테슬라는 Fleet API라는 공식 차량 제어 인터페이스를 열어 두었고, 차주가 자기 계정을 연결하면 프로그램이 문 잠금·트렁크·공조·충전·내비 목적지·센트리 모드까지 명령할 수 있다. 가장 실용적인 첫 자동화는 애프터블로우다. 차에서 내린 뒤 잠깐 바람을 돌려 에어컨 증발기를 말리는 동작인데, 여름 쉰내의 원인이 대부분 여기 남은 물기라 효과가 바로 체감되고, 정작 차량 메뉴에는 이 버튼이 없어서 이 기능 하나만 월 구독으로 파는 서비스가 따로 있을 정도다. 만드는 법은 단순하다. 도착하면 공조를 켜는 명령(auto_conditioning_start)과 온도를 올리는 명령(set_temps)을 부르고, 10분 뒤 끄는 명령(auto_conditioning_stop)을 부른다. 실제로 막히는 지점은 코드가 아니라 등록 절차다 — 개발자 앱 등록, 내 도메인의 정해진 경로에 공개키 올리기, 명령에 서명하는 프록시 실행 셋을 통과해야 한다. 이 절차야말로 Claude Code나 Codex 같은 코딩 에이전트에 그대로 맡기기 좋은 일이고, 비용은 계정마다 매달 붙는 10달러 크레딧 안에서 끝난다.
유튜브 투자 주장을 백테스트로 검증하려면 — 자막부터 무료 시세 API까지
유튜브 영상이 "지금이 바닥"이라고 말할 때, 믿거나 안 믿거나 말고 세 번째 길이 있다. 주장을 숫자 규칙으로 바꿔 과거 데이터에 돌려 보는 것이고 이걸 백테스트라고 부른다. 필요한 도구는 둘뿐이다 — 영상 자막을 텍스트로 뽑아 주는 yt-dlp와, 가입·결제 없이 일별 종가를 주는 공개 API(미국은 나스닥, 국내는 네이버 금융). 절차는 셋이다. 자막을 받아 주장을 글로 확보하고, "급락 후 반등했으니 바닥" 같은 사람 말을 "60일 고점 대비 35% 넘게 빠진 상태에서 하루 20% 이상 오르면 다음 날 종가에 산다"처럼 조건과 숫자로 옮기고, 그 규칙을 과거 10년 데이터에 돌린다. 결과를 볼 때 반드시 두 가지를 같이 봐야 한다 — 같은 종목을 그냥 계속 들고 있었을 때(비교군)와, 평균이 아니라 중앙값이다. 비교군이 없으면 오른 시장에서는 어떤 규칙이든 좋아 보이고, 평균만 보면 소수의 대박이 만든 숫자를 규칙의 실력으로 착각한다. 그리고 숫자 조건으로 도저히 옮길 수 없는 주장이 나오면 그건 검증 실패가 아니라 애초에 검증할 수 없는 주장이며, 그 판정 자체가 결과다.
npm run dev와 localhost는 무엇인가 — 내 컴퓨터를 서버로 띄우는 법
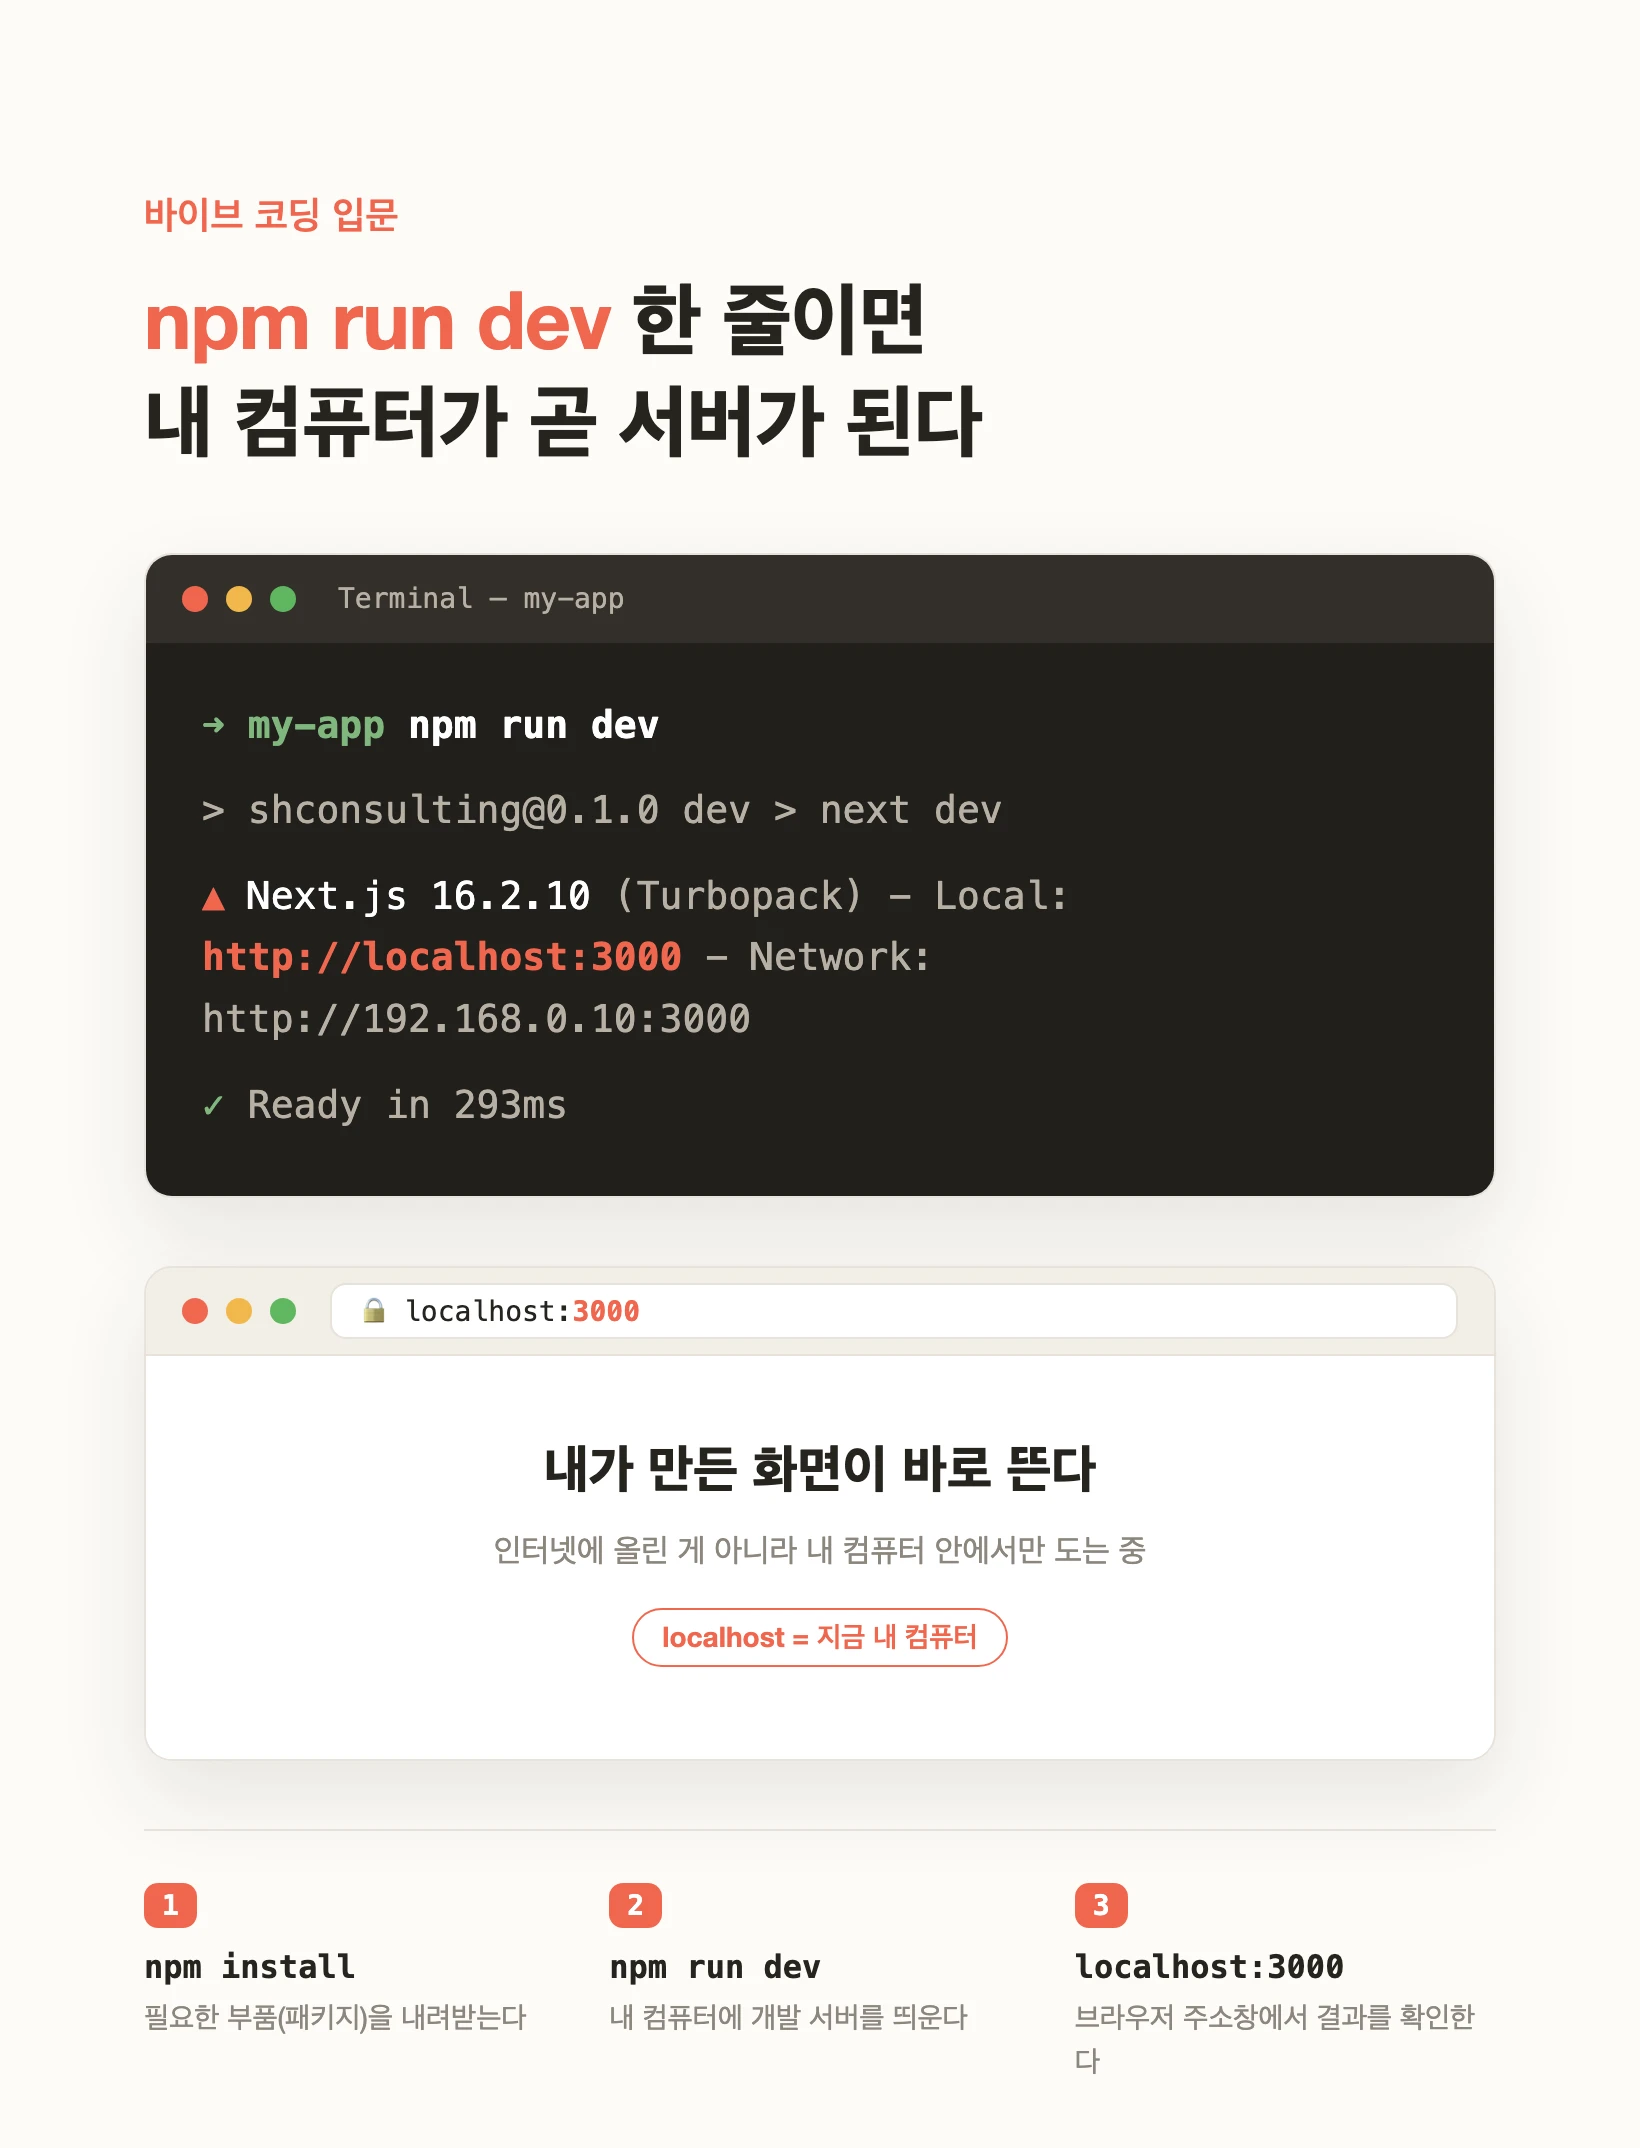
npm run dev는 내가 짠 코드를 웹페이지로 바꿔 실시간으로 보여 주는 '개발 서버'를 내 컴퓨터에서 켜는 명령이다. 명령을 치면 터미널에 'Local: http://localhost:3000'이 뜨는데, 이 localhost는 남의 서버 주소가 아니라 지금 이 명령을 친 내 컴퓨터 자신을 가리키는 이름(숫자로는 127.0.0.1)이고, 뒤의 3000은 이 앱이 쓰는 포트(문) 번호다. 그래서 이 주소로 띄운 화면은 인터넷에 올라간 게 아니라 내 기계 안에서만 돌고 나만 볼 수 있다. npm은 이 명령을 굴려 주는 도구(Node Package Manager)로, 프로젝트 폴더의 package.json에 적힌 부품(패키지)을 내려받고 'dev'·'build' 같은 실행 이름에 연결된 진짜 명령을 대신 실행한다. 처음 받아 온 프로젝트라면 순서는 늘 셋이다 — npm install로 부품을 채우고, npm run dev로 서버를 띄우고, 브라우저 주소창에 localhost:3000을 넣어 확인한다. 인터넷에 공개하는 배포는 이게 다 잘 도는 것을 확인한 다음 이야기다.
온프레미스 AI는 언제 필요하고 얼마가 드나
온프레미스 AI는 모델을 우리 회사 장비에 얹어 우리 망 안에서만 돌리는 방식입니다. 필요성은 두 가지에서 나옵니다. 데이터가 학습에 쓰이느냐와 별개로 그 데이터가 지나간 경로가 외부에 남는다는 점, 그리고 보안 사고가 났을 때 프론티어 모델이 가드레일로 분석을 거절할 수 있다는 점입니다. 비용은 프론티어급 오픈웨이트 모델 기준으로 순수 가중치만 1.4TB, H200 클러스터 72장 랙 하나 수준, 클라우드 대여로 환산하면 시간당 300달러, 장비를 사면 약 50억 원입니다. 다만 이 비용이 성립하려면 워크로드가 끊임없이 밀려와 GPU를 최대로 돌려야 합니다. 그래서 실무의 답은 전량 이전이 아니라, 나가면 안 되는 것만 오픈웨이트로 안에 두고 나머지는 프론티어 API에 맡기는 쪽입니다.
Claude의 Chat·Cowork·Code, 언제 무엇을 쓰나
Claude에는 제품이 셋 있습니다. Chat은 인턴, Cowork는 팀장, Code는 아인슈타인입니다. 셋 다 대화하고 파일을 만들고 도구에 붙기 때문에 겉으로는 구분이 안 됩니다. 가르는 기준은 하나, 일이 어디서 끝나느냐입니다. Chat은 답을 건네는 순간 끝나고, Cowork는 목표에 닿을 때까지 멈추지 않으며, Code는 없던 것을 만듭니다. 잘못된 모드에 있다는 신호도 분명합니다. Chat 답변을 문서에 복사해 붙이고 조각을 꿰맞추고 있다면, 이미 넘겼어야 할 일을 손으로 하고 있는 것입니다.
Impeccable이란 무엇이고 어떻게 시작하는가? — AI 코딩 도구에 디자인 규칙 심기
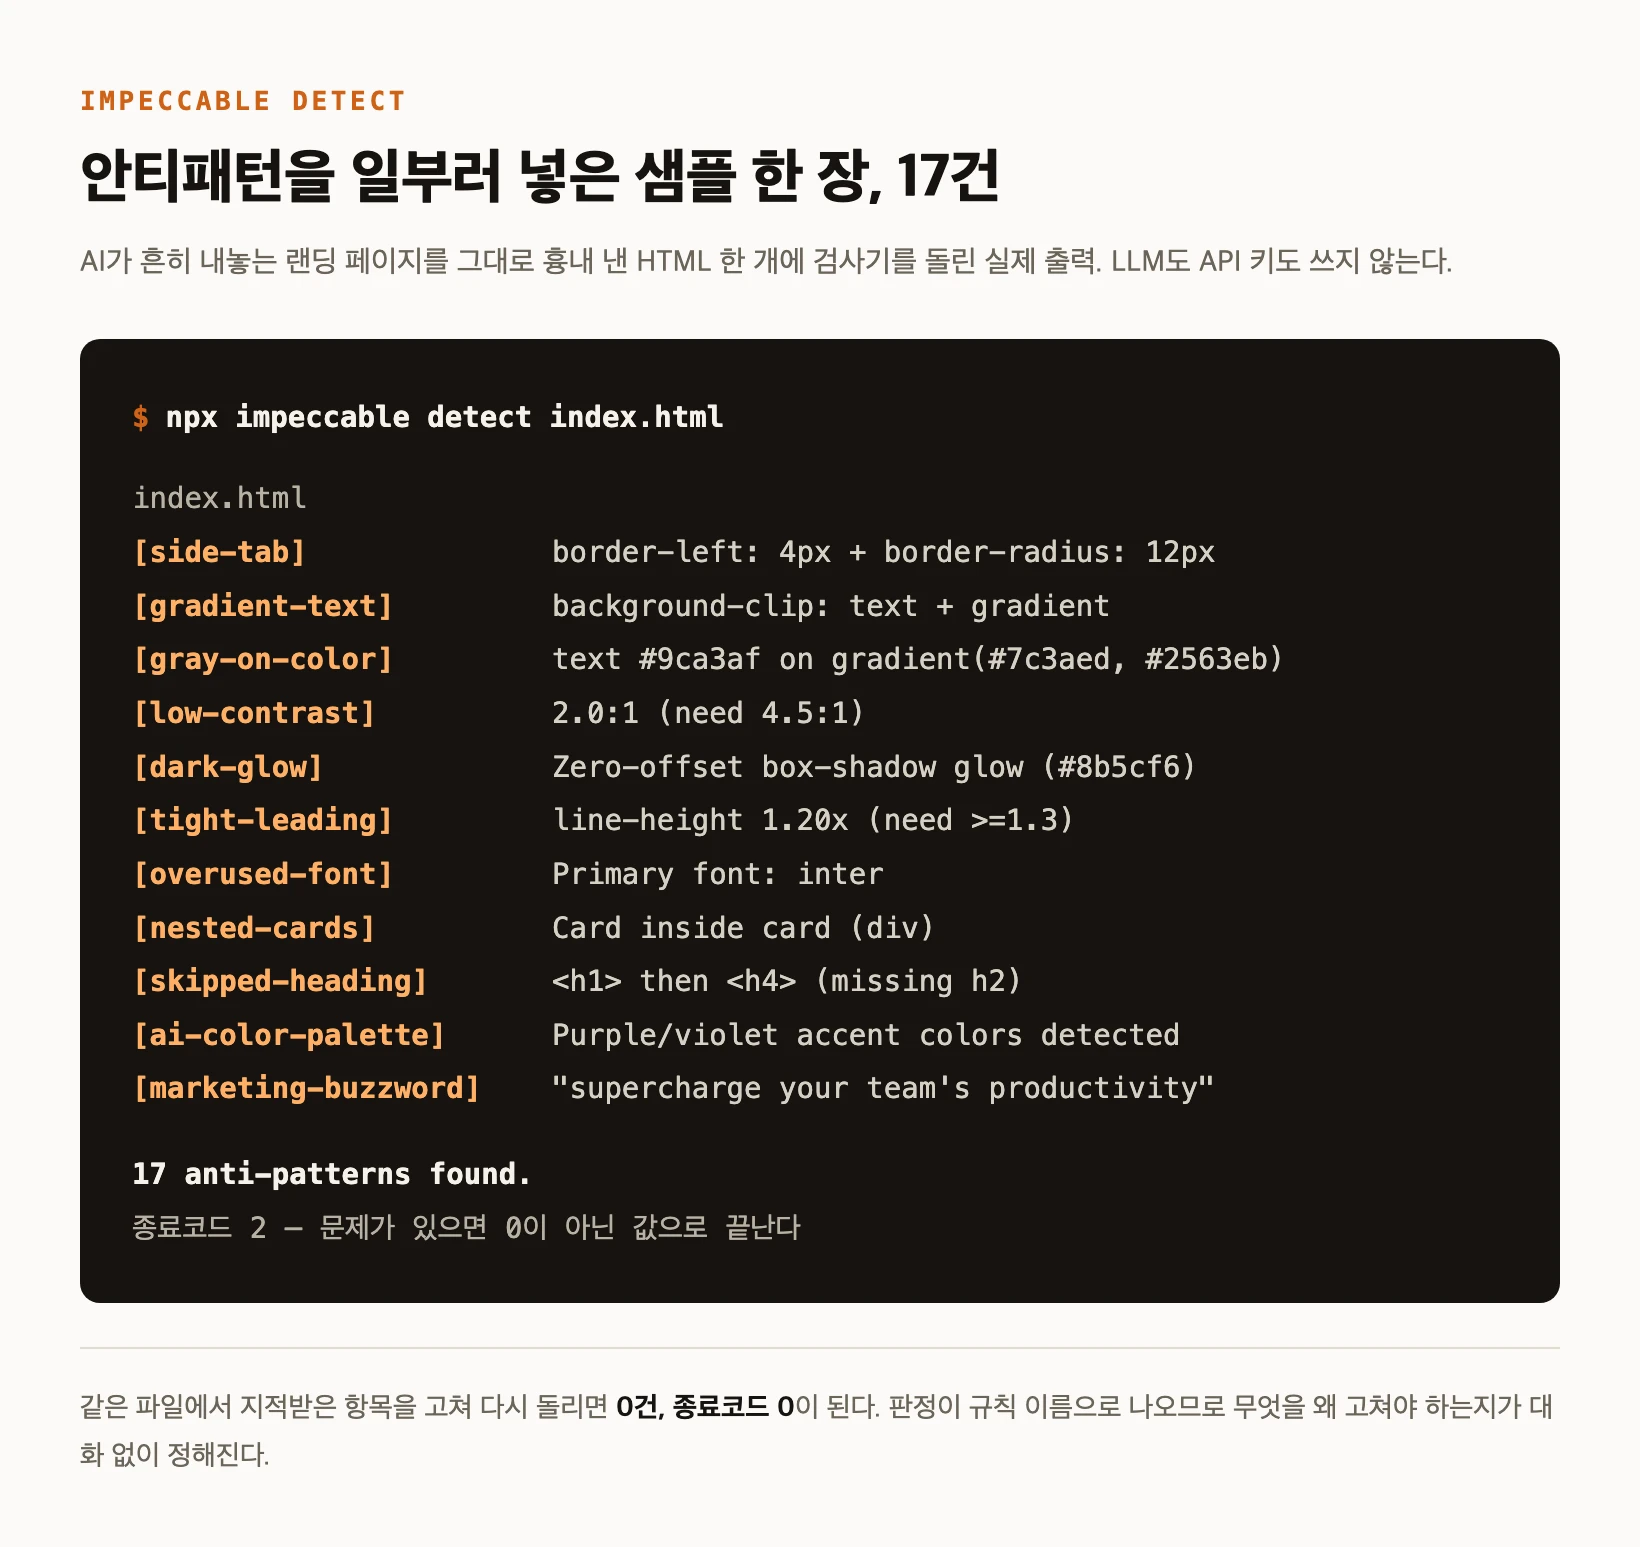
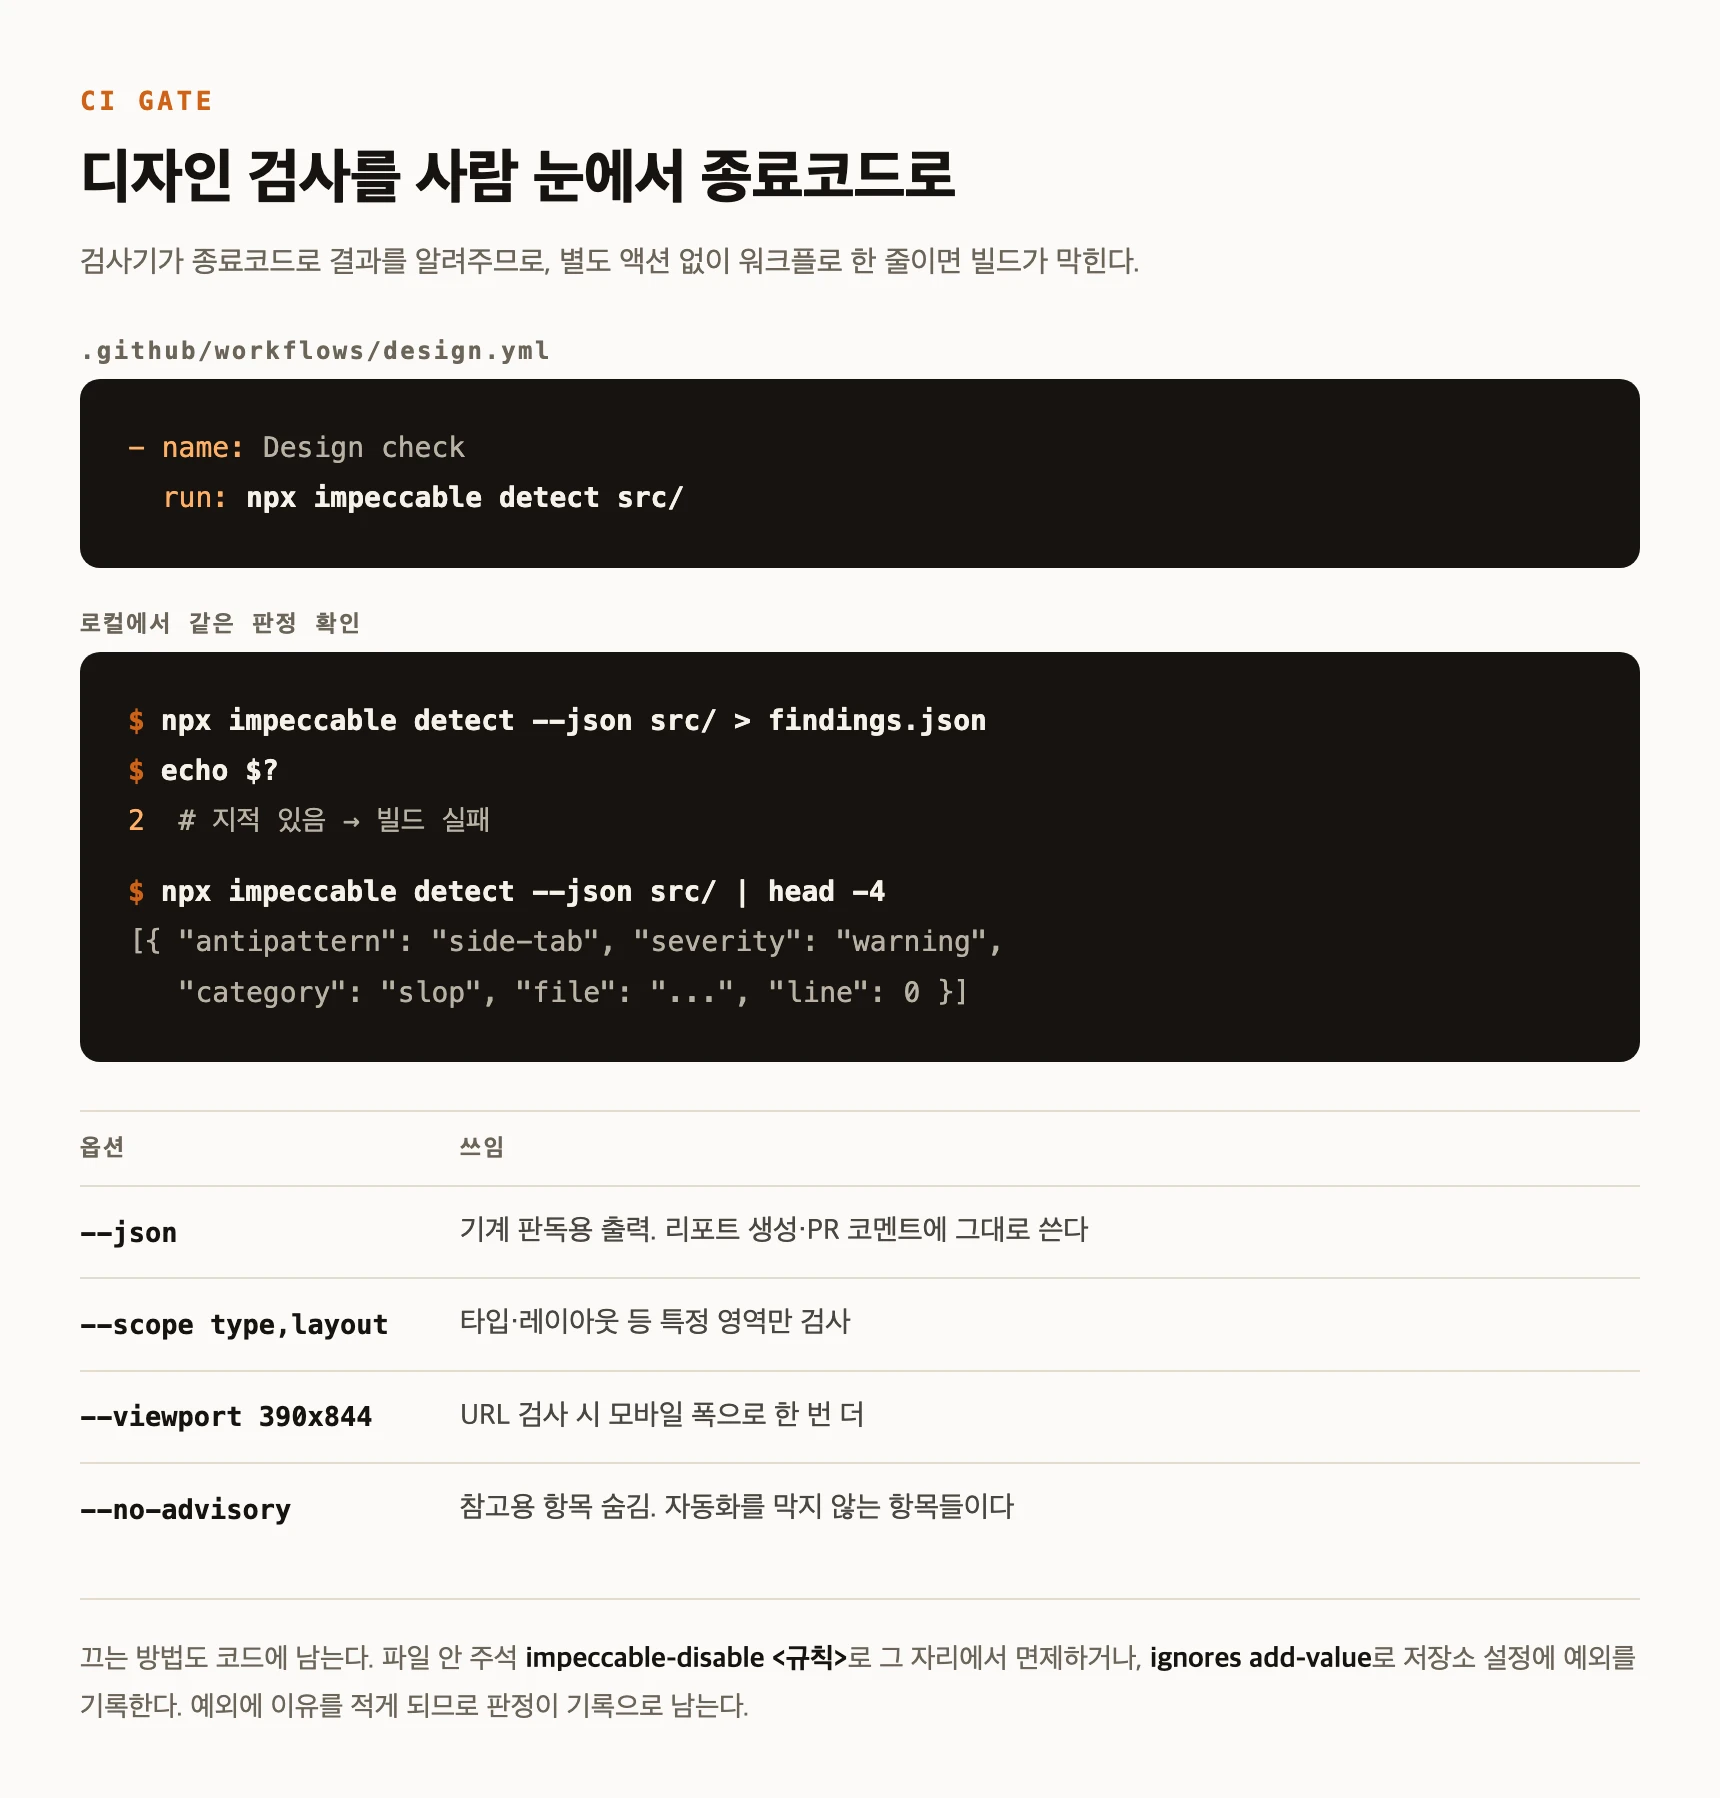
Impeccable은 AI 코딩 에이전트가 화면을 만들 때 읽어야 할 디자인 지침을 프로젝트에 심어 두는 오픈소스 도구다. Anthropic이 공개했던 frontend-design 스킬에서 출발해 명령 23개와 결정론적 검출 규칙 60개를 얹었고, Paul Bakaus가 Apache-2.0으로 공개했다. 시작에 필요한 건 두 줄이다. 프로젝트 폴더에서 npx impeccable install을 돌리면 이 컴퓨터에 이미 깔린 AI 코딩 도구를 스스로 찾아 목록으로 보여주고 이 프로젝트에만 넣을지 컴퓨터 전체에 넣을지 묻는다. 그다음 도구 안에서 /impeccable init을 한 번 실행하면 만들 화면이 브랜드용인지 제품용인지 물어본 뒤 PRODUCT.md와 DESIGN.md를 쓰고, 이후 모든 명령이 이 두 파일을 먼저 읽는다. 실제 작업은 audit(점검), critique(위계·가독성 리뷰), polish(마감), bolder와 quieter(강도 조절), distill(덜어내기)처럼 명령 이름으로 지시하며, 매일 쓰는 명령은 /impeccable pin audit으로 /audit 단축을 만들어 둔다. 에이전트를 쓰지 않아도 된다. npx impeccable detect는 LLM도 API 키도 없이 규칙 검사만 돌리고, 지적이 있으면 종료코드 2, 없으면 0으로 끝나 CI 게이트로 그대로 쓸 수 있다. 안티패턴을 일부러 넣은 샘플 HTML 한 장에 돌려 보니 17건이 나왔고, 지적받은 항목만 고치자 0건이 됐다.
AI가 만든 화면은 왜 다 비슷해 보이는가? — 반복되는 표시와 고치는 방향
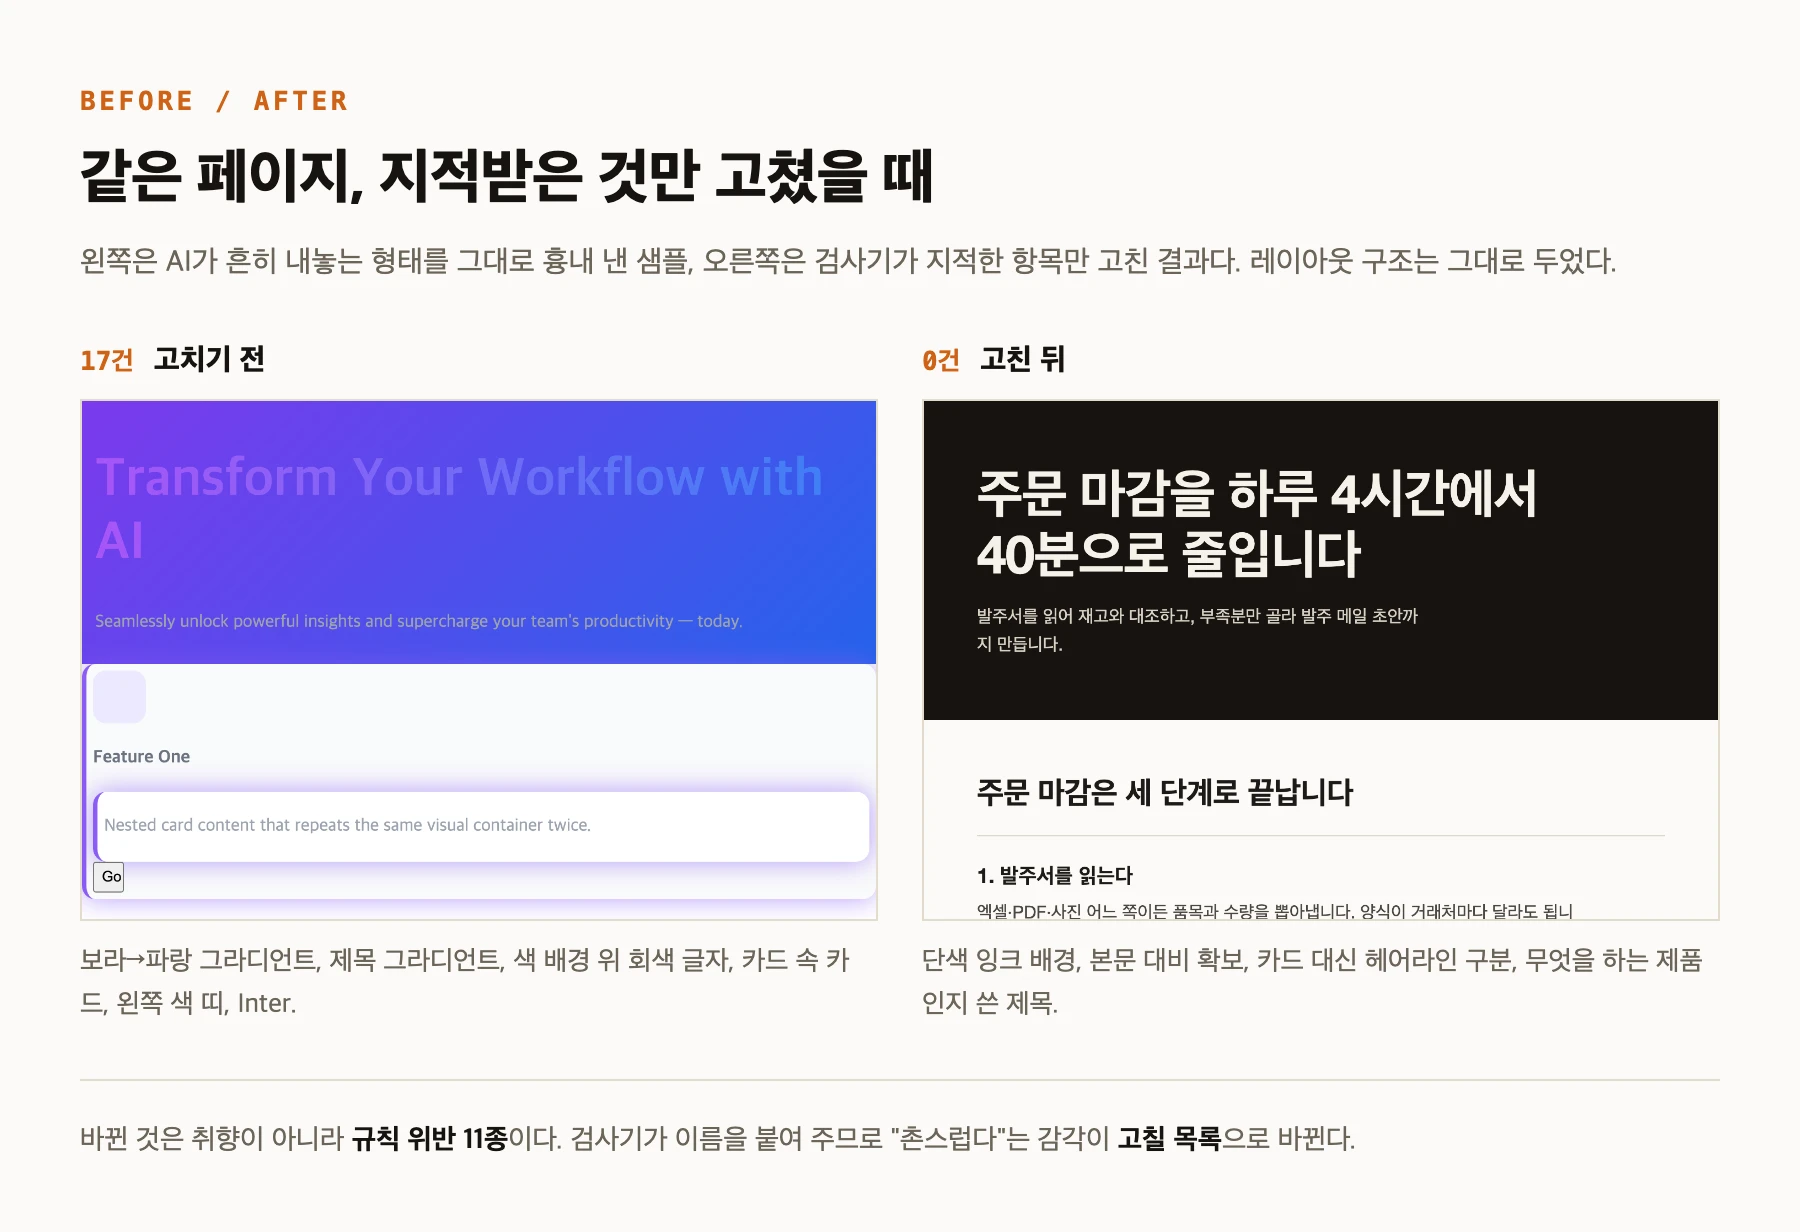
AI가 만든 화면의 촌스러움은 취향의 문제가 아니라 목록의 문제다. 모델은 대체로 공개 웹에 널린 같은 SaaS 템플릿을 보고 배웠고, 그래서 별다른 지시 없이 화면을 만들라고 하면 서로 다른 모델과 프로젝트에서 같은 선택이 반복된다. 자주 나오는 것은 카드 왼쪽의 굵은 색 띠, 제목에 얹은 그라디언트, 보라에서 파랑으로 흐르는 배경, 색 배경 위의 회색 글자, 사방으로 퍼진 색 발광, 카드 안에 또 카드, 제목 위의 작은 대문자 라벨, 그리고 Inter 계열 폰트다. 여기에 streamline이나 supercharge 같은 상투어가 겹친다. 오픈소스 도구 Impeccable은 이 표시들에 규칙 이름을 붙여 LLM 없이 도는 검사기로 만들었다. 고치는 방향도 단순하다. 색 띠는 지우고, 제목은 단색으로, 색 배경 위 글자는 회색 대신 흰색이나 배경의 짙은 계열로, 카드 중첩은 여백과 얇은 구분선으로 푼다. 확인은 눈이 아니라 명령으로 한다. 이 표시들을 일부러 넣은 샘플 HTML 한 장은 17건이 나왔고, 지적받은 항목만 고치고 레이아웃 구조는 그대로 둔 채 다시 검사하니 0건이 됐다.
디자인 검사를 CI에 넣으려면 무엇이 필요한가? — 종료코드로 만드는 게이트
디자인 리뷰를 사람 눈에서 종료코드로 옮기는 것이 핵심이다. 코드는 린트가 막아 주지만 화면은 매번 누군가 봐야 통과하는데, Impeccable의 detect 명령은 LLM도 API 키도 없이 규칙 검사만 돌리고 결과를 종료코드로 알려준다. 지적이 있으면 2, 없으면 0이다. 그래서 CI 워크플로에 npx impeccable detect src 한 줄만 넣으면 전용 액션 없이 게이트가 된다. 검사 방식은 대상에 따라 갈린다. HTML은 연결된 CSS까지 묶어 정적 분석하고, JSX나 CSS 같은 나머지 파일은 패턴 매칭이며, 주소를 주면 실제 브라우저로 띄워 렌더된 화면을 본다. 그래서 소스 스캔이 깨끗해도 주소 스캔에서 걸리는 항목이 따로 있고, 배포 미리보기 주소를 함께 걸면 그 간극이 준다. 실무에서 알아야 할 옵션은 json, scope, viewport, no-advisory 넷이다. 예외를 두고 싶으면 파일 안 impeccable-disable 주석으로 그 자리만 면제하거나 ignores add-value로 저장소 설정에 기록하는데, 어느 쪽이든 이유를 적게 되므로 판단이 기록으로 남는다.
백테스트 수익률이 진짜 실력인지 어떻게 확인하나 — 보유비중과 노출 보정 알파
수익률 옆에 보유비중을 세워 두고, 수익률에서 보유비중 곱하기 바이앤홀드 수익률을 뺀다. 남는 값이 시장 노출로 설명되지 않는 몫, 곧 알파다. 보유비중은 백테스트 전체 거래일 중 실제로 포지션을 들고 있던 날의 비율이다. 이 숫자를 빼놓고 수익률만 보면, 전략이 잘해서 번 것인지 그냥 시장에 덜 들어가 있었던 것인지 구분할 방법이 없다. 널리 알려진 기술적 기법 다섯 개를 개별주·레버리지 ETF·지수 ETF 16종목에 워크포워드로 돌려 보면 이 차이가 그대로 드러난다. 다섯 개 전부 바이앤홀드를 못 이겼고, 승률이 가장 높은 것도 34.5퍼센트였다. 그리고 그 자산이 해당 구간에 오른 폭과 전략의 초과수익은 상관 마이너스 0.945로 맞물려 있었다. 자산이 오르면 전략이 지고 자산이 내리면 전략이 이긴다는 뜻이다. 원인은 노출이었다. 1년 구간 평균 보유비중이 23.8퍼센트, 나머지 시간은 현금이었다. 노출 보정 알파는 중앙값 마이너스 5.73퍼센트포인트, 회귀 절편은 마이너스 0.52퍼센트포인트로 사실상 0 이하였다. 이 글은 그 검증을 처음부터 따라 할 수 있게 절차와 계산식으로 정리한 것이다.
AI에게 매매 규칙을 백테스트로 검증시키려면 무엇을 정해 줘야 하는가?
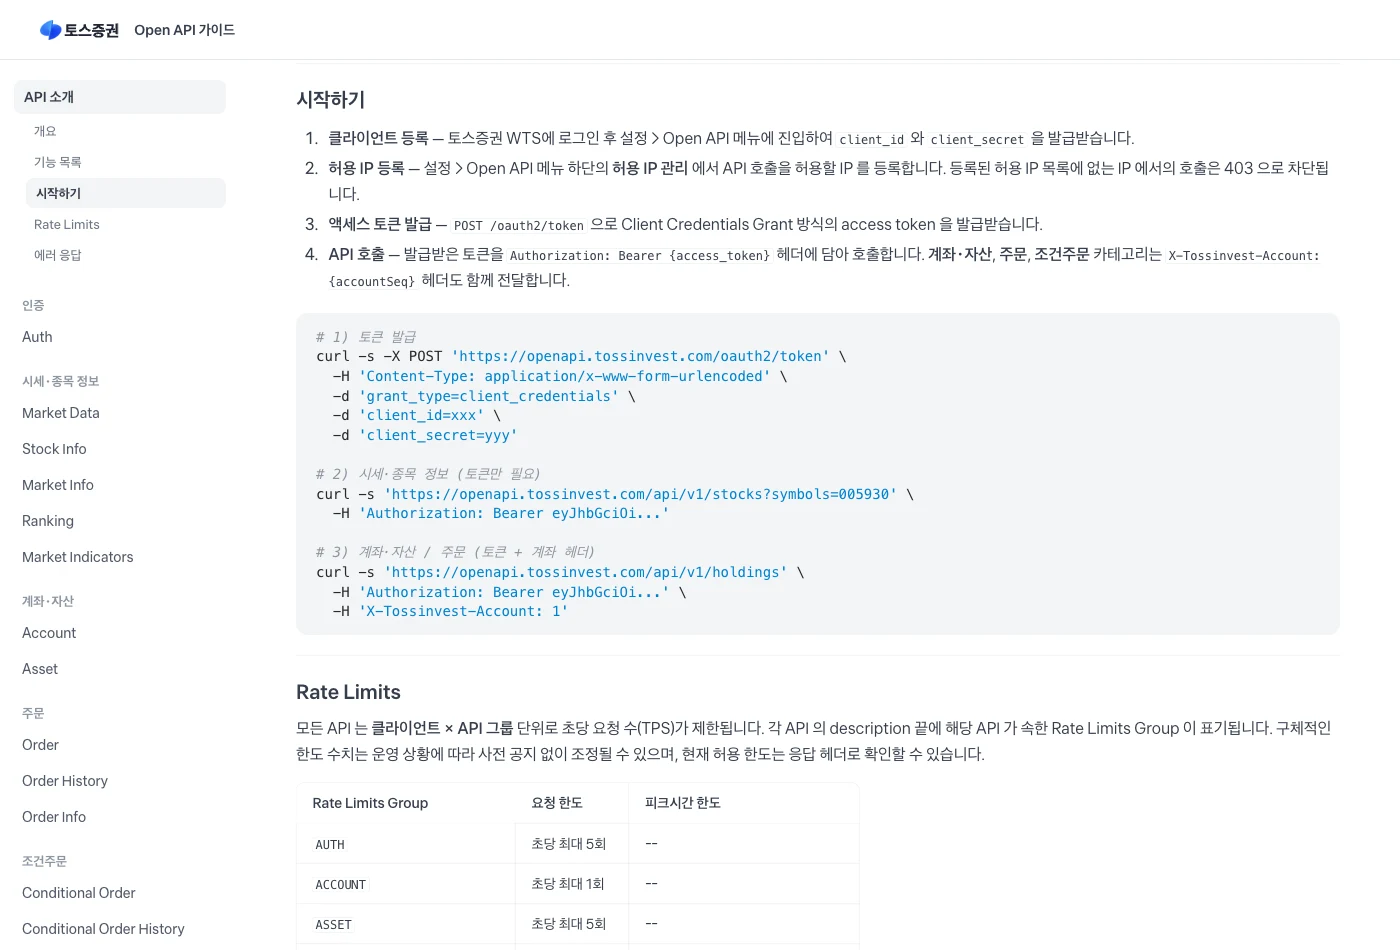
백테스트는 과거 시세에 내 매매 규칙을 그대로 적용해, 그 규칙대로 샀다 팔았다면 지금 잔고가 얼마일지 계산해 보는 절차다. 토스증권 Open API의 캔들 조회로 일봉 시가·고가·저가·종가를 받아 오면, Claude Code나 Codex 같은 터미널 AI 에이전트에게 매매 규칙을 말로 설명하는 것만으로 몇 분 안에 매매 내역과 수익률이 나온다. 다만 결과를 실제로 가르는 것은 규칙이 아니라 내가 정해 주지 않은 가정이다. 판정 시점, 체결 가격, 거래 비용, 데이터 구간 네 가지를 못 박지 않으면 에이전트는 되묻지 않고 가장 그럴듯한 쪽을 골라 채우며, 그 선택이 그대로 성과표가 된다. 실제로 3배 레버리지 ETF에 같은 규칙과 같은 데이터를 넣고 청산 체결 가정 하나만 바꿨더니 다섯 달 수익률이 15퍼센트와 95퍼센트로 갈렸다.
Fable 5·GPT-5.6 Sol·Kimi K3, 단가 3.3배 차이는 실제 비용 3.3배 차이인가?
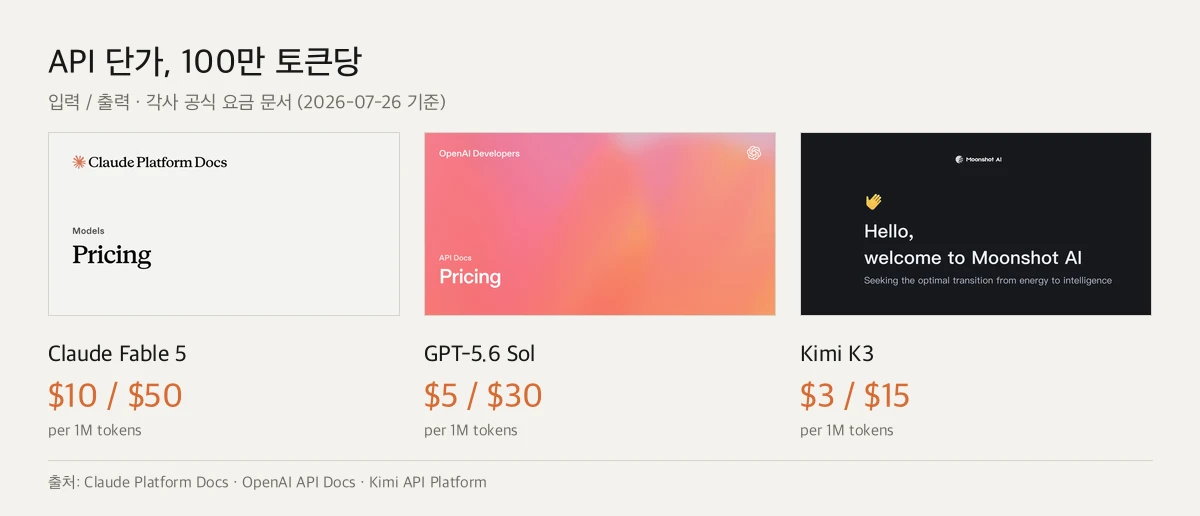
아니다. 100만 토큰당 공식 단가는 Claude Fable 5가 입력 10달러·출력 50달러, GPT-5.6 Sol이 5달러·30달러, Kimi K3가 3달러·15달러로 가장 비싼 쪽과 싼 쪽이 정확히 3.3배 차이지만, 실제로 결제되는 금액은 이 표 밖의 세 가지가 정한다. 첫째는 같은 글을 몇 토큰으로 세는지다. 앤스로픽은 Claude 4.7 이후 모델이 새 토크나이저를 써서 같은 텍스트를 약 30% 많은 토큰으로 센다고 공지했고, 단가가 그대로여도 청구 수량이 늘어난다. 둘째는 길이에 따라 요금 구간이 바뀌는지다. Sol은 입력이 27만 2천 토큰을 넘으면 그 요청 전체가 입력 2배·출력 1.5배로 계산돼 실질 100만 토큰당 10달러·45달러가 되고, Fable 5와 Kimi K3의 요금표에는 이런 길이 구간이 없다. 셋째는 원하는 결과가 한 번에 나오는지다. 재시도 횟수는 단가에 그대로 곱해지는 배수이고, 세 모델에 같은 프롬프트를 한 번씩만 준 비교 리뷰에서 물리 처리와 화면 디테일은 Fable이 확실히 앞섰으며 Kimi와 Sol은 서로 비슷한 수준이었다. 참고로 캐시 히트 할인율은 세 곳 모두 입력가의 10%로 완전히 같아서, 캐싱을 잘 쓰더라도 세 모델 사이의 상대 격차는 그대로 남는다.
케이퍼빌리티 오버행이란 무엇이고, 조직은 무엇을 해야 하는가?
케이퍼빌리티 오버행(capability overhang)은 AI 도구가 할 수 있는 일의 범위는 몇 달 단위로 빠르게 넓어지는데, 그 도구를 쓰는 사람의 역량은 훨씬 느리게 자라서 둘 사이에 '쓰이지 않은 성능'이 계속 쌓이는 현상을 말한다. 여기서 따라 나오는 결론이 하나 있다. 같은 도구를 똑같이 나눠 줘도 잘 쓰는 사람과 평균적으로 쓰는 사람의 생산성 격차는 줄지 않고 오히려 벌어진다. 그래서 조직에서 AX의 실제 과제는 도구를 도입하는 일이 아니라 이 격차를 관리하는 일이 된다. 볼 지표도 사용률이 아니라 분포다.
토스증권 Open API로 AI에게 주식 거래를 맡기려면 무엇이 필요한가?
토스증권 Open API는 시세·종목 정보, 계좌와 보유 주식, 주문 생성·정정·취소, 그리고 가격을 감시하다 조건이 맞으면 자동으로 주문을 내는 조건주문까지 제공하는 REST API다. 토스증권 WTS에 로그인해 설정 안의 Open API 메뉴에서 client_id와 client_secret을 발급받고 호출할 IP를 허용 목록에 등록하면 준비가 끝난다. 여기에 Claude Code나 Codex 같은 터미널 AI 에이전트를 붙이면, 코드를 직접 쓰는 대신 매매 규칙을 말로 설명해 조회와 주문을 자동화할 수 있다. 다만 조회가 되는 순간 주문도 되기 때문에, 실주문 앞에는 연습 모드 기본값·실행 플래그·금액 한도·멱등키 같은 게이트를 사람이 먼저 걸어야 한다.
AI 도구를 다 갖춘 조직은 왜 빨라지지 않는가?
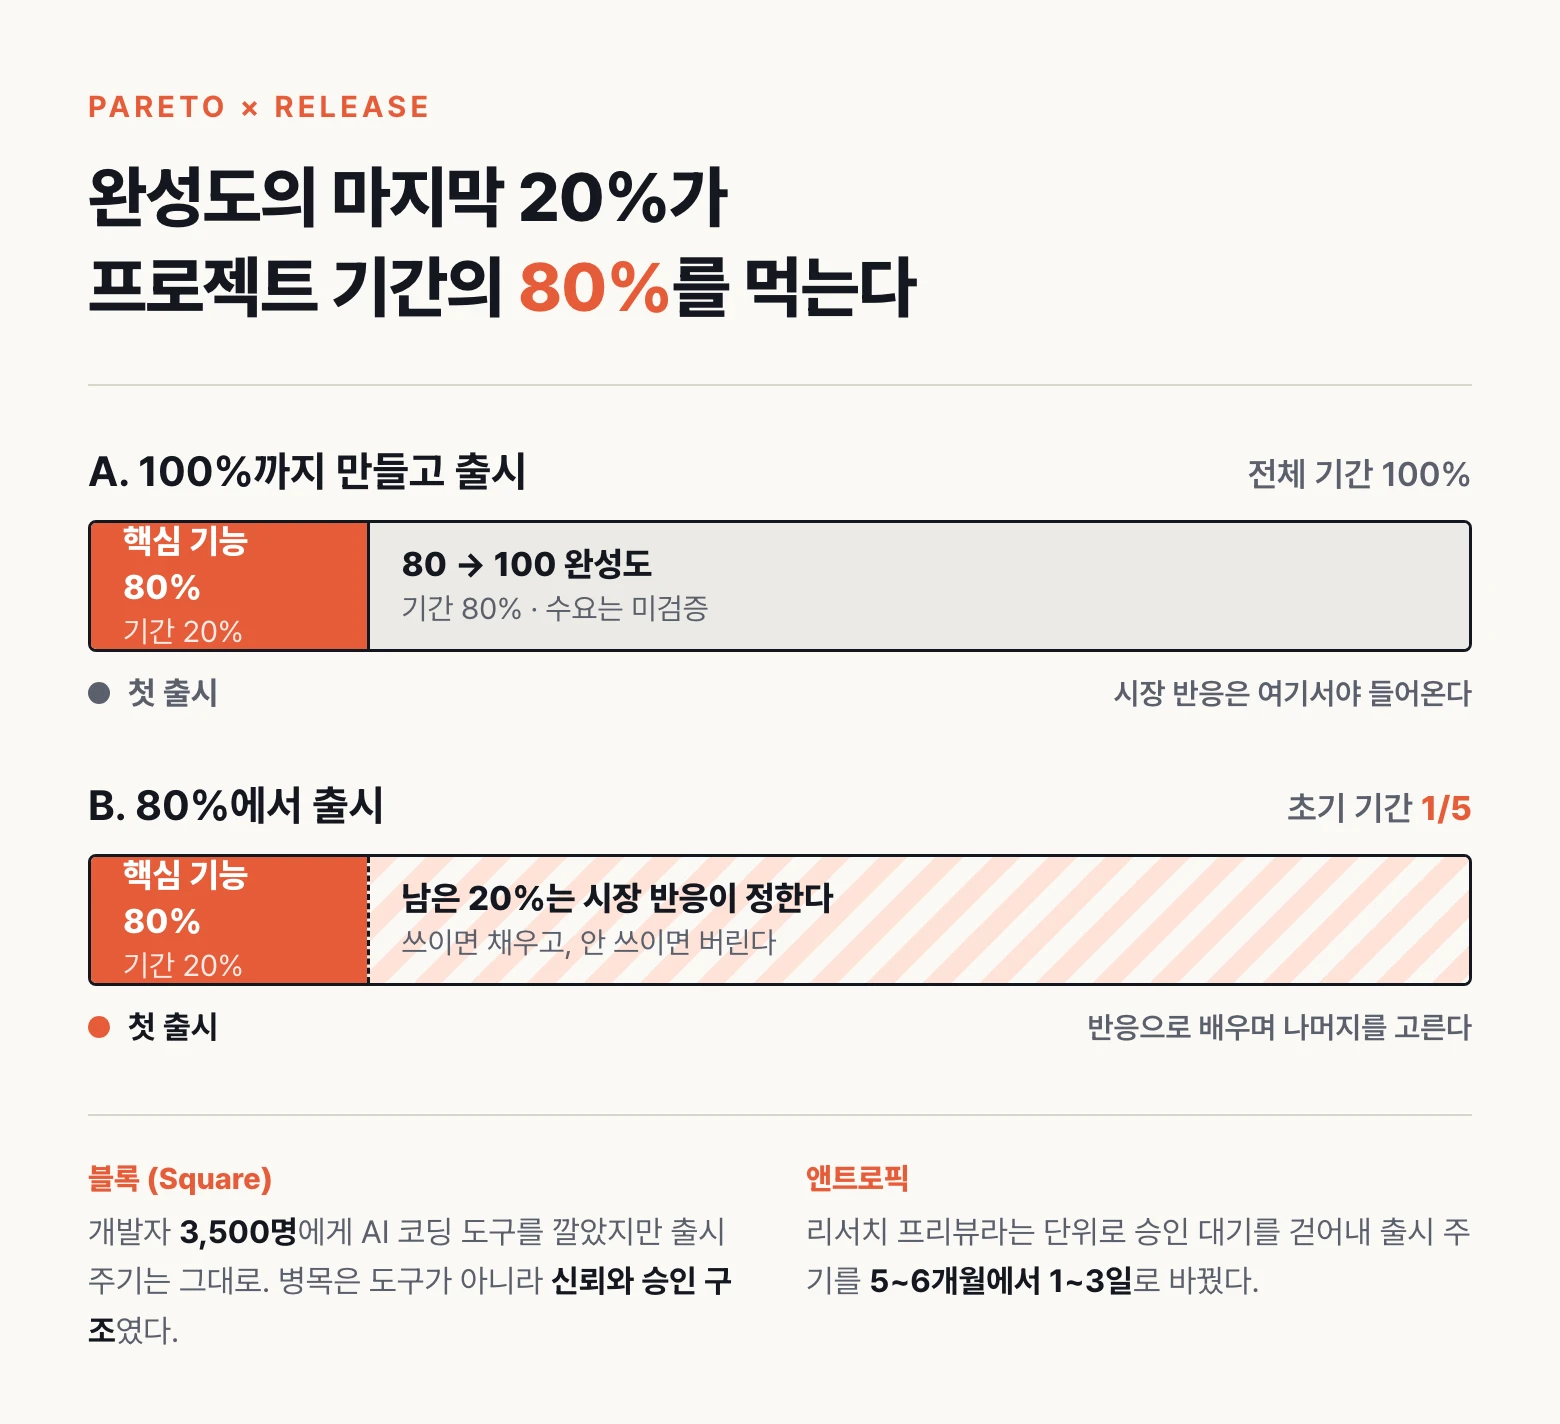
도구가 아니라 완성 기준과 승인 구조가 속도를 정하기 때문이다. 핀테크 기업 블록은 개발자 3,500명 대부분에게 AI 코딩 도구를 배포했지만 제품 출시 주기가 기대만큼 줄지 않았다. 병목이 도구 부재가 아니라 AI가 쓴 코드에 대한 신뢰와 결재·승인 구조에 있었기 때문이다. 반대로 앤트로픽은 리서치 프리뷰라는 공개 단위를 만들어 승인 대기를 걷어내고 제품 출시 주기를 5~6개월에서 1~3일로 줄였다. 이 둘을 파레토 법칙으로 다시 읽으면 실행 규칙이 나온다. 핵심 기능 80%는 전체 기간의 20%면 만들어지고, 나머지 기간 80%는 80을 100으로 올리는 데 쓰인다. 그런데 그 마지막 완성도를 시장이 원했는지는 검증된 적이 거의 없다. 그래서 80%에서 내보내고 남은 20%는 시장 반응이 정하게 두면, 초기 프로젝트 기간은 5분의 1로 줄어든다.
Record a skill이란 무엇이고, 어떻게 쓰는가?
Record a skill은 Claude 데스크톱 앱에서 화면·클릭·타이핑·목소리를 함께 녹화해, 그 작업을 Claude가 다시 실행할 수 있는 '스킬'로 바꿔 주는 기능이다. 프롬프트로 절차를 설명하는 대신 평소 하던 대로 한 번 시연하면, Claude가 무엇을 하는 워크플로인지 요약하고 필요한 폴더·커넥터 권한을 요청한 뒤 재사용 가능한 스킬로 저장한다. 저장 뒤에는 '이번 주 것도 정리해 줘' 한마디로 같은 작업이 반복된다. 단 녹화 중에는 화면에 보이는 모든 것이 전송되므로, 비밀번호·계좌·개인 대화가 노출되는 업무에는 쓰지 않는 것이 맞다.
Claude가 실제로 따르는 CLAUDE.md는 어떻게 쓰는가?
CLAUDE.md는 강제되는 설정(configuration)이 아니라, 매 세션 Claude에게 함께 읽히는 지침 모음이다. 그래서 한 파일에 규칙을 계속 쌓으면 규칙끼리 경쟁해, 정작 중요한 지시가 사소한 지시에 묻히고 Claude가 오히려 덜 따른다. 잘 따르게 하는 방법은 다섯 가지다. 첫째, 애초에 CLAUDE.md가 맞는 도구인지 묻는다 — '절대 main에 직접 push 금지' 같은 강제 규칙은 지침이 아니라 pre-tool-use hook에 넣는다(hook은 Claude가 시도하는 순간 실제로 막는다). 둘째, CLAUDE.md는 네 곳에 있다 — managed policy(조직)·user(내 컴퓨터 전역)·project(팀 공유)·local(이 repo의 나만, git 무시). 전부 함께 로드되므로 개인용·임시 결정은 local에 둔다. 셋째, @경로 import로 파일을 쪼갠다 — 단 import는 실행 시 인라인으로 펼쳐져 '정리'에는 좋지만 컨텍스트(토큰)를 줄여 주지는 않는다. 넷째, 표현이 준수를 가른다 — '베스트 프랙티스를 따르라'가 아니라 '새 API 라우트는 파일 하나당 하나씩'처럼 구체적·검증가능하게 쓰고, 'default export 쓰지 마'가 아니라 'named export를 써라'로 대체안을 못박는다. IMPORTANT·YOU MUST 같은 강조는 예산이라 깨지면 아픈 두세 규칙에만 쓴다. 다섯째, 계속 개정한다 — Claude가 틀리면 그것을 CLAUDE.md의 버그로 보고 'CLAUDE.md에 추가해'라고 시키면 규칙을 써 준다. 프로덕션 코드처럼 다루고, 정당화 못 하는 줄은 지운다. 파일이 린할수록 Claude가 그중 더 많은 부분을 따른다.
Claude Opus 5란 무엇이고, 무엇이 달라졌는가?
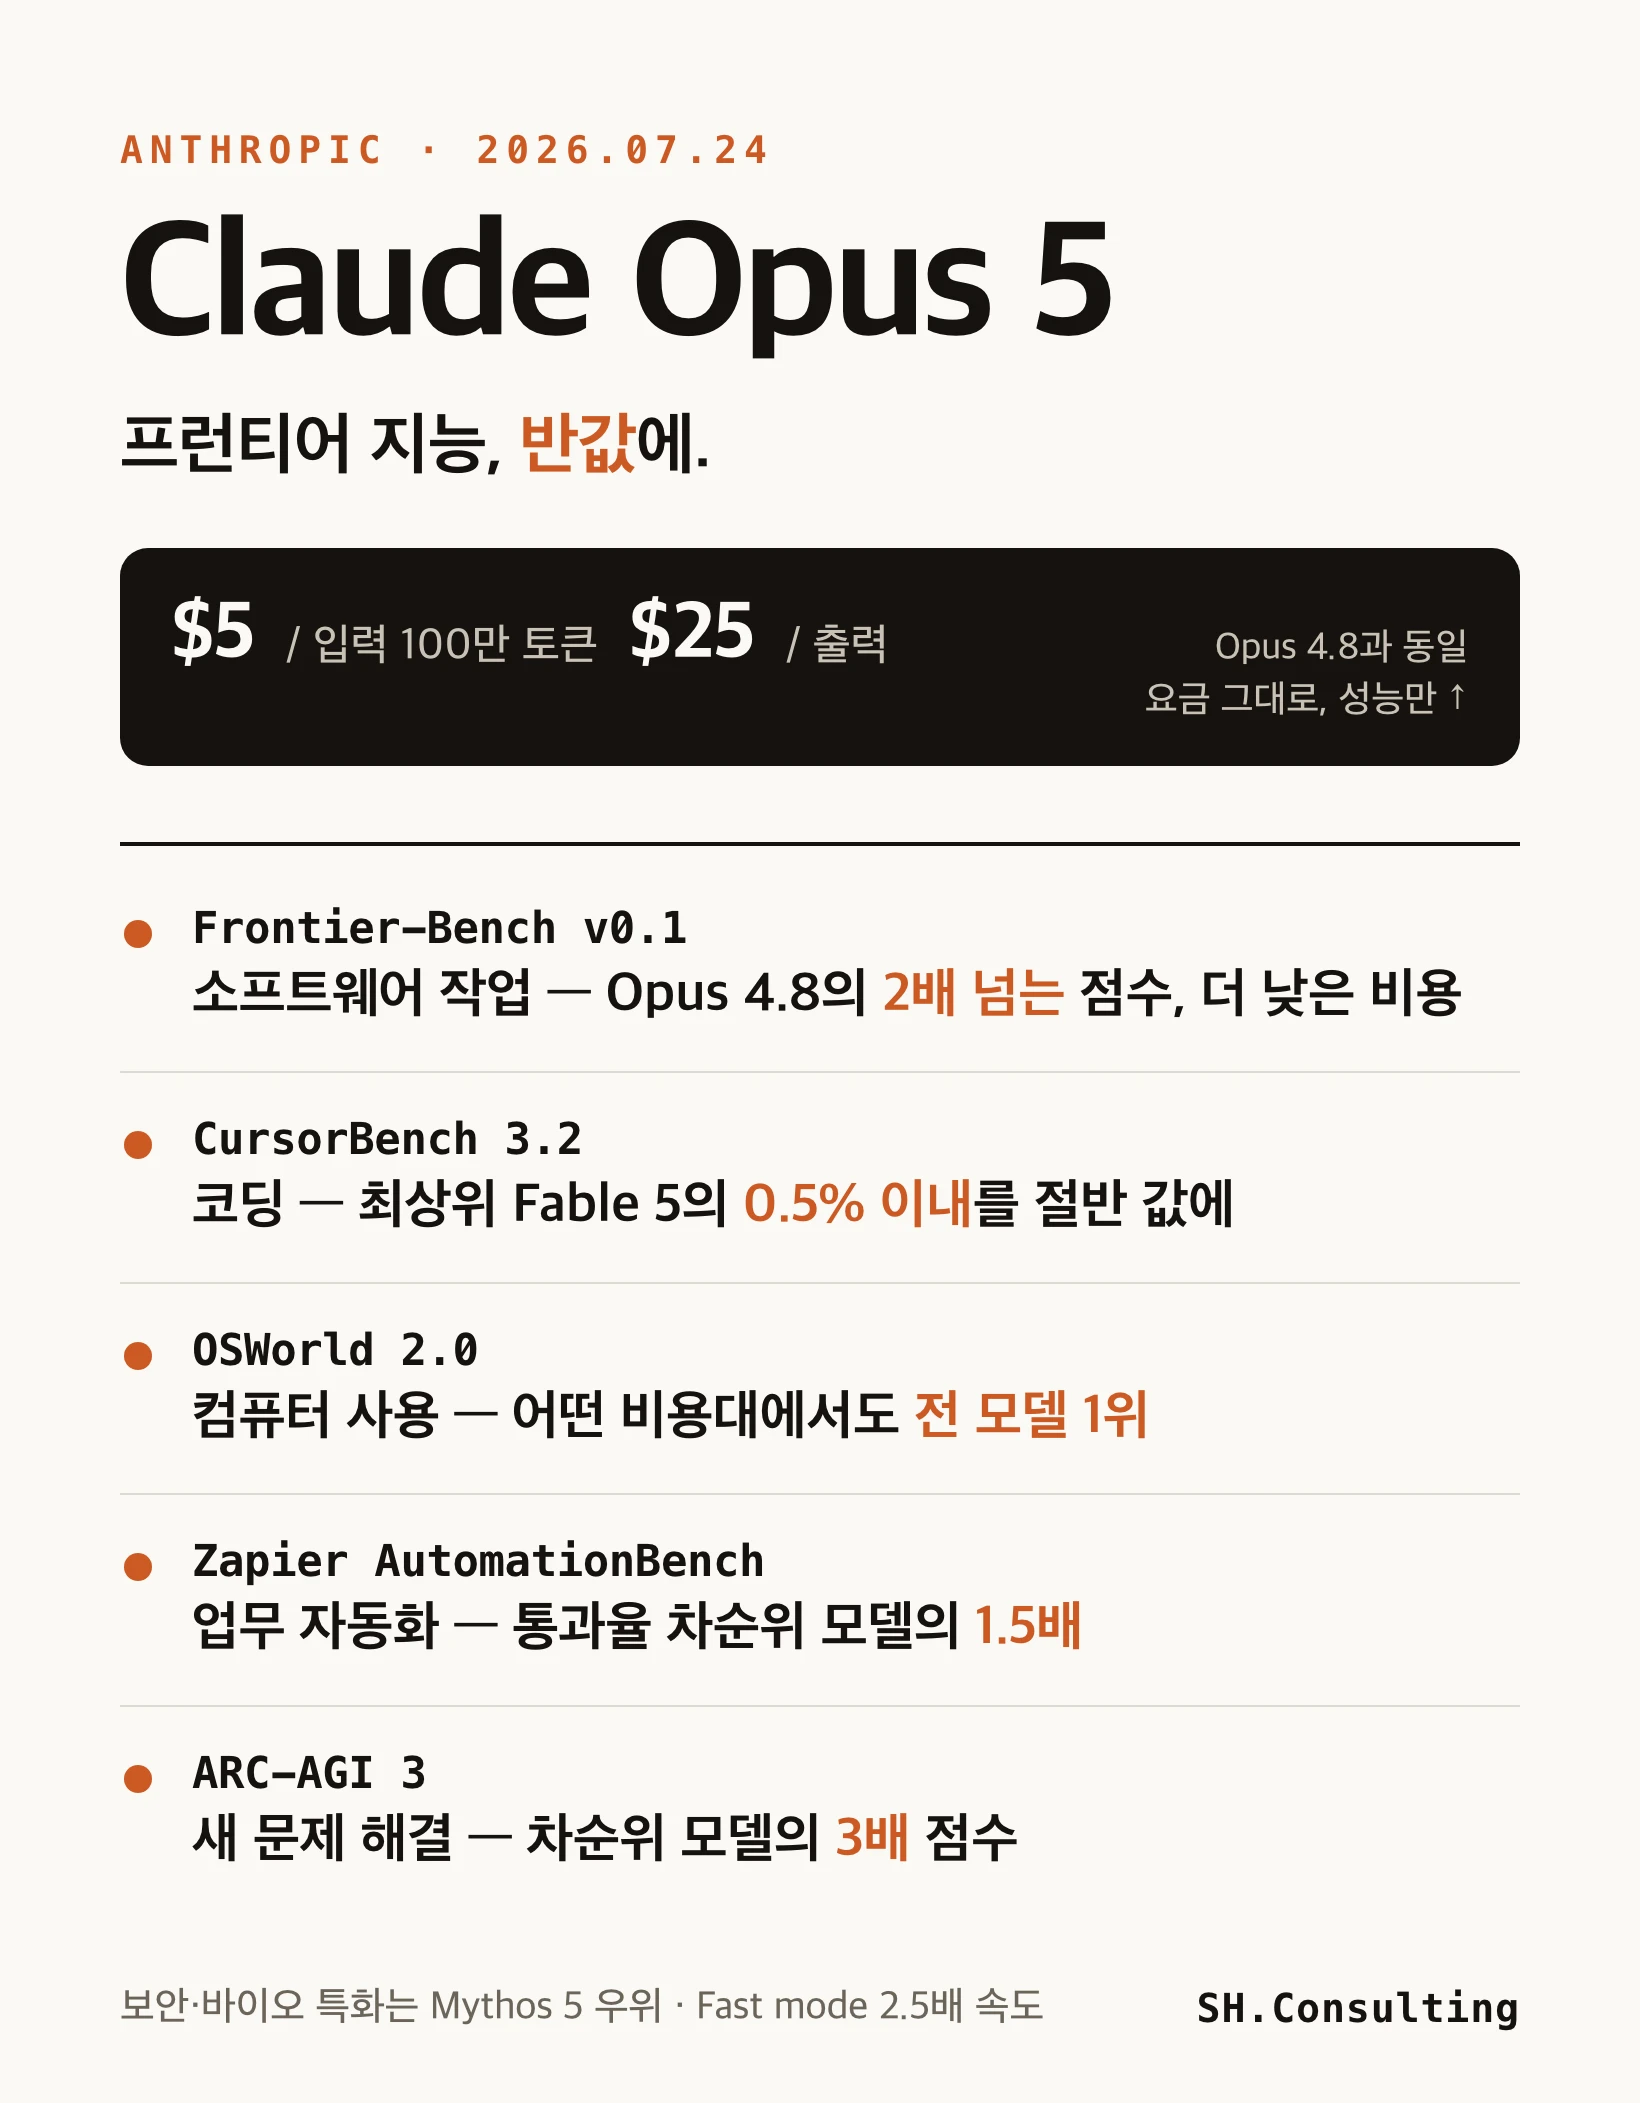
Claude Opus 5는 Anthropic이 2026년 7월 24일 공개한 최상위급 범용 AI 모델이다. 핵심은 '반값에 온 프런티어 지능'으로, 최상위 모델 Claude Fable 5에 근접한 지능을 그 절반 가격에 제공한다. 요금은 입력 100만 토큰당 5달러·출력 25달러로 직전 모델 Opus 4.8과 똑같은데 성능만 크게 올라, 코딩·지식노동·컴퓨터 사용·업무 자동화 벤치마크에서 새로운 최고 성적을 냈다. 다만 보안·생물학 같은 특화 영역은 전용 모델 Mythos 5가 여전히 앞선다.
몇 시간짜리 클로드 코드 세션은 어떻게 조종하는가? — Plan·Compact·Rewind·Goal·Loop·Worktree
짧은 작업은 시켜 놓고 지켜보면 되지만, 리팩터링이나 새 기능처럼 몇 시간이 걸리는 긴 작업은 맡겨 두는 게 아니라 '조종'하는 것이다. 핵심 습관은 둘이다. 시작 전에 범위를 좁히고(scope), 진행 중에는 방향을 잡는다(steer). 여섯 도구가 이를 돕는다. Plan Mode는 실행 전에 읽기 전용으로 조사해 계획을 내밀고, 그 계획을 읽고 다듬으면 이후 실행에서 어긋날 여지가 준다. Compact는 대화를 요약해 새 컨텍스트로 삼고 옛것을 지워 컨텍스트 창을 비우는데, 이때 '무엇을 남길지' 지시를 함께 주면 중요한 게 사라져 엉뚱한 방향으로 흐르는 것을 막는다. Rewind는 잘못 갔을 때 프롬프트로 빠져나오려 애쓰는 대신 빈 프롬프트에서 ESC를 두 번 눌러 체크포인트로 되돌아가, 코드·대화를 복원하거나 특정 지점 앞뒤를 요약한다. Goal은 완료 조건을 걸어 두면 Claude가 '스스로 끝났다고 여기는 첫 순간'에 멈추지 않고, 빠른 평가자가 그 조건 충족을 확인할 때까지 여러 턴에 걸쳐 계속 일한다(단 평가자는 대화 기록만 읽으므로 조건은 출력으로 확인 가능해야 한다). Loop는 프롬프트를 일정 간격으로 돌려 CI 실행이나 배포 같은 외부 상태를 지켜보다 변화가 생기면 반응한다. Worktree는 여러 에이전트가 한 저장소의 파일을 두고 다투지 않도록 독립된 파일 트리를 나눠 준다. 결국 범위를 먼저 좁히고 그다음 조종하면, 긴 실행을 붙어 지키지 않고도 믿고 맡길 수 있다.
클로드 코드 권한 모드란 무엇이고, 언제 auto로 손을 떼도 되는가?
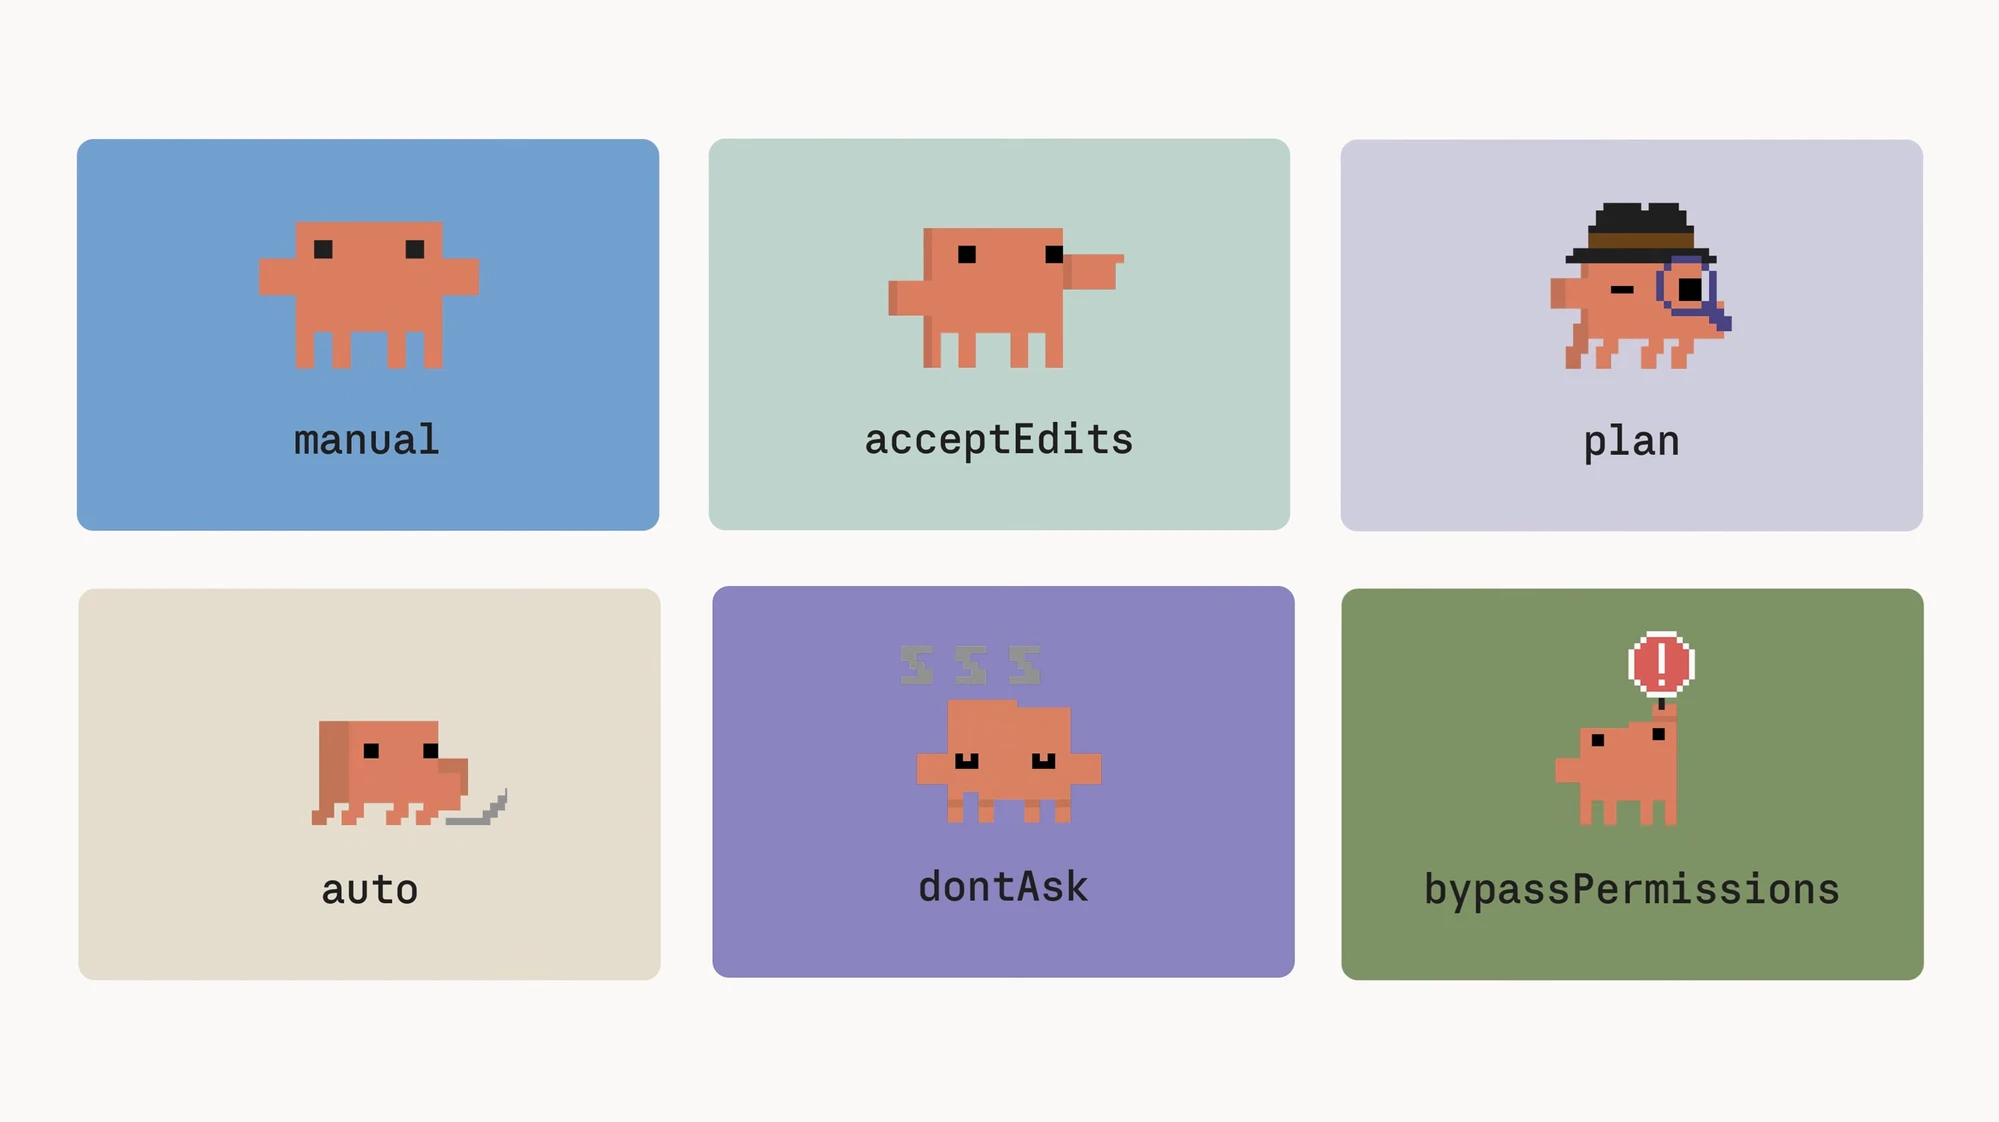
권한 모드(permission mode)는 클로드 코드에게 '내가 매번 승인하지 않아도 무엇을 실행해도 되는지'를 한 번에 정해 두는 설정이다. 여섯 가지가 있다. manual은 읽기만 하고 나머지는 매번 묻는다. acceptEdits는 읽기와 파일 편집, 흔한 파일시스템 명령까지 묻지 않고 진행해 나중에 몰아서 리뷰하게 한다. plan은 읽고 조사해 계획을 제안할 뿐 편집은 하지 않는다. auto는 전부 실행하되 별도 분류기 모델이 매 동작을 실행 직전에 검사해 위험한 것만 막는, 손을 떼는 기본값이다. dontAsk는 사전 승인된 도구만 허용하고 나머지는 프롬프트 없이 자동 거부해 CI·야간 배치에 쓴다. bypassPermissions는 모든 검사를 건너뛰는 'dangerously-skip-permissions'와 같아 격리된 컨테이너·VM에서만 쓴다. shift+tab으로 manual→acceptEdits→plan→auto를 순환하고 상태바가 현재 모드를 보여 준다. auto의 분류기는 '의도'는 지키지만 코드가 맞는지는 못 보므로, 테스트를 돌리는 stop hook과 함께 써서 의도는 분류기가, 정확성은 hook이 나눠 맡게 한다. 결국 얼마나 손을 뗄지는 배짱이 아니라 작업에 맞춰 정하고, 그에 맞는 모드를 고르면 된다.
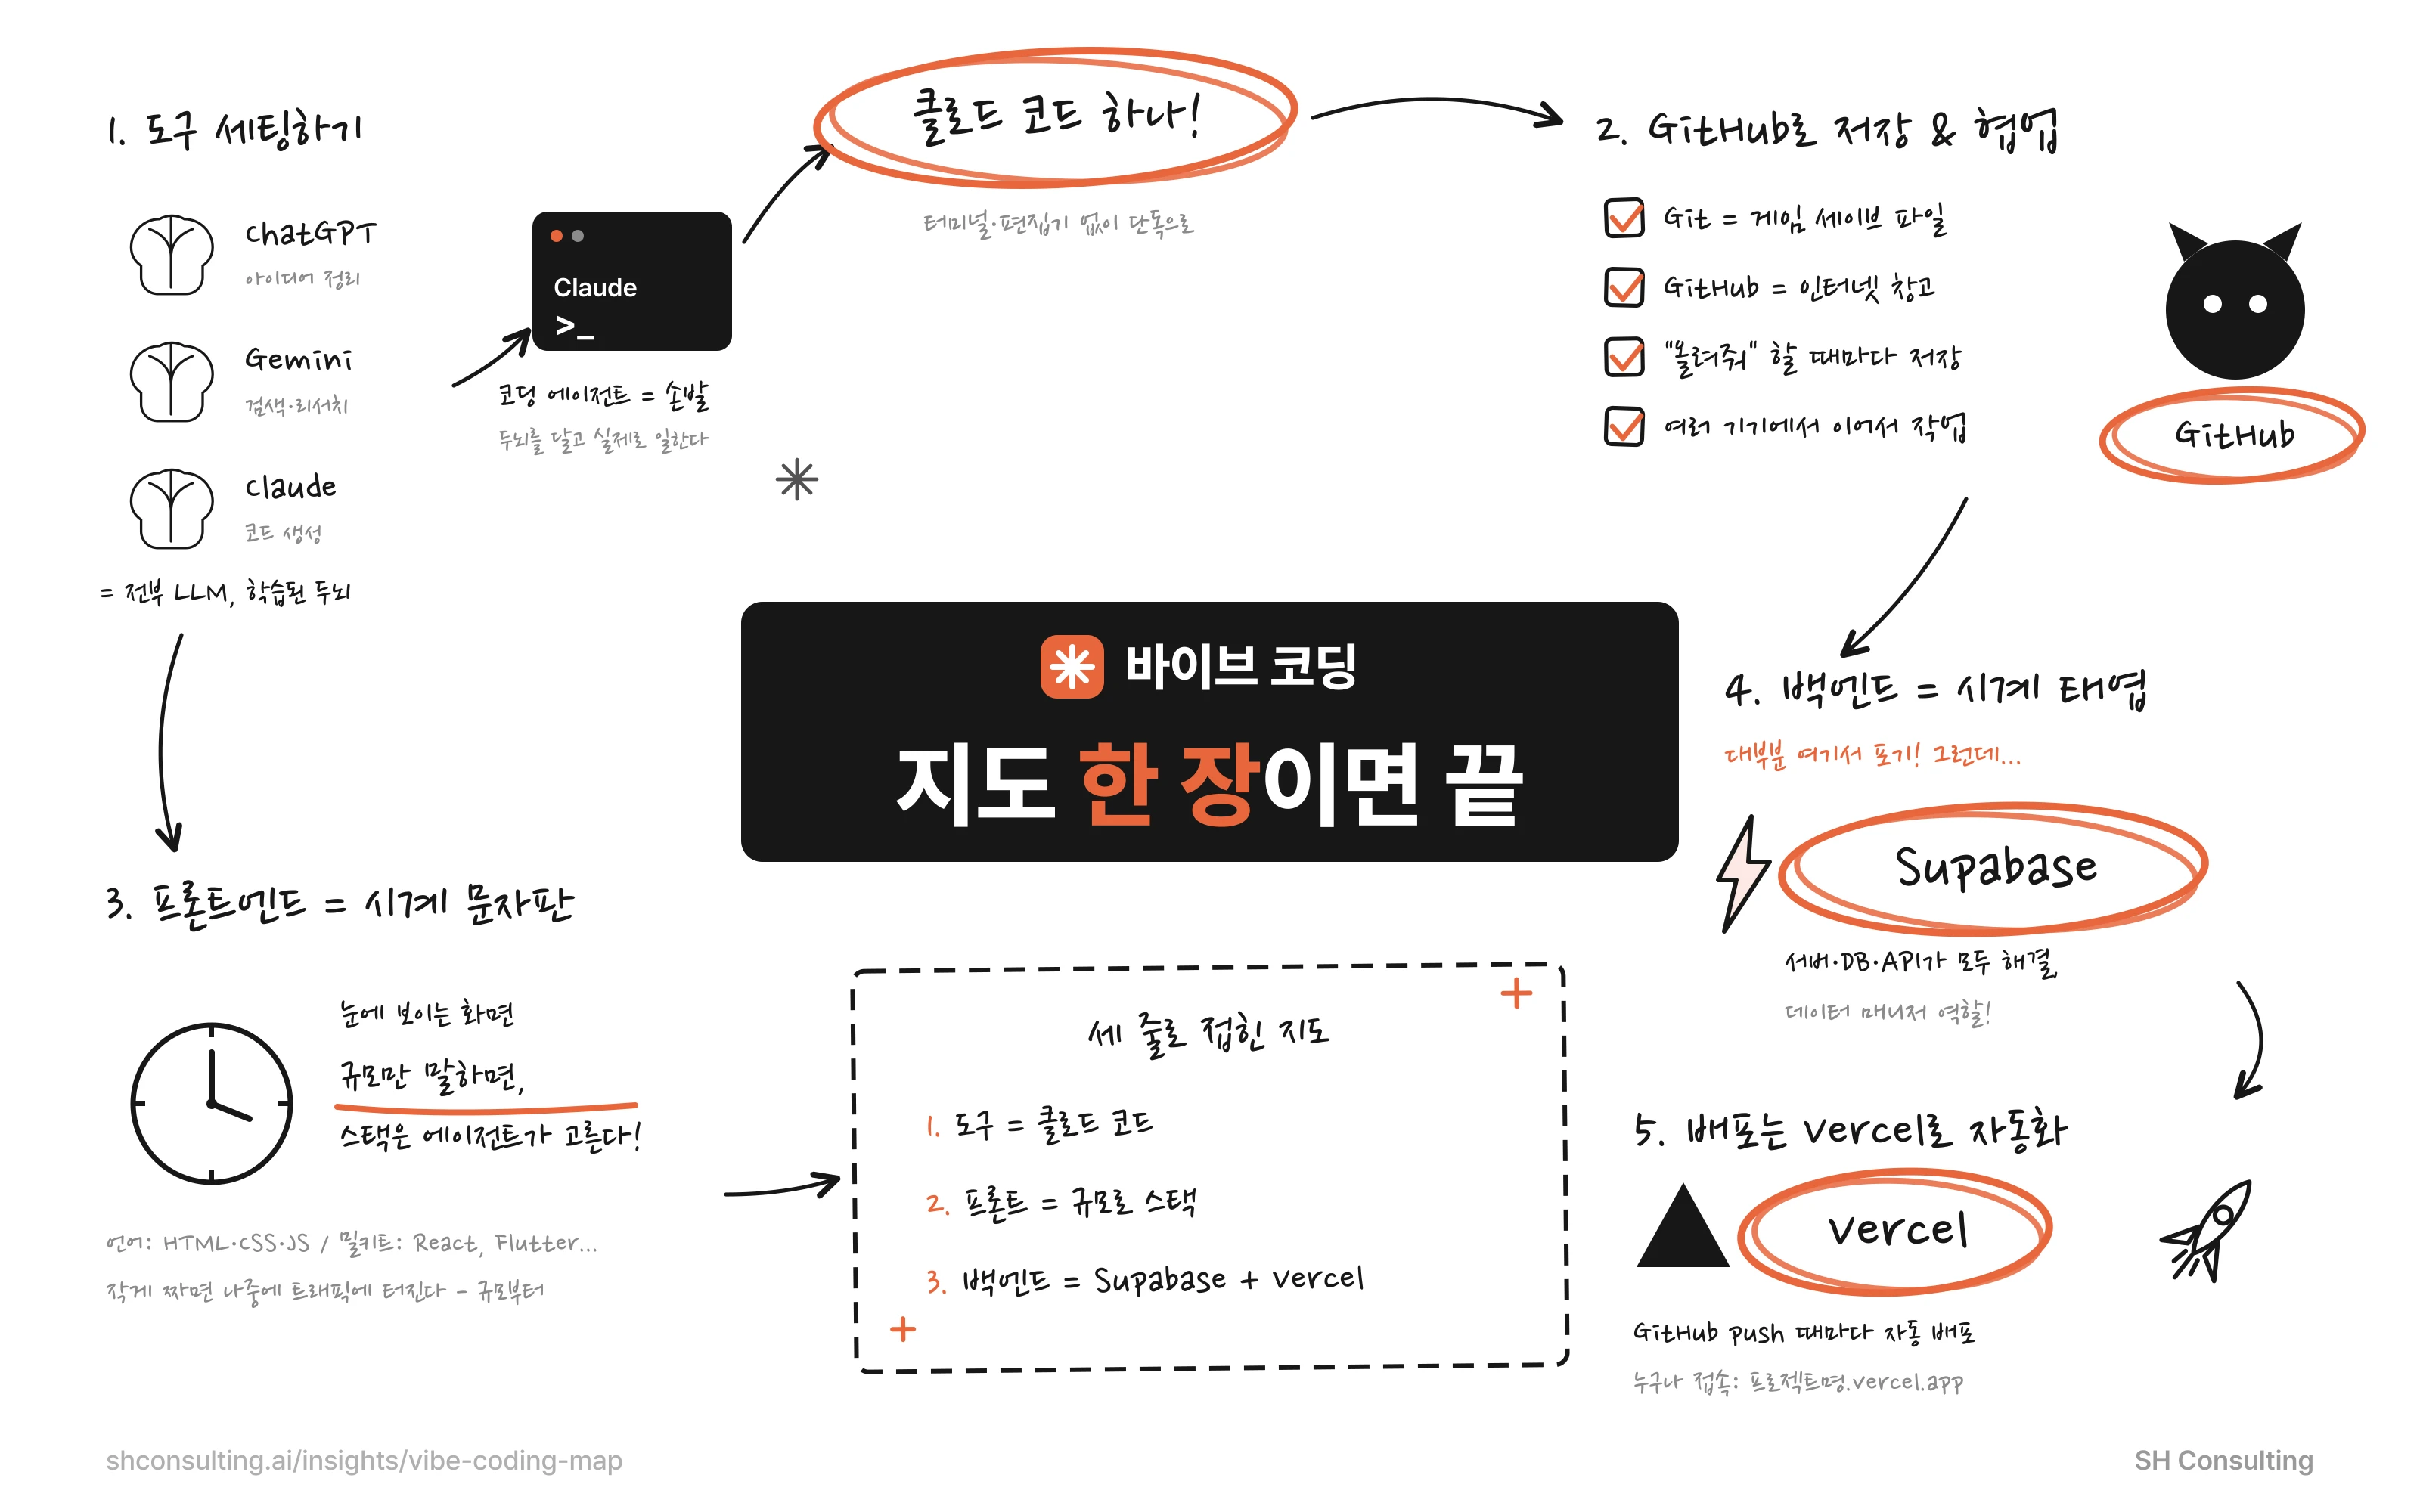
바이브 코딩이란 무엇이고, 도구부터 배포까지 지도 한 장으로 어떻게 정리되는가?
바이브 코딩은 코드를 한 줄씩 직접 타이핑하는 대신, AI에게 한국어(자연어)로 지시해 웹사이트나 서비스를 만드는 방식이다. 코딩을 한 번도 안 해 본 사람이 막막함을 느끼는 이유는 개별 도구가 어려워서가 아니라, 전체가 어떻게 맞물려 돌아가는지 그림이 머릿속에 없기 때문이다. 그 전체 그림은 지도 한 장으로 접힌다. 첫째, 도구다. ChatGPT·클로드 같은 LLM이 학습된 두뇌라면, 그 두뇌를 달고 실제로 파일을 만들고 고치는 손발이 코딩 에이전트이고, 요즘은 클로드 코드 하나가 터미널·편집기 없이 이 역할을 단독으로 한다. 둘째, 프론트엔드(눈에 보이는 화면)다. 만들 서비스의 규모만 알려 주면 에이전트가 맞는 스택을 골라 준다. 셋째, 백엔드(화면 뒤에서 데이터를 저장·처리하는 서버)다. 대부분이 여기서 포기하는데, 서버·데이터베이스·배포의 복잡한 과정을 Supabase(데이터 매니저)와 Vercel(배포 매니저)이 대신 넘겨 준다. Git과 GitHub은 그 사이에서 작업을 저장하고 인터넷 창고에 올리는 역할을 맡는다. 결국 지도는 세 줄로 접힌다: 도구는 클로드 코드, 프론트는 규모를 말해 스택을 맡기고, 백엔드는 Supabase와 Vercel.
Scrapling이란 무엇이고, 사이트가 개편돼도 스크래퍼가 안 깨지는 이유는?
Scrapling은 파이썬으로 웹 데이터를 긁어오는 오픈소스 프레임워크다(BSD-3 라이선스, GitHub 별 7만 개). 가장 큰 특징은 적응형 셀렉터다. 보통 웹 스크래퍼는 '이 클래스명을 가진 요소를 가져와라'처럼 화면 위 위치를 규칙으로 지정해 데이터를 뽑는데, 상대 사이트가 개편돼 클래스명이나 구조가 바뀌면 그 규칙이 전부 어긋나 빈 값만 나온다. Scrapling은 처음 수집할 때 요소의 특징을 함께 저장해 두었다가, 다음 실행에서 adaptive 옵션을 켜면 유사도 알고리즘으로 옮겨간 요소를 다시 찾아낸다. 그래서 사이트가 바뀌어도 사람이 셀렉터를 다시 고치지 않아도 된다. 여기에 Cloudflare 같은 안티봇 우회, 대규모 동시 크롤러, Claude·Cursor에 붙이는 MCP 서버까지 한 라이브러리에 들어 있다.
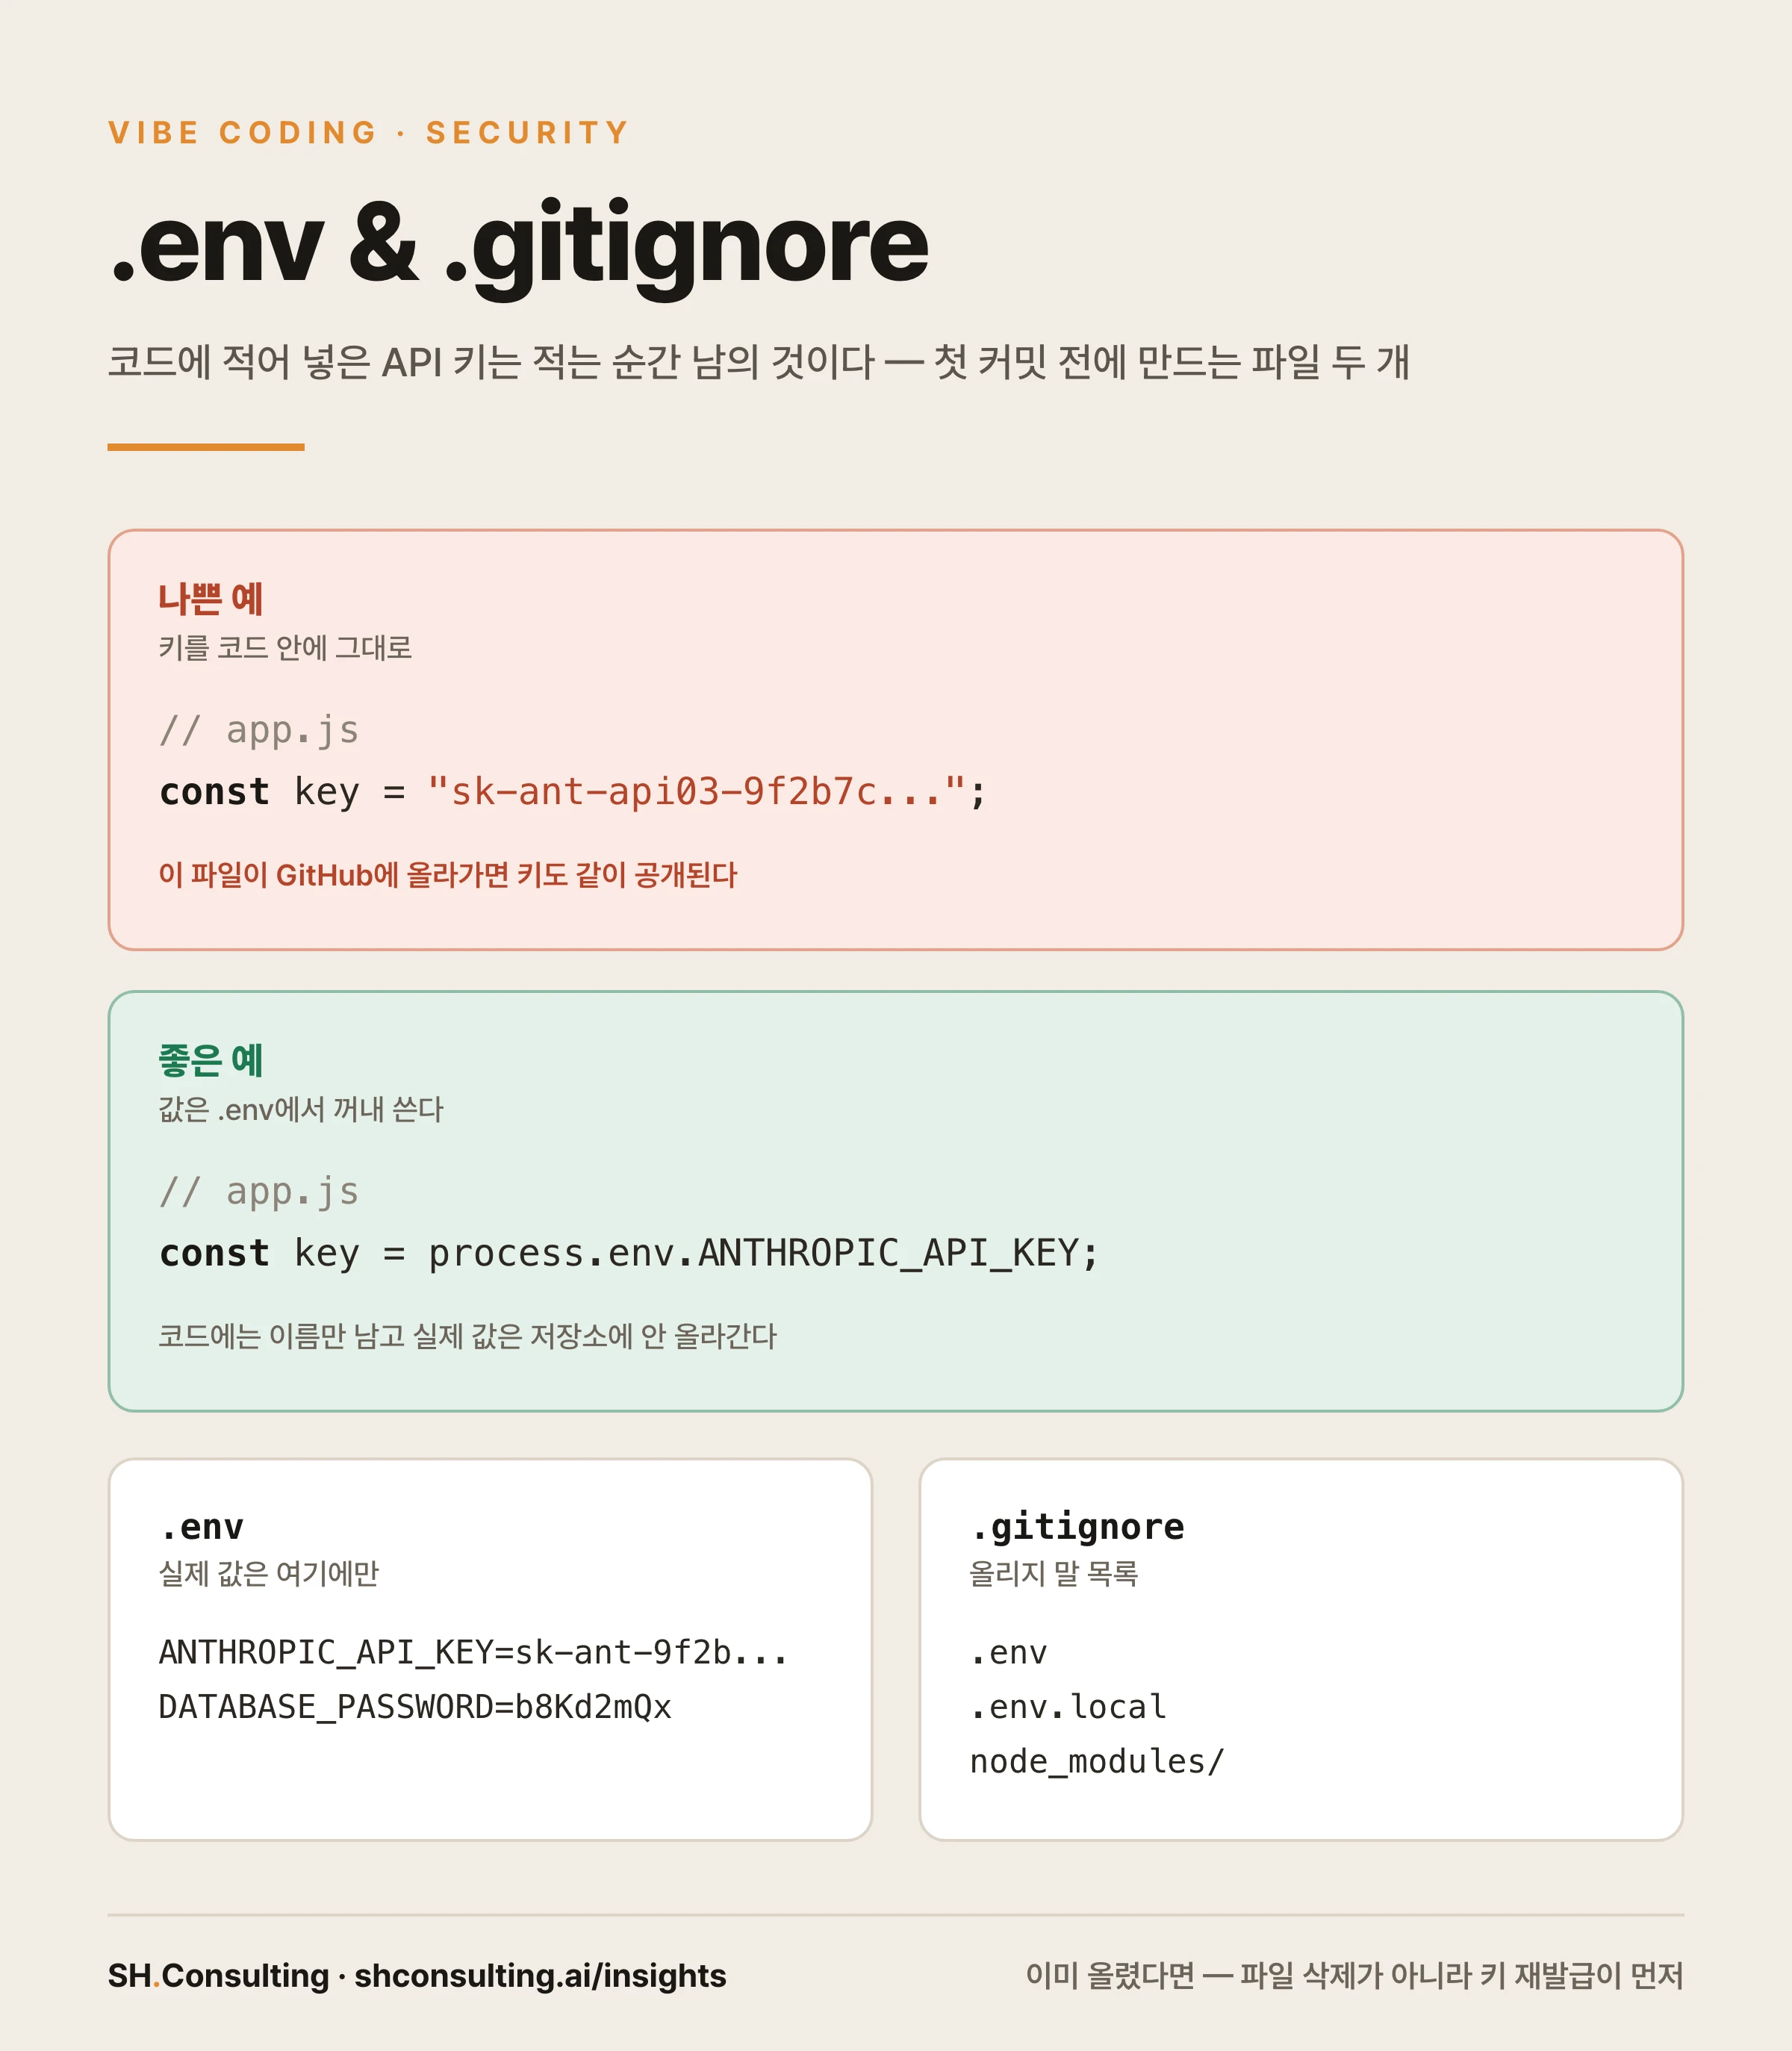
.gitignore와 .env란 무엇이고, 왜 첫 커밋 전에 만들어야 하는가
.env는 API 키·비밀번호처럼 남에게 보이면 안 되는 값을 코드 밖으로 빼서 담아두는 파일이고, .gitignore는 '이 파일은 저장소에 올리지 마라'고 깃에게 알려주는 목록이다. 둘 다 프로젝트 첫날, 첫 커밋 전에 만들어야 한다. 코드에 적어 넣은 키는 GitHub에 올라가는 순간 공개되고, 공개 저장소를 훑어 키만 긁어가는 자동 스캐너가 몇 분 만에 찾아내기 때문이다. 이미 올렸다면 파일을 지우는 것보다 키를 새로 발급받는 게 먼저다 — 깃 기록에는 옛 키가 그대로 남는다.
AI 시대에 사람에게 남는 능력은 무엇인가
AI에게 넘어가는 것은 정답을 내는 일과 그 정답을 채점하는 일이고, 사람에게 남는 것은 무엇을 채점할지 정하는 일이다. 지금 AI 업계에서 가장 비싸게 사들이는 자산은 각 분야 전문가의 판정 기준, 즉 채점표(eval·verifier)다. 그러나 채점표는 한 번 추출되면 복제되고, 채점 자체도 모델이 모델을 심사하는 방식으로 빠르게 자동화되고 있다. 자동화되지 않고 남는 층은 그 위에 있다. 어디를 볼 것인가를 고르는 호기심과 무엇을 좋다고 할 것인가를 고르는 취향이다. 둘 다 목적함수를 정하는 일이고, 목적함수는 모델이 스스로 만들지 못한다.
바이브 코딩 원칙 — AI에게 코드를 잘 시키려면 무엇을 정해줘야 하는가
AI에게 코드를 잘 시키는 원칙은 크게 여덟 가지다. 안드레이 카파시의 4원칙(생각 먼저·군더더기 없이·딱 고칠 데만·될 때까지)과 코드 정돈 4원칙(SSOT·DRY·KISS·YAGNI). 이 여덟은 사실 네 가지 상식(시키기 전 확인·단순하게·맡긴 데만·한 곳으로 모으기)으로 접힌다. 비개발자는 이 원칙들을 CLAUDE.md 또는 AGENTS.md 파일(=하네스)에 한 번 적어두면, AI가 매 대화를 그 지침부터 읽고 시작한다. 유능하지만 눈치 없는 신입 책상에 붙여두는 메모라고 생각하면 쉽다.
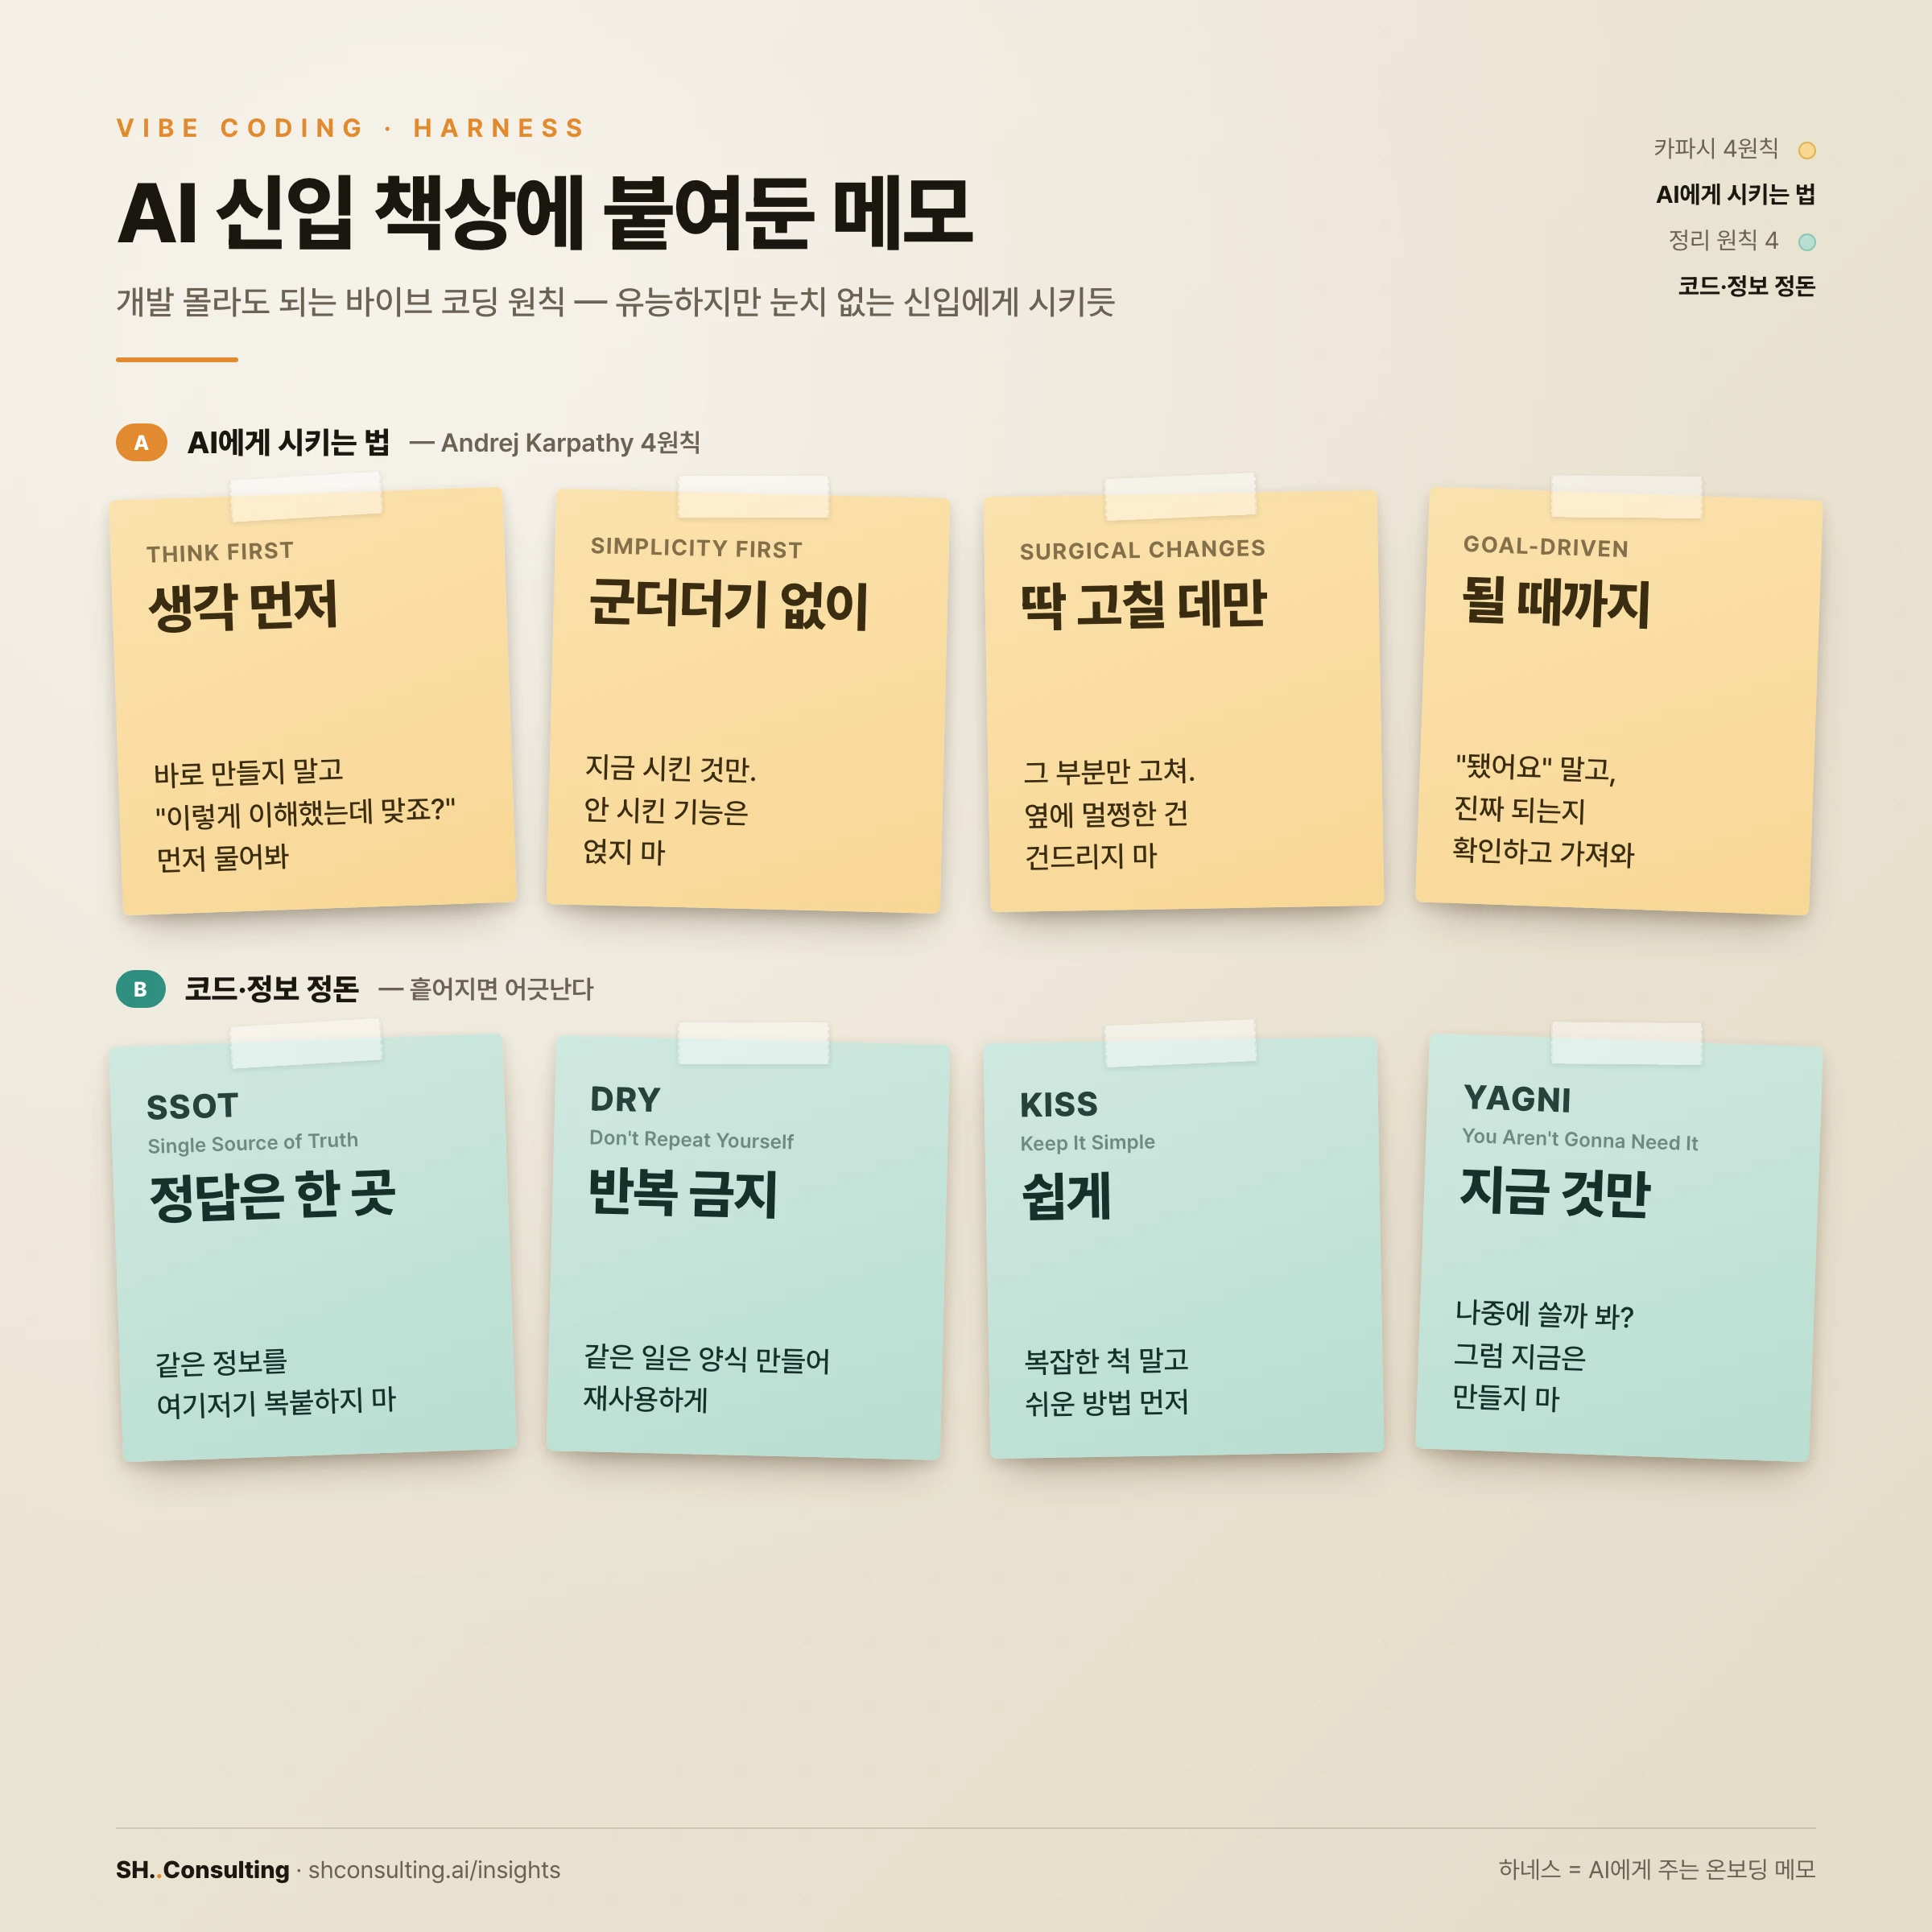
바이브 코딩 하네스(harness)란 무엇이고, 비개발자는 무엇부터 설정해야 하는가
하네스는 AI가 내 실력과 상황에 맞게 일하도록 프로젝트에 미리 깔아두는 규칙과 안내문을 말한다. 바이브 코딩(코드를 직접 쓰지 않고 AI에게 시켜서 소프트웨어를 만드는 방식)을 처음 하는 비개발자가 가장 먼저 해야 할 하네스 설정은 딱 한 줄이다. 프로젝트 폴더에 CLAUDE.md 또는 AGENTS.md라는 파일을 만들고 '나는 개발자가 아니다. 전문용어는 쉬운 말로 풀어서 짧고 간결하게 설명하라'라고 적어두면, AI가 매 대화를 그 지시부터 읽고 시작해 모든 답변의 눈높이가 달라진다.
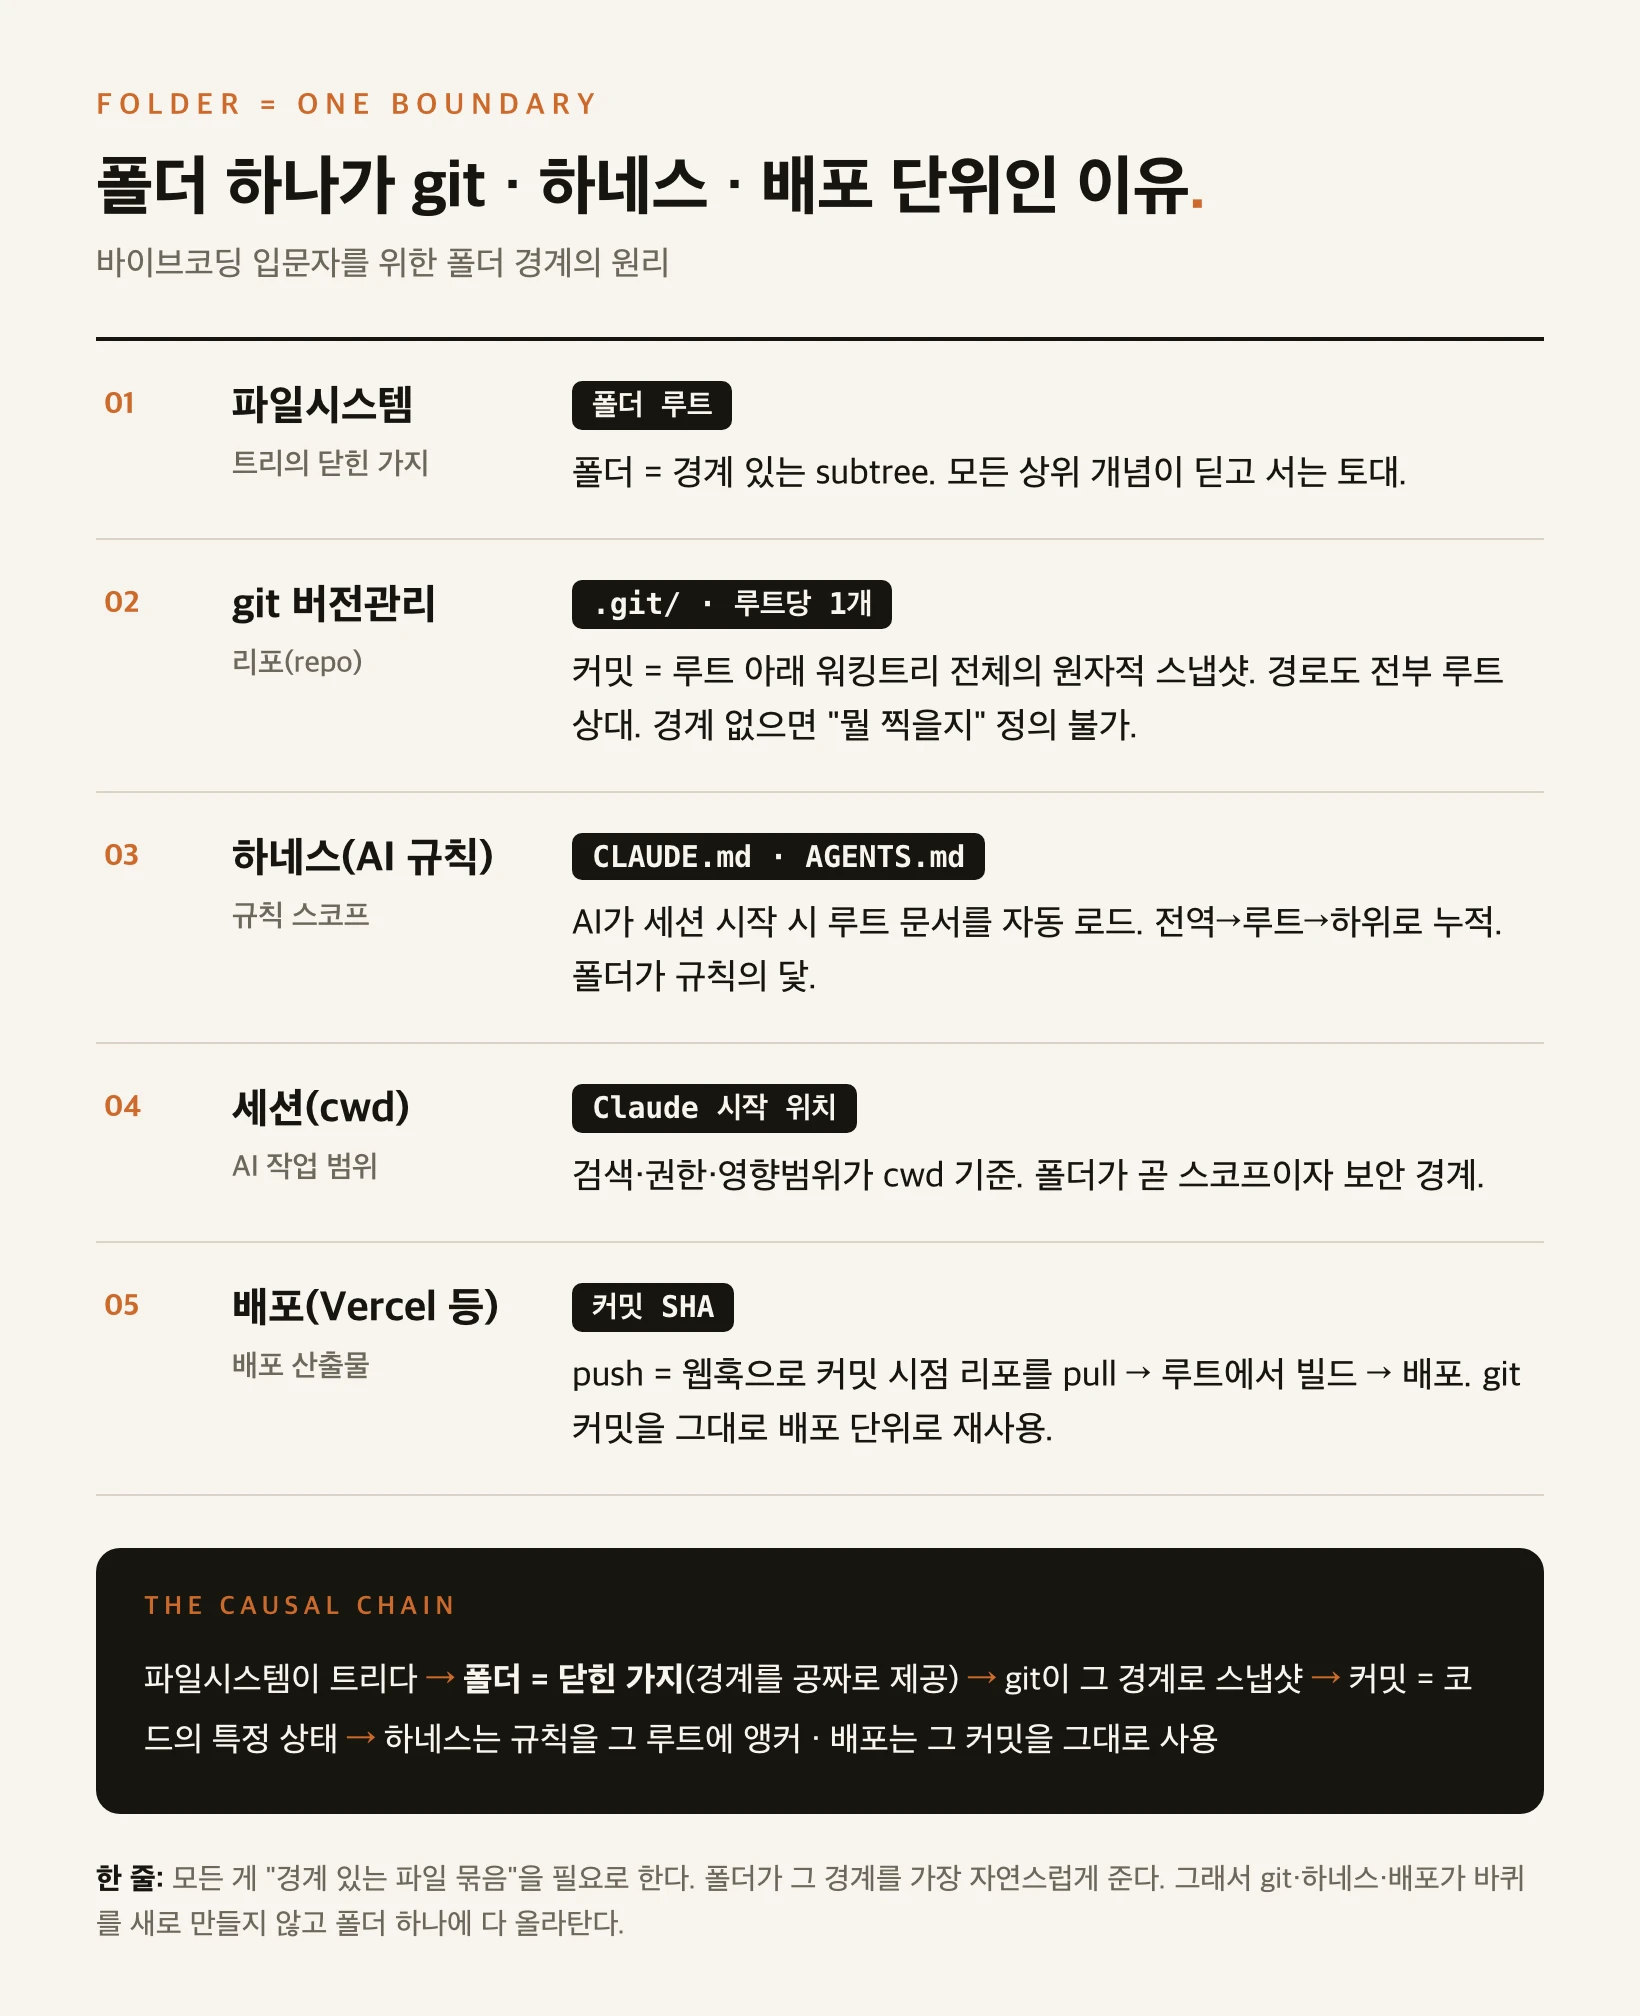
바이브코딩에서 프로젝트를 왜 폴더 하나에 두나
폴더가 git·하네스·배포의 공통 경계이기 때문이다. 파일시스템이 트리 구조라서 폴더 하나는 '경계 있는 닫힌 가지(subtree)'가 되고, git 리포(.git 루트당 1개)·AI 규칙 문서(CLAUDE.md·AGENTS.md)·배포(커밋 SHA)가 전부 그 같은 폴더 경계를 재사용한다. 그래서 push 한 번에 저장·규칙적용·배포가 동시에 돈다. 프로젝트는 폴더 안에 겹쳐 넣지 말고 나란히 두고, 각 폴더 루트에서 시작하는 게 표준이다.
AI 워싱이란 무엇이고, 감원의 진짜 이유는 무엇인가
AI 워싱은 기업이 실적 압박이나 조직 슬림화 같은 진짜 이유를 감춘 채 감원을 AI 탓으로 포장하는 행위를 말한다. 미국에서 'AI 때문'이라 명시된 감원은 올 상반기에만 10만 건을 넘었지만, CFO 700명을 대상으로 한 익명 조사에서는 90%가 'AI가 고용에 미친 영향은 사실상 없었다'고 답했다. 진짜 벌어지고 있는 일은 AI가 사람을 직접 대체하는 것이 아니라, AI를 잘 다루는 소수가 여러 사람 몫을 해내면서 특히 신입·저경력자의 채용 문이 닫히고 있는 현상이다.
뉴스 기사, 사실인지 거짓인지 어떻게 교차검증하나
같은 뉴스가 여러 매체에 떠 있어도 교차검증이 아니다 — 대부분 연합뉴스 한 건을 받아쓴 것이기 때문이다. 이 플러그인은 뉴스 URL을 받아 핵심 주장을 뽑고, 각 주장을 서로 독립된 출처로 대조해 사실·거짓을 판정한다. 확정 판정은 AI의 감이 아니라 코드가 계산하고(독립 지지 2개 이상=사실, 독립 반박 2개 이상=거짓, 못 채우면 검증 불가), 통신사 재출고는 하나로 눌러 센다. 봇 차단 사이트도 우회해 읽으며, 오픈소스(MIT)로 공개한 보조 도구다.
인스타 릴스 속 장소, 영상만으로 어떻게 역추적하나
홍보용 릴스는 사람을 끌어야 하니 화면에 단서를 잔뜩 남긴다. 이 스킬은 영상에서 프레임을 뽑아 그 단서(간판·지형지물·자막·캡션)를 AI가 읽고, 카카오맵·네이버 블로그·업로더 계정을 동시에 뒤져 후보를 좁힌 뒤, 반증까지 시도해 위치를 확정한다. Claude Code에 플러그인으로 설치하고 릴스 URL만 주면 된다. 업소·관광지 같은 공개 장소 홍보 콘텐츠 전용이며, 오픈소스(MIT)로 공개했다.
K Public Data MCP 병원 상세 조회는 무엇을 더 보여주나
K Public Data MCP는 한국 공공데이터를 AI가 곧장 쓰게 묶은 오픈소스 MCP 서버다. 이번에 건강보험심사평가원(심평원)의 '의료기관별상세정보서비스'를 붙여, 병원을 이름·지역·종별로 찾은 뒤 그 병원의 시설·병상, 진료과목별 전문의 수, 보유 의료장비(PET·CT 등), 교통 정보까지 한 번에 조회하도록 확장했다. 검색에서 멈추던 데이터가 그 병원 '안'까지 이어진다.
Claude Code 리모트 컨트롤이란 무엇인가 — 로컬 세션을 폰에서 이어받기
Claude Code 리모트 컨트롤(Remote Control)은 내 컴퓨터에서 실행 중인 AI 코딩 세션을 폰·태블릿·다른 브라우저에서 그대로 이어받아 지시하는 기능입니다. 세션은 계속 내 컴퓨터에서 돌고(클라우드가 아닙니다), 코드 실행과 파일 접근도 내 기기에 남습니다. 폰과 브라우저는 그 로컬 세션을 들여다보고 말 거는 창입니다. 프로젝트 폴더에서 claude remote-control 한 줄을 치면 세션 URL과 QR코드가 뜨고, 폰으로 QR을 찍으면 Claude 앱에서 그 세션이 열립니다. claude.ai Pro·Max·Team·Enterprise 구독에서 쓸 수 있고, 2026년 7월 기준 리서치 프리뷰입니다.
ir-search란 무엇인가 — 정부 지원사업 전수조사 AI 스킬
ir-search는 한국 정부·공공기관의 지원사업을 '전수조사'해 주는 오픈소스 에이전트 스킬입니다. K-Startup·기업마당·NIPA·KOCCA·SMTECH의 모집중 공고를 통째로 크롤링해서, 내 프로젝트 프로필(창업 단계·지역·필요한 것)에 맞는 사업을 골라 상세공고 원문으로 자격을 검증한 뒤, 지금 즉시 가능(A)·요건 충족 시(B)·변형하면 가능(C) 세 그룹으로 분류한 보고서를 만들어 줍니다. Claude Code·Codex·Cursor·Gemini 등 여러 에이전트에서 한 줄로 설치·실행되며, 모든 공고에 원문 URL을 붙이고 공고에 없는 정보는 추정하지 않고 '불명'으로 표기합니다. 제작자(djfksjd)가 MIT 라이선스로 공개했습니다.
AI가 만든 회원가입에 빠져 있는 5가지는 무엇인가
AI에게 '이메일과 비밀번호로 회원가입 만들어줘'라고 한 줄로 시키면 화면은 5분 만에 나오지만, 그 결과물에는 비밀번호 찾기, 회원정보 수정, 회원 탈퇴, 개인정보 처리방침, 이용약관 다섯 가지가 빠져 있습니다. 이건 기능을 하나 더 붙이는 문제가 아니라 정책을 정하는 결정의 문제입니다. 재설정 링크를 몇 분 유효하게 할지, 탈퇴 데이터를 진짜 지울지 익명화만 할지, 처리방침을 실제 수집 항목 기준으로 쓸지를 사람이 먼저 정해야 AI에게 제대로 시킬 수 있습니다. 탈퇴와 처리방침을 빼먹으면 개인정보보호법 위반으로 과태료 대상이 됩니다. AI 시대에 만드는 사람의 실력은 코드가 아니라 이 결정 목록에서 나옵니다.
GPT 라이브로 실시간 동시통역은 어떻게 하는가
GPT 라이브(GPT-Live)는 OpenAI가 내놓은 새 ChatGPT 음성 모델로, 듣기와 말하기를 동시에 하는 '풀 듀플렉스(full duplex)' 구조 덕분에 사람이 말하는 도중에도 끼어들 때와 물러설 때를 스스로 판단합니다. 그래서 실시간 동시통역이 비로소 자연스러워졌습니다. 사용법은 ChatGPT 앱에서 음성 모드를 켜고 '지금부터 내가 한국어로 말하는 걸 영어로 바로바로 통역해줘'라고 한 문장 지시하는 것으로 끝입니다. 발표자가 한국어로 말하면 AI가 곧바로 영어로 옮겨 상대의 이어폰으로 흘려보내고, 서로 말이 겹쳐도 끊기지 않습니다. 이 기능은 무료 사용자에게까지 열려, 통역이 돈과 사람의 문제이던 시대가 끝나가고 있습니다.
기업의 뇌(Enterprise IQ)란 무엇이고, AI 전환은 왜 끼워넣기가 아닌가
AI 전환의 성패는 기존 업무의 어디에 AI를 끼워넣느냐가 아니라, 우리 회사가 시장에서 이겨온 고유한 전략 로직 — BCG가 '기업의 뇌(Enterprise IQ)'라 부르는 것 — 을 AI에 심느냐에 달려 있습니다. 대부분의 기업은 업무 순서는 그대로 두고 사이사이에 AI를 꽂는 '끼워넣기(deployment)'에 머물러 손발만 빨라지고, BCG가 말하는 '리셰이프(reshape)'는 일의 순서 자체를 재설계해 신제품 기획을 6개월~1년에서 1~2개월로 줄입니다. 이 재설계를 가능하게 하는 뇌는 OpenAI도 팔란티어도 만들 수 없고, 자기 시장의 논리를 아는 회사만 만들 수 있습니다.
고객이 직접 개발하는 시대, 외주 개발사는 무엇을 남기나
고객이 AI로 직접 개발할 수 있는 시대에 외주 개발사가 남기는 것은 완성된 결과물이 아니라 '판단하는 게이트'와 '고객이 스스로 하게 만드는 교육'입니다. AI 개발사 리트머스는 고객이 화면에서 고칠 곳을 클릭해 코멘트를 남기면 그것이 티켓이 되고 에이전트가 개발에 들어가는 구조를 만들었고, 프로젝트가 무르익으면 PM이 무엇을 반영하고 무엇을 막을지 게이트에서 판단합니다. 같은 골격으로 SH Consulting은 RFP의 100%를 다 구현해 넘기는 대신 핵심 80%를 만들고, 남은 20%는 AX 교육으로 고객이 직접 마무리하고 유지보수하도록 돕습니다. AI가 실행을 대신할수록 개발사의 값어치는 코드가 아니라 판단과 교육으로 옮겨갑니다.
전문직 사무소에 AI 에이전트를 붙이면 무엇이 달라지나
전문직 사무소에 AI 에이전트를 붙인다는 것은, 전문가의 ‘판단’ 앞단에 놓인 반복 업무—문의 접수, 사건·상담 유형 분류, 1차 리스크 정리—를 AI가 처리하고 사람은 판단과 책임에만 집중하도록 업무를 재설계하는 일입니다. 21년 검사 출신 이영남 변호사의 사무소 사이트 thechain.lawyer가 그 사례입니다. 방문자가 자기 상황을 적으면 AI 상담 에이전트가 사건 유형을 나누고 쟁점과 리스크를 1차로 정리해 변호사에게 넘기고, 변호사는 정리된 맥락 위에서 판단만 합니다. 베테랑의 직관은 그대로 두고 그 앞단의 반복만 걷어내는 구조라, AI는 전문가를 대체하는 것이 아니라 증강합니다.
AI가 만든 결과, 어디까지 이해하고 어디서 덮어야 하는가
AI로 일할 때는 모든 것을 이해하려 들지 말고, 어디까지 파고 어디서 덮을지 경계를 먼저 그어야 합니다. 다 이해하려 하면 오히려 사람의 이해가 병목이 되어 일이 느려집니다. 핵심 기술은 깊이 이해하는 대신 값싼 반복 검증으로 신뢰를 사는 것입니다. 예를 들어 같은 AI에게 '이거 진짜 맞아?'를 세 번 되물어 세 번 다 맞다고 하면 그대로 신뢰하고 덮습니다. 대신 돈의 흐름·보안·계약처럼 틀리면 치명적인 곳에만 검증 게이트를 촘촘히 두면 됩니다. 이 글은 그 경계를 어떻게 긋고, 되묻기를 실제로 어떻게 돌리며, 무엇을 덮고 무엇을 남길지를 처음 해 보는 사람도 그대로 따라 할 수 있게 정리한 것입니다.
Claude Design이란 무엇이고 비개발자가 어떻게 시작하나
Claude Design은 Anthropic이 만든 AI 디자인 도구로, 채팅하듯 대화만으로 웹사이트·프로토타입·발표 슬라이드·광고·문서를 만들어 주는 Anthropic Labs의 리서치 프리뷰 제품입니다. Claude의 프런티어 모델(튜토리얼 기준 Opus 4.8)로 구동되며, Pro·Max·Team·Enterprise 구독자가 claude.ai 사이드바나 Claude 데스크톱 앱에서 쓸 수 있습니다. 핵심은 '디자인 시스템'을 먼저 만들어 브랜드의 폰트·색·로고를 고정한 다음, 그 위에서 모든 결과물을 같은 톤으로 뽑아낸다는 점입니다. 완성한 시안은 Claude Code로 넘겨 실제 코드로 만들고 배포까지 이어갈 수 있습니다. 이 글은 디자이너나 영상 편집자 없이 한 사람이 브랜드 자산 한 벌을 만드는 흐름을, 처음 접하는 사람 기준으로 하나씩 따라갑니다.
HITL: AI가 기획·개발까지 하는데 사람은 왜 남는가
AI 업무 자동화는 반복 실행을 넘어 신규 서비스 기획·개발까지 확장됩니다. AI CS 봇은 업무 '종류'로는 20%지만 실제 업무량으로는 80%를 차지하는 반복 문의(파레토 8:2)를 근거와 함께 자동 처리합니다. 여기서 더 나아가, 커뮤니티 여론을 모니터링해 AI가 신규 서비스를 자동 기획·개발하는 파이프라인에서는 사람이 'Go/Stop 결정'과 '기능 테스트'라는 두 판단 지점에만 남습니다. 이렇게 사람이 자동화 고리(loop) 안에 남아 판단하는 구조를 HITL(Human In The Loop)이라 합니다. 실행부터 기획까지 기계가 맡고, 사람의 일은 판단으로 수렴합니다.
GPT-5.6 워크와 클로드 코워크, 업무 자동화는 어느 쪽이 나은가
한 AI 교육 크리에이터가 GPT-5.6과 클로드 페이블5에 같은 프롬프트를 주고 유튜브 데이터를 실시간으로 끌어오는 대시보드를 만들게 한 비교 리뷰다. 두 도구의 성격이 갈렸다. 클로드는 수단을 가리지 않고 원하는 결과를 빠르게 가져다주고, GPT는 오래 생각하며 안전하게 가되 새 '사이트' 기능으로 배포까지 가능한 서비스를 만들었다. 그러나 정작 중요한 변화는 결과물이 아니라 구조에 있다. 그동안 사람이 직접 엮어야 했던 하네스(서브에이전트·스킬)가 도구 안으로 흡수되면서, 사용자가 그 개념을 몰라도 되게 됐다. 이것이 기업 AX 도입의 진입 장벽을 실질적으로 낮춘다.
테슬라 HW3와 HW4, FSD 성능은 얼마나 다른가
같은 길을 테슬라 구형 하드웨어(HW3)와 신형(HW4)으로 각각 자율주행으로 달려 비교한 영상에 따르면, 일상 주행에서는 두 세대 차이가 거의 없습니다. 시내와 고속도로를 왕복하는 내내 핸들도 페달도 개입이 없었고, 2025년 초부터 같은 FSD 빌드(v12.6.4)에 묶여 있는 HW3도 HW4만큼 매끄럽게 달렸습니다. HW4와 v14의 실질 이점(추론 연산 3~5배, MLIR 컴파일러 재작성, 주차 상태 출발)은 긴급차량·복잡한 주차 같은 까다로운 엣지 케이스에서 드러납니다. 결론적으로 대다수 오너에게 HW3는 여전히 충분합니다.
바이브 코딩 입문자를 위한 Git, 무엇부터 배우나
Git은 코드의 버전을 관리하는 도구입니다. 실수해도 이전 상태로 되돌리고, 지금까지 무슨 작업을 했는지 이력을 남기고, 원본을 건드리지 않고 안전하게 실험하게 해 줍니다. 입문자가 알아야 할 건 세 덩어리뿐입니다. 첫째 add와 commit으로 마음에 드는 순간을 버전으로 박아 두고, 둘째 diff와 에디터 GUI로 커밋 전에 무엇이 바뀌었는지 확인하고, 셋째 branch로 사본을 떠서 거기서 먼저 만들어 본 뒤 잘 되면 원본에 합칩니다. 설치는 한 줄, 외울 명령어는 몇 개뿐이고, 터미널을 고집하지 않고 VS Code의 GUI로 시작해도 충분합니다.
기업 AI 도입은 왜 실무로 이어지지 못하는가
기업의 AI 도입이 POC에서 멈추는 이유는 기술이 아니라 구조입니다. 실험할 전담 조직도 시간도 없이 AI 활용을 기존 업무 위에 엑스트라 워크로 얹으면, 그럴듯한 시제품은 나와도 상용화로는 넘어가지 못합니다. 업계에서는 이 지점을 'POC의 저주'라 부릅니다. 성패는 AI를 전담하는 팀의 유무, 그리고 결과를 검증할 수 있는 도메인 지식으로 갈립니다. 대단한 걸 만들려 하지 말고, 매일 반복하는 내 업무의 작은 조각부터 넘기는 편이 낫습니다.
바이브 코딩에서 스킬·CLI·MCP는 서로 뭐가 다른가
스킬은 클로드에게 방법을 알려주는 마크다운 지침서이고, CLI는 모델이 학습 데이터로 이미 익힌 터미널 명령이며, MCP는 인증·권한·도구 설명을 표준 규격에 담아 외부 서비스와 연결하는 프로토콜입니다. 셋은 경쟁하지 않고 층을 이룹니다. 스킬이 방법을 정하면 CLI나 MCP가 실제로 실행합니다.
클로드 코워크 모바일, 무엇이 달라졌나
클로드 코워크가 웹과 모바일로 확장됐습니다. 이제 앤트로픽 서버에서 원격으로 실행되어, 노트북을 닫아도 작업이 계속되고 휴대폰으로 이어받을 수 있습니다. 예약 작업으로 아침 브리핑을 미리 만들어 두고 사람의 결정만 기다리게 할 수 있으며, 데스크톱 앱은 챗과 코워크가 하나의 홈으로 합쳐졌습니다. 다만 웹·모바일은 계정에 연결된 클라우드 자료로만 일하고, 로컬 파일이나 브라우저 조작은 여전히 데스크톱 앱이 열려 있어야 합니다.
바이브 코딩은 왜 'AI에게 최대한 떠넘기기'인가
바이브 코딩의 핵심은 AI가 할 수 있는 일을 사람이 대신 하지 않는 것입니다. 초보자는 AI가 'git을 설치하세요', 'Vercel을 설정하세요'라고 안내하면 그대로 자기가 하다가 지칩니다. 하지만 그 일들은 대부분 AI가 직접 할 수 있고, '네가 설치해', '네가 설정해줘', '네가 직접 확인해봐' 한 마디면 에이전트가 대신 처리합니다. 회원가입처럼 사람만 할 수 있는 일만 남기고, AI가 '정말 못 한다'고 할 때까지 나머지를 전부 떠넘기는 것 — 그것이 바이브 코딩에서 위임의 진짜 의미입니다.
전 직원에게 AI 코딩을 도입하면 조직은 무엇을 재설계해야 하는가
전사에 코딩 에이전트를 배포하는 진짜 과제는 도구 지급이 아니라 그 뒤에 드러나는 병목을 재설계하는 일입니다. 도어대시는 엔지니어를 넘어 전 직원에게 Claude Code를 지급했는데, 처리량이 오르자 CI/CD·코드 리뷰·보안이 새 병목으로 떠올랐고 이를 다시 AI로 자동화해야 했습니다. 조직 차원의 교훈은 세 가지입니다. 학습은 글로 남긴 산출물로만 확산되고, 실험 팀에는 임원 스폰서십이 필요하며, AI 챔피언은 위에서 지정하는 게 아니라 자발적으로 드러나게 해야 합니다. AX는 도구 구매가 아니라 코딩이 빨라진 뒤 병목을 어떻게 다시 설계하느냐의 문제입니다.
비개발자가 바이브 코딩을 시작할 때 왜 git이 첫 난관인가
비개발자가 바이브 코딩을 시작하면 코드보다 먼저 git이라는 벽을 만납니다. Claude Desktop에 코드를 실행해달라고 하면 가장 먼저 'git을 설치하라'는 안내가 나오기 때문입니다. git은 코드의 모든 변경을 기록해 언제든 이전 상태로 되돌리게 해주는 버전 관리 도구로, AI가 코드를 망쳐도 복구하게 해주는 안전장치입니다. 문제는 개념이 아니라 설치입니다. PC 환경과 숙련도가 저마다 달라 설치 화면의 선택 하나에서 대부분 막힙니다. 그래서 git 설치 자체를 Claude Code에게 시키는 것이 바이브 코딩의 실질적인 첫 실습이 됩니다.
Claude Code와 Codex, 어디서 어떻게 쓰나
Claude Code와 OpenAI Codex 같은 코딩 에이전트는 네 가지 표면에서 씁니다. 터미널 없이 버튼으로 쓰는 데스크톱 앱, 쓰던 에디터에 얹는 VS Code 확장, 자동화까지 되는 CLI, 그리고 Cursor·Replit처럼 에이전트가 처음부터 내장된 IDE입니다. 같은 모델이라도 어느 표면에서 쓰느냐가 작업의 성격을 바꿉니다. 터미널에서 쓰면 자동화가 되고 데스크톱에서 쓰면 대화가 됩니다. 그래서 도구보다 표면 선택이 먼저입니다.
바이브 코딩에서 만나는 파일 포맷, 어떻게 구분하는가
비개발자가 바이브 코딩에서 마주치는 수십 개의 파일 포맷은 사실 딱 세 부류로 나뉩니다. 데이터를 담는 그릇(CSV·JSON·XML), 화면으로 보여주는 것(HTML·마크다운), 그리고 설정과 비밀(YAML·.env)입니다. 확장자를 하나하나 외울 필요는 없습니다. 낯선 파일을 만났을 때 '이건 데이터냐, 화면이냐, 설정이냐'만 구분하면 진입 장벽의 절반은 사라집니다.
AI 모델의 진짜 프론티어는 무엇으로 정의되는가
AI 모델의 프론티어는 이제 벤치마크 정답률이 아니라 '지저분한 실제 환경에서 오래 버티는 능력'으로 정의됩니다. 수십 년 쌓인 레거시 도구, 항상 맞아야 하는 법률·금융 문서, 여러 시간 이어지는 자율 작업처럼 현실 업무의 혼란 속에서 스스로 궤도를 유지하는 것이 새 도약의 핵심입니다. 그 결과 기업 AI 도입의 병목도 '모델이 충분히 똑똑한가'에서 '우리 조직의 지저분한 맥락을 모델에게 어떻게 넘기는가'로 옮겨갑니다.
AI 시대에 moat는 어디에 남는가
AI 시대의 해자(moat)는 '무엇을 아느냐'에서 '격차를 얼마나 빨리 닫느냐'로 옮겨가고 있습니다. 프론티어 랩이 전문가의 암묵지를 post-train 데이터로 사들이고 AI가 도메인에 직접 진입하는 지금, 도메인 지식 그 자체도 모델 접근성도 지속가능한 해자가 되기 어렵습니다. 남는 해자는 도메인 전문가가 AI를 흡수하는 속도와 AI 네이티브가 도메인을 따라잡는 속도, 그 둘 중 격차를 먼저 닫는 쪽에 있습니다.
AX의 최대 수혜자는 왜 50대일 수 있는가
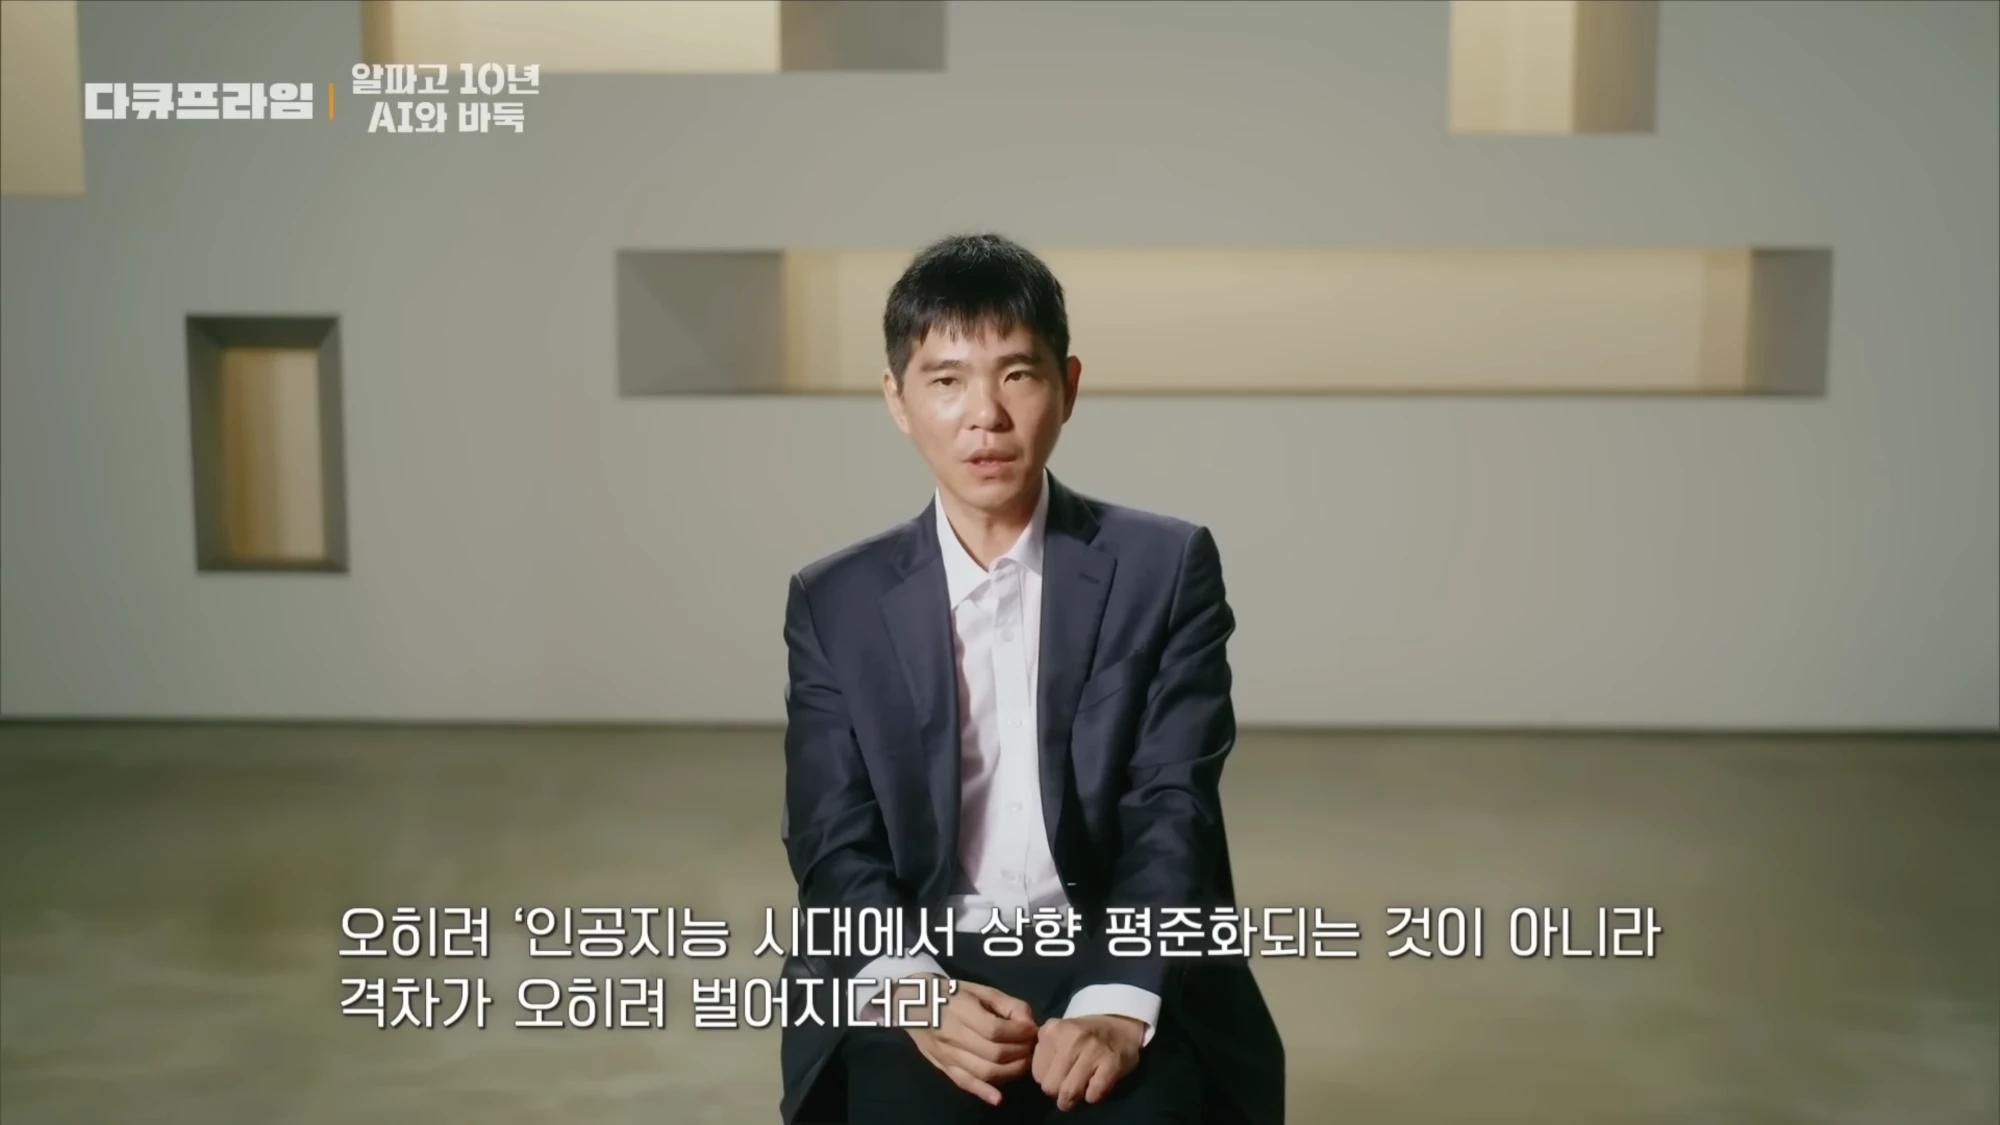
AX(AI 전환)의 최대 수혜자는 AI 도구에 익숙한 20대가 아니라, 업무의 흐름(work flow)을 이미 몸으로 아는 50대일 수 있습니다. AX의 본질은 도구 사용법이 아니라 업무 흐름을 다시 그리는 데 있고, 그 흐름을 아는 사람이 도구를 만날 때 결과물의 격차가 가장 크게 벌어지기 때문입니다. 실제로 AI가 보편화된 바둑계에서도 상향 평준화가 아니라 상위·하위의 격차가 오히려 심화됐습니다.
Advisor Strategy란 무엇이고 opusplan과 어떻게 다른가
Advisor Strategy는 실행을 저비용 모델에 맡기고 판단이 막힐 때만 상위 모델을 온디맨드로 불러 조언을 받는 구조다. 클로드 코드 CLI의 opusplan은 같은 발상을 계획과 실행의 경계에 고정한 축약판으로, 실행 도중 상위 모델이 다시 개입해 검증하는 루프가 없다는 점에서 다르다.
AI 교육 이후, 배운 것을 실제로 남기는 방법은 무엇인가
AI 교육은 업무 레벨에 맞는 단계부터 밟고, 교육이 끝난 뒤 업무와 무관한 사이드 프로젝트를 정기적으로 리뷰하는 자리를 만들 때 실제로 남는다. 레벨을 건너뛴 학습은 강의가 끝나는 순간 증발하고, 리뷰 없는 실습은 우선순위에 밀려 잊히기 때문이다.
골프장 빈자리 알림봇은 왜 혼자서도 만들 수 있는 서비스가 됐는가
골프신(GolfShin)은 국내 골프장 34곳의 예약 페이지를 매시간 확인해 빈자리가 나면 텔레그램으로 알려주는 서비스입니다. 텔레그램 봇(@golfshinbot)에 원하는 골프장·날짜·시간대를 등록해두면 로그인 없이 무료로 알림을 받을 수 있습니다. 신승호가 혼자 만들어 운영하는 사이드 프로젝트로, 예전 같으면 개발팀 하나가 붙어야 했을 자동화를 개인이 감당할 수 있게 된 과정을 보여줍니다.
Claude Tag란 무엇이고, AI는 왜 개인 도구를 넘어 팀 인프라가 되는가
앤트로픽이 공개한 'Claude Tag'는 협업 채널(슬랙, 곧 팀즈)에서 @Claude로 부르면 상주하며 스스로 일하는 에이전트입니다. AI가 내가 열고 묻는 반응형 개인 도구에서 팀 인프라로 옮겨가는 전환을 압축해 보여주며, 그 동력은 더 똑똑한 모델이 아니라 상주·지속 기억·멀티플레이어라는 환경 설계입니다.
스포티파이의 AI 에이전트 활용에서 일반 사무직이 배울 점은 무엇인가
스포티파이가 코드의 73%를 AI로 작성하면서도 품질을 유지한 비결은 검증 자동화·표준화·시간 재배분 세 가지입니다. 이 원칙은 개발이 아니라 보고서, 이메일, 데이터 정리 등 어떤 사무 업무에도 그대로 적용됩니다.
AI 시대 팀은 왜 직무 대신 다섯 가지 원형으로 짜야 하는가
AI가 엔지니어링·기획·디자인·데이터 역할을 하나로 녹이면서, 팀을 가르는 기준은 직무명이 아니라 프로토타이퍼·빌더·스위퍼·그로워·메인테이너라는 다섯 가지 일하는 방식으로 바뀌고 있습니다. 사람은 대부분 2~3개 원형을 겸하고, 제품이 어느 단계냐에 따라 필요한 조합도 달라집니다.
AI 에이전트에게 왜 Skill보다 AGENTS.md가 더 잘 통하는가
AI에게 문서를 꺼낼지 말지 선택하게 만들면 절반은 안 꺼내서 틀립니다. AGENTS.md처럼 프로젝트에 항상 펼쳐두면 선택할 순간 자체가 없어 틀릴 여지도 없습니다. Vercel 실험에서 필요할 때 꺼내 쓰는 Skill은 강하게 지시해도 79점에 그쳤지만, 늘 눈앞에 펼쳐진 AGENTS.md는 100점을 받았습니다. 도구를 똑똑하게 만드는 것보다 틀릴 기회를 없애는 설계가 AX의 승부처입니다.
망분리 폐지는 한국 기업에 무엇을 요구하는가
20년간 유지된 한국의 획일적 망분리가 2026년 5월 국가 사이버 보안 지침 개정으로 폐지됐습니다. 핵심은 규제 완화가 아니라, 그동안 미뤄온 데이터 분류라는 숙제를 더는 피할 수 없게 됐다는 점입니다. 망을 열려면 데이터를 국가안보·민감·공개 세 등급으로 나눠야 하는데, 한국은 이 분류를 제대로 해본 적이 없습니다. 게다가 폐쇄망은 이미 섀도 AI로 깨져 있었습니다. AI 도입을 막는 진짜 병목은 모델도 인프라도 아니라, 우리 데이터가 어떤 데이터인지 아무도 정리해두지 않았다는 데 있습니다.
한국 AI 스타트업은 유럽에서 무엇으로 승부하는가
한국 AI 스타트업이 유럽에서 내세운 무기는 더 똑똑한 모델 성능이 아니라 신뢰입니다. 비바테크 K스타트업 통합관의 여섯 팀은 사내 문서 검색부터 공장 설비 데이터, 3D 디지털 트윈 압축, 향 추천, 피부 진단, 동시통역까지 영역이 모두 달랐지만, 데이터를 외부로 내보내지 않는 온프레미스 구조와 ISO·GDPR 같은 규제 준수, 그리고 이미 확보한 PoC 레퍼런스로 공통의 답을 들고 왔습니다. 화려한 데모가 아니라 현장에서 작동하는 AI가 환상과 임팩트를 가르는 선이었습니다.
AI 에이전트가 차단된 공개 페이지를 읽지 못할 때 무엇이 문제인가
AI 에이전트가 공개 페이지를 읽지 못하는 문제는 대개 콘텐츠가 없어서가 아니라, 기본 fetch가 403이나 봇 차단 신호를 만나면 곧장 포기하기 때문입니다. insane-search는 Claude Code 플러그인으로, 차단을 미리 단정하지 않고 공개 API와 피드, 경량 프로브, TLS 임퍼소네이션, 헤드리스 브라우저 순으로 되는 경로가 나올 때까지 올라갑니다. 단 로그인과 페이월은 넘지 않고 인증이 필요하다고 보고합니다. 공개 콘텐츠를 읽는 도구이지 인증 우회 도구가 아닙니다.
AI 시대, 왜 모든 직원이 메이슨에서 아키텍트로 올라서야 하는가
지금까지 대부분의 직장인은 누군가 그린 도면대로 반복하는 메이슨(벽돌공)이었습니다. AI는 이 구도를 바꿔, 직원이 MCP 도구를 직접 만들고 소상공인이 콘텐츠를 1-click으로 배포하듯 누구나 자기 시스템을 설계하는 아키텍트가 될 수 있게 합니다. 제가 보는 AX의 진짜 목표는 자동화율 몇 퍼센트가 아니라, 조직의 모든 사람이 메이슨에서 아키텍트로 올라서는 것입니다.
제가 만들어 공개한 일상 자동화 도구 다섯 가지는 무엇인가
누구나 자기 일상을 자동화할 수 있도록, 제가 직접 만들어 공개한 도구는 사주 운세부터 성격검사 기반 컨설팅, 공공데이터 통합, 카드뉴스 생성, 연금 시뮬레이션까지 다섯 가지입니다. 거창한 플랫폼이 아니라 필요한 도구를 필요한 만큼만 빠르게 만든 것으로, AX의 끝은 모두가 자기 시스템의 아키텍트가 되는 일이라는 믿음에서 출발했습니다.
코딩 에이전트의 거짓 완료와 사각지대는 어떻게 막는가
코딩 에이전트의 거짓 완료와 사각지대는 합의·검증·교차 리뷰라는 세 단계 하네스로 막습니다. 오픈소스 하네스 oh-my-claudecode(OMC)는 코드를 짜기 전에 합의를 강제하는 ralplan, 별도 리뷰어의 검증을 통과해야 완료를 인정하는 ralph, 한 모델의 맹점을 다른 모델로 메우는 교차 리뷰 ccg를 제공합니다. AI 성과의 차이는 대개 모델이 아니라 이 하네스에서 갈립니다.
AI는 인원을 줄이는 가위인가, 사람을 강하게 만드는 갑옷인가
기업 교육 현장에서 제가 가장 많이 받는 질문은 'AI를 도입하면 사람을 줄이는 거죠?'입니다. 저는 정반대로 봅니다 — AI는 인원을 잘라내는 가위가 아니라 같은 사람을 더 강하게 만드는 갑옷이며, 400명을 무장시킨 조직이 100명으로 줄인 조직을 이깁니다. 줄이기는 한 번의 비용 절감으로 끝나지만, 무장은 복리로 쌓이기 때문입니다.
AX에서 사람과 AI의 역할은 어떻게 나뉘는가
AX에서 사람은 어디를 팔지를 정하고, AI는 그 가설이 진짜인지 데이터로 빠르게 검증합니다. AI의 진짜 가치는 좋은 아이디어를 만드는 것이 아니라, 틀린 가설을 정직하게 죽이는 데 있습니다. 실제로 의료 데이터로 입지 모델을 만들 때, 그럴듯한 포화 가설을 AI가 데이터로 기각했고, 현장을 아는 전문가의 한마디가 진짜 신호의 방향을 가리켰습니다. 둘의 결합이 AX의 본질입니다.
루프 엔지니어링이란 무엇이고 언제 써야 하는가
루프 엔지니어링은 매번 프롬프트를 입력하는 대신, AI가 정해진 간격마다 진행 중인 일감을 스스로 이어받아 처리하도록 루프를 설계하는 일하는 방식입니다. 클로드 코드를 만든 Boris Cherny도 이제 프롬프트를 매번 치지 않고 루프를 걸어 둔다고 밝혔습니다. 핵심은 반복 작업을 루프에 맡기고, 사람은 루프 설계와 모니터링, 그리고 외부로 나가는 동작을 막는 가드레일에 집중하는 것입니다.
인테리어 견적은 왜 비교할 수 없고, 어떻게 비교 가능한 시장으로 바꾸는가
22조 원 규모 인테리어 시장에서 가격 경쟁이 작동하지 않는 이유는 업체마다 실측과 견적 양식이 달라 객관적 비교가 불가능하기 때문입니다. 저는 친한 동료들과 이 정보 비대칭을 표준화와 AI로 풀기로 했고, 핵심은 '실측과 견적의 분리'입니다. 인스펙터가 모바일 LiDAR로 한 번 실측하면 동일한 항목 체계가 만들어지고, 그 위에서 검증된 시공사들이 단가와 마진만으로 경쟁하며 소비자는 한 번의 미팅으로 다섯 견적을 비교합니다.
AX는 왜 교육이 아니라 환경 설계인가
AX는 구성원에게 도구 사용법을 교육하는 일이 아니라, AI로 일하는 환경 자체를 설계하는 일입니다. 매주 쏟아지는 업데이트를 개인이 100% 따라잡으려 하면 지치기만 합니다. 핵심은 "예전엔 못 하던 걸 이제 한다"고 말할 수 있도록 일하는 방식을 바꾸는 것이고, 그 출발점은 반복되는 짜증나는 업무를 찾아 자동화하는 작은 실험입니다.
골프 티 타임 도구를 왜 직접 만들었고, 불편을 느낀 사람이 직접 푸는 시대란 무엇인가
주말 라운드 하나를 잡으려고 십수 개 사이트를 일일이 돌던 불편을, 저는 한국 인기 골프장 34곳의 티 타임을 한 화면에서 비교하는 도구를 직접 만들어 해결했습니다. 메이저 부킹 앱이 다루지 않는 비제휴 인기 클럽만 골라 실시간으로 모았고, 수익화 의도 없이 지금은 저와 지인들이 실제 부킹에 쓰고 있습니다. 핵심은 불편을 느낀 사람이 Vibe Coding으로 그 불편을 직접 풀 수 있는 시대가 왔다는 것입니다.
한 사람이 매달 결제받는 SaaS를 만드는 시대, 무엇이 먼저인가
노트북 한 대와 AI 한 줄이면 한 사람이 매달 결제받는 작은 SaaS를 만들 수 있는 시대가 열렸습니다. 과거에는 만들 수 없던 서비스의 투자 단가가 무너지면서, 아이디어에서 출시까지의 거리가 며칠로 줄었기 때문입니다. 그래서 먼저 필요한 것은 큰 자본이나 큰 팀이 아니라, 일상의 작은 불편을 향한 관찰과 실행입니다.
AI 시대에는 어떤 회사가 살아남을까
살아남는 회사는 AI를 도입한 회사가 아니라 일하는 방식 자체를 100% 다시 짠 회사입니다. 같은 도구를 써도 엔지니어의 90%가 AI를 쓰는 조직과 100%가 쓰는 조직 사이엔 10배 차이가 납니다. 도구는 모두에게 같고, 그 위에 어떤 프로세스를 새로 쌓느냐가 격차를 만듭니다.
AX의 본질은 무엇인가 — 컨설턴트가 떠난 뒤에도 직원의 손으로 진화하는 시스템
제가 동생이 운영하는 무역 회사 Astros에서 검증한 AX의 본질은, 시스템이 사람의 일을 대신하는 구조가 아니라 직원이 LLM에게 자연어로 지시하고 그 결과를 검증하는 구조였습니다. 결과는 회계 업무의 60% 자동화였지만, 더 중요한 변화는 담당자의 일이 단순 입력에서 분석과 의사결정으로 옮겨가고, 컨설턴트가 떠난 뒤에도 시스템이 직원의 손으로 계속 진화했다는 점입니다.
AX의 끝은 왜 시스템이 아니라 사람인가 — SH Consulting을 시작하며
광고와 브랜드 전략에서 출발한 22년의 여정 동안 저는 SaaS를 창업하고 Exit까지 겪었고, 그 길의 끝에서 확인한 결론은 의외로 단순했습니다. AX(AI Transformation)의 끝은 시스템이 아니라 사람이라는 것입니다. 좋은 자동화는 일을 대신해 주고 떠나지만, 좋은 AX는 컨설턴트가 빠진 뒤에도 스스로 도구를 고치고 새 자동화를 발굴하는 사람을 남깁니다.
AX는 누가 만들어야 성공하는가
AX(AI 전환)는 외부 개발자가 아니라 그 업무를 매일 하는 현업의 손에서 만들어질 때 성공합니다. 워크플로에 숨은 예외와 암묵 규칙은 그 일을 매일 하는 사람만 알기 때문입니다. 그래서 AX 교육의 본질은 개발자를 늘리는 것이 아니라, 현업이 바이브 코딩으로 자기 일을 스스로 자동화하게 만드는 것입니다. 재무·경영관리 담당자가 매일의 발주 업무를 직접 자동화한 사례가 이를 보여 줍니다.
일상 자동화는 왜 AX의 가장 좋은 출발점인가
내가 매일 반복하는 작은 일 하나를 통째로 없애 보는 것이 AX(AI 전환)의 가장 좋은 출발점입니다. 효율을 몇 퍼센트 높이는 게 아니라 그 작업 자체를 손에서 떼어 내는 경험을 하면, AI가 무엇을 대신할 수 있고 어디까지 믿고 맡길 수 있는지를 몸으로 알게 되기 때문입니다. 흩어진 카카오톡 일정을 AI가 추려 캘린더에 등록하고 아침마다 한 장으로 브리핑하는 개인 자동화가 그 예입니다.
AI 코딩 생산성을 가르는 것은 모델인가 워크플로인가
AI 코딩의 결과물 품질은 모델 선택보다 워크플로가 더 크게 가릅니다. 진짜 병목은 약한 모델이 아니라 모호한 명세와 끝맺지 못한 작업이기 때문입니다. oh-my-claudecode(OMC)는 Claude Code 위에서 세 가지 습관을 도구로 굳힌 오케스트레이션 레이어입니다. deep-interview가 무엇을 만들지를 명확히 하고, ralplan이 어떻게 만들지를 검증하며, ralph가 끝까지 완성됨을 보장합니다. '무엇을·어떻게·끝까지'를 강제된 파이프라인으로 바꾸는 것이 핵심입니다.
AI 결과물은 왜 마크다운이 아니라 HTML로 받아야 하나
완성된 결과물이라면 마크다운 대신 HTML로 받는 편이 이해 속도를 크게 높입니다. AI가 문서를 만드는 속도가 사람이 읽는 속도를 추월한 지금, 100줄 넘는 마크다운은 사실상 읽히지 않기 때문입니다. Anthropic의 Claude Code 엔지니어도 "HTML이 새로운 마크다운"이라며 산출물을 HTML로 받기 시작했고, 동적 화면이 필요하면 Playground 플러그인이 그 간극을 메웁니다. 기준은 단순합니다. 구조를 봐야 이해되는 완성물은 HTML, 중간 산출물은 텍스트입니다.
고객센터는 비용 부서인가, 신규 사업의 원천인가
고객센터는 비용 부서로만 볼 곳이 아니라 신규 서비스와 사업을 발굴하는 원천이 될 수 있습니다. 매일 들어오는 고객 문의에는 미충족 수요의 단서가 이미 담겨 있고, STT와 LLM 위키로 상담 기록을 자산화하면 이 단서를 체계적으로 캐낼 수 있습니다. 남은 관문은 개인정보 마스킹이며, 이를 풀면 CS는 비용 부서에서 사업 발굴 엔진으로 바뀝니다.
AI는 왜 규칙이 아니라 확률을 내놓는가
지금의 AI는 사람이 작성한 규칙을 실행하는 기계가 아니라, 데이터에서 스스로 찾아낸 패턴으로 "스팸일 확률 93%" 같은 확률을 출력하는 기계입니다. 계좌 이체처럼 조건이 명확한 문제는 규칙 기반 코드가 완벽하게 풀지만, 이미지 인식처럼 예외가 많고 경계가 흐릿한 문제에서는 규칙이 무너지기 때문입니다. 머신러닝과 딥러닝은 규칙 기반 시스템의 이 실패에서 나왔고, 이 구분은 AX 컨설팅에서 업무를 분해하는 첫 번째 기준이 됩니다.
AI 오케스트레이션이란 무엇인가: RAG 챗봇이 멈추는 곳에서 시작되는 제어 흐름 설계
AI 오케스트레이션은 질문을 받아 검색하고 답하는 단선 파이프라인 대신, 막히면 되돌아가는 루프와 상황에 따라 길을 바꾸는 분기를 설계해 AI가 복잡한 실무를 처리하도록 만드는 제어 흐름 설계입니다. 랭체인이 표준 부품을, 랭그래프가 제어 흐름을, 랭스미스가 가시성을 맡습니다. API 한 번이면 끝날 일에는 낭비이고, 루프와 분기가 필요할 만큼 업무가 복잡할 때 꺼내는 도구입니다.
백엔드란 무엇인가: 1993년 방명록에서 시작된 문제 해결의 계보
백엔드는 서버가 요청을 받아 데이터를 처리하고 결과를 돌려주는 영역으로, 1993년 방명록 문제를 풀다가 태어났습니다. 미리 만들어 둔 HTML 파일로는 방금 방문자가 남긴 글을 다음 사람에게 보여 줄 수 없어서, 서버가 요청이 올 때마다 그 자리에서 화면을 새로 조립하기 시작한 것이 출발점입니다. 이후 30년의 발전사도 같은 패턴의 반복이며, 이 계보를 알면 비개발자도 AI에게 백엔드를 구체적으로 지시할 수 있게 됩니다.
바이브 코딩에서 AI는 왜 자꾸 슈퍼베이스를 권할까
바이브 코딩에서 AI가 슈퍼베이스를 자주 권하는 것은, 원래 전혀 다른 계보의 기술이던 데이터베이스와 스토리지가 각자의 한계를 넘어 한 플랫폼으로 합류했고 슈퍼베이스가 바로 그 합류점이기 때문입니다. 이 추천은 취향이 아니라 기술사의 결과이며, 그 계보를 지도로 갖고 있으면 어떤 도구를 왜 쓰는지, AI에게 무엇을 어떻게 지시하는지가 함께 달라집니다.
AI가 코드를 다 짜 주는 시대에 프론트엔드 지식은 왜 필요한가
AI가 코드를 대신 써 주더라도 프론트엔드의 기본 개념을 모르면 AI에게 시킬 수 있는 일의 수준이 거기서 멈추기 때문입니다. React, npm, 빌드, SSR 같은 용어는 암기 대상이 아니라 웹이 문제를 풀 때마다 새 문제가 생기며 이어진 문제 해결의 연쇄이고, 이 진화의 지도가 머릿속에 있어야 AI에게 내리는 지시가 구체적으로 바뀝니다.
LLM은 어떻게 작동하는가 — 비개발자가 코드로 직접 확인해야 할 네 가지
LLM은 대화를 기억하는 존재가 아니라, 매 턴마다 이전 대화 전체를 다시 읽어 다음 토큰을 예측하는 확률 모델입니다. 이 작동 방식은 컨텍스트 윈도우와 비용 증가, 한국어의 토큰 불리, 환각, 그리고 temperature·시스템 프롬프트에 따른 출력 변동으로 드러납니다. 이런 현상은 설명으로 들을 때보다 코드 몇 줄로 직접 재현해 화면에서 확인할 때, 비로소 검증 절차와 히스토리 관리 같은 설계 과제로 이어집니다.
배포란 무엇인가 — localhost는 왜 친구 컴퓨터에서 열리지 않는가
배포란 내 컴퓨터에만 있는 코드를 서버 컴퓨터에 올려 인터넷에 있는 누구나 쓸 수 있게 만드는 과정입니다. 바이브 코딩으로 만든 결과물이 localhost:3000에서만 도는 이유, FTP에서 Git·Docker·CI/CD로 이어진 배포의 진화, Vercel 같은 플랫폼이 대신해 주는 일과 그 대가를 정리했습니다. 이 지도가 머리에 있으면 AI에게 던지는 질문이 달라지고, 그 구체성이 비개발자 바이브 코딩의 실력을 가릅니다.
K Public Data MCP란 무엇인가 — 대한민국 공공데이터를 AI에 연결하는 서버
K Public Data MCP는 법제처 국가법령정보센터, DART 전자공시시스템, 공공데이터포털 등 흩어져 있는 대한민국 공공데이터 API를 MCP(Model Context Protocol) 서버 하나로 통합해, AI 채팅창에서 "민법 750조 보여줘", "삼성전자 재무제표 보여줘", "강남구 약국 찾아줘"가 바로 작동하게 만드는 오픈소스 도구입니다. 커넥터 URL 등록만으로 사용할 수 있어 API 키 발급이나 설치가 필요 없습니다.
하네스 엔지니어링이란 무엇인가
하네스 엔지니어링(Harness Engineering)은 AI 모델 자체를 바꾸는 대신, 모델에 어떤 도구를 쥐여주고 어떤 규칙과 워크플로 안에서 움직이게 할지를 설계해 결과물의 품질을 끌어올리는 작업입니다. 같은 모델이라도 하네스 설계에 따라 성능이 크게 달라지기 때문에, 더 비싼 모델로 갈아타기 전에 먼저 점검해야 할 레이어입니다.
AX 프로젝트는 왜 실패하는가 — 팀을 돕지 말고 업무를 없애라
AX(AI Transformation) 프로젝트가 실패하는 가장 흔한 패턴은 AX 팀이 부서를 돌며 요건을 받아 도구를 만들어 주는 방식입니다. 만들어 줘도 현업이 쓰지 않기 때문입니다. 성공하는 AX의 출발점은 "저 팀을 도와주세요"가 아니라 "저 팀의 단위 업무를 통째로 없애세요"이며, 사람은 자르는 것이 아니라 새 직무로 전환하는 것입니다.
생성형 UI와 MCP 앱 — 에이전트 시대의 인터페이스는 어디로 가는가
에이전트 UI는 정적(미리 만든 컴포넌트에 데이터만 채움), 선언적(에이전트가 JSON 기술서를 쓰면 렌더링 엔진이 디자인 시스템에 매핑), 생성형(모델이 런타임에 HTML·CSS를 즉석 생성)의 세 단계로 진화하고 있습니다. 현재의 균형점은 선언적 방식이며, 생성형으로 가는 관건은 모델의 능력이 아니라 신뢰 — 즉 샌드박스라는 안전한 유통 구조입니다. MCP 앱이 그 배포 채널로 주목받고 있습니다.
AI 네이티브와 AI 어시스티드의 차이 — 우리 회사는 어느 쪽인가
AI 네이티브(AI Native)는 사람의 개입이 거의 없이 워크플로 전체가 AI로 완결되는 구조이고, AI 어시스티드(AI Assisted)는 사람이 하던 일은 그대로 둔 채 AI가 옆에서 일부를 거들어주는 구조입니다. 대부분 기업의 "AI 네이티브 선언"은 실제로는 AI 어시스티드에 머물러 있으며, 이 차이를 구분하지 못하면 AI 도입 후에도 생산성이 제자리에 머뭅니다.
Claude는 어떻게 영상을 '보고' 답할 수 있는가
Claude는 기본적으로 영상을 직접 재생해서 볼 수 없지만, 오픈소스 도구 /watch를 연결하면 유튜브 링크나 화면 녹화 파일 하나만으로 영상을 프레임 단위로 분해하고 자막을 붙여 실제 내용을 파악한 뒤 답하게 만들 수 있습니다. 제목이나 설명글로 추측하는 것이 아니라 화면에 실제로 있었던 장면을 근거로 판단한다는 점이 핵심입니다.