2026 年 9 月第一周发生了什么
一周之内出了四个顶级模型:Anthropic 的 Claude Fable 5.1、Google 的 Gemini 3.8 Flash、Meta 的 Muse Spark 1.3、OpenAI 的 GPT-6 Astra。四家都在自家公告里宣称某项第一。
同一周动的不只是模型。9 月 1 日出现了两个生成画面与空间的模型:Runway 的 Solaris 和 World Labs 的 Atlas。9 月 3 日微软发布语音识别模型 MAI-Transcribe-2,同日英伟达宣布已同意收购 Hugging Face。
这篇文章不是要罗列那一周的发布。各家依据不同的表宣称第一,这个景象本身就是一个事实;对于要选模型的人来说,读懂这个景象比记住某个分数更耐用。
第一,第一名因表而异
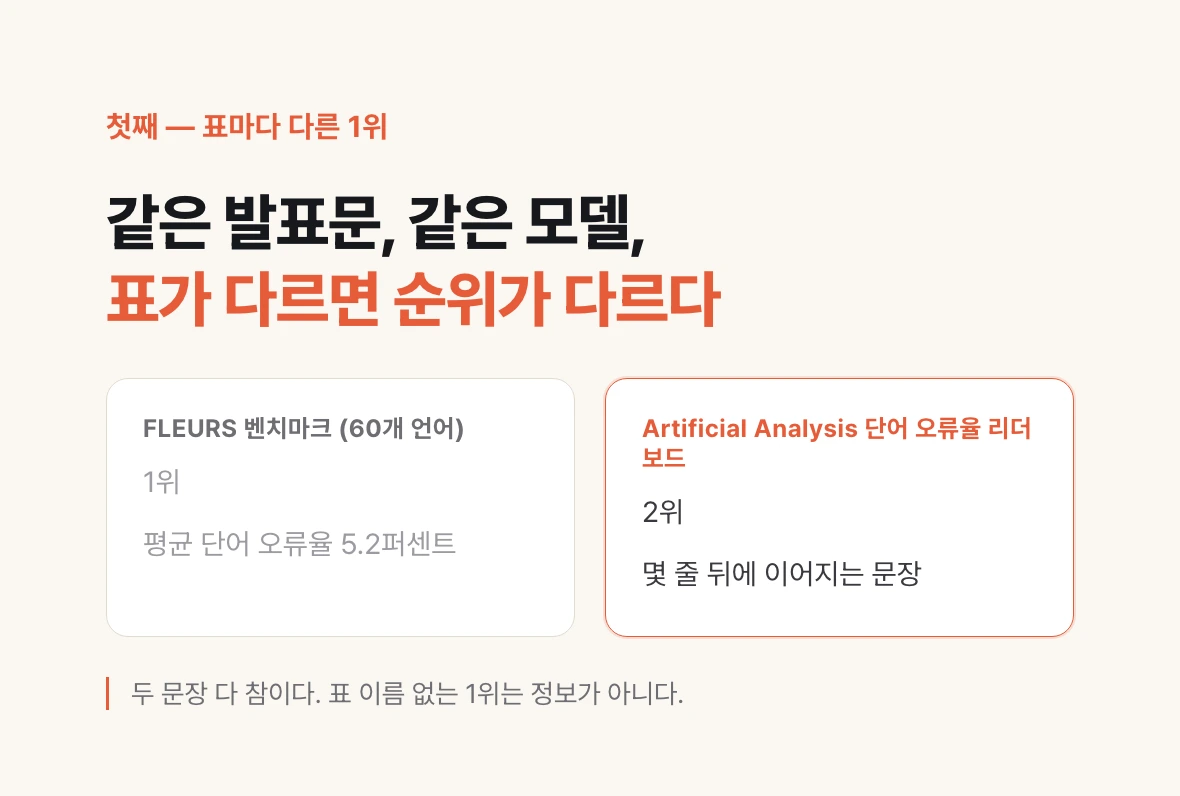
最干净的例证就在微软自己的公告里。MAI-Transcribe-2 公告的标题是全球最快、最准确、最便宜的语音识别模型。正文写道,它在覆盖 60 种语言的 FLEURS 基准上排名第一,平均词错误率 5.2%。
几行之后,同一段又写道,在 Artificial Analysis 的词错误率榜上排名第二。两句都是真的,因为衡量的表不同。哪一句都不是谎言,哪一句也都不是这个模型的全部。
由此可得一个习惯:任何公告说第一时,先看它旁边的表名。没有表名的第一不是信息。
第二,综合排名是权重的函数
Artificial Analysis 这类综合指数会汇集多个基准,给每个加上权重,合成一个分数。这很方便,一张表就能把所有模型排开。
但权重一变,顺序就变。所以综合排名回答的不是哪个模型更聪明,而是在这套权重下哪个模型领先。提高编码权重,编码模型上升;提高推理权重,推理模型上升。
因此综合排名与实际体感不符并不奇怪。那个指数的权重分配与你的业务权重分配不同而已。排行榜没有错,它只是没有回答你的问题。
第三,价格在排行榜之外
性能排行榜通常不按价格排列。然而这一周发布的模型之间,价格的差距远大于性能的差距。
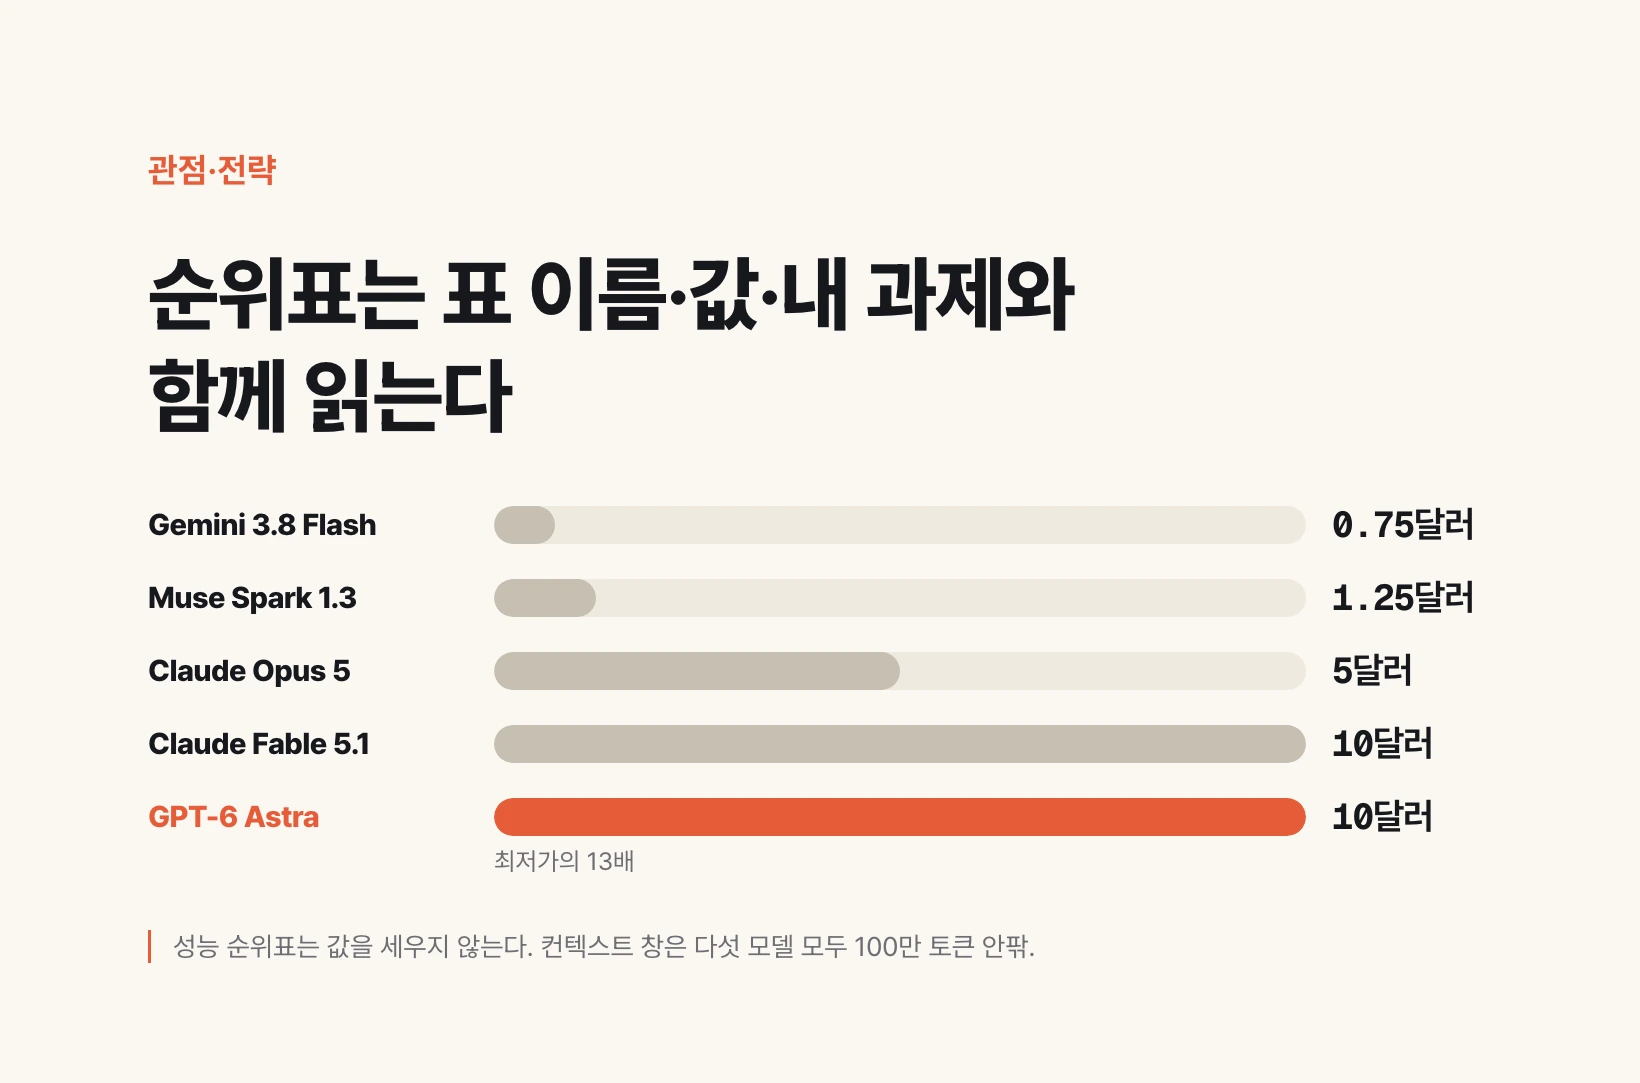
按 2026 年 9 月 7 日 OpenRouter 的公开价格,每百万输入 token 的单价依次是:Gemini 3.8 Flash 0.75 美元、Muse Spark 1.3 1.25 美元、Claude Opus 5 5 美元、Claude Fable 5.1 10 美元、GPT-6 Astra 10 美元。最便宜与最贵的相差超过 13 倍。
输出价差更大,同样顺序为 3.75、4.25、25、50、50 美元。上下文窗口五个模型都在百万 token 上下,这条轴上几乎没有区别。
为了在排行榜上高一格而多付 13 倍是否值得,排行榜不会回答。答案因业务而异。合同初稿审查这类一次失误代价高昂的工作,贵的模型是对的;每天要跑几百份会议纪要摘要,价格就直接决定能否落地。
那该看什么 — 用自己的任务做评测集
与其学会读别人的表,不如做自己的表。不需要复杂工具,一个文档就够。
四个步骤。第一,从真实业务里挑出三到五个任务,连提示词一起写下来。必须是昨天真的做过的事,编出来的例子分不出模型。第二,写通过条件而不是标准答案:必须包含什么才算通过,出现什么就算不合格。第三,新模型发布时,把同样的提示词原样投入,把结果并排放。第四,在结果旁边一并记下价格和耗时。
这个文档积累起来,就能不依赖任何公告的第一名而自行判断。而且这个判断以能向别人说明的形式留存。在组织里提议更换模型时需要的不是基准截图,而是一张写着我们五个任务上结果如此分化的表。
# 我们的任务评测集 (2026-09)

## 任务 1 — 客户通话记录摘要
提示词:把下面的通话记录整理为客户需求 / 我方承诺 / 未决事项三块。<记录>
通过:未决事项不遗漏。不编造承诺。
不合格:编造日期或金额。

| 模型 | 结果 | 价格 | 耗时 |
|---|---|---|---|
| (记录) | | | |

## 任务 2 — 合同风险条款检查
提示词:...
通过:...
不合格:...
这一周真正的新闻不是排行榜,而是地形
9 月 3 日,黄仁勋以本人名义发文宣布,英伟达已同意收购 Hugging Face。金额为 129 亿 3,030 万美元。
用公告自己的数字看 Hugging Face 是什么:超过 1,800 万名开发者、研究者与创作者在此分享超过 300 万个模型、50 万个数据集和 100 万个应用,超过 20 万家企业用这个平台发现、评估、定制和部署 AI。称它为开放模型的 GitHub 并不为过。
公告里有两句被反复强调:在 Hugging Face 上构建或部署并不需要英伟达的算力,以及将继续支持多云与多加速器的开发和部署。在收购公告里把这两句写两遍,本身就说明了顾虑所在。
芯片公司买下开放模型仓库的理由值得一读。Meta、OpenAI、Google 都在转向自研芯片。即便前沿实验室少买英伟达算力,那些想在自己服务器上直接运行开源权重模型的企业和机构仍然要买 GPU。英伟达表示自己是 Hugging Face 上开放模型与数据的最大贡献者,已在那里发布超过 500 个模型和 250 个开放数据集。这次收购是在同一方向上下了更大的注。
生成的对象从文本转向画面与空间
9 月 1 日 Runway 公开的 Solaris 是一个界面世界模型。此前界面要通过代码这一中间表示来实现,因此外观与行为必须事先全部指定。Solaris 跳过这一步,直接根据用户操作逐帧生成画面。
结构分为两部分。语言模型解读用户意图,指定该操作应如何反映到生成的环境中;视觉模型只负责渲染结果。高层推理与画面渲染被分离。论文把这称作迈向软件新范式的一步:界面不再是预定义状态的有限集合,而是围绕用户意图持续生成并适应。
同一天 World Labs 公开的 Atlas 走的是空间一侧。它是从零开始在文本、图像、视频和 3D 上共同预训练的全模态模型,把所有输入合并为一个共享的空间上下文。给它一张到几十张照片,它就能按你指定的相机位置与角度生成新视角,而且相机以几何量而非文字指令作为原生输入。不是往左一点,而是坐标。输出最长一分钟、1440p,照片没拍到的部分由模型接着想象。
Atlas 还能用多张照片把真实场景重建为 3D,输入视频则建模时空,用于机器人的真实到仿真流程。World Labs 声称其表现优于专门做 3D 重建的最新模型。
总结 — 读排行榜的三句话
一,先看第一名后面挂的表名。没有表名的第一不是信息。
二,综合指数是权重的函数。问一句那套权重是否与自己的业务一致。
三,固定自己的三到五个任务,每出新模型就用同样的提示词亲自测,并在结果旁记下价格与耗时。别人的排行榜晃动时,这张表不会晃。