给问题加上数字的那一刻
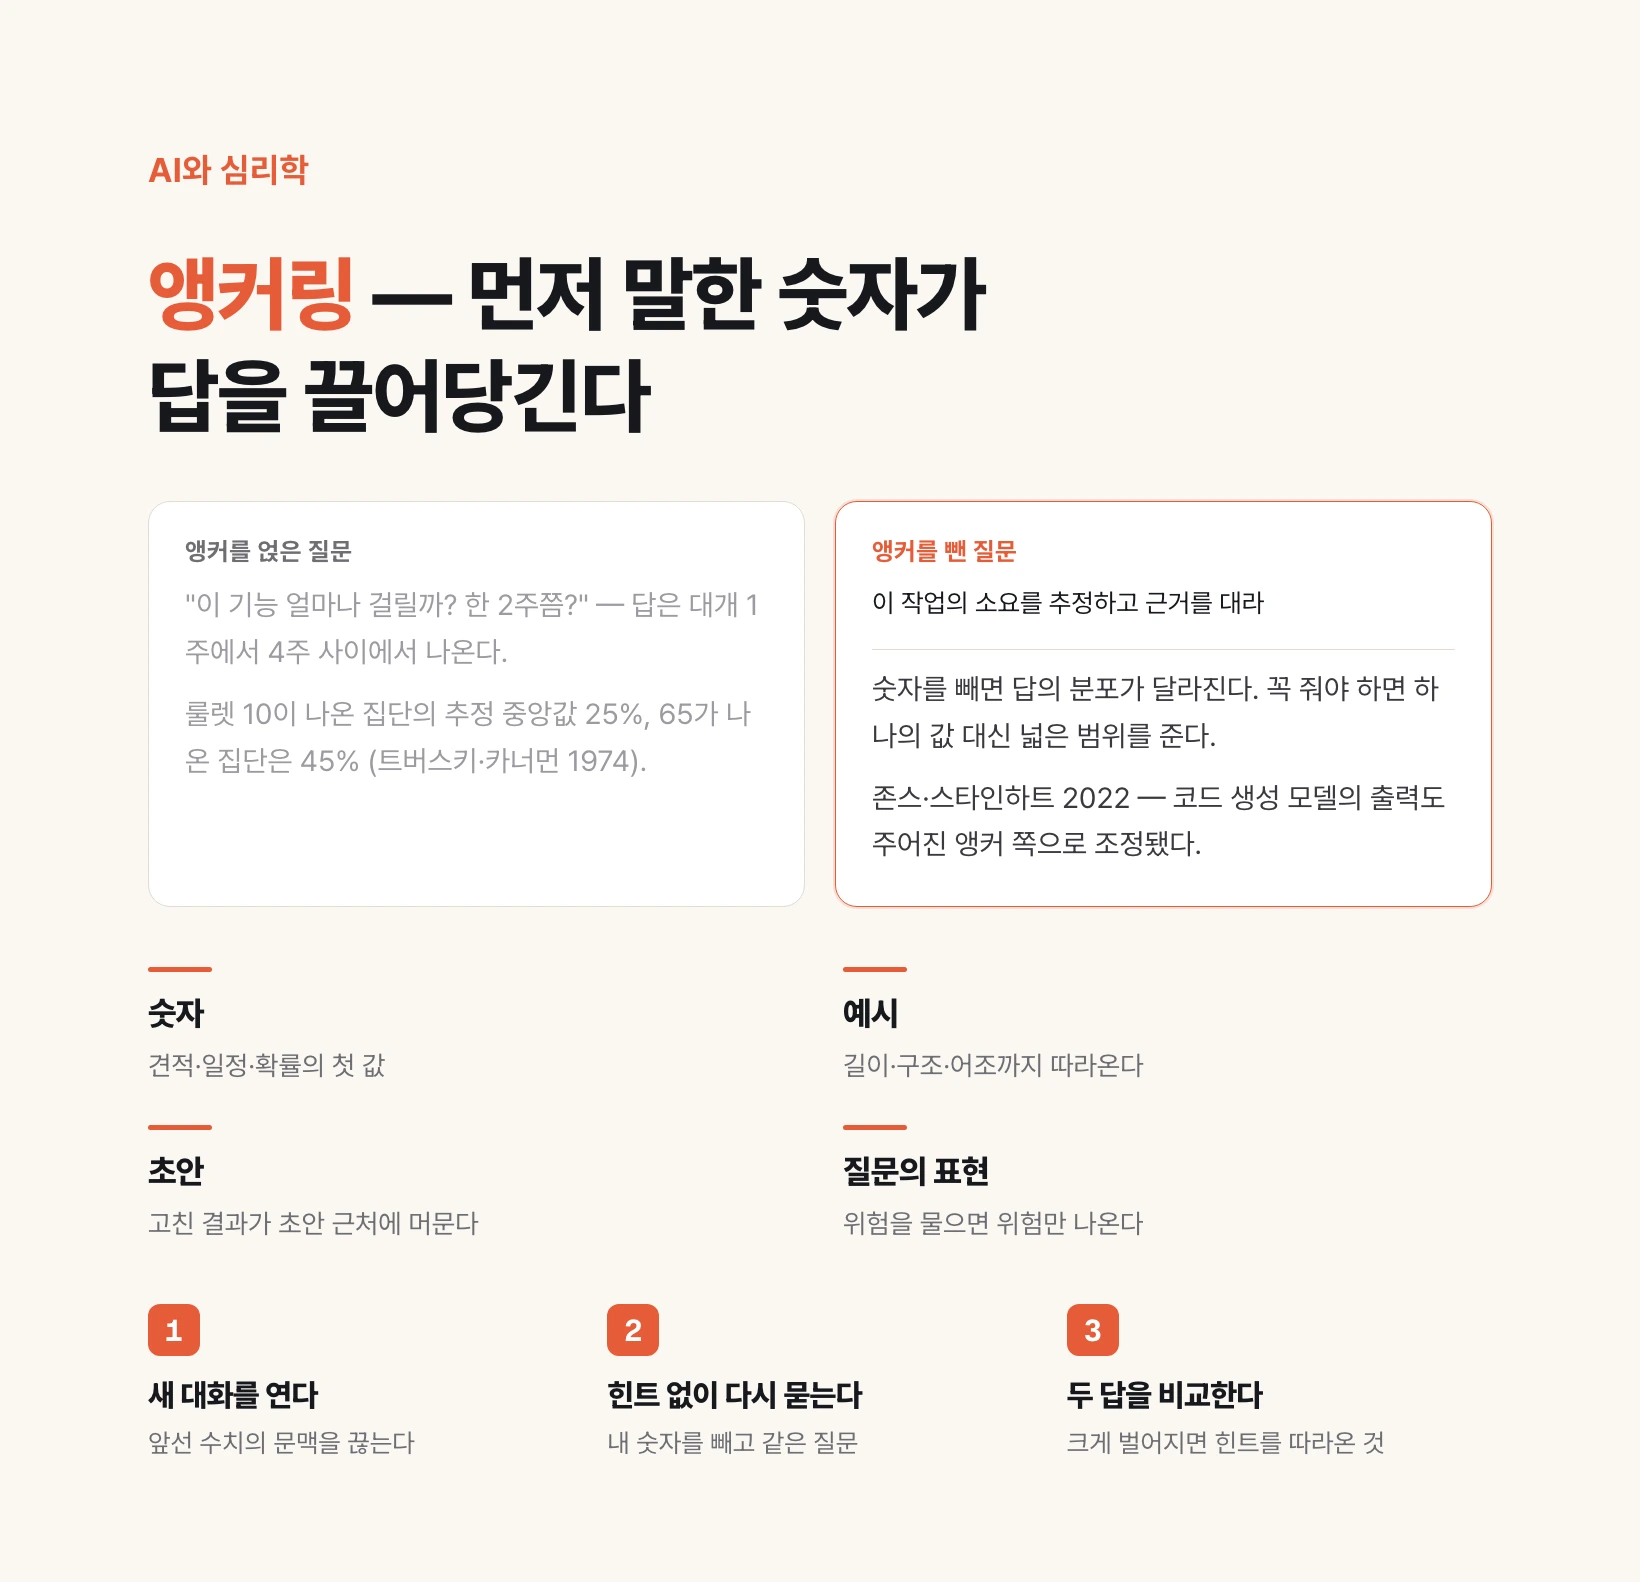
你大概这样问过。这个功能开发要多久?两周左右吧?
答案已经有一半在问题里了。两周这个数字一出来,回答大多落在一周到四周之间。三个月这样的答案很少出现,哪怕实际就是三个月。
问题恰恰出在你的体贴上。为了让对方好把握而加上的那个数字,已经把对方的答案收窄了。
而这不只发生在人身上。我们问AI的时候,几乎总是这样问。
1974年,被做过手脚的转盘
阿莫斯·特沃斯基和丹尼尔·卡尼曼的实验设计,今天看依然大胆。
在参与者面前放一个标着0到100的转盘并转动它。参与者不知道,这个转盘被做了手脚,只会停在10或65。数字出来后问两个问题:联合国成员国中非洲国家的比例,比刚才那个数字高还是低?以及你认为实际是百分之多少?
结果是这样:抽到10的那组,估计值的中位数是百分之二十五;抽到65的那组是百分之四十五。
同一个问题。唯一不同的是转盘停在哪一格。而结果差了二十个百分点。
这个实验特别在哪里
演示锚定的实验很多,这个设计之所以一直被引用是有理由的:参与者亲眼看到那个数字不含任何信息。
他们看着转盘转。他们知道那个数字是偶然出来的,也知道它和非洲毫无关系。没有任何理由把它当证据。可他们还是被拉走了。
而且原论文写到,即使给答得准的人奖励,效果也没有减弱。这不是靠更努力思考就能挣脱的那一类。
所以锚定不是误用信息的案例,而是不属于信息的东西成了判断起点的现象。起点一旦定下,剩下的只是从那里一点点挪。
锚定挺过了可重复性危机
上一期讲过巴特利特的实验隔了六十七年才被重复出来。心理学里有名的结果,重新量过就晃动的并不少。那么锚定呢。
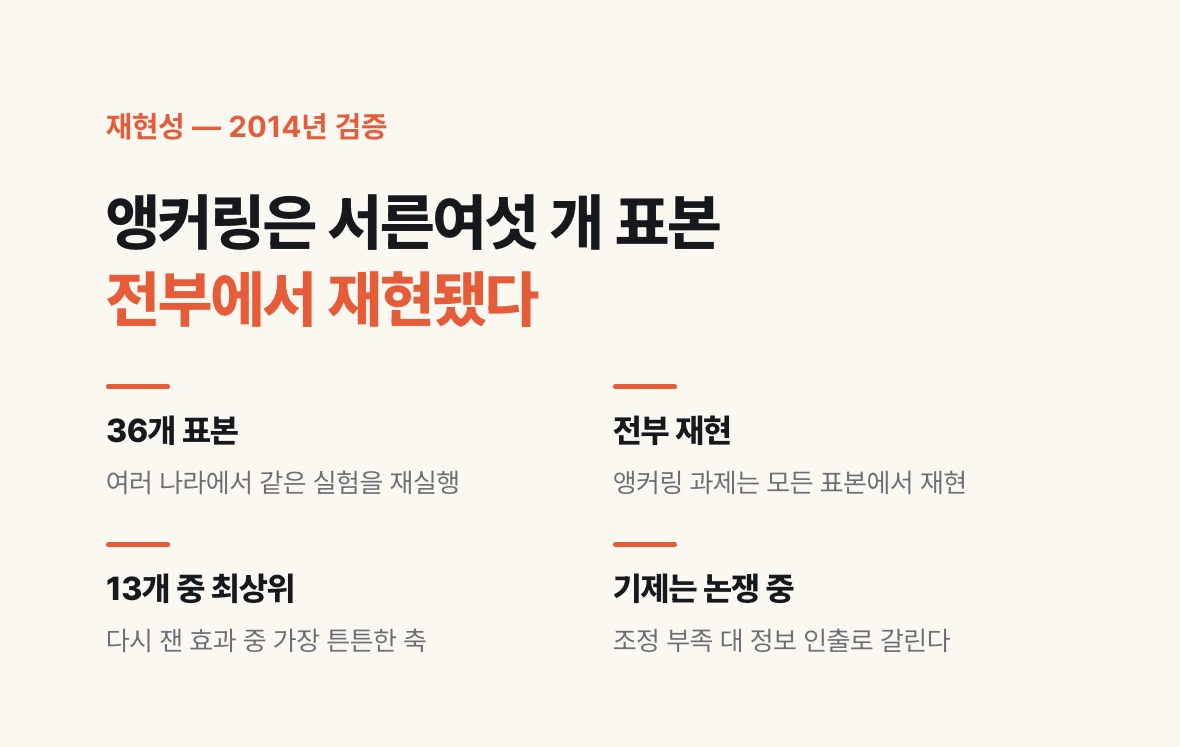
这里情况不同。2014年有一个大型重复项目,在几个国家的三十六个样本里重做了同样的实验,锚定任务在所有样本中都被重复了出来。在重新测量的十三个效应里,它属于最结实的一档。
特意点出这一点,是因为这个系列引用的每个实验标准并不相同。有的只有概念活了下来,有的连数字都活了下来。锚定属于后者。
不过关于它为什么发生,至今仍有争论。一种解释说人从起点挪得不够远,另一种说锚会先在脑中唤起与之相符的信息。现象是确凿的,机制还开着。
2022年,用同样的原理来测AI
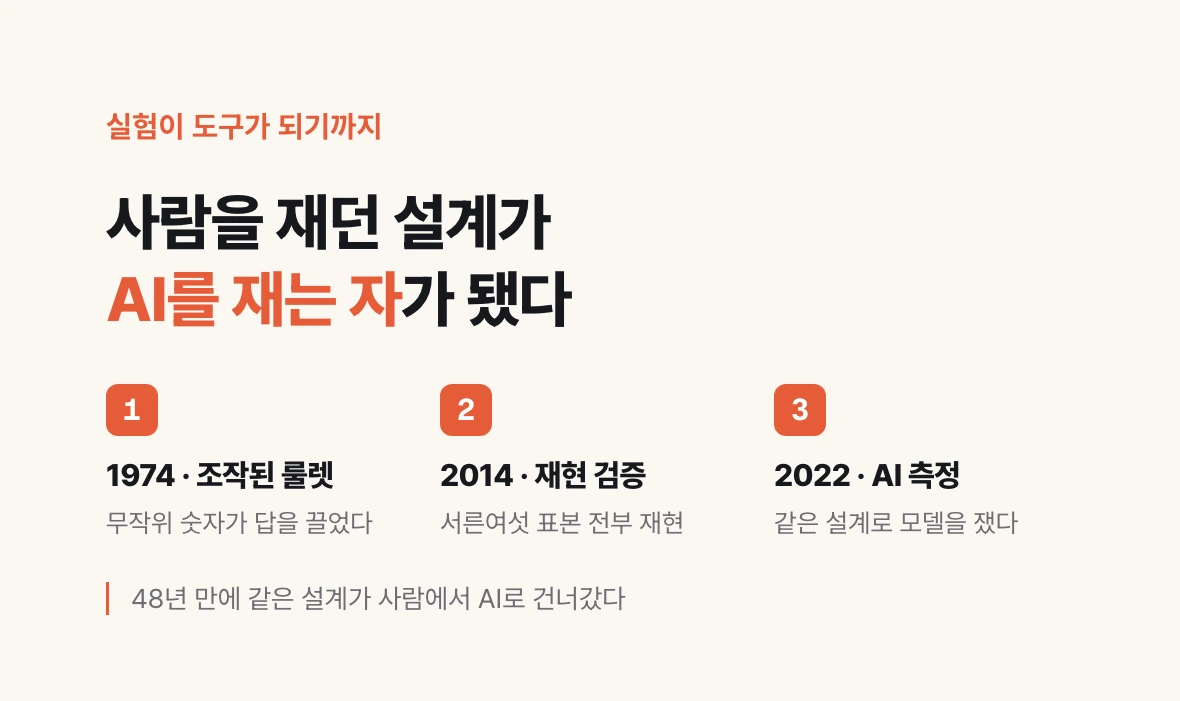
这一期与前几期不同的地方就在这里。锚定不是用来造AI的理论,而是用来测AI的工具。所以它的标签既不是谱系也不是比喻,而是诊断。
2022年埃里克·琼斯和雅各布·斯坦哈特做的正是这件事。他们没有照搬转盘实验,而是把人的认知偏差清单拿来,当作设计模型容易出错的输入的尺子。
这个想法为什么有用。大模型的失败案例很难随机找到。它在大多数输入上都工作良好,你不知道该往哪儿戳。可是人在什么条件下会系统性地出错,已经有几十年份的清单。把那份清单当考卷,找失败的效率远高于随机搜索。
在代码生成模型上测试的结果是:模型会随着输入的表述方式而可预测地出错,输出朝着给定的锚被调整。用论文的话说,这种偏差是稳健的、可测量的、可解释的。
也就是说,心理学的实验设计直接成了AI的评价工具。如今测量奉承、框架效应、心智读取的研究,全都属于这一脉。
为什么会这样——人和AI的原因不同
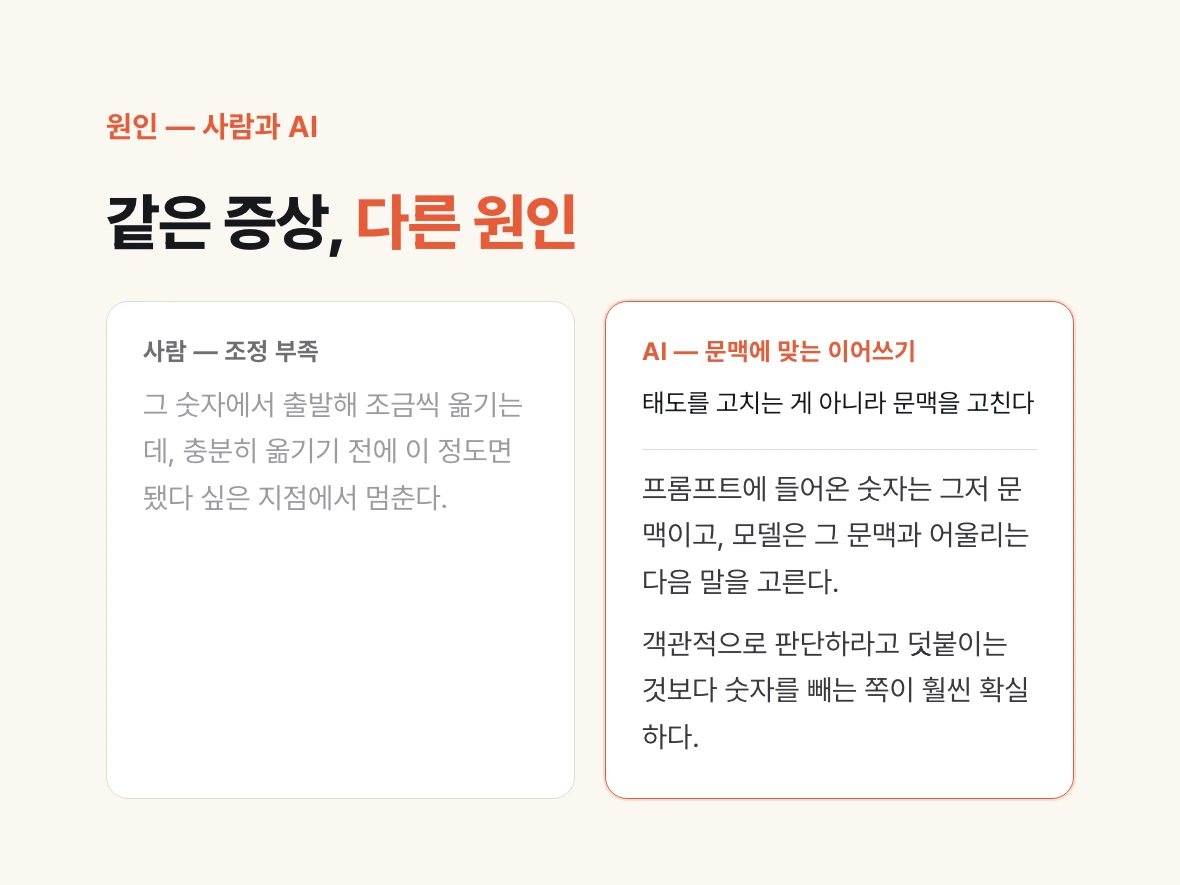
人这边的解释是调整不足。先从那个数字出发,再一点点挪,可是在还没挪够的地方就觉得差不多了而停下。
AI那边是另一回事。进入提示的数字只是上下文,模型挑的是与这个上下文相配的下一个词。在含有两周左右的上下文里,自然接下去的答案不是三个月。这不是有偏的判断,而是合乎上下文的续写。
但结果和人的锚定朝同一个方向。同样的症状,不同的原因。
这个区分在实务上是值钱的。如果原因是上下文,那么应对就不是纠正态度而是修改上下文。把数字拿掉,比在后面加一句请客观判断要可靠得多。
锚不只是数字
把锚定只归到数字名下,实务上就丢了一半。先进来的东西拉住后面的东西,这个结构不挑形式。
示例是典型。说照这个样子写并附上一个例子,结果就会连那个例子的长度、句式、语气一起跟过来。附上的一个例子比你用指令写下的要求作用更强,这很常见。
草稿也是锚。把第一稿交出去请它修改,改出来的东西就停在第一稿附近。要出来完全不同的路子,得把草稿删掉重来。
问题的措辞也是锚。请指出这个方案的风险,出来的是风险清单;请指出它的优点,出来的是优点清单。同一个方案,两个回答给人的印象却相反。琼斯和斯坦哈特测试的偏差清单里就有这个框架效应。
归纳起来,锚就是先进来的一切。数字只是其中最显眼的形态。
只讲一个术语:锚定
锚定是先提出的值成为之后判断的起点,并把结果朝它拉过去。
关键在于那个值不必是依据。转盘上的数字也一样奏效。哪怕你从没承认它是依据,它照样承担起点的角色。
所以锚定的反面不是给出准确的信息,而是先什么都不给。这不是在好锚和坏锚之间选,而是要不要放锚的问题。
实务中锚藏在哪里
最常见的位置是别人给的数字。把收到的报价原样贴上去问这个合不合理,那个金额已经是锚了。回答会聚拢在它为什么合理、还能砍多少的方向上,很少出现一个数量级不同的答案。
先前的对话也是锚。如果在同一个窗口里先前提过某个数值,它会留下来作为上下文起作用。这与第四期讲的工作台是同一块地方。
示例代码和模板也是锚。琼斯和斯坦哈特发现,把相似但不同的函数放进上下文,模型会被拉过去而给出错误的代码。
而最危险的,是自己心里已经拿定主意时抛出的问题。问这个方向没问题吧,锚定就和第五期的奉承叠在同一个方向上。两股力往一边推,回来的不是验证而是批准。
那么明天该改变什么
问估算时,把自己的数字拿掉。不要问是不是两周左右,而要说请估算这项工作的耗时并给出依据。只改了一句话,答案的分布就变了。
非要给数字就给区间。单个值是磁铁,区间的吸力弱一些。一周到三个月之间的哪个位置,胜过两周左右。区间越宽,锚的力量越弱。
重要的数字要在没有锚的情况下再问一遍。开一个新对话,用不带暗示的问题再拿一次。两个答案相差很大,那个估算就不是依据而是跟着你的暗示来的。这等于把第五期的对称检验用在数字上。
别人的报价要抹掉金额再放进去。只给规格和条件让它先估,再拿结果与对方的金额比较。只换了顺序,判断就独立出来了。
示例只留形式,抹掉内容。附参考示例时,只留下你要的结构,把具体的句子和数值拿掉。否则结果就会变成那个示例的变奏。
概括起来就是:想听到答案,就别先把答案说出来。