为什么人看到的画面和爬虫拿到的文档不一样
打开一个网址时,服务器会发回一份 HTML 文档。浏览器收到之后还要继续做事:下载文档附带的 JavaScript 并执行,再把文字和图片填进画面。我们说网站打开了的那一刻,是这些都做完之后。
搜索引擎和 AI 公司派出的程序也打开同一个网址,这类程序叫机器人或爬虫。但爬虫不是浏览器。它的默认动作是拿到服务器发来的 HTML、抽出其中的文字、然后转向下一个网址;执行 JavaScript 是额外需要加上的能力。
所以同一个页面,人和爬虫手里拿到的可能是不同的文档。差别从哪里开始,是下一节的内容。
CSR 和 SSR 有什么不同
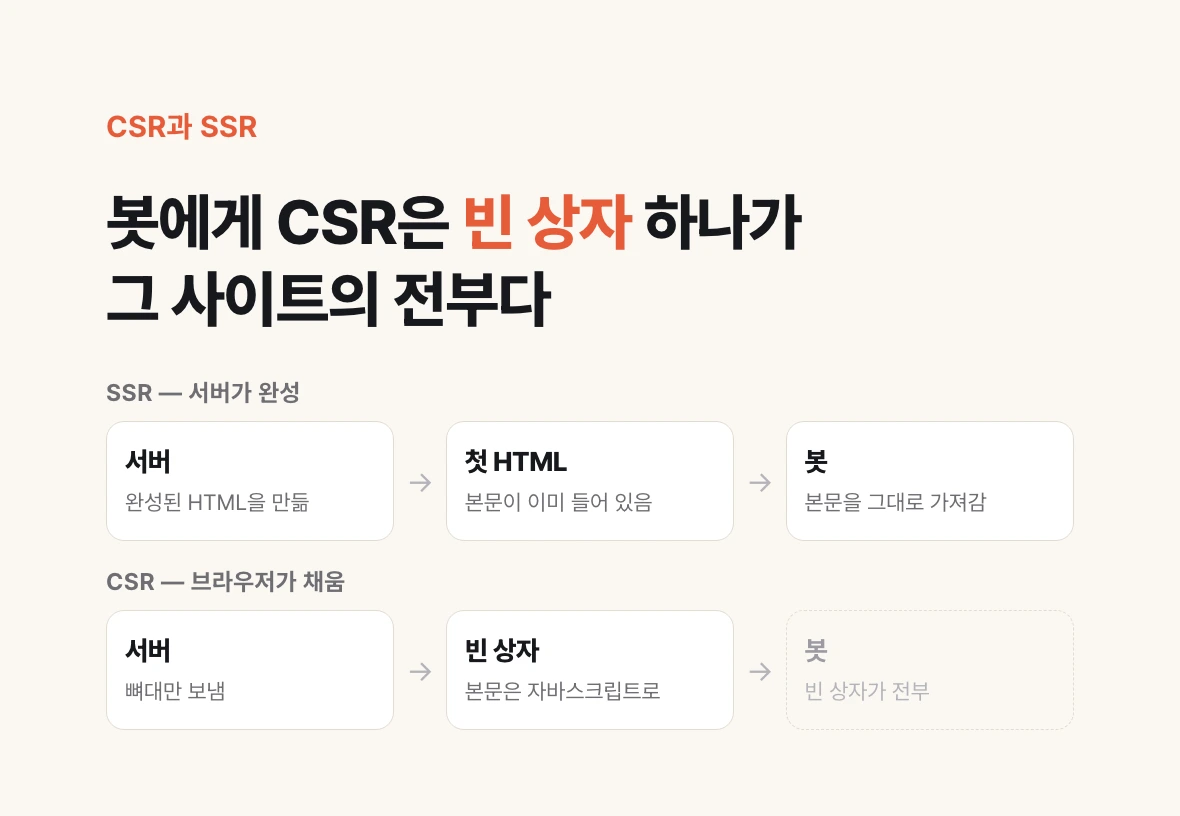
把文字送上画面的方式大致有两种。服务器直接生成完整 HTML 再发出去,叫服务端渲染(SSR);服务器只发骨架、由浏览器执行 JavaScript 填内容,叫客户端渲染(CSR)。这里的客户端指的就是自己的浏览器。
人眼分不出两者,因为画面上的结果一样。对制作方来说,CSR 在不少地方更省事,于是常被选作默认。
但对爬虫来说是完全不同的文档。SSR 的话,服务器发出的第一份 HTML 里已经有正文;CSR 的话,那个位置只有一个空盒子,正文要等 JavaScript 跑起来才出现。爬虫若不执行 JavaScript,那个空盒子就是整个网站。
访谈中主持人把这一点归纳成一句话,嘉宾表示确认:如果是 CSR,GPT 的爬虫进到这个网站也看不到任何信息。人能看到的信息确实存在,只是没有交到爬虫手里。
怎么确认自己的网站属于哪一种
不需要安装工具,也不必去问做网站的人,有 Chrome 就够了。
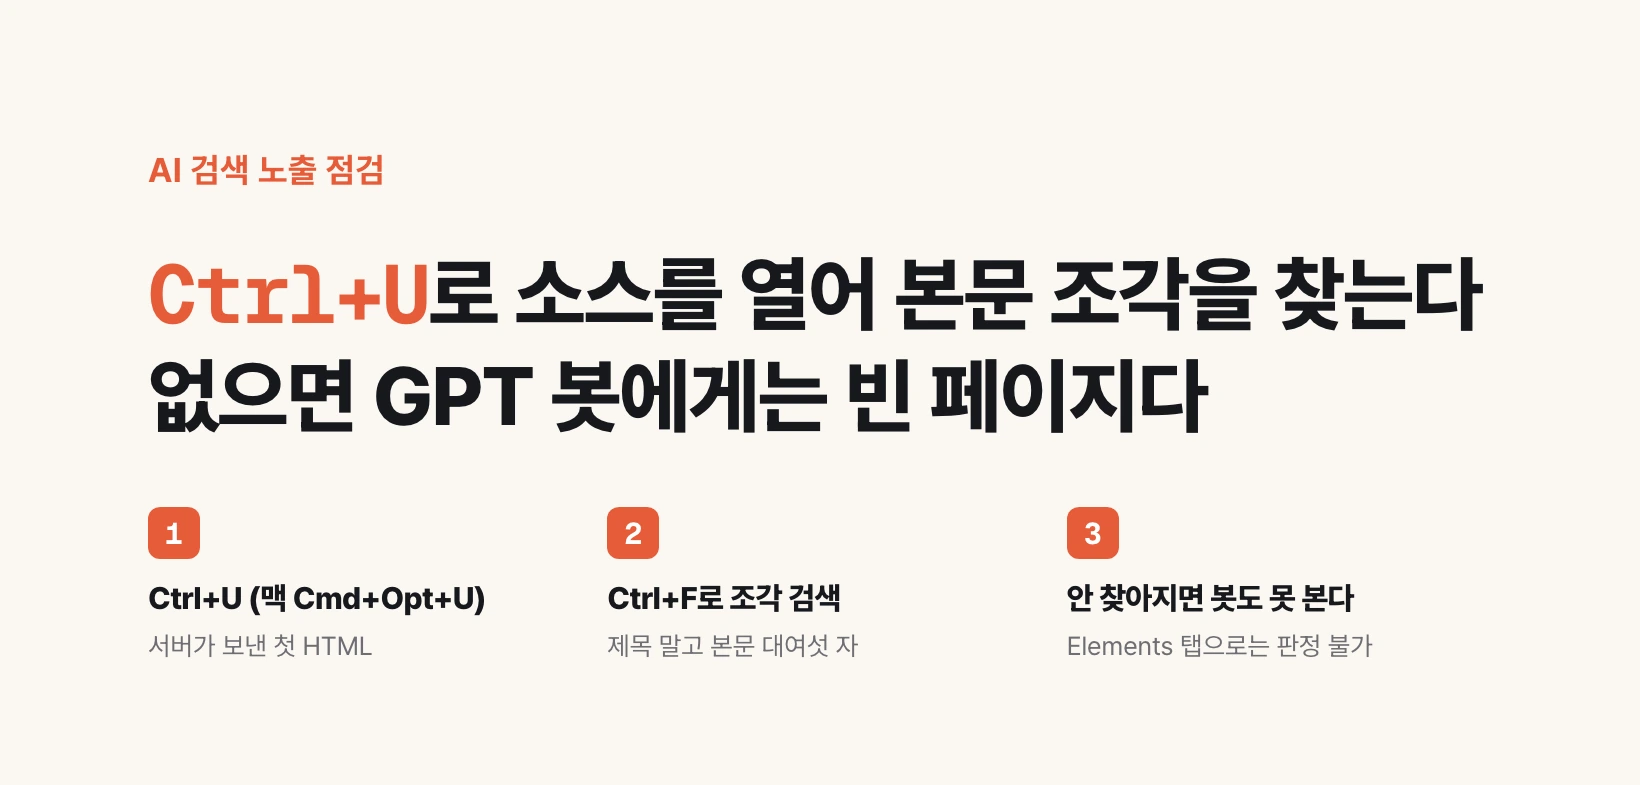
1. 在 Chrome 里打开想确认的页面。公司介绍也好、服务说明也好,挑一个希望 AI 读到的页面。
2. Windows 按 Ctrl+U,Mac 按 Cmd+Option+U。用鼠标的话,在页面空白处右键选择查看网页源代码。在网址前加上 view-source: 打开的也是同一个画面,不过 Chrome 会在粘贴时把这个前缀去掉,只能手动输入。用快捷键更稳妥。
3. 新标签页里会出现密密麻麻的文字和符号,不必费力去读。这就是服务器最先发出的 HTML,也就是爬虫手里文档的全部。
4. 在那个画面按 Ctrl+F(Mac 为 Cmd+F),搜索从原页面正文里截出的五六个字的短片段。不要整句粘贴进去。HTML 会在句子中间插入加粗、链接之类的标签,正文明明发出来了的网站,用整句去搜也常常搜不到。片段要从正文里挑,不要用标题,标题另有位置,会让判断变模糊。
5. 搜得到,说明这段文字是服务器一开始就发出来的,不执行 JavaScript 的爬虫也看得到;搜不到,这句话对那个爬虫就不存在。不放心的话,再从正文别处挑两个片段重复同样的搜索。
结论只在一个方向上是确定的:源代码里没有,不执行 JavaScript 的爬虫就一定看不到。反过来不成立,源代码里有并不等于一定会被引用。如果在 robots.txt 里挡住了那个爬虫,它根本就不会来,那是本文之外的另一条轴。
为什么不能用开发者工具来确认
这里最容易搞错。按 F12 打开的开发者工具,Elements 标签里也显示 HTML。但在那个画面上,正文里的句子永远搜得到,不管是 CSR 还是 SSR。
因为两个画面呈现的是不同时刻。查看网页源代码是服务器发出的原始文档;开发者工具的 Elements 是 JavaScript 全部执行完之后、此刻正在生成画面的状态。爬虫拿到的是前者。
确认一定要用查看网页源代码。在开发者工具里看得到正文,对这个判断不提供任何信息。
爬虫到底执不执行 JavaScript,有人实测过吗
各家公司并没有写进文档。OpenAI 的爬虫页面只列出名称和用途:OAI-SearchBot 用于在 ChatGPT 搜索中呈现网站,GPTBot 用于训练基础模型,ChatGPT-User 用于用户指示下打开页面。这一页没有提到 JavaScript 渲染。
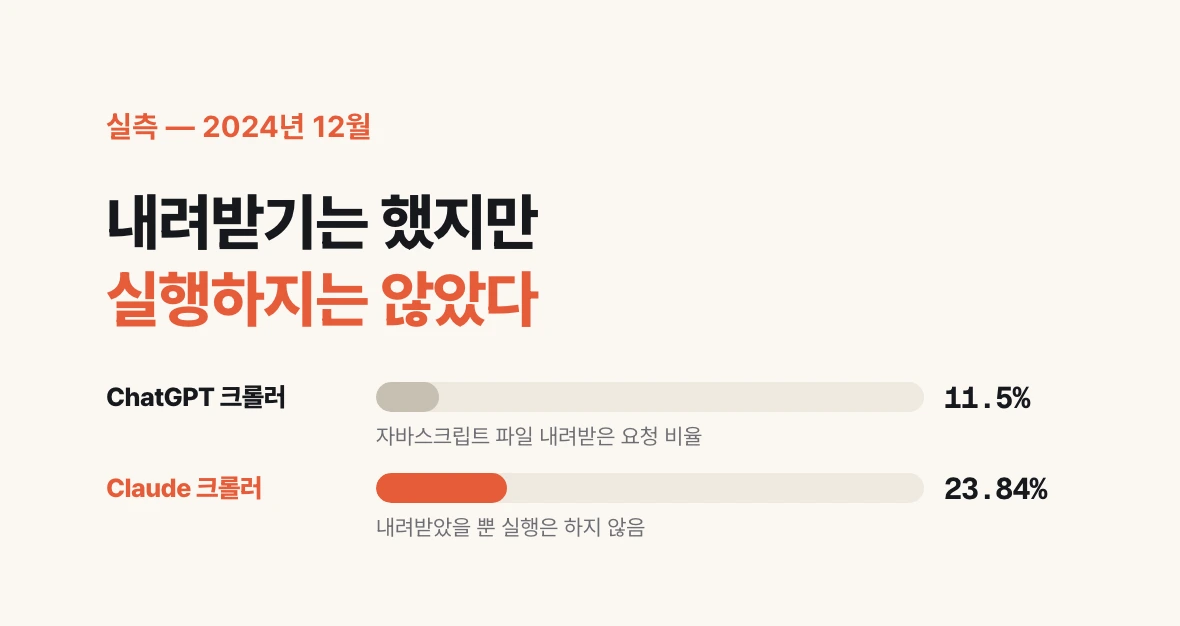
实测来自托管一侧。Vercel 与 Merj 在 2024 年 12 月 17 日发布的 The rise of the AI crawler 汇总了真实爬虫流量,报告称主要 AI 爬虫中没有一家渲染 JavaScript。ChatGPT 爬虫在 11.50% 的请求中下载了 JavaScript 文件,Claude 爬虫为 23.84%,但都没有执行。
谷歌是例外。Googlebot 会执行 JavaScript,Gemini 沿用这套基础设施。所以会出现这样的情况:在谷歌搜索里排得好好的页面,在 ChatGPT 的回答里一次都没出现过。搜索排名正常,并不能作为被 AI 引用的依据。
这些数字是 2024 年 12 月的状况。爬虫行为随时可能被各家改动,与其记住数字,不如把确认方法握在手里。上一节的源代码检查显示的是今天的状态。
源代码里没有正文时,今天能做什么
改渲染结构是正路。如果在用的工具设置里有静态生成或服务端渲染选项,就切过去。不过这通常需要做网站的人或工具本身配合,未必一天能完成。
在那之前,今天就能做的有一件。title 和 meta description 装在服务器发出的第一份 HTML 里,即使是 CSR 通常也保得住。在源代码画面用 Ctrl+F 搜 title 和 description,当场就能看到现在写的是什么。
在这两行里用一句话写清楚我们是什么公司、卖什么。很多站点所有页面都印着同一句话,按页面分开写,爬虫能带走的信息就多出那么多。
信息只存在于图片里的页面也是同样的问题。商品详情或公司介绍如果只是一张图,爬虫拿不走里面的文字。访谈中提到一种做法:只把背景做成图片,内容用文字嵌进去。人眼看着像图片,对爬虫却留下的是文字。
如果是 SSR,就算做完了吗
不是。访谈中指出,同样是 SSR,也有 GPT 拿不到的情况。若把画面的一部分稍后单独发送,信息到达的顺序和时点就会改变。
所以判断依据是实际的源代码画面,而不是结构的名字。不是我们是 SSR 所以没问题,而是此刻这个页面的源代码里有没有这句话。
结果可能逐页不同。首页过得去、服务详情页却不行,是常见的情形。挑出三四个希望 AI 读到的页面,分别确认。
在继续堆内容之前该看的
谈 AI 搜索曝光时,话题通常从再写点什么开始。但如果爬虫根本拿不到正文,再加几篇结果也一样。
顺序是确认在先。看一次源代码,搜一个正文片段,三十秒就知道自己在哪一边。