ARC-AGI-3 测的是什么
多数 AI 测评考的是模型知道什么。解数学题、写代码、答考题。记得牢、整理得好的模型分数高。
ARC-AGI-3 反着来。它把模型丢进从未见过的环境,不给说明书,不告诉它规则是什么、目标是什么、怎样算成功。模型必须自己动手试,观察结果,然后推断出来。
就像小孩拿到一台没见过的游戏机。没有说明书,只有一堆按钮。孩子按下去,看画面变化,猜每个按钮的作用,推测目标是什么。这个测试问的就是 AI 能不能做到这件事。
测试由非营利组织 ARC Prize 制作并评分。他们把它当作 AGI 指标的理由正在于此:它测的不是记忆的调取,而是在没学过的情境里自己造出方法的能力。
从 7.8 到 99.9——如何准确读这个数字
这个测试于 2026 年 3 月公开。起初表现最好的模型只有 0.37%,等于基本没人做得出来。
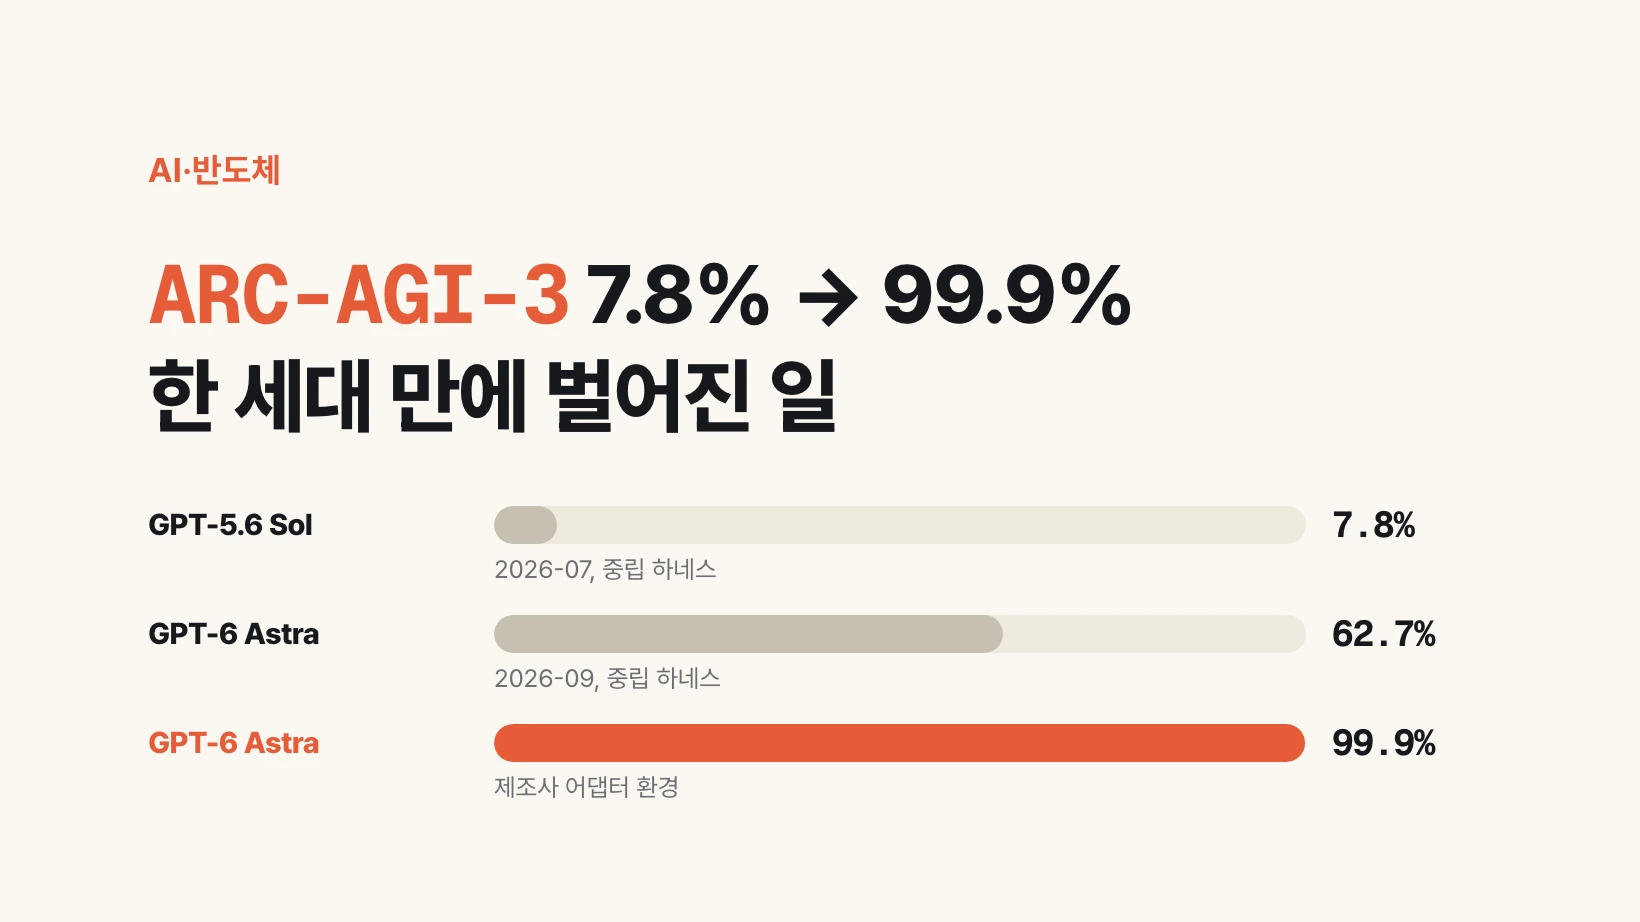
7 月,OpenAI 的 GPT-5.6 Sol 拿到 7.8%,是首个真正通关其中一局的模型。同一口径下 Claude Opus 5 为 30.2%。
然后在 2026 年 9 月 3 日,GPT-6 Astra 拿到 99.9%。搬运这个数字时必须一并写上一个条件:分数有两个,不是一个。
ARC Prize 在两种执行环境下测量。一种是对所有厂商一视同仁的中立环境(Standard harness),另一种是接上厂商自家上下文管理的适配器环境(Provider Adapter harness)。Astra 在中立环境下 62.7%,在厂商适配器环境下 99.9%。同一个模型,相差 37 个百分点。
差距来自适配器会在请求之间保留模型的内部推理状态。对人来说,这相当于思路不被打断地接着想下去,而不是每次从头开始。据 ARC Prize 测量,这让整体耗时快了约 3.66 倍,token 少用了 49%。
所以 99.9% 不是错误的数字,而是带条件的数字。而且即便只看中立口径,也是从 7.8% 到 62.7%,一代之间约八倍。无论怎么量,方向是一致的。
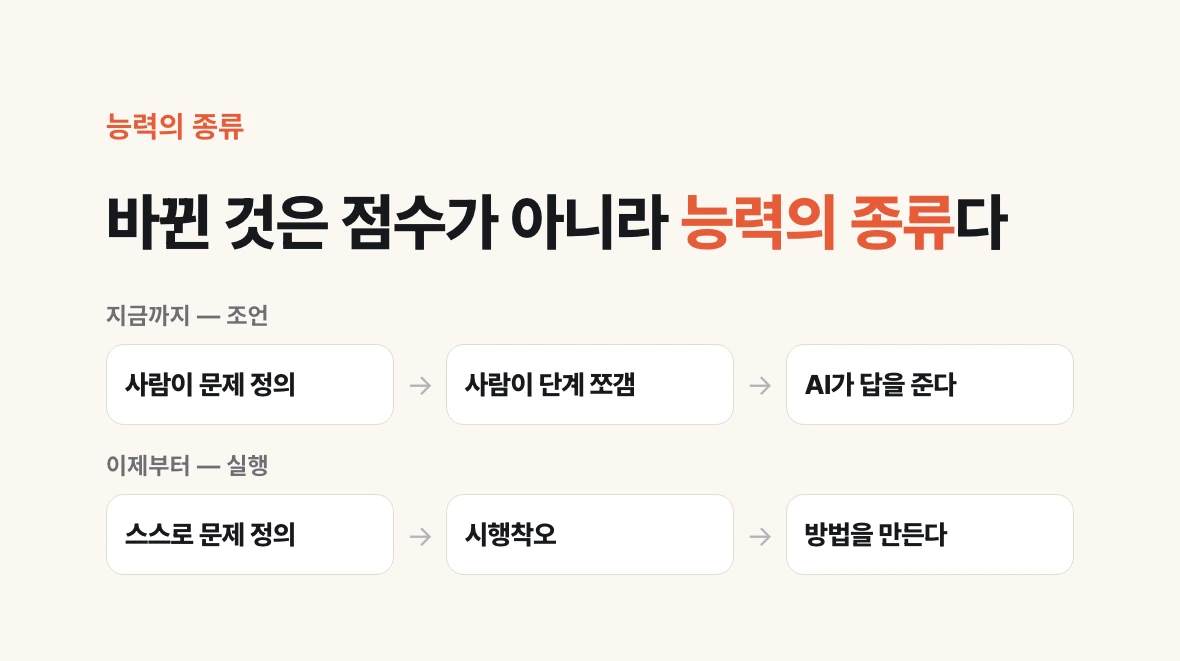
变的是能力的种类,不是分数
比数字更重要的是它现在能做什么。
到目前为止,AI 的用处大体是建议。你问它答,帮你写 Excel 公式,起草邮件,搭出汇报提纲。都做得不错,但都得由人来启动。人定义问题,人拆分步骤,人决定下一步做什么。
ARC-AGI-3 测的是更前面那一步:自己定义问题是什么,经历试错,造出方法。这个分数跃升意味着 AI 已经可以在没有人指示的情况下着手陌生的工作。
ARC Prize 同时公布的观察让这一变化更具体。Astra 在 96.0% 的关卡上用比人类基线更少的动作解决了问题,每关平均动作数比人少 51.7%。它还会自己发明记号来追踪游戏机制;给它一个可执行的工作空间,它会自行造出该游戏专用的工具。
从经济上看,这个差别就是全部。提供建议的 AI 只省下人的时间;自己干活的 AI 则替代了劳动本身。
为什么这会变成存储器的故事
这里转向半导体,连接点是 token。
token 是 AI 处理文本的单位,中文大约一两个字,英文约为一个词的片段。让 AI 做任何事,其成本与算力最终都归结为处理了多少 token。
假设一个人一天向聊天机器人提十个问题。问答加起来不过几千 token。但如果一个智能体接下一件事,连续跑上几个小时,情况就不同了。它打开浏览器、搜索、读结果、觉得不对就换方向、运行程序、失败后读原因再试一次。所有中间步骤全是 token。
再叠加并行。一个人同时跑五个智能体,消耗不是五倍。因为每个智能体本身就在做一个人份的试错,量级会变。
算力上去,需要的不只是 GPU。模型要抓住长上下文、把多个步骤接续下去,这个状态得有地方放,那个地方就是高带宽存储器 HBM。而插满 HBM 的服务器旁边,常规 DRAM 也会跟着增加。智能体一多,存储器需求就上来。
ChatGPT 刚出现时半导体股票被推动的正是这套结构。这次不同之处在于,制造需求的不再是敲字提问的人,而是自己连续工作数小时的 AI。
市场已经这样读了
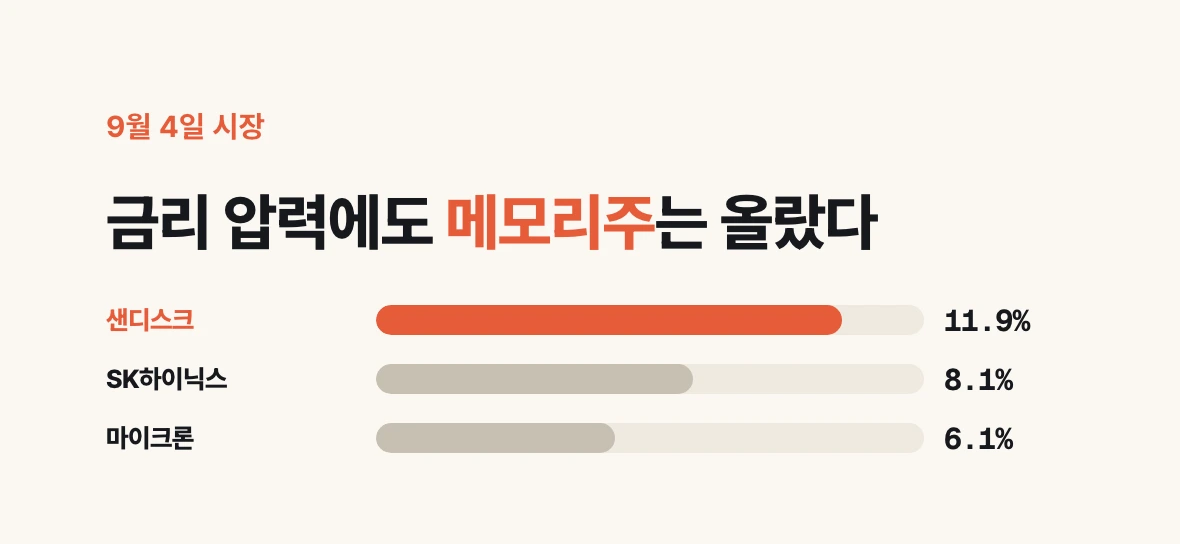
发布次日、2026 年 9 月 4 日的市场表现支持这一解读。
那天有一个对存储股不利的条件:美国就业数据远超预期,加息压力上升,而利率走高会压制股票估值。即便如此,SanDisk 涨 11.9%,SK 海力士涨 8.1%,美光涨 6.1%。
供给端的数字方向一致。Susquehanna 预计本季度 DRAM 合约价将上涨 50% 以上,NAND 约 60%。这是他人的预测,因此只标明主体、记一行为止。
但这篇文章不是叫谁去买什么。一个基准测试决定不了个股的未来。这里能确认的是方向,不是价格。
今天可以试的事
把这个变化当新闻读,和亲手体会一遍,是两回事。今天可以做两件事。
第一,换一种下指令的方式。如果你一直花时间精雕提示词,这次只用一两句话说出你想要的结果,然后交出去。不要替它拆步骤,中途也不要插手。早期用过 Astra 的人反复提到的变化正是这个:说出结果,比设计指令更管用。
第二,看看这一次跑下来用了多少 token。在 ChatGPT 或 Claude 的用量页面可以看到,用 API 的话在控制台里看。拿它和平时一个问题作比较。超级周期论据的根据,就在这两个数字的差里。
还有一点值得带走。这篇文章从不单写 99.9%,总把 62.7% 放在旁边,是有理由的。发布的数字通常都带条件,而确认条件是读懂基准测试的唯一办法。挑选 AI 工具时,同样的习惯照样管用。