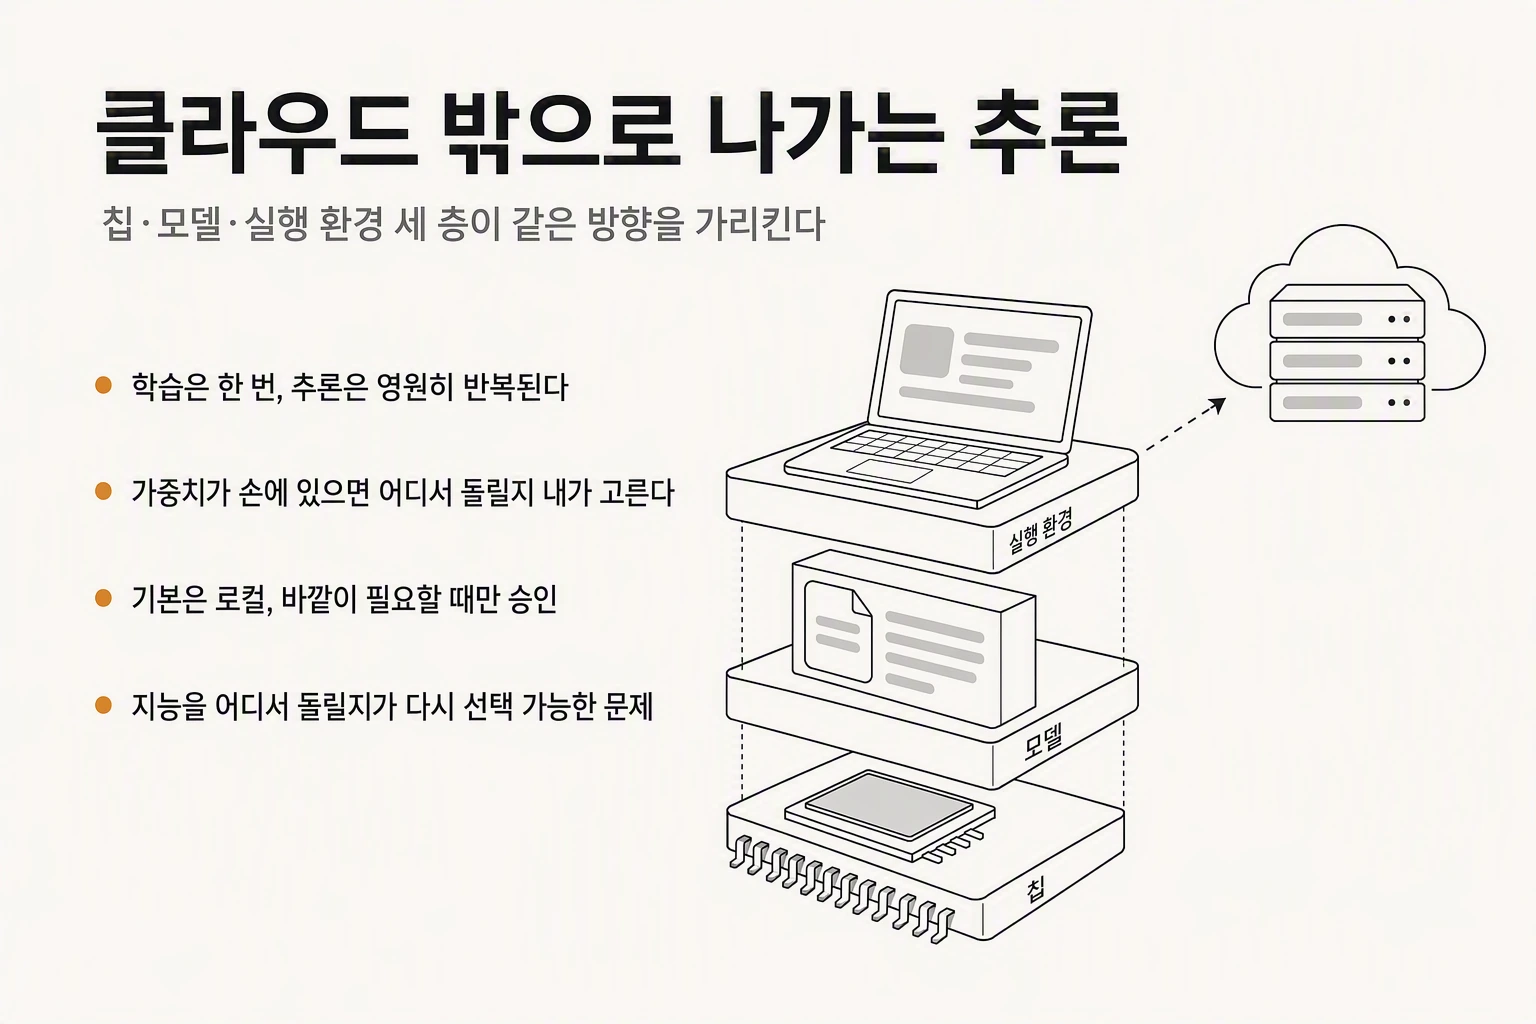
什么是推理,它为什么成了成本问题
使用 AI 模型分为两个阶段。训练是把海量数据灌入模型以生成权重,做一次即可。推理则是我们输入提示、拿到回答的那一刻。
训练只做一次,推理却按用户数乘请求数无限重复。服务运行越久,推理在总成本中的比重越大。智能体让情况更严重:一次请求不再只对应一次推理,系统调用工具、读取结果、再次判断,如此重复数十次,延迟层层累积。
第二个问题叠加其上。通过闭源模型的 API 获取智能,意味着内部文档与代码每次请求都会离开自己的边界。个人使用尚可接受,整个组织都跑智能体时就难以治理。
本周的消息对这两个问题给出了三种不同答案:自己造芯片(成本)、使用权重开放的模型(选择权)、干脆在自己的机器上运行(数据)。
OpenAI Jalapeño:模型公司自己造芯片意味着什么
OpenAI 公布了首款自研推理芯片 Jalapeño 的首批实测结果。顾名思义它只用于推理,不承担训练新模型的任务。
测量在 SemiAnalysis 的公开基准 InferenceX 上进行。值得注意的是测试所用模型:GPT-OSS 120B、DeepSeek R1 670B、Kimi K2.5 1T,都是任何人都能下载运行的开放权重模型。用自家闭源模型测无人可验证,用公开模型测则允许其他公司把同一模型放到不同芯片上对照。
三个模型上,Jalapeño 在峰值吞吐下的每瓦性能比对照商用系统高 1.5 至 1.9 倍,端到端延迟低 1.7 至 3.6 倍。在最大的 Kimi 上约为每瓦性能高 1.5 倍、端到端延迟低 3.4 倍。芯片额定 700 瓦,实测持续功耗保持在 550 瓦及以下。OpenAI 称在其内部前沿模型上优势进一步扩大,这部分外界无法验证。
从设计到流片用了九个月,过程中使用了自家模型。年底开始在自有基础设施中部署,第二代深度开发中,第三代已在成形。
同一篇文章里还有一句同样重要:NVIDIA 及其他合作伙伴的加速器在训练与推理两侧都将继续被广泛部署。这不是替代,而是多了一个选项,而有选项就有议价能力。
什么是开放权重模型,本周发布了什么
开放权重模型公开训练完成的权重文件,任何人都能下载并自行运行。闭源模型只在厂商服务器上运行,我们通过 API 拿结果。差别在于模型能跑在哪里:权重在手,就由自己决定用哪朵云,或者根本不用云。
本周有两个。Z.ai 的 GLM-5.3-Flash 是 GLM-5 系列首个原生多模态模型,以 MIT 许可发布在 Hugging Face 上。官方称其在基准与实际负载上均超过 GLM-5.2,价格为十分之一,并在编码与智能体基准上接近 Claude Opus 4.8。
另一个是 Qwen3.8-Flash-Next,模型卡自称是支撑 Qwen4 的架构的实验性预览,即提前公开下一代结构。
两者共同瞄准的不是性能而是效率:用更少算力换同等智能,这正是能够跑在别人云外的前提。
什么是激活参数:存 3200 亿,只点亮 180 亿
GLM-5.3-Flash 标注为总参数 320B、激活参数 18B。乍看矛盾,理解 MoE(专家混合)结构后就很简单。
模型内含多个专家模块,处理一个 token 时只点亮其中一部分。需要存储的是全部 320B,但每次真正参与计算的只有 18B。因此内存需求像大模型,算力与成本却接近小模型。
Qwen3.8-Flash-Next 把同一思路推得更远:125B 参数中激活 6B,另加 51B 的 n-gram 嵌入与 4B 的 MTP。单独的嵌入轴是有趣之处——它让参数扩展走在一条算力更省、更易卸载的路径上,在显存受限的加速器上更有利。
注意力机制也做了改动。Gated DeltaNet 与 QSA(Qwen 稀疏注意力)配对,不再逐个挑选 token 而是以微块为单位选择,从而降低长上下文延迟。GLM-5.3-Flash 则在 GLM 系列中首次混合稀疏注意力与线性注意力来攻同一个问题。
结构不同,目标一致:把长上下文的成本压下来。智能体注定要处理长上下文,那里正是当下最贵的位置。
智能体下沉到自己的机器:Perplexity Portable Computer
Perplexity 发布的 Portable Computer 是本地优先的智能体。模型、框架、对话与执行轨迹全都留在用户机器上。只有需要外部世界的工作——网页搜索、连接器、向云端更强的顾问模型升级——才会在用户批准后越过边界。
这里的 harness(框架)指包裹模型的外层程序:挂载工具、驱动决定下一步的循环、组装上下文。模型是引擎,框架就是车身。
该公司的主张是本地模型需要为本地设计的框架。通用框架预设一个能吸收长上下文、驾驭宽工具面的前沿模型,而小模型在这些要求下并不可靠。
四条设计原则很具体。其一,节省上下文:端侧模型即便标称 26 万 token 窗口,实测超过 10 万就开始吃力,因此核心框架保持精简,其余能力做成按需加载卸载的技能。其二,把连接器从 MCP 服务器改成紧凑的命令行工具,因为 MCP 的工具定义很长,会大量占用上下文。其三,自我校验虽然增加步骤,却显著缩小与前沿模型的差距。其四,强制沙箱:沙箱不可用时框架直接停用,而不是退化为无沙箱执行。
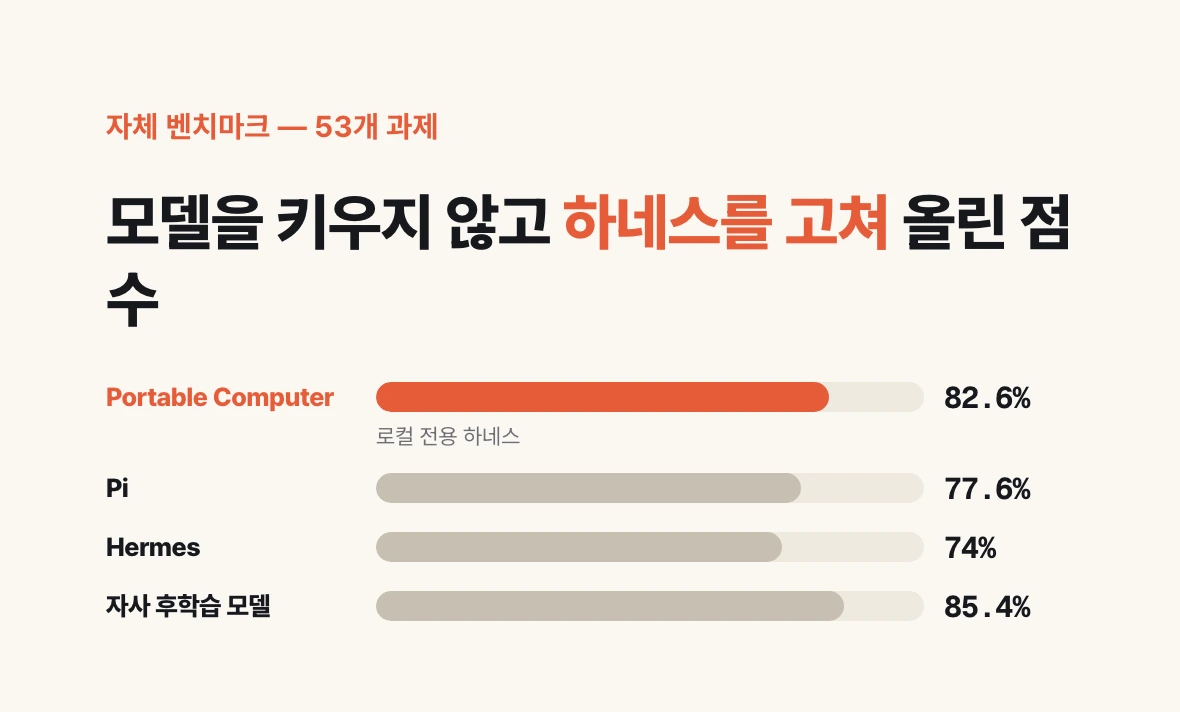
在其自建的 53 项日常知识工作基准上,Qwen 3.8 27B 跑在 NVIDIA DGX Spark 上得分 82.6%,同条件下 Pi 为 77.6%、Hermes 为 74.0%,其后训练模型达到 85.4%。厂商自评基准需谨慎看待,但方向才是重点:分数是靠改框架而非放大模型提上去的。
同一周谷歌发布的:视频控制权、转录准确度、搜索内结账
Gemini Omni 1.1 Flash 是视频模型更新,新增的部分全是控制权:把场景延长至最多 40 秒,指定首帧与尾帧让模型生成之间的转场,附加最多三秒参考视频以维持角色一致性,并把成片升采样到 1080p 或 4K。
实务上更关键的是 360p 草稿:比 720p 最多快 60%、成本为三分之一。先便宜地多试几版,只把选中的一版渲成 4K。这是工作流成本设计,而非画质提升。
Gemini 3.5 Transcribe 按 Artificial Analysis 测量,流式词错率 4.0%、非流式 2.6%,最终转录耗时较上一代 Chirp 3 缩短 70%。比数字更显眼的是处理方式:它会消化「周二见吧,不,周三」这类口头更正,去掉语气词,自动排版。可自动识别并转录 85 种以上语言,对预录音频最多区分三名说话人并附时间戳。
搜索方面,AI 模式新增三项旅行能力:对话中直接设置机票价格追踪,基于 300 多家航司与旅行网站的最新票价,覆盖 180 多个国家;以积分或里程显示机票与酒店价格;酒店预订可通过「在 Google 上继续」选择房型、确认取消政策并用 Google Pay 结账。商户与客服仍由酒店或预订平台承担,先在美国以英语推出。
三者的共同点不是模型跑分,而是产出如何嵌进真实工作流。
资金、机器人,以及离开工位的开发环境
Stability AI 于 8 月 25 日宣布完成 7600 万美元 B 轮融资,累计融资达 2.32 亿美元。投资人名单才是重点:索尼音乐集团、环球音乐集团、华纳音乐集团一同进入,游戏方面有 Electronic Arts,此外还有 AMD Ventures 与 Pacific Alliance Ventures。音乐产业并非只用诉讼应对生成式 AI,也在用股权进场。
机器人方面,Skild AI 发布了基础模型 S1,条件是四句话:未见过的任务、十分钟长任务、一个视频提示、无需后训练。其判断很明确:机器人学习一直停留在 BERT 时代——要稳健地学会一项新任务,仍需在部署条件下采集数十到数百小时数据并微调专用策略。语言模型跨过那一步靠的是上下文学习,S1 试图在机器人上完成同样的转变。
开发环境也在移动。谷歌 Antigravity 2.0 加入了远程控制:用任意网页浏览器连上分布在笔记本、服务器与台式机上的 Antigravity 会话并直接操控,保留对文件、工作区、构建工具与凭据的访问。除在桌面应用中启用外,还有无头守护进程的安装路径,只需一次登录。
文档给出的理由与前文相连:当智能体承担整子系统重构、大规模测试运行这类任务时,运行时间长到人无法一直守在前面。
这一周可以实际动手做什么
第一,亲手跑一次开放权重模型。打开 zai-org/GLM-5.3-Flash 或 Qwen/Qwen3.8-Flash-Next 的模型卡,读一读许可与运行要求,就已经很有收获。两者对多数个人电脑仍然偏大,按小时租用云 GPU 是现实的第一步。
第二,算清当前工具的开销来自哪里。用推理的视角看一个月的 API 账单,往往会发现制造账单的是智能体的循环次数,而不是请求数。
第三,如果有处理内部文档的工作,评估这一项能否单独迁到本地模型。不必全部搬走。Perplexity 设计的要点是默认本地、必要时经批准短暂外出。
第四,养成节省上下文的习惯:只保留真正常用的 MCP 服务器,其余做成按需加载的技能。这对前沿模型同样有效。
总的来看,本周芯片、模型与运行环境指向同一个方向:智能在哪里运行,重新成为一个可以选择的问题。