写得好的谎言和写得好的事实外表相同
我们把一张配药袋交给模型,让它生成用药说明。输出的句子总是看起来很可信。问题恰恰在这里:可信本身不能作为判定标准。
以「一日三次,饭后三十分钟」为例。语法无可挑剔,读起来就像真正的用药说明。但那张药袋上是否真的写了三十分钟,这句话本身并不包含。可能是模型从原文读到的,也可能是从同类药物的常识里带出来的。两者产生的句子完全一样。
这确定了我们的起点。人工阅读输出来做审核,在原理上无法区分这两者。审核者再仔细,也无法从句子中取出句子里没有的信息。
我们把检查转向输入侧
于是我们把方向反了过来。不再阅读生成文本去寻找异常,而是追问它的每一个片段来自原文的哪里。手里握有原件,是这个问题唯一真正的杠杆。
数字只有出现在输入原文中才通过。剂量、次数、时间、天数都受此约束。原文中没有的数字,无论在医学上正确与否都会被拒绝——因为判断这种正确性并不在我们的位置上。
年龄安全提示绑得更紧。「12岁以下儿童请勿服用」这类语句必须与原文完全一致,不允许部分匹配或语义等价的改写。这类文句改动一个词就会改变覆盖范围,而这种变化靠阅读很难看出来。
关于合用药物的注意事项,每一条都必须带上自己的依据,没有依据的条目不予保存。原始材料中不存在的相互作用,句子读起来再正确也要丢弃。
一旦强制规定条数,模型就会编造
收获最大的一课来自事故而非设计。最初为了固定输出形态,我们规定了固定条数——四条注意事项。版面因此整齐,校验代码也简单,看起来是自然的选择。
但如果来的药袋只支撑三条呢。模型没有写完三条就停下,而是造出了第四条。
它并没有违背指令。我们要求四条,它就给了四条。留出空位并要求填满,被填满是理所当然的。我们称之为幻觉的相当一部分,并非模型的缺陷,而是我们制造的空位带来的结果。
现在的范围是零到四条,材料不足就留空。版面稍微不那么整齐了,编造的句子却消失了。在把数字写进提示词之前,应先问:材料不够时这个位置会被什么填满。
验证用的模型只观察,不拦截
我们也接入了另一个模型来检查生成结果,但刻意没有给它拦截的权限。它发现问题只做记录,真正阻止保存的是基于规则的检查。
这不是不信任它的判断,而是分工。站在拦截位置上的东西必须可复现、可解释——你要能准确回溯某段文本为何被拒,而模型判断在相同输入上也会摇摆。
取而代之,验证器被放在展示规则遗漏之处的位置。当某类问题通过了全部规则却被验证器反复标记,它就成为下一条规则的候选。是否把观察升格为拦截,依据这些数据来定。
为什么以配药为单位而不是以单粒药为单位
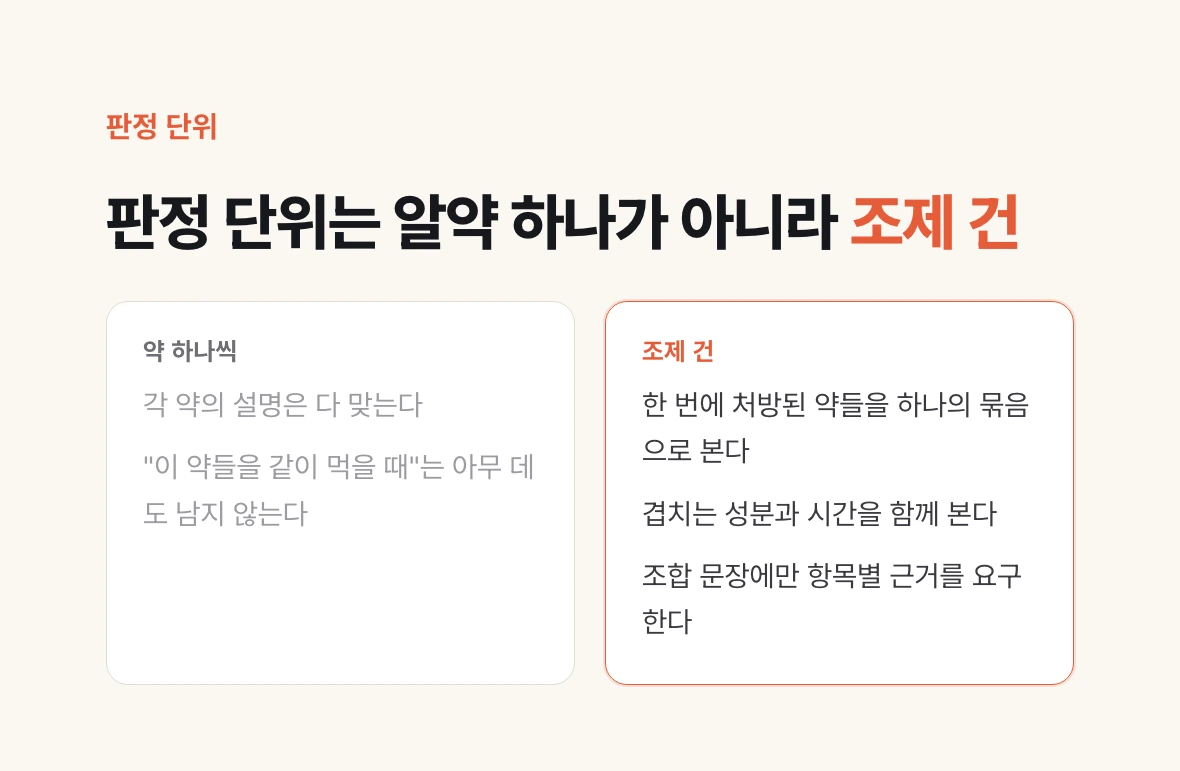
构建用药说明的常见做法是每种药一段说明。数据本来就是这个形状,做起来也更容易。
但逐粒解释的结果是,「这些药一起吃会怎样」无处安放。每一段单独描述都准确,唯独关于组合的内容整块缺失。而拿到药袋的人真正想知道的正是这一点。
所以我们把判定单位定在配药这一次事件上。一次开出的所有药视为一个整体,从而能一并看到重叠的成分与时间。
这个选择又回接到验证设计上。关于组合的句子比单药描述更容易被编造——仅凭常识就能拼出看似合理的相互作用。因此我们为组合类语句单独设置了逐条依据的要求。