这里说的工具是什么
先解释术语。在 AI 智能体里,工具指的是替模型完成它自己做不到的事的外部能力——搜索网页、读取文件、查询数据库、发送邮件等等。
如今挂载这些工具的标准方式是 MCP(Model Context Protocol)。在配置文件里加几行服务器配置,工具就多了,挂载的成本几乎为零。于是它们不断累积。
但挂工具并不只是把列表变长。每个挂上的工具,其名称、说明和参数规格每次都会被模型读入。二十个工具,就等于每次对话一开始就摊开了二十本说明书。
而且模型每次都得从那份列表里选一个。可选的多了,选择就会摇摆——和人是一样的。
基准线 —— 四五个,或者一两个
这个数字在演讲里出现过两次,而且不一样。幻灯片写的基准线是四到五个工具,讲者口头说的是一两个。
无论取哪个,方向都一致:越过那条线,推理质量下降,工具选择变得不稳定。这里的「不稳定」不是指报错,而是指对同一个请求每次选不同的工具、或者选错工具的情况变多。
不必把数字背下来。换成实务里能用的形式就是:「这个智能体在这次对话里真正会用到的工具,是不是只剩这些?」如果有一半从来没被用过,那就已经越线了。
木匠的比喻 —— 为什么拆开更划算
演讲里的比喻很准确。你叫了个木匠到家里,他带着水管工具、木工工具和电工工具出现,宣称自己什么都能做。
你多半不想要这个人。你想要的是一个像样的木匠。什么都能做,不等于把某一件事做得特别好。
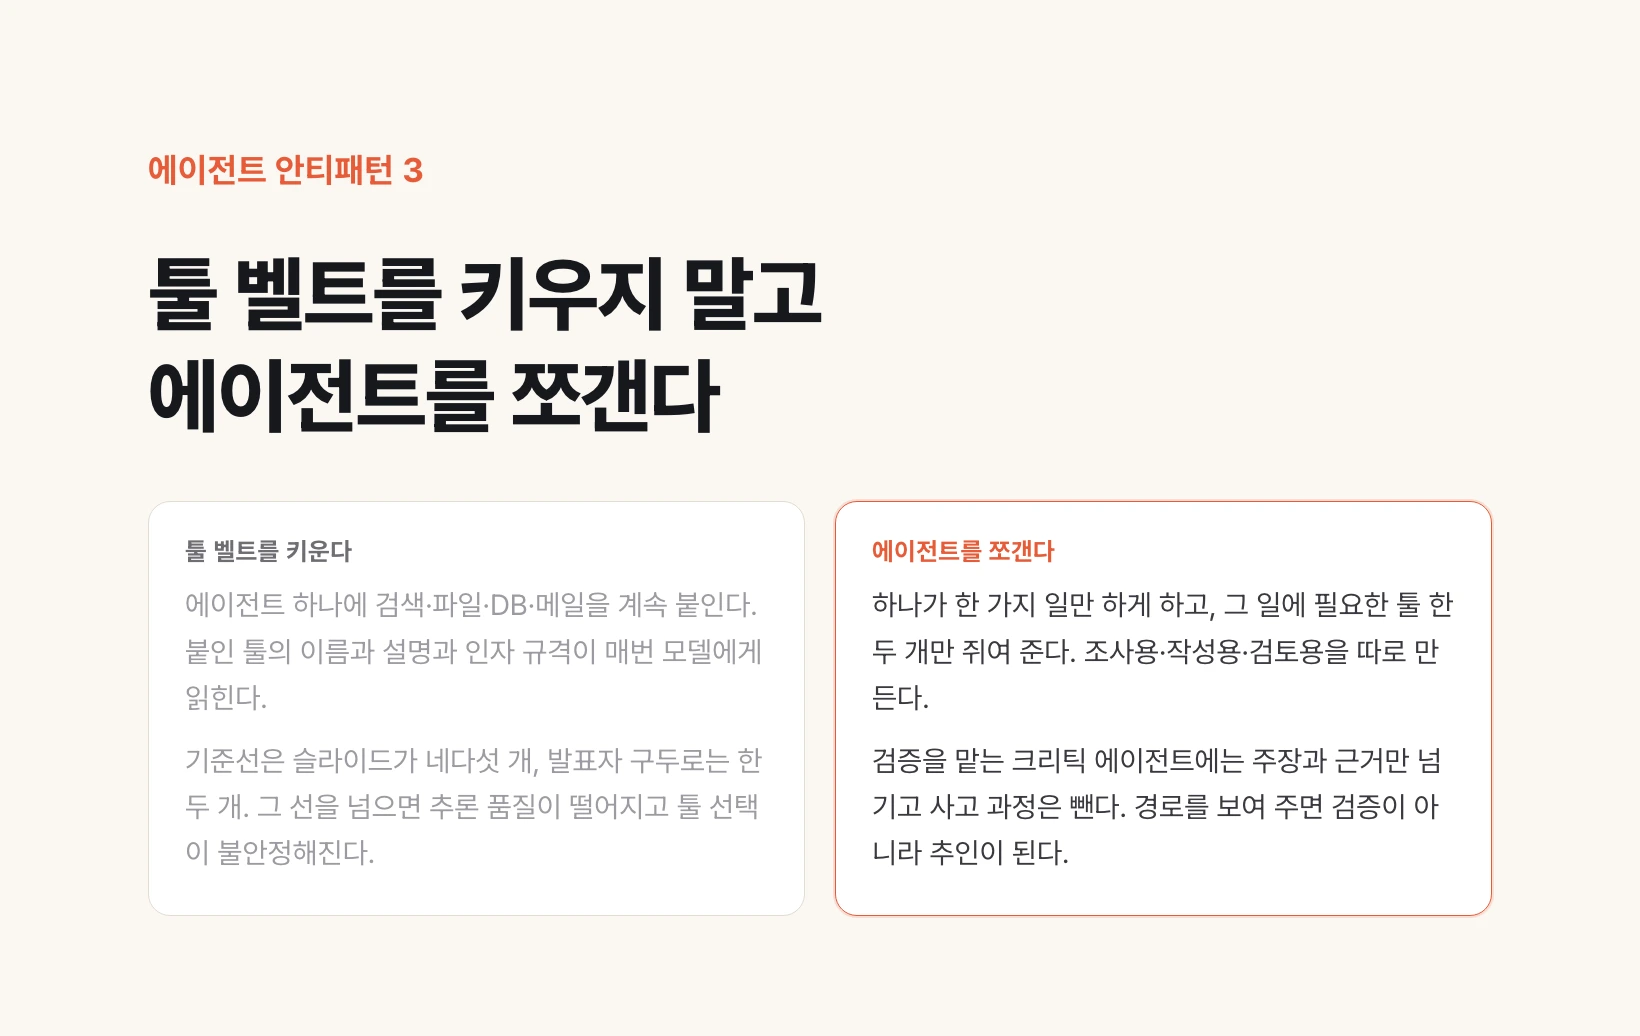
所以处方是:别把工具带做大,把智能体拆开。让每一个只做一件事,只给它这件事所需的一两个工具。这就是函数式编程里「函数只做一件事」的老规矩,被原样搬了过来。
不写代码的人也有对应的用法。做自定义 GPT 或项目时,别把所有角色塞进一个,而是分别做「资料调研用」「初稿撰写用」「审阅用」。是同一个道理。
顺带得到的好处 —— 别让子智能体的上下文流回主上下文
把智能体拆开,会自然带来一个好处:每个智能体在做事过程中积累的中间内容,不会流进主对话。
这之所以重要,是因为上下文就是 token,token 就是钱。但还有一个更重要的理由:上下文越多,模型越糊涂,答案越不准。
所以给子智能体的只是解决那件事所需的东西,回来时也只拿结果。过程留在里面。
critic 智能体 —— 让它验证,却给它更少
演讲中最令人印象深刻的代码就是这个。用来检查此前工作的 critic 智能体,收到的东西正好两样:主张(claim)与依据(evidence)。
得出该主张的思考过程被刻意拿掉。给负责验证的一方更少的信息,乍看是反的。
理由是群体思维。把多个智能体聚在一起互相交谈,它们会收敛到同一个结论。讲者的比喻是:派对上大家都想吃披萨,只有你不想,为了不扫兴你也跟着去了。智能体也是这样。
如果把前一个智能体到达结论的路径展示给验证者,验证者会顺着那条路走,然后到达同一个结论。那不是验证,是背书。所以只交出结论和依据,让它重新判断「这对不对」。
这与人的组织里做交叉复核时,不把原作者的结论笔记一并交出去,是同一个道理。
今天可以试的一件事
打开你正在用的智能体、自定义 GPT 或 MCP 配置,数一数挂了几个工具。
超过五个,其中一半很可能最近一个月一次都没用过。把那一半摘掉,再让它做同样的事,工具选择的准确度会有明显变化。
如果觉得摘掉可惜,那就别删,把它们移到别的智能体上。搜索和网页阅读给调研智能体,文件读写给撰写智能体。
下一篇是第四个反模式:不看模型为什么停下就直接用答案,会在哪里悄悄出错。