为什么是循环,为什么是现在 —— 1966 年的证明
进入反模式之前,先说清这为什么在现在成为问题。
计算的早期,编程语言急剧增加,人们争论谁的语言能做更多事。1966 年,科拉多·伯姆与朱塞佩·雅可比尼用一个证明结束了争论:任何计算只需要三样东西——按顺序执行、按条件分支,以及循环。
把如今的 AI 代进去,画面就清晰了。抛出一次提示、拿到一个回答,那是顺序;加上条件分支,很多人也已经在做。缺的是循环——把回答再喂回去,再拿一个,再喂回去。
智能体之所以感觉不同,一部分是模型变强了,但从结构上说,正是这第三件被补上的时刻。而循环一出现就随之而来的新错误,就是这个反模式。
先拆一个误解 —— LLM 无法执行工具
我们常说「AI 搜索了网页」「AI 读取了文件」,从字面上讲,这并不成立。
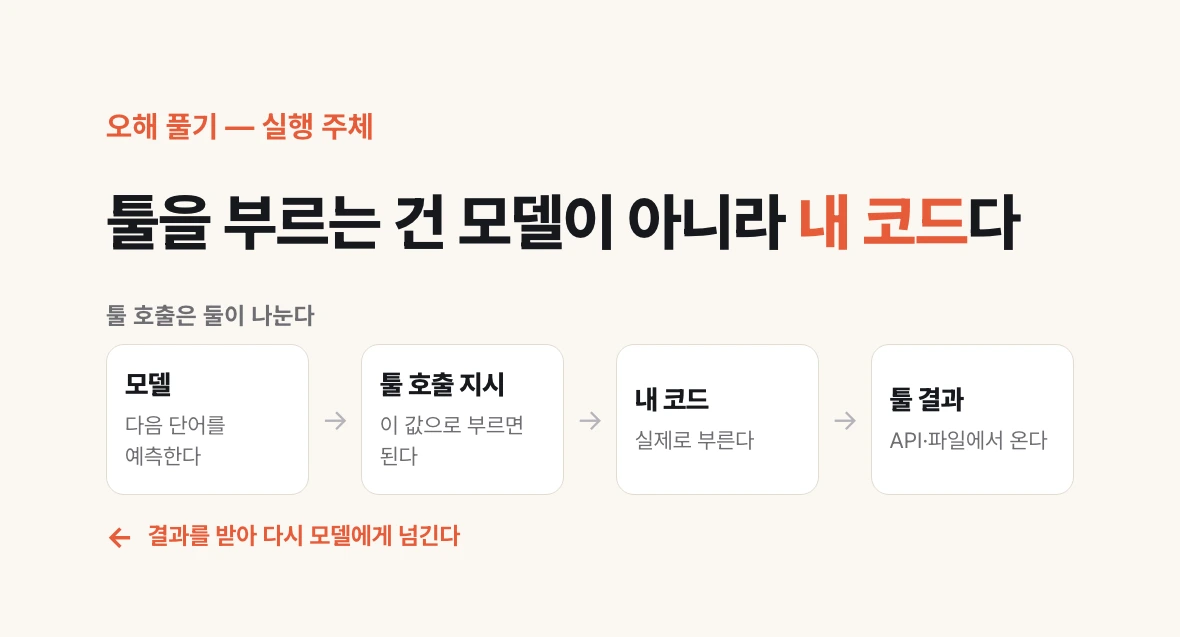
LLM 除了按概率预测下一个词,什么也做不了。就算把工具交给它,它也执行不了。它能做的,只是非常聪明地告诉你「用这些参数调用这个工具」。
真正去调用的是你的代码。请求搜索 API、打开文件、拿到结果再交回给模型,全都是你这边的事。
这个区分之所以重要,是因为「模型停下的理由」有好几种这一事实正是由此而来。答完了停下、为了要工具而停下、因为长度到顶而停下,是三件不同的事,但表面上都只是「回应来了」。
stop_reason —— 分成三条路
所以回应到达时,不是先读正文,而是先看一个叫 stop_reason 的字段。模型为什么停下,就写在那里。
| stop_reason | 含义 | 代码该做什么 |
|---|---|---|
| tool_use | 为了请求调用工具而停下 | 执行工具、把结果附加进消息,再循环一圈 |
| end_turn | 话说完了停下 | 跳出循环,使用答案 |
| max_tokens | 因长度上限被截断 | 不是完整答案 —— 重新请求或按失败处理 |
循环长这样
写成代码很短。在 while 循环里调用模型,按 stop_reason 分支,是 tool_use 就 continue 再转一圈。
值得注意的是,执行工具那一行在模型调用之外。模型决定要调用什么,调用的是你的代码。
while True:
    resp = client.messages.create(
        model="claude-opus-5",
        messages=messages,
        tools=tools,
    )

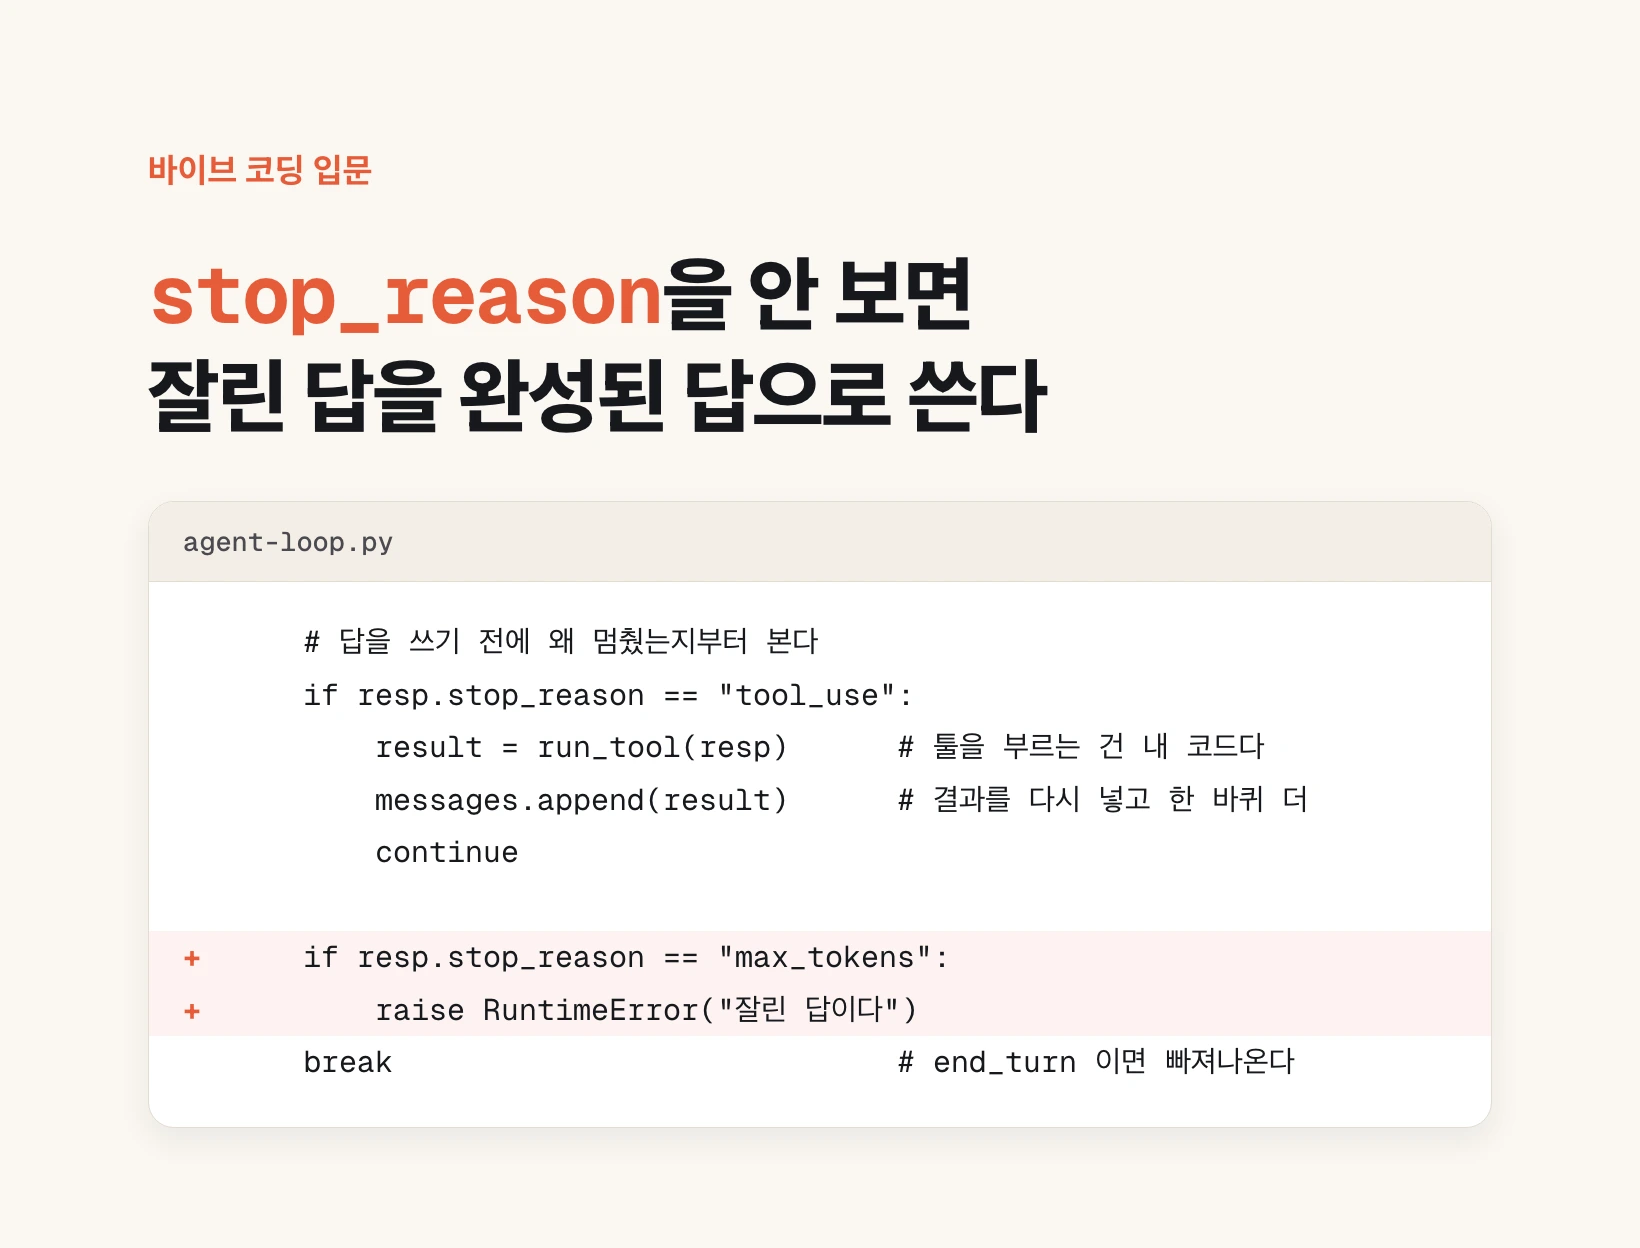
    # 用答案之前,先看它为什么停下
    if resp.stop_reason == "tool_use":
        result = run_tool(resp)          # 调用工具的是你的代码
        messages.append(result)          # 把结果喂回去,再转一圈
        continue

    if resp.stop_reason == "max_tokens":
        raise RuntimeError("答案被截断了 —— 不要当成完整答案")

    break                                # end_turn 就跳出
最危险的是第三种 —— 截断的答案看不出被截断
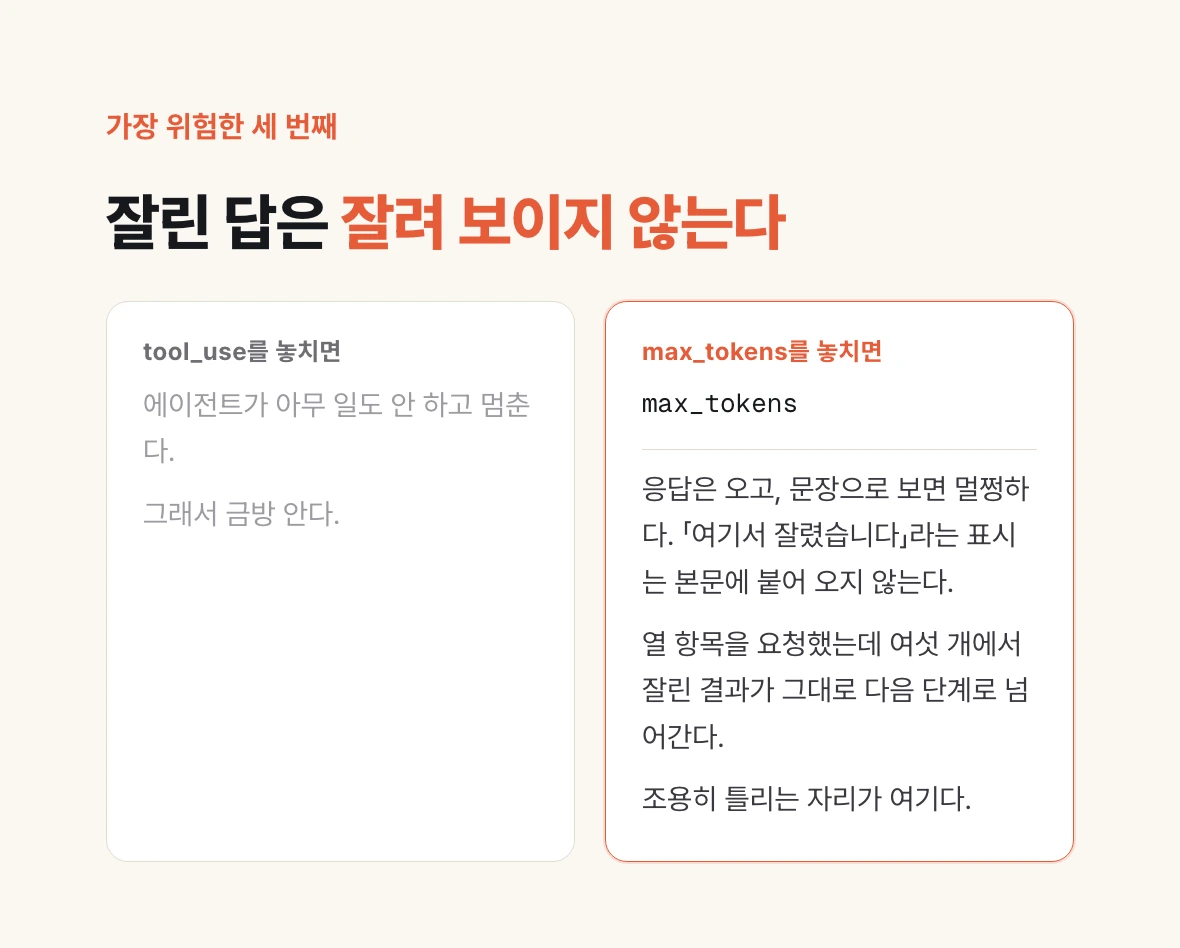
漏掉 tool_use,智能体就什么也不做地停住,很快就会发现。麻烦的是 max_tokens。
因 token 用尽而停下时,回应照样会来,而且作为文字读起来是通顺的。即便从中间被切断,也只是最后一句结束得有点别扭,正文里不会附带一个「到这里被截断」的标记。
所以不看 stop_reason,你会把它当成完整答案拿去用。你要十条,拿到六条,这六条就直接进入下一步。悄悄出错的地方就在这里。
不写代码的人也有对应的场景。如果你在聊天机器人里要一张长表或长列表,结果结束得半途而废,那多半是长度上限,而不是模型只知道这么多。打一句「继续」,剩下的就出来了。
跳出循环之后 —— 人该介入的位置
以 end_turn 跳出之后,正是人该介入的位置。
演讲里说,在这一步要检查置信度。结果看起来不错就直接用,否则交给人。也就是把自动化的终点定义为「自动 + 交接条件」,而不是「全自动」。
不设这个条件,智能体在没把握时也会给出答案——因为它不会停下来说自己不知道,而是会把空白填得像模像样。
今天可以试的一件事
如果你写代码,去看看接收模型回应的地方有没有在看 stop_reason。没有的话,先加上 max_tokens 那一条分支。这一行会把无声的失败变成有声的失败。
如果你不写代码,回想一下最近有没有哪次 AI 的回答半途而止。那多半是长度上限,而不是模型的极限。下次先打一句「接着写」。
下一篇是最后一篇:百万 token 的窗口开了,为什么还是不该全塞进去。