如果你只把 token 当作计费单位
API 价目表按每百万 token 报价,上下文上限也写成 20 万、100 万 token。于是很容易把 token 当成「用来计费的、类似字数的东西」。
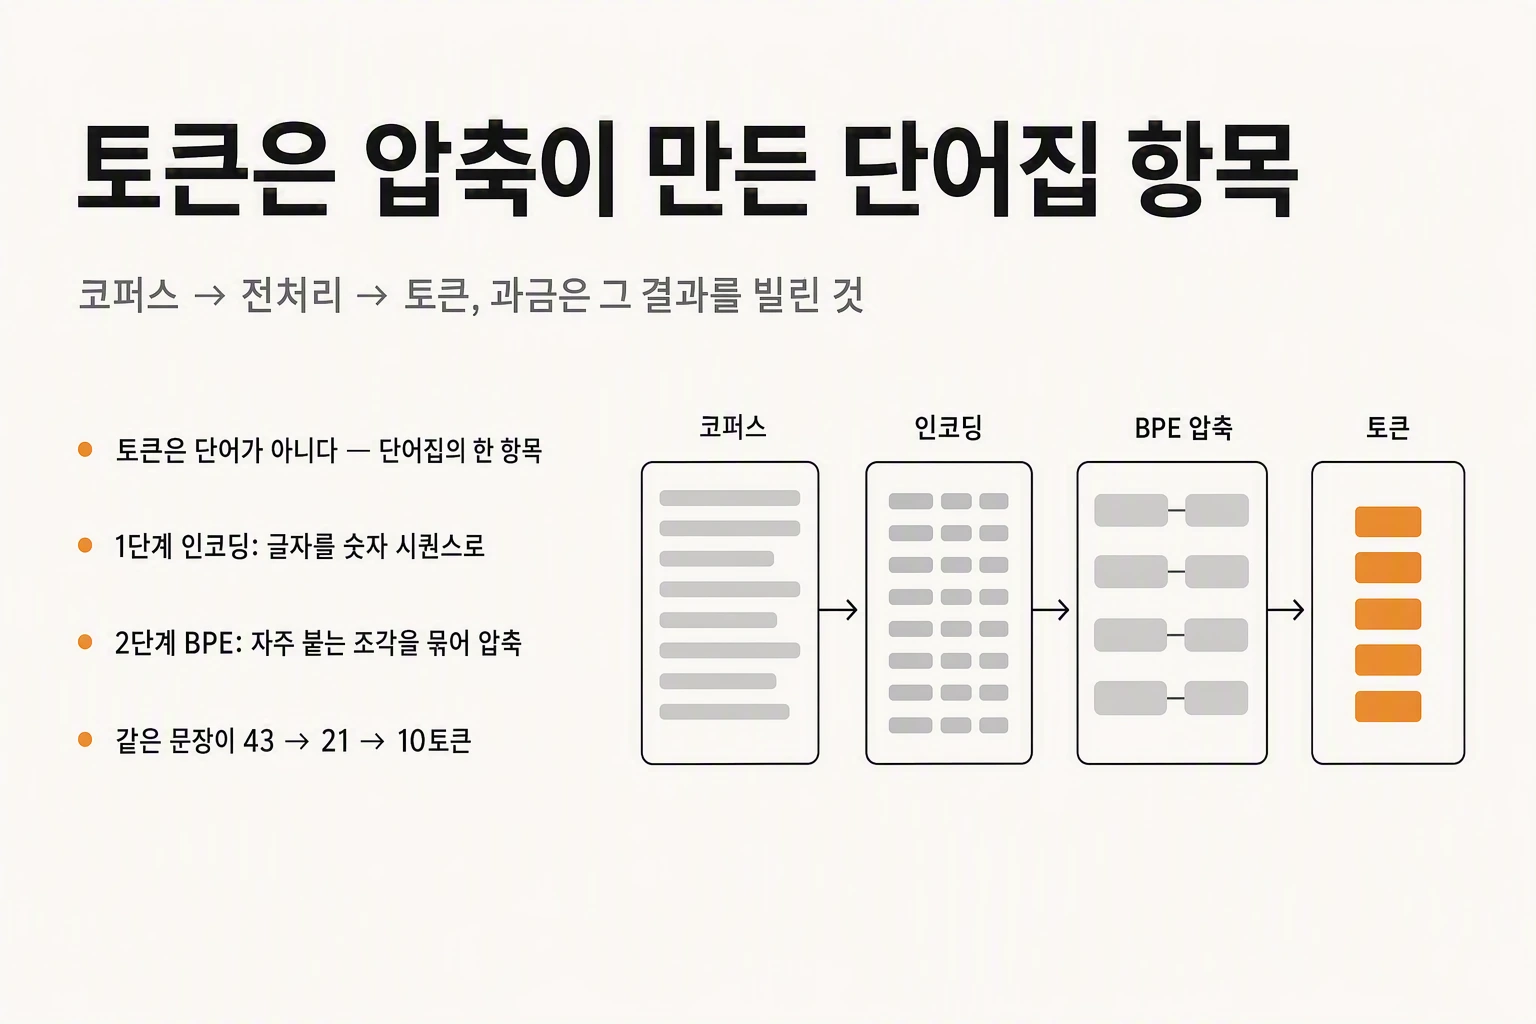
但 token 并不是为计费而发明的。它出现在训练开始之前,在把原始文本变成机器可处理材料的那一步中不得不产生。计费只是借用了这个结果。
弄清这个顺序,实务中常撞见的三件事就一起说通了:为什么中文韩文比英文贵,为什么同一段文字换模型 token 数就变,以及为什么把上下文上限换算成字数总是对不上。
本文从头跟踪这个过程,不需要任何前置知识。
一切始于语料库
先出现的词是语料库(corpus)。听起来像术语,意思却很朴素:文本的集合,大量汇集起来的文字。
互联网上到处都是文字。博客里有,主页上有,社交媒体上也有。GitHub 上的代码归根结底也是写下来的字符,所以同样算文本。哪怕只收集无需登录就能看到的公开页面,其体量也难以想象。
把这些全部接成一整块巨大的文本,那就是语料库。模型的原材料从这里开始。
先把终点定下来会更好理解。要造的是一台机器,看到「我们的午餐菜单是」这样的片段,能猜出后面接什么。看着前文预测下一个词。从根本上说,LLM 做的就是这一件事。
数据和数据集不是一回事
文字收集得再多,原样也没法用来训练。机器学习需要按规格整理过的材料,整理好的形态叫数据集。数据和数据集是两个词。
所以要先做预处理,把语料库变成训练材料。这一步的产物就是 token。
顺序是:语料库(只是很长的文本)→ 预处理 → token(训练材料)。下面要看的是中间那个箭头里发生的事,它分成两个阶段。
第一步 —— 把字符变成数字
计算机不认识字符,只处理数字。所以第一步是把字符转成数字,这套规则叫编码。
编码这个词你多半已经在别处遇到过。下载文件后中文变成乱码,去搜原因时冒出来的就是它。当今世界上使用最广的方案是 UTF-8。
在 UTF-8 中,一个汉字或韩文字符存为三个字节。一个字节是八位 0 或 1,八位就有 256 种可能。从零开始数,即 0 到 255。网络设置里频繁出现的 255 也是同一套算术。
把这条规则套用到整个语料库,世上所有字符——中文、韩文、英文、表情符号、生僻符号——都变成数字。整块文本变成一长串数字,这串数字叫序列(sequence)。
这就是第一步。token 还没出现。
第二步 —— 合并重复片段来压缩
直接使用原始数字串太长,所以要压缩。
用图像压缩来类比就明白了。把图片压成 JPEG,做的是找出重复的图案、只记录一次、其余用引用替代。文本压缩用的是同一个思路。
扫一遍长文本,相同的组合会不断重复。英文里是 ing、the 这样的片段,中文里是常见的双字词,韩文里是敬语词尾。找出这些经常相邻的片段,各自合并成一个条目。合并出来的条目清单就是词表(vocabulary)。
合并规则由算法决定。使用最广的是 BPE(字节对编码),它把出现频率最高的相邻片段对反复融合固定的轮数。由此生成的词表中,每一个条目就是一个 token。
所以定义落在这里:token 不是词,而是压缩算法产出的词表中的一个条目。
自己数一遍就一目了然
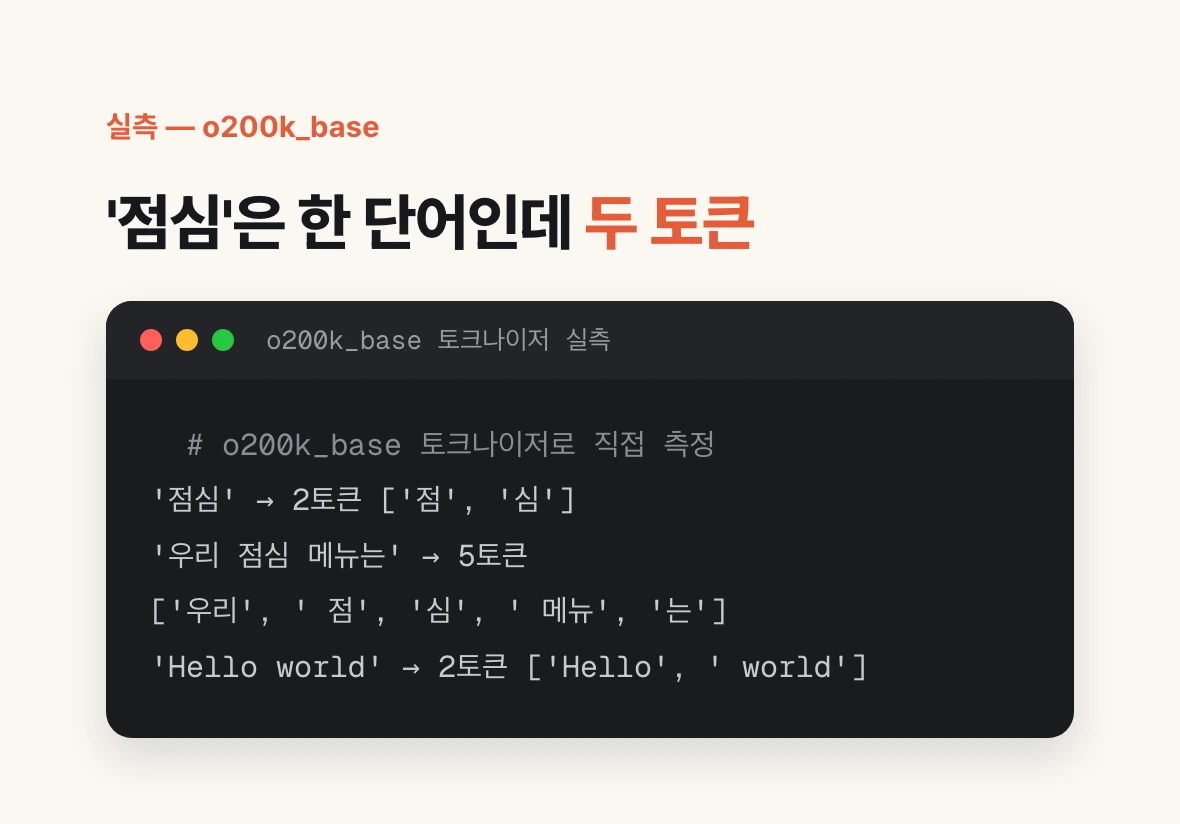
光听描述太抽象,下面是用 GPT-4o 系列所用的 o200k_base 分词器实测的结果。
韩语的「점심」(午餐)是一个词,却拆成「점」和「심」两个 token。「우리 점심 메뉴는」用眼睛看是三块,按 token 算是五个。还能看到前置空格会附着在后面的片段上。
这就清楚了:token 既不是词也不是字符。有时比词更细,有时几个词又粘成一个。唯一的标准是这些片段在训练语料中相邻出现得有多频繁。
'점심'(午餐)        → 2 tokens   ['점', '심']
'우리 점심 메뉴는'    → 5 tokens   ['우리', ' 점', '심', ' 메뉴', '는']
'Hello world'        → 2 tokens   ['Hello', ' world']
同一个句子:43 个、21 个、10 个 token
词表是训练时从语料库一并构建的。模型不同,词表就不同,同一句话的 token 数也随之不同。
我用三种分词器测了同一个韩语句子。GPT-3 时代的 p50k_base 是 43 个 token,GPT-4 用的 cl100k_base 是 21 个,GPT-4o 用的 o200k_base 是 10 个。同一句话,差距超过四倍。
而英文句子「What should we have for lunch?」在三者中都是 7 个 token。差异只在非英语上拉开。
原因在于词表的规模和构成。早期分词器围绕英语构建,几乎不含韩文片段,于是韩文碎成原始 UTF-8 字节。用 cl100k_base 拆「점심」,断点不在字符边界而在字节中间,产出的是破碎的片段。后来的模型扩大词表,整段韩文片段被收入,token 数因此下降。
「中文韩文比英文贵」的说法就来自这里。实务上要紧的是:这不是固定事实,而是随模型选择而变的数值。
如何自己验证
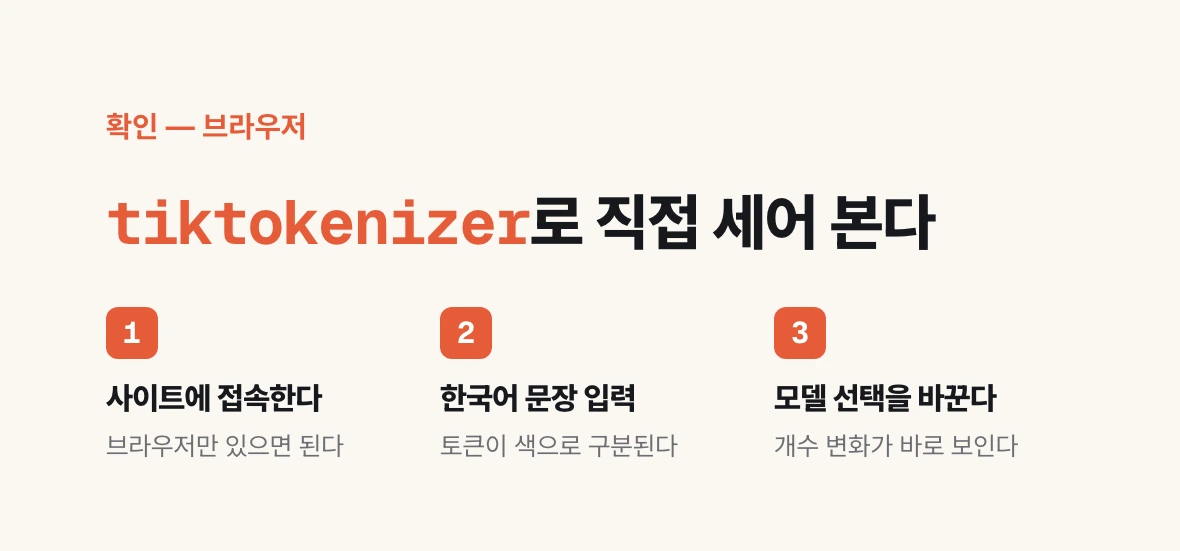
数一次胜过读一段解释,有浏览器就够了。
打开 tiktokenizer.vercel.app,在左侧输入框里输入任意句子。右侧会用颜色区分显示 token,下方给出总数。改动顶部的模型选择器,同一句话的 token 数如何变化立刻可见。
建议试三件事。第一,把常用句子和它的英文翻译并排放进去比较数量。第二,固定句子,逐个切换模型。第三,输入公司名、产品名这类不常见的专有名词。你会看到越不常见的词被切得越碎。
第三点最有用。如果你的提示词结构里反复出现专有名词,那里很可能正在以超出预期的速度消耗 token。
这个概念在实务中咬人的地方
第一,成本估算。用字数换算 token,在非英语上通常对不准。用实际要用的模型的分词器去测一遍代表性提示词才准确。
第二,上下文上限。20 万 token 相当于多少字,取决于语言和模型。想知道还剩多少余量,同样得测。
第三,更换模型。换了更便宜的模型但成本没降到预期,可能是单价降了、而分词器把文本切得更碎导致 token 数上升。真实成本要把单价和 token 数一起看。
这三件事都能靠测量回答,而测量用不了五分钟。
材料到此备齐
我们收集了语料库,把它转成数字,又把重复合并成 token。训练用的材料准备好了。
下一篇看神经网络如何用这些材料实际学习:遮住答案让它猜,再按错误的幅度反向修正。被修正的对象就是参数。模型名旁边 7B、70B 这类数字在数什么,到那时也会清楚。