记住电话号码的那几秒
别人念电话号码给你,你一边找纸一边在心里反复念。写下来之后,几秒钟就忘了。
那几秒里号码在哪儿。不是长期记忆,因为很快就消失了。但也不是不在任何地方。反复念的时候你确实抓着它。而一停下来复述,它就没了。
心理学给这个位置起的名字叫工作记忆。这个概念后来原样搬进了AI的结构。这一期就沿着这条路线走。
1974年,把记忆拆成部件
在此之前,短期记忆被看作一个单一的存储库。有一个房间让信息短暂停留,能装的量是固定的。
1974年艾伦·巴德利和格雷厄姆·希奇提出了另一幅图。短期记忆不是一个房间,而是若干职能不同的部件的组合。
语音回路是在心里复述语音的地方,抓着电话号码的就是它。视空间画板短暂地抓住形状和位置,在脑中摆家具、在陌生建筑里回想方向时用的就是它。中央执行系统是指挥这两者的管理者,决定注意什么、取出什么、丢掉什么。
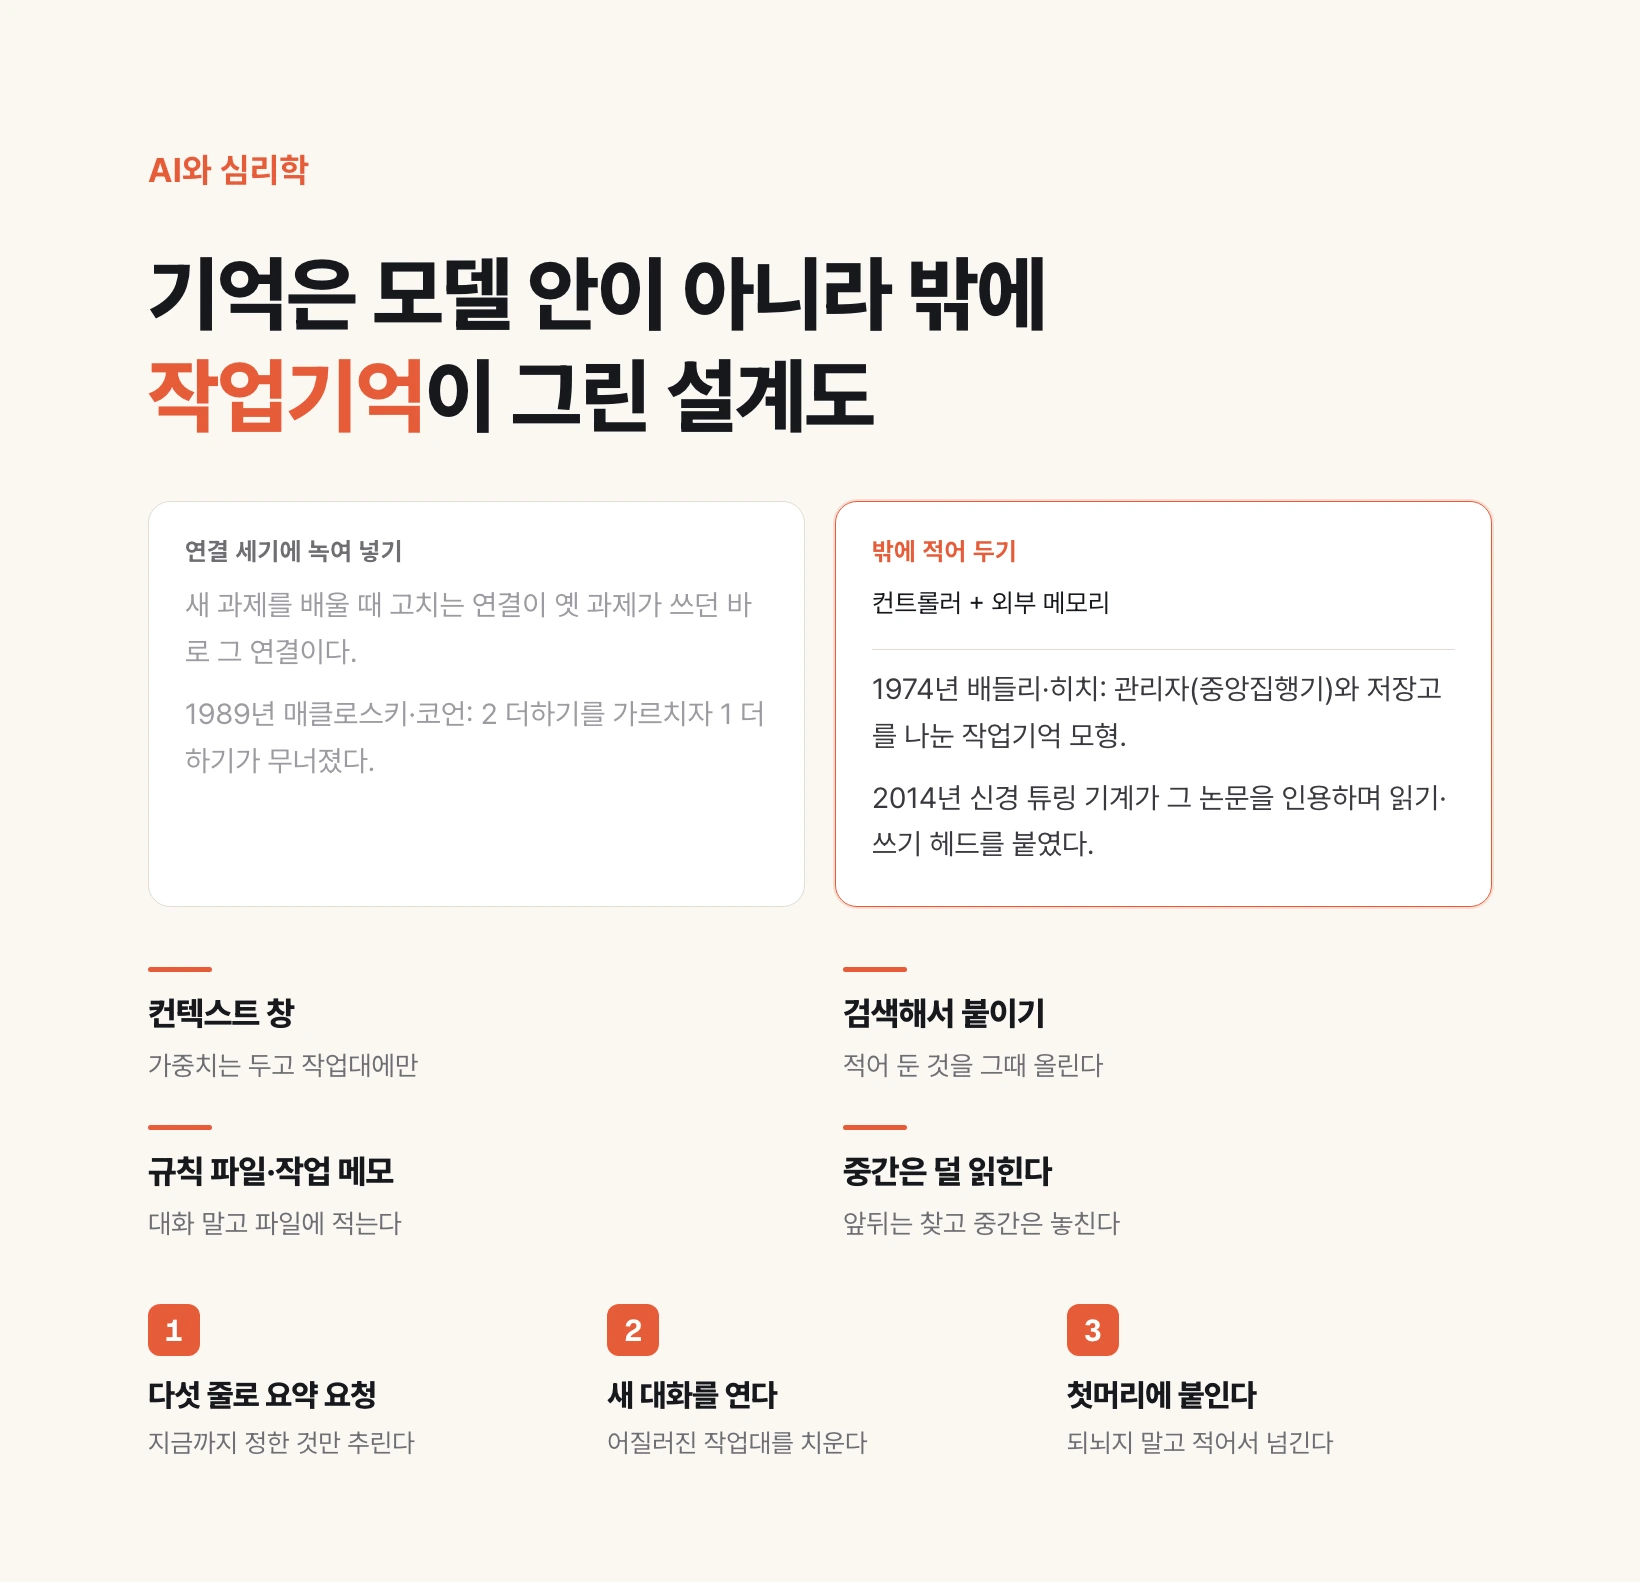
部件的名字不用背。要记住的只有一件事:管理者和存储库是分开的。思考的部分和记录的部分是分离的。这幅图就是这一期的设计图。
这些部件确实存在的证据
把模型拆成几块谁都会。巴德利这一派之所以有说服力,是因为拿出了只有这样拆才能解释的现象。
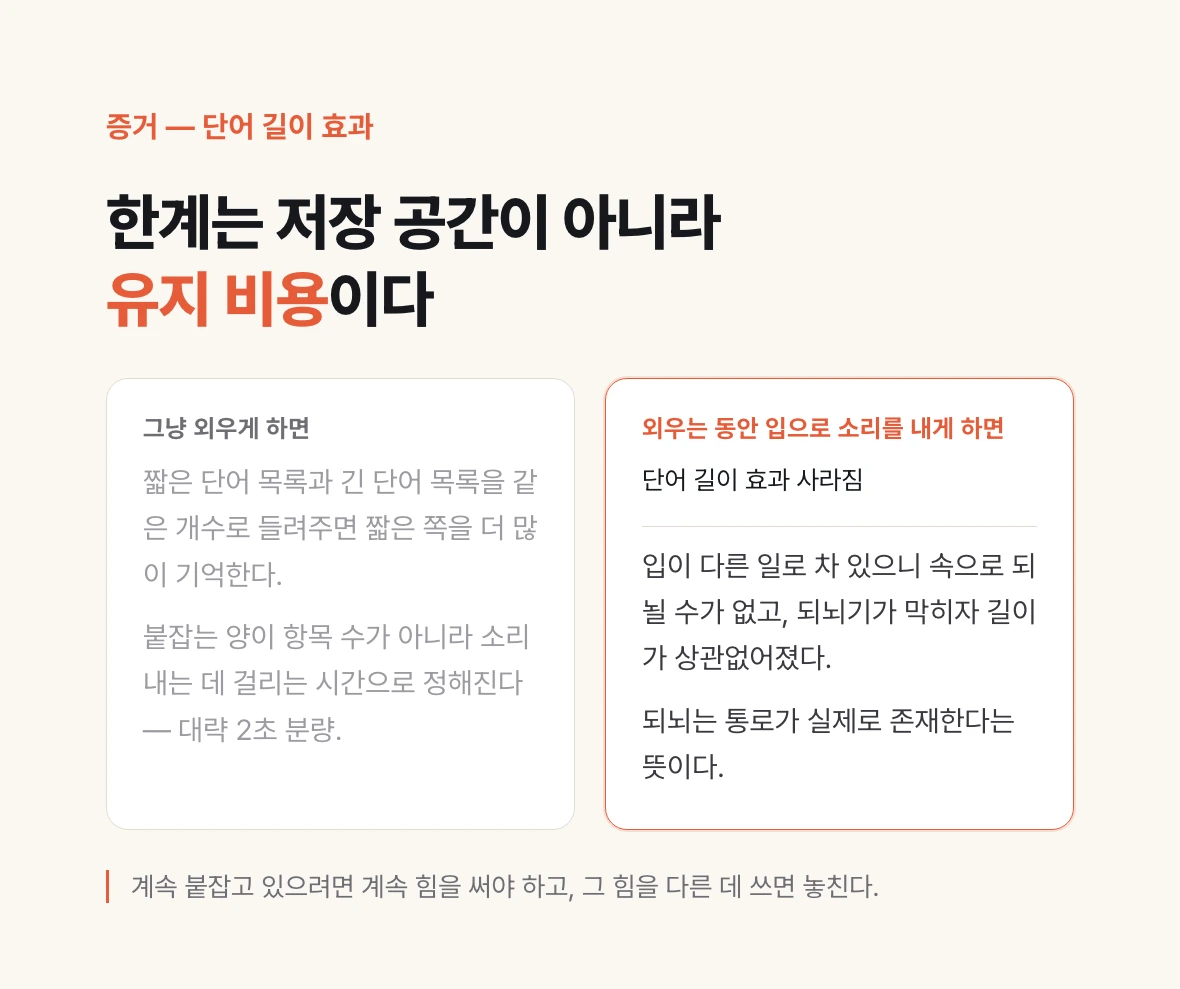
最有名的是词长效应。给人听同样数量的短词表和长词表让他们记,短词那边记住的更多。数量相同结果却不同,因为语音回路能抓住的量不是由项目数决定,而是由念出来所需的时间决定。研究给出的界限大约是两秒内能发音的量。
还有一个更关键的实验。在记忆的同时让人不停地念出无意义的声音,词长效应就消失了。嘴被别的事占着,心里就无法复述,复述一被堵住,长度就不再有影响。这说明复述的通道确实存在。
由此得出的结论支撑着这一整期。工作记忆的限制不是存储空间的大小,而是维持的成本。要一直抓着就得一直用力,把这份力用到别处就会掉。
工作台比想象中窄得多
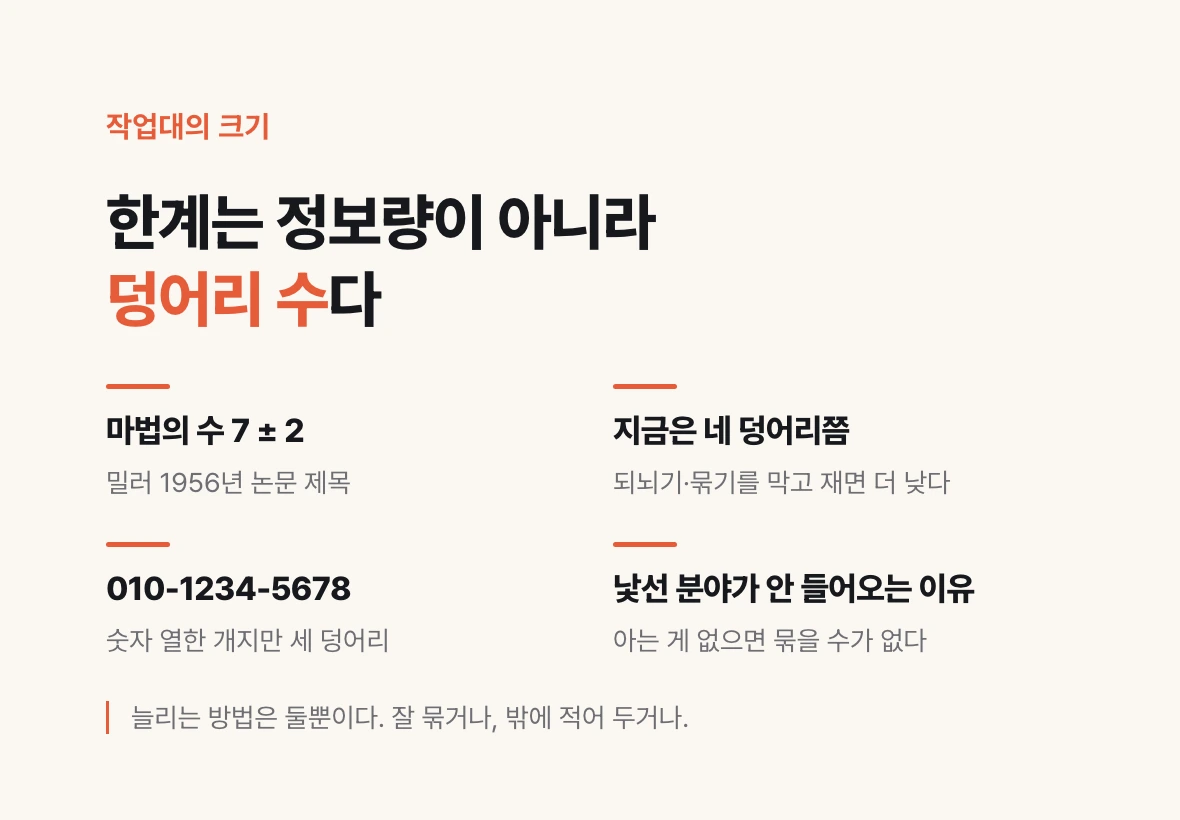
关于这个工作台有多窄,有一个著名的数字:乔治·米勒1956年论文标题里的神奇数字七加减二。它作为人一次能抓住大约七个项目的说法广为流传。
但这个数字如今已不照搬使用。后来的研究认为,如果阻断复述和分组、干净地测量,界限要低得多,大约四个组块的估计被广泛引用。米勒本人在论文里把这个数称为神奇,也有一半是玩笑。
重要的不是数字而是单位。界限在于组块数而非信息量。电话号码有十一个数字,我们却按三组来抓。把项目捆成一格叫作组块化。陌生领域的内容特别难进脑子,原因就在这里:没有既有知识就无法捆绑,于是每一项各占一格。
所以扩展工作记忆现实的办法只有两条。捆得更好,或者写到外面去。人类用纸和白板做后者已经很久了。神经网络最终也走上了同一条路。
神经网络的老问题——学了新的就抹掉旧的
如上一期所见,神经网络把学到的东西融进连接强度里。任何地方都不以条目形式保存,而是分散在整体之中。这种方式有一个讨厌的副作用。
1989年迈克尔·麦克洛斯基和尼尔·科恩把这个副作用干净利落地展示了出来。他们先用加一的一位数加法训练网络到做得很好,接着训练加二的题目。结果刚学的加二做得好,之前学会的加一性能却崩了。谁也没让它抹掉。
原因在结构里。学习新任务时修改的连接,正是旧任务在用的那些连接。如果每一项各有各的位置就不会被覆盖,但分散在整体之中就会重叠。这个现象叫作灾难性遗忘。
换成人来说,就相当于每认识一个新人的名字,就抹掉一个老朋友的名字。把模型做大解决不了。这不是容量问题,而是存储方式本身的性质。
2014年,给神经网络挂上记事本
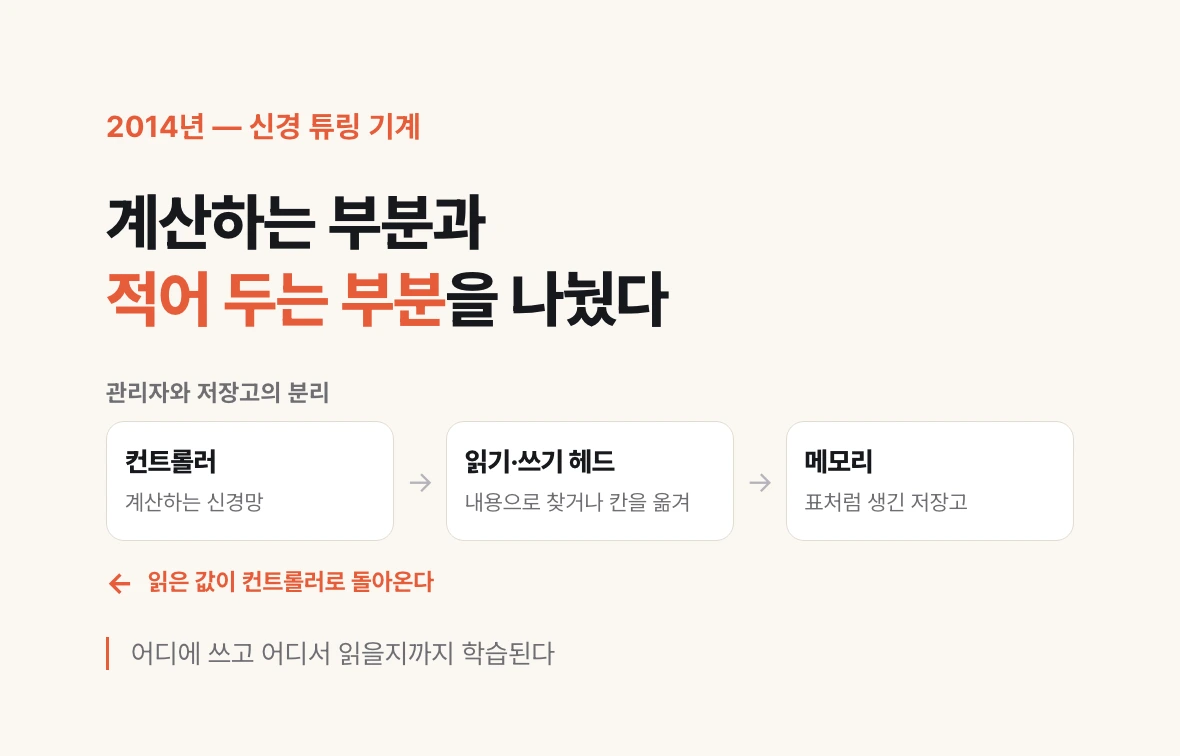
亚历克斯·格雷夫斯和同事们2014年提出的神经图灵机,其解法就是巴德利那幅图本身。它把负责计算的神经网络和存放数值的记忆体分开了。
结构是这样的。一个被称为控制器的神经网络扮演管理者。旁边另有一块形如表格的记忆体,控制器通过读头和写头往表格的特定行写入或读取。看哪一行有两种决定方式:按内容查找,或者从当前所在位置移动若干格。
这个设计的核心在于,往哪儿写、从哪儿读本身也是学出来的。不是人来定规则,而是在把答案做对的过程中,连记事本的用法一起被学会。因此这台机器能把比训练中见过的更长的序列原样复制出来。这意味着它掌握的是程序,而不是背下了例子。
这篇论文不只是把认知科学当比喻借来,证据就在参考文献里。它直接引用了巴德利与希奇1974年的工作记忆以及中央执行系统的概念。不过它并没有把图表照搬成电路,而是取来把管理者与存储库分开的这一发想,用神经网络重新设计。
这条谱系如今在哪里
神经图灵机本身如今已不再使用。但它的发想就在我们每天使用的工具里。
对话框上的上下文窗口是最近的一处。模型的权重保持不变,只把此刻需要的东西摆上工作台。把对话存成文档、需要时找出相关段落贴进来,也是同一个发想。我们用检索来称呼它,但它做的事就是把写在外面的东西在需要时摆上工作台。
智能体把工作备忘写进文件、把项目规则放在单独文件里每次读取、把对话历史总结后贴在下一次对话的开头,全都属于同一类。
共同点只有一个。不把记忆塞进模型里面,而是写在外面。巴德利画出的管理者与存储库的分离,跨过四十年依然立在那里。
只讲一个术语:工作记忆
工作记忆是把当前任务所需的信息暂时抓住并加以操作的能力。
它常和短期记忆混淆,但侧重不同。短期记忆看的是抓多久,工作记忆看的是抓着的时候拿它做什么。是工作台,不是仓库。
所以说某人工作记忆好,与其说是能装得多,不如说是管理得好。往台面上放什么、清掉什么,什么时候写到外面、什么时候再取回来,才是真正拉开表现差距的地方。
用AI也一样。上下文窗口很宽和把这个窗口用好,是两个问题。
长对话里实际发生的事
对话一长回答就变差,这种经历大多数人都有过。一开始还理解得很好的模型,从某个时刻起开始无视先前定好的东西。
这里是有测量依据的。有研究给出很长的输入,把支撑答案的段落分别放在靠前、中间和靠后的位置来比较准确率,结果放在开头和结尾时找得最好,放在中间时性能明显下降。在窗口里并不等于被同等地使用。
还有一层叠加上来。对话越长,开头给出的指示就越被之后的大量话语埋住。在被挤出窗口之前就已经埋住了。这和人开会到第三个小时忘掉开场共识,结构上是一回事。
所以把回答突然变差读成模型变笨了,应对就会错。是工作台乱了,而应对不是再多解释,而是收拾。
那么明天该改变什么
重要的东西不要交给对话,写进文件。项目规则、术语、禁止事项、语气,不该在对话上方说一次就完事,而要放进文件或记忆功能里。用上一期的说法就是:不要交给连接强度,写在记事本上。
对话开始迷路就开新的。但别光开,要把该带的带走。请它把目前定下的内容总结成五行,然后把这五行贴在新对话的开头。这正是人类复述该在的位置。与其费力抓着,不如写下来交出去。
贴长材料时,把指示在材料之后再写一遍。材料贴上去而问题只放在上面,那个问题就会被埋在中间。把同样的指示前后包住,能避开大部分位置问题。
一个对话只交代一件事。在改代码的窗口里请它起草邮件,工作台上就混进了两种东西,接下来的代码回答就会变差。这和人在多任务上吃亏是同一个地方。
概括起来就是:工作台不是靠加宽,而是靠清理。而在清理之前,先写下来。