2026년 9월 첫째 주에 무슨 일이 있었나
한 주에 최상위 모델 네 개가 나왔다. Anthropic의 Claude Fable 5.1, Google의 Gemini 3.8 Flash, Meta의 Muse Spark 1.3, OpenAI의 GPT-6 Astra. 네 곳 모두 자사 발표에서 어떤 항목의 1위를 주장했다.
같은 주에 모델 말고 다른 것도 움직였다. 9월 1일에는 화면과 공간을 생성하는 모델이 둘 나왔다. Runway의 Solaris와 World Labs의 Atlas다. 9월 3일에는 마이크로소프트가 음성인식 모델 MAI-Transcribe-2를 냈고, 같은 날 엔비디아가 허깅페이스 인수에 합의했다고 발표했다.
이 글은 그 주의 발표를 나열하려는 것이 아니다. 발표들이 서로 다른 표를 근거로 1위를 주장하는 광경 자체가 하나의 사실이고, 모델을 고르는 사람에게는 그 광경을 읽는 법이 개별 점수보다 오래 쓸모 있다.
첫째, 1위는 표마다 다르다
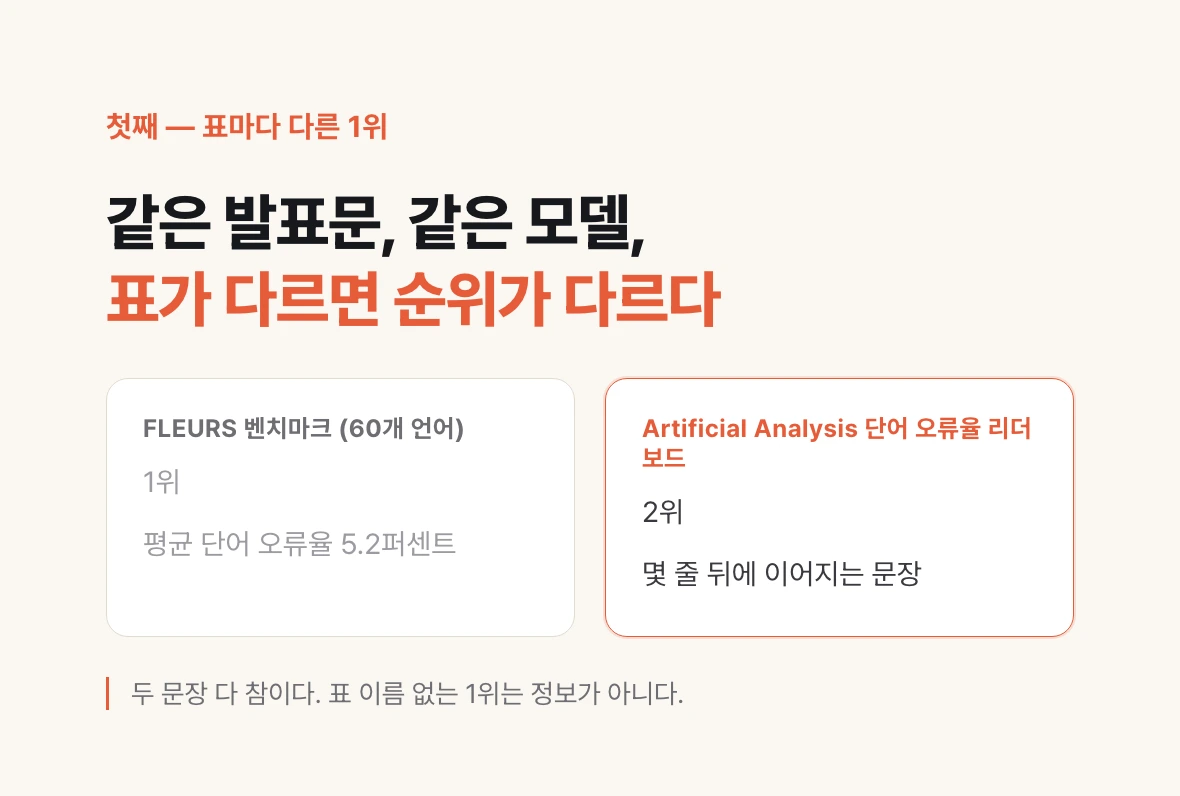
가장 깔끔한 실증은 마이크로소프트 발표문 안에 있다. MAI-Transcribe-2 발표문의 제목은 세계에서 가장 빠르고 정확하고 싼 음성인식 모델이다. 그리고 본문은 60개 언어를 재는 FLEURS 벤치마크에서 1위라고 적는다. 평균 단어 오류율 5.2퍼센트다.
같은 문단이 몇 줄 뒤에 이렇게 이어진다. Artificial Analysis의 단어 오류율 리더보드에서는 2위라고. 두 문장 다 참이다. 재는 표가 다르기 때문이다. 어느 쪽도 거짓말이 아니고, 어느 쪽도 그 모델의 전부가 아니다.
여기서 얻을 요령은 하나다. 어떤 발표문이 1위라고 쓰면 그 옆의 표 이름을 먼저 본다. 표 이름 없는 1위는 정보가 아니다.
둘째, 종합 순위는 가중치의 함수다
Artificial Analysis 같은 종합 지수는 여러 벤치마크를 모아 각각에 가중치를 얹고 하나의 점수로 합친다. 편리하다. 표 하나로 모델 전체를 세울 수 있으니까.
그런데 가중치가 바뀌면 순위가 바뀐다. 즉 종합 순위는 어느 모델이 더 똑똑한가에 대한 답이 아니라, 이 가중치 배분에서는 어느 모델이 앞서는가에 대한 답이다. 코딩 비중을 늘리면 코딩 모델이 올라오고, 추론 비중을 늘리면 추론 모델이 올라온다.
그래서 종합 지수 순위와 실제 결과물의 체감이 어긋나는 것은 이상한 일이 아니다. 그 지수의 가중치 배분이 내 업무의 가중치 배분과 다를 뿐이다. 순위표가 틀린 것이 아니라 내 질문에 답하는 표가 아닌 것이다.
셋째, 값은 순위표 밖에 있다
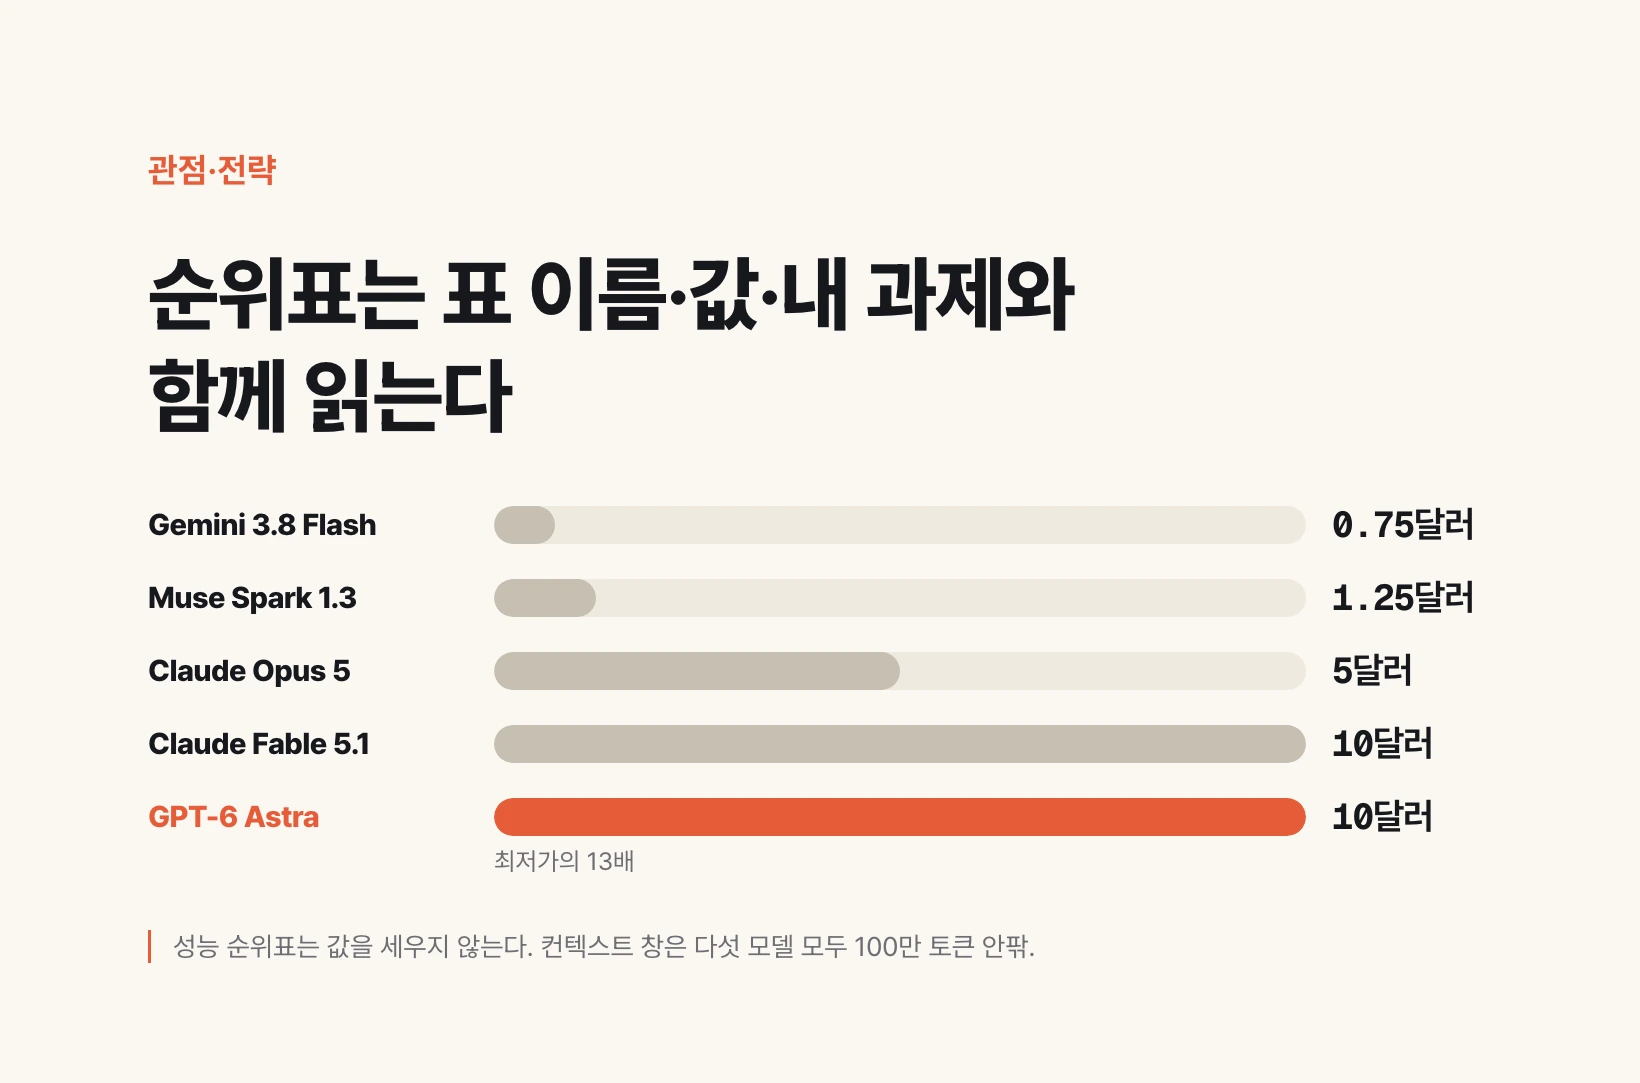
성능 순위표는 대개 값을 함께 세우지 않는다. 그런데 같은 주에 나온 모델들의 값 차이가 성능 차이보다 훨씬 크다.
2026년 9월 7일 OpenRouter 공개 가격 기준으로 입력 100만 토큰 단가를 나란히 두면 이렇다. Gemini 3.8 Flash 0.75달러, Muse Spark 1.3 1.25달러, Claude Opus 5 5달러, Claude Fable 5.1 10달러, GPT-6 Astra 10달러. 가장 싼 것과 가장 비싼 것이 13배 넘게 벌어진다.
출력은 격차가 더 크다. 같은 순서로 3.75달러, 4.25달러, 25달러, 50달러, 50달러다. 컨텍스트 창은 다섯 모델 모두 100만 토큰 안팎이라 이 축에서는 차이가 거의 없다.
순위표에서 한 칸 위에 있기 위해 13배를 낼 이유가 있는지는 순위표가 답하지 않는다. 그 답은 업무마다 다르다. 계약서 초안 검토처럼 한 번의 실수가 비싼 일이라면 비싼 모델이 맞고, 회의록 요약을 하루에 수백 건 돌린다면 값이 곧 도입 가능 여부다.
그러면 무엇을 봐야 하나 — 내 과제로 만든 평가셋
남의 표를 읽는 법을 익히는 것보다 내 표를 만드는 편이 빠르다. 거창한 도구가 필요하지 않다. 문서 파일 하나면 된다.
만드는 순서는 넷이다. 첫째, 실제 업무에서 과제 3~5개를 뽑아 프롬프트째로 적어 둔다. 실제로 어제 한 일이어야 한다. 예제로 지어낸 과제는 모델을 가르지 못한다. 둘째, 정답이 아니라 합격 조건을 적는다. 무엇이 들어 있어야 통과인지, 무엇이 들어 있으면 탈락인지를 문장으로 쓴다. 셋째, 새 모델이 나오면 같은 프롬프트를 그대로 넣고 결과를 나란히 붙인다. 넷째, 결과 옆에 값과 소요 시간을 함께 적는다.
이 문서가 쌓이면 발표문의 1위와 무관하게 판단할 수 있다. 그리고 이 판단은 남에게 설명할 수 있는 형태로 남는다. 조직에서 모델을 바꾸자고 제안할 때 필요한 것은 벤치마크 캡처가 아니라 우리 과제 다섯 개에서 이렇게 갈렸다는 표다.
# 우리 과제 평가셋 (2026-09)

## 과제 1 — 상담 녹취 요약
프롬프트: 아래 녹취를 고객 요구사항 / 우리 약속 / 미결 항목 세 덩어리로 정리하라. <녹취>
합격: 미결 항목이 빠지지 않는다. 없는 약속을 만들지 않는다.
탈락: 날짜·금액을 지어낸다.

| 모델 | 결과 | 값 | 소요 |
|---|---|---|---|
| (기록) | | | |

## 과제 2 — 계약서 독소조항 체크
프롬프트: ...
합격: ...
탈락: ...
이번 주의 진짜 뉴스는 순위표가 아니라 지형이다
9월 3일 젠슨 황이 직접 올린 글로 엔비디아가 허깅페이스 인수에 합의했다고 발표했다. 금액은 129억 3,030만 달러다.
허깅페이스가 어떤 곳인지 발표문의 숫자로 보면 이렇다. 개발자와 연구자 1,800만 명 이상이 모델 300만 개 이상, 데이터셋 50만 개, 애플리케이션 100만 개를 올려 두었고 기업 20만 곳 이상이 이 플랫폼에서 모델을 찾고 평가하고 배포한다. 오픈 모델의 깃허브라고 부를 만한 자리다.
발표문이 두 번 못 박은 문장이 있다. 허깅페이스에 올리거나 배포하는 데 엔비디아 컴퓨트가 필수는 아니라는 것, 그리고 멀티클라우드와 멀티가속기 지원을 계속한다는 것이다. 인수 발표에서 이 문장을 두 번 쓰는 것 자체가 무엇을 우려했는지 보여 준다.
칩을 파는 회사가 오픈 모델 저장소를 사는 이유는 읽어 볼 만하다. 메타도 오픈AI도 구글도 자체 칩으로 옮겨 가는 중이다. 프런티어 랩이 엔비디아 컴퓨트를 덜 사게 되더라도, 오픈웨이트 모델을 직접 자기 서버에서 돌리려는 기업과 기관은 여전히 GPU를 사야 한다. 엔비디아는 자사가 허깅페이스에 오픈 모델 500개 이상과 오픈 데이터셋 250개 이상을 올린 최대 기여자라고 밝혔다. 이번 인수는 그 방향에 돈을 더 크게 건 것이다.
생성의 대상이 텍스트에서 화면과 공간으로 넘어갔다
9월 1일 Runway가 공개한 Solaris는 인터페이스 월드 모델이다. 지금까지 화면은 코드라는 중간 표현으로 구현했고, 그래서 생김새와 동작을 미리 다 정해 두어야 했다. Solaris는 그 중간 단계 없이 사용자의 조작에 반응해 화면을 한 프레임씩 만들어 낸다.
구조가 둘로 나뉜다. 언어 모델이 사용자의 의도를 해석해 그 조작이 화면에 어떻게 반영돼야 하는지를 정하고, 시각 모델은 그 결과를 그리는 일만 맡는다. 고수준 추론과 화면 렌더링을 분리한 것이다. 논문은 이것을 소프트웨어의 새 패러다임을 향한 한 걸음이라고 적었다. 인터페이스가 미리 정의된 상태의 유한한 집합이 아니라 사용자 의도를 따라 계속 생성되고 적응하는 것이 된다는 뜻이다.
같은 날 World Labs가 공개한 Atlas는 공간 쪽이다. 텍스트와 이미지와 영상과 3D를 처음부터 함께 학습해 하나의 공간 컨텍스트로 다루는 모델이다. 사진 한 장에서 수십 장까지 넣으면 카메라 위치와 각도를 지정해 새 시점을 만드는데, 문장 지시가 아니라 기하값으로 카메라를 받는다. 왼쪽으로 조금이 아니라 좌표다. 최대 1분, 1440p까지 나온다. 사진에 찍히지 않은 부분은 모델이 이어서 상상한다.
Atlas는 이 밖에도 여러 장의 사진으로 실제 장면을 3D로 재구성하고, 영상을 넣으면 시공간을 모델링해 로봇 학습용 시뮬레이션으로 넘긴다. World Labs는 3D 재구성 전용 최신 모델보다 나은 성능이라고 주장한다.
정리 — 순위표 읽는 세 줄
하나, 1위라는 말 뒤에 붙은 표 이름을 먼저 본다. 표 이름 없는 1위는 정보가 아니다.
둘, 종합 지수는 가중치의 함수다. 그 가중치가 내 업무와 같은지 묻는다.
셋, 내 과제 3~5개를 고정해 두고 새 모델이 나올 때마다 같은 프롬프트로 직접 잰다. 결과 옆에 값과 소요 시간을 함께 적는다. 이 표는 남의 순위표가 흔들려도 흔들리지 않는다.