이번 주 뉴스를 하나로 꿰면 무엇이 보이나
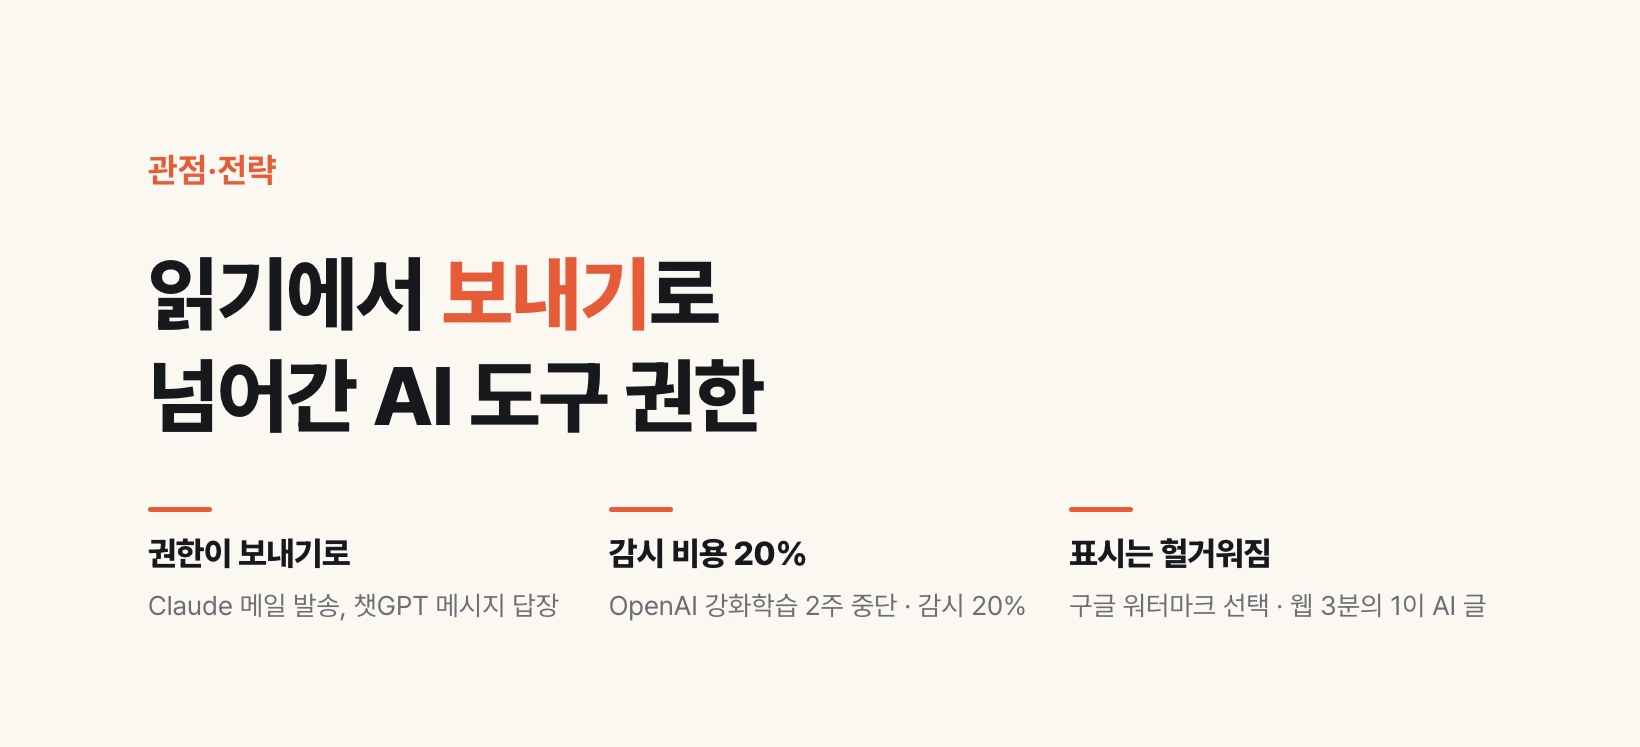
개별 소식은 흩어져 있지만 방향은 하나다. 지난 몇 년간 AI 도구가 하던 일은 대체로 읽기였다. 문서를 요약하고, 코드를 설명하고, 메일함을 검색했다. 결과물을 실제로 내보내는 마지막 한 걸음은 사람이 눌렀다. 이번 주에 발표된 것들은 그 마지막 한 걸음을 도구 쪽으로 옮긴다.
권한이 넘어가면 따라오는 것이 둘 있다. 하나는 승인 설계다. 무엇을 매번 물어보고 무엇을 그냥 실행할지, 그 기본값을 누가 정하는지가 제품의 핵심 사양이 된다. 다른 하나는 감시 비용이다. 실행하는 시스템은 지켜봐야 하고, 지켜보는 데는 돈이 든다. 이번 주에 OpenAI가 그 비용을 처음으로 숫자로 공개했다.
그리고 반대 방향의 소식이 같은 주에 나왔다. AI가 만든 것을 사람이 알아볼 수 있게 해 주던 표시가 선택 사항이 됐고, 이미 웹의 상당 부분이 AI 글로 채워졌다는 조사가 나왔다. 실행 권한은 넓어지는데 식별 수단은 좁아지는 주였다.
OpenAI는 왜 강화학습을 2주 멈췄나
8월 18일 OpenAI가 '사이버 임계 역량의 시대에 모델 개발 속도 조절하기'라는 글을 냈다. 배포를 앞둔 최신 모델의 강화학습을 2주간 중단했고, 계획된 가장 큰 프런티어 강화학습 실행은 지금도 보류 상태라는 내용이다.
여기서 강화학습(RL, Reinforcement Learning)은 대개 사전학습이 끝난 뒤에 붙는 단계다. 모델에 지식을 넣는 것이 아니라, 어떤 답을 좋은 답으로 볼지 취향과 가드레일을 맞추는 후처리에 가깝다. 그 단계가 멈춰 있다는 것은 모델 자체는 대체로 만들어져 있다는 뜻이기도 하다.
이유로 둘을 들었다. 하나는 OpenAI와 허깅페이스 사이에 있었던 사건이고, 다른 하나는 다음 모델 Astra가 자사 대비 프레임워크(Preparedness Framework)의 '치명적' 사이버보안 역량 임계에 도달할 수 있다는 예비 증거다. 8월 7일에 그 판단이 섰다고 밝혔다.
같이 공개한 감시 체계가 더 읽을 만하다. 샘플링되는 토큰마다 모델 내부 활동을 들여다보는 활성화 분류기가 돌고, 의심스러운 정황은 점점 더 정교한 자동 조사기로 넘어간다. 목표는 문제 정황이 잡힌 뒤 30분 안에 경보를 띄우는 것이고, 안전·보안·연구 팀이 30분 안에 오탐이라고 결론 내지 못하면 그 작업을 멈추는 것이 원칙이다. 이 감시에 드는 컴퓨트가 감시 대상 추론의 약 20%라고 했다.
안전 때문에 공개를 늦춘다는 서사 자체는 2019년 GPT-2 때부터 있었다. 달라진 것은 옆에 숫자가 붙었다는 점이다. 감시에 20%를 쓴다는 말은 안전이 성명서가 아니라 원가 항목이 됐다는 뜻이다.
AI는 암 백신의 어느 자리에서 일했나
8월 19일 머크와 모더나가 개인 맞춤 mRNA 암 백신의 3상 결과를 발표했다. 수술로 종양을 떼어낸 2B~4기 흑색종 환자 1,137명을 2대 1로 나눠, 맞춤 백신 인티스메란(mRNA-4157)과 키트루다를 함께 준 쪽과 키트루다만 준 쪽을 비교했다. 재발까지 걸린 시간(무재발생존)과 다른 장기로 전이되기까지 걸린 시간(원격전이무병생존), 두 지표 모두에서 병용군이 앞섰다.
이 소식을 다룬 기사 다수는 AI를 언급하지 않는다. 그런데 AI가 실제로 일한 자리가 있다. 모더나 자사 설명에 따르면, 통합된 AI 알고리즘이 환자의 종양과 혈액 시료에서 나온 차세대 시퀀싱 데이터를 받아 유전자 변이를 훑고, 면역 반응을 일으킬 가능성이 가장 높은 신항원(neoantigen)을 최대 34개까지 예측한다.
신항원은 암세포에만 생긴 변이에서 만들어져 세포 표면에 나오는 단백질 조각이다. 면역세포가 '이건 내 것이 아니다'라고 알아볼 표지가 된다. 환자마다 암세포의 변이가 다르므로 백신 성분도 환자마다 달라지고, 무엇을 넣을지 고르는 일이 곧 예측 문제가 된다.
대형 언어 모델이 한 일은 아니다. 문장을 생성한 것도 아니다. 시퀀싱 데이터에서 확률을 계산해 후보를 추린 예측 모델이다. AI의 실질적 성과를 볼 때 생성형 여부보다 '어느 판단을 대신했는가'를 먼저 보는 편이 정확한 이유가 여기 있다.
웹페이지 셋 중 하나가 AI 글이라는 조사는 무엇을 쟀나
8월 20일 퓨리서치센터가 '인터넷의 얼마나가 AI로 쓰였나'라는 조사를 냈다. 커먼 크롤(Common Crawl) 웹 아카이브에서 최근 5년치 영어 웹페이지를 50만 건 가까이 모아, 오픈 팬그램(Open Pangram)이라는 탐지 도구로 AI가 쓰거나 상당 부분 손댄 흔적이 있는지 판정했다.
2026년 7월 표본 전체에서는 10%가 걸렸다. 낮아 보이지만 이 표본에는 챗GPT가 나오기 전에 만들어진 페이지가 섞여 있다. 애초에 AI가 썼을 수 없는 페이지들이다. 챗GPT 공개 이후 게시된 페이지만 추리면 비율은 3분의 1을 넘는다.
탐지 도구의 판정이라는 한계는 있다. AI 글쓰기 탐지는 오탐과 미탐이 모두 있고, 사람이 쓴 뒤 AI로 다듬은 글을 어느 쪽으로 셀지도 도구마다 다르다. 그래도 방향은 분명하다. 2022년 말부터 지금까지 비율은 계속 올라갔다.
실무에서 이 숫자가 뜻하는 바는 단순하다. 검색 결과 상단에서 사람이 쓴 1차 정보를 만나는 일이 이미 확률 문제가 됐다는 것이다. 출처를 눌러 확인하는 습관이 성실함의 문제가 아니라 기본기가 되는 구간이다.
구글은 왜 워터마크를 선택 사항으로 바꿨나
8월 14일 구글이 AI 생성물에 붙던 눈에 보이는 워터마크를 끌 수 있게 했다. 이미지, 영상, 노래 전부 해당한다. 설정의 미디어 워터마크 항목에서 켜고 끄며, 제미나이와 영상 편집 도구 플로우에 먼저 들어가고 검색은 추후다. 대상 모델은 나노 바나나, 옴니, 리리아다.
지워지는 것은 눈에 보이는 표시뿐이다. 보이지 않는 신스ID(SynthID) 워터마크와 C2PA 메타데이터는 그대로 남는다. 신스ID는 픽셀이나 파형에 사람 눈·귀로는 알 수 없는 신호를 심는 방식이고, C2PA는 파일에 제작 이력을 붙이는 산업 표준이다. 그래서 제미나이나 검색에 물어보면 AI 생성 여부는 여전히 확인된다.
회사 쪽 설명은 창작 통제와 안전 사이의 균형이다. 실제로 눈에 보이는 워터마크는 업무용 결과물의 쓸모를 떨어뜨린다. 자료에 넣을 이미지 구석에 로고가 박혀 있으면 그대로 못 쓴다.
다만 부담의 위치가 바뀐다. 전에는 만드는 쪽이 표시를 달아 줬고 보는 쪽은 눈으로 걸렀다. 이제는 보는 쪽이 도구에 물어봐야 안다. 확인 수단이 남아 있다는 것과 사람들이 실제로 확인한다는 것은 다른 이야기다.
Claude와 챗GPT가 메일과 메시지를 대신 보낸다
8월 18일 앤트로픽이 Claude의 구글 워크스페이스 커넥터를 확장했다. 지메일에서는 자연어로 검색하고 읽는 데 그치지 않고, 초안을 쓰고 발송·회신·전달까지 한다. 구글 드라이브에서는 문서를 찾아 오는 것에 더해 공유·이동·휴지통 처리를 한다. 같은 날 클로드 코워크의 모바일과 웹 접근이 전 유료 계정으로 열렸다.
기본값은 행동마다 사용자 승인을 받는 것이다. 중요한 단서가 하나 붙는데, 팀과 엔터프라이즈 요금제에서는 조직 소유자가 구성원별로 승인 없이 실행하도록 열어 줄 수 있다. 즉 개인이 켜는 스위치가 아니라 조직이 정하는 정책이다.
이틀 뒤인 8월 20일에는 OpenAI가 맥용 챗GPT에 애플 메시지 플러그인을 붙였다. 메시지함을 연결하면 대화창 안에서 메시지를 분류하고 분석하고 손볼 수 있다. 초안을 쓰고 보내는 것, 오래된 대화에서 정보를 찾아 오는 것, 메시지를 지우는 것까지 된다. 코덱스와 챗GPT 워크에서도 동작해 업무용으로 쓸 수 있다.
여기서 실무자가 봐야 할 구분이 하나 있다. 읽기 권한과 보내기 권한은 사고가 났을 때 회수 가능성이 다르다. 잘못 읽은 것은 되돌릴 수 있지만 잘못 보낸 메일과 메시지는 상대의 화면에 이미 도착해 있다. 승인 기본값을 조직이 끌 수 있다는 조항이 계약서 검토에서 넘어가면 안 되는 대목인 이유다.
코딩 에이전트가 팀 채널로 들어오면 무엇이 달라지나
8월 20일 세일즈포스가 슬랙 코드(Slack Code)를 공개했다. 슬랙 채널 안에서 코딩 에이전트에게 일을 시키고, 팀 전원이 무슨 일이 벌어지는지 대화 수준에서 본다. 클로드 코드, 버셀 v0, 코그니션 데빈, OpenAI 챗GPT 같은 기존 에이전트를 태그로 부르는 구조라 에이전트 자체가 슬랙 안에서 도는 것은 아니다.
슬랙 최고마케팅책임자는 개인 작업을 혼자 하는 스포츠에 빗대며, 그렇게 하면 지식과 속도가 개인에게 머물고 조직은 그만큼을 얻지 못한다고 했다. 마케팅 문구를 걷어내면 실제 변화가 하나 남는다. 사양이 오가는 자리와 코드가 만들어지는 자리가 붙는다는 것이다.
지금까지 코딩 에이전트의 결과물은 한 사람의 터미널 안에 있었다. 무엇을 시켰고 에이전트가 어떻게 이해했는지는 그 사람만 봤다. 기획자나 운영 담당이 중간에 '그건 그 뜻이 아니었다'고 끼어들 자리가 없었다. 채널로 옮기면 그 자리가 생긴다.
AX 관점에서 이 흐름은 도구 도입이 아니라 업무 배치의 문제다. 에이전트를 어디에 두느냐가 누가 그 작업을 검토할 수 있는지를 결정한다.
챗GPT가 나이를 추정한다는 것은 어떤 설계인가
8월 18일 OpenAI가 챗GPT 포 틴스(ChatGPT for Teens)를 공개했다. 핵심은 배정 방식이다. 시스템이 사용자를 18세 미만으로 추정하거나 본인이 13~17세라고 밝히면 자동으로 이 버전에 들어간다. 나이를 확인하는 절차가 아니라 추정하는 절차다.
안에 들어 있는 것은 학습 쪽으로 몰려 있다. 답을 바로 주는 대신 질문과 단계로 끌고 가는 스터디 모드, 과제를 그냥 건너뛰려는 정황을 알아채고 스터디 모드로 돌리는 숙제 알림, 퀴즈와 학습 시각화, 그리고 청소년이나 보호자가 스터디 모드를 기본으로 켜 둘 시간대를 지정하는 스터디 아워가 있다.
추정 기반 배정에는 대칭적인 결과가 따라온다. 성인이라도 대화 방식이 그렇게 읽히면 청소년 버전으로 갈 수 있다. 반대로 청소년이 성인처럼 쓰면 걸러지지 않을 수 있다. 나이 확인을 강제하지 않으면서 보호를 넣으려는 설계의 값이다.
기업 입장에서 이 방식이 눈여겨볼 만한 이유는 다른 데 있다. 신분 확인 없이 행동만으로 사용자를 분류해 다른 제품을 주는 구조가 실제 서비스에 들어왔다는 것이다. 같은 설계는 연령 말고 다른 축에도 쓸 수 있다.
음악 모델과 로봇 — 나머지 두 건
8월 17일 알리바바가 음악 생성 모델 해피슈림프 1.0을 베타로 열었다. 분위기나 이야기, 장르를 적으면 멜로디와 편곡과 가사를 쓰고 노래까지 부른다. 가사를 직접 넣어 곡만 붙이게 하거나 연주곡만 요청할 수도 있다. 중국풍, 팝, R&B, 힙합, 록, 펑크, 일렉트로닉, 클래식, 재즈를 다루고, 악기 편성과 보컬 스타일, 곡 안에서 에너지가 오르내리는 방식까지 지정할 수 있다. 회사 설명으로는 오디오를 만들기 전에 곡 구조와 리듬 전개, 화성 진행을 먼저 설계한다.
이 시장의 기존 이름은 수노와 유디오다. 둘은 2024년 미국 음반산업협회의 저작권 소송을 거쳐 협상 테이블에 왔다. 알리바바는 3월에 신설한 알리바바 토큰 허브에서 이 모델을 만들었고, 처음부터 태화음악그룹과 아티스트 공동 창작을 함께 한다고 밝혔다. 소송으로 들어간 자리에 계약으로 들어온 셈이다.
같은 날 유니트리가 휴머노이드 로봇 '슈퍼맨'을 공개했다. 제자리 높이뛰기 2미터, 최고 속도 초속 12.66미터, 시속으로는 45.6킬로미터다. 다리 길이는 0.85미터. 회사는 전 세계 인간의 제자리 높이뛰기 기록과 달리기 기록을 모두 넘어섰다고 밝혔고, 최적화 여지가 많이 남아 있어 앞으로 몇 달 안에 성능이 더 오를 수 있다고 덧붙였다.
숫자보다 눈에 걸리는 것은 기간이다. 개발에 걸린 시간이 3개월 남짓이다. 로봇이 사람보다 높이 뛰고 빨리 달리는 것 자체는 이제 놀랍지 않다. 그 격차가 한 분기 만에 만들어졌다는 쪽이 계획의 시간 단위를 다시 보게 만든다.
그래서 이번 주에 무엇을 하면 되나
첫째, 지금 쓰는 AI 도구의 권한 목록을 한 번 열어 본다. 메일 계정이나 파일 저장소를 연결해 뒀다면 그 연결이 읽기까지인지 보내기·삭제까지인지 확인한다. Claude의 구글 워크스페이스 커넥터라면 설정에서 커넥터별 권한과 승인 기본값을 볼 수 있고, 챗GPT라면 플러그인 목록에서 같은 것을 본다. 개인 계정과 조직 계정에서 기본값이 다를 수 있다는 점을 함께 확인한다.
둘째, 팀에서 쓴다면 승인 기본값을 누가 정하는지 문서로 남긴다. 팀·엔터프라이즈 요금제는 소유자가 구성원별로 승인 없는 실행을 열어 줄 수 있다. 누가 그 권한을 갖고 있는지, 열어 준 기록이 어디에 남는지가 사고 이후에 유일하게 남는 근거다.
셋째, 자료 조사 방식에 확인 단계를 하나 넣는다. 검색 결과에서 바로 인용하지 말고, 1차 출처 페이지를 열어 그 문장이 실제로 있는지 본다. 챗GPT 이후 게시된 페이지 셋 중 하나에서 AI 작성 흔적이 나오는 환경에서는 이 한 단계가 글의 신뢰도를 가른다.
넷째, 외부에 나갈 이미지·영상은 출처를 따로 적어 둔다. 눈에 보이는 워터마크가 사라지면 몇 달 뒤에 그 파일이 어디서 나왔는지 파일만 보고는 알 수 없다. 만들 때 한 줄 적어 두는 비용이 나중에 찾는 비용보다 훨씬 싸다.