사람이 보는 화면과 봇이 받는 문서는 왜 다른가
웹사이트 주소를 열면 서버가 HTML 문서를 하나 보내 줍니다. 브라우저는 그 문서를 받은 뒤에도 일을 더 합니다. 문서에 딸려 온 자바스크립트를 내려받아 실행하고, 그 결과로 글자와 그림을 화면에 채웁니다. 우리가 사이트가 떴다고 말하는 시점은 이 일이 다 끝난 뒤입니다.
검색엔진과 AI가 보내는 프로그램도 같은 주소를 엽니다. 이 프로그램을 봇 또는 크롤러라고 부릅니다. 다만 봇은 브라우저가 아닙니다. 서버가 보낸 HTML을 받아 글자를 뽑아내고 다음 주소로 넘어가는 것이 기본 동작이고, 자바스크립트까지 실행하는 것은 따로 붙여야 하는 기능입니다.
그래서 같은 페이지를 열어도 사람과 봇이 손에 쥐는 문서가 다를 수 있습니다. 그 차이가 어디서 벌어지는지가 다음 절입니다.
CSR과 SSR은 무엇이 다른가
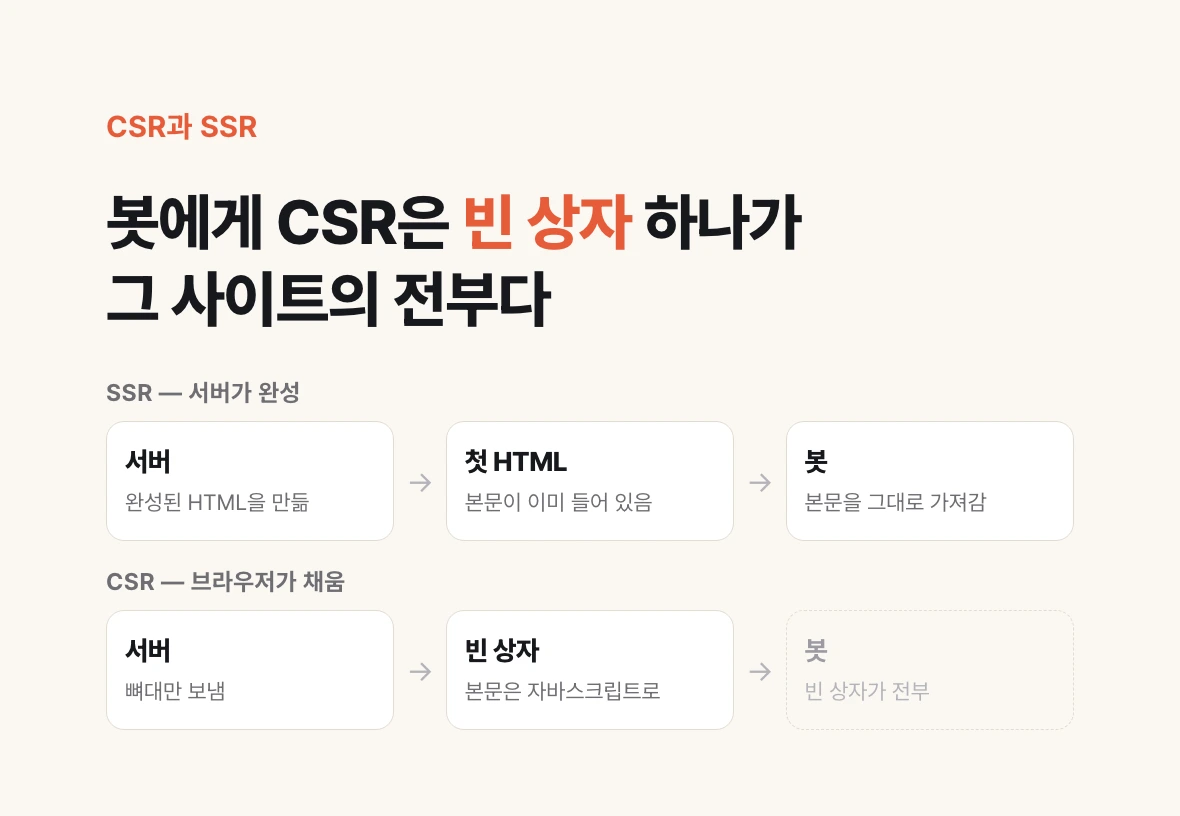
화면에 글자를 채우는 방식은 크게 둘입니다. 서버가 완성된 HTML을 만들어 보내면 서버 사이드 렌더링(Server-Side Rendering, SSR)입니다. 서버는 뼈대만 보내고 브라우저가 자바스크립트를 실행해 내용을 채워 넣으면 클라이언트 사이드 렌더링(Client-Side Rendering, CSR)입니다. 여기서 클라이언트는 내 브라우저를 가리키는 말입니다.
사람 눈에는 둘이 구별되지 않습니다. 화면에 뜬 결과가 같기 때문입니다. 만드는 쪽에서는 CSR이 편한 구석이 많아 기본값으로 자주 선택됩니다.
봇 입장에서는 완전히 다른 문서입니다. SSR이면 서버가 보낸 첫 HTML에 본문이 이미 들어 있습니다. CSR이면 그 자리에 빈 상자 하나만 있고 본문은 자바스크립트가 돌아야 생깁니다. 봇이 자바스크립트를 실행하지 않으면 그 빈 상자가 그 사이트의 전부입니다.
영상에서 이 지점을 진행자가 한 문장으로 되묻고 게스트가 맞다고 답합니다. CSR이라면 GPT 봇은 그 사이트에 들어와도 아무 정보를 못 본다는 것입니다. 사람이 볼 수 있는 정보는 분명히 존재하는데 봇에게는 넘어가지 않는 구조라는 뜻입니다.
내 사이트가 어느 쪽인지 확인하는 법
도구를 설치할 필요도, 만든 사람에게 물어볼 필요도 없습니다. 크롬 브라우저만 있으면 됩니다.
1. 확인하고 싶은 페이지를 크롬에서 엽니다. 회사 소개든 서비스 설명이든, AI가 읽어 주기를 바라는 페이지를 고릅니다.
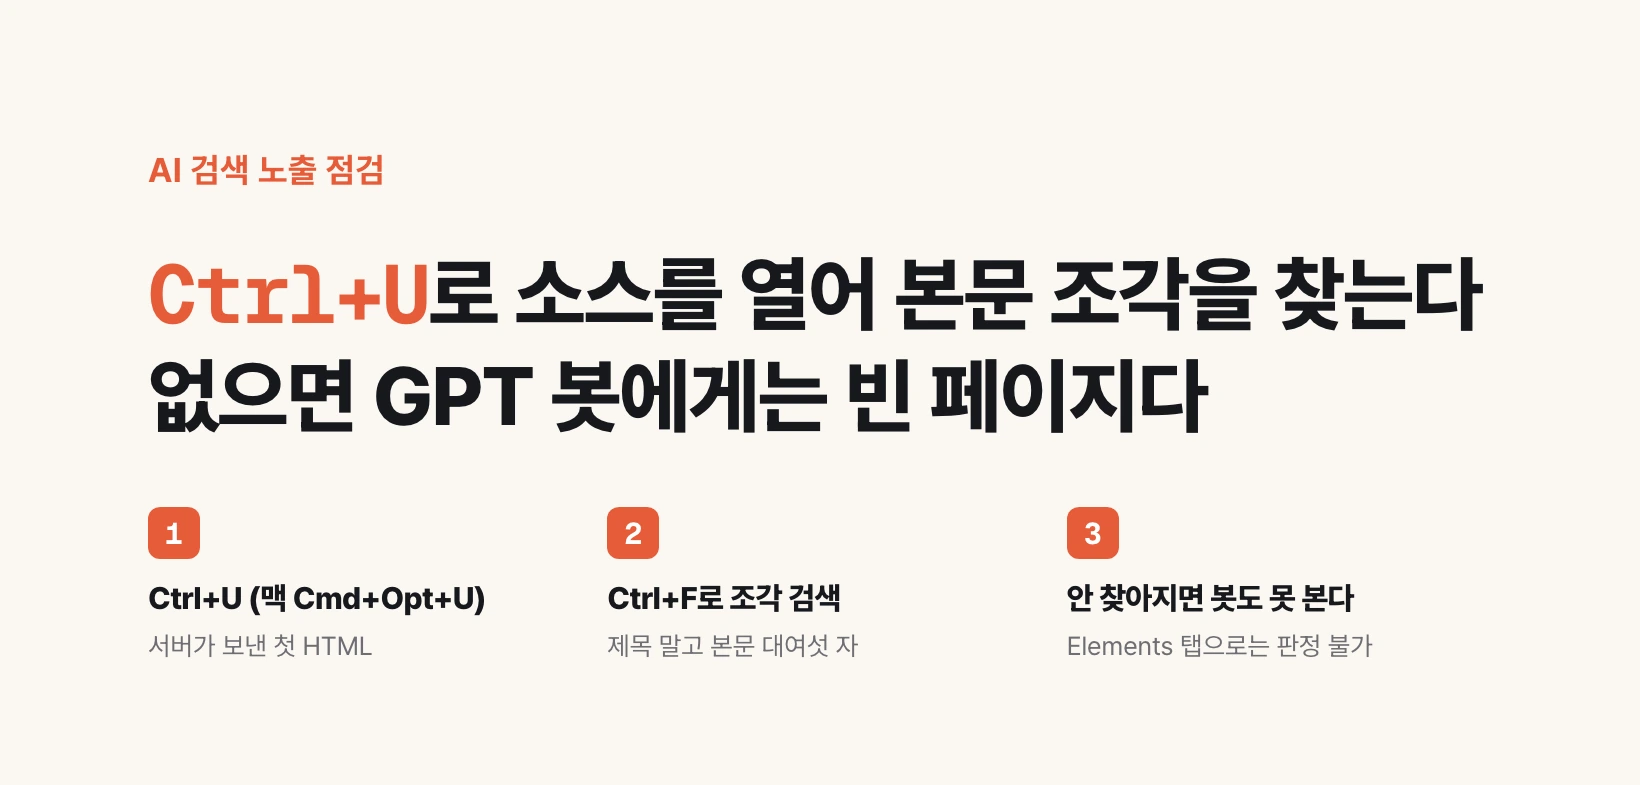
2. 윈도우는 Ctrl+U, 맥은 Cmd+Option+U를 누릅니다. 마우스로 하려면 페이지 빈 곳에서 오른쪽 클릭 후 페이지 소스 보기를 고릅니다. 주소창에 view-source: 를 붙이는 방법도 있지만, 크롬은 붙여넣기로 들어온 view-source: 를 지워 버려서 직접 타이핑해야 합니다. 단축키 쪽이 확실합니다.
3. 새 탭에 글자와 기호가 빽빽한 화면이 뜹니다. 읽으려 애쓰지 않아도 됩니다. 이것이 서버가 처음 보낸 HTML, 곧 봇이 손에 쥐는 문서 전부입니다.
4. 그 화면에서 Ctrl+F(맥은 Cmd+F)를 누르고, 원래 페이지 본문에서 고른 대여섯 글자짜리 짧은 조각을 찾습니다. 문장을 통째로 붙여 넣으면 안 됩니다. HTML에는 문장 중간에 굵게나 링크 같은 태그가 끼어 있어서, 본문이 멀쩡히 실려 있는 사이트도 문장 전체로는 안 잡히는 일이 흔합니다. 조각은 제목이 아니라 본문에서 고릅니다. 제목은 다른 자리에 따로 실려 있어서 판정이 흐려집니다.
5. 찾아지면 그 대목은 서버가 처음부터 실어 보낸 것이고, 자바스크립트를 실행하지 않는 봇도 그 문장을 봅니다. 안 찾아지면 그 문장은 그 봇에게 존재하지 않습니다. 미심쩍으면 본문 다른 곳에서 조각을 두어 개 더 골라 같은 검색을 반복합니다.
판정은 한쪽으로만 확실합니다. 소스에 없으면 자바스크립트를 실행하지 않는 봇은 확실히 못 봅니다. 반대로 소스에 있다고 해서 반드시 인용된다는 뜻은 아닙니다. 그 봇을 robots.txt로 막아 두었다면 애초에 오지 않고, 그건 이 글이 다루는 축이 아닙니다.
개발자 도구로 확인하면 왜 안 되나
여기서 가장 자주 틀립니다. F12를 눌러 나오는 개발자 도구의 Elements 탭에도 HTML이 보입니다. 그런데 그 화면에서는 본문 문장이 언제나 찾아집니다. CSR이든 SSR이든 마찬가지입니다.
두 화면이 서로 다른 시점을 보여 주기 때문입니다. 페이지 소스 보기는 서버가 보낸 원본 문서입니다. 개발자 도구의 Elements는 자바스크립트가 다 실행된 뒤, 지금 화면을 만들고 있는 상태입니다. 봇이 받는 것은 앞쪽입니다.
확인은 반드시 페이지 소스 보기로 합니다. 개발자 도구에서 본문이 보인다는 것은 이 판정에 아무 정보도 주지 않습니다.
봇이 자바스크립트를 실행하는지는 실제로 측정된 적이 있나
각 회사가 문서로 밝혀 두지는 않았습니다. OpenAI의 크롤러 문서는 크롤러 이름과 용도만 적어 둡니다. OAI-SearchBot은 ChatGPT 검색 결과 노출용, GPTBot은 모델 학습용, ChatGPT-User는 사용자가 시켜서 페이지를 여는 경우입니다. 자바스크립트 렌더링 여부는 이 문서에 언급이 없습니다.
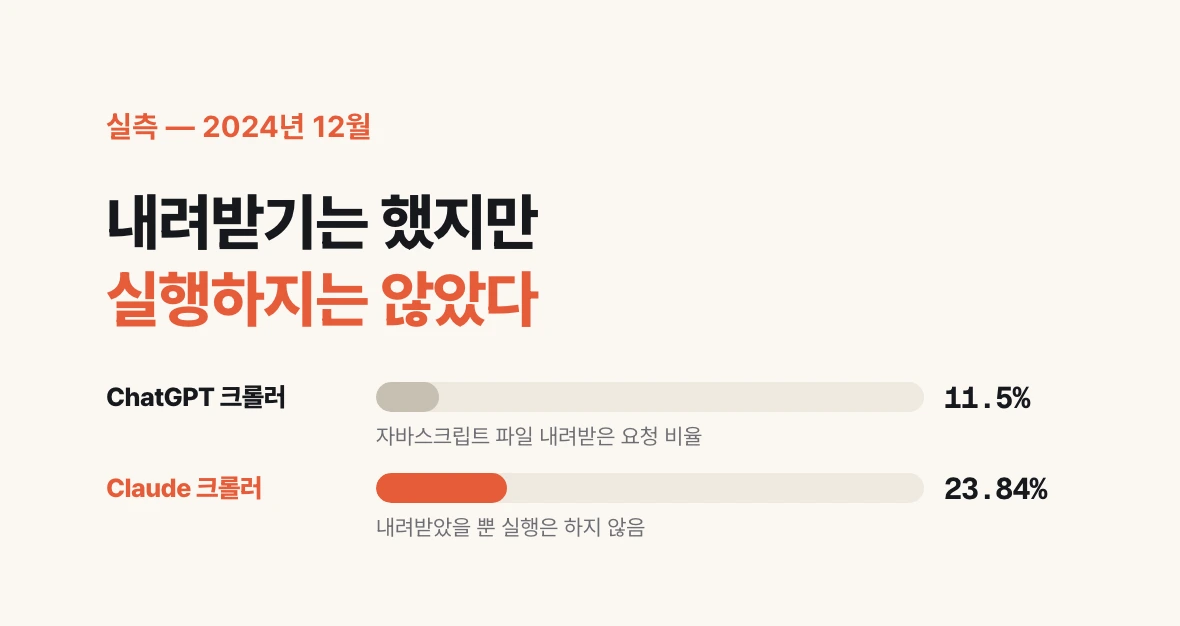
실측은 사이트를 운영하는 쪽에서 나왔습니다. Vercel과 Merj가 2024년 12월 17일에 낸 The rise of the AI crawler는 실제 크롤러 트래픽을 집계해, 주요 AI 크롤러 중 자바스크립트를 렌더링하는 곳이 없다고 보고했습니다. ChatGPT 크롤러는 요청의 11.50%, Claude 크롤러는 23.84%에서 자바스크립트 파일을 내려받기는 했지만 실행하지는 않았습니다.
구글은 예외입니다. 구글봇은 자바스크립트를 실행하고, 제미나이가 그 인프라를 씁니다. 그래서 구글 검색에서는 잘 잡히는 페이지가 ChatGPT 답변에는 한 번도 안 나오는 일이 생깁니다. 검색 순위가 멀쩡하다는 사실이 AI 인용의 근거가 되지 못하는 이유입니다.
이 수치는 2024년 12월 기준입니다. 크롤러 동작은 회사가 언제든 바꿀 수 있으니 숫자보다 확인 방법 쪽을 손에 쥐는 편이 오래갑니다. 앞 절의 소스 보기는 오늘 상태를 보여 줍니다.
소스에 본문이 없을 때 오늘 할 수 있는 것
렌더링 구조를 바꾸는 것이 정공법입니다. 쓰고 있는 도구 설정에 정적 생성이나 서버 렌더링 옵션이 있으면 그쪽으로 돌립니다. 다만 이건 만든 사람이나 도구의 도움이 필요한 일이고 하루 안에 끝나지 않을 수도 있습니다.
그 전에 오늘 할 수 있는 것이 있습니다. title과 meta description은 서버가 보내는 첫 HTML에 들어 있어서 CSR이어도 대개 살아남습니다. 소스 보기 화면에서 title 과 description 을 Ctrl+F로 찾으면 지금 뭐라고 적혀 있는지 그 자리에서 보입니다.
그 두 줄에 우리가 무슨 회사이고 무엇을 파는지 한 문장으로 넣습니다. 모든 페이지에 같은 문장이 박혀 있는 경우가 흔한데, 페이지별로 갈라 주면 봇이 가져갈 정보가 그만큼 늘어납니다.
정보가 이미지 안에만 들어 있는 페이지도 같은 문제입니다. 상품 상세나 회사 소개가 이미지 한 장으로 되어 있으면 봇은 그 안의 글자를 가져가지 못합니다. 영상에서는 배경만 이미지로 두고 내용은 텍스트로 심어 두는 방식이 언급됩니다. 사람 눈에는 이미지처럼 보이지만 봇에게는 글자로 남습니다.
SSR이면 끝났다고 봐도 되나
아닙니다. 영상에서는 같은 SSR이라도 GPT가 못 받는 경우가 있다고 짚습니다. 화면 일부를 나중에 따로 보내는 방식을 쓰면 정보가 도착하는 순서와 시점이 달라지기 때문입니다.
그래서 판정은 구조 이름이 아니라 실제 소스 화면으로 합니다. 우리는 SSR이니까 괜찮다가 아니라, 지금 이 페이지의 소스에 이 문장이 있는가로 봅니다.
페이지마다 결과가 다를 수 있습니다. 홈은 나오는데 서비스 상세는 안 나오는 경우가 흔합니다. AI가 읽어 주기를 바라는 페이지를 서너 개 정해 각각 확인합니다.
콘텐츠를 더 쌓기 전에 볼 것
AI 검색 노출을 이야기할 때 대개 어떤 글을 더 쓸 것인가에서 시작합니다. 그런데 봇이 본문을 아예 못 받아 가는 상태라면 글을 몇 편 더 얹어도 결과는 같습니다.
순서는 확인이 먼저입니다. 소스 보기 한 번, 본문에서 고른 조각 하나 검색. 30초면 지금 어느 쪽인지 압니다.