ARC-AGI-3는 무엇을 재는 시험인가
AI 성능 시험은 대개 아는 것을 묻는다. 수학 문제를 풀게 하고, 코드를 짜게 하고, 시험 문제를 내준다. 잘 외우고 잘 정리한 모델이 좋은 점수를 받는다.
ARC-AGI-3는 반대다. AI를 처음 보는 환경에 던져 놓고 설명서를 주지 않는다. 규칙이 무엇인지, 목표가 무엇인지, 어떻게 해야 성공인지를 알려 주지 않는다. AI가 직접 이것저것 눌러 보고 결과를 관찰하면서 스스로 알아내야 한다.
어린아이가 처음 보는 게임기를 붙잡은 상황과 같다. 설명서는 없고 버튼만 여러 개 있다. 아이는 눌러 보고, 화면이 바뀌는 것을 보고, 어떤 버튼이 무엇을 하는지 짐작하고, 목표가 무엇인지 추측한다. 이 과정을 AI가 할 수 있느냐를 재는 시험이다.
ARC Prize라는 비영리 단체가 만들고 채점한다. 만든 사람들이 이 시험을 AGI의 지표로 내세우는 이유가 여기에 있다. 외운 것을 꺼내는 능력이 아니라, 배운 적 없는 상황에서 스스로 방법을 만들어 내는 능력을 재기 때문이다.
7.8에서 99.9로 — 숫자를 정확히 읽는 법
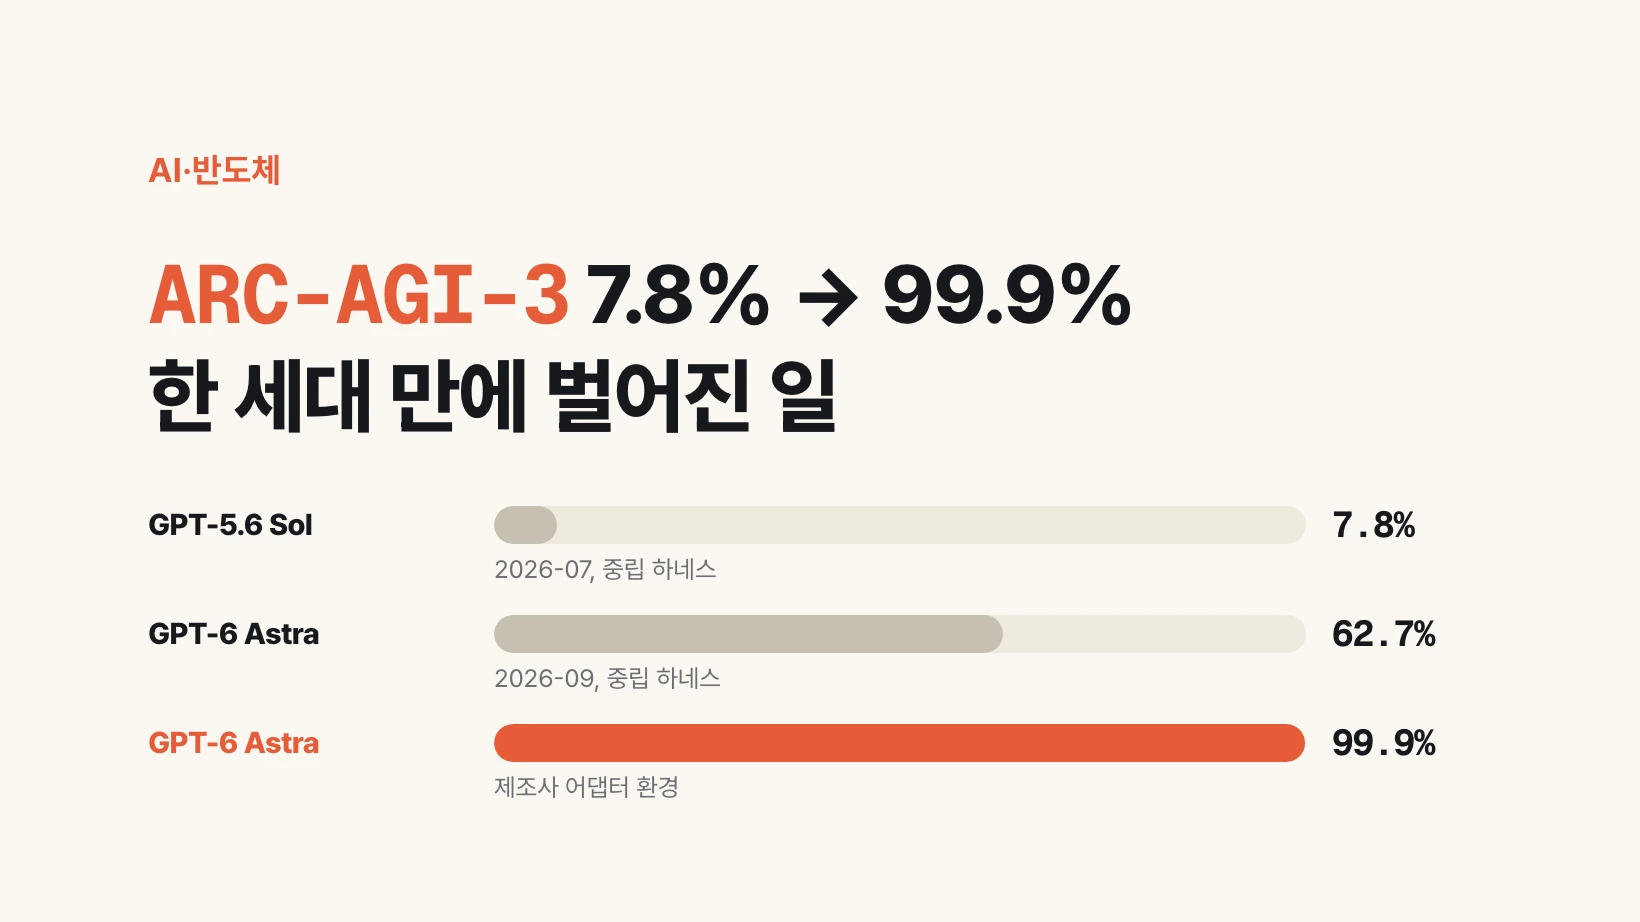
이 시험은 2026년 3월에 공개됐다. 처음에는 가장 잘하는 모델이 0.37%였다. 사실상 아무도 못 풀었다는 뜻이다.
7월에 OpenAI의 GPT-5.6 Sol이 7.8%를 받았다. 이 시험에서 게임 하나라도 실제로 깬 첫 모델이었다. 같은 기준에서 Claude Opus 5는 30.2%였다.
그리고 2026년 9월 3일, GPT-6 Astra가 99.9%를 받았다. 이 수치를 옮길 때 반드시 함께 적어야 하는 조건이 하나 있다. 점수가 두 개라는 것이다.
ARC Prize는 두 가지 실행 환경에서 잰다. 하나는 어느 회사에나 똑같이 적용하는 중립 하네스(Standard harness)이고, 다른 하나는 제조사가 자기 모델에 맞게 만든 어댑터를 붙인 환경(Provider Adapter harness)이다. Astra는 중립 하네스에서 62.7%, 제조사 어댑터 환경에서 99.9%를 받았다. 같은 모델인데 37%포인트가 차이 난다.
차이가 나는 이유는 어댑터가 모델의 내부 추론 상태를 요청과 요청 사이에 그대로 이어 주기 때문이다. 사람으로 치면 앞에서 생각하던 흐름을 끊지 않고 계속 이어 가는 것과 같다. ARC Prize 측정에 따르면 그 덕에 전체 소요 시간이 약 3.66배 빨라지고 토큰은 49% 덜 썼다.
즉 99.9%는 잘못된 숫자가 아니라 조건이 붙은 숫자다. 그리고 조건을 빼고 중립 기준만 봐도 7.8%에서 62.7%다. 한 세대 만에 여덟 배다. 어느 쪽으로 재든 방향은 같다.
바뀐 것은 점수가 아니라 능력의 종류다
숫자보다 중요한 것은 무엇을 할 수 있게 됐느냐다.
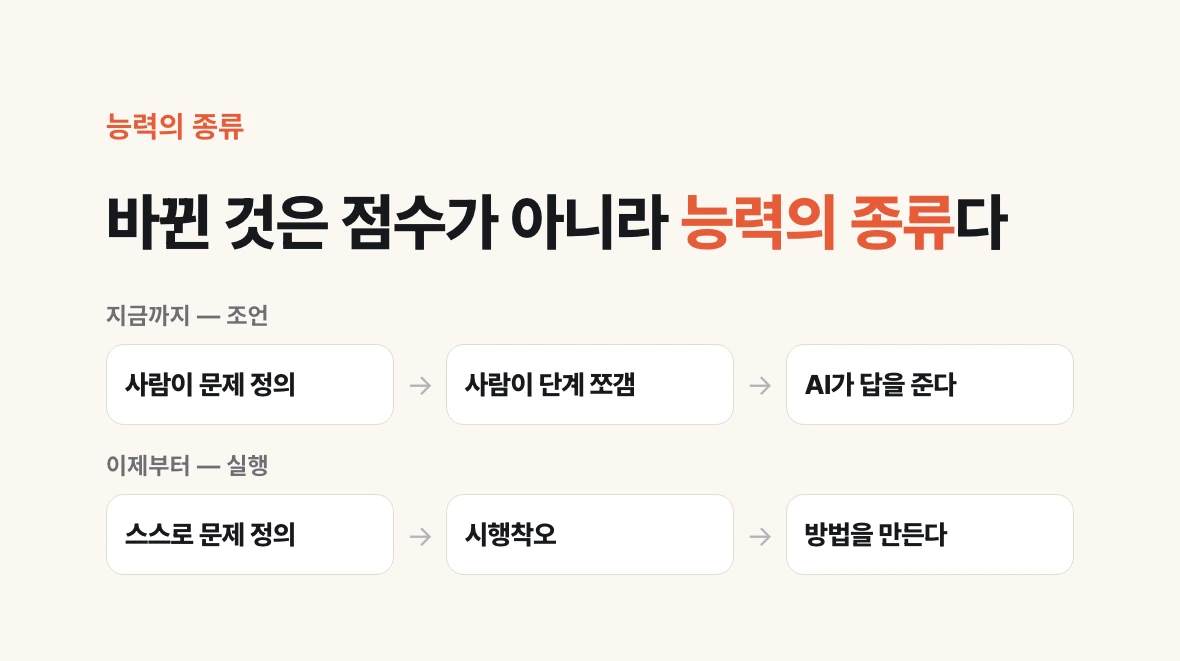
지금까지 AI의 쓸모는 대체로 조언이었다. 물어보면 답을 주고, 엑셀 수식을 만들어 주고, 메일 초안을 써 주고, 발표 자료 구성을 잡아 준다. 잘하지만 전부 사람이 시켜야 시작된다. 사람이 문제를 정의하고, 사람이 단계를 쪼개고, 사람이 다음에 무엇을 할지 정해 준다.
ARC-AGI-3가 재는 것은 그 앞 단계다. 문제가 무엇인지부터 스스로 정의하고, 시행착오를 거치고, 방법을 만들어 낸다. 이 시험 점수가 뛰었다는 것은 AI가 사람의 지시 없이 낯선 일에 착수할 수 있게 됐다는 뜻이다.
ARC Prize가 함께 공개한 관찰이 이 변화를 더 구체적으로 보여 준다. Astra는 전체 레벨의 96.0%에서 사람 기준선보다 적은 수의 행동으로 문제를 풀었고, 레벨당 평균 행동 수가 사람보다 51.7% 적었다. 게임 규칙을 추적하려고 스스로 표기법을 만들어 쓰기도 했고, 작업 공간이 주어지면 그 게임 전용 도구를 직접 만들어 쓰기도 했다.
경제적으로 보면 이 차이가 전부다. 조언하는 AI의 가치는 사람의 시간을 아껴 주는 데서 그친다. 스스로 일하는 AI의 가치는 사람이 하던 노동 자체를 대신하는 데까지 간다.
왜 이것이 메모리 이야기가 되는가
여기서 반도체로 넘어간다. 연결 고리는 토큰이다.
토큰은 AI가 글을 처리하는 단위다. 한국어로는 대략 한두 글자, 영어로는 단어 조각 하나쯤 된다. AI에게 무언가를 시킬 때 드는 비용과 연산량은 결국 이 토큰을 몇 개나 처리했느냐로 정해진다.
사람이 챗봇에 하루 질문 열 개를 던진다고 하자. 질문과 답을 합쳐 봐야 토큰 수천 개다. 그런데 에이전트가 한 가지 일을 맡아 몇 시간 동안 돌면 이야기가 달라진다. 브라우저를 열고, 검색하고, 결과를 읽고, 아닌 것 같으면 다른 것을 찾고, 프로그램을 돌려 보고, 실패하면 원인을 읽고 다시 시도한다. 그 모든 중간 단계가 전부 토큰이다.
여기에 병렬이 붙는다. 한 사람이 에이전트를 다섯 개 동시에 돌리면 소비는 다섯 배가 아니다. 각 에이전트가 이미 사람 한 명분의 시행착오를 하고 있기 때문에, 자릿수가 바뀐다.
연산이 늘면 필요한 것은 GPU만이 아니다. 모델이 긴 맥락을 붙들고 여러 단계를 이어 가려면 그 상태를 어딘가에 담아 둬야 한다. 그 자리가 HBM이라고 부르는 고대역폭 메모리다. 그리고 HBM을 잔뜩 꽂은 서버 옆에는 일반 D램도 함께 늘어난다. 결국 에이전트가 늘면 메모리 수요가 늘어난다.
챗GPT가 처음 나왔을 때 반도체 주가가 움직인 구조가 이것이었다. 이번에 달라진 점은 수요를 만드는 주체가 질문을 던지는 사람이 아니라, 스스로 몇 시간씩 일하는 AI라는 것이다.
시장은 이미 그렇게 읽었다
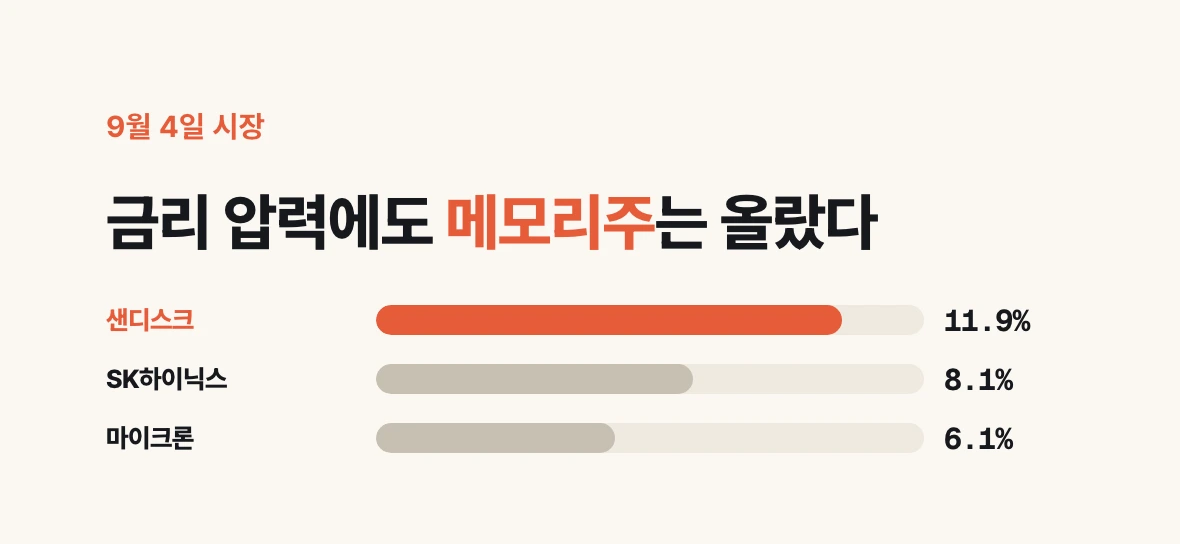
발표 다음 날인 2026년 9월 4일 시장 반응이 이 해석을 뒷받침한다.
이날은 메모리주에 불리한 조건이 하나 깔려 있었다. 미국 고용지표가 예상을 크게 웃돌아 금리 인상 압력이 커졌다. 금리가 오르면 주식 가치 평가에 부담이 된다. 그런데도 샌디스크가 11.9%, SK하이닉스가 8.1%, 마이크론이 6.1% 올랐다.
공급 쪽 숫자도 같은 방향이다. 서스쿼해나는 이번 분기 D램 계약 가격이 50% 이상, 낸드가 약 60% 오를 것으로 봤다. 남의 전망이므로 그대로 믿을 것은 아니고, 주체를 밝혀 한 줄로만 적는다.
다만 이 글은 무엇을 사라는 이야기가 아니다. 벤치마크 하나가 종목의 미래를 정하지 않는다. 여기서 확인할 수 있는 것은 방향이지 가격이 아니다.
오늘 해볼 수 있는 것
이 변화를 기사로 읽는 것과 손으로 겪는 것은 다르다. 오늘 할 수 있는 것이 두 가지 있다.
첫째, 지시 방식을 바꿔 본다. 지금까지 프롬프트를 정교하게 짜는 데 시간을 썼다면, 이번에는 원하는 결과만 한두 문장으로 말하고 맡겨 본다. 단계를 쪼개 주지 않고, 중간에 끼어들지 않는다. Astra를 먼저 써 본 사람들이 공통적으로 말하는 변화가 이것이다. 복잡한 지시문을 설계하는 대신 결과를 말하는 쪽이 더 잘 나온다는 것이다.
둘째, 그 한 번에 토큰이 얼마나 나갔는지 확인한다. ChatGPT나 Claude의 사용량 화면, 또는 API를 쓴다면 대시보드에서 볼 수 있다. 평소 질문 한 개와 비교해 본다. 슈퍼사이클 논리의 근거가 그 두 숫자의 차이 안에 있다.
숫자를 옮길 때 하나만 더 기억하면 좋다. 이 글에서 99.9%를 그냥 쓰지 않고 62.7%를 함께 적은 이유가 있다. 발표 수치에는 대개 조건이 붙어 있고, 조건을 확인하는 습관이 벤치마크를 읽는 유일한 방법이다. AI 도구를 고를 때도 같은 습관이 그대로 쓰인다.