여기서부터는 다른 이야기다
앞의 세 편은 모델을 만드는 이야기였다. 지금부터는 다 만들어진 모델이 우리 질문에 답을 만들어 내는 이야기, 추론이다.
이 둘을 갈라 두는 것이 중요하다. 학습은 모델 내부의 값을 바꾸는 일이고, 추론은 바뀐 적 없는 모델을 그냥 쓰는 일이다. 실무 대화에서 가장 자주 어긋나는 지점이 여기다.
채팅창에 글을 넣고 보내기를 누른 순간부터 답이 한 글자씩 나오기까지, 안에서 무슨 일이 벌어지는지 순서대로 따라가 보자.
먼저 숫자가 된다
입력한 글은 1편에서 본 대로 토큰으로 쪼개진다. 그리고 모든 토큰에는 고유 번호가 붙어 있다. 단어집이 20만 개면 0번부터 20만 번까지 번호가 매겨져 있는 셈이다.
그래서 글이 먼저 번호의 나열로 바뀐다. 그런데 번호만으로는 부족하다. 17번과 18번이 뜻이 비슷하다는 보장이 없기 때문이다. 번호는 그냥 이름표일 뿐이다.
그래서 각 번호를 의미를 담은 숫자 묶음으로 바꾼다. 이 변환을 임베딩이라고 한다. 임베딩을 거치면 뜻이 비슷한 토큰끼리 수치적으로도 가까운 자리에 놓인다.
임베딩이라는 말이 낯설지 않다면 RAG에서 이미 들었기 때문일 것이다. 문서를 벡터로 바꿔 벡터 데이터베이스에 넣는다고 할 때의 그 임베딩과 같은 개념이다. 마지막 편에서 다시 만난다.
추론기는 여러 겹으로 되어 있다
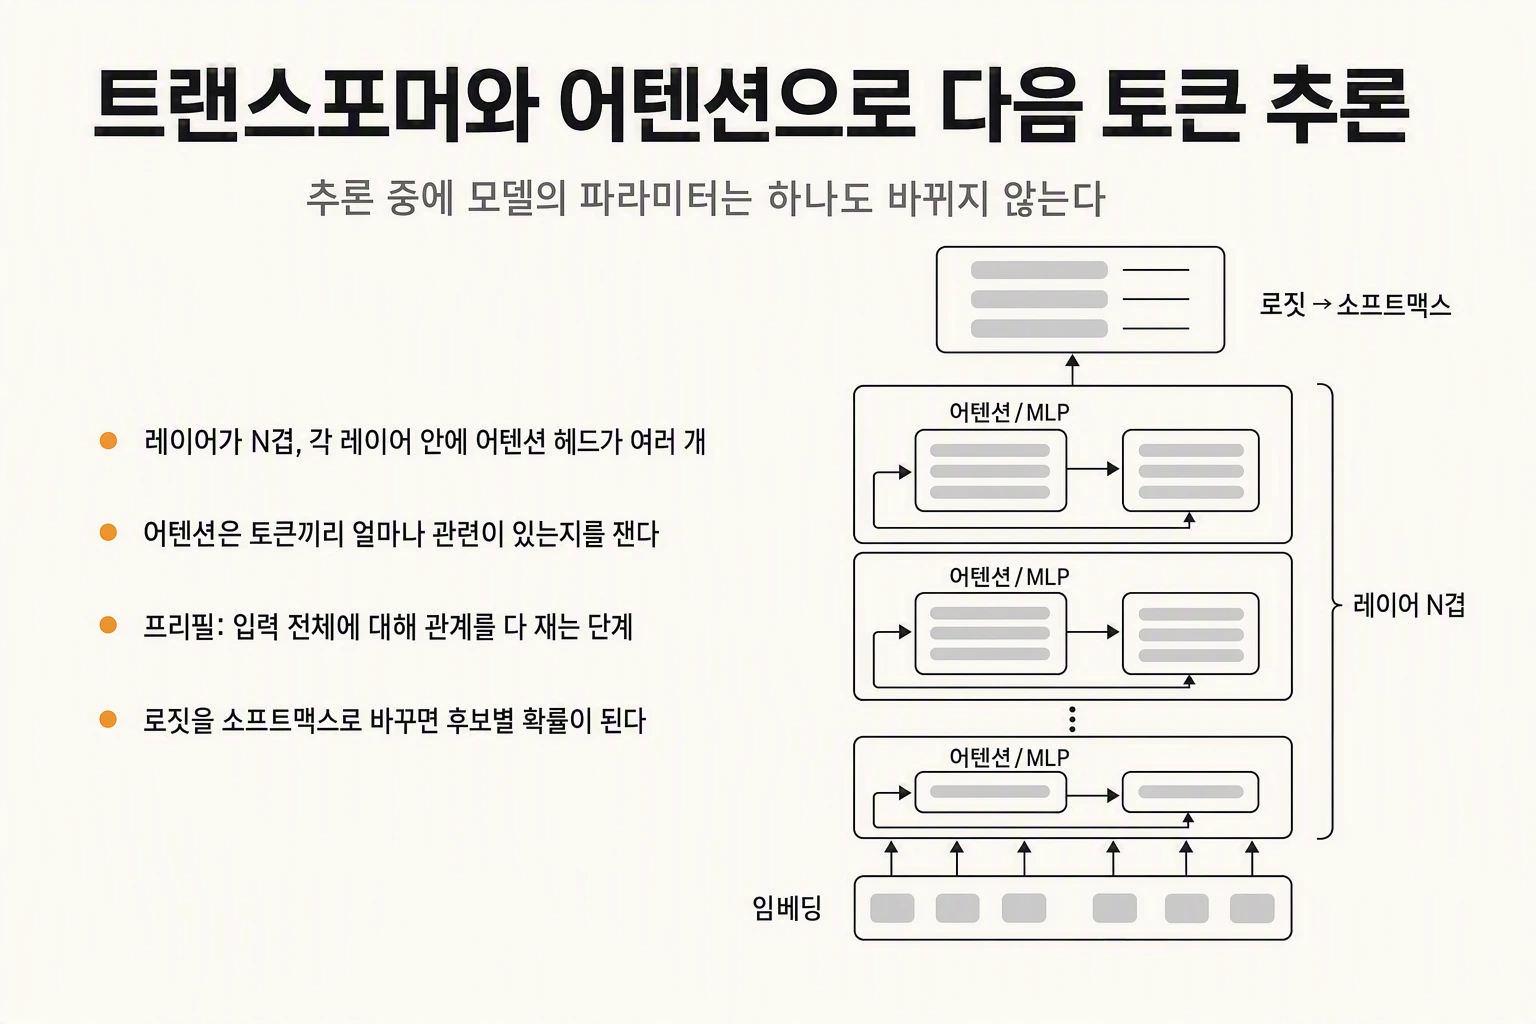
임베딩까지 끝나면 이제 본격적인 추론이 시작된다. 추론기는 레이어라고 부르는 층이 여러 겹 쌓인 구조다.
레이어 1을 통과한 결과가 레이어 2로 들어가고, 그것이 레이어 3으로 들어가는 식으로 N겹을 지난다. 그리고 각 레이어 안에서 벌어지는 일은 사실상 같다.
왜 같은 일을 여러 번 반복하는가. 한 번으로는 관계를 충분히 파악하지 못하기 때문이다. 겹을 지날수록 후보가 정교해진다. 그래서 레이어 수가 많을수록 추론 한 번에 드는 계산이 늘어난다.
이 구조를 부르는 이름이 트랜스포머다. LLM은 트랜스포머라는 방식으로 다음 토큰을 추론하는 물건이다.
어텐션 — 관계를 재는 일
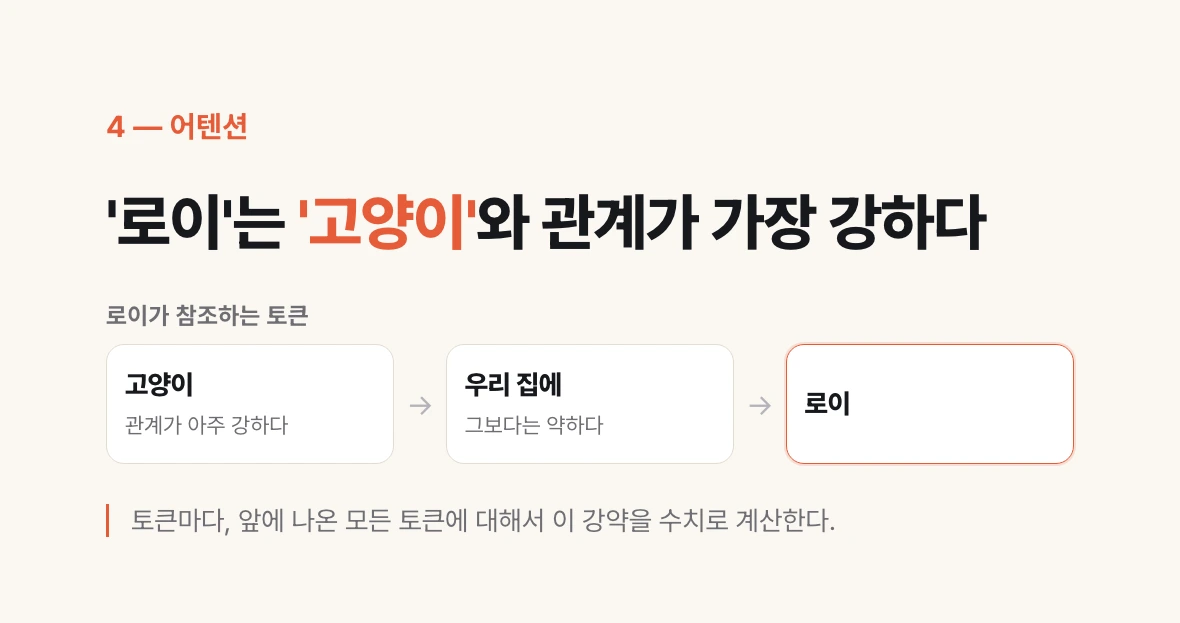
레이어 안에서 벌어지는 핵심 작업이 어텐션이다. 하는 일은 한 문장으로 요약된다. 토큰끼리 서로 얼마나 관련이 있는지를 재는 것이다.
예를 들어 보자. '저희 집 고양이 이름은 로이예요. 품종은 벵갈이에요. 로이는 우리 집에 사는 고양이입니다.'
여기서 마지막 문장의 '로이'는 앞 문장의 '고양이'와 관계가 아주 강하다. '우리 집에'와도 어느 정도 관계가 있지만 그보다는 약하다. 어텐션은 이 강약을 전부 수치로 계산한다. 토큰마다, 앞에 나온 모든 토큰에 대해서.
그리고 계산된 값을 그대로 두면 특징이 흐릿하다. 그래서 후가공을 한 번 거쳐 두드러진 것을 더 두드러지게 만든다. 이 후가공 부분을 MLP라고 부른다.
이 어텐션 계산 자체도 레이어 안에서 여러 갈래로 동시에 일어난다. 그 갈래 하나를 어텐션 헤드라고 부른다. 즉 레이어가 N겹인데 각 레이어 안에서 헤드가 또 여러 개다. 반복의 반복이라 실제 계산 횟수가 대단히 커진다.
왜 이 방식이 판을 바꿨나
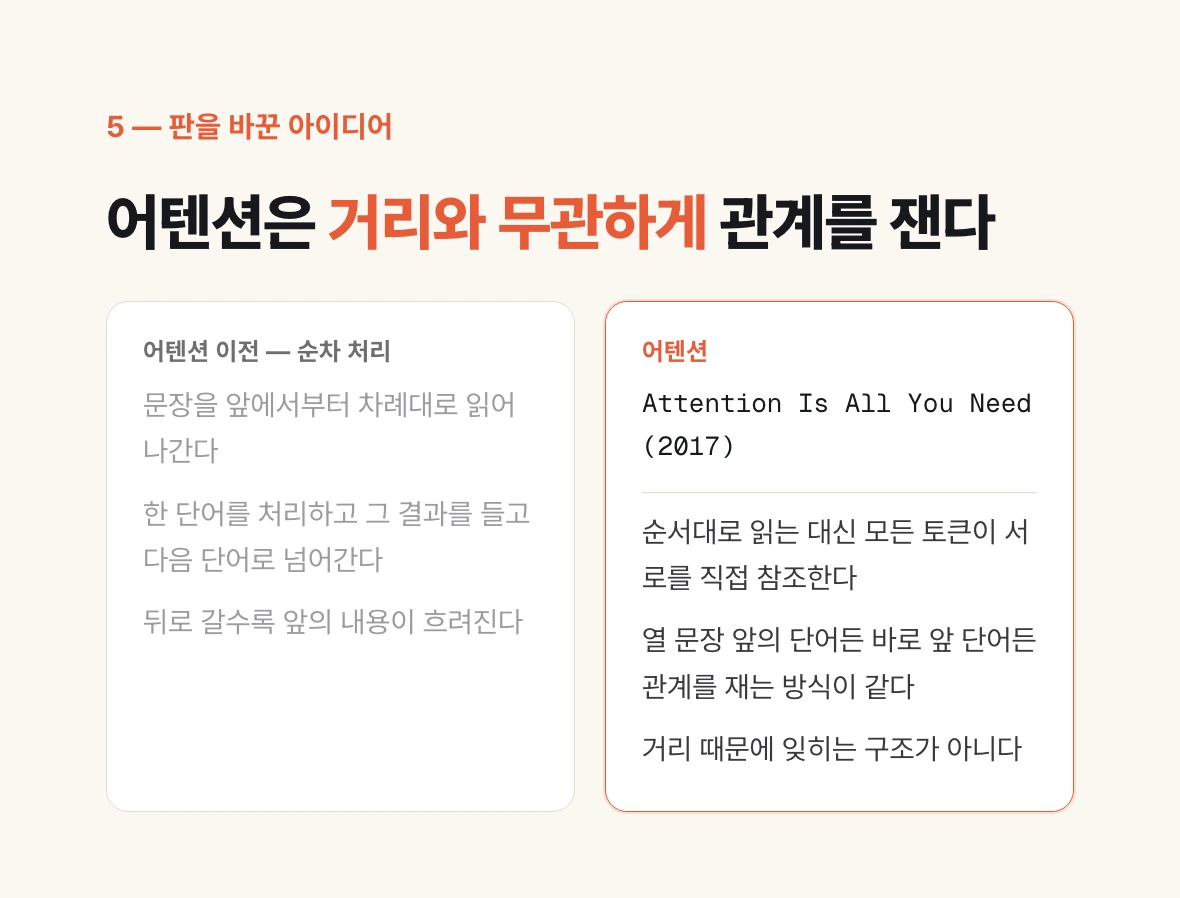
어텐션이 등장하기 전 자연어 처리는 문장을 앞에서부터 차례대로 읽어 나가는 방식이 주류였다. 한 단어를 처리하고 그 결과를 들고 다음 단어로 넘어가는 식이다.
이 방식에는 구조적인 약점이 있었다. 뒤로 갈수록 앞의 내용이 흐려진다는 것이다. 짧은 문장에서는 문제가 없지만, 소설처럼 긴 글에서 앞에 나온 이름을 뒤에서 '그것'으로 받으면 무엇을 가리키는지 놓쳤다.
어텐션은 순서대로 읽는 대신 모든 토큰이 서로를 직접 참조하게 한다. 열 문장 앞의 단어든 바로 앞 단어든 관계를 재는 방식이 같다. 거리 때문에 잊히는 구조가 아니다.
이 아이디어를 제시한 것이 2017년 구글 연구진의 논문 'Attention Is All You Need'다. 지금 쓰는 거의 모든 LLM이 여기서 갈라져 나왔다. 발표 당시에는 연구진 자신도 이만한 파장을 예상하지 못했다.
보내기를 누른 뒤 잠시 멈추는 이유
채팅창에 긴 글을 붙여넣고 보내면 잠깐 멈췄다가 답이 나오기 시작한다. 그 뒤로는 글자가 빠르게 이어진다.
처음 멈춰 있는 동안 하는 일이 방금 본 어텐션 계산이다. 입력 전체에 대해 관계를 다 재는 단계이고, 이 구간을 프리필이라고 부른다.
여기서 놓치기 쉬운 것이 있다. 계산 대상은 우리가 입력한 글만이 아니다. 눈에 보이지 않는 시스템 프롬프트, 이전 대화 내역, 각종 설정값이 함께 들어간다. 화면에 보이는 것이 전부가 아니다.
그래서 입력이 길어지면 이 대기 시간이 눈에 띄게 늘어난다. 대화가 길어질수록 첫 응답이 느려지는 것도 같은 이유다. 매번 앞의 내역을 다시 계산에 넣기 때문이다.
후보에 점수가 매겨진다
레이어를 다 통과하면 다음에 올 토큰의 후보들이 점수와 함께 나온다. 학습을 마친 모델이므로 '점심 메뉴는' 다음에 자동차가 1위로 오는 일은 없다. 음식 이름들이 위쪽에 줄을 선다.
이때 나오는 값은 확률이 아니라 그냥 점수다. 4.3, 1.7, 0.4 같은 숫자이고 음수도 나온다. 이 날것의 점수를 로짓이라고 부른다.
그대로는 다루기 불편하니 전부 더해서 1이 되도록 바꾼다. 그러면 각 후보가 몇 퍼센트인지로 읽을 수 있다. 이 변환을 소프트맥스라고 한다.
이렇게 해서 '다음에 올 토큰 후보와 각각의 확률'이 만들어졌다. 여기까지가 한 토큰을 뽑기 위한 준비다.
추론 중에 모델은 바뀌지 않는다
여기서 반드시 짚어야 할 것이 있다. 지금까지 본 추론 과정에서 모델의 파라미터는 단 하나도 바뀌지 않는다.
2편에서 본 조절 손잡이들은 학습 때 맞춰진 그대로 고정되어 있다. 추론은 그 고정된 설정으로 계산을 흘려보내는 일이다. 손잡이를 건드리는 것은 학습뿐이고, 그건 연산 비용이 완전히 다른 차원이라 대화 중에 일어날 수 없다.
그래서 '어제 알려줬는데 오늘 또 모른다'는 현상이 생긴다. 대화에서 알려준 내용은 그 대화의 입력에 들어 있었을 뿐 모델에 새겨진 적이 없다. 새 대화를 열면 그 입력이 사라진다.
같은 질문에 어제와 오늘 답이 다른 것도 학습 때문이 아니다. 그 이유는 다음 편에서 본다.
아직 한 글자도 안 나왔다
여기까지 해서 후보 목록과 확률이 나왔다. 그런데 답은 아직 한 글자도 나오지 않았다. 이 중에서 실제로 무엇을 고를지가 남아 있기 때문이다.
1위를 항상 고르면 될 것 같지만 그렇게 하지 않는다. 그리고 그 선택 방식이 우리가 API에서 만지는 temperature, top-k, top-p라는 값들이다.
다음 편에서는 그 고르는 단계를 본다. 같은 질문에 답이 매번 조금씩 달라지는 이유가 거기 있다.