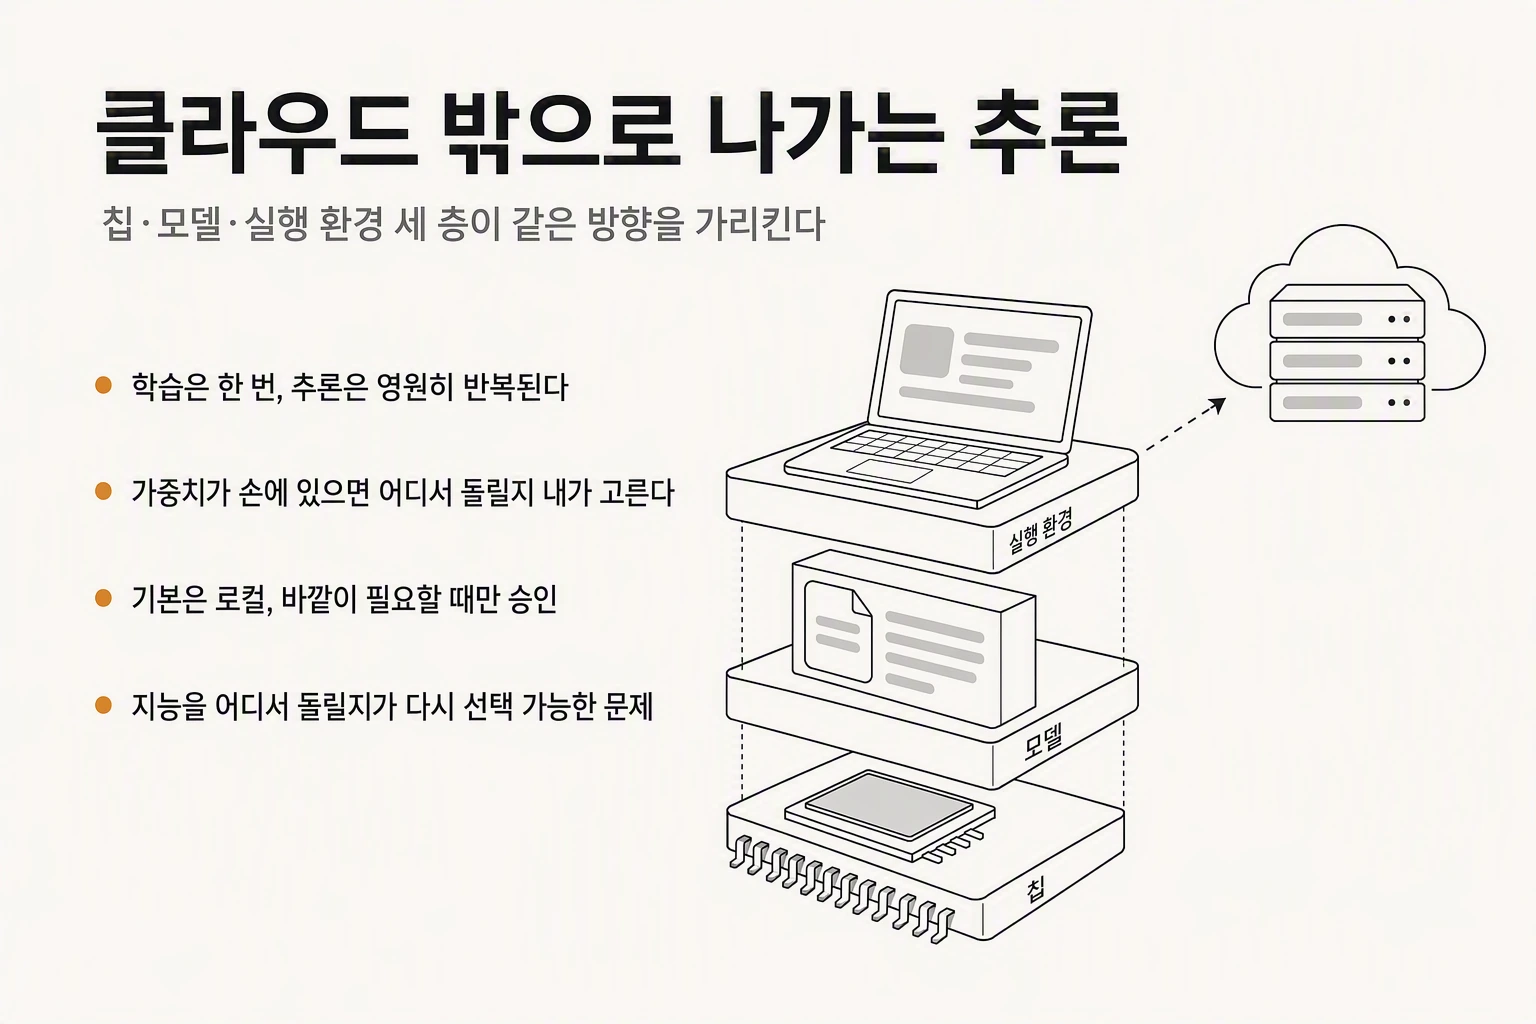
추론이란 무엇인가, 그리고 왜 지금 비용 문제가 됐나
AI 모델을 쓰는 일은 크게 두 단계로 나뉜다. 하나는 학습(training)이다. 방대한 데이터를 흘려 넣어 모델의 가중치를 만드는 단계이고, 한 번 끝내면 그 모델을 쓰는 동안 다시 하지 않는다. 다른 하나가 추론(inference)이다. 우리가 프롬프트를 입력하고 답을 받는 그 순간이 추론이다.
학습은 한 번이지만 추론은 사용자 수 곱하기 요청 수만큼 영원히 반복된다. 그래서 서비스를 오래 운영할수록 전체 비용에서 추론이 차지하는 비중이 커진다. 게다가 에이전트가 등장하면서 요청 한 건이 한 번의 추론으로 끝나지 않게 됐다. 도구를 부르고, 결과를 읽고, 다시 판단하는 과정을 수십 번 반복하므로 지연이 단계마다 누적된다.
여기에 두 번째 문제가 겹친다. 폐쇄형 모델의 API로 지능에 접근하면 요청 한 건마다 사내 문서와 코드가 회사 밖 클러스터로 나간다. 개인이 쓸 때는 넘어갈 수 있지만, 조직 전체가 에이전트를 돌리기 시작하면 토큰 지출과 데이터 이동을 관리하기 어려워진다.
이번 주 소식들은 이 두 문제에 대한 서로 다른 답이다. 칩을 직접 만들거나(비용), 가중치를 여는 모델을 쓰거나(선택권), 아예 내 기계에서 돌리거나(데이터).
OpenAI Jalapeño: 모델 회사가 칩을 직접 만들면 무엇이 달라지나
OpenAI가 자체 추론 칩 Jalapeño의 첫 측정 결과를 공개했다. 이름 그대로 추론 전용이고, 새 모델을 학습시키는 용도가 아니다.
측정은 SemiAnalysis가 만든 공개 벤치마크 InferenceX에서 했다. 여기서 중요한 대목은 테스트에 쓴 모델이 GPT-OSS 120B, DeepSeek R1 670B, Kimi K2.5 1T — 즉 누구나 받아서 직접 돌려 볼 수 있는 오픈웨이트 모델이라는 점이다. 자사 폐쇄형 모델로 재면 아무도 검증할 수 없지만, 공개 모델로 재면 다른 회사가 다른 칩에 같은 모델을 올려 대조할 수 있다.
결과는 세 모델 모두에서 최고 처리량 기준 와트당 처리량이 비교 상용 시스템 대비 1.5~1.9배, 종단 지연이 1.7~3.6배 낮았다. 가장 큰 모델인 Kimi에서는 와트당 성능 약 1.5배, 종단 지연 3.4배 낮음이었다. 칩 정격은 700W인데 실측 지속 전력은 550W 이하였다. 내부 자사 프런티어 모델 테스트에서는 격차가 더 벌어졌다고 밝혔는데, 이 부분은 외부에서 검증할 수 없다.
설계에서 테이프아웃까지 9개월이 걸렸고, 그 과정에 자사 모델을 썼다고 한다. 배치는 연말부터 자사 인프라에서 시작하며, 2세대는 개발 중이고 3세대는 구상 단계라고 밝혔다.
다만 같은 글이 분명히 적어 둔 문장이 있다. 엔비디아를 비롯한 파트너 가속기는 학습과 추론 양쪽에서 계속 폭넓게 배치한다는 것이다. 대체가 아니라 선택지를 하나 더 갖는 것이고, 그 선택지가 있으면 가격 협상력이 생긴다.
오픈웨이트 모델이란 무엇이고, 이번 주에 무엇이 나왔나
오픈웨이트(open-weight) 모델은 학습이 끝난 가중치 파일을 공개해 누구나 내려받아 직접 돌릴 수 있게 한 모델이다. 폐쇄형 모델은 회사 서버에서만 돌고 우리는 API로 결과만 받는다. 이 차이가 크다. 가중치가 손에 있으면 어느 클라우드에서 돌릴지, 아예 내 서버에서 돌릴지를 내가 고른다.
이번 주에 두 개가 나왔다. 하나는 Z.ai의 GLM-5.3-Flash다. GLM-5 계열 처음으로 텍스트와 이미지를 함께 처리하는 네이티브 멀티모달 모델이고, MIT 라이선스로 허깅페이스에 올라와 있다. 회사 설명으로는 이전 세대인 GLM-5.2를 벤치마크와 실사용 양쪽에서 앞서면서 가격은 10분의 1이고, 코딩과 에이전트 벤치마크에서 Claude Opus 4.8에 근접한다.
다른 하나는 Qwen3.8-Flash-Next다. 모델 카드가 스스로 "Qwen4를 떠받칠 아키텍처의 실험적 프리뷰"라고 적고 있다. 즉 다음 세대 구조를 먼저 열어 보인 셈이다.
두 모델이 공통으로 겨냥한 것은 성능이 아니라 효율이다. 같은 지능을 더 적은 연산으로 낸다는 쪽이고, 그래야 남의 클라우드 밖에서 돌릴 수 있다.
활성 파라미터란 무엇인가 — 320B인데 18B만 켠다는 말의 뜻
GLM-5.3-Flash의 설명에는 총 파라미터 320B, 활성 파라미터 18B라는 표기가 붙는다. 처음 보면 모순처럼 읽히는데, MoE(Mixture of Experts, 전문가 혼합) 구조를 알면 간단하다.
모델 안에 서로 다른 전문가 모듈이 여러 개 들어 있고, 토큰 하나를 처리할 때 그중 일부만 켜진다. 저장하고 있어야 하는 파라미터는 320B 전부지만, 실제 계산에 참여하는 것은 매번 18B뿐이다. 그래서 메모리는 큰 모델만큼 필요하지만 연산량과 비용은 작은 모델에 가깝다.
Qwen3.8-Flash-Next는 같은 발상을 더 밀었다. 125B 파라미터 중 활성이 6B이고, 여기에 n-gram 임베딩 51B와 MTP 4B가 별도로 붙는다. n-gram 임베딩을 따로 둔 이유가 흥미롭다. 파라미터를 늘리는 축을 하나 더 만들되 그 축은 연산이 덜 들고 메모리 밖으로 내보내기(오프로딩) 쉽게 설계했다는 것이다. 가속기 메모리가 좁은 환경에서 유리하다.
어텐션도 손봤다. Gated DeltaNet과 QSA(Qwen Sparse Attention)를 짝지어, 어떤 토큰을 볼지 하나씩 고르는 대신 마이크로 블록 단위로 골라 롱컨텍스트 지연을 줄였다. GLM-5.3-Flash도 GLM 계열 처음으로 희소 어텐션과 선형 어텐션을 섞어 같은 문제를 공격했다.
구조는 다르지만 목표는 하나다. 긴 문맥을 다루는 비용을 떨어뜨리는 것. 에이전트는 문맥이 길어질 수밖에 없으므로, 여기가 지금 가장 비싼 자리다.
에이전트가 내 기계로 내려온다: Perplexity Portable Computer
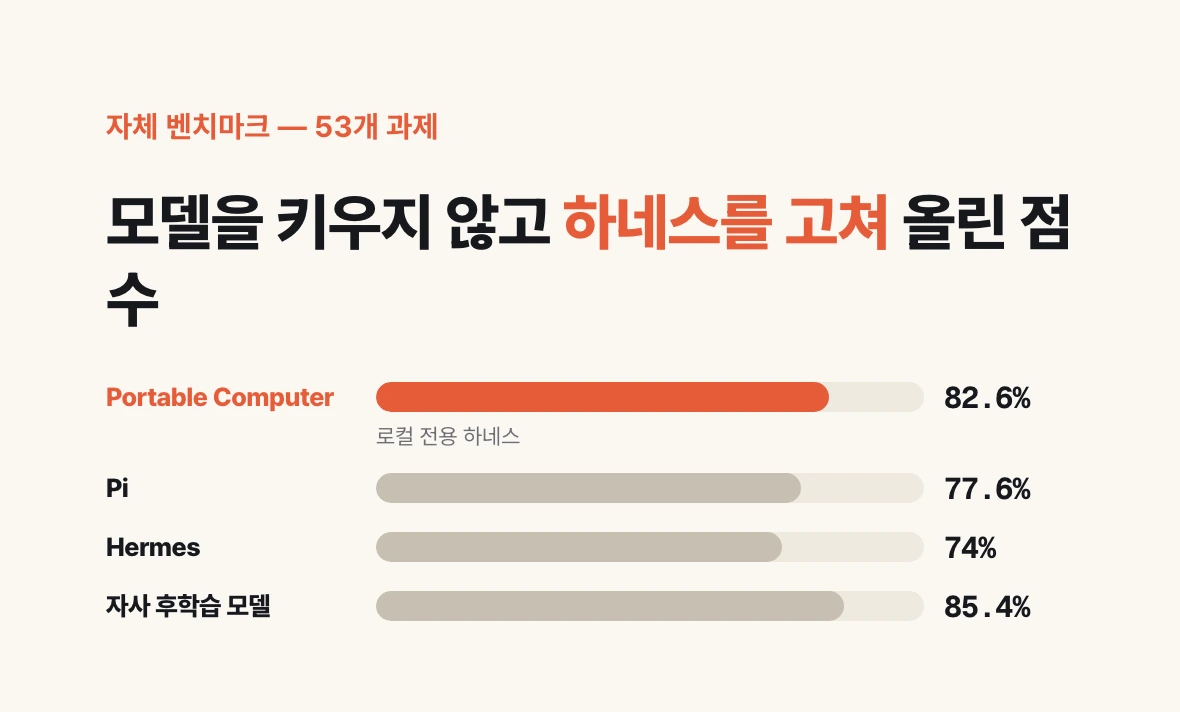
Perplexity가 공개한 Portable Computer는 로컬 우선(local-first) 에이전트다. 모델도, 하네스도, 대화와 작업 기록도 전부 사용자 기계 안에서 돈다. 웹 검색이나 커넥터, 또는 클라우드의 더 강한 자문 모델 호출처럼 바깥이 필요한 일만 그때그때 사용자 승인을 거쳐 나간다.
여기서 하네스(harness)는 모델을 감싸 도구를 붙여 주고, 무엇을 다음에 할지 반복을 돌리고, 컨텍스트를 조립하는 바깥 프로그램을 말한다. 모델이 엔진이라면 하네스는 차체다.
이 회사의 주장은 로컬 모델에는 로컬 전용 하네스가 필요하다는 것이다. 범용 하네스는 긴 컨텍스트를 다 흡수하고 넓은 도구 표면을 다루는 프런티어 모델을 전제하는데, 작은 모델은 그 조건에서 흔들린다.
설계 원칙 네 가지가 구체적이다. 첫째, 컨텍스트 절약. 온디바이스 모델이 26만 토큰 컨텍스트를 표방해도 실측상 10만 토큰을 넘으면 흔들리기 시작하므로, 시스템 프롬프트와 핵심 도구를 최소로 두고 나머지는 필요할 때 붙였다 떼는 스킬로 뺐다. 둘째, 커넥터를 MCP 서버가 아니라 짧은 CLI 도구로 바꿨다. MCP는 도구 정의가 길어 컨텍스트를 크게 먹는다. 셋째, 자기 검증. 단계가 늘지만 결과가 좋아지고 프런티어 모델과의 격차가 크게 줄어든다. 넷째, 샌드박스 강제. 샌드박스를 쓸 수 없으면 도구 호출을 아예 막는다.
자체 벤치마크(일상 지식 업무 53개 과제)에서 Qwen 3.8 27B를 NVIDIA DGX Spark에 올린 기준 82.6%였고, 같은 조건에서 Pi 77.6%, Hermes 74.0%였다. 자사 후학습 모델을 쓰면 85.4%였다. 자체 벤치라는 점은 감안해서 읽어야 하지만, 모델을 키우지 않고 하네스를 고쳐 점수를 올렸다는 방향 자체가 요지다.
같은 주 구글이 낸 것들: 영상 통제권, 받아쓰기 정확도, 검색 안 결제
Gemini Omni 1.1 Flash는 영상 생성 모델의 업데이트인데, 추가된 것이 전부 통제권이다. 장면을 최대 40초까지 이어 붙이고, 시작 프레임과 끝 프레임을 지정해 그 사이 전환을 만들고, 최대 3초짜리 영상을 레퍼런스로 물려 인물 일관성을 유지하고, 결과물을 1080p나 4K로 업스케일한다.
실무에서 더 중요한 건 360p 초안이다. 720p 대비 최대 60% 빠르고 비용은 3분의 1이다. 여러 안을 싸게 굴려 보고 고른 하나만 4K로 올리라는 뜻이고, 이건 화질 개선이 아니라 워크플로 비용 설계다.
Gemini 3.5 Transcribe는 받아쓰기 모델이다. Artificial Analysis 측정 기준 단어 오류율이 스트리밍 4.0%, 비스트리밍 2.6%이고, 최종 확정까지 걸리는 시간이 이전 모델 Chirp 3 대비 70% 줄었다. 숫자보다 눈에 띄는 건 처리 방식이다. "화요일에 만나자, 아니 수요일"처럼 말하다 고친 대목을 알아서 반영하고, 군말을 빼고, 서식을 붙인다. 85개 이상 언어를 자동 감지하고 사전 녹음은 화자 3명까지 타임스탬프와 함께 구분한다.
검색 쪽에서는 AI 모드에 여행 기능 세 가지가 들어갔다. 대화 중 항공권 가격 추적을 걸면 300곳이 넘는 항공사·여행사 최신가 기준으로 변동 시 메일이 오고(180개국 이상), 항공권과 호텔을 마일리지·포인트 기준으로 환산해 보여주며, 호텔은 구글에서 계속을 눌러 객실과 취소 정책을 확인하고 구글 페이로 결제까지 한다. 다만 판매자와 고객 응대는 호텔이나 예약 플랫폼이 진다. 미국 영어부터 순차 적용이다.
세 건의 공통점은 모델 성능 자랑이 아니라 결과물이 실제 작업 흐름에 끼워지는 방식이라는 것이다.
돈과 로봇, 그리고 개발 환경도 자리를 뜬다
Stability AI가 시리즈 B로 7,600만 달러를 새로 조달해 누적 2억 3,200만 달러가 됐다고 8월 25일 밝혔다. 신규 투자자 명단이 본론이다. Sony Music Group, Universal Music Group, Warner Music Group이 함께 들어갔고, 게임 쪽에서 Electronic Arts, 여기에 AMD Ventures와 Pacific Alliance Ventures가 붙었다. 음악 산업이 생성 AI에 소송으로만 대응하는 것이 아니라 지분으로도 들어온다는 신호로 읽힌다.
로봇 쪽에서는 Skild AI가 파운데이션 모델 S1을 공개했다. 회사가 내건 조건이 네 줄이다. 처음 보는 과제, 10분짜리 긴 작업, 영상 프롬프트 한 개, 사후 학습 없음. 진단이 명확한데, 지금까지 로봇 학습은 BERT 시대에 머물러 있었다는 것이다. 새 과제 하나를 제대로 시키려면 현장 조건에서 수십에서 수백 시간짜리 데이터를 모아 전용 정책을 파인튜닝해야 했다. 언어모델이 그 단계를 넘은 계기가 in-context learning, 즉 프롬프트였다는 점을 들어, 같은 전환을 로봇에서 시도한 것이 S1이다.
개발 환경도 자리를 뜬다. 구글 Antigravity 2.0에 원격 제어가 들어갔다. 노트북·서버·데스크톱에 흩어져 도는 Antigravity 세션에 웹 브라우저로 붙어 그대로 조종하고, 파일과 워크스페이스, 빌드 도구, 자격 증명 접근이 유지된다. 데스크톱 앱에서 켜는 방식 외에 헤드리스 데몬 설치 경로가 따로 있고, 로그인은 최초 1회다.
문서가 밝힌 이유가 앞의 이야기와 이어진다. 에이전트 작업 단위가 서브시스템 전체 리팩터링이나 대규모 테스트 실행처럼 길어지면서, 사람이 그 앞에 붙어 있을 수 없게 됐다는 것이다.
그래서 이번 주에 무엇을 해 보면 되나
첫째, 오픈웨이트 모델을 한 번 직접 돌려 본다. 허깅페이스에서 zai-org/GLM-5.3-Flash나 Qwen/Qwen3.8-Flash-Next 모델 카드를 열어 라이선스와 실행 요건을 읽는 것만으로도 감이 잡힌다. 개인 컴퓨터에 올리기엔 여전히 크므로, 처음에는 클라우드 GPU를 시간 단위로 빌려 돌려 보는 편이 현실적이다.
둘째, 지금 쓰는 도구의 비용이 어디서 나는지 한 번 센다. 한 달 API 청구서를 학습이 아니라 추론 관점에서 보면, 요청 수보다 에이전트 반복 횟수가 비용을 만들고 있다는 게 보이는 경우가 많다.
셋째, 사내 문서를 다루는 작업이 있다면 그 작업만 따로 떼어 로컬 모델로 옮길 수 있는지 검토한다. 전부 옮길 필요는 없다. Perplexity의 설계가 보여주는 요지는 기본을 로컬로 두고 바깥이 필요한 순간에만 승인을 받아 나가는 구성이다.
넷째, 컨텍스트를 아끼는 습관을 들인다. MCP 서버를 무한정 붙이는 대신 자주 쓰는 것만 남기고, 나머지는 필요할 때 불러오는 스킬로 빼는 방식이다. 이건 로컬 모델뿐 아니라 프런티어 모델에서도 그대로 효과가 있다.
정리하면, 이번 주 소식들은 칩·모델·실행 환경 세 층에서 같은 방향을 가리킨다. 지능을 어디서 돌릴지가 다시 선택 가능한 문제가 되고 있다는 것이다.