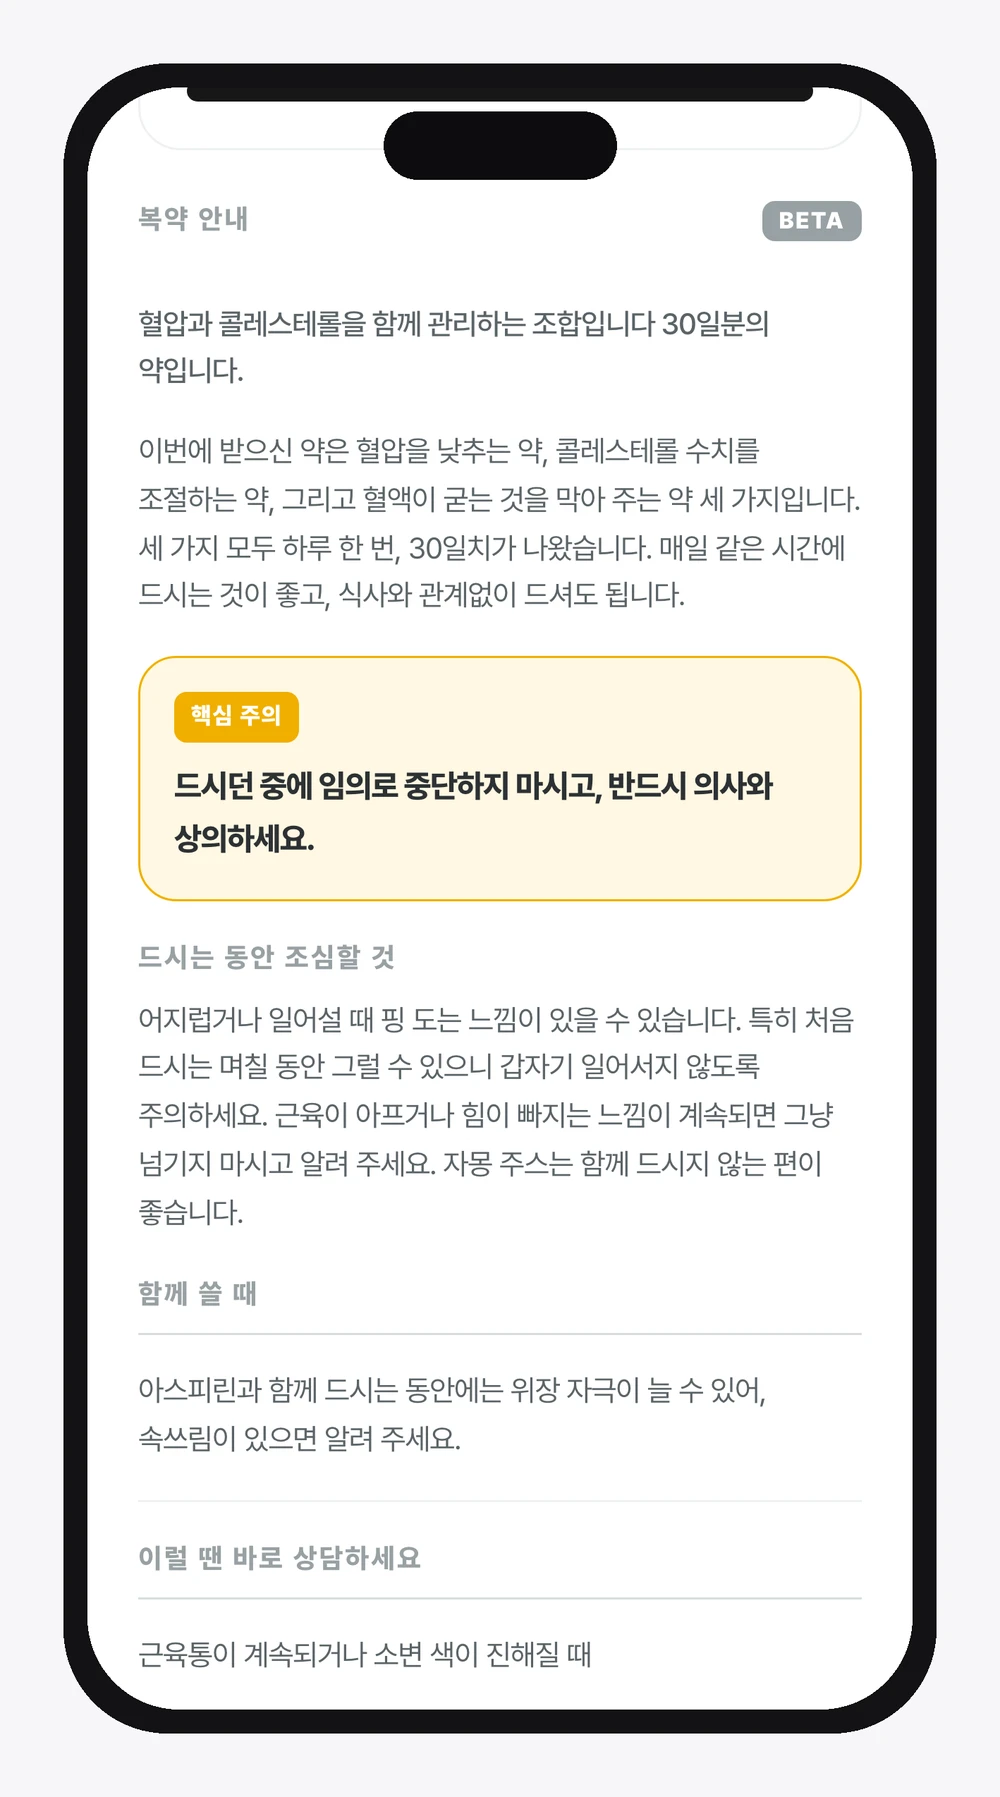
잘 쓴 거짓말과 잘 쓴 사실은 겉이 같다
조제 봉투 한 장을 AI에게 주고 복약안내를 만들게 했다. 나오는 문장은 늘 그럴듯했다. 문제는 그럴듯함이 판정 기준이 못 된다는 데 있었다.
"하루 세 번 식후 30분"이라는 문장을 보자. 문법도 어법도 흠잡을 데가 없고, 복약안내로서 자연스럽다. 그런데 그 봉투에 실제로 30분이 적혀 있었는지는 이 문장 안에 없다. 모델이 원문에서 읽어 온 30분일 수도 있고, 비슷한 약의 통념에서 끌어온 30분일 수도 있다. 둘은 결과 문장이 완전히 같다.
여기서 출발점이 정해졌다. 사람이 결과를 읽어 검수하는 방식은 이 구분을 원리적으로 못 한다. 검수자가 아무리 꼼꼼해도, 문장에 없는 정보를 문장에서 꺼낼 수는 없다.
검사를 출력이 아니라 입력 쪽으로 돌렸다
그래서 검사의 방향을 뒤집었다. 생성된 글을 읽고 이상한 데를 찾는 대신, 생성된 글의 모든 조각이 입력 원문 어디에서 왔는지를 물었다. 대조할 원본이 손에 있다는 것이 이 문제의 유일한 지렛대였다.
숫자는 입력 원문에 등장하는 것만 통과시킨다. 용량, 횟수, 시간, 일수가 전부 여기 걸린다. 원문에 없는 숫자는 그 값이 의학적으로 옳든 그르든 거부된다 — 옳고 그름을 우리가 판정할 위치에 있지 않기 때문이다.
연령 안전 문구는 더 세게 묶었다. "12세 미만 어린이는 복용하지 마세요" 같은 문장은 원문과 완전일치여야 한다. 부분일치나 의미가 같은 재작성을 허용하지 않는다. 이런 문구는 한 단어가 바뀌면 대상 범위가 바뀌는데, 그 변화는 읽어서는 잘 안 보인다.
약을 함께 쓸 때의 주의사항에는 항목마다 근거를 달게 했다. 근거가 없는 항목은 저장되지 않는다. 재료에 없는 상호작용은 문장이 아무리 옳게 읽혀도 버린다.
개수를 강제하면 지어낸다
가장 많이 배운 것은 설계가 아니라 사고에서 나왔다. 처음에는 출력 형식을 고정하려고 "주의사항 네 개"처럼 개수를 정해 뒀다. 화면 레이아웃이 깔끔해지고 검증 코드도 단순해지니 자연스러운 선택으로 보였다.
그런데 재료가 세 개뿐인 봉투가 오면 어떻게 될까. 모델은 세 개를 쓰고 멈추지 않았다. 네 번째를 만들어 냈다.
지시를 어긴 것이 아니다. 우리가 네 개를 요구했고 모델은 그 요구를 지켰다. 빈칸을 만들어 두고 채우라고 하면 채워지는 게 당연하다. 환각의 상당 부분은 모델의 결함이 아니라 우리가 만든 빈칸의 결과였다.
지금은 0에서 4개 사이이고, 재료가 없으면 그냥 비운다. 화면은 조금 덜 균일해졌지만 지어낸 문장이 사라졌다. 프롬프트에 숫자를 박기 전에 "재료가 모자라면 이 자리는 무엇으로 채워지나"를 먼저 물어야 한다.
검증용 AI는 막지 않고 보게 뒀다
생성물을 다른 모델에게 검사시키는 구조도 붙였다. 다만 그 검증기에게 차단 권한을 주지 않았다. 문제를 발견하면 기록만 하고, 저장을 막는 것은 규칙 기반 검사들이 한다.
검증기의 판정을 못 믿어서가 아니다. 역할을 나눈 것이다. 막는 자리에는 재현 가능하고 설명 가능한 것이 서야 한다. 어떤 글이 왜 거부됐는지를 나중에 정확히 되짚을 수 있어야 하는데, 모델 판정은 같은 입력에도 흔들린다.
대신 검증기는 규칙이 놓친 것을 보여 주는 자리에 뒀다. 규칙을 다 통과했는데 검증기가 계속 걸고 넘어지는 유형이 쌓이면, 그것이 다음에 만들 규칙의 후보가 된다. 관측을 차단으로 승격시킬지는 그 데이터를 보고 정한다.
왜 알약 하나씩이 아니라 조제 단위인가
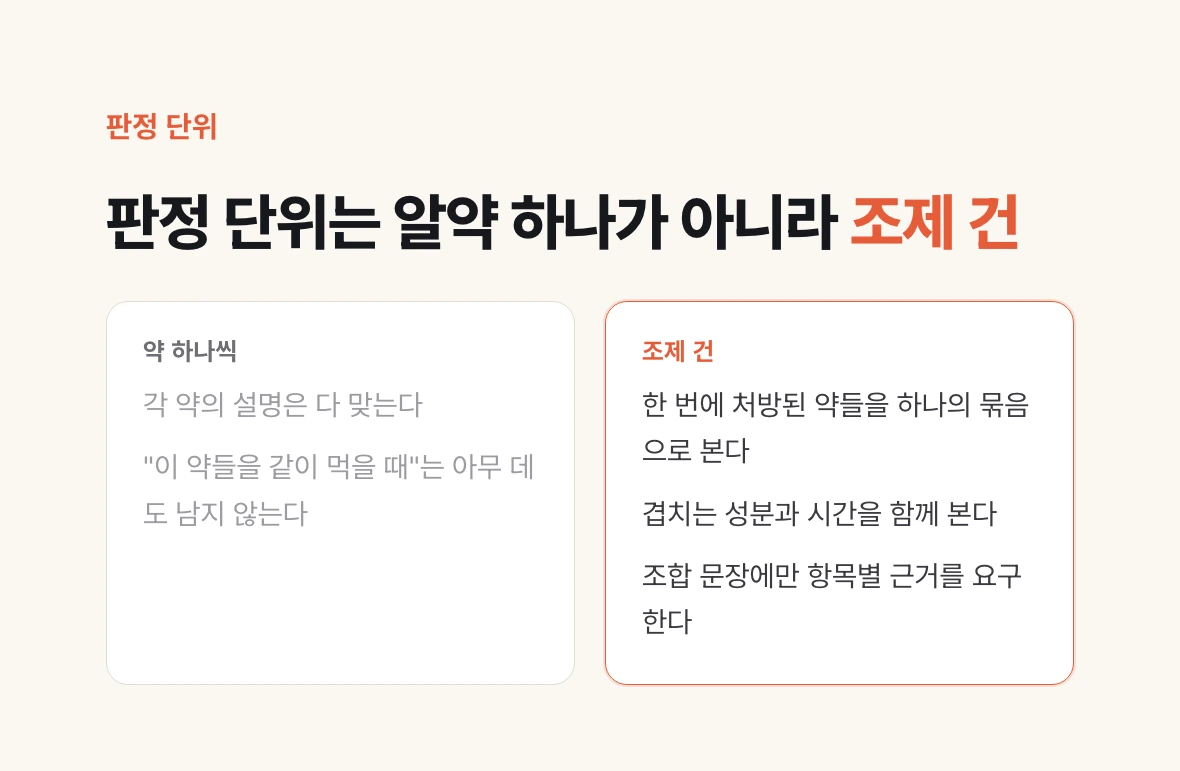
복약안내를 만드는 흔한 방식은 약 하나마다 설명을 붙이는 것이다. 데이터도 그렇게 생겼고 만들기도 쉽다.
그런데 한 알씩 설명하면 "이 약들을 같이 먹을 때"가 아무 데도 남지 않는다. 각 약의 설명은 다 맞는데, 조합에 대한 이야기만 통째로 빠진다. 정작 봉투를 받아 든 사람이 알고 싶은 건 그것이다.
그래서 판정 단위를 조제 건으로 잡았다. 한 번에 처방된 약들을 하나의 묶음으로 보고, 그 묶음 안에서 겹치는 성분과 시간을 함께 볼 수 있게 했다.
이 선택이 앞의 검증 설계와 이어진다. 조합에 대한 문장은 개별 약 설명보다 지어내기 쉽다 — 그럴듯한 상호작용은 상식만으로도 만들어진다. 그래서 조합 문장에만 항목별 근거를 요구하는 검사를 따로 뒀다.