여기서 말하는 툴이 무엇인가
먼저 용어를 풀어야 합니다. AI 에이전트에서 툴이란, 모델이 자기 힘으로는 못 하는 일을 대신 해 주는 바깥의 기능입니다. 웹을 검색하고, 파일을 읽고, 데이터베이스에 질의하고, 메일을 보내는 것들입니다.
요즘은 이런 툴을 붙이는 표준 방식이 MCP(Model Context Protocol)입니다. 설정 파일에 서버를 몇 줄 추가하면 툴이 늘어나는 구조라, 붙이는 데 드는 노력이 거의 없습니다. 그래서 자꾸 늘어납니다.
그런데 툴을 붙인다는 건 목록을 늘리는 일이기만 한 게 아닙니다. 붙인 툴의 이름과 설명과 인자 규격이 전부 모델에게 매번 읽힙니다. 툴이 스무 개면 스무 개 분량의 설명서가 대화 앞에 깔린 채로 시작하는 셈입니다.
그리고 모델은 그 목록에서 매번 하나를 골라야 합니다. 고를 것이 많아지면 사람이 그렇듯 선택이 흔들립니다.
기준선 — 네다섯 개, 혹은 한두 개
발표에서 이 숫자가 두 번 나왔는데 값이 달랐습니다. 슬라이드에 적힌 기준선은 툴 네다섯 개이고, 발표자가 말로 한 것은 한두 개였습니다.
어느 쪽으로 잡든 방향은 같습니다. 그 선을 넘어가면 추론 품질이 떨어지고 툴 선택이 불안정해집니다. 여기서 「불안정하다」는 건 오류가 난다는 뜻이 아니라, 같은 요청에 대해 매번 다른 툴을 고르거나 엉뚱한 툴을 고르는 일이 늘어난다는 뜻입니다.
숫자를 정확히 외울 필요는 없습니다. 실무에서 쓸 만한 형태로 바꾸면 이렇습니다. 「이 에이전트가 이번 대화에서 실제로 쓸 툴만 남아 있나?」 한 번도 안 쓰이는 툴이 절반이면 이미 선을 넘은 것입니다.
목수 비유 — 왜 쪼개는 쪽이 이기나
발표에서 든 비유가 정확합니다. 집에 목수를 부르는데, 그 사람이 배관 공구와 목공 공구와 전기 공구를 전부 들고 나타나서 「나는 뭐든 할 수 있다」고 합니다.
그 사람을 부르고 싶지는 않을 겁니다. 제대로 된 목수를 원한 것이니까요. 뭐든 할 수 있다는 말은 무엇 하나를 특별히 잘한다는 말이 아닙니다.
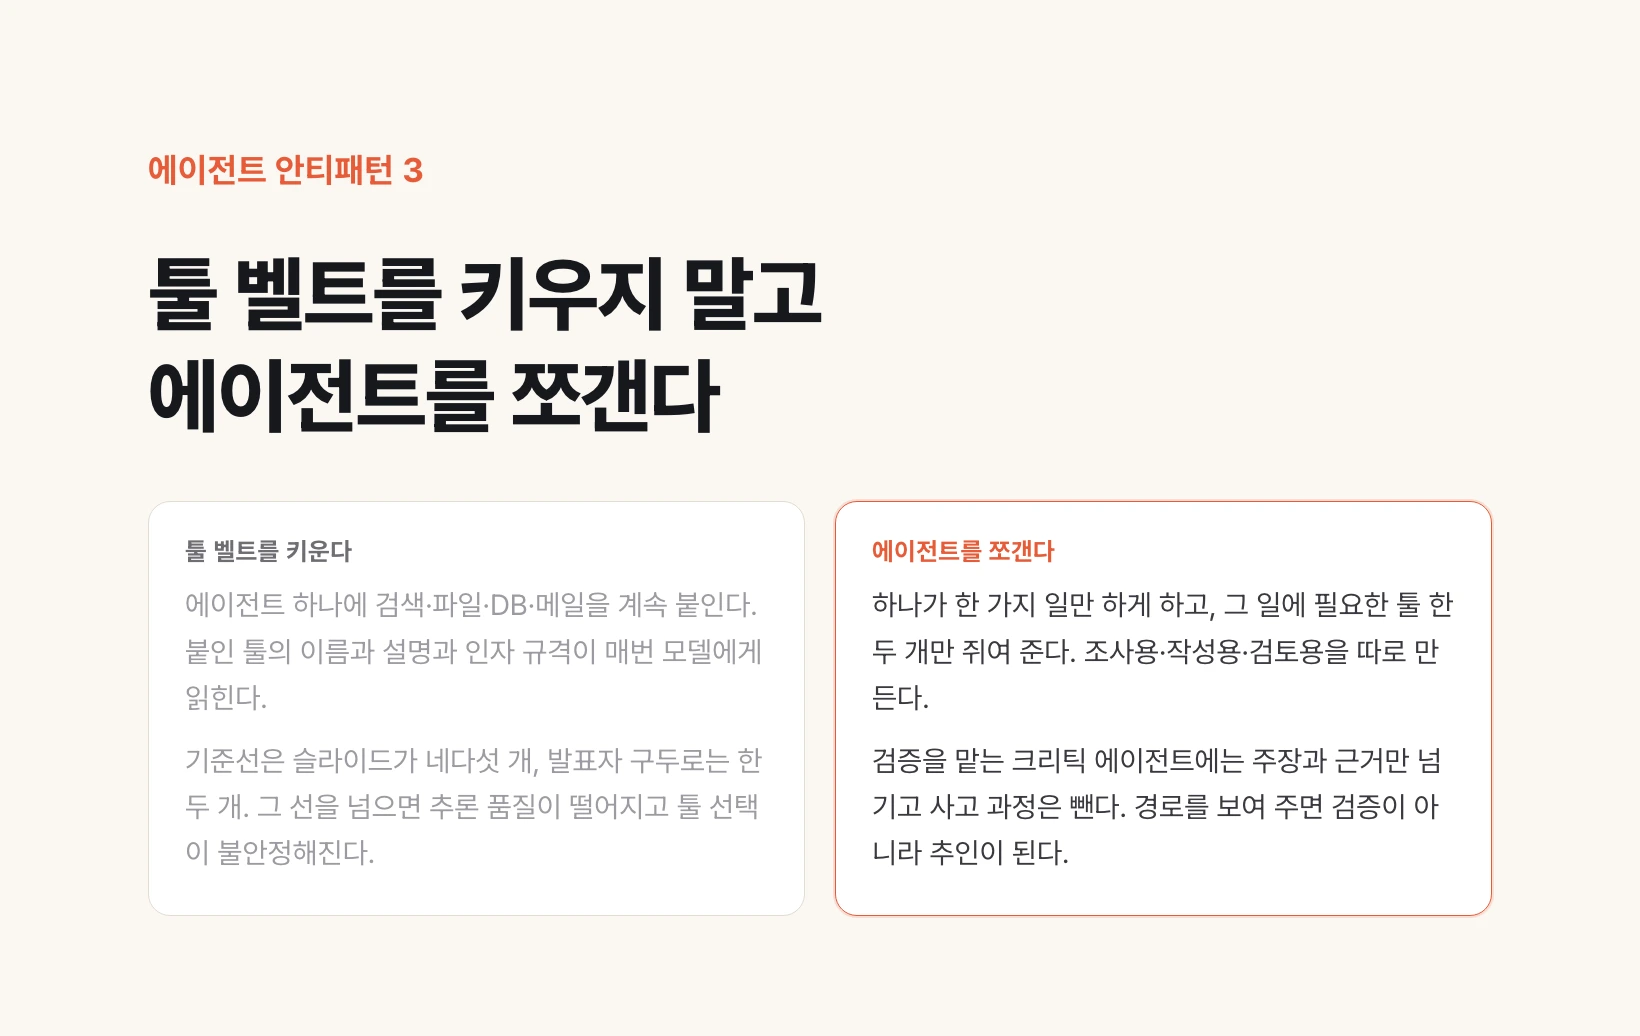
그래서 처방이 「툴 벨트를 키우지 말고 에이전트를 쪼개라」입니다. 하나가 한 가지 일만 하게 만들고, 그 일에 필요한 툴 한두 개만 쥐여 줍니다. 함수는 한 가지 일만 해야 한다는 함수형 프로그래밍의 오래된 규칙이 그대로 옮겨 온 셈입니다.
코드를 안 쓰는 사람에게도 쓸 자리가 있습니다. 커스텀 GPT나 프로젝트를 만들 때 하나에 모든 역할을 담지 말고, 「자료 조사용」과 「초안 작성용」과 「검토용」을 따로 만드는 것이 같은 이야기입니다.
덤으로 따라오는 것 — 서브에이전트의 컨텍스트를 메인에 흘리지 않는다
에이전트를 쪼개면 자연히 따라오는 이득이 하나 있습니다. 각 에이전트가 자기 일을 하며 쌓은 중간 과정이 메인 대화로 흘러들지 않는다는 점입니다.
이게 왜 중요하냐면, 컨텍스트는 토큰이고 토큰은 돈이기 때문입니다. 그런데 그보다 중요한 이유가 따로 있습니다. 컨텍스트가 많을수록 모델이 헷갈려서 답이 부정확해집니다.
그래서 서브에이전트에는 그 일을 푸는 데 필요한 것만 넘기고, 돌아올 때도 결과만 받습니다. 과정은 그 안에 두고 옵니다.
크리틱 에이전트 — 검증하라고 만들어 놓고 정보를 덜 준다
발표에서 가장 인상적인 코드가 이것이었습니다. 앞선 작업 결과를 검증하라고 만든 크리틱 에이전트인데, 넘기는 것이 주장(claim)과 근거(evidence) 딱 두 개입니다.
그 판단이 나오기까지의 사고 과정은 일부러 뺍니다. 검증을 맡긴 상대에게 정보를 덜 주는 셈이라 처음 보면 거꾸로 보입니다.
이유가 그룹싱크였습니다. 여러 에이전트를 모아 서로 이야기하게 하면 하나의 결론으로 수렴해 버립니다. 발표자의 비유가 이랬습니다. 파티에서 다들 피자를 먹자고 하는데 나만 아닐 때, 분위기를 깨기 싫어 따라가게 됩니다. 에이전트도 그렇게 움직입니다.
앞선 에이전트가 어떤 경로로 그 결론에 이르렀는지를 보여 주면, 검증자는 그 경로를 따라 걷다가 같은 결론에 도착합니다. 그러면 검증이 아니라 추인입니다. 그래서 결론과 근거만 주고 「이게 맞나」를 새로 판단하게 합니다.
사람 조직에서 교차 검토를 시킬 때 원본 담당자의 결론 노트를 같이 주지 않는 것과 같은 이치입니다.
오늘 해 볼 것 하나
지금 쓰고 있는 에이전트나 커스텀 GPT, MCP 설정을 열어 붙어 있는 툴 개수를 세어 보십시오.
다섯 개를 넘어간다면 그중 절반은 최근 한 달 동안 한 번도 안 쓰였을 가능성이 큽니다. 그 절반을 떼어내고 같은 일을 시켜 보십시오. 툴을 고르는 정확도가 눈에 띄게 달라집니다.
떼어낸 툴이 아깝다면 지우지 말고 다른 에이전트로 옮깁니다. 조사용 에이전트에는 검색과 웹 읽기, 작성용 에이전트에는 파일 읽기와 쓰기 식으로 나눕니다.
다음 편은 네 번째 안티패턴입니다. 모델이 왜 멈췄는지를 안 보고 답부터 쓰면 어디서 조용히 틀리는가에 대한 이야기입니다.