왜 지금 와서 루프인가 — 1966년의 증명
안티패턴에 들어가기 전에 왜 이게 지금 문제가 되는지부터 짚습니다.
초기 컴퓨팅 시절에는 프로그래밍 언어가 폭발하듯 늘어나며 「내 언어가 네 언어보다 더 많은 걸 할 수 있다」는 싸움이 있었습니다. 1966년 코라도 뵘과 주세페 야코피니가 이 논쟁을 증명으로 끝냈습니다. 어떤 계산이든 세 가지만 있으면 전부 할 수 있다는 것입니다. 순서대로 실행하는 것, 조건에 따라 갈라지는 것, 그리고 반복하는 것.
여기에 지금 AI를 대입해 보면 그림이 선명해집니다. 프롬프트를 한 번 던지고 답을 받는 건 순서입니다. 조건을 걸어 갈라지게 만드는 것까지는 많이들 해 왔습니다. 그런데 루프가 없었습니다. 답을 받아 다시 넣고, 또 받아 다시 넣는 구조 말입니다.
에이전트가 다르게 느껴지기 시작한 데는 모델이 좋아진 몫도 있지만, 구조적으로는 이 세 번째가 채워진 시점입니다. 그리고 루프가 생기자마자 생긴 새 실수가 이 안티패턴입니다.
먼저 풀어야 할 오해 — LLM은 툴을 실행하지 못한다
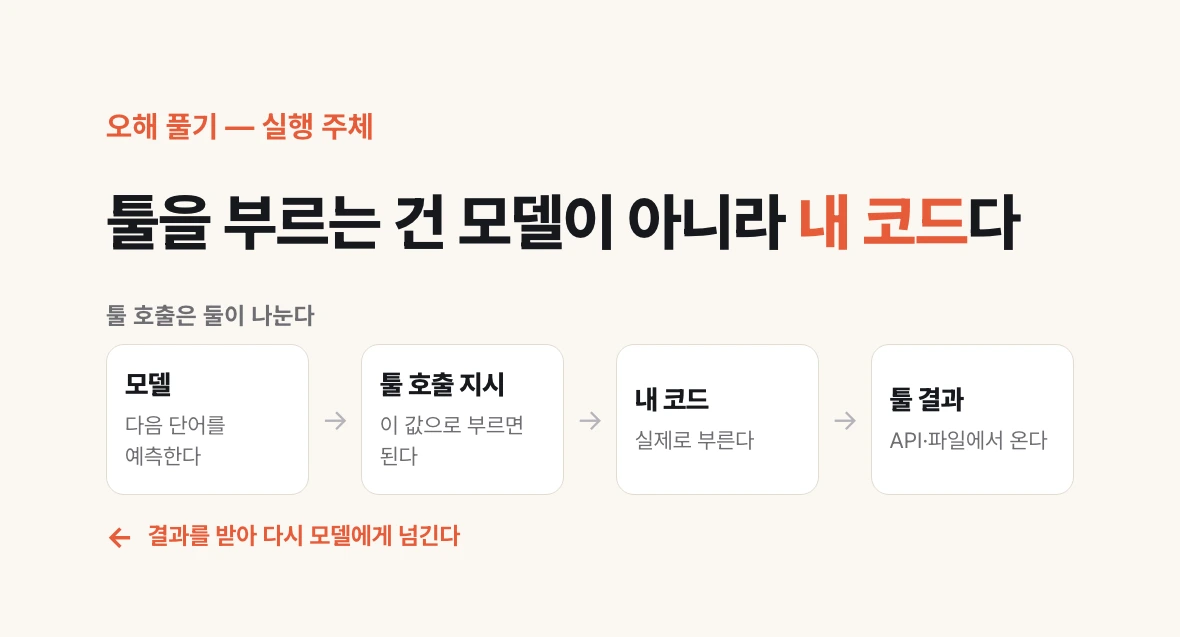
「AI가 웹을 검색했다」거나 「AI가 파일을 읽었다」는 표현을 자주 쓰는데, 문자 그대로는 사실이 아닙니다.
LLM은 확률적으로 다음 단어를 예측하는 것 말고는 아무것도 못 합니다. 툴을 쥐여 줘도 실행은 못 합니다. 할 수 있는 건 「이 툴을 이런 값으로 부르면 된다」고 아주 똑똑하게 말해 주는 것뿐입니다.
실제로 부르는 건 내 코드입니다. 검색 API를 호출하고, 파일을 열고, 결과를 받아 다시 모델에게 넘기는 것 전부가 내 쪽 일입니다.
이 구분이 왜 중요하냐면, 모델이 「멈추는 이유」가 여러 가지라는 사실이 여기서 나오기 때문입니다. 답을 다 해서 멈추는 것과, 툴을 불러 달라고 멈추는 것과, 분량이 차서 멈추는 것이 전부 다른 사건인데 겉보기에는 다 「응답이 왔다」로 보입니다.
stop_reason — 세 갈래를 가른다
그래서 응답이 오면 본문부터 읽는 게 아니라 stop_reason이라는 필드를 먼저 봅니다. 모델이 왜 멈췄는지가 여기 적혀 있습니다.
| stop_reason | 무슨 뜻인가 | 코드가 할 일 |
|---|---|---|
| tool_use | 툴을 불러 달라고 멈춤 | 툴을 실행해 결과를 메시지에 붙이고 루프를 한 바퀴 더 |
| end_turn | 할 말을 다 하고 멈춤 | 루프를 빠져나와 답을 쓴다 |
| max_tokens | 분량이 차서 잘림 | 완성된 답이 아니다 — 재요청하거나 실패로 처리 |
루프는 이렇게 생겼다
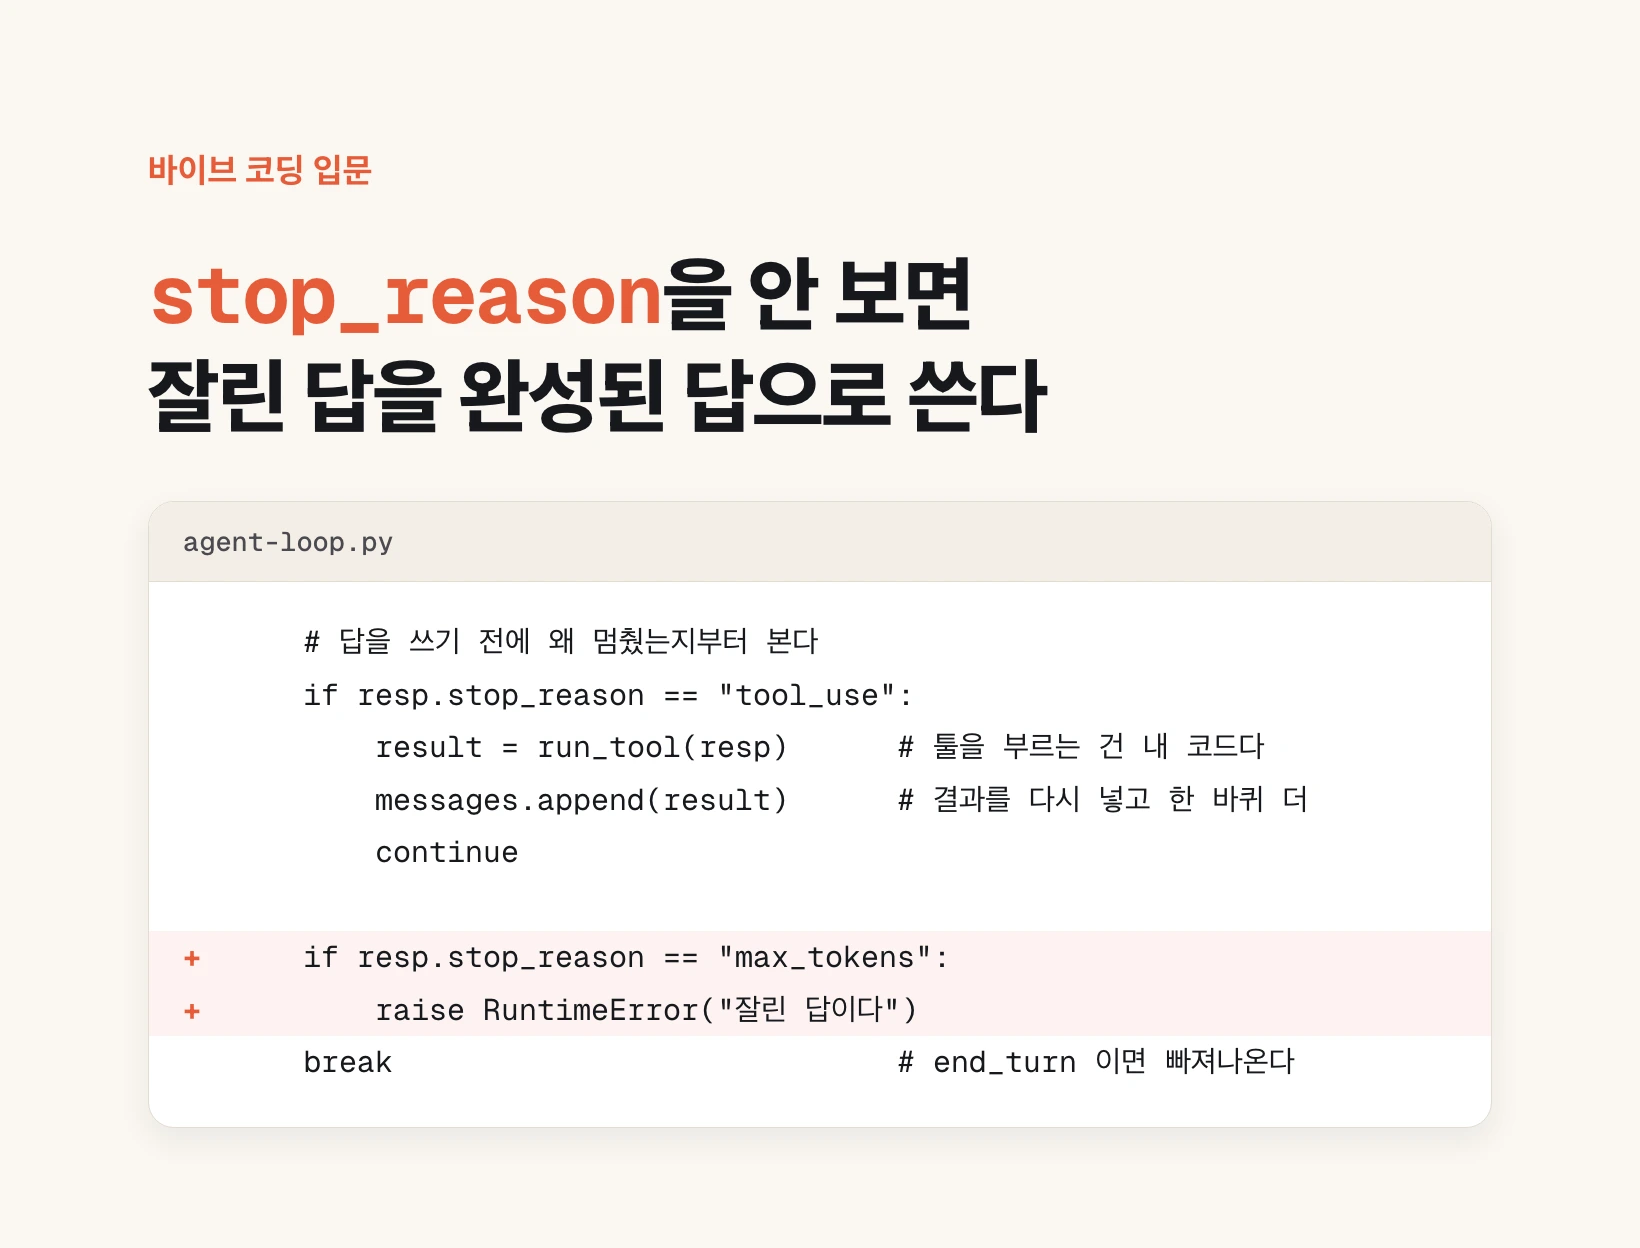
코드로 보면 짧습니다. while 루프 안에서 모델을 부르고, stop_reason으로 갈라지고, tool_use면 continue로 한 바퀴 더 돕니다.
여기서 눈여겨볼 곳은 툴을 실행하는 줄이 모델 호출 바깥에 있다는 점입니다. 모델은 무엇을 부를지 정해 주고, 부르는 건 내 코드입니다.
while True:
    resp = client.messages.create(
        model="claude-opus-5",
        messages=messages,
        tools=tools,
    )

    # 답을 쓰기 전에 왜 멈췄는지부터 본다
    if resp.stop_reason == "tool_use":
        result = run_tool(resp)          # 툴을 부르는 건 내 코드다
        messages.append(result)          # 결과를 다시 넣고 한 바퀴 더
        continue

    if resp.stop_reason == "max_tokens":
        raise RuntimeError("잘린 답이다 — 완성된 답으로 쓰지 말 것")

    break                                # end_turn 이면 빠져나온다
가장 위험한 건 세 번째다 — 잘린 답은 잘려 보이지 않는다
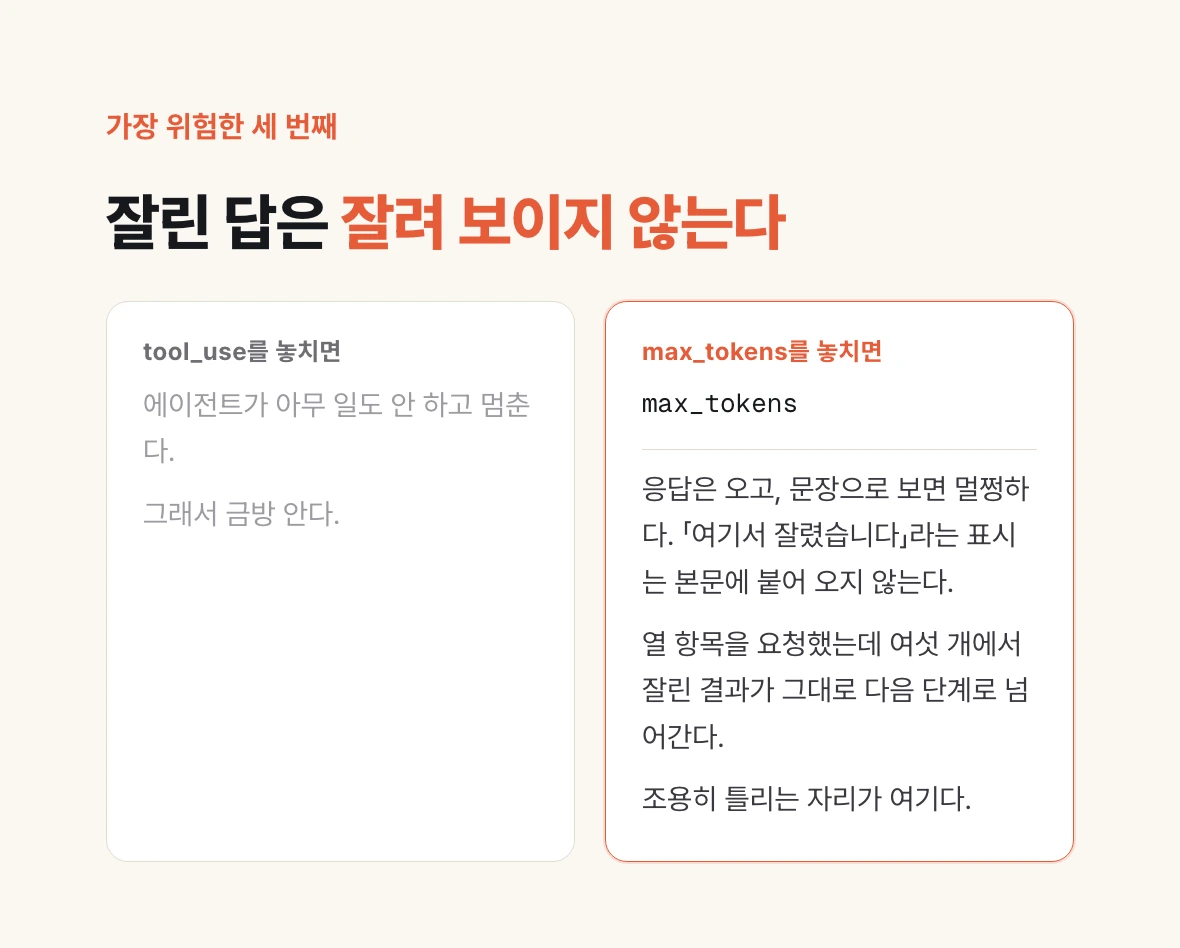
tool_use를 놓치면 에이전트가 아무 일도 안 하고 멈추니까 금방 압니다. 문제는 max_tokens입니다.
토큰이 떨어져서 멈춘 경우에도 응답은 옵니다. 그리고 그 응답은 문장으로 보면 멀쩡합니다. 중간에서 잘렸어도 마지막 문장이 어색하게 끝났을 뿐, 「여기서 잘렸습니다」라는 표시가 본문에 붙어 오지는 않습니다.
그래서 stop_reason을 안 보면 완성된 답이라고 생각하고 그대로 씁니다. 열 항목을 정리해 달라고 했는데 여섯 개에서 잘린 결과가 그대로 다음 단계로 넘어가는 식입니다. 조용히 틀리는 자리가 여기입니다.
코드를 안 쓰는 사람에게도 같은 자리가 있습니다. 챗봇에서 긴 표나 목록을 요청했을 때 결과가 어중간하게 끝났다면, 그건 모델이 그만큼만 알아서가 아니라 분량이 찼기 때문일 가능성이 큽니다. 「이어서」라고 한 줄 치면 나머지가 나옵니다.
루프를 빠져나온 뒤 — 사람이 들어갈 자리
end_turn으로 빠져나온 다음이 사람이 개입할 자리이기도 합니다.
발표에서는 이 지점에서 확신도를 확인하라고 했습니다. 결과가 괜찮아 보이면 그대로 쓰고, 아니면 사람에게 넘깁니다. 자동화의 끝을 「전부 자동」이 아니라 「자동 + 넘기는 조건」으로 잡는 것입니다.
이 조건을 만들어 두지 않으면 에이전트는 확신이 없을 때도 답을 내놓습니다. 모르는 것을 모른다고 멈추는 게 아니라 그럴듯하게 채우기 때문입니다.
오늘 해 볼 것 하나
코드를 쓰고 있다면, 모델 응답을 받는 자리에서 stop_reason을 보고 있는지 확인하십시오. 안 보고 있다면 max_tokens 분기 한 줄을 먼저 넣습니다. 그 한 줄이 조용한 실패를 시끄러운 실패로 바꿉니다.
코드를 안 쓴다면, 요즘 AI에게 받은 답 중 어중간하게 끝난 것이 있었는지 떠올려 보십시오. 그게 모델의 한계가 아니라 분량 상한이었을 가능성이 큽니다. 다음에는 「이어서 써 줘」를 먼저 쳐 보십시오.
다음 편이 마지막입니다. 100만 토큰 창이 열렸는데 왜 다 넣으면 안 되는지에 대한 이야기입니다.