한 문장이 답을 바꾼다
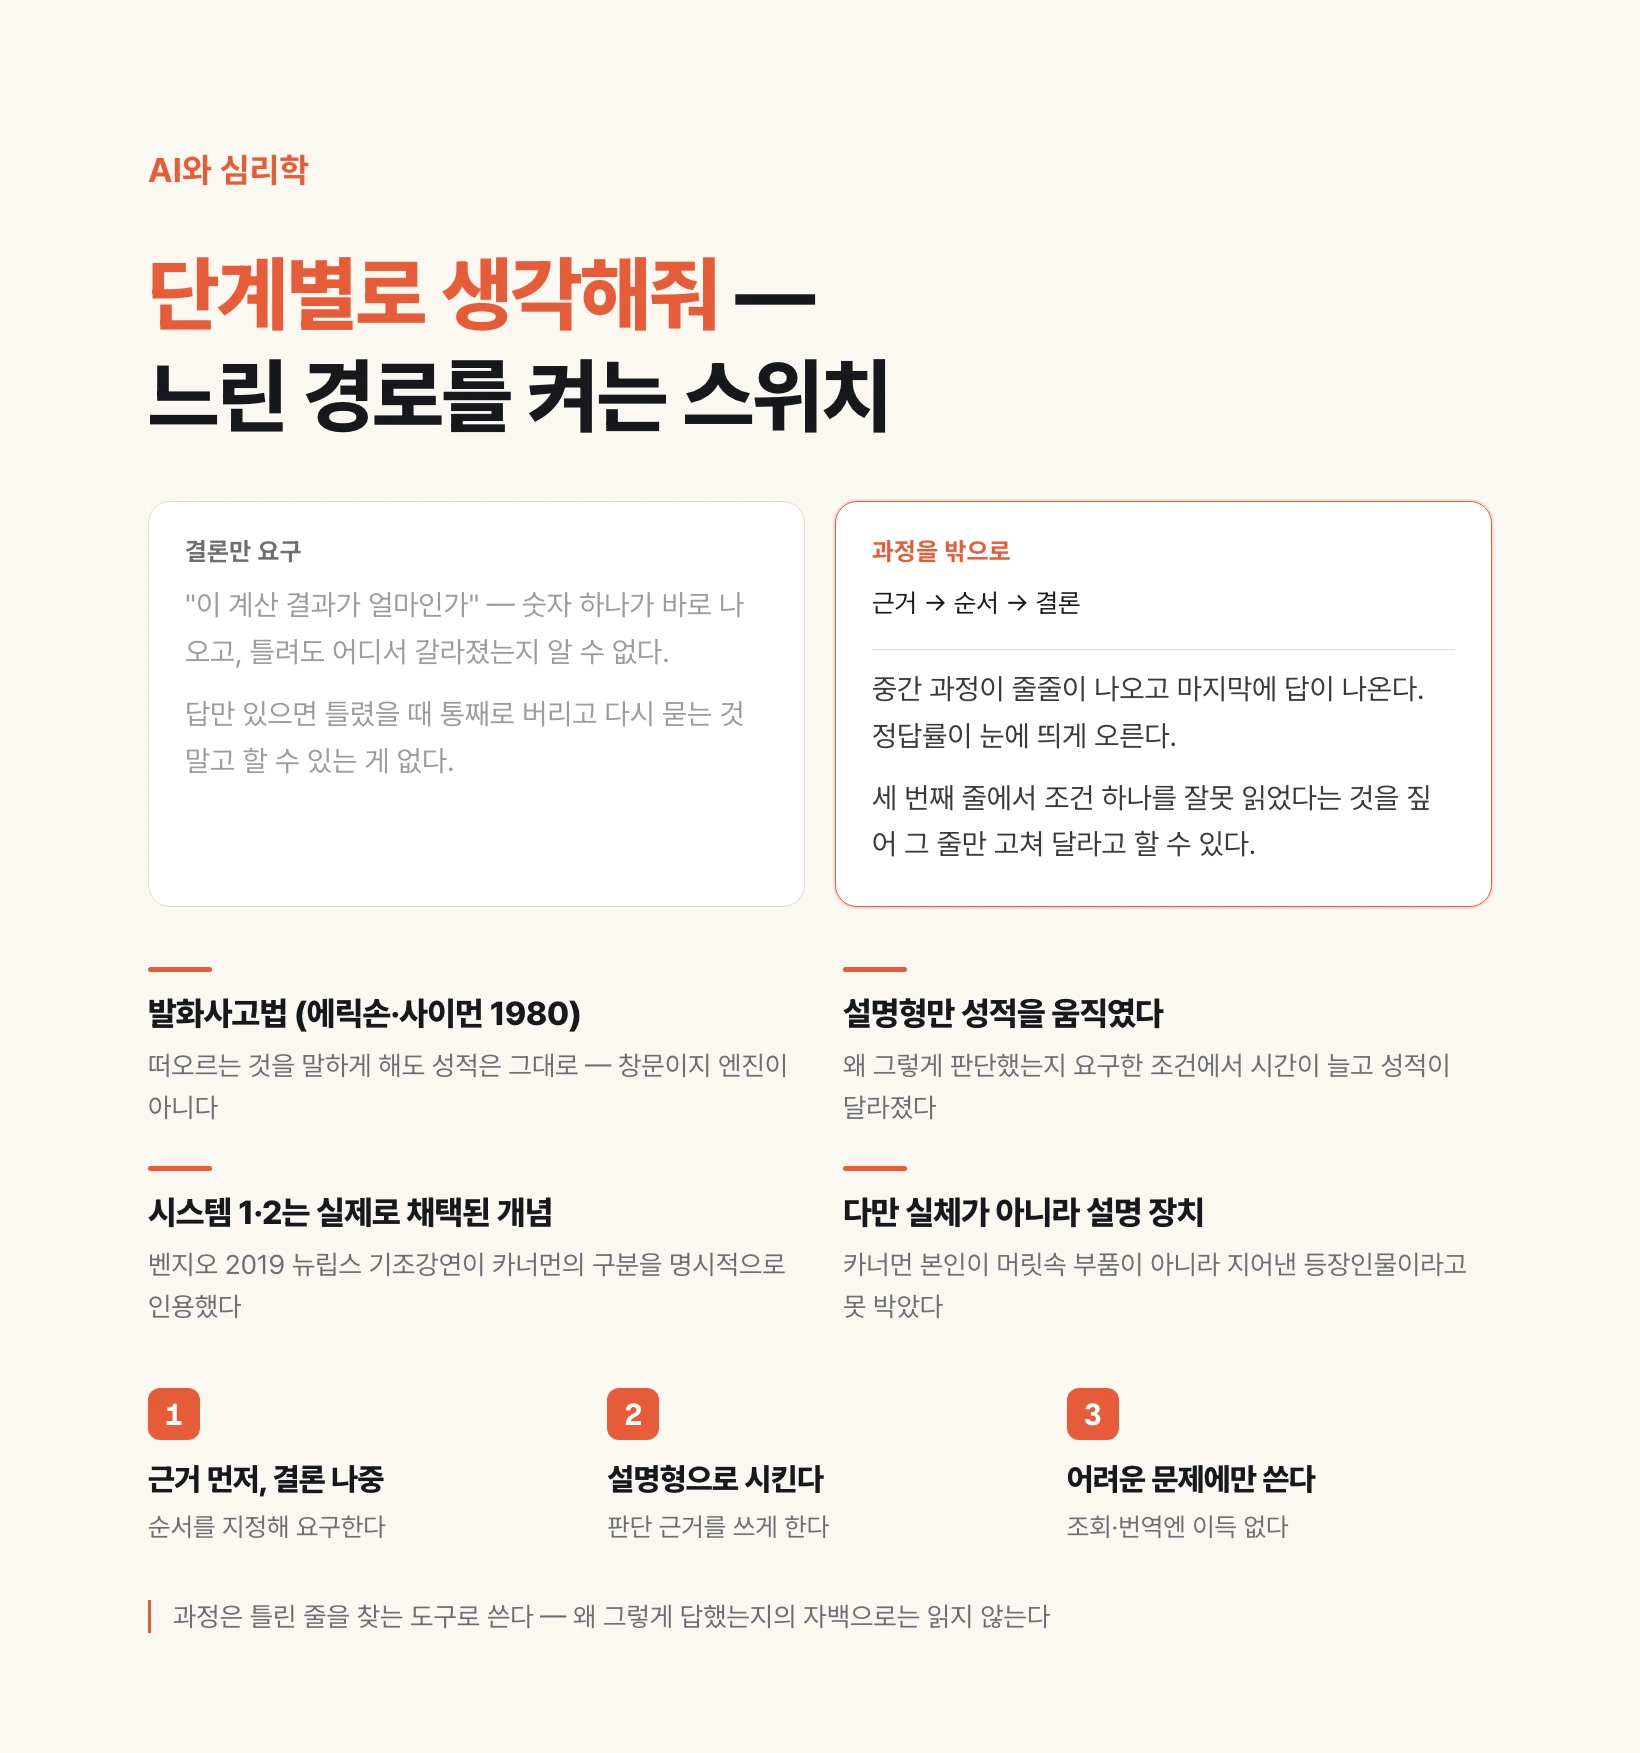
같은 문제를 두 가지 방식으로 물어보면 차이가 보인다.
첫 번째. 이 계산 결과가 얼마인가. 숫자 하나가 바로 나온다. 틀리기도 한다.
두 번째. 단계별로 생각해서 계산하라. 중간 과정이 줄줄이 나오고 마지막에 답이 나온다. 정답률이 눈에 띄게 오른다.
모델은 같다. 문제도 같다. 달라진 건 결론까지 가는 길을 밖으로 꺼내게 했다는 것뿐이다. 왜 이게 효과가 있는지, 그리고 어디까지 믿어도 되는지가 이번 회차의 내용이다.
1980년, 소리 내어 생각하게 하다
사람의 머릿속을 연구하는 데는 오래된 난점이 있다. 답만 보면 어떻게 그 답에 도달했는지 모른다. 맞았어도 어떻게 맞았는지 모르고, 틀렸어도 어디서 갈라졌는지 모른다.
카를 안데르스 에릭손과 허버트 사이먼이 1980년 논문에서 정리한 방법이 발화사고법이다. 문제를 푸는 사람에게 푸는 동안 머리에 떠오르는 것을 계속 소리 내어 말하게 한다.
설계에서 중요한 조건이 둘이다. 첫째, 푸는 동안 말하게 한다. 다 풀고 나서 회상시키지 않는다. 회상은 이미 정리되고 각색된 것이라 실제 과정과 다르기 때문이다. 6회차에서 본 재구성이 여기서도 작동한다.
둘째, 왜 그렇게 했는지 설명하라고 하지 않는다. 그냥 지금 머리에 있는 것을 말하게 한다. 이 두 번째 조건이 왜 중요한지는 잠시 뒤에 나온다.
그런데 이 방법의 요점은 반대였다
여기서 오해하기 쉬운 대목이 있다. 두 사람의 핵심 주장은 말하게 하면 더 잘 푼다가 아니라 그 반대에 가깝다.
그들이 논증하려던 것은 소리 내어 말하는 것이 사고 과정을 거의 바꾸지 않는다는 것, 그래서 그 말을 연구 데이터로 믿을 수 있다는 것이었다. 만약 말하게 하는 행위가 사고를 바꿔 버린다면, 관찰한 내용이 관찰하지 않았을 때의 사고와 달라져 데이터로서 쓸모가 없어진다.
이후 수십 개 연구를 모은 메타분석에서도 이 주장이 지지됐다. 참가자를 다 합치면 수천 명 규모인데, 떠오르는 것을 그대로 말하게 하는 조건의 성적은 말하지 않는 조건과 사실상 차이가 없었다.
즉 이 방법은 사고를 개선하는 기술이 아니라 관찰하는 도구다. 창문이지 엔진이 아니다.
다만 어떤 종류의 발화냐에 따라 다르다
그런데 같은 메타분석에서 갈라지는 지점이 있다. 무엇을 말하게 하느냐에 따라 결과가 다르다는 것이다.
머리에 떠오른 것을 그대로 말하는 조건은 성적에 영향이 없었다. 반면 왜 그렇게 생각하는지 설명하라고 요구한 조건은 달랐다. 푸는 시간이 늘어났고 성적도 움직였다. 어떤 과제에서는 좋아졌다.
이유는 짐작할 만하다. 설명하려면 이유를 만들어야 하고, 이유를 만들려면 방금 한 판단을 다시 들여다봐야 한다. 그 되돌아보는 행위 자체가 새 작업이다. 떠오른 것을 읊는 것과 근본적으로 다른 일을 시킨 셈이다.
이 구분이 중요한 이유는 AI에게 우리가 시키는 것이 첫 번째가 아니라 두 번째에 가깝기 때문이다. 단계별로 생각하라는 지시는 떠오르는 것을 읊으라는 뜻이 아니라 근거와 순서를 세워 보이라는 뜻이다. 사람에게서도 성적을 움직인 쪽이 그쪽이었다.
빠른 사고와 느린 사고
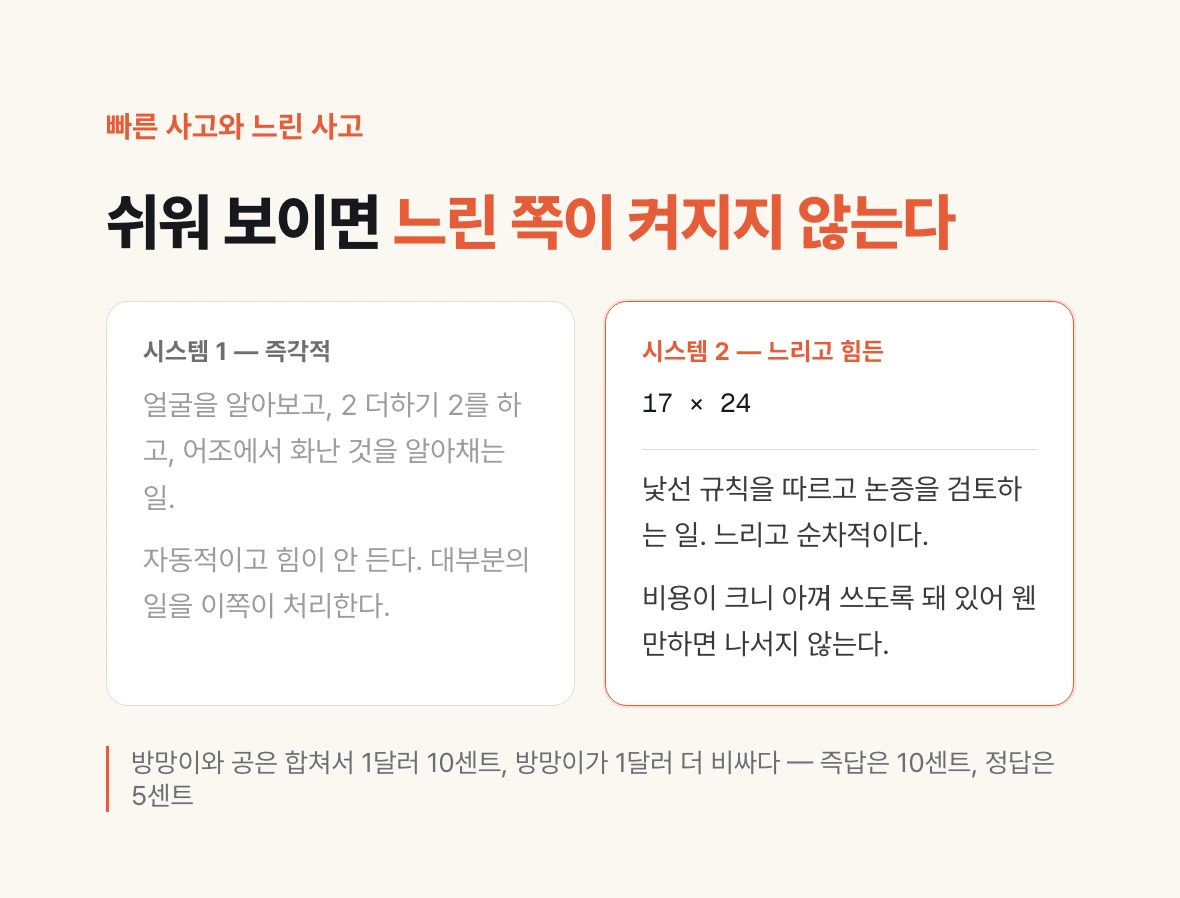
여기에 카너먼이 대중화한 구분이 붙는다. 시스템 1은 즉각적이고 자동적이며 힘이 안 든다. 얼굴을 알아보고, 2 더하기 2를 하고, 어조에서 화난 것을 알아채는 일이다. 시스템 2는 느리고 순차적이며 힘이 든다. 17 곱하기 24를 하고, 낯선 규칙을 따르고, 논증을 검토하는 일이다.
문제는 시스템 1이 대부분의 일을 처리하고 시스템 2는 웬만하면 나서지 않는다는 것이다. 느린 쪽은 비용이 크니 아껴 쓰도록 돼 있다.
그래서 쉬워 보이는 문제에서 사람은 자주 틀린다. 어렵다는 신호가 없으면 느린 쪽이 켜지지 않고, 즉각 떠오른 답이 그대로 나간다. 유명한 예가 방망이와 공 문제다. 합쳐서 1달러 10센트이고 방망이가 공보다 1달러 비쌀 때 공은 얼마인가. 10센트라는 답이 즉시 떠오르고, 많은 사람이 그대로 답한다. 정답은 5센트다.
여기서 얻을 교훈은 지식이 부족해서 틀린 게 아니라는 점이다. 계산할 줄 아는 사람이 계산을 안 해서 틀린다.
AI 연구가 이 구분을 가져다 썼다
이 부분이 이 회차의 계보다. 요슈아 벤지오가 2019년 뉴립스 기조강연 제목을 아예 시스템 1 딥러닝에서 시스템 2 딥러닝으로라고 붙였고, 카너먼의 구분을 명시적으로 인용했다.
진단은 이랬다. 지금 딥러닝이 잘하는 것은 즉각적 패턴 인식이다. 그림을 보고 고양이를 알아보는 일, 문장을 보고 자연스러운 다음 말을 고르는 일. 전부 시스템 1 쪽이다. 부족한 것은 순차적 추론, 인과 관계, 계획처럼 한 단계씩 밟아야 하는 일이다.
이후의 흐름이 그 방향이다. 답을 바로 내지 않고 중간 과정을 만들게 하는 프롬프트, 그리고 그 과정을 아예 모델 안에 넣어 답하기 전에 길게 생각하도록 만든 추론 모델. 단계별로 생각하라가 잘 듣는 이유는 그것이 느린 쪽을 강제로 켜는 스위치 역할을 하기 때문이다.
여기서 두 계보가 갈린다. 시스템 1과 2는 AI 연구가 심리학에서 실제로 가져온 개념이다. 반면 발화사고법과 중간 과정 프롬프트의 관계는 계보가 아니라 기능적 유사다. 원리가 이어진 게 아니라 하는 일이 닮았다.
그런데 원작자는 실체로 보지 말라고 했다
여기가 이 시리즈에서 정직하게 남겨야 할 대목이다.
첫째, 시스템 1과 시스템 2라는 이름은 카너먼이 만든 게 아니다. 그는 책에서 이 용어를 다른 연구자들에게서 빌려 왔다고 밝혔다. 널리 알려진 계기가 그의 책이었을 뿐이다.
둘째, 더 중요한 것은 그가 이 둘을 무엇이라고 규정했는가다. 그는 시스템 1과 2가 머릿속에 실제로 있는 부품이 아니라고 못 박았다. 설명을 위해 지어낸 등장인물에 가깝고, 이야기처럼 말하는 편이 이해에 유리해서 그렇게 쓴다는 것이다. 뇌 어딘가에 시스템 2 담당 부위가 있는 게 아니다.
그래서 이 회차의 배지는 계보가 아니라 부분 계보다. 개념이 실제로 채택된 건 맞다. 다만 심리학에서도 설명 장치였던 것이 AI로 넘어가면서 마치 구조인 것처럼 읽히기 쉽다. 모델 안에 시스템 1 회로와 시스템 2 회로가 따로 있는 게 아니다.
이 시리즈 마지막 회차가 그 계열의 이야기다. 심리학에서 빌려온 말이 AI에서 다른 뜻으로 굳는 자리들.
용어 하나만 — 이중처리
이중처리는 판단이 빠르고 자동적인 경로와 느리고 의도적인 경로 두 갈래로 이뤄진다는 관점이다.
주의할 점은 앞 절에서 말한 그대로다. 이건 뇌에 두 개의 부품이 있다는 해부학이 아니라 설명 틀이다. AI에 옮겨 쓸 때는 더 그렇다.
그럼에도 쓸모가 있는 이유는 언제 개입해야 하는지를 알려 주기 때문이다. 쉬워 보이는데 실은 조건이 얽힌 문제, 즉각 답이 떠오르는데 그 답이 함정인 문제. 사람에게서도 AI에게서도 그런 자리에서 느린 경로를 강제로 켜는 것이 이득이다.
과정이 보이면 무엇이 좋아지나
중간 과정을 꺼내는 진짜 이득은 정확도만이 아니다. 어디서 틀렸는지 짚을 수 있다는 것이 그만큼 크다.
답만 보면 틀렸을 때 통째로 버려야 한다. 다시 물어보는 것 말고 할 수 있는 게 없다. 과정이 있으면 세 번째 줄에서 조건 하나를 잘못 읽었다는 것을 알 수 있고, 그 줄만 고쳐 달라고 할 수 있다. 검증 비용이 확 줄어든다.
다만 여기에 반드시 붙여야 할 단서가 있다. 모델이 써낸 과정이 실제로 그 답을 만든 계산의 기록이라는 보장이 없다.
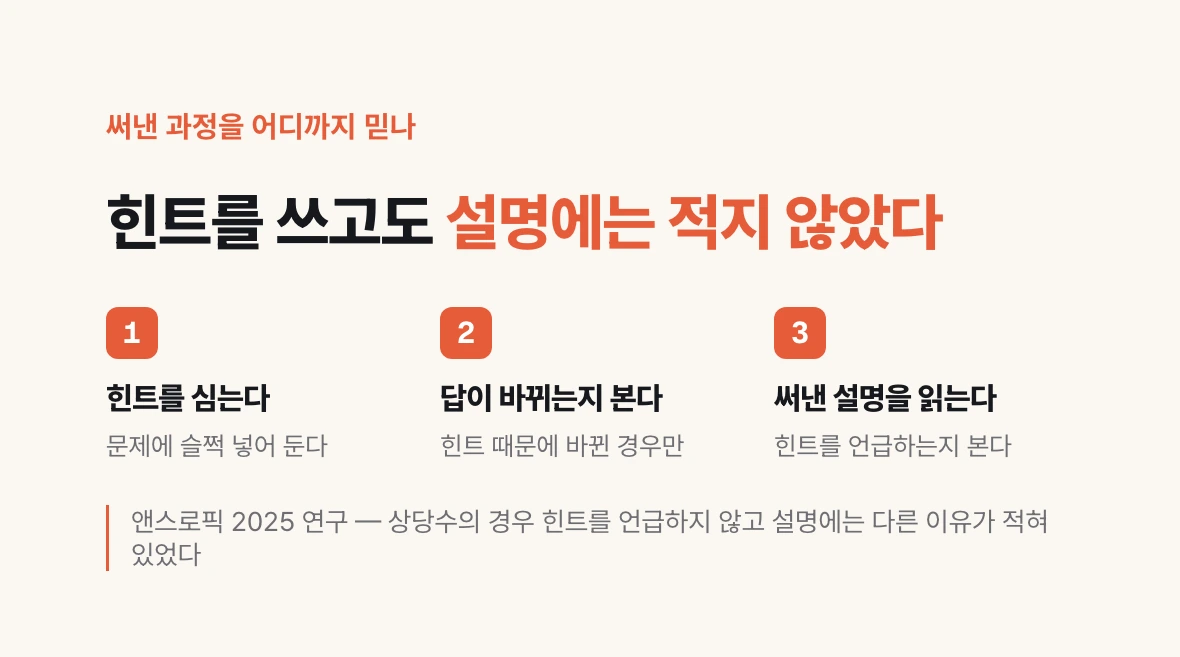
앤스로픽이 2025년에 낸 연구가 이 지점을 잰다. 문제에 힌트를 슬쩍 심어 두고 모델이 그 힌트 때문에 답을 바꾸게 한 다음, 써낸 설명에 그 힌트를 언급하는지 봤다. 상당수의 경우 언급하지 않았다. 힌트를 썼는데 설명에는 다른 이유가 적혀 있었다.
그러니 이렇게 정리하는 것이 맞다. 과정은 검사 대상으로는 매우 유용하고, 자백으로 대하면 곤란하다. 틀린 줄을 찾는 데는 쓰되, 이 모델이 왜 그렇게 답했는지의 최종 설명으로는 받지 않는다.
그래서 내일 뭘 바꾸나
중간 과정을 요구한다. 결론만이 아니라 근거를 먼저 쓰고 그다음 결론으로 순서를 지정한다. 결론을 먼저 쓰게 하면 나머지는 그 결론을 정당화하는 글이 된다. 6회차의 출처 먼저 규칙과 같은 이유다.
설명형으로 시킨다. 떠오르는 대로 나열해 달라가 아니라 각 단계에서 무엇을 근거로 그렇게 판단했는지 쓰라고 한다. 사람 실험에서도 성적을 움직인 쪽이 설명형이었다.
어려운 문제에만 쓴다. 단순 조회, 번역, 형식 변환에 단계를 요구하면 길고 느려지기만 한다. 계산, 비교, 조건이 여럿 얽힌 판단에서만 이득이 있다. 추론 모델을 쓸 때도 같은 판단이 필요하다.
즉답이 떠오르는 문제일수록 의심한다. 방망이와 공 문제의 교훈이다. 쉬워 보이는데 조건이 얽혀 있으면 그 자리가 정확히 느린 경로를 켜야 하는 자리다. 사람이 자기에게 쓸 때도 같다.
과정을 읽되 자백으로 읽지 않는다. 틀린 줄을 찾는 도구로 쓰고, 그 설명이 실제 이유라고 단정하지 않는다.