토큰을 과금 단위로만 알고 있다면
API 요금표를 보면 100만 토큰당 얼마라고 적혀 있다. 컨텍스트 한도도 20만 토큰, 100만 토큰으로 표시된다. 그래서 토큰을 '요금을 매기는 글자 수 비슷한 것'으로 알고 넘어가기 쉽다.
그런데 토큰은 과금을 위해 만든 단위가 아니다. 모델이 학습을 시작하기도 전에, 글을 기계가 다룰 수 있는 재료로 바꾸는 과정에서 어쩔 수 없이 생겨난 것이다. 과금은 그 결과를 빌려 쓴 것뿐이다.
이 순서를 알면 실무에서 자주 부딪히는 세 가지가 한꺼번에 설명된다. 한국어가 영어보다 비싼 이유, 같은 글인데 모델을 바꾸면 토큰 수가 달라지는 이유, 그리고 컨텍스트 한도를 글자 수로 환산하면 늘 어긋나는 이유다.
이 글은 그 과정을 처음부터 따라간다. 사전 지식은 필요 없다.
모든 것은 코퍼스에서 시작한다
코퍼스라는 말이 먼저 나온다. 전문 용어처럼 들리지만 뜻은 단순하다. 글뭉치다. 아주 많이 모아 놓은 글이다.
인터넷에는 글이 사방에 흩어져 있다. 블로그에도 있고 홈페이지에도 있고 SNS에도 있다. 깃허브에 올라온 코드도 결국 쓰여 있는 문자이니 글이다. 로그인 없이 그냥 보이는 공개된 글만 모아도 사람이 가늠하기 어려운 양이 된다.
그것을 한 군데로 이어 붙인 거대한 글 덩어리, 그게 코퍼스다. 모델이 될 재료의 출발점이 여기다.
여기서 목적지를 먼저 정해 두면 이해가 쉽다. 만들려는 것은 '우리 점심 메뉴는' 다음에 무엇이 올지 맞히는 기계다. 앞을 보고 다음에 올 것을 예측하는 기계. LLM이 하는 일은 근본적으로 이것 하나다.
데이터와 데이터셋은 다르다
글을 아무리 많이 모아도 그대로는 학습에 못 쓴다. 기계가 학습하려면 규격에 맞게 정리된 형태가 필요하고, 그렇게 정리된 것을 데이터셋이라고 부른다. 데이터와 데이터셋은 다른 말이다.
그래서 코퍼스를 학습 재료로 바꾸는 전처리가 먼저 온다. 그 전처리의 결과물이 토큰이다.
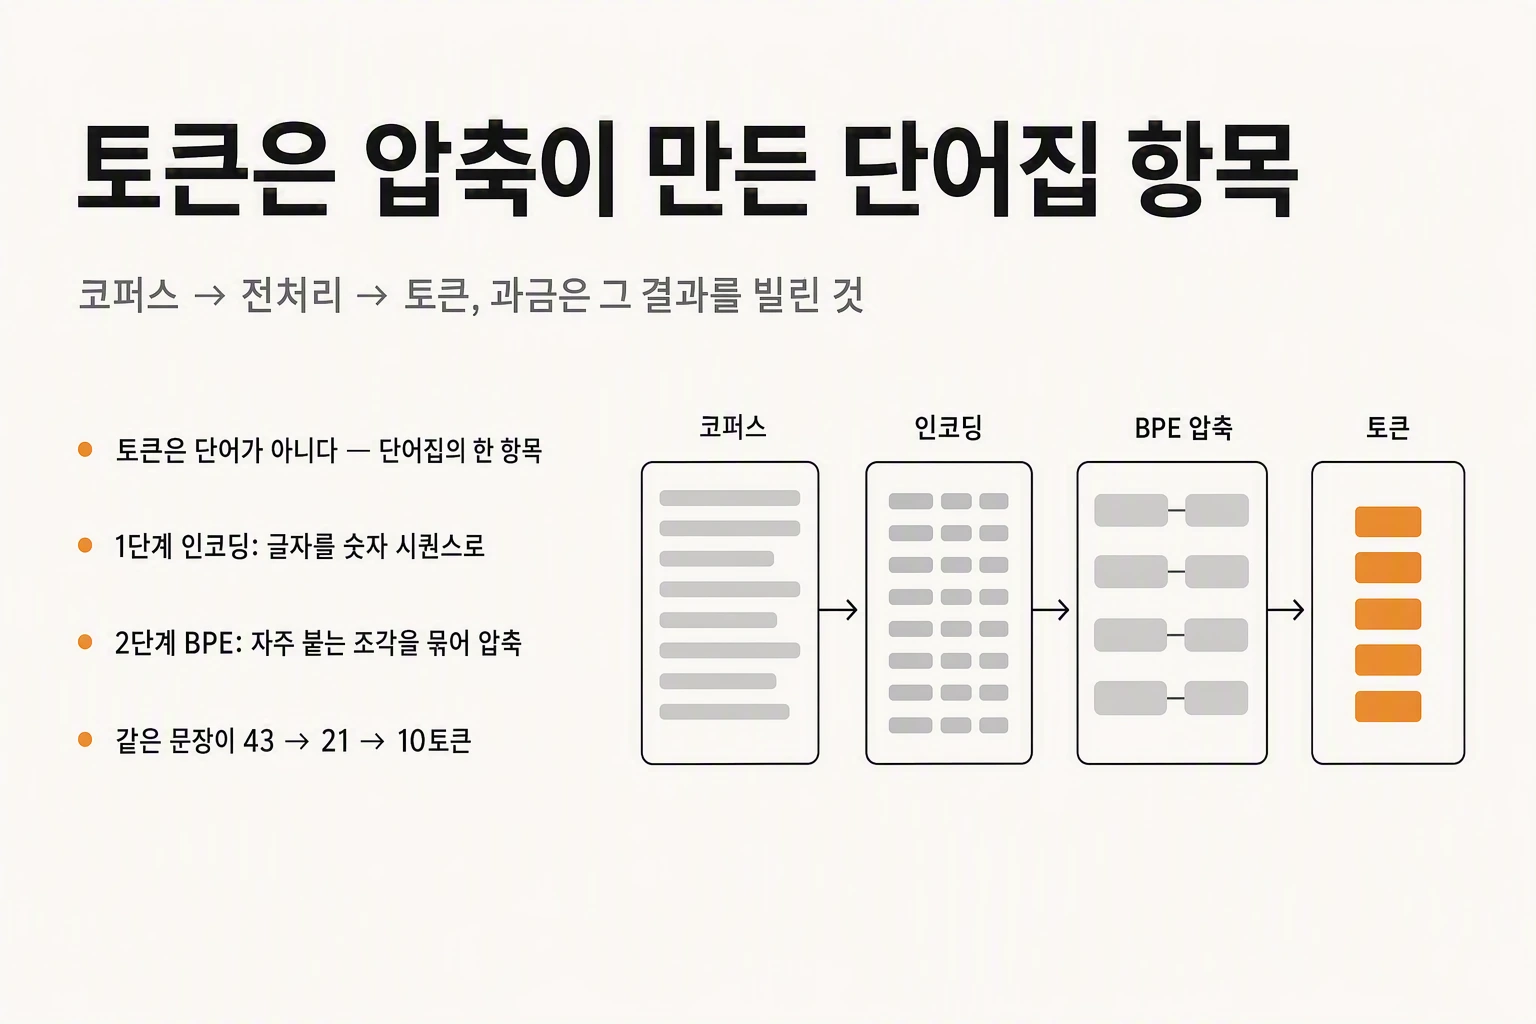
정리하면 순서는 이렇다. 코퍼스(그냥 긴 글) → 전처리 → 토큰(학습 재료). 지금부터 볼 것은 가운데 화살표 안에서 벌어지는 일이다. 두 단계로 나뉜다.
1단계 — 글자를 숫자로 바꾼다
컴퓨터는 글자를 모른다. 숫자만 다룬다. 그래서 첫 단계는 글자를 숫자로 바꾸는 일이고, 그 규칙을 인코딩이라고 한다.
인코딩이라는 말은 아마 다른 데서 이미 마주쳤을 것이다. 파일을 받았는데 한글이 깨져서 검색해 보면 나오는 그 인코딩이다. 지금 세계에서 가장 널리 쓰이는 방식이 UTF-8이다.
UTF-8에서 한글 한 글자는 3바이트로 저장된다. 1바이트는 0 또는 1이 여덟 자리 늘어선 것이고, 여덟 자리면 경우의 수가 256가지다. 0부터 세니까 0~255다. 네트워크 설정에서 255라는 숫자를 자주 보는 것도 같은 이유다.
이 규칙을 코퍼스 전체에 적용하면 세상의 모든 글자가 — 한글이든 영어든 이모지든 특수기호든 — 숫자로 바뀐다. 글 전체가 숫자의 긴 나열이 된다. 이 나열을 시퀀스라고 부른다.
여기까지가 1단계다. 아직 토큰은 나오지 않았다.
2단계 — 반복되는 조각을 묶어 압축한다
숫자 나열을 그대로 쓰면 너무 길다. 그래서 압축한다.
이미지 압축을 떠올리면 감이 온다. 원본 이미지를 JPG로 줄일 때 하는 일은 반복되는 패턴을 찾아 한 번만 기록하고 나머지는 참조로 바꾸는 것이다. 글에서도 같은 발상을 쓴다.
긴 글을 훑어보면 똑같은 조합이 계속 나온다. 한국어라면 '습니다'가 수없이 반복되고, 영어라면 'ing'나 'the'가 그렇다. 이렇게 자주 붙어 다니는 조각을 찾아 하나의 항목으로 묶는다. 그 묶음 목록이 단어집, 영어로 vocabulary다.
묶는 규칙은 알고리즘이 정한다. 가장 널리 쓰이는 것이 BPE(Byte Pair Encoding)로, 가장 자주 붙어 다니는 두 조각을 하나로 합치는 일을 정해진 횟수만큼 반복한다. 그 결과로 만들어진 단어집의 항목 하나하나가 바로 토큰이다.
그래서 토큰의 정의는 이렇게 된다. 토큰은 단어가 아니다. 압축 알고리즘이 만들어 낸 단어집의 한 항목이다.
직접 세어 보면 바로 보인다
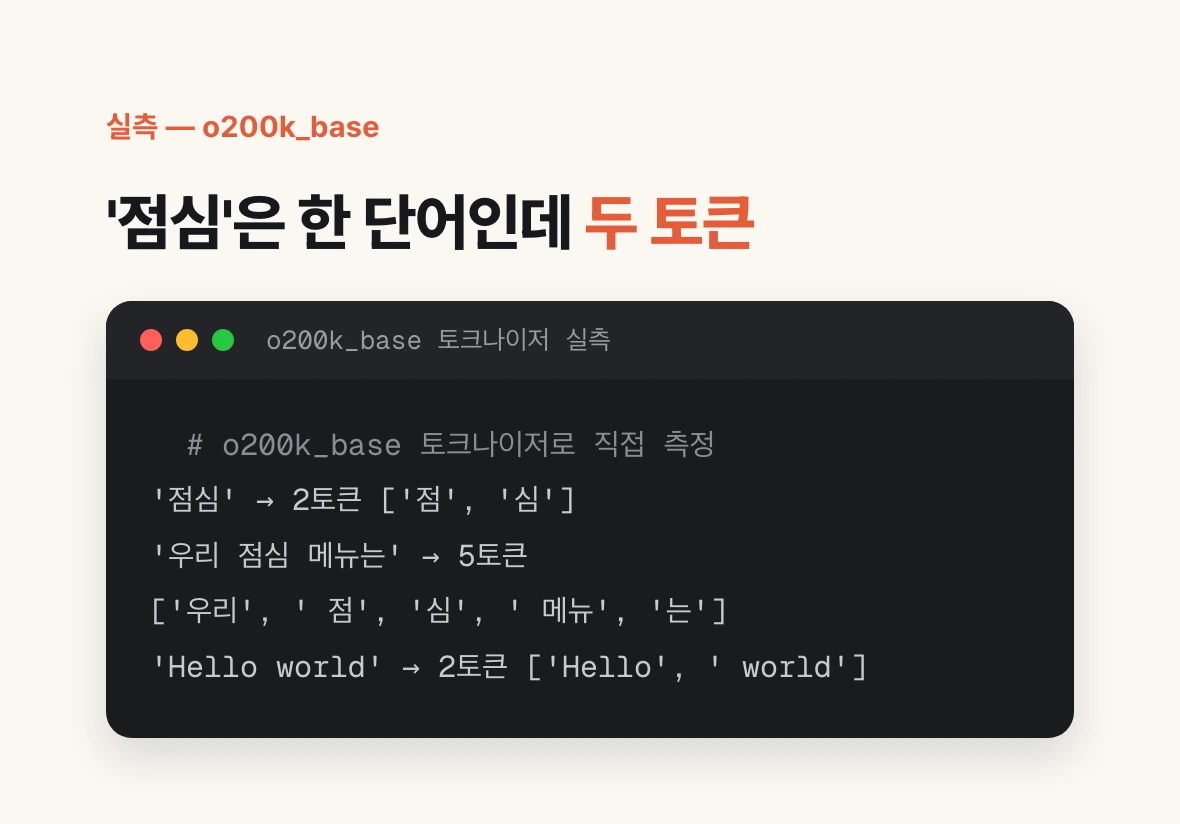
말로 들으면 추상적이니 실제로 세어 보자. 아래는 GPT-4o 계열이 쓰는 o200k_base 토크나이저로 직접 측정한 결과다.
'점심'은 한 단어인데 '점'과 '심' 두 토큰으로 쪼개진다. '우리 점심 메뉴는'은 눈으로 세면 세 덩어리인데 토큰으로는 다섯 개다. 앞의 빈칸이 다음 조각에 붙어 다니는 것도 보인다.
여기서 토큰이 단어도 글자도 아니라는 게 분명해진다. 단어보다 잘게 쪼개질 때도 있고, 여러 단어가 하나로 붙을 때도 있다. 기준은 오직 '학습 코퍼스에서 얼마나 자주 붙어 다녔나'다.
'점심'            → 2토큰   ['점', '심']
'우리 점심 메뉴는' → 5토큰   ['우리', ' 점', '심', ' 메뉴', '는']
'Hello world'     → 2토큰   ['Hello', ' world']
같은 문장이 모델마다 43토큰, 21토큰, 10토큰
단어집은 학습할 때 코퍼스로부터 함께 만들어진다. 그래서 모델이 다르면 단어집도 다르고, 같은 문장의 토큰 수도 달라진다.
'우리 점심 메뉴는 무엇으로 할까요?'라는 한 문장을 세 토크나이저로 재 봤다. GPT-3 시절의 p50k_base에서는 43토큰, GPT-4의 cl100k_base에서는 21토큰, GPT-4o의 o200k_base에서는 10토큰이 나온다. 같은 문장인데 4배 넘게 차이가 난다.
그런데 영어 문장 'What should we have for lunch?'는 셋 다 7토큰으로 동일하다. 차이가 오직 한국어에서만 벌어진 것이다.
이유는 단어집의 크기와 구성에 있다. 초기 토크나이저는 영어 중심으로 만들어져 한국어 조각이 단어집에 거의 없었다. 그러면 한글은 UTF-8 바이트 단위로 잘게 부서진다. cl100k_base로 '점심'을 분해해 보면 글자 경계가 아니라 바이트 중간에서 잘려 깨진 조각으로 나온다. 이후 모델들이 단어집을 키우면서 한국어 조각이 통째로 들어갔고, 그래서 토큰 수가 줄었다.
한국어가 영어보다 비싸다는 말은 여기서 나온 것이다. 그리고 그것이 고정된 사실이 아니라 모델 선택에 따라 달라지는 값이라는 점이 실무에서 중요하다.
직접 확인하는 법
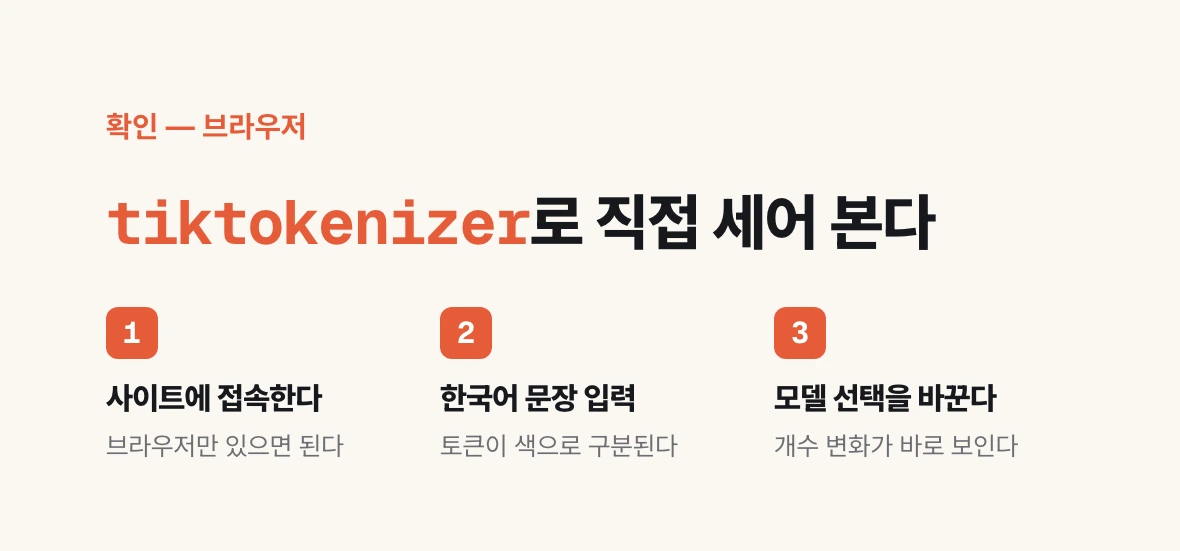
설명을 읽는 것보다 한 번 세어 보는 편이 빠르다. 브라우저만 있으면 된다.
tiktokenizer.vercel.app에 접속한다. 왼쪽 입력창에 아무 문장이나 한국어로 넣는다. 오른쪽에 토큰이 색깔로 구분되어 표시되고 아래에 총 개수가 나온다. 화면 위의 모델 선택을 바꾸면 같은 문장의 토큰 수가 어떻게 달라지는지 바로 보인다.
여기서 확인해 볼 것 세 가지를 권한다. 첫째, 자주 쓰는 한국어 문장과 그 영어 번역을 나란히 넣어 개수를 비교한다. 둘째, 모델을 바꿔 가며 같은 한국어 문장의 개수 변화를 본다. 셋째, 회사 이름이나 제품명처럼 흔하지 않은 고유명사를 넣어 본다. 흔하지 않은 말일수록 잘게 쪼개진다는 것이 눈으로 보인다.
세 번째가 특히 쓸모 있다. 프롬프트에 고유명사를 반복해 넣는 구조라면 그 부분에서 토큰이 예상보다 많이 소모되고 있을 가능성이 높다.
이 개념이 실무에서 걸리는 자리
첫째, 비용 추정이다. 글자 수로 토큰을 환산하면 한국어에서는 대체로 어긋난다. 실제 쓸 모델의 토크나이저로 대표 프롬프트를 재 보는 것이 정확하다.
둘째, 컨텍스트 한도다. 20만 토큰이 몇 글자인지는 언어와 모델에 따라 달라진다. 한도에 얼마나 여유가 있는지 알려면 역시 재 봐야 한다.
셋째, 모델 교체다. 더 싼 모델로 바꿨는데 비용이 기대만큼 안 줄었다면, 단가는 내렸지만 토크나이저가 한국어를 더 잘게 쪼개서 토큰 수가 늘었을 수 있다. 단가와 토큰 수를 함께 봐야 실제 비용이 나온다.
이 셋은 전부 '재 보면 알 수 있는' 문제다. 그리고 재는 데 5분이 걸리지 않는다.
여기까지가 재료다
코퍼스를 모으고, 숫자로 바꾸고, 반복을 묶어 토큰을 만들었다. 이제 학습에 쓸 재료가 준비된 것이다.
다음 편에서는 이 재료로 신경망이 실제로 어떻게 학습하는지를 본다. 답을 가리고 맞혀 보게 한 뒤 틀린 만큼 되돌려 고치는 과정이고, 그 '고치는 대상'이 바로 파라미터다. 모델 이름 옆에 붙는 7B, 70B 같은 숫자가 무엇을 세고 있는지도 그때 분명해진다.