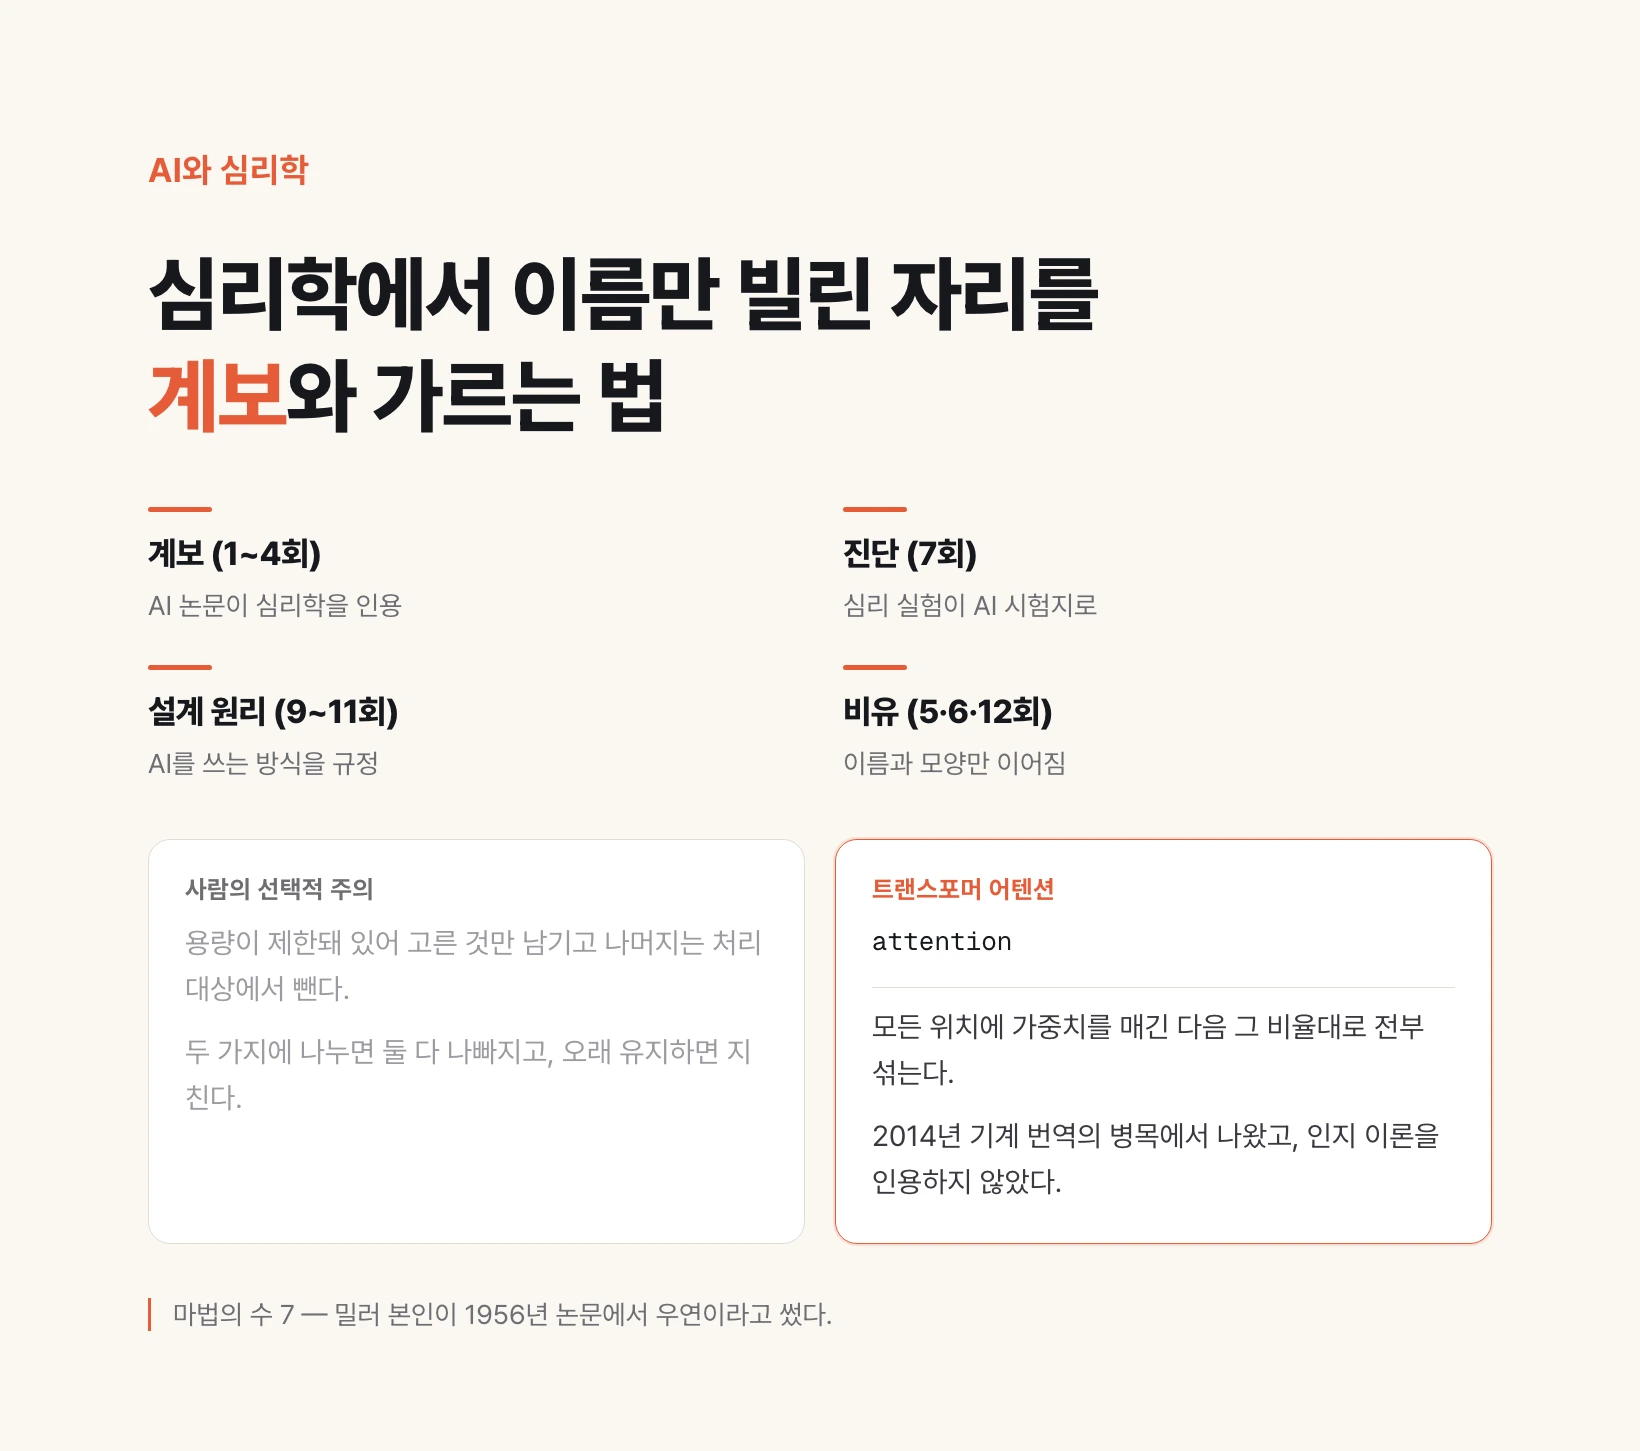
十一回の話をここで仕分ける
この十一編で異なる種類の話をしてきた。文献でたどれる系譜があった。パブロフから強化学習へ、猫の視覚野からCNNへ、ヘッブからPDPへ、バドリーから外部メモリへ。
心理学の実験設計がAIを測る物差しになった場合もあった。アンカリングがそれだ。心理学と人間工学の知識がAIの技法ではなくAIの使い方を規定した場合もあった。擬人化、自動化の皮肉、使い方の四分類である。
そして理解を助ける比喩があった。アッシュの同調とお世辞、バートレットの記憶と幻覚。
回ごとにバッジを付けた理由がこの回だ。AIの記事で心理学の用語を見たら、それが系譜なのか名前なのかを問わねばならない。その見分け方を三つの事例で整理し、連載全体を等級にまとめて締める。
アテンション — 名前だけが同じ
いま使う言語モデルの中核装置がアテンションだ。ところがこれは、この連載が扱ったどの系譜とも違う。
この装置が出てきた場所は2014年の機械翻訳である。当時主流だった再帰型ネットワークは文を先頭から一つずつ読んで状態を更新していたが、文が長くなると先頭が薄れた。長い文を丸ごと固定長のベクトル一つに押し込まねばならなかったからだ。
そこで出た解法が、デコーダが出力語を作るたびに入力のどの位置でも見返せるようにすることだった。この語を出すとき入力のどこが関係するかを毎回計算させたのである。この装置を最初に出した論文は、これを整列の問題として解いた。翻訳におけるどの原文語がどの訳語に対応するかという古い問題だ。
つまり出発点は認知理論ではなく工学的な隘路である。ブロードベントのフィルタモデルやカクテルパーティ効果のような選択的注意理論を引用して設計したのではない。アテンションという名は、その計算がしていることを説明するのに便利だから付き、その後に標準用語として固まった。
人の注意と何が違うのか
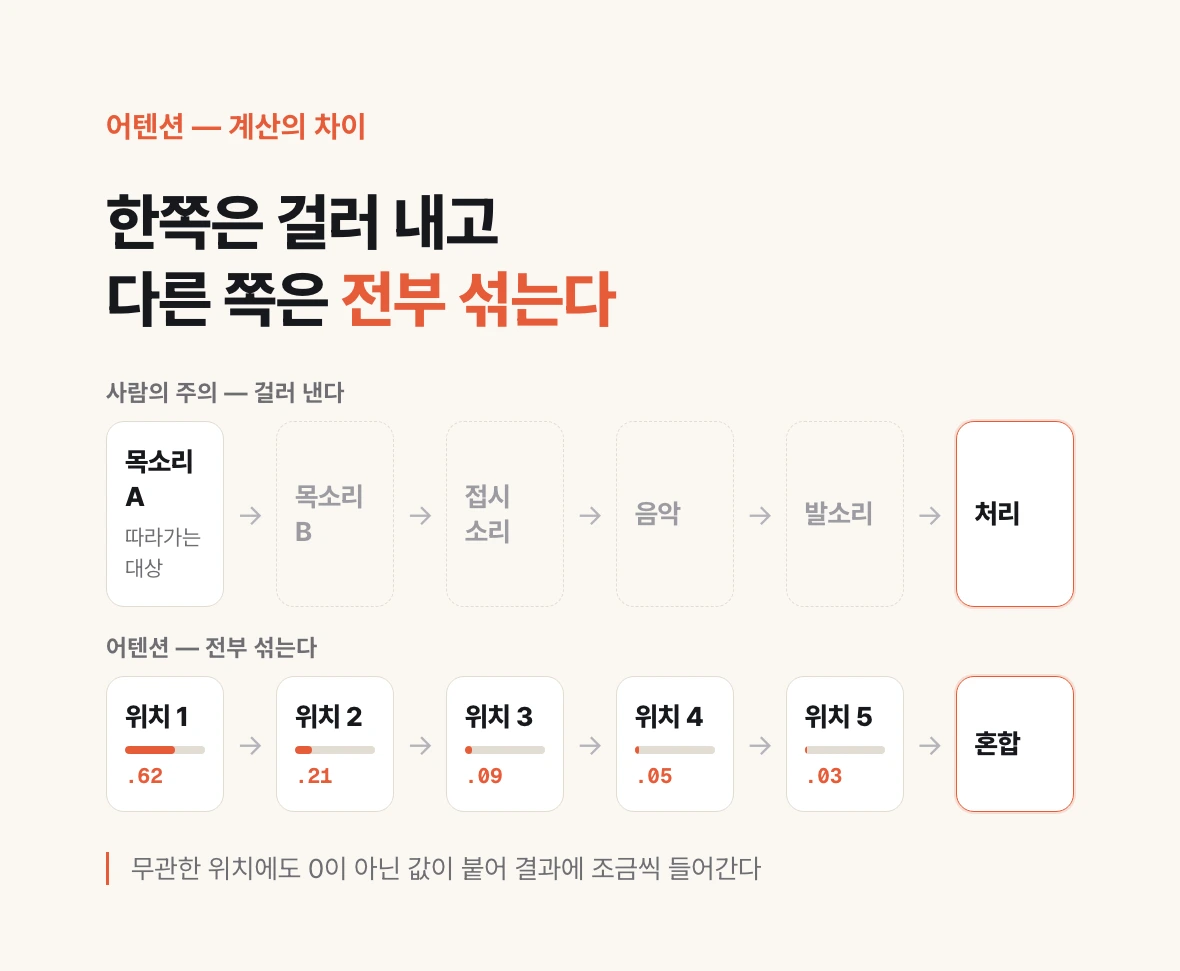
名前が同じなら計算も同じだと思えるが、実際にしていることが違う。差は一文で片づく。人の注意はふるい落とし、トランスフォーマーのアテンションは重みを置く。
選択的注意理論の核心は捨てることだ。騒がしい会場で一人の声を追うとき、残りの音はかなりの部分が処理の対象から外れる。容量が限られているので選ばねばならず、選ばれなかったものはたいてい入ってこない。
アテンションは逆だ。すべての位置に重みを付け、その重みどおりに全部を混ぜる。無関係な位置にもゼロでない値が付き、その値が結果に少しずつ入る。ふるいではなく配合比を決める装置である。
この違いが些細でない理由がある。人の注意について私たちが知る性質の多くは容量制限から出ている。二つに同時に集中すれば両方悪くなり、注意を長く保てば疲れ、訓練すれば特定の対象への選択が速くなる。これらをアテンションにそのまま移せば全部誤りだ。
だからAIが注意を向けるという言い方は比喩であって、心理学的現象の実装ではない。名前がよくできているので誤解が長持ちする。
コンテキストウィンドウ — 7プラスマイナス2と何の関係もない
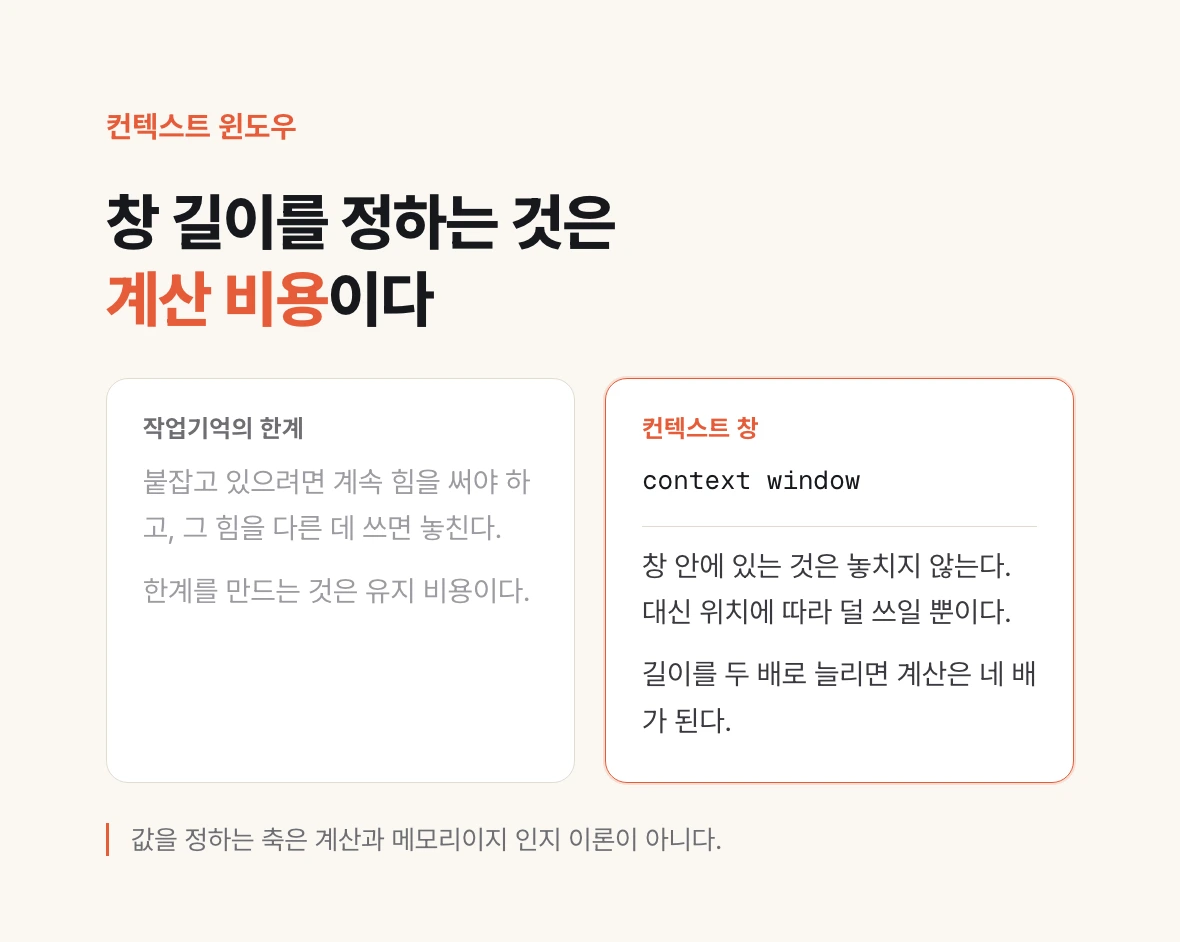
AIの記憶容量という表現とともにミラーのマジカルナンバー7プラスマイナス2が引かれるのをよく見る。二重に誤った引用だ。
第一に、コンテキストウィンドウの長さを決めるのは計算費用である。アテンションがすべての位置の対を見るため、計算量が長さの二乗で増える。長さを倍にすれば計算は四倍だ。この費用を減らす技法が次々に出て窓は広がってきたが、値を決める軸は依然として計算とメモリであって認知理論ではない。
第二に、そもそも二つの概念は測っているものが違う。作業記憶の限界は第4回で見たとおり維持費用の問題だ。つかみ続けるには力を使い続けねばならず、その力を別に使えば落とす。コンテキストの窓はそうではない。窓の中にあるものは落ちない。ただ位置によって使われ方が薄くなるだけだ。
もちろん実務では二つの話が交わる点がある。第4回で見たとおり窓が広いからといってよく使われるわけではなく、だから作業台を片づける工夫が要る。ただしそれは容量が7だからではない。
ミラー本人がその数字を否定した
もっと面白いのは元の論文のほうだ。マジカルナンバー7は、引用されるようなかたちで主張されたことがない。
1956年の論文の末尾でミラーはこう書く。これらすべての7の背後に深く玄妙な何かがあるのかもしれないが、私はそれが有害なピタゴラス的偶然にすぎないと疑っている。世界の七不思議、七つの海、七つの大罪を並べたあとに来る一文だ。著者がその数字を神秘化するなと直接言っているのである。
1989年にはもっとはっきり述べている。あの論文は別々の二つの研究の流れを扱っており、7という数字はそれを一つの講演にまとめるための修辞的な装置だった、と。発見された定数ではなく物語の継ぎ目だったのだ。
ついでによく付いてくる、だから電話番号が七桁だという説明も根拠がない。時期が重なるだけで因果を裏づける記録がない。
この連載が繰り返してきた教訓がここでまた出る。有名な数字ほど原典を確かめること。広く引かれていることは広く読まれたことを意味しない。
幻覚という語も正確ではない
第6回で幻覚を扱ったが、その名前自体が今回の題材だ。
臨床で幻覚は知覚の問題である。ないものが見えたり聞こえたりすることだ。ところがモデルが存在しない論文をこしらえるのは知覚の問題ではなく記憶と言明の問題である。第6回で見たとおり、より正確な相手は作話だ。空白を自覚なく埋め、それを確信すること。
この名が付いた経路も心理学からの直輸入ではない。この語はAIの中で先に別の意味で使われていた。低解像度の画像に存在しない細部をもっともらしく作り出す作業を呼ぶ名があり、その用法が言語のほうへ移ってきた。つまり心理学の概念を借りたのではなく、分野内の慣用語が拡張されたのである。
だから研究者のあいだでもこの用語は適切でないという指摘が出る。一つはいま述べた正確さの問題で、もう一つはこの語が病理を連想させる点だ。幻覚と呼ぶと、普段はまともなのにときどきおかしくなるように聞こえるが、実際には正常な動作の延長線上にある。
それでもこの連載が幻覚という語を使い続けたのは、通用している語だからだ。ただし使いながら何を知っているかが違う。
幻覚とお世辞 — 比喩は有用で、原因は違う
第6回と第5回の比喩をここで回収する。
幻覚は作話症と形が驚くほど似ている。空白に気づかず、埋めた結果を確信し、指摘されるまで平然としている。しかし原因は損なわれた記憶回路ではなく、次の語を確率で選ぶ構造、学習データの隙間、そして棄権に点を与えない採点の仕方だ。
お世辞はアッシュの同調と結果が同じである。圧力が来れば引き下がる。しかし原因は集団の圧力ではなく、人の選好データが同意する答えに高い点を付けてきた履歴だ。
二つの比喩を使い続ける理由ははっきりしている。処方が変わるからだ。嘘と見れば正直さを求めることになるが、空白埋めと見れば材料を供給することになる。性格が甘いと見れば毅然と言えと求めることになるが、採点表の産物と見れば自分の意見を先に言わないようになる。
よい比喩は原因の説明ではなく行動を変える道具である。この連載で比喩等級の回が実用項目を最も多く出したのも偶然ではない。
ではどこまでが本当だったのか
この連載で扱ったものを整理すると四等級になる。最初は三つに分けたが、それだと第9回から第11回の行き場がなかった。あの三つは心理学がAIの技法を作ったのではなく、AIの使い方を規定した場合なので別に立てる必要がある。
第一に、アルゴリズムの系譜。AI論文が心理学の文献を引用して技法を作ったものだ。強化学習はパブロフとレスコーラ・ワグナーからサットン・バルトへ、CNNはヒューベル・ウィーゼルから福島を経てルカンへ、コネクショニズムはヘッブからPDPへ、外部メモリはバドリーからニューラル・チューリング・マシンへとつながる。第1回から第4回。
第二に、診断。心理学の実験設計がAIを測る物差しとして使われるものだ。アンカリングをはじめとする認知バイアスの一覧がそのまま試験問題になった。第7回。
第三に、設計原理。心理学と人間工学の知識がAIの技法ではなく運用の仕方を規定するものだ。擬人化、自動化の皮肉、使い方の四分類。系譜と呼ぶにはAIアルゴリズムの祖先ではなく、比喩と呼ぶにはそのまま当てはまる。第9回から第11回。
第四に、比喩。名前や形だけがつながったものだ。アテンション、コンテキストウィンドウ、幻覚、お世辞。第5回、第6回、そして今回である。
第8回は一回の中で分かれる。システム1と2はAI研究が実際に採用したので第一に近く、発話思考法と思考の連鎖の関係は第四だ。だからバッジが部分系譜だった。
名前が付いた瞬間に何が起きるか
とはいえ名前が少し合わないのがなぜ問題なのか。通じればよいのではないか。
問題は名前が単独では来ないことにある。ある概念の名前を借りると、その概念に付いている他の性質まで根拠なく一緒に入ってくる。
注意と呼べば、人はそれが限られた資源だと仮定し、分散すれば悪くなると仮定し、訓練でよくなると仮定する。記憶容量と呼べば、人の記憶のように時間が経てば薄れると仮定し、容量の近くで性能が急に落ちると仮定する。どれも確かめられたことがない。
これが組織で実際の費用になる場所がある。この道具は人のように働くから人を扱うようにすればよい、という結論が導入の判断に入るときだ。第9回で見た語調を能力として読む癖も同じ根である。
逆方向の危険もある。名前が合わないという理由で本物の系譜まで否定することだ。強化学習がパブロフを引用したのは事実であり、ニューラル・チューリング・マシンがバドリーを引用したのも事実である。全部比喩だと畳めばそれも誤りだ。
では明日から何を変えるか
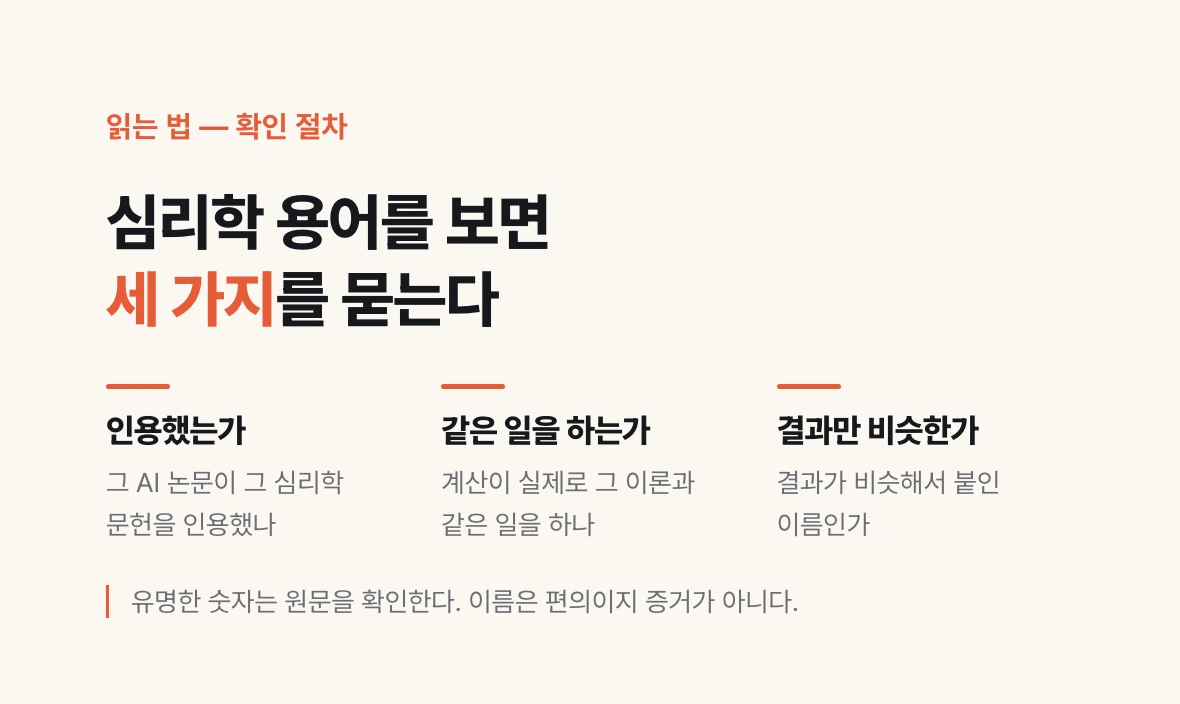
AIの記事で心理学の用語を見たら三つを問う。そのAI論文はその心理学の文献を引用したか。計算は実際にその理論と同じことをしているか。それとも結果が似ているので付けた名前か。三つのどれに当たるかを決めるだけで、その記事の読み方が変わる。
用語が同じだからといって性質も同じだと畳まない。AIが注意を向けるから人の注意の性質を推し量れば誤りで、AIの記憶容量から人の記憶の限界を持ってくれば誤りだ。名前は便宜であって証拠ではない。
有名な数字は原典を確かめる。7プラスマイナス2が最良の例だ。広く引かれているものと著者が主張したものは違いうる。この連載でも実際に何度もそうだった。
それでも比喩は捨てない。この連載の結論は比喩を使うなではなく、比喩と知って使えということだ。知って使えば道具であり、知らずに使えば誤解である。
そしてこの十二編を貫く一文があるとすればこれだ。AIを理解するのに最も役立った心理学は、AIの心を説明してくれる心理学ではなく、AIを前にした自分の判断がどう狂うのかを教えてくれる心理学だった。