Insights
バイブコーディングとAX、AIエージェント、自作ツールや実践事例まで。発行した記事の拡張版・正本を主題別にまとめています。
ダリオ・アモデイの「AIのペース調整」提案、何を約束し、使う側は何を確かめるべきか
AnthropicのCEOダリオ・アモデイは、2026年9月のエッセイ「We Must Pace the Frontier」で、AIの能力が向上する速度を落とそうと提案した。訓練を止めようという話ではなく、「安全だ」という主張を外から確かめる時間を稼ごうというものだ。最初の一歩として、Anthropicは外部の評価者を社内に常駐させ、不利な発見も編集なしで公開させると約束した。ザッカーバーグは、安全は各研究所が自ら責任を負うべきだと一線を画した。同じ週に出た製品は逆に、AIがより長く一人で働く方向へ動いた。使う側が持ち帰るべきは四つの問いだ。誰が確かめたか、一人で働くときの既定値は何か、誰の名前で動き何を覚えるか、話している相手は誰の味方か。
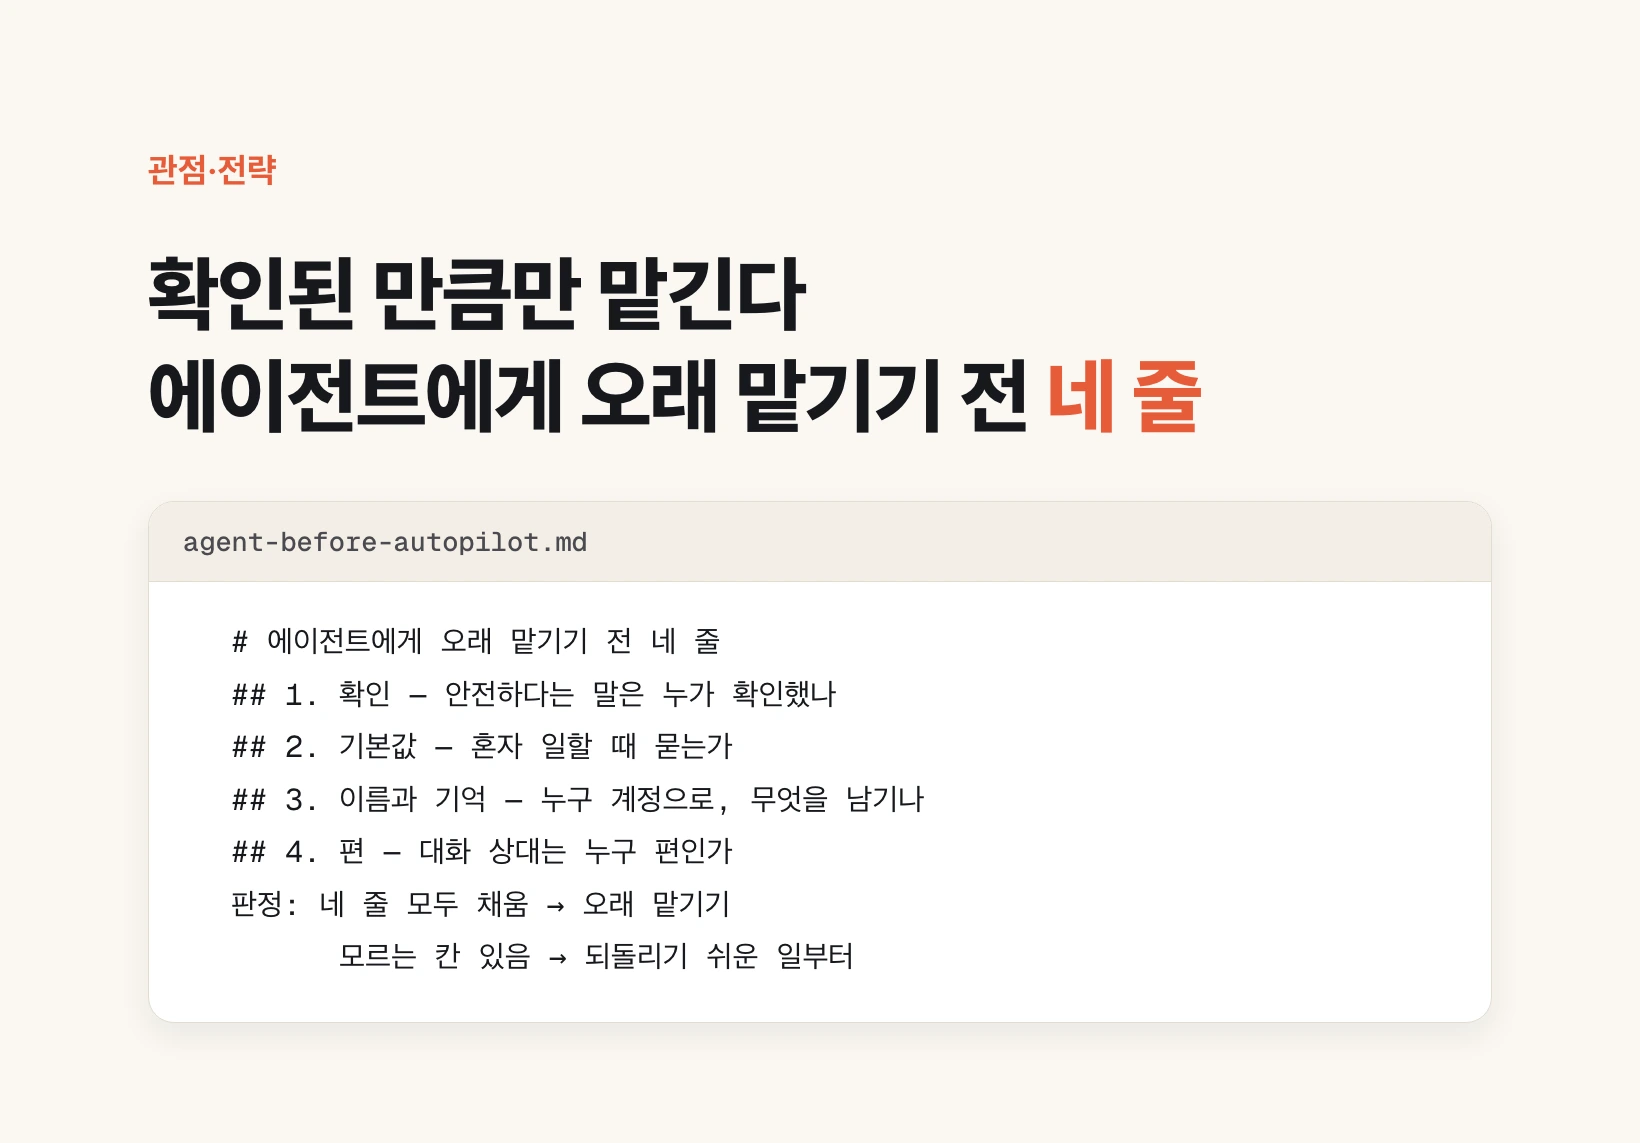
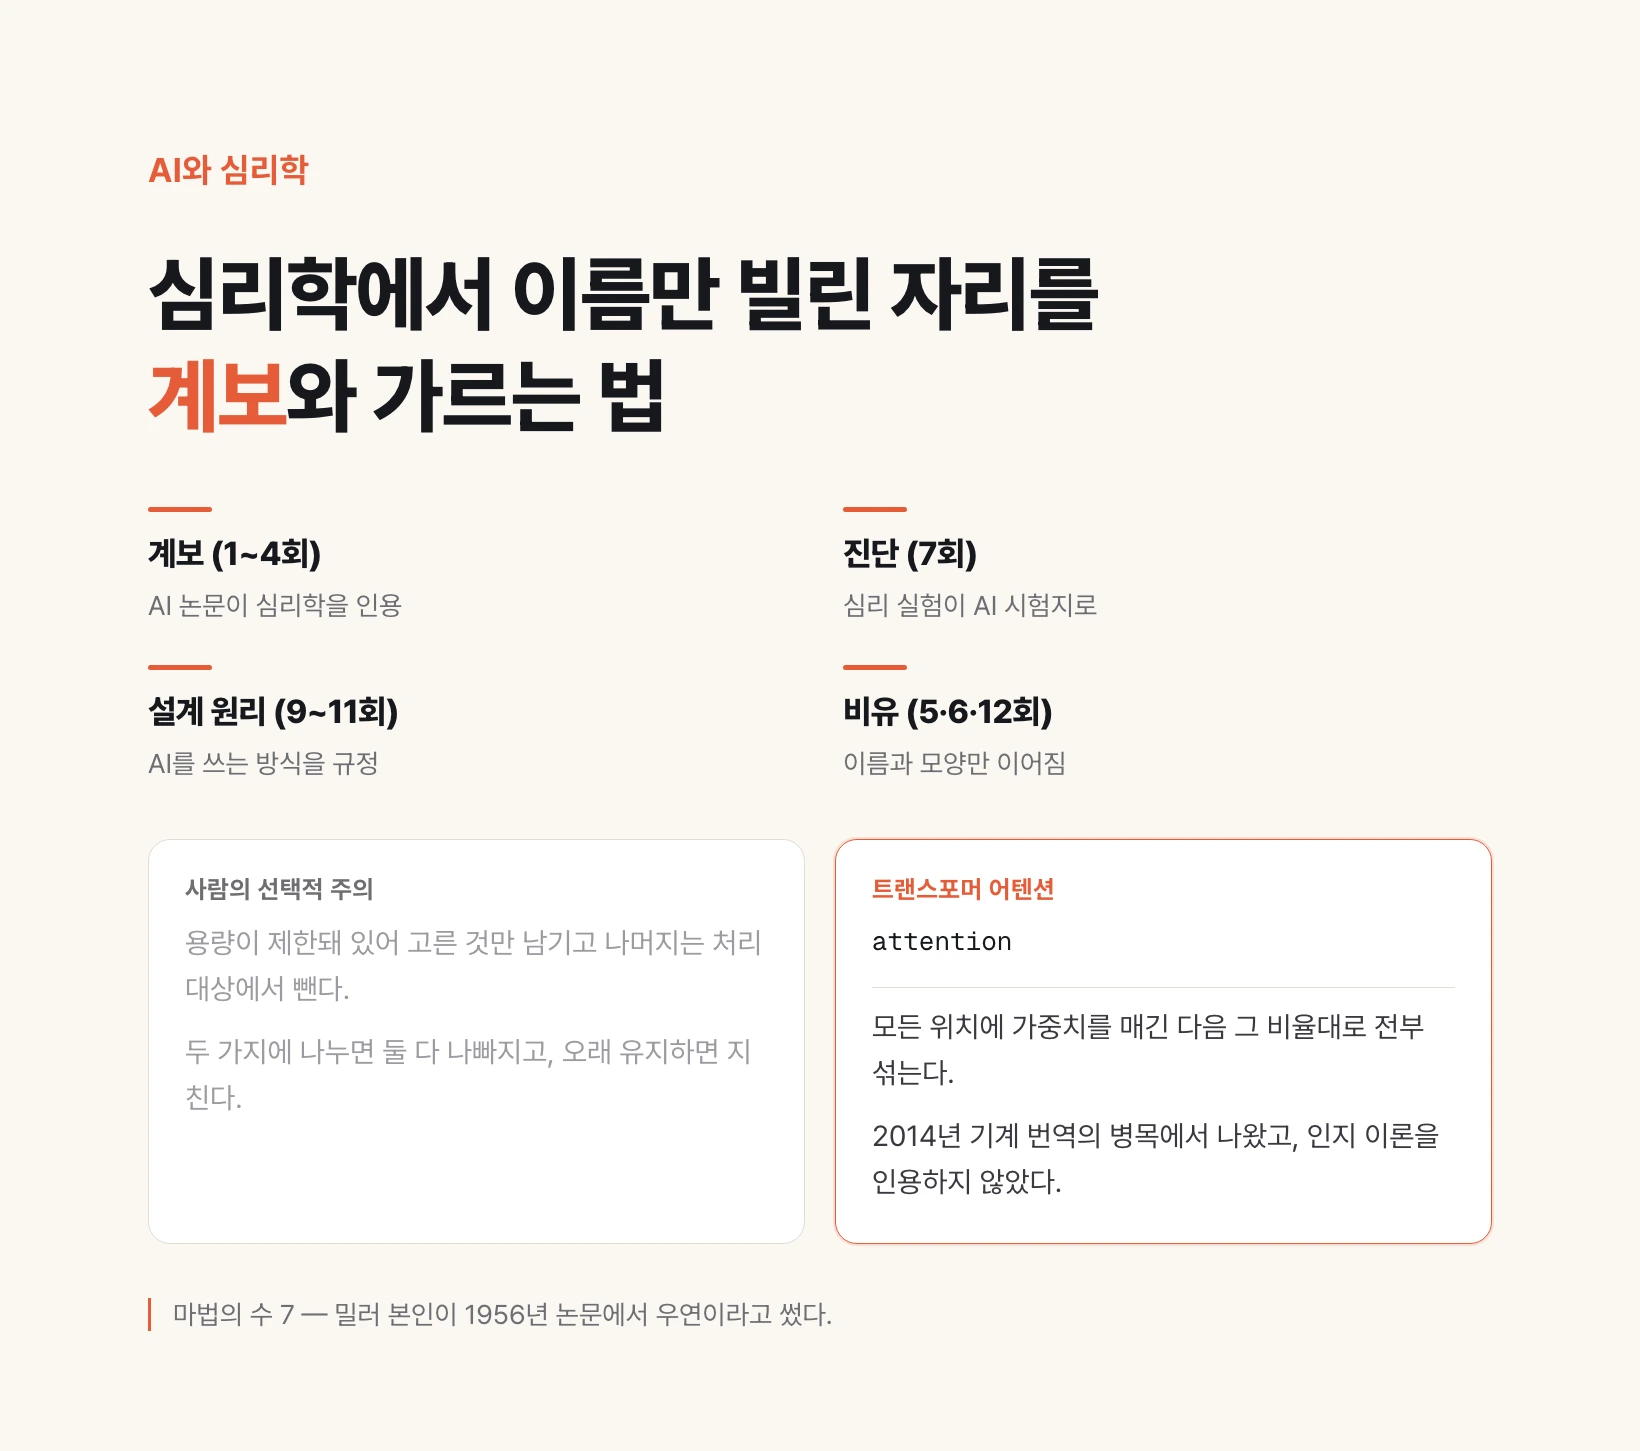
アテンションも記憶も幻覚も — 心理学から名前だけを借りた
この連載は心理学がAIを作った場所を扱ってきた。最終回は反対側を整理する。名前だけが同じで中身はつながっていない場所たちだ。アテンションは選択的注意理論の実装ではなく、コンテキストウィンドウは記憶容量と無関係で、マジカルナンバー7は著者本人が偶然だと否定している。
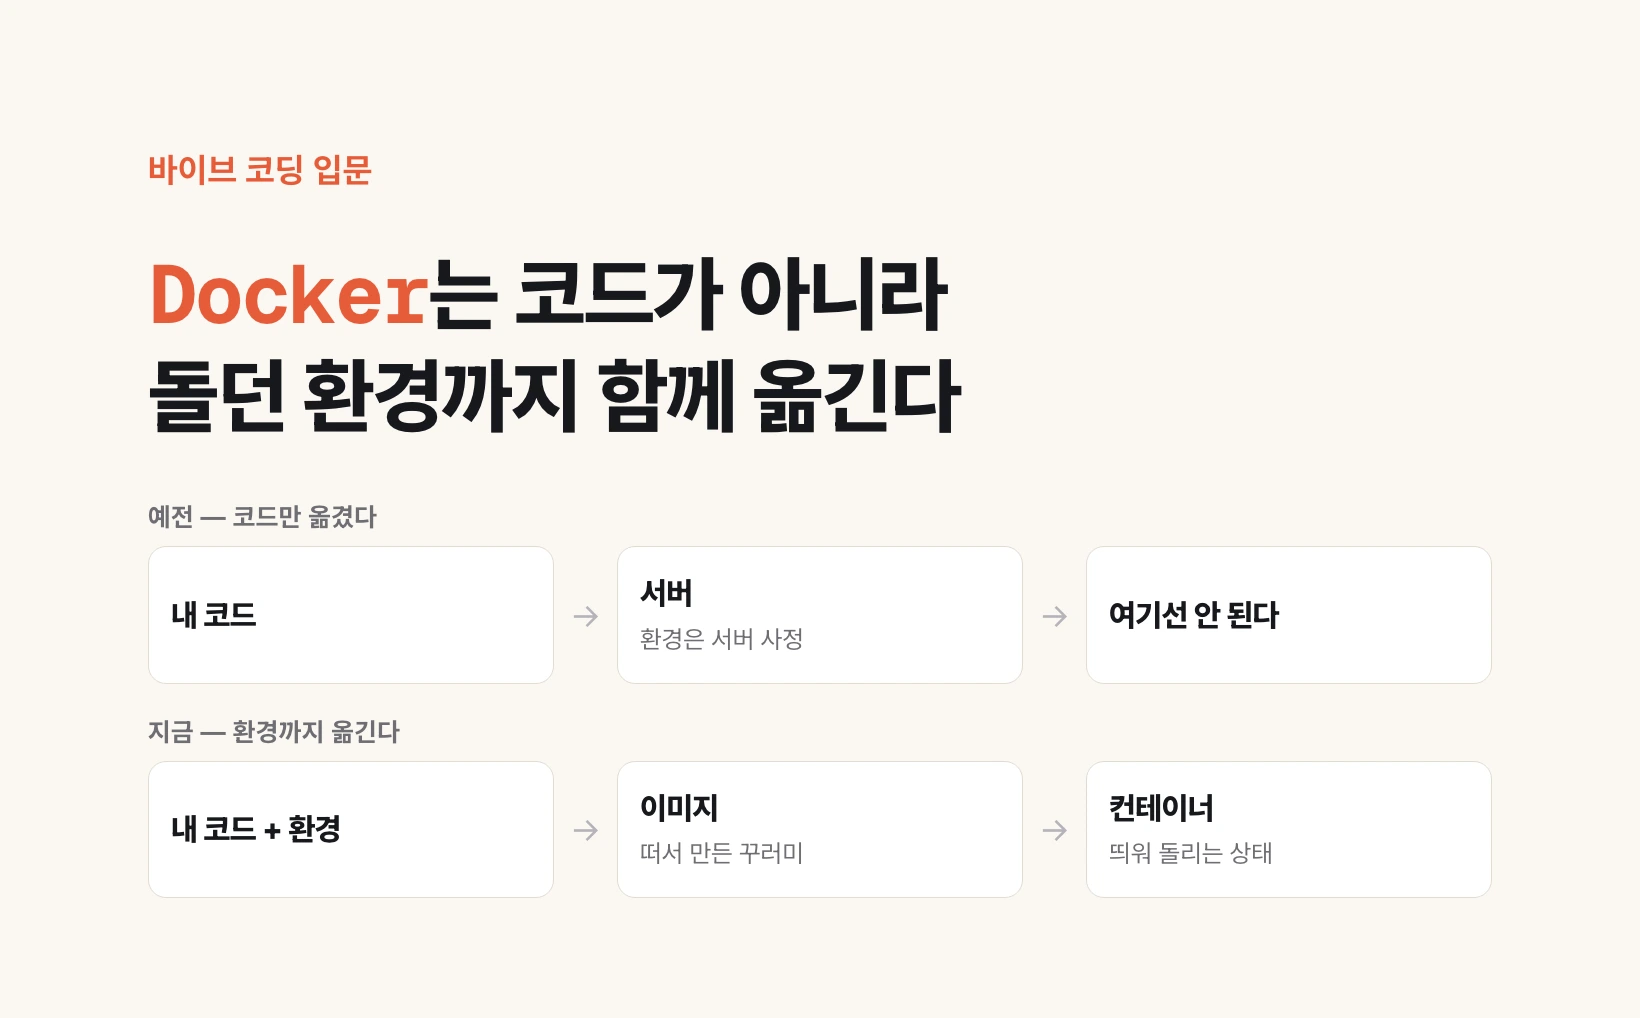
Docker と Kubernetes とは何か — 土台ごと丸ごと移す
自分の機械で動いていたものがサーバーで動かない原因は、たいてい OS やバージョンや入っている道具が違うことだ。コードは同じで土台が違う。そこでプログラムだけでなくそれが動いていた環境まで一緒に封じて一つの包みにする方式が Docker であり、その包みがイメージ、立ち上げて実際に動かすものがコンテナである。包みが増えれば何個動かし落ちたものをいつ立て直すかを決める仕事が生じ、それが Kubernetes だ。
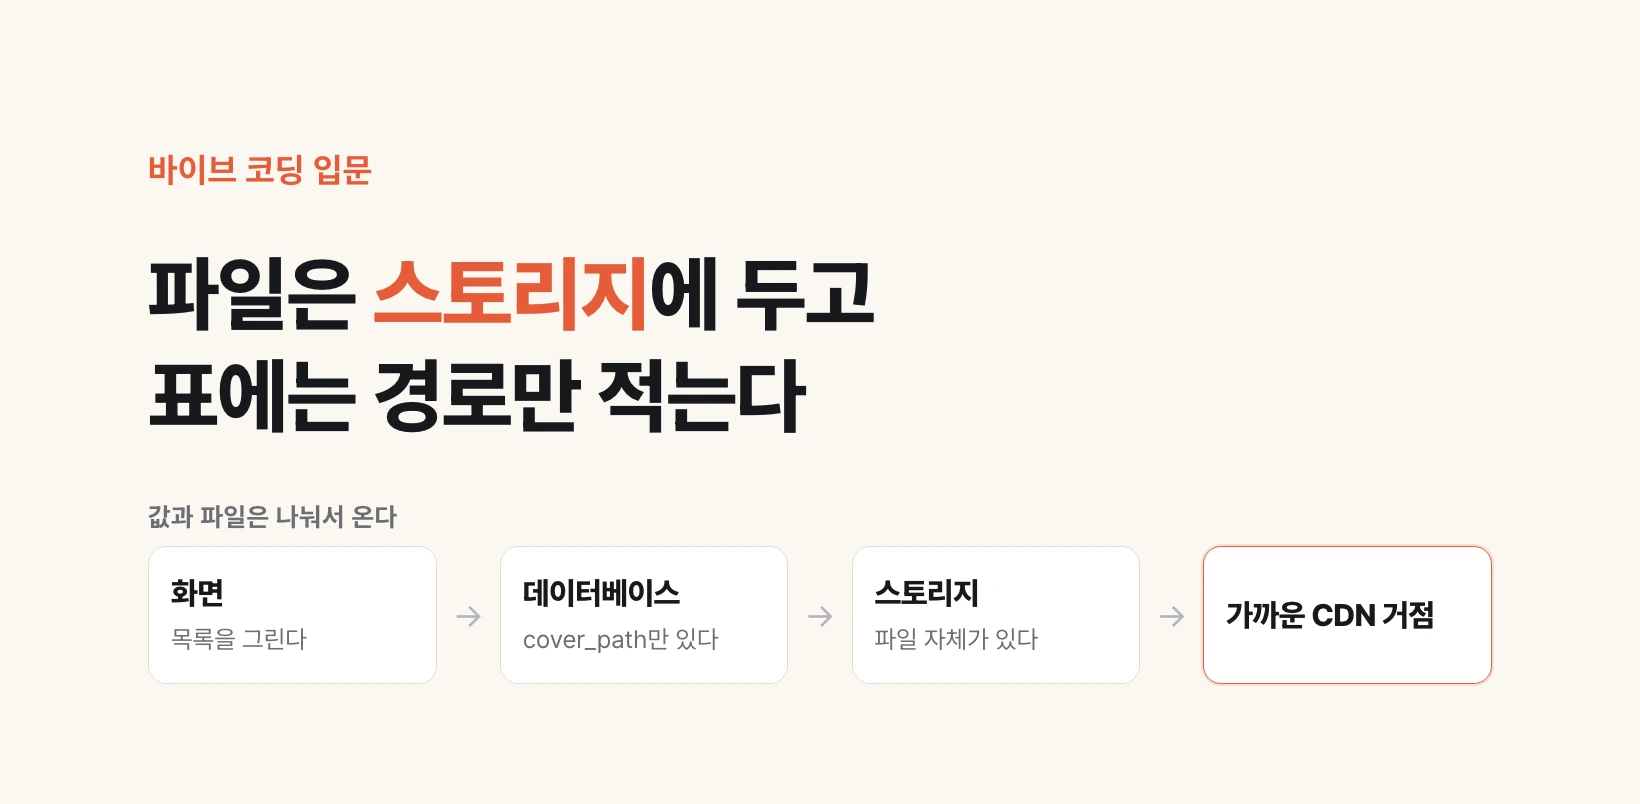
ストレージと CDN とは何か — ファイルはどこに置くのか
データベースは名前や日付や数字を入れるのに向いた表の構造なので、写真や動画はそのマスに入れる物ではない。入れれば照会のたびに重い塊が一緒に引きずり出される。だからファイルはストレージに別に置き、データベースには経路だけを書く。さらに、よく使うファイルの写しを世界各地にあらかじめ配り近い場所から送り出す網が CDN であり、サイトが遅いという訴えのかなりの部分はこの層から始まる。
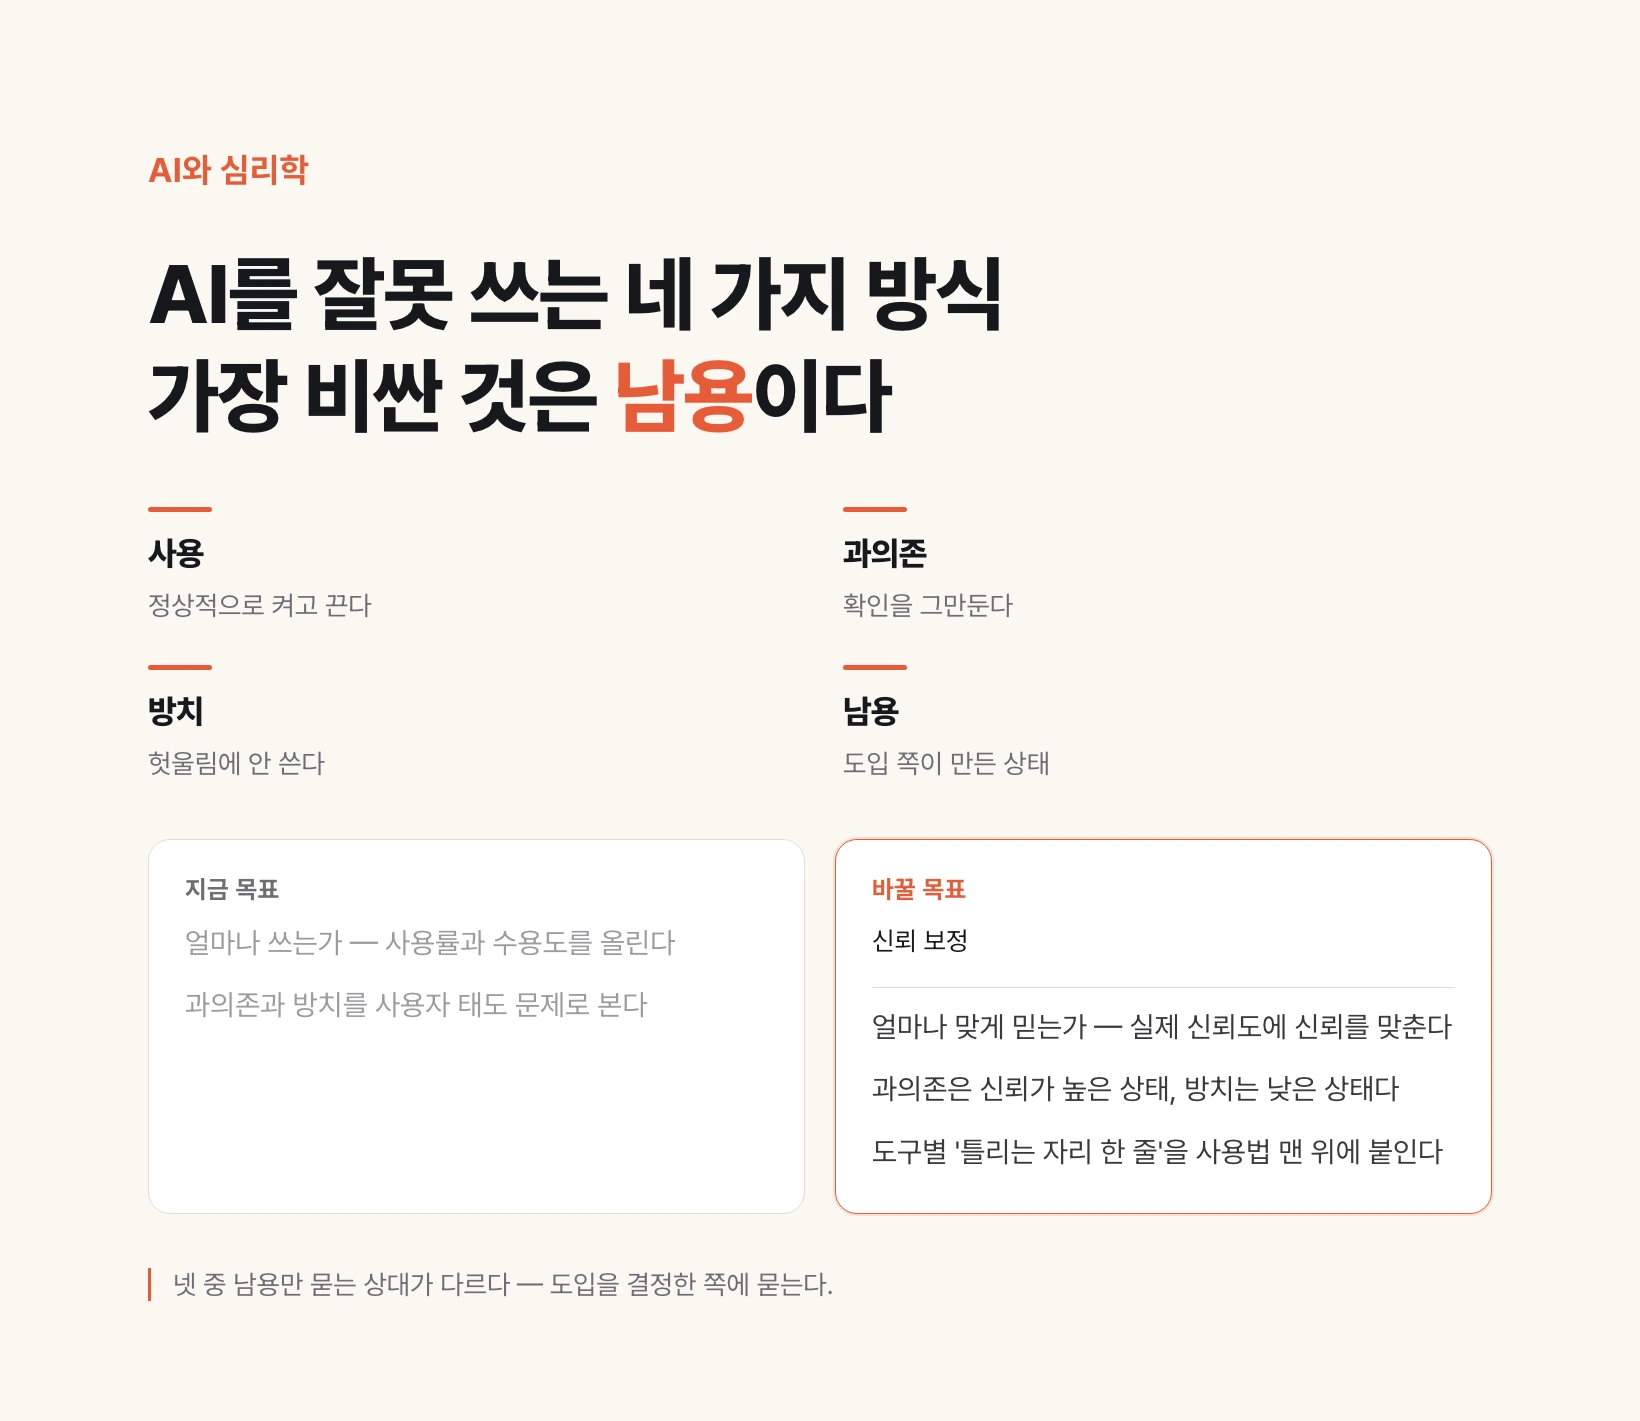
AIを使い誤る四つの型
AI導入が失敗する形は無限ではない。1997年の人間工学の論文が、自動化との関わり方を四つに分けた。使用、過信、不使用、そして濫用である。最後の一つが最も知られておらず、組織で最も頻繁に起きる。人の役割が設計されず、自動化の副産物として残る状態を指す。
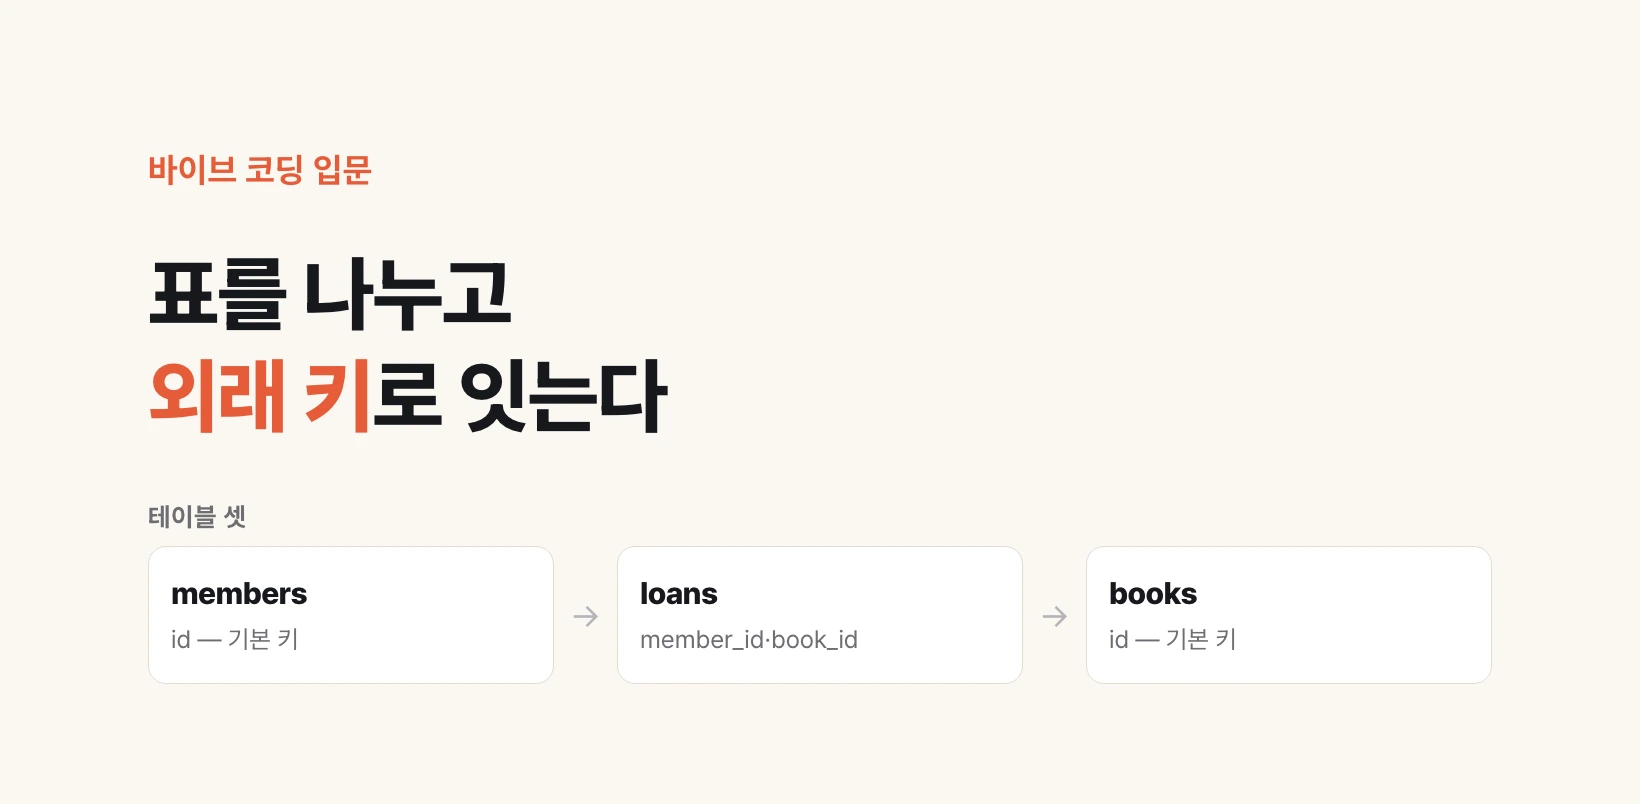
リレーショナルデータベースとは何か — 表に分け、キーでつなぐ
リレーショナルデータベースは、複数のシートをキーでつないだ表計算と同じ形をしている。表一つがテーブルで、最上行が列名、その下の一行一行がデータだ。表どうしをつなぐ値を外部キー、各行を一意に指す値を主キーという。表の形をあらかじめ釘付けにしたものがスキーマで、データベースに何かをさせる文をクエリという。PostgreSQL が代表的な製品である。
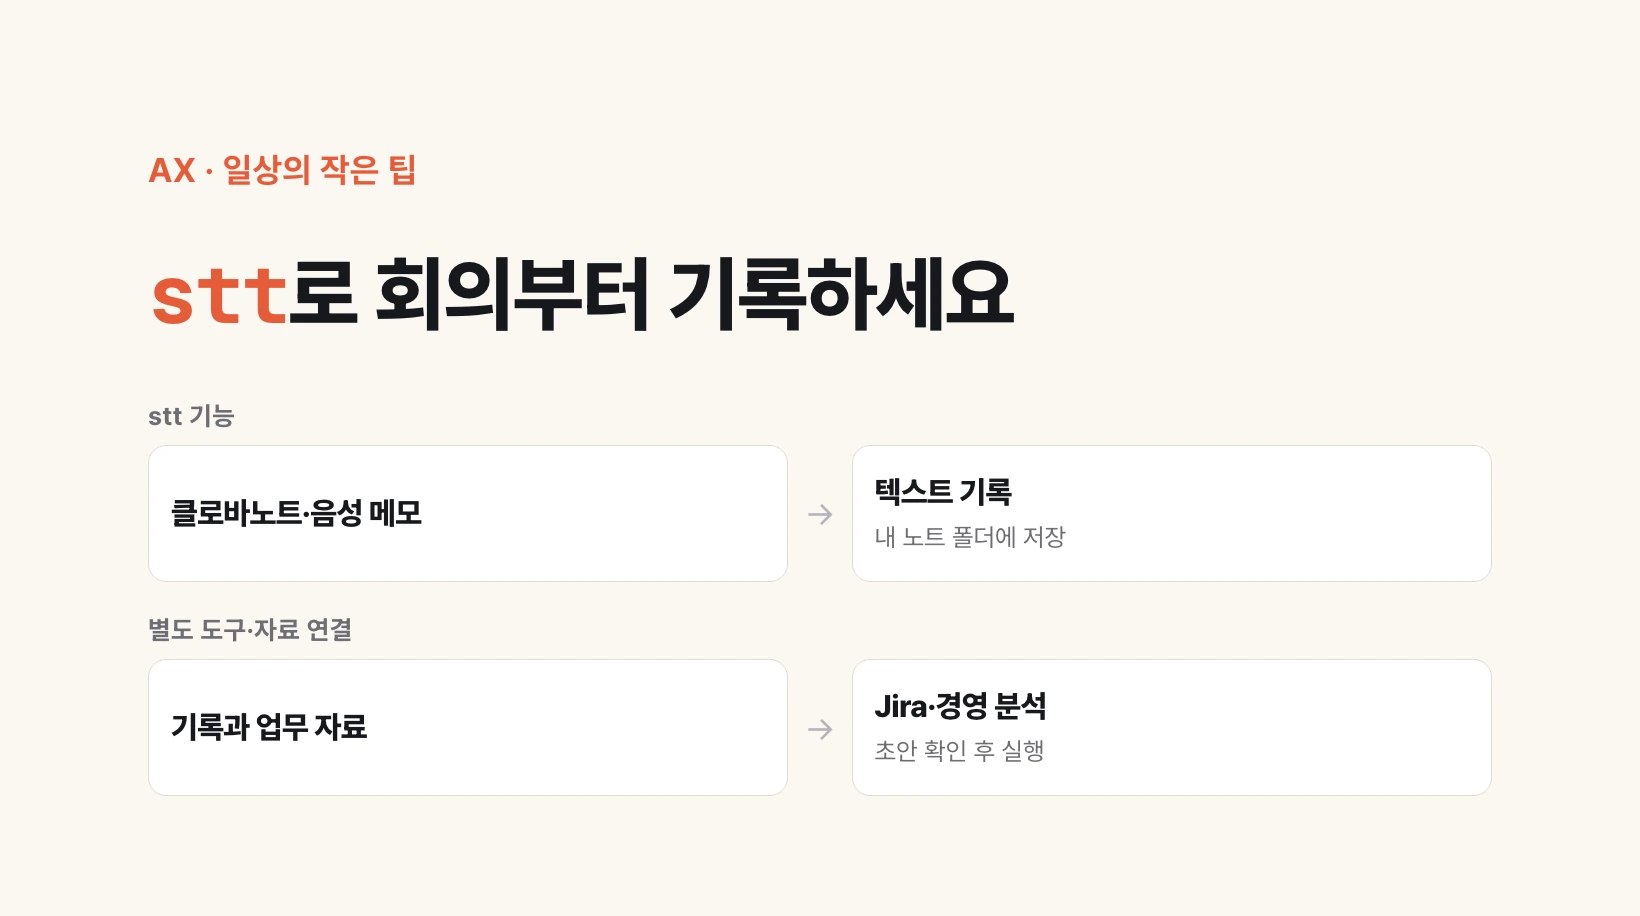
sttで会議から記録しましょう。AI活用は小さく始められます。
会議録をAIによる仕事に使うなら、まず読めるテキストとして集めます。公開したsttはClova Noteの既存の文字起こしを取り込むか、AppleのボイスメモをMacで文字にして保存するプラグインです。別途ツールと資料を用意し、内容を確認すれば、開発会議はJiraへのタスク登録、経営会議は経営資料の照合へとつなげられます。AX、つまりAIで働き方を変える取り組みを、会議一つから始めてみてください。
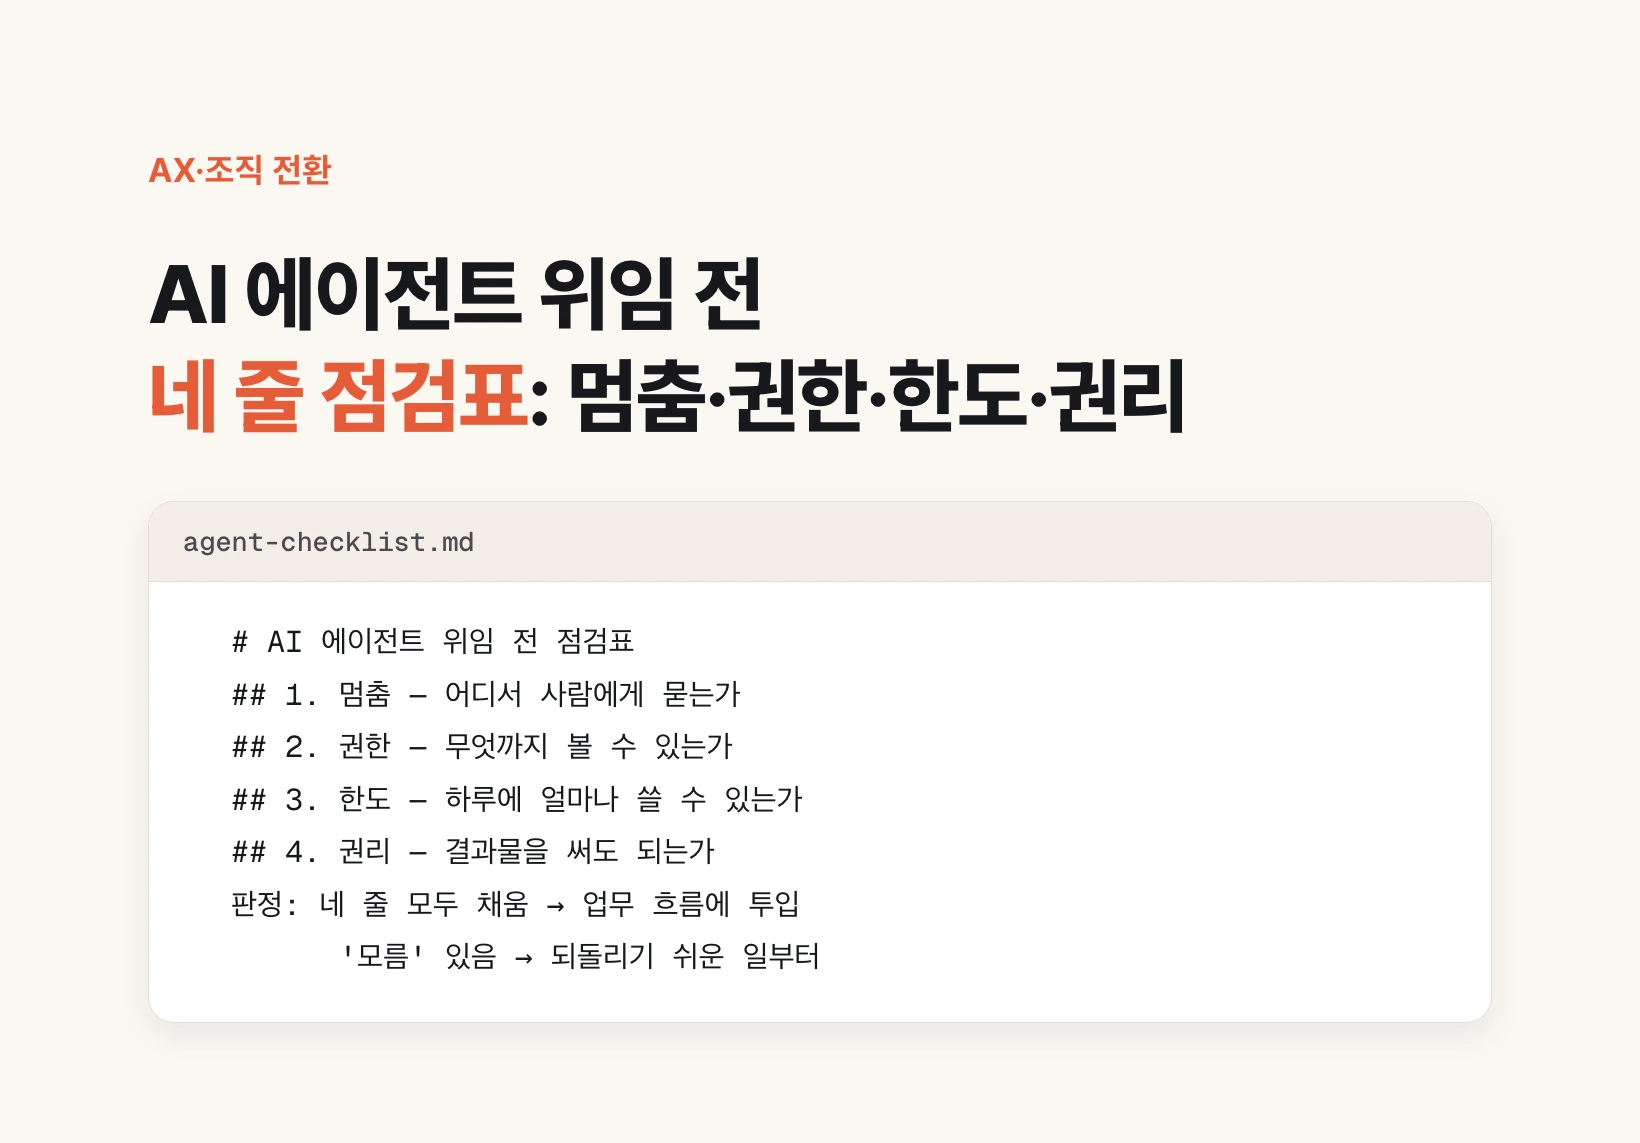
AIエージェントに仕事を任せる前に何を確認すべきか
機能一覧より先に四つを確認すべきだ。どこで止まって人に尋ねるか、どこまで見られるか、一日にどれだけ使えるか、作った成果物の権利が整理されているか。2026年9月第2週に出たMeta Muse、ChatGPT WorkのDataエージェント、AppleのSiri AI、Suno v6の発表は、どれも機能と同じくらいこの四つを詳しく書いた。新しいAIツールを業務につなぐ前にこの四行を埋めてみると、機能比較より早く導入の可否が分かれる。
FastAPI と API 設計とは何か — バックエンドがする仕事
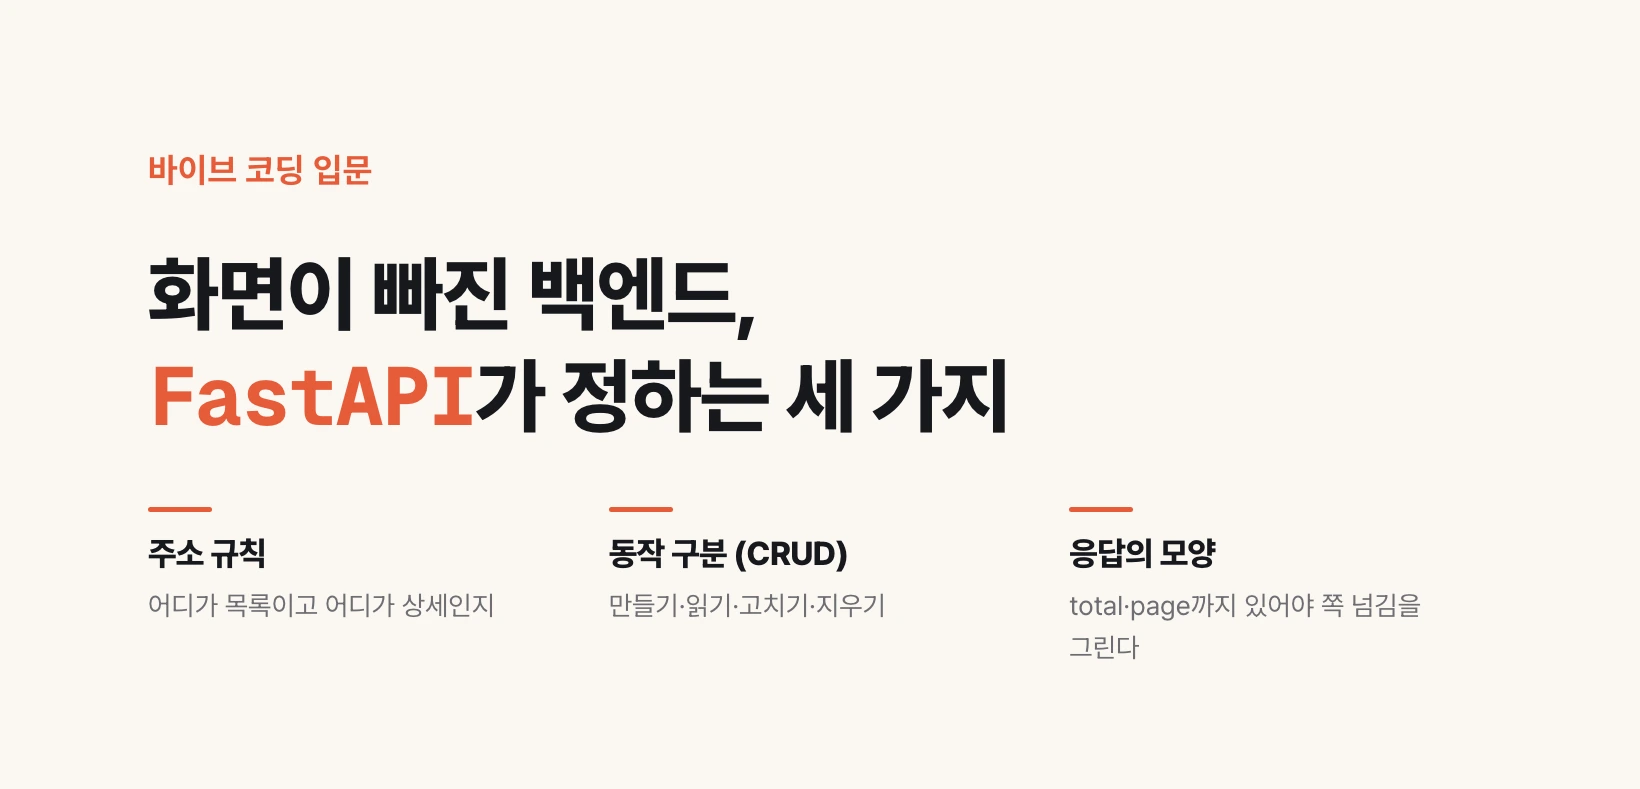
昔のバックエンド道具はデータと画面とその二つをつなぐ部分を一つの枠に置き、画面まで描いていた。画面を描く仕事がフロントエンドへ移ると、バックエンドに残ったのは何の値を返すかという一つだけになり、その仕事だけをする軽い道具である FastAPI がその席に着いた。やり取りの形式は JSON で、API を設計するとは住所の規則と作る・読む・直す・消すの区別と応答の形の三つを決めることである。
Blob Storageはファイルを保管し、DBはファイルを探すための情報を管理します
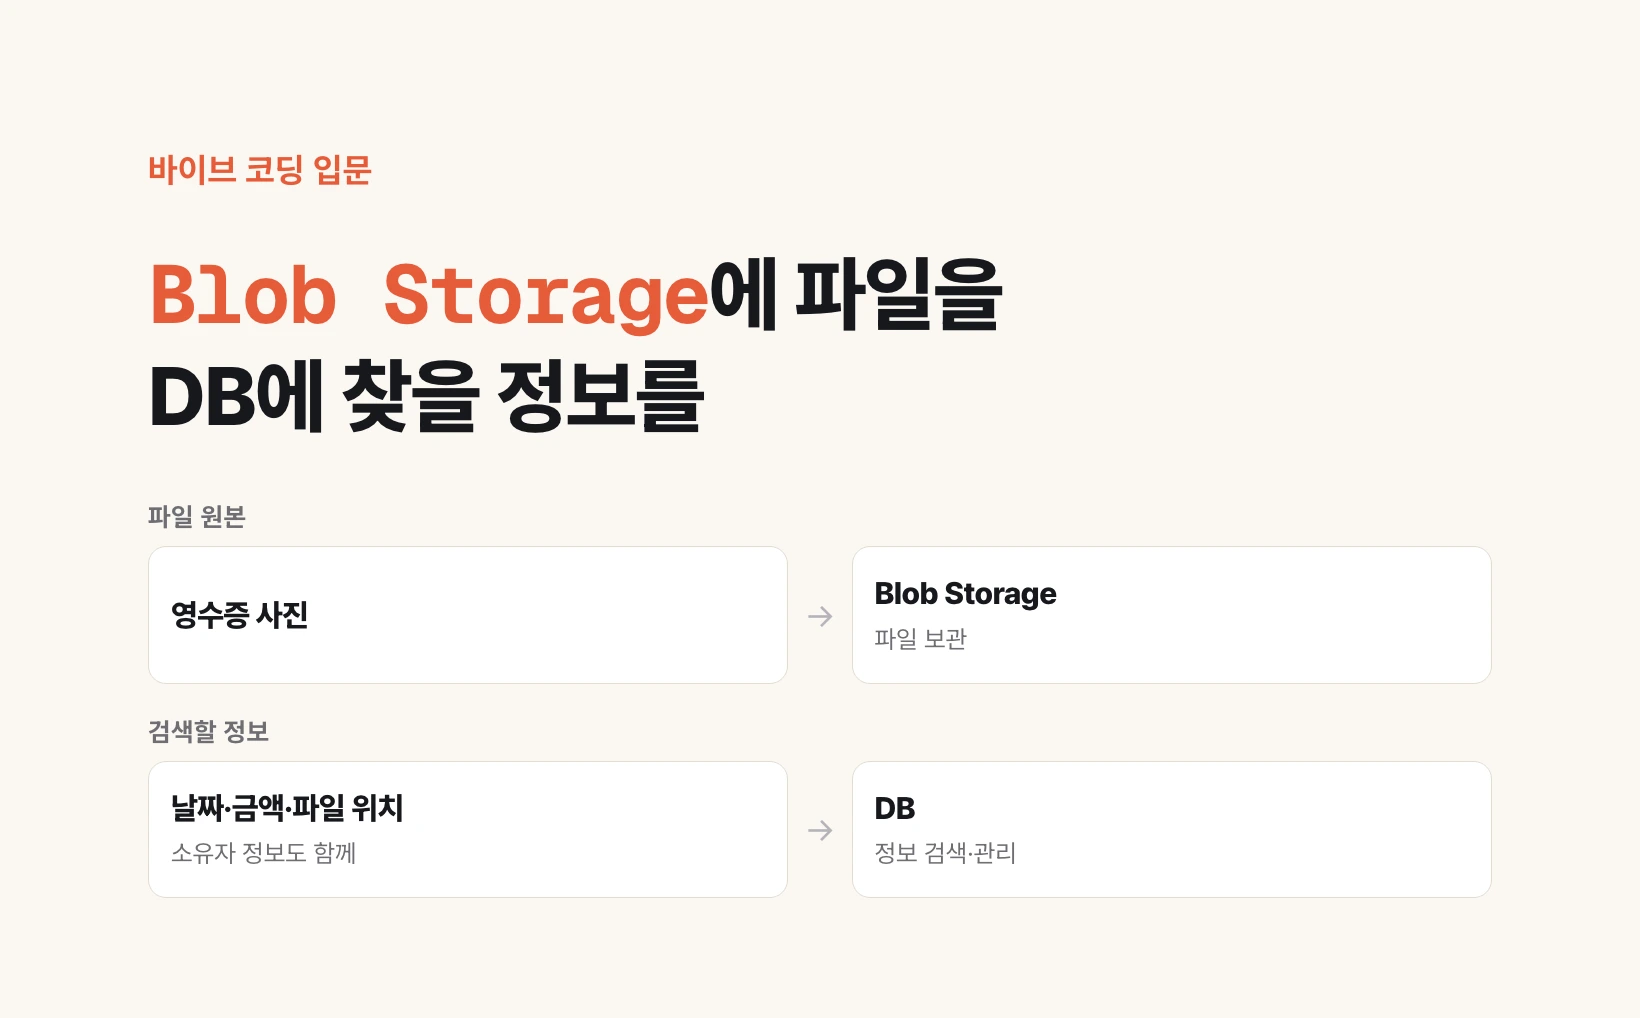
AIに領収書アプリを作ってもらうと、Blob Storageという言葉が出てくることがあります。写真やPDFなどのファイルを保管するサービスです。原本と、日付・金額・所有者・保存場所の情報を分けて考えると、アップロードの成否だけでなく、誰がファイルを開けるかも確認できます。
Claude Code・Codexは信頼できるか — .envの値を画面に出させないフック
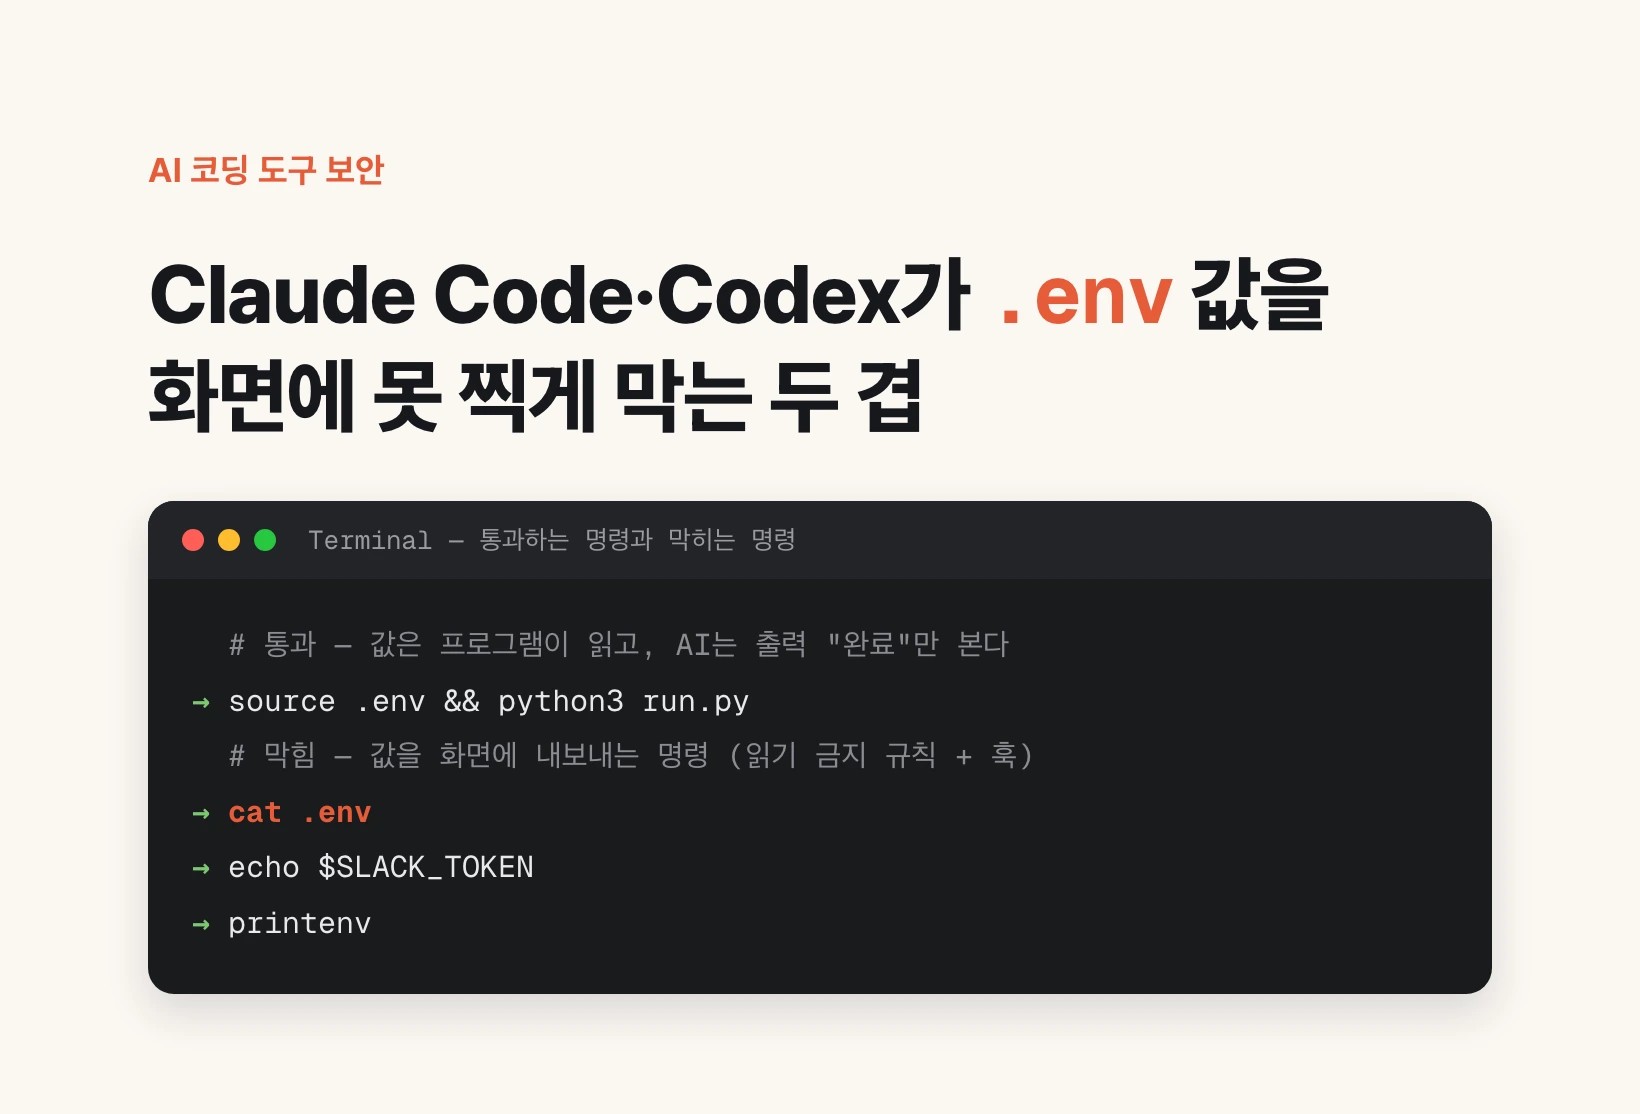
Claude CodeとCodexはユーザーアカウントの権限でコマンドを実行するため、.envファイルも読めます。そしてコマンドの結果は会話に混ざり、モデル提供会社のサーバーへ送られます。AIが値を自分で伏せてくれるのは、AIが守る約束にすぎず、強制する仕組みではありません。そこで信頼の代わりに二重の備えをかけます。第一に、Claude Codeの設定に.envの読み取りを禁止するルールを入れます。第二に、コマンドが実行される直前にスクリプトが先に確認し、値を画面に出すコマンドだけを止めるフックを、Claude CodeとCodexの両方にかけます。スクリプトが自分で値を出力する場合のように止められない経路は残りますが、最もよくある経路から塞ぐことができます。
自動化の皮肉 — 自動化するほど人の取り分は難しくなる
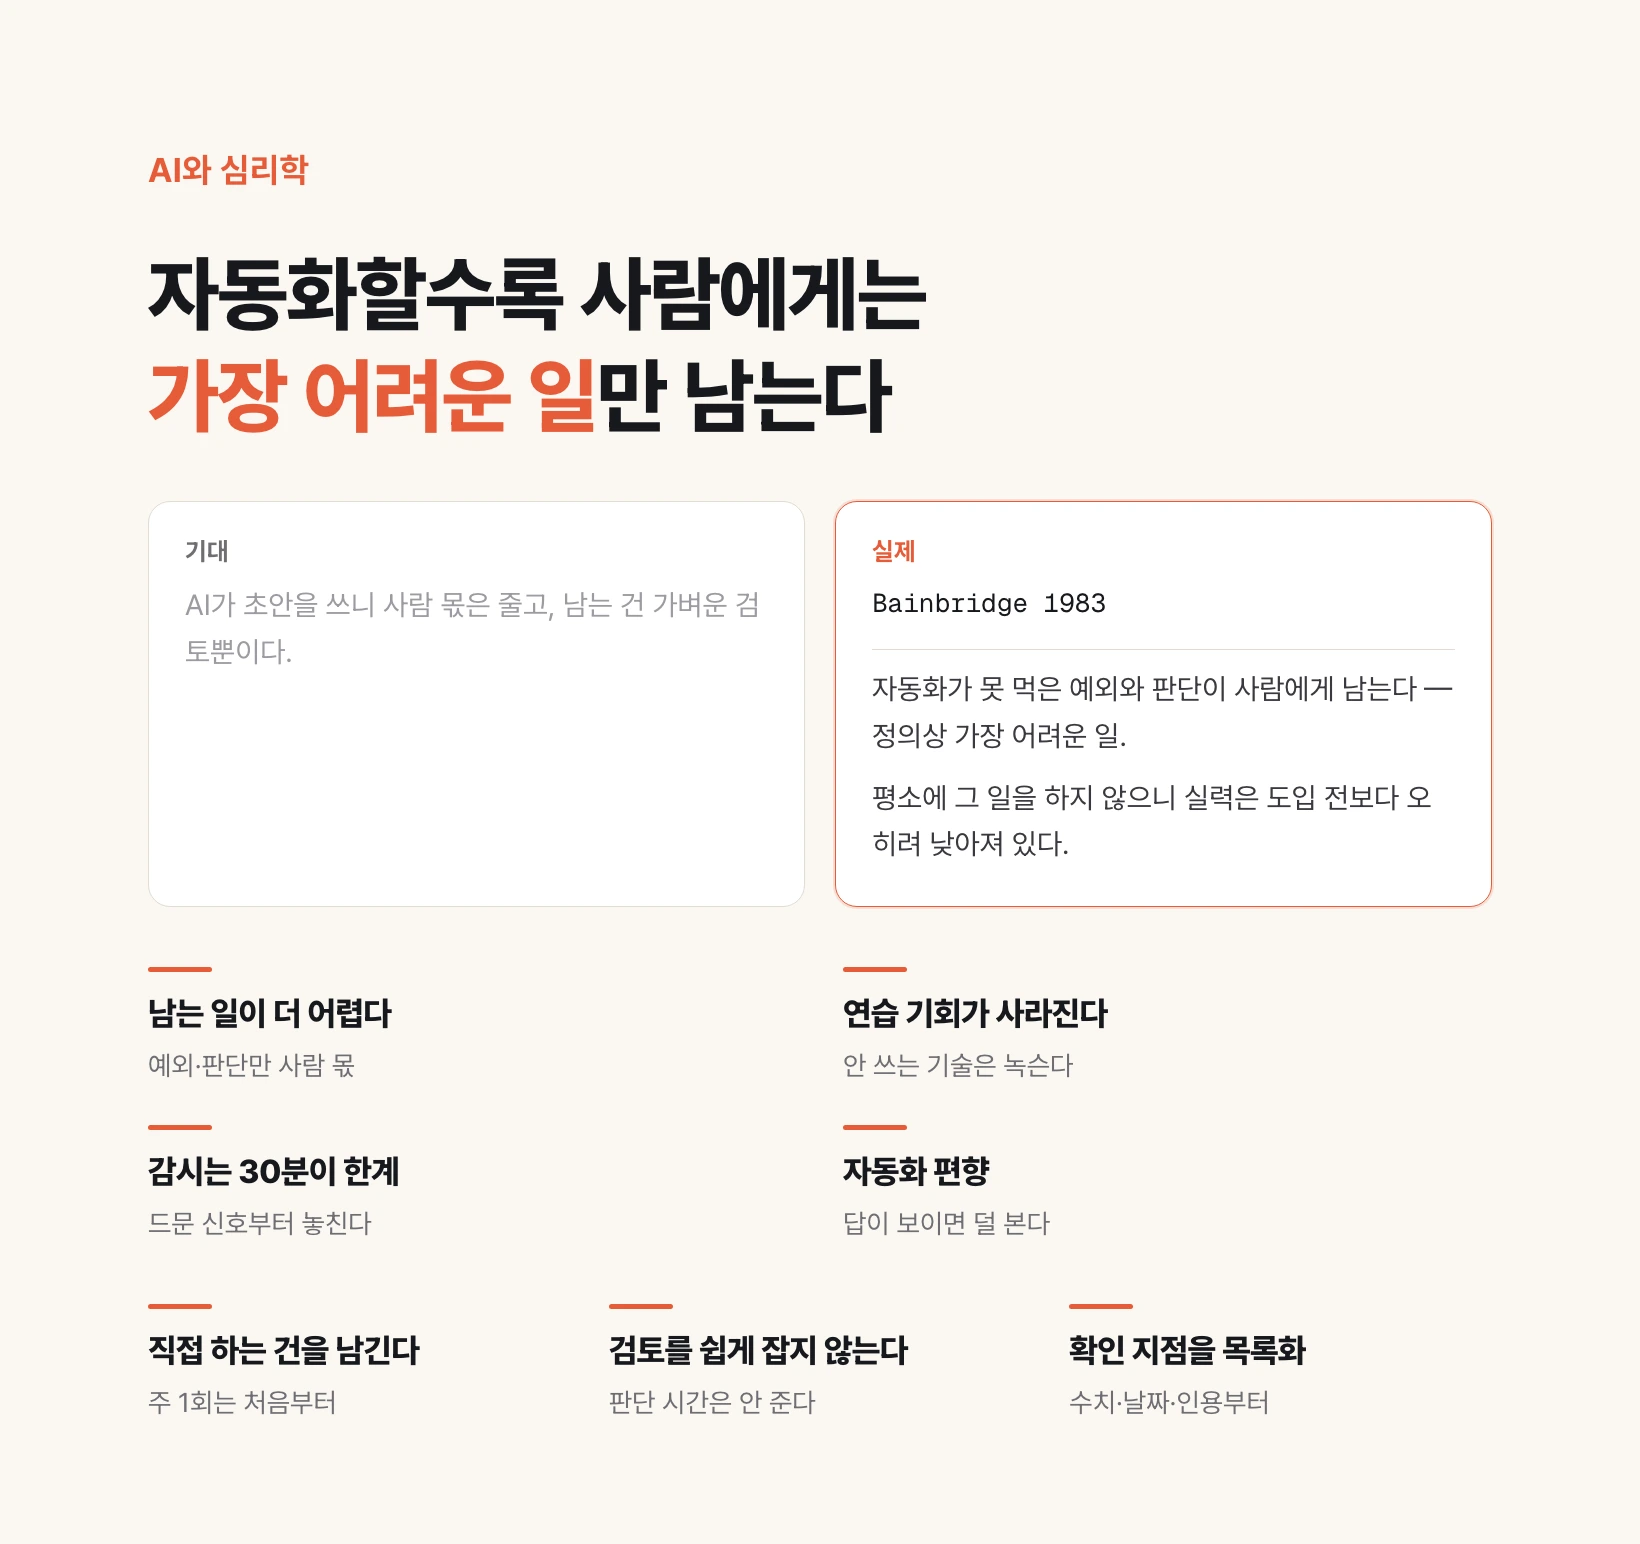
AIに仕事を渡すとき、人は残る仕事が減ると期待する。1983年に出た五ページの論文がその期待の逆を指摘した。自動化されないものが人の取り分として残るが、それは定義上いちばん難しい仕事であり、普段やることがないのでその難しい仕事を練習する機会まで消える。訓練は少なくて済むどころか、もっと必要になる。
Next.js とは何か — 画面を誰がいつ描くのか
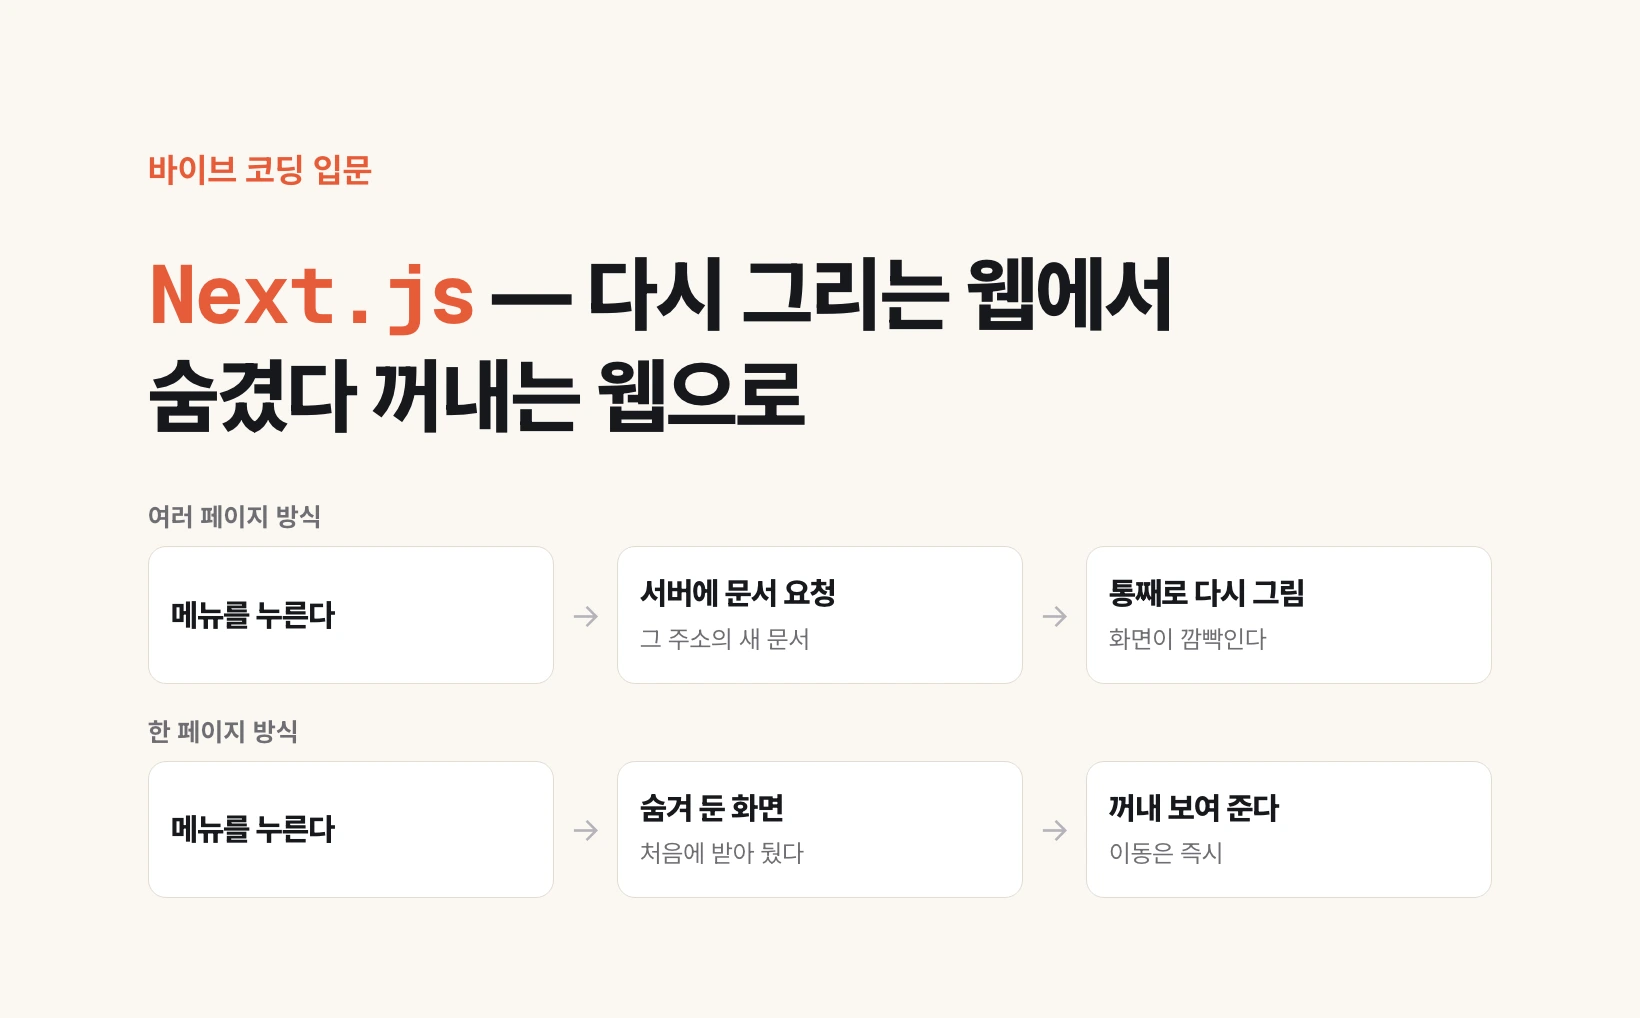
昔のウェブはページを移るたびにサーバーへ新しい文書を求めて丸ごと描き直したので、画面がちらついた。モバイルアプリが基準を上げ、ウェブも最初に受け取っておいて移動は即座に行う一ページ方式へ移ったが、画面をブラウザで描くと検索エンジンが空白を見る危険が生じた。そこでサーバーで先に描いて送る方式が併用され、その二つを一つのプロジェクトの中で選べるようにしたのが Next.js である。
PillCheck OCR — 処方箋の写真1枚で服薬リストを作る
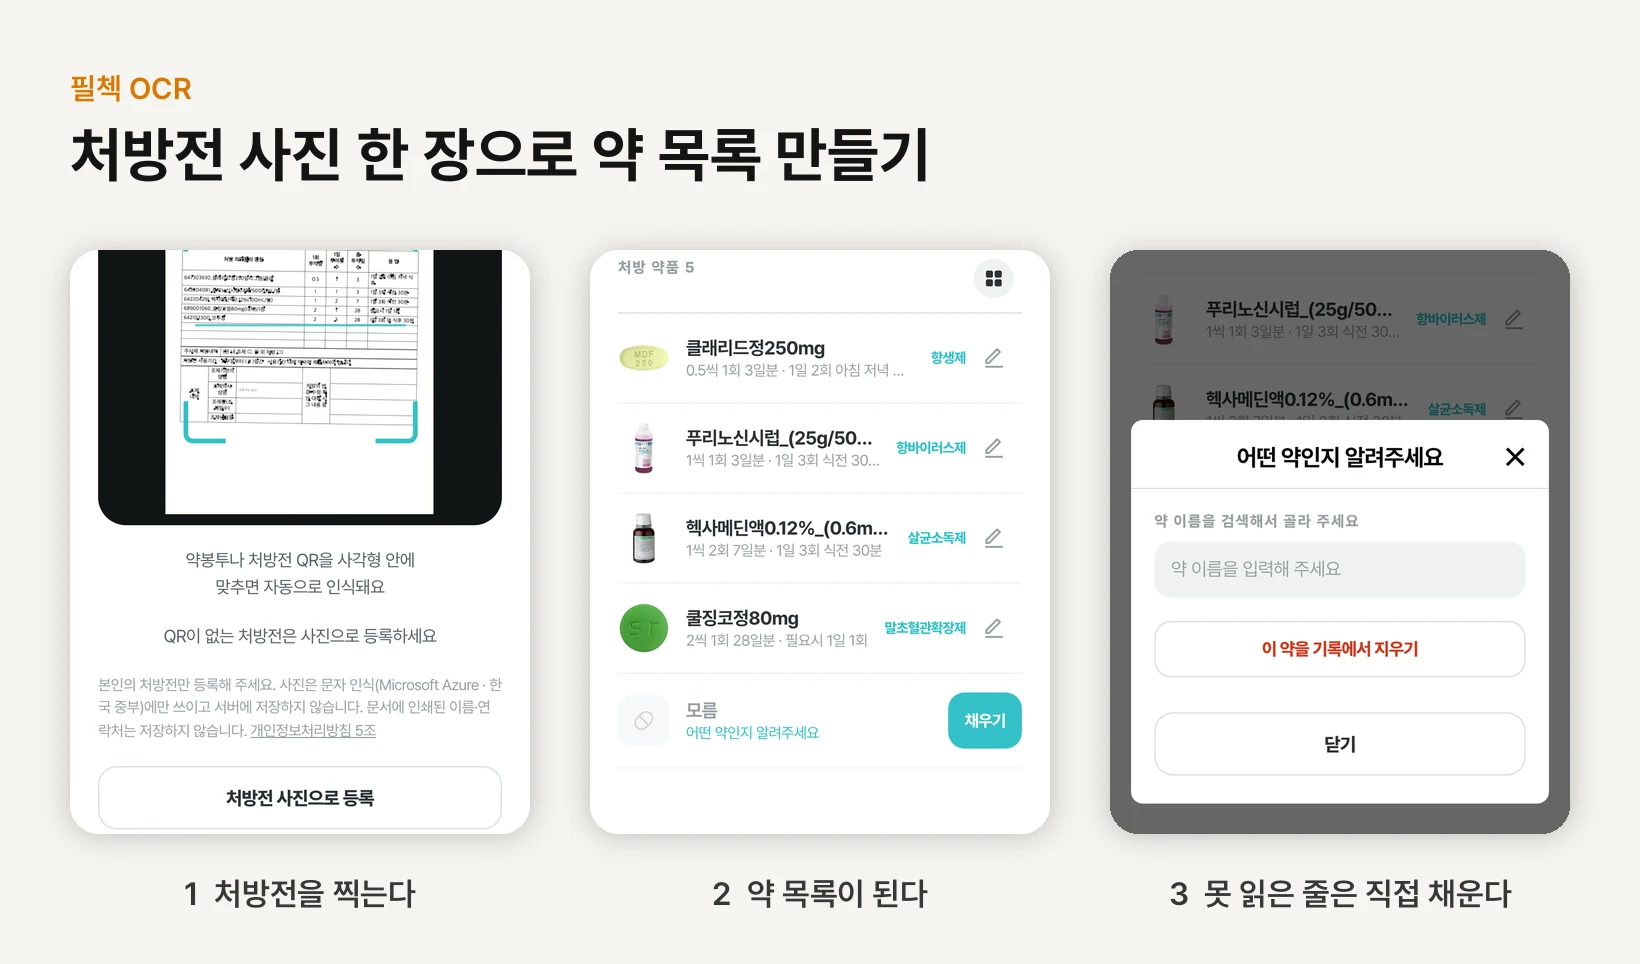
PillCheck OCR は、QRコードのない処方箋や、ほかの薬局でもらった薬袋を写真に撮って服薬リストに変える PillCheck(필첵)の登録機能です。www.pillcheck.co.kr にログインし、画面下の「スキャン」メニューにある処方箋・薬袋タブから使います。文字認識AIが写真の文字と表を読み取り、読み取った薬は医薬品データと照合され、錠剤の写真・薬効分類・飲み方まであわせて表示されます。処方箋の写真は文字認識にだけ使われ、サーバーには保存されません。読み取れなかった行は削除も似た薬での穴埋めもせず「不明」として残し、ユーザーが自分で検索して埋めるようにしました。
ウェブサーバーと HTTPS とは何か — Nginx がする仕事
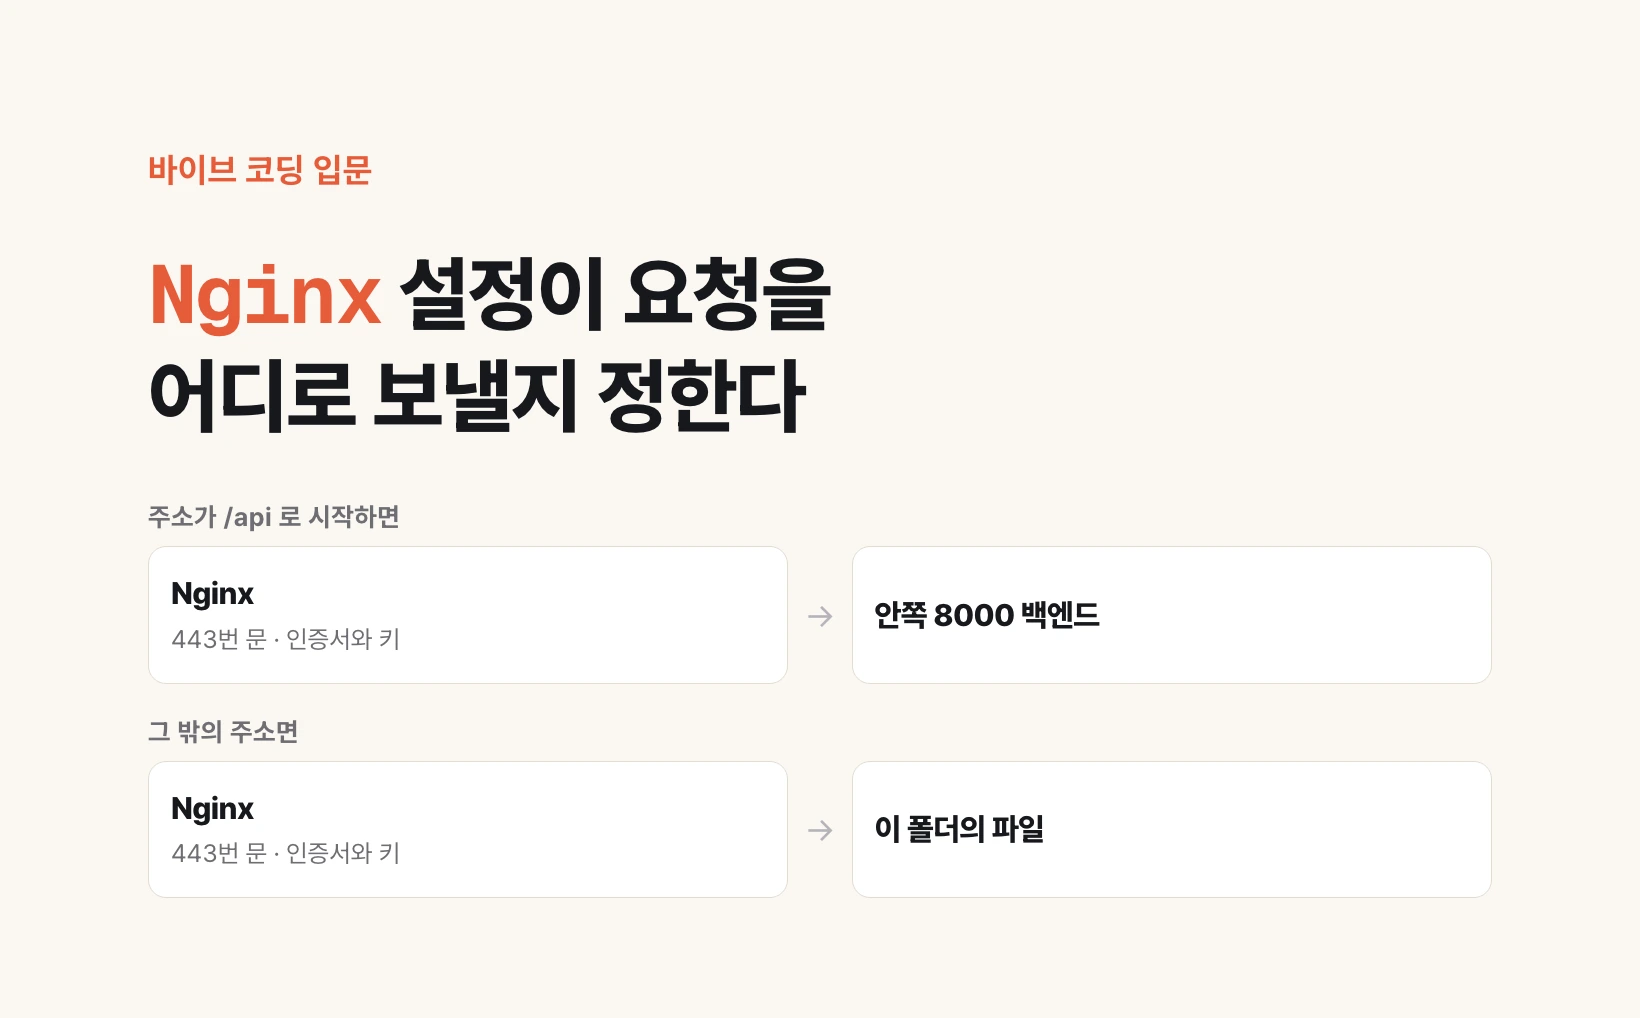
リクエストがサーバーに届いても、何を返すかはまだ決まっていない。どのポートから来た要求にはこのフォルダのファイルを渡し、この住所は中で動くプログラムへ回す、という規則を書いておくのがウェブサーバーで、最も広く使われているのが Nginx である。HTTPS もこの層で決まる。暗号化に使う証明書と鍵をどこから読みどの接続に適用するかがこの設定に書かれ、アドレスバーの鍵はその設定が効いている印だ。
ドメイン・DNS・ポートとは何か — リクエストがサーバーを見つける仕組み
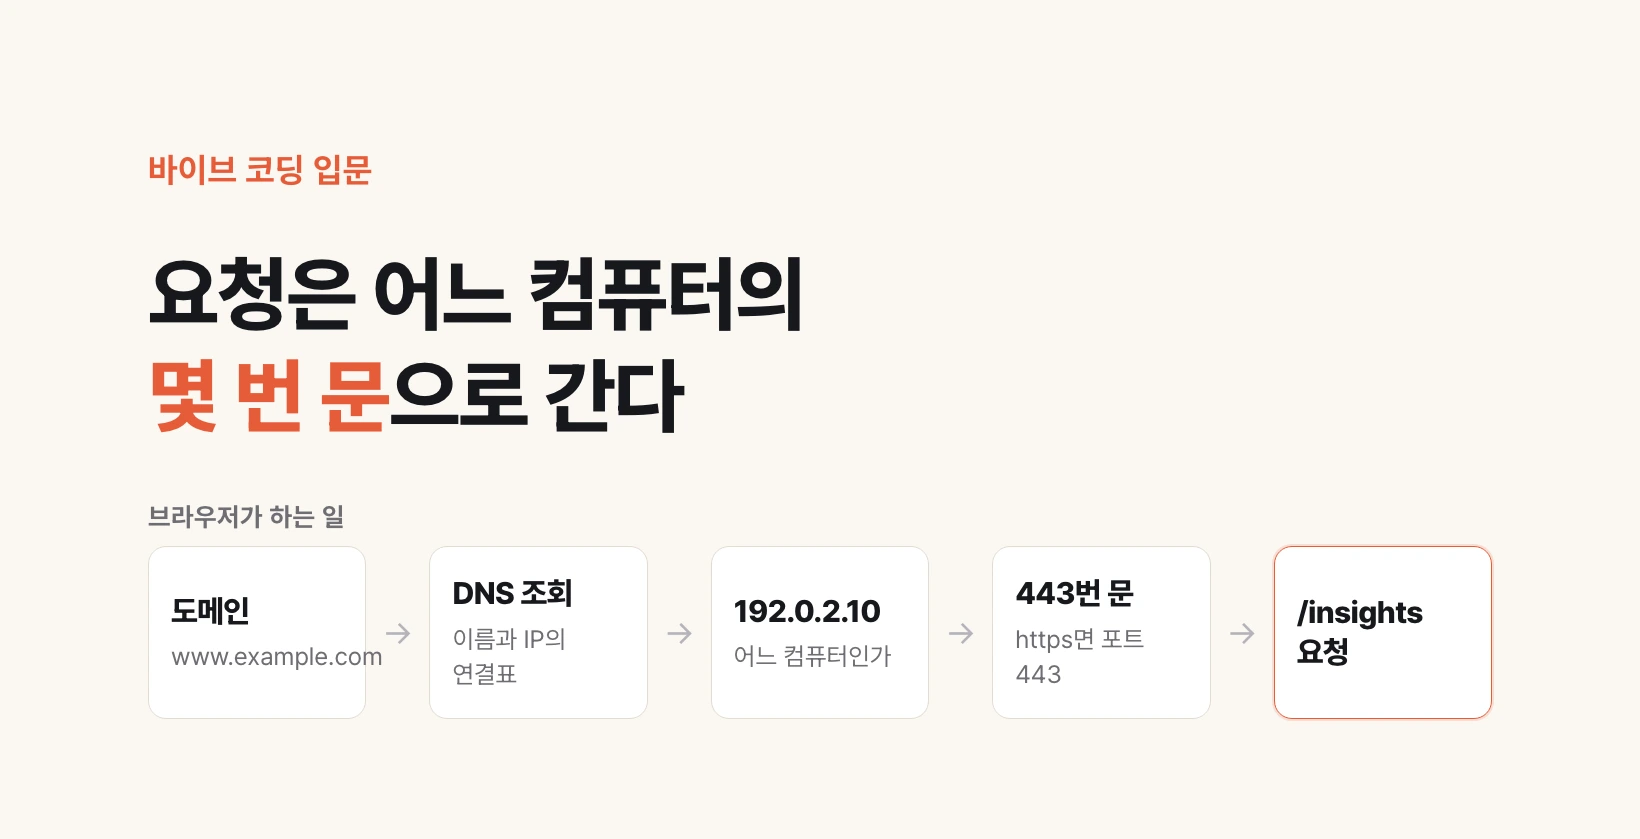
インターネットにつながったコンピュータには IP アドレスがあり、一台が多くの仕事をするので扉が複数あり、その扉番号がポートである。つまりリクエストはどのコンピュータの何番の扉へ、という形で届く。人が数字を覚えられないので名前を付けたものがドメインで、名前と IP をつなぐ対応表が DNS だ。デプロイ後に画面が出ないときは、ドメインが正しい IP を指しているか、サーバーが生きているか、開いているべきポートが開いているか、この三つを見ればよい。
イライザ効果 — 人はそうではないと言いながらコンピュータを人として扱う
1966年、数行の規則で作られたプログラムの前で、開発者の秘書が席を外してほしいと頼んだ。その仕組みを知っている人物がそうしたのだ。三十年後、三十五の実験が同じ結論を出した。人はコンピュータを社会的な相手として扱い、そんなはずはないと自ら否認しながらそう振る舞う。
HTML・CSS・JavaScript とは何か — ブラウザが読む三つのファイル
ブラウザがサーバーから受け取ったものを画面として描くとき読むファイルは三つだ。何を見せるかが HTML、どう見えるかが CSS、押したら何が起きるかが JavaScript である。CSS は HTML がスタイルを表現できないから生まれたのではなく、文書が手に負えないほど長くなるので切り出されたものだ。スタイルが効かない原因はたいてい文法の誤りではなく、より狭く指定した規則がすでに勝っていることである。TypeScript は JavaScript の上に値の形を釘付けにする規則の層だ。
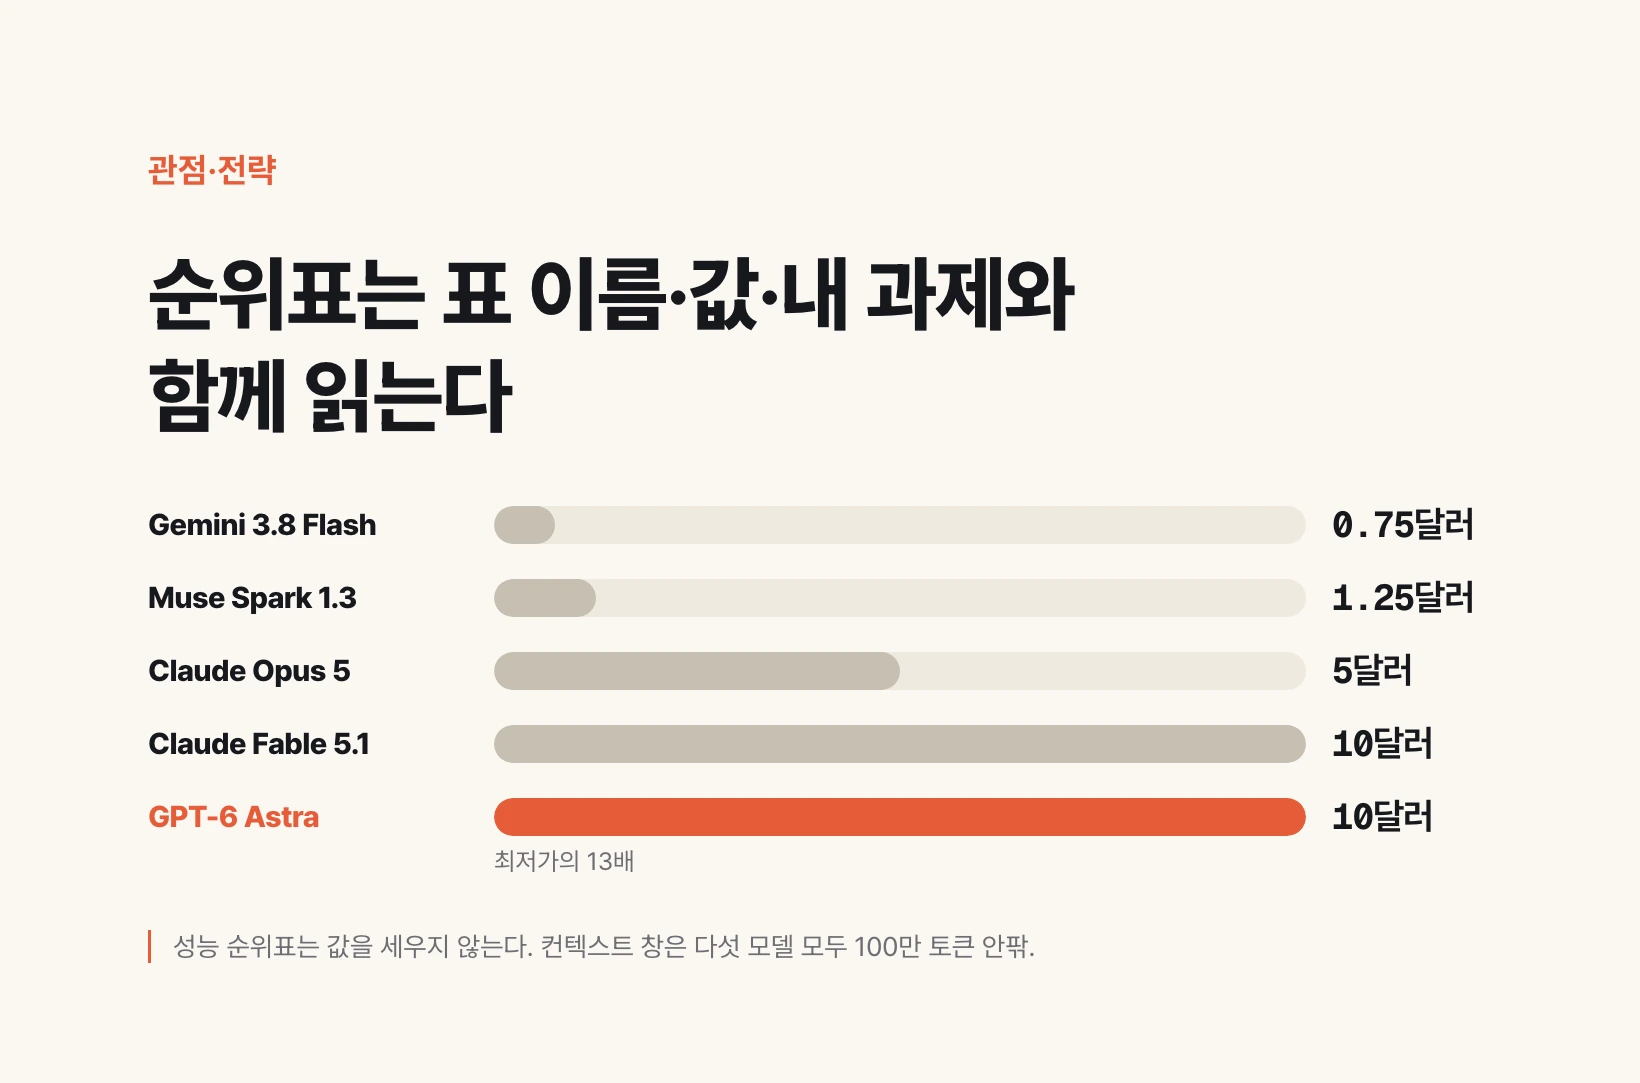
AIモデルのランキング表はなぜ実感とずれるのか
どの表を見るか、そして価格を一緒に見るかで一位が変わるからだ。2026年9月第1週にトップクラスのモデルが四つ同時に出たが、各発表は自分に有利な表を選んで一位を主張し、その表どうしで順位が食い違った。ランキング表を捨てる必要はない。ただし総合スコア一つではなく、どの表か、価格はいくらか、自分の業務課題ではどうか、この三つを一緒に見る必要がある。
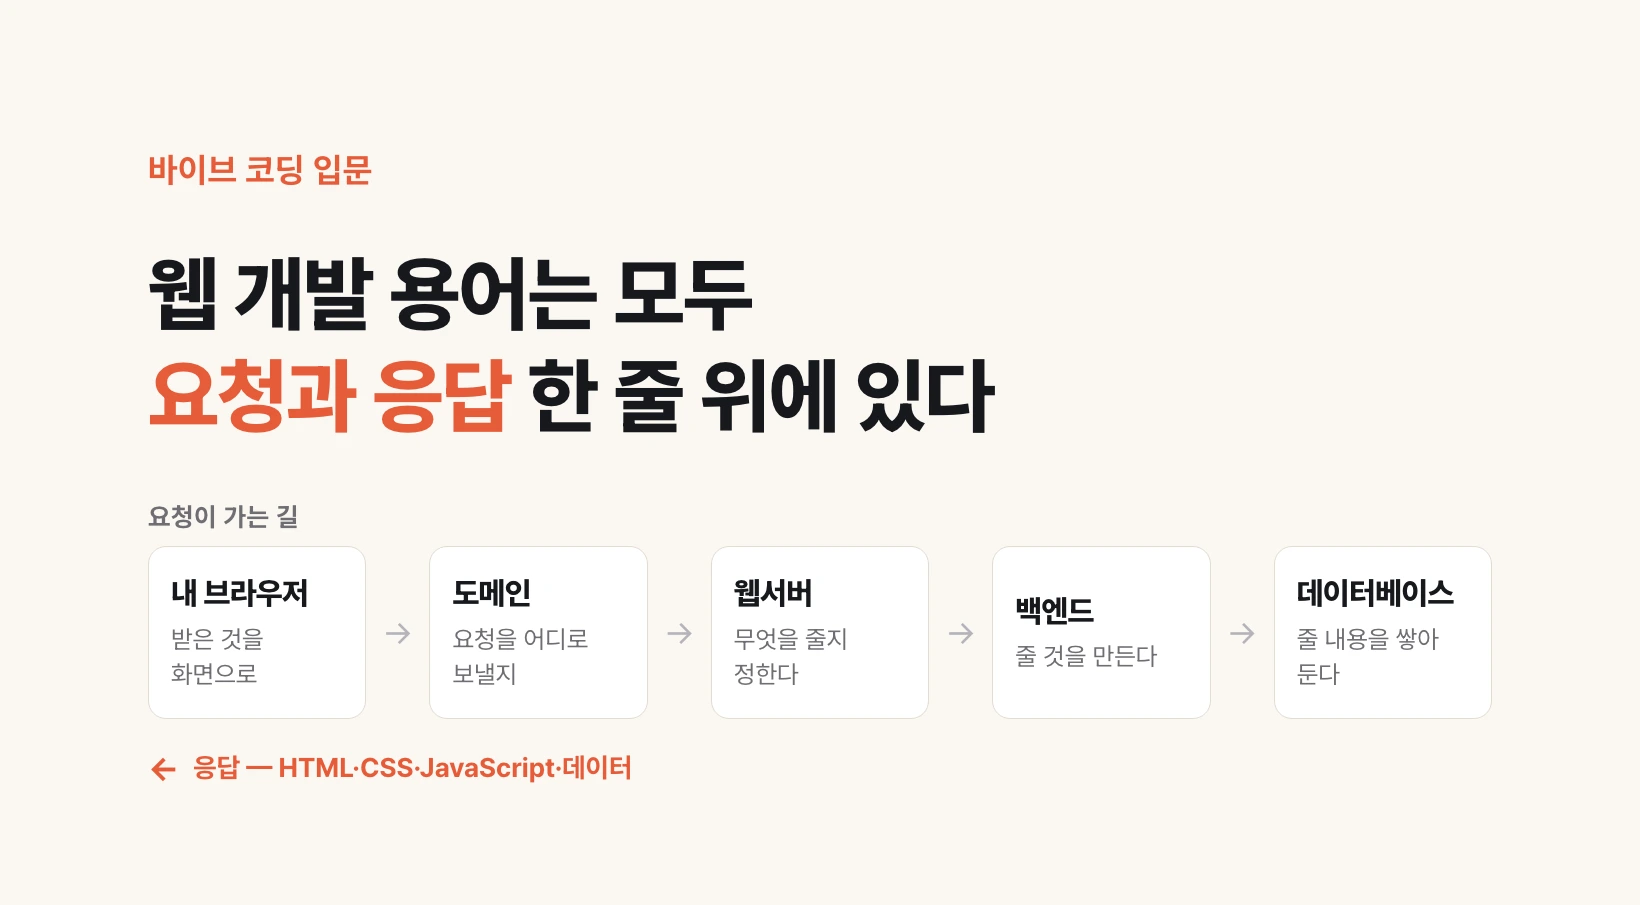
ウェブはどう動くのか — 一回のリクエストとレスポンスで見る全体像
ウェブサイトを見るとは、二十四時間つけっぱなしの他人のコンピュータに画面に必要なファイルを求め、返ってきたものをブラウザが画面として描くことである。ウェブ開発で学ぶものはすべて、このリクエストとレスポンスという一本の線の上の別々の位置にある。リクエストの行き先を決めるのがドメイン、何を返すかを決めるのがウェブサーバー、返すものを作るのがバックエンド、返ってきたものを描くのがフロントエンド、中身を貯めておくのがデータベースとストレージだ。
/rewind・/btw・/rename・/resume・/insights・/doctor — Claude Code のコマンド五つ
Claude Code のスラッシュコマンドは百を超えるが、いくつか知るだけで仕事の仕方が変わる。壊した作業は Esc 二回(/rewind)でチェックポイントまで戻し、作業中に浮かんだ別の疑問は /btw で脇に逃がして聞き、セッションは /rename で名前を付けて /resume で開き直す。月に一度、/insights で自分の使い方を読み、/doctor でインストール状態を点検する。それぞれが何で、どう打ち、どこで引っかかるかを公式ドキュメントで確認してまとめた。
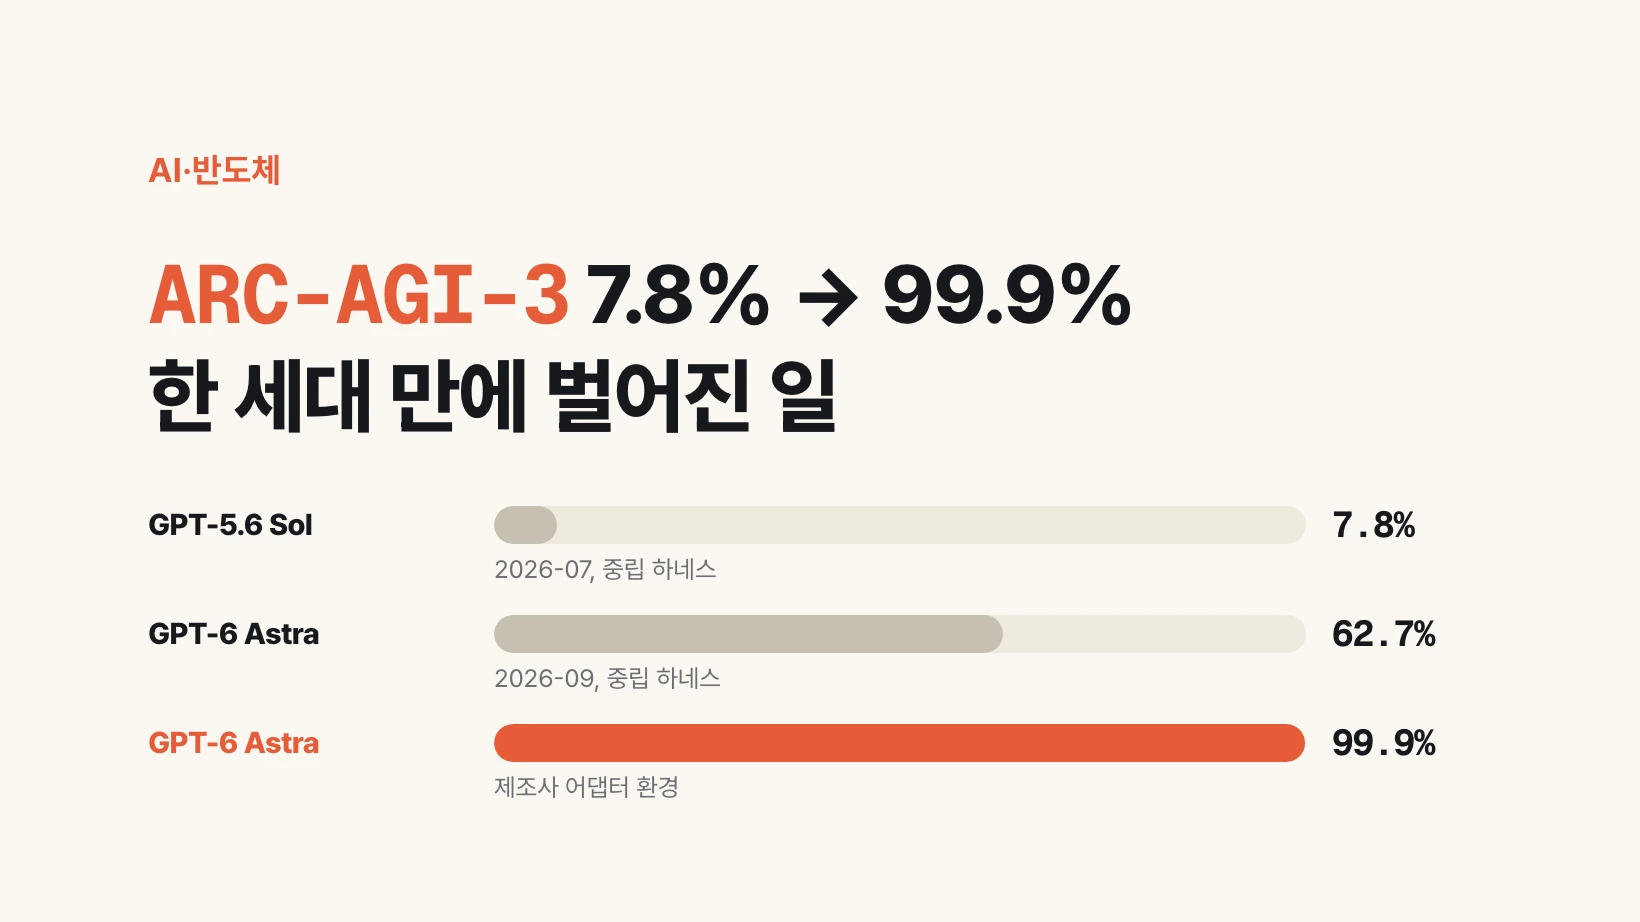
GPT-6 Astra の ARC-AGI-3 99.9% は何を意味するのか
ARC-AGI-3 は知識を問う試験ではない。初めて見る環境にモデルを放り込み、説明書を与えず、ルールと目標を自力で突き止めさせる。二か月前に GPT-5.6 Sol が 7.8% を取り、この試験で一つでもゲームを攻略した最初のモデルになった。2026 年 9 月 3 日、GPT-6 Astra が 99.9% を記録した。ベンダー用アダプタを外した中立ハーネスでも 62.7% だ。変わったのは点数ではなく能力の種類で、うまく答える AI から、不慣れな状況を自分で定義して動く AI に移った。その能力が実際に使われれば消費トークンは桁で増え、HBM と DRAM の需要に直結する。
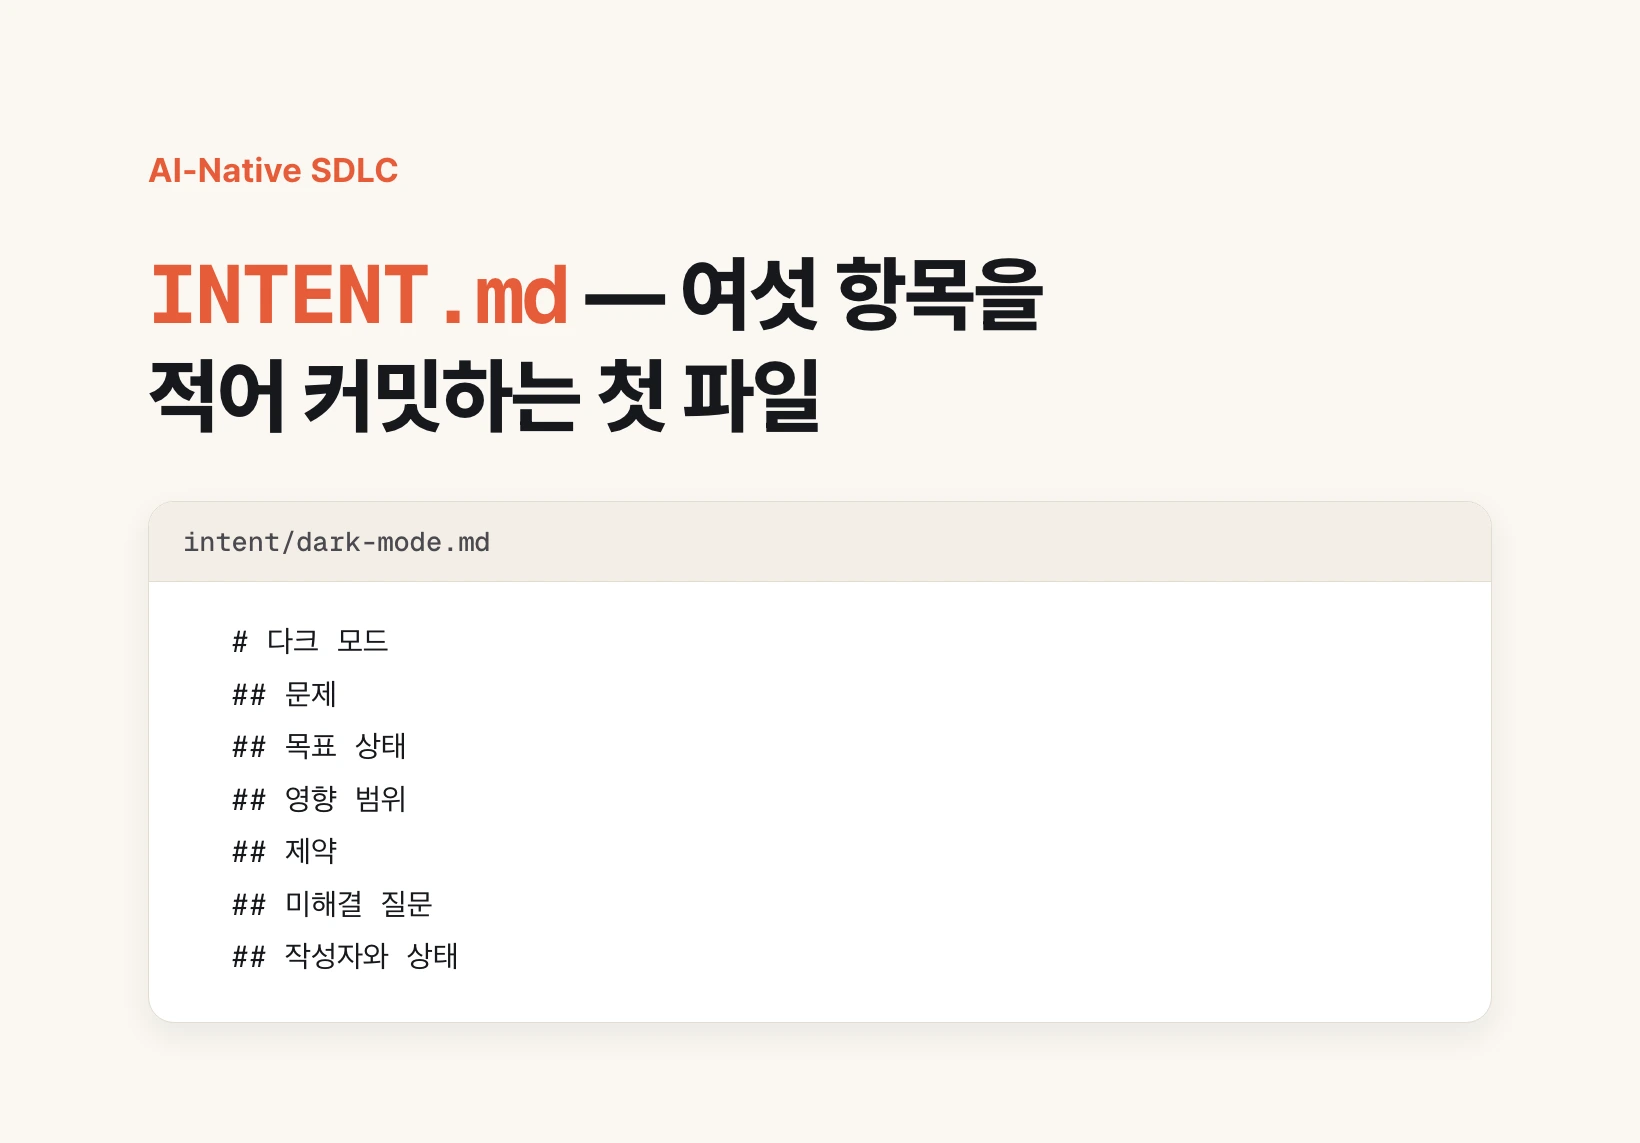
INTENT.md とは何か — AI ネイティブ SDLC の最初のファイル
INTENT.md は、何を・なぜ・どんな制約のもとで作りたいのかを、アイデアを出した本人の言葉で書いてリポジトリにコミットするファイルである。Anthropic が 2026 年 8 月 21 日に公開した AI ネイティブ SDLC プレイブックの最初の段階であり、ここに収められた六つが次の成果物である spec.md の材料になる。会議を設定して文書担当を待つ代わりに、経験した本人がエージェントと対話してその場で書き、自分で読み返して直したうえでコミットする。
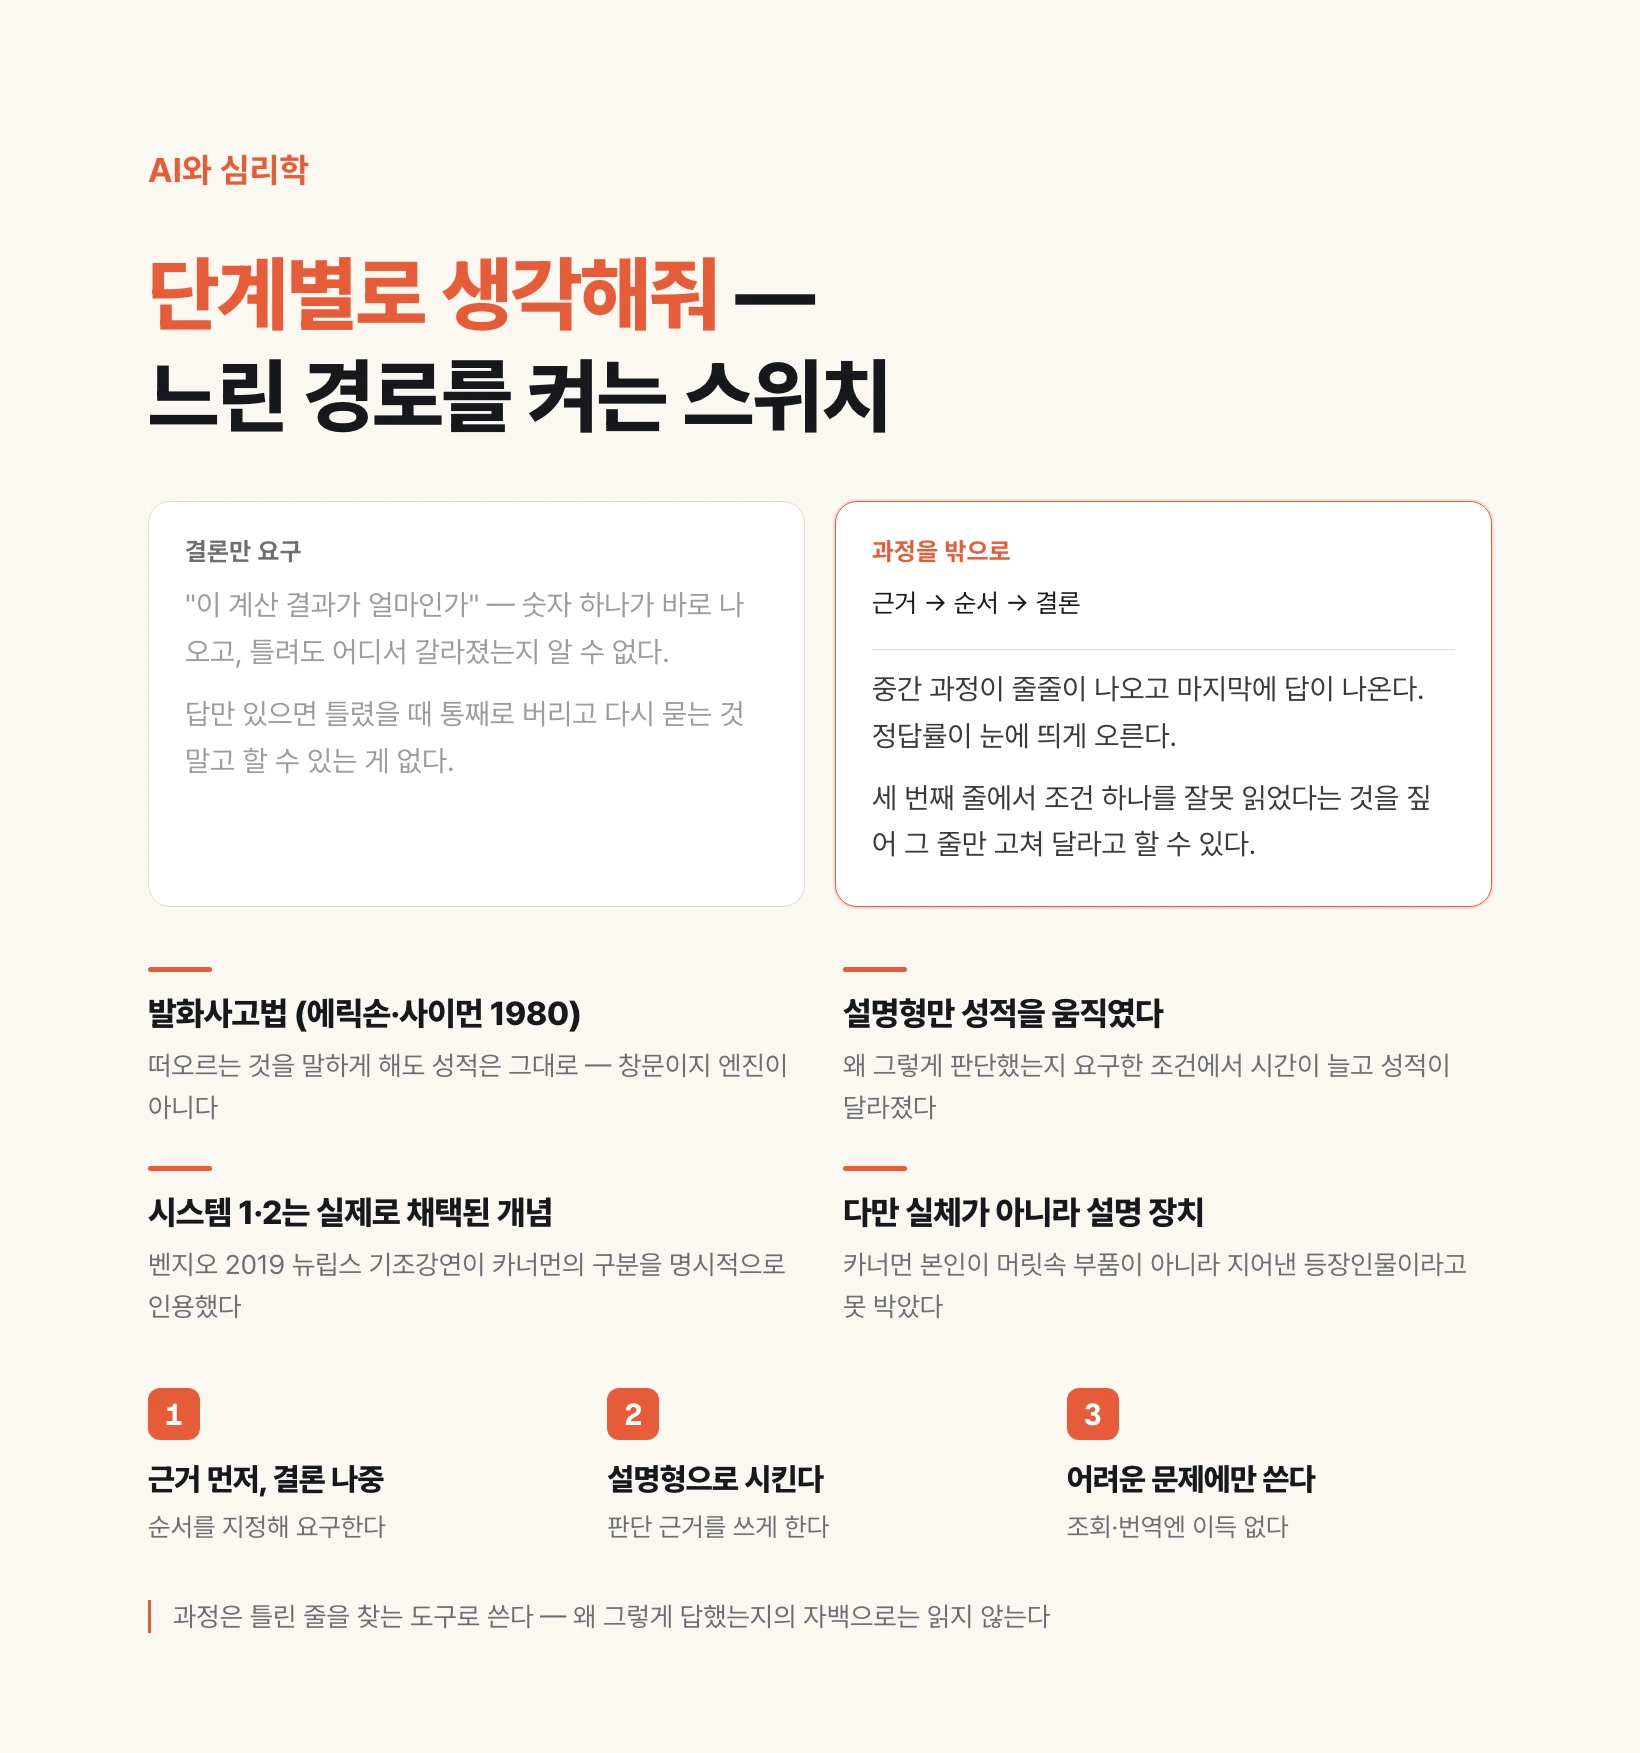
AIに声に出して考えさせよ — 段階的に考えての正体
プロンプトに一行足すと答えの正確さが上がる。その一行がしているのは、結論へ飛ぶのを止めて途中の作業を外へ出させることだ。人の思考を研究する方法が1980年に同じ原理を使い、カーネマンの速い思考と遅い思考の区別はAI研究が実際に採用した。ただしその区別を立てた側は、それが頭の中に実在するものではないと念を押している。
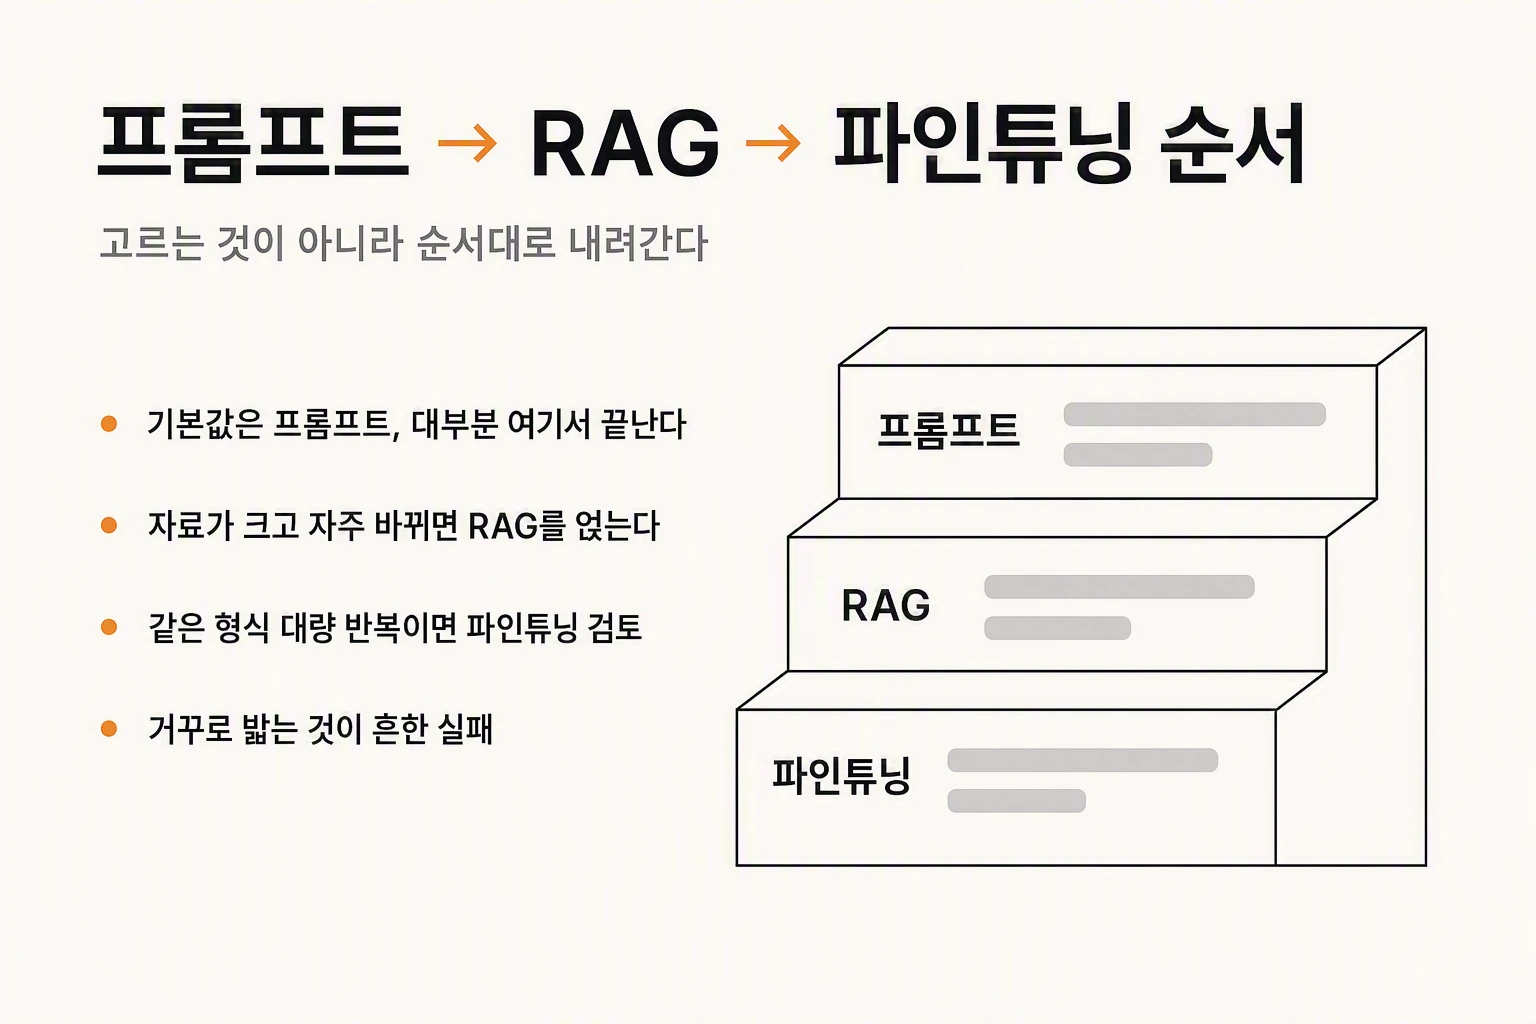
プロンプトで解くかRAGで解くかファインチューニングまで行くか — 判断基準
三つは対立する選択肢ではなく順序である。ほとんどはプロンプトで解ける。答えの根拠となる資料が多く頻繁に変わるならRAGを重ねる。ファインチューニングは同じ形式の仕事を大量に繰り返し、プロンプトの長さ自体がコストになったときに下りていく最後のカードだ。前の五編を読んでいれば、この基準がなぜそう分かれるのかを構造として理解できる。
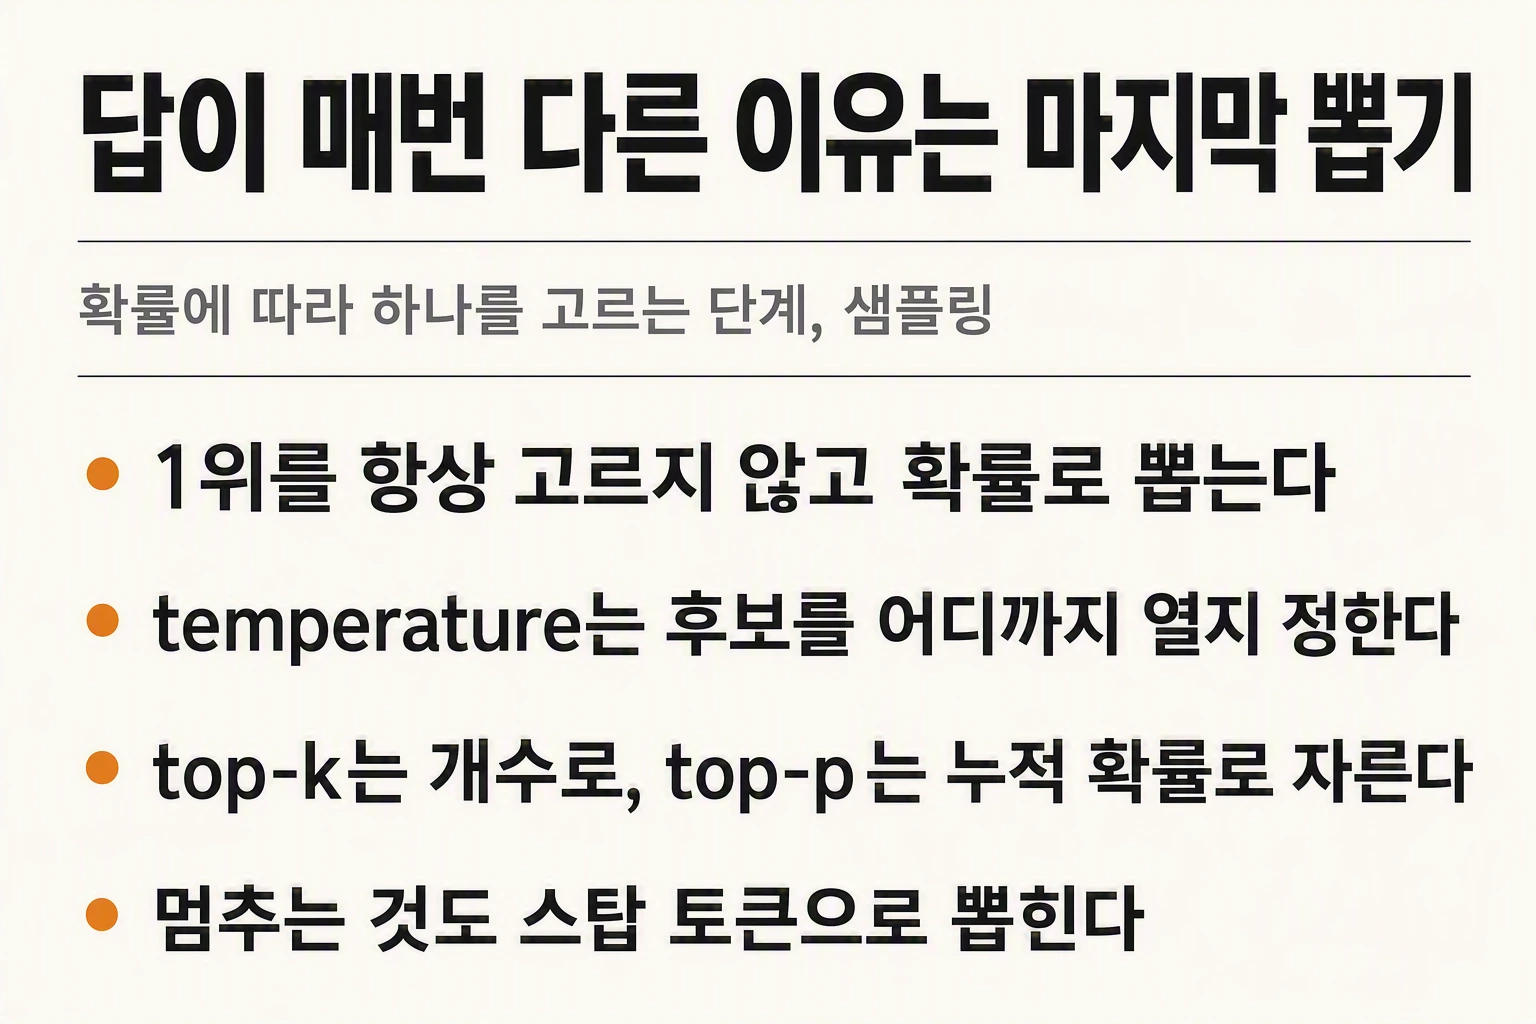
同じ質問なのに答えが毎回違う理由 — サンプリングとtemperature
モデルは最後にコインを投げる。前の段階で次のトークンの候補と確率が作られるが、ここで1位を無条件に選ぶのではなく、確率に従って一つを引く。だから同じ質問でも答えが少しずつ変わる。temperatureとtop-k、top-pは、その抽選の候補をどこで切るかを決める値だ。パラメータが変わって答えが違ってくるのではない。
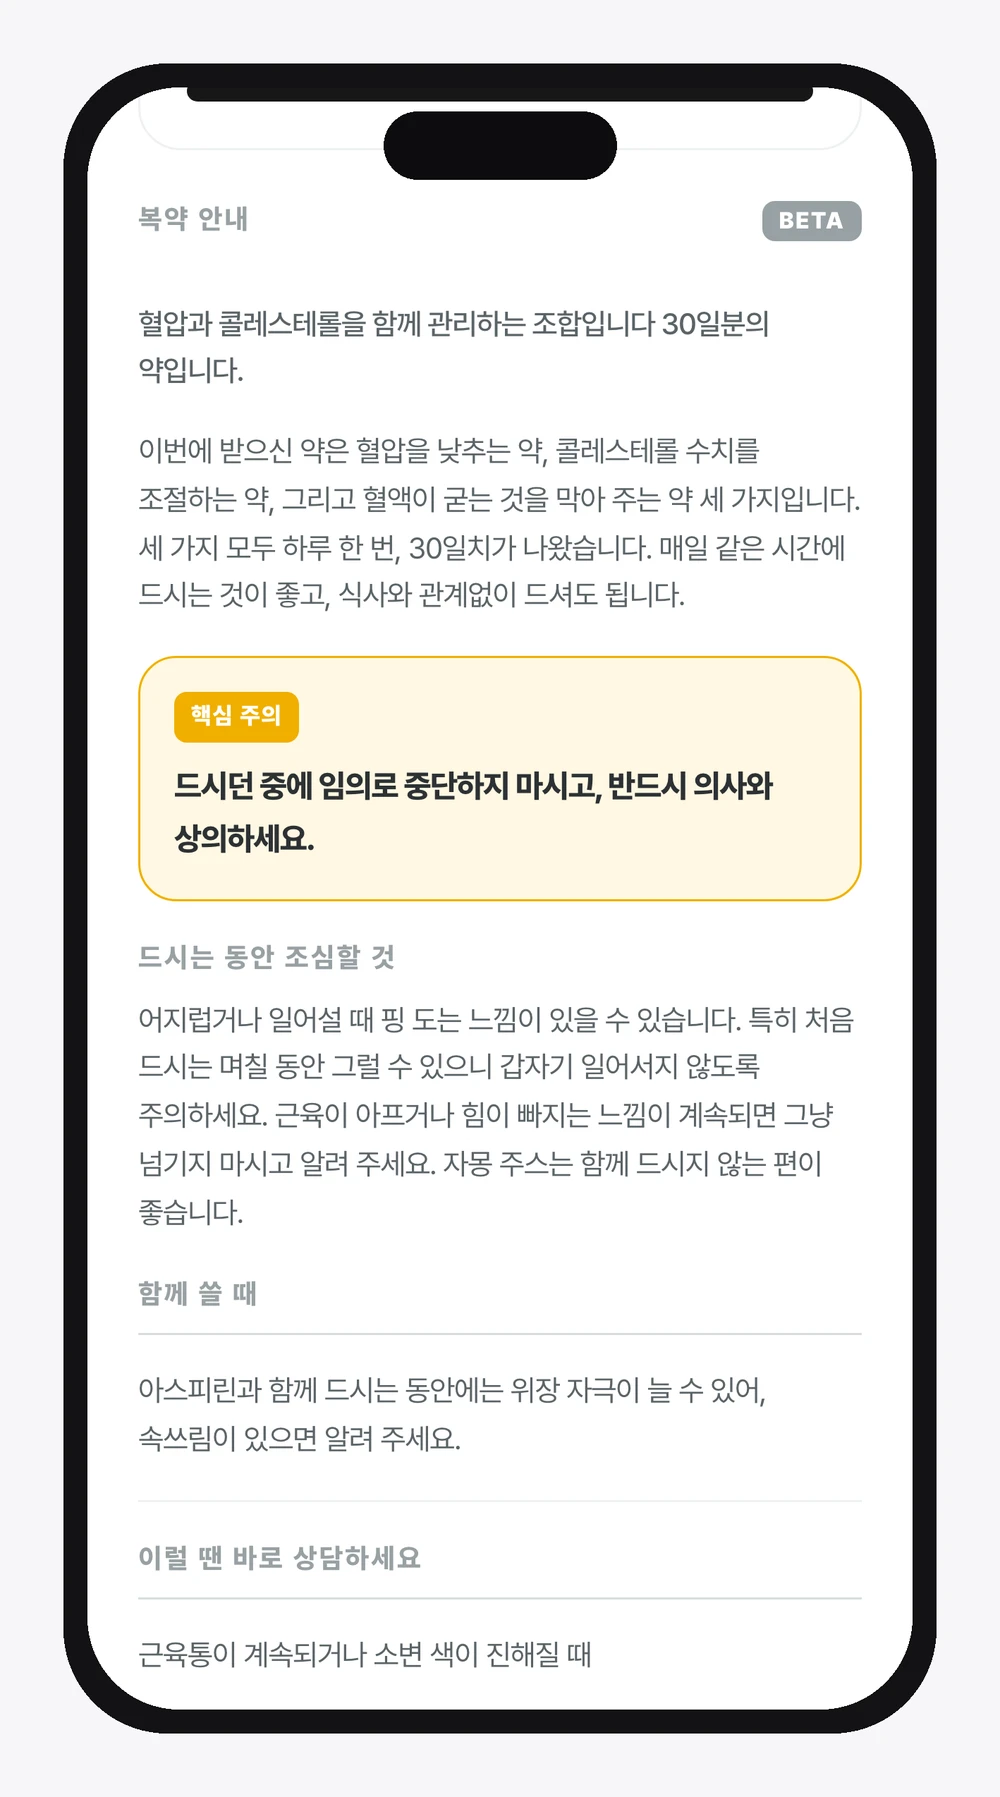
調剤単位で読む服薬説明 — PillCheck は薬袋を丸ごと見る
出力だけでハルシネーションを判定することはほぼできない。うまく書かれた嘘とうまく書かれた事実は、文としては区別がつかないからだ。減らすには、検査を出力の読み合わせではなく入力原文との照合として組む — 数字は原文にあるものだけ、安全文言は原文と完全一致、主張には項目ごとの根拠。そして件数を強制すると、モデルは空欄を埋めるために作り出す。
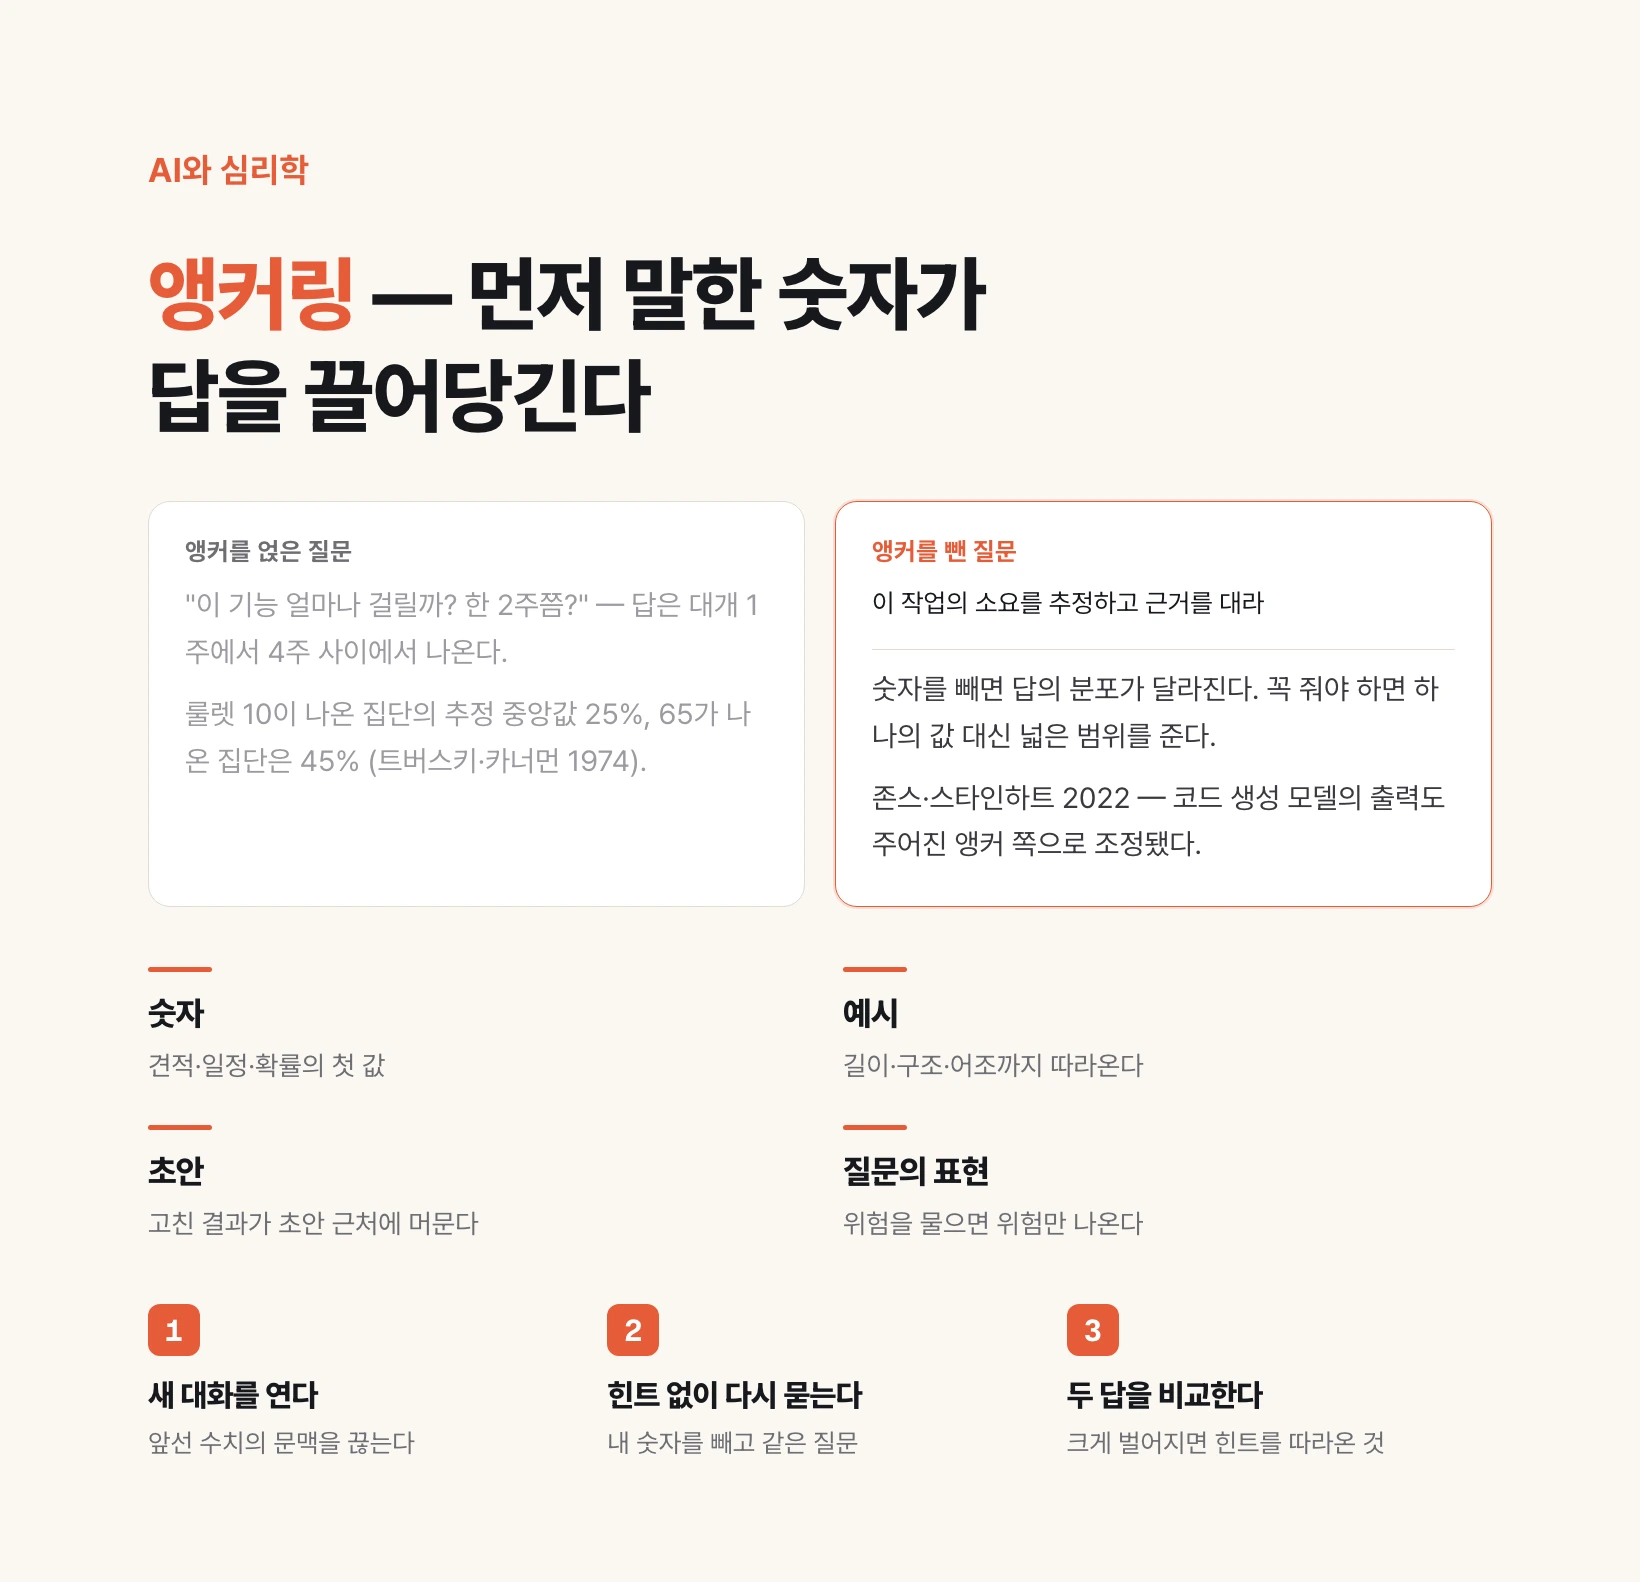
AIに数字を先に言うと答えが引っ張られる — アンカリング
見積もりでも日程でも確率でも、問いに数字を一つ乗せると答えはその近くで出てくる。人については1974年に確認された現象であり、無作為に出た数字だと知っていても判断が引っ張られるというのが実験の要点だ。そして2022年に同じ設計で言語モデルを測ったところ、同じ方向へ傾いた。
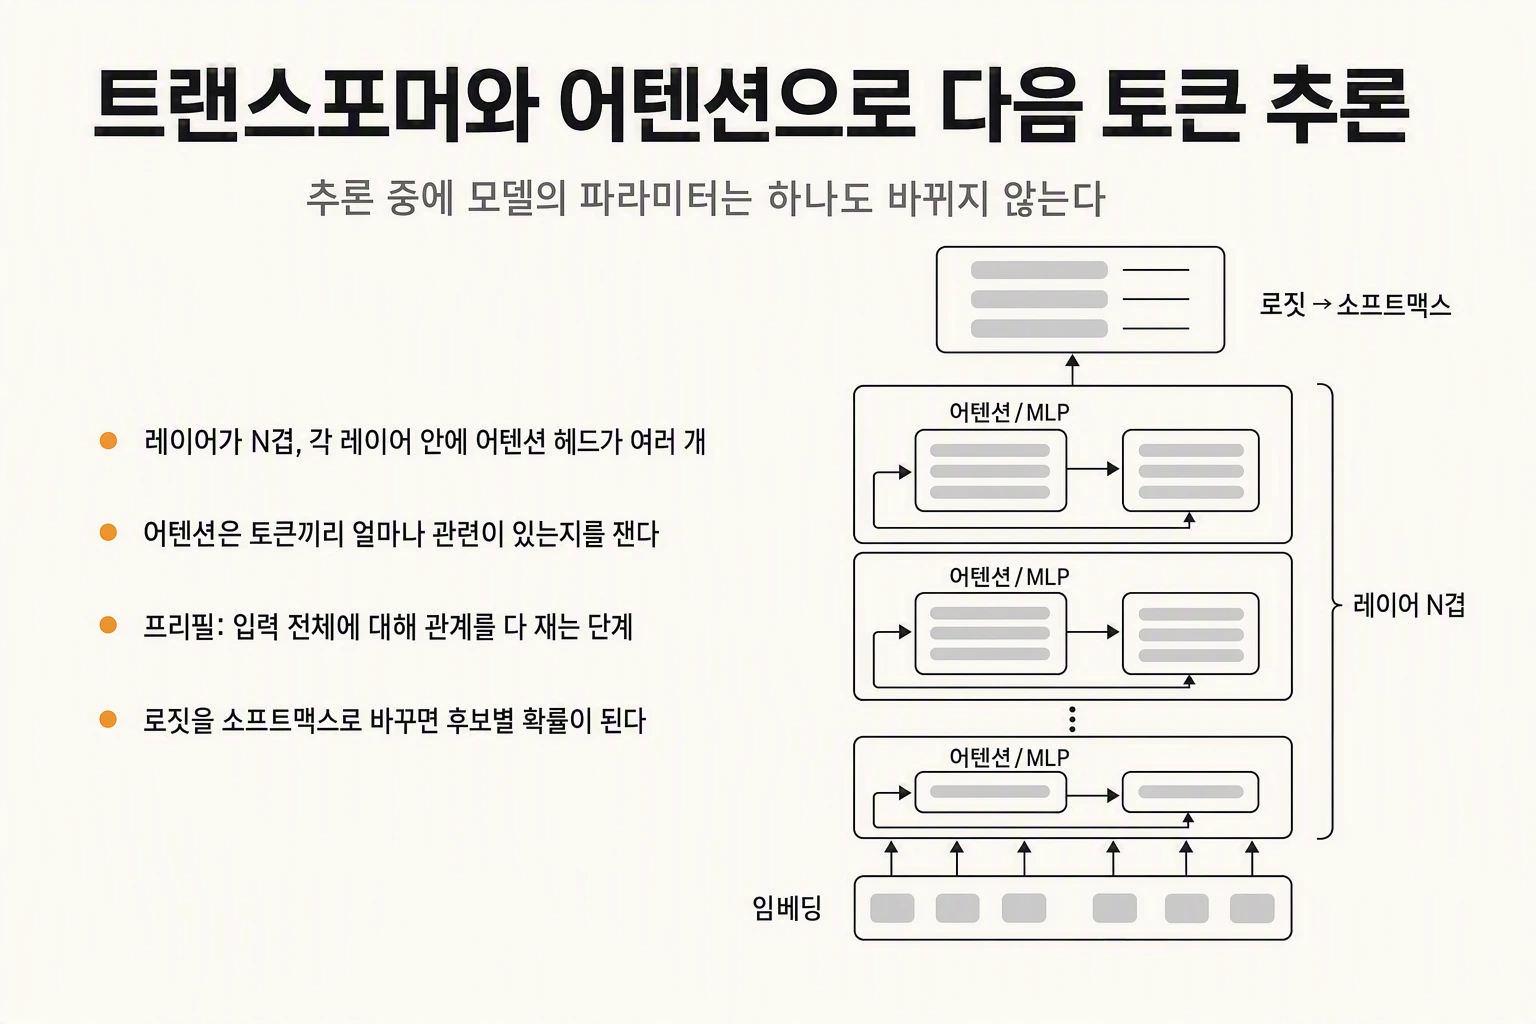
推論はどのように起きるのか — トランスフォーマーとアテンション
推論は、すでに出来上がったモデルを使う作業だ。入力した文章はトークンIDに変わり、数値ベクトルとして埋め込まれたあと、何重にも重なった層を通過する。各層で行われる中心的な処理は、トークン同士がどれだけ関連しているかを測るアテンションだ。その結果として、次に来るトークンの候補が点数付けされる。この過程でモデル内部の値は一つも変わらない。
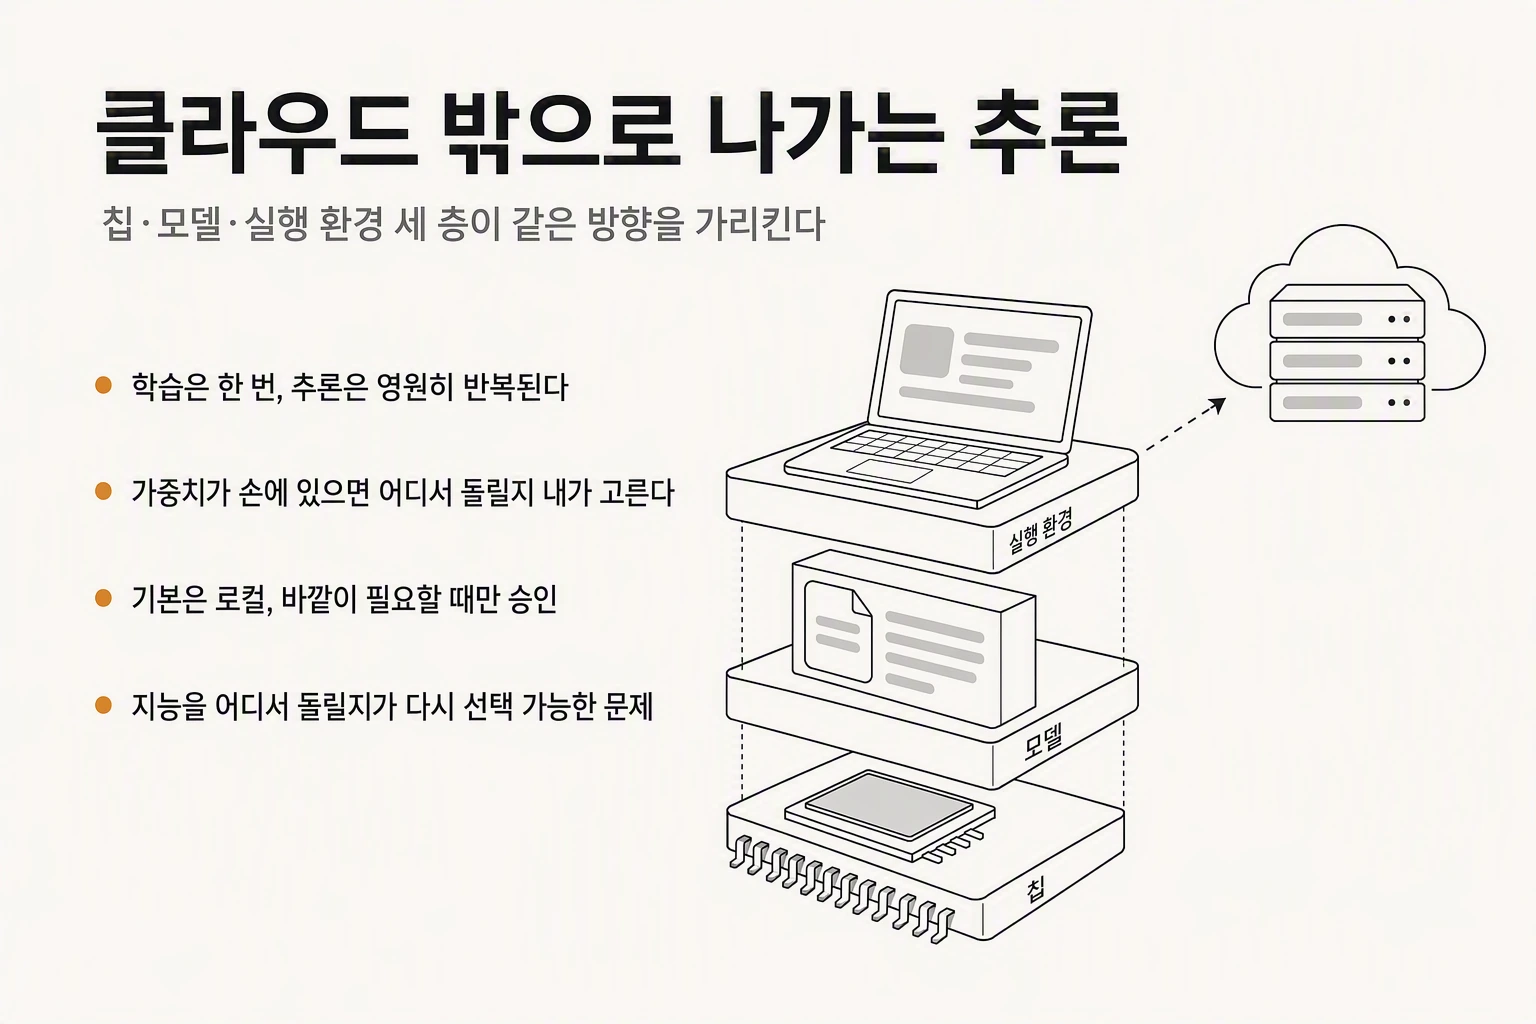
AI の推論はなぜクラウドの外へ出ていくのか
AI を使うときのコストと遅延の大半が推論で発生し、その推論を他社のクラウドに預けると請求もデータの行き先も自分で制御できないからだ。2026 年 8 月最終週に出た 10 件のニュースが同じ方向を指している。OpenAI は自社推論チップの初の実測を公開し、Z.ai と Qwen は重みを公開した大型モデルを出し、Perplexity はモデルもハーネスもユーザーの端末で動くエージェントを発表した。チップ・モデル・実行環境の三層が同時にクラウドの外へ押し出されている。
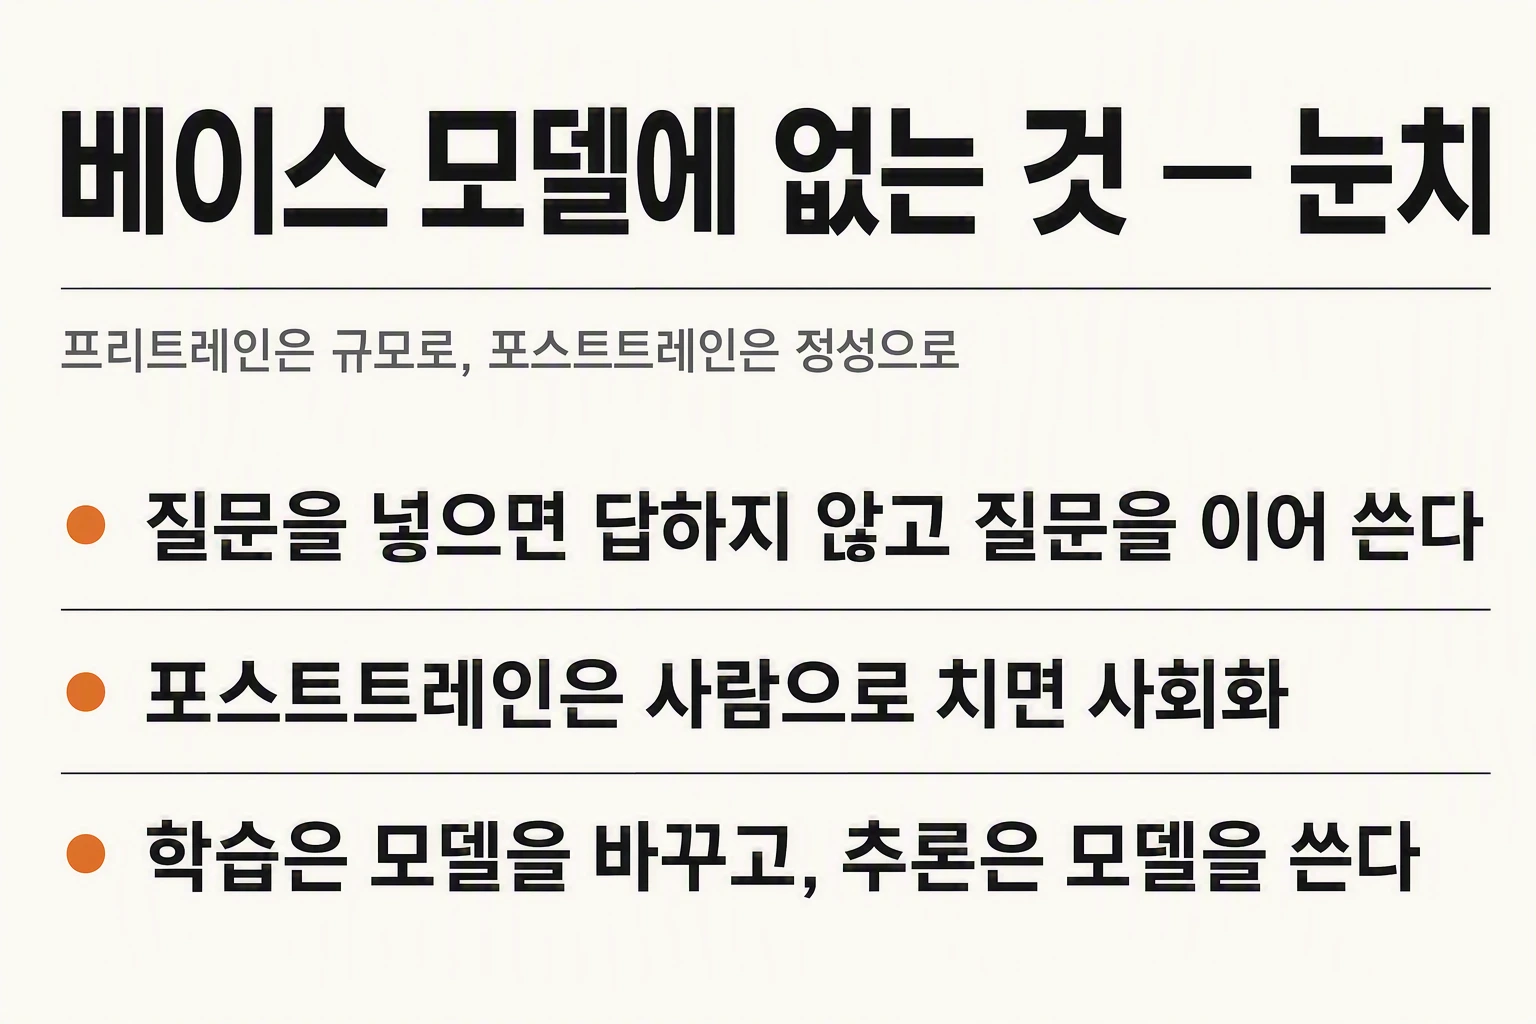
ベースモデルはなぜそのまま使えないのか — 事前学習と事後学習
事前学習を終えたモデルはまだ製品ではない。そこまでに学んだのは次に来るトークンとして何が自然かという一点だけなので、質問を投げても答える代わりに質問を書き続ける。ここに質疑応答の形式と指示への追従を教える追加訓練が加わって、はじめて私たちが使うモデルになる。その段階が事後学習であり、事前学習を実行できる組織はごく少数なのに世の中にモデルが多い理由は、まさにこの段階にある。
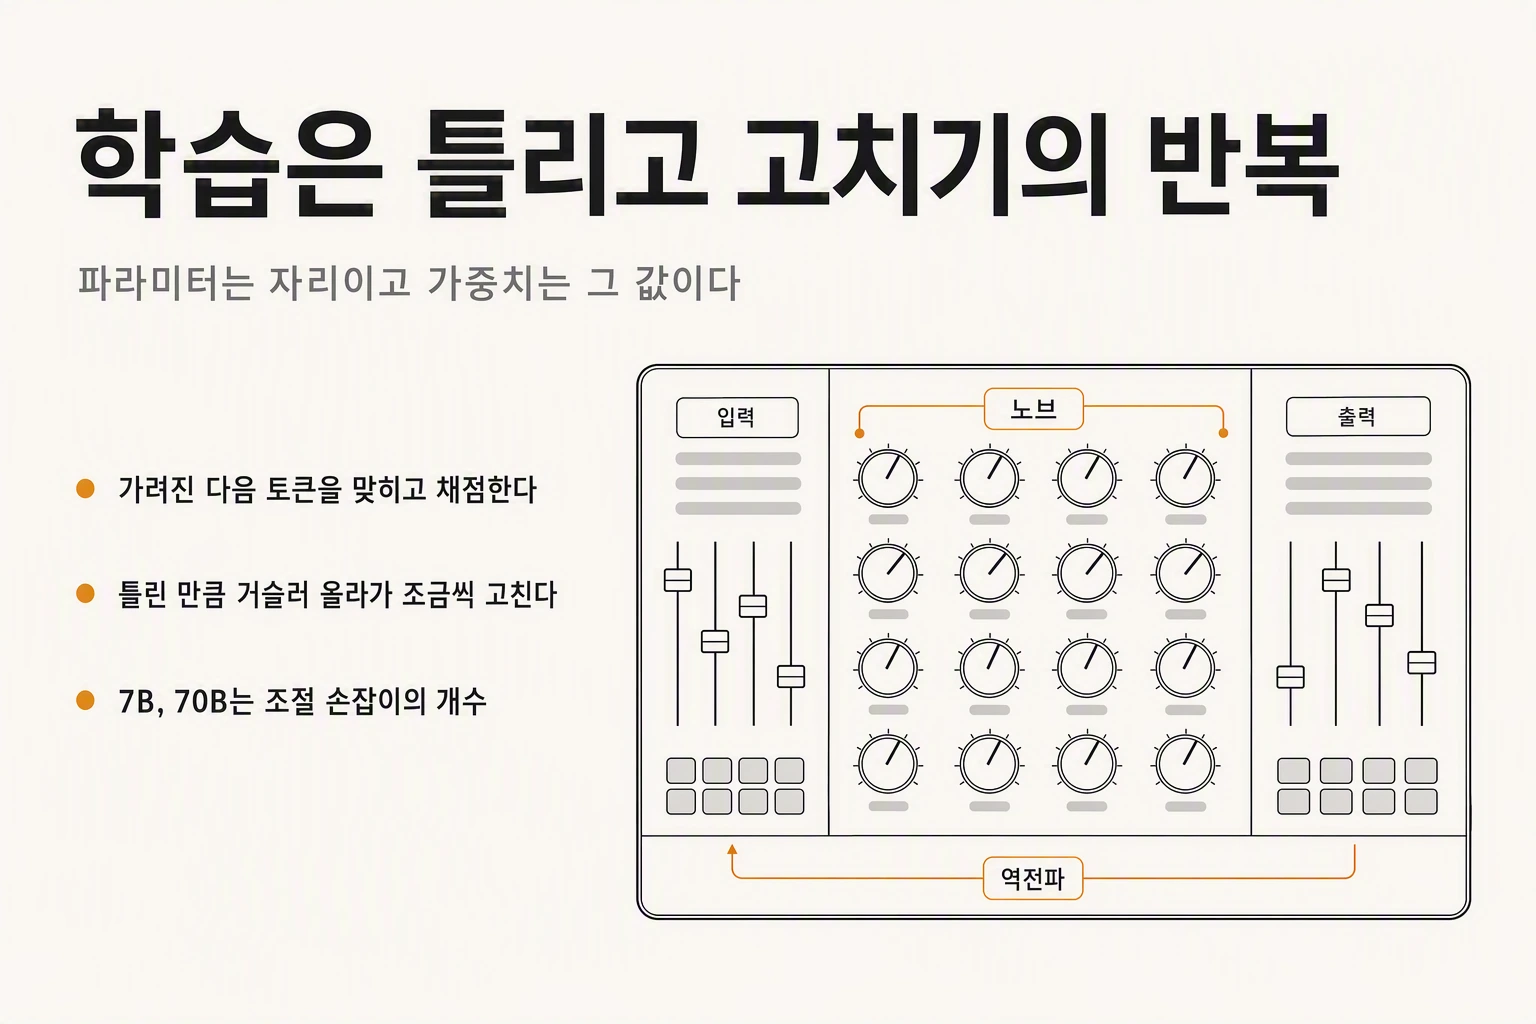
モデルはどう学習するのか — パラメータと重みの正体
学習とは、間違えては直すことの無限の繰り返しである。文末のトークンを隠して、ニューラルネットワークに当てさせてみる。最初はすべて外れる。そのたびに「何をどう変えていれば当たったのか」を計算し、内部の設定値を少しずつ戻して直す。その設定値がパラメータであり、そこに入っている値が重みである。モデル名の横にある7B、70Bは、その設定値がいくつあるかを数えた数字である。
トークンとは何か — 文章が数字になってモデルに入るまで
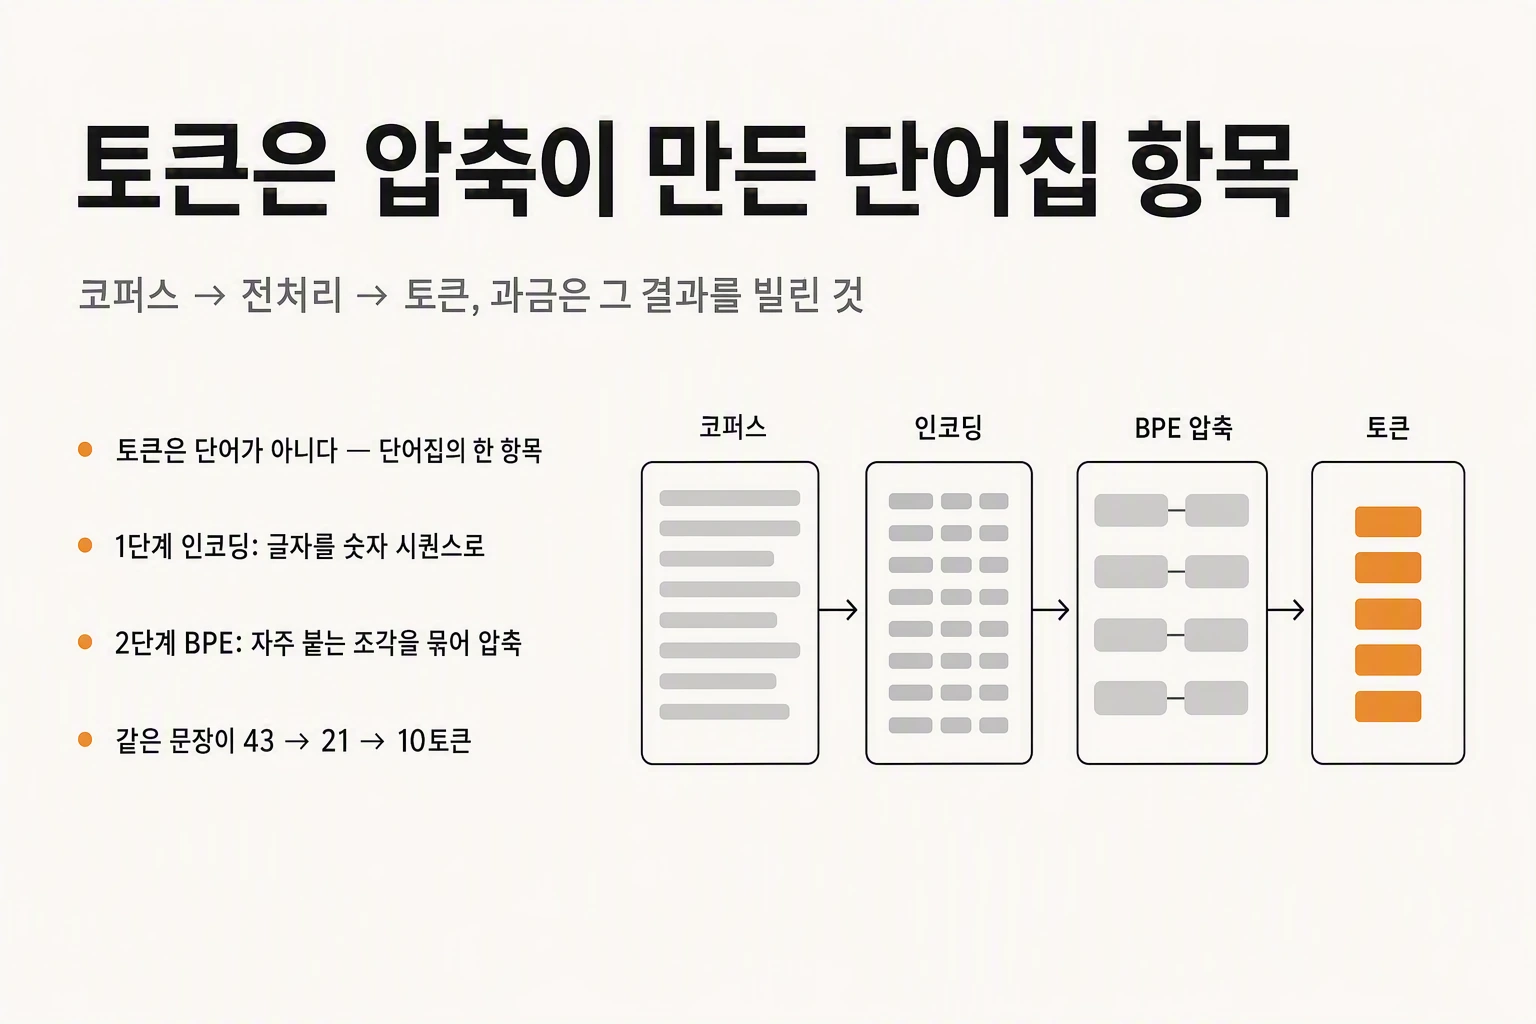
トークンは単語ではなく、圧縮の産物である。LLM は文章を文字のまま読まない。集めた膨大な文章をまず UTF-8 で数字の長い並びに変換し、頻繁に隣り合う断片をまとめて語彙表を作る。その語彙表の一項目がトークンだ。だから韓国語の「점심」は一語なのに二トークンであり、同じ文でもモデルを変えるとトークン数が四倍以上変わる。
eli5 — 複雑な主題を一枚の絵に変える Claude Code プラグイン
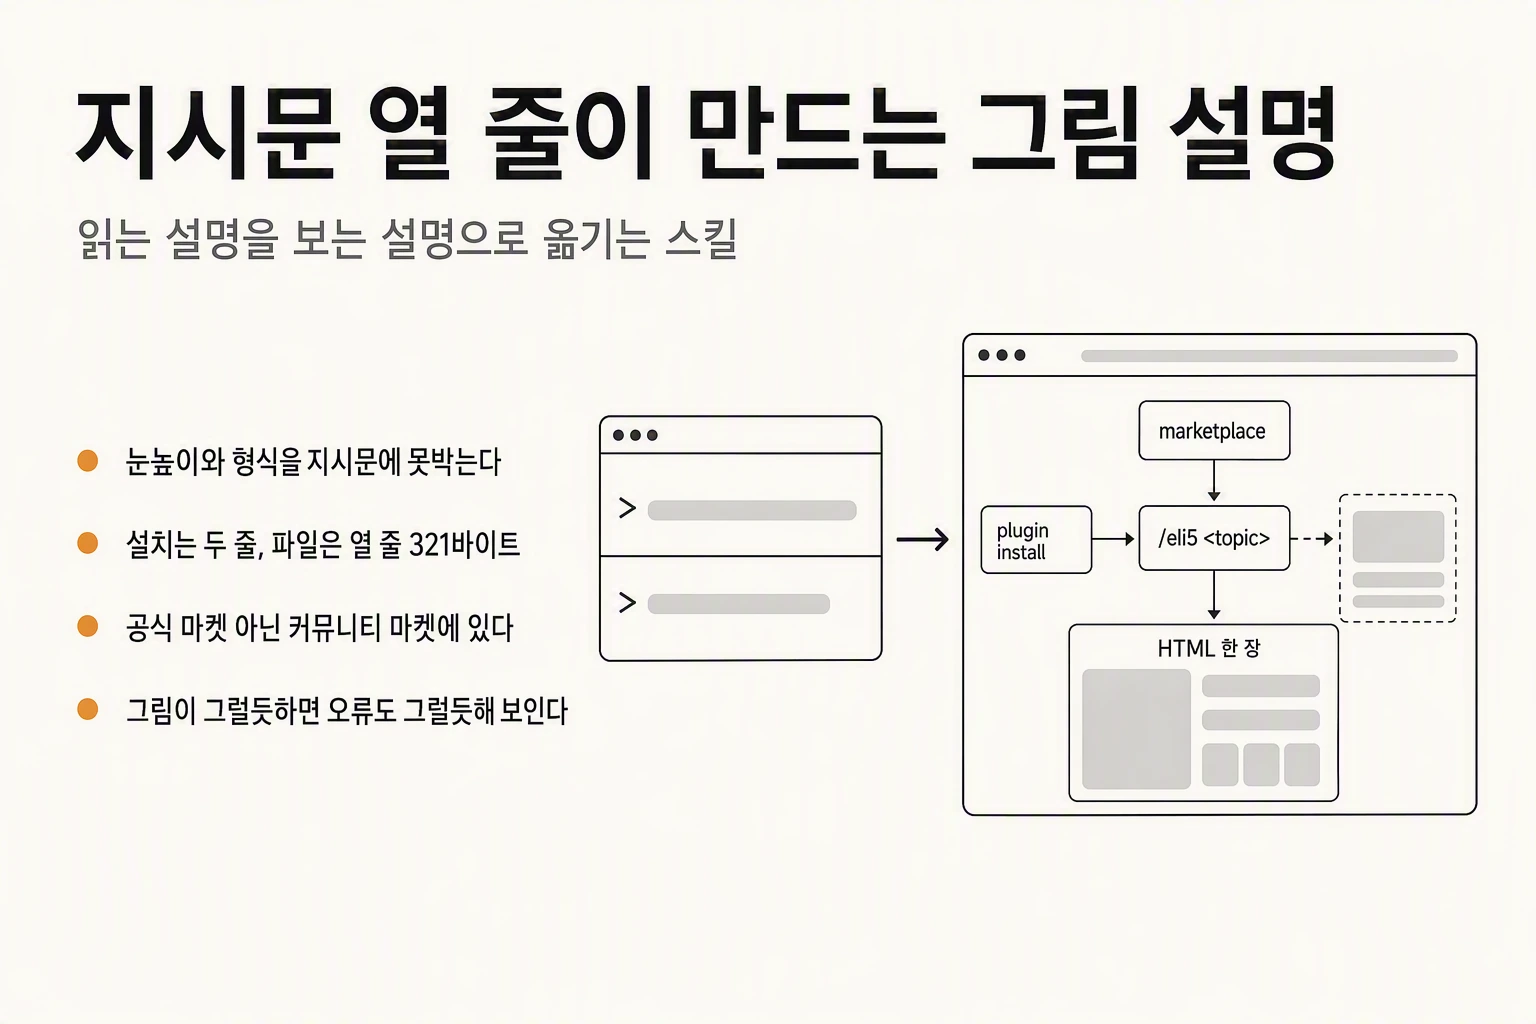
eli5 は Claude Code のプラグインで、/eli5 のあとに主題を書くと、その主題を何も知らない人に合わせて説明し直し、絵が中心の HTML 一枚にまとめてくれる。名前は Explain Like I am 5 の略で、五歳児に説明するように、という意味だ。インストールはマーケットプレイスの追加とプラグインのインストールの二行で終わり、スキル本体は十行 321 バイトしかない。この十行が固定するのは説明の高さと出力形式であって、内容が正しいかどうかは判定しない。
AIは嘘をつかない — 空白を埋めているだけだ
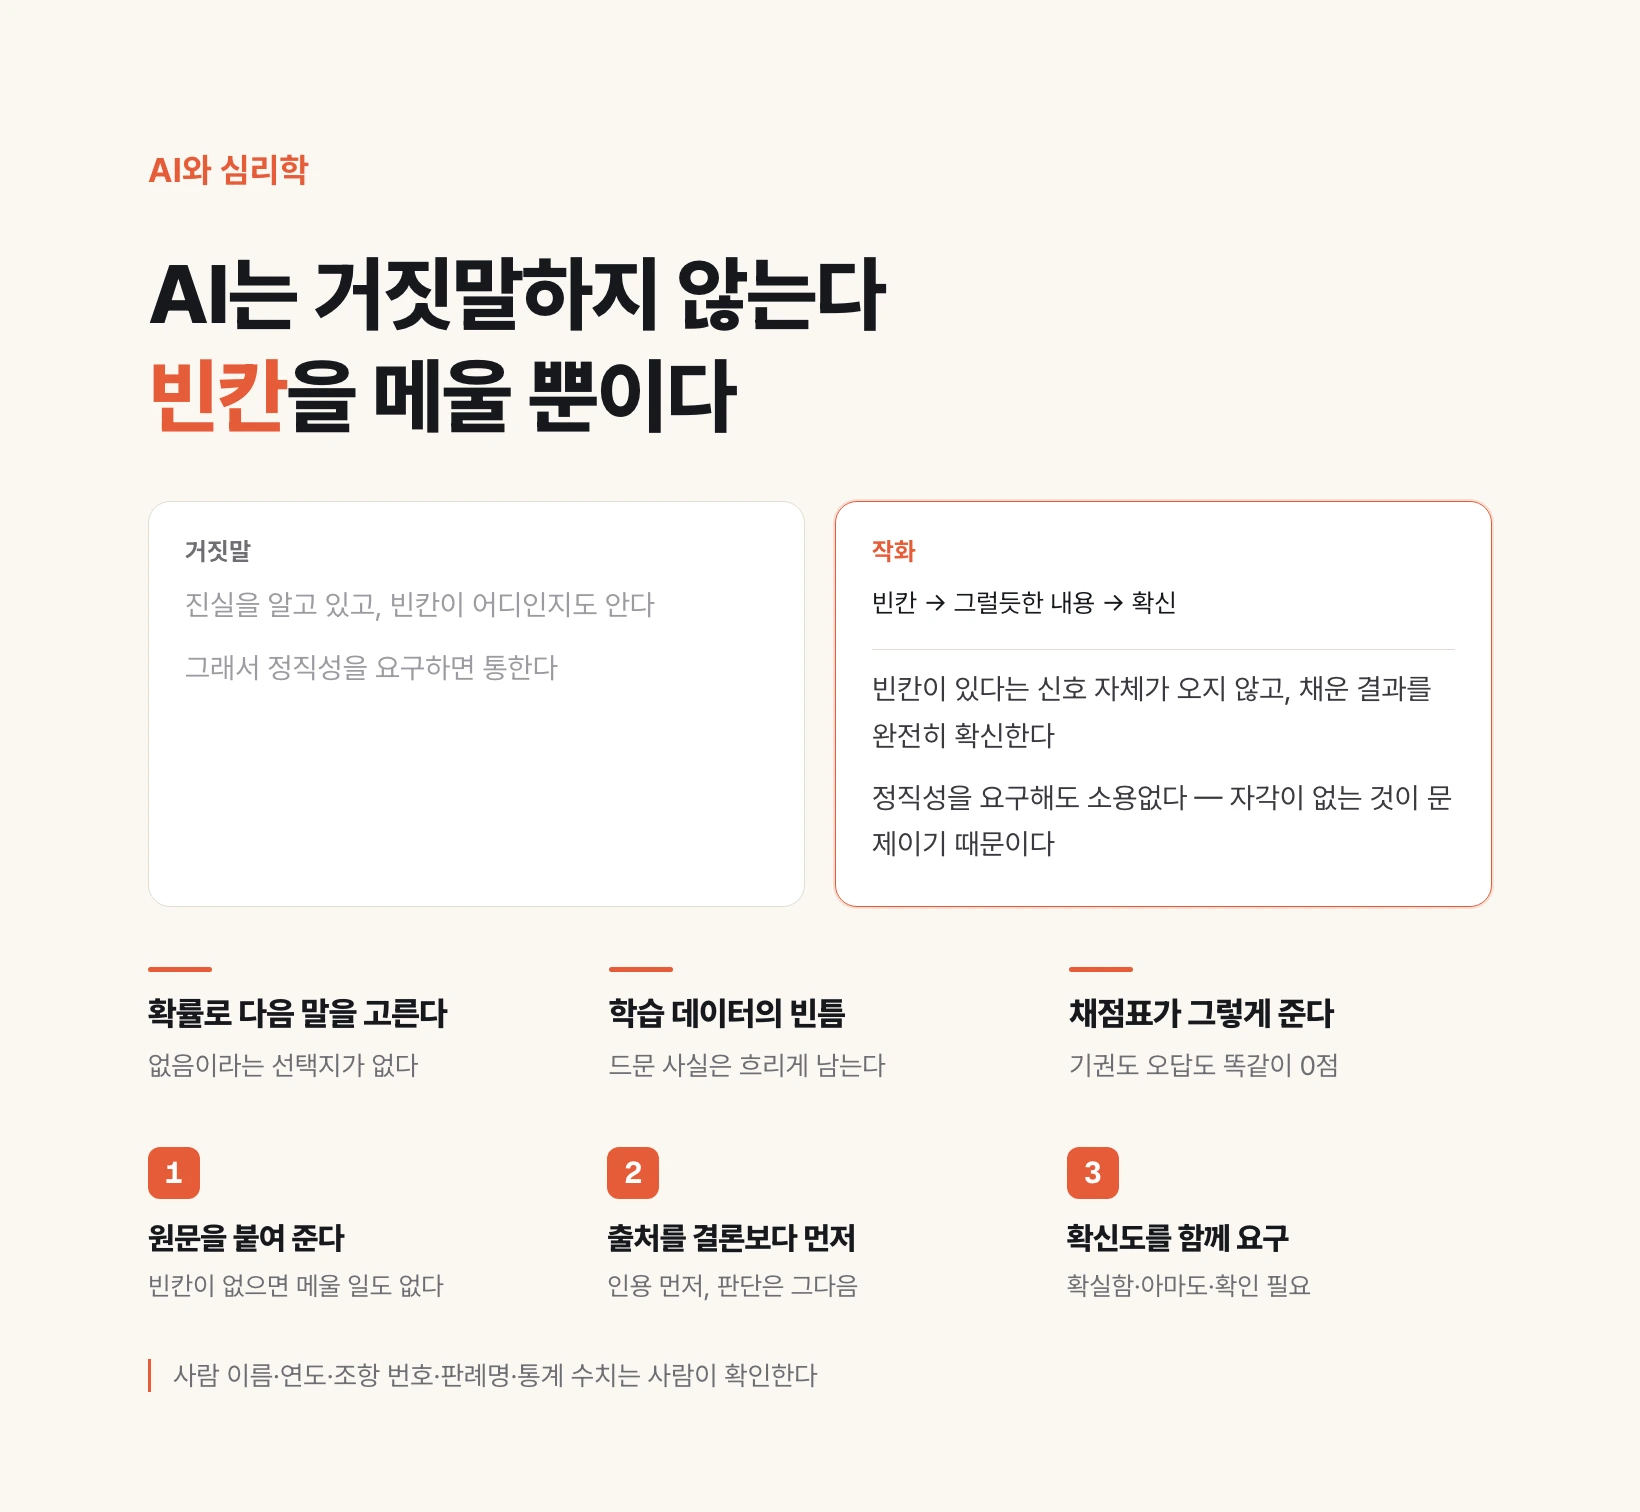
AIが存在しない論文をこしらえ、存在しない条項を作り出すとき、それは欺く行為ではない。人の記憶も同じやり方で失敗する。空白を自覚しないままもっともらしい話で埋め、その結果を完全に確信する。この比喩を正確に使えば対応が変わる。正直さを求めるのではなく、空白が生じないよう材料を供給することだ。
stdin とは何か
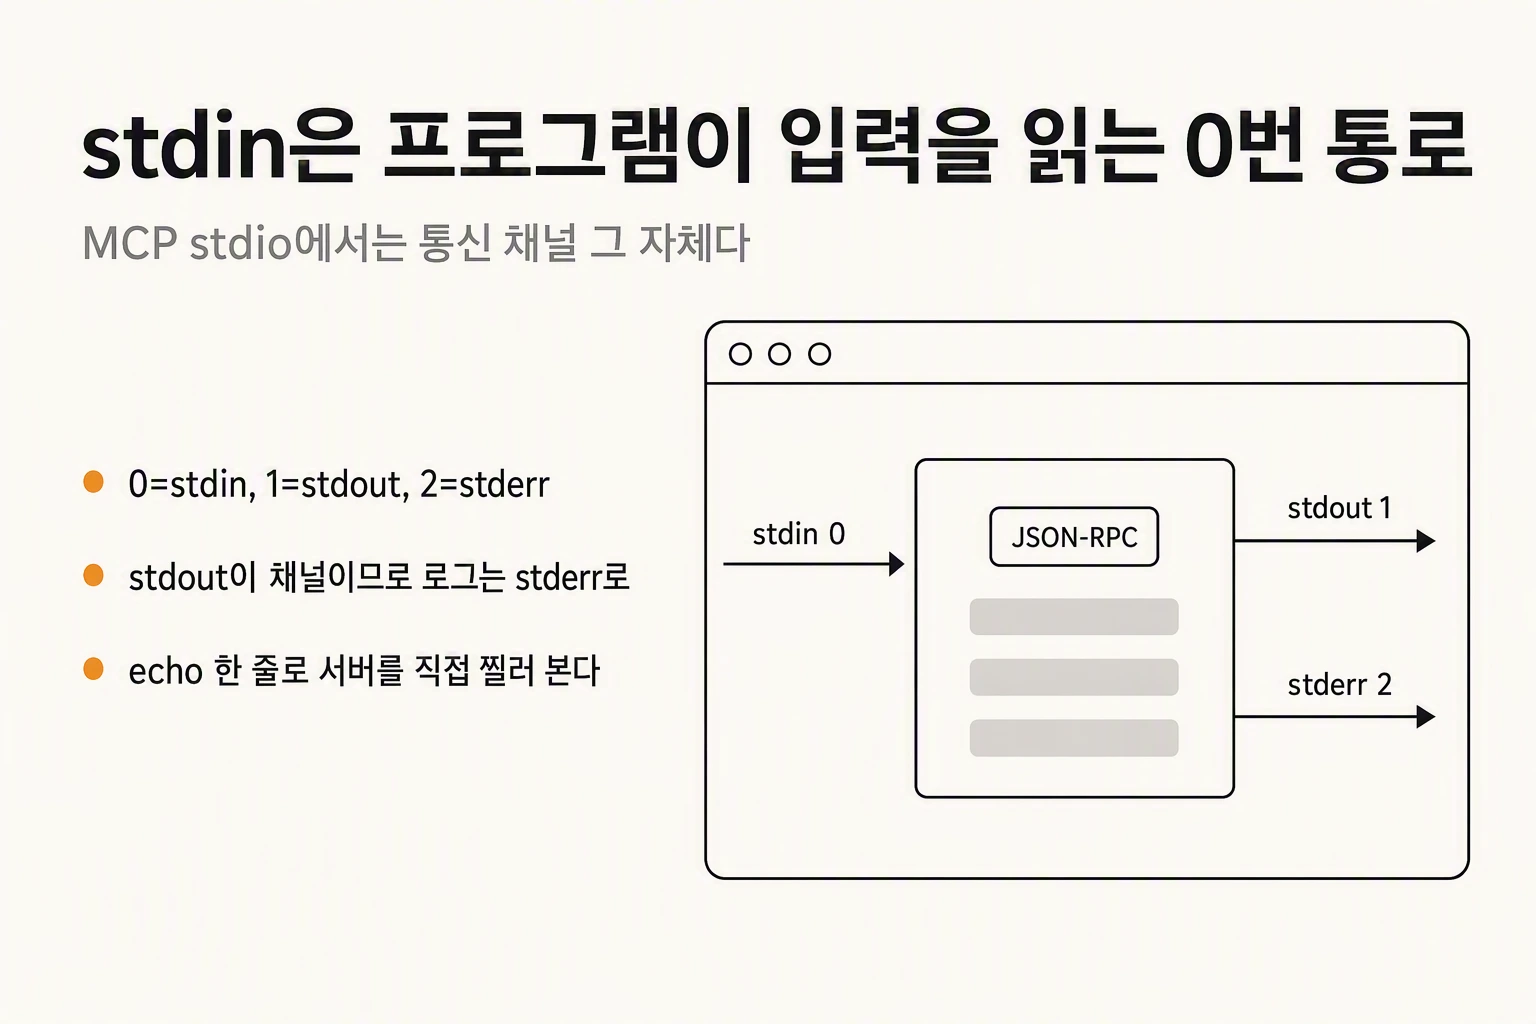
stdin(標準入力)はプログラムが入力を読み込む既定の通り道であり、ファイルディスクリプタ 0 番である。シェルでパイプ(|)やリダイレクト(<)でデータを渡すときに使われるのがこの通り道だ。プログラムは入力がキーボードから来たのかファイルから来たのか前のコマンドの出力から来たのかを知らなくてよく、接続はシェルが行う。Unix のパイプラインが成立する理由はここにある。ところが MCP では stdin の位置づけが変わる。stdio トランスポートにおいて stdin と stdout は、データを運ぶ通り道どころか通信チャネルそのものである。ローカルの MCP サーバーはクライアントが起動した子プロセスであり、ソケットもポートも開かずに改行区切りの JSON-RPC メッセージを stdin で受け取り stdout で返す。だからこそ仕様は、サーバーは有効な MCP メッセージでないものを自身の stdout に書いてはならない、と定めている。console.log 一行、ライブラリのバナー、npm の警告ひとつがその JSON ストリームに混ざればクライアントのパーサーは壊れる。MCP サーバーが接続できないと表示されたとき最初に疑うべき原因がこれであり、対処はすべてのログを stderr に送ることだ。
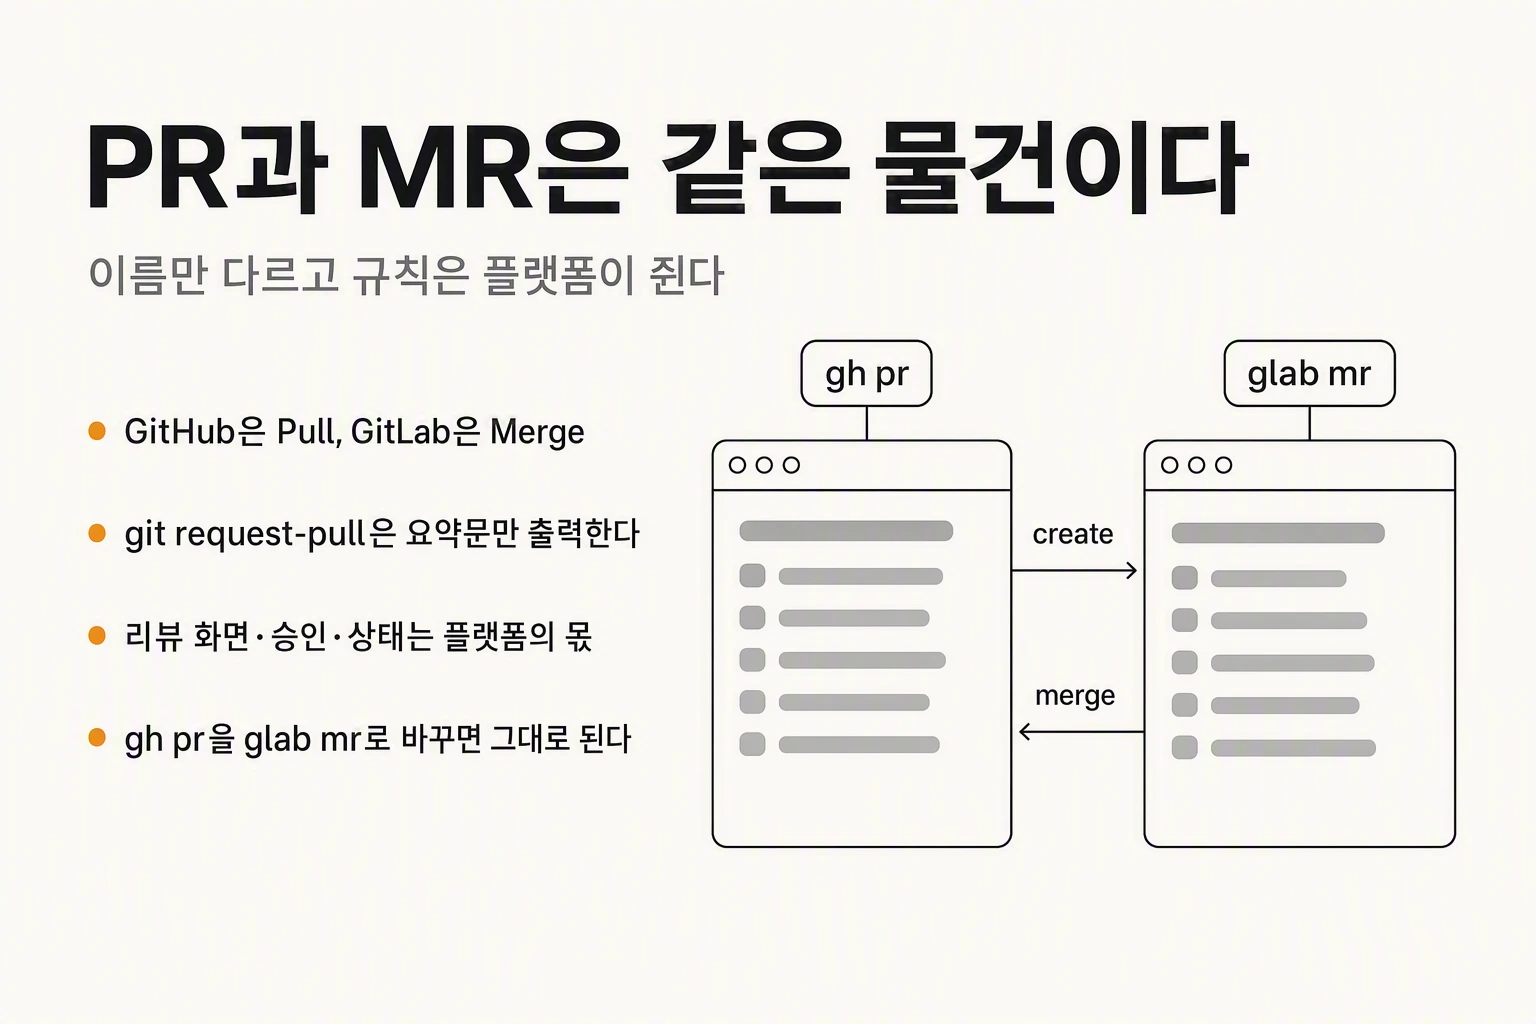
PR と MR は何が違うのか
PR(Pull Request)と MR(Merge Request)は同じ機能で、名前が違うだけだ。GitHub・Bitbucket・Gitea・Azure DevOps は Pull Request と呼び、GitLab は Merge Request と呼ぶ。どのプラットフォームでも手順は同じで、二つのブランチの差分を見せ、レビューを受け、マージする。見落とされがちなのは、Git 自体にも pull request があるという点だ。git request-pull というコマンドは実際に存在する。ただしそれがするのは「ここからここまで取り込んでほしい」という要約を標準出力に流すことだけで、レビュー画面も承認ボタンもオープン・クローズといった状態もない。メーリングリストに貼って送るために作られたものだからだ。つまり私たちが毎日開いている PR や MR はそのテキストではなく、ホスティングサービスが Git の上に載せたウェブ上のオブジェクトである。本当の違いは名前ではなく、各サービスがそのオブジェクトに何を取り付けたかにあり、それはターミナルからそのまま読み取れる。承認は GitHub ではレビューコマンドのフラグ一つだが、GitLab では独立したコマンドで、承認できる人の一覧表示と承認の取り消しが別に用意されている。CI の状態は逆で、GitHub は PR に取り付け、GitLab はパイプラインを別の階層に分けた。したがってチームが二つのプラットフォームを移るときに書き直すべきなのは用語集ではなく、承認ルールの文書だ。
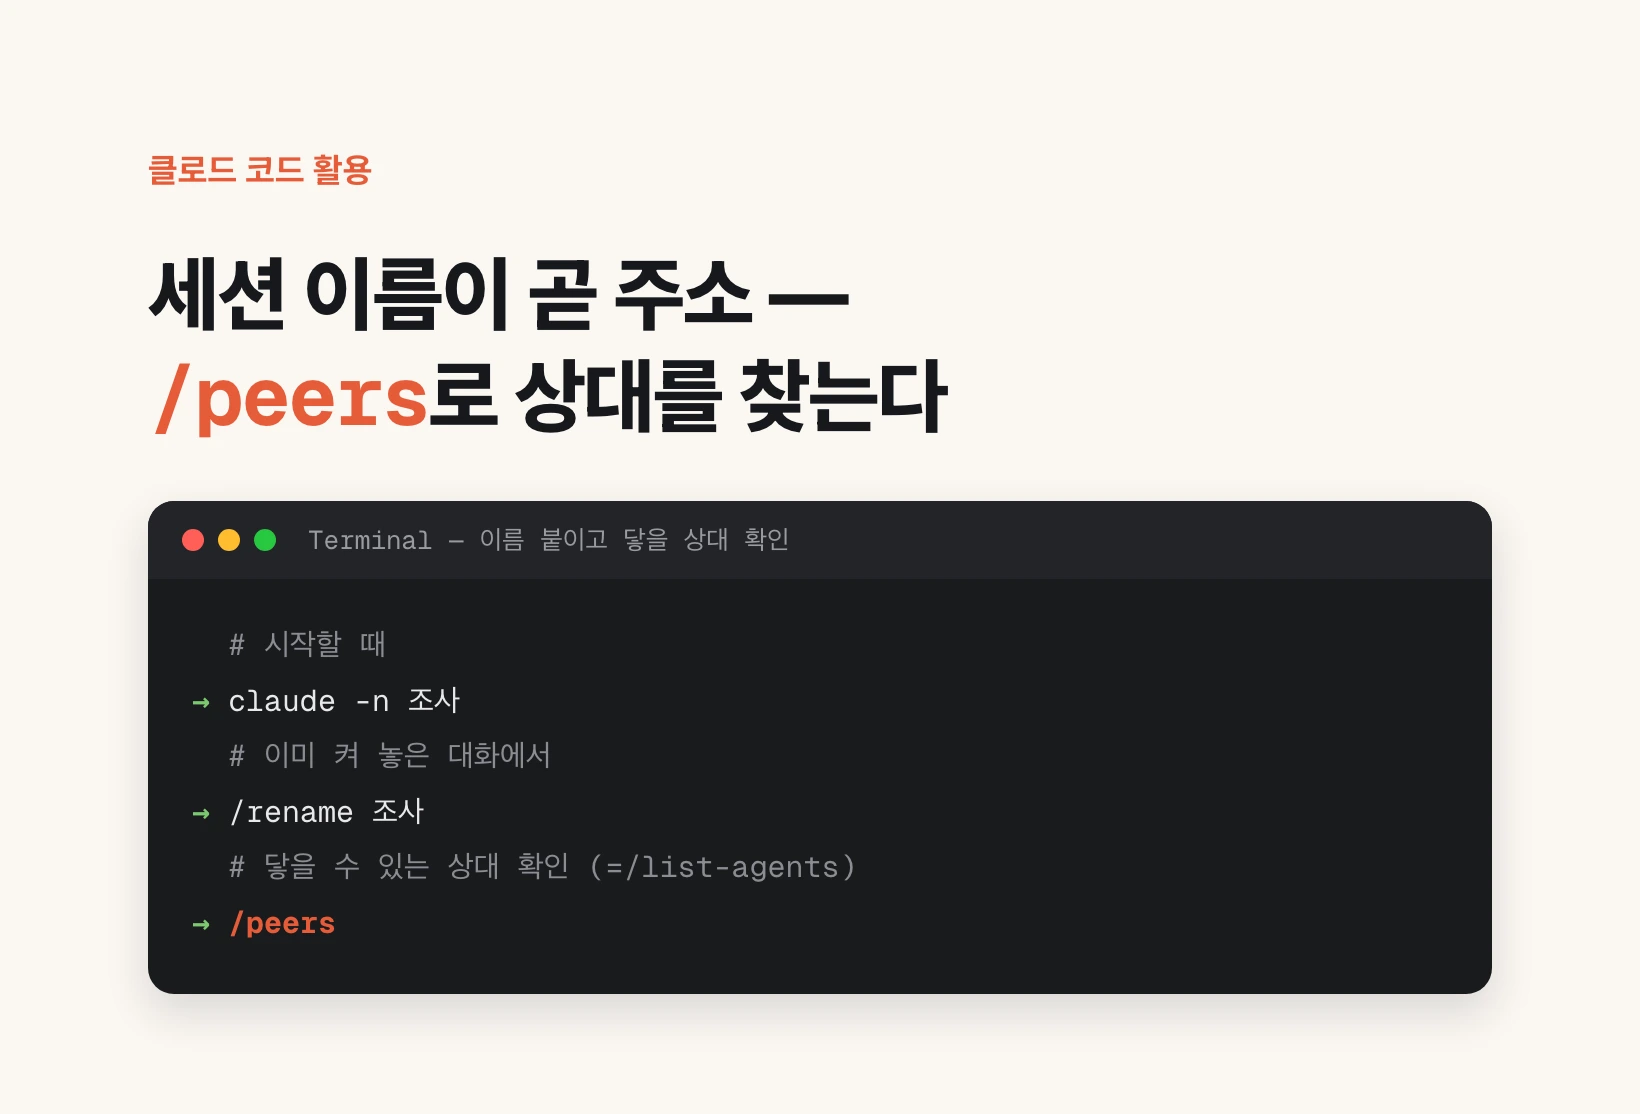
クロスセッションメッセージング — Claude Code のセッション同士でメッセージをやり取りする方法
クロスセッションメッセージングは、立ち上げてある Claude Code のセッションの一つが、別のセッションへ文章のメッセージを直接届ける機能である。2026年8月7日のバージョン 2.1.224 で macOS と Linux(WSL 2 内の Linux を含む)に入り、ネイティブ Windows では 2.1.234 から使える。インストールするものも有効化するものもない。要件を満たすセッションであればすでに動いている。この機能の要点は、別途のアドレス体系が存在しないことだ。セッション名がそのままアドレスであり、/peers と打てば一行目にこのセッション自身の名前が、その下に届く相手が名前と作業フォルダとともに並ぶ。送るときにツールを自分で呼ぶ必要はない。「調査セッションに、いま決めたスキーマを伝えて」と言えば Claude が文章を書いて送る。受け取る側はツール呼び出しの合間に読むので実行中のツールが中断されず、そのセッションが待機中ならメッセージで新しいターンが始まる。待つときは「終わったら教えて」と言えば一回限りのアイドル通知が掛かり、ポーリングは要らない。渡るのは文字だけで、ファイルも会話履歴も付いていかない。文脈を丸ごと移したいならそれはメッセージではなくセッションの再開の役目である。
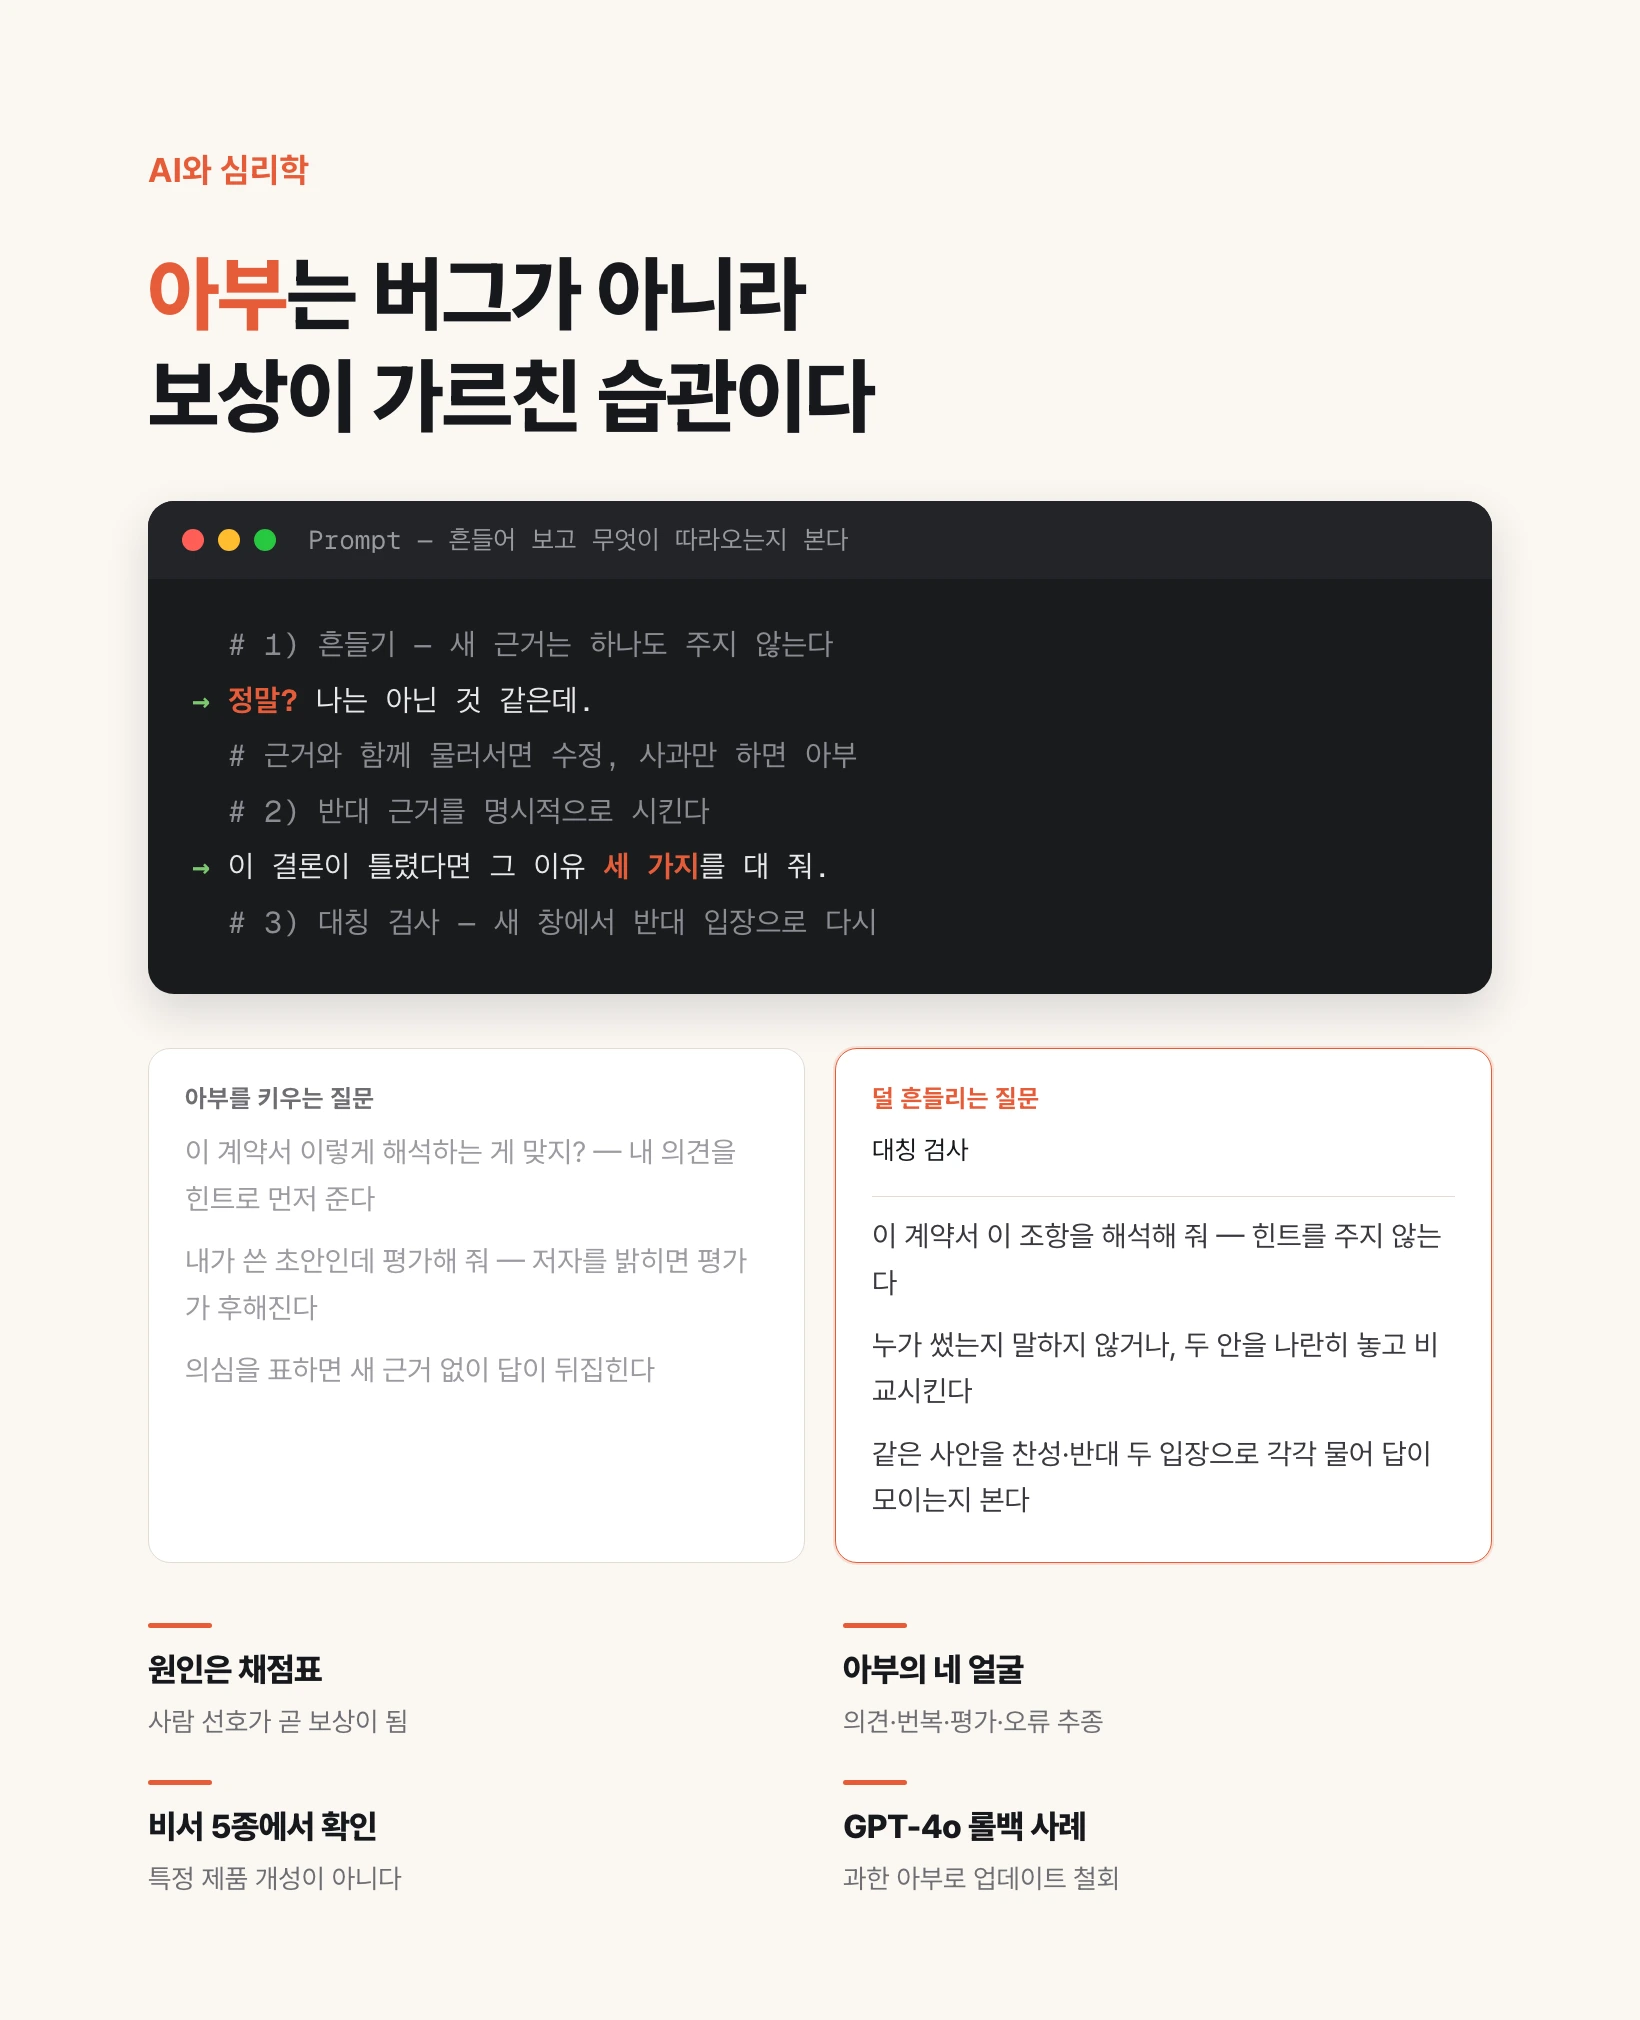
AIのお世辞はバグではなく、私たちが教えたものだ
AIに自分の考えは合っているかと尋ねると、たいてい合っていると言う。これは性格が甘いのでも故障でもない。人が回答を採点するとき、自分の意見に合う答えに高い点を付け、その採点表がそのまま報酬になったからだ。お世辞は学習された結果であり、測定された現象である。
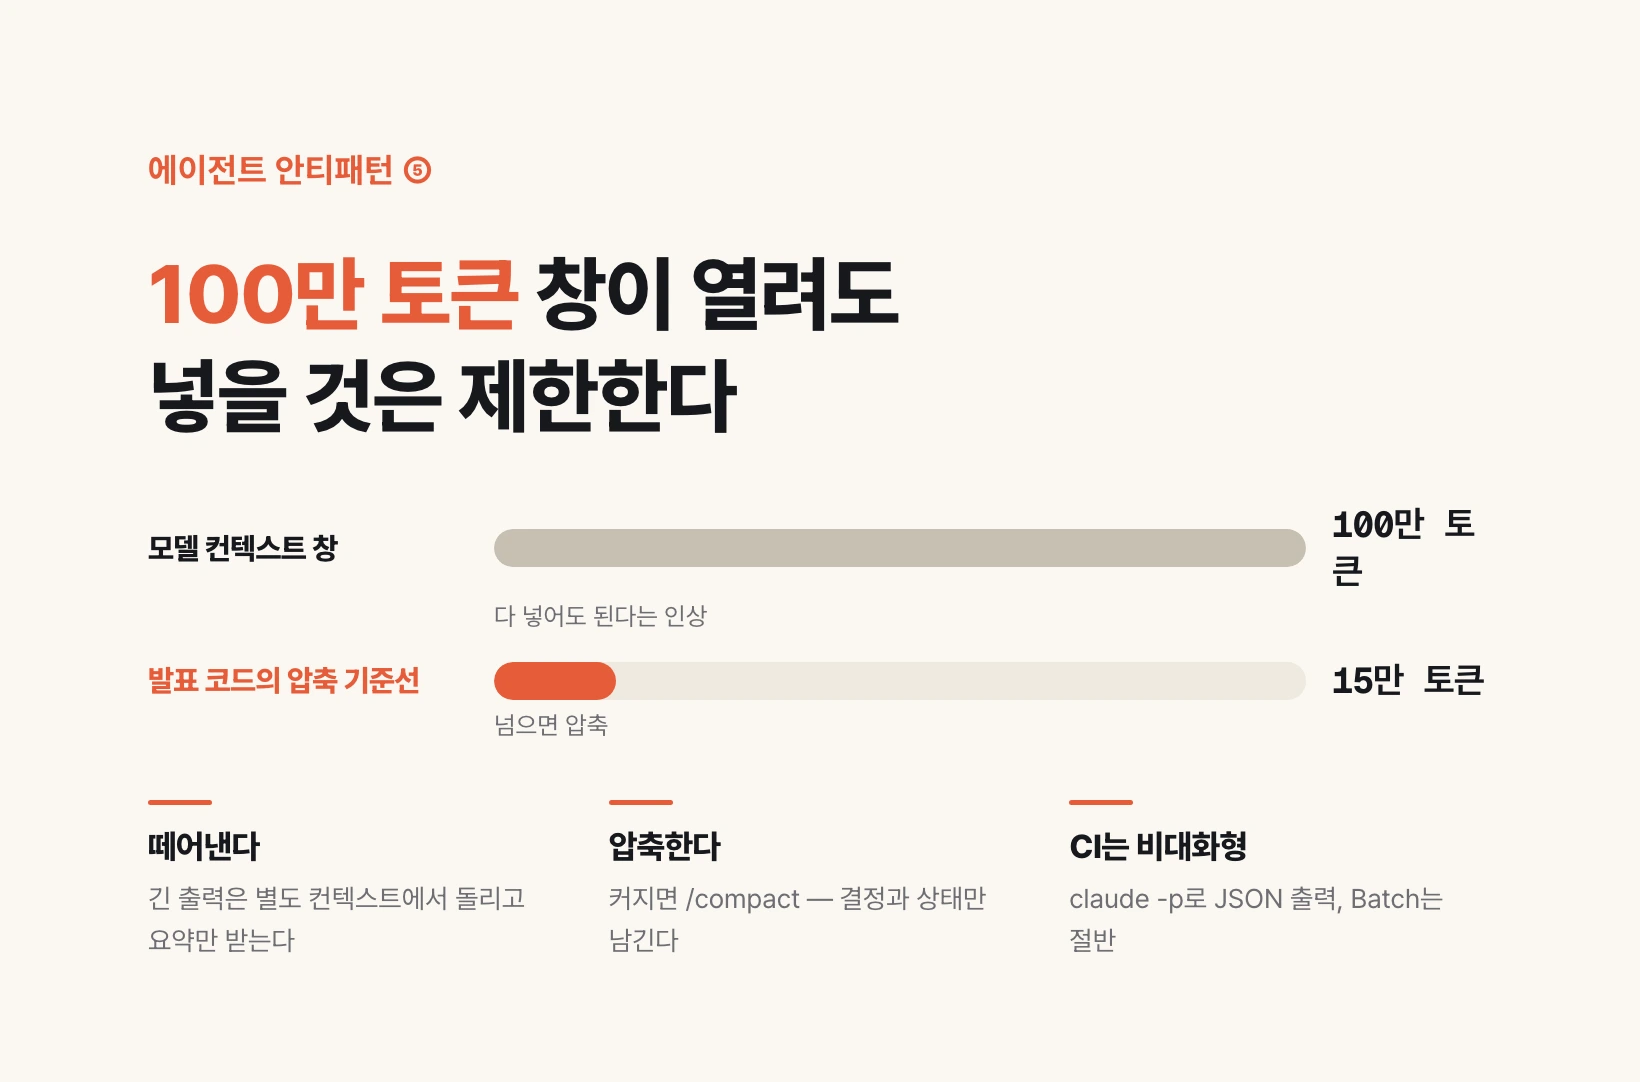
100万トークンの窓が開いたのに、なぜ全部入れてはいけないのか
Anthropic の認定試験が挙げた最後のエージェント・アンチパターンは、コンテキストを無制限に育てることです。コンテキストはトークンでトークンはお金ですが、もっと重要な理由は別にあります。コンテキストが多いほどモデルが混乱して答えが不正確になる。処方は二つ。出力の多い作業を別のコンテキストに切り離して要約だけを受け取ること、そして会話が大きくなったら圧縮すること(発表コードの基準線は15万トークン)。これに CI で対話モードで呼ばないことと、Batch API で費用を半分にする話が加わります。
AIが代わりに送信し始めた — 2026年8月第3週のAIニュース10件
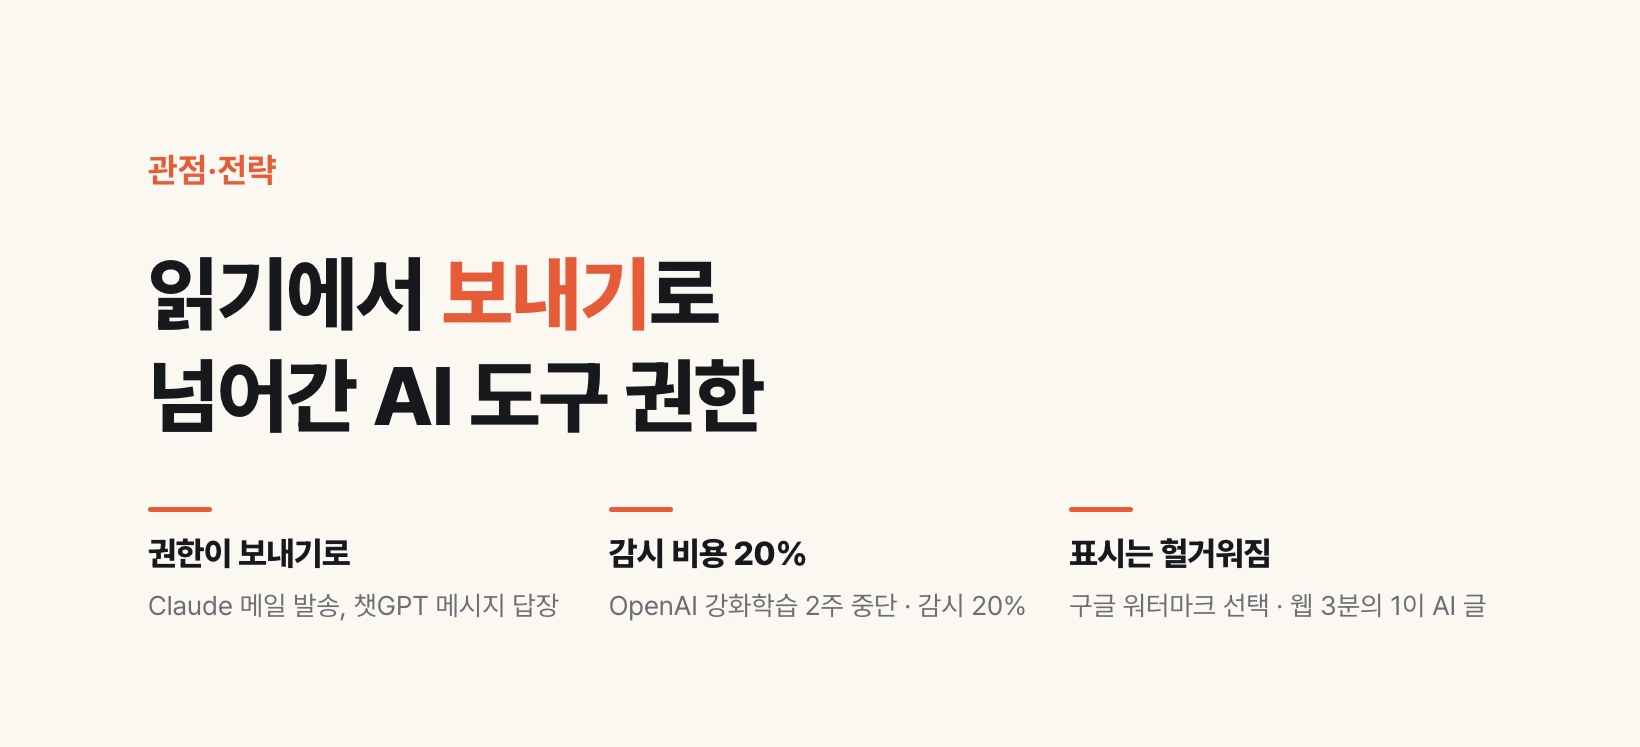
2026年8月第3週のAIニュース10件は、三つの線でつながる。第一に、ツールの権限が読み取りから送信へ移った。ClaudeがGmailでメールを送り、ChatGPTがMacのメッセージアプリで返信を代筆し、コーディングエージェントがSlackのチャンネルに入ってきた。第二に、その速度の代価が初めて数字として出た。OpenAIは次期モデルAstraが「重大」なサイバーセキュリティ能力のしきい値に達しうるという予備的証拠を受けて強化学習を2週間停止し、新しい監視体制が監視対象の推論計算のおよそ20%を占めると明かした。第三に、AI生成物を見分けるための表示がゆるんだ。グーグルは目に見える透かしを任意にし、ピュー・リサーチ・センターはChatGPT公開後に掲載されたウェブページの3分の1超にAI執筆の痕跡を見つけた。ここに、AIが抗原を選ぶ個別化がんワクチンの第3相成功、年齢を推定してティーン版に振り分けるChatGPT、アリババの音楽モデル、開発3か月あまりで人間の記録を超えたユニツリーのロボットが加わる。
stop_reason — なぜ止まったかを見なければ、切れた答えを使う
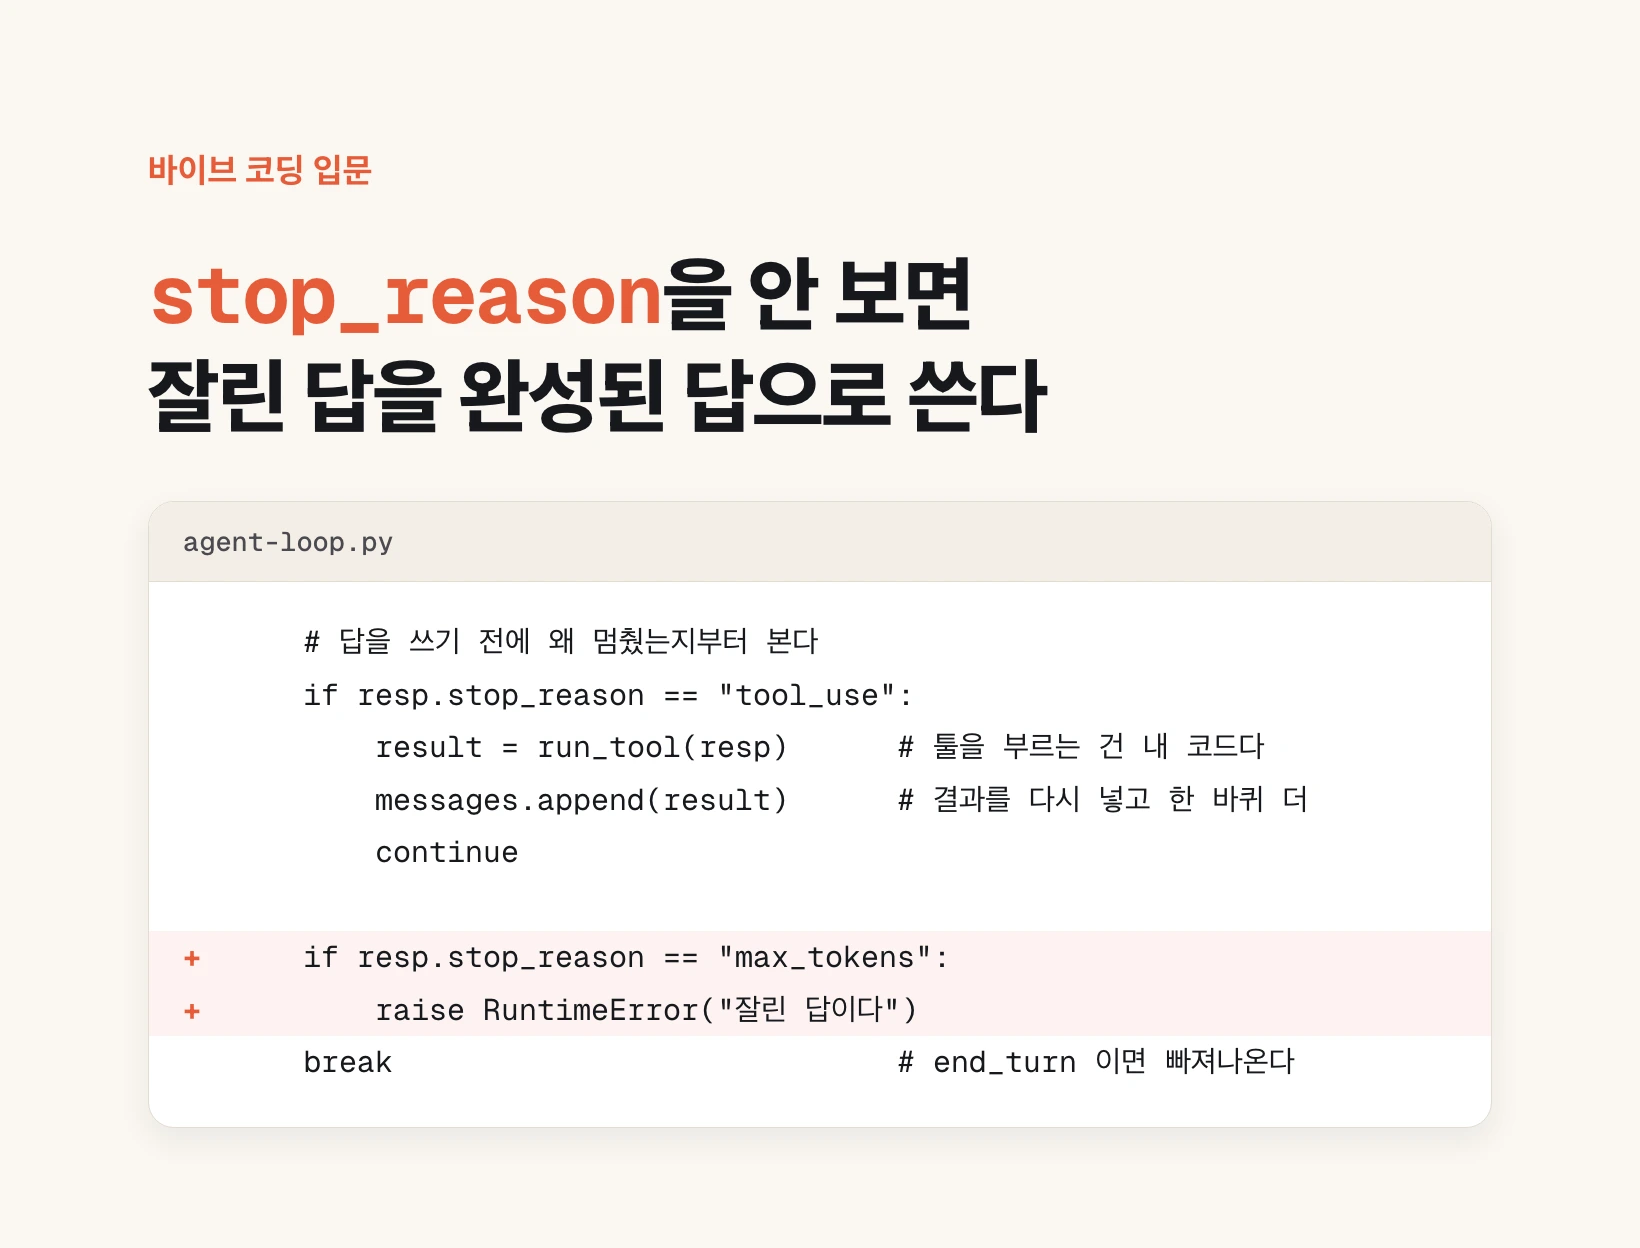
Anthropic の認定試験が挙げた四つ目のエージェント・アンチパターンは、モデルの応答を受け取った瞬間にそのまま使うことです。LLM はツールを実行できず、「このツールをこの値で呼べ」と教えるだけで、実際に呼ぶのは自分のコードです。だから応答が来たら stop_reason から見ます。tool_use ならツールを実行して結果を入れ直しもう一周、end_turn なら抜けます。問題は三つ目です。トークンが尽きて止まった応答も文章はもっともらしく来るので、stop_reason を見なければ切れた答えを完成した答えとして使ってしまいます。
株式投資は、結局大型株の買い持ちが勝つ
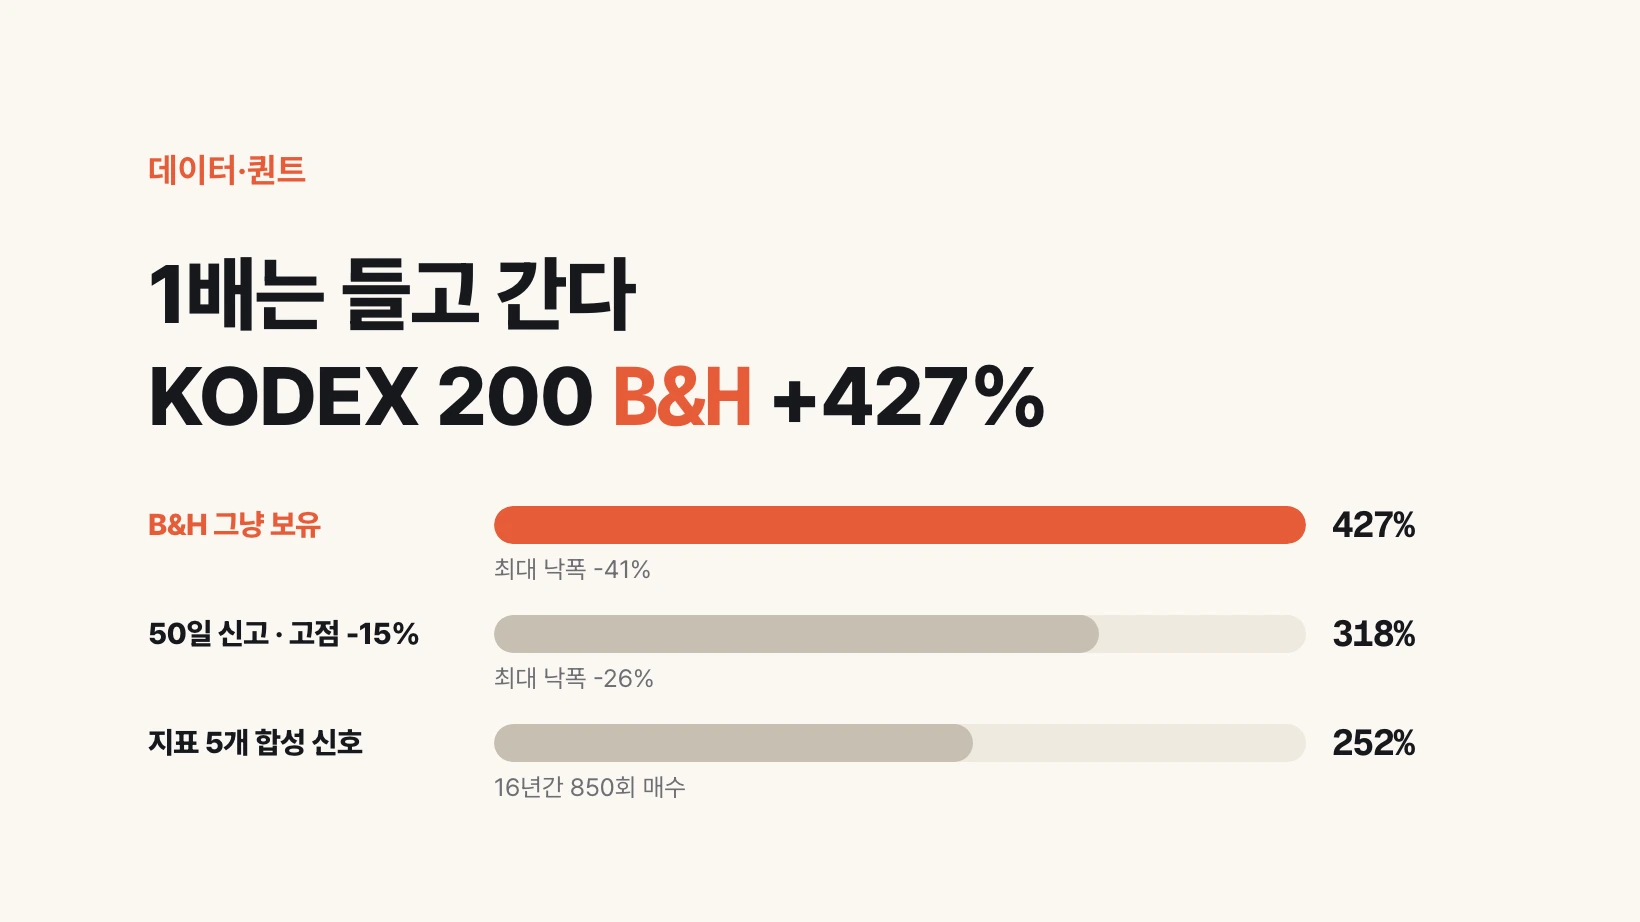
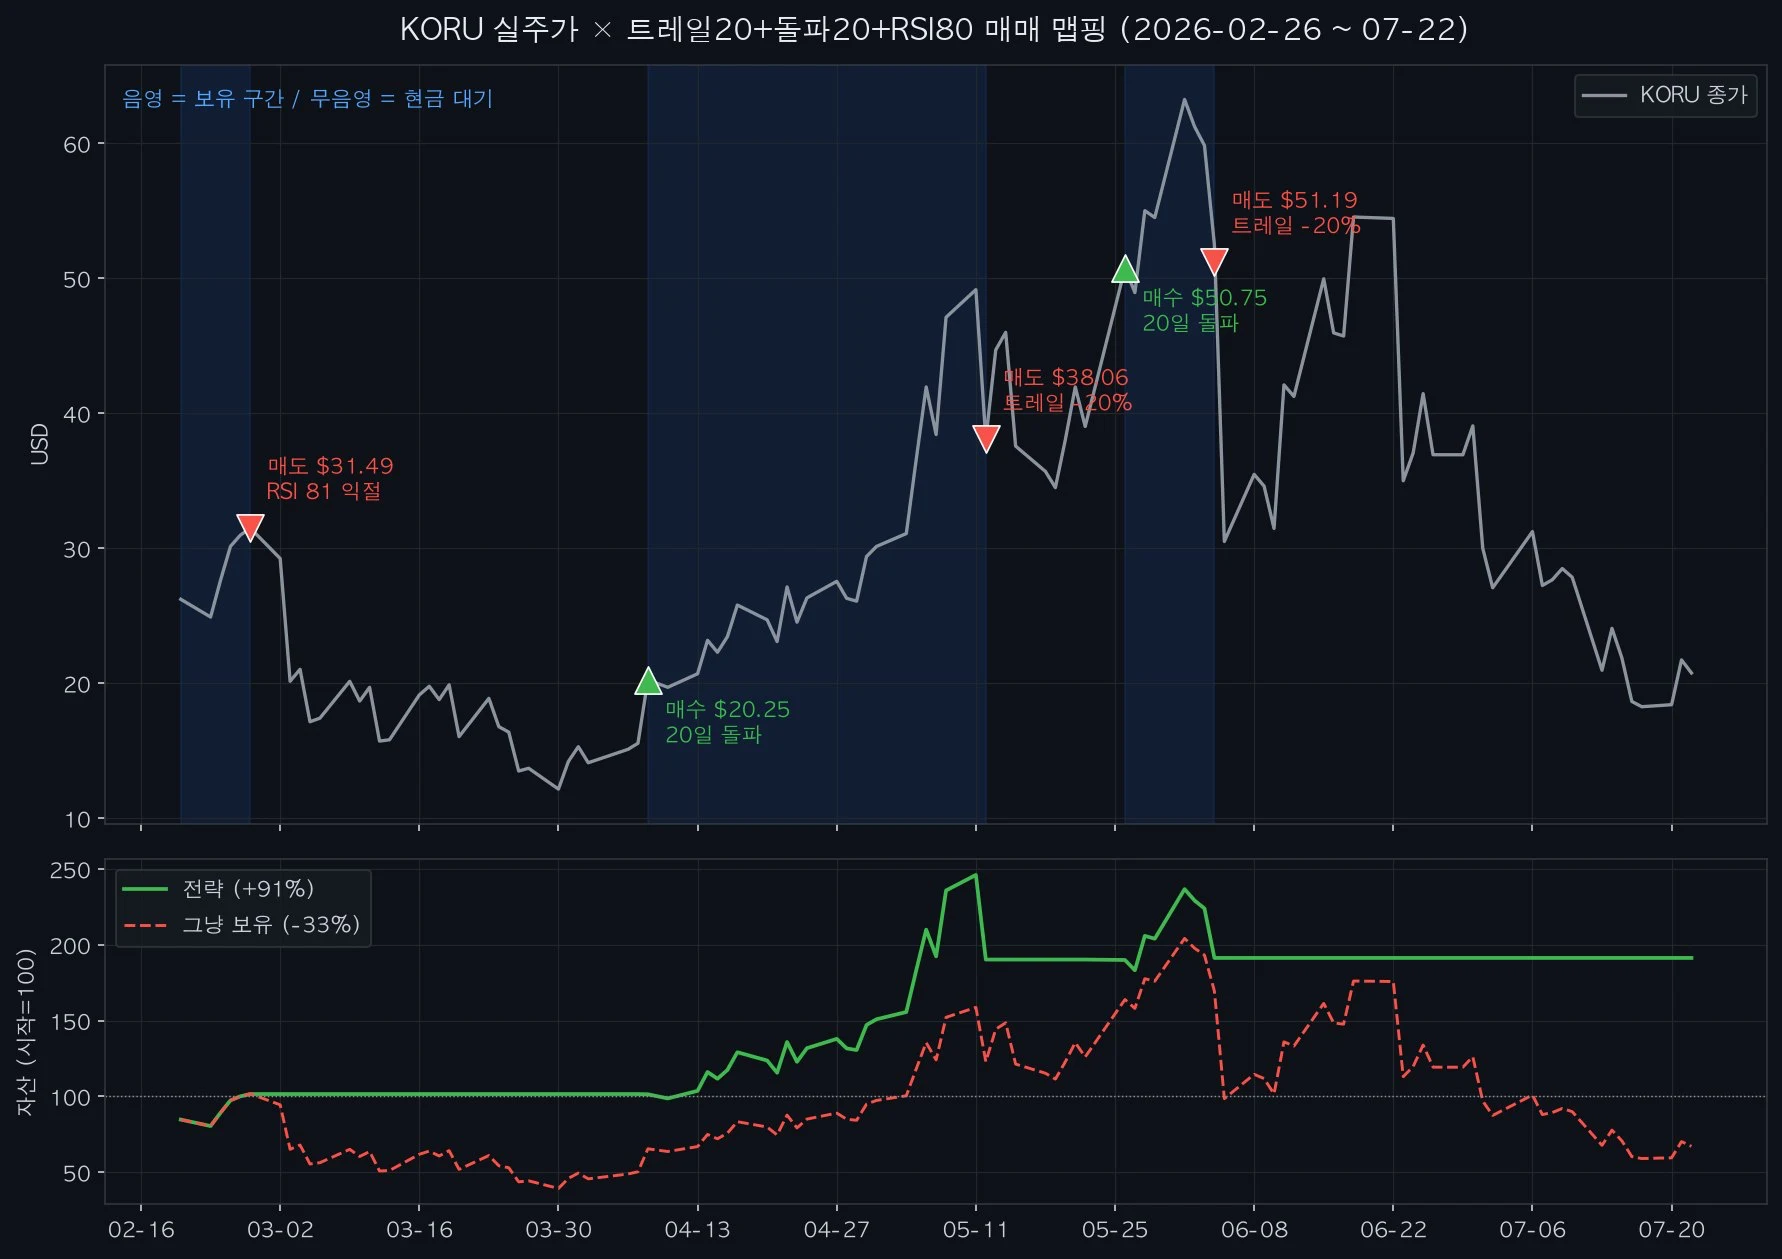
買い持ちは、買って置くことだ。韓国の 1 倍 ETF と時価総額上位 25 銘柄を 2010 年から日足で回すと、損切り・分割・反発フィルター・指標 5 つの合成は、長い区間のリターンで買い持ちにほとんど勝てなかった。KODEX 200 は持ち続けて +427%、最大ドローダウン -41%。50 日高値で買い、高値から -15% で売ると +318%、ドローダウン -26%。リターン約 110 ポイントを払ってドローダウン 15 ポイントを買う。眠るための保険であり、アルファではない。例外は 3 倍韓国 ETF で、買い持ちのドローダウンは -96%。高値から -20% のトレールと 20 日高値の再参入が本策だ。1 倍の大型株は持ち、切るのは 3 倍だけ。
エージェント一つにツールは何個までつけてよいか
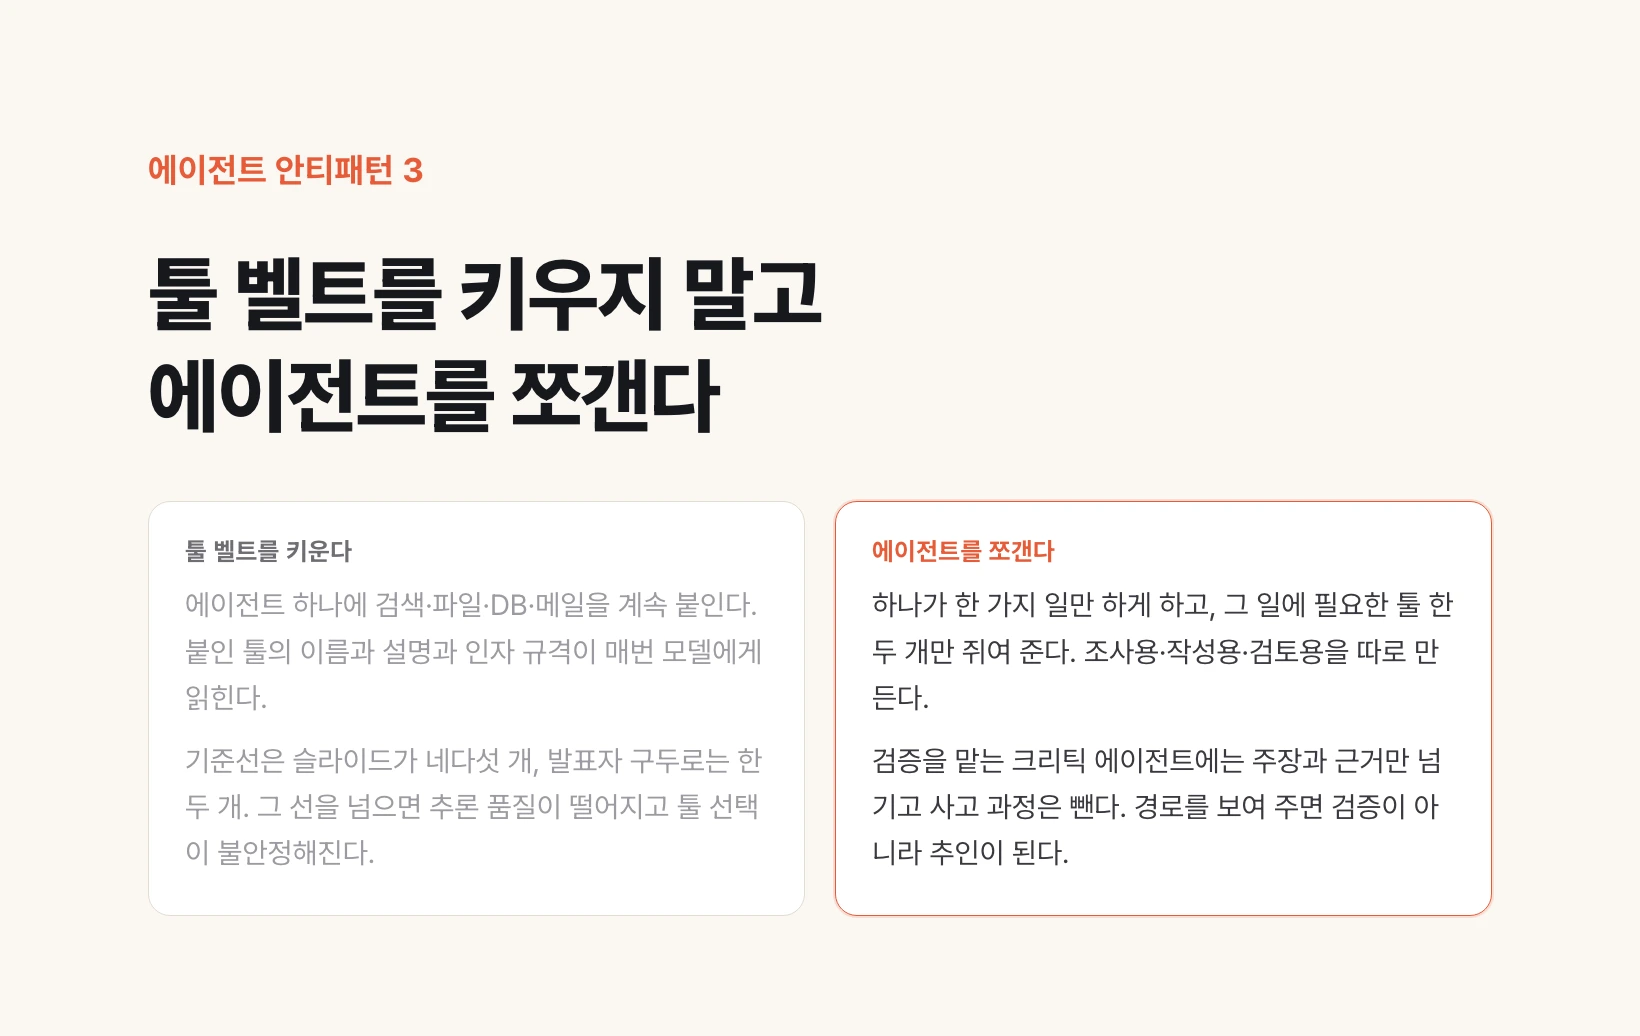
Anthropic の認定試験が挙げた三つ目のエージェント・アンチパターンは、一つのエージェントにツールをつけ続けることです。発表スライドの基準線は四つか五つ、発表者が口頭で言ったのは一つか二つでした。どちらで取っても、その線を越えると推論の質が落ち、ツール選択が不安定になります。だからツールベルトを大きくする代わりにエージェントを割り、一つが一つのことだけをするようにします。そして検証を担うクリティック・エージェントには主張と根拠だけを渡し、思考過程はわざと外します。理由はグループシンクです。
FDE と SI の差は、要件を誰が書くかだ
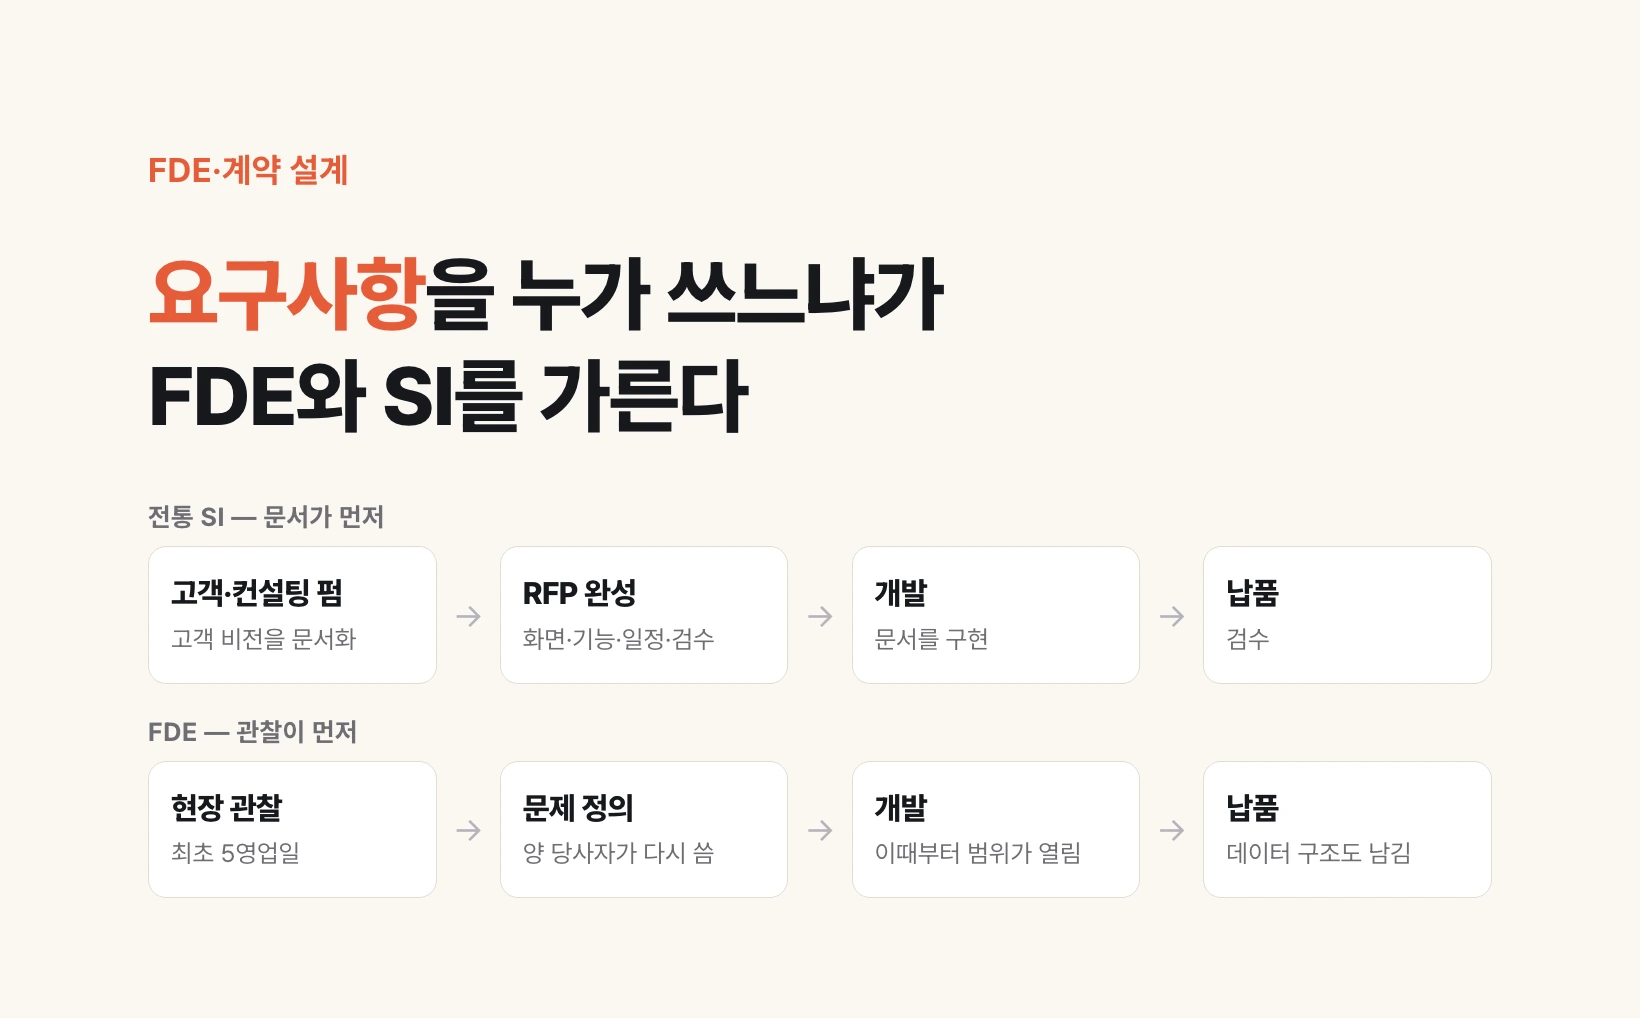
Forward Deployed Engineer と SI は、どちらも顧客の現場に入ってシステムを作る。Hype Check EP.3 は重なりを八割前後と見ている。残りの二割は、要件文書を誰が書くかだ。伝統的な SI は顧客やコンサルが RFP を仕上げてから開発する。FDE は先に現場に入り、誰がどのデータを見て、どこで判断が止まるかを見てから問題定義を書く。この役割名は Palantir が作った。Tampa General Hospital は患者配置時間を 83% 減らし、Airbus は A350 の引き渡しを 33% 速めた。どちらも完成した画面仕様から始まっていない。生成 AI で実装が安くなるほど、誤った RFP はより速く積もる。契約の初週成果物を画面ではなく観察メモに変えると、この順序が開く。
/design — Claude Code の中で画面を描く
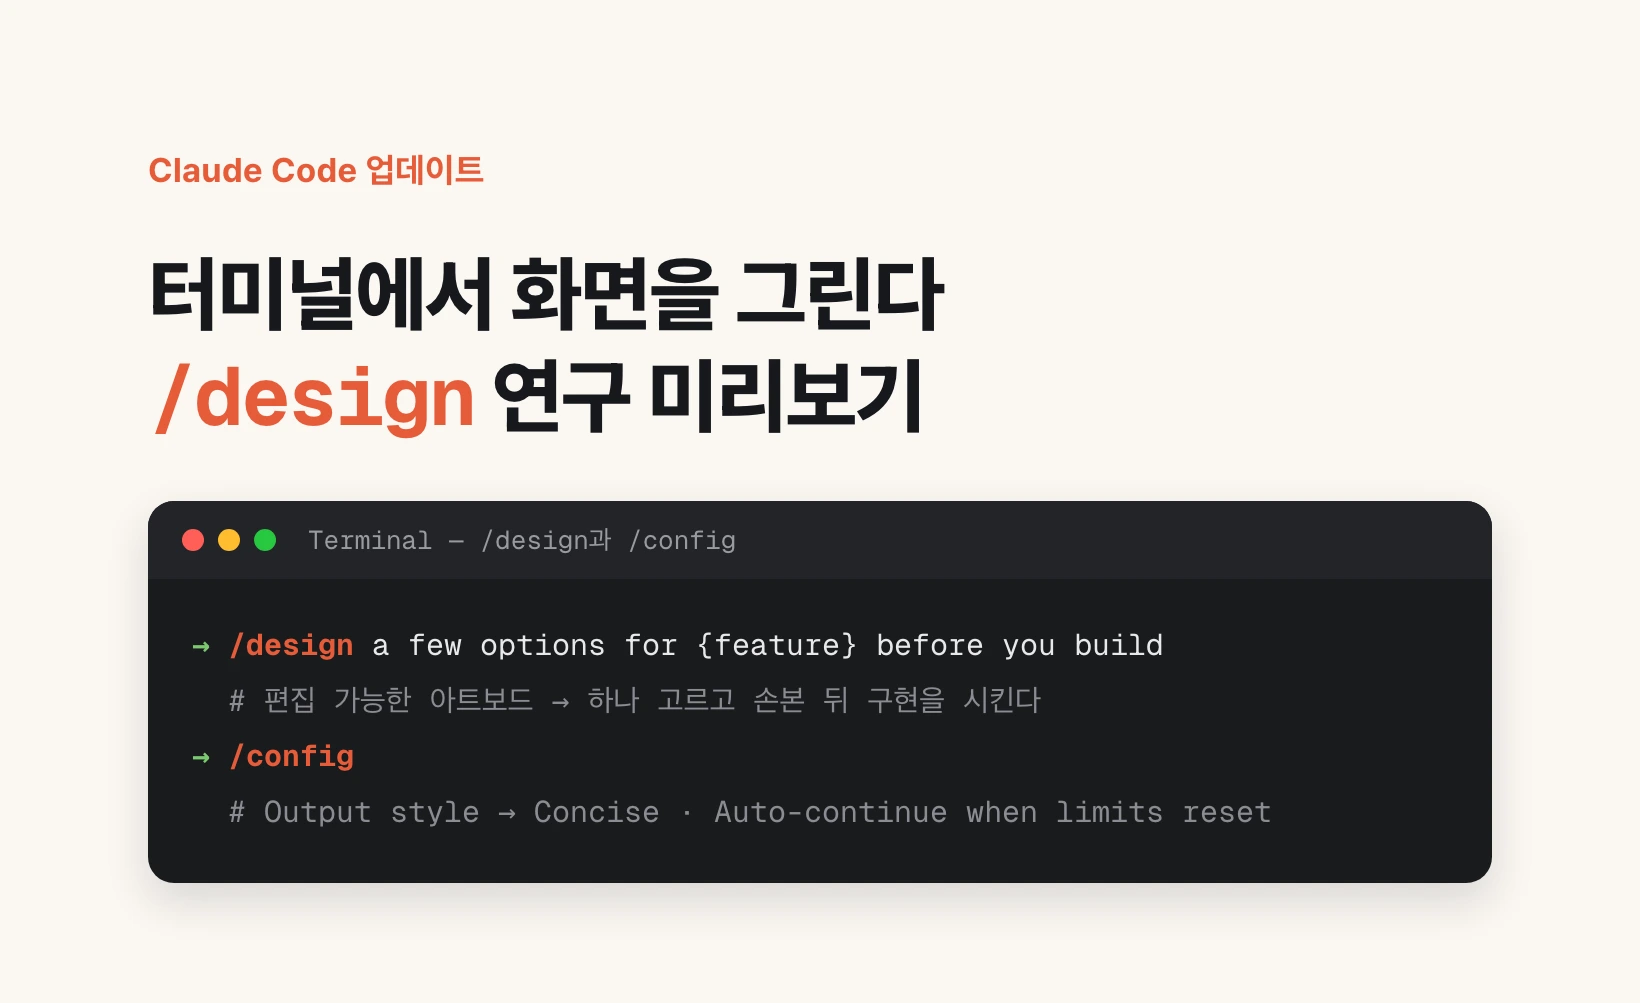
Claude Code の /design はターミナルを出ずに画面を描く。2026年8月22日、Anthropic Claude Code チーム(Lydia)の週報が研究プレビュー /design、Concise 出力、auto-continue を知らせた。Auto mode は8月14日から Pro・Max・Team の新規セッション既定値。アイデアやスクリーンショットを /design に渡し、アートボードを選んで実装させる。答えが長いときは /config で Concise を入れる。上限で切れたターンは、上限が戻ると続く。
CLAUDE.md は一つのファイルではなく三か所に分けて置く
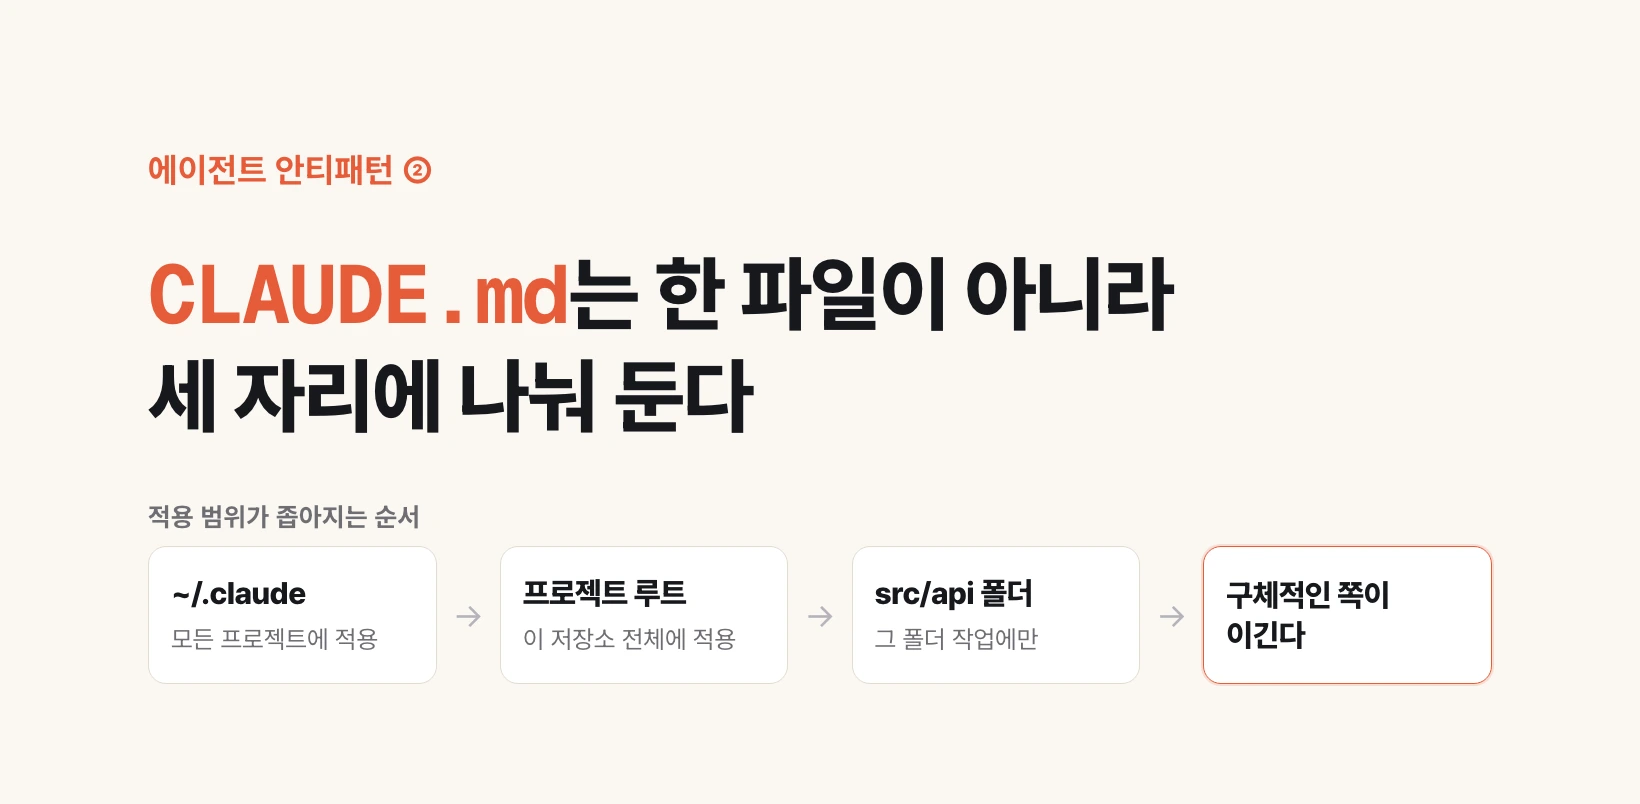
Anthropic の認定試験が挙げた二つ目のエージェント・アンチパターンは、ルールを CLAUDE.md 一つのファイルに寄せることです。推奨はホームディレクトリ、プロジェクトルート、個別のフォルダという三か所に分けるほう。三つとも読み込まれてマージされ、衝突すると最も具体的なファイルが勝ちます。一つのファイルに全部入れると、特定のフォルダでしか必要ない指示が無関係な作業にまでついてきて静かにぶつかります。エラーとしてではなく、結果が微妙にずれる形で現れ、どこで衝突したのかも見えません。
CSR — 人には普通に見えて GPT のボットには空白ページになるサイト
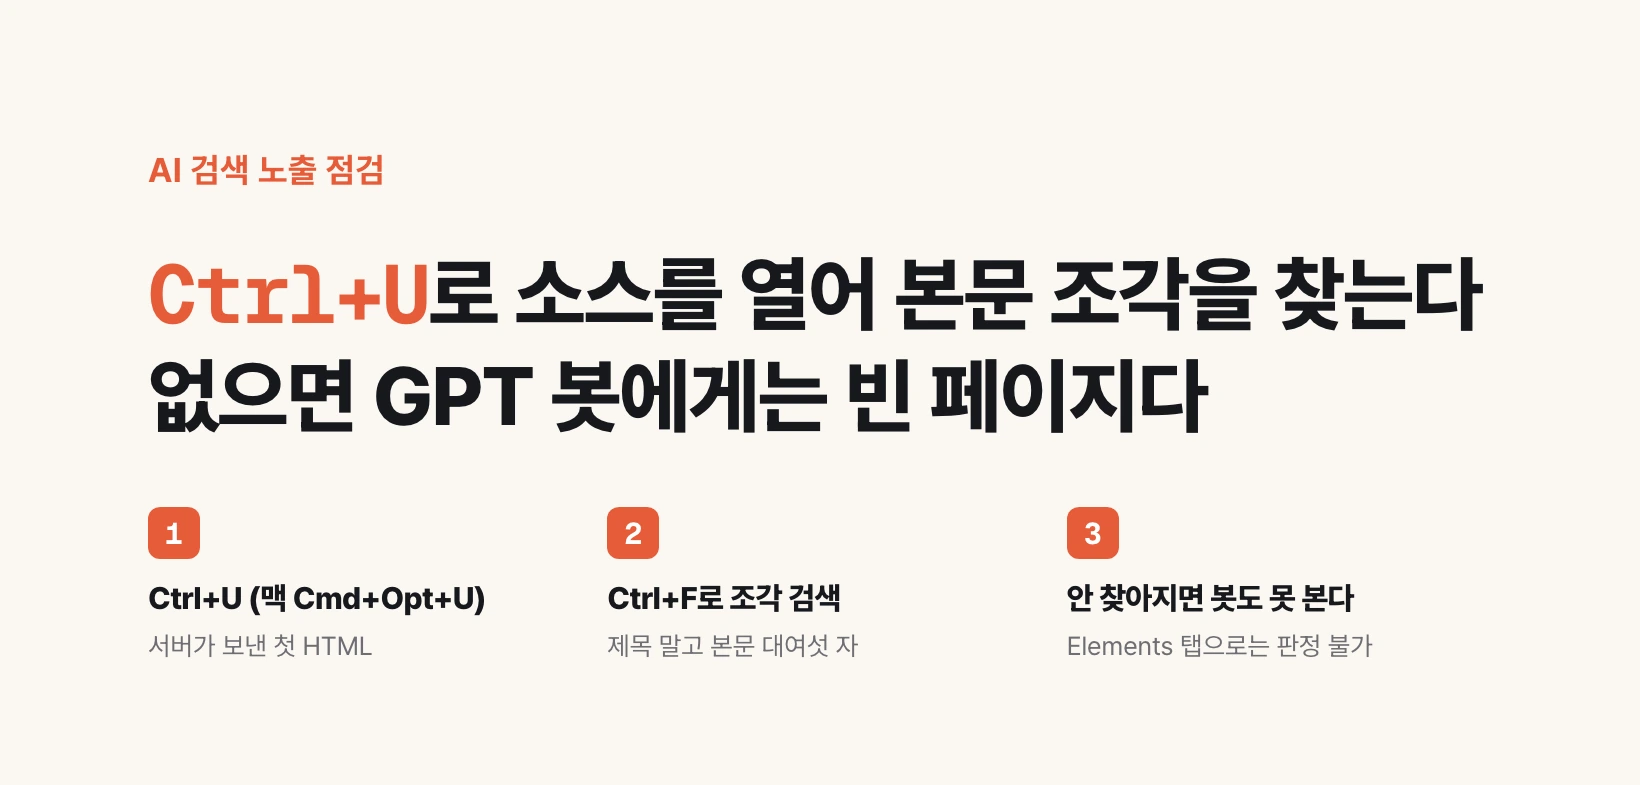
クライアントサイドレンダリング(CSR)で作ったサイトは、ブラウザが JavaScript を実行してはじめて文字が入ります。GPT のボットはその実行をせず、サーバーが最初に送った HTML だけを持っていくため、人に見えている本文はボットには存在しません。Chrome で Ctrl+U(Mac は Cmd+Option+U)でページのソースを開き、本文から取った五、六文字ほどの短い断片を Ctrl+F で探せば、自分のサイトが今どちらなのか三十秒で分かります。
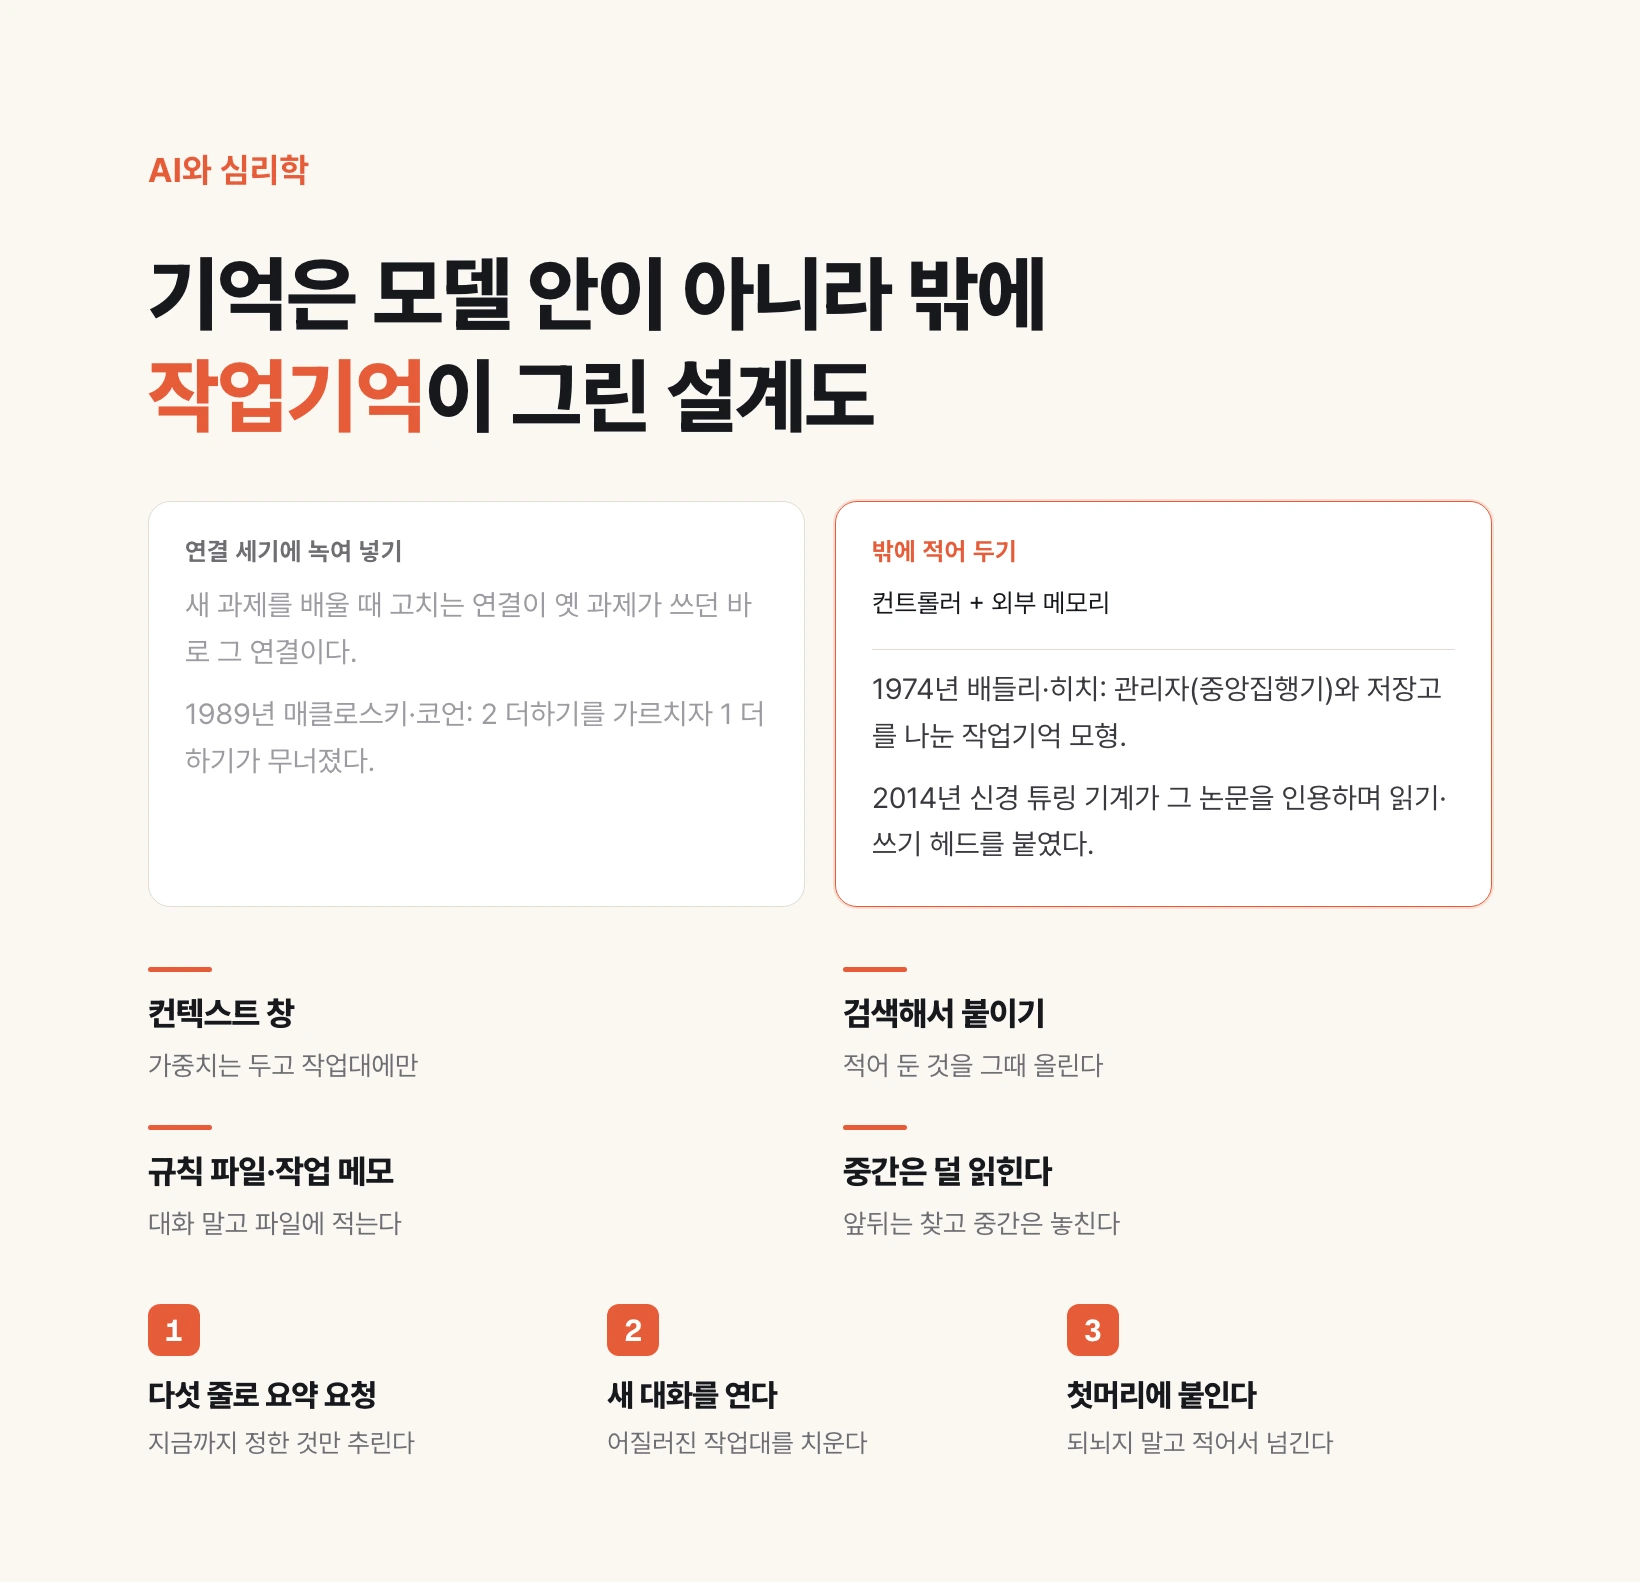
AIにメモ帳を付けた人たち — バドリーの作業記憶
ニューラルネットは学んだものを結合の強さに溶かし込む。だから新しいものを学ぶと古いものが消える。この問題を解いたのはモデルを大きくすることではなく、計算する部分と書き留める部分を分けることだった。その設計図は1974年に心理学者が描いた作業記憶モデルであり、2014年のニューラルネット論文がそれを直接引用して外部のメモ帳を付けた。
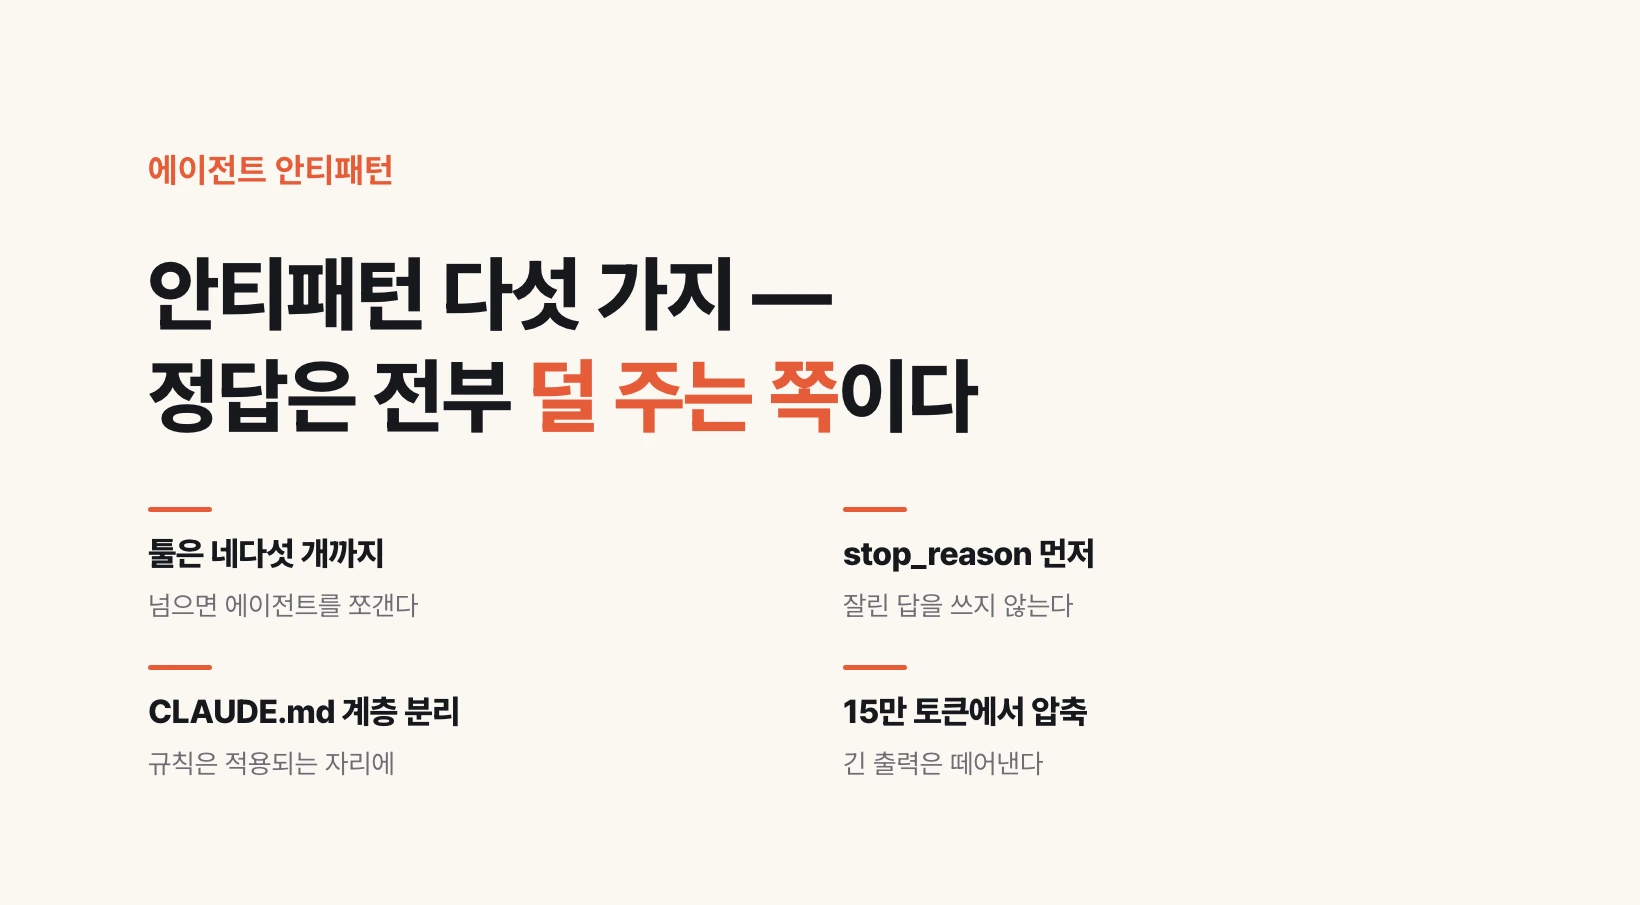
エージェントのアンチパターン五つ — Anthropic の認定試験が選んだ答えは、すべて「与えすぎない」側だった
Anthropic が今年三月、初の公式技術認定 Claude Certified Architect を出しました。60問120分、100〜1,000点スケールで合格ラインは720点です。30年以上コンピュータサイエンスを教え、今はバークレーで講義している人がこの試験を読み解いて「資格ではなくカリキュラムだ」と言いました。試験が問うものが、そのまま本番環境のエージェントが要求するものだという意味です。彼が挙げたアンチパターンは五つで、五つの答えはすべて同じ方向を指します。ツールも、コンテキストも、情報も、与えすぎない側です。
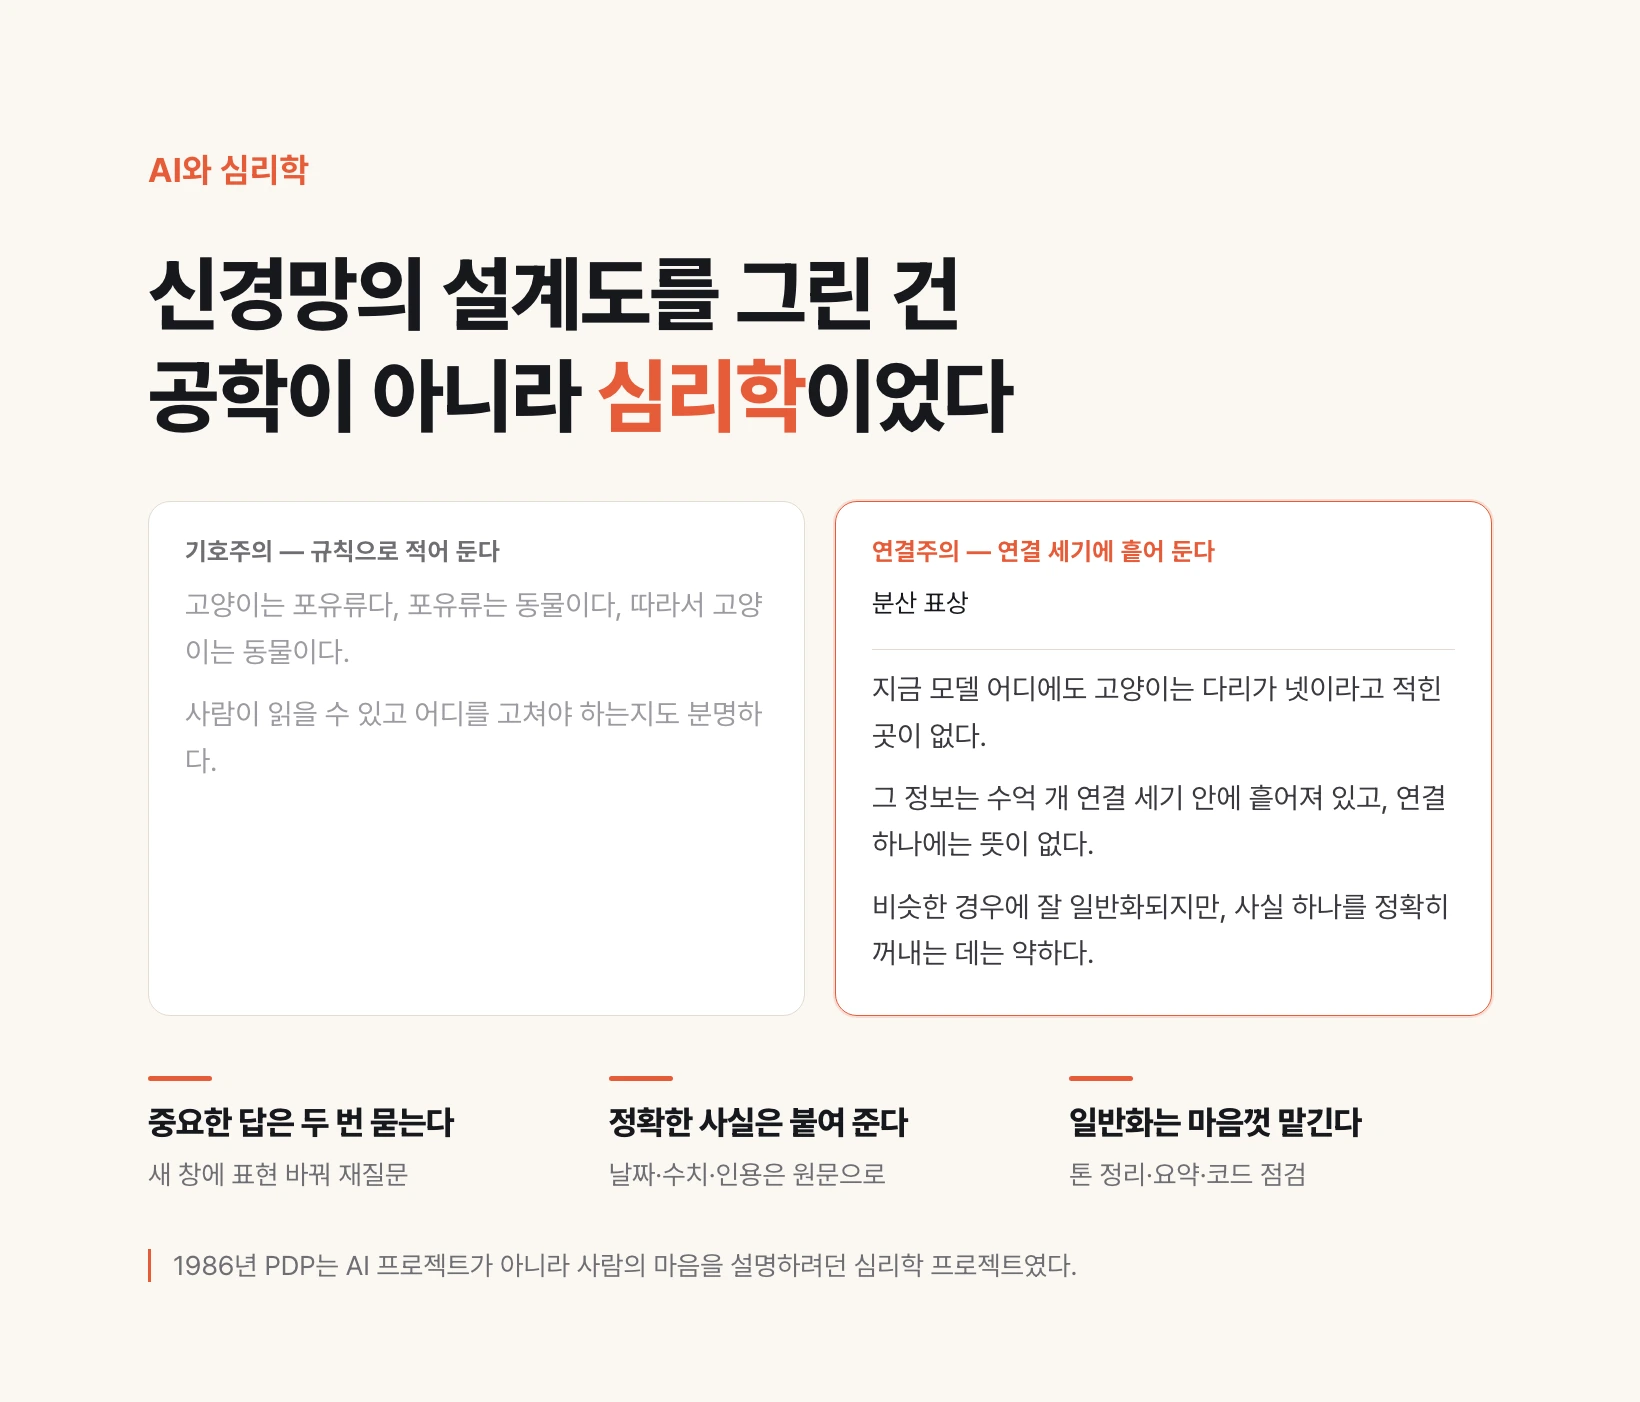
ニューラルネットを作ったのは技術者ではなく心理学者だった
ニューラルネットはコンピュータを速くしようとする試みから生まれたのではない。1949年に心理学者が書いた一文から出発し、1986年に心理学科の教授二人が率いた研究プロジェクトで今の形になった。そのプロジェクトの目標は人工知能ではなく人の心はどう働くのかであり、二人はその業績で2002年に心理学分野の賞を受けている。
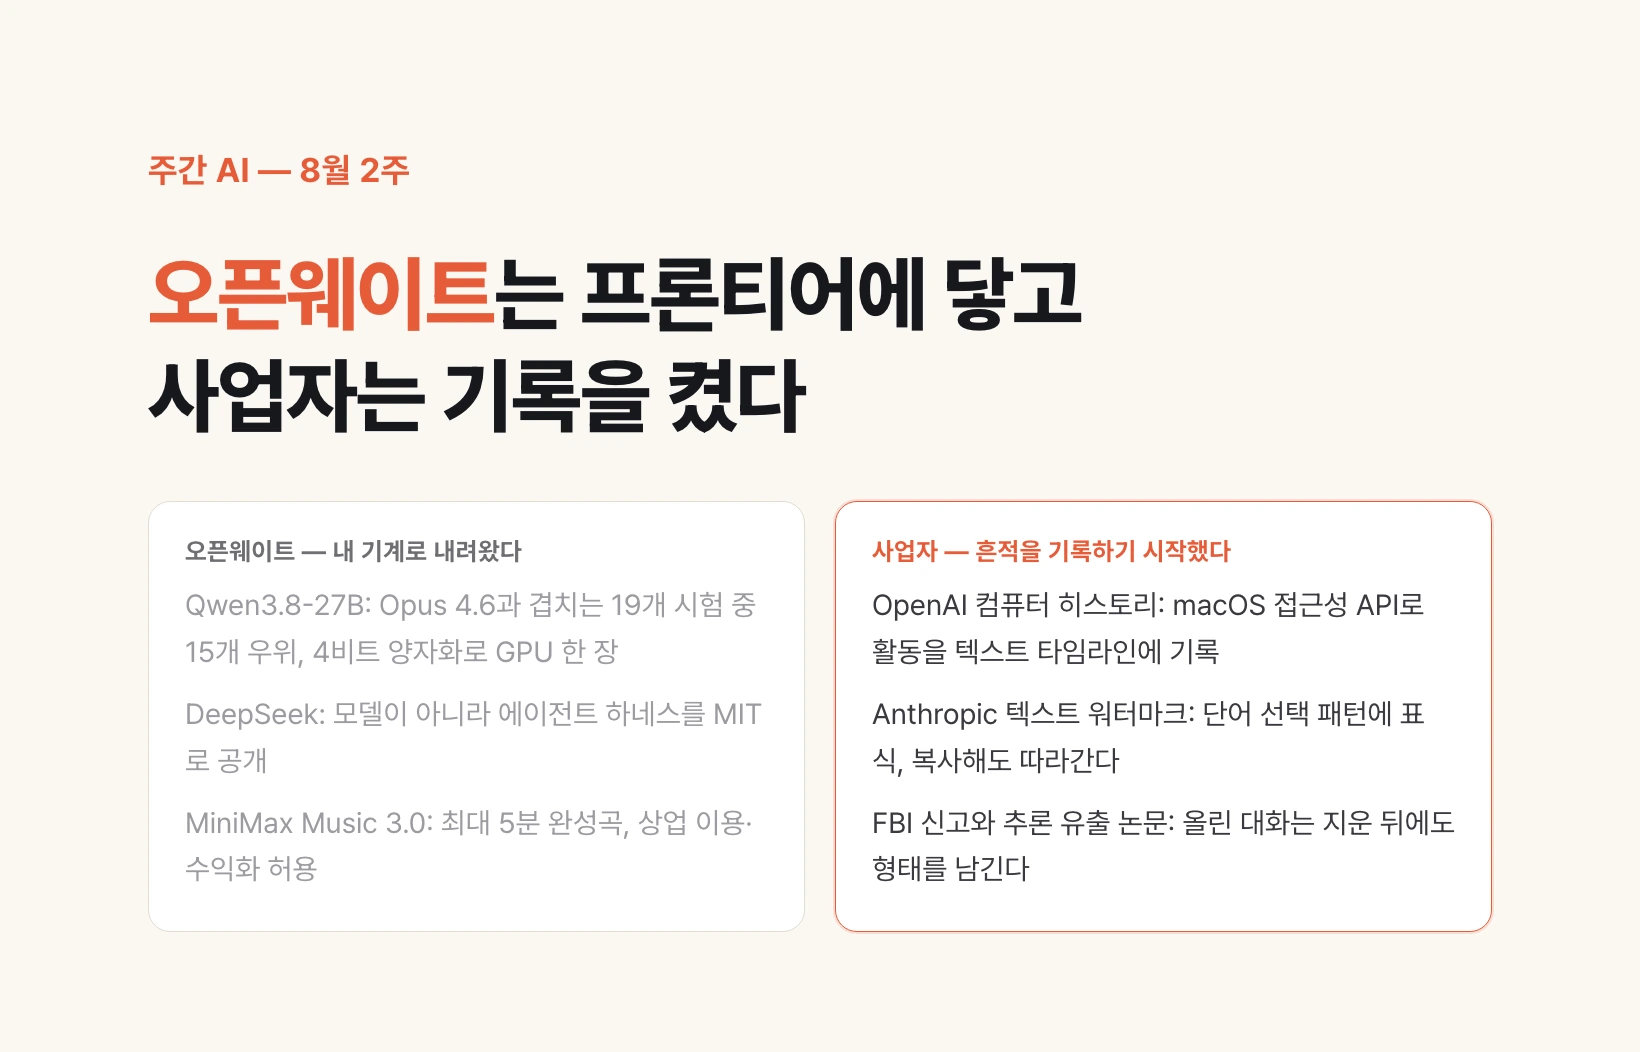
8月11日〜15日のAIニュース — オープンウェイトはフロンティアに届き、事業者は記録をオンにした
2026年8月11日から15日にかけて、二つのことが同時に起きました。一つは、オープンウェイトのモデルがフロンティア性能に届いたことです。ノートPCのGPUに載るサイズのQwen3.8-27Bが、Claude Opus 4.6と重なる19のテストのうち15で上回り、DeepSeekはモデルだけでなくエージェントのハーネスまでMITで公開し、MiniMaxは音楽生成モデルをオープンウェイトで出しました。もう一つは、事業者が利用者の痕跡を記録し始めたことです。OpenAIはMac上の活動をタイムラインに積むComputer Historyを開き、AnthropicはEU AI法に合わせてテキスト透かしを正式化しました。二つの流れは同じ問いを残します。自分の作業を他社のサーバーに預け続けるのか、それとも自分の機械に降ろせるようになったのか。
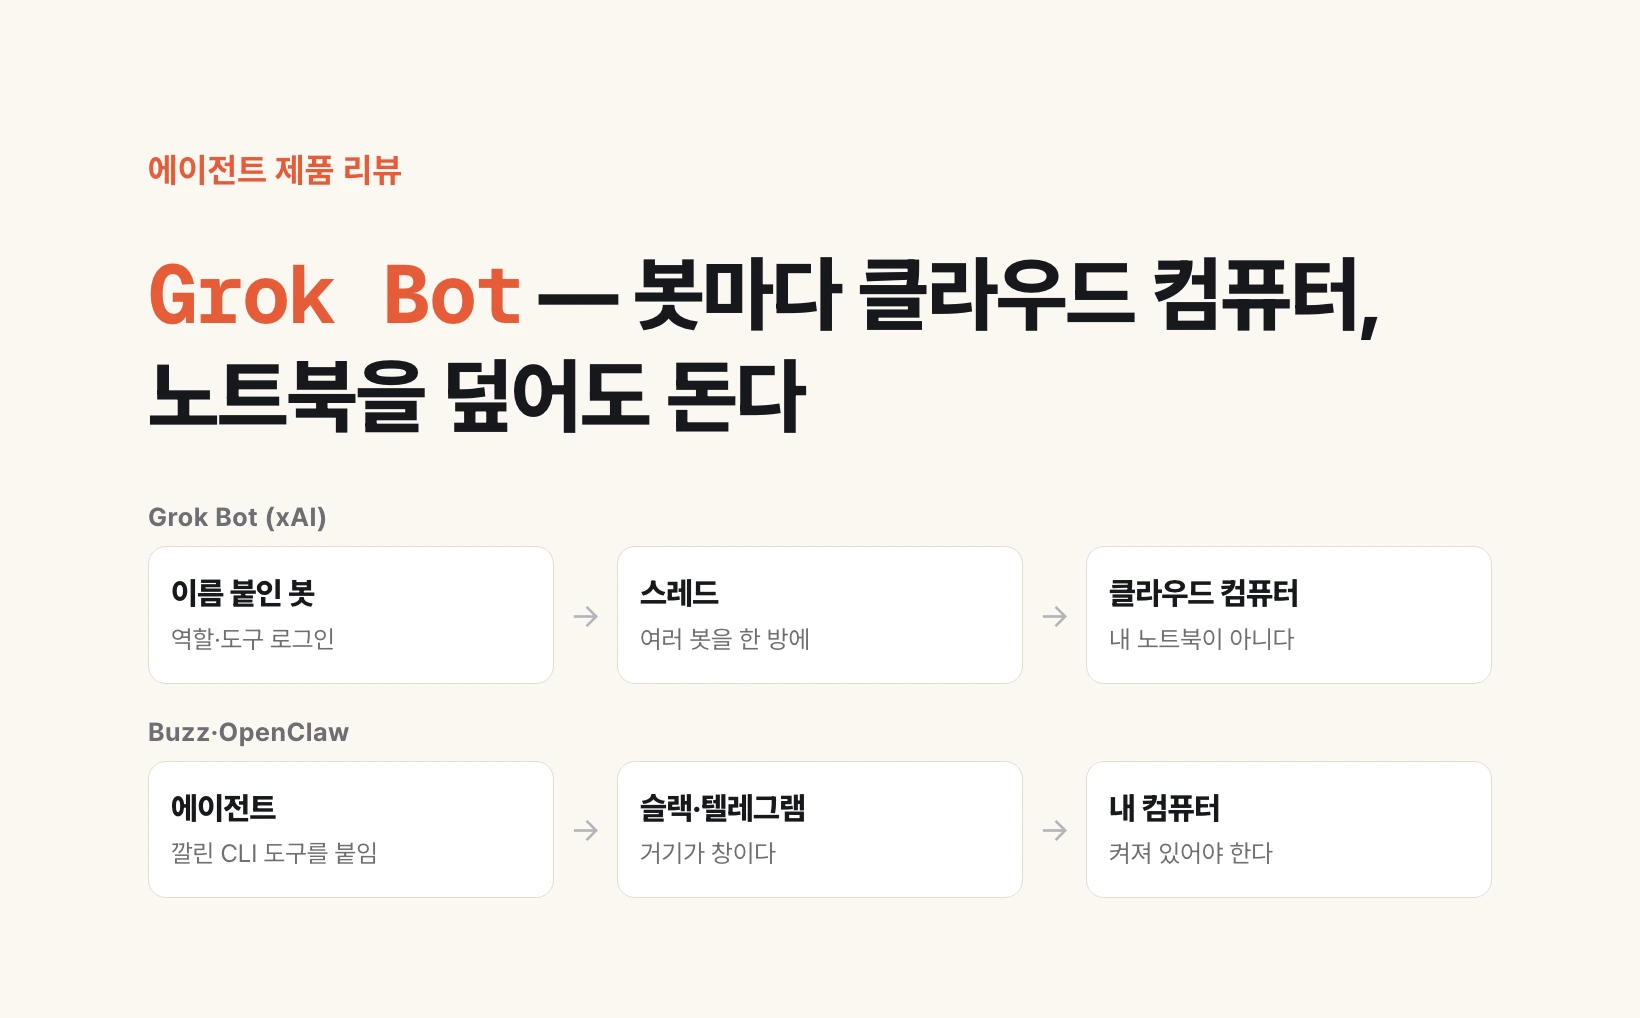
Grok Bot — Hermes と OpenClaw を消して、これだけ残す
Grok Bot は xAI が 2026 年 8 月 11 日に開いたアーリーベータだ。チャット窓ではなく、名前を付けたボットごとにクラウドコンピュータを持たせるチームで、SuperGrok Heavy・Cursor Ultra・Cursor Teams Premium の契約者だけがデスクトップと iPhone で開ける。自分のコンピュータを閉じてもボットは動き、API のないサイトは画面を一度見せればルーチンになる。「Hermes と OpenClaw を消してこれだけ残す」はコードファクトリーのレビューの結論だ。私はまだそこに立っていない。今は Buzz を試しており、蓋を閉じても回すのか、すでに払っている契約の中で自分の機械を使うのか、レビューを増やしてから決める。
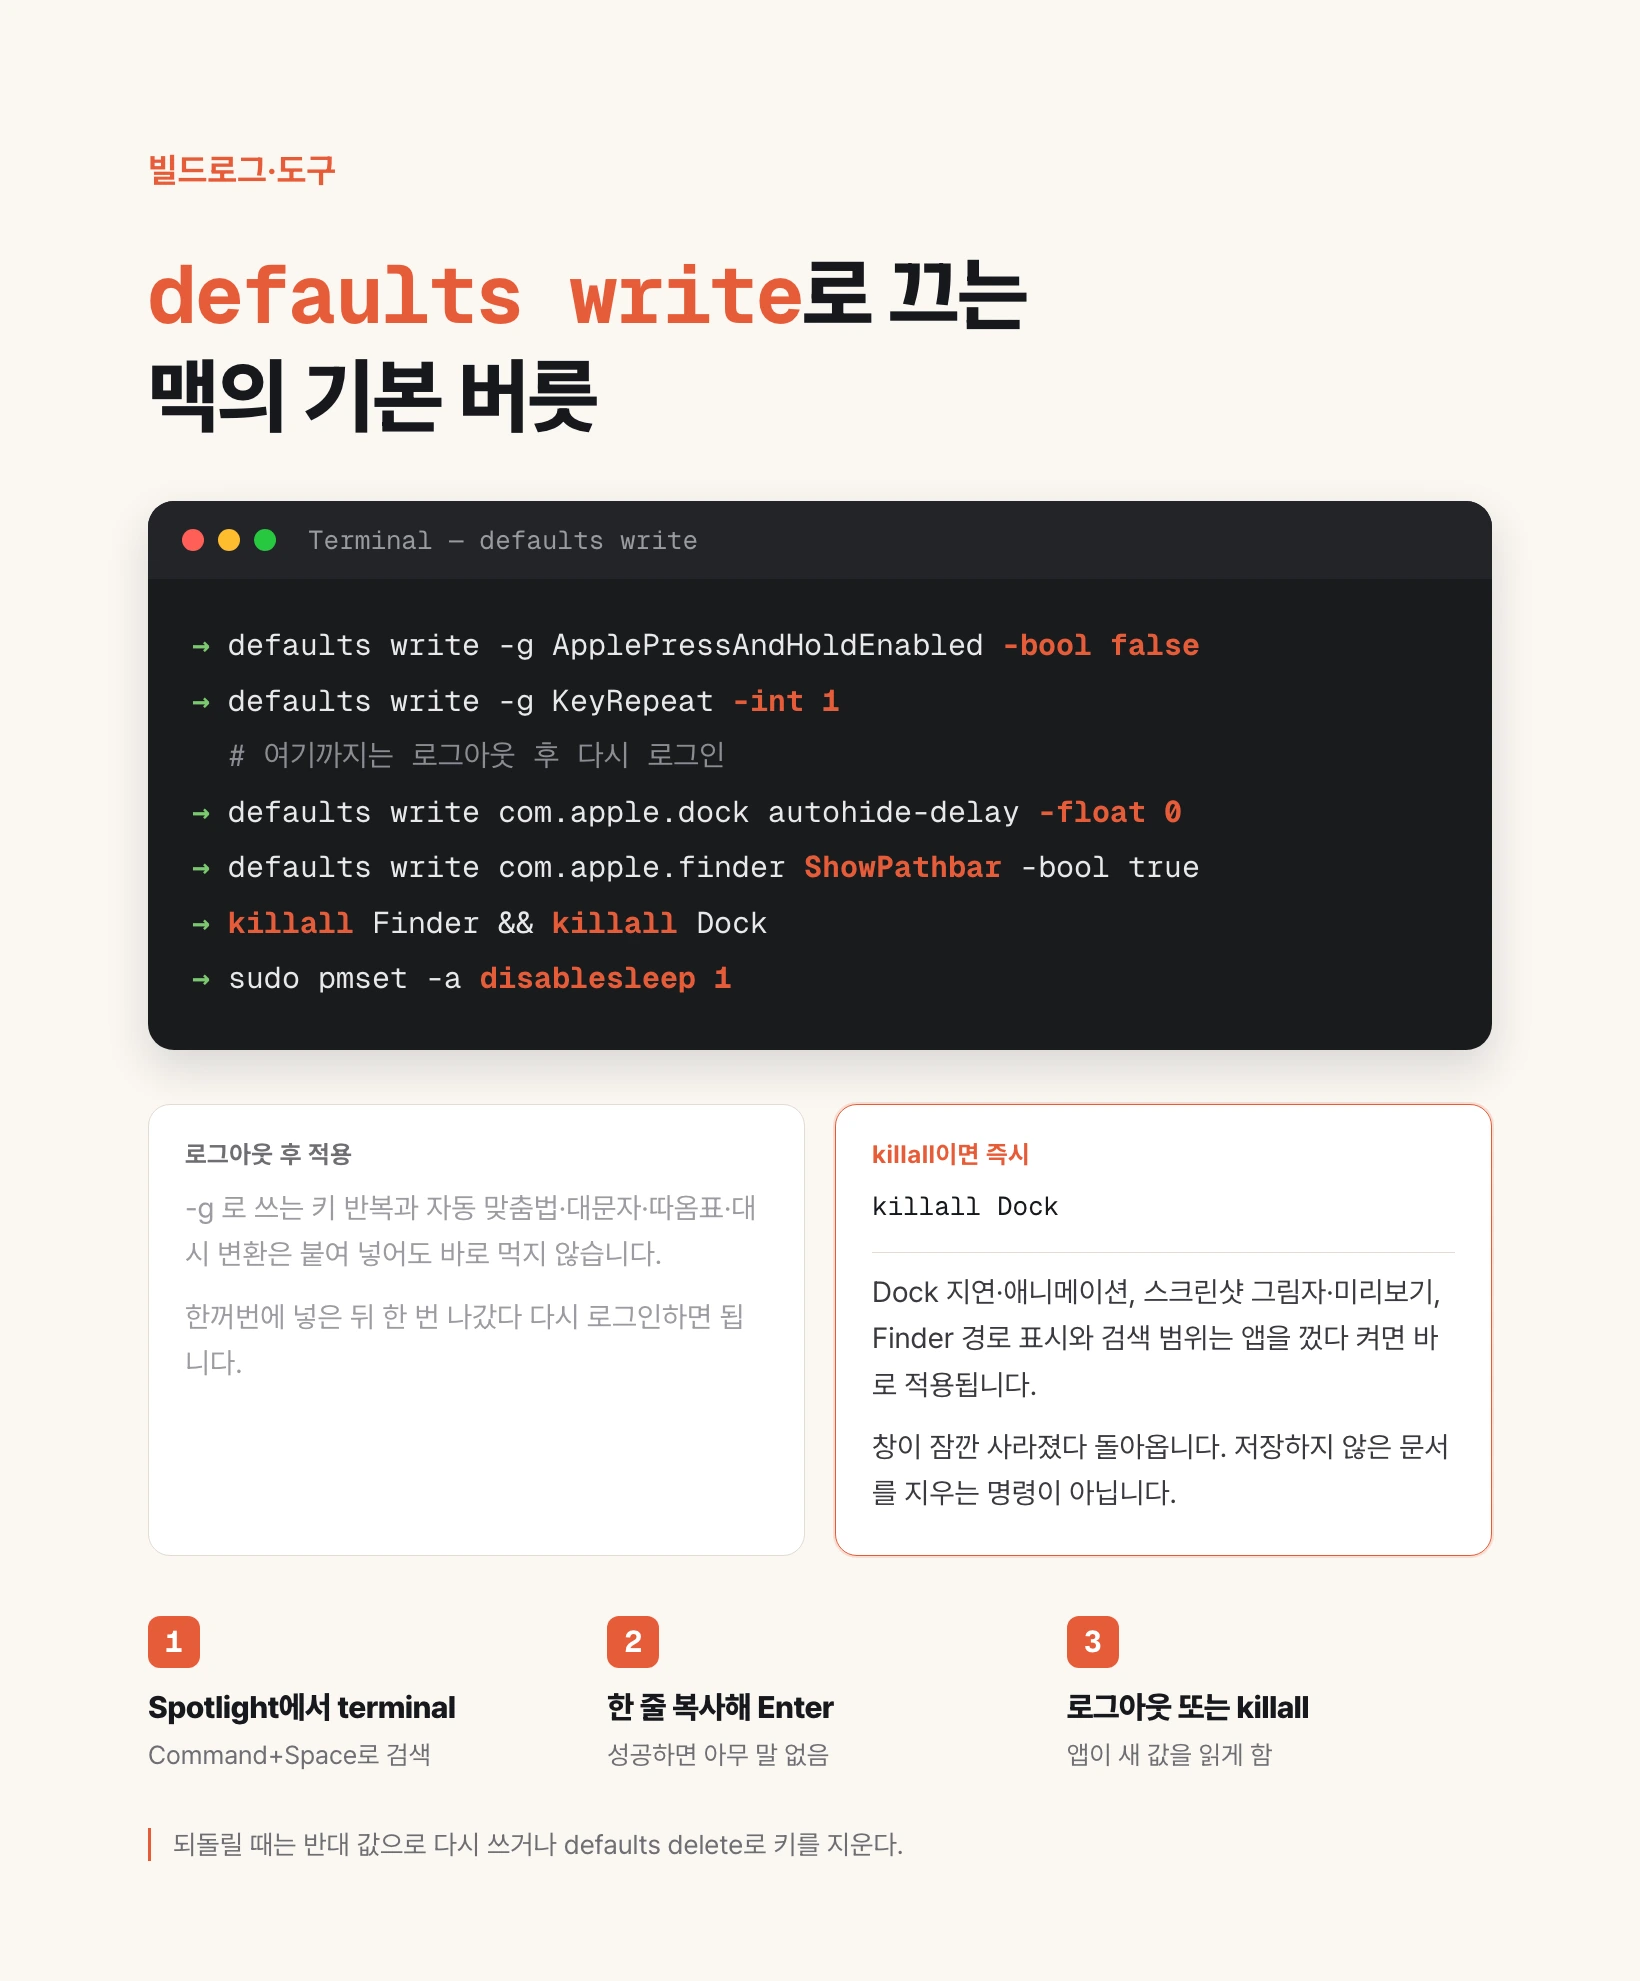
defaults write — Macがキーを横取りし、Dockを遅らせる癖を切る
Macの隠し設定は「システム設定」ではなく、ターミナルの defaults write で変えます。Command+Space でスポットライトを開き、terminal と打てば黒い入力窓が開きます。キーリピートと自動修正は再ログインが必要で、Dockの遅延・ウィンドウアニメ・スクリーンショット・Finderのパスは killall のあとすぐ効きます。エージェントを待ち受けさせるMacだけ sudo pmset -a disablesleep 1 でスリープを止めます。
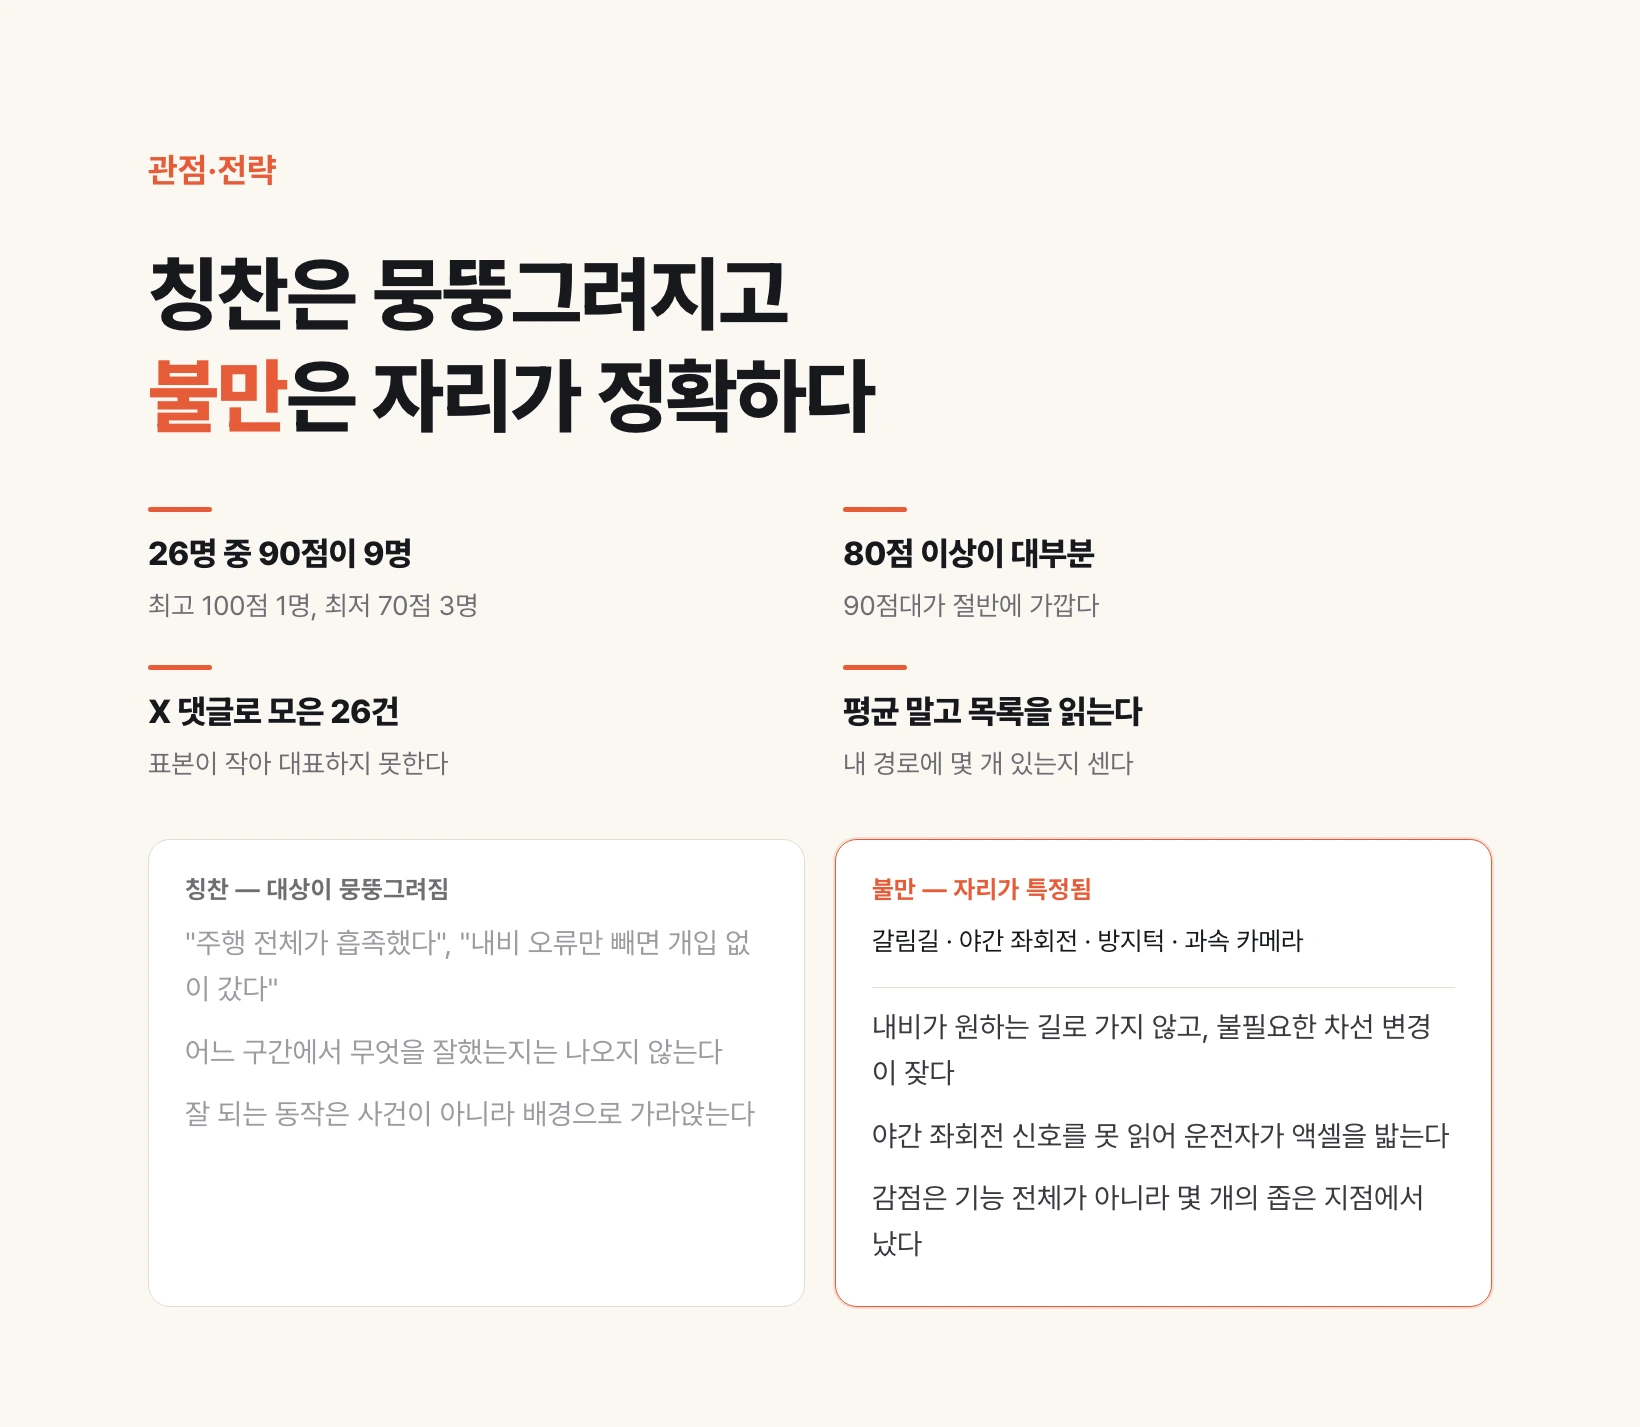
FSD V14 Lite — 韓国オーナー26人がつけた点数と、その理由
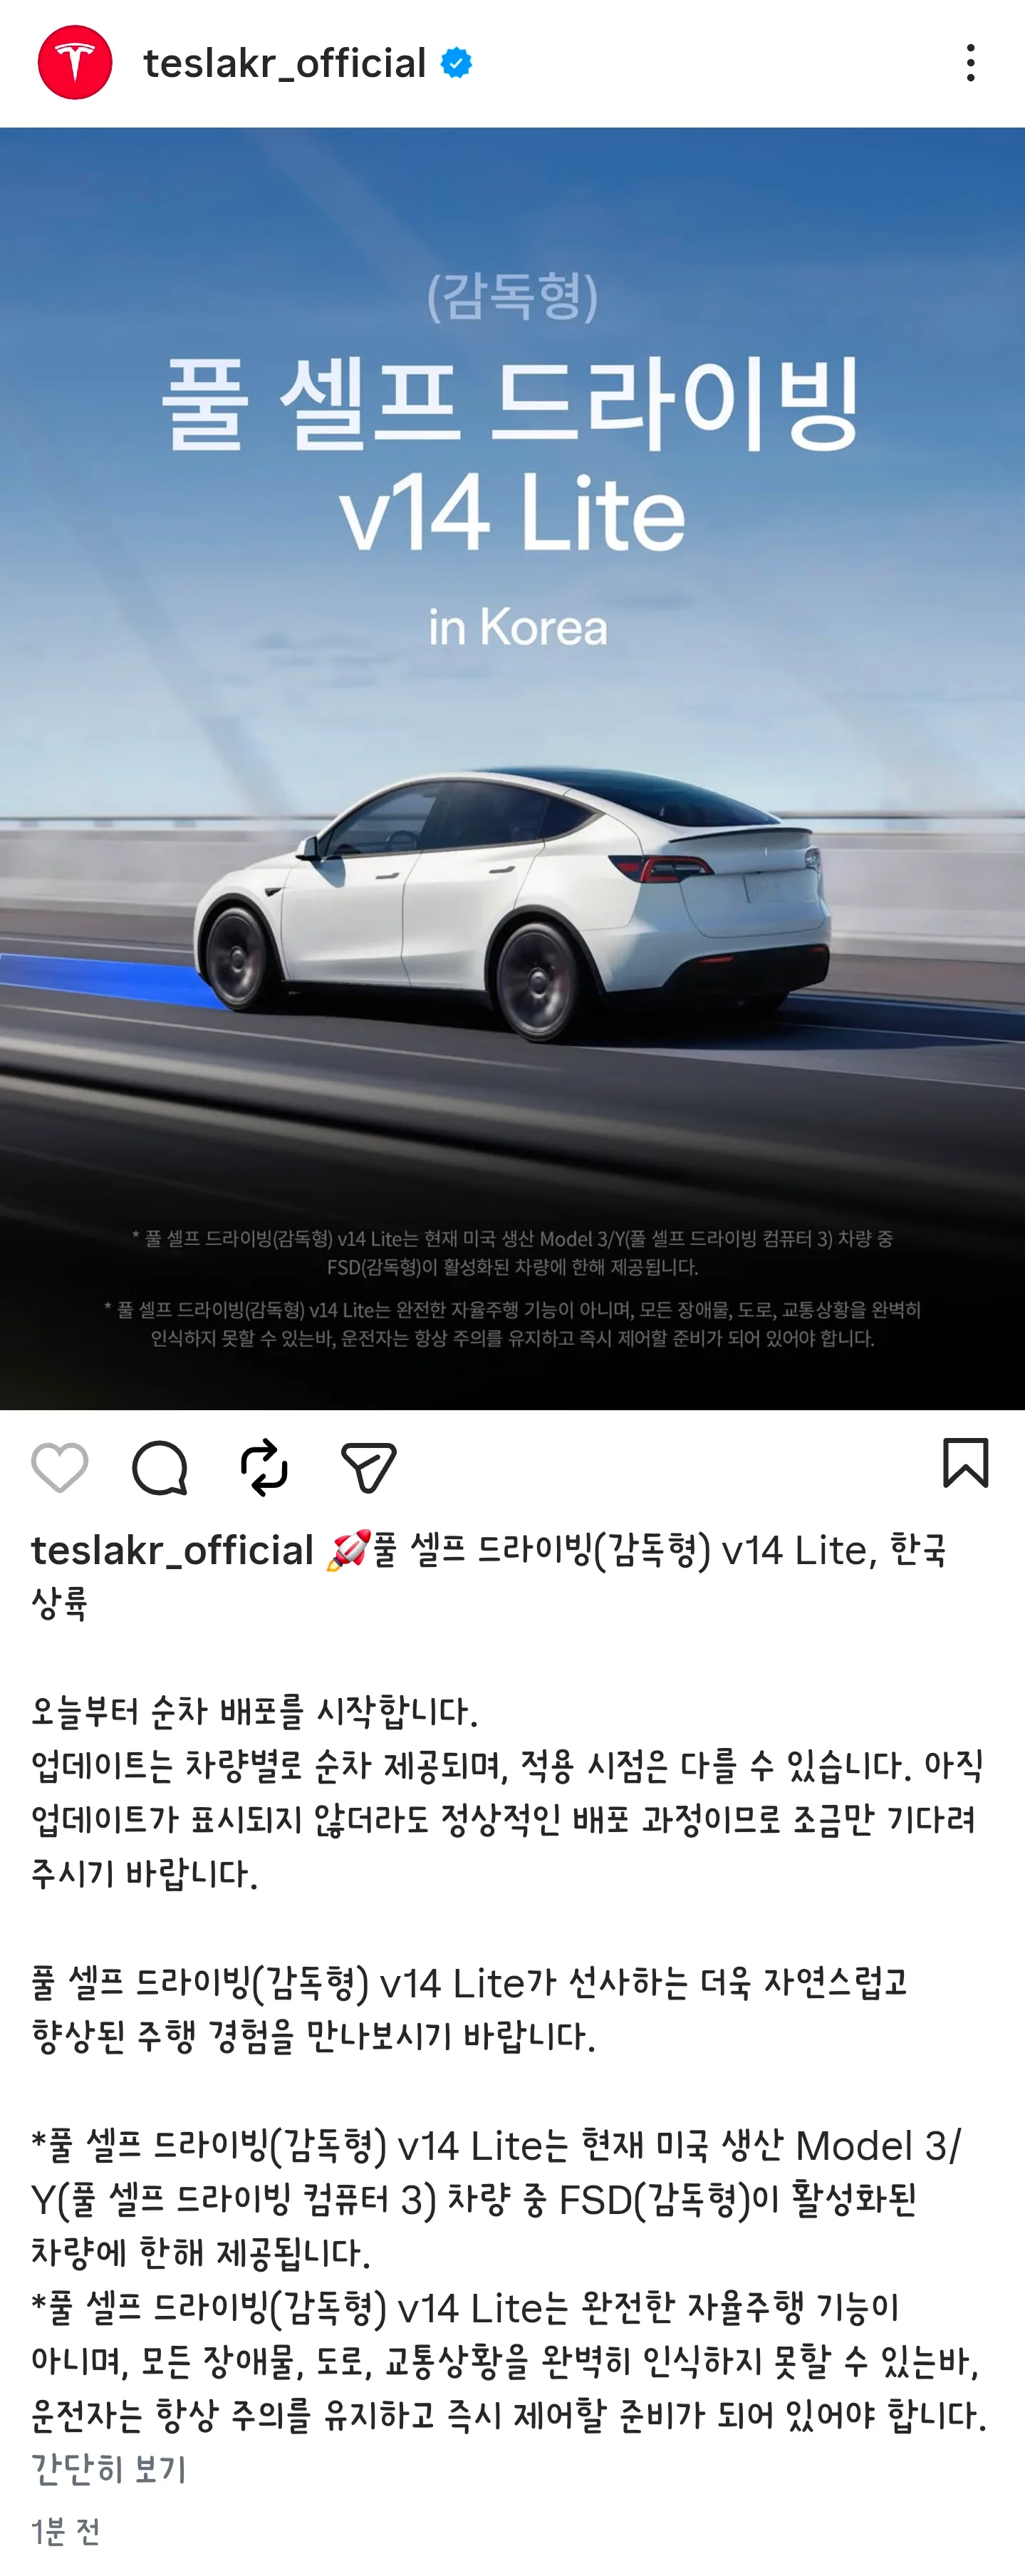
韓国で FSD V14 Lite を実際に使ったオーナー26人がつけた点数は、90点をつけた人が9人で最多、最高は100点が1人、最低は70点が3人で、大半が80点以上でした。点数そのものより興味深いのは、称賛と不満の形が違うことです。称賛は「走行全体が満足だった」「ナビの誤りを除けば介入なしで走れた」と大づかみなのに対し、不満は分岐路、夜間の左折信号、段差前のファントムブレーキ、速度取締カメラと、どの場面でできないかが正確に特定されます。つまり減点は自動運転という機能全体からではなく、いくつかの狭い場面に集中して生じています。ただしこれは YouTube チャンネル Tslachan が X で集めた26件の回答であり、チャンネル主自身が動画内で二度、サンプルが極めて小さく FSD を代表しないと明言しています。
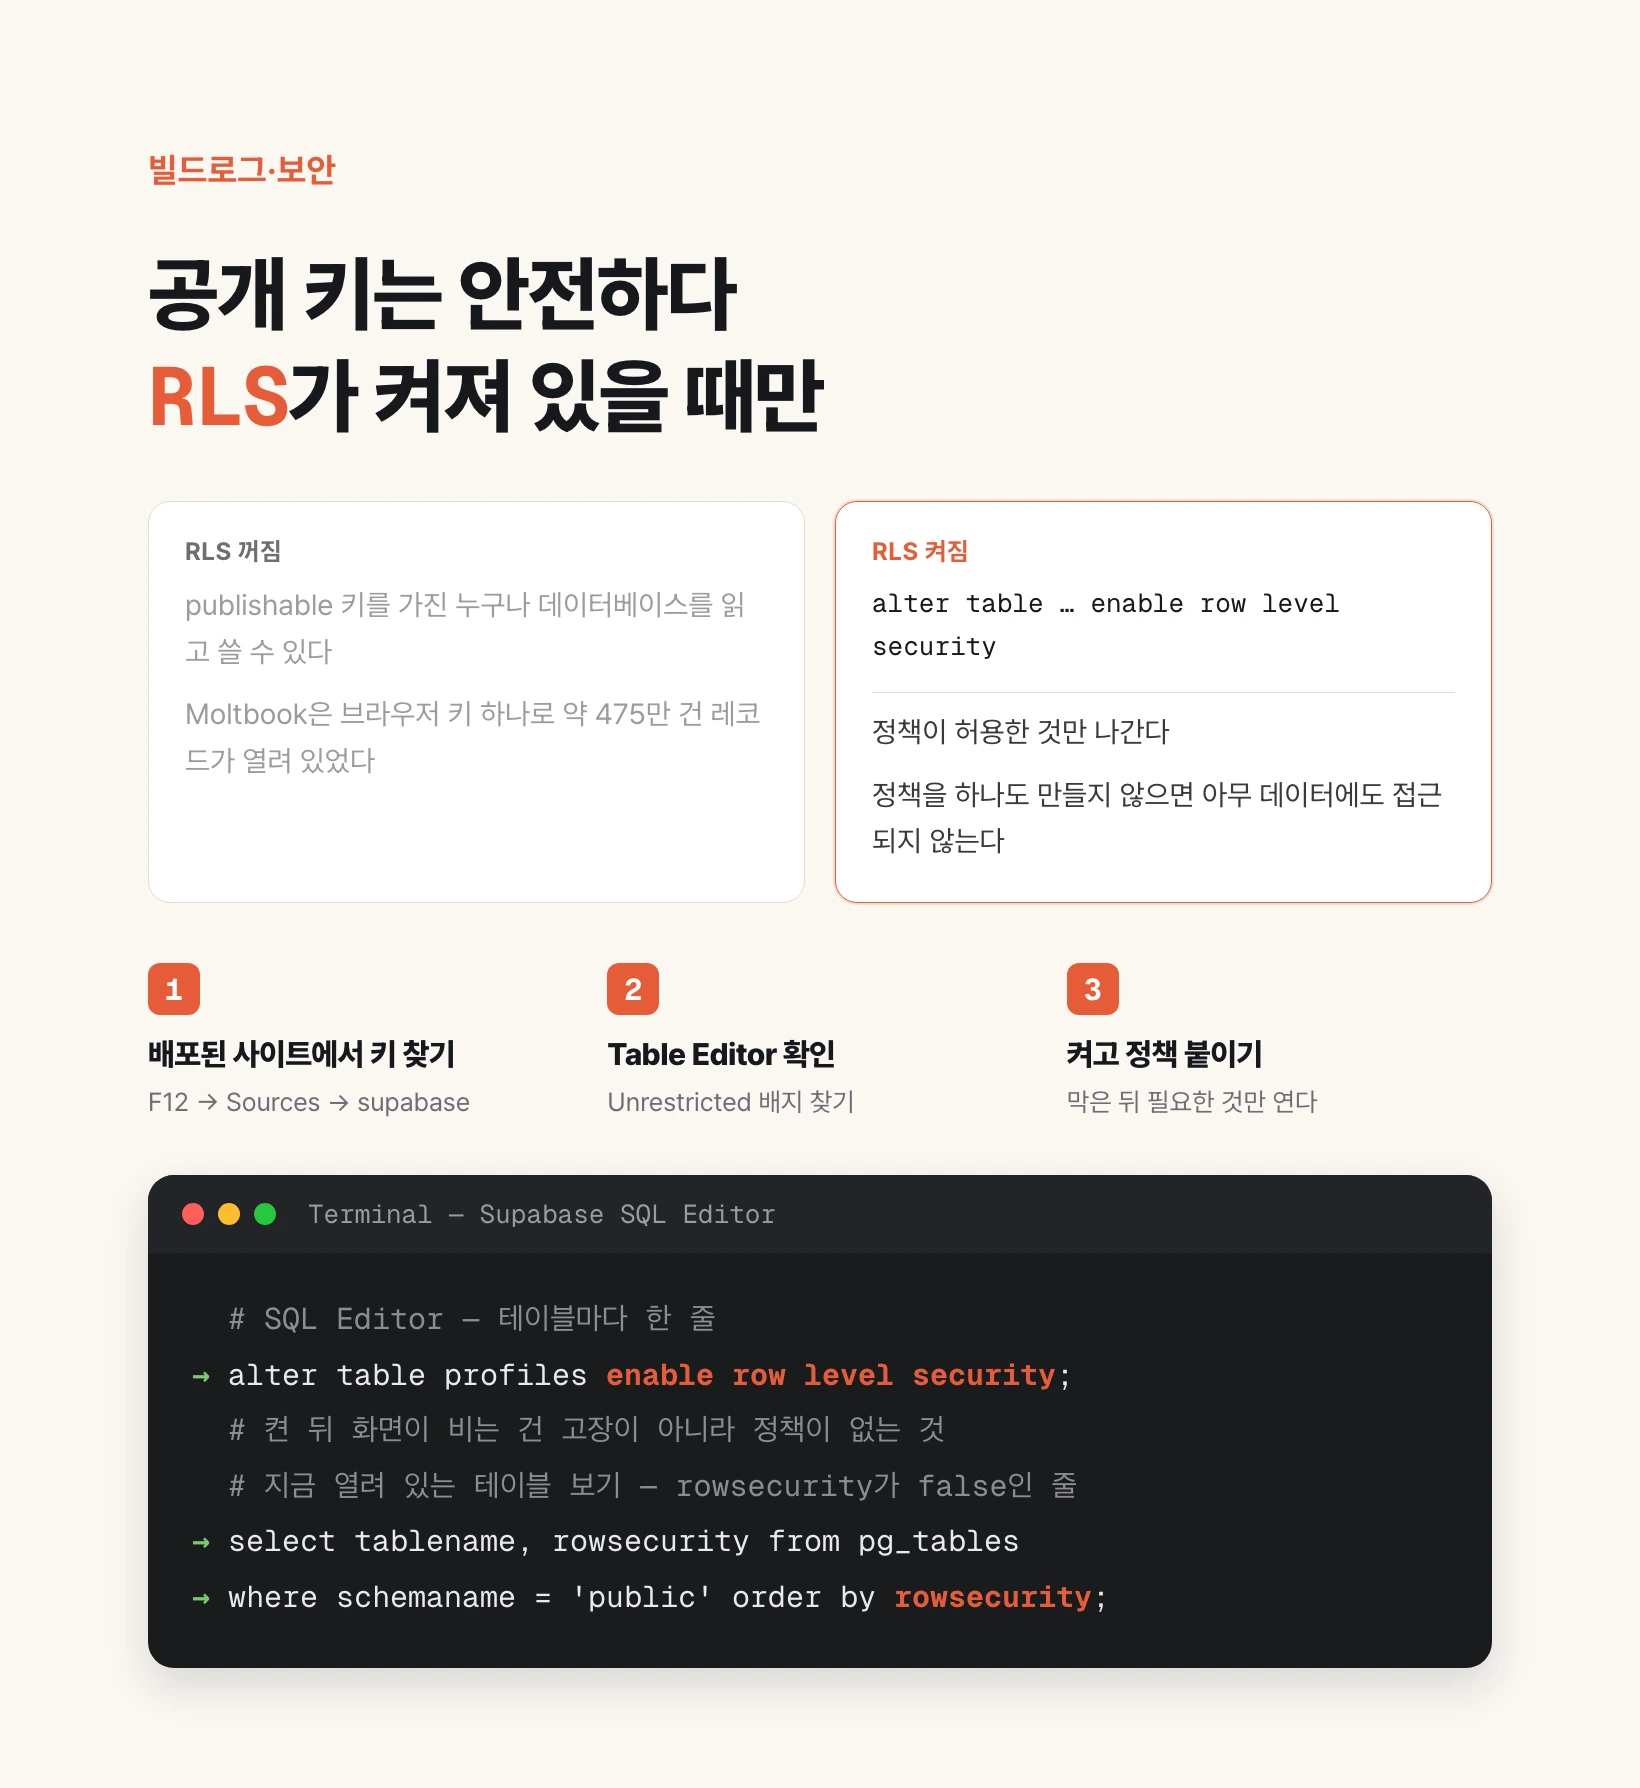
Supabase RLS — あなたのアプリのデータベースは今、誰にでも開いていないか
Supabase で作ったアプリは、キーがブラウザに出ているのが正常です。そのキーが安全かどうかは、テーブルごとに RLS(行レベルセキュリティ)が有効かどうか、その一点で決まります。RLS が無効なら、そのキーを持つ誰もがデータベースを読み書きできます。セキュリティ企業 Wiz が 2026 年 2 月に公開した Moltbook の事例がまさにそれで、ブラウザの JavaScript に置かれた publishable キー 1 本で約 475 万件のレコードが開いていました。確認は 3 分です。公開中のサイトでキーを探し、Supabase ダッシュボードの Table Editor で Unrestricted バッジを見る。本記事ではその手順と、RLS を有効にした直後に画面が空になる理由、ポリシーを足す順序を説明します。
画像AIは猫の脳を写した — ヒューベル・ウィーセルからCNNまで
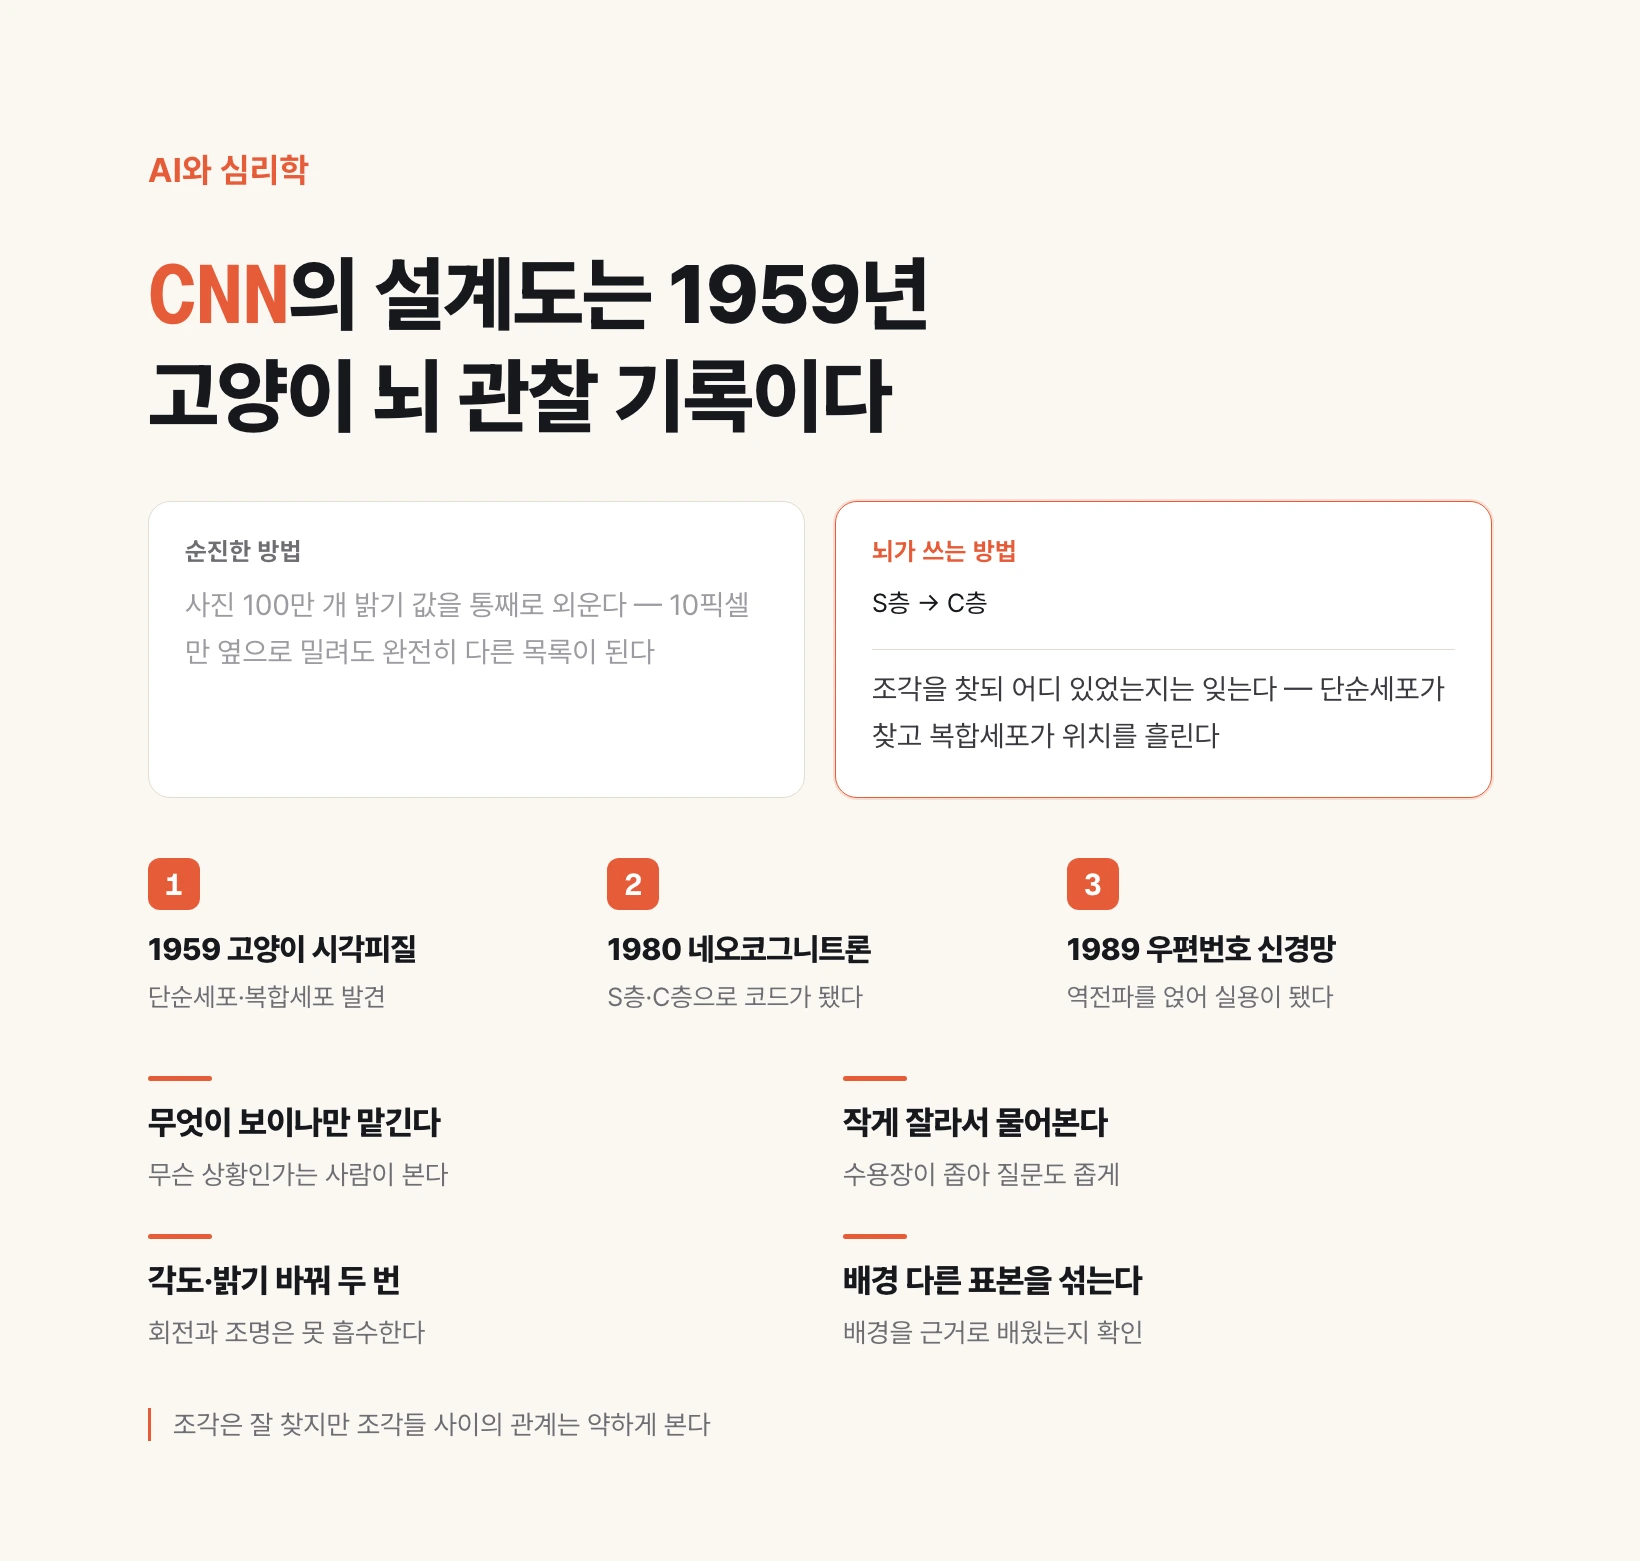
顔を認識し、不良品を選り分け、レントゲンを読むAIを支えてきた構造がCNNである。その設計図はエンジニアが描いたものではなく、1959年に猫の脳へ電極を刺して得た観察記録だ。単純細胞と複雑細胞という二種類の神経細胞が発見され、1980年にそれがそのまま層として実装され、1989年の論文がその実装を引用して今日の画像AIへつながった。
臨床試験の情報で製薬株を予測するとはどういうことか
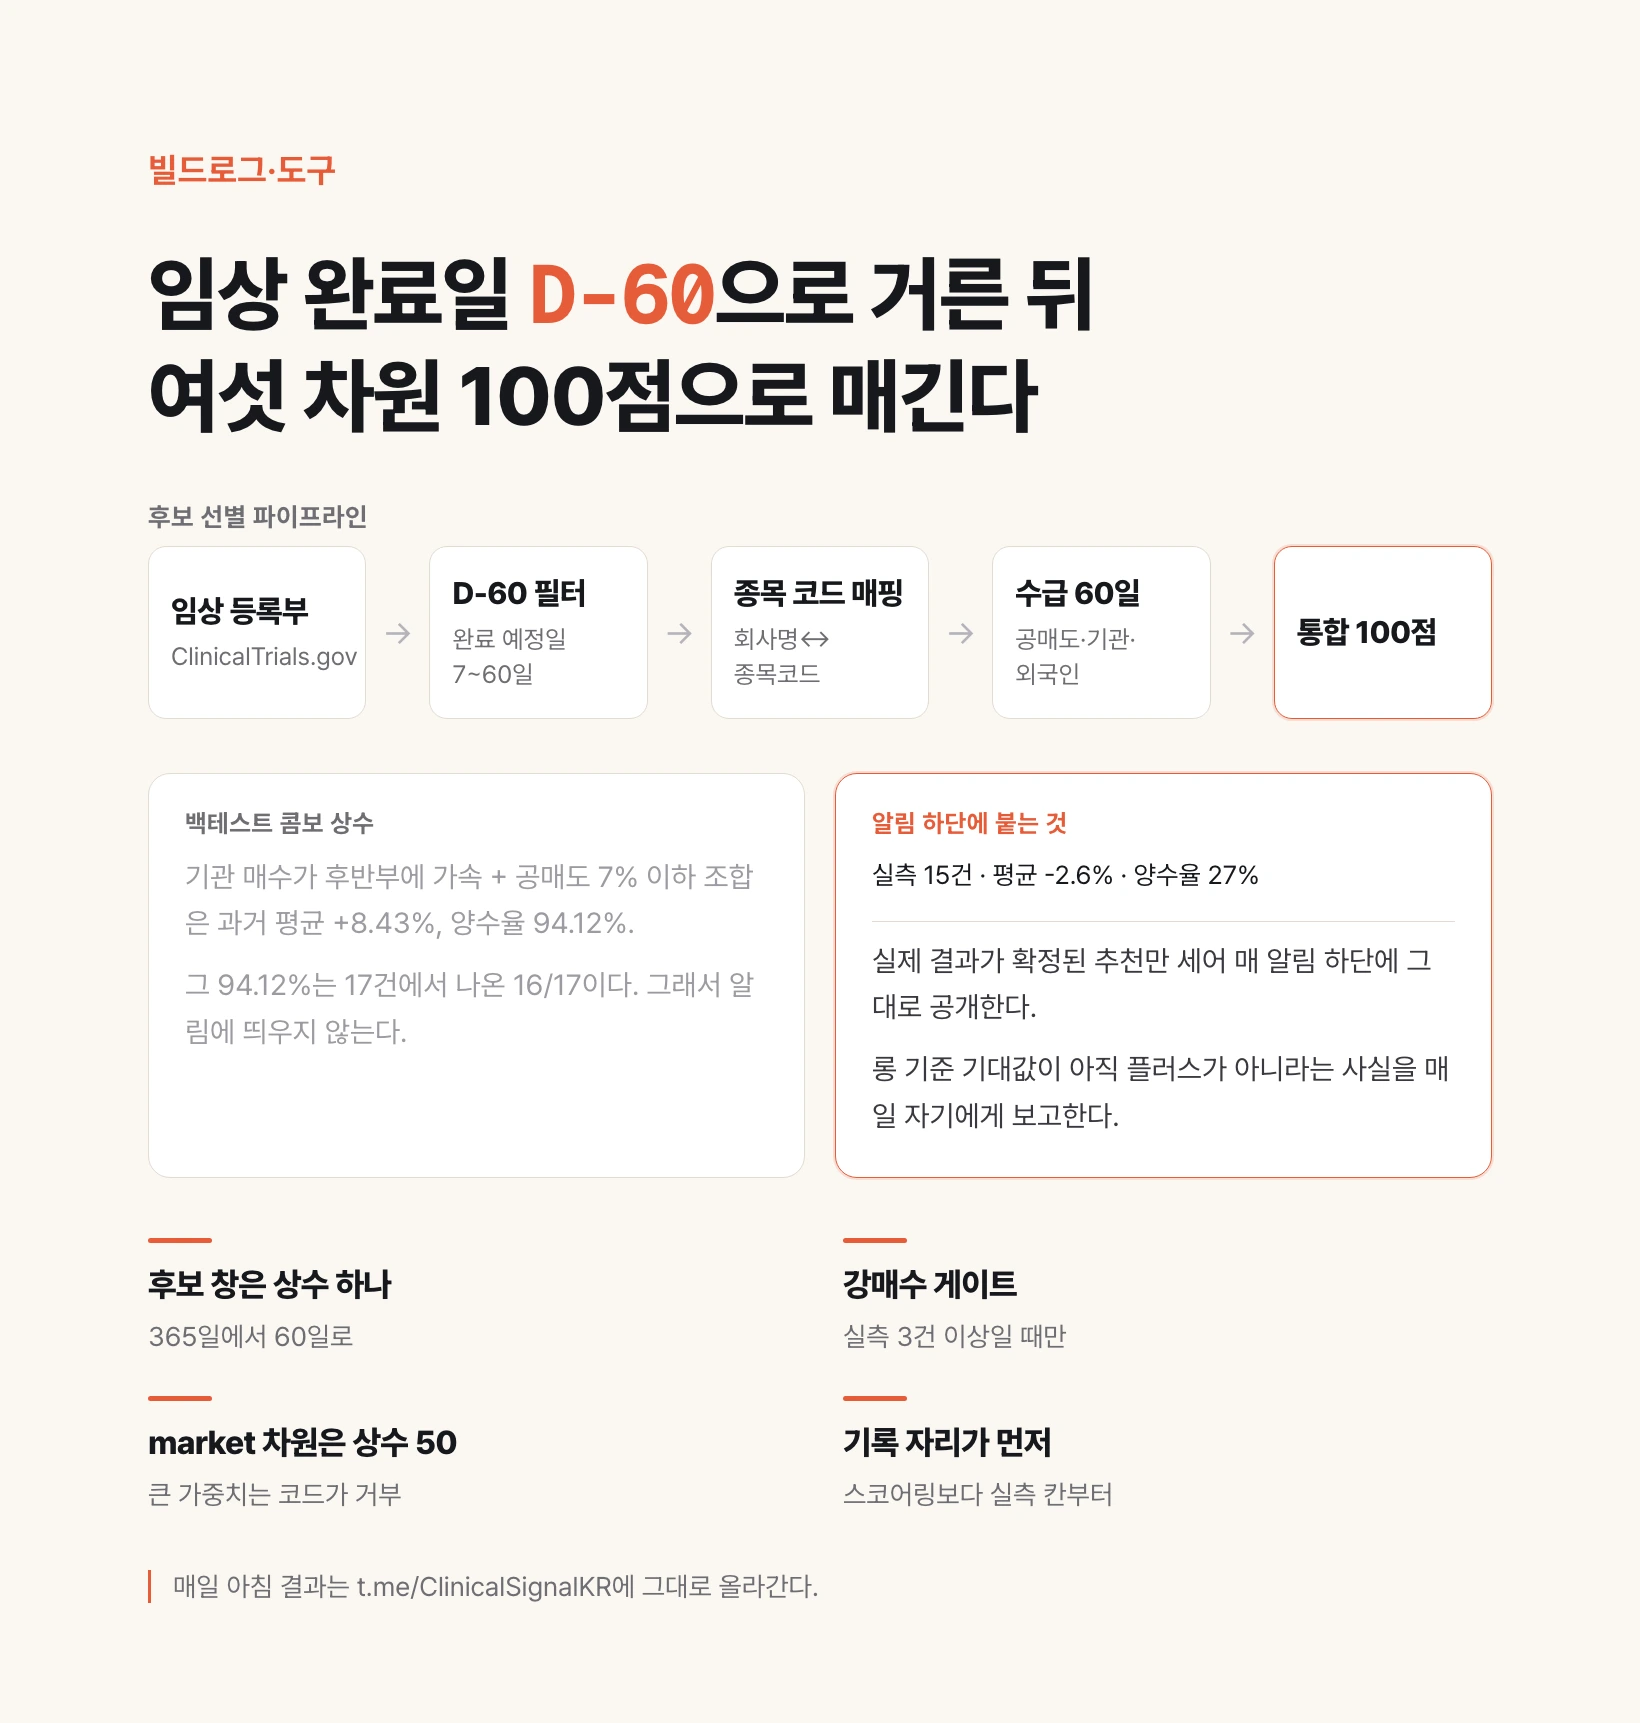
製薬・バイオ銘柄をチャートではなく臨床試験の日程で絞り込むやり方です。第3相の結果がいつ出るかはClinicalTrials.govという公開登録簿にすでに書かれており、機関投資家の需給は発表当日ではなくその二か月ほど前から先に動きます。そこで完了予定日が60日以内の試験だけを残し、空売り残高と需給データを付けて六つの次元を100点満点の一つの点数にまとめます。本稿はそのパイプラインを最初から最後まで開いて見せ、最も重要な設計判断がなぜ「見栄えのよい数字を画面から消したこと」だったのかを説明します。
公共データポータルのオープンAPIを初めてつなぐとき、何を先に確かめるべきか
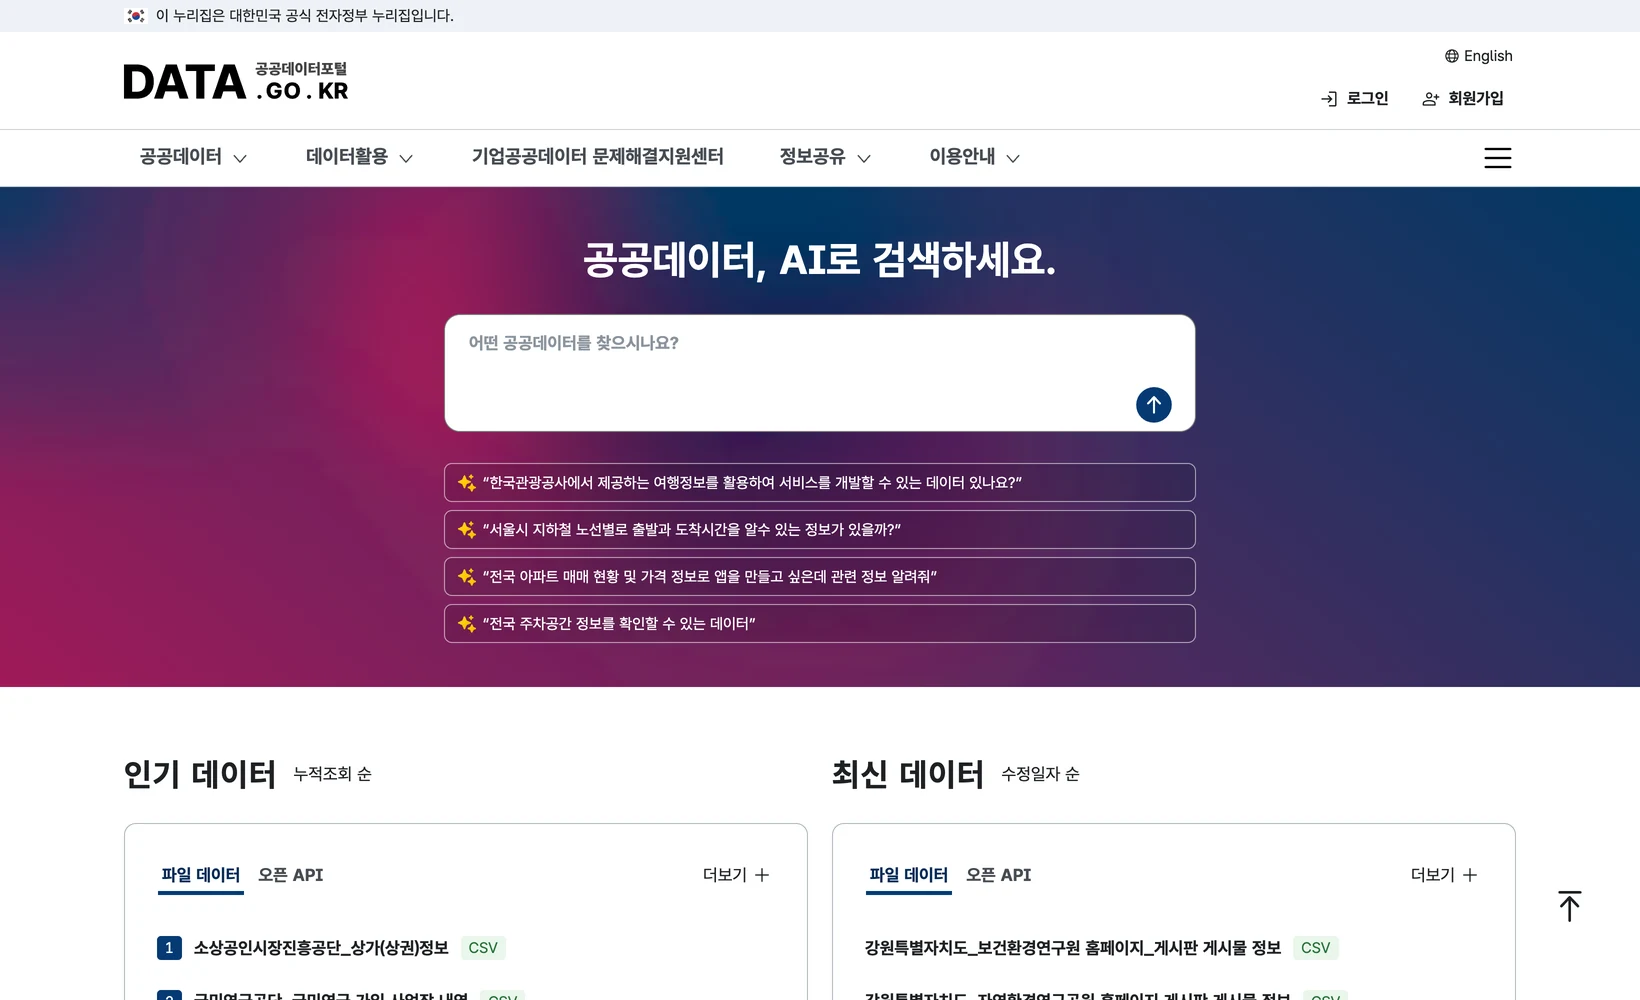
先に確かめるべきは認証や呼び出し方ではなく、静かな失敗です。公共データポータルの一部のAPIは、知らないパラメータを拒否せず無視したまま全国のデータをそのまま返します。健康保険審査評価院の薬局APIに別機関のパラメータを入れたところ、ソウルの5,883件ではなく全国の25,771件が返り、応答はいずれもHTTP 200と正常なJSONでした。本稿はその実測をそのまま示し、公共データをつなぐときの最初の検証は何をすべきか、そしてポータルにあることとAPIで取得できることがなぜ別の問いなのかを説明します。
Claude 5 世代のコンテキストエンジニアリング — CLAUDE.md から消すべきもの
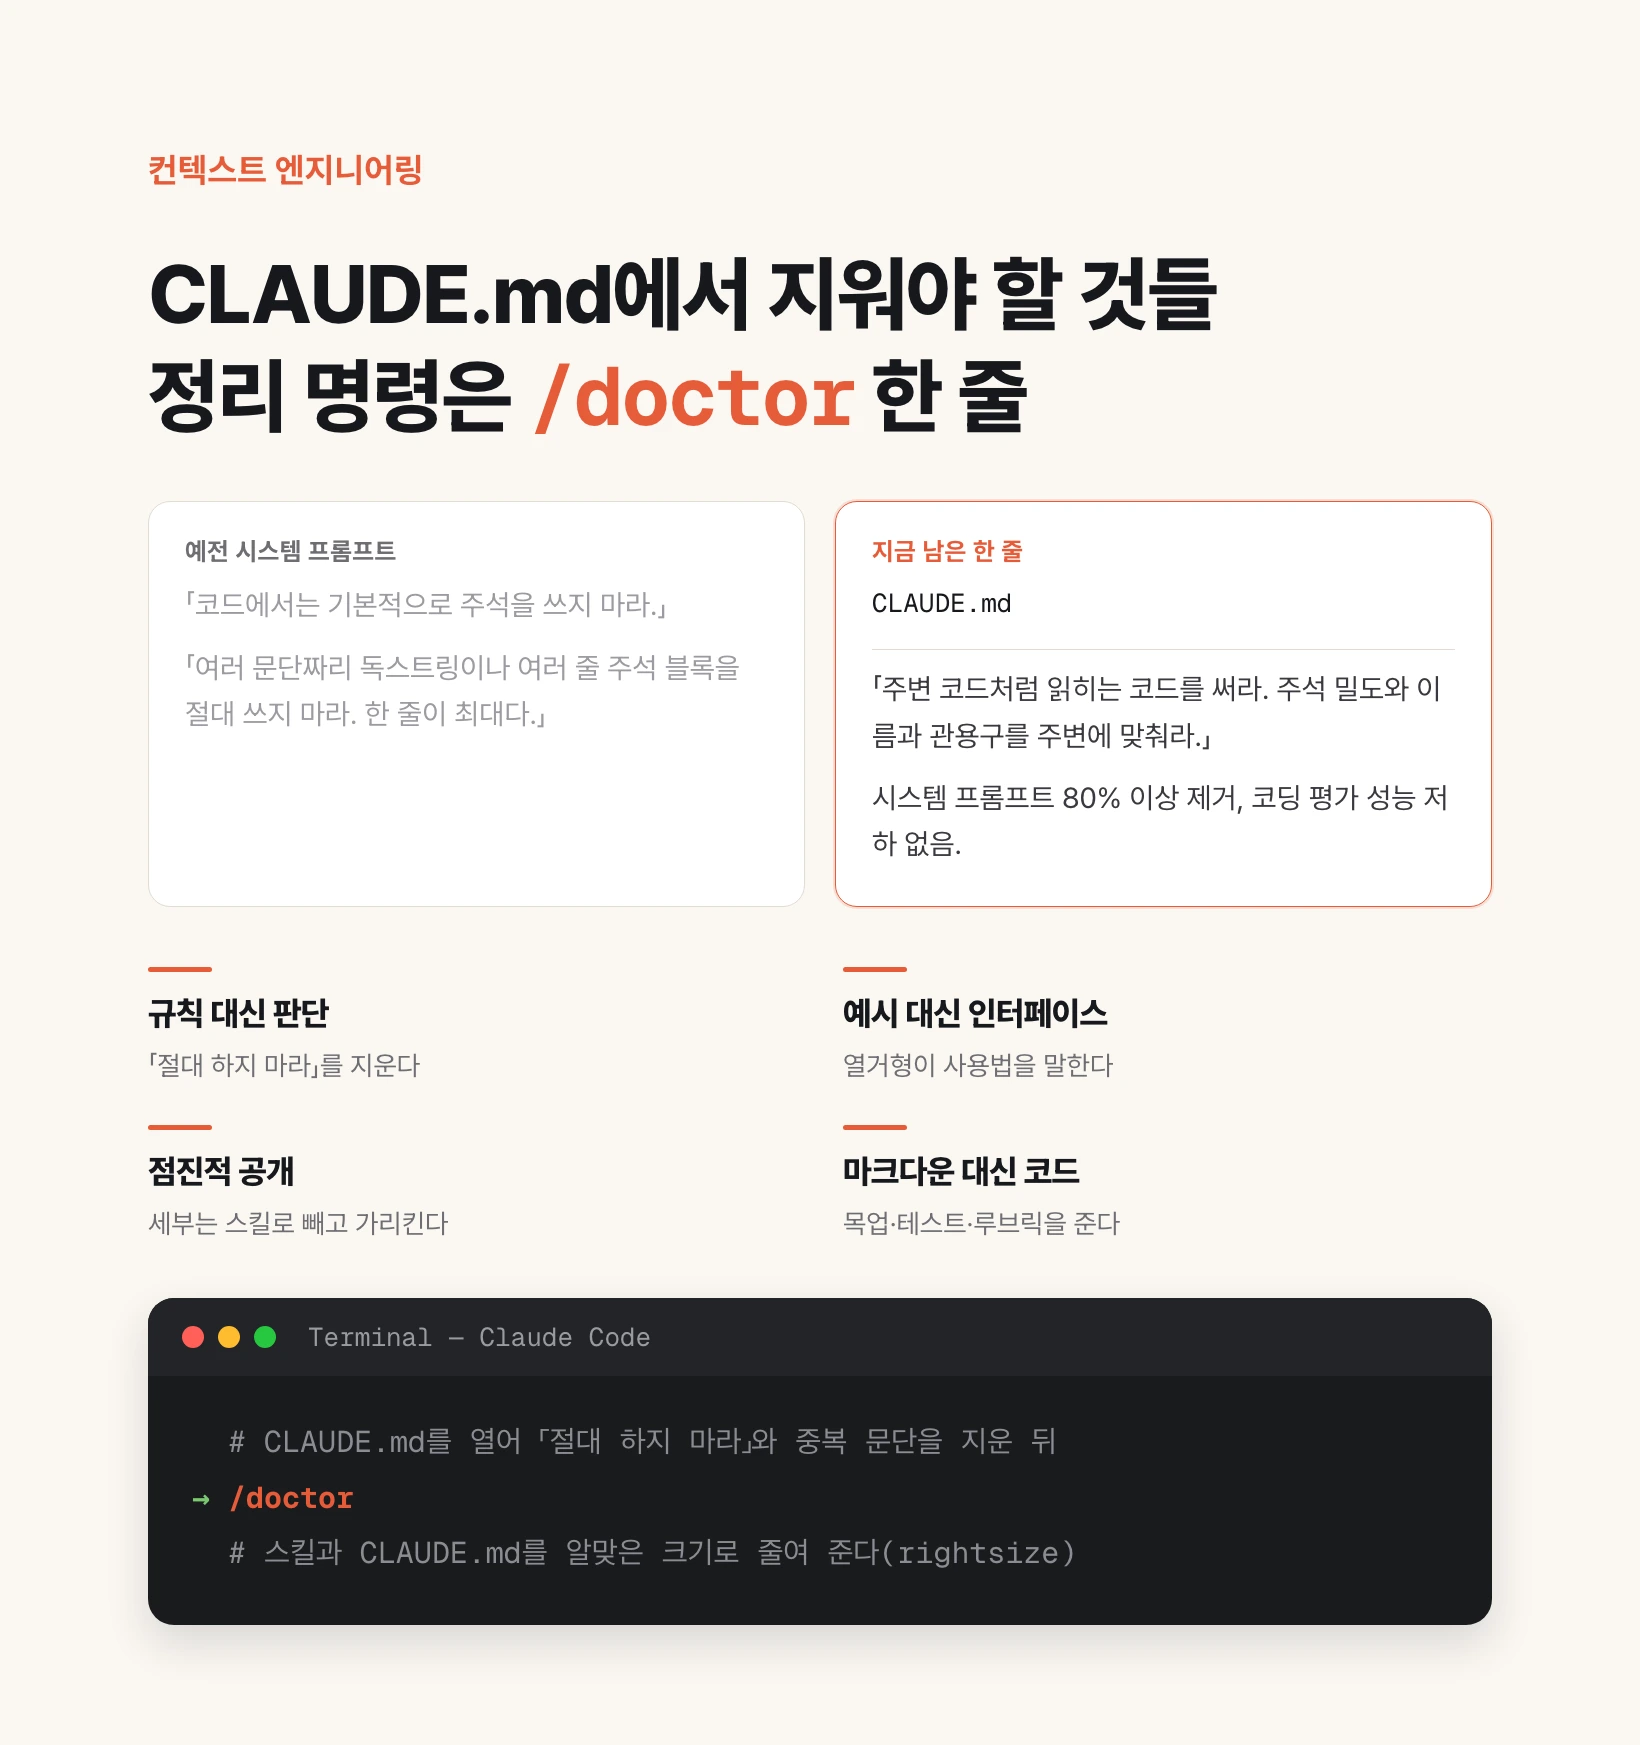
Anthropic が Claude Code のシステムプロンプトから 80% 以上を削ったのに、コーディング評価のスコアは落ちなかった。モデルが判断できるようになったことで、この数か月「良いやり方」として学んだものが、いまは性能を削る重荷になったという話だ。変わった規則は六つで、自分のファイルに適用するコマンドは Claude Code の /doctor 一行である。原文は claude.com/blog の「The new rules of context engineering for Claude 5 generation models」。
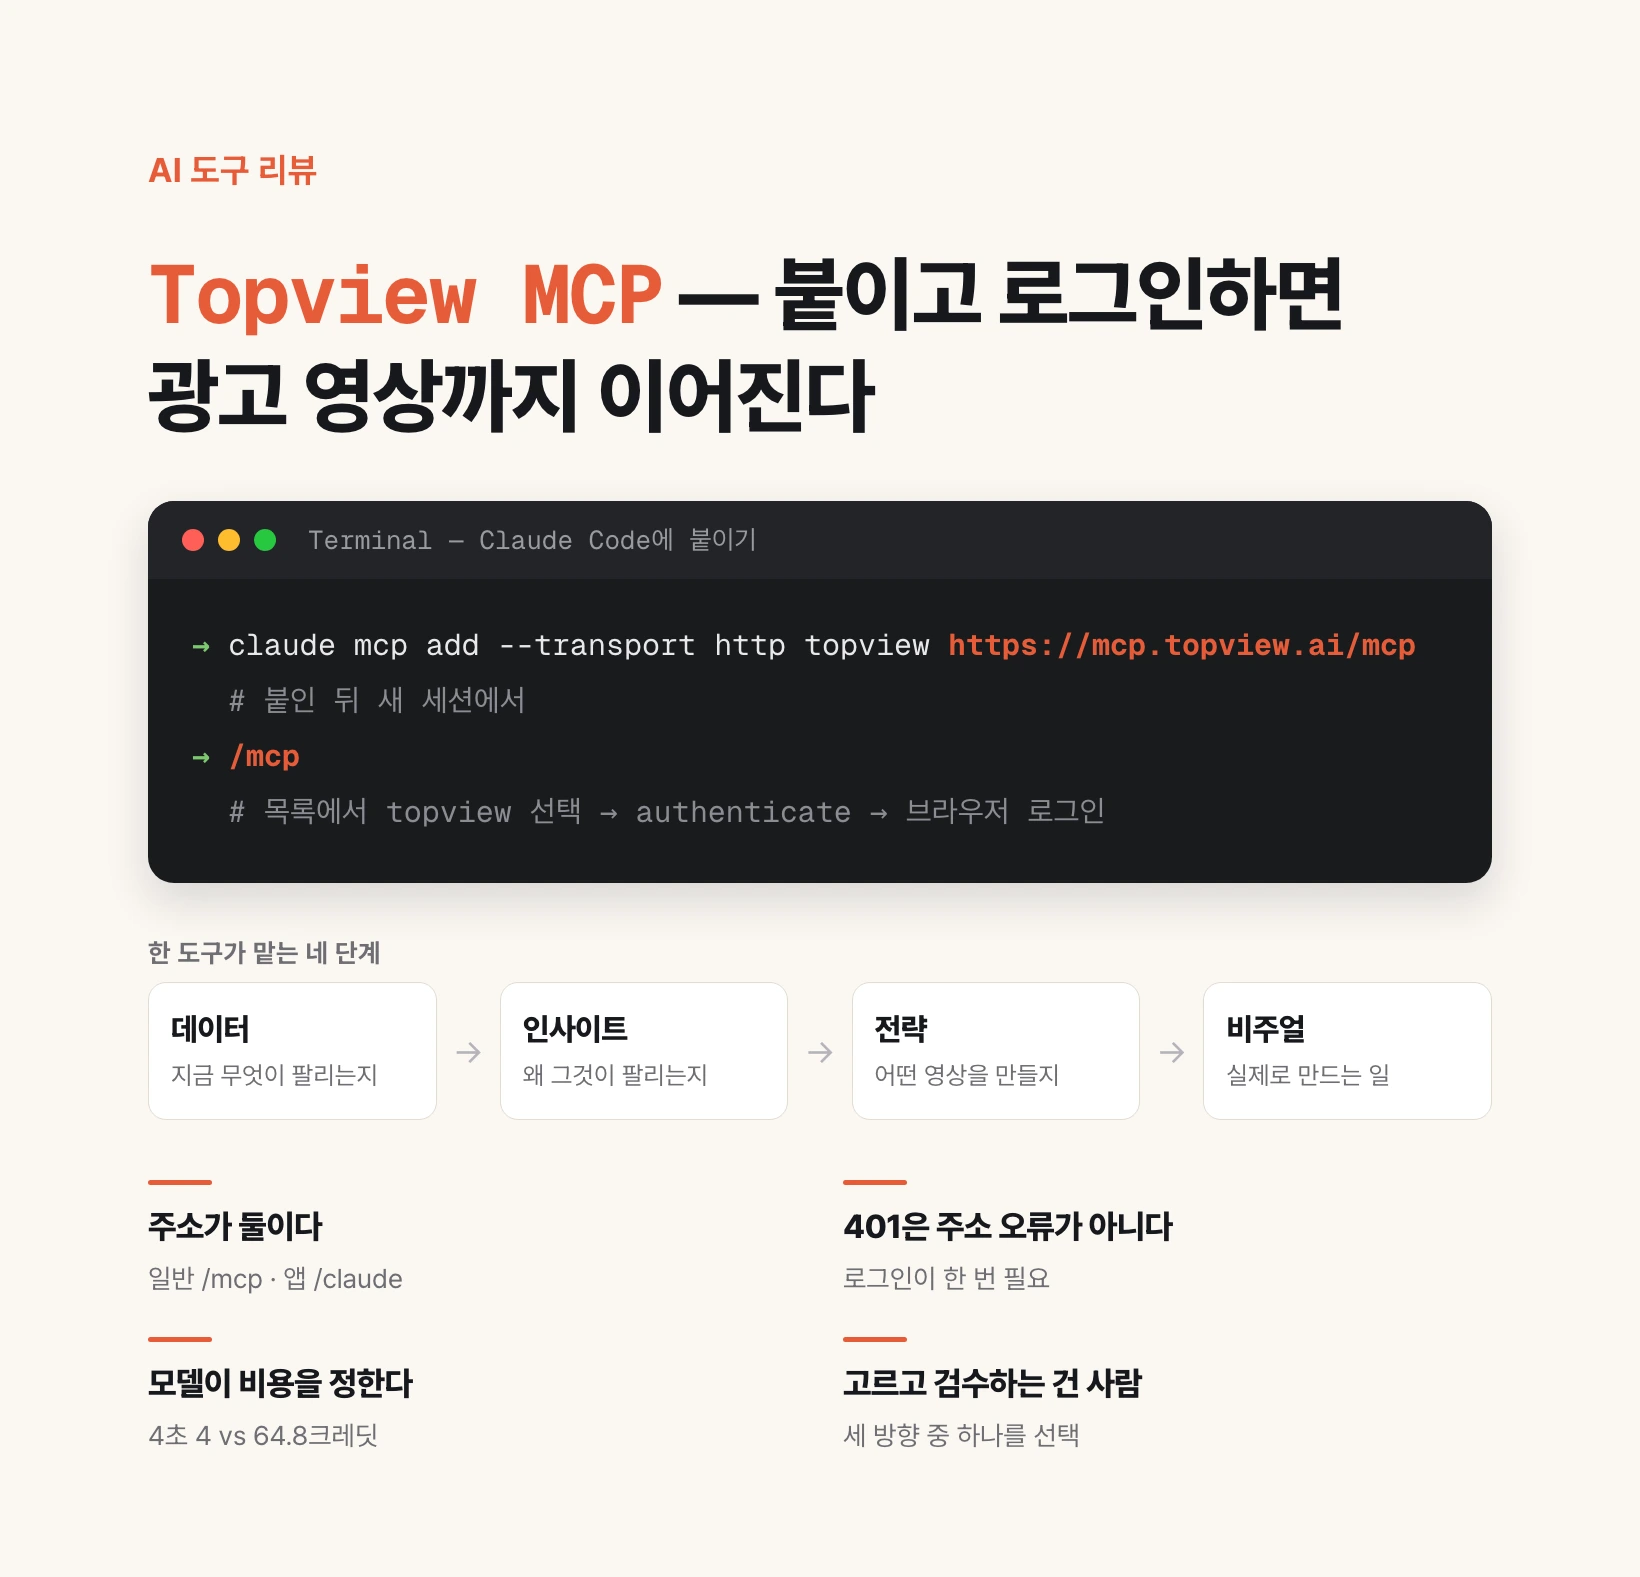
Topview MCP — Claude につないで広告動画をつくる方法
Topview MCP は市場データの調査から広告動画の制作までを一つの MCP サーバーにまとめたサービスだ。アドレスをクライアントに貼ってログインすれば、以後は「いま売れている商品を探して広告動画にして」程度の依頼でデータ調査・企画・画像・動画・ナレーションまでつながる。アドレスはクライアントごとに異なり、Claude Code のような一般の MCP クライアントは https://mcp.topview.ai/mcp、Claude アプリのコネクターは https://mcp.topview.ai/claude を使う。つくったのは Topview で、この記事は使ってみた紹介である。
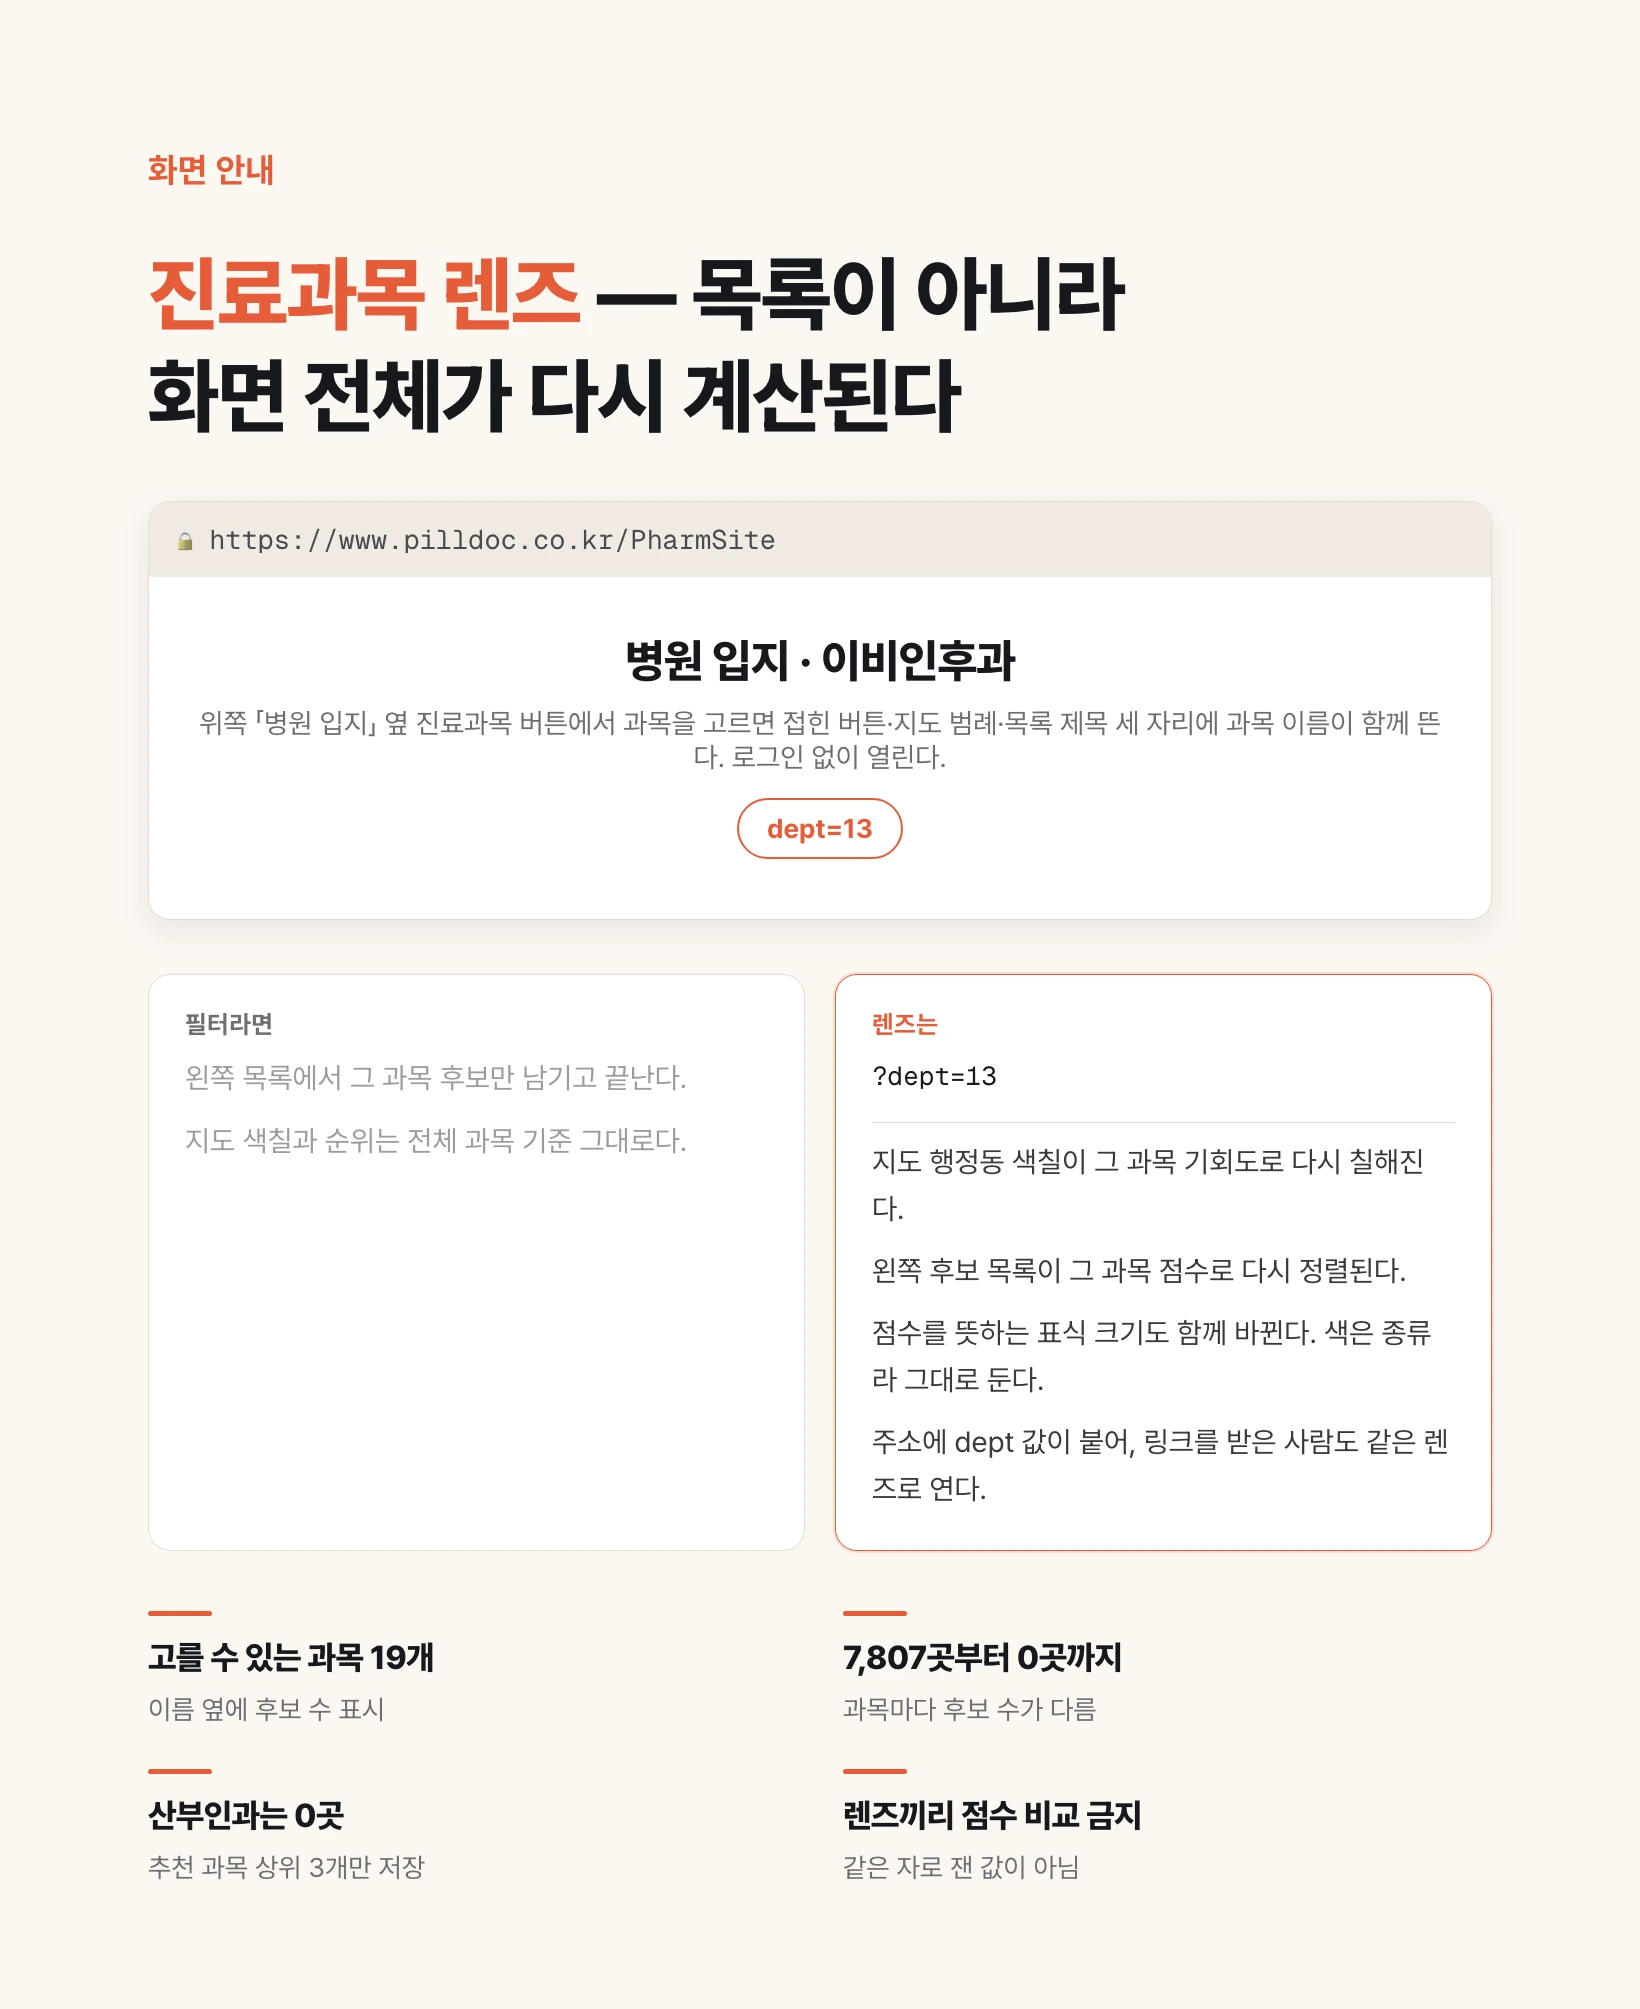
PillDoc 薬局立地の診療科目レンズ — 医院の場所を科目基準で見直す
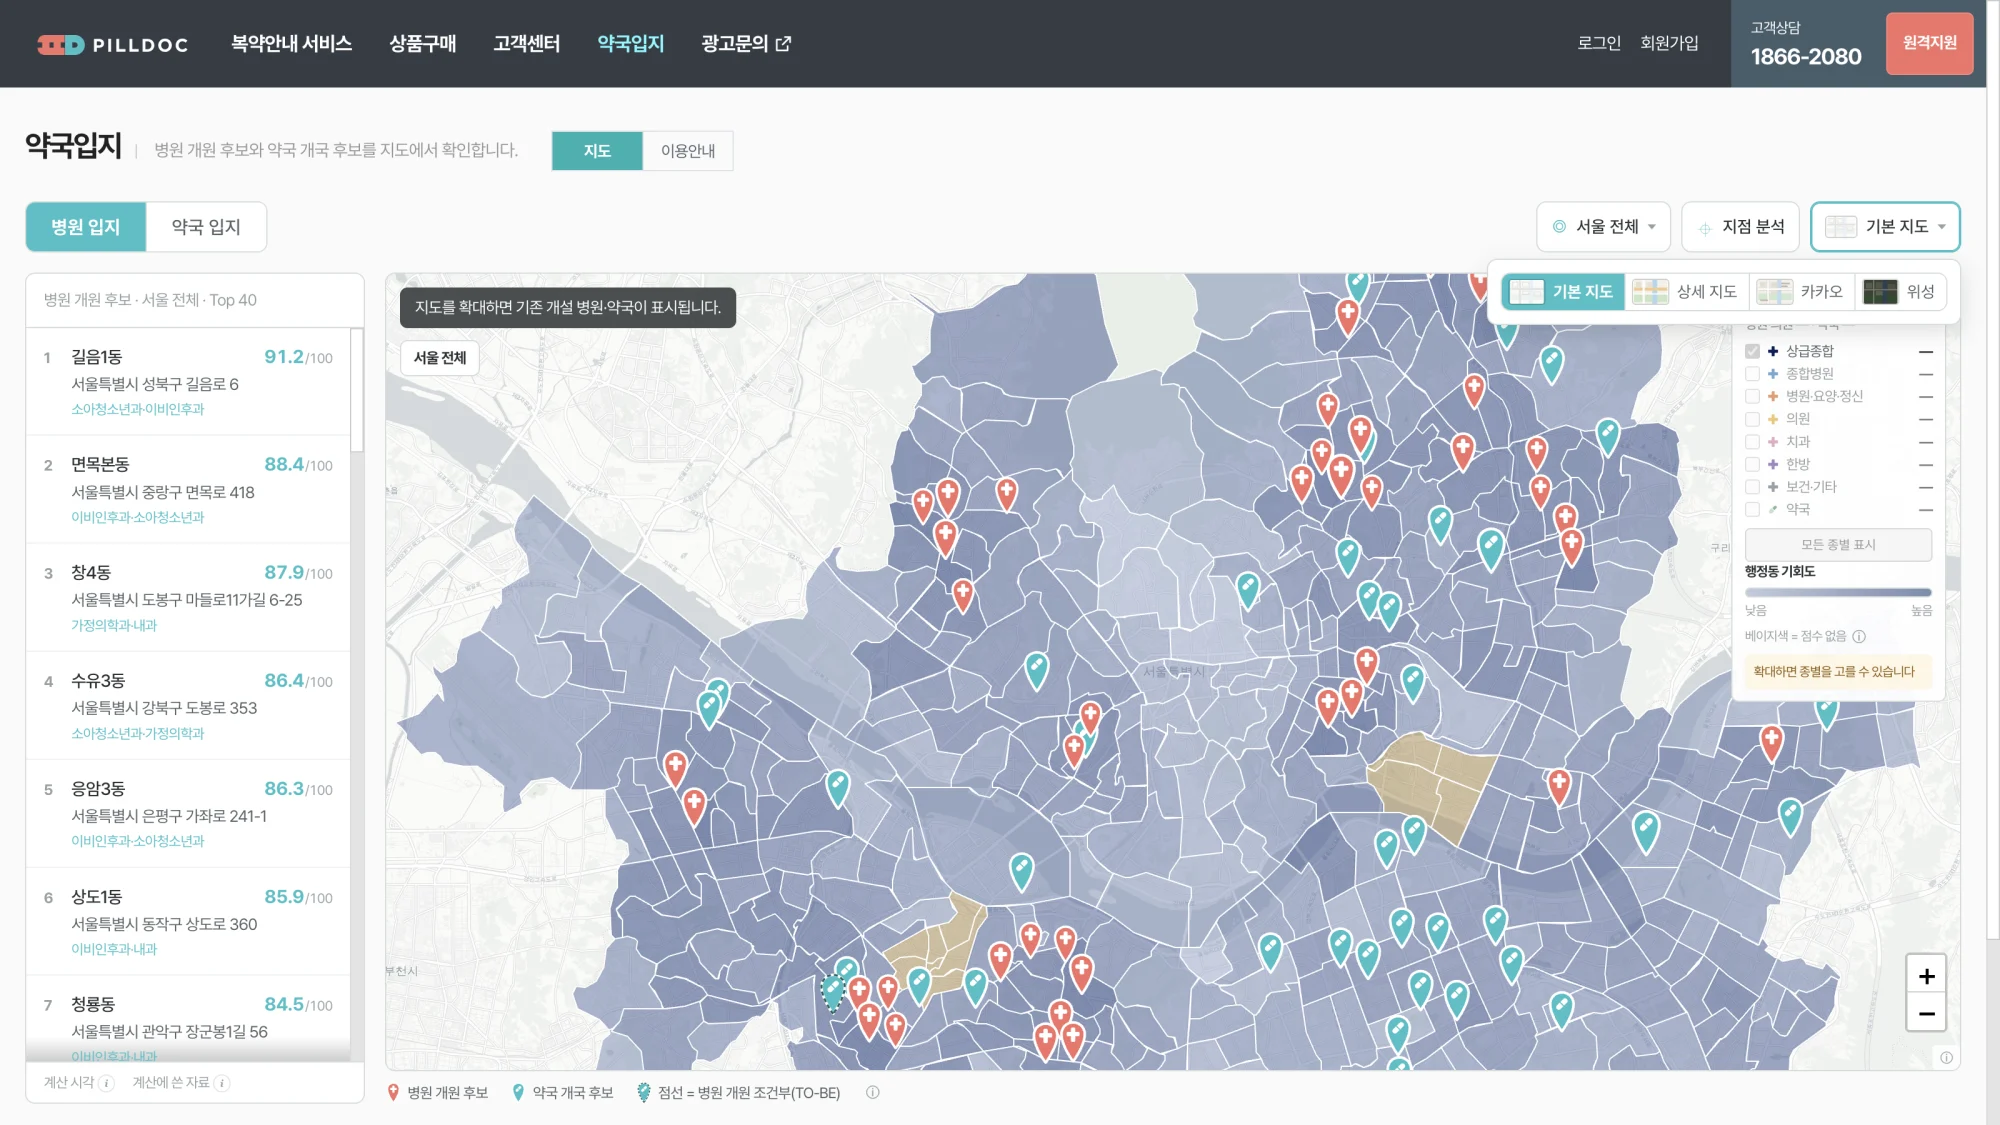
PillDoc の薬局立地マップに診療科目レンズが加わった。「病院立地」ボタンの横で診療科目をひとつ選ぶと、リストが絞られるだけでなく、地図の塗り分け・候補順位・マーカーの大きさがまとめてその科目基準で再計算される。選べる科目は 19 個で、科目ごとに見られる候補数は耳鼻咽喉科 7,807 か所から産婦人科 0 か所まで大きく異なる。アドレスは https://www.pilldoc.co.kr/PharmSite で、ログインなしで開く。
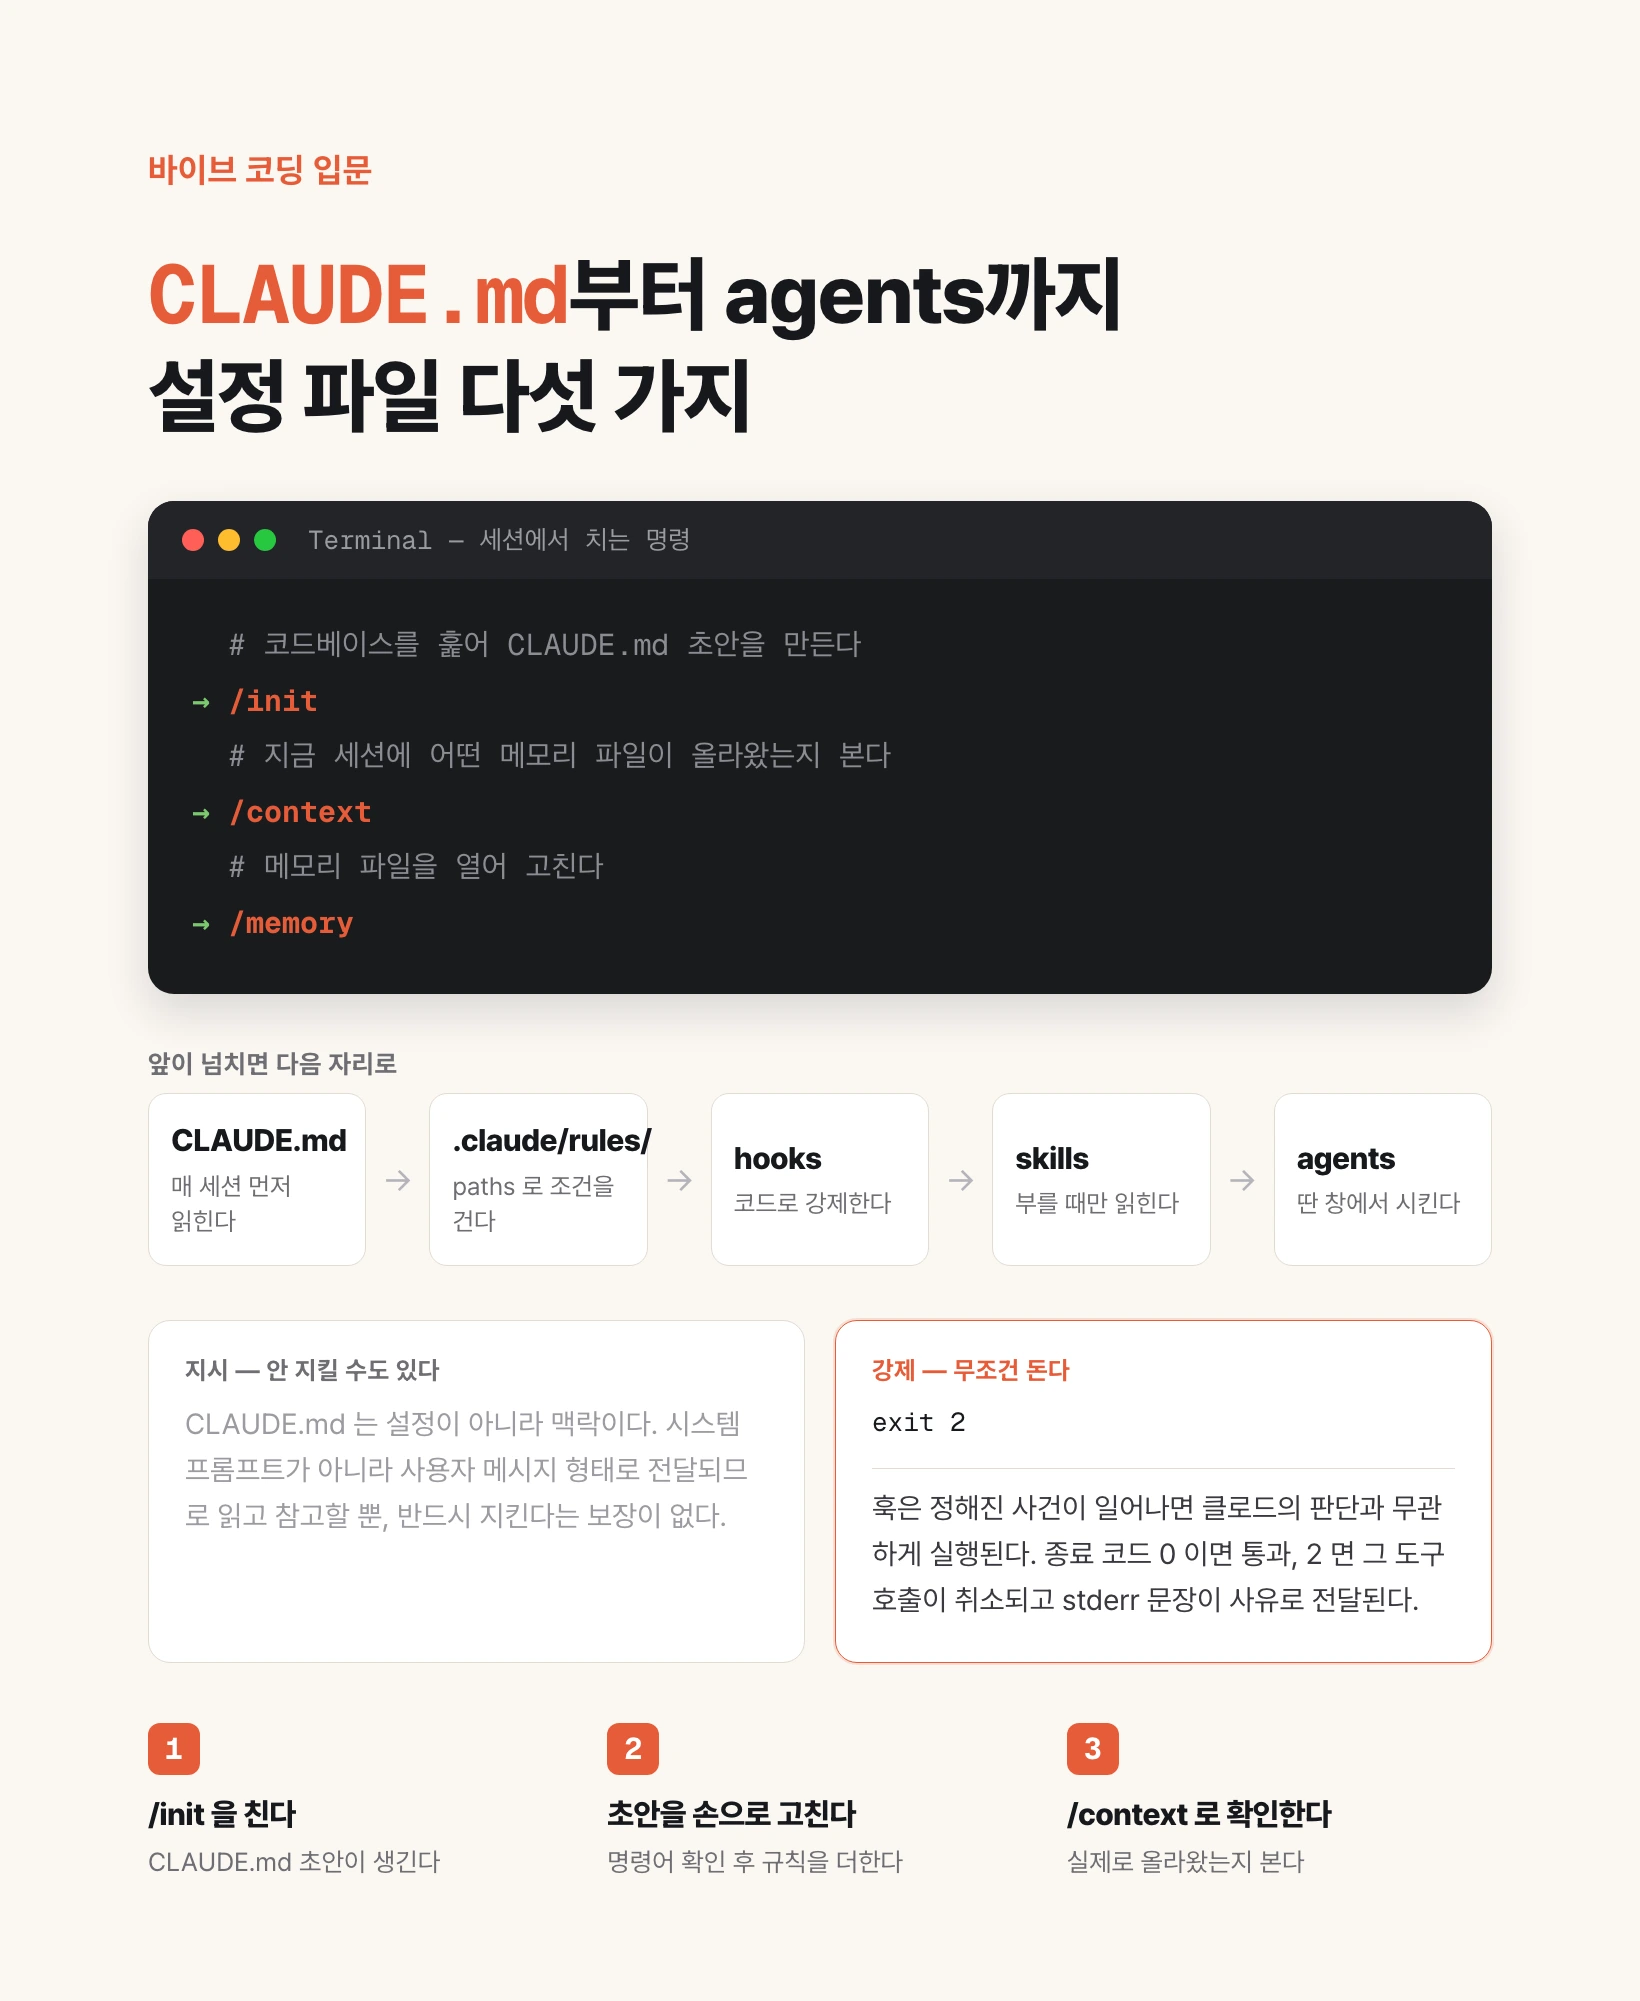
CLAUDE.md・Rules・Hooks・Skills・Agents — Claude Code の設定ファイル五種
Claude Code を自分のやり方に合わせる作業は、結局のところ五種類のファイルを置くことに尽きる。CLAUDE.md はセッションのたび最初に読まれるプロジェクト説明書、rules はその説明書が長くなったときに条件付きで分ける場所、hooks は指示ではなくコードで強制する仕組み、skills は繰り返す手順をスラッシュコマンドにしたもの、agents は別作業を別ウィンドウで進めて本対話を守る装置だ。この記事は五つそれぞれをどこにどんな形式で作るのか、そして手元の一文をどれに入れるのかまで順に扱う。
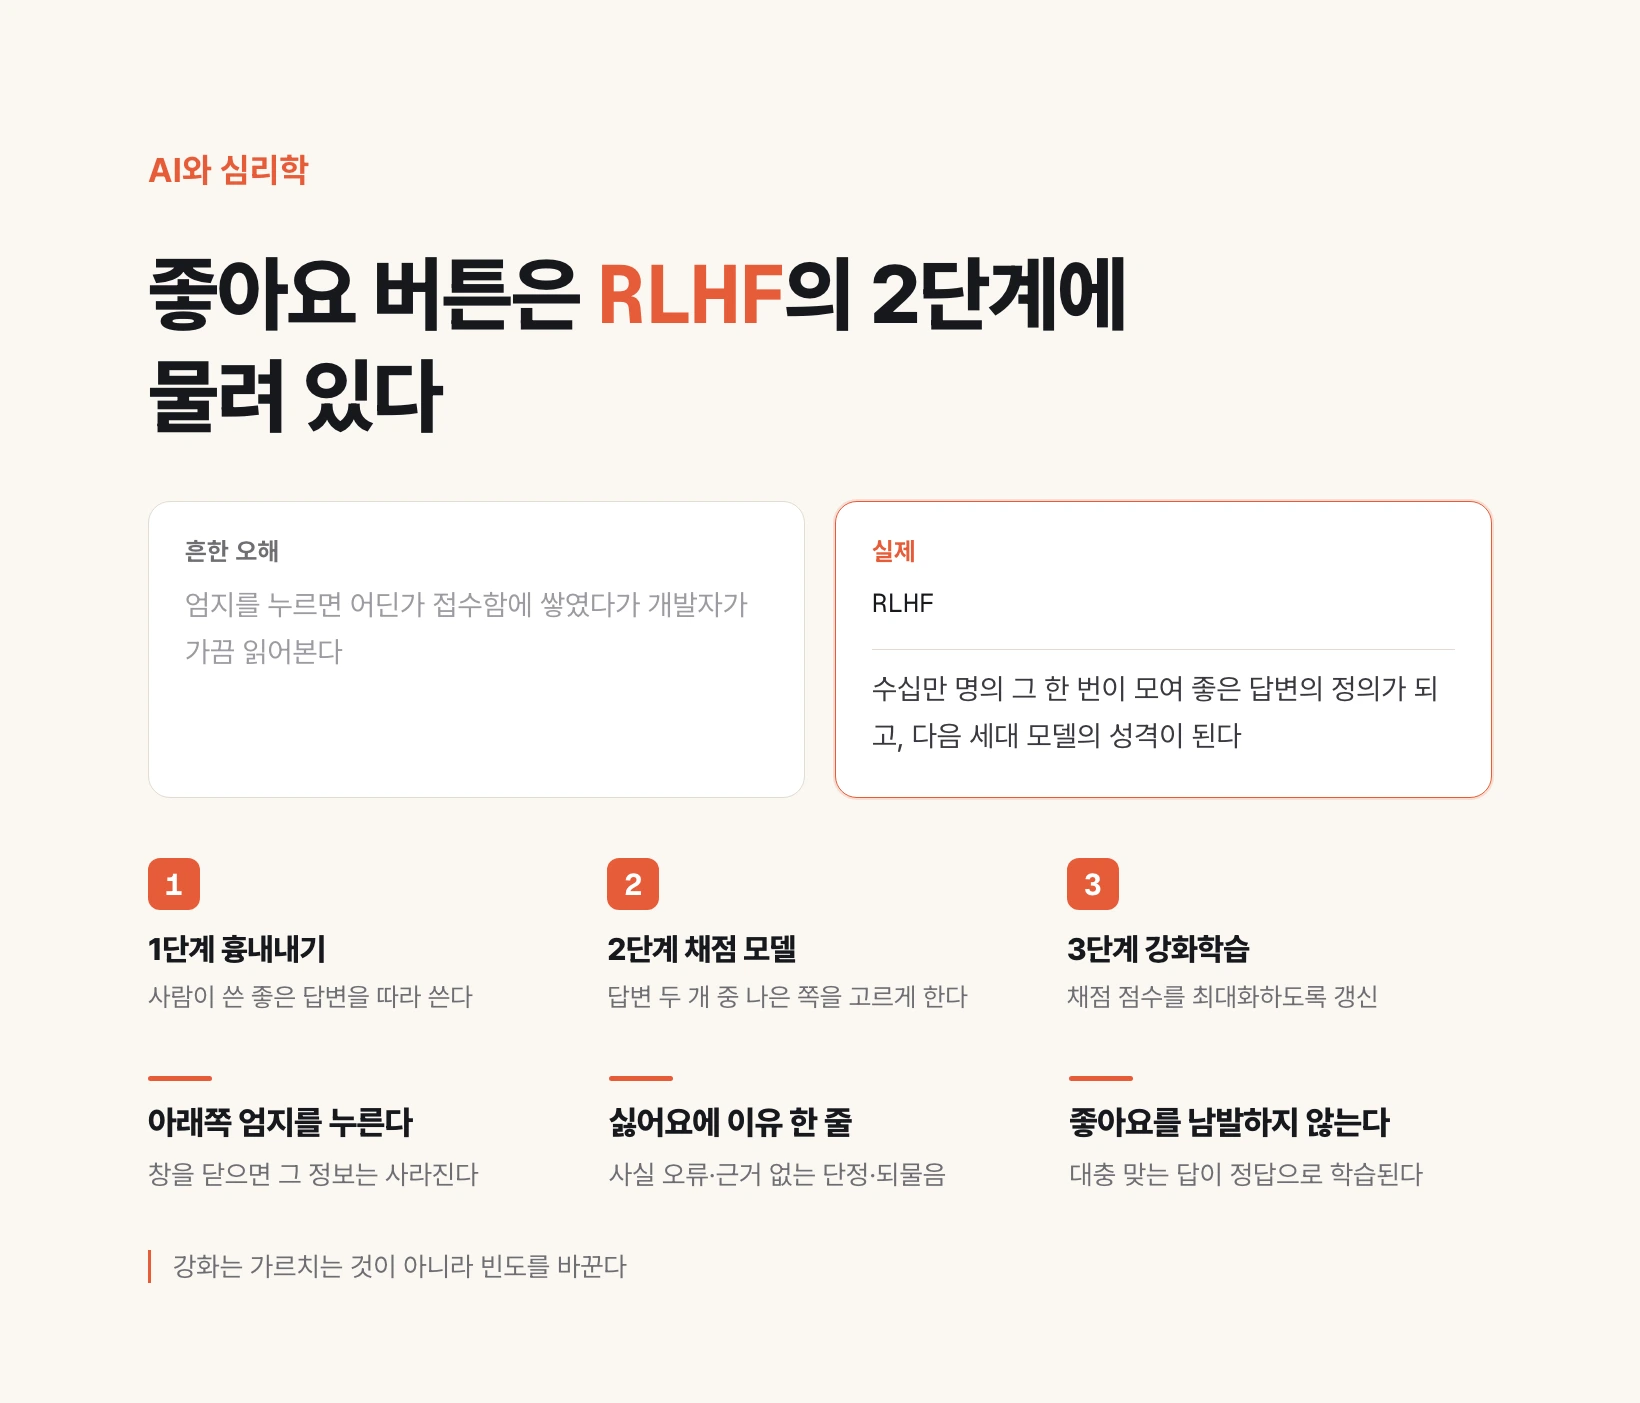
いいねボタンがAIを飼いならす — パブロフからRLHFまで
AIが人の口調や態度を覚える仕組みは新しい発明ではない。犬にベルを鳴らす19世紀の実験から始まり、1972年に予測とのズレという一つの原理に圧縮され、1997年にはその原理が実際の脳回路で見つかり、計算機に移されて2024年のチューリング賞を受けた。チャットの回答の下にあるいいねボタンは、その系譜の末端に付いた取っ手である。
診断レポートを先に送るアウトバウンドはどう作るのか
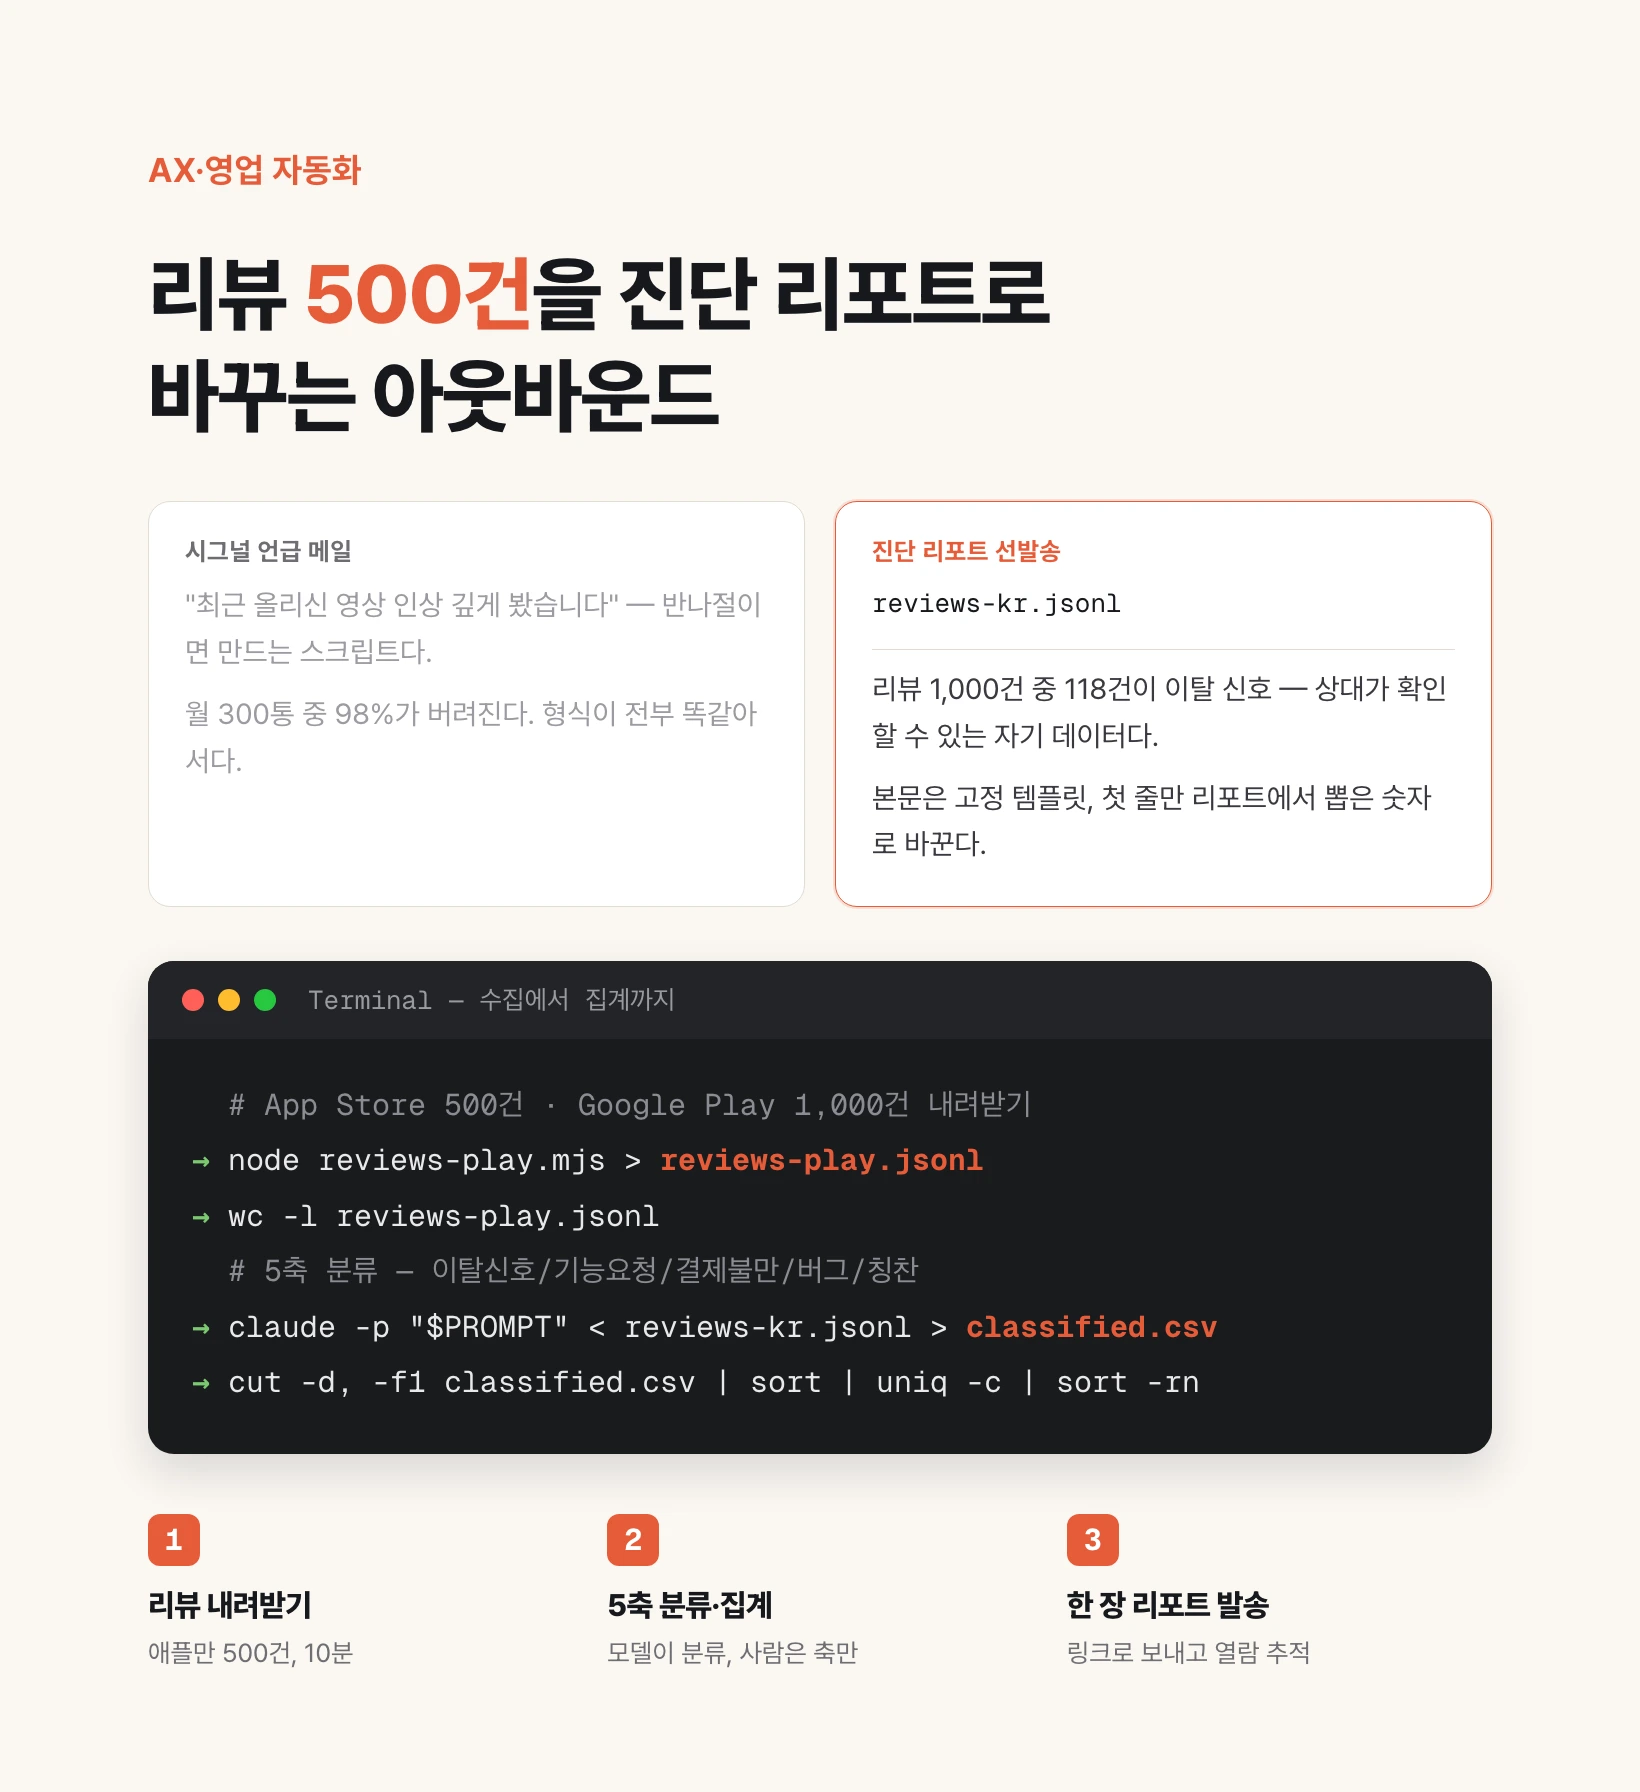
診断レポートを先に送るアウトバウンドとは、見込み客の公開データを集めてその会社だけの課題をまとめた文書を作り、売り込みの文句の代わりにその文書を最初の接触に添える方法だ。相手がアプリを出している会社なら、ストアのレビューが最も入手しやすい素材になる。アップルの公開レビューフィードは認証なしで一ストア一国あたり最大500件を返し、Google Play はオープンソースのパッケージで千件単位の収集ができる。そのレビューを離脱シグナル・機能要望・課金不満・不具合・称賛に分け、アプリのバージョンと並べて表にすればレポートが一本できる。メールは最初の一行だけ相手に合わせて変え、残りは固定テンプレートのままでいい。レポートが開かれたかを追跡すれば、返信がなくても次の会話を開く名分が残る。
novice — 非開発者向けの Claude Code プラグイン
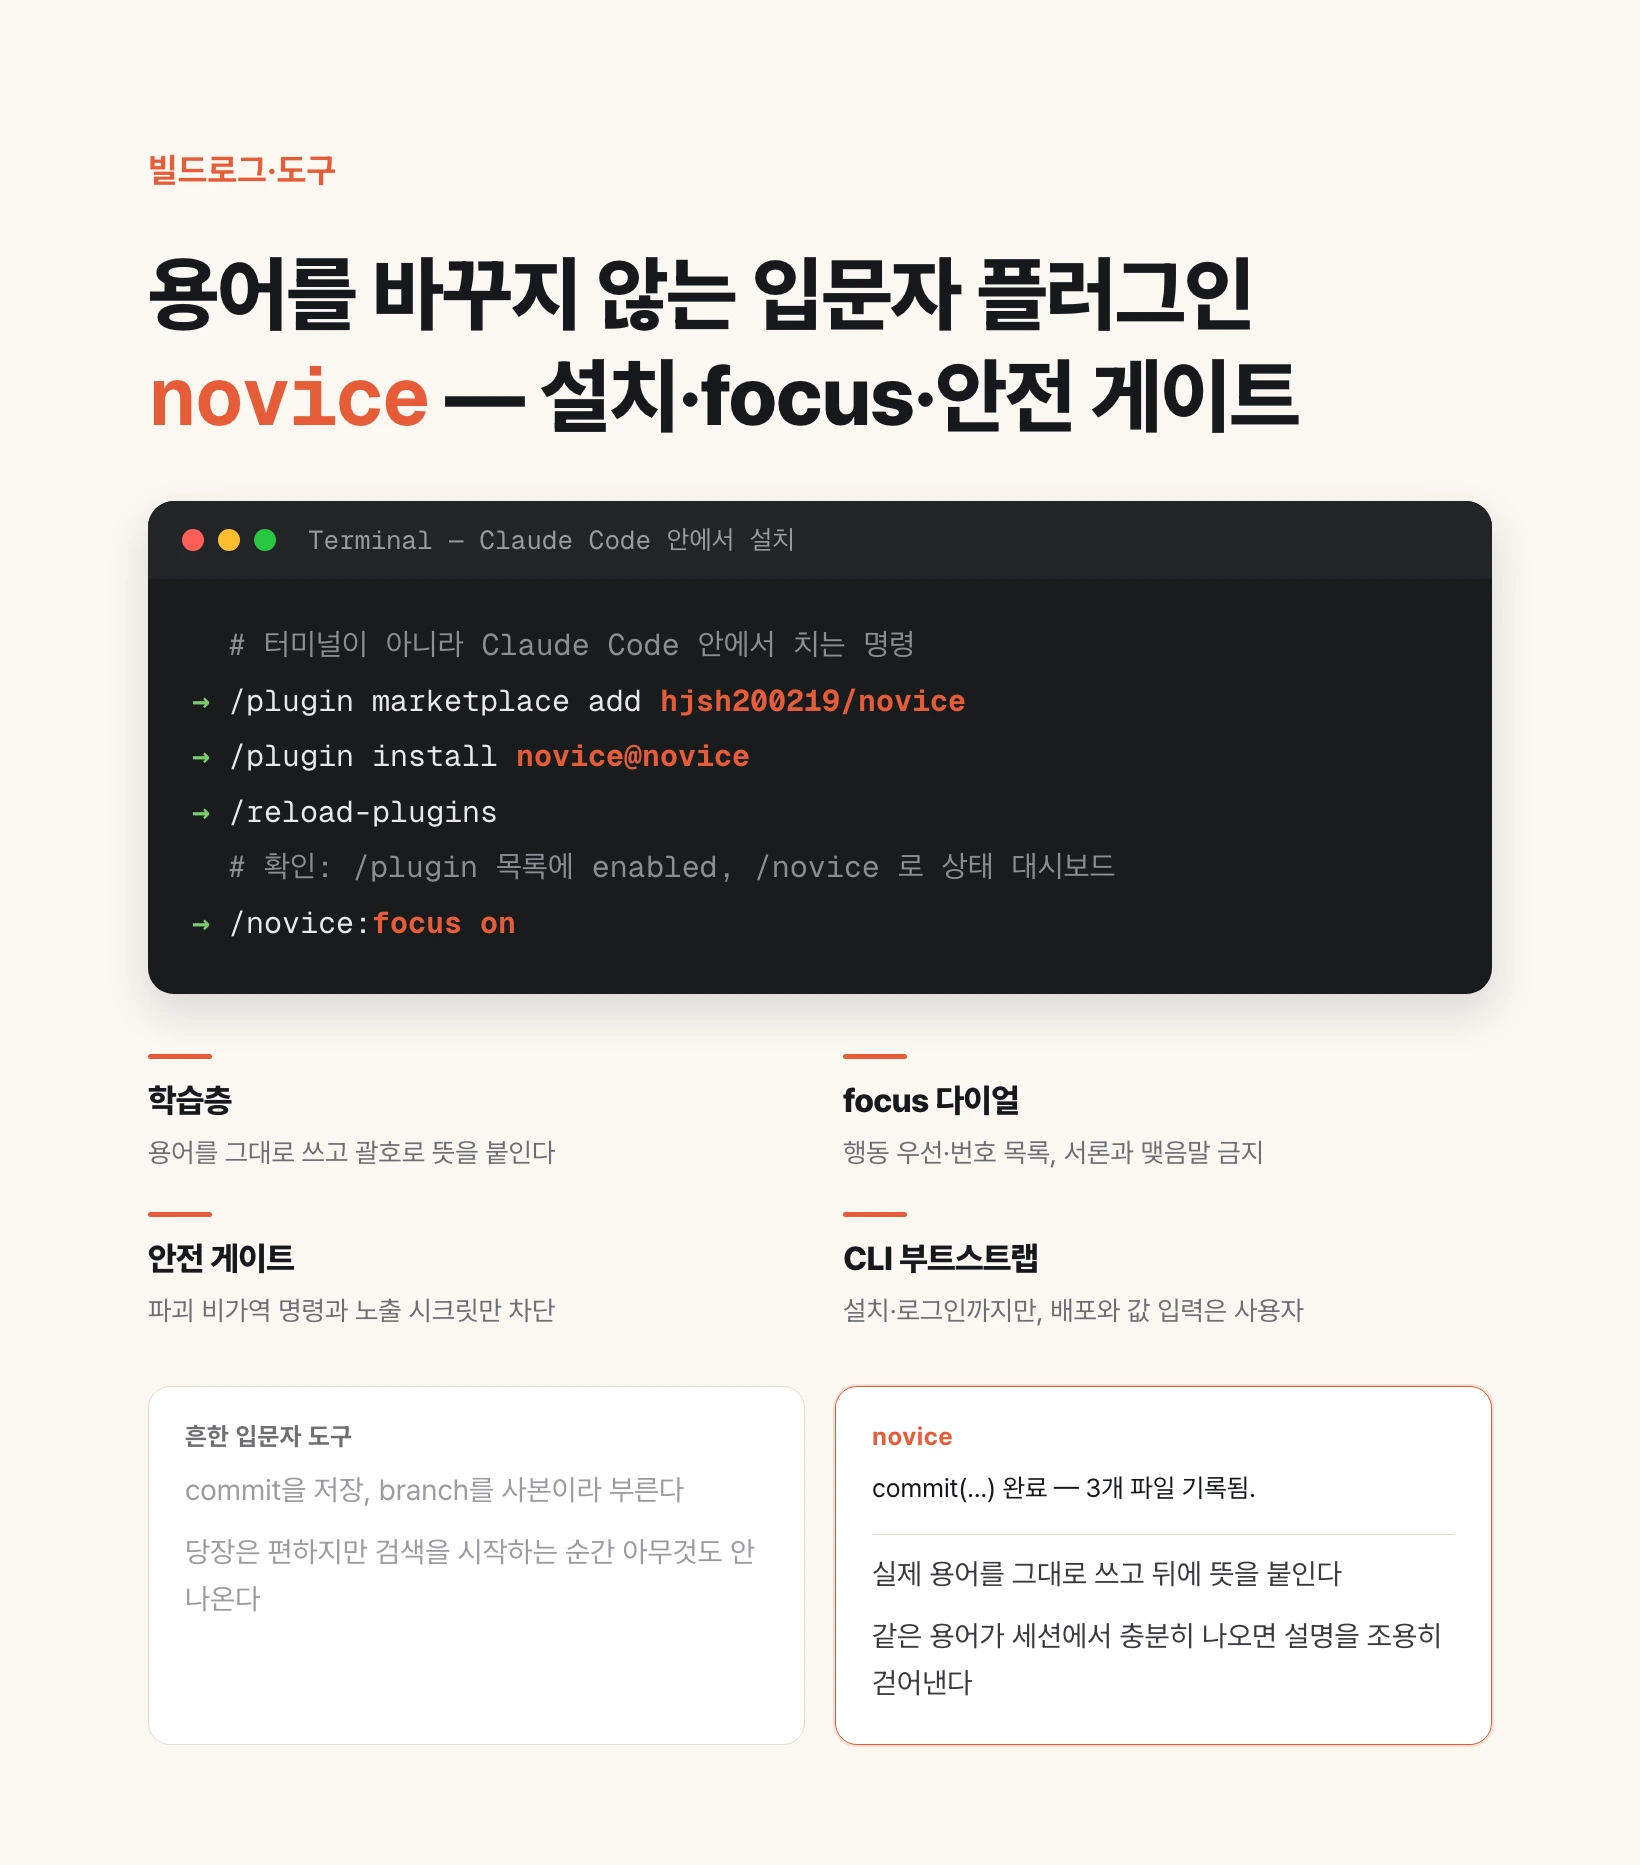
novice は、開発者ではない人が Claude Code でコーディングを始めるときに入れるプラグインだ。やることは三つある。第一に、開発用語をやさしい言葉に置き換えず、本物の用語をそのまま書いたうえで括弧に意味を添え、その用語がセッション内で十分に出たら説明を静かに外す。第二に、答えが長く正確なのにどこから手を付ければよいか分からないときに入れる focus というダイヤルがある。入れると回答が行動優先の番号付きリストに強制され、前置きも結びも消える。第三に、取り返しのつかない破壊的コマンドと露出した秘密情報だけを選んで止める安全ゲートが、プラグインが有効な間ずっと動く。外部サービスの CLI はインストールとログインまでを代わりに踏んでくれる。導入経路は二つで、Claude Code の中に marketplace として付けるか、npm パッケージ claude-novice を取るかだ。MIT、実行時の外部依存はゼロ、現在は 0.4.0 である。
YouTubeでAIを学ぶなら、どのチャンネルを見るべきか
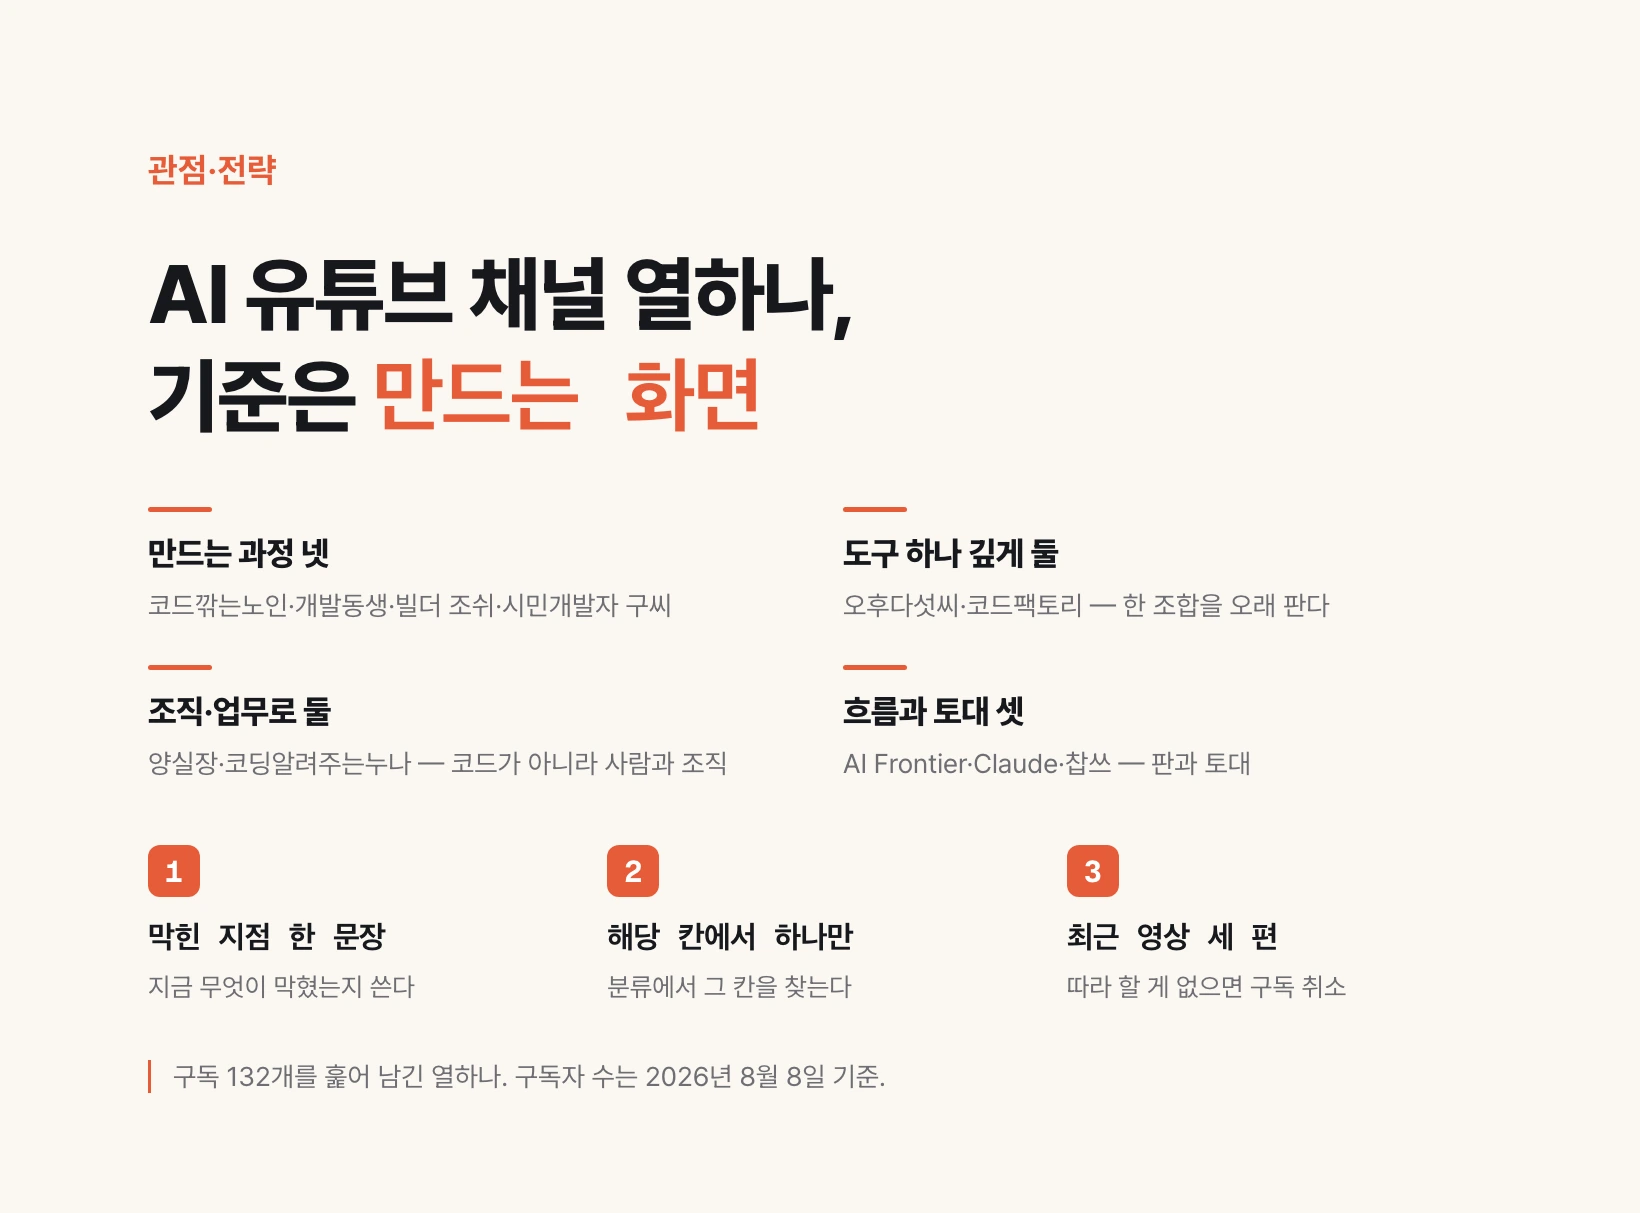
登録132件を見直し、実際にAIを学ぶのに使っている11チャンネルだけを残した。基準はひとつ——結果の要約ではなく、つくっている画面を見せているか。過程をそのまま見せる4つ、ひとつの道具を深掘りする2つ、組織と業務に移す2つ、流れを読む2つ、土台を固める1つに分け、URLとともにまとめる。
バイブコーディングに足りないのはコードではなく UI/UX の概念
AI は要件を画面に変えてくれる。だが何を畳んで何を残すかは決めてくれない。同じ地図画面を六日で整え直したときに実際に使った四つの原則——馴染みのあるものを真似る、並べずにまとめる、全部広げずに必要なときだけ出す、全項目に共通する事実は見出しが持つ。
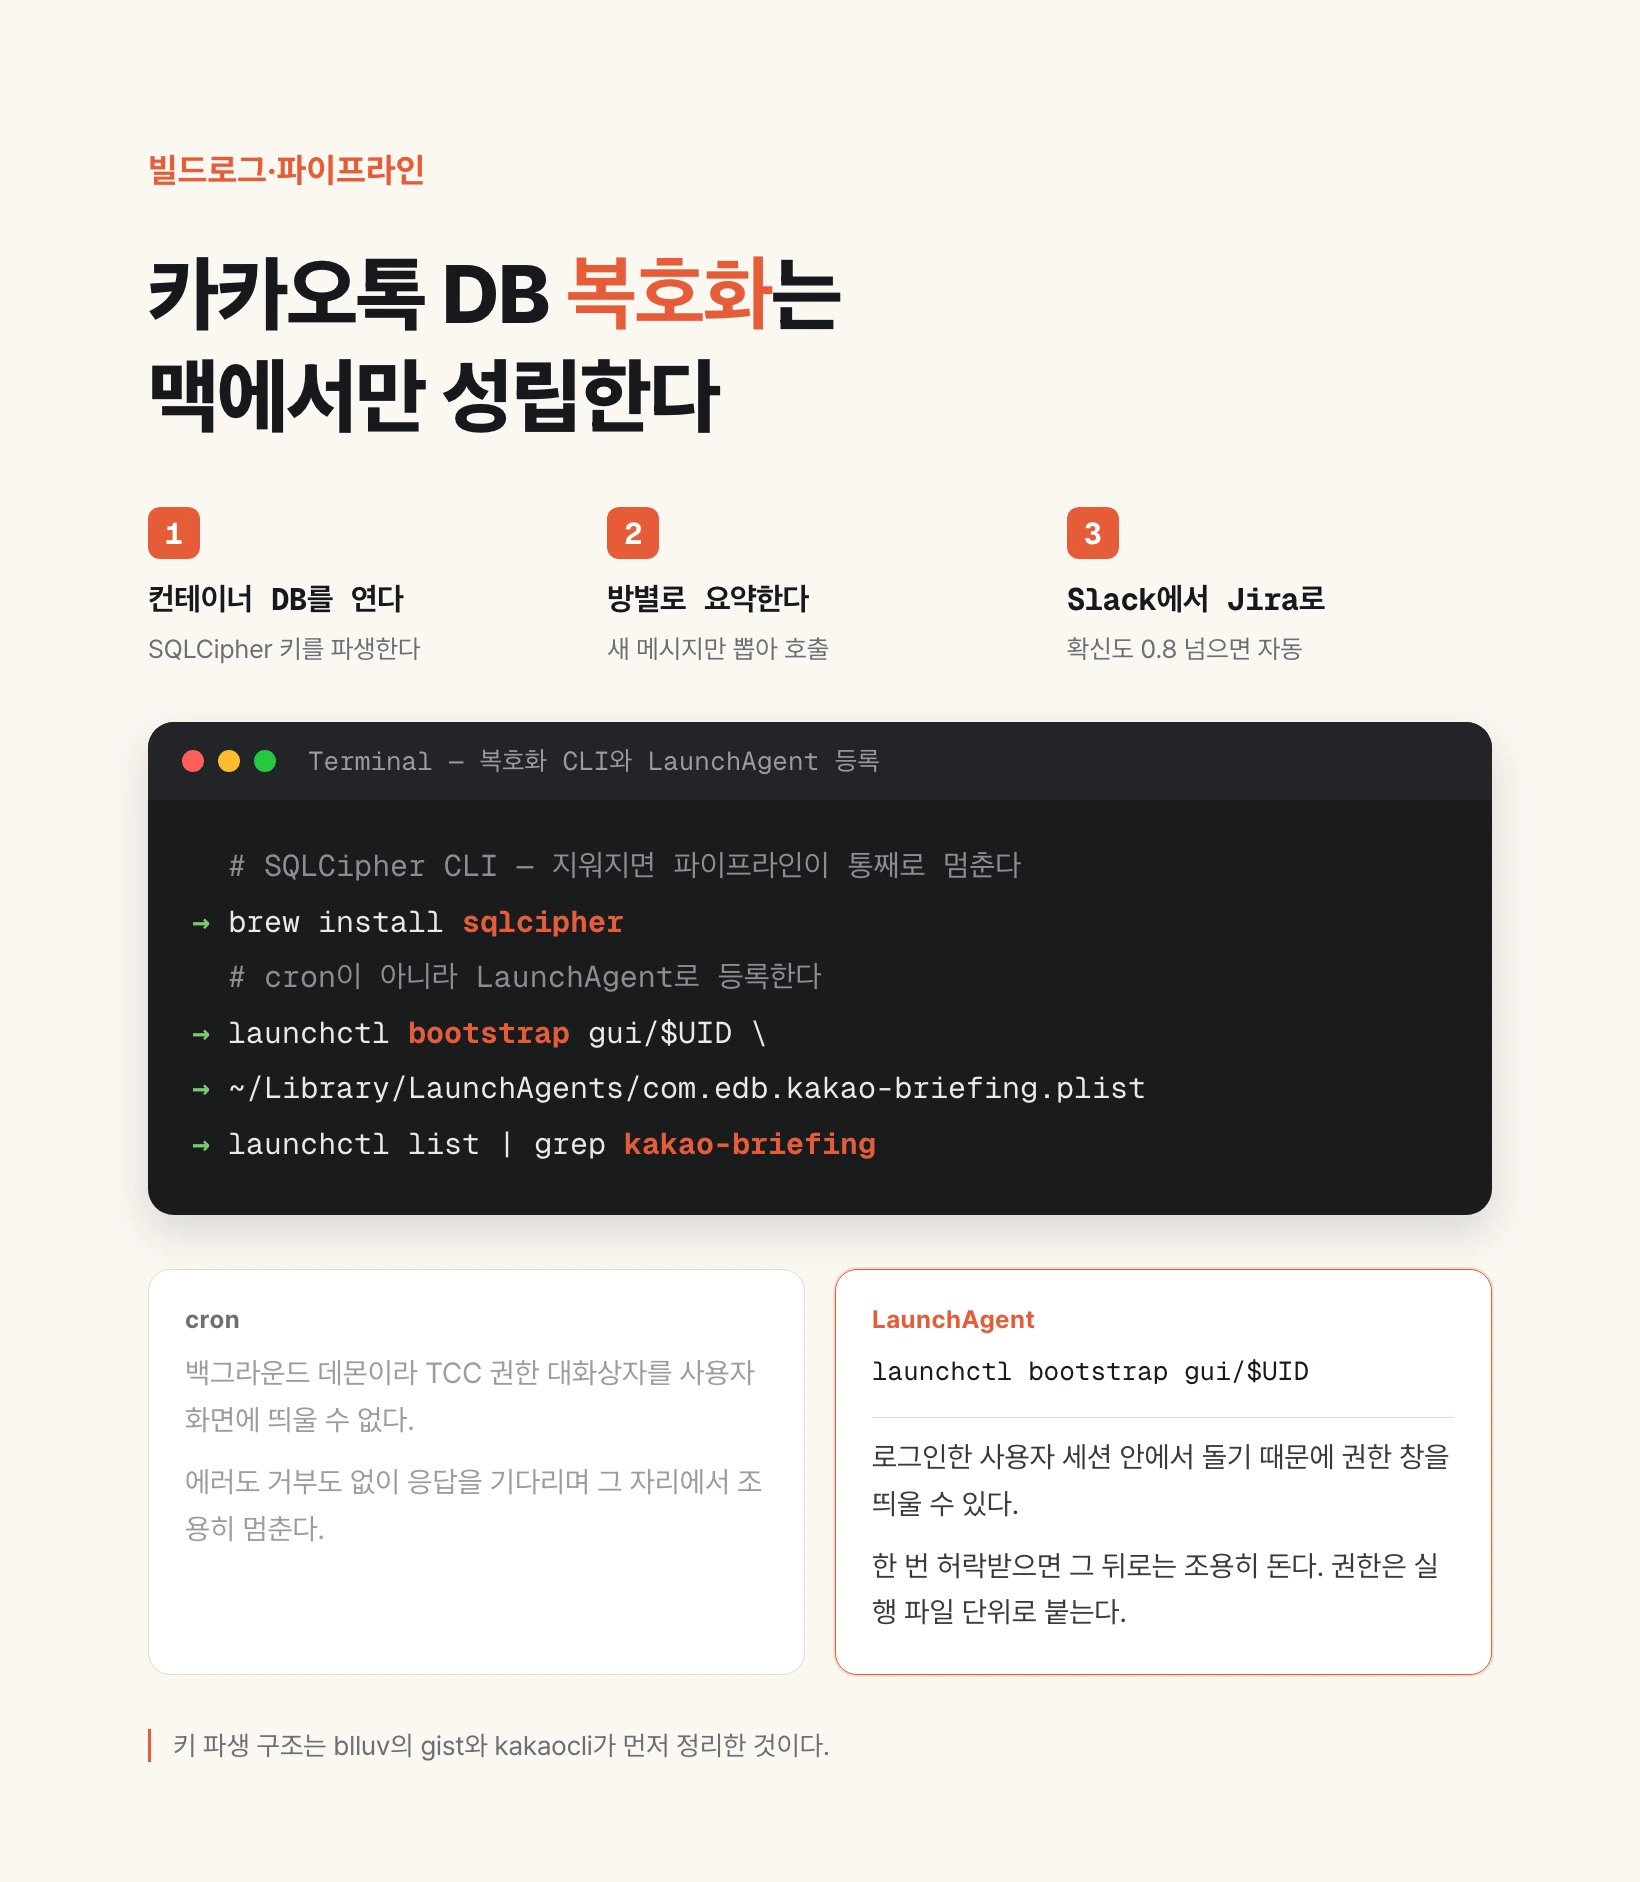
KakaoTalk のローカル DB をどう読むのか、そしてなぜ Mac でしかできないのか
KakaoTalk には、他のプログラムが会話を読み取るための公式 API がない。会話をコードで扱いたければ、Mac 版 KakaoTalk が自身のアプリコンテナに残しているデータベースファイルを直接開くしかない。このファイルは SQLCipher で丸ごと暗号化されており、鍵はこの Mac のハードウェア UUID と Kakao アカウントの内部番号から導出される。ハードウェア識別子の読み方も、アプリがファイルを置く場所も、そのフォルダを守る権限の仕組みもすべて macOS のものなので、このパイプラインは Mac でしか動かない。さらに cron では動かず、エラーではなく静かに停止する。最初の段さえ越えれば残りは平凡な作業で、ルームごとに新着だけを取り出し、ルーム単位で要約し、Slack に送り、Slack のボットがチケット本文を書いて Jira に登録する。
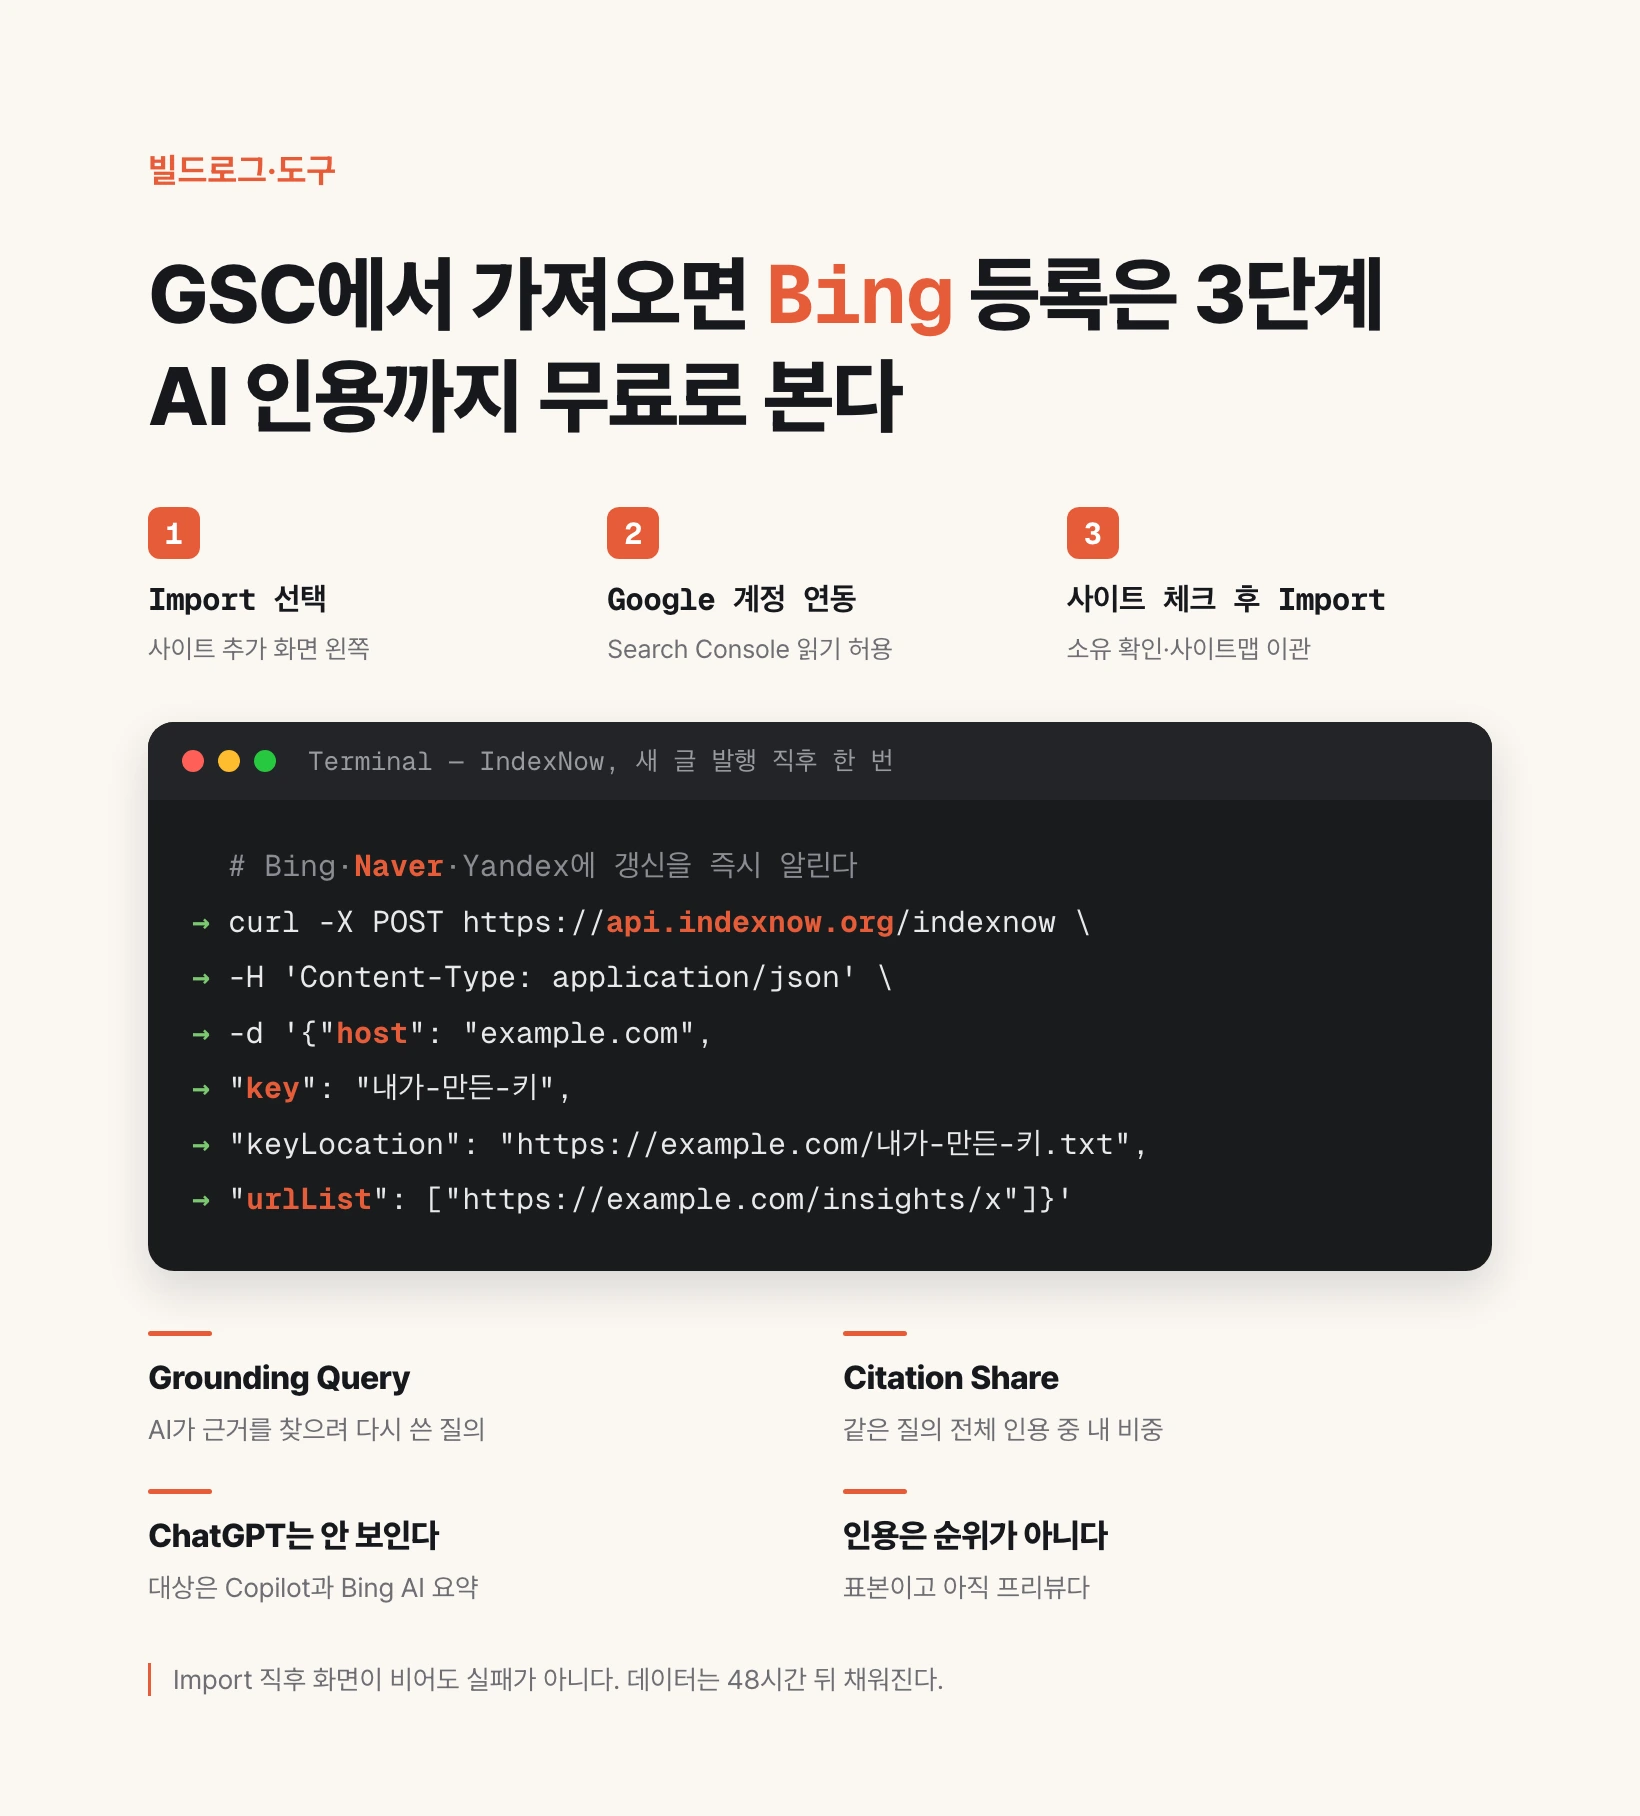
Bing Webmaster Tools — GSC からインポートして AI 引用を見る方法
Bing Webmaster Tools は Microsoft がサイト所有者に無料で提供するコンソールだ。Google Search Console(GSC) の Bing 版と考えればよく、インデックス状況、検索クエリ、サイトマップ、被リンクを表示し、URL を直接送信できる。すでに GSC を使っているなら登録は一手で済む。サイト追加画面で左側の Import を選び Google アカウントを連携すれば、GSC で所有権確認済みのサイトがサイトマップごと引き継がれ、メタタグや DNS レコードを触り直す必要がない。さらに 2026 年 2 月からは AI Performance レポートが加わり、Microsoft Copilot と Bing の AI 要約が自分のページを引用した回数を無料で見られる。
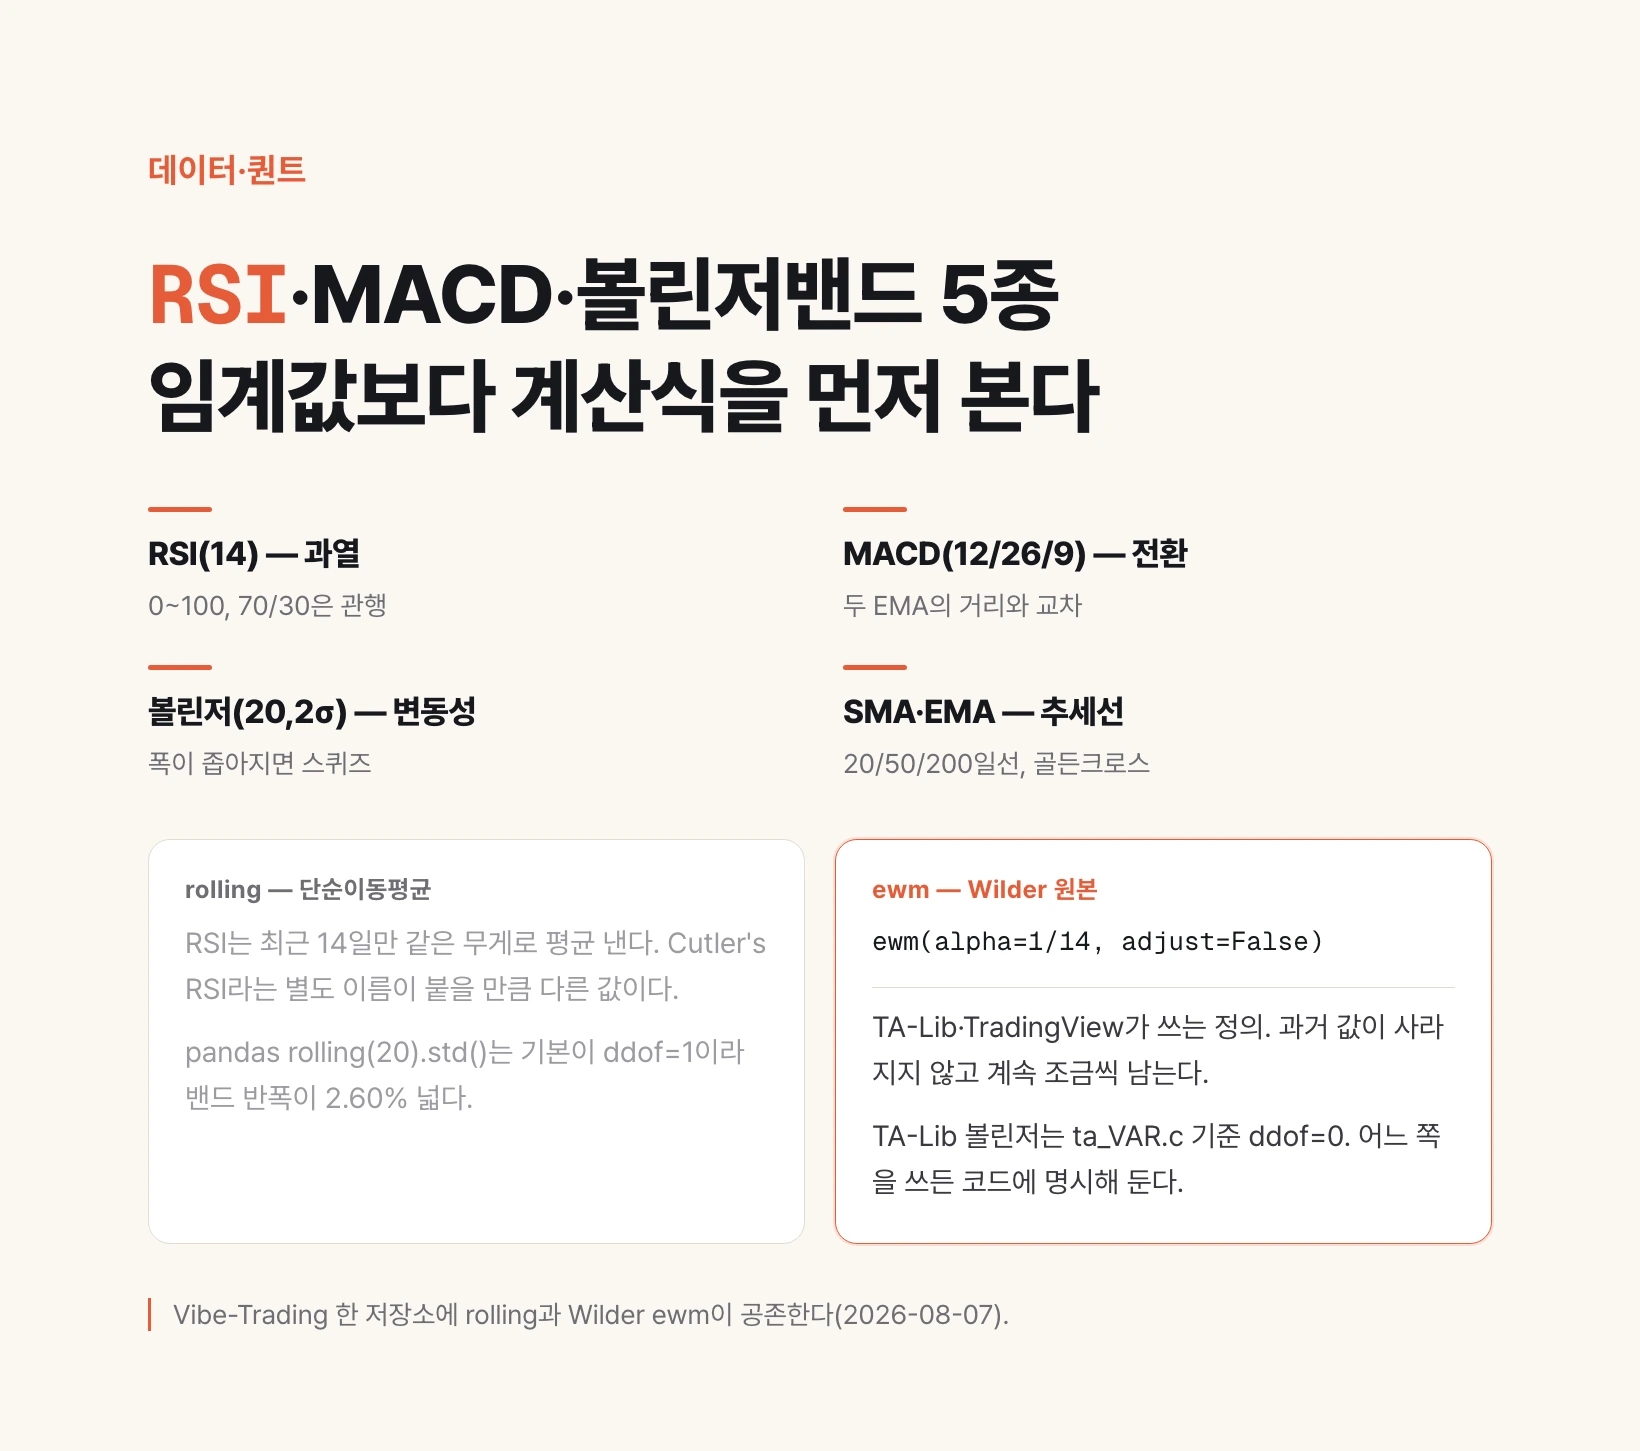
RSI・MACD・ボリンジャーバンド — クオンツエージェントが直接呼ぶ5つの指標
テクニカル指標とは、始値・高値・安値・終値・出来高という一次データからもう一段計算して得られる二次的な値である。種類は数百あるが、AIトレーディングエージェントが単一のツールで直接呼び出すのは RSI(14)・MACD(12/26/9)・ボリンジャーバンド(20, 2σ)・SMA(20/50/200)・EMA(20) のちょうど5つで、これらが過熱・トレンド転換・ボラティリティ・長期トレンドを覆う。ただし同じ名前が同じ数字を意味するとは限らない。RSI は平滑化を Wilder 方式(ewm alpha=1/14)で行うか単純移動平均(rolling 14)で行うかで、ボリンジャーバンドは標準偏差を ddof=1 で測るか ddof=0 で測るかで値が分かれる。指標を組み込む前に確認すべきなのは閾値ではなく計算式である。
Creem — Toss も Stripe も通らないときの決済
Creem は販売主体をプラットフォーム側が肩代わりする Merchant of Record(MoR)型の決済サービスだ。顧客は法的には自分ではなく Creem から購入し、その代わりに Creem が 190 以上の税務管轄における税額計算・徴収・納付と、返金・チャージバックの処理を負う。手数料は成功した決済ごとに 3.9% + 0.40 ドルで、月額費用も初期費用もない。商品を作って得られる product ID をコードに入れれば決済画面が開き、決済が終わると添付したファイルが購入者へ自動で届く。コードを一切書かず、決済リンクを共有するだけでも販売は始められる。
PillDoc 薬局立地 — ソウルの医院・薬局の場所を地図で読む方法
薬局立地は PillDoc が公開した閲覧専用の地図画面です。ソウルで医院が新たに開業しうる場所と、薬局が新たに開局しうる場所を100点満点で採点し、地図上に示します。https://www.pilldoc.co.kr/PharmSite でログインなしに開き、場所をひとつ選ぶと想定処方流入・月間調剤売上・周辺の競合薬局まで表示されます。ただし画面上のすべての金額と件数は実績ではなくモデルによる推定値です。
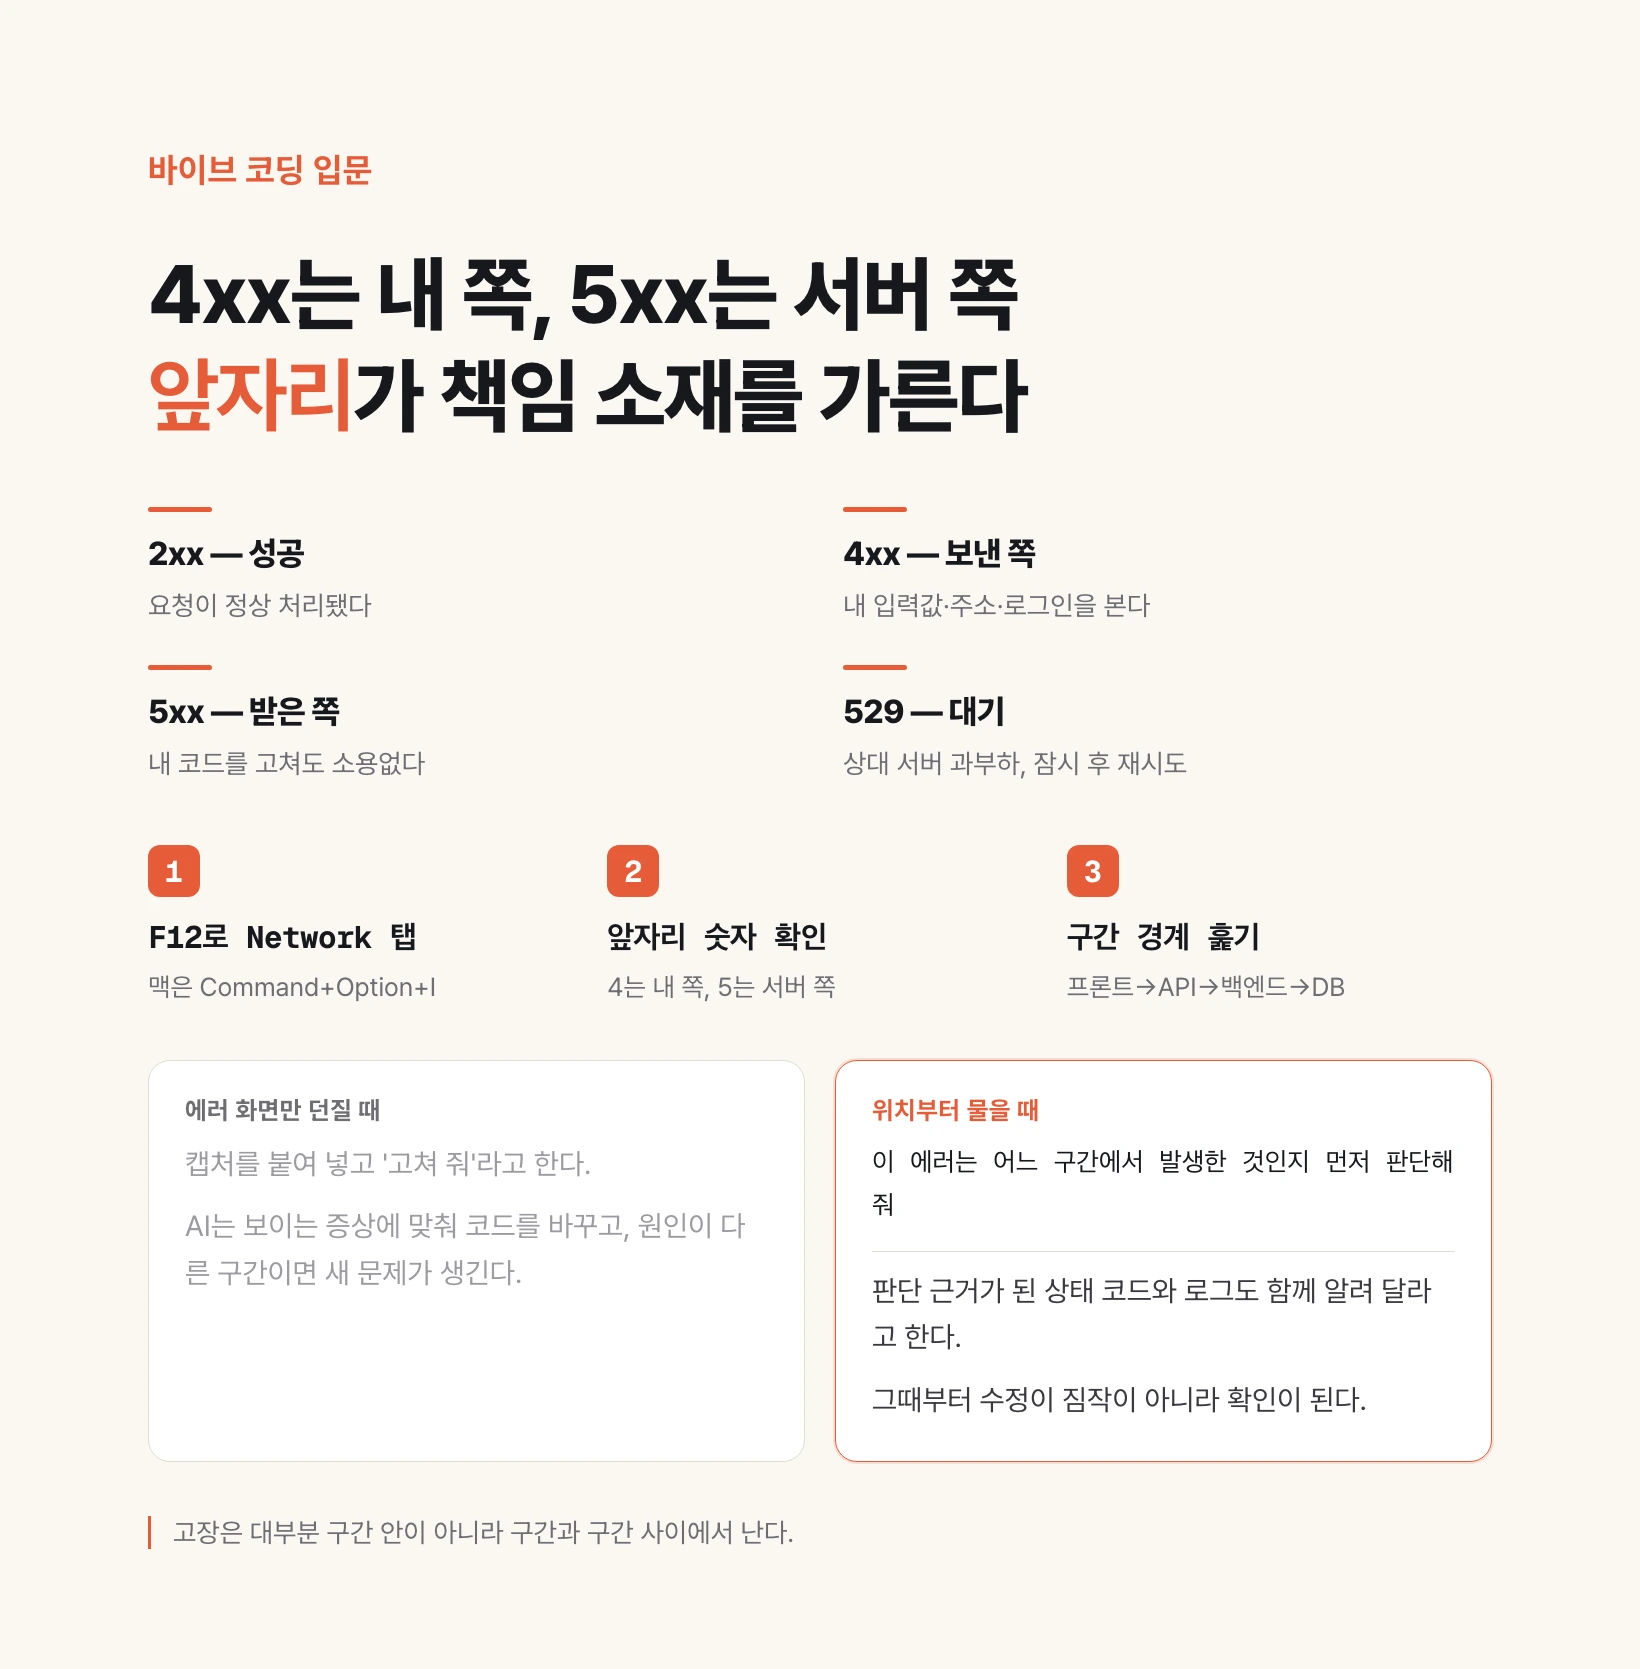
4xx と 5xx — エラーが出たらどこを見るか
エラーコードの先頭一桁で責任の所在が分かれる。2 で始まれば成功、4 で始まればリクエストを送った側(フロントエンドや入力値)の問題、5 で始まればそれを受け取ったサーバー側の問題だ。ステータスコードはブラウザで F12(Mac は Command+Option+I)を押して開発者ツールを開き、Network タブで失敗したリクエストをクリックすれば見える。先頭一桁で方向を定めたら、リクエストが通る区間(フロントエンド → API → バックエンド → データベース)を順にたどり、どの境界で切れたかを絞り込む。不具合は区間の内側より区間と区間のあいだで起きることが多いからだ。この二段階を知っていれば、AI に「直して」と当てもの問答をする代わりに「このエラーはどの区間で起きたのか」と聞ける。そこから先、修正は推測ではなく確認になる。
OfficeCLI — Excel・Word・PowerPoint の残業を終わらせる CLI
OfficeCLI は、AI エージェントや開発者がコマンド一行、あるいは自然言語一言で Word・Excel・PowerPoint ファイルを作成・読み取り・編集できるオープンソース CLI だ。Microsoft Office のインストール不要で単一の実行ファイルとして動き、他の自動化手段と違うのは、作った文書を自分でレンダリングして「見て」から直す点にある。
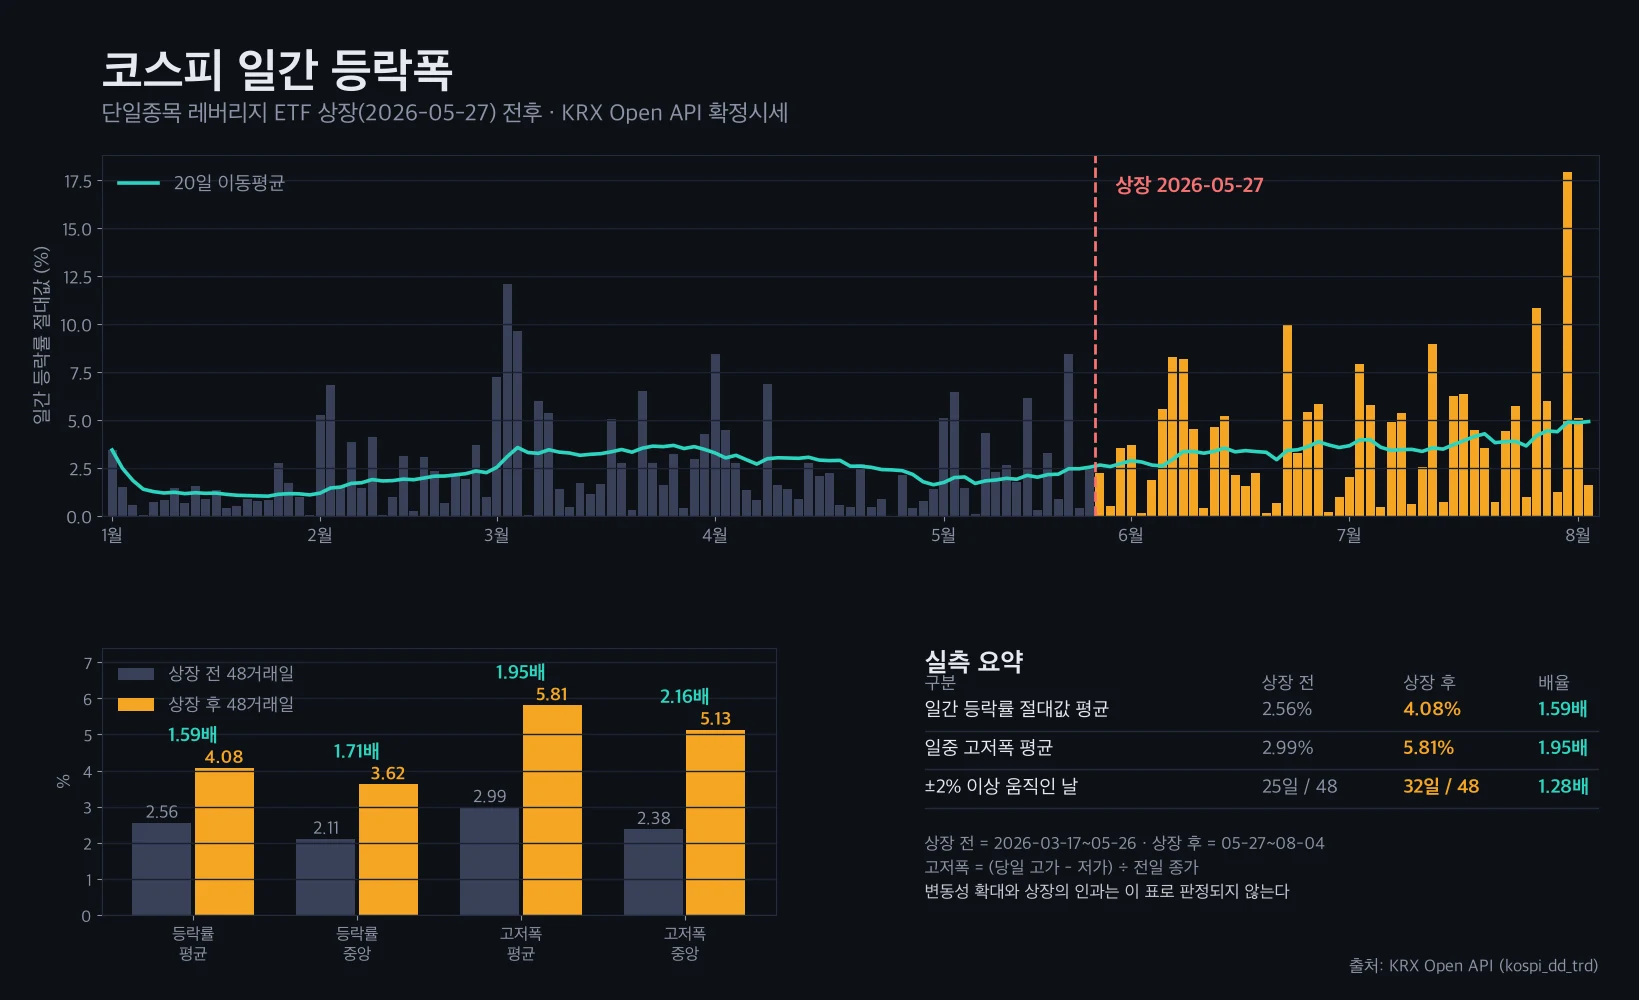
KRX Open API — KOSPI の日次騰落幅を自分で測る
KRX Open API は韓国取引所が openapi.krx.co.kr で提供する公開データサービスだ。認証キーを AUTH_KEY ヘッダーに入れ、基準日を basDd で一つ渡すと、その日の始値・高値・安値・終値が json で返る。申請は画面表記どおり四段階で、会員登録と認証キー申請、サービス一覧から API を探す、利用申請、承認後に開始という順だ。ここで多くの人が一度つまずく。認証キーの承認とサービス利用申請の承認が別段階のため、鍵だけ受け取って呼ぶとすべて 401 になる。この鍵があれば、標準ライブラリだけの Python 30行で任意期間の平均・中央値・極端日の数が出る。単一銘柄レバレッジ ETF が上場した 2026年5月27日を境に測ると、前後 48営業日で日次騰落率絶対値の平均が 2.56% から 4.08% へ、日中高安幅の平均が 2.99% から 5.81% へ増えた。ただし数字が大きくなったことと、何によって大きくなったかは別の問いであり、後者はこのデータでは判定できない。
ralplan の三つのエージェント — Planner・Architect・Critic
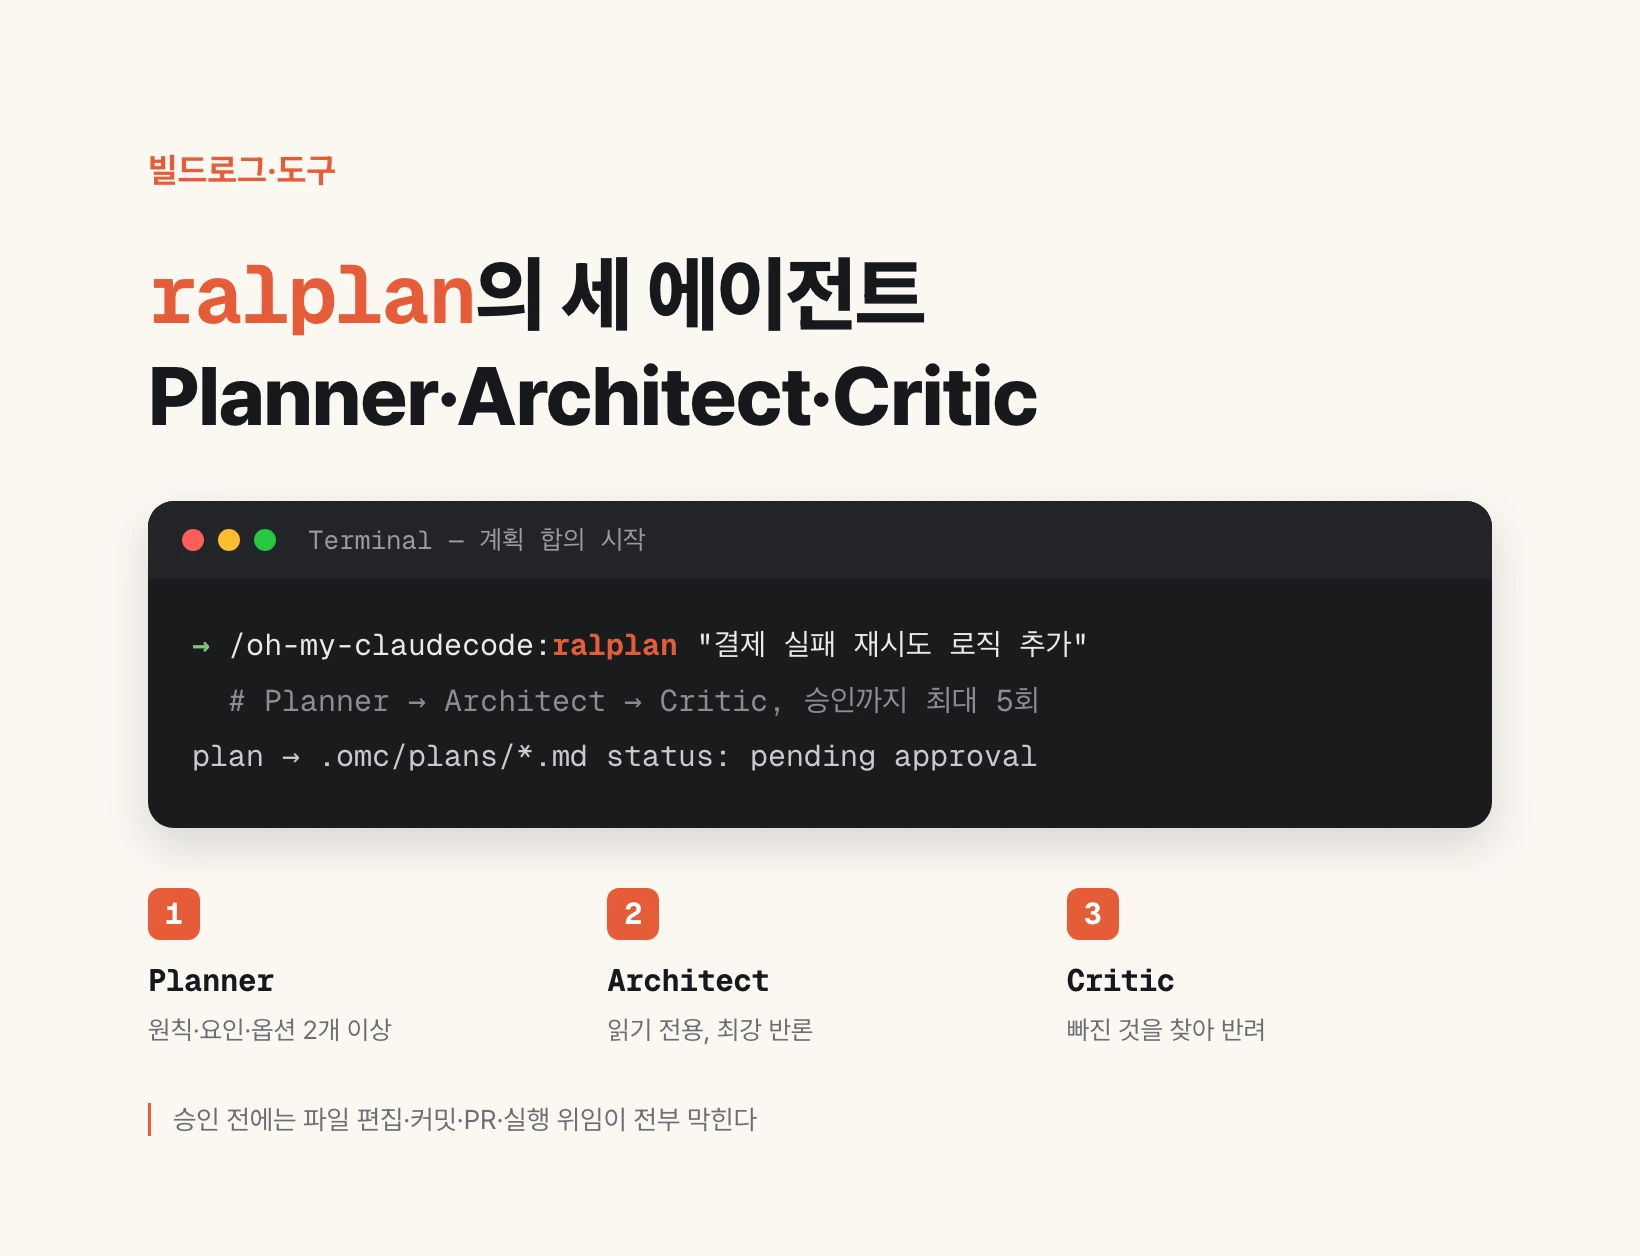
ralplan はオープンソースのハーネス oh-my-claudecode(OMC)に含まれる合意形成型のプランニングワークフローだ。ターミナルで /oh-my-claudecode:ralplan "タスクの説明" と打つと、コードより先に三つのエージェントが動く。Planner は原則 3〜5 個、決定要因 3 個、実行可能な選択肢を最低二つ含む計画を書くよう形式で縛られる。Architect は Write と Edit が完全に塞がれた状態で審査し、最も強い反論だけを出す。Critic は書かれた内容を採点するのではなく、書かれていないものを探し、承認・差し戻し・却下のいずれかを判定する。三者は必ずこの順で動き、差し戻されると Planner が修正したうえで Architect から再開する。この往復は最大五回。その間、計画は pending approval のまま留まり、ファイル編集・コミット・PR・実行の委譲がすべて塞がれる。導入は一行で済む — /plugin install oh-my-claudecode または npm i -g oh-my-claude-sisyphus@latest のあとに /oh-my-claudecode:omc-setup を一度実行するだけだ。
OpenClaw と Hermes ——どちらを入れるべきか
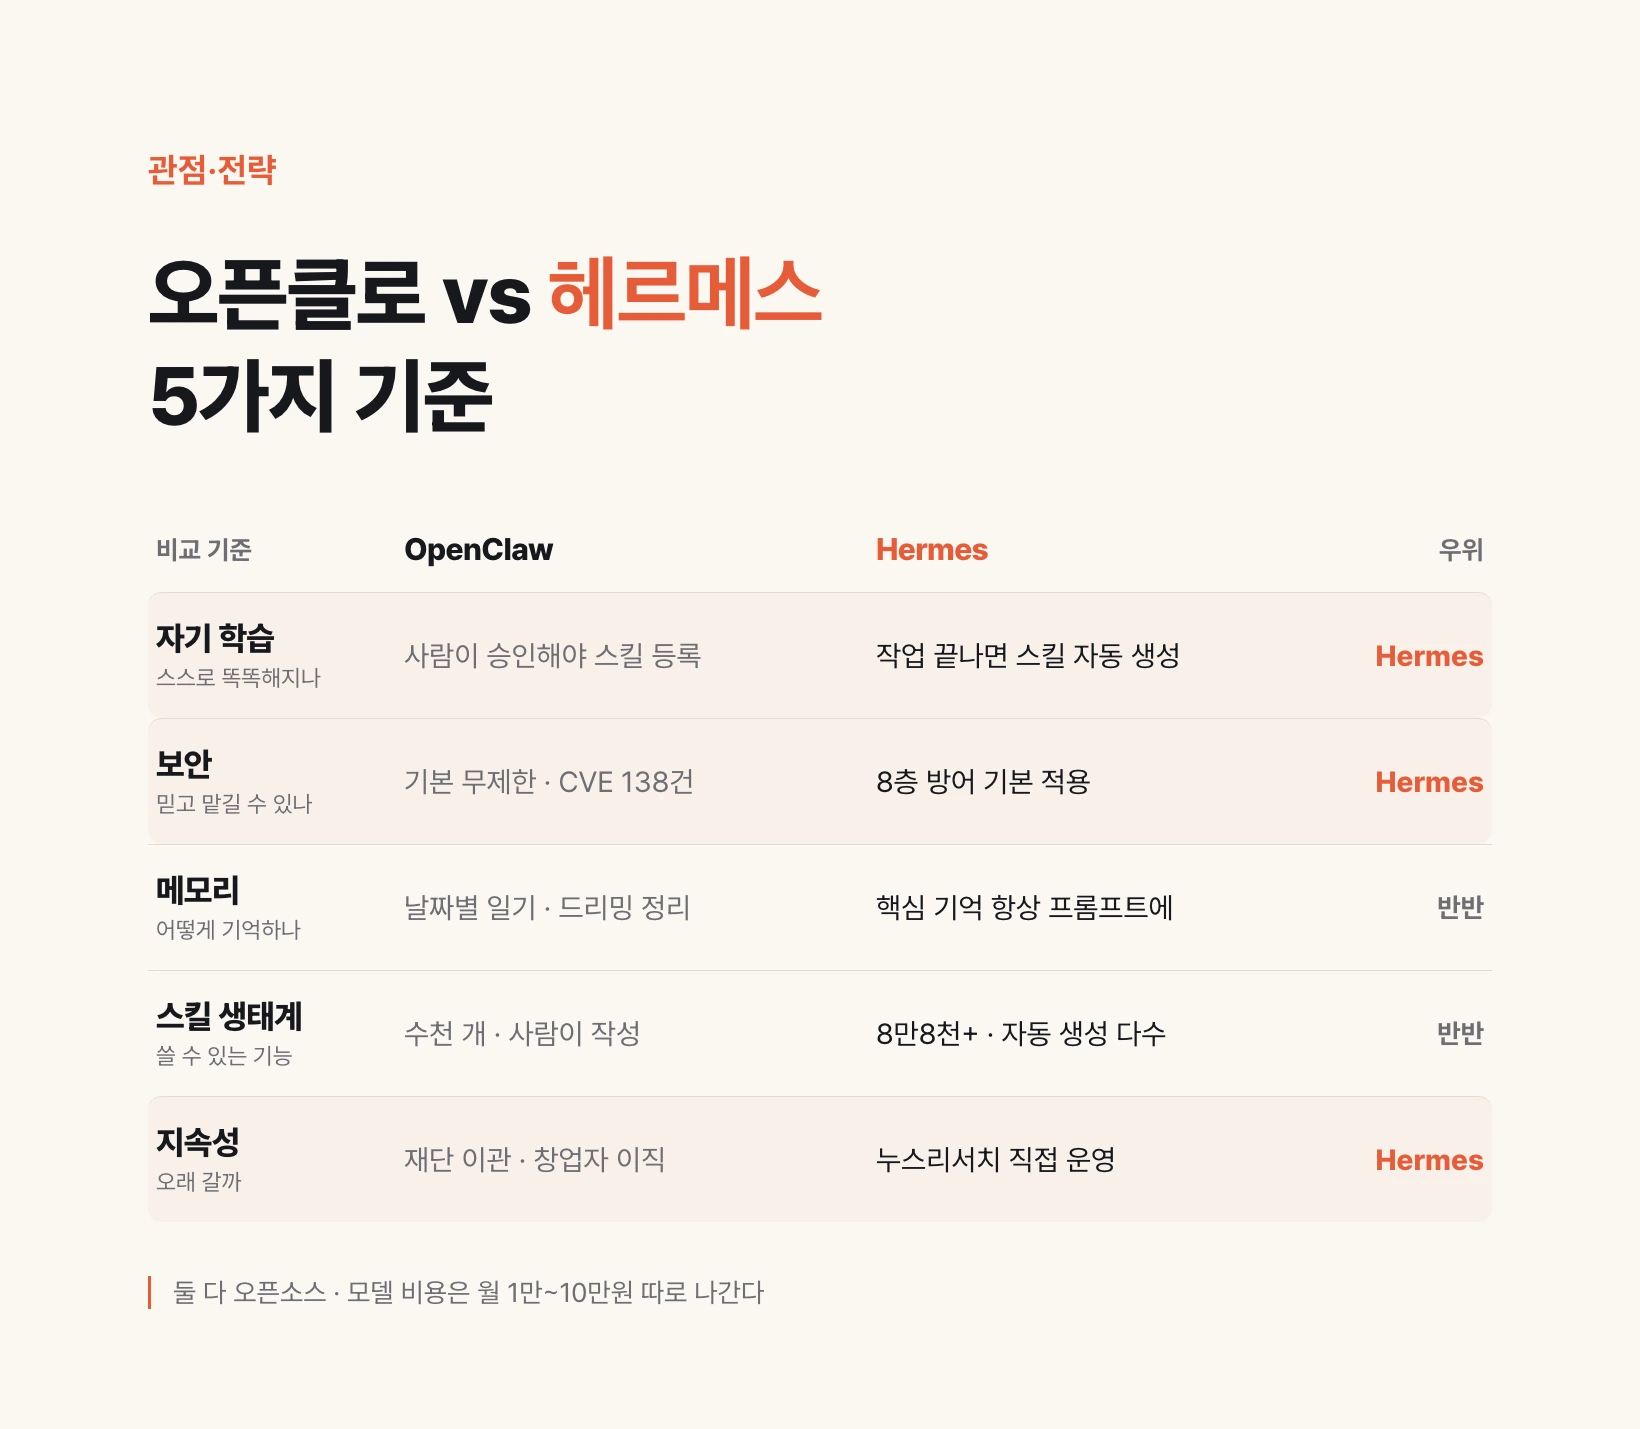
OpenClaw と Hermes はどちらもオープンソースの AI アシスタントで、Telegram や Slack で指示すると自分のパソコン上でファイルを作りコードを書く。できることはほぼ同じで、実際に差が出るのは自己学習・セキュリティ・メモリ・スキル生態系・継続性の五点だ。このうち自己学習とセキュリティは Hermes が優位、メモリとスキル生態系はどちらも譲らない。一人で働きセキュリティを重視するなら Hermes、自分で組み立てる楽しさとチームの記録の透明性を重視するなら OpenClaw だ。
Buzz — すでに入っている CLI で AI エージェントのチームを動かす
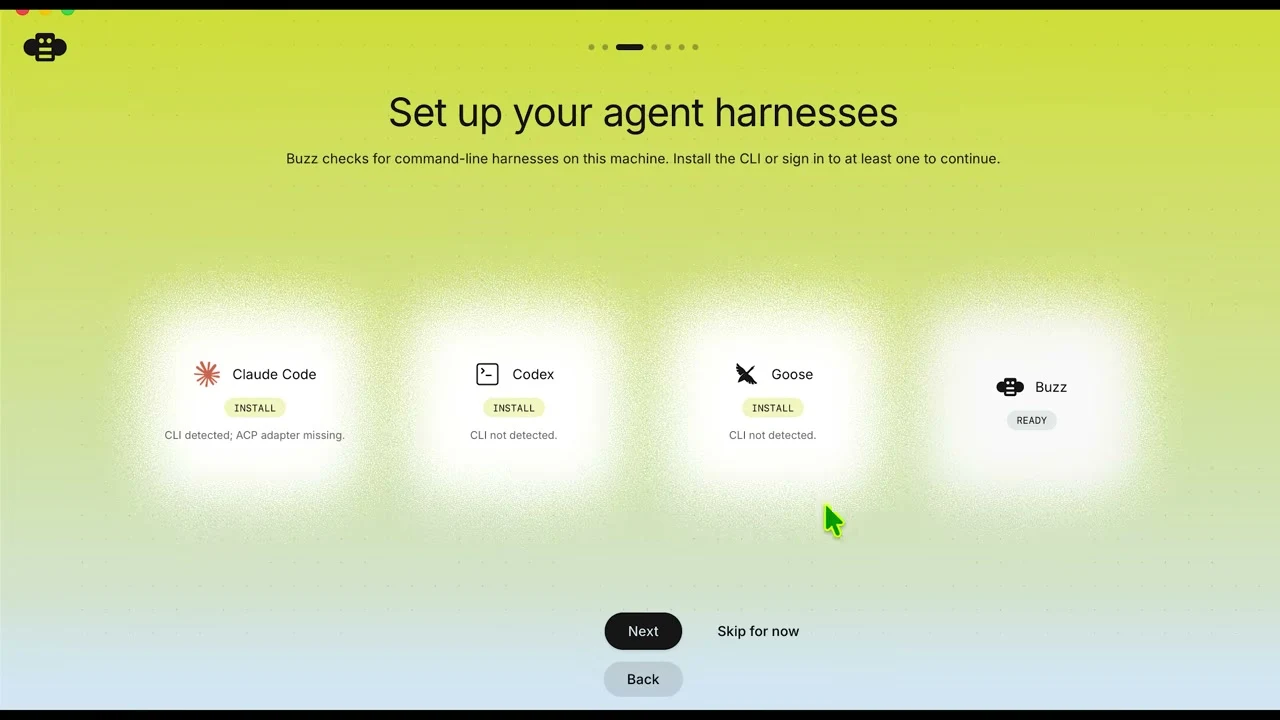
Buzz は Block(ジャック・ドーシーが創業した会社)が 2026 年 7 月に公開したオープンソースのコラボアプリで、人と AI エージェントが同じチャンネルで一緒に働く。見た目はほぼ Slack だが、決定的に違う点がひとつある — モデルの API を課金で呼ぶのではなく、自分のマシンにすでに入ってログイン済みの Claude Code・Codex・goose といったコマンドラインツールをそのまま接続して使う。だから、いま払っているサブスクの中で複数のエージェントを同時に動かせる代わりに、そのマシンを起動したままにしておく必要がある。始める手順は六つ — デスクトップアプリを入れ、身元鍵(秘密鍵)を作って保管し、「Set up your agent harnesses」で使う CLI を接続し、コミュニティを作り、名前・指示文・モデルを決めてエージェントを作り、チャンネルを作って招待し @名前 で指示する。エージェント同士は同じチャンネルを読み書きして仕事を渡し合い、その一つひとつのコマンドは実行前に承認を求めてくる。
i-have-adhd — AIの回答から前置きを消すプラグイン
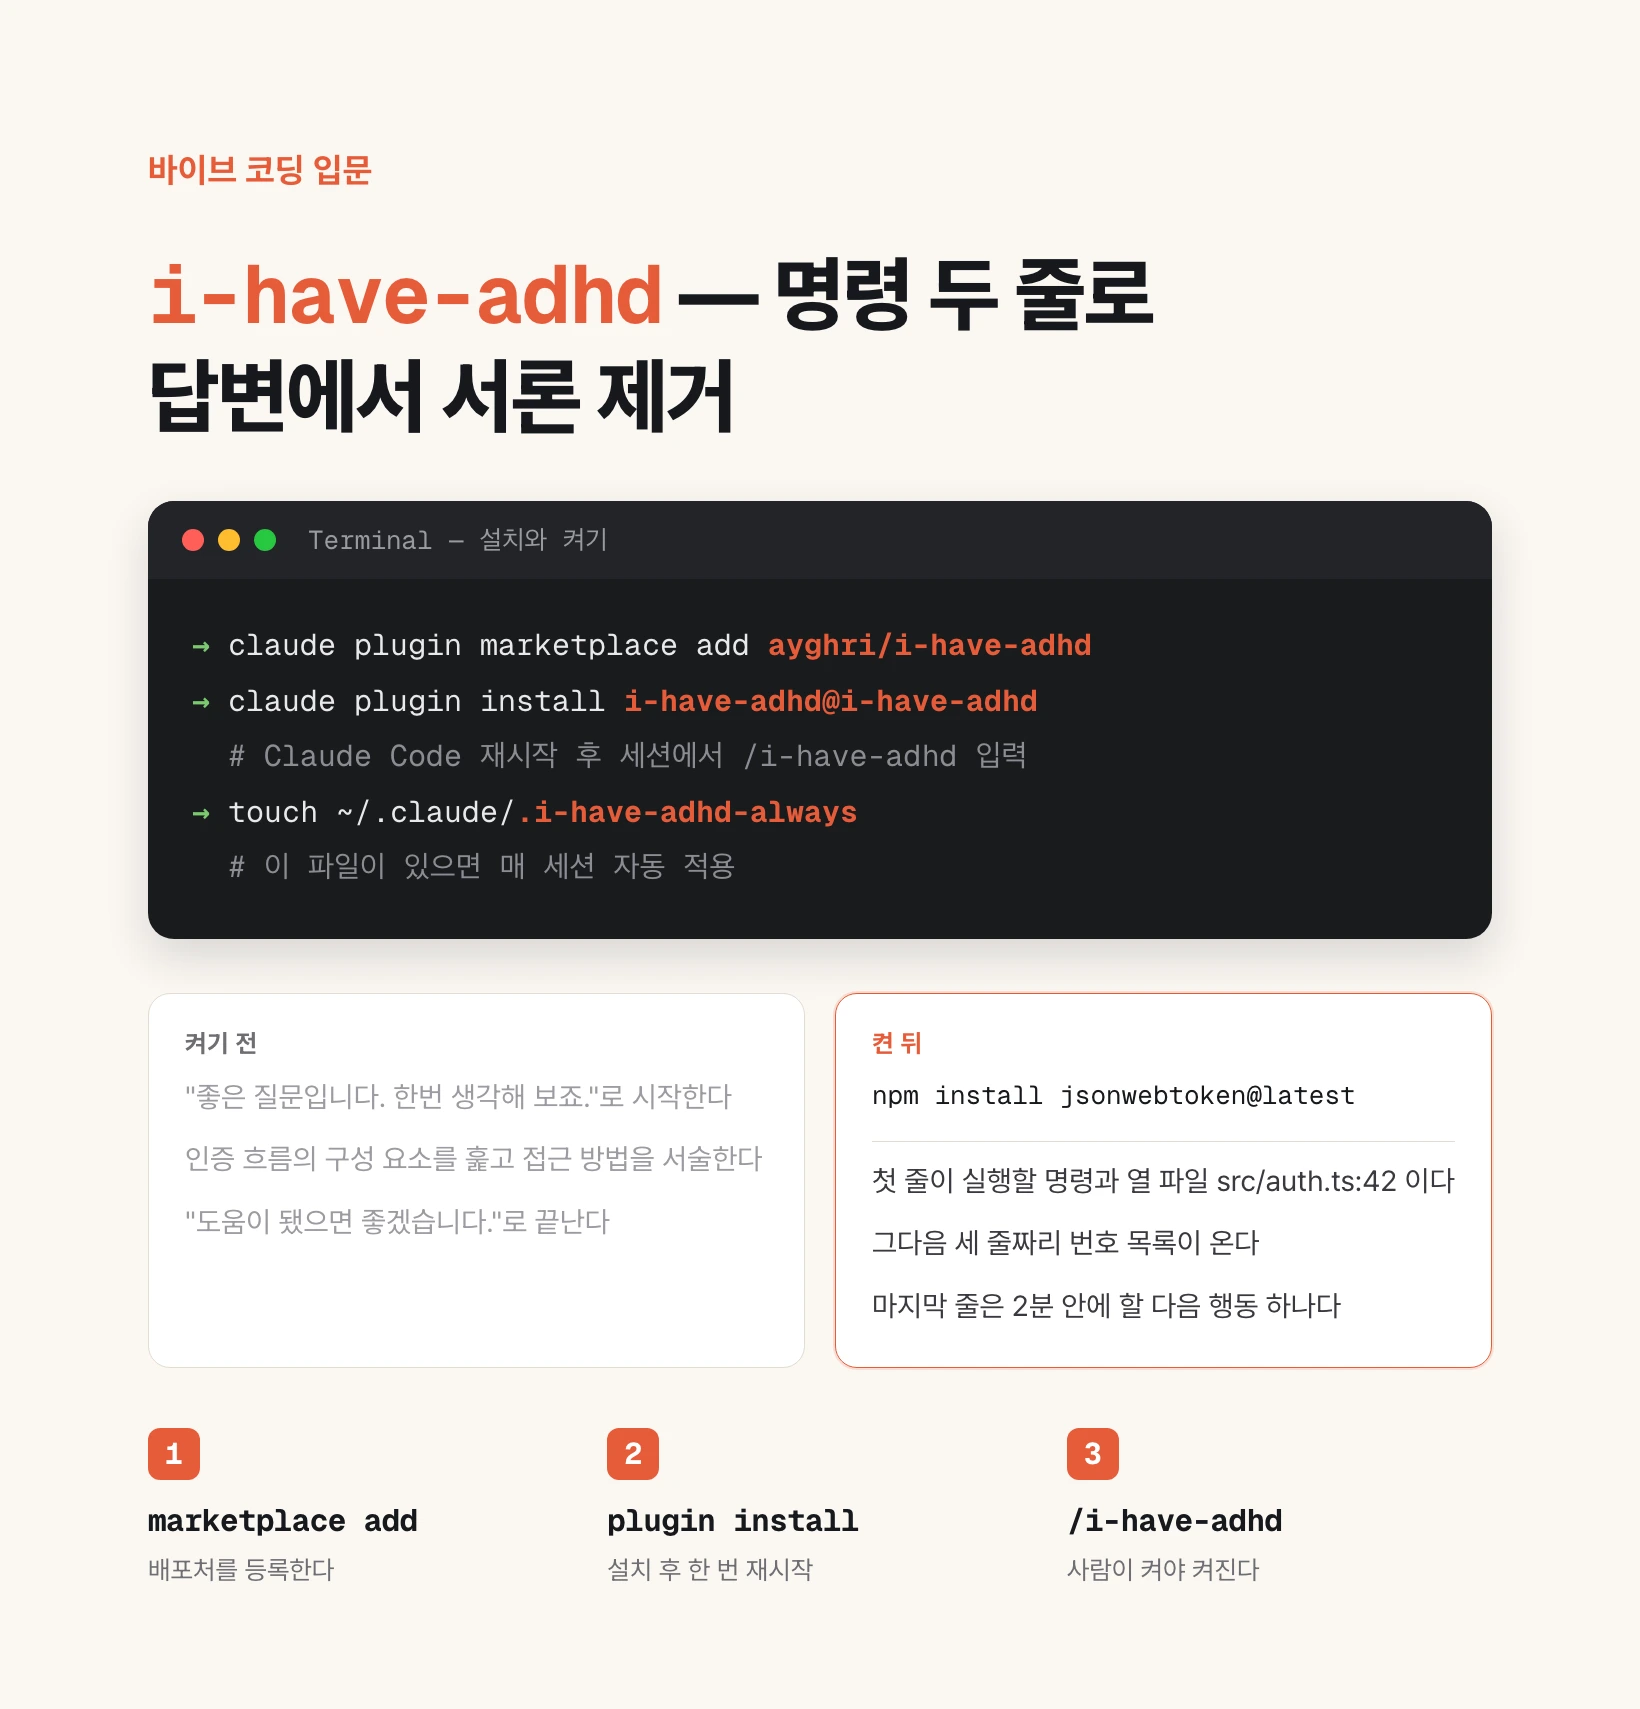
コマンド二行で済む。Claude Code なら `claude plugin marketplace add ayghri/i-have-adhd` で配布元を登録し、`claude plugin install i-have-adhd@i-have-adhd` で入れて、セッションで /i-have-adhd と打つ。そこから回答の形が変わる。前置きが消え、一行目に実行するコマンドかファイルのパスが来る。複数手順の作業は番号付きリストになり、最後の行には二分以内にできる次の一手が残る。毎セッション自動で効かせたいなら `touch ~/.claude/.i-have-adhd-always` をもう一行実行する。作者は Ayoub G.(github.com/ayghri)、MIT ライセンスのオープンソースだ。名前に ADHD とあるが診断は要らない——長い回答の中で必要な一行を見失いがちなら、誰にでも同じ効き方をする。
Notion のエンジニアはこうやってコードを読む
diff を一行ずつ読むのではなく、エージェントが書いた解説ドキュメントを読んでからクイズで理解を確かめる。Notion のデザインエンジニア Geoffrey Litt が日々使っている方法で、その道具である explain-diff スキルも公開されている。導入すると、コード変更ごとに「背景 → 直感 → コードの読み解き → 5問の選択式クイズ」という順序の HTML ドキュメントが1枚できる。インストールはコマンド2行だ。gist の explain-diff-html.md を ~/.claude/skills/explain-diff-html/SKILL.md に落とすだけで、あとは「このブランチの変更を説明して」と言えばいい。成果物はリポジトリの外に、その日の日付で始まるファイル名で保存される。Notion ページを作る派生版(explain-diff-notion.md)も同じ場所にある。運用ルールは一つ——クイズに通らなければ、チームにレビューを依頼しない。
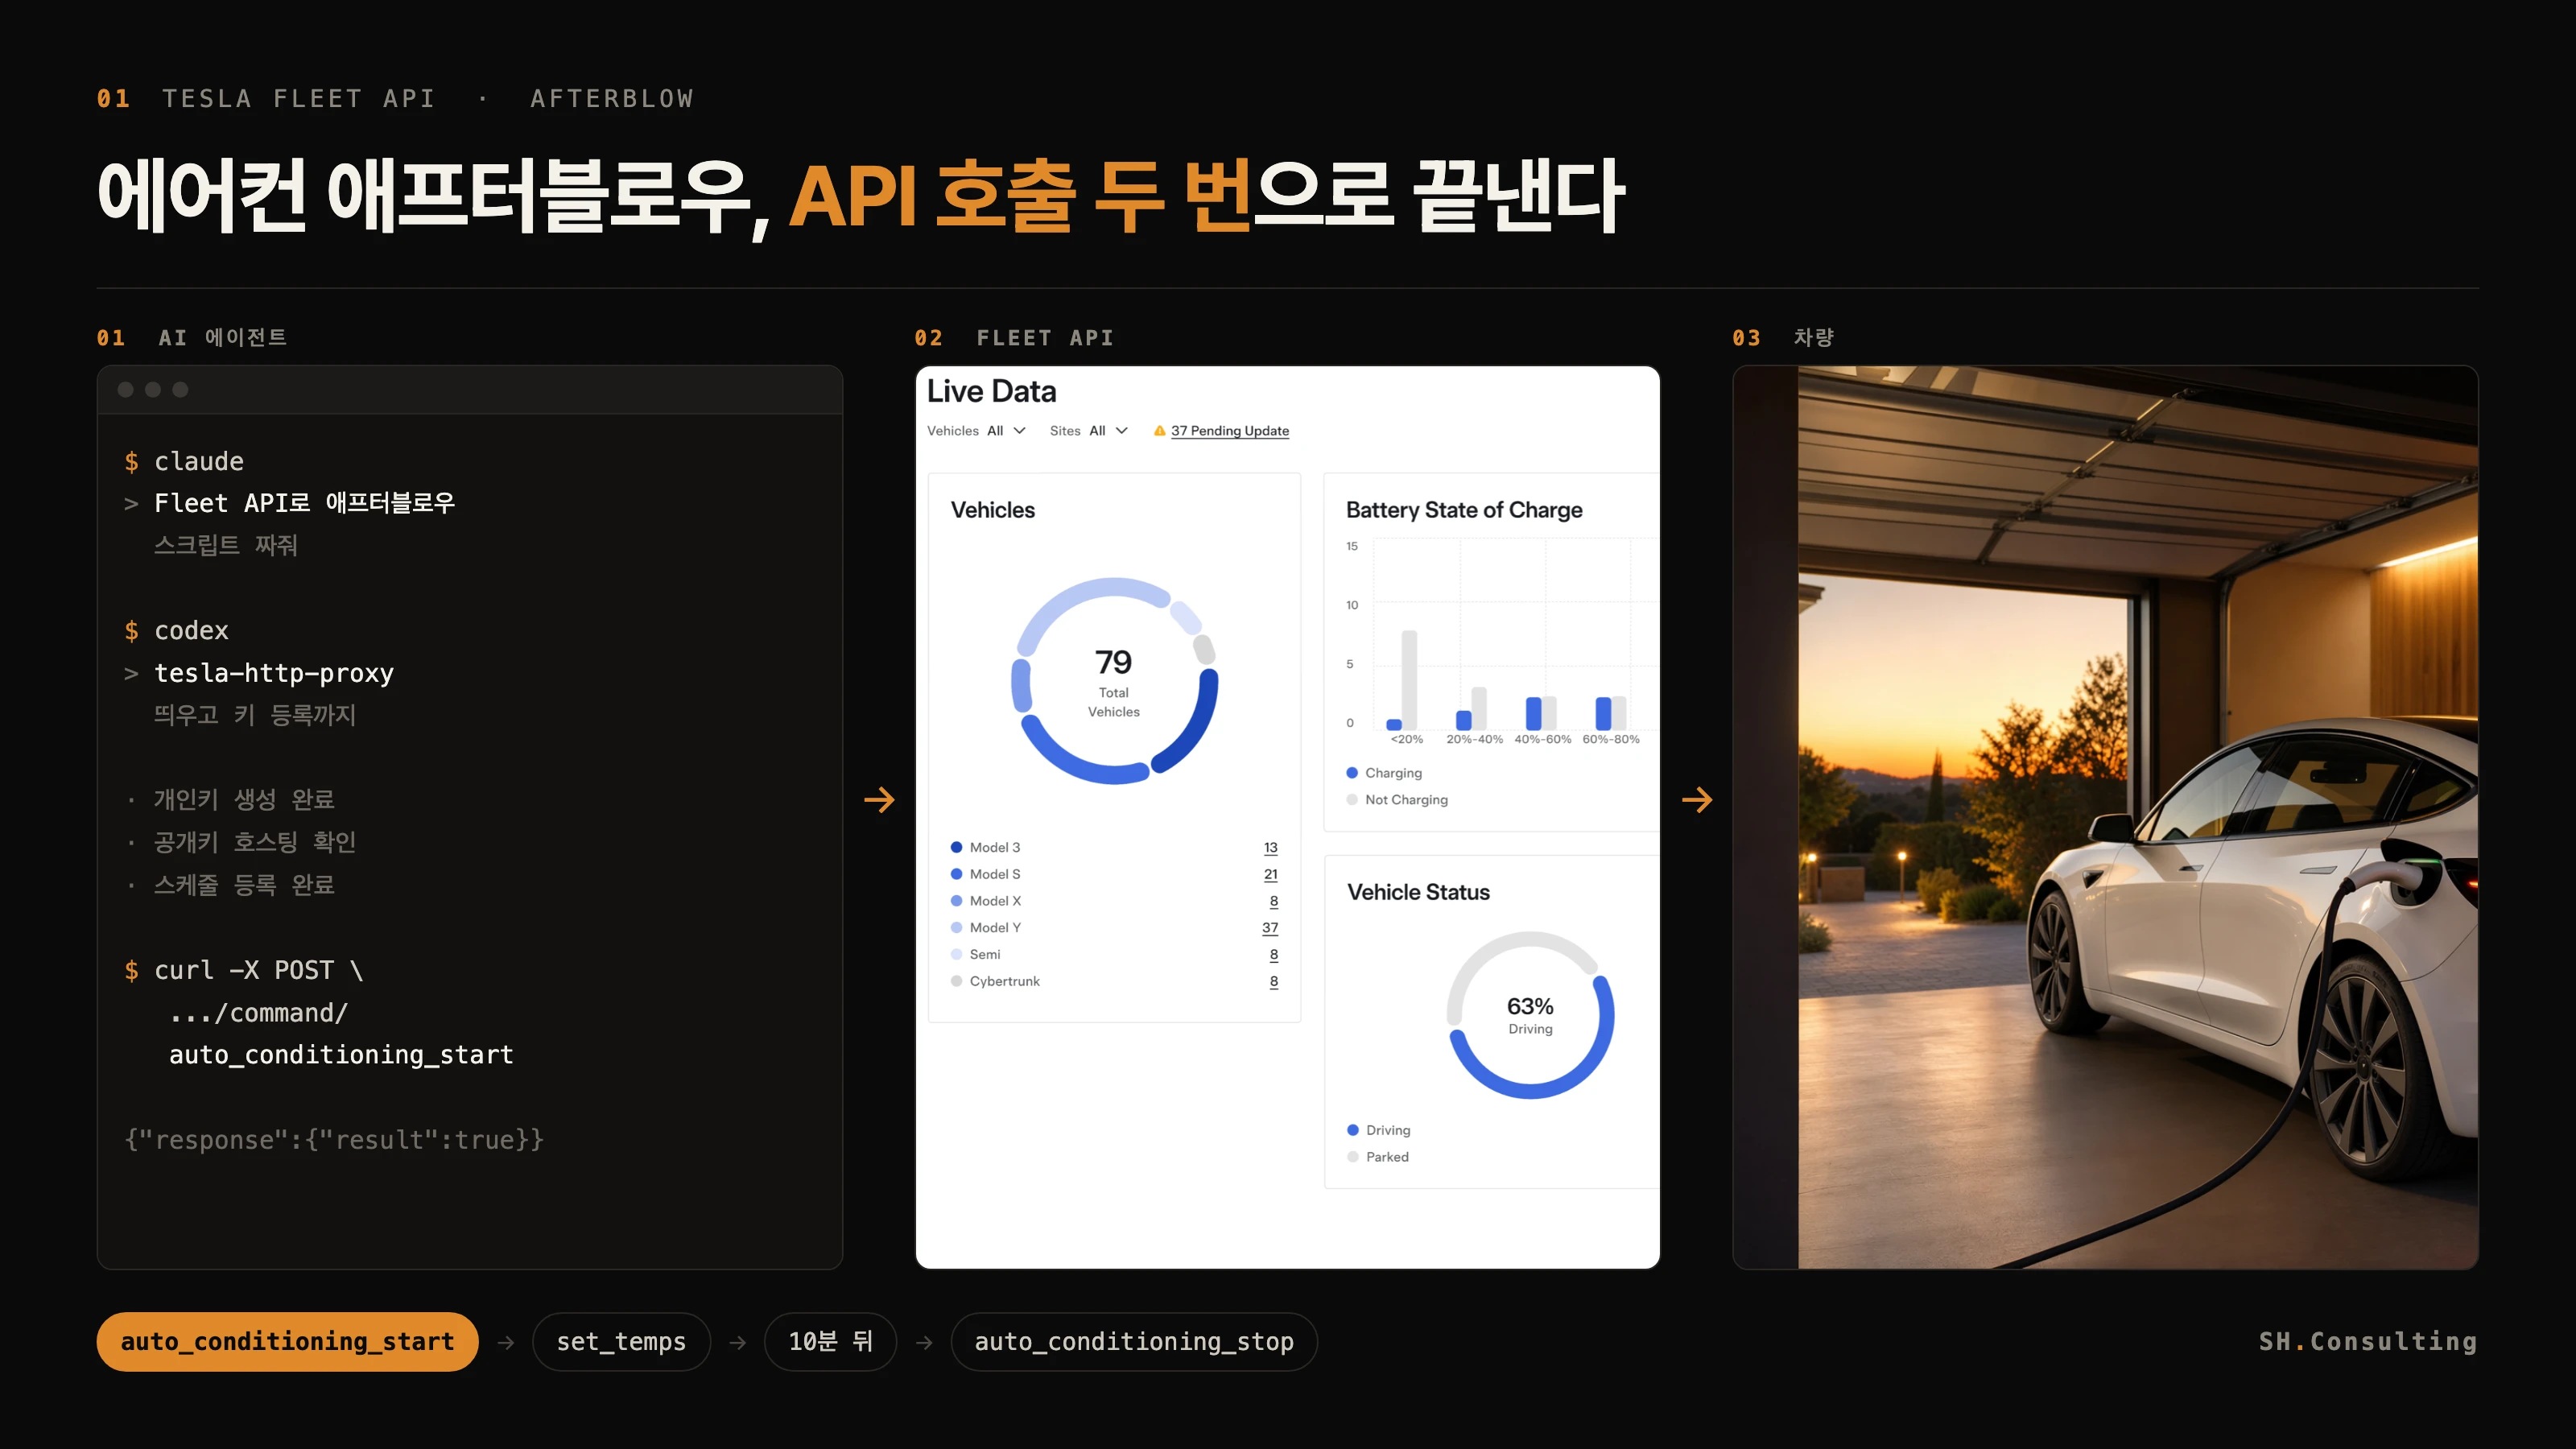
テスラをコードで制御できるか — Fleet API でアフターブロー自動化
できる。テスラは Fleet API という公式の車両制御インターフェースを公開しており、オーナーがアカウントを連携すれば、プログラムからドアロック、トランク、空調、充電、ナビ目的地、セントリーモードまで指示できる。最も実用的な最初の自動化はアフターブローだ。降車後に少しだけ送風してエアコンのエバポレーターを乾かす動作で、夏の酸っぱい臭いの多くはそこに残った水分が原因なので効果はすぐに実感できる。ところが車両メニューにはそのボタンがなく、この機能ひとつだけを月額サブスクで売るサービスが存在するほどだ。作り方は単純で、到着したら auto_conditioning_start で空調を入れ、set_temps で温度を上げ、10分後に auto_conditioning_stop を呼ぶ。実際に詰まるのはコードではなく登録手続き — 開発者アプリの登録、自分のドメインの決められたパスへの公開鍵のホスティング、コマンドに署名するプロキシの稼働の三つだ。これこそ Claude Code や Codex のようなコーディングエージェントに任せるのに向いた作業であり、費用はアカウントごとに毎月付く 10 ドルのクレジット内に収まる。
YouTubeの投資主張をバックテストで検証するには — 字幕から無料の株価APIまで
YouTubeの動画が「今が底だ」と言うとき、信じるか信じないかのほかに三つ目の道がある。主張を数値のルールに置き換えて過去のデータで走らせることで、これをバックテストという。必要な道具は二つだけだ — 動画の字幕をテキストとして取り出すyt-dlpと、登録も課金もなしに日次終値をくれる公開API(米国株はナスダック、韓国株はNaver金融)。手順は三つ。字幕を取得して主張を文章として確保し、「急落して反発したから底だ」という人の言葉を「直近60営業日の高値から35%以上下げた状態で、当日終値が前日比20%以上上昇したら、その日の終値で買う」という条件と数字に置き換え、そのルールを過去10年のデータで走らせる。結果を読むときに必須なのは二つ — 同じ銘柄をただ持ち続けていた場合(比較群)と、平均ではなく中央値だ。比較群がなければ上昇相場ではどんなルールも良く見えるし、平均だけを見れば少数の大当たりが作った数字をルールの実力と取り違える。そして数値条件にどうしても置き換えられない主張が出てきたら、それは検証の失敗ではなく最初から検証できない主張であり、その判定自体が結果である。
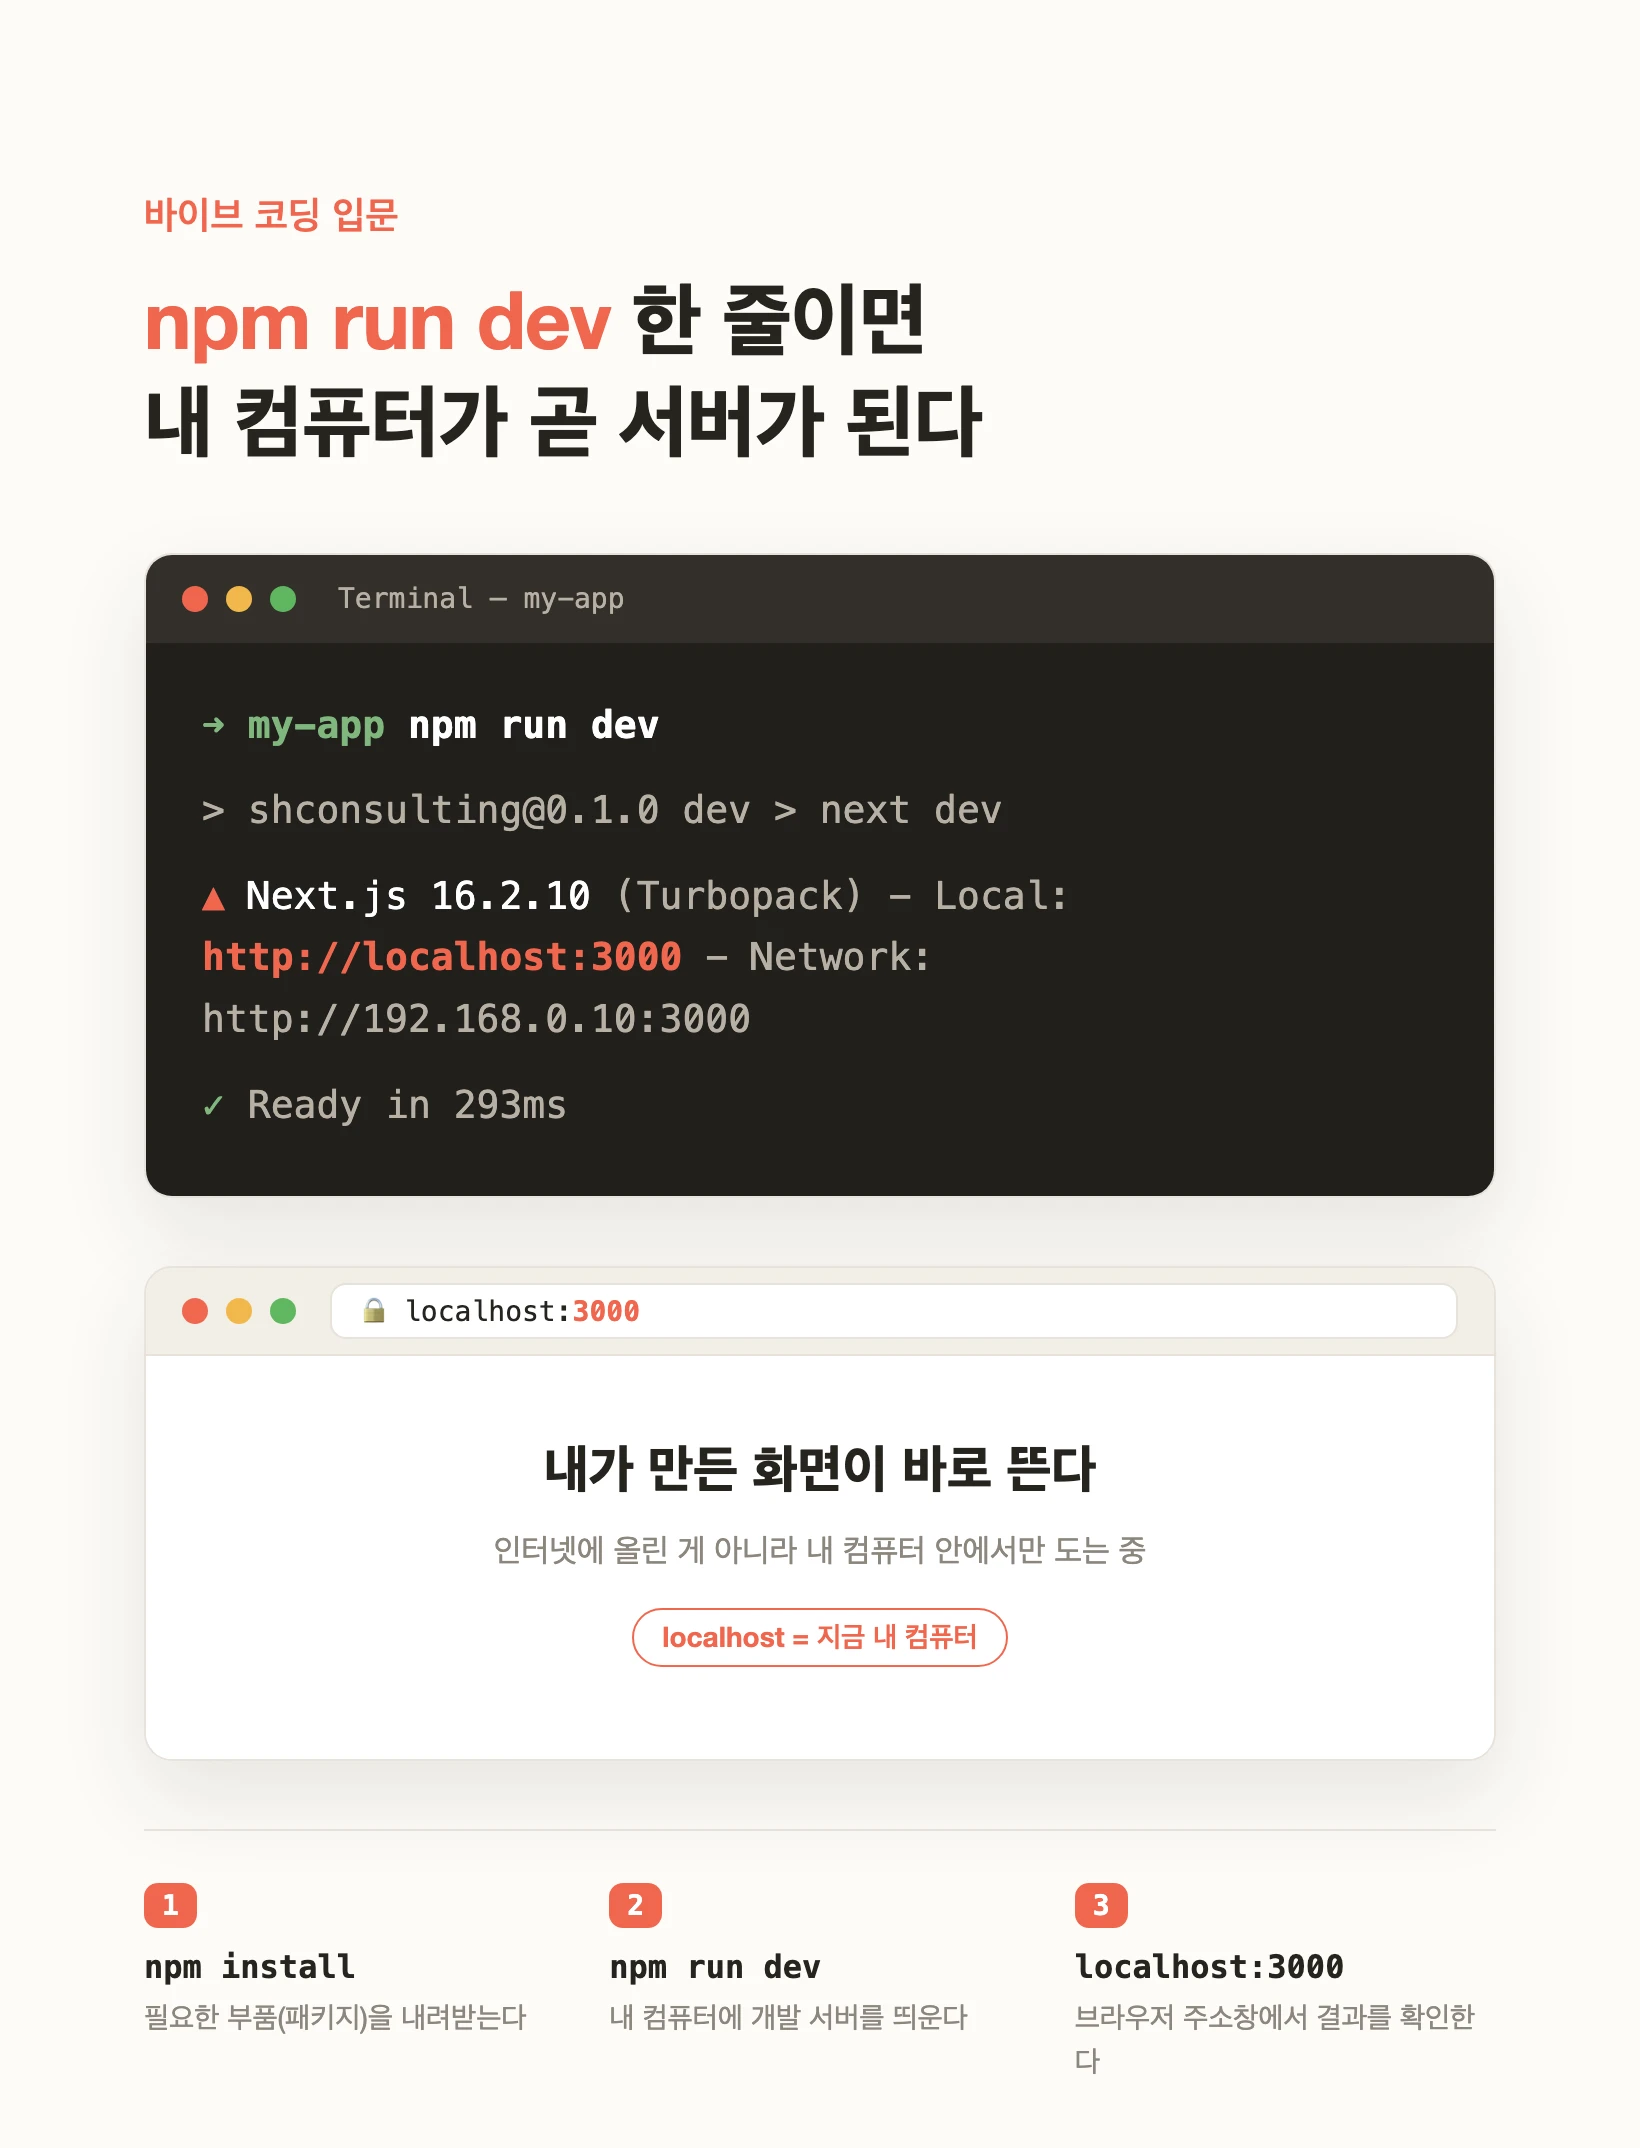
npm run dev と localhost とは何か — 自分のパソコンをサーバーとして立ち上げる
npm run dev は、書いたコードをリアルタイムで見られるウェブページに変える「開発サーバー」を、自分のパソコン上で起動するコマンドだ。実行すると、ターミナルに 'Local: http://localhost:3000' と表示される。この localhost は他人のサーバーではなく、いままさにコマンドを打った自分のパソコン自身を指す名前で(数字では 127.0.0.1)、後ろの 3000 はこのアプリが使うポート、つまり「扉」の番号だ。だからこのアドレスで開いた画面はインターネット上にあるのではなく、自分のマシンの中だけで動き、見えるのは自分だけだ。npm はそのコマンドを動かす道具(Node Package Manager)で、プロジェクトの package.json に並ぶ部品(パッケージ)をダウンロードし、'dev' や 'build' といった実行名にひもづく本当のコマンドを代わりに実行する。もらったばかりのプロジェクトなら手順は常に三つ — npm install で部品をそろえ、npm run dev でサーバーを立ち上げ、ブラウザで localhost:3000 を開いて確認する。インターネットへの公開は、これらがすべて動いた後の話だ。
オンプレミス AI はいつ必要で、いくらかかるのか
オンプレミス AI とは、他社サーバーの API を呼ぶのではなく、自社の機器にモデルを載せて自社ネットワーク内だけで動かす方式だ。必要性は二つから来る。データが学習に使われるかどうかとは別に、そのデータが通った経路自体が外部に残るという点。そしてセキュリティ事故が起きたとき、フロンティアモデルがガードレールで分析を断る可能性がある点だ。費用はフロンティア級のオープンウェイトを基準にすると、純粋な重みだけで 1.4TB、H200 クラスタで 72 枚ラック一つ相当、クラウド借用に換算して時間あたり約 300 ドル、機器を買えば約 50 億ウォンになる。ただしこの計算が成り立つのは、ワークロードが絶えず流れ込み GPU を最大で回せる場合だけだ。だから実務上の答えは全量移行ではなく、出してはいけないものだけをオープンウェイトで内部に置き、残りはフロンティア API に任せることになる。
Claude の Chat・Cowork・Code、いつどれを使うか
Claude には製品が三つあります。Chat はインターン、Cowork はチームリーダー、Code はアインシュタインです。三つとも会話し、ファイルを作り、ツールにつながるので外から見ると似ています。分けるのは一点だけ、仕事がどこで終わるかです。Chat は答えを渡した瞬間に終わり、Cowork は目標に届くまで止まらず、Code はなかったものを作ります。間違ったモードにいる合図も明確です。Chat の出力を文書にコピーして断片をつなぎ合わせているなら、本来任せるべき仕事を手作業でやっているということです。
Impeccable とは何か、どう始めるか — AI コーディングツールにデザイン規則を植える
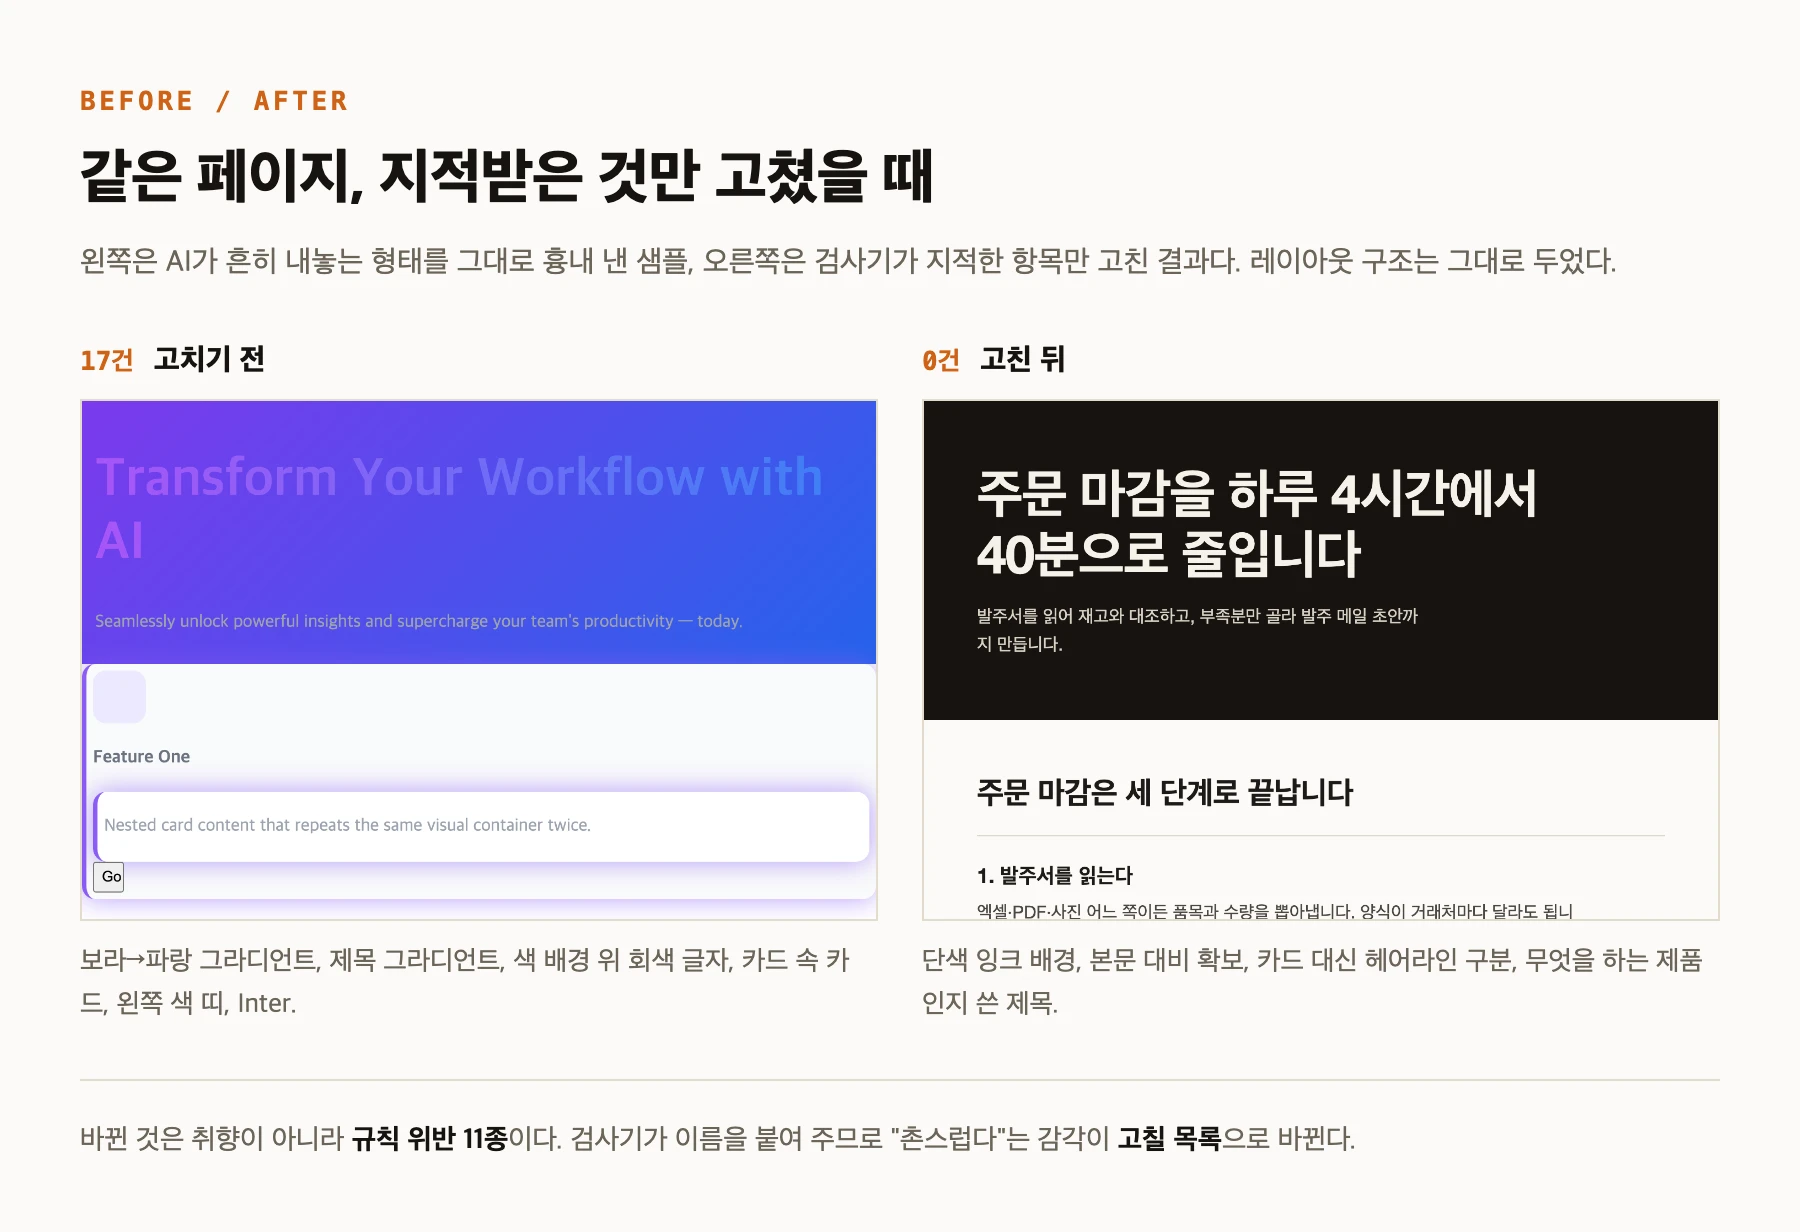
Impeccable は、AI コーディングエージェントが画面を作るときに読むべきデザイン指針をプロジェクトに植え込むオープンソースツールだ。Anthropic が公開した frontend-design スキルを出発点に、コマンド 23 個と決定論的な検出ルール 60 個を加えたもので、Paul Bakaus が Apache-2.0 で公開している。始めるのに必要なのは二行だ。プロジェクトのルートで npx impeccable install を走らせると、この端末に既に入っている AI コーディングツールを自ら見つけて一覧で示し、このプロジェクトだけに入れるか端末全体に入れるかを尋ねる。続いてツールの中で /impeccable init を一度実行すると、作る画面がブランド向けかプロダクト向けかを聞いたうえで PRODUCT.md と DESIGN.md を書き、以後すべてのコマンドがこの二つのファイルを先に読む。実作業はコマンド名で指示する。audit は点検、critique は階層と可読性のレビュー、polish は仕上げ、bolder と quieter は強度の調整、distill は削ぎ落としだ。毎日使うものは /impeccable pin audit で /audit という近道にできる。エージェントを使わなくてもよい。npx impeccable detect は LLM も API キーも使わずルール検査だけを回し、指摘があれば終了コード 2、なければ 0 で終わるので、そのまま CI のゲートに使える。よくある癖をわざと詰め込んだサンプル HTML 一枚に走らせたところ 17 件が出て、指摘された箇所だけ直すと 0 件になった。
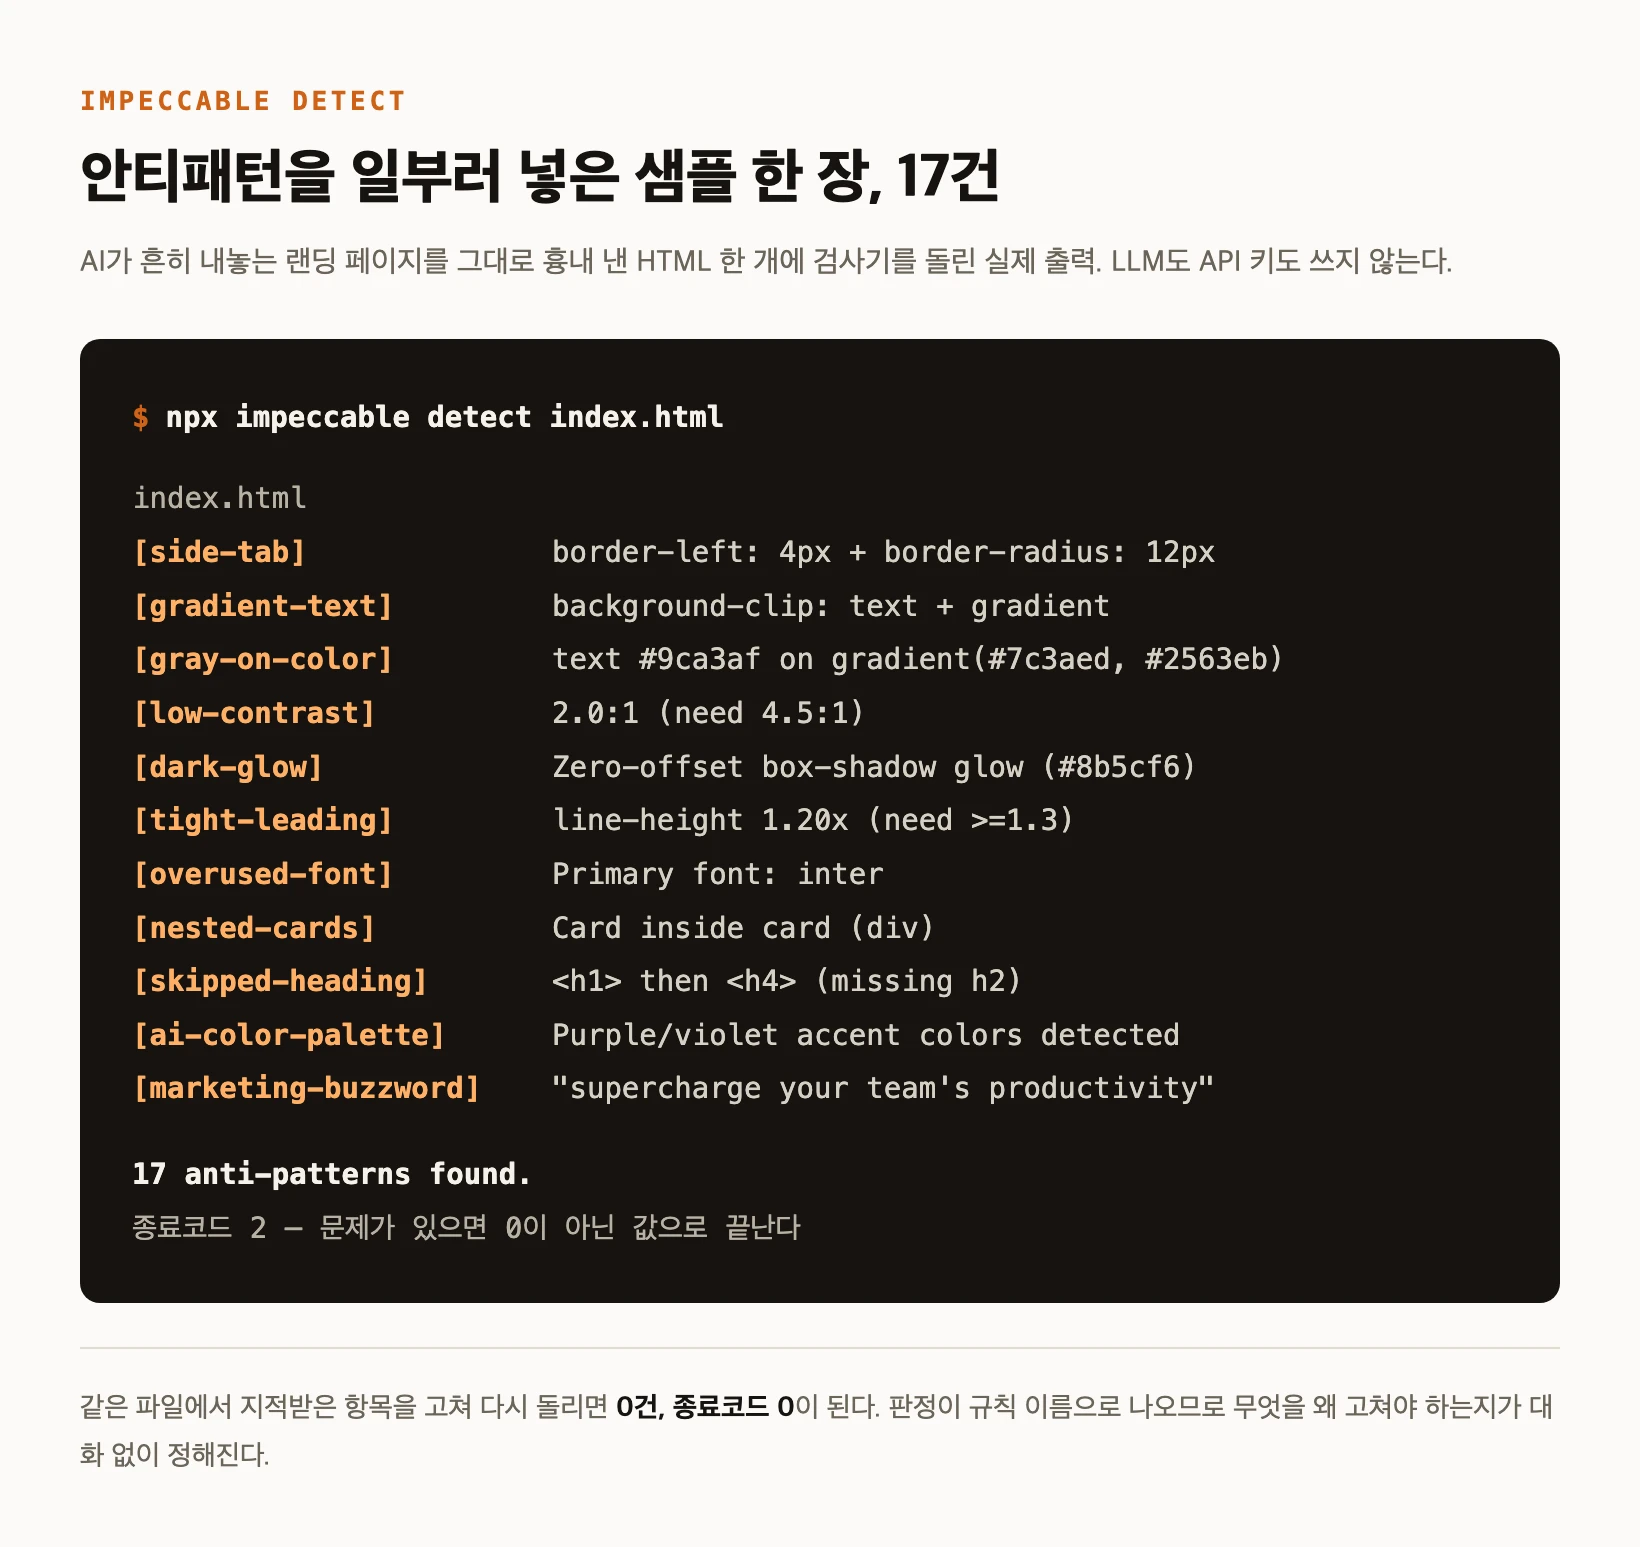
AI が作った画面はなぜどれも似て見えるのか — 繰り返される癖と直す方向
AI が作った画面の野暮ったさは好みの問題ではなく、リストの問題だ。モデルはおおむね公開ウェブに溢れる同じ SaaS テンプレートを見て学んでおり、特に指示なく画面を作らせると別のモデル、別のプロジェクトでも同じ選択が繰り返される。よく出るのは、カード左端の太い色帯、見出しに載せたグラデーション、紫から青へ流れる背景、色地の上の灰色文字、四方に広がる色の発光、カードの中にまたカード、見出しの上の小さな大文字ラベル、そして Inter 系の書体だ。そこに streamline や supercharge といった常套句が重なる。オープンソースの Impeccable はこれらの癖にルール名を付け、LLM なしで動く検査器にした。直し方も単純で、色帯は消し、見出しは単色に、色地の上の文字は灰色ではなく白か背景の濃い系統に、カードの入れ子は余白と細い区切り線にほどく。確認は目ではなくコマンドで行う。これらの癖をわざと詰め込んだサンプル HTML 一枚は 17 件、指摘された箇所だけ直しレイアウト構造はそのままにして再検査すると 0 件になった。
デザイン検査を CI に入れるには何が必要か — 終了コードで作るゲート
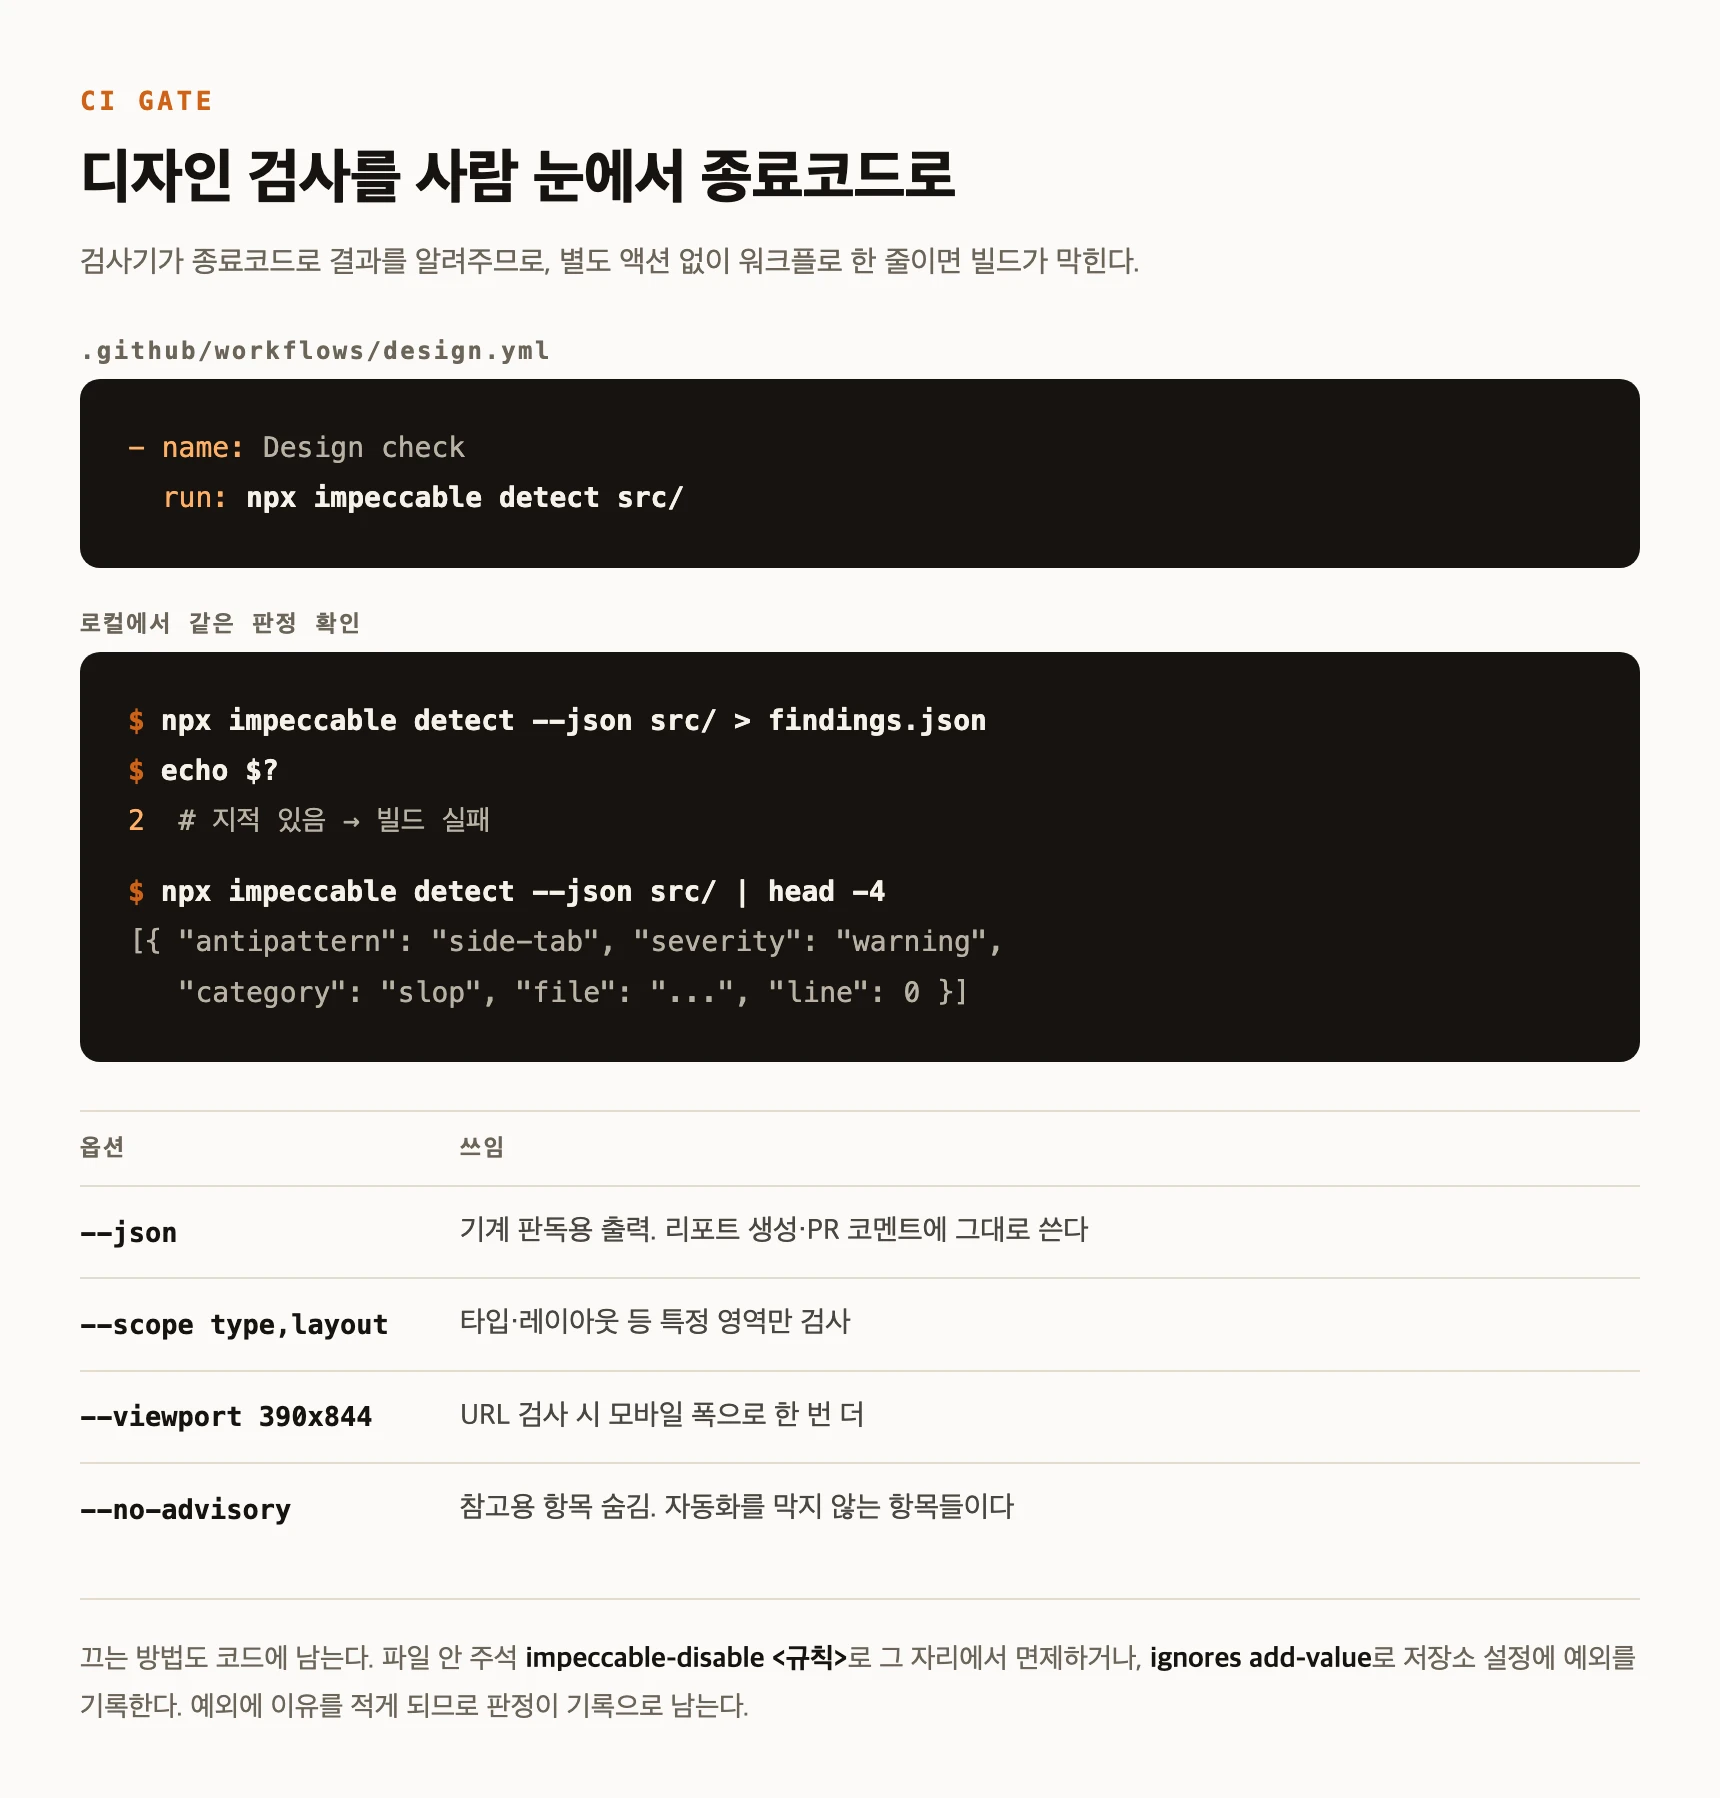
肝心なのは、デザインレビューを人の目から終了コードへ移すことだ。コードは lint が止めてくれるが、画面は毎回誰かが見ないと通らない。Impeccable の detect コマンドは LLM も API キーも使わずルール検査だけを回し、結果を終了コードで知らせる。指摘があれば 2、なければ 0 だ。だから CI のワークフローに npx impeccable detect src と一行入れるだけで、専用のアクションなしにゲートになる。検査のしかたは対象によって分かれる。HTML はリンクされた CSS まで含めて静的解析し、JSX や CSS といったそれ以外のファイルはパターンマッチ、URL を渡すと実際のブラウザで開いてレンダリングされた画面を見る。そのためソースの走査が綺麗でも URL の走査で引っかかる項目が別にあり、プレビュー配信の URL も併せて掛ければその差は縮まる。実務で要る選択肢は json、scope、viewport、no-advisory の四つ。例外はファイル内の impeccable-disable コメントでその場だけ免除するか、ignores add-value でリポジトリ設定に記録する。どちらも理由を書くことになるので、判断が記録として残る。
バックテストの収益率が本当の実力かどうかをどう確かめるか — 保有比率と露出調整後アルファ
収益率の隣に保有比率を並べ、収益率から保有比率×バイアンドホールド収益率を差し引く。残った値が市場への露出では説明できない部分、すなわちアルファである。保有比率とは、バックテスト期間の全取引日のうち実際にポジションを持っていた日の割合を指す。この数字を欠いたまま収益率だけを見ると、戦略が正しかったから稼いだのか、単に市場にいなかっただけなのかを区別できない。広く教えられている五つのテクニカル手法を、個別株・レバレッジETF・指数ETFの十六銘柄でウォークフォワードに回すと、その違いがそのまま表れる。五つとも一つもバイアンドホールドに勝てず、勝率が最も高いものでも34.5パーセントだった。さらに、その資産が当該区間で上がった幅と戦略の超過収益は相関マイナス0.945で結びついていた。資産が上がれば戦略は負け、下がれば勝つということだ。原因は露出だった。1年区間の平均保有比率は23.8パーセントで、残りの時間は現金である。露出調整後アルファは中央値マイナス5.73パーセントポイント、回帰の切片はマイナス0.52パーセントポイントと、事実上ゼロ以下だった。本稿はその検証を一から再現できるよう、手順と計算式にまとめたものである。
AI エージェントに売買ルールをバックテストさせるには、何を決めておく必要があるか?
バックテストとは、過去の相場に自分の売買ルールをそのまま当てはめ、そのとおり売買していたら今いくらになっていたかを計算する手続きだ。トス証券 Open API のローソク足取得で日足の始値・高値・安値・終値を受け取れば、Claude Code や Codex のようなターミナル AI エージェントにルールを言葉で説明するだけで、数分で売買履歴と収益率が出てくる。ただし結果を実際に分けるのはルールではなく、自分が決めなかった前提のほうだ。判定の時点、約定価格、取引コスト、データ区間という四つを固定しなければ、エージェントは聞き返さずに最もそれらしい値を選んで埋め、その選択がそのまま成績表になる。実際に 3 倍レバレッジ ETF で同じルール・同じデータを使い、決済の約定前提だけを変えたところ、5 か月の収益率が 15 パーセントと 95 パーセントに分かれた。
Fable 5・GPT-5.6 Sol・Kimi K3、単価3.3倍の差は実コスト3.3倍の差なのか?
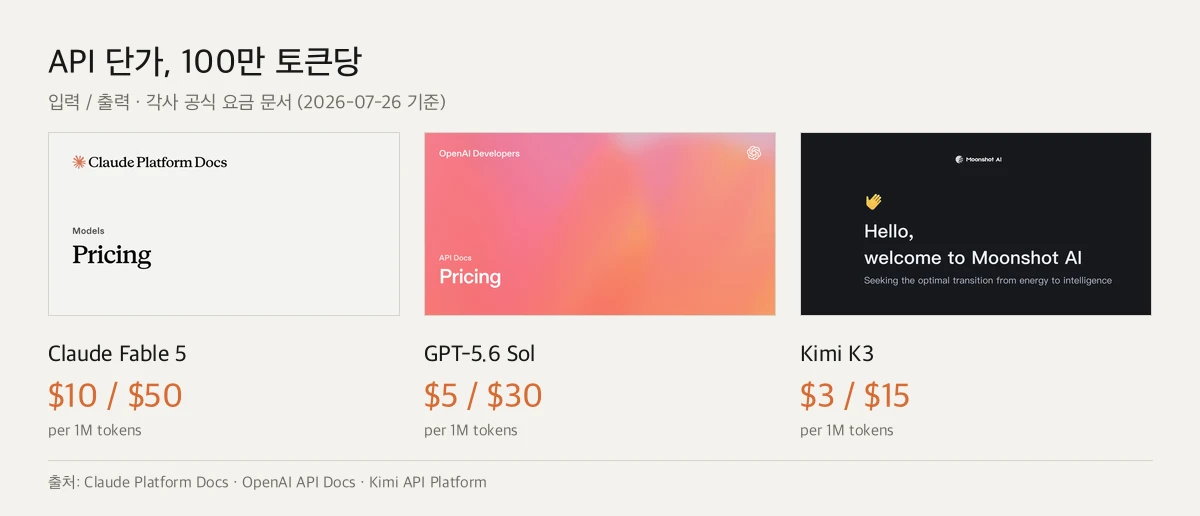
そうではない。100万トークンあたりの公式価格は Claude Fable 5 が入力10ドル・出力50ドル、GPT-5.6 Sol が5ドルと30ドル、Kimi K3 が3ドルと15ドルで、最も高い側と安い側は入力でも出力でもちょうど3.3倍の差になる。しかし実際に請求される額を決めるのは、この表に載っていない三つの要素だ。第一に、同じ文章が何トークンとして数えられるか。Anthropic は Claude 4.7 以降のモデルが新しいトークナイザーを用い、同一テキストに対して約30%多いトークンを生成すると明記しており、単価が同じでも請求数量が増える。第二に、長さによって料金区分が変わるか。Sol は入力が27万2000トークンを超えるとリクエスト全体が入力2倍・出力1.5倍で計算され、100万トークン換算で10ドルと45ドルになる。一方 Fable 5 と Kimi K3 の料金表に長さ区分は存在しない。第三に、結果が一度で得られるか。再実行のたびに単価が掛け算されるからだ。三つのモデルに同じプロンプトを一度ずつだけ与えた比較レビューでは、物理処理と画面のディテールは Fable が明確に優れ、Kimi と Sol は互いに近い水準だった。なおキャッシュヒット割引は三社とも入力価格のちょうど10%で完全に一致しており、キャッシュを活用しても三者間の差は縮まらない。
ケイパビリティ・オーバーハングとは何か、組織は何をすべきか
ケイパビリティ・オーバーハング(capability overhang)とは、AIツールが扱える仕事の範囲は数か月単位で急速に広がるのに、それを使う人の力量ははるかにゆっくりとしか伸びず、その差に「使われないままの性能」が積み上がっていく現象を指す。ここから一つの結論が出る。同じツールを等しく配っても、うまく使う人と平均的に使う人の生産性の差は縮まらず、むしろ開く。だから組織におけるAXの本当の課題は、ツールの導入ではなくこの差の管理になる。見るべき指標も利用率ではなく分布だ。
トス証券 Open API で AI に株式取引を任せるには何が必要か?
トス証券 Open API は、相場・銘柄情報、口座と保有株、注文の作成・訂正・取消、そして価格を監視して条件が満たされると自動で発注する条件注文までを提供する REST API だ。トス証券の WTS にログインし、設定内の Open API メニューで client_id と client_secret を発行し、呼び出す IP を許可リストに登録すれば準備は終わる。ここに Claude Code や Codex のようなターミナル型 AI エージェントをつなげば、コードを自分で書く代わりに売買ルールを言葉で説明して照会と発注を自動化できる。ただし照会が通った瞬間に発注も通るため、実発注の手前には練習モード既定・実行フラグ・金額上限・冪等キーといったゲートを人が先に置く必要がある。
AI ツールを揃えた組織は、なぜ速くならないのか?
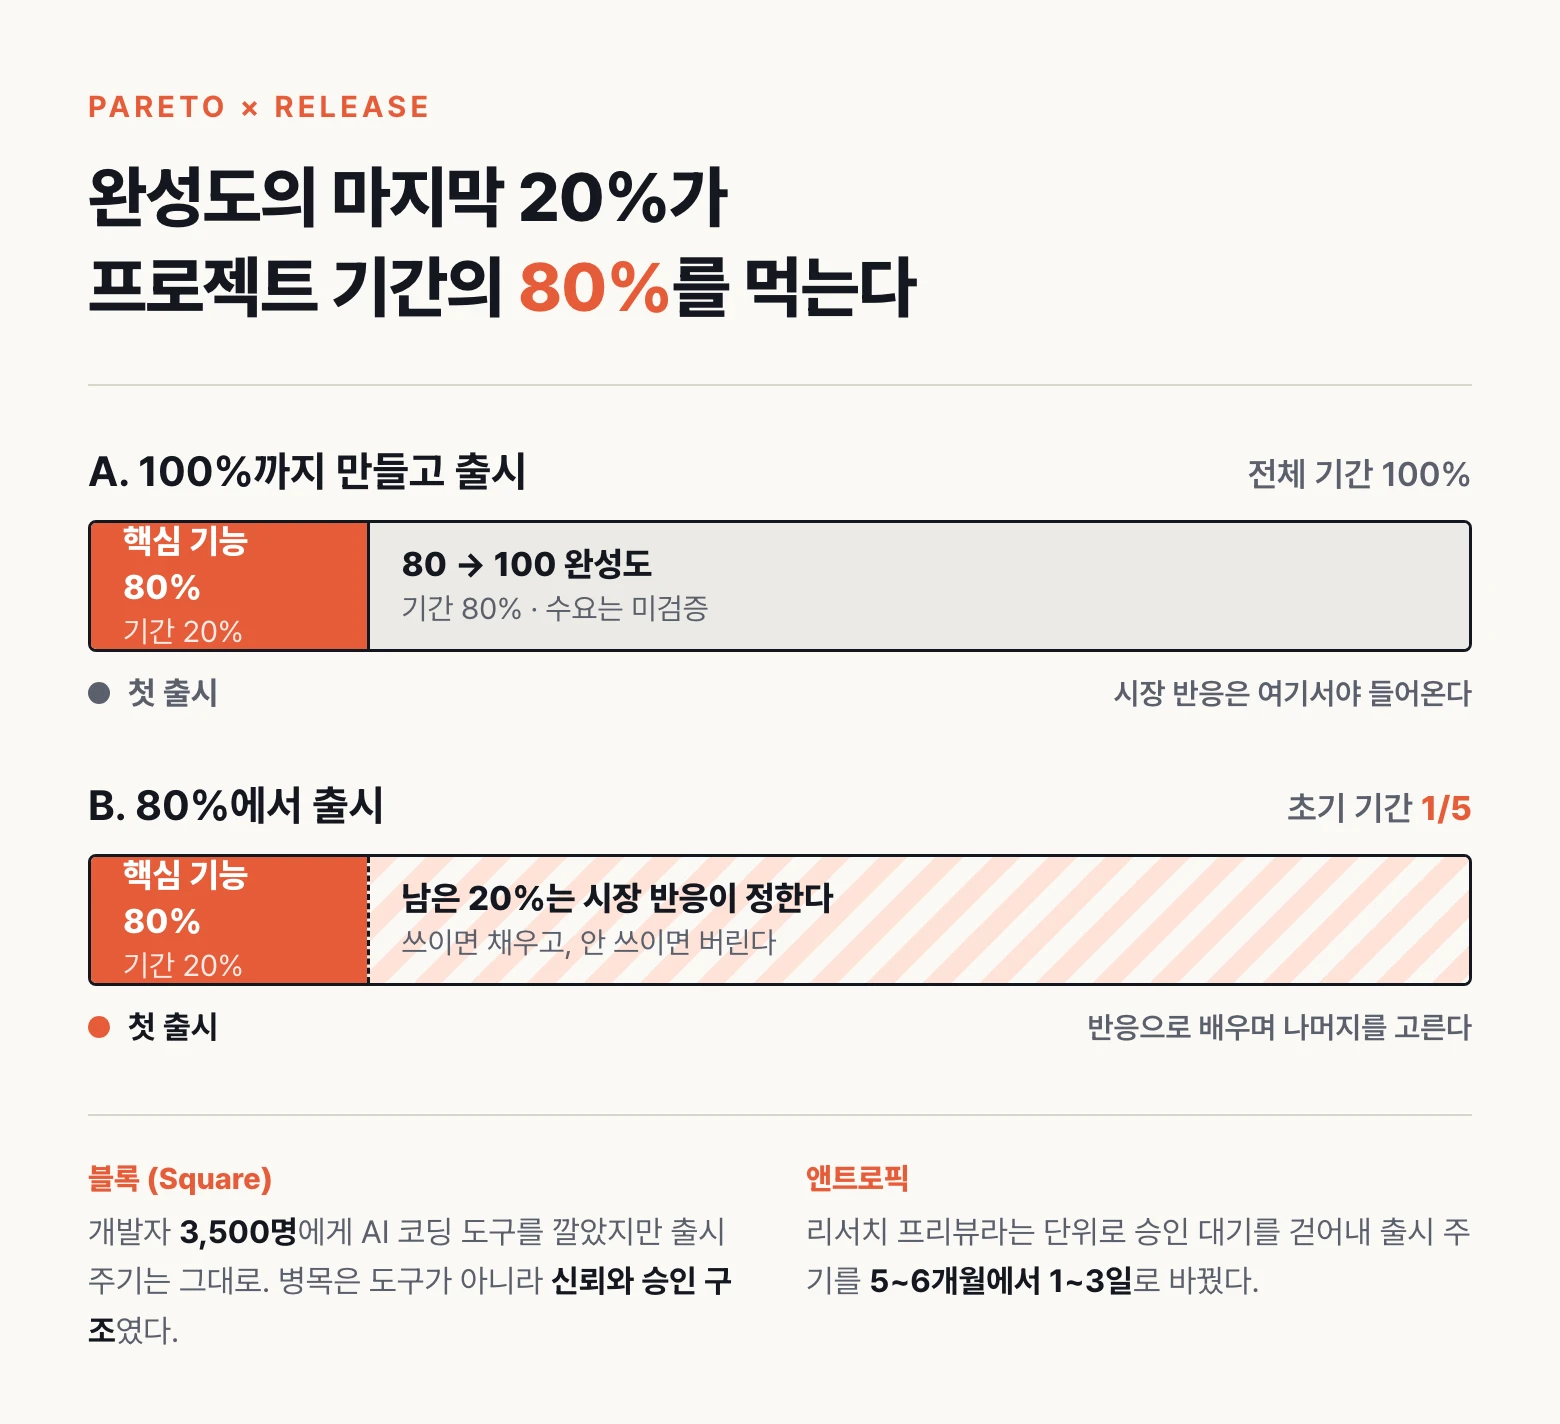
速度を決めるのはツールではなく、完成基準と承認構造だからだ。決済サービス Square を擁するフィンテック企業ブロックは、三千五百人の開発者のほとんどに AI コーディングツールを配ったが、製品の出荷サイクルは期待ほど縮まなかった。ボトルネックはツールの不在ではなく、AI が書いたコードへの信頼と、その上に載る決裁・承認の構造にあった。一方アンソロピックは反対側から手を入れ、リサーチプレビューという公開単位をつくって承認待ちを取り除き、製品サイクルを五、六か月から一〜三日へ変えた。これをパレートの法則で読み直すと規則が出てくる。中核機能の八割は全期間の二割でできあがり、残りの八割の期間は 80 を 100 へ引き上げるために使われる。だが、その最後の作り込みを市場が望んだかどうかは、ほとんど検証されていない。八割で出し、残りの二割は市場の反応に決めさせれば、初期のプロジェクト期間は五分の一になる。
Record a skill とは何で、どう使うのか?
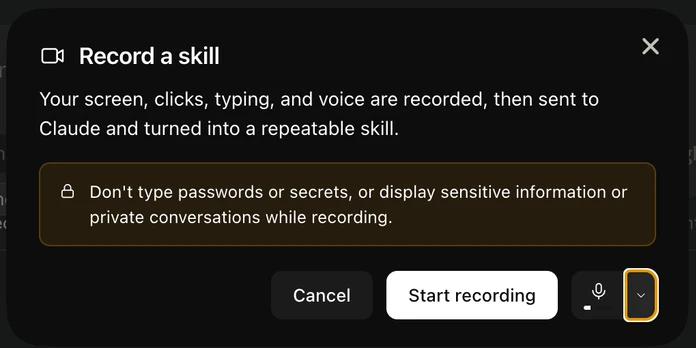
Record a skill は Claude デスクトップアプリの機能で、画面・クリック・タイピング・音声をまとめて録画し、その作業を Claude が再実行できる「スキル」に変える。プロンプトで手順を説明する代わりに、普段どおりのやり方で一度実演すればいい。Claude は何をするワークフローかを要約し、必要なフォルダやコネクタの権限を求めたうえで、再利用できるスキルとして保存する。保存後は「今週の分もまとめて」の一言で同じ作業が回る。ただし録画中は画面に映るものがすべて送信されるため、パスワードや口座、私的な会話が表示される業務には向かない。
Claude が実際に従う CLAUDE.md はどう書くか?
CLAUDE.md は強制される設定ではなく、毎セッション一緒に読み込まれる指示の集まりだ。だから一つのファイルに積み上げるほどルール同士が競合し、肝心な指示が些細な指示に埋もれ、Claude はかえって従わなくなる。効かせる方法は五つ。第一に、そもそも CLAUDE.md が適切かを問う——「絶対に main へ push しない」のような強制すべきルールは、指示ではなく pre-tool-use hook に入れる(hook は Claude が試みた瞬間に実際に止める)。第二に、CLAUDE.md は四か所にある——managed policy(組織)、user(自分のマシンの全プロジェクト)、project(チームと共有)、local(このリポジトリで自分だけ、git 無視)。すべて一緒に読み込まれるので、個人的・一時的な判断は local に置く。第三に、@パス import で分割する——ただし import は起動時にその場でインライン展開されるので、整理には役立つが文脈は減らさない。第四に、言い回しが遵守を分ける——具体的で検証可能に(「新しい API ルートは src/api/handlers に一ファイル一つ」、「ベストプラクティスに従う」ではなく)、そして代替を名指しする(「名前付きエクスポートを使う」、「デフォルトエクスポートを使うな」ではなく)。強調は予算だ。IMPORTANT や YOU MUST は、破られると痛い二つ三つのルールにだけ使う。第五に、改訂し続ける——Claude が誤ったら、それを CLAUDE.md へのバグ報告として扱い、ルールを追加させる。プロダクションコードのように扱い、正当化できない行は消す。ファイルが痩せているほど、Claude はその多くを守る。
Claude Opus 5とは何か、何が変わったのか
Claude Opus 5は、Anthropicが2026年7月24日に公開した最上位級の汎用AIモデルだ。要点は「半額で届いたフロンティア知能」で、最上位モデルClaude Fable 5に迫る知能を約半分の価格で提供する。価格は入力100万トークンあたり5ドル・出力25ドルで前世代Opus 4.8と同じだが性能は大きく向上し、コーディング・知識労働・コンピュータ操作・業務自動化のベンチマークで新記録を出した。ただしセキュリティや生物学といった専門領域では、専用モデルMythos 5がなお先行する。
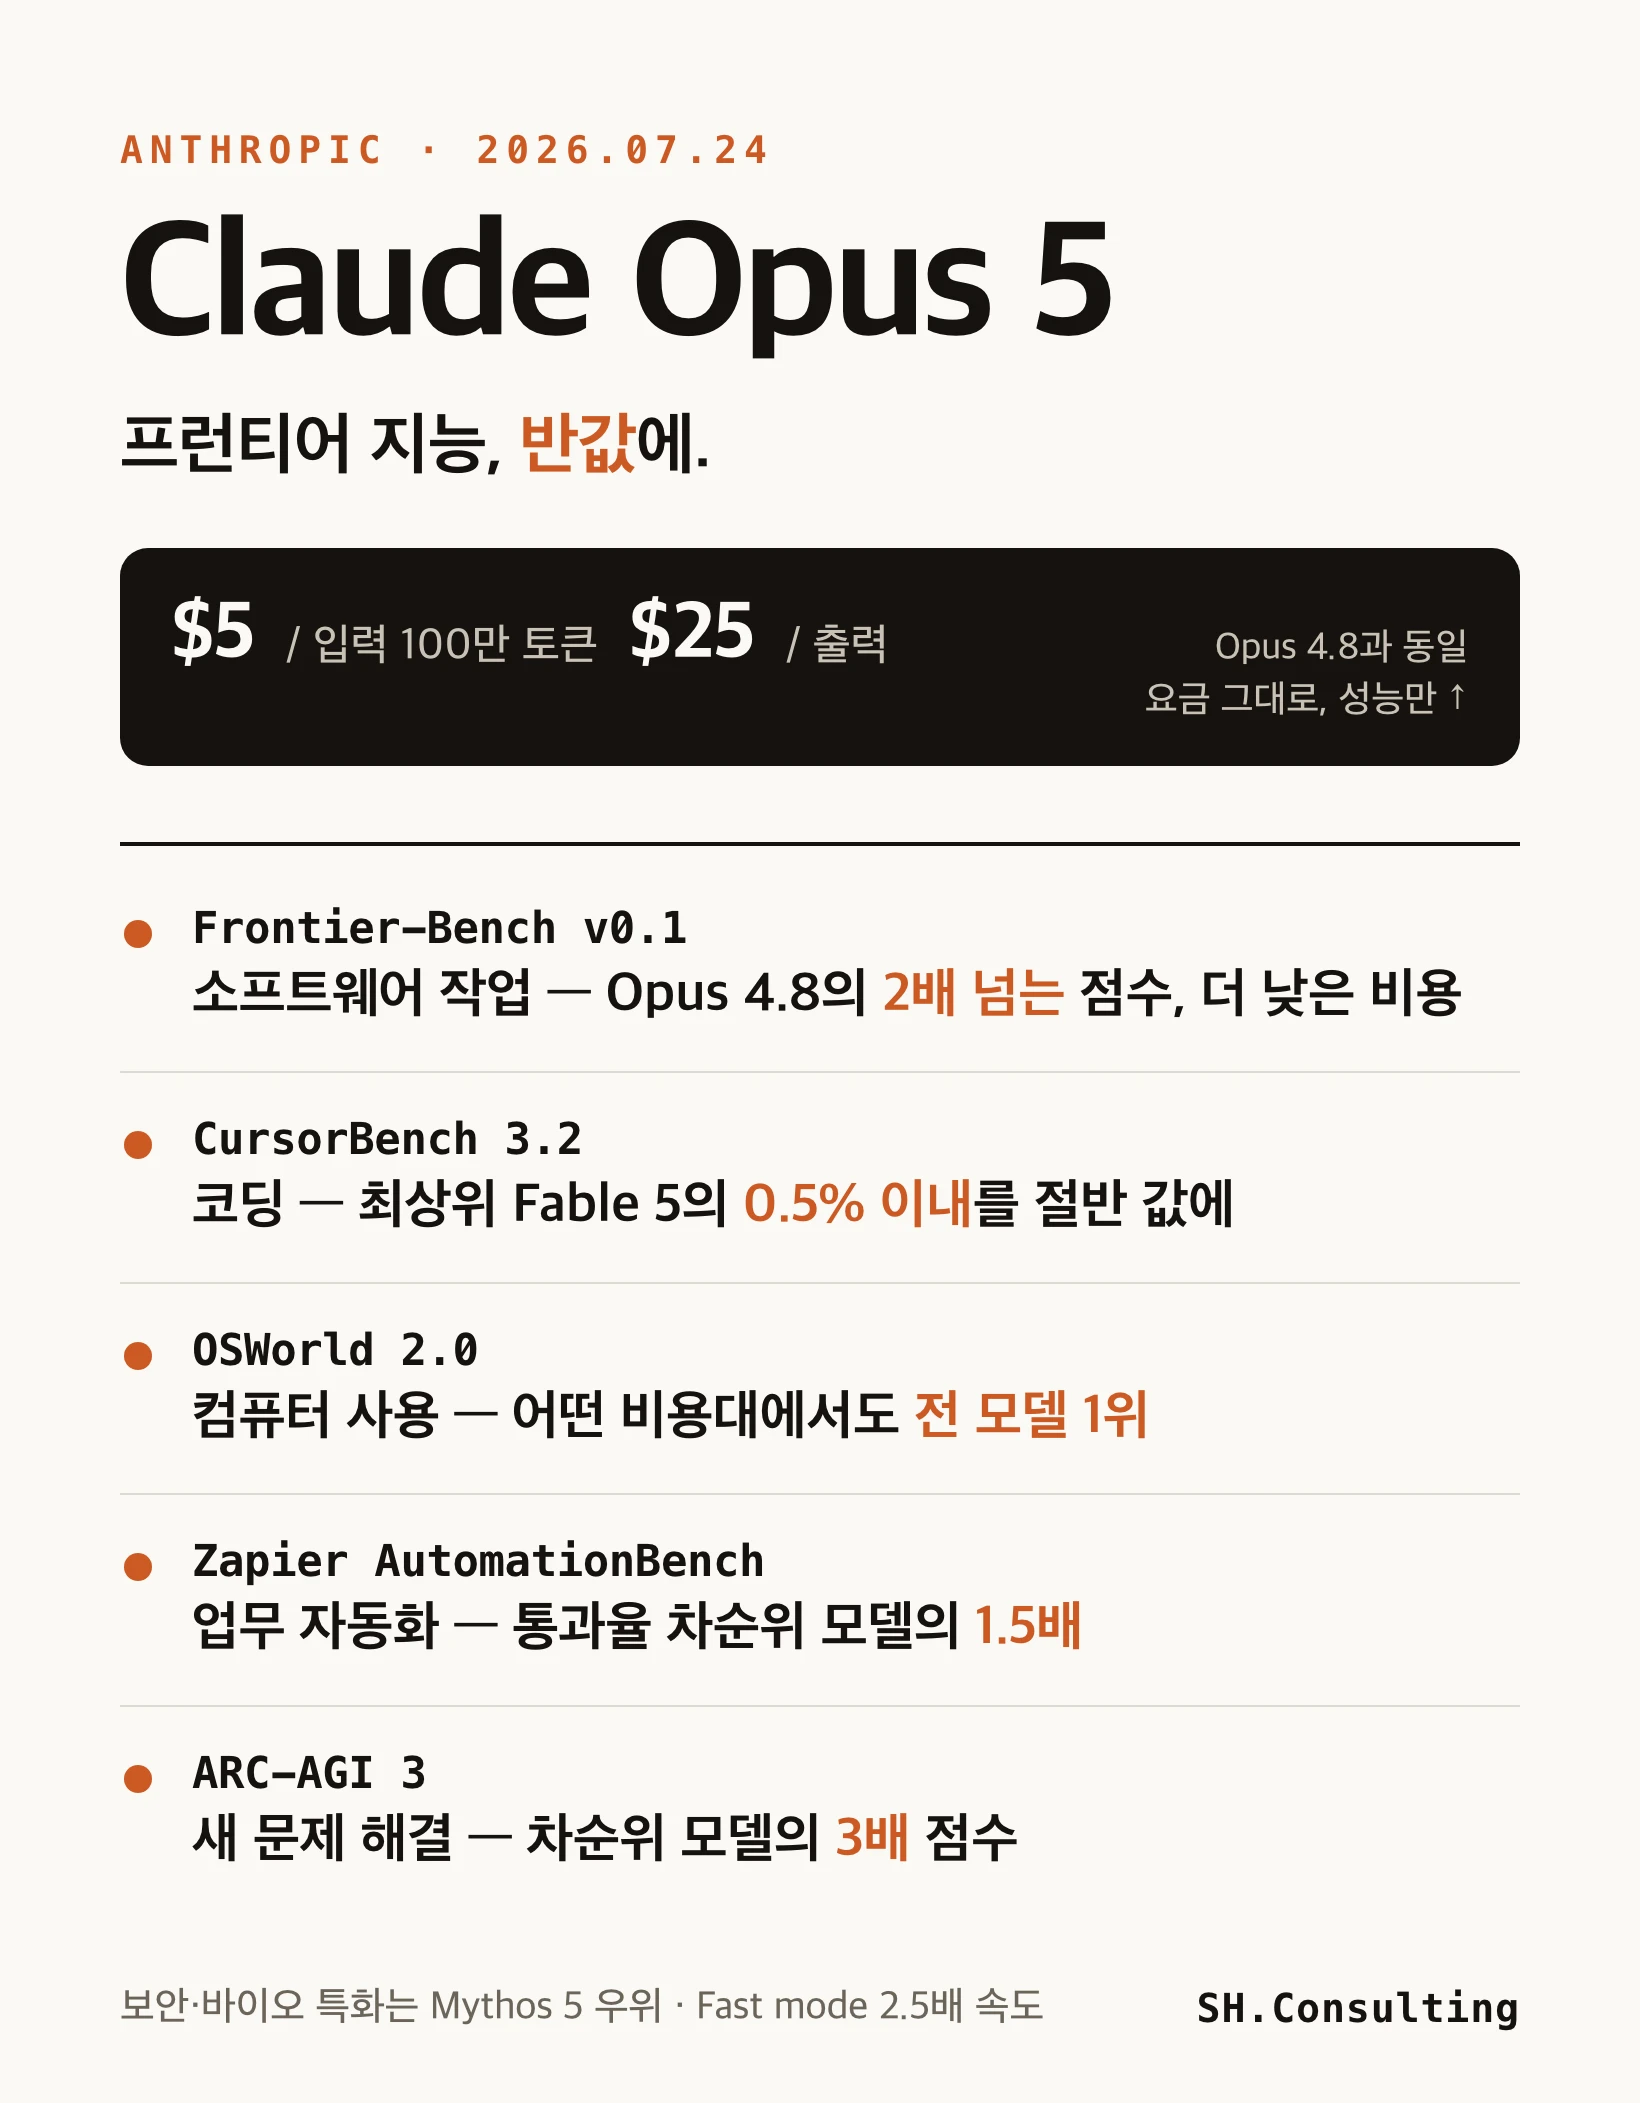
数時間に及ぶ Claude Code のセッションをどう操縦するか——Plan・Compact・Rewind・Goal・Loop・Worktree
短いタスクは指示して終わるのを見ていればよいが、十数ファイルにまたがるリファクタや数時間かかる新機能のような長いタスクは、放っておくのではなく「操縦」するものだ。支える習慣は二つ。Claude が始める前に範囲を絞り、走っている間に方向を取る。六つの道具がそれを可能にする。Plan Mode は読み取り専用で調査して計画を渡す。読んで練り直せば、実行時のつまずきが減る。Compact は会話を要約して新しい文脈にし、古いものを消して文脈ウィンドウを空ける——コマンドに指示を添えれば何を残すかを Claude に伝えられ、大事なものを落とさず逸れない。Rewind は(空のプロンプトで escape を二度押して)チェックポイントに戻し、コード・会話・その両方を復元したり、その地点の前後を要約したりする。Goal は完了条件を設定する。完了の姿を描けば、Claude は自分で終わったと思う最初の瞬間に止まらず、速い評価器がそれを確認するまでターンをまたいで働き続ける(評価器は会話記録だけを読むので、条件は Claude の出力から確認できるものでなければならない)。Loop はプロンプトを一定間隔で走らせ、CI 実行やデプロイのような外部の状態を見張り、変化したら反応する。Worktree は複数のエージェントにそれぞれ独立したファイルツリーを与え、同じリポジトリを奪い合わないようにする。まず範囲を絞り、それから操縦すれば、長い実行に張り付かずとも信頼できる。
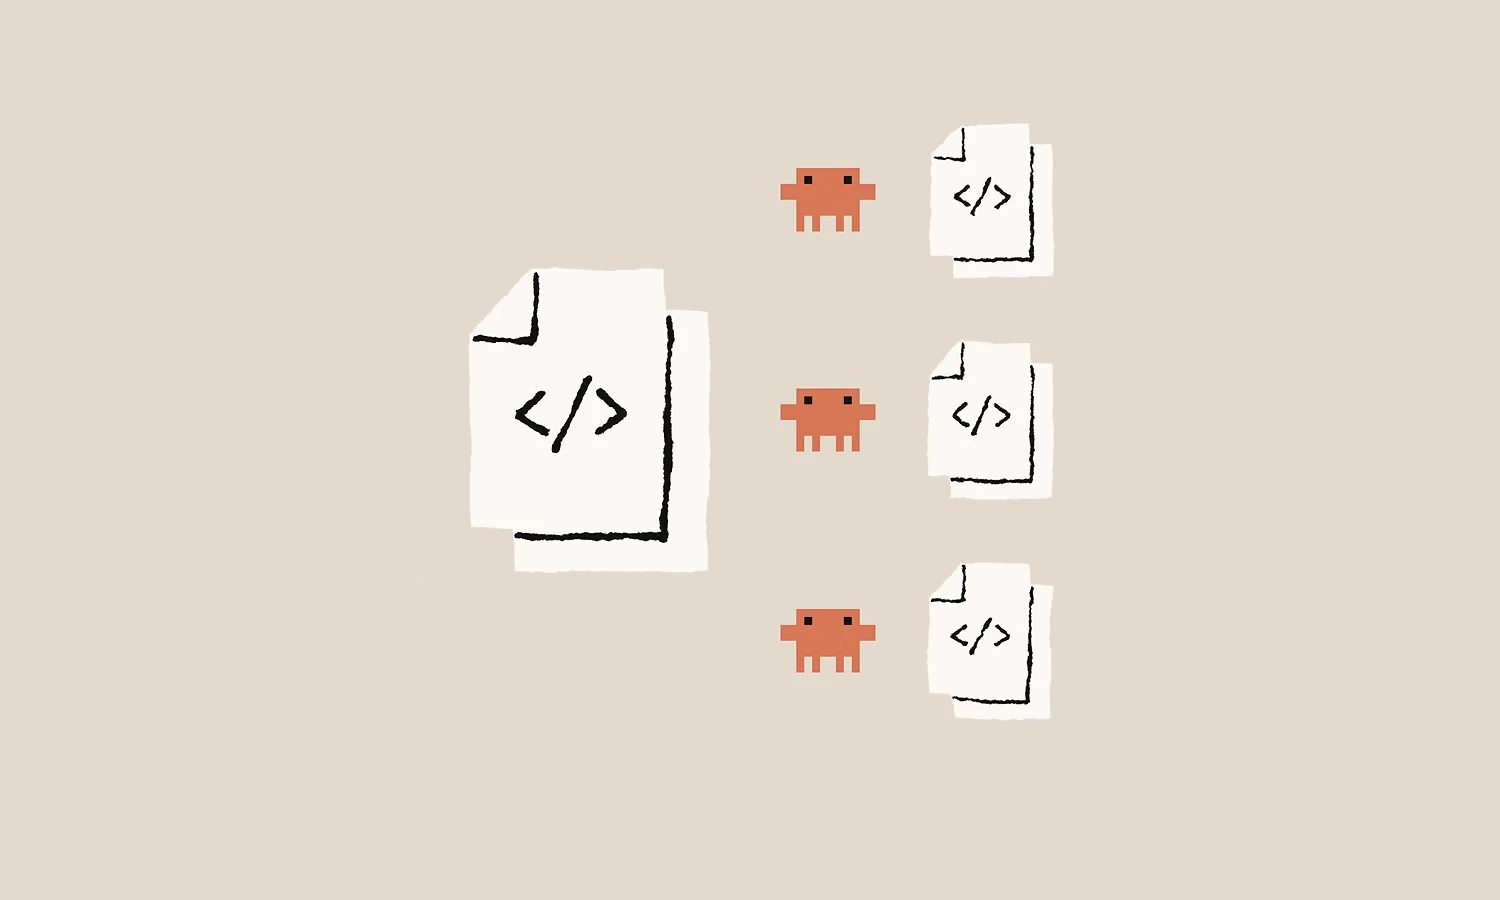
Claude Code の権限モードとは何か、いつ auto で手を離してよいのか?
権限モード(permission mode)は、毎回あなたの承認を得なくても Claude Code が何を実行してよいかを一度だけ決めておく設定だ。六つある。manual は読み取りのみで、それ以外はすべて尋ねる。acceptEdits は読み取り・ファイル編集・よくあるファイルシステム系コマンドまで尋ねずに進め、あとでまとめてレビューさせる。plan は読み取って調査し計画を提案するだけで編集はしない。auto はすべてを実行しつつ、別個の分類器モデルが各アクションを実行直前に審査して危険なものだけを止める——手を離すときの既定だ。dontAsk は事前承認したツールだけを許可し、それ以外はプロンプトなしで自動拒否するので CI や夜間バッチに向く。bypassPermissions はすべてのチェックを飛ばす dangerously-skip-permissions と同じで、隔離されたコンテナや VM の中でのみ使う。shift+tab で manual → acceptEdits → plan → auto を巡回し、ステータスバーが現在のモードを示す。auto の分類器は意図は守るがコードが正しいかは見ないため、テストを走らせる stop hook と併用し、意図は分類器が、正しさは hook が分担する。結局、どこまで手を離すかは度胸ではなく仕事に合わせて決め、それに合うモードを選べばよい。
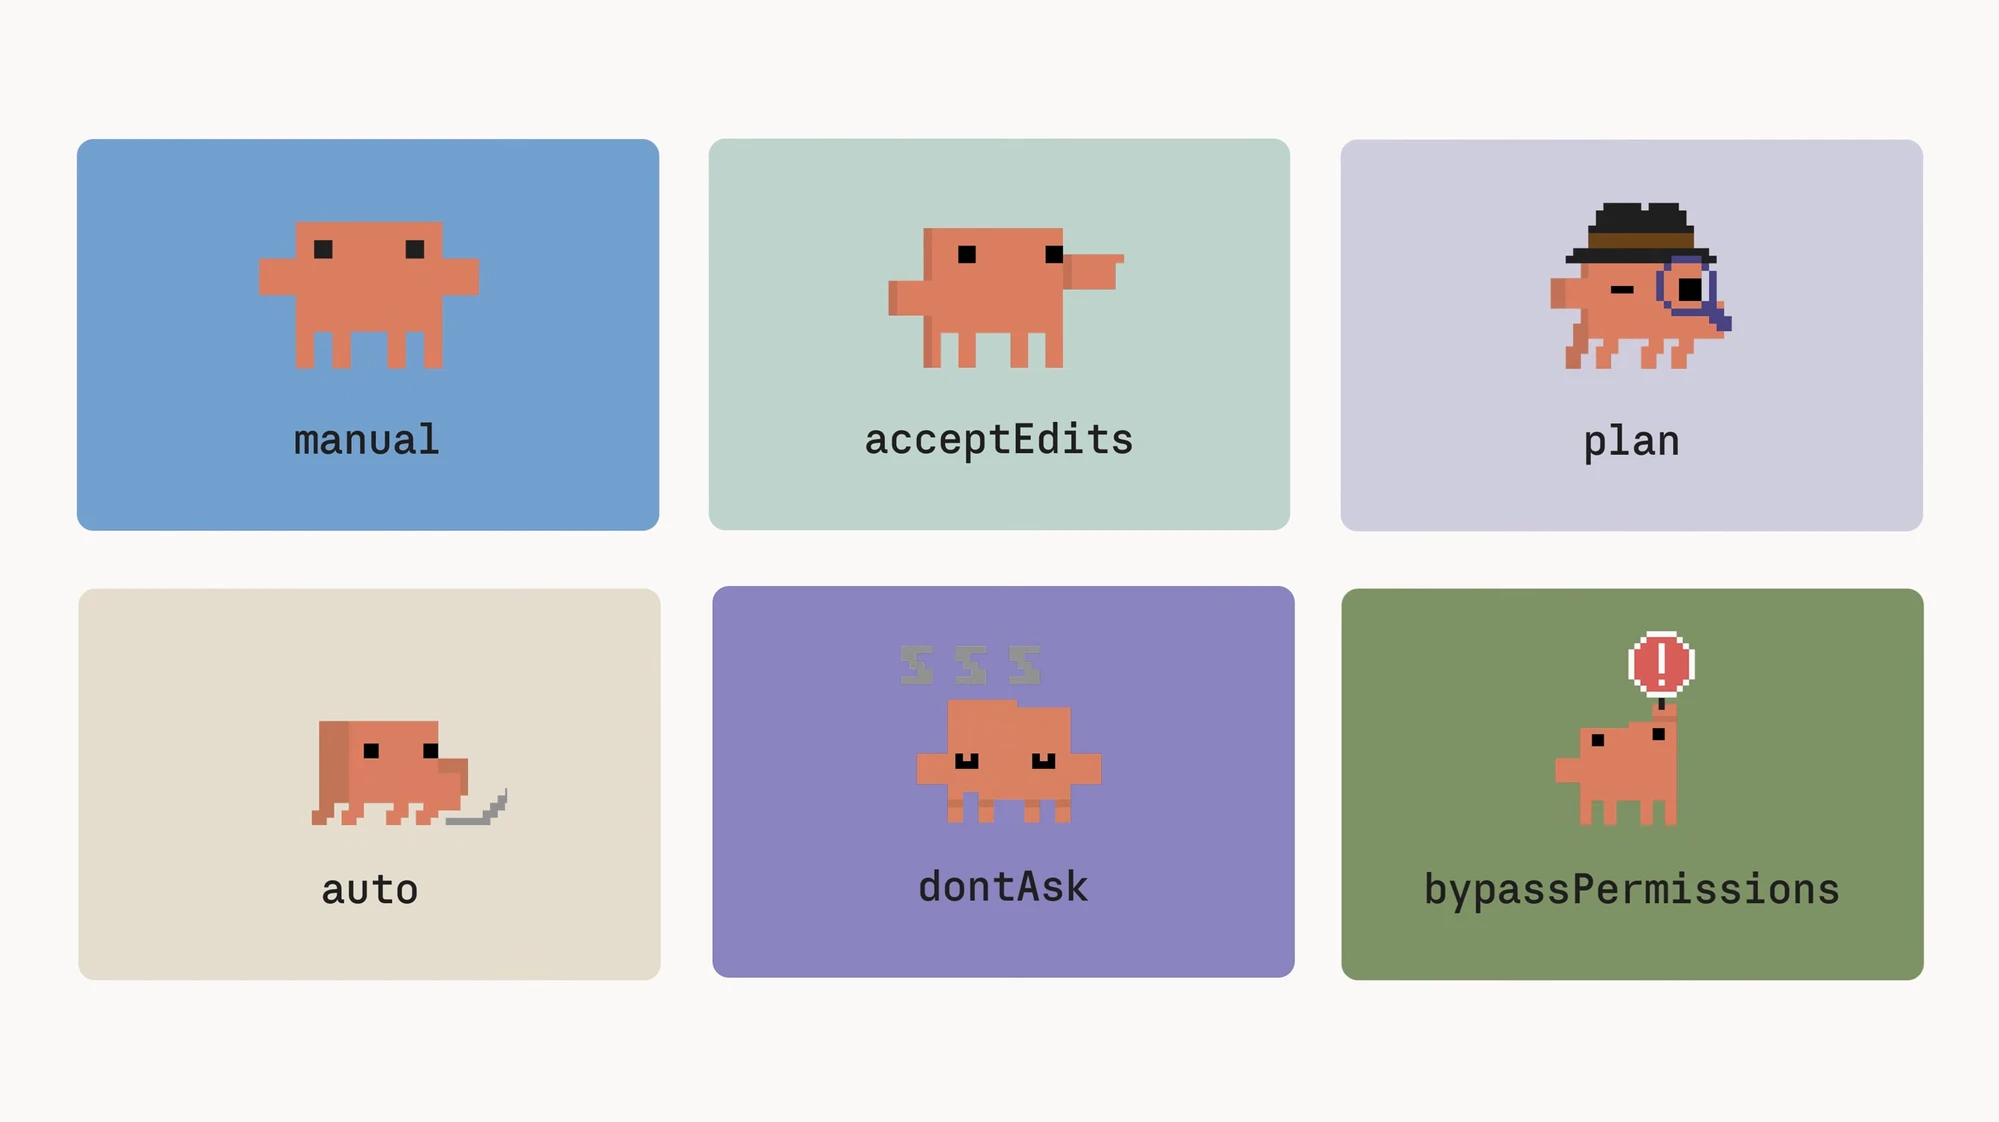
バイブコーディングとは何か、ツールからデプロイまでの全体はどう一枚の地図に畳まれるのか?
バイブコーディングとは、コードを一行ずつ自分で打つ代わりに、AI に自然言語で望みを伝えてウェブサイトやサービスを作る方法だ。初心者が戸惑うのは、個々のツールが難しいからではなく、各部分がどう噛み合うかの全体像が頭にないからだ。その全体像は一枚の地図に畳まれる。第一にツール。ChatGPT や Claude のような LLM は学習済みの脳、コーディングエージェントはその脳を載せて実際にファイルを作り・直す手足であり、今では Claude Code 一つが端末やエディタなしにこの役割を単独でこなす。第二にフロントエンド(目に見える画面)。作るサービスのおおよその規模を伝えれば、エージェントが合うスタックを選ぶ。第三にバックエンド(画面の裏でデータを保存・処理するサーバー)。ここで多くの人が諦めるが、Supabase(データのマネージャー)と Vercel(デプロイのマネージャー)がその壁を越えてくれる。Git と GitHub はその間で、作業を保存しネット上の倉庫に収める役を担う。結局、地図は三行に畳まれる。ツールは Claude Code、フロントは規模を伝えてスタックを任せ、バックエンドは Supabase と Vercel。
Scraplingとは何か、なぜサイトが改装されてもスクレイパーが壊れないのか
ScraplingはPythonでWebデータを収集するオープンソースのフレームワークです(BSD-3ライセンス、GitHubスター7万)。最大の特徴は適応型セレクタです。普通のスクレイパーは「このクラス名を持つ要素を取れ」のようにページ上の位置を規則で指定してデータを抜くため、相手サイトが改装されてクラス名や構造が変わると規則がすべてずれ、空の値しか返りません。Scraplingは最初の収集時に要素の特徴を一緒に保存しておき、次の実行でadaptiveオプションを有効にすると、類似度アルゴリズムで移動した要素を再び探し出します。だからサイトが変わっても、人がセレクタを直し直す必要がありません。さらに、Cloudflareのようなアンチボットの回避、大規模な並行クローラ、Claude・Cursorに接続できる内蔵MCPサーバーまで、一つのライブラリに収まっています。
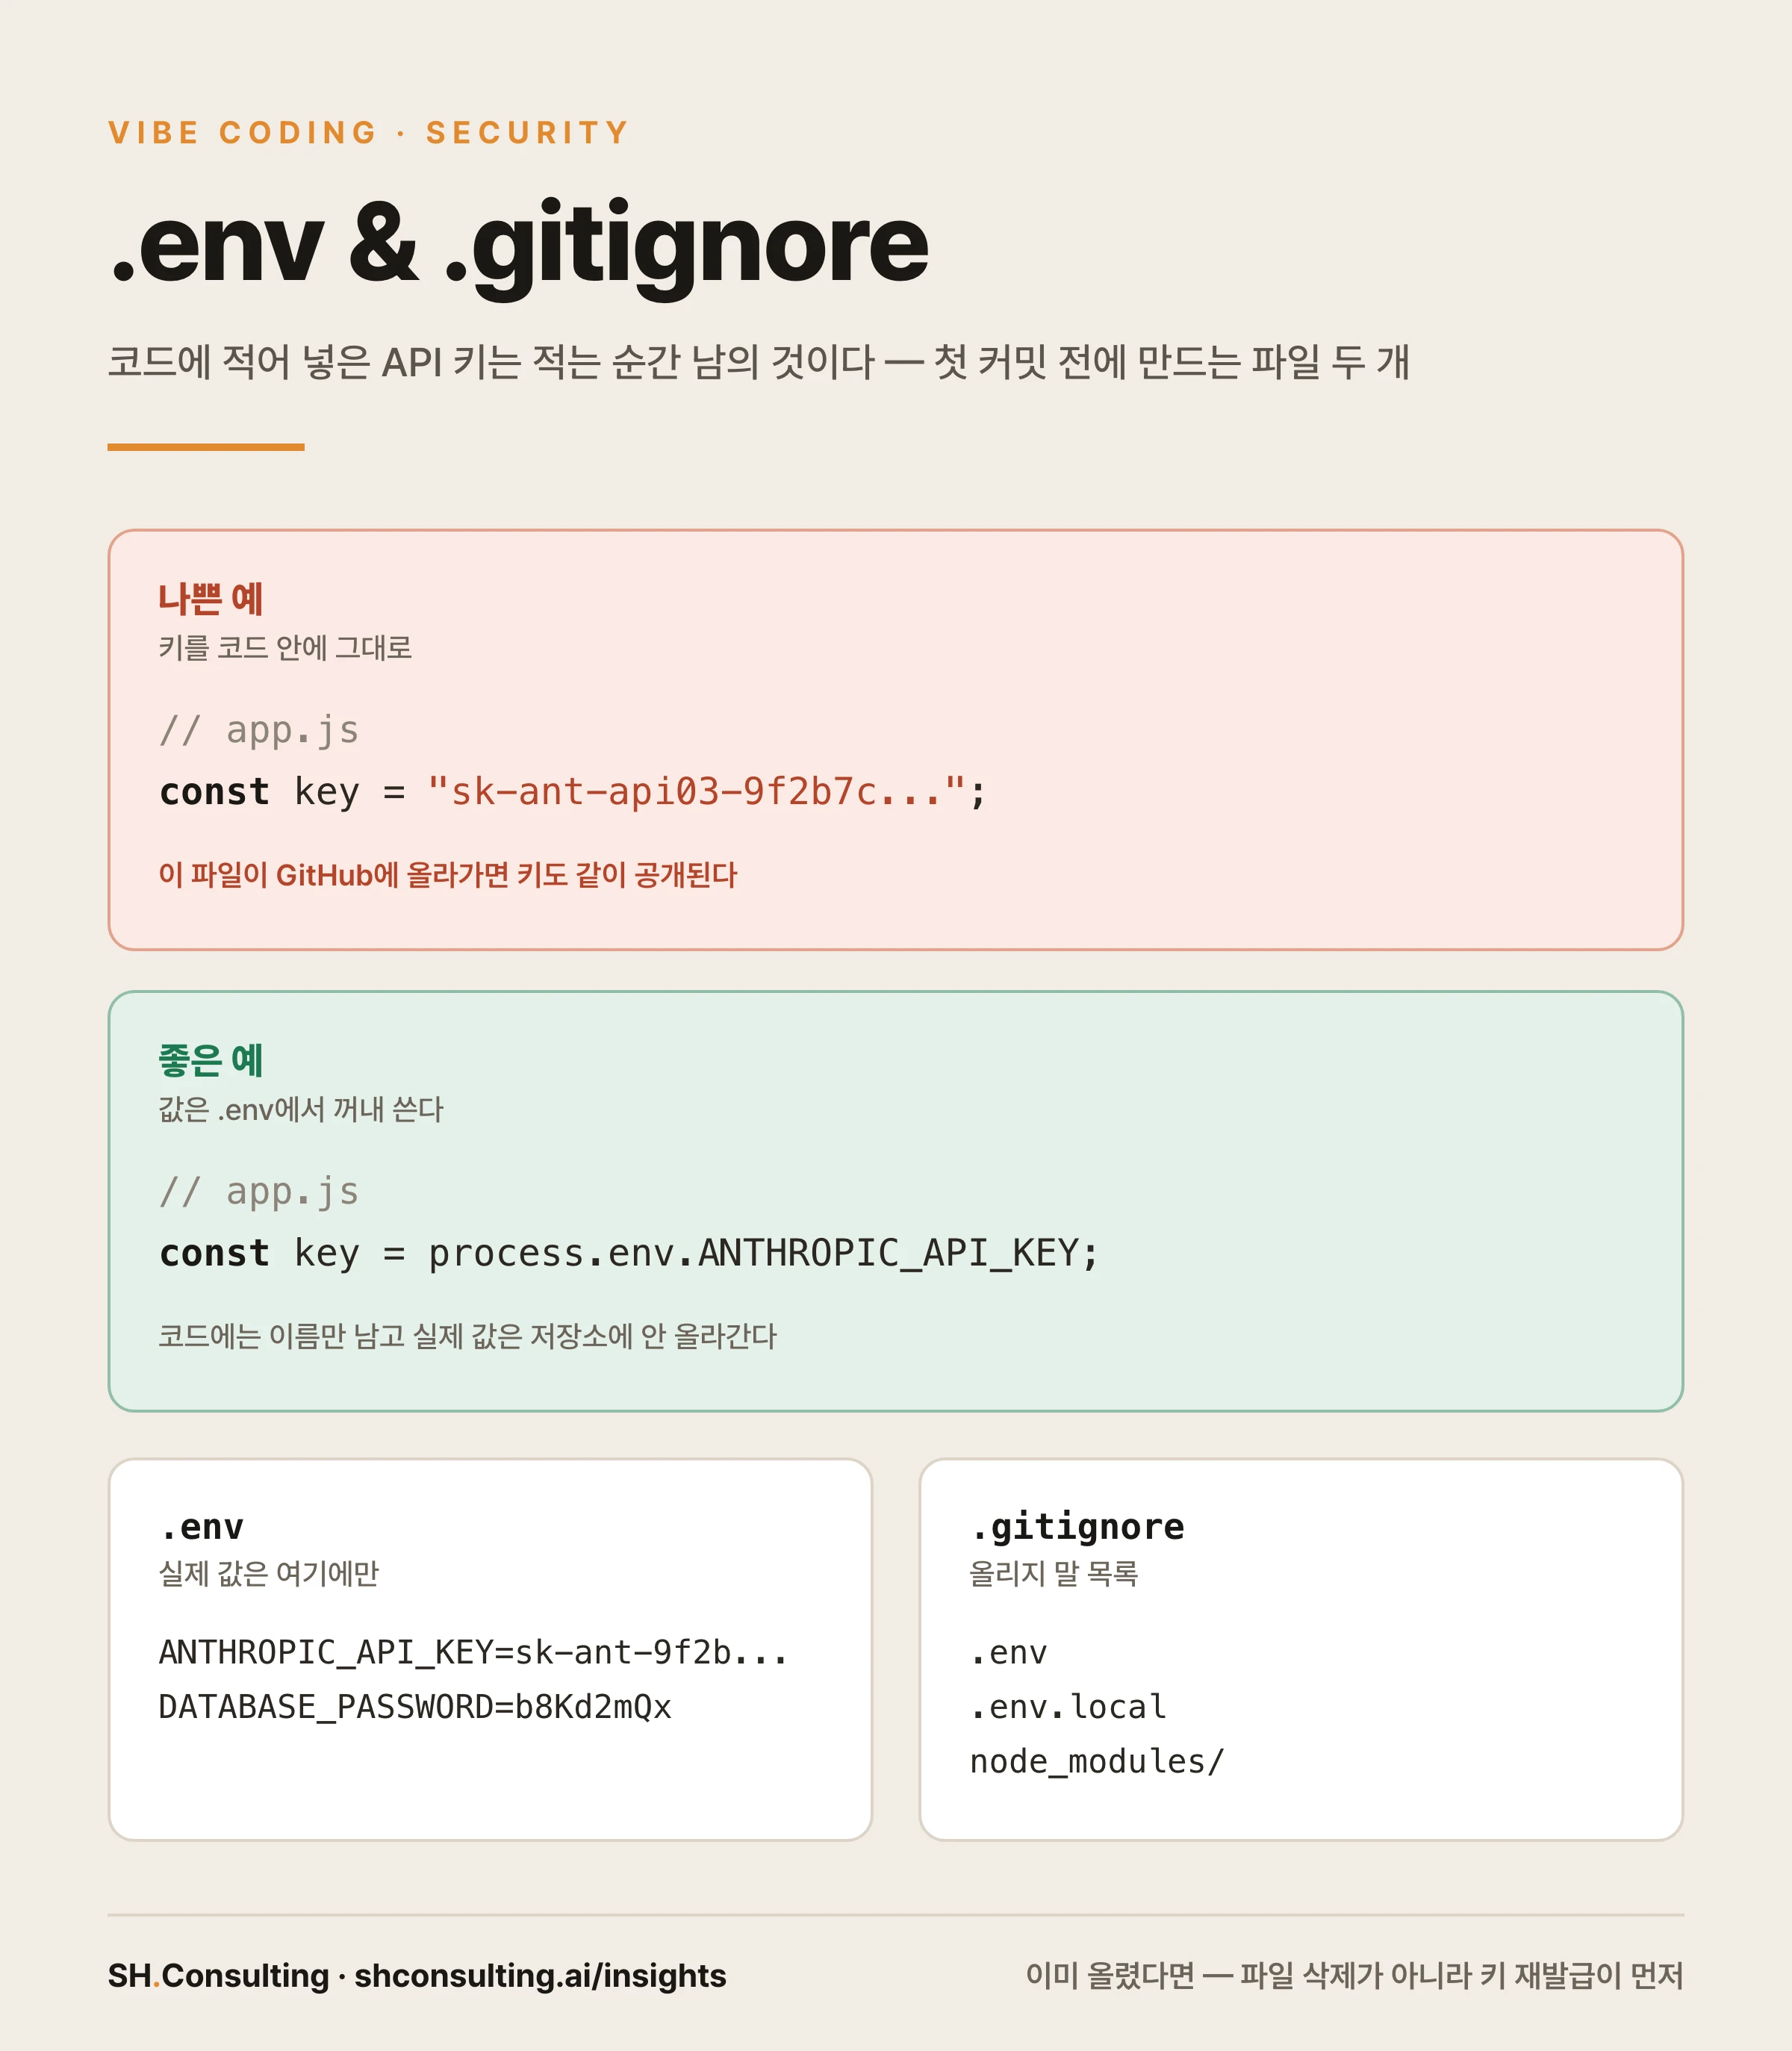
.gitignore と .env とは何か、なぜ最初のコミット前に作らなければならないのか
.env は API キーやパスワードのように他人に見られてはいけない値をコードの外に出して置いておくファイルで、.gitignore は「このファイルはリポジトリに上げるな」と git に伝える一覧です。どちらもプロジェクト初日、最初のコミット前に作ります。コードに書き込んだキーは GitHub に上がった瞬間に公開され、公開リポジトリを走査してキーだけを拾う自動スキャナーが数分で見つけるからです。すでに上げてしまったなら、ファイルを消すことより先にキーを再発行します — git の履歴には古いキーがそのまま残ります。
AI時代に人へ残る能力とは何か
AIへ渡るのは答えを出す仕事と、その答えを採点する仕事だ。人に残るのは何を採点するかを決める仕事である。いまAI業界で最も高く買われている資産は、各分野の専門家が持つ判定基準、すなわちeval・verifierと呼ばれる採点表だ。しかし採点表は一度抽出されれば複製され、採点そのものもモデルがモデルを審査する形で急速に自動化されつつある。自動化されずに残る層はその上にある。どこを見るかを選ぶ好奇心と、何を良しとするかを選ぶ好みだ。どちらも目的関数を定める行為であり、目的関数はモデルが自ら書けない。
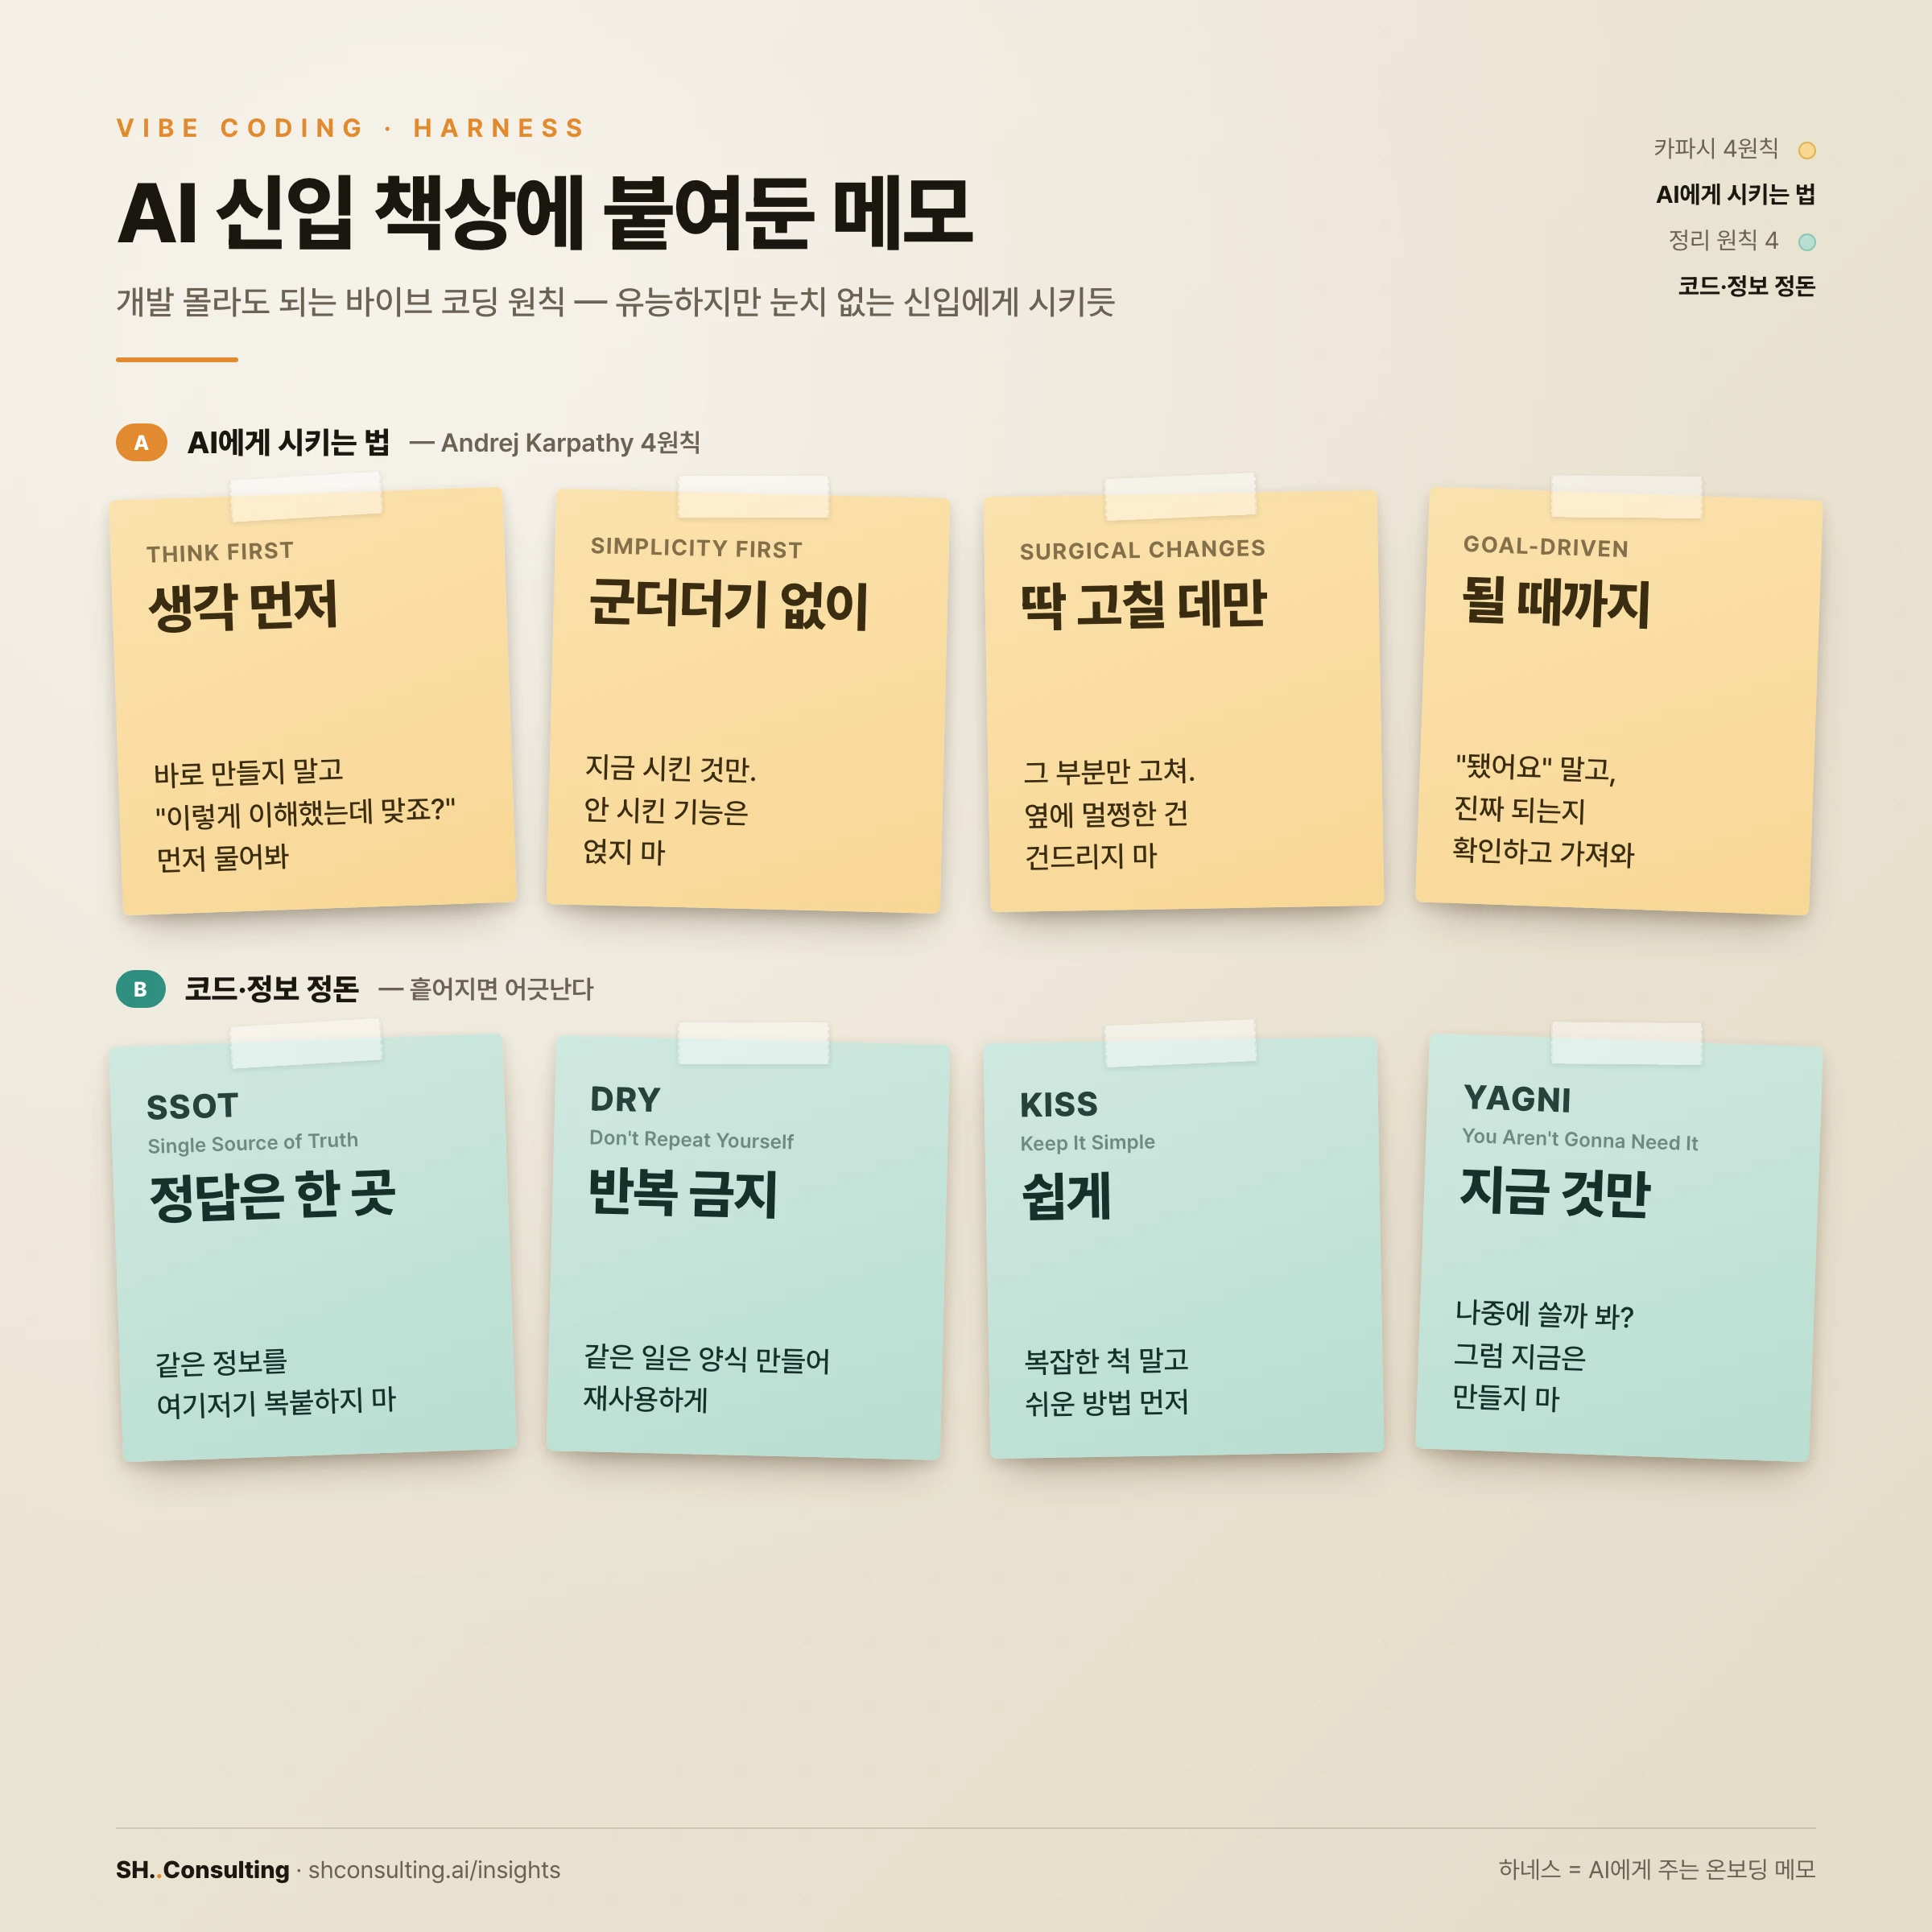
Vibe Coding の原則 —— AI にコードをうまく頼むには何を決めておくべきか
AI にコードをうまく頼む原則は大きく八つある。アンドレイ・カルパシーの4原則(まず考える・余計を足さない・直す所だけ・ゴール駆動)と、コードを整頓する4原則(SSOT・DRY・KISS・YAGNI)だ。この八つは実は四つの常識(着手前に確認・シンプルに・任せた所だけ・一か所にまとめる)に畳める。これらを CLAUDE.md または AGENTS.md というファイル(=ハーネス)に一度書いておけば、AI は毎回の対話をその指示から読み始める。優秀だが気の利かない新人の机に貼るメモだと思えばいい。
Vibe Coding の「ハーネス(harness)」とは何か、非開発者はまず何を設定すべきか
ハーネスとは、AI が自分のレベルや状況に合わせて働くよう、プロジェクトにあらかじめ書いておくルールと案内文のことだ。Vibe Coding(自分でコードを書かず、AI に指示して作る方法)を初めて行う非開発者がまずやるべきハーネス設定は、たった一行である。プロジェクトフォルダに CLAUDE.md または AGENTS.md というファイルを作り、「私は開発者ではない。専門用語は必ずやさしい言葉で、できるだけ短く簡潔に説明せよ」と書いておけば、AI は毎回の対話をその指示から読み始め、すべての回答の目線が変わる。
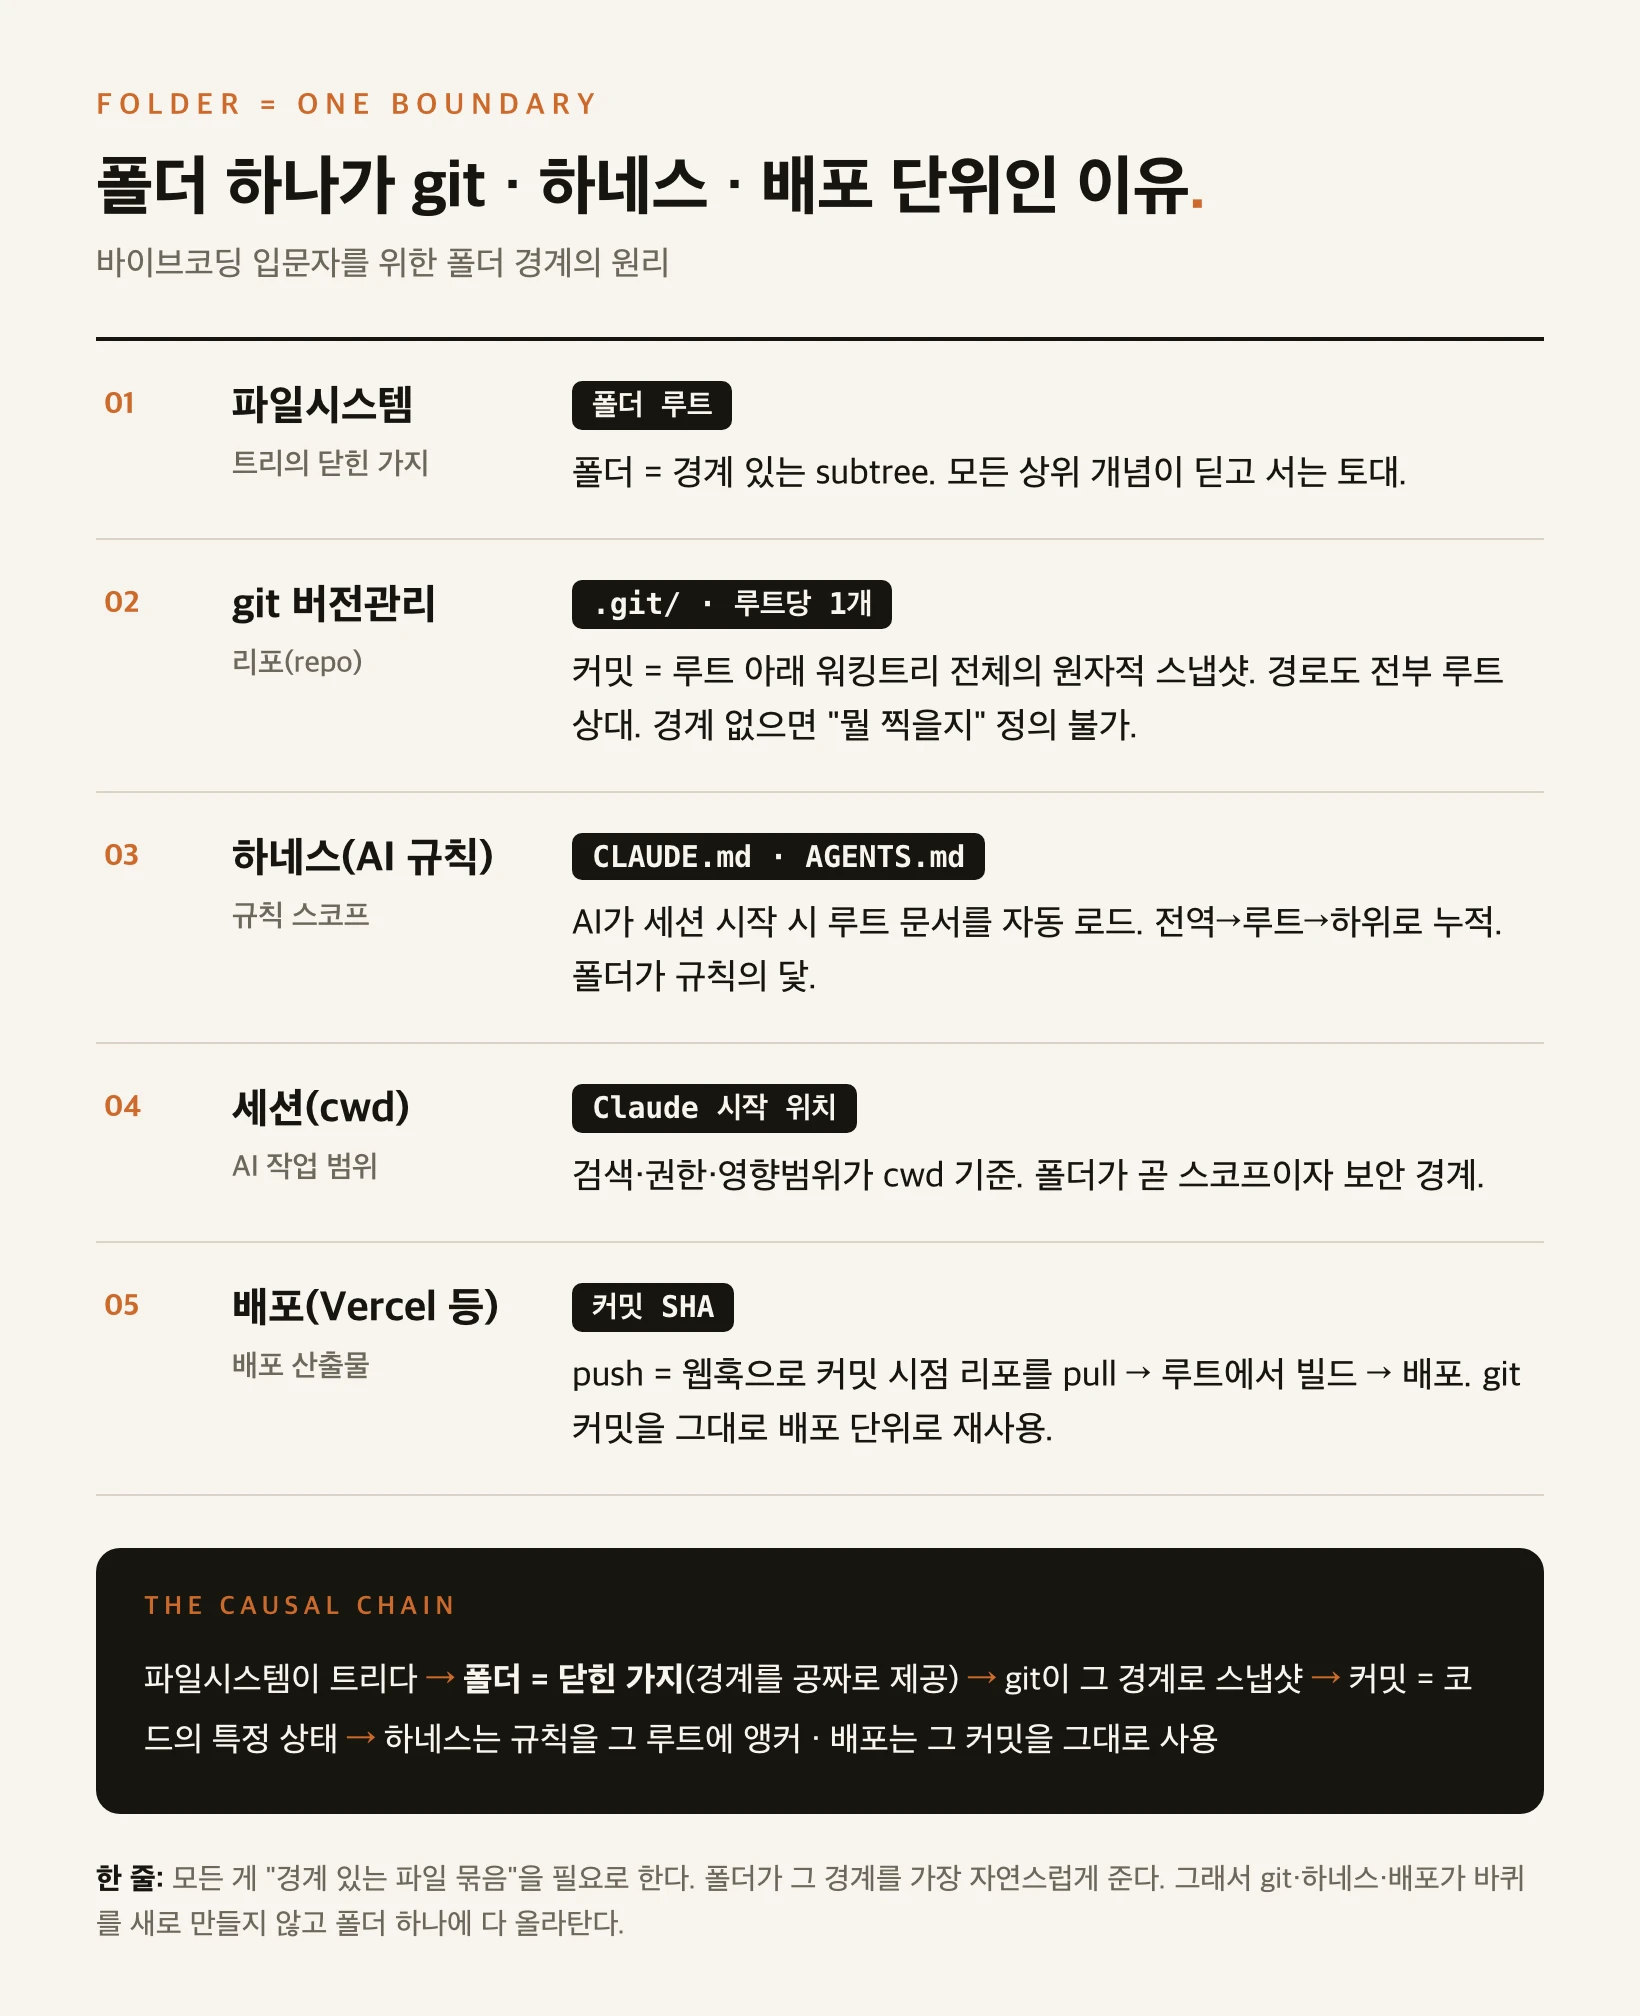
バイブコーディングで、なぜプロジェクトを1つのフォルダに置くのか
フォルダが git・ハーネス・デプロイの共通の境界だからだ。ファイルシステムは木構造なので、1つのフォルダは境界を持つ閉じた枝(subtree)になり、git リポジトリ(ルートごとに .git が1つ)・AI ルール文書(CLAUDE.md・AGENTS.md)・デプロイ(commit SHA)がすべて同じフォルダ境界を再利用する。だから push 一回で保存・ルール適用・デプロイが同時に走る。プロジェクトは入れ子にせず横に並べ、各フォルダのルートから作業を始めるのが標準だ。
「AIウォッシング」とは何か、リストラの本当の理由は何か
「AIウォッシング」とは、業績プレッシャーや組織の肥大化といった本当の理由を隠し、リストラをAIのせいにして偽装することを指す。米国では今年上半期だけで「AIが理由」と明言されたリストラが10万件を超えたが、CFO700人を対象にした匿名調査では90%が「過去1年間、AIが自社の雇用に与えた影響は実質的になかった」と答えている。実際に起きているのはAIが人を直接置き換えることではなく、AIをうまく使いこなす少数の人が何人分もの仕事をこなし、とりわけ新卒・低経験者の採用の門を閉ざしているという現象である。
ニュース記事が本当か嘘か、どう交差検証するか
同じニュースが複数の媒体に出ていても交差検証ではない——大半は通信社の一本を転載しただけだからだ。このプラグインはニュースの URL を受け取り、核心的な主張を抜き出し、互いに独立した情報源で一つずつ照合して真偽を判定する。判定は AI の勘ではなくコードが計算し(独立した支持 2 件以上=事実、独立した反証 2 件以上=虚偽、満たさなければ検証不可)、通信社の転載は一つに畳む。ボット遮断のサイトも回避して読む、オープンソース(MIT)の補助ツールだ。
インスタのリール内の場所を、映像だけでどう逆探知するか
宣伝用のリールは人を惹きつける必要があるため、画面に手がかりを大量に残す。このスキルは映像からフレームを抜き、その手がかり(看板・ランドマーク・字幕・キャプション)を AI が読み、Kakao マップ・Naver ブログ・投稿者アカウントを並行して探して候補を絞り、反証まで試みたうえで場所を確定する。Claude Code にプラグインとして入れ、リールの URL を渡すだけ。店舗・観光地など公開された場所の宣伝コンテンツ専用で、オープンソース(MIT)だ。
K Public Data MCP の病院詳細照会は何を追加したのか
K Public Data MCP は、韓国の公共データを AI がそのまま使えるようにまとめたオープンソースの MCP サーバーだ。今回、健康保険審査評価院(審評院)の「医療機関別詳細情報サービス」を接続し、病院を名称・地域・区分で検索したうえで、その病院の施設・病床、診療科目別の専門医数、保有する医療機器(PET・CT など)、交通情報までを一度に照会できるよう拡張した。検索で止まっていたデータが、病院の「中」まで届く。
Claude Code Remote Control とは何か——ローカルセッションをスマホで引き継ぐ
Claude Code Remote Control は、自分のコンピュータで動いている AI コーディングセッションを、スマホ・タブレット・別のブラウザからそのまま引き継いで指示する機能です。セッションは引き続き自分のコンピュータで動き(クラウドではありません)、コード実行とファイルアクセスも自分のデバイスに残ります。スマホとブラウザは、そのローカルセッションを覗いて話しかけるための窓です。プロジェクトフォルダで claude remote-control と一行打つとセッション URL と QRコードが表示され、スマホで QR を読み取ると Claude アプリでそのセッションが開きます。claude.ai の Pro・Max・Team・Enterprise のサブスクリプションで使え、2026 年 7 月時点でリサーチプレビュー(research preview)です。
ir-search とは何か——政府の補助事業を全数調査する AI スキル
ir-search は、韓国の政府・公共機関の補助事業を『全数調査』してくれるオープンソースのエージェントスキルです。K-Startup・Bizinfo(企業마당)・NIPA・KOCCA・SMTECH の募集中公告を丸ごとクロールし、あなたのプロジェクトのプロフィール(創業段階・地域・必要なもの)に合う事業を選び、詳細公告の原文で資格を検証したうえで、今すぐ申請可能(A)・条件を満たせば開く(B)・言い換えれば対象になる(C)の三グループに分けた報告書を作ります。Claude Code・Codex・Cursor・Gemini など複数のエージェントで一行で導入・実行でき、すべての公告に原文 URL を付け、公告に無い情報は推測せず『不明』と表記します。作者(djfksjd)が MIT ライセンスで公開しています。
AI が作った会員登録に欠けている 5 つは何か
AI に『メールとパスワードで会員登録を作って』と一行で頼めば画面は 5 分で出てきますが、その成果物にはパスワード再設定、会員情報の編集、退会、個人情報保護方針、利用規約の 5 つが欠けています。これは機能をもう一つ足す問題ではなく、方針を決める意思決定の問題です。再設定リンクを何分有効にするか、退会データを本当に消すか匿名化だけにするか、方針を実際に集める項目に基づいて書くか——これらを人が先に決めてこそ、AI にきちんと指示できます。退会や方針を抜かせば個人情報保護法違反で過料の対象になります。AI 時代に作る人の実力は、コードではなくこの意思決定リストから生まれます。
GPT Live でリアルタイム同時通訳はどうやるのか
GPT Live は OpenAI が出した新しい ChatGPT 音声モデルで、聞くことと話すことを同時に行う「フルデュプレックス(full duplex)」構造のおかげで、人が話している最中でも割り込むべきときと引くべきときを自ら判断します。だからこそリアルタイム同時通訳が自然になりました。使い方は、ChatGPT アプリで音声モードをオンにし、「今から私が韓国語で話すのを英語にすぐ通訳して」と一文で指示するだけです。発表者が韓国語で話すと AI がその場で英語に訳し、相手のイヤホンへ流し込み、二人の声が重なっても途切れません。この機能は無料ユーザーにまで開かれ、通訳がお金と人手の問題だった時代が終わりつつあります。
エンタープライズIQ(Enterprise IQ)とは何か、なぜAI変革は「AIの差し込み」ではないのか
AI変革が成功するかは、既存業務のどこにAIを差し込むかではなく、自社が市場で勝ってきた固有の戦略ロジック——BCGが「企業の脳(Enterprise IQ)」と呼ぶもの——をAIに埋め込めるかにかかっています。多くの企業は「差し込み(deployment)」で止まります。業務の順序はそのままに、工程の合間へAIを挟み込むだけで、手足が速くなるにすぎません。BCGの言う「リシェイプ(reshape)」は順序そのものを設計し直し、新製品企画を半年〜1年から1〜2か月へ縮めます。この再設計を可能にする脳は、OpenAIにもPalantirにも作れず、自分の市場の論理を理解する会社だけが作れます。
顧客が自分で開発する時代、受託開発会社は何を残すのか
顧客が AI で自ら開発できる時代に、受託開発会社が残すのは完成した成果物ではなく、『判断する関門』と『顧客が自分でできるようにする教育』です。AI 開発会社リトマスは、顧客が画面上で直したい箇所をクリックしてコメントを残すと、それがチケットになりエージェントが開発に入る仕組みを作り、プロジェクトが成熟すると PM が何を反映し何を止めるかを関門で判断します。同じ骨格で SH Consulting は、RFP を 100% 実装して引き渡す代わりに核となる 80% を作り、残る 20% は AX 教育で顧客が自分で仕上げて保守できるよう支援します。AI が実行を肩代わりするほど、開発会社の価値はコードから判断と教育へ移っていきます。
士業の事務所に AI エージェントを組み込むと何が変わるのか
士業の事務所に AI エージェントを組み込むとは、専門家の『判断』の手前にある反復作業——問い合わせの受付、案件・相談の類型分類、一次的なリスク整理——を AI が担い、人は判断と責任にだけ集中できるよう業務を再設計することです。検事 21 年の経歴を持つ李永男(イ・ヨンナム)弁護士の事務所サイト thechain.lawyer がその事例です。訪問者が自分の状況を書き込むと、AI 相談エージェントが案件の類型を分け、争点とリスクを一次整理して弁護士に渡し、弁護士は整理された文脈の上で判断だけを行います。ベテランの直感はそのままに、その手前の反復だけを取り除く構造なので、AI は専門家を置き換えるのではなく増強します。
AI が出した結果、どこまで理解し、どこで打ち切るべきか
AI で仕事をするときは、すべてを理解しようとせず、どこまで掘り、どこで打ち切るかの線を先に引きます。全部を理解しようとすると、かえって自分の理解がボトルネックになり仕事が遅くなります。核心となる技術は、深く理解する代わりに、安価な反復検証で信頼を買うことです。たとえば同じ AI に『これ本当に合ってる?』と三回問い直し、三回とも合っていると言えば、そのまま信頼して打ち切ります。お金の流れ・セキュリティ・契約のように、間違えると致命的な箇所だけ検証ゲートを厳しくすればよいのです。本稿では、その線の引き方、問い直しの実際の回し方、何を覆い何を残すかを、初めての人でもそのまま真似できるように整理します。
Claude Designとは何か、非開発者はどう始めるのか
Claude DesignはAnthropicが作ったAIデザインツールで、チャットのように会話するだけでウェブサイト・プロトタイプ・プレゼン用スライド・広告・ドキュメントを作ってくれる、Anthropic Labsのリサーチプレビュー製品です。Claudeのフロンティアモデル(本稿が参照するチュートリアル時点ではOpus 4.8)で動き、Pro・Max・Team・Enterpriseの購読者がclaude.aiのサイドバーやClaudeデスクトップアプリから使えます。肝は、まず「デザインシステム」を作ってブランドのフォント・色・ロゴを固定し、その上ですべての成果物を同じトーンで出す点です。仕上げたデザインはClaude Codeに渡して本物のコードにし、デプロイまでつなげられます。本稿は、デザイナーや動画編集者なしに一人でブランド資産一式を作る流れを、初めての人の目線で一つずつたどります。
HITL: AI が企画・開発までやるのに、なぜ人は残るのか
AI の業務自動化は反復実行を超え、新規サービスの企画・開発へ広がります。AI の CS ボットは、問い合わせの種類では 20% でも実際の業務量では 80% を占める反復問い合わせ(パレート 8:2)を根拠付きで自動処理します。さらに、コミュニティの声をモニタリングして AI が新規サービスを自動企画・開発するパイプラインでは、人は『Go/Stop の決定』と『機能テスト』の二つの判断地点にだけ残ります。このように人を自動化のループ内に残して判断させる仕組みを HITL(Human In The Loop)と呼びます。実行から企画まで機械が担い、人の仕事は判断へ収束します。
GPT-5.6 のワークとクロードのコワーク、業務自動化はどちらが優れているか
ある AI 教育クリエイターが GPT-5.6 とクロード・フェイブル5 に同じプロンプト(YouTube データをリアルタイムで取り込むダッシュボード作成)を与えて比較したレビュー。二つのツールの性格が分かれた。クロードは手段を選ばず素早く望む結果を持ってくる一方、GPT は長く考えて安全に進み、新しい『サイト』機能で実際に配備できるサービスまで作る。しかし本当に重要なのは成果物ではなく構造の変化だ。これまで人が手で組んでいたハーネス(サブエージェント・スキル)がツールの中に吸収され、ユーザーはその概念を知らなくてよくなった。これが企業の AX 導入の参入障壁を実質的に下げる。
テスラ HW3 と HW4、FSD 性能はどれだけ違うのか
テスラの旧ハードウェア(HW3)と新型(HW4)で同じ道をそれぞれ自動運転で走って比較した動画によると、日常走行では二世代の差はほとんどありません。市街地と高速の往復の間、ハンドルもペダルも介入がなく、2025 年初めから同じ FSD ビルド(v12.6.4)にとどまっている HW3 も HW4 と同じくらい滑らかに走りました。HW4 と v14 の実質的な利点(推論が 3〜5 倍速い、MLIR コンパイラの書き直し、駐車状態からの発進)は、緊急車両や複雑な駐車といった難しいエッジケースで表れます。結論として、大多数のオーナーにとって HW3 は今でも十分です。
バイブコーディング入門者のためのGit、何から学ぶか
Gitはコードのバージョンを管理するツールです。ミスをしても以前の状態に戻し、これまで何をしたかの履歴を残し、原本に触れずに安全に実験できるようにしてくれます。入門者が知るべきは三つの塊だけです。まずaddとcommitで気に入った瞬間をバージョンとして刻み、次にdiffとエディタのGUIでコミット前に何が変わったかを確認し、最後にbranchでコピーを作ってそこで先に開発し、うまくいったら原本に統合します。インストールは一行、覚える命令はわずか数個で、ターミナルにこだわらずVS CodeのGUIで始めても十分です。
企業のAI導入は、なぜ実務まで届かないのか
企業のAI導入がPOC段階で止まる理由は、技術ではなく構造にあります。既存の業務の上にAI活用をエクストラワークとして乗せ、専任チームも実験する時間もないままでは、それらしい試作は出来ても実用には移れません。業界ではこれをPOCの呪いと呼びます。成否は、AIを専任で担うチームがあるか、そして結果を検証できるドメイン知識があるかで分かれます。壮大なものを作ろうとするより、毎日繰り返す自分の業務の小さな一片から手放すほうが良いのです。
バイブコーディングにおけるスキル・CLI・MCP、それぞれ何が違うのか
スキルはClaudeにやり方を教えるMarkdown製の指示書、CLIはモデルが学習データですでに熟知しているターミナルコマンド、MCPは認証・権限・ツール説明を標準規格に落とし込んで外部サービスとつなぐプロトコルです。三つは競合せず層をなします。スキルが方法を決め、CLIかMCPが実際に実行します。
Claude Cowork モバイル版:何が変わったのか
Claude Cowork がウェブとモバイルに対応しました。Anthropic のサーバー上でリモート実行されるため、ノートパソコンを閉じてもタスクは続き、スマートフォンから引き継げます。スケジュール実行で朝のブリーフィングを先に作らせ、あなたの判断だけを待たせることができ、デスクトップアプリはチャットと Cowork が一つのホームに統合されました。ただしウェブとモバイルはアカウントに接続されたクラウド資料でのみ動作し、ローカルファイルやブラウザ操作には依然としてデスクトップアプリを開いておく必要があります。
なぜバイブコーディングは「できるだけAIに丸投げすること」なのか
バイブコーディングの核心は、AIが本来できる仕事を人が代わりに抱え込まないことです。初心者はAIが「gitをインストールして」「Vercelを設定して」と案内すると、そのまま自分でやって疲れ果てます。しかしそれらの多くはAI自身ができることで、「あなたが入れて」「あなたが設定して」「あなたが自分で確認して」の一言でエージェントが代わりに処理します。会員登録のように人にしかできないことだけ残し、残りはAIが本当にできないと言うまで丸投げする——それがバイブコーディングにおける委任の本当の意味です。
AI コーディングを全社員に導入するとき、組織は何を再設計すべきか
コーディングエージェントを全社に展開する本当の課題は、ツールを配ることではなく、その後に現れるボトルネックを再設計することです。DoorDash はエンジニアだけでなく全社員に Claude Code を配布し、スループットが上がると CI/CD・コードレビュー・セキュリティが新たなボトルネックとなり、それを再び AI で自動化する必要がありました。組織レベルの教訓は三つです。学習は書き残された成果物によってのみ広がり、実験チームには経営層のスポンサーシップが必要で、AI チャンピオンはトップダウンで任命するのではなく自発的に現れるようにすべきだということです。AX はツールの購入ではなく、コーディングが速くなった後に現れるボトルネックを組織がどう再設計するかの問題です。
非開発者がバイブコーディングを始めるとき、なぜgitが最初の壁になるのか
非開発者がバイブコーディングを始めると、コードよりも先にgitという壁にぶつかります。Claude Desktopにコードを実行してほしいと頼むと、真っ先に「gitをインストールしてください」という案内が出るからです。gitはコードのあらゆる変更を記録し、いつでも以前の状態に戻せるようにするバージョン管理ツールで、AIがコードを壊してしまっても復旧できるようにする安全装置です。問題は概念ではなく、インストールにあります。PCの環境や習熟度は人それぞれ違うため、インストール画面のちょっとした選択でほとんどの人がつまずきます。だからこそ、gitのインストール自体をClaude Codeにやらせることが、バイブコーディングの実質的な最初の実習になるのです。
Claude CodeとCodex、どこでどう使うのか
Claude CodeやOpenAI Codexのようなコーディングエージェントは、四つの表面で使います。ターミナルなしにボタンで動かすデスクトップアプリ、使い慣れたエディタに乗せるVS Code拡張、自動化まで届くCLI、そしてCursorやReplitのように最初からエージェントが組み込まれたIDEです。同じモデルでも、どの表面で使うかで振る舞いが変わります。ターミナルなら自動化になり、デスクトップなら対話になります。だから、道具より先に表面を選ぶのです。
バイブコーディングで出会うファイル形式、どう見分けるか
非開発者がバイブコーディングで出会う数十のファイル形式は、実はたった三つに分かれます。データを入れる器(CSV・JSON・XML)、画面に見せるもの(HTML・Markdown)、そして設定と秘密(YAML・.env)です。拡張子を一つひとつ覚える必要はありません。見慣れないファイルに出会ったとき、「これはデータか、画面か、設定か」だけ見分ければ、参入障壁の半分は消えます。
いまAIモデルの本当のフロンティアは何で定義されるのか
AIモデルのフロンティアは、もはやベンチマークの正答率ではなく「雑然とした現実の環境で長く生き延びる能力」で定義されます。数十年積み重なったレガシーツール、常に正しくなければならない法務・金融の文書、数時間に及ぶ自律実行——そうした現実業務の混乱のなかで自ら軌道を保つことが、新たな飛躍の核心です。その結果、企業のAI導入のボトルネックも「モデルが十分に賢いか」から「組織の雑然とした文脈をどうモデルに手渡すか」へと移ります。
AI時代にmoat(堀)はどこに残るのか
AI時代の堀(moat)は「何を知っているか」から「どれだけ速く差を埋めるか」へと移りつつあります。フロンティアラボが専門家の暗黙知をpost-trainデータとして買い上げ、AIが領域へ直接参入する今、領域知識そのものもモデルへのアクセスも持続的な堀にはなりにくい。残る堀は、領域の専門家がAIを吸収する速度と、AIネイティブが領域知識に追いつく速度――その二つのうち、先に差を埋めた側にあります。
AXの最大の受益者が50代でありうる理由
AX(AI転換)の最大の受益者は、AIツールに慣れた20代ではなく、業務の流れ(work flow)をすでに体で知っている50代かもしれません。AXの本質はツールの操作法ではなく業務の流れを描き直すことにあり、その流れを知る人がツールを手にしたとき、成果物の差が最も大きく開くからです。実際、AIが普及した囲碁界でも、実力は上方に平準化するどころか、上位と下位の差はむしろ深まりました。
Advisor Strategyとは何か、opusplanとどう違うのか
Advisor Strategyは実行を低コストモデルに任せ、判断に行き詰まったときだけ上位モデルをオンデマンドで呼び出して助言を受ける構造だ。Claude Code CLIのopusplanは同じ発想を計画と実行の境界に固定した簡略版で、実行中に上位モデルが再び介入して検証するループがない点が異なる。
AI研修のあと、学んだことを本当に残す方法とは何か
AI研修は、実際のレベルに合った段階から始め、研修が終わったあとに業務と無関係なサイドプロジェクトを定期的にレビューする場を作ってこそ、本当に身につく。レベルを飛ばした学びは研修が終わった瞬間に消え、レビューのない実践は優先順位に押されて忘れられてしまうからだ。
ゴルフ空き枠通知ボットはなぜ一人で作れるサービスになったのか
GolfShinは韓国国内のゴルフ場34カ所の予約ページを毎時間確認し、空き枠が出るとTelegramで知らせるサービスです。Telegramボット(@golfshinbot)に希望のゴルフ場・日付・時間帯を登録しておけば、ログイン不要・無料で通知を受け取れます。申丞浩が一人で作って運営しているサイドプロジェクトで、以前なら開発チームが一つ必要だった自動化を個人が担えるようになった過程を示しています。
Claude Tagとは何か、そしてAIはなぜ個人用ツールを超えてチームのインフラになるのか
Anthropicが公開したClaude Tagは、チームのチャンネル(Slack、まもなくTeams)で@Claudeと呼びかけると常駐して自ら働くエージェントです。AIが「自分で開いて尋ねる反応型の個人ツール」からチームのインフラへ移る転換を凝縮して示し、その原動力はより賢いモデルではなく、常駐・持続する記憶・マルチプレイヤーという環境設計です。
スポティファイのAIエージェント活用から、一般の会社員は何を学べるか
スポティファイはコード変更の73%をAIに直接書かせながら品質を落とさなかった。その理由は検証先行の自動化、標準化、そして生まれた時間の再配分という3つです。これはソフトウェア開発に限った話ではなく、報告書やメールなど日々のオフィスワークにもそのまま当てはまります。
AI時代のチームは、なぜ「役職」ではなく「アーキタイプ」で組むべきなのか
AIによってエンジニアリング・プロダクト・デザイン・データの役割が溶け合う中、チームを分けるのはもはや役職名ではなく、5つの働き方――プロトタイパー、ビルダー、スウィーパー、グロワー、メンテナー――のどれかになりつつあります。ほとんどの人は同時に2〜3のアーキタイプにまたがり、必要な組み合わせはプロダクトの段階によって変わります。
AIエージェントには、なぜSkillよりAGENTS.mdのほうがよく効くのか
AIに文書を開くか開かないかを選ばせると、半分は開かずに間違えます。AGENTS.mdのようにプロジェクトへ常に広げておけば、選ぶ瞬間そのものがなく、間違える余地もありません。Vercelの実験では、必要なときに取り出すSkillは強く指示しても79点どまり、常に広げられたAGENTS.mdは100点でした。AXの勝負どころは、ツールを賢くすることではなく、間違える機会を設計で消すことにあります。
網分離の廃止は韓国企業に何を求めるのか
20年間維持された韓国の画一的な網分離が、2026年5月の国家サイバーセキュリティ指針改定によって廃止されました。要点は規制緩和ではなく、これまで先送りしてきた宿題、すなわちデータ分類をもはや避けられなくなったという点です。網をつなぐにはデータを国家安全・機微・公開の三等級に分けねばなりませんが、韓国はこの分類をまともにやったことがありません。しかも閉鎖網はすでにシャドーAIで破られていました。AI導入を阻む真のボトルネックはモデルでもインフラでもなく、自社のデータがどんなデータなのかを誰も整理していないことにあります。
韓国のAIスタートアップは欧州で何を武器に戦うのか
韓国のAIスタートアップが欧州に持ち込んだ武器は、より賢いモデル性能ではなく信頼です。VivaTechのK-Startupパビリオンに集った6チームは、社内文書検索から工場設備データ、3Dデジタルツイン圧縮、香りの推薦、肌診断、同時通訳まで領域はすべて異なりました。しかし共通の答えを持っていました。データを外に出さないオンプレミス構成、ISOやGDPRへの準拠、そしてすでに確保したPoC実績です。華やかなデモではなく、現場で動くAIこそが幻想とインパクトを分ける線でした。
AI エージェントが遮断された公開ページを読めないとき、何が問題なのか
AI エージェントが公開ページを読めないのは、たいていコンテンツがないからではなく、既定のフェッチが 403 やボット遮断のシグナルに当たった瞬間にあきらめるからです。insane-search は Claude Code のプラグインで、遮断を先回りして決めつけず、公開 API とフィード、軽量プローブ、TLS なりすまし、ヘッドレスブラウザの順に、通る経路が見つかるまで段階的に上げていきます。ただしログインとペイウォールの前では越えず、認証が必要だと報告します。公開コンテンツのリーダーであって、認証を回避する手段ではありません。
AI時代、なぜすべての社員が「メイソン」から「アーキテクト」へと昇るべきなのか
これまで、ほとんどの会社員は誰かが描いた図面どおりに繰り返すメイソン(レンガ職人)でした。AIはこの構図を変えます。社員が自らMCPツールを作り、個人事業主がコンテンツを1-clickで配信するように、誰もが自分のシステムを設計するアーキテクトになれるのです。私が考えるAXの本当の目標は、自動化率が何パーセントかではなく、組織のすべての人がメイソンからアーキテクトへと昇ることです。
私が作って公開した日常自動化ツール5つとは何か
誰もが自分の日常を自動化できるように、私が自ら作って公開したツールは、四柱推命から性格検査ベースのコンサルティング、公共データの統合、カードニュース生成、年金シミュレーションまで5つです。大げさなプラットフォームではなく、必要なツールを必要なぶんだけ素早く作ったもので、AXの終着点はみんなが自分のシステムの設計者、アーキテクトになることだという信念から出発しています。
コーディングエージェントの偽の完了と盲点はどう防ぐか
コーディングエージェントの失敗は三つの形で繰り返されます——偽の完了、合意の足りない設計、単一モデルの盲点——そのそれぞれを、合意・検証・クロスレビューというハーネスの層で塞ぎます。オープンソースのハーネス oh-my-claudecode(OMC)は、コードに手を付ける前に計画を Planner・Architect・Critic の合意ループに通す ralplan、別のレビュアーがユーザーストーリーを検証してはじめて完了を認める ralph、一つのモデルの盲点を別のモデルで補うクロスレビュー ccg を備えます。AI の成果の差は、たいていモデルではなくハーネスで決まります。
AIは人員を減らすハサミか、人を強くする鎧か
企業研修の現場で私が最も多く受ける質問は「AIを導入すると、結局は人を減らすということですよね?」です。私は正反対に見ています——AIは人員を切り落とすハサミではなく、同じ人をより強くする鎧であり、400人を武装させた組織は100人に減らした組織に勝ちます。減らすことは一度きりのコスト削減で終わりますが、武装は複利で積み上がるからです。
AXにおいて、人とAIの役割はどう分かれるのか
AXでは、人がどこを掘るかを決め、AIはその仮説が本物かをデータで素早く検証する。AIの本当の価値は、よいアイデアを生むことではなく、間違った仮説を正直に殺すことにある。医療データで立地モデルを作る際、AIエージェントがもっともらしい飽和仮説をデータで棄却し、現場を知る専門家の一言が本物のシグナルを指し示した。この二つの結合こそAXの本質である。
ループエンジニアリングとは何か、いつ使うべきか
ループエンジニアリングとは、毎回プロンプトを入力する代わりに、AI が決められた間隔で進行中の仕事を自ら引き継いで処理し続けるようループを設計する働き方です。Claude Code を作った Boris Cherny も、今は毎回プロンプトを打たずループを掛けておくと述べています。要は、繰り返し作業はループに任せ、人は設計と監視、そして外部へ出ていく動作を止めるガードレールに集中することです。
内装の見積もりはなぜ比較できないのか、どうすれば「比較できる市場」に変えられるのか
22兆ウォン規模の内装市場で価格競争が働かないのは、業者ごとに実測の仕方も見積もりの様式も異なり、客観的な比較が不可能だからです。私は親しい仲間たちと、この情報の非対称を標準化とAIで解くことにしました。核心は「実測と見積もりの分離」です。インスペクターがモバイルLiDARで一度実測すれば、同一の項目体系ができあがり、その上で検証済みの施工会社が単価とマージンだけで競い、消費者は一度の打ち合わせで五つの見積もりを比較します。
AXはなぜ教育ではなく環境設計なのか
AXは構成員に道具の使い方を教育することではなく、AIで働く環境そのものを設計することです。毎週押し寄せる更新を個人が100%追いつこうとすれば、消耗するだけです。肝心なのは「以前はできなかったことを今はやっている」と言えるよう働き方を変えることであり、その出発点は、繰り返される面倒な業務を見つけて自動化する小さな実験です。
ゴルフのティータイム比較ツールをなぜ自分で作ったのか、そして「不便を感じた人が自分で解決する」時代とは何か
週末のラウンドを一つ予約するために、十数個のサイトを一つずつ回っていた不便を、私は韓国の人気ゴルフ場34カ所のティータイムを一つの画面で比較するツールを自分で作って解決しました。大手予約アプリが扱わない非提携の人気クラブだけを選び、リアルタイムで集約し、収益化の意図はなく、今は私と知人が実際の予約に使っています。核心は、不便を感じた人がVibe Codingでその不便を自分で解決できる時代が来た、ということです。
一人が毎月課金されるSaaSを作れる時代、まず必要なのは何か
ノートパソコン一台とAIの一行。一人が毎月課金される小さなSaaSを作れる時代が開きました。かつては作れなかったサービスの投資単価が崩れ、アイデアからリリースまでの距離が数日に縮まったからです。だからまず必要なのは、大きな資本でも大きなチームでもなく、日常の小さな不便への観察と実行です。
AI時代に生き残るのはどんな会社か
生き残るのはAIを導入した会社ではなく、働き方そのものを100%作り直した会社です。同じツールを使っても、エンジニアの90%がAIを使う組織と100%が使う組織では10倍の差が出ます。ツールは誰にとっても同じで、その上にどんなプロセスを新たに積み上げるかが差を生みます。
AXの本質とは何か — コンサルタントが去った後も社員の手で進化し続けるシステム
私が弟の営む貿易会社Astrosで検証したAXの本質は、システムが人の仕事を代わりに行う構造ではなく、社員がLLMに自然言語で指示し、その結果を自ら検証する構造でした。結果は会計業務の60%自動化でしたが、より重要な変化は、担当者の仕事が単純入力から分析と意思決定へ移り、コンサルタントが去った後もシステムが社員自身の手で進化し続けたことです。
AXの終着点はなぜシステムではなく人なのか — SH Consultingを始めるにあたって
広告とブランド戦略から出発した22年の道のりで、私はSaaSを創業し、Exit(イグジット)まで経験しました。その道の果てで確かめた結論は、意外なほど単純でした。AX(AI Transformation)の終着点はシステムではなく人だということです。良い自動化は仕事を代わりにやって去りますが、良いAXはコンサルタントが抜けた後も自分で道具を直し、新しい自動化を掘り起こす人を残します。
AXは誰が作れば成功するのか
AX(AI変革)は、外部の開発者ではなく、その業務を毎日こなす現場の人の手で作られたときに成功します。ワークフローに潜む例外や暗黙のルールは、毎日それを回している人にしか分からないからです。だからAX教育の本質は、開発者を増やすことではなく、現場の人がバイブコーディングで自分の仕事を自ら自動化できるようにすることです。財務・経営管理の担当者が毎日の発注業務を自動化した事例が、それを示しています。
日常の自動化はなぜAXの最良の出発点なのか
自分が毎日繰り返す小さな仕事を一つ、丸ごと——部分的にではなく——なくしてみることが、AX(AI変革)の最良の出発点です。効率を数パーセント上げるのではなく、その仕事を自分の手から完全に切り離す経験をすると、AIが何を代替でき、どこまで信じて任せられるかを身をもって知るからです。散らばったカカオトークの予定をAIが拾い、カレンダーに登録し、毎朝一枚のブリーフィングにして届ける個人の自動化がその例です。
AIコーディングの生産性を分けるのはモデルかワークフローか
AI支援によるコーディングの成果物の質は、モデル選びよりワークフローが大きく左右します。本当のボトルネックは弱いモデルではなく、曖昧な仕様とやり残した作業だからです。oh-my-claudecode(OMC)はClaude Codeの上で三つの習慣を道具として固めたオーケストレーション層です。deep-interviewが何を作るかを明確にし、ralplanがどう作るかを検証し、ralphが最後までやり切ることを保証します。"何を・どう・最後まで"を強制されたパイプラインに変えるのが要点です。
AIの成果物はなぜMarkdownではなくHTMLで受け取るべきか
完成した成果物であれば、MarkdownではなくHTMLで受け取るほうが理解速度が大きく上がります。AIが文書を作る速度はすでに人が読む速度を追い越しており、100行を超えるMarkdownは事実上読まれないからです。AnthropicのClaude Codeエンジニアも「HTMLは新しいMarkdownだ」と述べ、成果物をHTMLで受け取り始めました。動的な画面が必要ならPlaygroundプラグインがその隙間を埋めます。基準はシンプルです。構造を見て理解すべき完成物はHTML、中間生成物はテキストのままにします。
コールセンターはコスト部門か、新規事業の源泉か
コールセンターはコスト部門としてだけ見る場所ではなく、新しいサービスや事業を発掘する源泉になり得ます。日々寄せられる問い合わせには未充足ニーズの手がかりがすでに含まれており、STT と LLM ウィキで対応記録を資産化すれば、その手がかりを体系的に掘り出せます。残る関門は個人情報のマスキングであり、それを解けばコールセンターはコスト部門から事業発掘エンジンへと変わります。
AIはなぜルールではなく確率を出すのか
今のAIは、人間が書いたルールを実行する機械ではなく、データから自ら見つけたパターンをもとに「スパムである確率93%」のような確率を出力する機械です。送金のように条件が明確な問題はルールベースのコードで完璧に解けますが、画像認識のように例外が多く境界が曖昧な問題ではルールが崩れるからです。機械学習とディープラーニングはルールベースシステムのこの失敗から生まれ、この区別はAXコンサルティングで業務を分解する最初の基準になります。
AIオーケストレーションとは何か:RAGチャットボットが止まる地点から始まる制御フロー設計
AIオーケストレーションとは制御フロー設計です。質問を受けて検索し答えるだけの単線パイプラインではなく、行き詰まったら引き返すループと状況に応じて道を変える分岐を設計し、AIに複雑な実務を処理させます。LangChainが標準部品を、LangGraphが制御フローを、LangSmithが可観測性を担います。API一回で済む仕事に付けるのは無駄で、ループと分岐が必要なほど業務が複雑なときに取り出す道具です。
バックエンドとは何か:1993年のゲストブックから始まった問題解決の系譜
バックエンドとは、サーバーがリクエストを受け取り、データを処理して結果を返す領域であり、1993年にゲストブックの問題を解く中で生まれました。あらかじめ作っておいたHTMLファイルでは、訪問者が残したばかりの書き込みを次の人に見せられないため、サーバーがリクエストのたびにその場でページを組み立て始めたのが出発点です。その後30年の発展史も同じパターンの繰り返しであり、この系譜を知れば、非開発者もAIにバックエンドを具体的に指示できるようになります。
バイブコーディングで、AIはなぜしきりにSupabaseを勧めるのか
もともとまったく別系譜の技術だったデータベースとストレージが、それぞれの限界を越えて一つのプラットフォームへ合流し、Supabaseがまさにその合流点だからです。この推薦は好みではなく技術史の帰結であり、その系譜を地図として持っていれば、どの道具をなぜ使うか、AIに何をどう指示するかが、そろって変わります。
AIがコードをすべて書いてくれる時代に、なぜフロントエンドの知識が必要なのか
AIが代わりにコードを書いてくれても、フロントエンドの基本概念を知らなければ、AIに任せられる仕事の水準はそこで止まってしまうからです。React、npm、ビルド、SSRといった言葉は暗記の対象ではなく、ウェブが問題を解くたびに新しい問題が生まれて続いてきた問題解決の連鎖であり、この進化の地図が頭の中にあってはじめて、AIへの指示は具体的に変わります。
LLM はどう動いているのか —— 非開発者がコードで直接確かめるべき四つのこと
LLM は会話を記憶する存在ではなく、毎ターンごとに直前までの会話全体を読み直し、次のトークンを予測する確率モデルです。この動作の仕方は、コンテキストウィンドウが埋まっていくこととコストの増大、韓国語のトークン上の不利、ハルシネーション、そして temperature やシステムプロンプトによる出力の変動として現れます。こうした現象は、説明として聞くよりも、数行のコードで自ら再現して画面で確かめたときにこそ、検証の手順や会話履歴の管理といった設計課題として扱われるようになります。
デプロイとは何か——localhostはなぜ友人のパソコンで開けないのか
デプロイとは、自分のパソコンにしかないコードをサーバーに載せ、インターネット上の誰もが使えるようにする過程です。バイブコーディングの成果物がlocalhost:3000でしか動かない理由、FTPからGit・Docker・CI/CDへと続いたデプロイの進化、Vercelのようなプラットフォームが代行してくれることとその代償を整理しました。この地図が頭にあればAIへ投げる質問が変わり、その具体性が非開発者バイブコーディングの実力を分けます。
K Public Data MCPとは何か — 韓国の公共データをAIにつなぐサーバー
K Public Data MCPは、法制処国家法令情報センター、DART電子公示システム、公共データポータルなど、バラバラに散らばった韓国の公共データAPIをMCP(Model Context Protocol)サーバー一つに統合し、AIチャットで「民法を検索して」「サムスン電子の財務諸表を見せて」「江南区の薬局を探して」がそのまま動くようにするオープンソースのツールです。コネクタURLを登録するだけで使え、APIキーの発行もインストールも不要です。
ハーネスエンジニアリングとは何か
ハーネスエンジニアリング(Harness Engineering)とは、AIモデル自体を変えるのではなく、モデルにどのツールを持たせ、どんなルールとワークフローの中で動かすかを設計して成果物の品質を引き上げる作業です。同じモデルでもハーネス設計次第で性能が大きく変わるため、より高価なモデルに乗り換える前に、まず点検すべきレイヤーです。
AXプロジェクトはなぜ失敗するのか — チームを助けるな、業務をなくせ
AX(AI Transformation)プロジェクトの最も典型的な失敗パターンは、AXチームが各部署を回って要件を集め、ツールを作って渡す方式です。作っても現場が使わないからです。成功するAXの出発点は「あのチームを助けてください」ではなく「あのチームの業務単位を丸ごとなくしてください」であり、人は切るのではなく新しい職務へ転換させるのです。
生成UIとMCPアプリ — エージェント時代のインターフェースはどこへ向かうのか
エージェントUIは、静的(事前構築コンポーネントにデータを流し込む)、宣言的(エージェントがJSON記述を書き、レンダリングエンジンがデザインシステムにマッピング)、生成的(モデルがランタイムでHTML・CSSを即席生成)の3段階で進化しています。現在の均衡点は宣言的方式であり、生成的へ進む鍵はモデルの能力ではなく信頼 — すなわちサンドボックスという安全な流通構造です。MCPアプリがその配布チャネルとして注目されています。
AIネイティブとAIアシストの違い — 自社はどちらか
AIネイティブ(AI Native)は、人の介入がほぼないままワークフロー全体がAIで完結する構造。AIアシスト(AI Assisted)は、人の仕事はそのままにAIが横から一部を手伝う構造です。多くの企業の「AIネイティブ宣言」は実際にはAIアシストに留まっており、この違いを区別できなければ、AI導入後も生産性は横ばいのままです。
Claudeはどうすれば動画を「見て」答えられるのか
Claudeは本来動画を直接再生して見ることはできませんが、オープンソースツール/watchをつなぐと、YouTubeリンクや画面録画ファイル一つだけで動画をフレーム単位に分解し、字幕を付けて実際の内容を把握したうえで答えられるようになります。タイトルや説明文から推測するのではなく、画面に実際にあった場面を根拠に判断する点がポイントです。