人が見る画面とボットが受け取る文書はなぜ違うのか
ウェブサイトのアドレスを開くと、サーバーが HTML 文書を一つ送ってきます。ブラウザはそれを受け取ったあとにもう一仕事します。文書に付いてきた JavaScript をダウンロードして実行し、その結果として文字や画像を画面に埋めます。サイトが表示されたと私たちが言う時点は、これが全部終わったあとです。
検索エンジンや AI 企業が送り出すプログラムも同じアドレスを開きます。このプログラムをボット、あるいはクローラーと呼びます。ただしボットはブラウザではありません。サーバーが送った HTML を受け取り、そこから文字を抜き出して次のアドレスへ移るのが既定の動作で、JavaScript まで実行するのは別に付け足す機能です。
そのため同じページでも、人とボットが手にする文書は違いうるのです。その差がどこで開くのかが次の節です。
CSR と SSR は何が違うのか
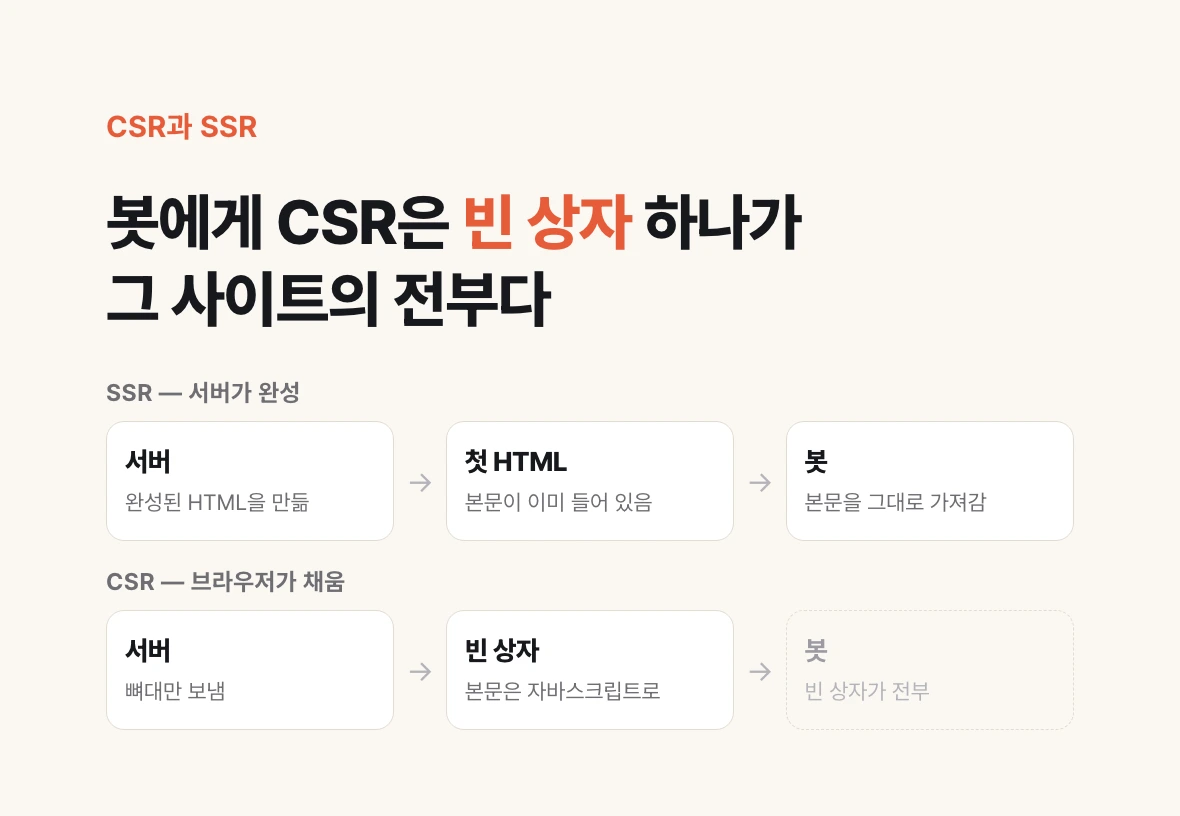
画面に文字を入れる方式は大きく二つです。サーバーが完成した HTML を作って送るならサーバーサイドレンダリング(SSR)。サーバーは骨組みだけ送り、ブラウザが JavaScript を実行して中身を埋めるならクライアントサイドレンダリング(CSR)です。ここでのクライアントは自分のブラウザを指します。
人の目には区別がつきません。画面に出た結果が同じだからです。作る側から見ると CSR は楽な点が多く、既定値としてよく選ばれます。
ボットから見ると全く別の文書です。SSR ならサーバーが送った最初の HTML に本文がすでに入っています。CSR ならその場所には空の箱が一つあるだけで、本文は JavaScript が回ってはじめて生まれます。ボットが JavaScript を実行しなければ、その空の箱がそのサイトの全部です。
インタビューでは司会がこの点を一文に言い換え、ゲストがそのとおりだと答えます。CSR なら、GPT のボットはこのサイトに入っても何の情報も見られない。人が見られる情報は確かに存在するのに、ボットには渡らない構造だという意味です。
自分のサイトがどちらなのか確認する方法
ツールを入れる必要も、作った人に聞く必要もありません。Chrome があれば足ります。
1. 確認したいページを Chrome で開きます。会社紹介でもサービス説明でも、AI に読んでほしいページを選びます。
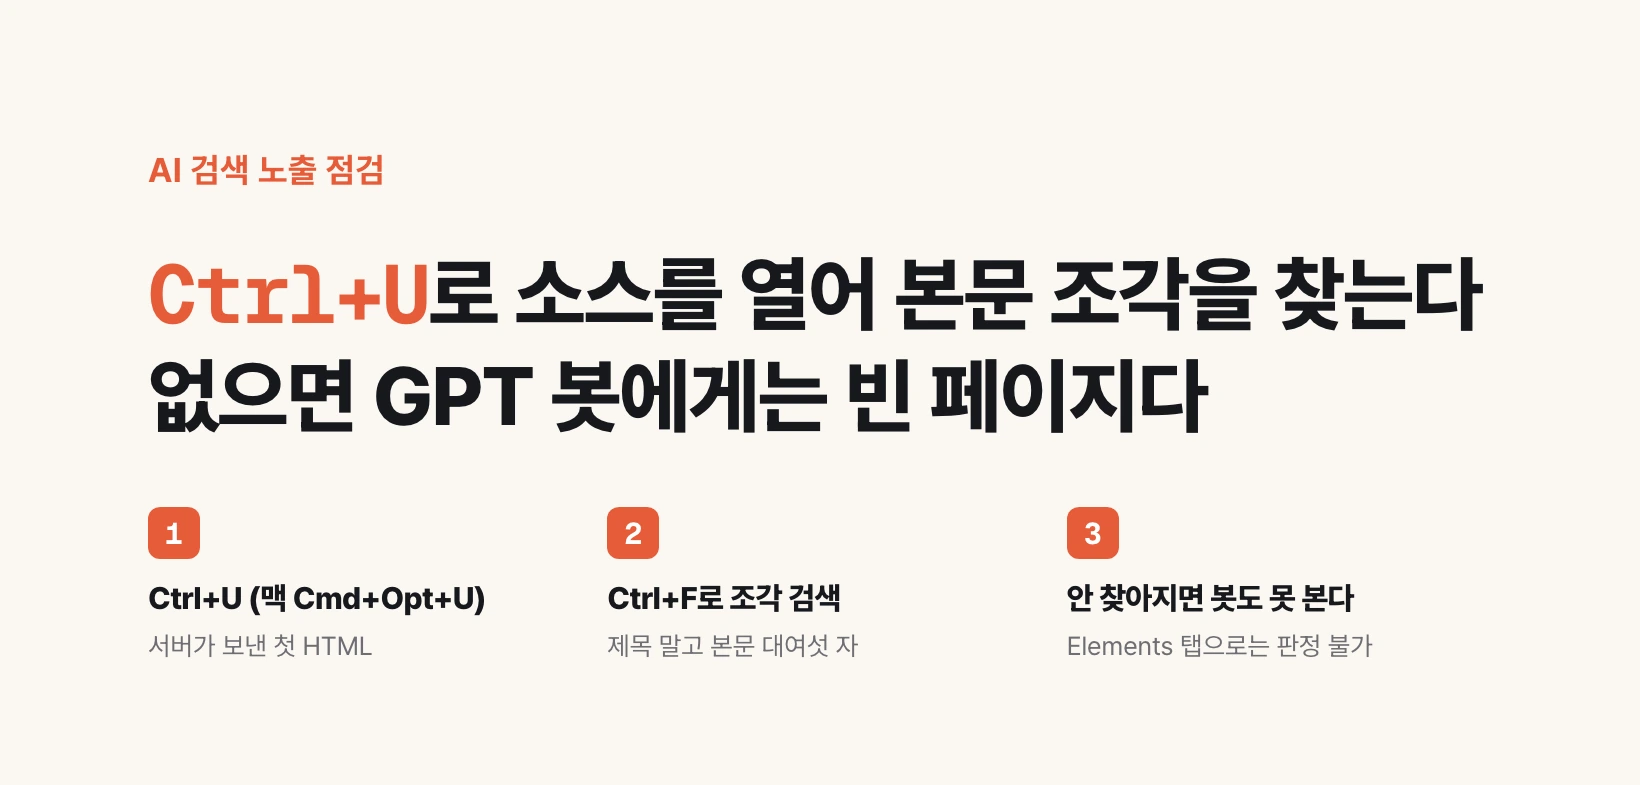
2. Windows は Ctrl+U、Mac は Cmd+Option+U を押します。マウスなら、ページの空いたところで右クリックしてページのソースを表示を選びます。アドレスの前に view-source: を付けても同じ画面が開きますが、Chrome は貼り付けたときにこの接頭辞を消してしまうので手で打つ必要があります。ショートカットのほうが確実です。
3. 新しいタブに文字と記号がびっしり並んだ画面が出ます。読もうと頑張らなくて構いません。これがサーバーが最初に送った HTML、つまりボットが手にする文書の全部です。
4. その画面で Ctrl+F(Mac は Cmd+F)を押し、元のページの本文から取った五、六文字ほどの短い断片を探します。一文をまるごと貼り付けてはいけません。HTML は文の途中に太字やリンクのタグが挟まるので、本文がきちんと載っているサイトでも一文まるごとでは引っかからないことがよくあります。断片は見出しではなく本文から選びます。見出しは別の場所にも載っていて判定がぼやけます。
5. 見つかれば、その箇所はサーバーが最初から載せて送ったもので、JavaScript を実行しないボットにも見えています。見つからなければ、その一文はそのボットには存在しません。心配なら本文の別のところからもう二つほど断片を選び、同じ検索を繰り返します。
判定が確実なのは片側だけです。ソースになければ、JavaScript を実行しないボットは確実に見られません。逆にソースにあるからといって必ず引用されるわけではありません。robots.txt でそのボットを止めていればそもそも来ませんし、それはこの記事が扱う軸とは別です。
開発者ツールで確認してはいけない理由
ここが一番よく間違えるところです。F12 で出る開発者ツールの Elements タブにも HTML が見えます。ところがその画面では本文の一文がいつでも見つかります。CSR でも SSR でも同じです。
二つの画面が別の時点を映しているからです。ページのソースを表示はサーバーが送った元の文書。開発者ツールの Elements は JavaScript が全部実行されたあと、今この画面を作っている状態です。ボットが受け取るのは前者です。
確認は必ずページのソースを表示で行います。開発者ツールで本文が見えることは、この判定に何の情報も与えません。
ボットが JavaScript を実行するかは実測されたことがあるのか
各社が文書で明かしてはいません。OpenAI のクローラーのページは名前と用途だけを載せています。OAI-SearchBot は ChatGPT の検索結果に出すため、GPTBot は基盤モデルの学習のため、ChatGPT-User はユーザーの指示でページを開く場合です。JavaScript のレンダリングについてはこのページに記述がありません。
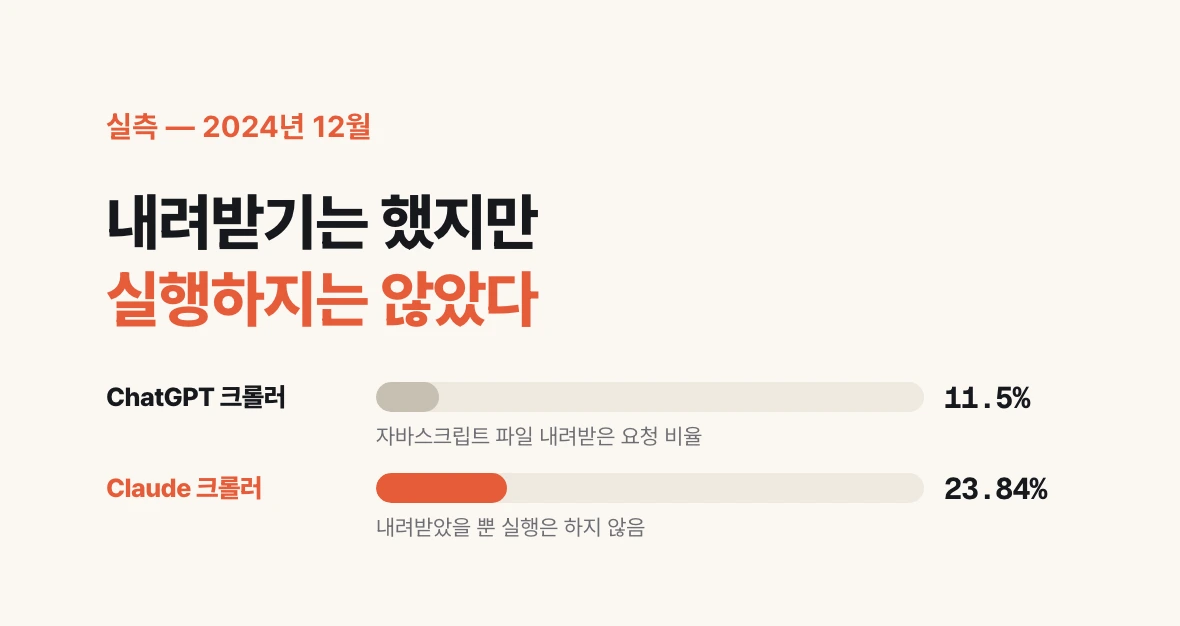
実測はホスティング側から出ました。Vercel と Merj が 2024 年 12 月 17 日に出した The rise of the AI crawler は実際のクローラートラフィックを集計し、主要な AI クローラーのうち JavaScript をレンダリングするものはないと報告しました。ChatGPT のクローラーはリクエストの 11.50%、Claude のクローラーは 23.84% で JavaScript ファイルをダウンロードはしたものの、実行はしていませんでした。
グーグルは例外です。Googlebot は JavaScript を実行し、Gemini がその基盤に乗っています。だからグーグル検索ではきちんと拾われるページが、ChatGPT の回答には一度も出てこないということが起きます。検索順位が問題ないことは AI に引用される根拠にならないのです。
この数値は 2024 年 12 月時点のものです。クローラーの動作は各社がいつでも変えられるので、数字より確認方法を手に持っておくほうが長く効きます。前の節のソース確認は今日の状態を見せてくれます。
ソースに本文がないとき今日できること
レンダリング構造を変えるのが本筋です。使っているツールの設定に静的生成やサーバーレンダリングの選択肢があれば、そちらに寄せます。ただしこれは作った人やツール側の助けが要る話で、一日で終わらないこともあります。
その前に今日できることが一つあります。title と meta description はサーバーが送る最初の HTML に入っていて、CSR でもたいてい生き残ります。ソース画面で Ctrl+F を使って title と description を探せば、今どう書かれているかがその場で見えます。
その二行に、自分たちが何の会社で何を売っているのかを一文で入れます。全ページに同じ一文が刻まれていることが多いので、ページごとに分けてやれば、ボットが持っていける情報がその分だけ増えます。
情報が画像の中にしかないページも同じ問題です。商品詳細や会社紹介が一枚の画像になっていると、ボットはその中の文字を持っていけません。インタビューでは、背景だけを画像にして中身はテキストで埋め込むやり方が語られています。人の目には画像のように見えて、ボットには文字として残ります。
SSR なら終わったと見てよいのか
いいえ。インタビューでは、同じ SSR でも GPT が受け取れない場合があると指摘されています。画面の一部をあとから別に送る方式を使うと、情報が届く順序と時点が変わるからです。
だから判定は構造の名前ではなく実際のソース画面で行います。うちは SSR だから大丈夫ではなく、今このページのソースにこの一文があるか、で見ます。
ページごとに結果が違うことがあります。トップは通るのにサービス詳細は通らない、というのはよくある形です。AI に読んでほしいページを三つ四つ決めて、それぞれ確認します。
コンテンツを積む前に見るもの
AI 検索での露出を話すとき、たいていは次に何を書くかから始まります。ところがボットが本文をそもそも受け取れない状態なら、何本足しても結果は同じです。
順序は確認が先です。ソースを一度見て、本文から取った断片を一つ探す。三十秒で今どちらなのかが分かります。