うまく書かれた嘘とうまく書かれた事実は見た目が同じだ
調剤薬袋を一枚モデルに渡し、服薬説明を作らせた。出てくる文はいつももっともらしかった。問題はまさにそこにあった — もっともらしさは判定基準にならない。
「一日三回、食後三十分」という文を見てみる。文法に非の打ちどころがなく、服薬説明として自然に読める。しかしその薬袋に実際に三十分と書かれていたかどうかは、この文のどこにもない。モデルが原文から読み取った三十分かもしれないし、似た薬の通念から持ってきた三十分かもしれない。どちらも出力される文はまったく同じだ。
ここで出発点が決まった。人が結果を読んで検査するやり方では、この区別が原理的にできない。どれほど注意深い検査者でも、文の中にない情報を文から取り出すことはできない。
検査を出力ではなく入力の側に向けた
そこで方向を反転させた。生成された文章を読んでおかしな箇所を探す代わりに、その断片一つひとつが入力原文のどこから来たのかを問うた。照合すべき原本が手元にあることが、この問題における唯一の梃子だった。
数字は入力原文に現れるものだけを通す。用量・回数・時間・日数がすべてここに掛かる。原文にない数字は、医学的に正しいかどうかに関わらず拒否される — その正誤を判定する立場に我々がいないからだ。
年齢に関する安全文言はさらに強く縛った。「12歳未満のお子様は服用しないでください」といった文は原文と完全一致でなければならない。部分一致も、意味が同じ書き換えも認めない。この種の文言は一語変わるだけで対象範囲が変わるが、その変化は読んでも見えにくい。
薬を併用する際の注意事項には、項目ごとに根拠を付けさせた。根拠のない項目は保存されない。材料にない相互作用は、文がどれほど正しく読めても捨てる。
件数を強制すると作り出す
最も学びが大きかったのは設計ではなく事故からだった。当初は出力の形を揃えるために「注意事項を四つ」といった件数を決めていた。レイアウトが整い検証コードも単純になるので、自然な選択に見えた。
ところが材料が三つしかない薬袋が来るとどうなるか。モデルは三つ書いて止まらなかった。四つ目を作り出した。
指示に背いたのではない。我々が四つを求め、モデルはそれに応えた。空欄を作って埋めよと言えば埋まるのは当然だ。我々がハルシネーションと呼んでいたものの相当部分は、モデルの欠陥ではなく我々が作った空欄の帰結だった。
今は0から4件で、材料がなければそのまま空にする。レイアウトは少し不揃いになったが、作り出された文は消えた。プロンプトに数字を書き込む前に、材料が足りないときその枠は何で埋まるのかを先に問うべきだ。
検証用のモデルは止めずに見せる位置に置いた
生成物を別のモデルに検査させる仕組みも入れた。ただしその検証器に遮断の権限は与えていない。問題を見つけても記録するだけで、保存を止めるのはルールベースの検査だ。
判定を信用していないからではない。役割を分けたのだ。遮断の位置に立つものは再現可能で説明可能でなければならない — なぜ拒否されたのかを後から正確に辿れる必要があるが、モデルの判定は同じ入力でも揺れる。
代わりに検証器は、ルールが取りこぼしたものを見せる位置に置いた。すべてのルールを通ったのに検証器が繰り返し引っ掛ける類型が溜まれば、それが次に作るルールの候補になる。観測を遮断に昇格させるかは、そのデータを見て決める。
なぜ一錠ずつではなく調剤単位なのか
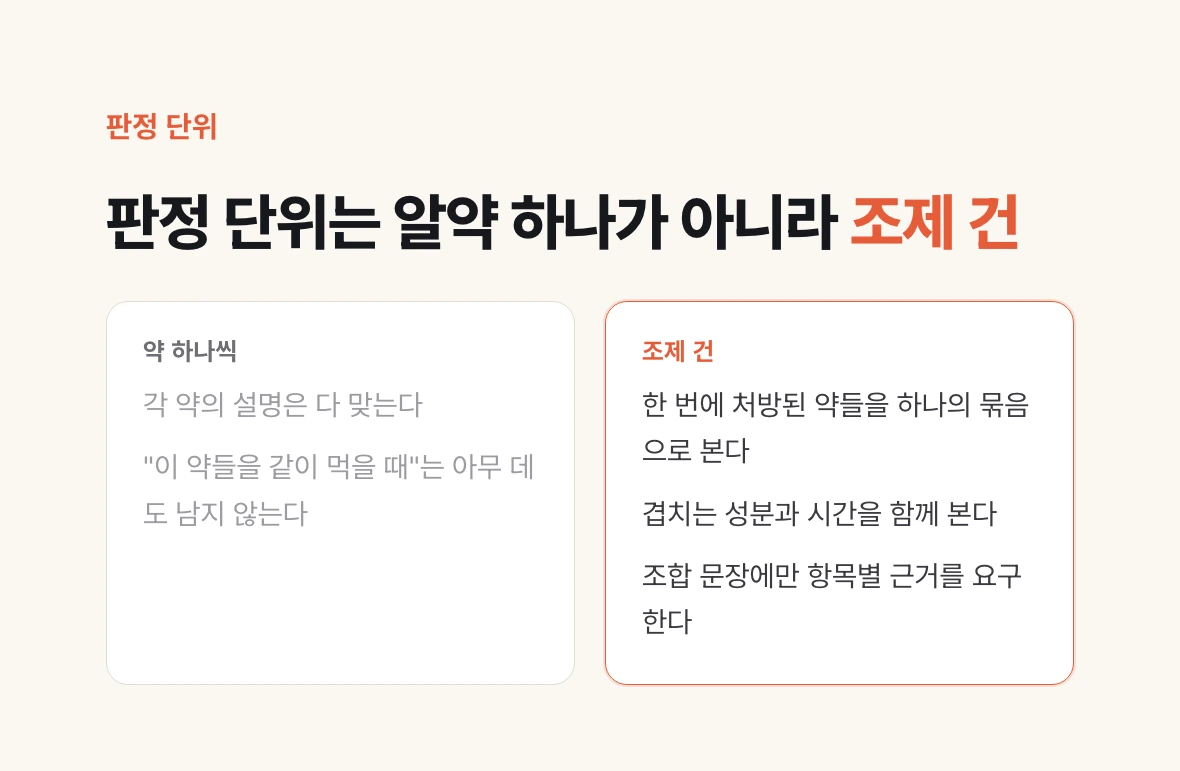
服薬説明を作る一般的なやり方は、薬ごとに説明を付けることだ。データもその形をしているし、作るのも容易だ。
しかし一錠ずつ説明すると「これらを一緒に飲むとどうなるか」がどこにも残らない。個々の説明はすべて正しいのに、組み合わせについての話だけが丸ごと抜ける。薬袋を受け取った人が本当に知りたいのはそこだ。
そこで判定の単位を調剤という出来事に置いた。一度に処方された薬を一つの束として見て、その中で重なる成分と時間を一緒に見られるようにした。
この選択が前述の検証設計につながる。組み合わせについての文は個々の薬の説明より作り出しやすい — もっともらしい相互作用は常識だけでも組み立てられる。だから組み合わせの文にだけ、項目ごとの根拠を求める検査を別に置いた。