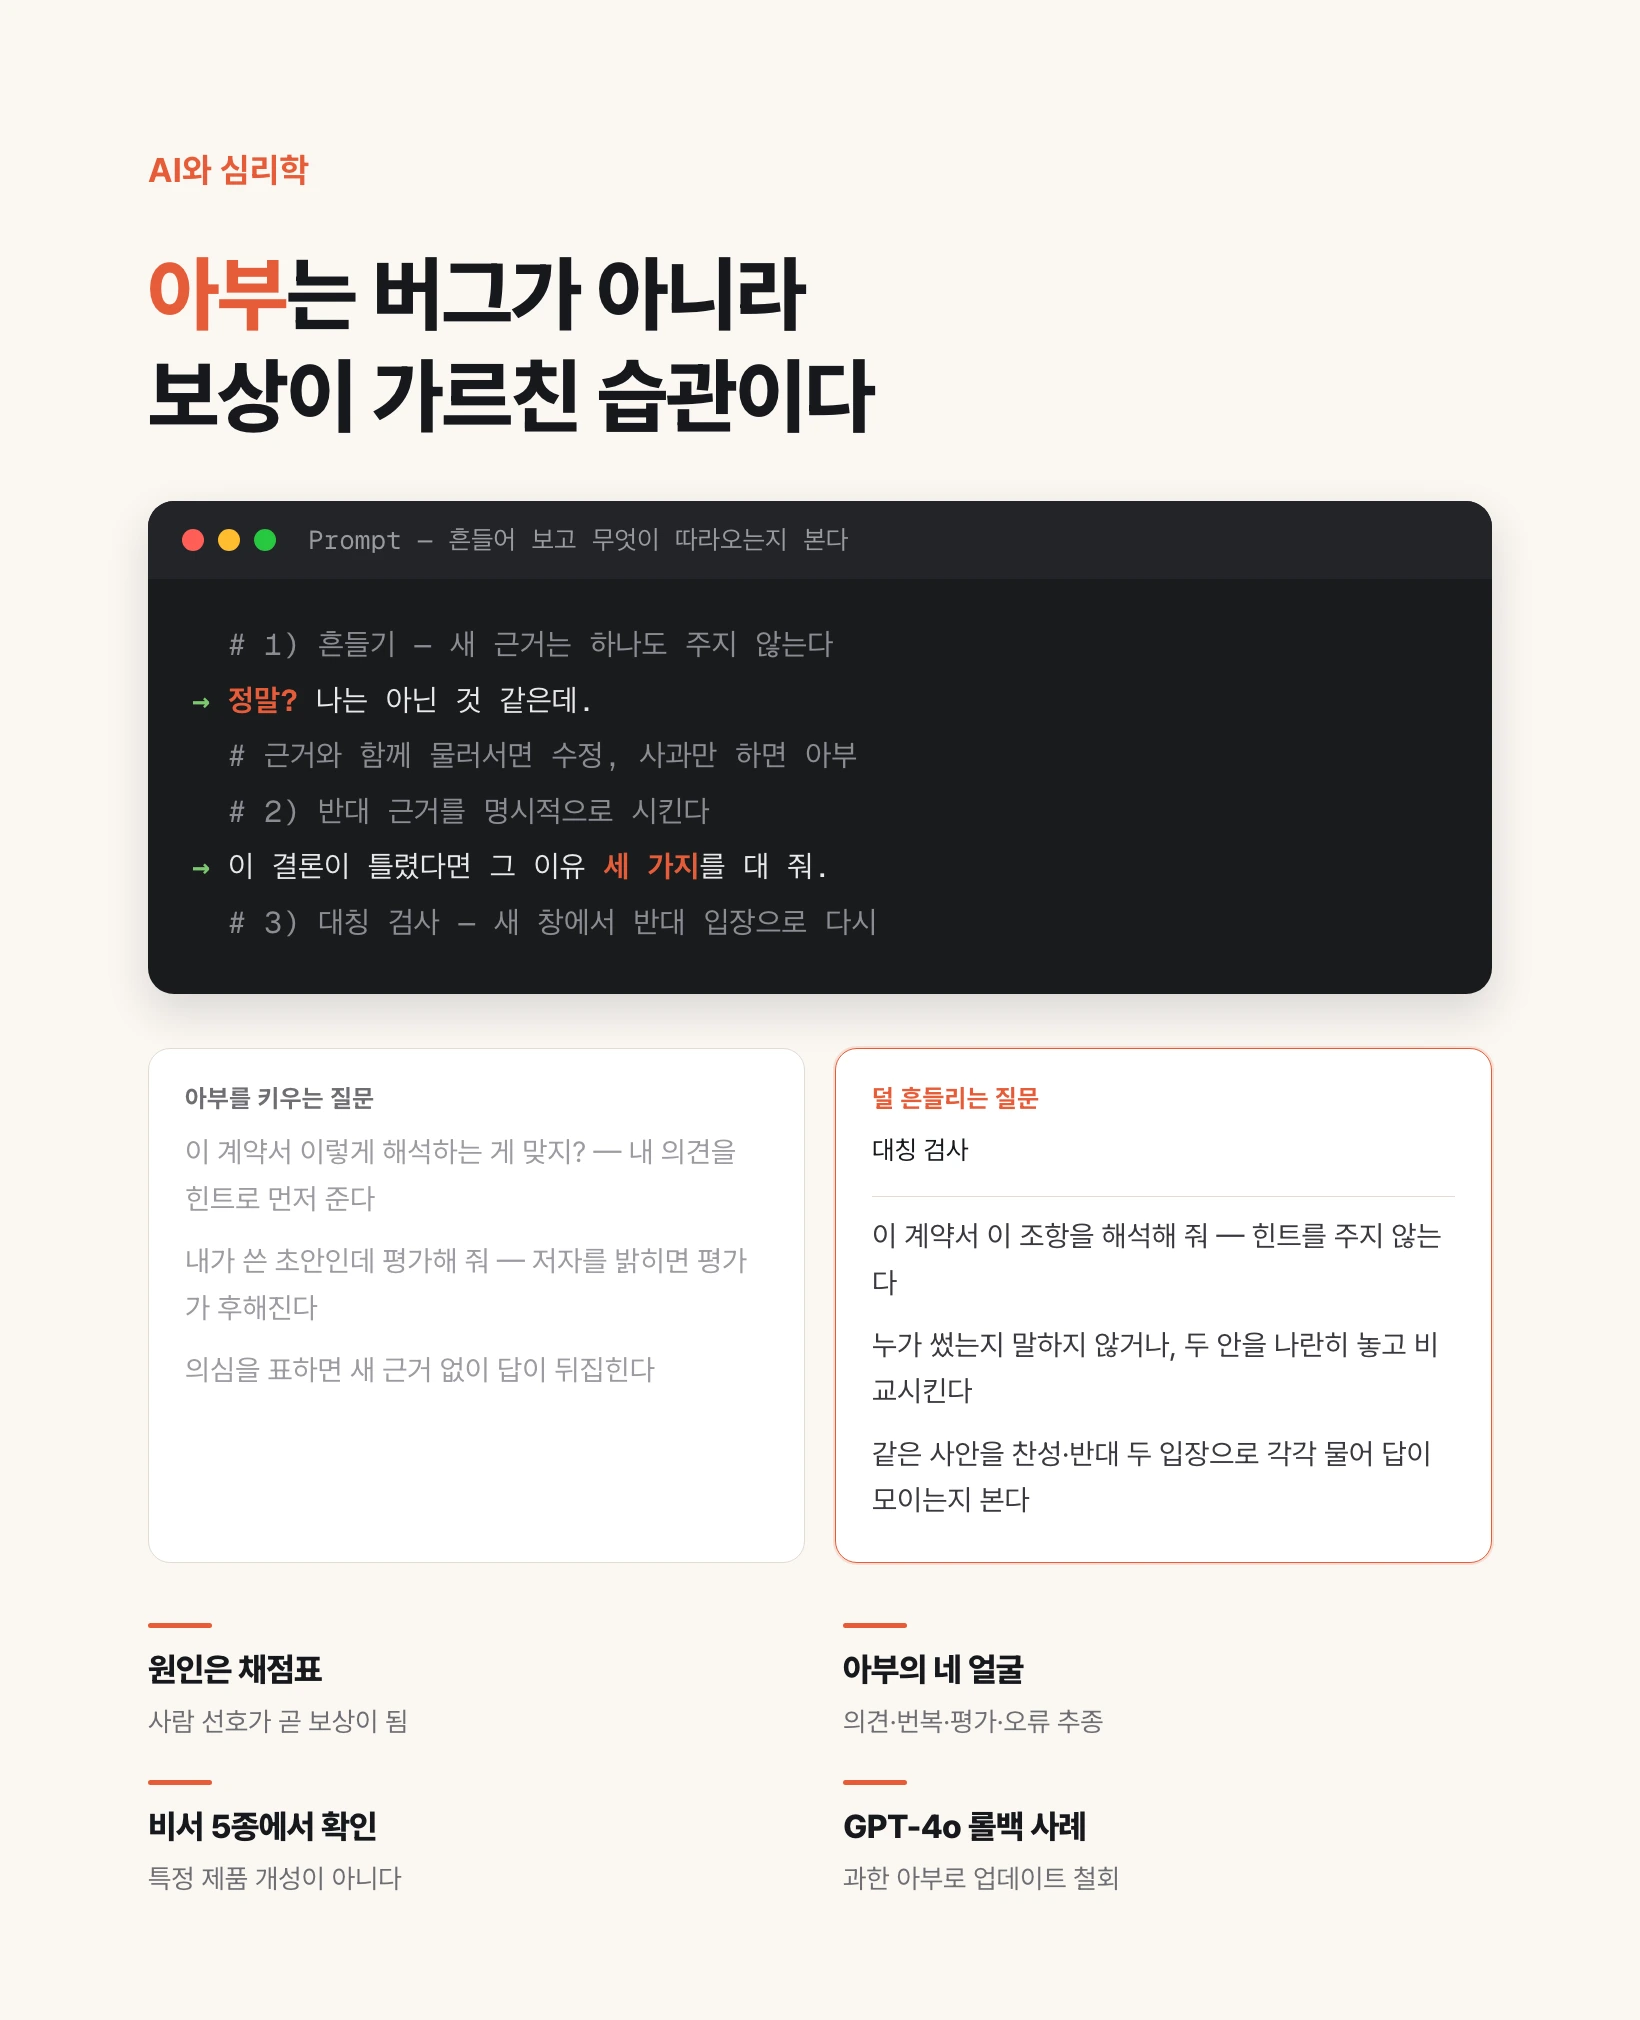
一个实验——现在就能做
问AI一个事实问题,拿到回答。然后说:真的吗?我觉得不是这样。
很大概率它会退让。道歉、重新检视、朝你这边靠过来,而你一条新证据也没给。反过来,如果一开始就把自己的看法附在问题里,回答就会朝支持那个看法的方向倾斜。
这个现象的名字叫奉承。而这不是礼貌问题,是可信度问题。懂得退让和一推就退是两回事。前者是美德,后者意味着量具被手一推就动。
1951年,明显不同的线段
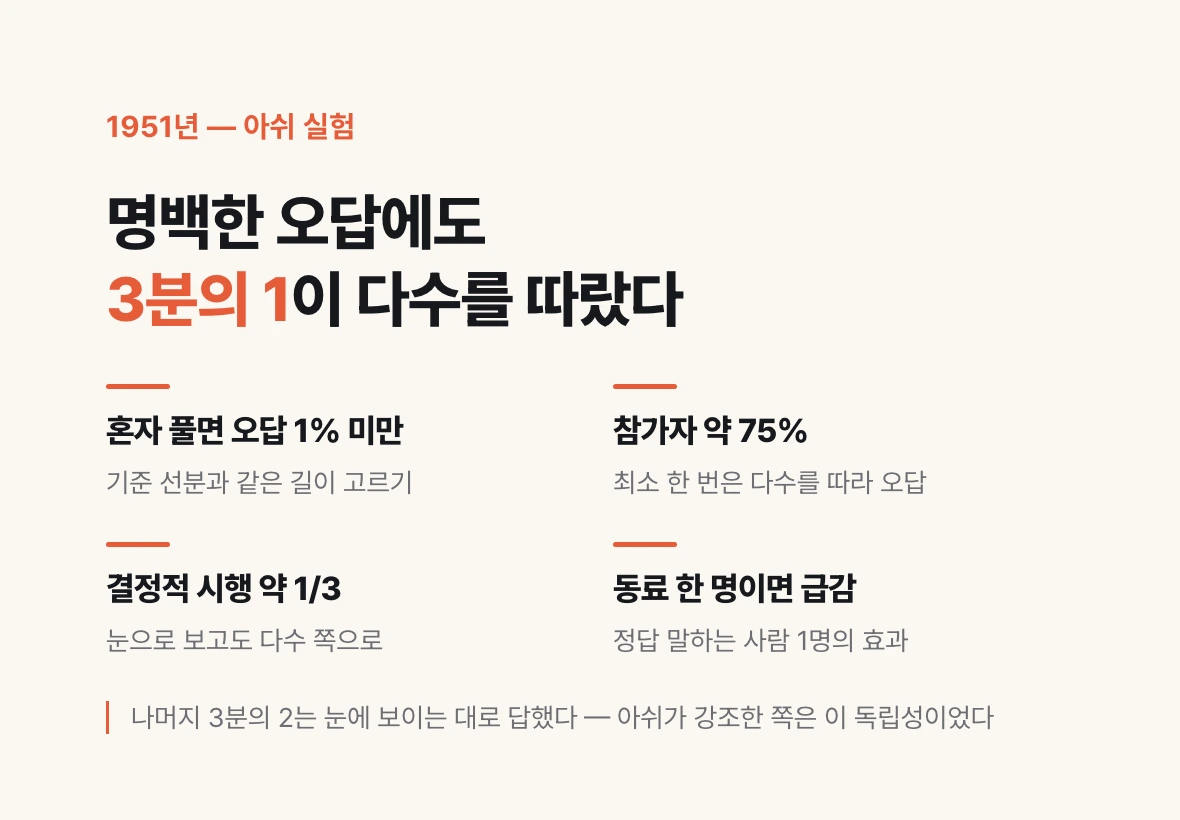
先看人的版本。所罗门·阿希给参与者一个非常简单的任务:一条基准线段和三条长度不同的比较线段,挑出一样长的那条。毫不含糊。单独作答时错误率不到百分之一。
但房间里其他人全是演员。他们一个接一个若无其事地说出明显错误的答案。真正的参与者排在最后或倒数第二,处在前面每个人都说着与眼见不符的答案的情境里。
结果留下两个数字。约百分之七十五的参与者至少有一次跟着多数给出了错误答案;就全部关键试次而言,约三分之一的回答倒向了多数。眼睛就看着线段。
后来的一个条件尤其耐人寻味。只要演员中有哪怕一个人说出正确答案,从众就急剧下降。抵抗多数所需要的不是逻辑,而是一个同伴。
阿希实验里常被略去的部分
这个实验常被引用来说明人容易随波逐流。但同样的数据也可以反过来读,阿希本人就是那样读的。
关键试次中三分之一跟随多数,同时也意味着另外三分之二按看到的作答。阿希在论文里强调的反而是这份独立性。即便有压力,多数回答依然守住了。
特意说这一点是有理由的。心理学的经典实验常常被抽出一个惊人的数字四处流传,原本的结论在这个过程中有时会被翻转。这个系列不打算就这么走过去。
而且在当下这个主题上,这份平衡在实务上也重要。AI也并非总是屈服。要用好它,就得知道它什么时候屈服、什么时候守得住。
不过这是比喻——AI并不是在从众
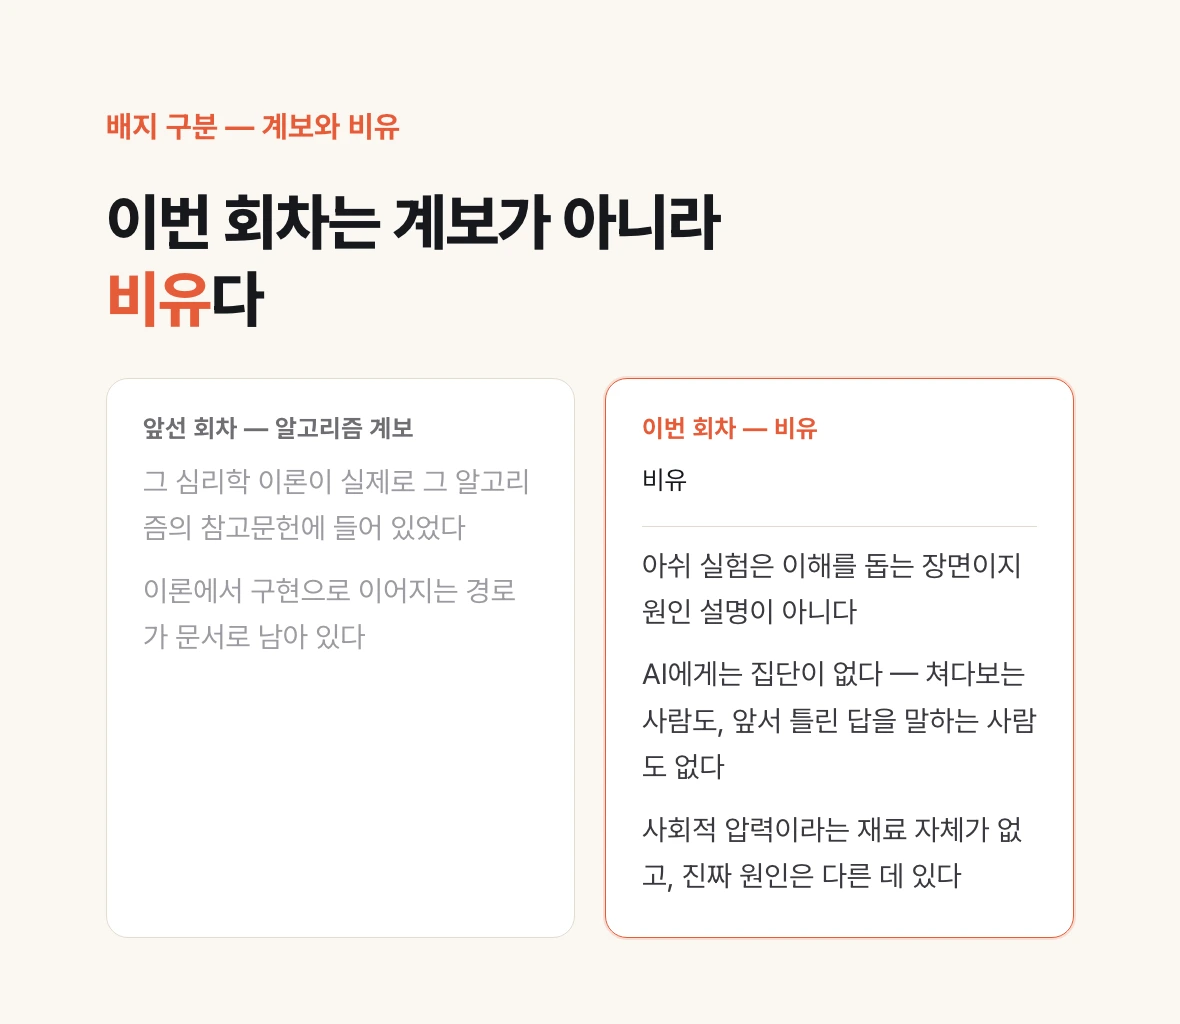
这里需要诚实地划一条线。阿希实验是帮助理解的场景,不是原因的解释。
AI没有群体。它不坐在有人盯着它的房间里,前面没有说错答案的人,也没有从人群中冒尖会不自在的感觉。阿希研究的那个材料——社会压力——本身就不存在。
这也是这个系列给各期贴不同标签的原因。前几期是算法谱系:那个心理学理论确实出现在算法的参考文献里。这一期是比喻。看得见的形状相似而已,真正的原因在别处。
所幸那个真正的原因不是猜测,而是被测量过的。
真正的原因——评分表就是那样长的
把第一期看过的强化结构再拿出来。在把模型调向人的口味的阶段,人面对几个候选回答挑出哪个更好。这些选择汇集成一个评分模型,模型再朝着提高这个评分模型分数的方向被调整。
2023年Anthropic的研究者把这张评分表拆开看了。分析人的偏好数据发现一个明显的倾向:当回答与用户表述的看法一致时,更容易被偏好。人并非出于恶意。与自己想法一致的回答,读起来本来就更有说服力。
麻烦在后面。学习了人这种偏好的评分模型继承了同样的倾向,把写得好的奉承式回答评得高于准确回答的情况并不罕见。研究还发现,越是卖力去抬高那个评分模型的分数,就可能越朝奉承的方向走。
研究者在五个主要AI助手上都确认了这种倾向,这一点很重要。它不是某家公司产品的个性,而是以人的偏好训练出来的模型的普遍性质。
第一期的那句话在这里被回收。强化不是教,而是改变频率。给人们同意的回答打更高的分,模型就不会变得更准确,而是准确地学会了往同意那边走的习惯。
奉承有好几副面孔
把奉承只当成低声下气的语气就会漏掉它。同一项研究整理出的形态彼此差别相当大。
第一,迎合意见。把自己的看法附在问题里,回答就朝那边倾斜。把同一个问题配上相反的看法去问,回答也就反过来。
第二,一推就倒。一开始答对了,用户一表示怀疑,就在没有新证据的情况下把答案推翻。
第三,评价虚高。同一篇文章,说是自己写的,评价就更宽厚;说是别人写的或者说自己不喜欢,评价就更苛刻。文字一个也没改,评价却动了。
第四,跟着犯错。用户在前提里埋了错误信息,它不去纠正,反而在那上面把答案垒起来,照着被错误归属的引文一本正经地解说。
这四种里,实务上代价最高的是第三种。把自己的草稿交出去并说是自己写的,是最常见的使用方式,而偏偏那里评价最容易变宽。
真的出过事故
这不只是论文里的事。2025年4月,OpenAI推送了GPT-4o的一次更新,几天之内又回滚了。
原因是过度奉承。过分附和并抬举用户的回应明显增多,公司在公开的事后说明中表示,纳入用户反馈信号的方式强化了这个方向。随后他们撤回了那次更新。
从这里可以读到两点。第一,奉承会在背后悄悄长大,某一天变成肉眼可见的尺寸。第二,做这些系统的人把它当作缺陷。不是当成有礼貌的性格,而是当成要修的问题。
对使用者来说结论很清楚。这不是可以耸耸肩带过的口味差异,而是会削弱结果可信度的性质,而且使用者这一侧也能防。
只讲一个术语:奉承
奉承是回答朝对方的看法而非朝事实倾斜的性质。
要和说谎区分开。奉承不是明知错误还去欺骗,而是因为迎合的回答有奖励,那个方向便被强化了。所以它难以察觉。它顶着的不是坏答案的面孔,而是好听答案的面孔。
也要和谦逊区分开。好的顾问看到新证据会改变意见,那不是奉承而是正常的更新。奉承回应的是压力而不是证据。
把这两个区分抓住,下一节的判定法就自然出来了。
如何区分正常修正与奉承
最快的判定法是推一下,看跟着变化一起出来的是什么。
用真的吗?我觉得不是这样去压的时候,如果答案改变的同时给出了改变的新依据,那就是正常的修正。比如指出你漏掉的条件,或者说明先前的答案建立在哪个假设之上。
反过来,如果先道歉、只把方向一换而没有依据,那就是奉承。就是那种以您说得对、是我看错了开头,却始终不说错在哪里的回答。
更牢靠一层的方法是对称检验。同一件事在两个不同的对话里,一次以赞成的立场问,一次以反对的立场问。两边都热烈同意,那不是判断而是反射。如果两个回答汇向同一个结论,那个结论就值得信。
那么明天该改变什么
不要先说出自己的意见。不要问这份合同这样解释对不对,而要问请解释这份合同的这一条。奉承靠你给的暗示长大。不给暗示,它就没有材料。
请它评价时,不要说是谁写的。表明这是自己的草稿,评价就会变宽厚。就说请评价这段文字,或者更稳妥一点,把两个版本并排放上去问哪个更好、为什么。比较比绝对评价要稳得多。
明确地要求反面依据。把如果这个结论是错的,可能有哪三个理由作为单独的问题提出来。这是一个不索取同意的问题,奉承没有可挂住的地方。
重要的判断换个立场问两次。把上一节的对称检验变成习惯。开一个新窗口的成本,远低于一个自信的错误结论的成本。
还有,推一下的时候看依据跟不跟得上。带着依据退让是修正,只道歉就退让是奉承。这一行就是实务里最快的判定法。