学习已经结束,却没法用
上一篇里我们一点点修改参数,完成了学习。手里得到了一个权重已被优化的模型。
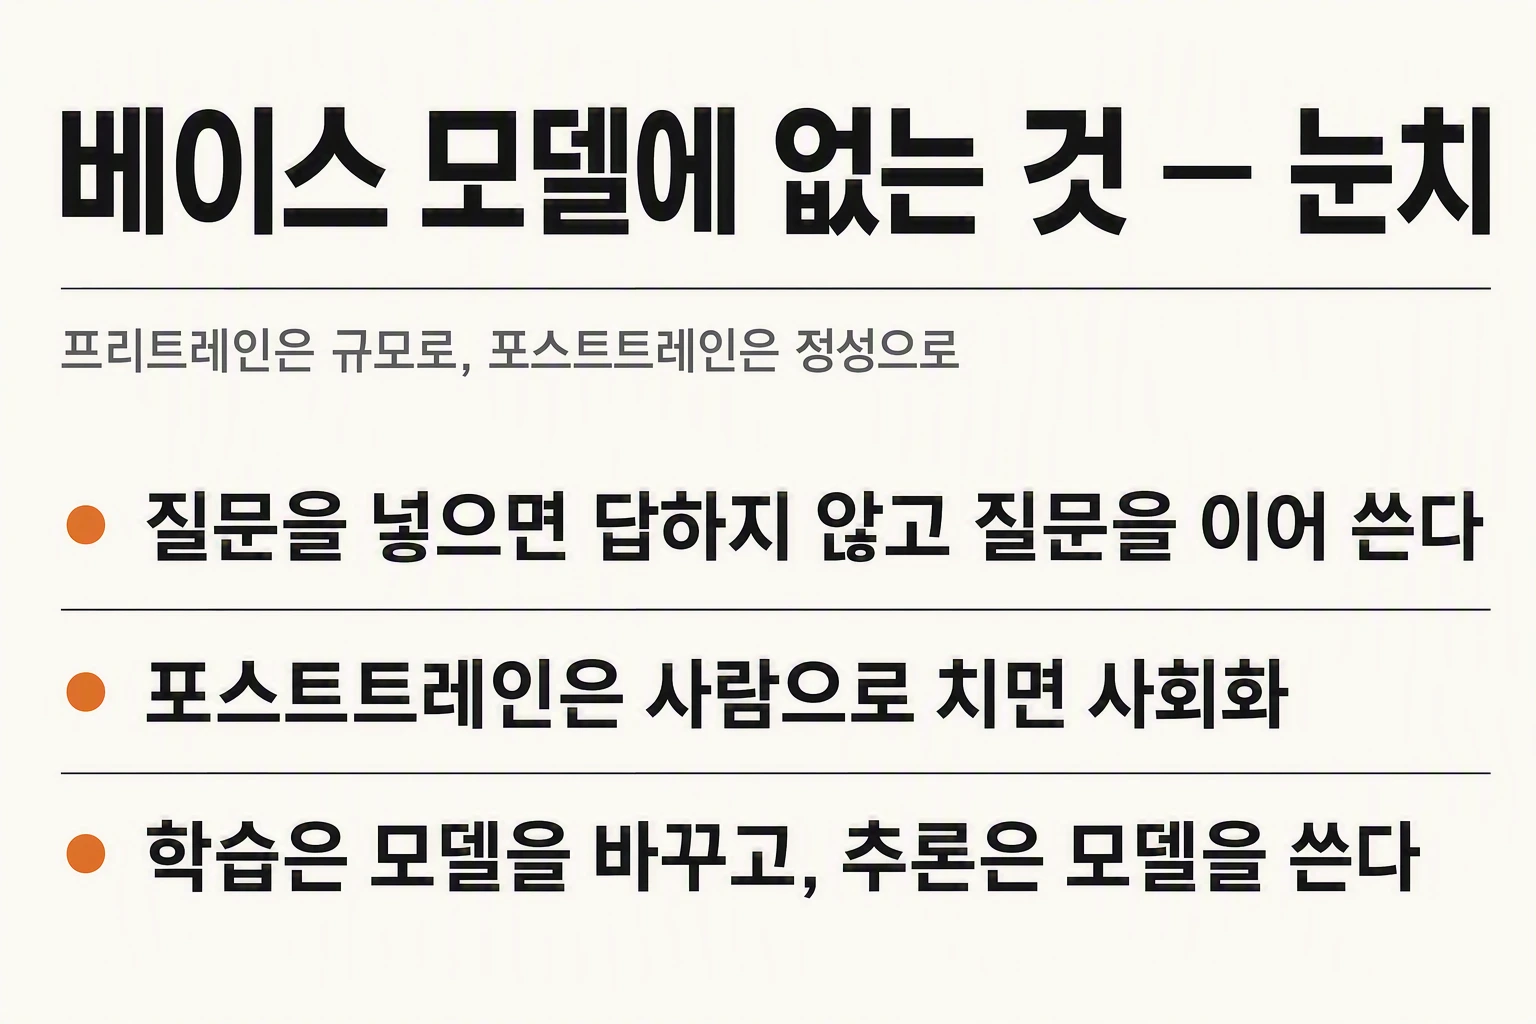
可是向这个模型抛出问题,它并不回答。它反而接着往下写问题。输入「韩国的首都在哪里?」,它就会照着「那么日本的首都在哪里?中国的首都是……」这样不断造出类似的句子。
这不是故障。它正是在按学到的东西做。这个模型受过的训练只有一件,就是看着前面的内容,判断接下来出现什么 token 才自然。至于问题后面要跟答案,它从没学过。
处于这种状态的模型叫作基座模型,到这里为止的过程叫作预训练。之所以带着「预」字,是因为它还只是前一个阶段。
基座模型缺的东西 — 分寸感
基座模型缺的东西用一个词概括,就是分寸感。它没有按场合行事的感觉。
假设把它当成编程工具来用。那么只把下一段代码猜对是不够的。给它错误日志,它要指出问题出在哪里,把改好的代码按规格返回,在需要说明的地方给出说明。
如果让它写报告,需要的又是另一种形式。摘要在前,依据在后,长度要符合要求。
这些全都是和「自然的下一个 token」不同层次的要求。所以需要额外训练,那个阶段就叫后训练。用人来比喻的话,更接近社会化。
微调 — 不重新做一台调音台
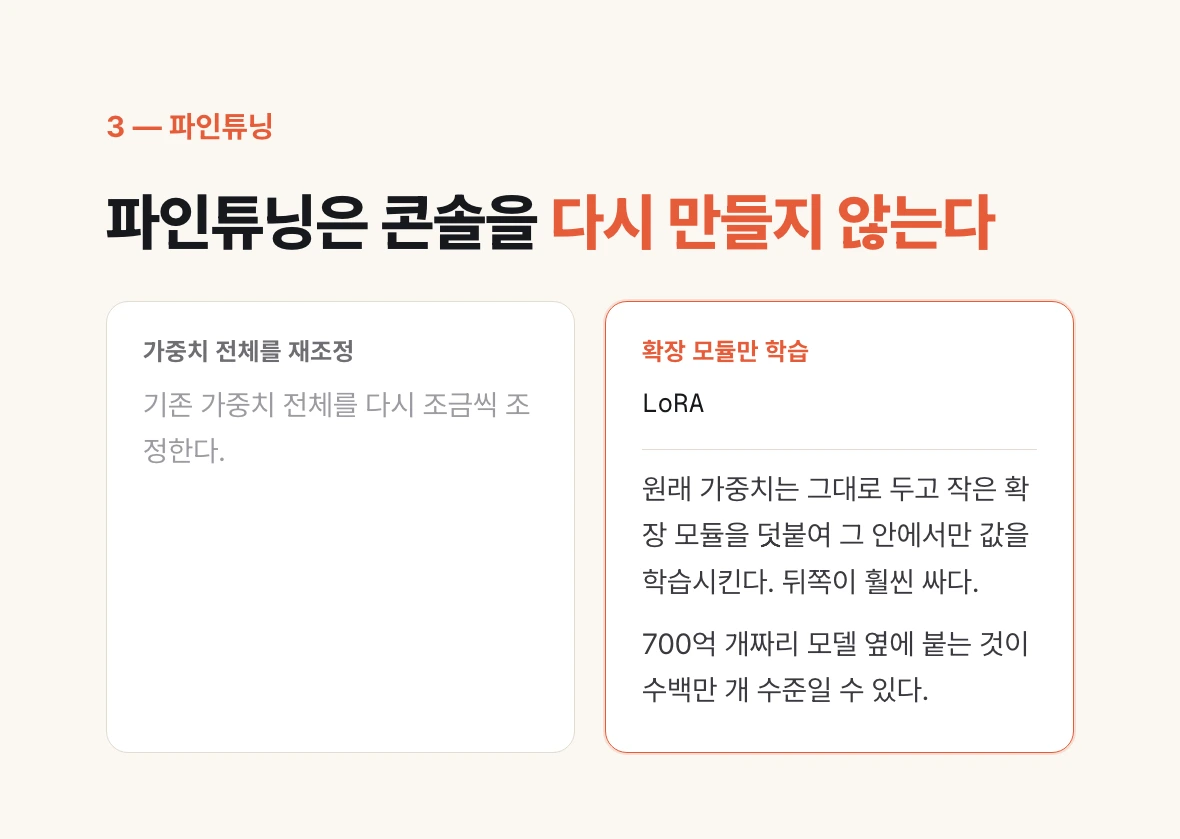
后训练的代表性方法是微调。这里重要的是,它并不把预训练从头再做一遍。
接着上一篇的 DJ 调音台比喻。已经有一台调好的调音台。微调不是把它丢掉重做一台,而是在现有的调音台上再做一些调整。
调整的方式大致分成两种。一种是把已有的权重整体再一点点调整。另一种是原来的权重保持不动,附加一个小的扩展模块,只在其中学习数值。后者便宜得多,被称作 LoRA 之类的名字。
附加模块的大小和原模型相比非常小。挂在 700 亿参数模型旁边的可能只有数百万个。画成图的话,是连头发丝粗细都看不出来的比例。即便如此,模型的行为也会明显改变。
材料的规模也不同
微调所用的数据和预训练数据性质不同。不是把互联网上的文章抓取汇集起来,而是制作「这样问就这样答」的问答集。
这很费人力。因为什么是好答案,需要由人来定。所以数量大约在几十万到几百万条。
听起来是个大数字,但和预训练投入的文本量相比非常小。这里是重点。前一个阶段靠规模推进,后一个阶段靠精心打磨。
也不是只有微调。还会一起用强化学习一类的方法,通过比较好答案和坏答案来给出方向。那一边设计的不是问答集,而是把什么算作做得好。
loss — 学习是缩小出错程度的游戏
这里先点明一个贯穿整个学习过程的概念。把一次学习后错得有多离谱用数值表示出来,就叫 loss。
学习归根到底是把这个 loss 最小化的游戏。把重复次数放在横轴、loss 放在纵轴画出图来,一开始陡峭下降,然后逐渐变缓,到某个时刻起就不再往下走了。
停止学习的点大多就在那里。不是「错得太多,从头再来」,而是「再做下去也不会降了」才是结束信号。
而且 loss 不会变成 0。100% 答对的状态不会到来,只能不断逼近。AI 的结果里没有 100% 这句话就是从这里来的。
经常搞混的地方 — token 数和参数数无关
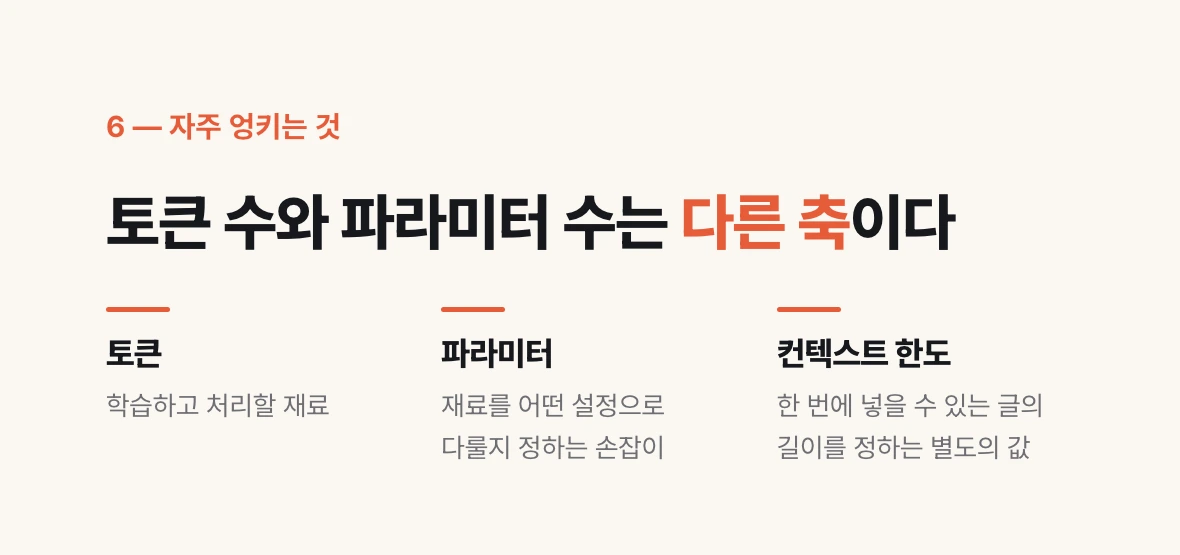
经常有人问,参数多是不是就能处理更多 token。这两者是不同的轴。
用洗衣机来比喻,token 是要洗的衣物,参数是洗涤程序。今天要放进去多少衣服,和程序设定有多少种,是两码事。
token 是要学习和处理的材料,参数是决定用什么设定来处理这些材料的旋钮。参数多了,一次能放进去的文本并不会变长。那个长度由上下文长度上限这个另外的数值决定。
另外,标注这个词也常被混进来。标注主要用在像图像识别那样、由人一个一个标出正确答案来制作数据集的场合。预训练里文本本身就含有正确答案,不需要那道工序。
模型为什么会这么多
预训练不是谁都能做的。这是要以数月为单位运转大规模算力资源的事情,实际能做的地方并不多。
可是世上的模型非常多。这两个事实看上去互相矛盾,答案在后训练。
这个阶段属于配方的领域。用什么样的问答集、把什么算作做得好、按什么顺序训练,结果都会不同。即便从同一个基座模型出发,这里不同,出来的模型性格也不同。
各个模型的基准测试分数参差不齐,原因也在这里。在编程上领先的模型和在文档摘要上领先的模型会分开,多半不是因为预训练规模,而是这套配方的差异。
在实际工作中挑选模型时不能只看参数数量,理由就在这里。要看和自己要做的事相近的任务上的基准测试。
学习到这里就结束了
收集语料库并转换成 token,用猜下一个 token 来打磨参数,再用后训练教会它分寸感。现在可以投入服务的模型出来了,把它接到聊天界面上,就成了我们使用的那个工具。
不过到目前为止看到的全都是学习。讲的是怎么造出一个模型。
从下一篇开始,会展开完全不同的故事。已经造好的模型接收我们的问题并生成答案的过程,也就是推理。把这两者混在一起,讨论就会跑偏,所以最好明确分开。学习是改变模型的事,推理是使用从未改变过的模型的事。