上一篇里,材料已经备好了
上一篇把庞大的文字堆变成了 token。现在就用这些 token 开始真正的学习。
目标依然只有一个:造一台能猜出 '우리 점심 메뉴는'(我们的午餐是)后面会接什么的机器。这一篇要看的,是这台机器怎么学会猜的。
先说结论:学习就是出错与修正的反复,不多也不少。只不过反复的次数和被修正对象的数量,超出了人的直觉。
猜猜看游戏 — 把答案遮住再让它猜
训练数据是已经知道答案的数据。这里有一个窍门:文字本身就含着答案。
如果语料库里有 '우리 점심 메뉴는 김치찌개다'(我们的午餐是泡菜汤)这样一句话,只要把最后一个 token 遮住,再去问神经网络就行。只给它看前半部分,问 '接下来会是什么?'。答案已经握在手里,所以打分是即时的。
重要的是不需要人一条一条去标注答案。互联网上的所有文字本身就成了习题集。挪动切断的位置,同一个句子里能造出无数道题。学习材料实际上无穷无尽,原因就在这里。
一开始全都猜错
刚开始学习的神经网络什么都不懂。问它被遮住的位置会是什么,它会对词表里的所有 token 排出一份概率名次,而这个名次完全一塌糊涂。
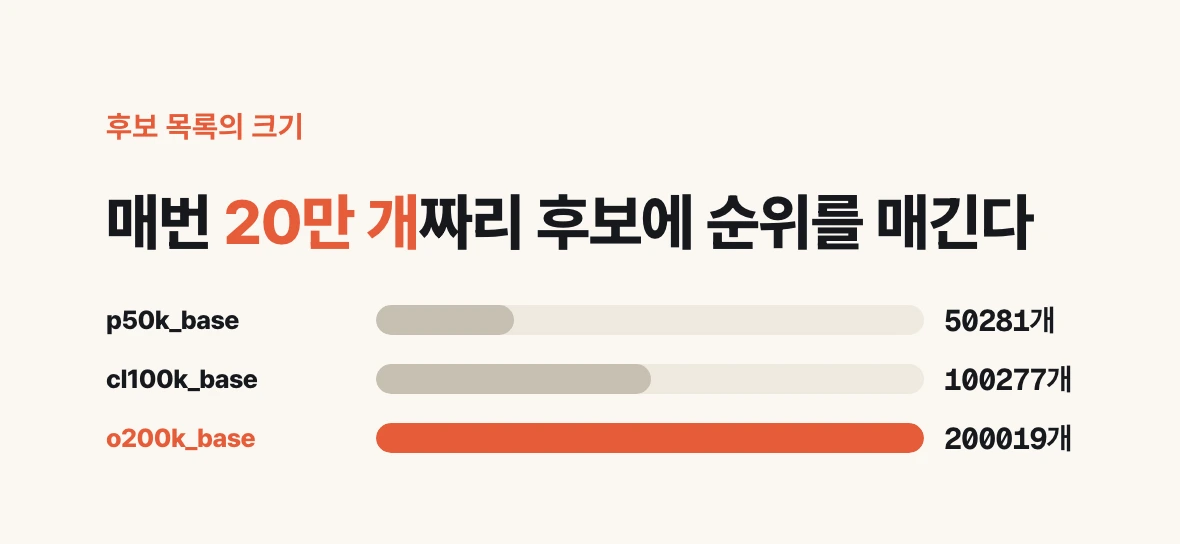
这里需要对规模有点实感。直接数一数词表有多少条目:p50k_base 是 50,281 个,cl100k_base 是 100,277 个,o200k_base 是 200,019 个。也就是说,神经网络每一次都在给一份 20 万条的候选名单排名次。
一开始会出现 '점심'(午餐)后面 '자동차'(汽车)排到第一名这种情况。跟一个不懂韩语的人摊开词典随手一指没什么两样。
但是答案是知道的。所以能打分,能打分就能修正。
错多少就往回修多少
打完分之后就这样问:'要让正确答案升到第一名,当初应该把什么改动多少。'
回答这个问题的计算叫做反向传播。名字听着难,做的事却很简单:把出错的程度从输出一侧朝输入一侧逆推回去逐层分摊,算清每个设定值对误差贡献了多少,再据此定下修正的方向和幅度。
这里重要的是,它不会一次就跳到正确答案上。每次只挪动极小的一点。因为为了对上一道题而大幅挪动,之前已经猜对的其他题目就会跟着走样。
所以是修一点点,再猜错,再修一点点。这个反复就是学习。
被修正的对象 — DJ 台上的那些旋钮
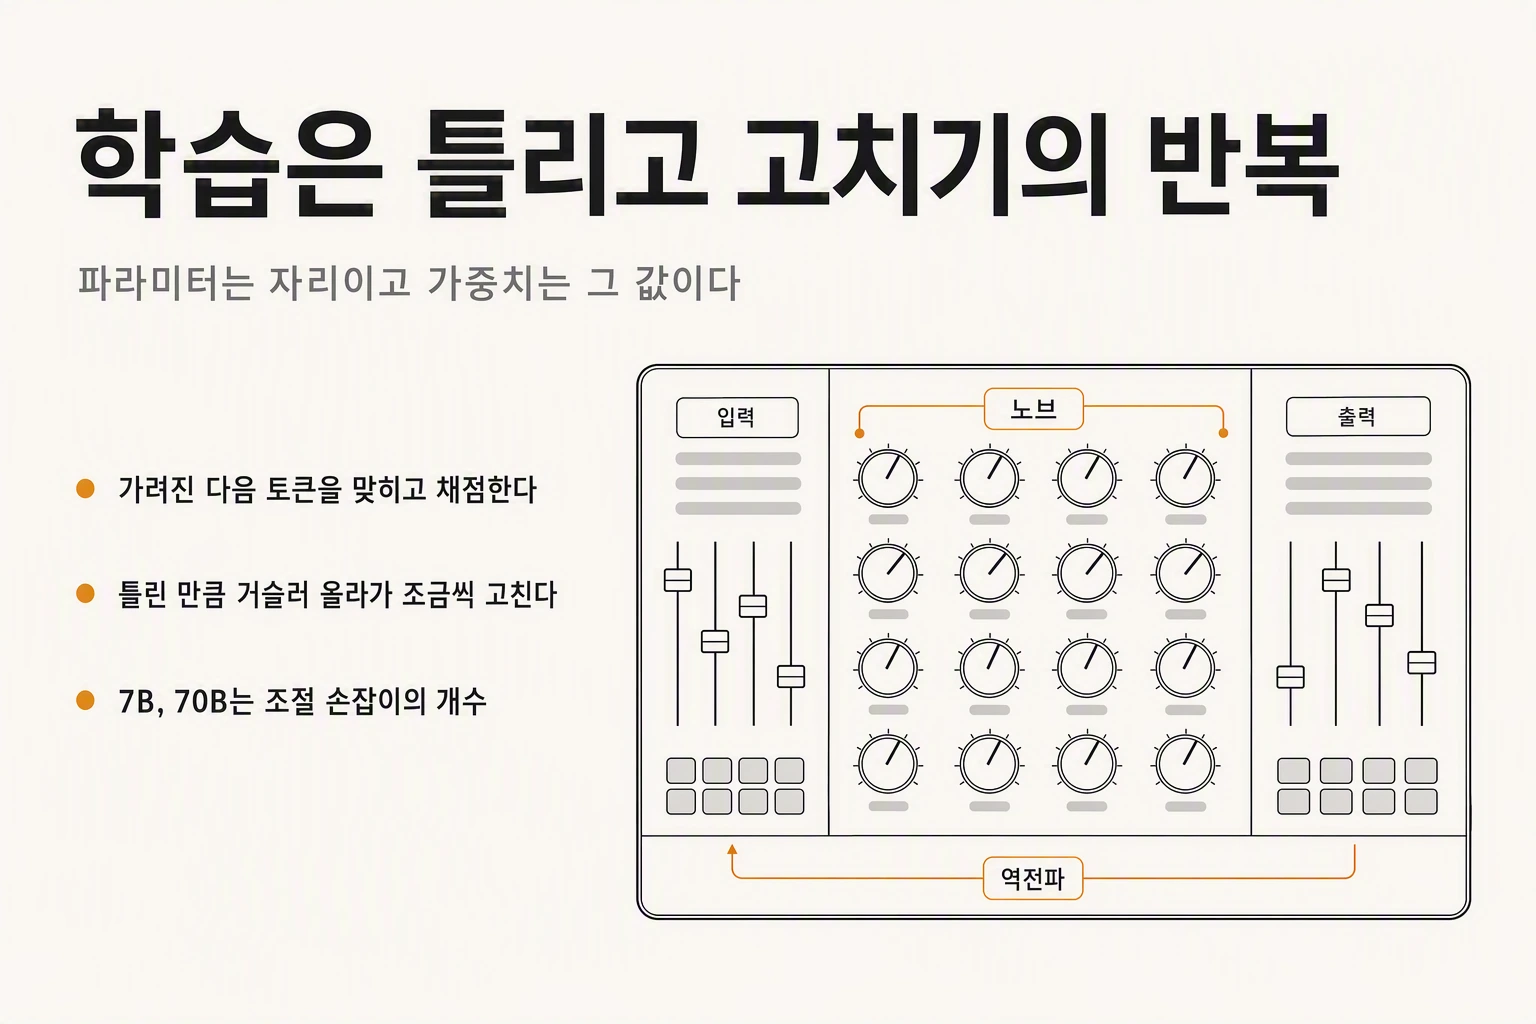
那么到底修的是什么。神经网络内部密密麻麻地插满了由数字构成的调节旋钮。想象一下 DJ 台上的旋钮就行。
输入进来之后,计算会经过这些数值往前流动,旋钮拧在什么位置,最终输出的概率分布就跟着变。学习就是一点点转动这些旋钮,去找能让正确答案升到第一名的那个组合。
这些旋钮叫做参数,拧在每个旋钮上的数值叫做权重。两个词几乎总是绑在一起出现,原因就在这里:参数是位置,权重是装进那个位置的数值。
深度学习里训练完成的模型文件常常以 weights 这个名字落地,也是同一个道理。因为学习的产物归根结底就是这些数值的清单。所谓拿到一个模型,实际上就是拿到这一堆权重。
7B、70B 数的是什么
模型名字旁边跟着的 7B、70B 之类的标记,正是这些旋钮的数量。B 是 billion,十亿。7B 就是说这个模型里有 70 亿个调节值,70B 就是 700 亿个。
对这个数字没概念是正常的。只要把方向记住就够了:旋钮越多,能调得越细,表达力越强,与此同时计算量也一起变大。
变大的地方有两处。训练的时候大一次,训练结束后实际生成答案的时候又大一次。第二处才是实际工作中会直接撞上的那一处。
在 Hugging Face 上搜模型时,左边有一个按参数数量筛选的过滤器。它看起来像性能过滤器,实际上更接近一个硬件问题:用现在手上的设备,能不能跑得动这个模型。
为什么偏偏是 Large
Large Language Model 里的 Large 不是营销修饰语,指的就是这个参数规模。而规模之所以变大,与其说是设计意图,不如说更接近观察的结果。
神经网络本身是个老想法。可是做得小的时候,顶多吐出符合语法的句子,出不来让人觉得可以当对话对象的结果。后来计算资源变便宜,把规模大幅拉高的实验成为可能,越过某个点之后,结果的性质就变了。那不是稍微变好了一点,而是看上去像是它做的事情本身换了种类。
参数和权重这套结构并不是 LLM 独有的。无论图像识别还是语音,几乎所有深度学习模型都是同一个样子,只是处理的材料和规模不同。
这里最常出岔子的地方
实际工作中最常见的混淆,是 '用我们的数据训练一个 LLM 吧' 这句话。说这话的人真正想要的,大多并不是训练。
训练就像刚才看到的那样,是把几百亿个参数一点点往回修的活儿,资源和时间都是另一个量级。想让内部文档反映到回答里,这种需求通常是用别的方法来解决的。
用什么来解决,判断标准会在本系列的最后一篇里讲。现在要记住的只有一点:所谓训练,是改动模型内部数值的事,而这件事不是随时都会发生的。
现在还不是能用的模型
做到这里,一个权重被优化过的模型出来了。可是这个模型还不是大家在用的那个模型。
到目前为止训练的只有一件事:下一个 token 接什么才自然。怎么回答问题、怎么遵循要求、怎么拒绝危险的请求,它都没学过。
处于这个状态的模型叫做基座模型,到这一步为止的过程叫做预训练。下一篇要看的是,这个基座模型为什么不能直接拿来用,以及还要再做什么,它才会变成我们在用的聊天机器人。