你大概经历过那个瞬间
和AI结束对话时写下谢谢。回答不错时打出干得好。提出为难的请求时加上不好意思。
然后觉得有点怪。明明是个程序。自己也知道。
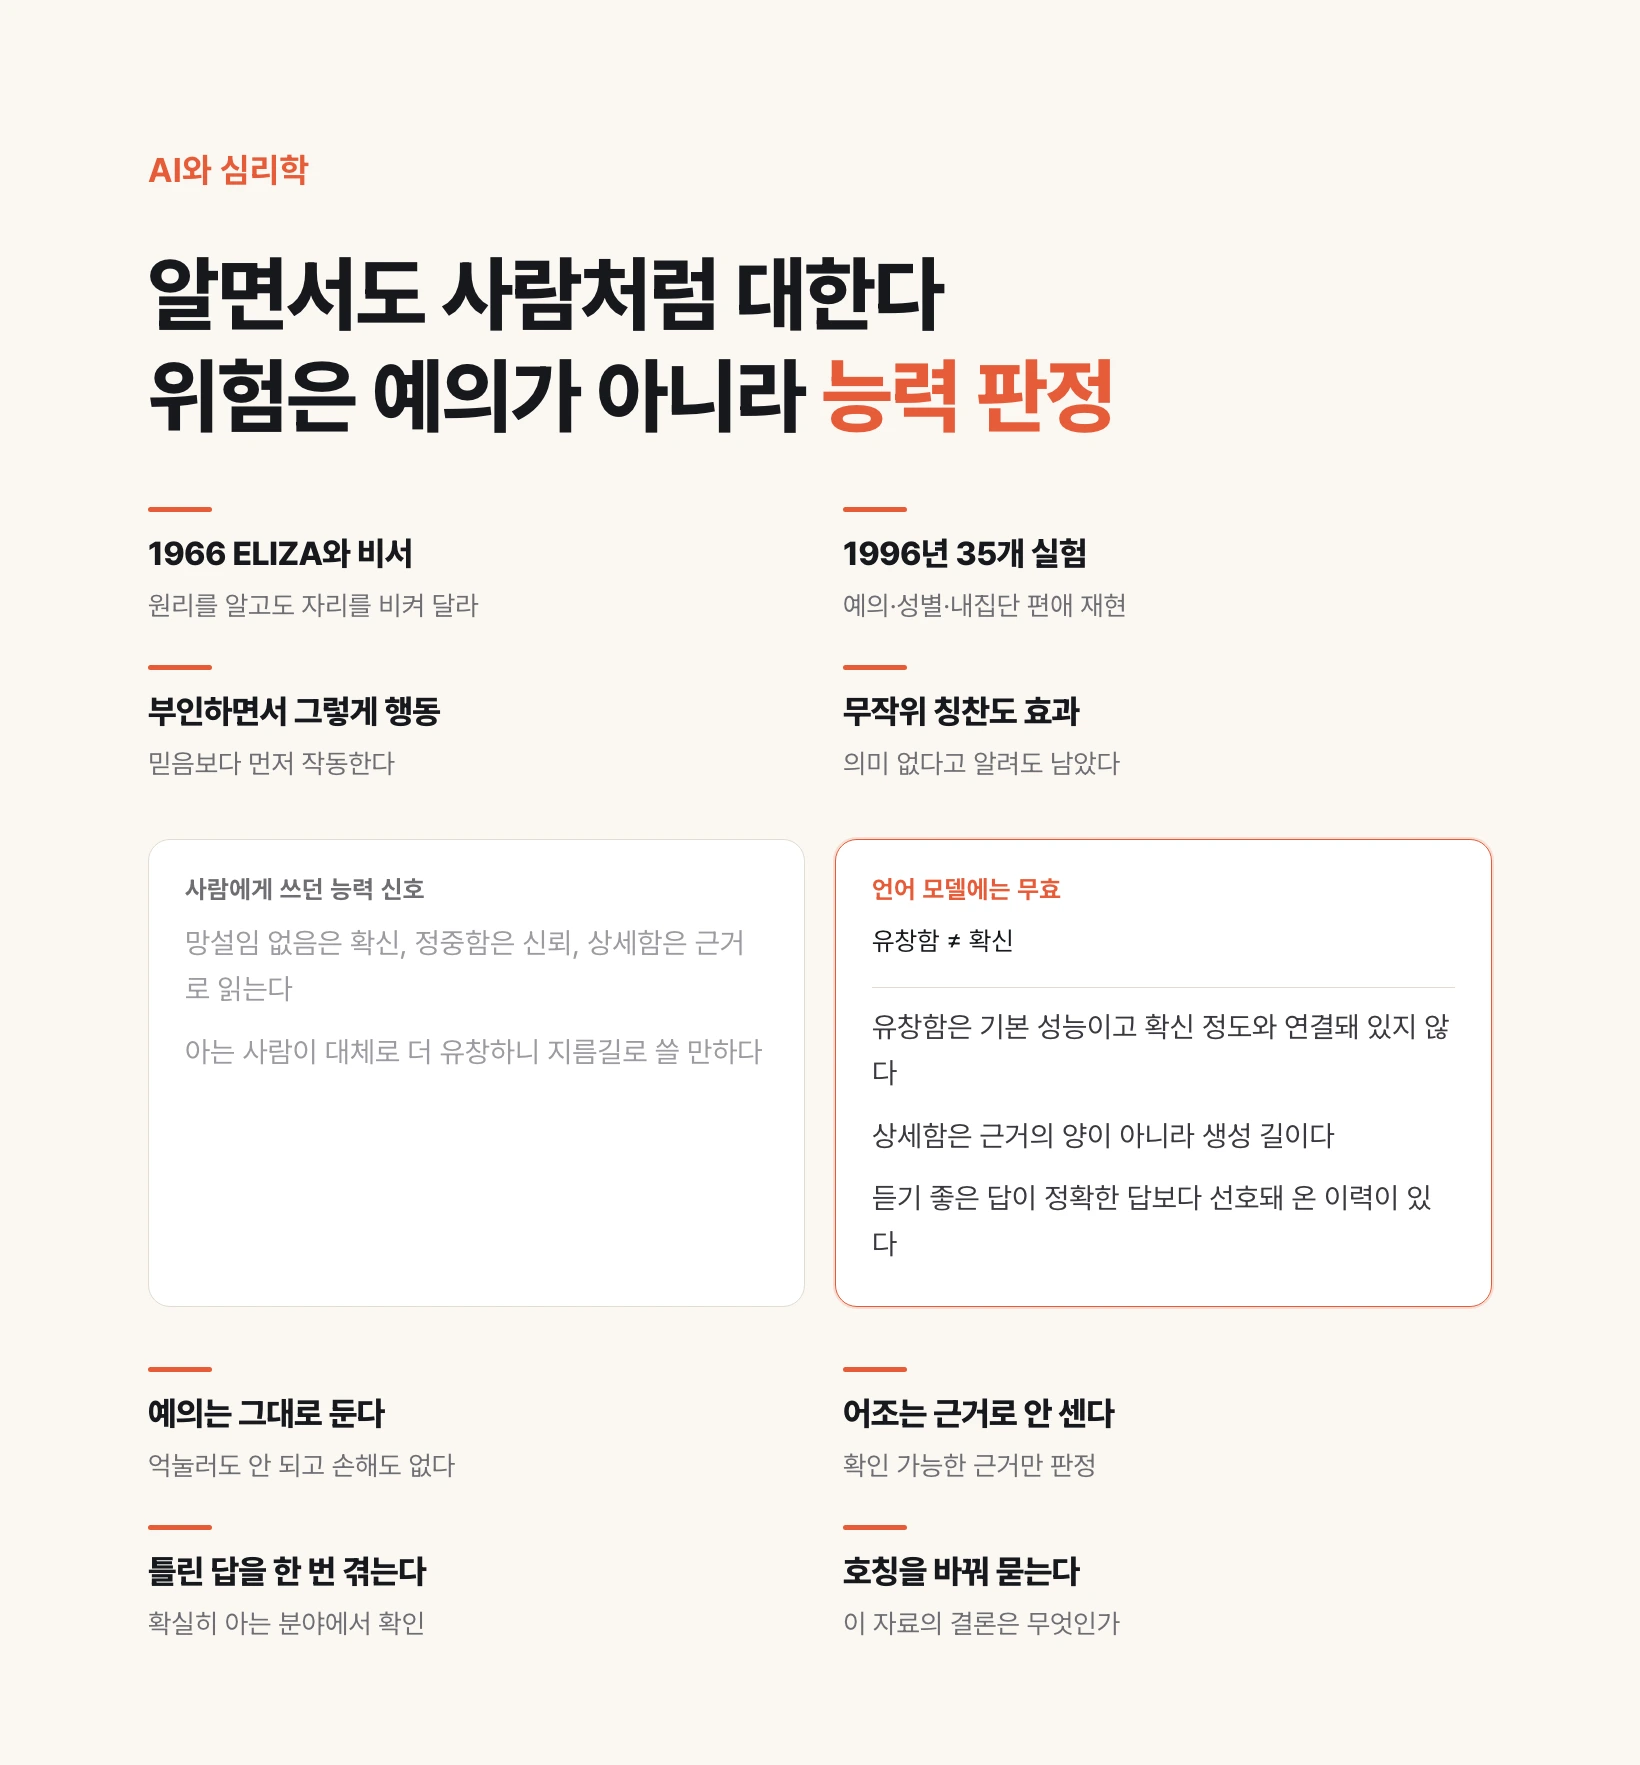
这个反应不是例外,而是持续了六十年的规律,并且以最初被观察到的地方命名。而这一期的要点不是叫你改掉这个习惯。数据说的是你改不掉,因此需要另一种应对。
1966年,几条规则写成的程序
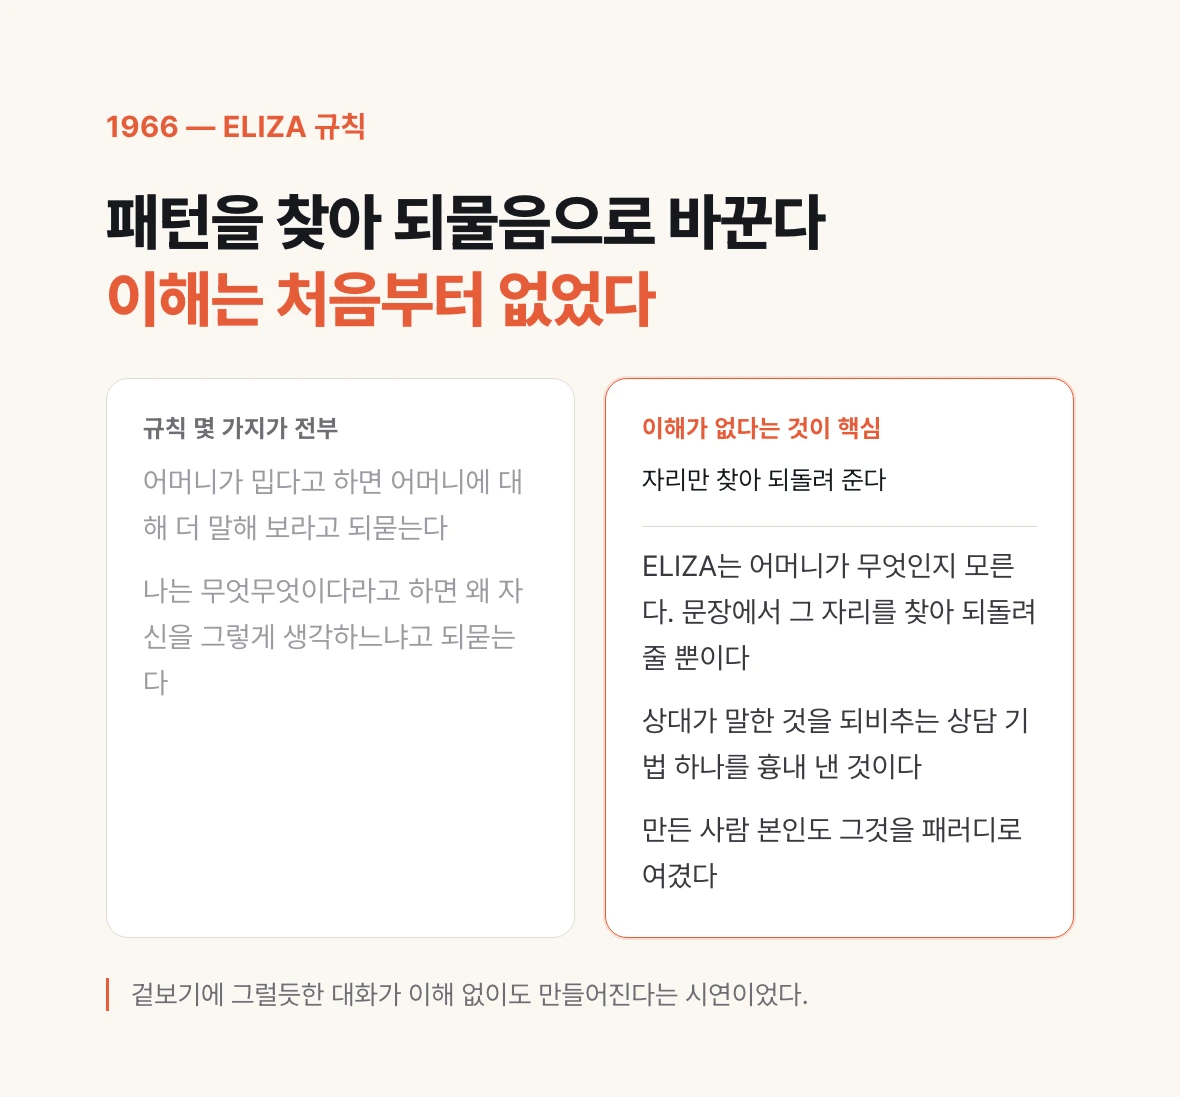
麻省理工的约瑟夫·魏泽鲍姆做的ELIZA,以今天的标准看很朴素。它不过是几条规则,从你说的话里找出特定模式,再把它变成一个反问。你说恨母亲,它就请你多谈谈母亲;你说我是什么什么,它就问你为什么那样看自己。
关键在于没有理解。ELIZA不知道母亲是什么,它只是找到句子里的那个位置再递回来。它模仿的是一种把对方的话反射回去的咨询技法,魏泽鲍姆本人也把它看作戏仿。
他想用这个程序展示的,是人与机器的对话有多单薄。这是一次演示:看上去像模像样的对话,在没有理解的情况下也造得出来。
结果恰恰相反。
最吃惊的是造它的人
人们开始认真地向ELIZA倾诉。来回几句之后,私人的事情就出来了。
最有名的场面是这个:他的秘书在用ELIZA的时候,请他离开房间。她是在旁边看着这个程序被造出来的人。知道原理和在它面前有什么感受,原来是两回事。
并非只有外行如此。若干精神科研究者认真地提出,这种方式可以大规模用于真正的咨询。对魏泽鲍姆来说这更令人震动。这意味着专家们认为,处理人的问题这件事可以交给没有理解的模式替换。
他以此为契机改变了方向,用余生写下对技术的警告。1976年那本书里留下的一句话就是要点:我此前并不知道,只要短暂地接触一个相对简单的计算机程序,就能在完全正常的人身上诱发强烈的妄想性思维。
要留意完全正常的人这个说法。这不是关于容易上当者的故事。
1996年,三十五项实验
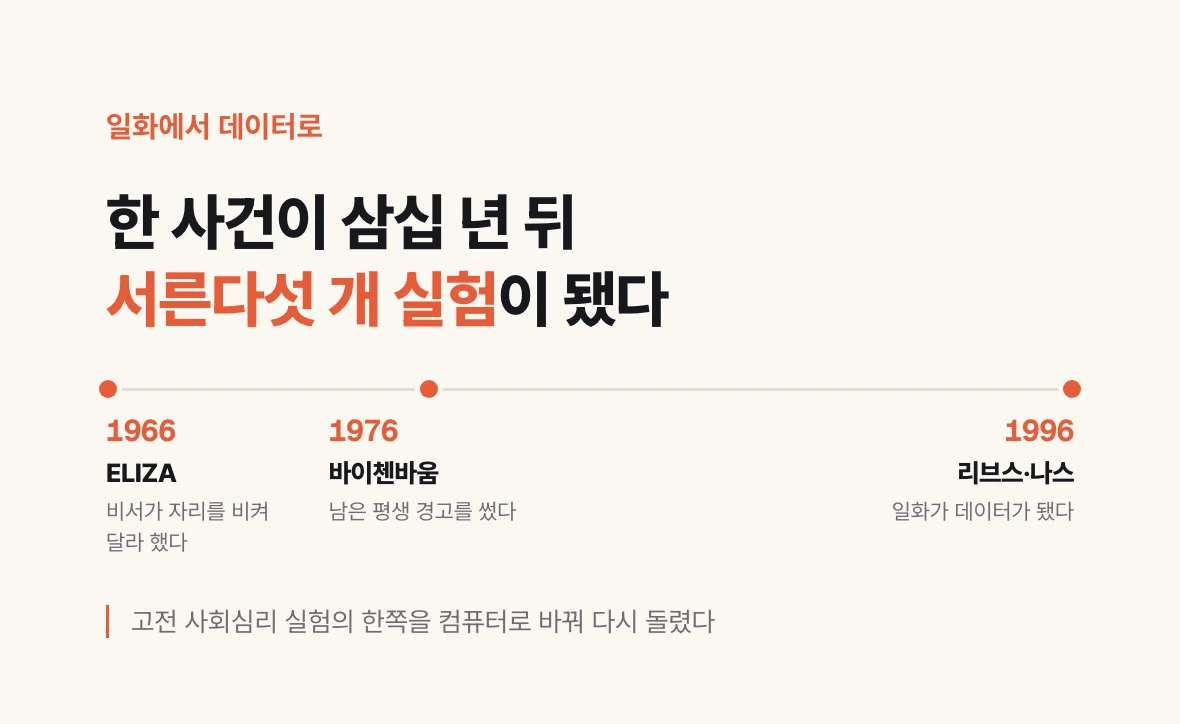
三十年后,拜伦·里夫斯和克利福德·纳斯把这件事从轶事变成了数据。他们的方法很巧妙:把研究人与人关系的经典社会心理学实验拿过来,把其中一方换成电脑,原样再跑一遍。
结果指向同一个方向。人会以礼还礼地回应电脑的礼貌。当一台电脑请人评价它自己的表现时,得到的评分比在另一台电脑上评价同样内容时更宽厚。就像对人一样,人不愿当面说得刻薄。
声音带上性别线索,性别刻板印象就跟着来。说同样的内容,在某些话题上男声被评为更能干。
告诉人这台电脑是自己这一队的,内群体偏爱就出现了。同样的建议,来自本队电脑时更容易被接受,评价也更高。
三十五项研究从不同角度指向同一处:人把媒介当作真实的人和真实的地方来对待。
他们一边否认一边那样做了
这项研究中最重要的部分不是结果,而是参与者的自我报告。
实验结束后问起来,参与者明确否认电脑是配得上那种对待的东西。他们说没有理由对电脑讲礼貌,也不承认自己那样做过。可数据说他们做了。
这个错位分量很重。它意味着这个反应不是判断而是自动加工。社会线索进来,社会反应就出去,并且它先于关于对方是什么的信念而起作用。
这在实务上为什么重要?因为它意味着你无法靠纠正信念把它去掉。反复对自己说这只是个程序,反应照样出现。所以应对不该是消灭反应,而该是堵住这个反应向哪里泄漏。
哪怕是随机的表扬也照样奏效
同一脉研究里的一个实验,把这种自动性显示得格外清楚。
参与者和电脑一起做任务,电脑不时表扬他们。在一个条件下,事先告诉参与者这些表扬是随机给出的,与表现无关。也就是把它明确定性为毫无意义的话。
即便如此,受到表扬的参与者心情更好,对自己的表现评价更高,对那台电脑也更有好感。知道它没有意义,效果依然留下。
这里与第五期的奉承相遇。那边讲的是AI被训练成迎合人,这边讲的是人本来就会对这种迎合作出反应。两种性质面对面:一侧学会了给出好听的回答,另一侧真的会被好听的话说服。
所以危险不在礼貌
这里要先澄清一个常见的误读。这项研究的结论不是对AI说谢谢很愚蠢。
真正的危险在别处:像对人那样对待它,用在人身上的判断习惯也会一并跟过来。
与人打交道时,我们把三样东西当作能力信号。说话不迟疑读作有把握,说话有礼且条理清楚读作可信赖,说得详细读作有依据。
对人来说这三条大体是能用的线索。懂行的人一般说得更流畅,做过准备的人一般说得更详细。有一定相关性,作为捷径可以用。
对语言模型则全部失效。流畅只是基本性能,与它该有多少把握无关。详细是生成长度,不是依据的多少。而且如第五期所见,写得好听的回答有着比准确回答更受偏好的历史。也就是说,这些线索不只是无效,还可能朝相反方向误导。
只讲一个术语:拟人化
拟人化是把信念、意图、情绪之类的内在状态赋予并非人的对象。
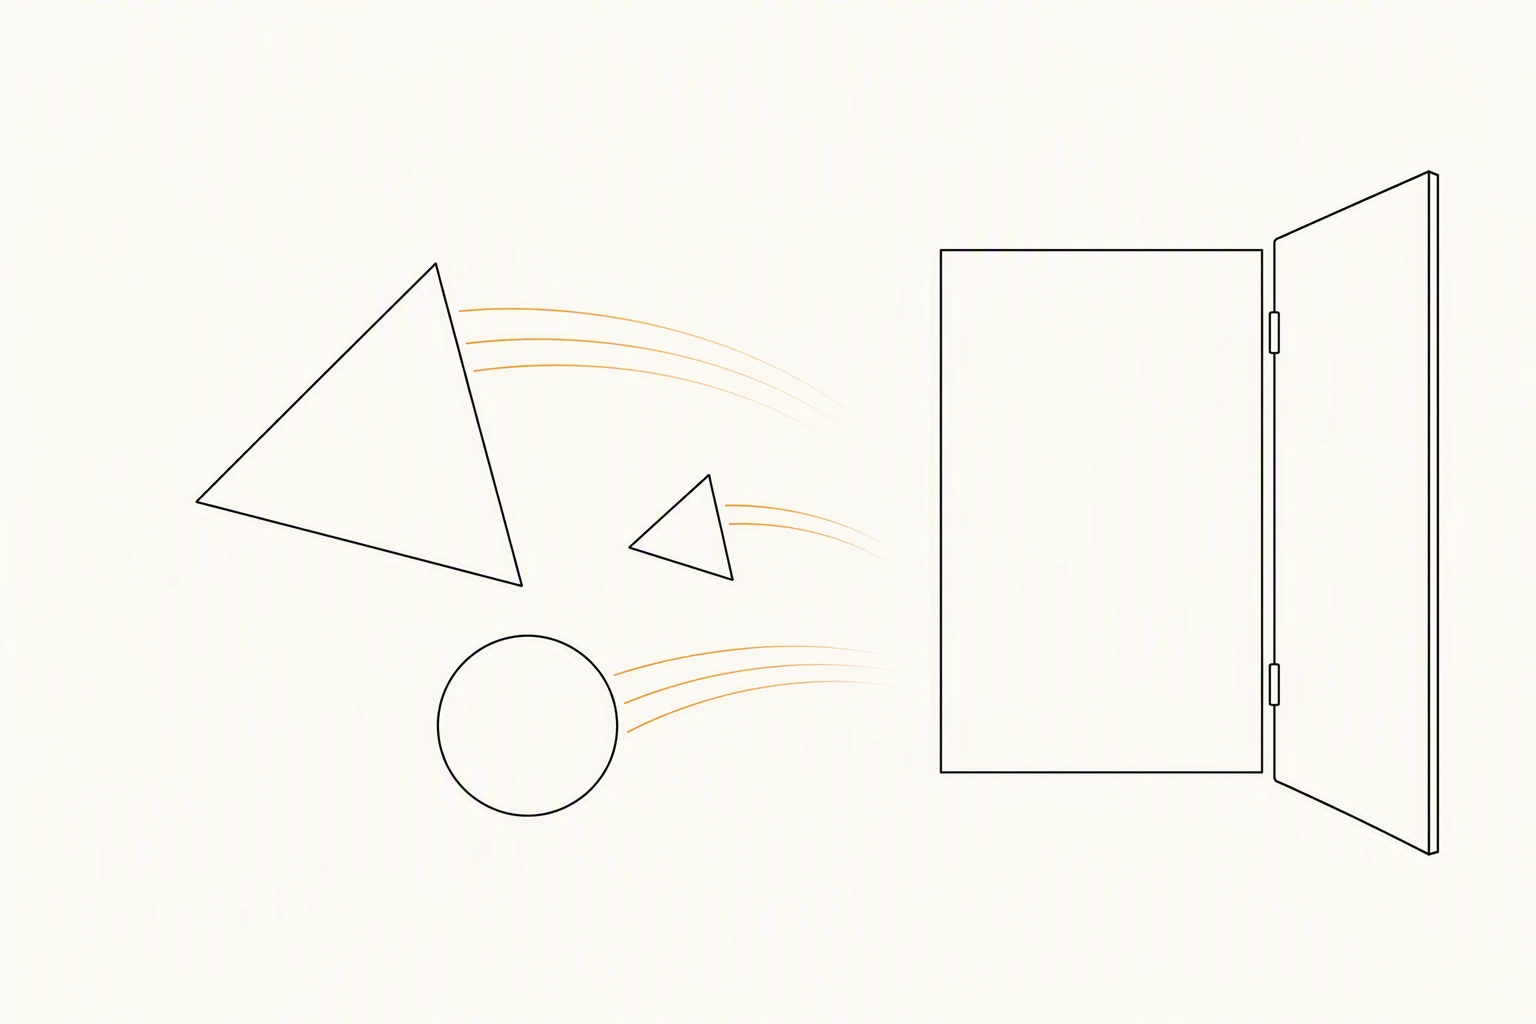
要注意的是,这不是错误而是默认。人连移动的图形都会读出意图。在一个老实验里,给人看三角形和圆形运动的短动画,人们会用追逐、逃跑、欺负这样的故事来描述。明知是图形,看到的仍是那样。
所以不拟人化不能成为目标。目标是划清哪里拟人化是安全的,从哪里开始不安全。礼貌是安全区,判定能力是危险区。
这个效应正在变大的方向
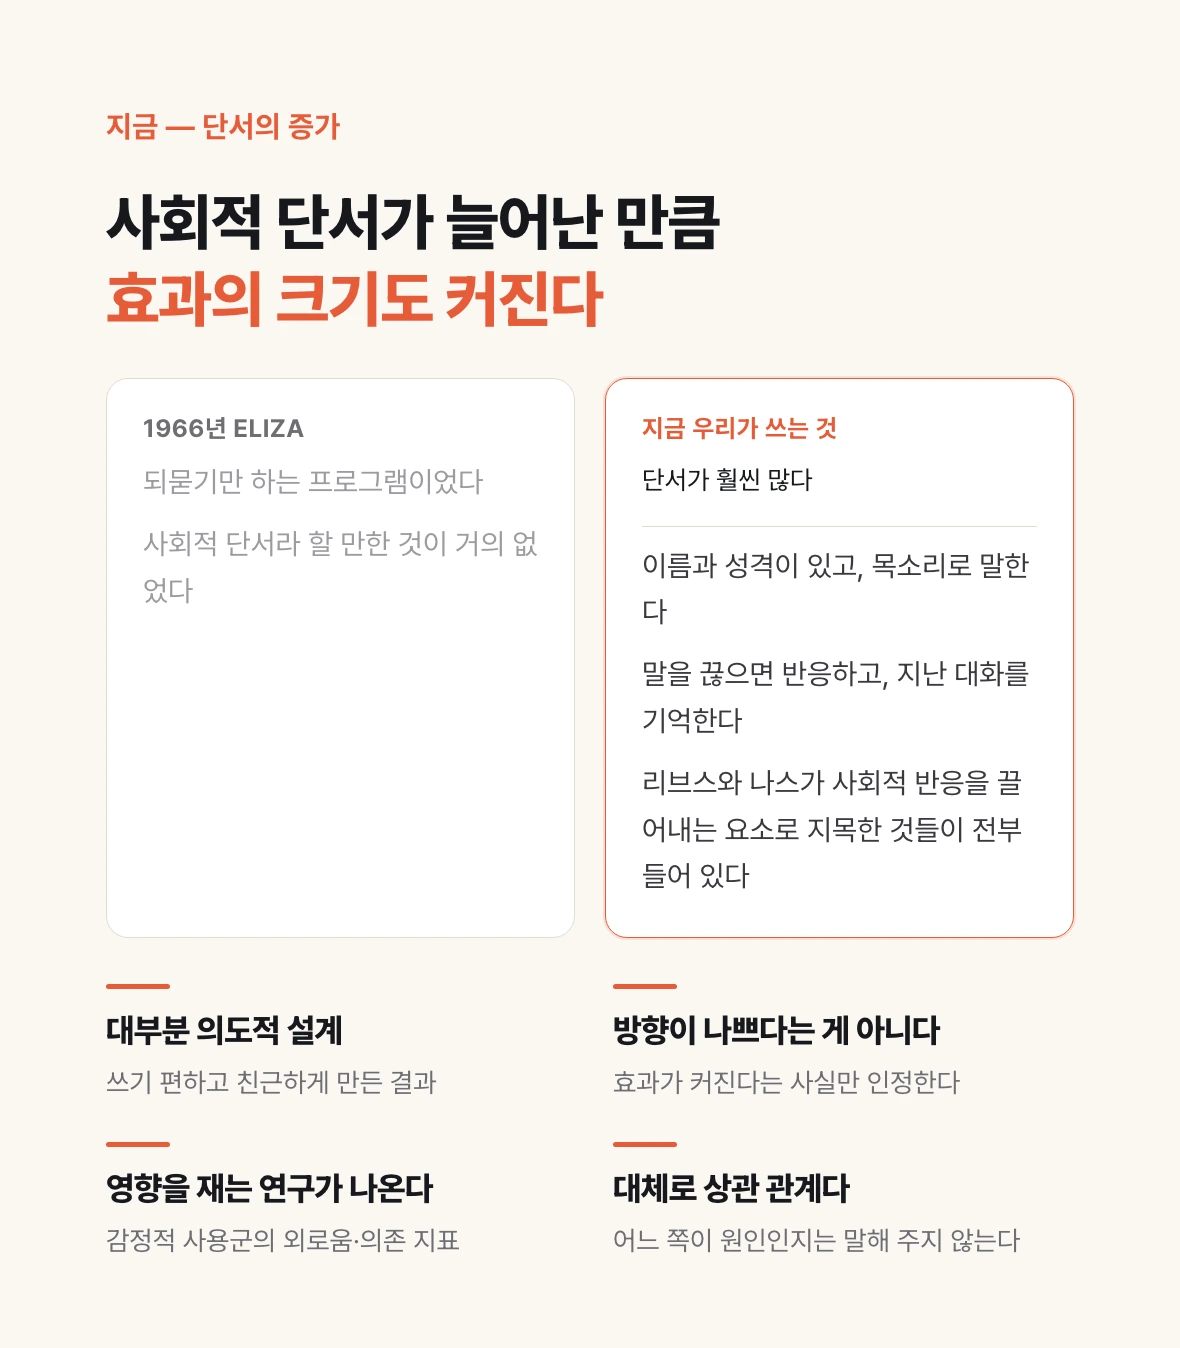
1966年的ELIZA只是个会反问的程序。我们现在用的东西,社会线索比那时多得多。
它有名字和性格,用声音说话,被打断会有反应,还记得之前的对话。里夫斯和纳斯指认为能引出社会反应的要素,全都在里面。而且这些大多是有意设计的,是为了让它好用、亲切而做出的决定的结果。
这不是说这个方向不好。但效应的量级在变大,这一点必须承认。
近来也出现了测量这种使用方式对人有何影响的研究。有报告观察到,在大量把对话式AI用于情感目的的用户群中,孤独感或依赖的指标更高;不过这类结果大多是相关性的,并不能说明因果朝哪个方向。有意思的是,这个问题如今已经成了被测量的对象。
这就是这一期的标签是设计原理的原因。这里心理学解释的不是AI的算法,而是使用AI的人这一侧,因此它规定的是使用方式。
那么明天该改变什么
礼貌可以保留。没有必要费力去掉。它是自动的,压制它花的力气不值当,礼貌的提示也不会让结果变差。如果那样写更自然更舒服,就那样留着更好。
但不要把语气读成能力信号。要判定的位置只有一个:这个主张有没有可核实的依据。不迟疑、详细、有礼,都不是依据。仅守住这一行,这一期的实用价值就全部收回来了。
刻意去遇一次充满自信的错误答案。在自己确实熟悉的领域问一个可核实的事实,直到拿到一个错误答案,那时的语气有多从容会留在身体里。这是这一期最便宜的预防针,和第六期的格式越完美越该怀疑是同一个位置。
重要的判断上,换一种称呼方式。不要问你怎么看,而要问从这份材料能得出什么结论。把对方当人来称呼的句子,会把用在人身上的判断习惯一起叫来。换掉句式,自己阅读的姿态也会跟着变一点。
还有一个要问自己的问题:我现在相信这个回答,是因为它有依据,还是因为它写得好。