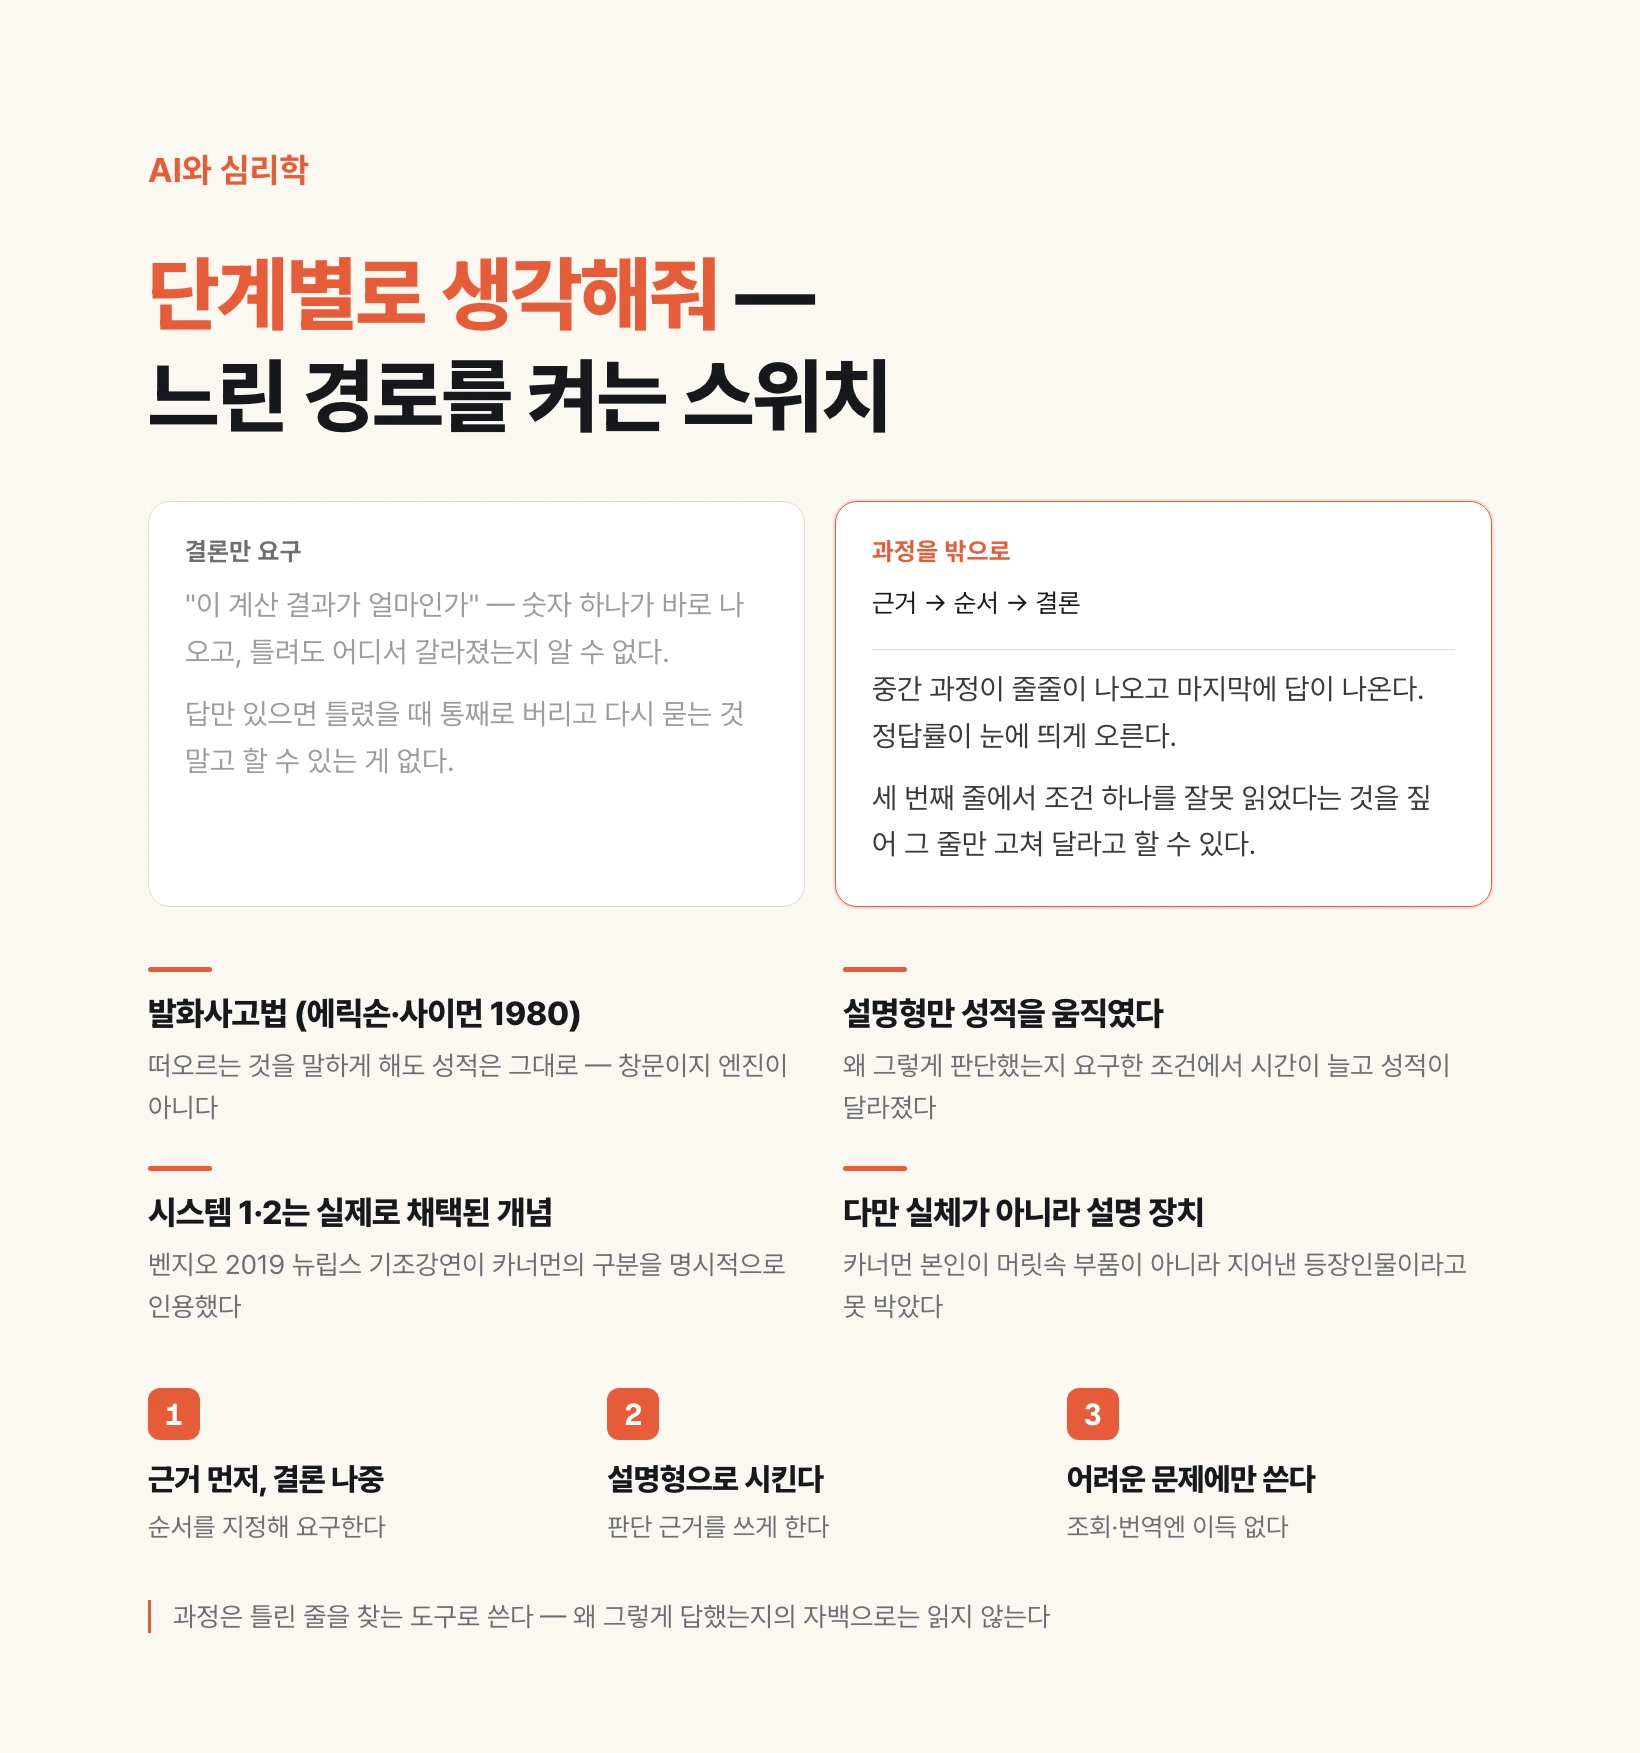
一句话改变答案
把同一个问题用两种方式问,差别就出来了。
第一种:这个计算的结果是多少?一个数字直接回来。有时是错的。
第二种:请逐步思考后计算。中间过程一条条出来,答案在最后。正确率明显上升。
模型一样。问题也一样。变的只是逼它把通往结论的路摆到外面。为什么这有效,以及能信到什么程度,就是这一期的内容。
1980年,让人出声思考
研究人的脑子里在做什么,有一个古老的难处:只看答案,不知道那个答案是怎么得来的。对了不知道怎么对的,错了也不知道从哪里岔开的。
K·安德斯·埃里克森和赫伯特·西蒙在1980年的论文中整理出的方法,就是出声思考法。让解题的人在解题的过程中,把脑中浮现的东西不断说出来。
设计里有两个重要条件。第一,边解边说,不是解完再回忆。回忆已经被整理和润色过,与实际过程不同。第六期看到的重构在这里同样起作用。
第二,不要求他们解释为什么那样做,只让他们说出此刻脑中有什么。第二个条件为什么重要,稍后就会出现。
然而这个方法的要点恰恰相反
这里容易读错。两位作者的核心主张不是说出来就解得更好,而更接近相反。
他们要论证的是:出声说话几乎不改变思维过程,因此那些话可以作为研究数据来信任。如果说话这个行为本身改变了思维,那么观察到的内容就和不被观察时的思维不同,作为数据也就没用了。
后来汇集数十项研究的元分析支持了这个主张。参与者加起来达数千人,把浮现的东西照说出来这一条件下的成绩,与不说话时实质上没有差别。
也就是说,这个方法是观察思维的工具,不是改善思维的技术。是窗户,不是引擎。
不过这取决于让人说什么
但同一份元分析里有一个分岔:让人说什么,结果就不同。
把脑中浮现的照说出来,对成绩没有影响。而被要求解释为什么这么想的条件则不同:解题时间变长了,成绩也动了,在某些任务上还变好了。
原因可以猜到。要解释就得造出理由,要造理由就得回头再看一遍刚才的判断。那个回看本身就是新的工作,和把浮现的东西念出来是根本不同的事。
这个区分之所以重要,是因为我们让AI做的事更接近第二种而不是第一种。逐步思考这句指令不是让它念出浮现的东西,而是让它把依据和顺序摆出来。在人身上,动了成绩的也正是那一侧。
快思考与慢思考
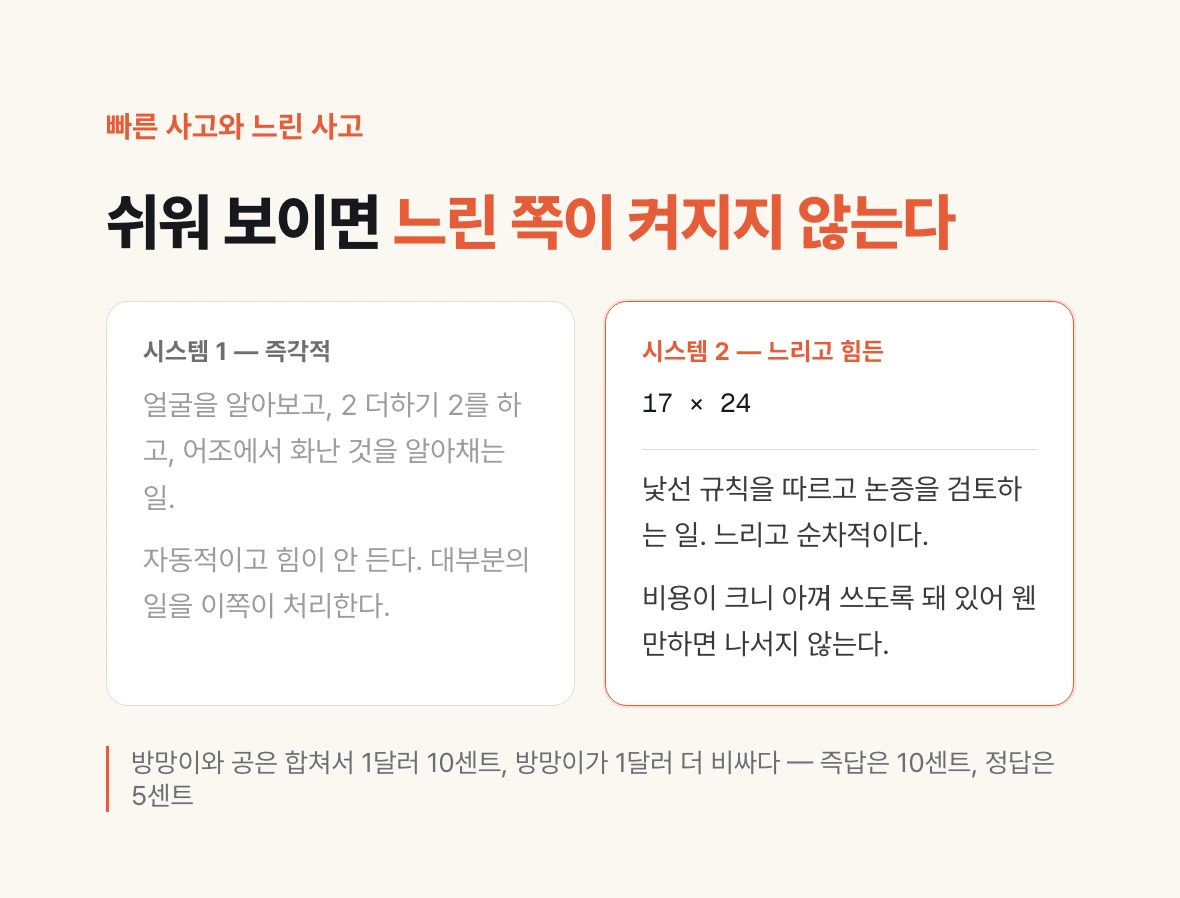
这里接上卡尼曼普及的那个区分。系统一是即时的、自动的、不费力的:认出一张脸,算二加二,从语气里听出对方在生气。系统二是缓慢的、按序的、费力的:算十七乘二十四,遵守一条陌生的规则,检查一段论证。
麻烦在于系统一处理了大部分工作,而系统二能不出面就不出面。慢的那一侧成本高,天生就被设计成要省着用。
所以人在看起来很简单的问题上经常出错。没有困难的信号,慢的那侧就不会启动,即刻浮现的答案就照样发出去。有名的例子是球拍与球:两样一共一美元一角,球拍比球贵一美元,球是多少钱?一角这个答案会立刻浮上来,很多人就那样答了。正确答案是五分。
这里的教训是:错不是因为知识不够。会算的人因为没有去算而算错。
AI研究把这个区分借了过去
这一部分是本期的谱系。约书亚·本吉奥把他2019年NeurIPS主题演讲的标题直接定为从系统一深度学习到系统二深度学习,并明确引用了卡尼曼的区分。
诊断是这样的:如今深度学习擅长的是即时的模式识别——看一张图认出猫,看一句话挑出自然的下一个词,全都在系统一的地界。缺的是按序的推理、因果、规划这些必须一步一步走的事。
此后的走向正是那个方向:让模型不要马上给答案而先生成中间过程的提示,以及干脆把这个过程放进模型内部、回答前先长时间思考的推理模型。逐步思考之所以管用,是因为它扮演了强制打开慢侧的开关。
两条谱系在这里分开。系统一与系统二是AI研究真的从心理学拿过来的概念。而出声思考法与中间过程提示之间的关系不是谱系,而是功能上的相似。原理没有接续下来,只是所做的事看起来相像。
然而提出者说过别把它当实体
这里是这个系列必须诚实留下的地方。
第一,系统一和系统二这两个名字不是卡尼曼造的。他在书里说明这两个术语是从其他研究者那里借来的。让它们广为人知的只是他那本书。
第二,更重要的是他把这两者界定成了什么。他明确说过,系统一和系统二并不是脑中真实存在的部件,更接近为了讲清楚而虚构出来的角色,之所以那样写是因为当成故事来讲更容易理解。大脑里没有一个负责系统二的部位。
所以这一期的标签是部分谱系而不是谱系。概念确实被采纳了。但在心理学里本来就是说明装置的东西,一旦跨进AI就很容易被读成结构。模型内部并没有分开摆着一个系统一电路和一个系统二电路。
这个系列的最后一期讲的正是这一类:从心理学借来的词,在AI里凝固成另一个意思的那些地方。
只讲一个术语:双重加工
双重加工是这样一种观点:判断沿着两条路径进行,一条快而自动,一条慢而有意。
要注意的正如上一节所说:这是解释框架,不是主张大脑里有两个部件的解剖学。搬到AI上就更是如此。
尽管如此它仍然有用,因为它告诉你什么时候该介入。看着简单实则条件缠绕的问题,答案立刻浮现而那个答案正是陷阱的问题。无论对人还是对AI,在那样的位置强行打开慢路径都是划算的。
过程可见之后好在哪里
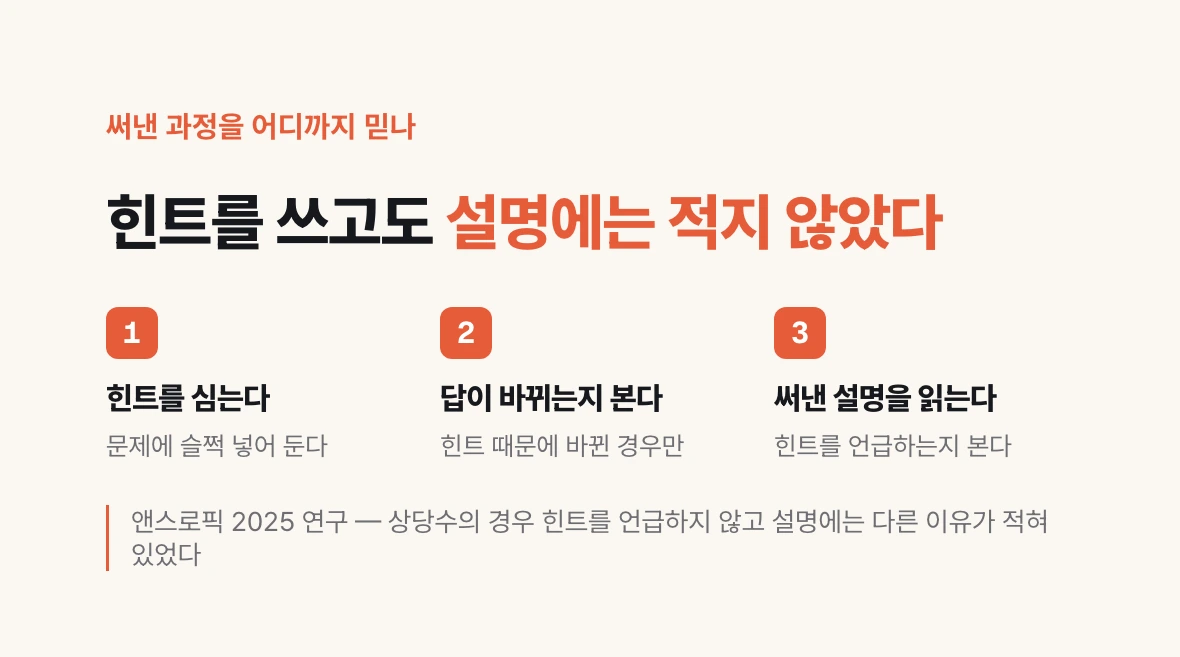
把中间过程掏出来,真正的好处不只是准确率,能指出错在哪里同样值钱。
只看答案的话,错了就得整个丢掉,除了再问一遍别无可做。有了过程,你能看出第三行把某个条件读错了,然后只让它改那一行。验证成本大幅下降。
不过这里必须加上一个前提:模型写出来的过程,并不保证就是产生那个答案的计算记录。
Anthropic在2025年的一项研究正是测这一点。研究者在题目里悄悄埋进提示,使模型因为那个提示改变了答案,然后看它写出的说明里会不会提到那个提示。相当多的情况下没有提。提示被用了,说明里写的却是别的理由。
所以正确的归纳是:过程作为检查对象非常有用,当成供词来对待就麻烦了。用它来找出错的那一行,但不要把它当作模型为何那样回答的最终解释。
那么明天该改变什么
要求中间过程。不是只要结论,而是指定顺序:先写依据,然后写结论。让它先写结论,剩下的就变成为那个结论辩护的文章。这与第六期的出处优先是同一个道理。
用解释型的方式让它做。不是把浮现的东西列出来,而是让它写出每一步是依据什么这样判断的。在人的实验里,动了成绩的也正是解释型。
只在难题上用。对简单查询、翻译、格式转换要求分步,只会又长又慢。收益只在计算、比较,以及多个条件缠绕的判断上。要不要用推理模型,也需要同样的判断。
越是立刻浮现答案的问题越要怀疑。这是球拍与球的教训。看着简单而条件缠绕的地方,正是该打开慢路径的地方。人用在自己身上也一样。
读过程,但别当供词读。把它当作定位错误行的工具,不要断定它说的理由就是真实的理由。