从这里开始是另一个故事
前三篇讲的是造模型。从现在起讲的是造好的模型为我们的问题生成答案,也就是推理。
把这两件事分开很重要。训练是改变模型内部数值的工作,推理则是直接使用从未被改动的模型。实际工作的讨论中,最常出岔子的就是这一点。
从在聊天框输入文字并按下发送的那一刻,到答案一个字一个字冒出来为止,我们按顺序看看里面发生了什么。
首先变成数字
输入的文字会像第一篇讲的那样被切成 token。而每个 token 都带有唯一编号。如果词表有 20 万个,就相当于从 0 号到 20 万号都编了号。
所以文字先变成一串编号。但只有编号还不够。因为无法保证 17 号和 18 号意思相近。编号只是一个名牌而已。
于是把每个编号换成承载语义的一组数字。这个转换叫作嵌入。经过嵌入之后,意思相近的 token 在数值上也被放在相近的位置。
如果觉得嵌入这个词并不陌生,那多半是因为在 RAG 里已经听过。把文档转成向量放进向量数据库时说的那个嵌入,是同一个概念。最后一篇会再次遇到它。
推理器是由很多层叠成的
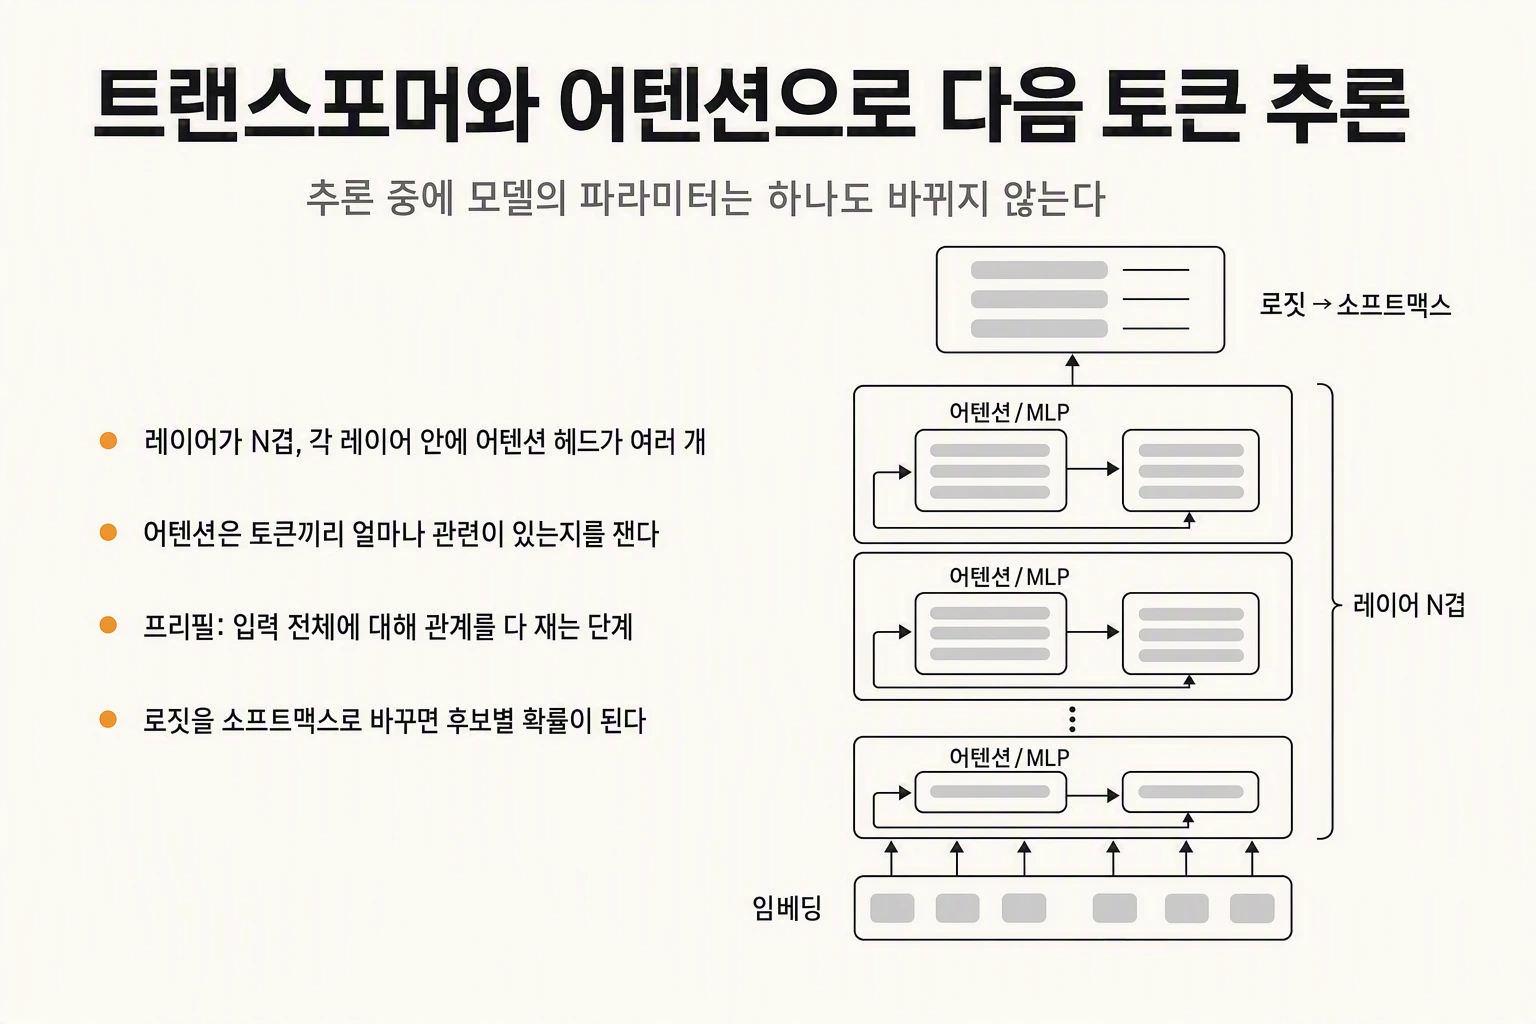
嵌入做完之后,真正的推理就开始了。推理器是由称为层的结构叠起来的。
穿过第 1 层的结果进入第 2 层,那个结果再进入第 3 层,就这样经过 N 层。而每一层内部发生的事情实际上是一样的。
为什么要把同样的事情重复很多次。因为一次不足以充分把握关系。层数越往后,候选越精细。因此层数越多,一次推理所需的计算量就越大。
这个结构的名字叫 Transformer。LLM 就是以 Transformer 这种方式推理下一个 token 的东西。
注意力 — 衡量关系的工作
层内部进行的核心工作就是注意力。它做的事情可以用一句话概括,就是衡量 token 之间彼此有多相关。
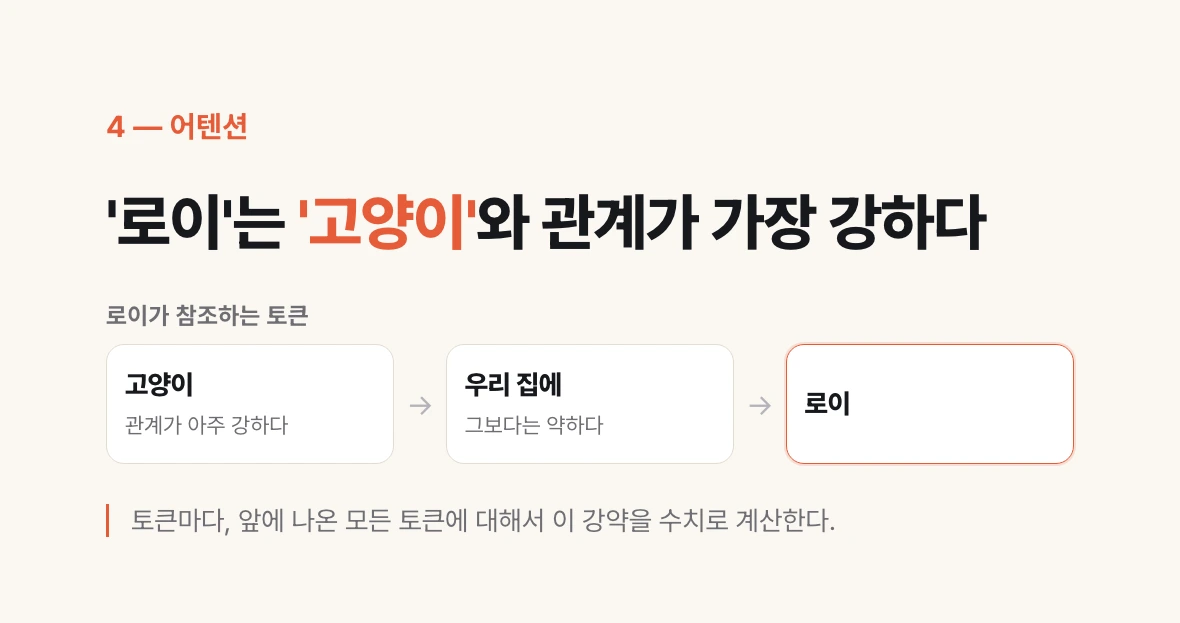
举个例子。「저희 집 고양이 이름은 로이예요. 품종은 벵갈이에요. 로이는 우리 집에 사는 고양이입니다.」(我家猫的名字叫 Roi。品种是孟加拉猫。Roi 是住在我家的猫。)
这里最后一句的「로이」(Roi)与前一句的「고양이」(猫)关系非常强。与「우리 집에」(在我家)也有一定关系,但比前者弱。注意力会把这种强弱全部计算成数值。对每个 token,针对之前出现过的所有 token。
而计算出来的值若原样放着,特征会比较模糊。于是再经过一次后处理,让突出的更突出。这个后处理部分叫作 MLP。
这个注意力计算本身在层内部也会分成好几路同时进行。其中的一路叫作注意力头。也就是说层有 N 层,而每一层里头又有好几个。是重复之中的重复,所以实际计算次数变得极其庞大。
为什么这种方式改变了格局
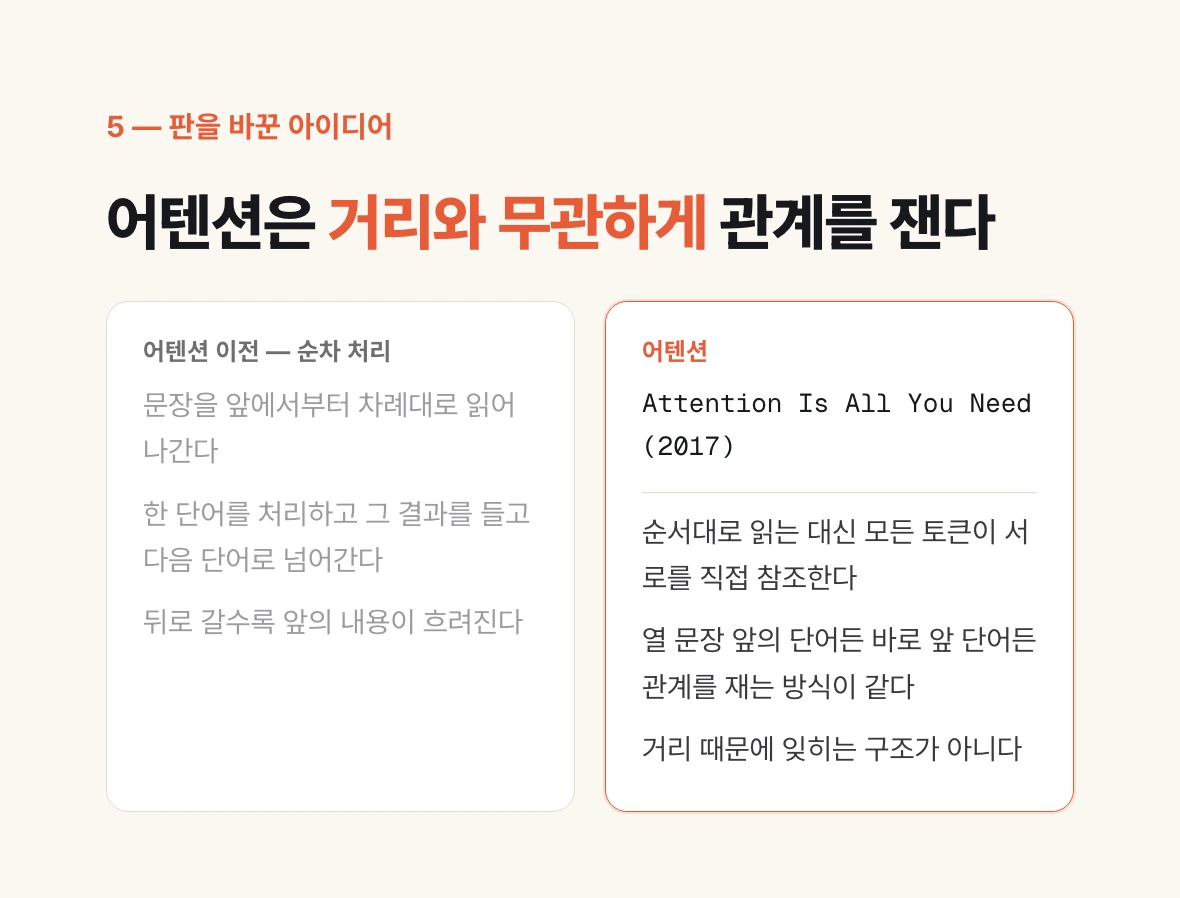
在注意力出现之前,自然语言处理的主流方式是从句子开头按顺序读下去。处理完一个词,带着那个结果再走到下一个词。
这种方式有结构性的弱点。越往后,前面的内容越模糊。短句子里没有问题,但在小说这样的长文中,前面出现的名字在后面用「그것」(那个)来指代时,就抓不住它指的是什么。
注意力不再按顺序读,而是让所有 token 直接互相参照。无论是十句话之前的词还是紧挨着的前一个词,衡量关系的方式都相同。它不是会因为距离而遗忘的结构。
提出这个想法的,是 2017 年谷歌研究团队的论文《Attention Is All You Need》。现在使用的几乎所有 LLM 都是从这里分支出来的。发表当时,连研究团队自己也没有预料到会有这么大的影响。
按下发送之后会停顿一会儿的原因
在聊天框粘贴一段长文并发送后,会停顿一下才开始出现答案。之后文字就会飞快地接连出现。
最初停顿期间做的事,就是刚才看到的注意力计算。这是对整个输入把关系全部衡量一遍的阶段,这一段叫作预填充。
这里有一点容易被忽略。计算对象并不只是我们输入的文字。看不见的系统提示词、之前的对话记录、各种设定值都会一起进入计算。屏幕上看到的并不是全部。
所以输入一长,这个等待时间就会明显变长。对话越长,首次响应越慢也是同样的原因。因为每次都要把之前的记录重新纳入计算。
候选被打上分数
穿过所有层之后,下一个 token 的候选就会带着分数出现。因为是已经完成训练的模型,所以在「점심 메뉴는」(午餐菜单是)之后不会出现汽车排第一的情况。食物名称会排在上面。
此时出现的值不是概率,只是分数而已。是 4.3、1.7、0.4 这样的数字,也会出现负数。这种未加工的分数叫作 logit。
就这样直接用不方便,于是把它们变成加起来等于 1。这样就能读成每个候选占百分之多少。这个转换叫作 softmax。
这样一来,「下一个 token 的候选及各自的概率」就做好了。到这里为止,是为了挑出一个 token 所做的准备。
推理过程中模型不会改变
这里有一点必须点明。在到目前为止看到的推理过程中,模型的参数一个都不会改变。
第二篇里看到的那些调节旋钮,保持着训练时调好的样子被固定住。推理就是让计算在那套固定设置上流过。动旋钮的只有训练,而那件事的运算成本完全是另一个量级,不可能在对话中发生。
所以才会出现「昨天告诉过它,今天又不知道了」的现象。在对话中告诉它的内容,只是存在于那次对话的输入里,从未被刻进模型。打开新对话,那份输入就消失了。
同一个问题昨天和今天答案不同,也不是因为训练。原因会在下一篇里看。
还一个字都没出来
到这里为止,候选列表和概率出来了。但答案还一个字都没有出现。因为还剩下究竟要从中挑哪一个。
看上去总是挑第一名就行,但实际上不会那样做。而那个挑选方式,就是我们在 API 里调的 temperature、top-k、top-p 这些值。
下一篇会看那个挑选的阶段。同一个问题每次答案都略有不同,原因就在那里。