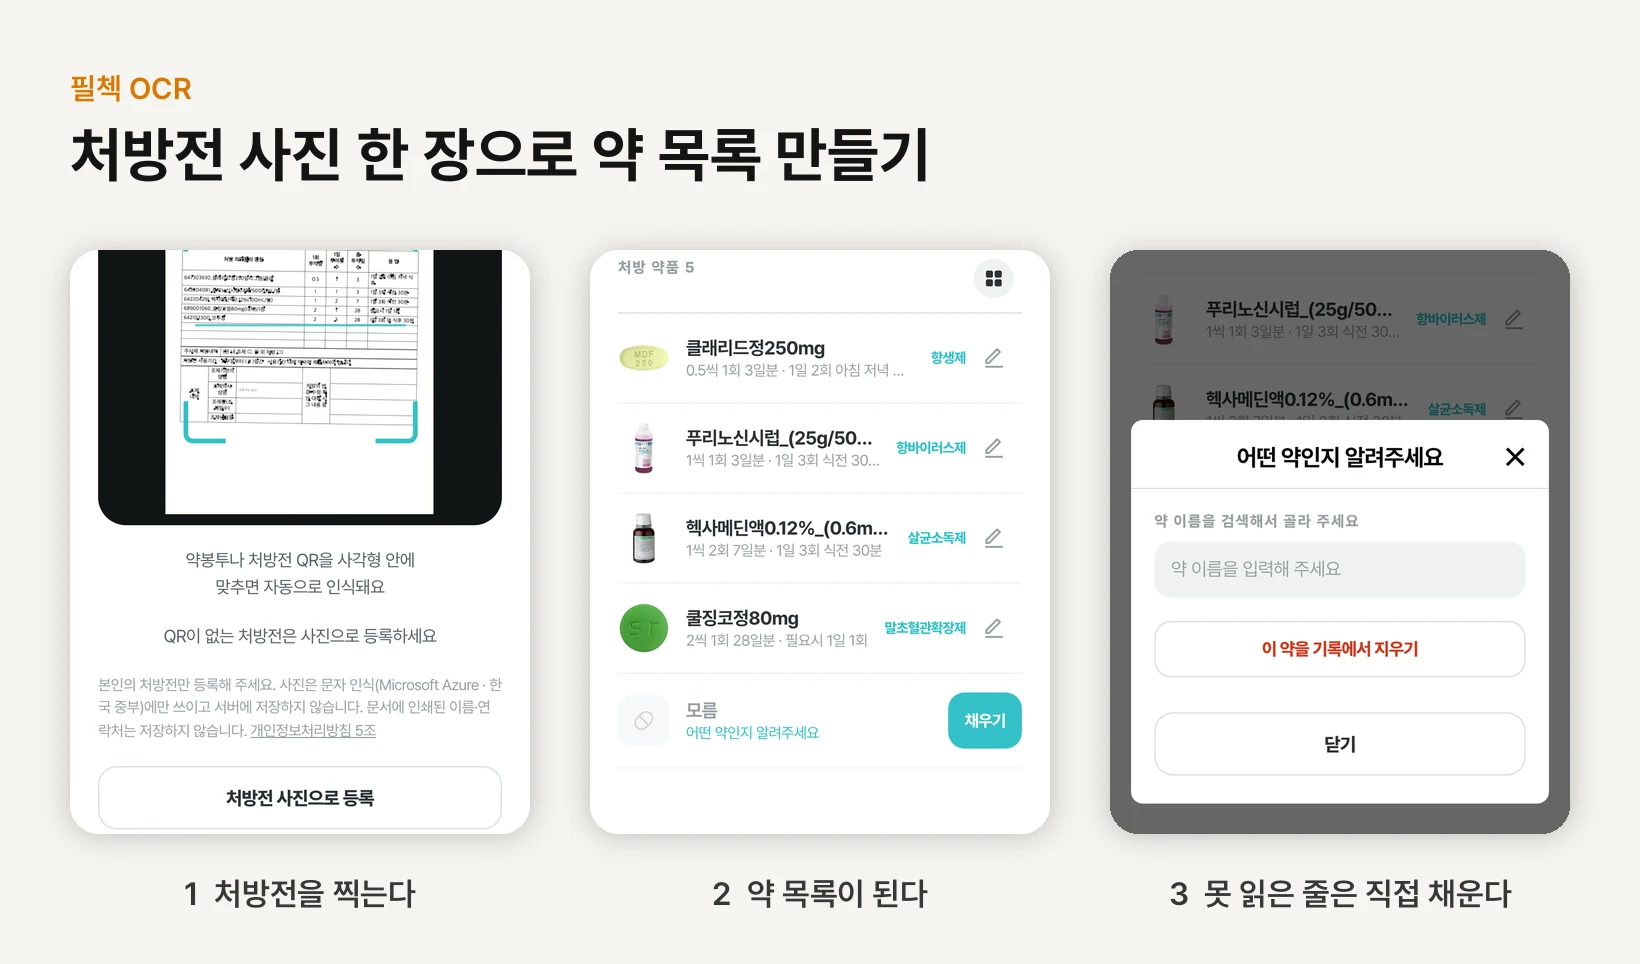
PillCheck OCR 是做什么的
PillCheck 是一个在同一处查看自己所服药物的功效、副作用、相互作用以及调剂记录的服务。记录药品最快的方法是扫描药袋或处方上的二维码,但很多处方没有印二维码,从其他药房拿到的药袋格式也各不相同。照片登记就是为了填补这一空白。
OCR(光学字符识别)是读取照片中的文字并转换成计算机可处理文本的技术。PillCheck OCR 用这项技术读取处方和药袋上的药品表格,生成用药清单。登记页面分为处方、药袋、药片三个标签页,照片登记在前两个标签页里。药片标签页是通过药片照片识别药品的另一项功能。
处方标签页下方的灰色文字就是这项功能的承诺。译成中文是:“请只登记本人的处方。照片仅用于文字识别(Microsoft Azure · 韩国中部),不会保存在服务器上。文件上印刷的姓名和联系方式不会保存。”下文说明代码如何兑现这个承诺。
在 pillcheck.co.kr 上的使用步骤
无需安装应用。用手机浏览器打开 www.pillcheck.co.kr,按四个步骤操作即可。
第一,登录。照片识别仅限已登录用户使用。第二,点击底部菜单的「扫描」(스캔),打开登记页面。第三,根据手中的文件选择「处方」(처방전)或「药袋」(약봉투)标签页。第四,点击「用处方照片登记」(처방전 사진으로 등록)并拍照。在药袋标签页,同一位置的按钮是「用药袋照片登记」(약봉투 사진으로 등록)。
拍药袋时,诀窍是把药袋平放,让药名和服用方法的表格清晰可见。如果文件上有二维码,二维码比照片更快。只要在同一页面的方框内对准二维码,就会自动识别。
整个流程也整理成了一分多钟的使用视频(韩语)。https://youtu.be/q5hYerY6ZO0
拍照之后发生了什么
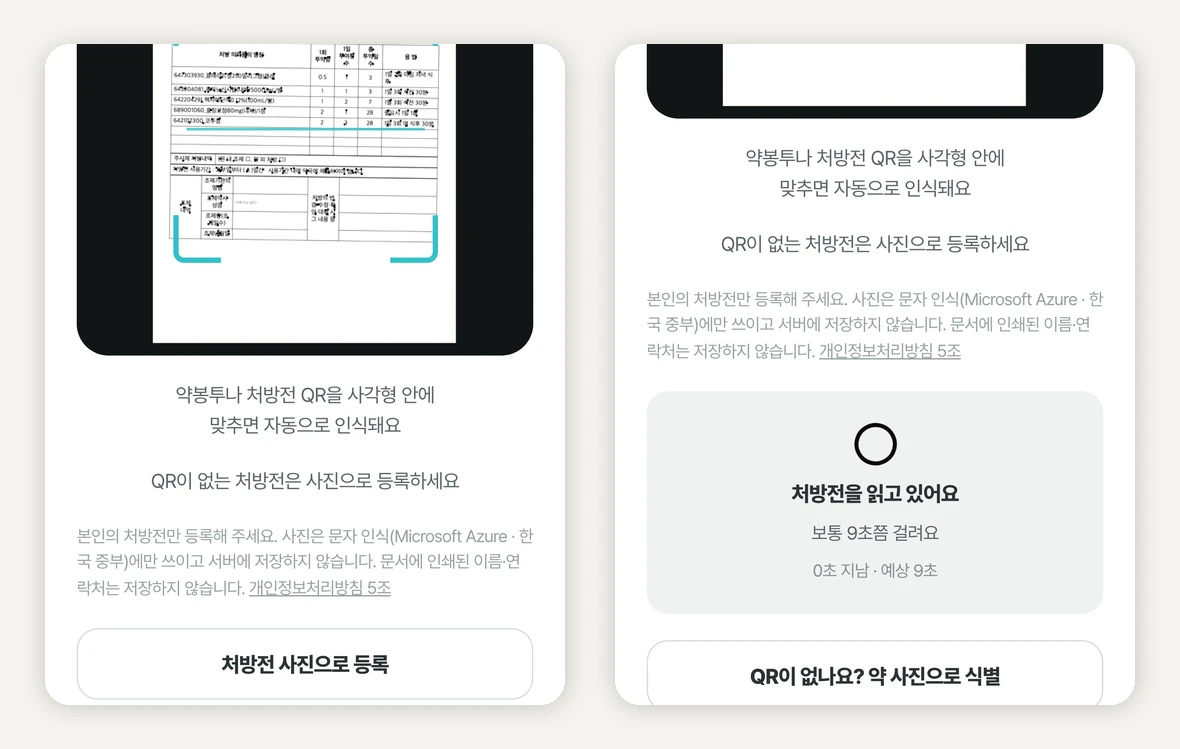
照片不会直接发送到服务器。手机会先检查照片。如果太小、太暗或太亮、或因抖动而模糊,会当场要求重拍。因为读不了的照片即使发出去,也只会得到错误或空白的结果。
通过检查的处方照片会缩小后发送到服务器,服务器再交给微软的文字识别 AI Azure Document Intelligence。它不仅读取文字,还读取表格的格子结构,从而分辨出哪个数字是第几种药的用量。如果识别的可信度低,服务器一个值也不返回,只要求重拍。这样设计是为了不让错误的值看起来像是读出来的值。
药名不是从照片上照抄的。韩国的处方上每种药旁边都印有 EDI 代码,即国民健康保险为每种药分配的 9 位编号。PillCheck 读取这个编号,在药品数据库中查找正式名称,并从同一处带出药片照片、药效分类和用药指导。与逐字抄写印得模糊的药名相比,用编号查找能减少药名出错的余地。
药袋多一个步骤。药袋上没有印这个编号,所以由语言模型对文字识别读出的内容再整理一遍,提取药名和服用数字。语言模型是像 ChatGPT 那样理解和整理文字的 AI。给这个模型的指令的核心句,译成中文是:“读不出来就是 null。不要替换成相似的药名,也不要补全。编造文字比遗漏更糟。”这里的 null 意思是“没有值”。
等待期间,页面会告诉你正在做什么、需要多长时间。处方页面写着「通常需要约 9 秒」,并计算已过去的时间。如果比预计长很多,就收起数字,把文字改为「还需要一点时间」。这是为了不持续显示一个无法兑现的数字。
读不出的行保留为「未知」
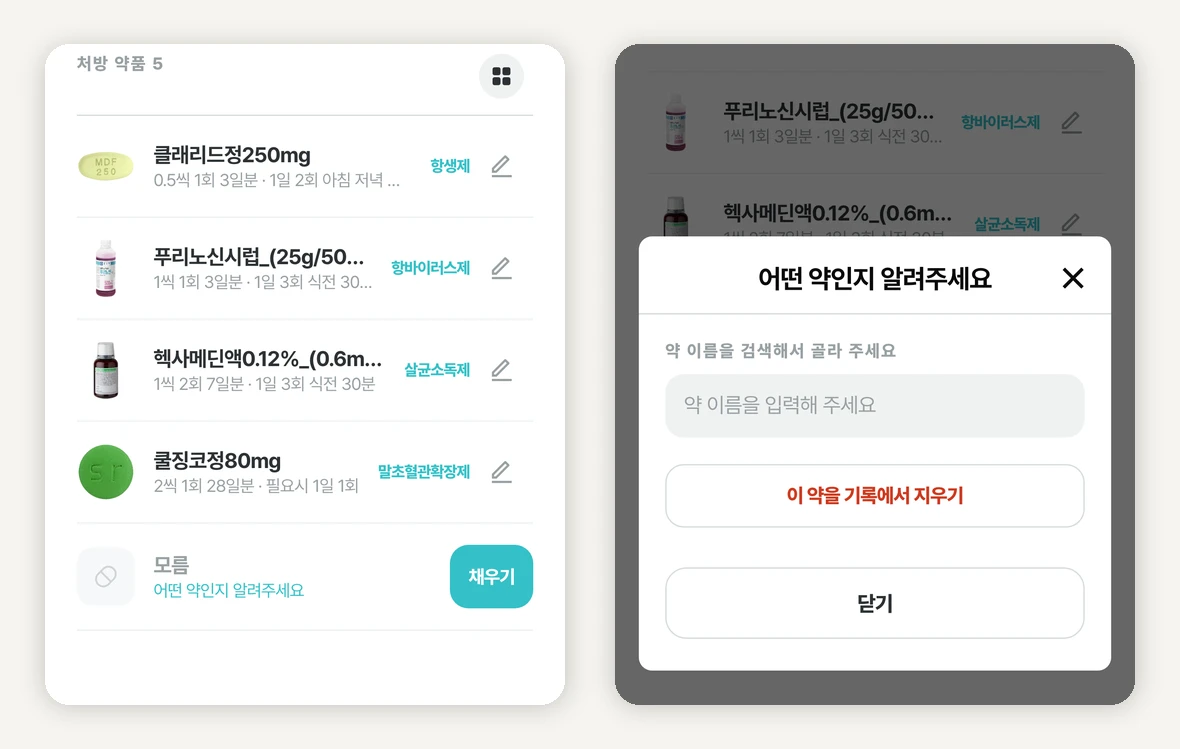
结果页面会把读出的药品列成清单。药名旁边附有药片照片和药效分类,下一行写着每次用量、每日次数、天数和服用方法。
但 OCR 并不能读出每一行。纸张起皱、墨迹晕开、角度倾斜总是存在。这时有两条省事的路:悄悄删掉读不出的行,或者用最相似的药填上。PillCheck 两样都不做。用药记录中少了一行,相互作用检查就会漏掉那种药;如果填进了名字相似的另一种药,就会针对错误的药给出指导。
所以读不出的行会保留为名为「未知」(모름)的位置。记录中会如实保留第几行是空的,用户点击「填写」(채우기)后,可以搜索药名选择,也可以把这一行从记录中删除。更换药品的方法只有搜索选择这一种。如果允许随意输入药名,就会产生与药品数据库对不上的记录。每次用量、每日次数和天数可以直接修改。
这与药袋指令中的“编造文字比遗漏更糟”是同一个原则。在用药记录里,把不知道的标为不知道,比装作知道更安全。
如何避开个人信息
一张处方上同时印有患者姓名、居民登记号码、医疗机构及其联系方式。PillCheck 需要的只是其中的药品表格。但无法只挑出照片中需要的部分发送,所以照片会经过服务器和文字识别服务。这一点没有隐瞒,写在了页面告知里。取而代之,设计目标定为“不留存”。
不留存的措施有三层。第一,PillCheck 服务器不保存照片。识别结束后,只留下要转入用药清单的值。第二,服务器返回给手机的识别结果里,从一开始就没有存放患者姓名、居民登记号码、电话号码的字段。没有字段,也就没有被误装进去的位置。在此之上,结果发出之前还会再检查一遍是否混有居民登记号码或电话号码形状的字符。第三,服务器日志只记录读了几行之类的数量,不记录读到的内容。
告知文字本身也和代码绑在一起。自动测试守着其中的关键句子,一旦被删改,测试会先发出提醒。这是为了防止页面上承诺的内容与实际行为在无人察觉中出现偏差。
第一句「请只登记本人的处方」也是有意为之。刻意没有放置鼓励拍摄家人处方的文字,是为了不产生记录主人不知情的记录。药袋标签页多一个处理步骤,所以另设了告知文字,拍照前可以在同一位置确认。
测试数据:虚构的处方与遮挡的处方
开发 OCR 需要大量处方,因为要读取、打分、修改、再读取。如果直接使用真实处方,开发过程本身就成了在流转个人信息。因此,材料限定为两种。
第一种是合成处方。合成数据是指仿照真实情况新编造的数据。在四种处方格式中填入全部虚构的患者、医生、医疗机构、联系方式和号码,只有药品栏使用了真实的药品清单。居民登记号码故意把最后一位校验数字做错,即使偶然也不可能与真实号码重合。除了干净的原件,还制作了稍微缩小、倾斜、模糊,看起来像手机拍摄的版本。本文画面和使用视频中出现的处方就是这种合成版本。
第二种是遮挡过的真实文件。真实文件只使用除药品表格外全部涂黑的版本。要点在于把遮挡的标准定为“保留哪里”,而不是“删除哪里”。以表格的表头为基准只保留表格区域,找不到表头就根本不生成文件,因此即使失败,也不会漏出遮挡不完整的文件。通过自动检查之后,仍由人逐张复查。
开发过程中如何使用 AI
PillCheck OCR 是与 AI 编程智能体一起开发的。AI 编程智能体是接受人的指令,亲自阅读、修改和运行代码的 AI。这里使用的是 Claude Code,与 OCR 相关的代码变更记录中,大部分都将这个智能体列为共同作者。
不过,有一件事没有交给 AI:什么算合格的标准。AI 给出的结果用三种方式加以约束。
其一,先写下合格线。打分之前,把“至少要达到这个程度”的标准值写入文件保存,如果写下标准的时间晚于打分,那个分数就作废。这样,无论人还是 AI,都无法在看到结果之后偷偷挪动合格线。
其二,故意破坏。为了确认测试是否真的起到保护作用,会做一个故意切断代码关键连接的版本,看测试能否报出失败。这叫变异测试。例如,有一个测试规定:如果「未知」行通过搜索填写后,却不再记录那种药的识别编号,就必须失败。
其三,让另一个 AI 站在对立面。规划文档由分别担任规划、架构、批评角色的多个 AI 反复打磨直到达成一致;实现部分另外交给其他公司的 AI 模型,要求它们专门找毛病。同一个模型写、同一个模型审,就会看漏同样的地方。
不让 AI 智能体看到个人信息,也是同样的原则。遮挡真实文件时使用的文字识别不是外部服务,而是在工作电脑本机上运行,交给智能体的只有遮挡后的结果。遮挡前的文字从未进入智能体的对话窗口。
使用视频也按同样的原则制作
一分多钟的使用视频同样是用 AI 制作的。画面由自动操作的浏览器在正在运营的 www.pillcheck.co.kr 上录制,旁白用 AI 语音合成,场景用代码拼接。
相机中映出的处方就是前面提到的合成版本。为了得到识别结果,也没有用真实账号登录去运行识别。只有识别请求这一项,改为返回根据合成处方的答案表生成的响应;药片照片、药效分类、搜索结果等其余画面,都原样接收正在运营的服务的真实数据。答案表是合成时一并记下的该处方的内容。因此,制作视频既没有产生识别费用,也没有在任何人的账号里留下记录。
视频可以在这里观看(韩语)。https://youtu.be/q5hYerY6ZO0
开发涉及个人信息的 AI 功能时可以借鉴的做法
PillCheck OCR 用到的方法中,有三点可以移用到其他工作上。
第一,把“发送什么”和“留存什么”分开承诺。如果功能必须发送照片才能运行,就写明会发送,同时具体写明不留存什么。“我们会安全处理”这样的句子不是承诺。
第二,测试数据先用虚构的。在把真实客户文件粘贴给 AI 之前,先用同一格式填入假值的文件跑一遍。能用合成版本确认的,就在合成版本上完成。
第三,为“不知道”留出标记的位置。让 AI 把空白填得像模像样看起来方便,但在药品、金钱、合同这类出错代价高的事情上,告诉你这里是空的更好。如果今天要让 AI 整理文件,不妨在指令里加一句:“读不出来就留空,不要用相似的值填补。”