第一篇提出的问题
这个连载是从一个问题开始的。遇到某个问题时,用什么来判断它能不能用提示词解决、是否需要 RAG、还是要一路做到微调。
这个问题之所以难,是因为三者处在不同的层次。提示词是改变输入,RAG 是把要放进输入的材料找回来,微调是改变模型本身。
前面五篇已经把那个结构都看过了。现在可以按各自作用的位置来立标准。
默认选项是提示词
先说结论,实务中遇到的问题大部分用提示词和指令就能解决。这是默认选项,其余两个是在附加了特定条件时才追加的。
理由在第五篇看过了。提示词是改变候选列表形状的做法。在「我们今天的午餐是」前面加上「家门口新开了一家日料店」,候选的上层就整个换掉了。不碰模型内部,输出也会有很大变化。
而且提示词可以立刻修改。不需要部署也不需要重新训练,错了就改一句话再跑一次。这个周转速度和另外两个没法比。
补充一句,最近说的 agent 或 skill 设计,原理上也属于这一层。单纯敲一句话和设计流程与工具,难度不同,但在不改变模型内部、用输入来规定行为这一点上属于同一个层次。
需要叠加 RAG 的条件
RAG 是 Retrieval Augmented Generation 的缩写。把需要的资料找回来放进提示词,在这个状态下让模型生成答案。
它的运作和第四篇的嵌入相连。把文档切开,把每个片段换成承载语义的一组数字存起来。问题进来时,问题也用同样的方式转换,从存好的东西里找出语义相近的片段。再把那个片段塞进提示词。
这里重要的是,RAG 归根到底是往提示词里放材料。模型不会改变。它更接近于把第五篇看到的「上下文会缩小候选」自动化。
需要叠加的条件有两个。第一,作为答案依据的资料超过上下文上限。不可能每次都把公司全部规章放进去。第二,资料经常变动。文档每更新一次就重新训练模型,成本上不成立。
再补一句,就算全部放得下,全放也未必总是更好。如第四篇所见,注意力要衡量所有 token 对之间的关系,所以输入越长计算量越大,焦点也越散。很多时候只挑必要的放进去更好。
走到微调这一步的条件
微调如第三篇所见,是调整模型参数的做法。三者当中只有它改变模型本身。
所以它最重,条件也相应地窄。归纳起来是三点重叠的时候。形式固定的同一行为的重复、专门化的单一任务,以及规模。
核心是第三点。而这个理由,只有读过这个连载的人才能准确看到。
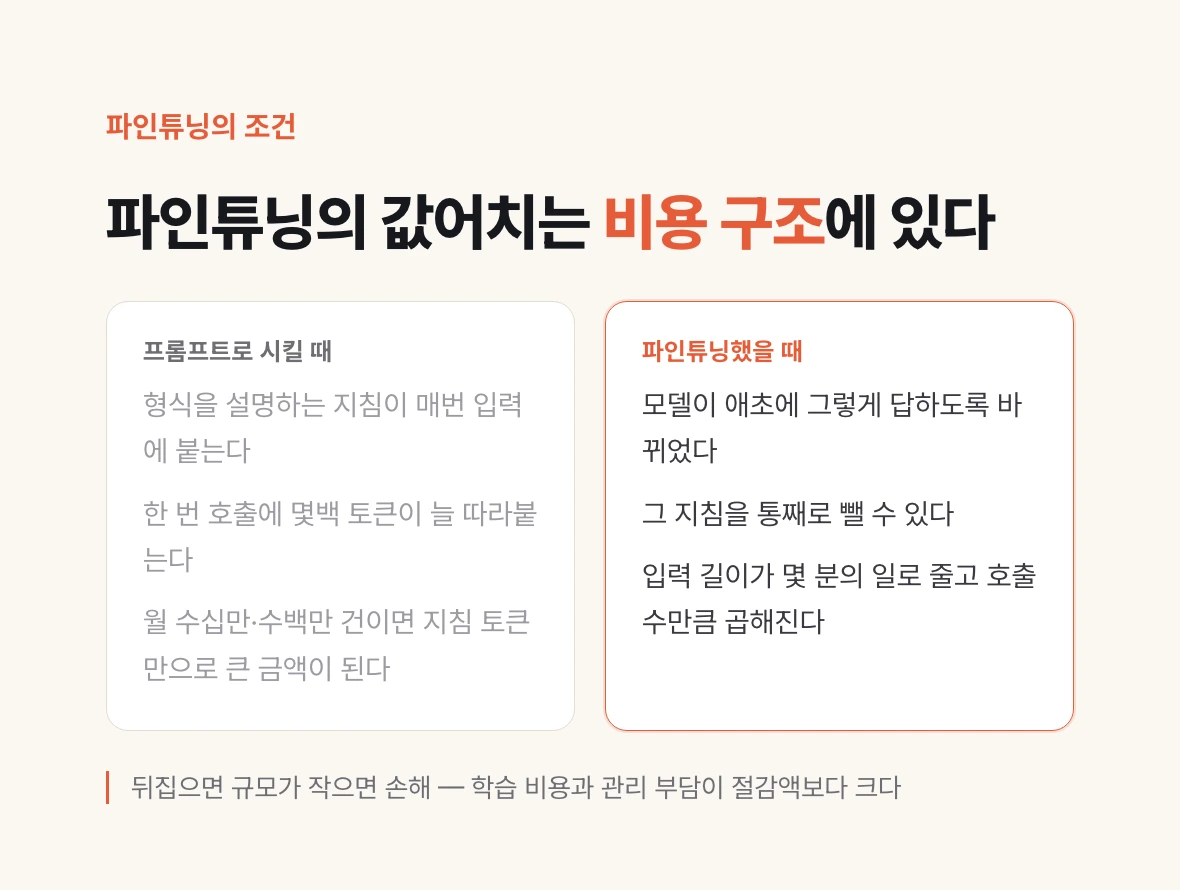
举例来说,假设有一件事是只让模型吐出固定形式的结果。要用提示词做,说明格式的指令每次都会附在输入上。相当于每次调用都固定多出几百个 token。如果调用一天只有几件,完全没有问题。可是如果每月几十万、几百万件,光是那些指令 token 就会变成一笔大金额。
做了微调就可以把那段指令整个拿掉。因为模型本身已经被改成那样回答了。输入长度缩到几分之一,而这个差额会乘以调用次数。也就是说,微调的实际价值往往不在性能而在成本结构。
反过来说,规模小的话微调就是亏的。训练成本和管理负担大于省下来的金额。
微调的位置变窄的原因
以前微调被选中的次数更多。因为基座模型的基础性能不如现在,处理提示词的方法论也整理得不够。
随着这两者上来,原本只能靠微调完成的事情有相当一部分转到了提示词。所以现在微调的位置比以前更特殊。
实务中这个误解经常出现。「用我们的数据训练一下吧」这类要求大多如此。如第二篇所见,训练是改变模型内部数值的事,和希望把公司文档反映到回答里的要求性质不同。那个要求几乎总是 RAG 的领域。
不过知道和使用是两回事。实验环境变便宜了,亲自试一次并不难,把它作为判断依据留着就行。
归纳起来是顺序
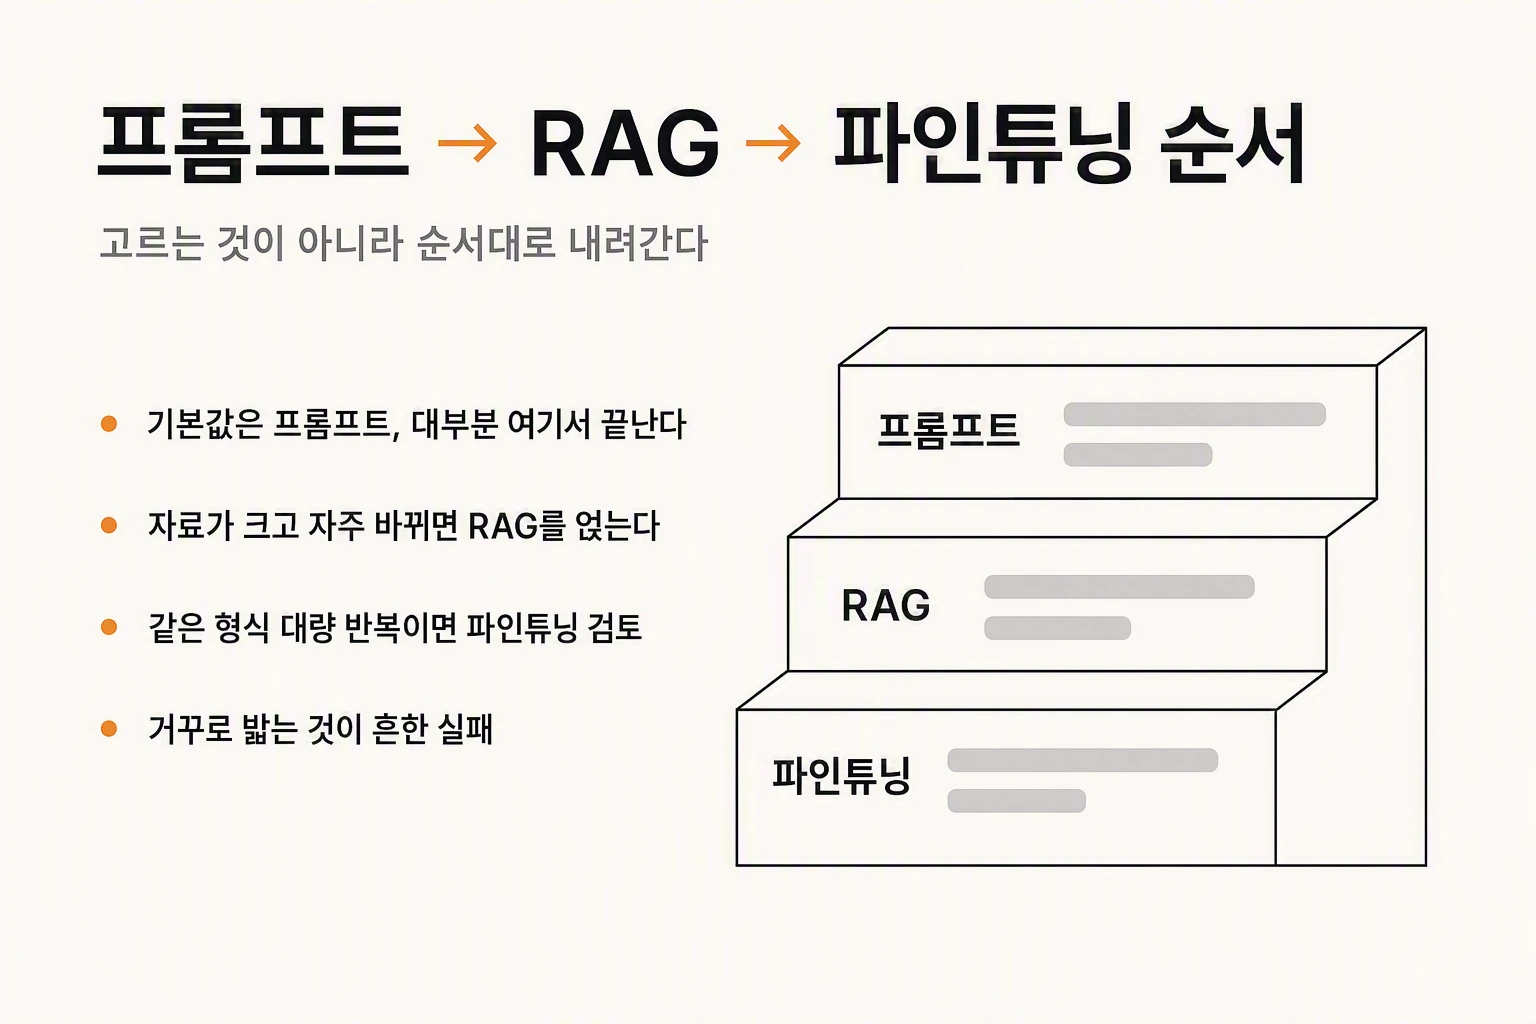
与其说是在三者之间做选择,不如说是按顺序往下走更准确。
先用提示词尝试。大部分到这里就结束了。作为答案依据的资料多而且经常变动,就叠加 RAG。实务中最常见的组合是提示词加 RAG。这样之后如果还因为同一形式的大量重复而出现成本问题,那时再考虑微调。
把这个顺序倒过来走是常见的失败。从微调开始考虑,花了时间和成本之后,才确认这件事本来用提示词就能做。
| 方式 | 改变什么 | 什么时候用 | 弱点 |
|---|---|---|---|
| 提示词·指令 | 输入 | 大部分情况。默认选项 | 每次都附在输入上,变成长度和成本 |
| RAG | 放进输入的材料 | 依据资料多或经常变动时 | 找回来的片段错了,答案也会错 |
| 微调 | 模型参数 | 同一形式大量重复导致成本成问题时 | 训练与管理成本。规模小就亏 |
模型该按什么来选
方式定下来之后就要选模型,而在这里把顺序搞错的情况很多。一上来就摊开性能对比表。
实务中先来的是约束。是只能在内网运行,还是可以上云。这决定了是用 API 还是自己把模型跑起来。而且客户或公司的治理与合规上往往已经有了限制。只能用特定供应商的地方也很常见。
在那些约束内,就剩下的选项做成本优化,这才是实际的顺序。而这里第一篇的内容又会被牵进来。成本不是只由单价决定的。tokenizer 把韩语切得多细,会让同一篇文字的 token 数不同。要把单价和 token 数放在一起看。
最后,模型不是固定不变的。有更好的出来就换上去,也会按任务种类分开使用多个模型。所以设计时最好做成模型可以替换的样子。
六篇结束时
从 token 出发,经过训练与推理,一路来到实务判断。归纳起来是这样。文字变成 token,通过猜下一个 token 来打磨参数,用后训练学会形式,推理时用注意力衡量关系,最后按概率抽出一个。
有了这张图,会有一些变化。听到关于 LLM 的说法时,能知道那是哪个阶段的事,说得通说不通也会被过滤掉。「训练一下」和「让它参考文档」是两回事,这一点马上就看得出来。
在 AX 里真正难的不是技术,而是把问题准确定义出来。不过要定义问题,就得知道什么是可能的、什么是昂贵的,而这六篇为那个判断铺了底。