上一篇讲到了候选
上一篇中,输入穿过所有层之后,生成了下一个 token 的候选和各自的概率。但此时回答还一个字都没有出现。
剩下的事情只有一件:在这些候选中实际选哪一个。这一步叫做采样。
这一步很短,但对实际工作的影响很大。API 中可以调整的值大多挂在这里,同一个问题每次回答不同的原因也在这里。
并不总是选第一名
看起来只要一直选概率最高的 token 就行了。但实际上并不这么做。
那样做的话,同样的输入永远会得到同样的回答。结果虽然可预测,文字却会变得单调,而且一旦走偏了方向,就会一直在同一个地方打转。
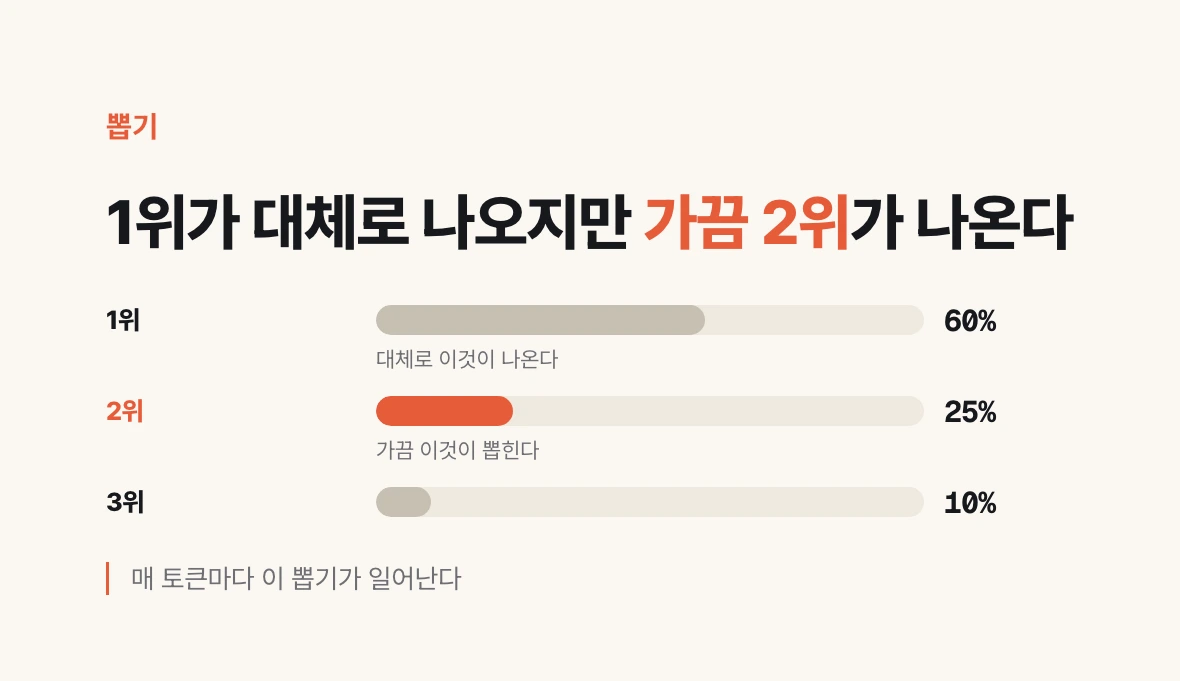
所以是按概率抽取一个。如果第一名是 60%、第二名是 25%、第三名是 10%,那么大多数时候出现的是第一名,但偶尔会出现第二名。每一个 token 都会发生一次这样的抽取。
这就是同一个问题每次回答都略有不同的原因。正如上一篇强调过的,这不是因为模型学到了什么。参数是固定的,变化的只是最后一次抽取的结果。
temperature — 候选要放开到哪里
决定这次抽取范围的值就是 temperature。名字就是温度,感觉也和名字一致。
把温度调高,下面的候选也有了被抽中的余地。结果变得多样,会朝着通常所说的有创造性的方向走。把温度调低,就只抽上面的部分。结果趋于稳定,反复执行也会得到相似的回答。
那么是不是一直调高就好?不是。放得太开,连脱离上下文的 token 也会进来。就像「我们午饭吃」后面接的不是食物,而是不着边际的话。反过来,调得太低,句子会变得生硬,并且重复同样的表达。
实际工作中的判断很简单。格式固定的输出、分类、抽取、代码生成用低值。文案初稿、罗列想法这类需要多个方案的场合用高值。拿不准时从低的一侧开始,按需要往上调。
top-k 与 top-p — 裁剪方式有两种
和 temperature 一起经常出现的是 top-k 和 top-p。两者都是裁剪候选列表的值,但裁剪的标准不同。
top-k 按数量裁剪。k 是 40 的话,就只留下概率最高的 40 个,其余丢弃。做法简单,但分不清情况。在答案明确、第一名压倒性领先的位置也留 40 个,在候选彼此相差不大的位置同样只留 40 个。
top-p 按累计概率裁剪。p 是 0.9 的话,就从上往下累加概率,加到 0.9 为止。第一名压倒性领先时只剩一两个,候选势均力敌时会剩下多个。相当于宽度会随情况自动调节。
所以现在用 top-p 的一方更多。没有必要三个同时调。通常只用 temperature 一个就够,输出总是跑偏时再一起收紧 top-p。
上下文会预先收窄候选
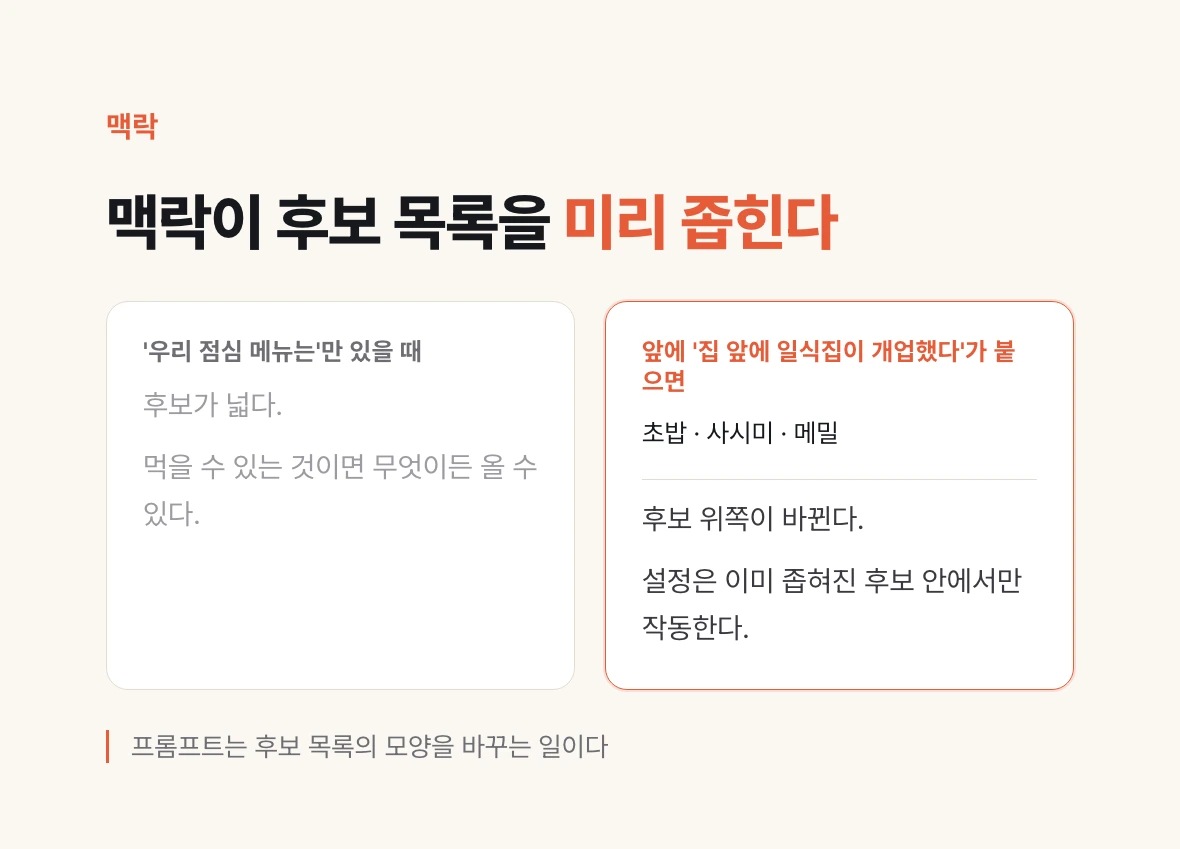
这里有一点常被忽略:候选列表本身早已随着前面的上下文而改变。
只有「我们午饭吃」时,候选很宽。能吃的东西什么都可能出现。但前面加上「家门口新开了一家日料店」之后,候选的上面部分就变成了寿司、刺身、荞麦面之类的东西。
在调 temperature 之前,先用上这个事实更好。如果有想要的方向,与其收紧设置值,不如把上下文给清楚,通常效果更大。因为设置只在已经被收窄的候选范围内起作用。
如果说「把提示词写好」这类建议听起来很含糊,用这幅图来看就很具体了。写提示词就是改变候选列表形状的工作。
第一次响应慢、之后很快的原因
抽出了一个 token。但一段回答通常由几百个 token 组成。要抽下一个 token,就得把刚抽出的 token 也包含进来重新计算。
这么看,每个 token 似乎都要把上一篇提到的那套沉重计算整个重复一遍。真那样做的话,出一个字都要等很久。
但在屏幕上,只有开头停顿一下,之后文字很快地接连出现。因为前面部分的计算结果被保存下来并重复使用了。这和开发中所说的缓存是同一个概念,在这里叫做 KV 缓存。
所以体感速度分成了两段。第一次计算整个输入的预填充阶段,输入越长越慢;之后一个字一个字往外出的阶段则相对稳定。觉得响应慢时,看清是哪一段的问题,应对方式就不同。前面慢就减少输入,后面慢就减少输出或者换更快的模型。
停止也是一个 token
那么模型什么时候停止?并不是在某个瞬间自行判断的。
词表里除了看得见的文字,还包含一些特殊的 token,其中就有表示「到此结束」的停止 token。当下一个 token 抽到它时,生成就停止。
也就是说,停止和其他 token 一样,同样是按概率被抽取的对象。而在哪里停止才合适,是在第三篇讲过的后训练过程中学到的。回答完问题就该停下来的这种感觉,是在那时形成的。
回答半途中断,或者长得超出需要,从这个角度看也容易理解。是撞上了最大输出长度限制,还是停止 token 被过早抽中,应对方式不同。
到这里就是推理
把输入变成 token,做嵌入,穿过各层得到候选,按概率选出一个接上去,直到抽到停止 token 为止。这就是 LLM 生成回答的全部过程。
五篇下来,训练和推理都看完了。剩下的是把这些知识转化为实际工作中的判断。
最后一篇会回答第一篇开头抛出的问题:什么样的问题用提示词解决,什么样的用 RAG 解决,什么样的要走到微调这一步,判断的依据是什么。