지난 편에서 재료가 준비됐다
앞 편에서 거대한 글뭉치를 토큰으로 바꿨다. 이제 그 토큰으로 실제 학습이 시작된다.
목표는 여전히 하나다. '우리 점심 메뉴는' 다음에 무엇이 올지 맞히는 기계를 만드는 것. 이번 편은 그 기계가 어떻게 맞히게 되는지를 본다.
결론부터 말하면 학습은 틀리고 고치기의 반복이다. 그 이상도 이하도 아니다. 다만 반복 횟수와 고치는 대상의 개수가 사람의 직관을 벗어날 뿐이다.
맞혀 보기 게임 — 답을 가리고 시킨다
학습 데이터는 정답을 이미 아는 데이터다. 여기서 요령이 하나 있다. 글 자체가 정답을 품고 있다는 것이다.
'우리 점심 메뉴는 김치찌개다'라는 문장이 코퍼스에 있다면, 마지막 토큰을 가리고 신경망에게 물으면 된다. 앞부분만 보여 주고 '다음에 뭐가 올 것 같아?'라고 묻는다. 정답은 이미 손에 있으니 채점이 즉시 된다.
사람이 일일이 정답을 달아 줄 필요가 없다는 점이 중요하다. 인터넷의 모든 글이 그 자체로 문제집이 된다. 자를 자리를 옮겨 가며 같은 문장에서 문제를 무수히 만들어 낼 수 있다. 학습거리가 사실상 무한한 이유가 여기 있다.
처음에는 전부 틀린다
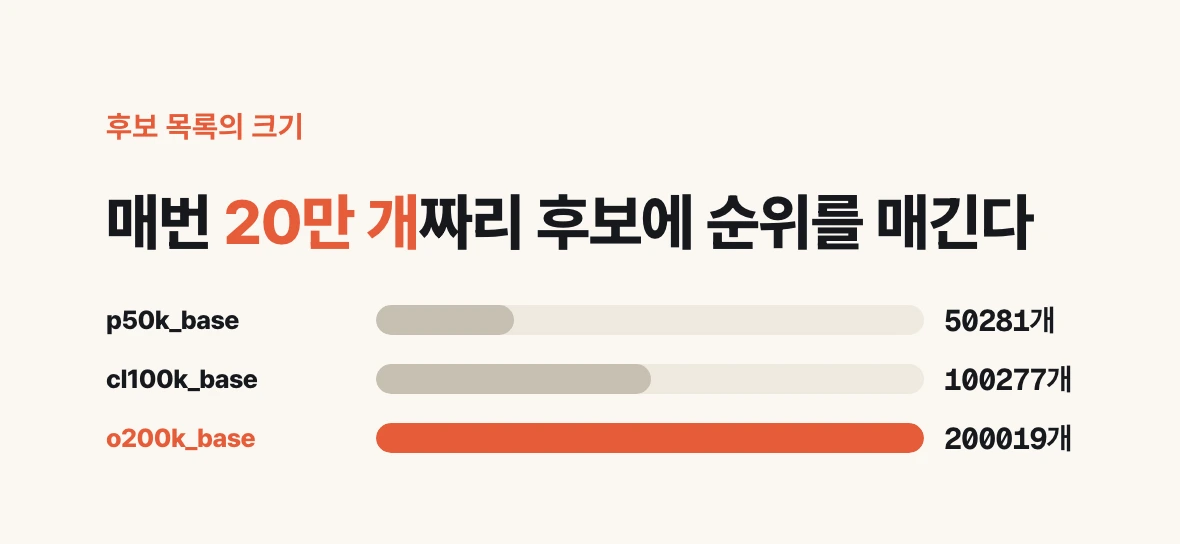
학습을 시작한 신경망은 아무것도 모른다. 가려진 자리에 무엇이 올지 물으면 단어집에 있는 모든 토큰에 대해 확률 순위를 매겨 내놓는데, 그 순위가 완전히 엉망이다.
여기서 규모를 실감할 필요가 있다. 단어집이 몇 개인지 직접 세어 보면 p50k_base는 50,281개, cl100k_base는 100,277개, o200k_base는 200,019개다. 즉 신경망은 매번 20만 개짜리 후보 목록에 순위를 매기고 있는 셈이다.
처음에는 '점심' 다음에 '자동차'가 1위로 올라오는 식이다. 한국어를 모르는 사람이 사전을 펴 놓고 아무거나 짚는 것과 다르지 않다.
그런데 정답은 알고 있다. 그래서 채점이 가능하고, 채점이 가능하니 고칠 수 있다.
틀린 만큼 되돌려 고친다
채점 결과가 나오면 이렇게 묻는다. '정답이 1위로 올라오게 하려면 무엇을 얼마나 바꿨어야 했나.'
이 질문에 답하는 계산을 역전파라고 부른다. 이름은 어렵지만 하는 일은 단순하다. 틀린 정도를 출력 쪽에서 입력 쪽으로 거슬러 올라가며 나눠 주고, 각 설정값이 오차에 얼마나 기여했는지를 따져 그만큼 고칠 방향과 크기를 정하는 것이다.
여기서 한 번에 정답으로 점프하지 않는다는 점이 중요하다. 매번 아주 조금씩만 움직인다. 한 문제에 맞추려고 크게 움직이면 앞서 맞히던 다른 문제들이 틀어지기 때문이다.
그래서 조금 고치고, 다시 틀리고, 또 조금 고친다. 이 반복이 학습이다.
고치는 대상 — DJ 콘솔의 노브들
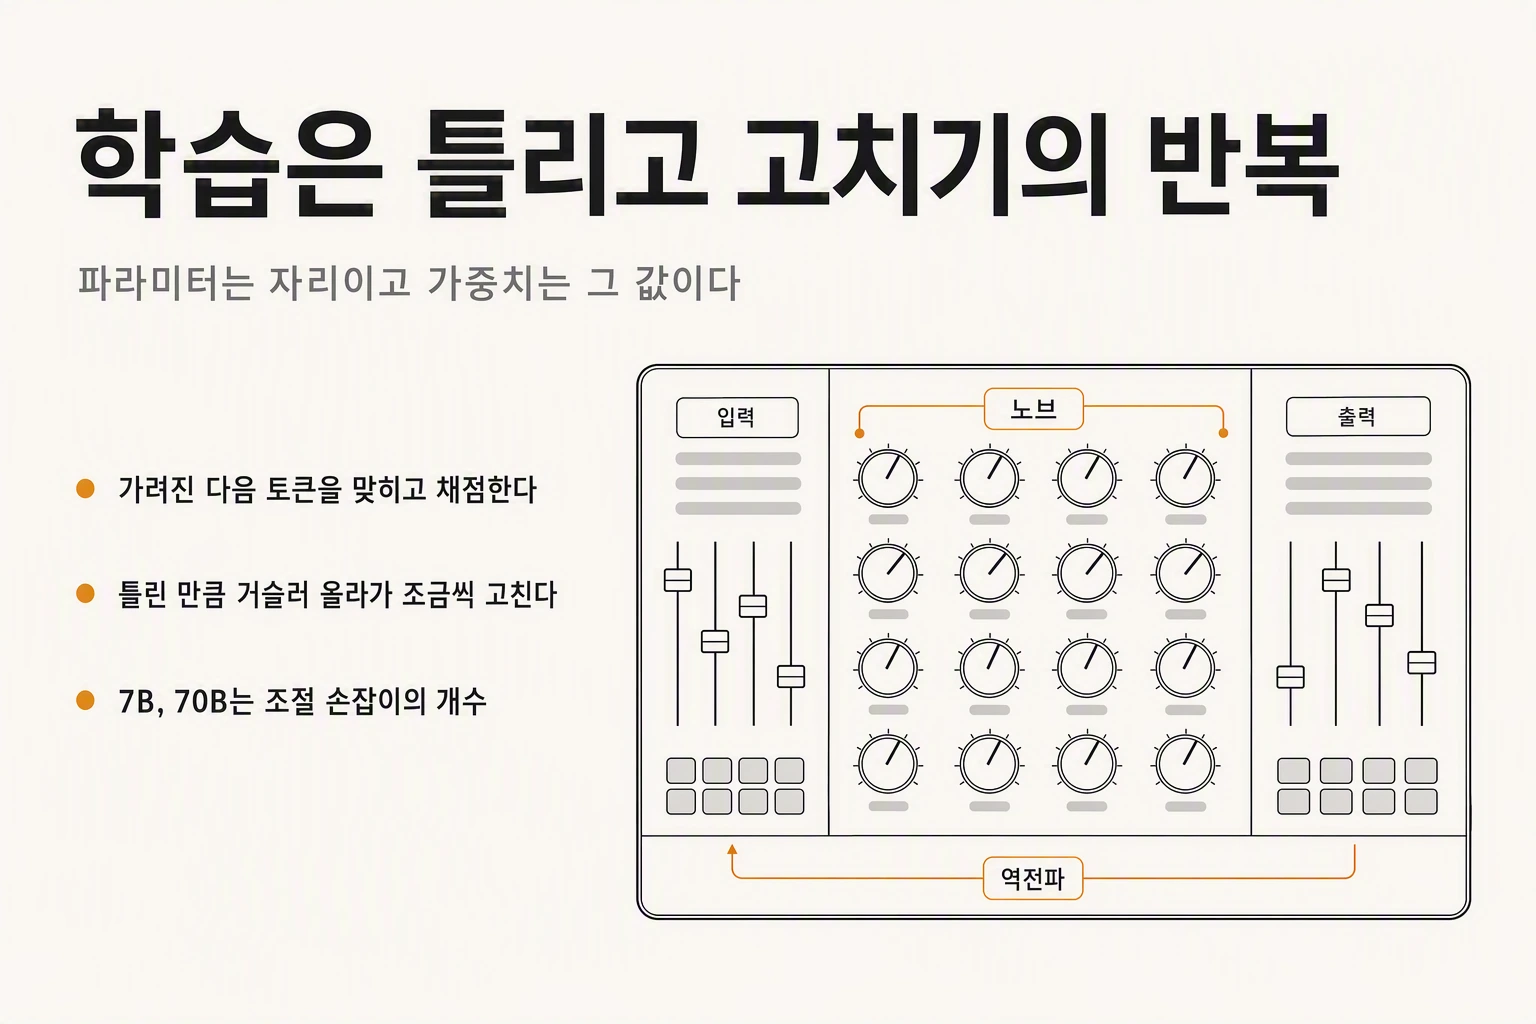
그러면 정확히 무엇을 고치는가. 신경망 내부에는 숫자로 된 조절 손잡이가 빽빽하게 박혀 있다. DJ 콘솔의 노브를 떠올리면 된다.
입력이 들어오면 그 값들을 거치며 계산이 흘러가고, 노브가 어디에 맞춰져 있느냐에 따라 최종 출력의 확률 분포가 달라진다. 학습은 이 노브들을 조금씩 돌려 가며 정답이 1위로 올라오는 조합을 찾는 과정이다.
이 손잡이를 파라미터라고 부르고, 각 손잡이에 맞춰진 값을 가중치라고 부른다. 두 말이 거의 붙어 다니는 이유가 이것이다. 파라미터는 자리이고 가중치는 그 자리에 들어간 값이다.
딥러닝에서 학습이 끝난 모델 파일이 흔히 weights라는 이름으로 떨어지는 것도 같은 맥락이다. 학습의 결과물이 결국 그 값들의 목록이기 때문이다. 모델을 받는다는 것은 사실상 이 가중치 뭉치를 받는 것이다.
7B, 70B가 세고 있는 것
모델 이름 옆에 붙는 7B, 70B 같은 표기가 바로 이 손잡이의 개수다. B는 빌리언, 10억이다. 7B면 70억 개, 70B면 700억 개의 조절값이 그 모델 안에 있다는 뜻이다.
이 숫자가 감이 안 오는 것이 정상이다. 다만 방향만 잡아 두면 된다. 손잡이가 많을수록 더 미세하게 조절할 수 있어 표현력이 커지고, 대신 계산량이 함께 커진다.
커지는 곳은 두 군데다. 학습할 때 한 번 커지고, 학습이 끝난 뒤 실제로 답을 만들어 낼 때 또 커진다. 두 번째가 실무에서 직접 부딪히는 쪽이다.
허깅페이스에서 모델을 검색할 때 왼쪽에 파라미터 수로 거르는 필터가 있다. 그것은 성능 필터처럼 보이지만 실제로는 하드웨어 질문에 가깝다. 지금 가진 장비로 이 모델을 돌릴 수 있는지를 묻는 것이다.
왜 하필 Large인가
Large Language Model의 Large는 마케팅 수식어가 아니라 이 파라미터 규모를 가리킨다. 그리고 규모가 커진 것은 설계 의도라기보다 관찰의 결과에 가깝다.
신경망 자체는 오래된 아이디어다. 그런데 작게 만들면 문법에 맞는 문장 정도는 뽑아도 사람이 대화 상대로 느낄 만한 결과는 나오지 않았다. 그러다 계산 자원이 값싸지면서 규모를 크게 키운 실험이 가능해졌고, 어느 지점을 넘자 결과의 성격이 달라졌다. 조금 나아진 것이 아니라 하던 일의 종류가 달라진 것처럼 보이는 변화였다.
이 파라미터와 가중치라는 구조는 LLM만의 것이 아니다. 이미지 인식이든 음성이든 거의 모든 딥러닝 모델이 같은 모양이다. 다루는 재료와 규모가 다를 뿐이다.
여기서 흔히 어긋나는 것
실무에서 가장 자주 보는 혼동은 '우리 데이터로 LLM을 학습시키자'는 말이다. 그 말을 하는 사람이 실제로 원하는 것은 대개 학습이 아니다.
학습은 지금 본 대로 파라미터 수백억 개를 조금씩 고치는 일이고, 자원도 시간도 규모가 다르다. 사내 문서를 답변에 반영하고 싶다는 요구는 그것과 다른 방법으로 푸는 것이 보통이다.
무엇으로 풀지 가르는 기준은 이 연재의 마지막 편에서 다룬다. 지금 잡아 둘 것은 하나다. 학습이란 모델 내부의 값을 바꾸는 일이고, 그건 아무 때나 일어나지 않는다.
아직 쓸 수 있는 모델이 아니다
여기까지 해서 가중치가 최적화된 모델 하나가 나왔다. 그런데 이 모델은 아직 사람들이 쓰는 그 모델이 아니다.
지금까지 훈련한 것은 딱 하나, 다음에 올 토큰으로 무엇이 자연스러운가뿐이다. 질문에 답하는 법도, 요청을 따르는 법도, 위험한 요구를 거절하는 법도 배운 적이 없다.
이 상태의 모델을 베이스 모델이라 부르고, 여기까지의 과정을 프리트레인이라고 한다. 다음 편에서는 이 베이스 모델을 왜 그대로 못 쓰는지, 그리고 무엇을 더 해야 우리가 쓰는 챗봇이 되는지를 본다.