지난 편에서 후보까지 나왔다
앞 편에서 레이어를 다 통과해 다음 토큰 후보와 각각의 확률이 만들어졌다. 그런데 답은 아직 한 글자도 나오지 않았다.
남은 일은 하나다. 그 후보 중에서 실제로 무엇을 고를 것인가. 이 단계를 샘플링이라고 부른다.
짧은 단계인데 실무에 미치는 영향이 크다. API에서 만지는 값들이 대부분 여기에 걸려 있고, 같은 질문에 답이 매번 달라지는 이유도 여기 있다.
1위를 항상 고르지 않는다
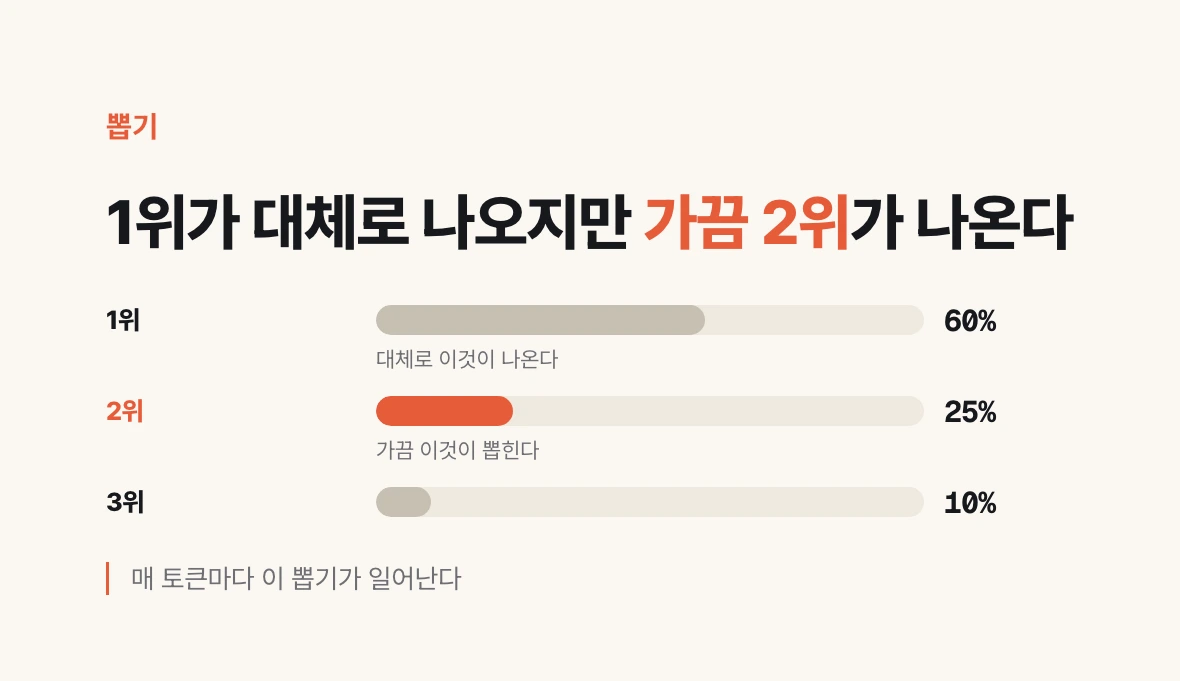
가장 확률이 높은 토큰을 항상 고르면 될 것 같다. 그런데 그렇게 하지 않는다.
그렇게 하면 같은 입력에 언제나 똑같은 답이 나온다. 예측 가능한 대신 글이 단조로워지고, 한 번 어긋난 방향으로 들어가면 계속 같은 자리를 맴돈다.
그래서 확률에 따라 하나를 뽑는다. 1위가 60%, 2위가 25%, 3위가 10%라면 대체로 1위가 나오지만 가끔 2위가 나온다. 매 토큰마다 이 뽑기가 일어난다.
이것이 같은 질문에 답이 매번 조금씩 다른 이유다. 앞 편에서 강조한 대로 모델이 학습돼서가 아니다. 파라미터는 고정되어 있고, 달라지는 것은 마지막 뽑기의 결과다.
temperature — 후보를 어디까지 열어 둘까
그 뽑기의 범위를 정하는 값이 temperature다. 이름 그대로 온도이고, 감각도 이름과 맞다.
온도를 높이면 아래쪽 후보까지 뽑힐 여지가 생긴다. 결과가 다양해지고, 흔히 창의적이라고 부르는 방향으로 간다. 온도를 낮추면 위쪽만 뽑힌다. 결과가 안정되고 반복 실행해도 비슷한 답이 나온다.
그러면 항상 높이면 좋을까. 아니다. 너무 열어 두면 맥락에서 벗어난 토큰까지 들어온다. '우리 점심 메뉴는' 다음에 음식이 아니라 엉뚱한 말이 붙는 식이다. 반대로 너무 낮추면 문장이 뻣뻣해지고 같은 표현을 반복한다.
실무 감각은 단순하다. 형식이 정해진 출력, 분류, 추출, 코드 생성에는 낮게. 문안 초안, 아이디어 나열처럼 여러 안이 필요할 때는 높게. 애매하면 낮은 쪽에서 시작해 필요한 만큼 올린다.
top-k와 top-p — 자르는 방식이 둘이다
temperature와 함께 자주 보이는 것이 top-k와 top-p다. 둘 다 후보 목록을 자르는 값인데 자르는 기준이 다르다.
top-k는 개수로 자른다. k가 40이면 확률 상위 40개만 남기고 나머지는 버린다. 단순하지만 상황을 못 가린다. 정답이 명백해서 1위가 압도적인 자리에서도 40개를 남기고, 후보가 고만고만한 자리에서도 40개만 남긴다.
top-p는 누적 확률로 자른다. p가 0.9면 확률을 위에서부터 더해 0.9가 될 때까지만 남긴다. 1위가 압도적이면 한두 개만 남고, 후보가 비등하면 여러 개가 남는다. 상황에 따라 자동으로 폭이 조절되는 셈이다.
그래서 요즘은 top-p를 쓰는 쪽이 많다. 셋을 동시에 만질 필요는 없다. 대개 temperature 하나로 충분하고, 출력이 자꾸 튀면 top-p를 함께 조인다.
맥락이 후보를 미리 좁힌다
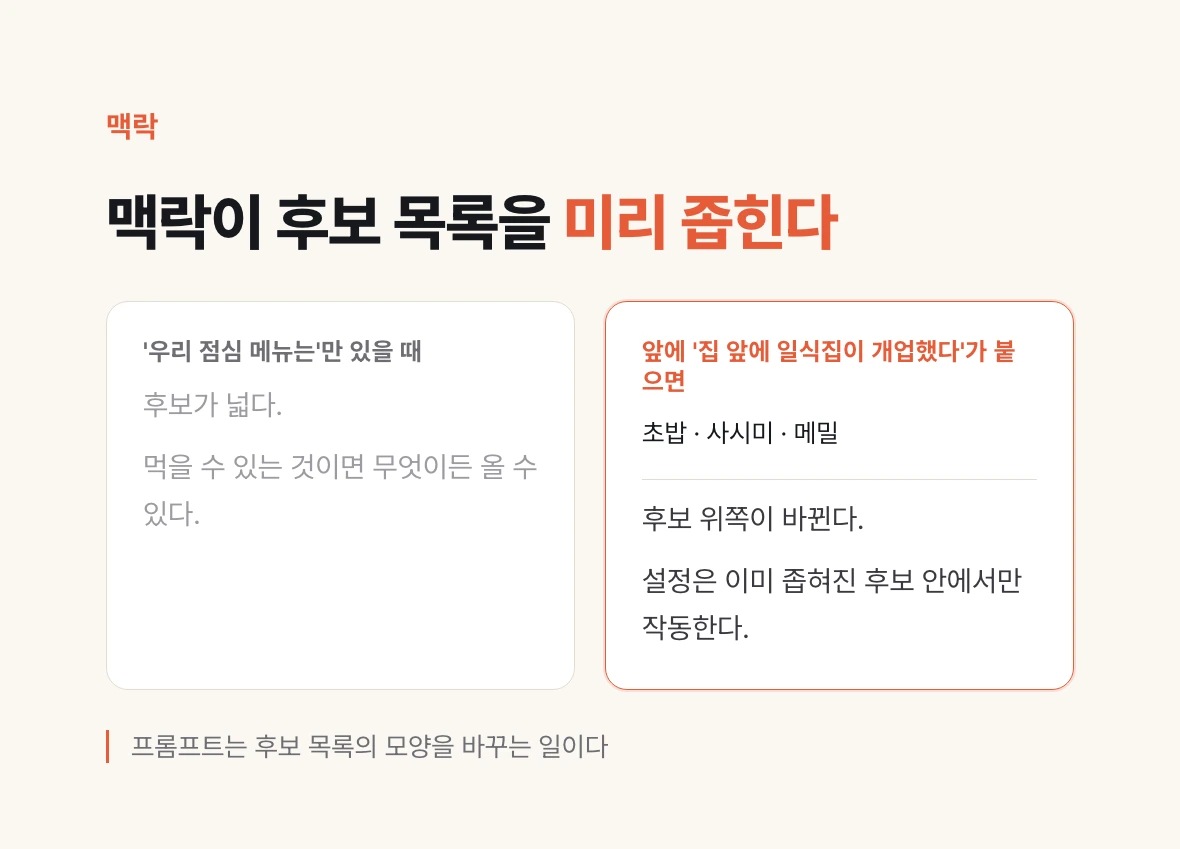
여기서 자주 놓치는 것이 있다. 후보 목록 자체가 앞 맥락에 따라 이미 달라져 있다는 점이다.
'우리 점심 메뉴는'만 있으면 후보가 넓다. 먹을 수 있는 것이면 무엇이든 올 수 있다. 그런데 앞에 '집 앞에 일식집이 개업했다'가 붙으면 후보 위쪽이 초밥, 사시미, 메밀 같은 것으로 바뀐다.
temperature를 만지기 전에 이 사실을 먼저 쓰는 편이 낫다. 원하는 방향이 있으면 설정값을 조이는 것보다 맥락을 명확히 주는 쪽이 대체로 효과가 크다. 설정은 이미 좁혀진 후보 안에서만 작동하기 때문이다.
프롬프트를 잘 쓰라는 조언이 막연하게 들렸다면 이 그림으로 보면 구체적이다. 프롬프트는 후보 목록의 모양을 바꾸는 일이다.
첫 응답은 느리고 그 뒤는 빠른 이유
토큰 하나를 뽑았다. 그런데 답은 보통 수백 개의 토큰으로 이루어진다. 다음 토큰을 뽑으려면 방금 뽑은 토큰까지 포함해 다시 계산해야 한다.
그러면 토큰마다 앞 편에서 본 무거운 계산을 통째로 반복해야 할 것 같다. 실제로 그렇게 하면 글자 하나 나오는 데 한참 걸린다.
그런데 화면에서는 처음만 잠깐 멈추고 그 뒤로는 글자가 빠르게 이어진다. 앞부분의 계산 결과를 저장해 두고 재사용하기 때문이다. 개발에서 말하는 캐싱과 같은 개념이고, 여기서는 KV 캐시라고 부른다.
그래서 체감 속도가 두 구간으로 갈린다. 입력 전체를 처음 계산하는 프리필 구간은 입력이 길수록 느리고, 그 뒤 한 글자씩 나오는 구간은 상대적으로 일정하다. 응답이 늦다고 느껴질 때 어느 쪽이 문제인지 보면 대처가 갈린다. 앞이 느리면 입력을 줄이고, 뒤가 느리면 출력을 줄이거나 더 빠른 모델을 쓴다.
멈추는 것도 토큰이다
그러면 모델은 언제 멈추는가. 어느 순간 알아서 판단하는 것이 아니다.
단어집에는 눈에 보이는 글자 말고 특수한 토큰들도 들어 있고, 그중에 '여기서 끝'을 뜻하는 스탑 토큰이 있다. 다음 토큰으로 이것이 뽑히면 생성이 멈춘다.
즉 멈추는 것도 다른 토큰과 똑같이 확률로 뽑히는 대상이다. 그리고 어디서 멈추는 것이 적절한지는 3편에서 본 포스트트레인 과정에서 학습된다. 질문에 답하고 나면 멈춰야 한다는 감각이 그때 붙는 것이다.
답이 어중간하게 끊기거나 필요 이상으로 길어지는 현상도 이 관점에서 보면 이해가 쉽다. 최대 출력 길이 제한에 걸린 것인지, 스탑 토큰이 일찍 뽑힌 것인지에 따라 대처가 다르다.
여기까지가 추론이다
입력을 토큰으로 바꾸고, 임베딩하고, 레이어를 통과시켜 후보를 뽑고, 확률에 따라 하나를 골라 이어 붙이다가 스탑 토큰에서 멈춘다. 이것이 LLM이 답을 만드는 전부다.
이제 다섯 편에 걸쳐 학습과 추론을 다 봤다. 남은 것은 이 지식을 실무 판단으로 옮기는 일이다.
마지막 편에서는 1편 첫머리에 던졌던 질문에 답한다. 어떤 문제를 프롬프트로 풀지, RAG로 풀지, 파인튜닝까지 갈지를 무엇으로 가르는가.