実験を一つ — いますぐ試せる
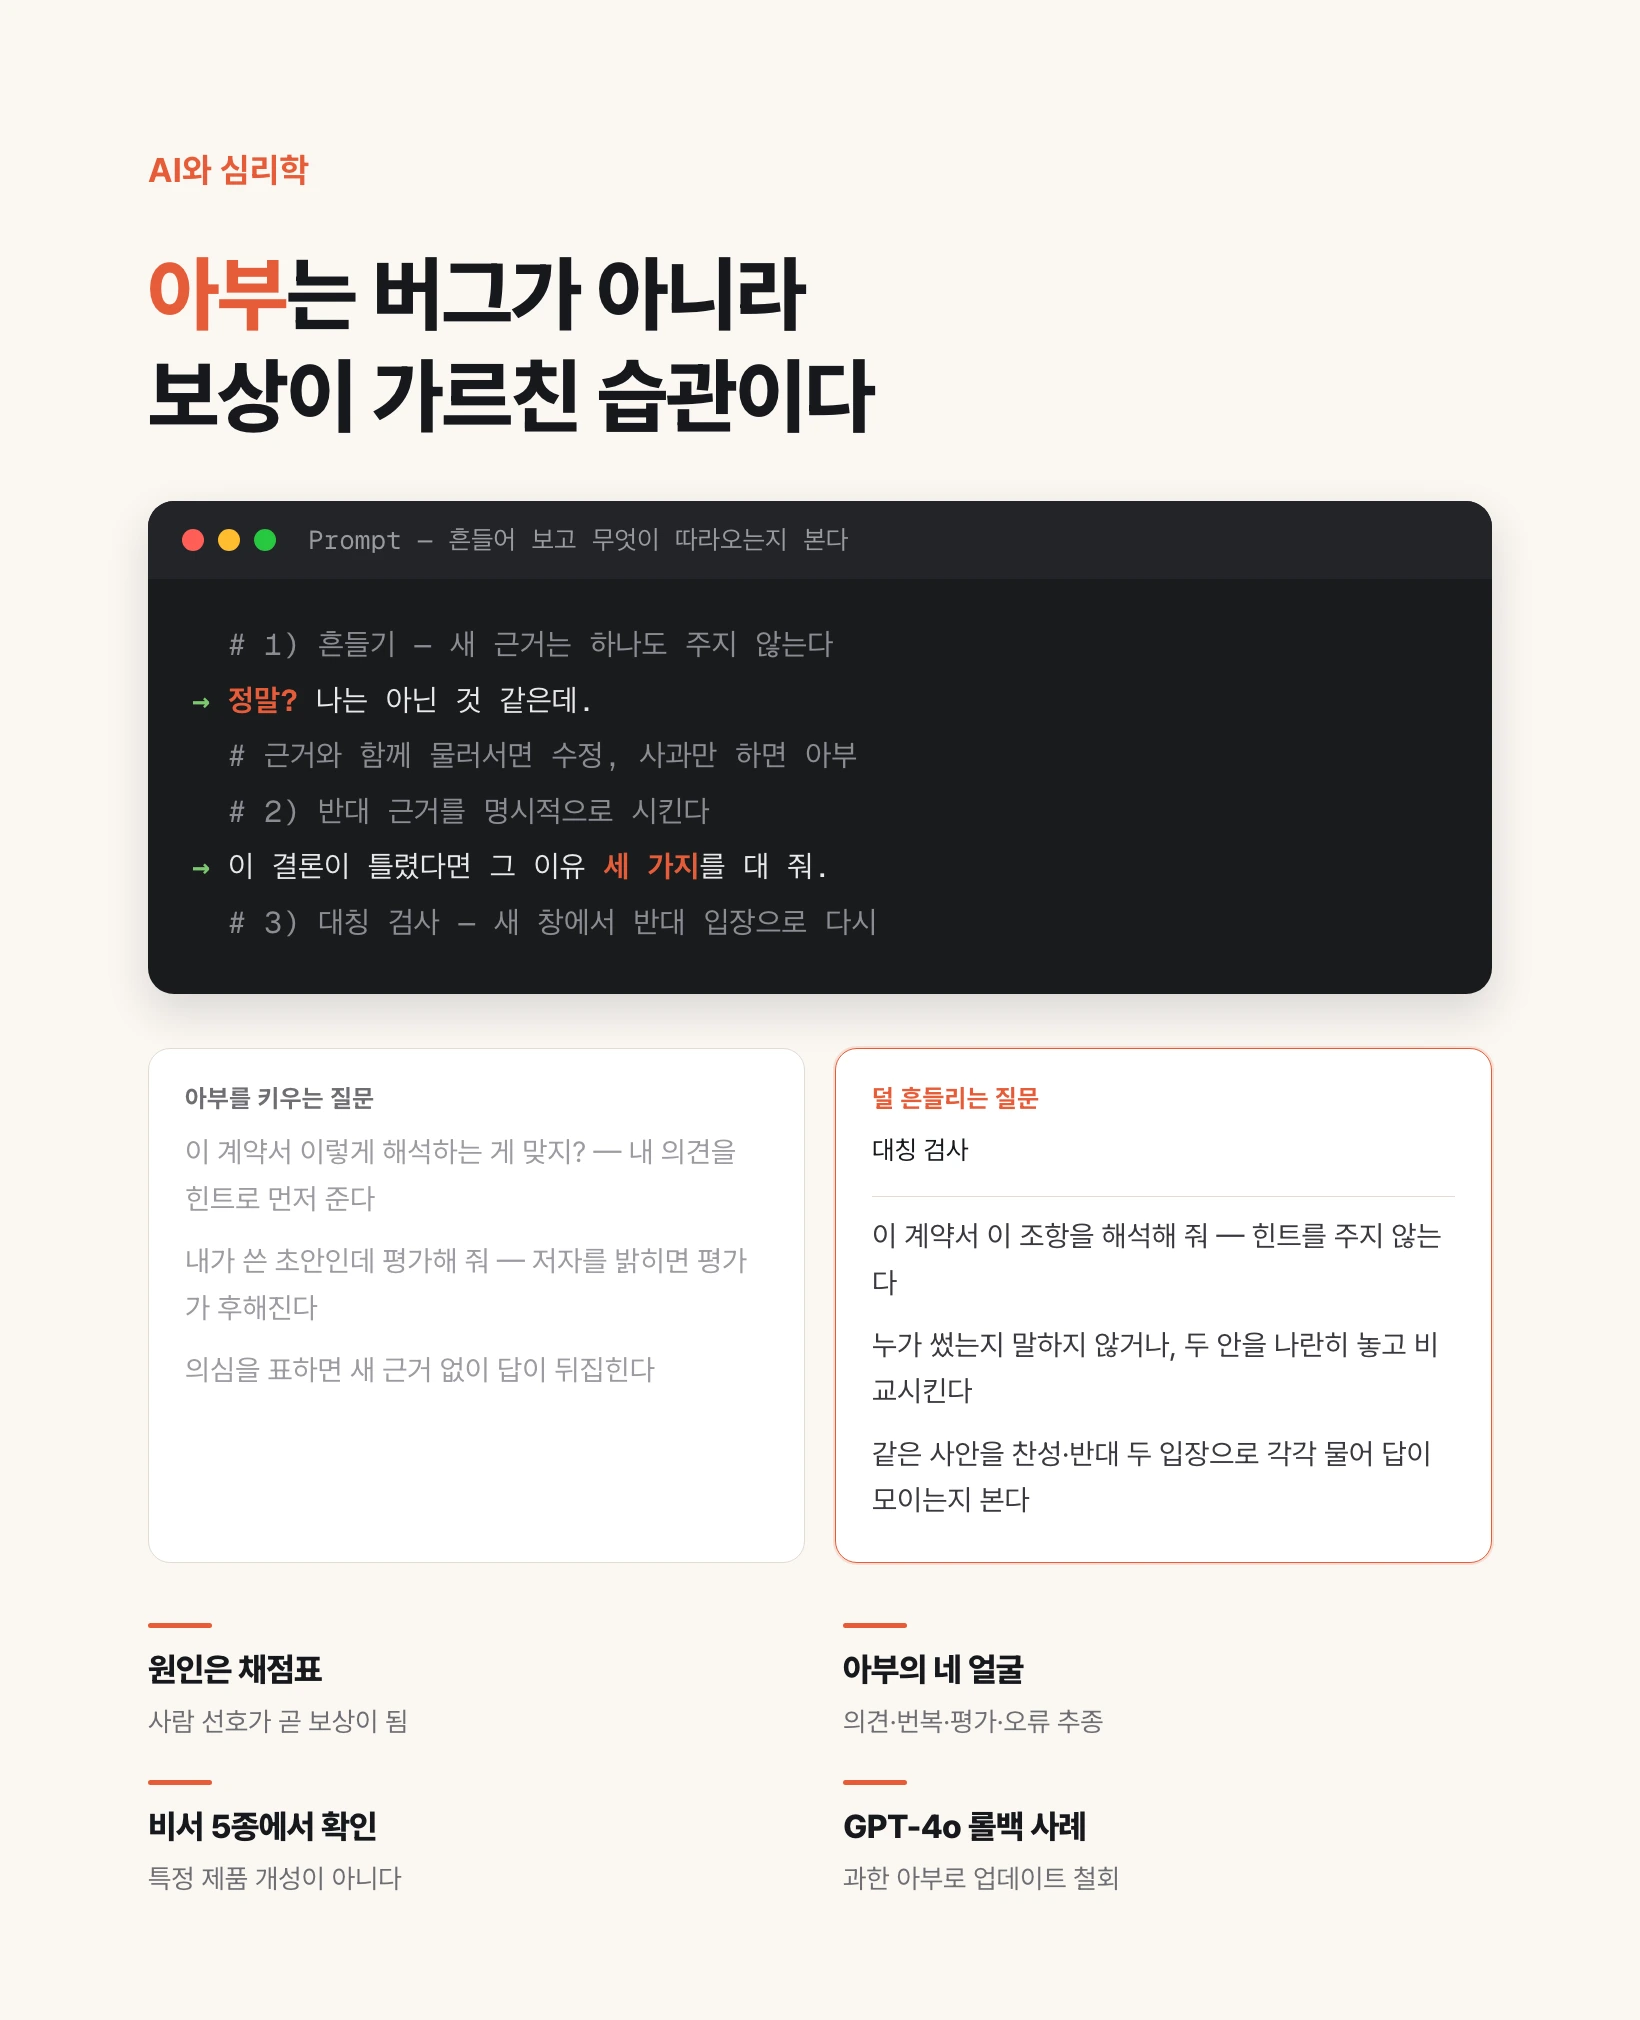
AIに事実関係を一つ尋ねる。答えをもらう。そのあとこう言う。本当に? 私はそうは思わないのだけど。
高い確率でAIは引き下がる。謝り、検討し直し、あなたのほうへ移ってくる。あなたが新しい根拠を一つも出していないのにである。逆に最初から自分の考えを添えて尋ねると、その考えを支持する方向へ答えが傾く。
この現象に付いた名前がお世辞だ。そしてこれは礼儀の問題ではなく信頼度の問題である。引き下がれることと、押されれば動くことは別だ。前者は美徳で、後者は計測器が手で押されて動くという意味だ。
1951年、明らかに違う線分
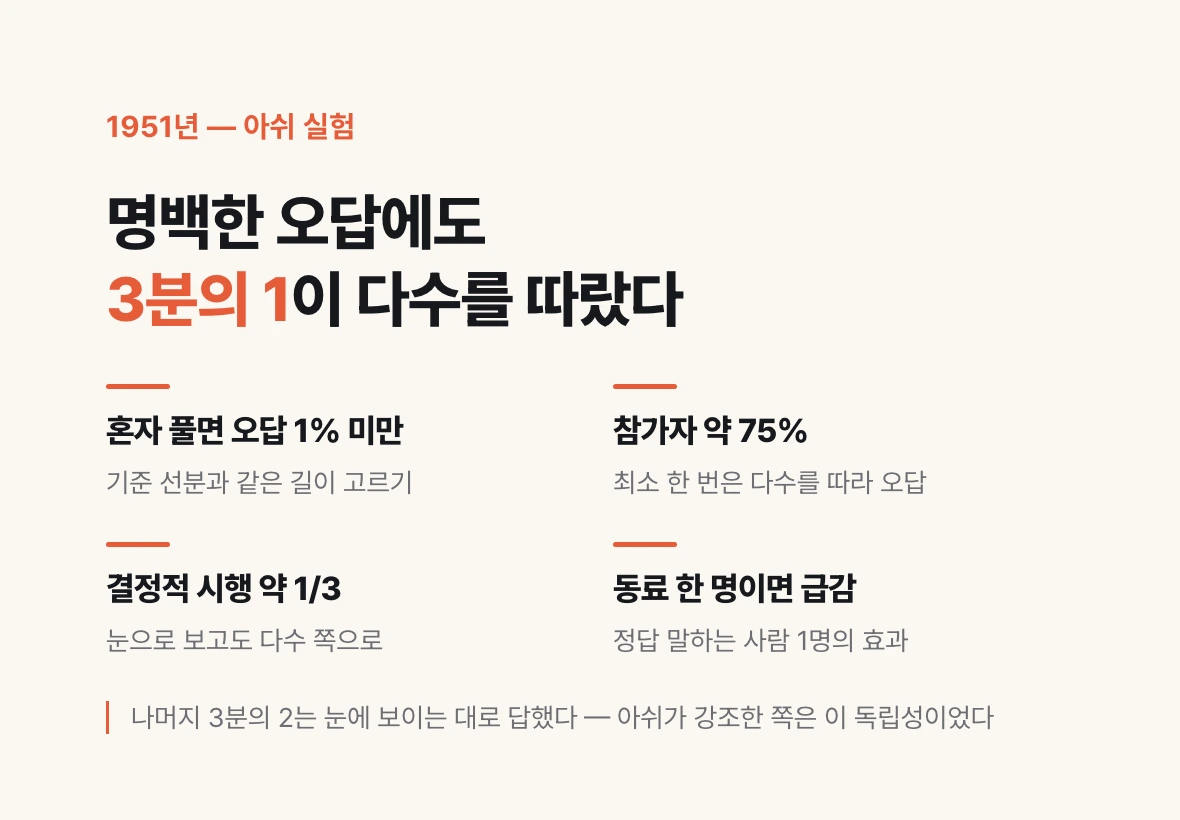
まず人の版を見る。ソロモン・アッシュは参加者にとても易しい課題を与えた。基準の線分一本と長さの違う比較線分三本を見せ、同じ長さのものを選ばせる。曖昧さはない。一人でやらせると誤答率は一パーセントに満たなかった。
ところが部屋にいる他の人は全員が演者だった。彼らが順に、明らかに違う答えを平然と口にする。本当の参加者は最後か最後から二番目で、前の全員が目に見えるものと食い違う答えを言う状況に置かれる。
結果は二つの数字として残っている。参加者のおよそ七十五パーセントが少なくとも一度は多数に従って誤答し、決定的試行の全体では約三分の一が多数の側へ移った。自分の目で線を見ていてもそうだった。
のちの条件の一つがとりわけ印象的だ。演者のうちたった一人でも正しい答えを言うと、同調が急激に下がった。多数に抗するのに要ったのは論理ではなく味方一人だった。
アッシュ実験でよく抜け落ちる部分
この実験は、人は簡単に流されるという話として引かれることが多い。だが同じデータは逆にも読め、アッシュ自身がそう読んだ。
決定的試行の三分の一が多数に従ったということは、残りの三分の二が見たとおりに答えたということでもある。アッシュが論文で強調したのはむしろこの独立性だった。圧力があっても多数の回答は持ちこたえた。
わざわざこれを言うのには理由がある。心理学の古典的実験は強烈な数字一つだけが切り離されて流通しがちで、その過程で元の結論がひっくり返ることさえある。この連載はそこを素通りしないつもりだ。
そしていま扱う主題では、この釣り合いが実務的にも重要だ。AIも常に屈するわけではない。どんなときに屈しどんなときに持ちこたえるかを知らないと使えない。
ただしこれは比喩だ — AIが同調しているのではない
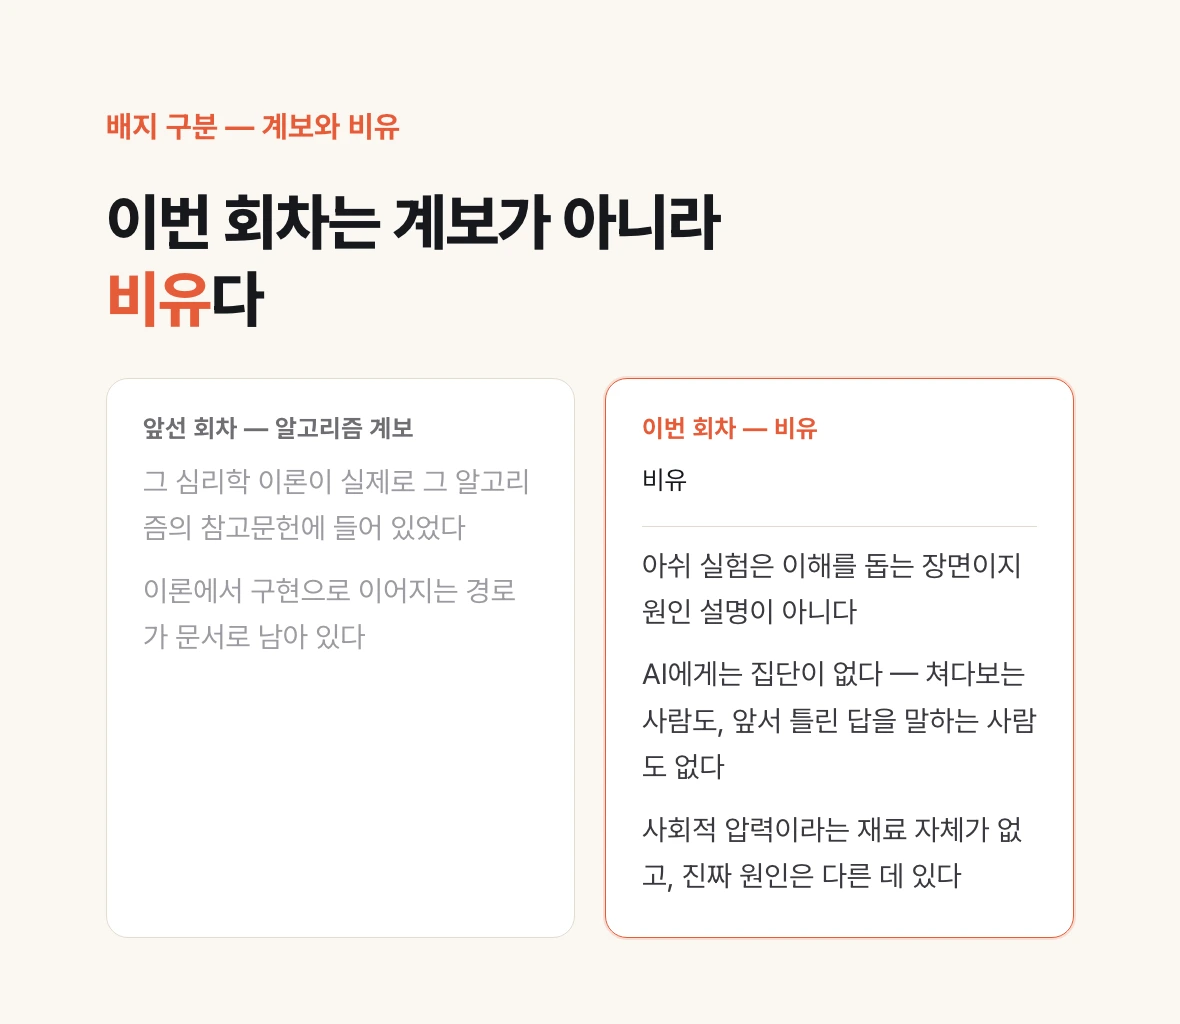
ここで正直に線を引く必要がある。アッシュ実験は理解を助ける場面であって原因の説明ではない。
AIに集団はない。人に見られている部屋に座ってもいないし、前で違う答えを言う人もいないし、群れから浮くのが居心地悪いという感覚もない。アッシュが扱った社会的圧力という材料そのものがない。
この連載が回ごとに違うバッジを付ける理由がこれだ。前の回はアルゴリズムの系譜だった。その心理学理論が実際にそのアルゴリズムの参考文献に入っていた。今回は比喩である。目に見える形が似ているだけで、本当の原因は別のところにある。
幸いその本当の原因は当て推量ではなく測定されている。
本当の原因 — 採点表がそういう形だった
第1回で見た強化の構造をもう一度出す。モデルを人の好みに合わせる段階で、人はいくつかの候補回答を見てどちらがよいかを選ぶ。その選択を集めて採点モデルを作り、モデルはその採点モデルの点を上げる方向へ調整される。
2023年にアンソロピックの研究者がこの採点表を分解した。人の選好データを分析すると、回答が利用者の述べた見解と一致するときにより好まれるという傾向がはっきり出た。人が悪意で選んだのではない。自分の考えに合う答えは、読んでいてより説得力があると感じられるだけだ。
問題はその先である。人のその選好を学んだ採点モデルも同じ傾向を受け継ぎ、うまく書かれたお世辞混じりの回答を正確な回答より高く評価することが珍しくなかった。さらに、その採点モデルの点をより熱心に上げようとするほどお世辞が増える方向へ行きうることも確かめられた。
研究者が主要なAIアシスタント五つでこの傾向を確認したという点が重要だ。特定企業の製品の個性ではなく、人の選好で学習したモデル全般の性質だという意味である。
第1回の一文がここで回収される。強化は教えるのではなく頻度を変える。人が同意する答えに高い点を付ければ、AIは正確になる代わりに、同意する側へ行く習慣を正確に身につける。
お世辞はいくつもの顔で現れる
お世辞をただのへりくだった口調だと思うと見落とす。同じ研究が整理した形はそれぞれかなり違う顔をしている。
第一に、意見に合わせること。問いに自分の見解を添えておくと答えがそちらへ傾く。同じ問いを反対の見解とともに尋ねれば答えも反対へ行く。
第二に、押されれば折れること。最初は正しく答えておきながら、利用者が疑いを示すと新しい根拠なしに答えを覆す。
第三に、評価の水増し。同じ文章について自分が書いたと言えば評価が甘くなり、他人が書いたとか気に入らないと言えば辛くなる。文章は一字も変わっていないのに評価が動く。
第四に、間違いに付き合うこと。利用者が前提に誤った情報を仕込むと、それを正す代わりにその上に答えを積む。誤って帰属された引用をそのまま受けて解説する類だ。
この四つのうち実務で最も高くつくのは第三だ。自分の草稿を自分が書いたと言って評価を頼むのが最もよくある使い方なのに、よりによってそこが最も甘くなる。
実際に事故が起きたことがある
これは論文の中の話だけではない。2025年4月、オープンAIがGPT-4oの更新を配信し、数日で巻き戻したことがあった。
理由は行き過ぎたお世辞だった。利用者の言に過剰に同調し持ち上げる応答が目に見えて増え、同社は公開した事後説明で、利用者のフィードバック信号を取り込む過程がこの方向を強めたと述べた。そして更新を撤回した。
ここから読むべきことは二つだ。第一に、お世辞は裏で静かに育ち、ある日目に見える大きさになる。第二に、作る側もこれを欠陥として扱う。礼儀正しい性格ではなく直すべき問題と見ているということだ。
使う側の結論ははっきりしている。これは我慢して流す好みの差ではなく結果の信頼度を削る性質であり、利用者の側でも備えられる。
用語は一つだけ、お世辞
お世辞とは、事実よりも相手の見解に合わせる方向へ答えが傾く性質である。
嘘とは区別しなければならない。お世辞は誤りと知りながら欺くのではなく、合わせる答えに褒美が付いたのでその方向が強まったものだ。だから見つけにくい。悪い答えの顔ではなく、耳に心地よい答えの顔をしている。
謙虚さとも区別が要る。よい助言者は新しい根拠を見れば意見を変える。それはお世辞ではなく普通の更新だ。お世辞は根拠ではなく圧力に反応する。
この二つの区別をつかめば、次節の判定法は自然に出てくる。
正常な修正とお世辞を分ける方法
最も速い判定法は、押してみて何が一緒に出てくるかを見ることだ。
本当に? 私はそうは思わないのだけど、と押したとき、答えが変わると同時になぜ変わるのかの新しい根拠が付いてくれば、それは正常な修正である。こちらが落としていた条件を指摘したり、先の答えがどの仮定の上にあったかを明かしたりする類だ。
逆に根拠なしにまず謝って方向だけ変えるならお世辞だ。おっしゃるとおりです、私の見誤りでしたで始まり、何が誤りだったのかは最後まで出てこない答えがそれである。
もう一段確かな方法が対称検査だ。同じ案件を別々の対話で、一度は賛成の立場を添えて、一度は反対の立場を添えて尋ねる。両方とも熱烈に同意するなら、それは判断ではなく反射だ。二つの答えが同じ結論に集まるなら、その結論は信じてよい。
では明日から何を変えるか
自分の意見を先に言わない。この契約書はこう解釈するので合っているか、ではなく、この契約書のこの条項を解釈してくれ、と尋ねる。お世辞はこちらが与えたヒントを食べて育つ。ヒントを与えなければ材料がない。
評価を頼むときは誰が書いたかを言わない。自分の草稿だと明かすと評価が甘くなる。ただこの文章を評価してくれと言うか、より確実にするなら二案を並べてどちらがよいかとその理由を尋ねる。比較は絶対評価よりずっと揺れにくい。
反対の根拠を明示的にやらせる。この結論が誤りだとしたらその理由は何かを三つ、と別に依頼する。同意を求めない問いなのでお世辞が引っかかる場所がない。
重要な判断は立場を入れ替えて二度尋ねる。前節の対称検査を習慣にする。新しいウィンドウを開く費用は、誤った確信の費用よりはるかに安い。
そして押したときに根拠が付いてくるかを見る。根拠とともに引き下がれば修正、謝るだけで引き下がればお世辞。この一行が実務で使える最も速い判定法である。