2026年9月第1週に何が起きたか
一週間でトップクラスのモデルが四つ出た。AnthropicのClaude Fable 5.1、GoogleのGemini 3.8 Flash、MetaのMuse Spark 1.3、OpenAIのGPT-6 Astra。四社とも自社発表で何かの一位を主張した。
同じ週に動いたのはモデルだけではない。9月1日には画面と空間を生成するモデルが二つ出た。RunwayのSolarisとWorld LabsのAtlasである。9月3日にはマイクロソフトが音声認識モデルMAI-Transcribe-2を出し、同じ日にエヌビディアがHugging Faceの買収に合意したと発表した。
この記事はその週の発表を並べるためのものではない。発表どうしが別々の表を根拠に一位を主張する光景そのものが一つの事実であり、モデルを選ぶ側にとっては、その光景の読み方が個々のスコアより長く役に立つ。
第一に、一位は表ごとに違う
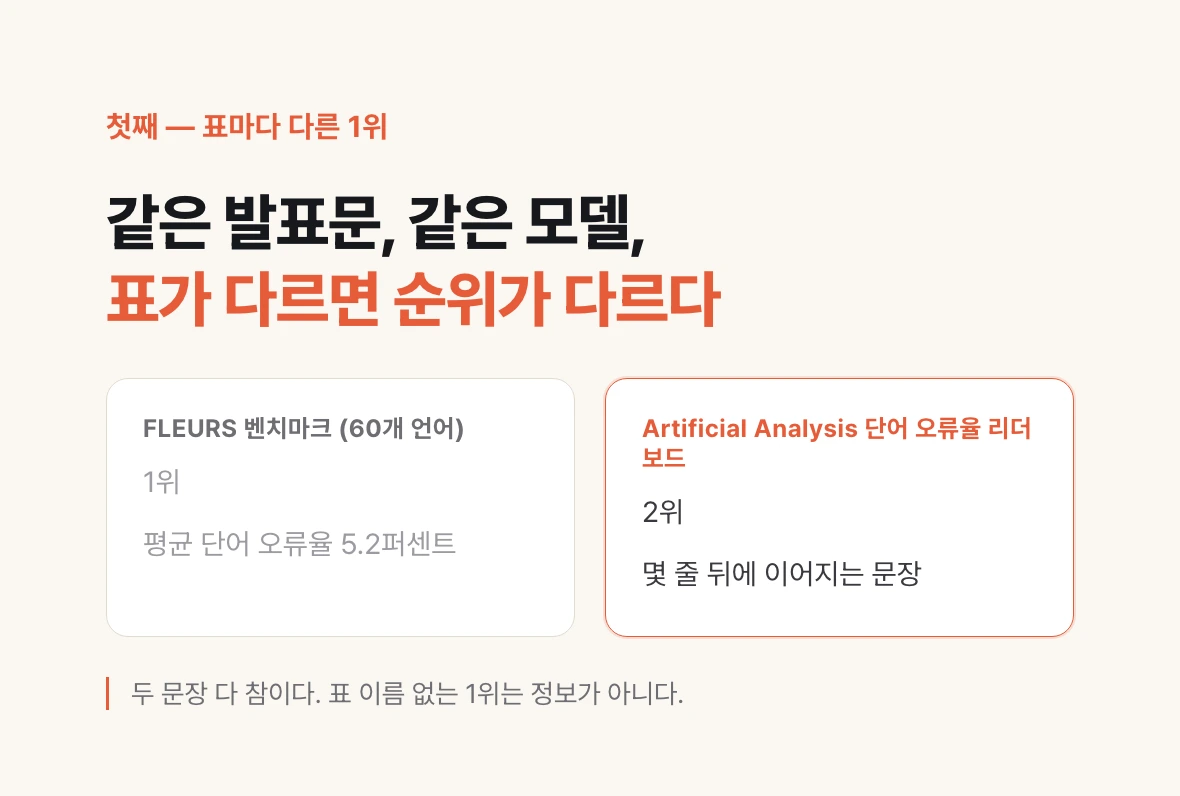
最もきれいな実例はマイクロソフト自身の発表文の中にある。MAI-Transcribe-2の発表文の見出しは、世界で最も速く、最も正確で、最も安い音声認識モデルだ。本文は60言語を測るFLEURSベンチマークで一位だと書く。平均単語誤り率は5.2パーセントである。
同じ段落が数行あとにこう続く。Artificial Analysisの単語誤り率リーダーボードでは二位だと。どちらの文も真である。測る表が違うからだ。どちらも嘘ではないし、どちらもそのモデルのすべてではない。
ここから得るべき習慣は一つ。発表文が一位と書いたら、その隣の表の名前をまず見る。表の名前のない一位は情報ではない。
第二に、総合順位は重みづけの関数だ
Artificial Analysisのような総合指数は、複数のベンチマークを集めてそれぞれに重みをかけ、一つのスコアにまとめる。便利である。表一つですべてのモデルを並べられる。
だが重みが変われば順位が変わる。つまり総合順位は、どのモデルが賢いかへの答えではなく、この重み配分ではどのモデルが先行するかへの答えである。コーディングの比重を上げればコーディングモデルが上がり、推論の比重を上げれば推論モデルが上がる。
だから総合順位と実際の手応えがずれるのは不思議なことではない。その指数の重み配分が自分の業務の重み配分と違うだけだ。ランキング表が間違っているのではなく、自分の問いに答える表ではないのである。
第三に、価格はランキング表の外にある
性能のランキング表はたいてい価格を一緒に並べない。ところが同じ週に出たモデルどうしの価格差は、性能差よりはるかに大きい。
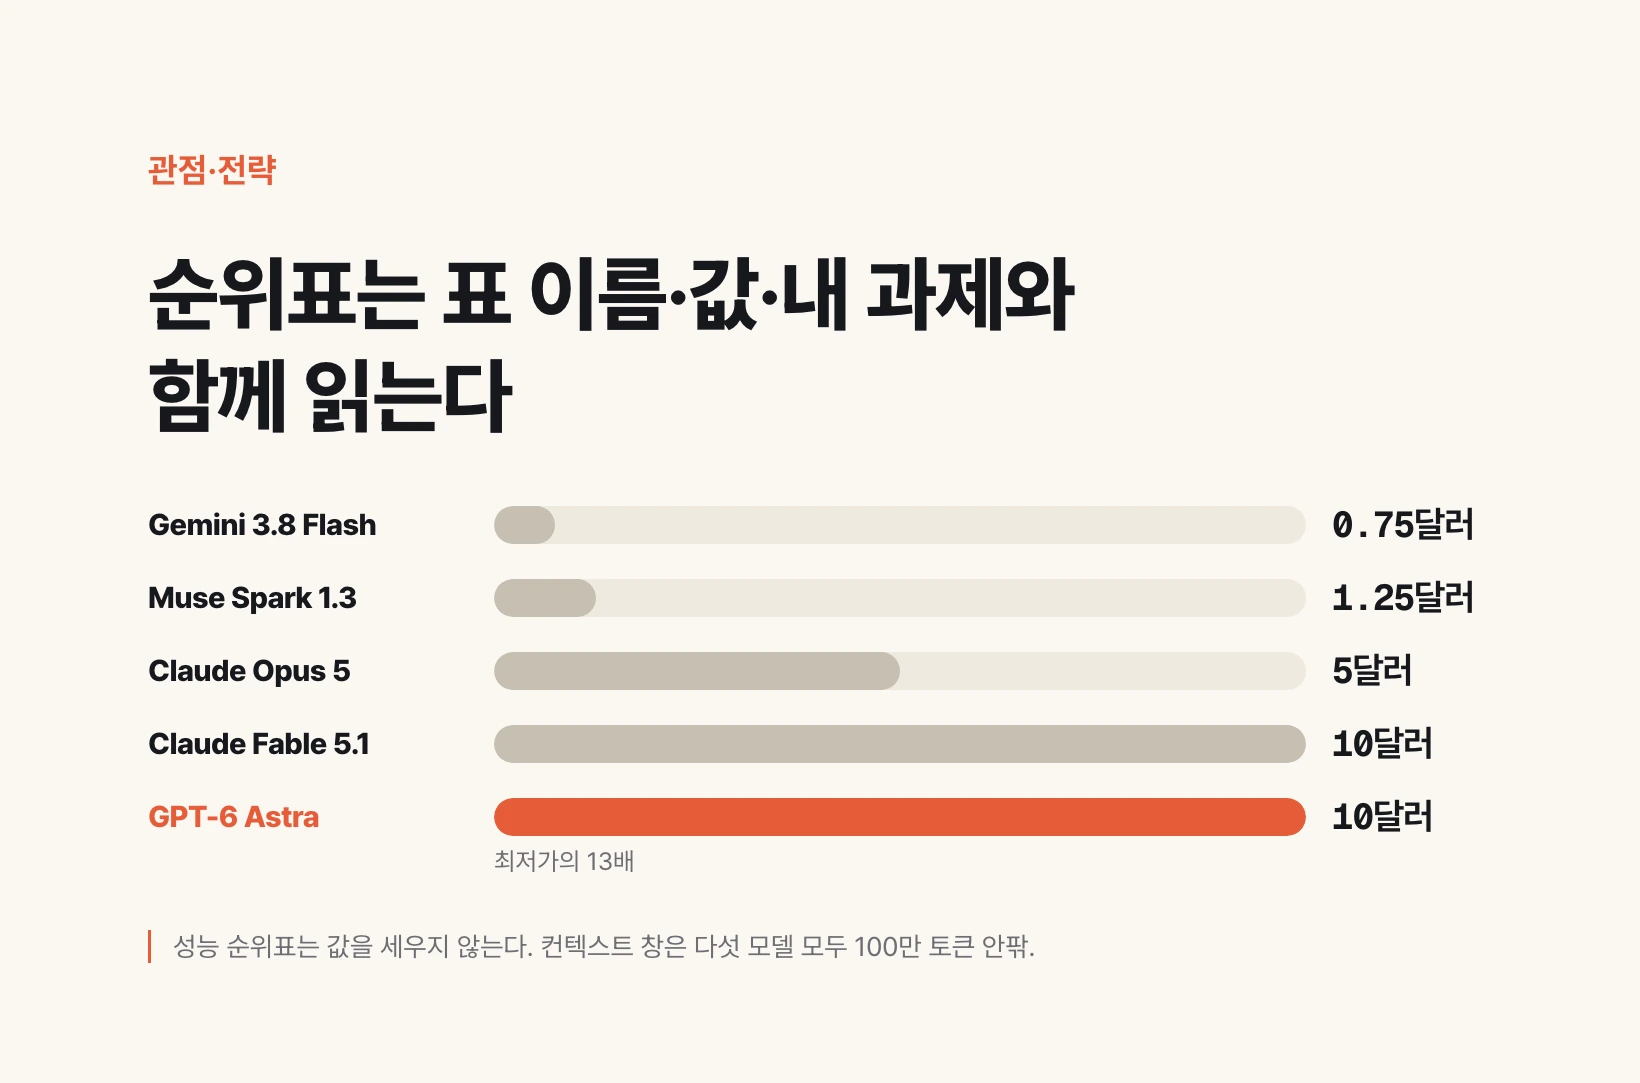
2026年9月7日時点のOpenRouter公開価格で入力100万トークンあたりの単価を並べるとこうなる。Gemini 3.8 Flashが0.75ドル、Muse Spark 1.3が1.25ドル、Claude Opus 5が5ドル、Claude Fable 5.1が10ドル、GPT-6 Astraが10ドル。最も安いものと最も高いものが13倍以上開く。
出力はさらに差が大きい。同じ順で3.75ドル、4.25ドル、25ドル、50ドル、50ドルである。コンテキスト窓は五つとも100万トークン前後で、この軸ではほとんど差がない。
ランキング表で一段上にいるために13倍を払う理由があるかどうかに、ランキング表は答えない。答えは業務ごとに違う。契約書ドラフトの点検のように一度のミスが高くつく仕事なら高いモデルが正しく、議事録要約を一日に数百件回すなら価格がそのまま導入可否になる。
では何を見るべきか — 自分の課題で作る評価セット
他人の表の読み方を身につけるより、自分の表を作るほうが速い。大げさな道具はいらない。文書ファイル一つで足りる。
手順は四つ。第一に、実際の業務から課題を三つから五つ抜き出し、プロンプトごと書いておく。昨日実際にやった仕事でなければならない。作った例題ではモデルを分けられない。第二に、正解ではなく合格条件を書く。何が入っていれば通過で、何が入っていれば不合格かを文章にする。第三に、新しいモデルが出たら同じプロンプトをそのまま入れて結果を並べる。第四に、結果の横に価格と所要時間を一緒に書く。
この文書が積み上がれば、発表文の一位と無関係に判断できる。しかもその判断は他人に説明できる形で残る。組織でモデルの入れ替えを提案するときに要るのは、ベンチマークのスクリーンショットではなく、うちの課題五つでこう分かれたという表だ。
# うちの課題 評価セット (2026-09)

## 課題1 — 商談録音の要約
プロンプト: 以下の録音を 顧客要望 / こちらの約束 / 未決事項 の三つに整理せよ。<録音>
合格: 未決事項が抜けない。ない約束を作らない。
不合格: 日付・金額をでっち上げる。

| モデル | 結果 | 価格 | 所要 |
|---|---|---|---|
| (記録) | | | |

## 課題2 — 契約書の危険条項チェック
プロンプト: ...
合格: ...
不合格: ...
今週の本当のニュースはランキングではなく地形だ
9月3日、ジェンスン・フアンが自身の名前で出した文で、エヌビディアがHugging Faceの買収に合意したと発表した。金額は129億3,030万ドルである。
Hugging Faceがどういう場所かは発表文の数字で分かる。1,800万人を超える開発者・研究者・クリエイターが300万を超えるモデル、50万のデータセット、100万のアプリケーションを共有し、20万社を超える企業がこのプラットフォームでAIを発見し評価しカスタマイズし配備している。オープンモデルのGitHubと呼んでよい位置だ。
発表文が二度釘を刺した文がある。Hugging Faceで作るにも配備するにもエヌビディアのコンピュートは必須ではないということ、そしてマルチクラウド・マルチアクセラレータの支援を続けるということだ。買収発表でこの二文を二度書くこと自体が、何を懸念したかを示している。
チップを売る会社がオープンモデルのリポジトリを買う理由は読む価値がある。MetaもOpenAIもGoogleも自社チップへ移りつつある。フロンティアラボがエヌビディアのコンピュートを買わなくなっても、オープンウェイトのモデルを自社サーバで直接動かしたい企業や機関は依然としてGPUを買う。エヌビディアは自社がHugging Faceへのオープンモデルとデータの最大の貢献者であり、そこに500を超えるモデルと250を超えるオープンデータセットを公開したと述べている。今回の買収は同じ方向により大きく賭けたものだ。
生成の対象がテキストから画面と空間へ移った
9月1日にRunwayが公開したSolarisはインターフェース世界モデルである。これまで画面はコードという中間表現で実装され、そのため見た目と挙動をあらかじめすべて決めておく必要があった。Solarisはその段階を飛ばし、ユーザーの操作に反応して画面を一フレームずつ作り出す。
構造は二つに分かれる。言語モデルがユーザーの意図を解釈し、その操作が生成環境にどう反映されるべきかを指定する。視覚モデルはその結果を描くことだけを担う。高水準の推論と画面レンダリングが分離されている。論文はこれをソフトウェアの新しいパラダイムへの一歩と書いた。インターフェースがあらかじめ定義された状態の有限集合ではなく、ユーザーの意図に沿って生成され適応し続けるものになるという意味だ。
同じ日にWorld Labsが公開したAtlasは空間の側だ。テキストと画像と映像と3Dを最初から一緒に学習し、すべての入力を一つの共有空間コンテキストとして扱うモデルである。写真を一枚から数十枚まで入れると、指定したカメラ位置と角度で新しい視点を生成する。しかもカメラを文章指示ではなく幾何量としてネイティブに受け取る。少し左へ、ではなく座標だ。最長1分、1440pまで出る。写真に写っていない部分はモデルが続けて想像する。
Atlasはこのほか、複数の写真から実際の場面を3Dに再構成し、映像を入れれば時空をモデリングしてロボットのReal-to-Simワークフローに渡す。World Labsは3D再構成に特化した最新モデルを上回る性能だと主張している。
まとめ — ランキング表を読む三行
一つ、一位という言葉の後ろにある表の名前をまず見る。表の名前のない一位は情報ではない。
二つ、総合指数は重みづけの関数だ。その重みが自分の業務と同じかを問う。
三つ、自分の課題を三つから五つ固定し、新しいモデルが出るたびに同じプロンプトで自分で測る。結果の横に価格と所要時間を一緒に書く。この表は他人のランキングが揺れても揺れない。