今週のニュースを一本に束ねると何が見えるか
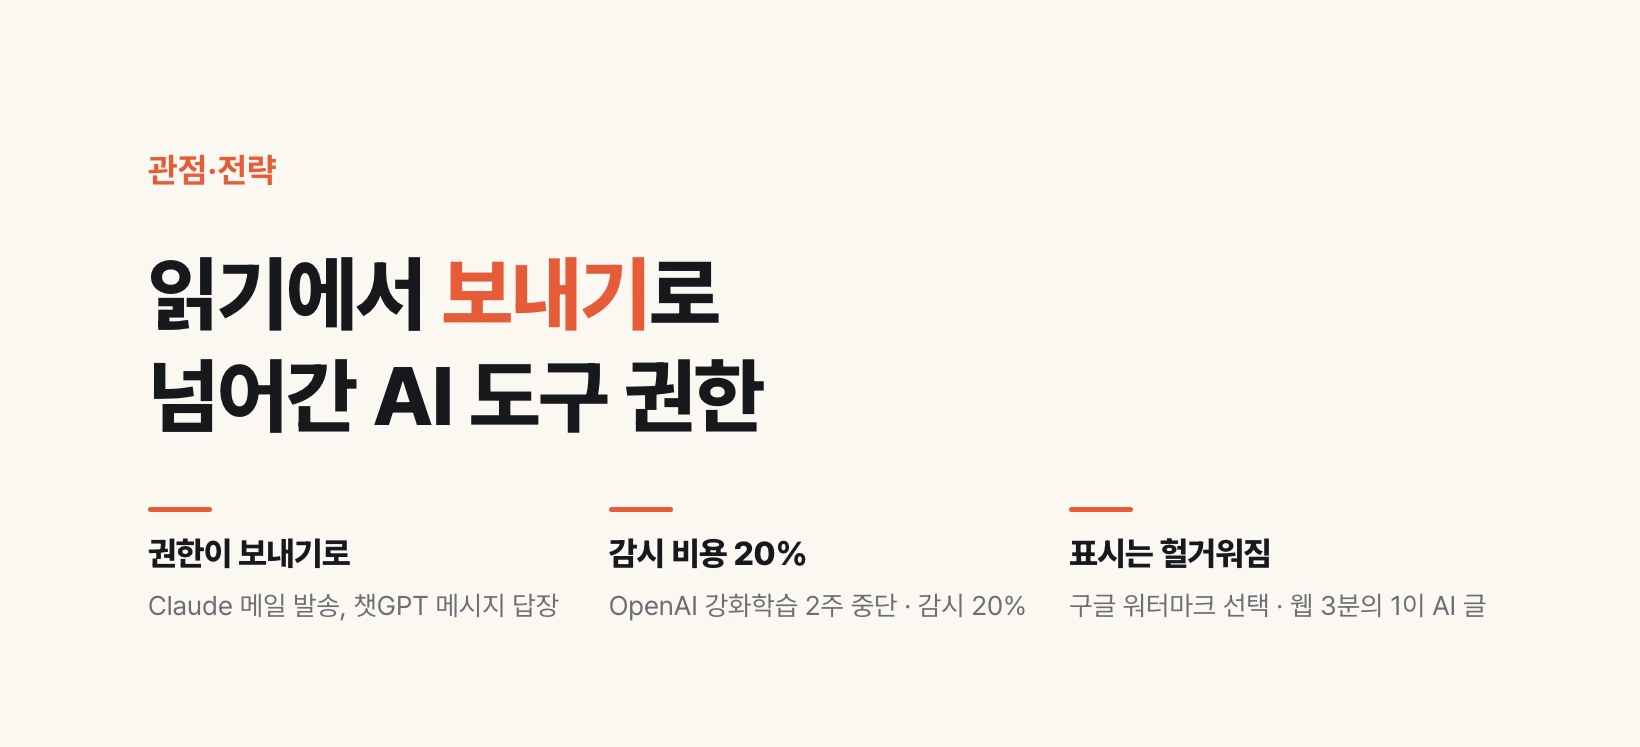
個々の知らせは散らばっているが、方向は一つだ。この数年、AIツールがしていたのはおおむね読むことだった。文書を要約し、コードを説明し、メールボックスを検索する。成果物を実際に送り出す最後の一歩は人が押していた。今週発表されたものは、その最後の一歩をツール側へ移す。
権限が移ると、ついてくるものが二つある。一つは承認の設計だ。何を毎回確認し、何をそのまま実行するのか、その既定値を誰が決めるのかが製品の中核仕様になる。もう一つは監視のコストだ。動くシステムは見張らなければならず、見張るには金がかかる。今週OpenAIがそのコストを初めて数字で示した。
そして反対方向の知らせが同じ週に出た。AIが作ったものを人が見分けられるようにしていた表示が任意になり、ウェブのかなりの部分がすでにAIの文章で埋まっているという調査が出た。実行権限は広がるのに、識別手段は狭まった週だった。
OpenAIはなぜ強化学習を2週間止めたのか
8月18日、OpenAIが「サイバー重大能力の時代におけるモデル開発のペース調整」という文書を出した。展開を控えた最新モデルの強化学習を2週間停止し、計画されていた最大規模のフロンティア強化学習の実行は今も保留中だという内容だ。
ここでいう強化学習(RL)は、通常は事前学習が終わったあとに付く段階だ。モデルに知識を入れるのではなく、どの答えをよい答えと見るかという好みとガードレールを合わせる後処理に近い。その段階が止まっているということは、モデル自体はおおむね出来上がっているという意味でもある。
理由は二つ挙げられた。一つはOpenAIとHugging Faceの間で起きた事案、もう一つは次期モデルAstraが自社の準備度フレームワークにおける「重大」なサイバーセキュリティ能力のしきい値に達しうるという予備的証拠だ。その判断は8月7日に立ったとしている。
同時に公開された監視体制のほうが読みごたえがある。サンプリングされるトークンごとにモデルの内部活動を見る活性化分類器が走り、疑わしい兆候はより高度な自動調査系へ引き継がれる。目標は問題の兆候が浮上してから30分以内に警報を出すことで、安全・セキュリティ・研究の各チームが30分以内に誤検知だと結論づけられなければ、その作業を止めるのが原則だ。この監視にかかる計算資源は監視対象の推論のおよそ20%だという。
安全のために公開を遅らせるという語り自体は2019年のGPT-2の頃からあった。変わったのは、その横に数字が付いたことだ。監視に20%を使うという言葉は、安全が声明ではなく原価項目になったという意味である。
AIはがんワクチンのどこで働いたのか
8月19日、メルクとモデルナが個別化mRNAがんワクチンの第3相結果を発表した。手術で腫瘍を切除したステージIIB〜IVの黒色腫患者1,137人を2対1に分け、個別化ワクチンintismeran(mRNA-4157)とキイトルーダを併用した群と、キイトルーダ単独の群を比較した。再発までの時間(無再発生存)と他臓器へ転移するまでの時間(無遠隔転移生存)の両指標で、併用群が上回った。
この知らせを扱った記事の多くはAIに触れていない。だがAIが実際に働いた場所がある。モデルナ自身の説明によれば、統合されたAIアルゴリズム群が患者の腫瘍と血液試料から得られた次世代シーケンシングデータを受け取り、遺伝子変異を精査して、免疫反応を引き起こす可能性が最も高いネオ抗原を最大34個まで予測する。
ネオ抗原とは、がん細胞にだけ生じた変異から作られ細胞表面に現れるタンパク質の断片で、免疫細胞に「これは自分のものではない」と知らせる目印になる。患者ごとにがん細胞の変異が違うのでワクチンの成分も患者ごとに変わり、何を入れるかを選ぶ作業がそのまま予測問題になる。
大規模言語モデルがやったことではない。文章を生成したわけでもない。シーケンシングデータから確率を計算して候補を絞った予測モデルだ。AIの実質的な成果を見るとき、生成的かどうかより「どの判断を代わりに担ったか」を先に見るほうが正確なのは、このためである。
ウェブページの3分の1がAIの文章という調査は何を測ったのか
8月20日、ピュー・リサーチ・センターが「インターネットのどれだけがAIで書かれているか」という調査を出した。Common Crawlのウェブアーカイブから直近5年分の英語ウェブページを50万件近く集め、Open Pangramという検出ツールでAIが書いた、あるいは大幅に手を入れた痕跡があるかを判定した。
2026年7月の全標本では10%が引っかかった。低く見えるが、この標本にはChatGPTが登場する前に作られたページが混ざっている。そもそもAIが書きようがなかったページだ。ChatGPT公開後に掲載されたページだけを取り出すと、比率は3分の1を超える。
検出ツールによる判定という限界はある。AI執筆の検出には誤検知も見落としもあり、人が書いたあとAIで整えた文章をどちらに数えるかもツールによって異なる。それでも方向ははっきりしている。2022年末から今まで比率は上がり続けた。
実務でこの数字が意味することは単純だ。検索結果の上位で人が書いた一次情報に出会うことが、すでに確率の問題になっている。出典をたどって確かめる習慣が、勤勉さではなく基本動作になる局面である。
グーグルはなぜ透かしを任意にしたのか
8月14日、グーグルがAI生成物に付いていた目に見える透かしを消せるようにした。画像、動画、楽曲のすべてが対象だ。設定のメディア透かしの項目で切り替え、Geminiと動画編集ツールFlowに先に入り、検索は後日となる。対象モデルはNano Banana、Omni、Lyriaだ。
消えるのは目に見える表示だけだ。見えないSynthIDの透かしとC2PAメタデータはそのまま残る。SynthIDはピクセルや波形に人の目や耳ではわからない信号を埋め込む方式で、C2PAはファイルに来歴を付ける業界標準だ。したがってGeminiや検索に尋ねればAI生成かどうかは今も確認できる。
会社側の説明は創作のコントロールと安全の間のバランスだ。実際、目に見える透かしは業務用の成果物の使い勝手を下げる。資料に入れる画像の隅にロゴが焼き付いていればそのまま使えない。
ただし負担の位置が変わる。以前は作る側が表示を付け、見る側は目で選り分けた。これからは見る側がツールに尋ねなければわからない。確認手段が残っていることと、人々が実際に確認することは別の話である。
ClaudeとChatGPTがメールとメッセージを代わりに送る
8月18日、AnthropicがClaudeのGoogle Workspaceコネクタを拡張した。Gmailでは自然言語で検索して読むだけでなく、下書きを書いて送信・返信・転送まで行う。Google Driveでは文書を取ってくることに加えて共有・移動・ゴミ箱への移動を行う。同じ日にClaude Coworkのモバイルとウェブのアクセスが全有料アカウントに開かれた。
既定では行動ごとにユーザーの承認を取る。重要な但し書きが一つある。チーム版とエンタープライズ版では、組織のオーナーがメンバーごとに承認なしで実行できるよう開放できる。つまり個人が入れるスイッチではなく、組織が決める方針だ。
2日後の8月20日には、OpenAIがMac版ChatGPTにAppleメッセージのプラグインを付けた。メッセージの受信箱をつなぐと、チャット画面の中でメッセージを分類し、分析し、手を入れられる。下書きを書いて送ること、古いやり取りから情報を探してくること、メッセージを削除することまでできる。CodexとChatGPT Workでも動くので業務用にも使える。
ここで実務者が押さえるべき区別が一つある。読み取り権限と送信権限は、事故が起きたときの回収可能性が違う。読み違えたものは正せるが、誤送信したメールやメッセージはすでに相手の画面に届いている。承認の既定値を組織が切れるという条項が契約レビューで飛ばしてはいけない箇所である理由が、そこにある。
コーディングエージェントがチームのチャンネルに入ると何が変わるか
8月20日、SalesforceがSlack Codeを公開した。Slackのチャンネルの中でコーディングエージェントに仕事をさせ、チーム全員が何が起きているかを会話のレベルで見る。Claude Code、Vercelのv0、CognitionのDevin、OpenAIのChatGPTといった既存のエージェントをタグで呼ぶ構造なので、エージェント自体がSlackの中で動くわけではない。
Slackの最高マーケティング責任者は、個人作業を一人でやるスポーツにたとえ、そうすると知識と速度が個人にとどまり組織はその分を得られないと述べた。マーケティングの言い回しを取り除くと、実際の変化が一つ残る。仕様がやり取りされる場所と、コードが作られる場所が隣り合うということだ。
これまでコーディングエージェントの成果物は一人のターミナルの中にあった。何を頼み、エージェントがどう理解したかは、その人だけが見ていた。企画や運用の担当が途中で「それはそういう意味ではなかった」と割り込む場所がなかった。チャンネルへ移すとその場所ができる。
AXの観点では、これはツール導入ではなく業務配置の問題だ。エージェントをどこに置くかが、誰がその作業を検証できるかを決める。
ChatGPTが年齢を推定するとはどういう設計か
8月18日、OpenAIがChatGPT for Teensを公開した。要点は振り分け方にある。システムが利用者を18歳未満と推定するか、本人が13〜17歳だと述べると、自動的にこの版に入る。年齢を確認する手続きではなく、推定する手続きだ。
中身は学習寄りにそろっている。答えをすぐに渡す代わりに問いと段階で導くStudy Mode、課題をそのまま飛ばそうとする気配を察知してStudy Modeへ戻す宿題リマインダー、クイズと学習の可視化、そしてティーンや保護者がStudy Modeを既定でオンにする時間帯を指定するStudy Hoursがある。
推定にもとづく振り分けには対称的な結果がついてくる。大人でも会話の仕方がそう読まれればティーン版に行きうる。逆にティーンが大人のように書けばすり抜けうる。年齢確認を強制せずに保護を入れようとする設計の代価だ。
企業にとって注目すべき点は別のところにある。身元確認なしに行動だけで利用者を分類し、別の製品を出す構造が実サービスに入ったということだ。同じ設計は年齢以外の軸にも使える。
音楽モデルとロボット — 残りの2件
8月17日、アリババが音楽生成モデルHappyShrimp 1.0をベータ公開した。雰囲気や物語、ジャンルを書けば、旋律と編曲と歌詞を書き、歌まで歌う。歌詞を自分で入れて曲だけ付けさせることも、器楽曲だけを頼むこともできる。中国風、ポップ、R&B、ヒップホップ、ロック、ファンク、エレクトロニック、クラシック、ジャズを扱い、楽器編成やボーカルのスタイル、曲の中でエネルギーがどう上下するかまで指定できる。会社の説明では、音を生成する前に曲の構造とリズムの展開、和声進行を先に設計する。
この市場の既存の名前はSunoとUdioだ。二社とも2024年の全米レコード協会による著作権訴訟を経て交渉のテーブルに来た。アリババは3月に新設したAlibaba Token Hubでこのモデルを作り、最初から太合音楽集団とアーティストの共同制作を行うと明かした。訴訟で入った場所に、契約で入ってきたわけだ。
同じ日、ユニツリーがヒューマノイドロボット「Superman」を公開した。立ち幅なしの高跳び2メートル、最高速度は秒速12.66メートル、時速では45.6キロメートル。脚の長さは0.85メートルだ。会社は世界の人間の立ち高跳び記録と走行速度記録をいずれも超えたとし、最適化の余地が大きく残っているため今後数か月で性能がさらに上がりうると付け加えた。
数字より目に留まるのは期間だ。開発にかかった時間が3か月あまりである。ロボットが人より高く跳び速く走ること自体は、もう驚きではない。その差が一四半期で作られたという側が、計画の時間単位を見直させる。
では今週、何をすればよいか
第一に、いま使っているAIツールの権限一覧を一度開いてみる。メールアカウントやファイル保管庫をつないでいるなら、その接続が読み取りまでか、送信・削除までかを確認する。ClaudeのGoogle Workspaceコネクタなら設定でコネクタごとの権限と承認の既定値が見え、ChatGPTならプラグイン一覧で同じものを見る。個人アカウントと組織アカウントで既定値が異なりうる点も併せて確認する。
第二に、チームで使っているなら承認の既定値を誰が決めるのかを文書に残す。チーム版とエンタープライズ版はオーナーがメンバーごとに承認なしの実行を開放できる。誰がその権限を持ち、開放した記録がどこに残るかが、事故のあとに唯一残る根拠になる。
第三に、資料調査のやり方に確認の段階を一つ入れる。検索結果からそのまま引用せず、一次出典のページを開いてその文が実際にあるかを見る。ChatGPT以降に掲載されたページの3件に1件でAI執筆の痕跡が出る環境では、この一段階が文章の信頼度を分ける。
第四に、外部に出す画像や動画は出典を別に書き留めておく。目に見える透かしが消えれば、数か月後にそのファイルがどこから来たかはファイルだけでは分からない。作るときに一行書いておく費用のほうが、あとで探す費用よりはるかに安い。