問いに数字を乗せる瞬間
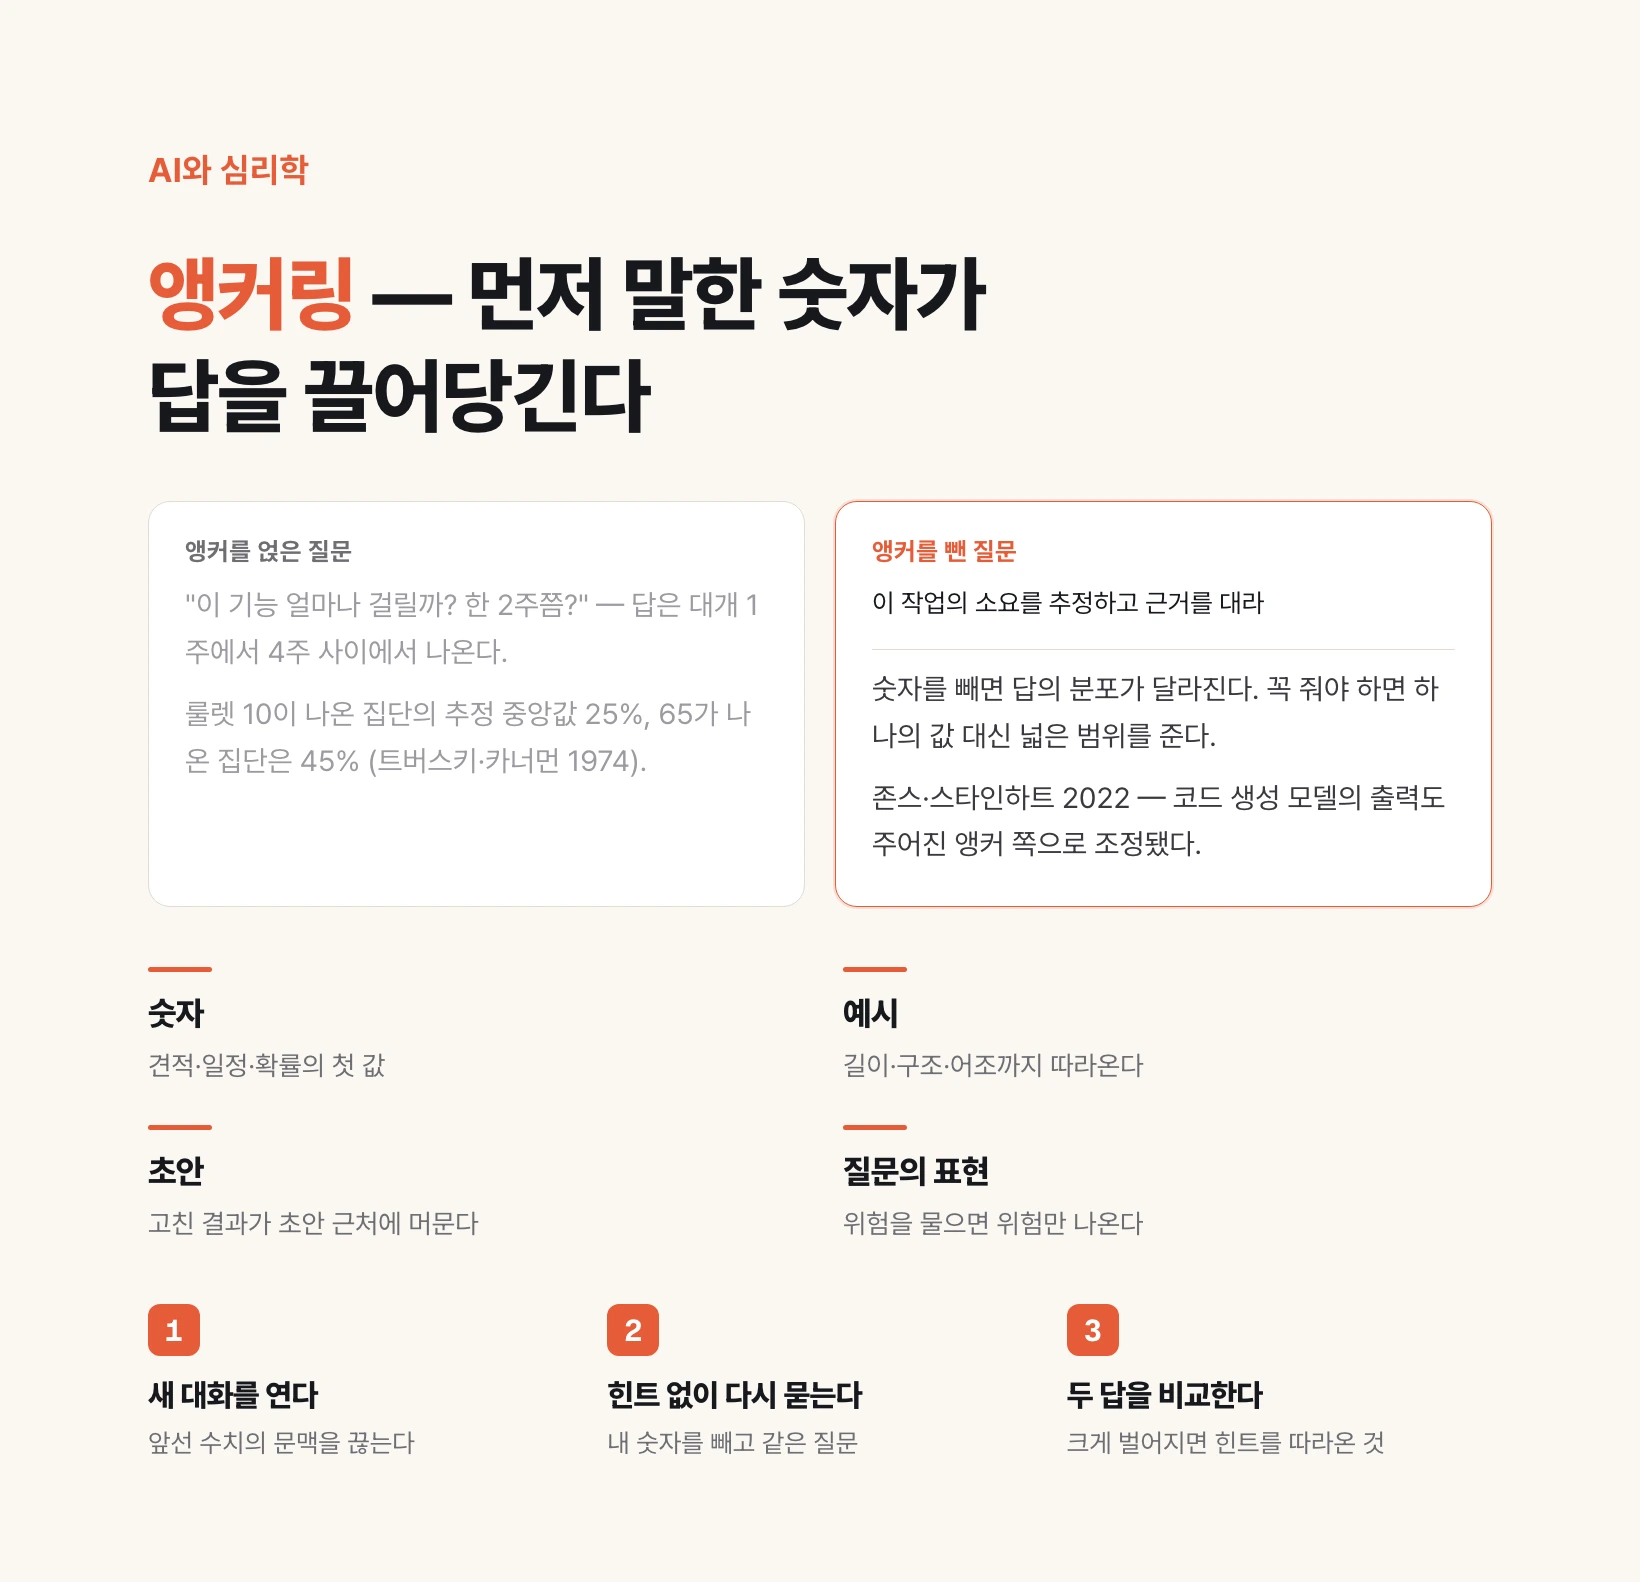
こう尋ねたことがあるはずだ。この機能の開発にどれくらいかかる? 二週間くらい?
この問いにはすでに答えが半分入っている。二週間という数字が出たあと、答えはたいてい一週間から四週間のあいだで出てくる。三か月という答えはめったに出ない。実際が三か月でもそうだ。
親切に尋ねたことが問題である。相手が見当をつけやすいようにと添えた数字が、相手の答えをあらかじめ狭めていた。
そしてこれは人にだけ起きることではない。AIに尋ねるとき、私たちはほとんど常にこの尋ね方をしている。
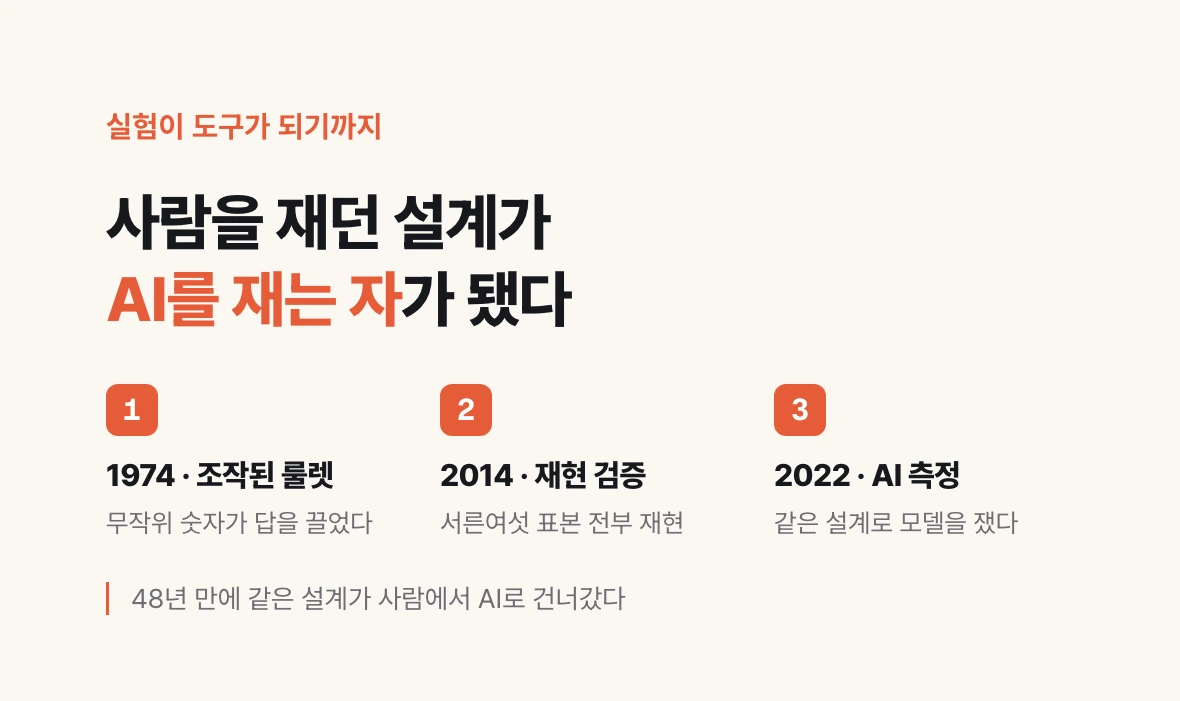
1974年、細工されたルーレット
エイモス・トベルスキーとダニエル・カーネマンの実験設計は、いま見ても大胆だ。
参加者の前に0から100までが書かれたルーレットを置いて回す。参加者は知らないがこのルーレットは細工されていて10か65にしか止まらない。数字が出たら二つを尋ねる。国連加盟国のうちアフリカの国の割合は、いま出た数字より高いか低いか。そして実際には何パーセントだと思うか。
結果はこうだ。10が出た群の推定値の中央値は二十五パーセント、65が出た群は四十五パーセントだった。
同じ問いである。違うのは先に回ったルーレットの目盛りだけだ。それで二十パーセントポイントが分かれた。
この実験が特別な理由
アンカリングを示す実験は多いが、この設計が引かれ続けるのには理由がある。その数字が情報ではないことを参加者が自分の目で見ているという点だ。
参加者はルーレットが回るのを目の前で見た。その数字が偶然出たことを知っているし、それがアフリカと何の関係もないことも知っている。情報として扱う理由が一つもない。それでも引っ張られた。
しかも正確に当てたら報酬を出す条件でも効果は減らなかったと元の論文に書かれている。もっとよく考えれば抜け出せる類ではないという意味だ。
だからアンカリングは情報を誤って使った事例ではなく、情報でないものが判断の出発点になる現象として整理される。出発点が決まれば、あとはそこから少しずつ動かす作業しか残らない。
アンカリングは再現性の危機を通り抜けた
前回はバートレットの実験が六十七年かかってようやく再現された話をした。心理学の有名な結果には、測り直すと揺らいだものが少なくない。ではアンカリングはどうか。
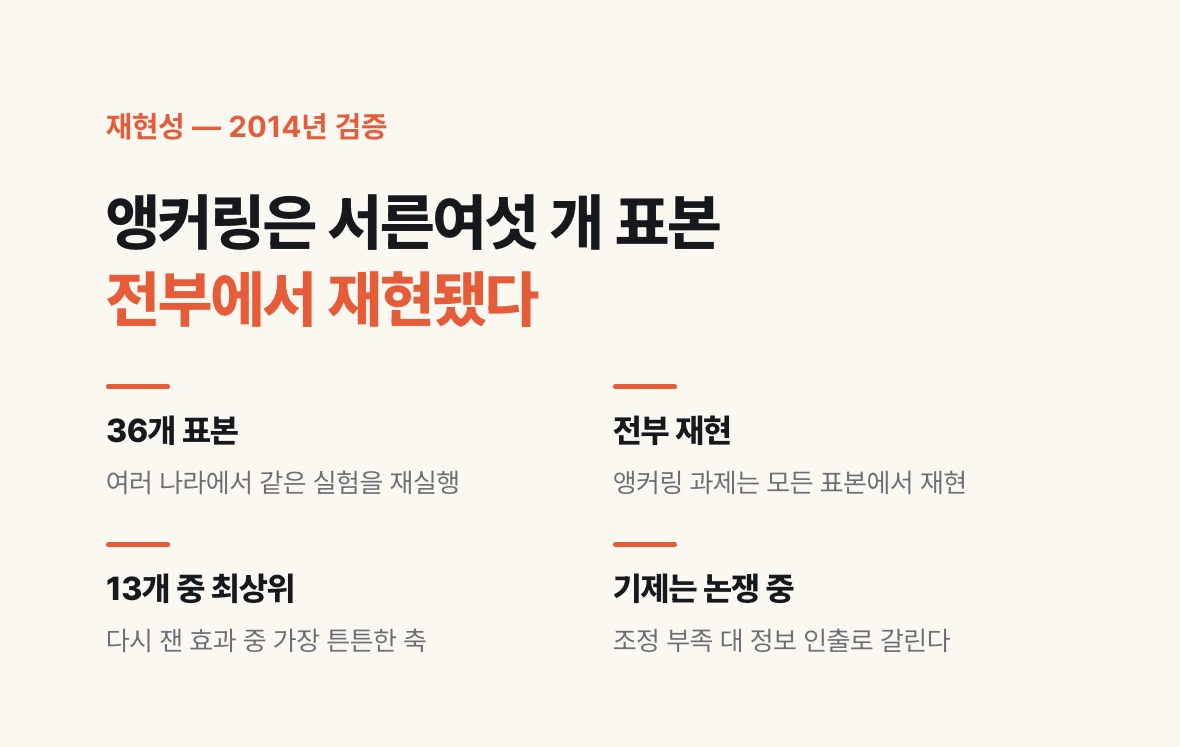
ここは事情が違う。2014年に複数の国の三十六の標本で同じ実験群をやり直した大規模な再現プロジェクトがあり、アンカリング課題はすべての標本で再現された。測り直した十三の効果のうち最も頑丈な部類に入った。
わざわざこれを指摘するのは、この連載が引く実験ごとに基準が違うからだ。概念だけが生き残ったものもあれば、数字まで生き残ったものもある。アンカリングは後者である。
ただしなぜ起きるのかについては今も論争がある。出発点から十分に動かせないという説明と、アンカーがそれと整合する情報を先に頭の中に呼び出すという説明が分かれている。現象は確かで機構は開いている。
2022年、同じ原理でAIを測る
この回が前のいくつかと違う点がここにある。アンカリングはAIを作るのに使われた理論ではなく、AIを測るのに使われる道具だ。だからバッジが系譜でも比喩でもなく診断である。
エリック・ジョーンズとジェイコブ・スタインハートが2022年にやったのがそれだ。ルーレット実験をそのまま移したのではなく、人の認知バイアスの一覧を持ってきて、モデルが誤りそうな入力を設計する物差しとして使った。
この発想がなぜ有用か。大きなモデルは失敗事例を無作為に見つけるのが難しい。ほとんどの入力でうまく動くので、どこを突けばよいか分からない。ところが人がどういう条件で体系的に誤るかは数十年分の一覧がすでにある。その一覧を試験問題として使えば、無作為な探索よりはるかに効率よく失敗を見つけられる。
コード生成モデルで試した結果、モデルは入力をどう表現するかによって予測どおりに誤り、出力が与えられたアンカーのほうへ調整された。論文の表現ではこのバイアスは頑健で、測定可能で、解釈可能だ。
つまり心理学の実験設計がそのままAIの評価道具になった。いまお世辞、フレーミング、心の読み取りを測る研究はすべてこの系列である。
なぜこうなるのか — 人とAIで理由が違う
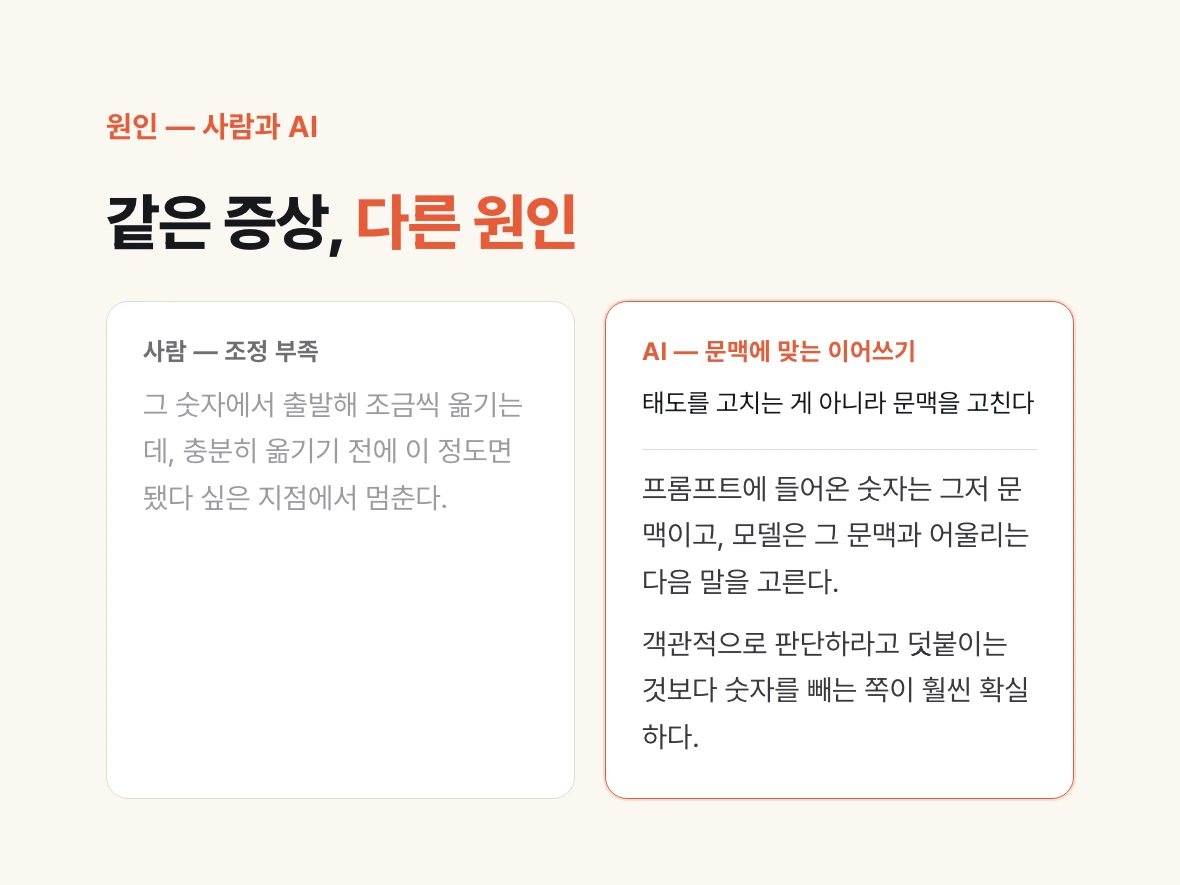
人の側の説明は調整不足だ。まずその数字から出発して少しずつ動かすのだが、十分に動かす前にこのくらいでいいと感じる地点で止まってしまう。
AIの側は別の話である。プロンプトに入ってきた数字は単なる文脈で、モデルはその文脈に合う次の語を選ぶ。二週間くらいという語が入っている文脈で自然に続く答えは三か月ではない。偏った判断ではなく文脈に合った書き継ぎだ。
ところが結果は人のアンカリングと同じ方向に出る。同じ症状、違う原因である。
この区別が実務で値を持つ理由がある。原因が文脈なら、対応は態度を直すことではなく文脈を直すことだ。客観的に判断せよと付け足すより、数字を抜くほうがはるかに確実である。
アンカーは数字だけではない
アンカリングを数字の話にとどめると実務では半分を落とす。先に入ってきたものが後のものを引っ張る構造は形式を選ばない。
例示が代表的だ。こういう調子で書いてくれと例を一つ添えると、結果はその例の長さ、文の作り、語調まで付いてくる。指示として書いた要件より、添えた例一つのほうが強く効くことがざらにある。
草稿もアンカーだ。第一案を渡して直してくれと頼むと、直った結果は第一案の近くにとどまる。まったく違う筋を出すには草稿を消してやり直すしかない。
問いの言い回しもアンカーである。この計画の危険を挙げてくれと頼めば危険の一覧が出て、この計画の強みを挙げてくれと頼めば強みの一覧が出る。同じ計画なのに二つの答えは正反対の印象を残す。ジョーンズとスタインハートが試したバイアスの一覧にこのフレーミングも入っている。
まとめると、アンカーとは先に入ってきたすべてだ。数字はそのうち最も目立つ形にすぎない。
用語は一つだけ、アンカリング
アンカリングとは、先に示された値がその後の判断の出発点になり、結果をそちらへ引き寄せることである。
肝心なのはその値が根拠である必要がないという点だ。ルーレットの数字でも掛かる。根拠と認めたことがなくても出発点の役は果たす。
だからアンカリングの反対は正確な情報を与えることではなく、先に何も与えないことだ。よいアンカーと悪いアンカーを選ぶ問題ではなく、アンカーを置くか置かないかの問題である。
実務でアンカーが潜んでいる場所
最もよくある場所は他人がくれた数字だ。相手が出した見積もりをそのまま貼って、これは妥当かと尋ねると、その金額がすでにアンカーである。答えはそれが妥当な理由と少し削れる余地のほうへ集まる。最初から桁の違う答えはなかなか出てこない。
以前の対話もアンカーだ。同じ画面で先にある数値を話していれば、それが残って文脈として働く。第4回で見た作業台の話と重なる場所である。
例示のコードやテンプレートもアンカーだ。似ているが違う関数を文脈に入れておくとモデルがそちらへ引っ張られて誤ったコードを出す傾向が、ジョーンズとスタインハートの実験で確認されている。
そして自分がすでに心を決めた状態で投げる問いが最も危ない。この方向で大丈夫だよねと尋ねると、アンカリングと第5回のお世辞が同じ方向に重なる。二つの力が一方へ押せば、返ってくるのは検証ではなく承認だ。
では明日から何を変えるか
見積もりを尋ねるときは自分の数字を抜いて尋ねる。二週間くらいかかるかではなく、この作業の所要を見積もって根拠を示せと尋ねる。一文を直しただけで答えの分布が変わる。
どうしても数字を出すなら幅で出す。一つの値は磁石で、幅はそれより弱い。一週間から三か月のあいだのどのあたりかは、二週間くらいよりよい。幅を広く取るほどアンカーの力は弱まる。
重要な数字はアンカーなしでもう一度尋ねる。新しい対話を開き、ヒントのない問いでもう一度受け取る。二つの答えが大きく開くなら、その見積もりは根拠ではなくこちらのヒントに付いてきたものだ。第5回の対称検査を数字に使うということである。
他人の見積もりは金額を消して入れる。仕様と条件だけを入れて先に見積もらせ、その結果と相手の金額を比べる。順序を変えただけで判断が独立して出てくる。
例示は形式だけ残して中身を消す。参考の例を添えるときは欲しい構造だけ残し、具体的な文や数値は取り除く。そうしないと結果がその例の変奏になる。
まとめるとこうだ。答えを聞きたければ、答えを先に言わない。