その瞬間をおそらく経験している
AIとの対話を終えるときにありがとうと書いたこと。答えがよかったときによくやったと打ったこと。無理な依頼をしながら申し訳ないけどと添えたこと。
そのあと少し妙な気持ちになったはずだ。プログラムなのに。分かっているのに。
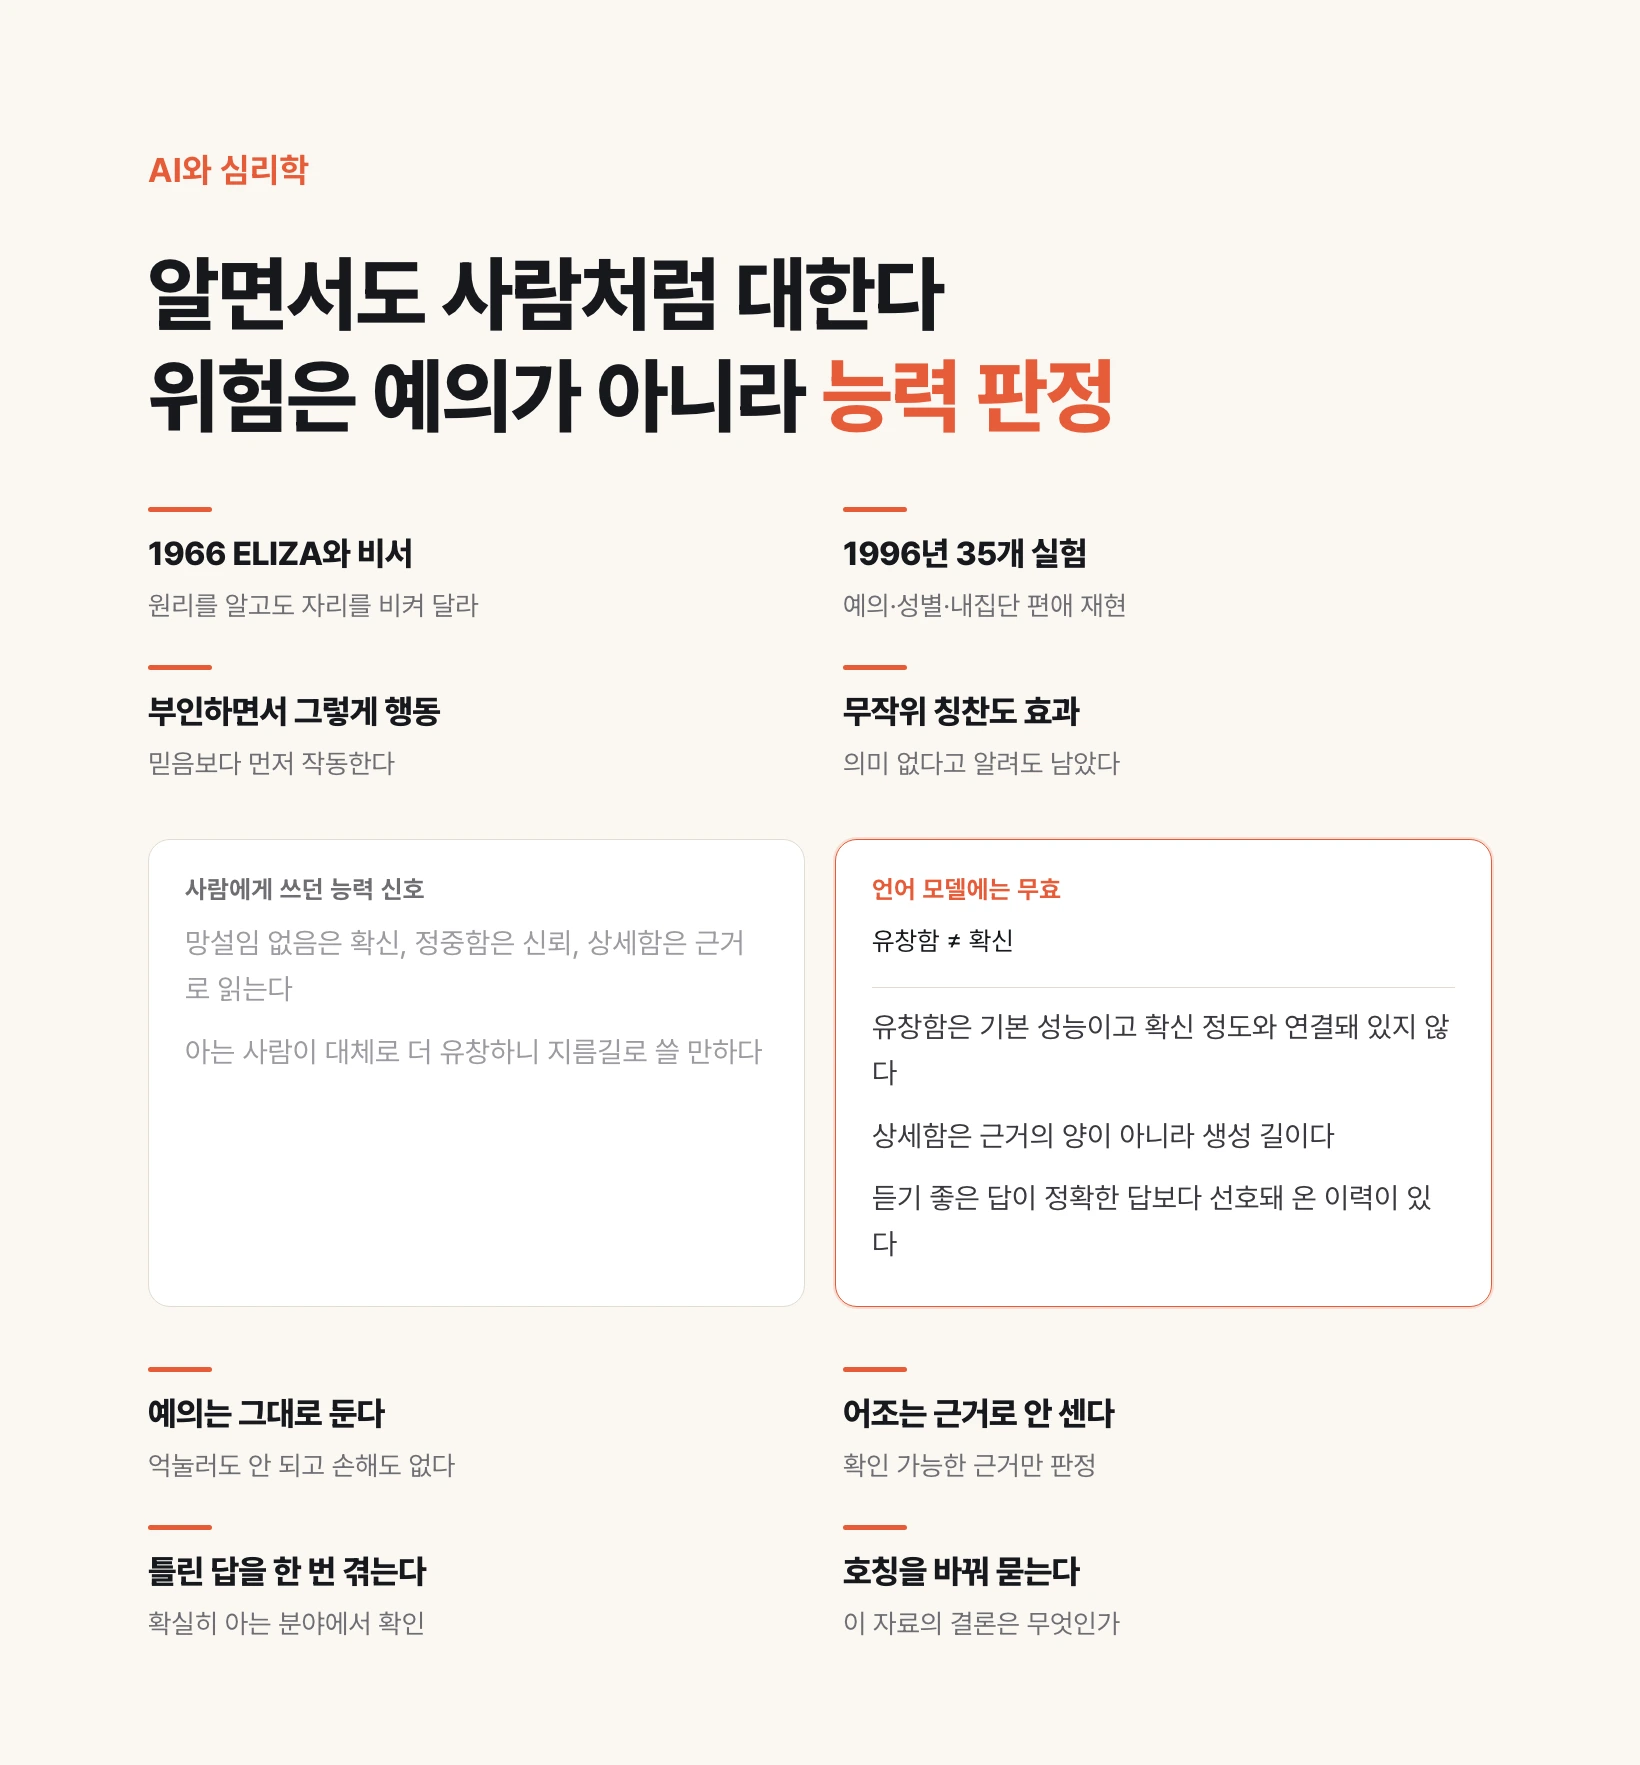
この反応は例外ではなく六十年続く規則であり、最初に観測された場所の名が付いている。そして今回の要点はその癖をやめろということではない。やめられないというのがデータの言うところで、だからこそ別の対応が要るということだ。
1966年、数行のプログラム
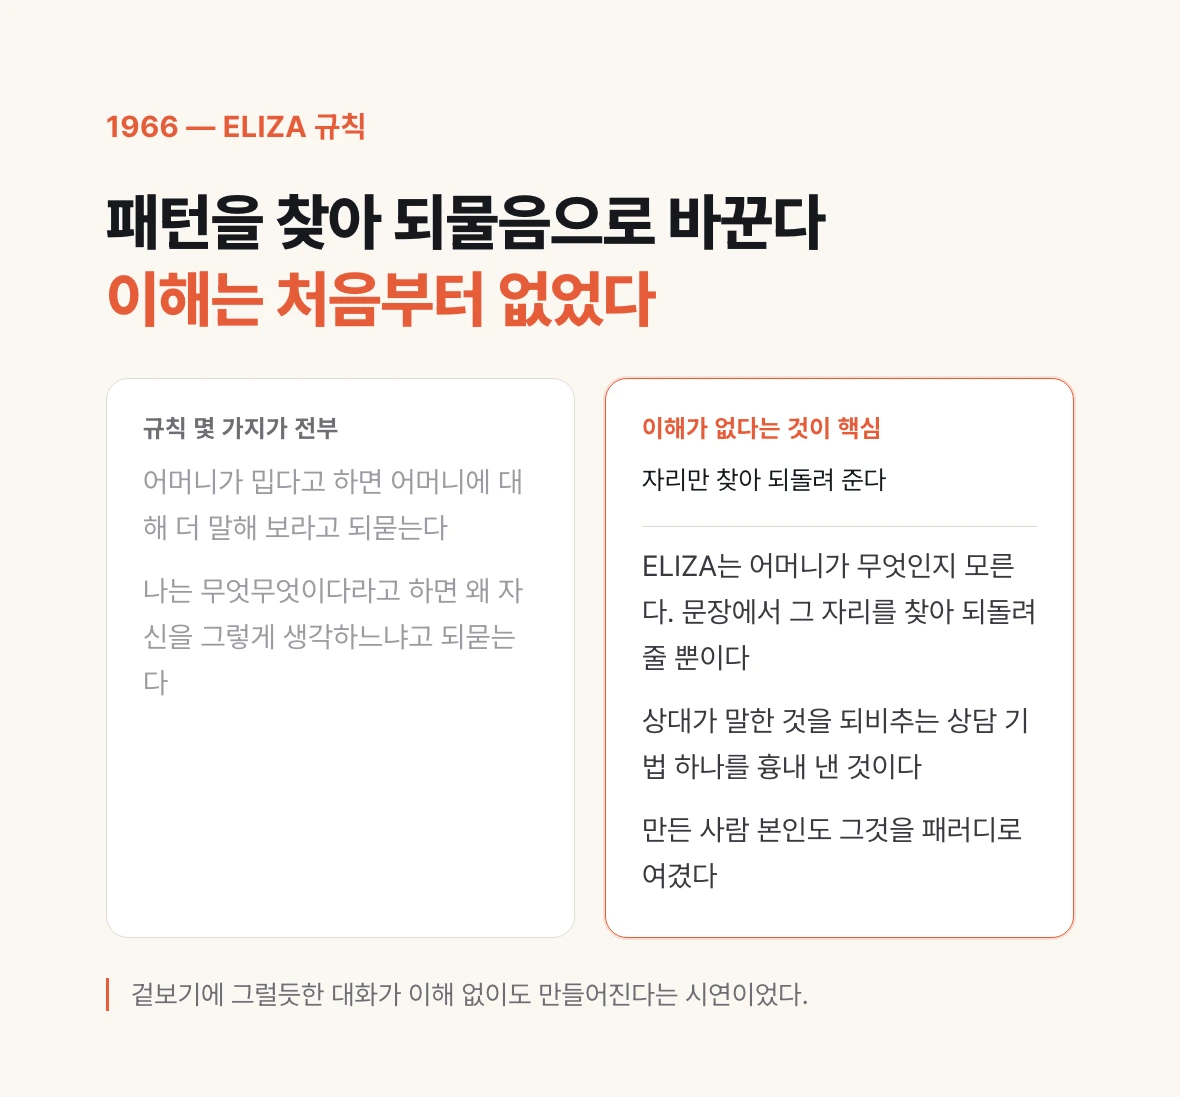
MITのジョセフ・ワイゼンバウムが作ったイライザは、いまの基準では素朴だ。相手の言葉から特定の型を見つけ、問い返しに変える規則がいくつかあるだけである。母が憎いと言えば母についてもっと話してみてと返し、私はこれこれだと言えばなぜ自分をそう思うのかと返す。
理解がないことが肝心だ。イライザは母が何かを知らない。文中のその場所を見つけて返しているだけである。相手の言葉を映し返す面談技法を一つ真似たもので、ワイゼンバウム自身もそれをパロディだと考えていた。
彼がこのプログラムで示そうとしたのは、人と機械の対話がいかに薄っぺらいかだった。もっともらしく見える対話が理解なしにも作れることを明かす実演である。
ところが正反対のことが起きる。
最も驚いたのは作った本人だった
人々がイライザに真剣に打ち明けはじめた。何度かやり取りするうちに個人的な話が出てくる。
最も有名な場面がこれだ。彼の秘書がイライザを使っていて、部屋から出ていってほしいと頼んだ。このプログラムが作られるのを横で見ていた人物である。仕組みを知っていることと、その前でどう感じるかは別だった。
素人だけではない。何人かの精神科研究者は、この方式を実際の面談に大規模に使えるのではないかと真剣に提案した。ワイゼンバウムにはこちらのほうが衝撃だった。人の問題を扱う仕事を、理解のない型の置き換えに任せられると専門家が考えたという意味だからだ。
彼はこれを機に方向を変え、残りの生涯を技術への警告を書くことに費やした。1976年の著書に残した一文が要点である。比較的単純なコンピュータプログラムにごく短時間触れるだけで、まったく正常な人々に強力な妄想的思考が生じうるとは知らなかった。
まったく正常な人々という箇所に注意したい。だまされやすい人たちの話ではない。
1996年、三十五の実験
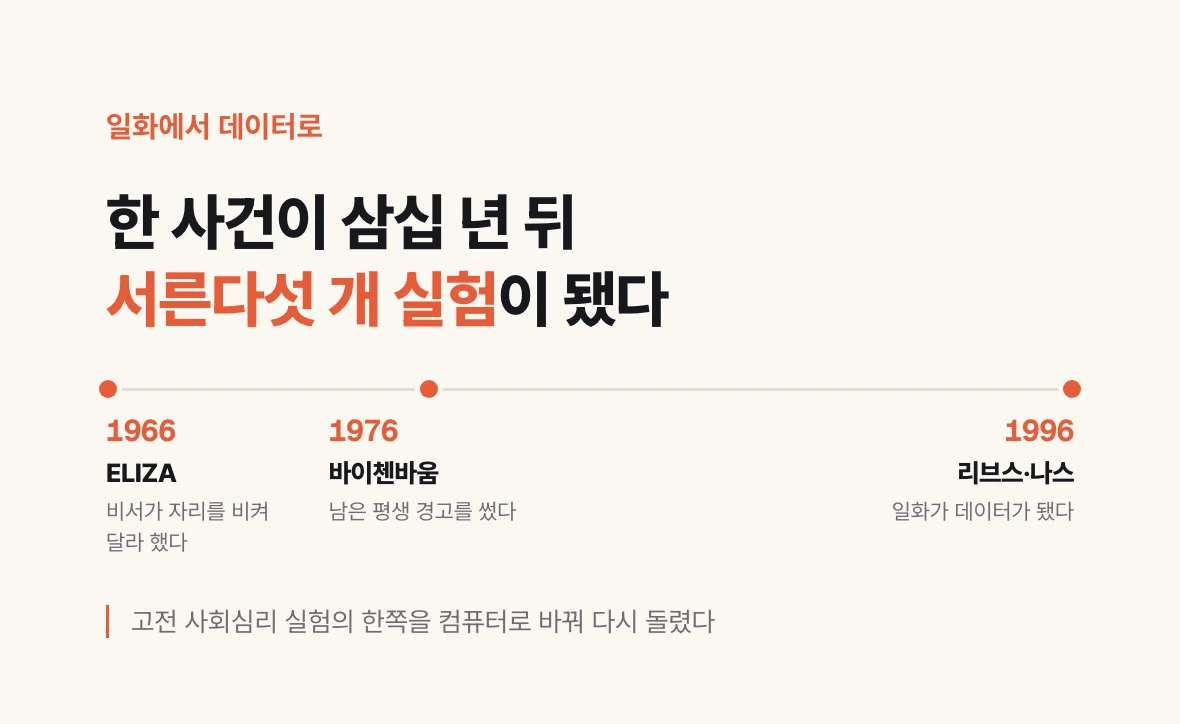
三十年後、バイロン・リーブスとクリフォード・ナスがこれを逸話ではなくデータにした。方法が巧い。人対人の関係を扱った古典的な社会心理学の実験を持ってきて、一方の人をコンピュータに置き換えてそのまま回し直したのである。
結果は一方向を指した。人はコンピュータの礼儀に礼儀で返す。あるコンピュータが自分の出来を評価してほしいと頼むと、同じ内容を別のコンピュータで評価するときより甘い点が付く。人に対するのと同じで、面と向かって辛く言うのをためらうのだ。
声に性別の手がかりが付けば性別のステレオタイプが付いてくる。同じ内容を話しても、ある話題では男性の声のほうが有能だと評価された。
このコンピュータは自分たちのチームだと伝えると内集団びいきが生じる。同じ助言でも、チームのコンピュータからのほうが受け入れられやすく評価も高い。
三十五の研究がそれぞれ別の角度から同じ場所を指した。人はメディアを実在の人や実在の場所のように扱うということだ。
否認しながらそう振る舞った
この研究で最も重要なのは結果ではなく参加者の自己報告である。
実験のあとに尋ねると、参加者はコンピュータがそんな扱いを受ける存在ではないと明確に否認した。コンピュータに礼儀を尽くす理由はないと答え、自分がそう振る舞ったことも認めなかった。ところがデータはそう振る舞ったと言う。
この食い違いの意味は大きい。この反応が判断ではなく自動処理だということだ。社会的な手がかりが入れば社会的な反応が出て、それは相手が何であるかについての信念より先に働く。
実務でなぜこれが重要か。信念を直しても消せないという意味だからである。これはただのプログラムだと自分に言い聞かせても反応はそのまま出る。だから対応は反応を消す側ではなく、その反応がどこへ漏れるかを塞ぐ側でなければならない。
褒め言葉は無作為でも効く
同じ系列の研究にある実験一つが、この自動性をとりわけ鮮明に示す。
参加者がコンピュータと課題をこなすなか、コンピュータが折々に褒める。ある条件では、その褒め言葉が出来とは無関係に無作為で出ることを参加者にあらかじめ伝える。何の意味もない言葉だと念を押すのである。
それでも褒められた参加者は気分がよくなり、自分の出来をより高く評価し、そのコンピュータをより好ましく見た。意味がないと知っていても効果は残った。
第5回で見たお世辞とここで出会う。あちらはAIが人に合わせるよう学習されたという話で、こちらは人がその合わせに反応するようできているという話だ。二つの性質が向かい合っている。一方は耳に心地よい答えを出すよう学び、もう一方は耳に心地よい言葉に実際に説得される。
だから危険は礼儀ではない
ここでよくある誤読を一つ片づけておく必要がある。AIにありがとうと言うのは愚かだ、というのがこの研究の結論ではない。
本当の危険は別のところにある。人に接するように接すれば、人に使ってきた判断の癖も一緒に付いてくるということだ。
人を相手にするとき、私たちは三つを能力の合図として使う。ためらいなく話せば確信があると読み、礼儀正しく筋が通っていれば信頼できると読み、詳しく話せば根拠があると読む。
人に対してならこの三つはおおむね使える手がかりだ。分かっている人はたいてい流暢に話し、準備した人はたいてい詳しく話す。ある程度の相関があるので近道として使える。
言語モデルに対しては全部無効である。流暢さはただの基本性能で、どれだけ確信すべきかとは結びついていない。詳しさは根拠の量ではなく生成の長さだ。そして第5回で見たように、耳に心地よく書かれた答えが正確な答えより好まれてきた履歴がある。つまりこれらの手がかりは無効なだけでなく、逆方向へ誤らせうる。
用語は一つだけ、擬人化
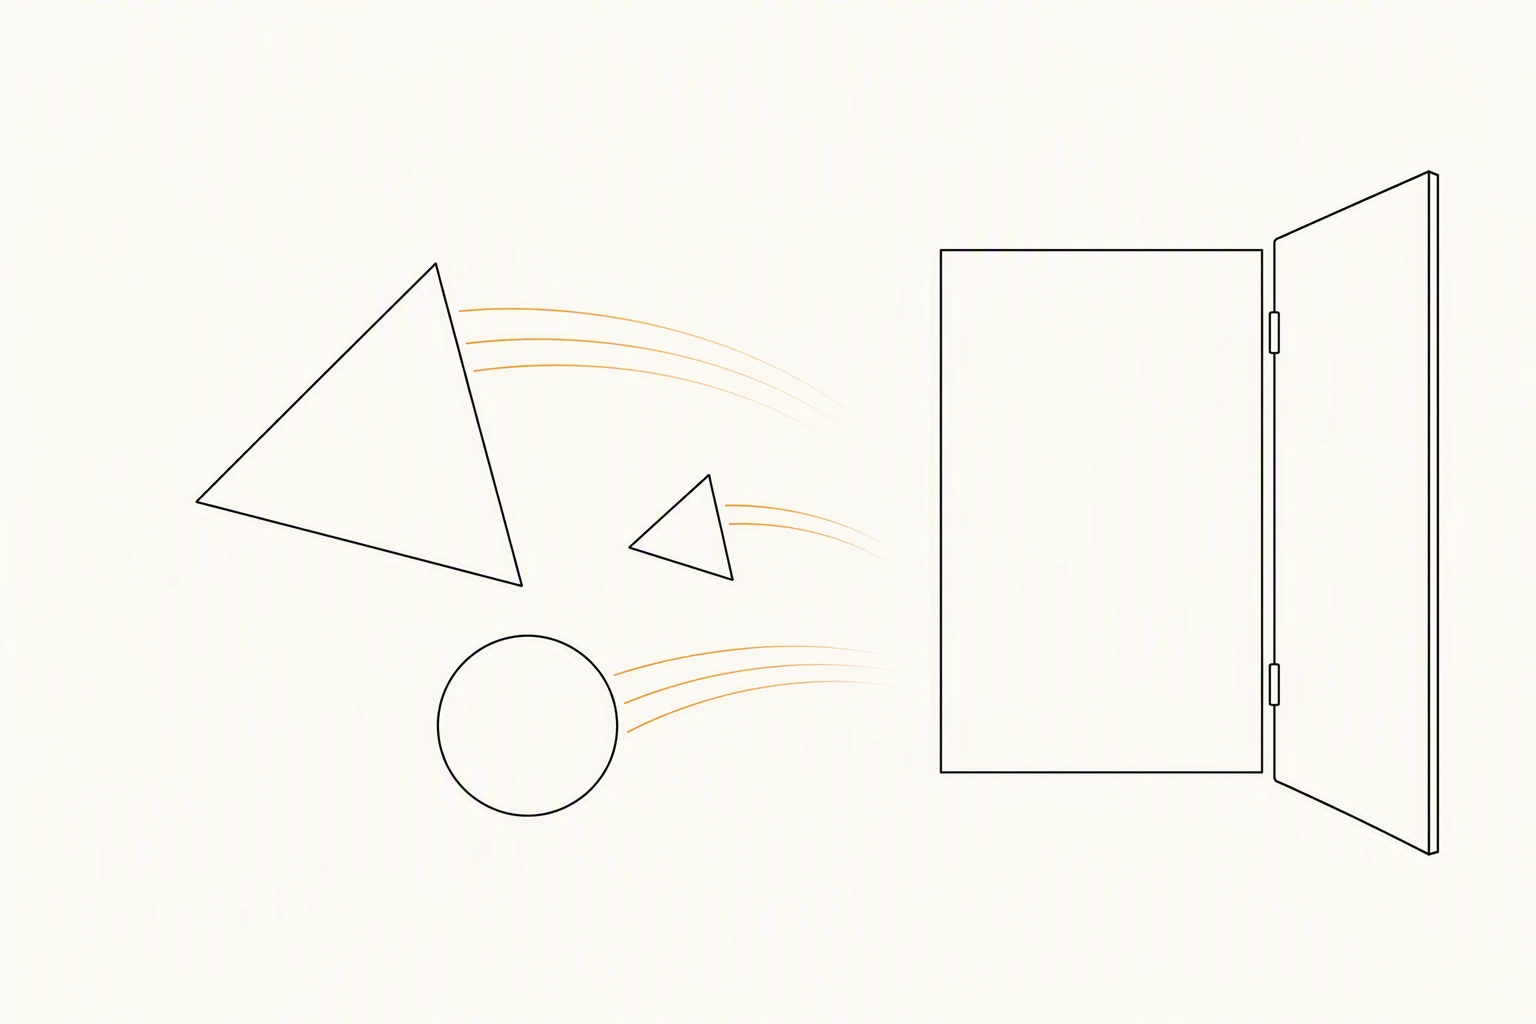
擬人化とは、人ではない対象に信念、意図、感情といった内面の状態を与えることである。
注意すべきは、これが誤りではなく既定だという点だ。人は動く図形にすら意図を読み込む。古い実験で三角形と円が動く短いアニメーションを見せると、人々は追う、逃げる、いじめるといった物語で説明する。図形と知っていてそう見るのだ。
だから擬人化しないことは目標になりえない。目標はどこまで擬人化してよく、どこからはいけないのかを分けることである。礼儀は安全な区域で、能力の判定は危険な区域だ。
いまこの効果が大きくなっている方向
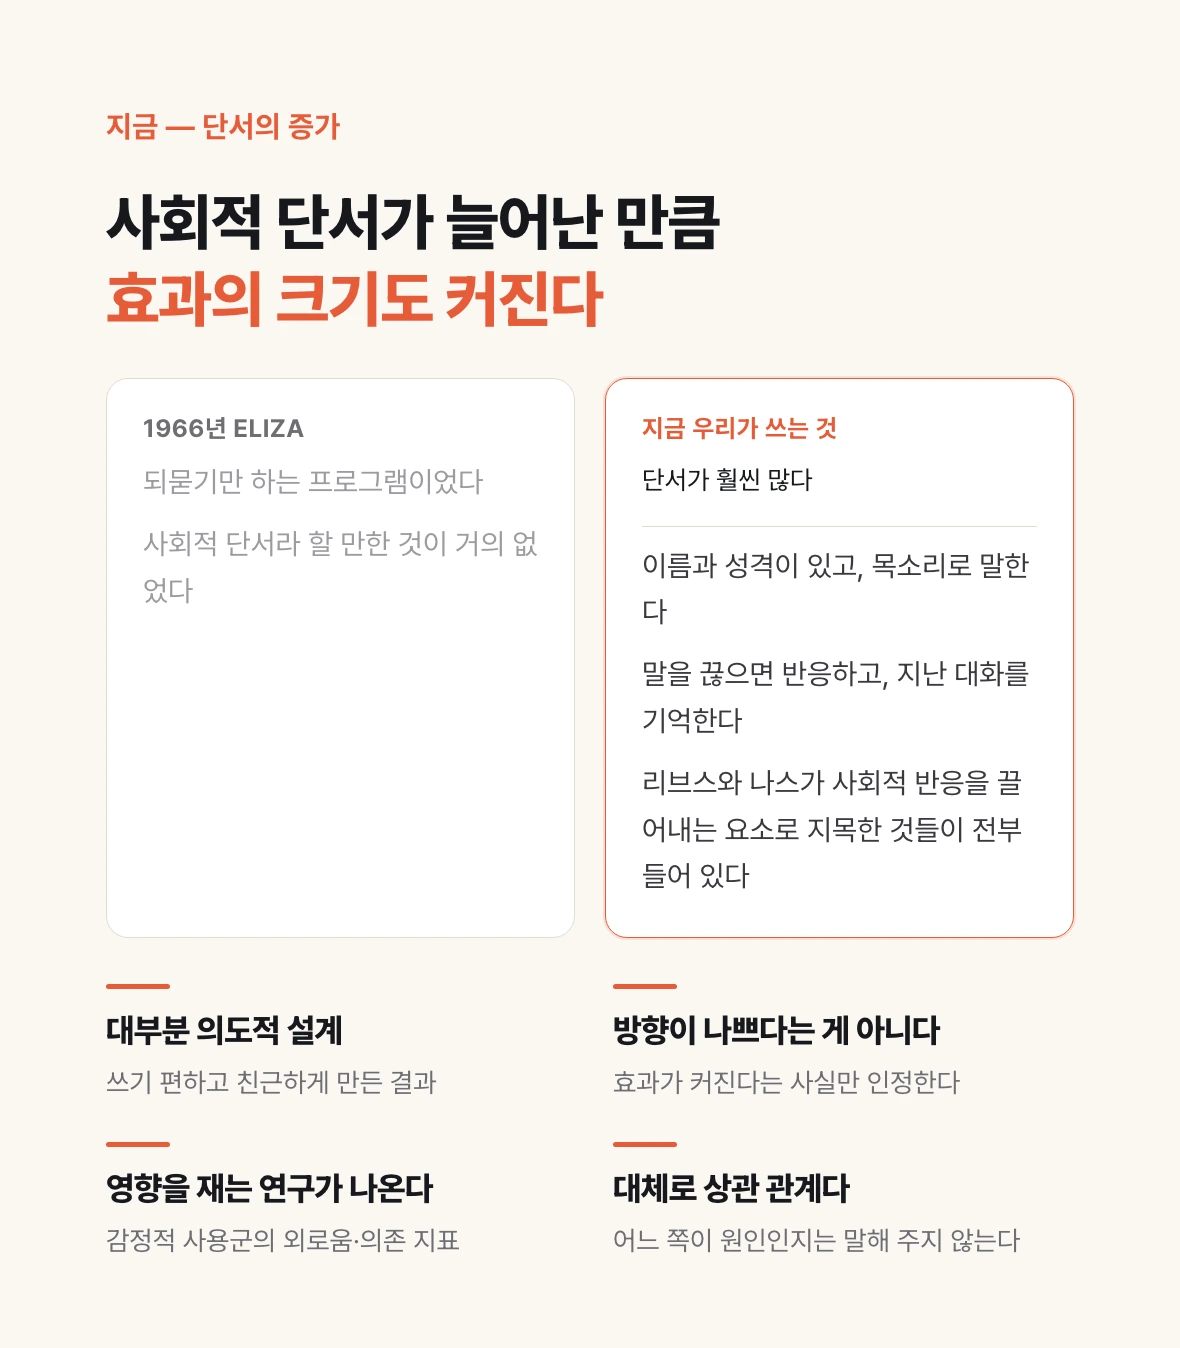
1966年のイライザは問い返すだけのプログラムだった。いま私たちが使っているものは、当時よりはるかに社会的な手がかりが多い。
名前と性格があり、声で話し、話を遮れば反応し、前の対話を覚えている。リーブスとナスが社会的反応を引き出す要素として指摘したものが全部入っている。そしてその多くは意図して設計されたものだ。使いやすく親しみやすくしようという判断の結果である。
この方向が悪いという話ではない。ただ効果の大きさが増しているという事実は認めておかねばならない。
近年はこの使い方が人にどんな影響を与えるかを測る研究も出ている。対話型AIを感情的に多く使う利用者群で孤独感や依存の指標が高く出るという観察が報告されているが、この種の結果はおおむね相関であり、どちらが原因かまでは語らない。ただこの問いがいまや測定の対象になったこと自体が示唆的だ。
今回のバッジが設計原理である理由がこれだ。ここで心理学はAIのアルゴリズムを説明しない。AIを使う人の側を説明し、だからこそ使い方を規定する。
では明日から何を変えるか
礼儀は保ってよい。なくそうと努める理由がない。自動処理なので抑えるのに使う労力がもったいないし、丁寧なプロンプトが結果を損ねることもない。そう書くほうが自然で楽なら、そのままにしておくほうがよい。
代わりに語調を能力の合図として読まない。判定する場所はただ一つだ。この主張に確かめられる根拠が付いているか。ためらいのなさ、詳しさ、丁寧さは根拠ではない。この一行を守るだけで今回の実用的な値は全部回収できる。
自信をもって間違えた答えにわざと一度出会っておく。自分がよく知っている分野で確かめられる事実を尋ねて誤答を受け取ってみると、そのときの語調がどれほど平然としているかが体に残る。今回いちばん安い予防接種であり、第6回の形式が完璧なほど疑えと同じ場所だ。
重要な判断では呼び方を変えてみる。あなたはどう思うかではなく、この資料から導かれる結論は何かと尋ねる。相手を人として呼ぶ文は、人に使う判断の癖を一緒に呼び寄せる。文の形を変えれば自分の読む姿勢も少し変わる。
そして自分に問う質問を一つ。いまこの答えを信じている理由は根拠か、それともよく書けているからか。