ARC-AGI-3 は何を測る試験か
AI のベンチマークは多くの場合、知っていることを問う。数学を解かせ、コードを書かせ、試験問題を出す。よく覚え、よく整理したモデルが高得点を取る。
ARC-AGI-3 は逆だ。初めて見る環境にモデルを放り込み、説明書を渡さない。ルールが何か、目標が何か、どうすれば成功かを教えない。モデルは自分で触ってみて、結果を観察し、突き止めなければならない。
初めて見るゲーム機を手にした子どもと同じ状況だ。説明書はなく、ボタンだけがある。子どもは押してみて、画面の変化を見て、どのボタンが何をするか見当をつけ、目標を推測する。AI にそれができるかを測る試験だ。
非営利団体 ARC Prize が作成し採点している。作った側がこれを AGI の指標とする理由はそこにある。覚えたものを取り出す能力ではなく、習っていない状況で自分から方法を作り出す能力を測るからだ。
7.8 から 99.9 へ — 数字を正確に読む
この試験は 2026 年 3 月に公開された。当初は最も良いモデルでも 0.37% で、事実上誰も解けなかった。
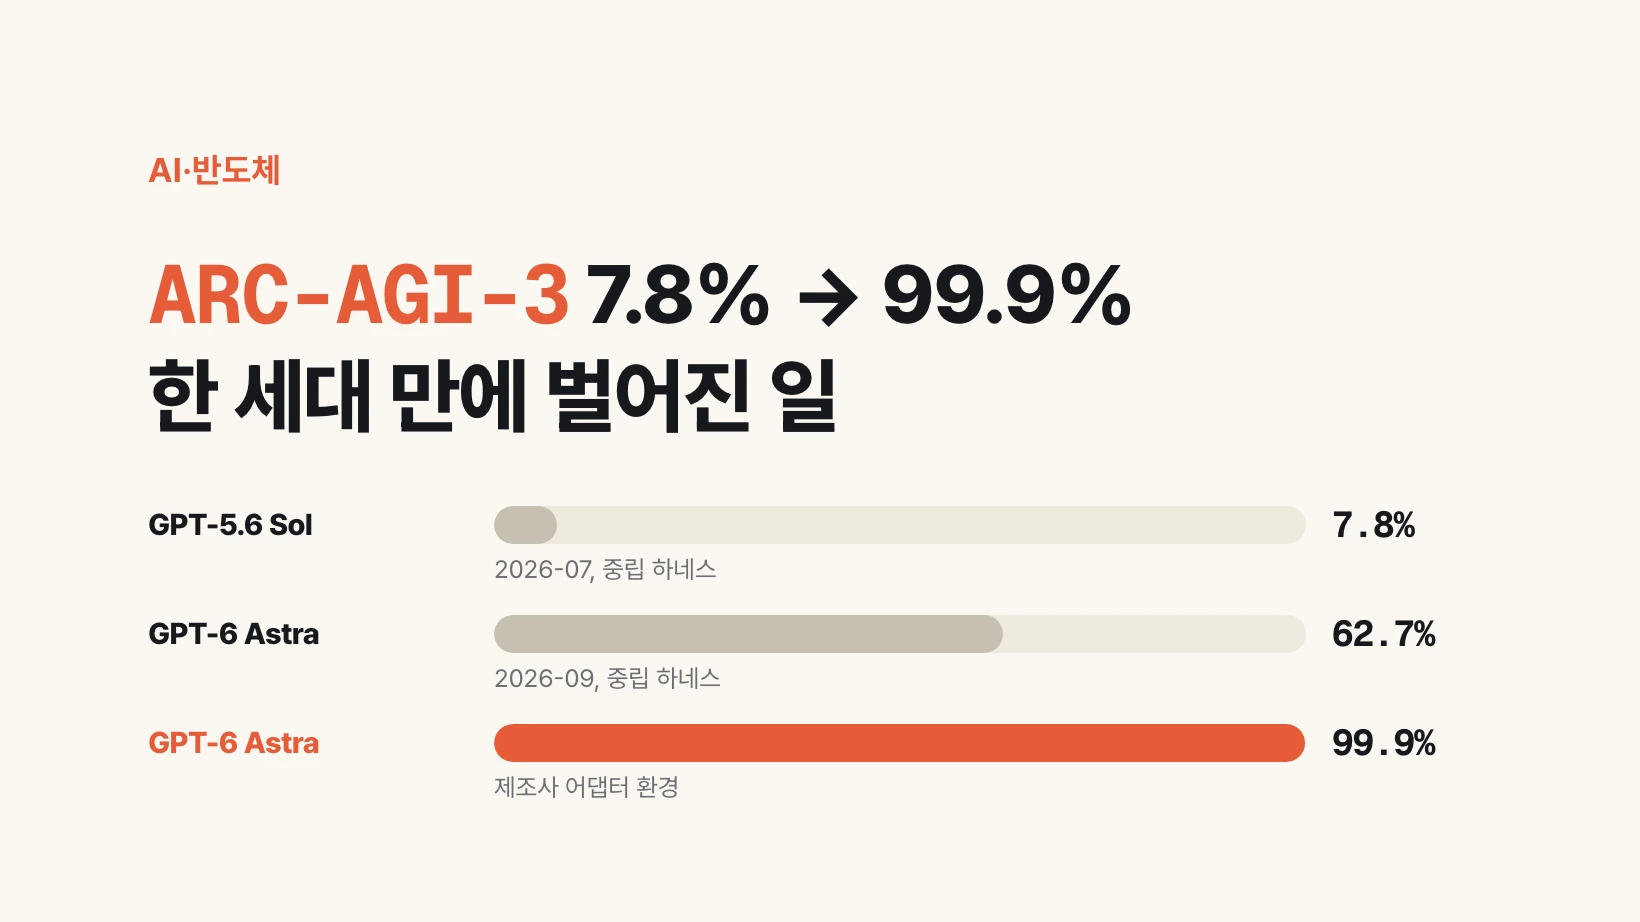
7 月に OpenAI の GPT-5.6 Sol が 7.8% を取った。この試験でゲームを一つでも実際に攻略した最初のモデルだ。同じ基準で Claude Opus 5 は 30.2% だった。
そして 2026 年 9 月 3 日、GPT-6 Astra が 99.9% を記録した。この数字を運ぶときに必ず添えるべき条件が一つある。点数は一つではなく二つある、ということだ。
ARC Prize は二つの実行環境で測る。一つはどのベンダーにも同じく適用する中立ハーネス(Standard harness)、もう一つはベンダー自身の文脈管理を使うアダプタ環境(Provider Adapter harness)だ。Astra は中立ハーネスで 62.7%、ベンダーアダプタ環境で 99.9% だった。同じモデルで 37 ポイントの差がある。
差が出るのは、アダプタがモデルの内部推論状態をリクエスト間で保持するからだ。人でいえば、考えの流れを切らずに続ける状態と、毎回やり直す状態の違いにあたる。ARC Prize の計測では、これにより全体の所要時間が約 3.66 倍速くなり、トークンは 49% 少なくて済んだ。
つまり 99.9% は誤った数字ではなく、条件のついた数字だ。そして条件を外して中立基準だけで見ても 7.8% から 62.7%、一世代で約八倍である。どちらで測っても方向は同じだ。
変わったのは点数ではなく能力の種類だ
数字より大事なのは、何ができるようになったかだ。
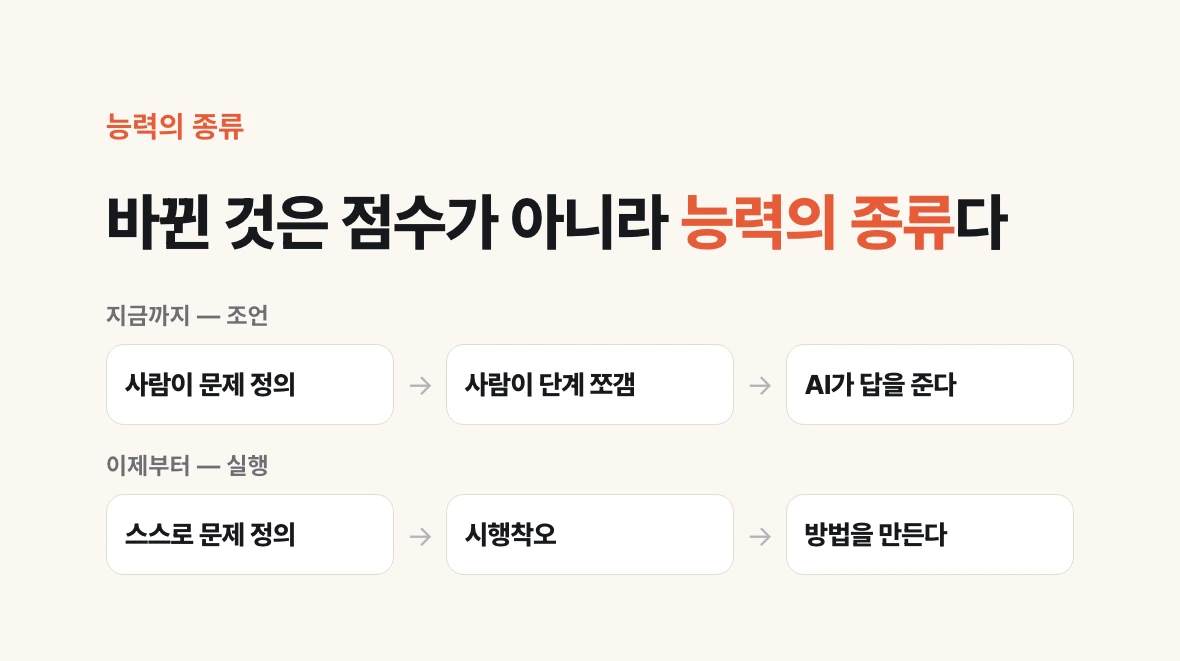
これまで AI の役立ち方はおおむね助言だった。聞けば答え、Excel の数式を作り、メールの下書きを書き、資料の構成を立てる。どれも上手いが、始めるのは常に人だ。人が問題を定義し、人が手順に分け、人が次に何をするかを決める。
ARC-AGI-3 が測るのはその手前だ。問題が何かを自分で定義し、試行錯誤を経て、方法を作り出す。この点数が跳ねたということは、AI が人の指示なしに不慣れな仕事に着手できるようになったということだ。
ARC Prize が併せて公開した観察が、この変化をより具体的に示している。Astra は全レベルの 96.0% で人間の基準線より少ない行動数で問題を解き、レベルあたりの平均行動数は人より 51.7% 少なかった。ゲームの仕組みを追うために自ら記法を作り、作業空間が与えられればそのゲーム専用の道具を自分で作ることもあった。
経済的に見れば、この違いが全てだ。助言する AI の価値は人の時間を節約するところで終わる。自分で働く AI の価値は、人がしていた労働そのものを代替するところまで行く。
なぜこれがメモリの話になるのか
ここで半導体に移る。つなぎ目はトークンだ。
トークンは AI が文章を処理する単位で、日本語ならおよそ一、二文字、英語なら単語の断片ほどにあたる。AI に何かをさせるときの費用と計算量は、結局このトークンをいくつ処理したかで決まる。
人がチャットに一日十個の質問を投げるとする。質問と回答を合わせても数千トークンだ。ところがエージェントが一つの仕事を受け持って何時間も回ると話が変わる。ブラウザを開き、検索し、結果を読み、違うと思えば別を探し、プログラムを走らせ、失敗すれば原因を読んで再挑戦する。その中間段階が全てトークンだ。
そこに並列が乗る。一人がエージェントを五つ同時に回せば、消費は五倍では済まない。各エージェントがすでに人一人分の試行錯誤をしているので、桁が変わる。
計算が増えて必要になるのは GPU だけではない。長い文脈を抱えたまま多段の手順をつなぐには、その状態をどこかに置かねばならない。その置き場が高帯域メモリ、HBM だ。そして HBM を大量に挿したサーバーの隣では通常の DRAM も一緒に増える。エージェントが増えればメモリ需要が増える。
ChatGPT が初めて出たときに半導体株を動かしたのがこの構造だった。今回違うのは、需要を作るのが質問を打ち込む人ではなく、自分で何時間も働く AI だという点だ。
市場はすでにそう読んだ
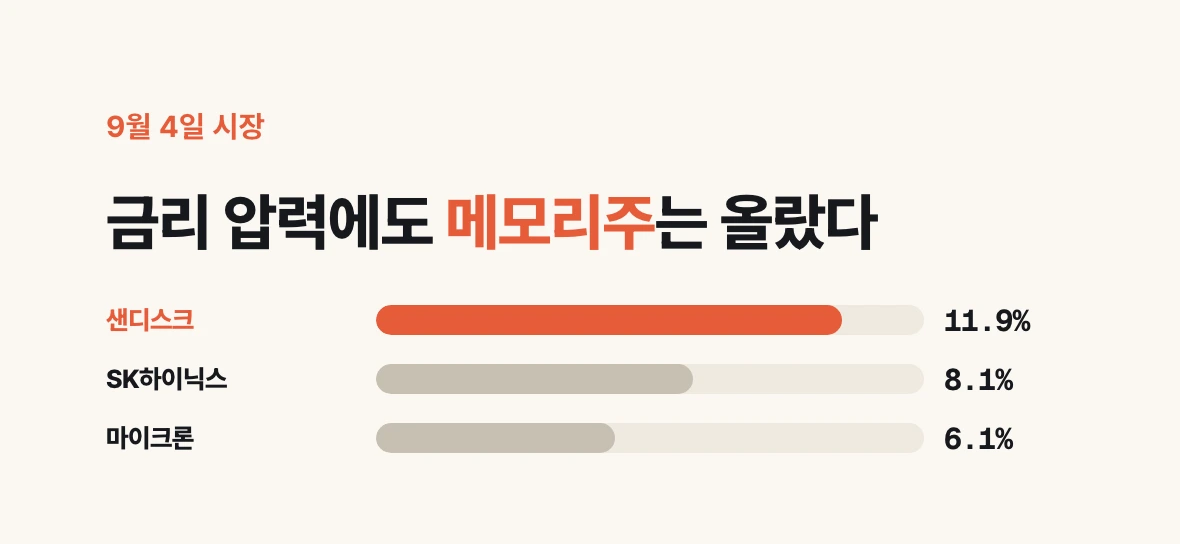
発表翌日、2026 年 9 月 4 日の市場の動きがこの解釈を裏づける。
この日はメモリ株に不利な条件が一つあった。米国の雇用統計が予想を大きく上回り、利上げ圧力が高まった。金利が上がれば株式の評価に重しになる。それでも SanDisk が 11.9%、SK ハイニックスが 8.1%、マイクロンが 6.1% 上昇した。
供給側の数字も同じ方向だ。Susquehanna は今四半期の DRAM 契約価格が 50% 以上、NAND が約 60% 上がると見ている。他者の見通しなので、主体を示して一行だけ記す。
ただしこの記事は何かを買えという話ではない。ベンチマーク一つが銘柄の将来を決めはしない。ここで確認できるのは方向であって価格ではない。
今日試せること
この変化を記事として読むのと、手で体験するのは別物だ。今日できることが二つある。
一つ目、指示の仕方を変えてみる。これまでプロンプトを精緻に組むことに時間を使ってきたなら、今回は望む結果だけを一、二文で言って任せてみる。手順を分けてやらず、途中で口を挟まない。Astra を早くから使った人たちが共通して挙げる変化がこれだ。複雑な指示文を設計するより、結果を言うほうがうまくいく。
二つ目、その一回でトークンがどれだけ出たかを確認する。ChatGPT や Claude の使用量画面、API を使っているならダッシュボードで見える。普段の質問一つと比べてみる。スーパーサイクル論の根拠が、その二つの数字の差の中にある。
もう一つ覚えておくとよい。この記事が 99.9% を単独で書かず、必ず 62.7% を隣に置いた理由がある。発表される数字にはたいてい条件がついていて、条件を確認することがベンチマークを読む唯一の方法だ。AI ツールを選ぶときにも同じ習慣がそのまま効く。