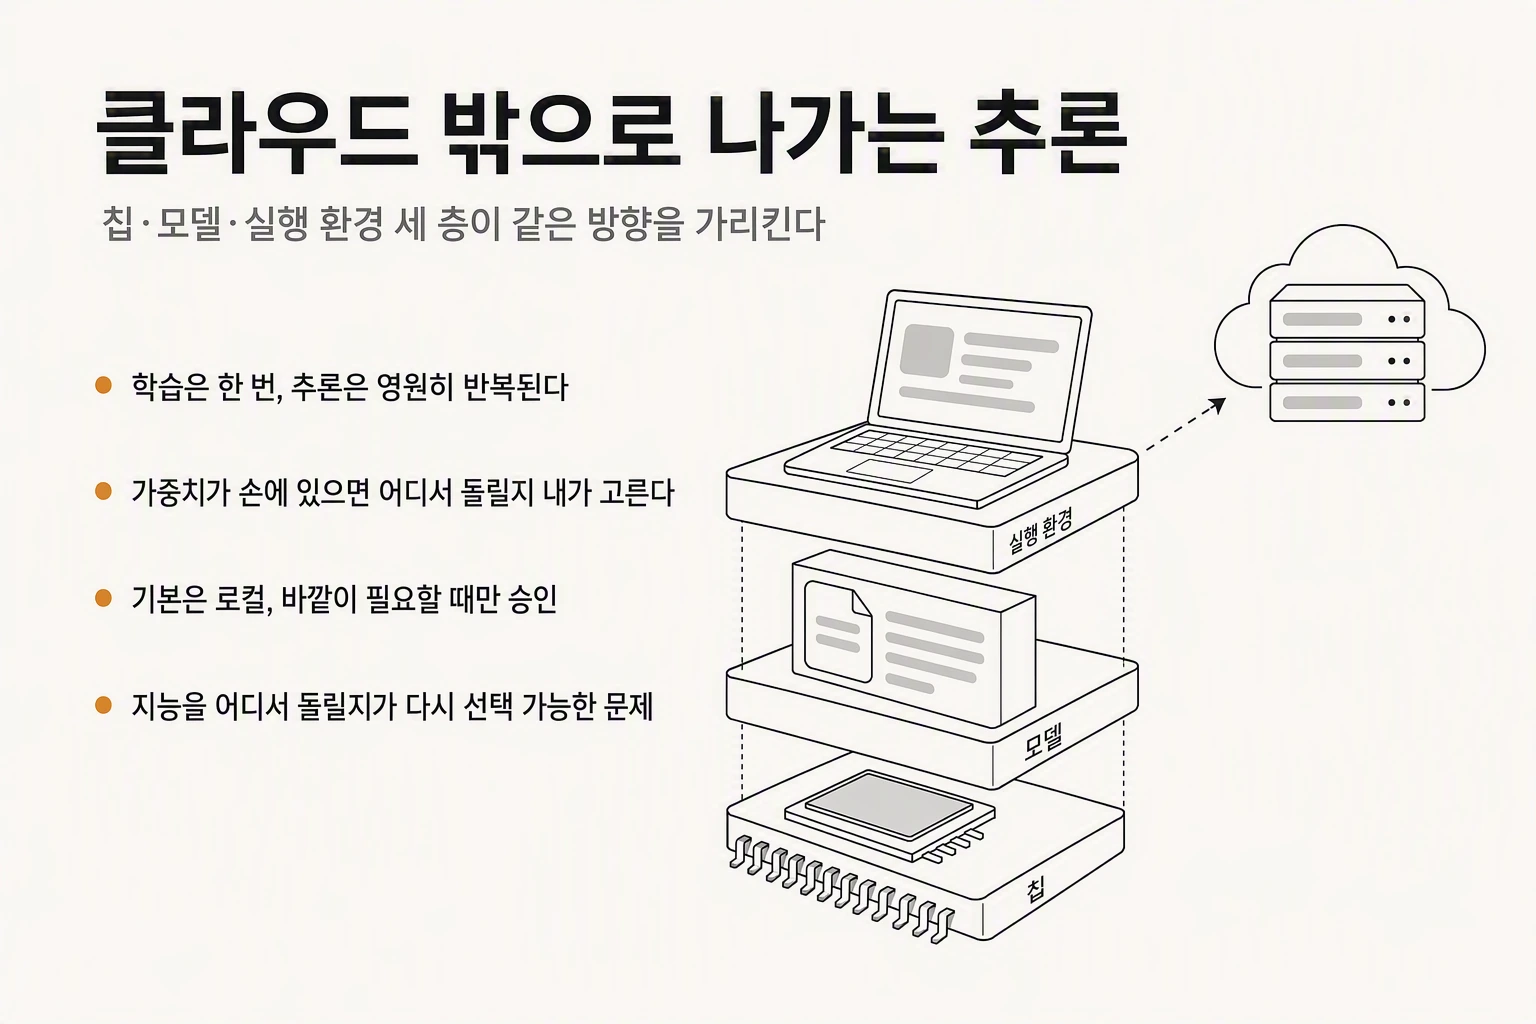
推論とは何か、そしてなぜ今コストの問題になったのか
AI モデルを使う作業は二段階に分かれる。学習は膨大なデータを流し込んで重みを作る段階で、一度終えれば繰り返さない。推論はプロンプトを入力して答えを受け取る、その瞬間だ。
学習は一度だが、推論はユーザー数×リクエスト数だけ永遠に繰り返される。サービスを長く運用するほど総コストに占める推論の比重は大きくなる。エージェントの登場でさらに悪化した。1 件のリクエストが 1 回の推論で終わらず、ツールを呼び、結果を読み、また判断する工程を数十回繰り返すため、遅延が段階ごとに積み上がる。
第二の問題が重なる。クローズドモデルの API で知能にアクセスすると、社内文書やコードがリクエストのたびに境界の外へ出ていく。個人なら許容できても、組織全体でエージェントを回し始めるとトークン支出とデータ移動の統治が難しくなる。
今週のニュースはこの二つに対する三つの異なる答えだ。チップを自作する(コスト)、重みが開かれたモデルを使う(選択権)、いっそ自分の端末で動かす(データ)。
OpenAI Jalapeño — モデル企業が自らチップを作ると何が変わるか
OpenAI が自社初のカスタム推論チップ Jalapeño の初の実測結果を公開した。名前のとおり推論専用で、新しいモデルの学習は担わない。
測定は SemiAnalysis の公開ベンチマーク InferenceX で行われた。注目すべきは使用モデルだ。GPT-OSS 120B、DeepSeek R1 670B、Kimi K2.5 1T — いずれも誰でもダウンロードして動かせるオープンウェイトモデルである。自社クローズドモデルで測っても誰も検証できないが、公開モデルなら他社が同じモデルを別のチップに載せて対照できる。
3 モデルすべてで、ピークスループット時のワットあたり性能は比較対象の商用システムより 1.5〜1.9 倍高く、エンドツーエンド遅延は 1.7〜3.6 倍低かった。最大の Kimi ではワットあたり性能が約 1.5 倍、遅延が 3.4 倍低い。チップ定格は 700W だが、実測の持続電力は 550W 以下にとどまった。社内のフロンティアモデルでは差がさらに広がったとしているが、この部分は外部から検証できない。
設計からテープアウトまで 9 か月で、その過程に自社モデルを用いたという。年末から自社インフラへの配備を始め、第 2 世代は開発が進み、第 3 世代も形になりつつある。
同じ記事にある一文も数字と同じくらい重要だ。NVIDIA をはじめとするパートナーのアクセラレータは学習・推論の両面で今後も広く配備される。置き換えではなく選択肢が一つ増えたということであり、選択肢があれば価格交渉力が生まれる。
オープンウェイトモデルとは何か、今週何が出たか
オープンウェイトモデルは学習済みの重みファイルを公開し、誰でもダウンロードして自分で動かせるようにしたモデルだ。クローズドモデルはベンダーのサーバーでのみ動き、私たちは API で結果だけを受け取る。違いはモデルがどこで動けるかにある。重みが手元にあれば、どのクラウドで動かすか、あるいはクラウドを使わないかを自分で選べる。
今週は二つ出た。Z.ai の GLM-5.3-Flash は GLM-5 系列で初のネイティブマルチモーダルモデルで、MIT ライセンスで Hugging Face に公開されている。同社の説明ではベンチマークと実運用の双方で GLM-5.2 を上回りながら価格は 10 分の 1 で、コーディングとエージェントのベンチマークでは Claude Opus 4.8 に迫るという。
もう一つは Qwen3.8-Flash-Next で、モデルカード自身が「Qwen4 を支えるアーキテクチャの実験的プレビュー」と記している。次世代の構造を先に開いて見せた形だ。
両者が共通して狙うのは性能ではなく効率である。同じ知能をより少ない計算で出すという方向で、それでこそ他社のクラウドの外で動かせる。
アクティブパラメータとは — 3200 億を積んで 180 億だけ点ける意味
GLM-5.3-Flash には総パラメータ 320B、アクティブ 18B という表記が付く。一見矛盾して読めるが、MoE(専門家混合)構造を知れば単純だ。
モデル内部に複数の専門家モジュールがあり、1 トークンを処理するときはその一部だけが点灯する。保持しておくべきパラメータは 320B すべてだが、実際に計算に参加するのは毎回 18B だけだ。だからメモリは大型モデル並みに必要でも、計算量とコストは小型モデルに近い。
Qwen3.8-Flash-Next は同じ発想をさらに進めた。125B のうちアクティブが 6B で、これに n-gram 埋め込み 51B と MTP 4B が別に付く。埋め込みを別軸に置いた理由が興味深い。パラメータを増やす軸をもう一つ作りつつ、その軸は計算が軽くオフロードしやすいよう設計したというのだ。アクセラレータのメモリが狭い環境で有利になる。
アテンションにも手を入れた。Gated DeltaNet と QSA(Qwen Sparse Attention)を組み合わせ、どのトークンを見るかを一つずつ選ぶ代わりにマイクロブロック単位で選び、長コンテキストの遅延を削った。GLM-5.3-Flash も GLM 系列で初めて疎アテンションと線形アテンションを混ぜ、同じ問題を攻めている。
構造は違うが目標は一つ、長い文脈を扱うコストを下げることだ。エージェントは文脈が長くならざるを得ないので、そこが今いちばん高い席になっている。
エージェントが自分の端末へ降りてくる — Perplexity Portable Computer
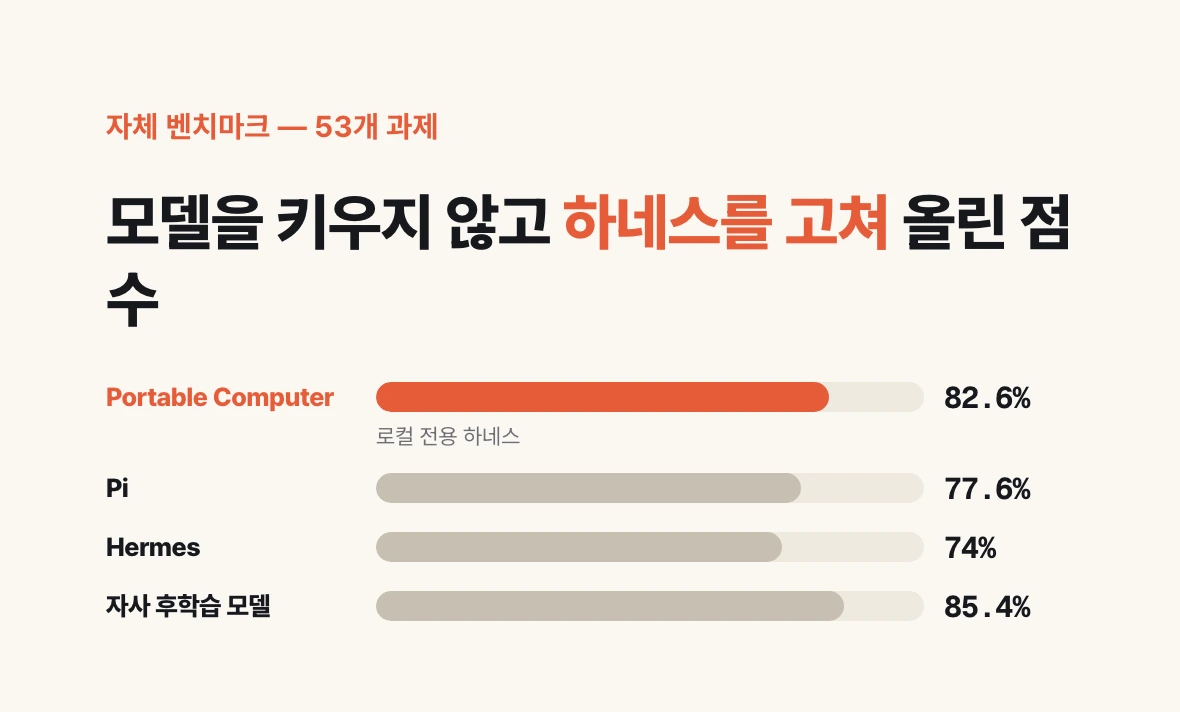
Perplexity が公開した Portable Computer はローカルファーストのエージェントだ。モデルもハーネスも、会話も作業の軌跡も、すべてユーザーの端末の中で動く。ウェブ検索やコネクタ、クラウド上のより強い助言モデルの呼び出しなど、外が必要な仕事だけがそのつどユーザーの承認を経て外へ出る。
ここでのハーネスとは、モデルを包んでツールを付け、次に何をするかのループを回し、コンテキストを組み立てる外側のプログラムを指す。モデルがエンジンなら、ハーネスは車体だ。
同社の主張は、ローカルモデルにはローカル専用のハーネスが要るということだ。汎用ハーネスは長いコンテキストを吸収し広いツール面を扱えるフロンティアモデルを前提にするが、小さいモデルはその条件で揺らぐ。
設計原則の四つが具体的だ。第一にコンテキストの節約。オンデバイスモデルが 26 万トークンのウィンドウを掲げても実測では 10 万トークンを超えると揺らぎ始めるため、システムプロンプトと中核ツールを最小に抑え、残りは必要なときだけ着脱するスキルに逃がした。第二にコネクタを MCP サーバーではなく短いコマンドラインツールに置き換えた。MCP はツール定義が長くコンテキストを大きく食う。第三に自己検証。手数は増えるが結果が良くなり、フロンティアモデルとの差が大きく縮まる。第四にサンドボックスの強制。サンドボックスが使えないときはツール呼び出し自体を止める。
自社ベンチマーク(日常的な知識労働 53 課題)では、Qwen 3.8 27B を NVIDIA DGX Spark に載せた条件で 82.6%、同条件で Pi が 77.6%、Hermes が 74.0% だった。自社の後学習モデルでは 85.4% に達した。ベンダー自製ベンチであることは差し引いて読むべきだが、モデルを大きくせずハーネスを直してスコアを上げたという方向そのものが要点だ。
同じ週に Google が出したもの — 映像の統制権、文字起こしの精度、検索内決済
Gemini Omni 1.1 Flash は映像生成モデルの更新だが、加わったものがすべて統制権だ。シーンを最大 40 秒まで延長し、開始フレームと終了フレームを指定してその間の転換を作らせ、最大 3 秒の映像をリファレンスとして与えて人物の一貫性を保ち、成果物を 1080p や 4K にアップスケールする。
実務でより重要なのは 360p の下書きだ。720p 比で最大 60% 速く、コストは 3 分の 1。複数案を安く回して選んだ一本だけを 4K に上げよ、ということであり、これは画質改善ではなくワークフローのコスト設計だ。
Gemini 3.5 Transcribe は Artificial Analysis の測定で、単語誤り率がストリーミング 4.0%、非ストリーミング 2.6%。最終確定までの時間は前世代の Chirp 3 比で 70% 短縮された。数字より目を引くのは処理の仕方だ。「火曜に会おう、いや水曜」のような言い直しを自動で反映し、言いよどみを取り除き、書式を整える。85 以上の言語を自動検出し、事前録音では話者 3 名までタイムスタンプ付きで区別する。
検索側では AI モードに旅行機能が三つ入った。会話の途中で航空券の価格追跡を設定すると、300 を超える航空会社・旅行サイトの最新価格を基準に変動時メールが届く(180 以上の国と地域)。航空券とホテルをマイルやポイント換算で表示する。ホテルは「Google で続行」を選んで部屋とキャンセル規定を確認し Google Pay で決済まで進む。ただし販売者と顧客対応はホテルや予約プラットフォームが担う。米国・英語から順次適用だ。
三件の共通点はモデルのスコア自慢ではなく、成果物が実際の作業の流れにどう嵌まるかにある。
資金とロボット、そして席を離れる開発環境
Stability AI は 8 月 25 日、シリーズ B で 7,600 万ドルを新たに調達し累計 2 億 3,200 万ドルになったと発表した。投資家の顔ぶれが本題だ。ソニー・ミュージックグループ、ユニバーサル ミュージック グループ、ワーナー ミュージック グループが揃って入り、ゲーム側から Electronic Arts、さらに AMD Ventures と Pacific Alliance Ventures が加わった。音楽産業が生成 AI に訴訟だけで応じているのではなく、出資でも入ってきているという合図として読める。
ロボット側では Skild AI が基盤モデル S1 を公開した。掲げた条件は四行だ。初見の課題、10 分に及ぶ長い作業、映像プロンプト 1 本、事後学習なし。診断は明快で、ロボット学習はこれまで BERT の時代に留まっていたという。新しい課題を確実にこなさせるには、現場条件で数十から数百時間のデータを集め専用ポリシーをファインチューニングする必要があった。言語モデルがその段階を越えた契機が in-context learning、つまりプロンプトだった点を挙げ、同じ転換をロボットで試みたのが S1 だ。
開発環境も席を離れる。Google Antigravity 2.0 にリモートコントロールが入った。ノート PC・サーバー・デスクトップに散らばって動く Antigravity セッションにウェブブラウザで接続してそのまま操作でき、ファイルやワークスペース、ビルドツール、資格情報へのアクセスが保たれる。デスクトップアプリで有効化する方法のほかにヘッドレスデーモンの導入経路があり、ログインは初回 1 回だけだ。
ドキュメントが挙げた理由が前段の話とつながる。エージェントの作業単位がサブシステム全体のリファクタリングや大規模テスト実行のように長くなり、人がその前に張り付いていられなくなったというのだ。
では今週、実際に何を試せばよいか
第一に、オープンウェイトモデルを一度自分で動かしてみる。Hugging Face で zai-org/GLM-5.3-Flash や Qwen/Qwen3.8-Flash-Next のモデルカードを開き、ライセンスと実行要件を読むだけでも感覚がつかめる。個人の端末に載せるにはまだ大きいので、最初はクラウド GPU を時間単位で借りて回すのが現実的だ。
第二に、いま使っている道具のコストがどこから出ているかを一度数える。1 か月の API 請求を推論の視点で見ると、リクエスト数ではなくエージェントの反復回数が請求を作っていると分かる場合が多い。
第三に、社内文書を扱う作業があるなら、その作業だけを切り出してローカルモデルに移せるか検討する。全部を移す必要はない。Perplexity の設計が示す要点は、既定をローカルに置き、外が必要な瞬間だけ承認を得て出るという構成だ。
第四に、コンテキストを節約する習慣をつける。MCP サーバーを無制限に足す代わりに常用するものだけを残し、残りは必要なときに読み込むスキルへ逃がす。これはローカルモデルだけでなくフロンティアモデルでもそのまま効く。
まとめると、今週のニュースはチップ・モデル・実行環境の三層で同じ方向を指している。知能をどこで動かすかが、再び選べる問題になりつつあるということだ。