なぜ今になってループなのか — 1966年の証明
アンチパターンに入る前に、これがなぜ今問題になるのかから。
コンピューティング初期にはプログラミング言語が爆発的に増え、「自分の言語のほうが多くのことができる」という争いがありました。1966年、コラド・ベームとジュゼッペ・ヤコピーニがこの論争を証明で終わらせます。どんな計算も三つだけあればすべてできる、というものです。順に実行すること、条件で分岐すること、そして繰り返すこと。
ここに今のAIを当てはめると絵がはっきりします。プロンプトを一度投げて答えを受け取るのは順序です。条件で分岐させるところまでは多くの人がやってきました。しかしループがなかった。答えを受け取ってまた入れ、また受け取ってまた入れる構造のことです。
エージェントが違って感じられ始めたのはモデルが良くなった分もありますが、構造的にはこの三つ目が埋まった時点です。そしてループができた途端に生まれた新しい間違いが、このアンチパターンです。
先に解くべき誤解 — LLM はツールを実行できない
「AI がウェブを検索した」「AI がファイルを読んだ」という言い方をよくしますが、文字どおりには事実ではありません。
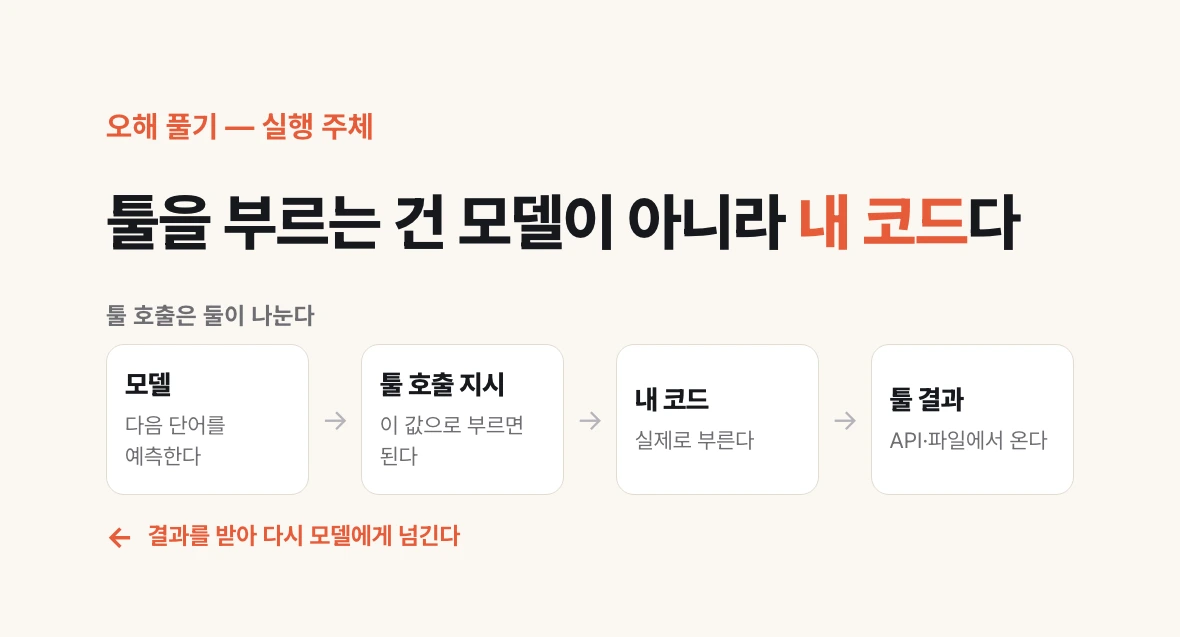
LLM は確率的に次の単語を予測する以外は何もできません。ツールを渡しても実行はできない。できるのは「このツールをこの値で呼べばよい」と、とても賢く教えてくれることだけです。
実際に呼ぶのは自分のコードです。検索 API を叩き、ファイルを開き、結果を受け取ってモデルに渡し直す。すべて自分側の仕事です。
この区別が重要なのは、モデルの「止まる理由」が複数あるという事実がここから出てくるからです。答え終わって止まるのと、ツールを呼んでほしくて止まるのと、分量が尽きて止まるのは別々の出来事なのに、見た目はどれも「応答が来た」です。
stop_reason — 三つに分かれる
だから応答が来たら本文からではなく、stop_reason というフィールドを先に見ます。モデルがなぜ止まったかがここに書かれています。
| stop_reason | 意味 | コードがやること |
|---|---|---|
| tool_use | ツール呼び出しを求めて止まった | ツールを実行し結果をメッセージに足してもう一周 |
| end_turn | 言うことを言い終えて止まった | ループを抜けて答えを使う |
| max_tokens | 分量の上限で切れた | 完成した答えではない — 再要求か失敗扱い |
ループはこう見える
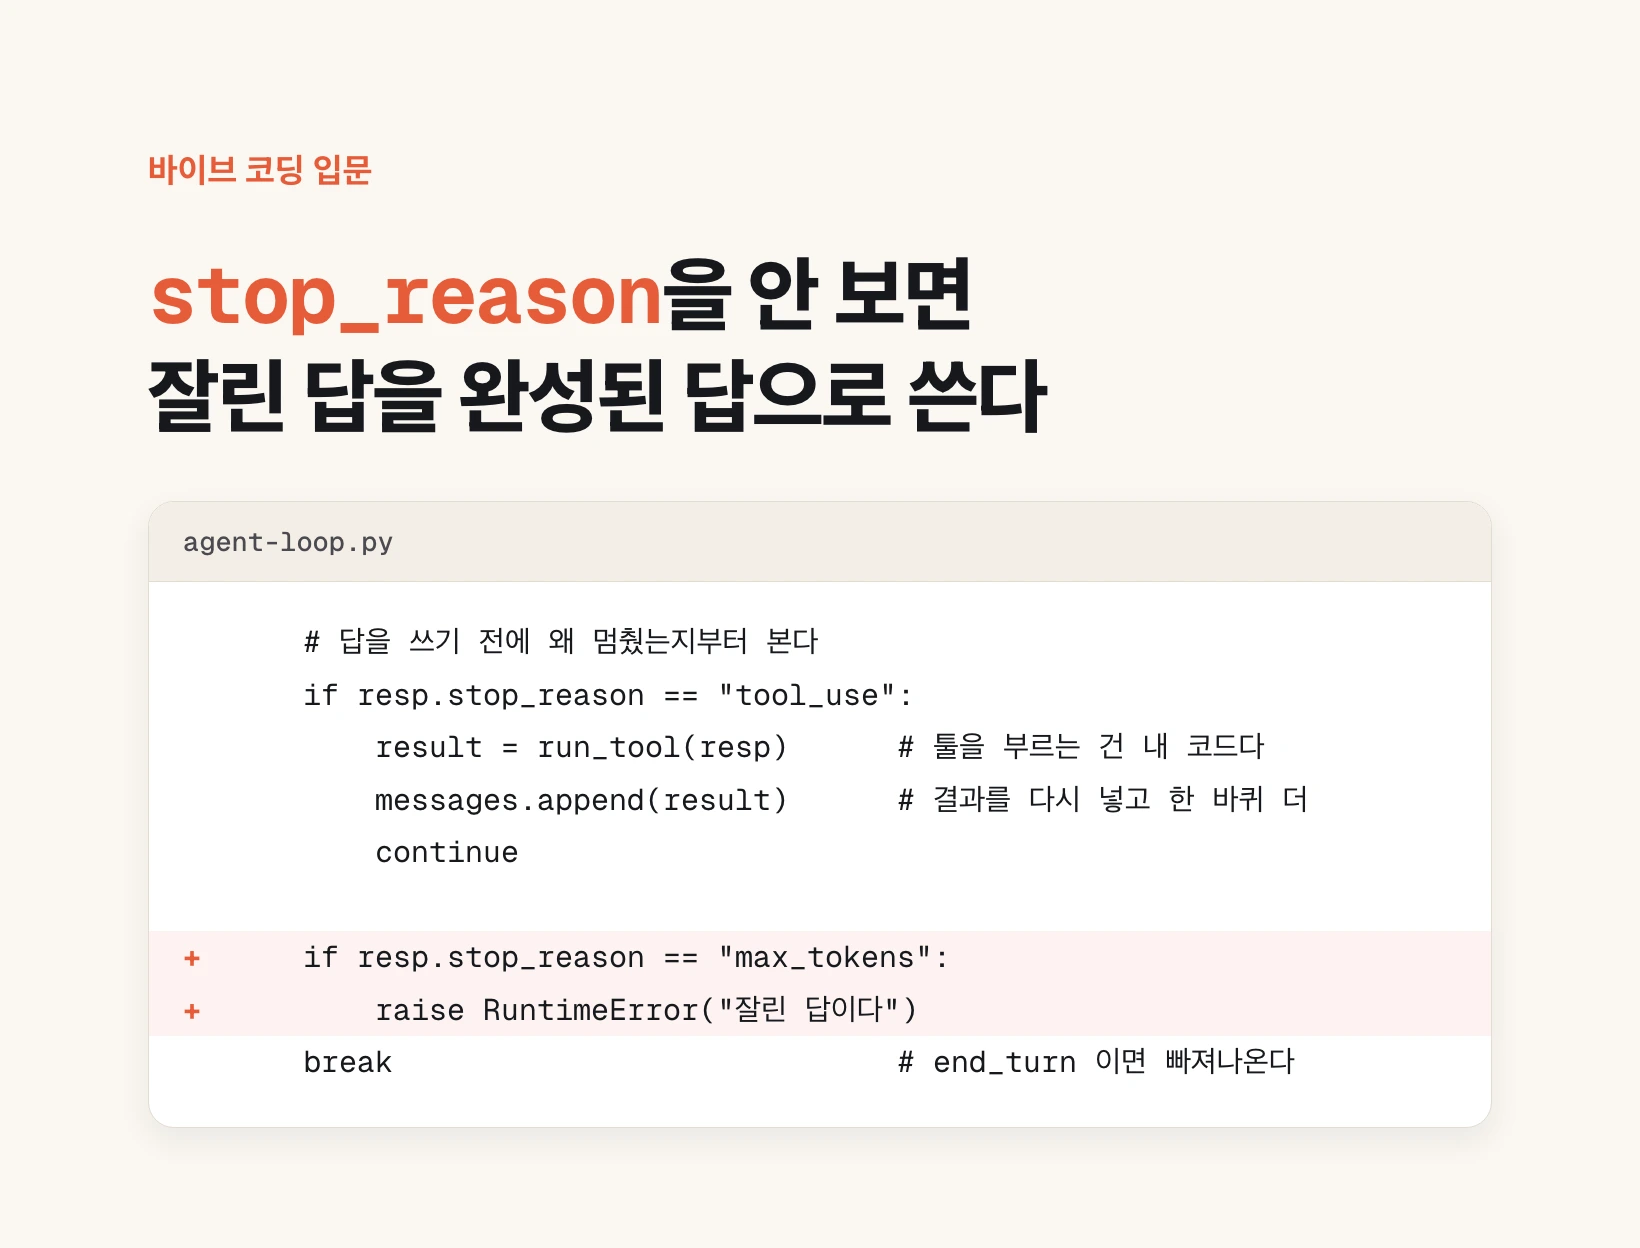
コードにすると短い。while ループの中でモデルを呼び、stop_reason で分岐し、tool_use なら continue でもう一周します。
注目すべきは、ツールを実行する行がモデル呼び出しの外にあることです。モデルは何を呼ぶかを決め、呼ぶのは自分のコードです。
while True:
    resp = client.messages.create(
        model="claude-opus-5",
        messages=messages,
        tools=tools,
    )

    # 答えを使う前に、なぜ止まったかを見る
    if resp.stop_reason == "tool_use":
        result = run_tool(resp)          # ツールを呼ぶのは自分のコード
        messages.append(result)          # 結果を入れ直してもう一周
        continue

    if resp.stop_reason == "max_tokens":
        raise RuntimeError("切れた答えだ — 完成した答えとして使わないこと")

    break                                # end_turn なら抜ける
最も危ないのは三つ目 — 切れた答えは切れて見えない
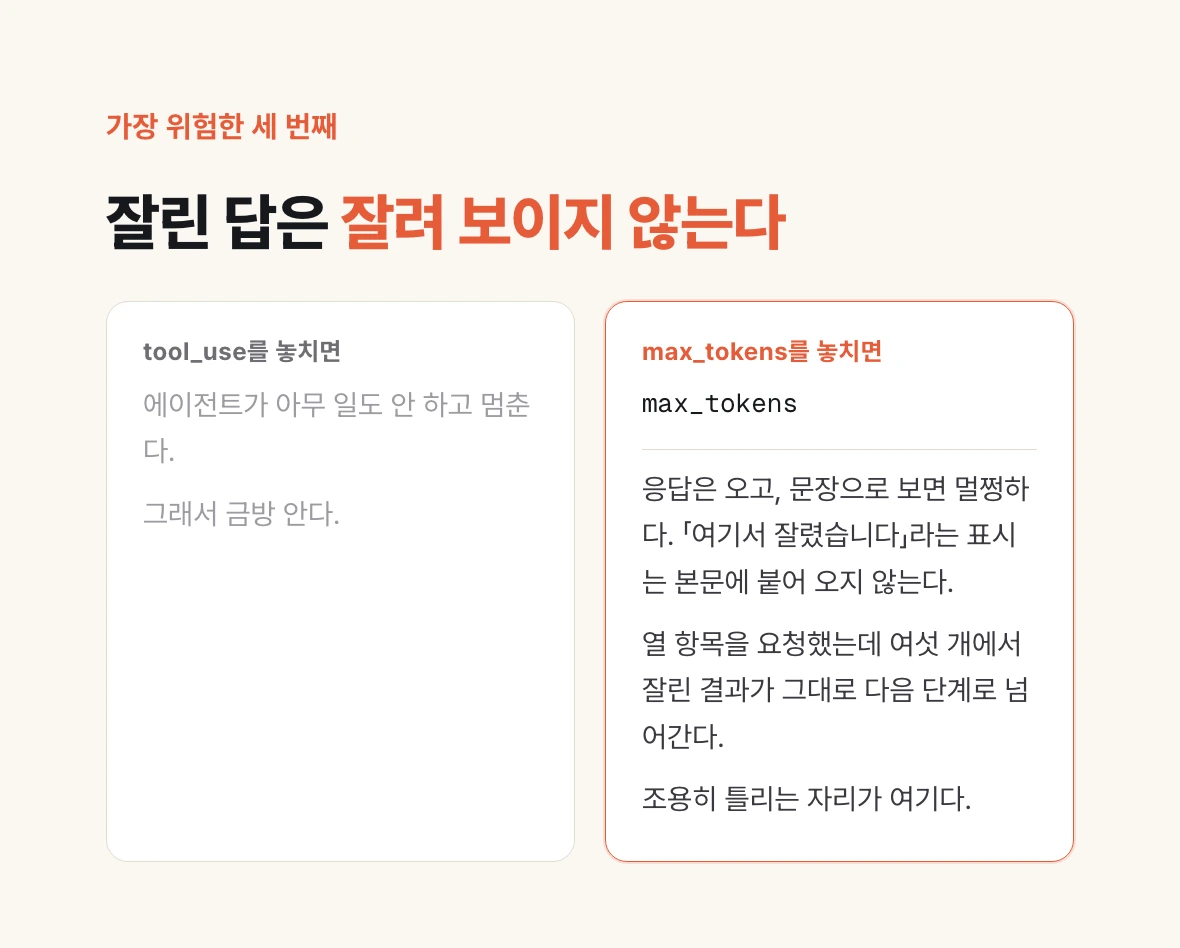
tool_use を取りこぼすとエージェントは何もせず止まるので、すぐ気づきます。問題は max_tokens です。
トークンが尽きて止まった場合にも応答は来ますし、文章として読むかぎりまともです。途中で切れていても最後の一文が不自然に終わるだけで、「ここで切れました」という印が本文についてくるわけではありません。
だから stop_reason を見なければ、完成した答えだと思ってそのまま使ってしまう。十項目を頼んで六項目で切れた結果が、そのまま次の工程に流れていく。静かに間違う場所がここです。
コードを書かない人にも同じ場面があります。チャットで長い表やリストを頼んで結果が中途半端に終わったなら、それはモデルがそこまでしか知らなかったからではなく、分量が尽きた可能性が高い。「続けて」と一行打てば残りが出てきます。
ループを抜けた後 — 人が入る場所
end_turn で抜けた後は、人が介入する場所でもあります。
発表ではこの地点で確信度を確認せよと言っていました。結果がよさそうならそのまま使い、そうでなければ人に回す。自動化の終わりを「全部自動」ではなく「自動+引き渡す条件」として設計するということです。
この条件を作っておかないと、エージェントは確信がないときにも答えを出します。分からないことを分からないと言って止まるのではなく、もっともらしく埋めるからです。
今日やってみること一つ
コードを書いているなら、モデルの応答を受け取る場所で stop_reason を見ているか確認してください。見ていないなら max_tokens の分岐を一行先に入れます。その一行が静かな失敗を騒がしい失敗に変えます。
コードを書かないなら、最近 AI から受け取った答えで中途半端に終わったものがなかったか思い出してみてください。それはモデルの限界ではなく分量の上限だった可能性が高い。次は「続けて書いて」と先に打ってみてください。
次回が最終回です。100万トークンの窓が開いたのに、なぜ全部入れてはいけないのかという話です。