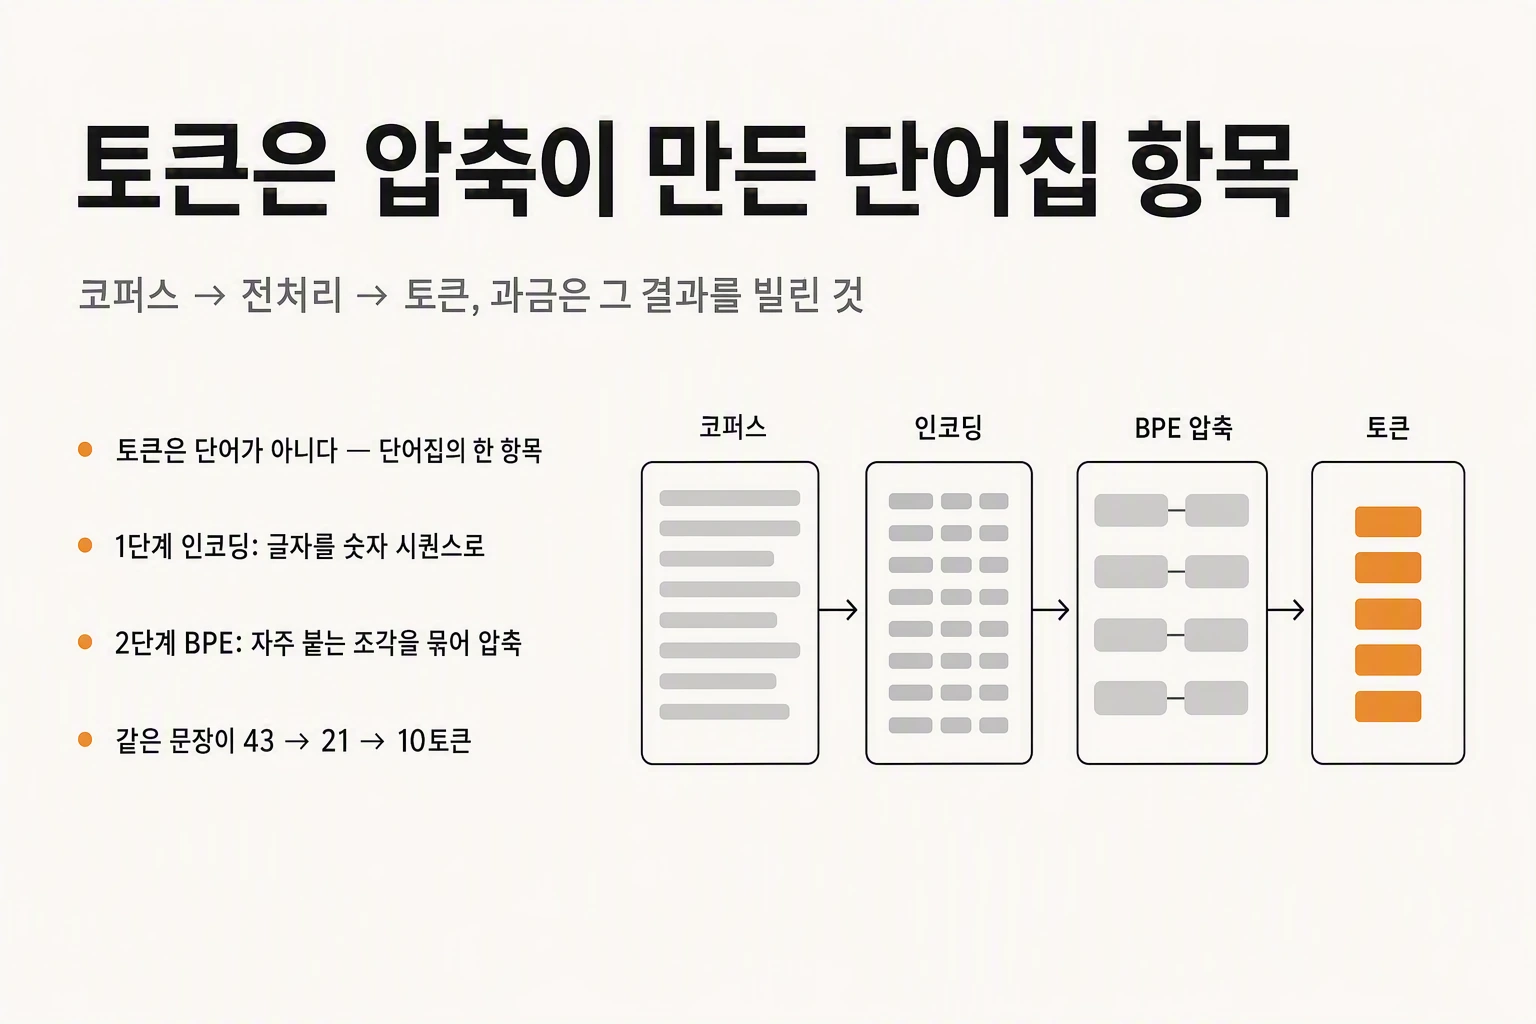
トークンを課金単位としてしか知らないなら
API の料金表は 100 万トークンあたりいくらと書かれている。コンテキスト上限も 20 万トークン、100 万トークンと表示される。だからトークンを「課金に使う文字数のようなもの」として済ませてしまいやすい。
しかしトークンは課金のために作られた単位ではない。学習が始まる前、文章を機械が扱える材料に変える工程でやむを得ず生まれたものだ。課金はその結果を借りているにすぎない。
この順序が分かると、実務で頻繁にぶつかる三つが一度に説明できる。日本語や韓国語が英語より高くつく理由、同じ文章でもモデルを変えるとトークン数が変わる理由、そしてコンテキスト上限を文字数に換算すると必ずずれる理由だ。
この記事はその工程を最初から追う。前提知識は要らない。
すべてはコーパスから始まる
まずコーパスという語が出てくる。専門用語のように聞こえるが意味は素朴で、文章のかたまりのことだ。大量に集めた文章である。
インターネット上には文章が至るところに散らばっている。ブログにもホームページにも SNS にもある。GitHub のコードも結局は書かれた文字なので文章に数えられる。ログインなしで見える公開ページだけに絞っても、人が見当をつけにくい量になる。
それを一箇所につなぎ合わせた巨大な文章の塊、それがコーパスだ。モデルになる材料の出発点がここにある。
先に目的地を決めておくと理解が早い。作ろうとしているのは「今日のお昼のメニューは」の続きに何が来るかを当てる機械だ。前を見て次に来るものを予測する機械。LLM がやっていることは根本的にこれ一つである。
データとデータセットは別物だ
文章をどれだけ集めても、そのままでは学習に使えない。機械が学習するには規格に沿って整理された形が必要で、そう整理されたものをデータセットと呼ぶ。データとデータセットは違う語だ。
だからコーパスを学習材料に変える前処理が先に来る。その前処理の産物がトークンである。
順序はこうなる。コーパス(ただの長い文章)→ 前処理 → トークン(学習材料)。これから見るのは真ん中の矢印の中で起きていることで、二段階に分かれる。
第一段階 — 文字を数字に変える
コンピュータは文字を知らない。数字しか扱えない。だから最初の一歩は文字を数字に変えることで、その規則をエンコーディングという。
エンコーディングという語は、おそらくどこかで既に出会っている。ファイルを受け取って日本語が文字化けし、原因を検索したときに出てくるあれだ。今もっとも広く使われている方式が UTF-8 である。
UTF-8 では日本語や韓国語の一文字は 3 バイトで保存される。1 バイトは 0 か 1 が八桁並んだもので、八桁なら場合の数は 256 通りだ。ゼロから数えるので 0 から 255 になる。ネットワーク設定で 255 という数字をよく見るのも同じ算数だ。
この規則をコーパス全体に適用すると、世界中のあらゆる文字が — 日本語も韓国語も英語も絵文字も特殊記号も — 数字に変わる。文章全体が数字の長い並びになる。この並びをシーケンスと呼ぶ。
ここまでが第一段階だ。トークンはまだ出てこない。
第二段階 — 繰り返す断片をまとめて圧縮する
数字の並びをそのまま使うと長すぎる。だから圧縮する。
画像圧縮を思い浮かべると感覚がつかめる。画像を JPEG に縮めるとき行うのは、繰り返すパターンを見つけて一度だけ記録し、残りを参照に置き換えることだ。文章でも同じ発想を使う。
長い文章を眺めると同じ組み合わせが延々と現れる。英語なら ing や the のような断片、日本語なら「ます」「という」、韓国語なら敬語の語尾がそうだ。こうして頻繁に隣り合う断片を見つけ、それぞれ一つの項目にまとめる。まとめた項目の一覧が語彙表、英語で vocabulary である。
まとめる規則はアルゴリズムが決める。もっとも広く使われているのが BPE(Byte Pair Encoding)で、もっとも頻繁に隣り合う二つの断片を融合する操作を決められた回数だけ繰り返す。そうしてできた語彙表の項目一つひとつが、まさにトークンだ。
だから定義はここに落ち着く。トークンは単語ではない。圧縮アルゴリズムが生み出した語彙表の一項目である。
自分で数えれば一目で分かる
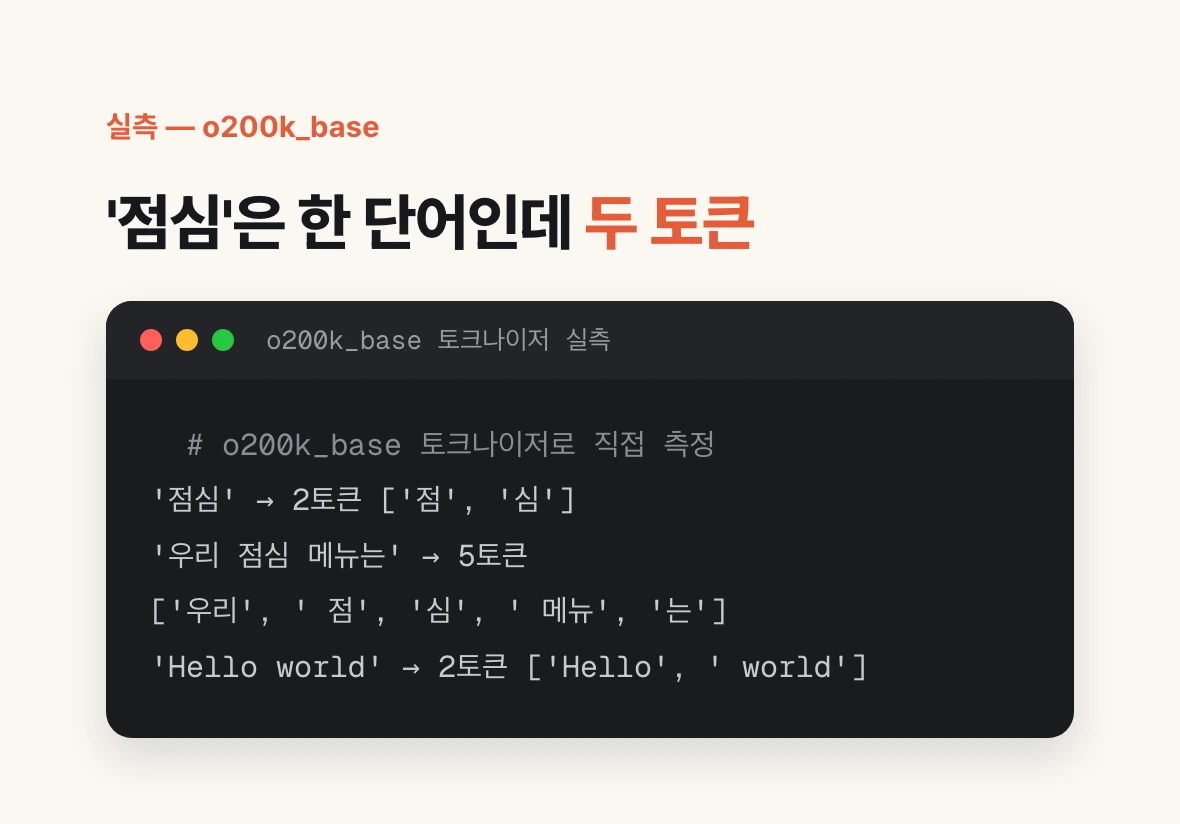
説明だけでは抽象的なので、実際に測った結果を出す。GPT-4o 系が使う o200k_base トークナイザでの実測だ。
韓国語の「점심」(昼食)は一語なのに「점」と「심」の二トークンに割れる。「우리 점심 메뉴는」は目で見れば三かたまりだが、トークンでは五個だ。先頭の空白が後ろの断片にくっついて動くことも見てとれる。
ここでトークンが単語でも文字でもないことがはっきりする。単語より細かく割れることもあれば、複数の単語が一つにくっつくこともある。基準は「学習コーパスでどれだけ頻繁に隣り合っていたか」だけだ。
'점심'(昼食)        → 2 トークン   ['점', '심']
'우리 점심 메뉴는'    → 5 トークン   ['우리', ' 점', '심', ' 메뉴', '는']
'Hello world'        → 2 トークン   ['Hello', ' world']
同じ文が 43 トークン、21 トークン、10 トークン
語彙表は学習時にコーパスから一緒に作られる。だからモデルが違えば語彙表も違い、同じ文のトークン数も変わる。
同一の韓国語の文を三つのトークナイザで測ってみた。GPT-3 時代の p50k_base では 43 トークン、GPT-4 が使う cl100k_base では 21 トークン、GPT-4o が使う o200k_base では 10 トークンになる。同じ文で四倍以上の開きだ。
一方、英語の文「What should we have for lunch?」は三つとも 7 トークンで同じだった。差は非英語でだけ開いている。
原因は語彙表の大きさと構成にある。初期のトークナイザは英語中心に作られ、韓国語の断片をほとんど持たなかった。すると韓国語は生の UTF-8 バイト単位に砕ける。cl100k_base で「점심」を分解すると、文字の境界ではなくバイトの途中で切れて壊れた断片になる。その後のモデルが語彙表を大きくして韓国語の断片を丸ごと取り込み、トークン数が減った。
日本語や韓国語が英語より高くつくという話はここから来ている。実務で重要なのは、それが固定された事実ではなくモデル選択によって動く値だという点だ。
自分で確かめる方法
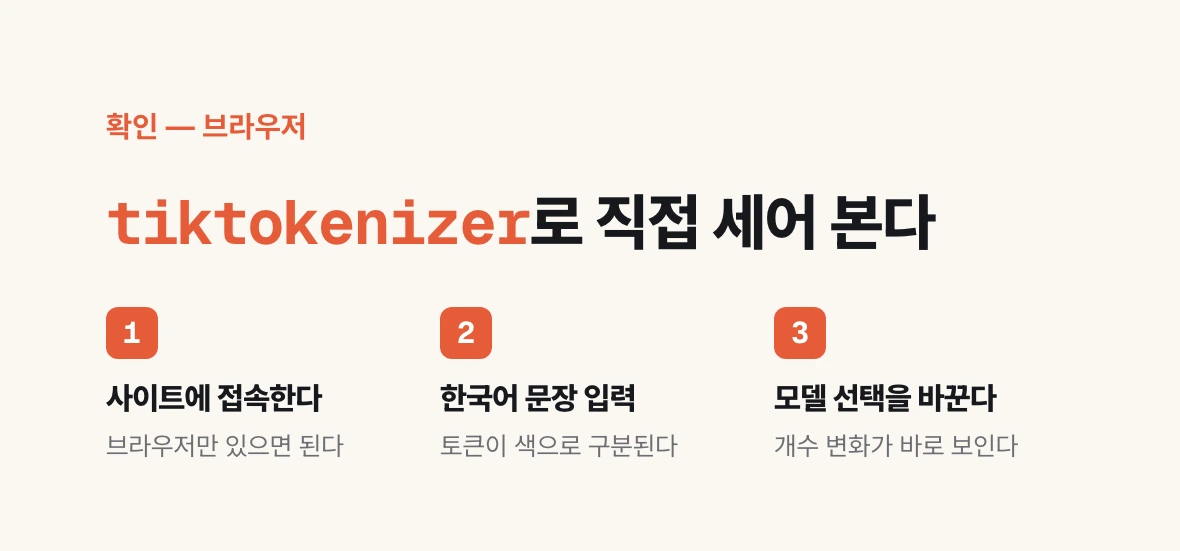
説明を読むより一度数えるほうが早い。ブラウザさえあればよい。
tiktokenizer.vercel.app を開く。左の入力欄に好きな文を入れる。右側にトークンが色分けで表示され、下に総数が出る。画面上部のモデル選択を変えると、同じ文のトークン数がどう動くかがすぐ見える。
試す価値があるのは三つ。第一に、よく使う文とその英訳を並べて数を比べる。第二に、文を固定してモデルを切り替えていく。第三に、社名や製品名のような珍しい固有名詞を入れてみる。珍しい語ほど細かく砕けることが目で分かる。
三つ目がとくに役に立つ。プロンプトの構造が固有名詞を繰り返し含むなら、そこが想定より速くトークンを消費している可能性が高い。
この概念が実務で効いてくる場所
第一に、コスト見積もりだ。文字数からトークンを換算すると、非英語ではおおむねずれる。実際に使うモデルのトークナイザで代表的なプロンプトを測るのが正確である。
第二に、コンテキスト上限だ。20 万トークンが何文字にあたるかは言語とモデルによって変わる。余裕がどれだけあるかを知るにはやはり測るしかない。
第三に、モデルの入れ替えだ。安いモデルに替えたのに期待ほどコストが下がらなかったなら、単価は下がったがトークナイザが文章をより細かく割ってトークン数が増えたのかもしれない。実際のコストは単価とトークン数を合わせて見る必要がある。
この三つはすべて測れば分かる問題であり、測るのに五分もかからない。
ここまでが材料だ
コーパスを集め、数字に変え、繰り返しをまとめてトークンを作った。学習に使う材料が整ったことになる。
次回は、この材料でニューラルネットワークが実際にどう学習するかを見る。答えを隠して当てさせ、外れた分だけ遡って直す工程であり、その「直す対象」がパラメータだ。モデル名の横につく 7B や 70B といった数字が何を数えているのかも、そのとき明らかになる。