学習は終わったのに使えない
前回、パラメータを少しずつ直しながら学習を終えた。重みが最適化されたモデルが一つ手に入った。
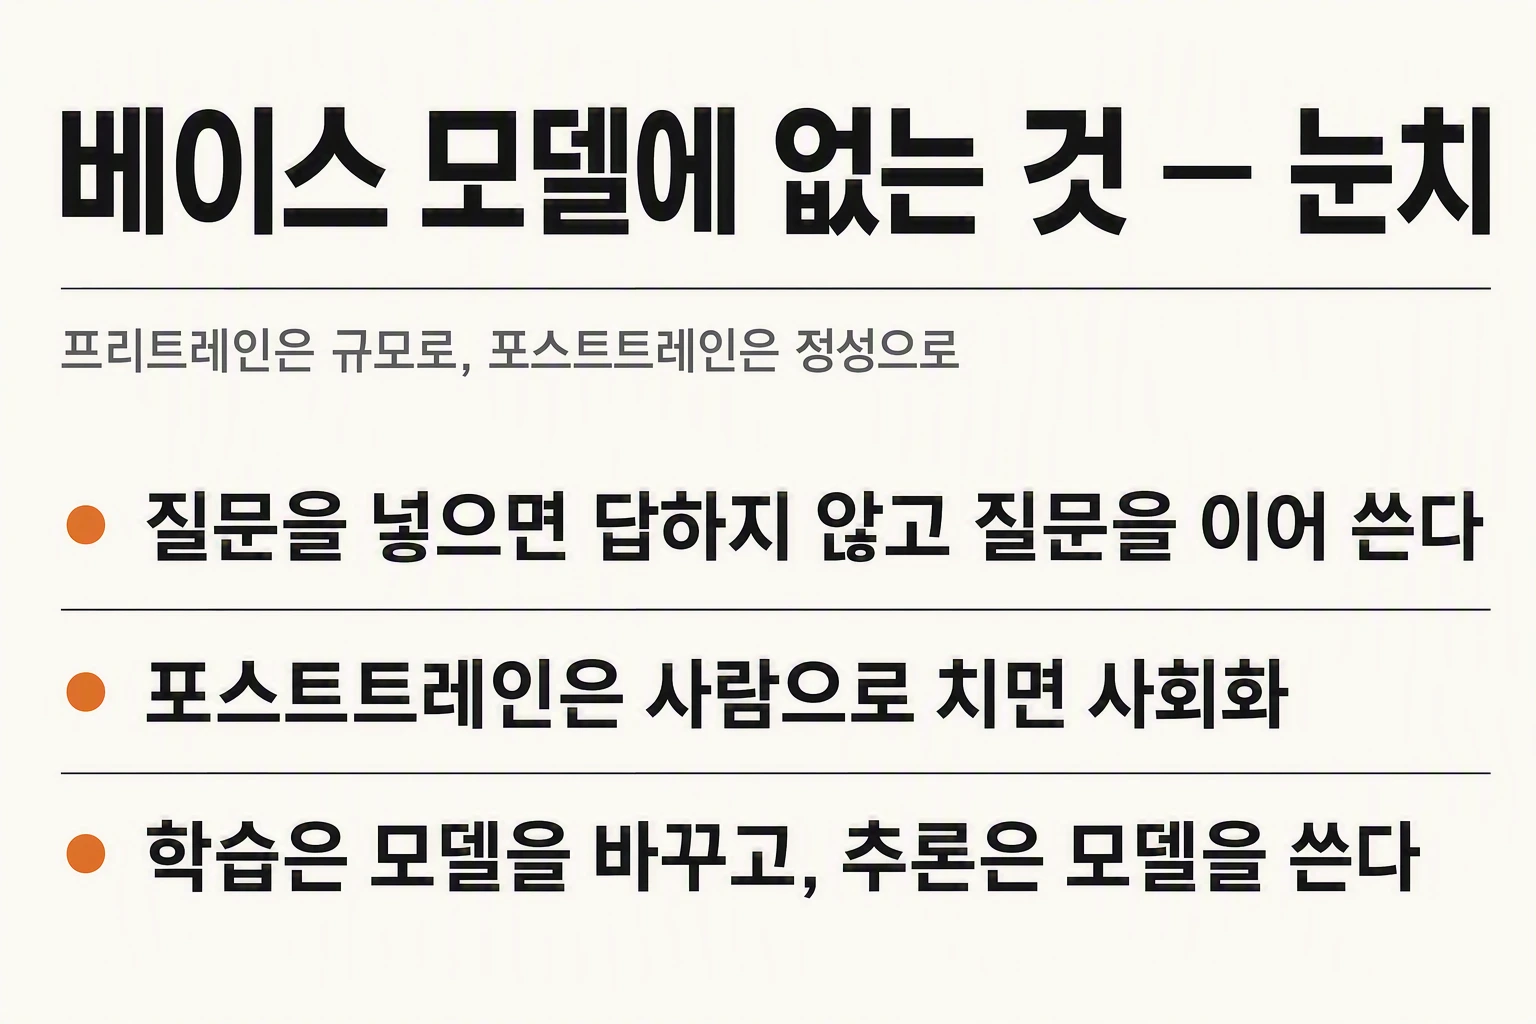
ところがこのモデルに質問を投げても答えない。代わりに質問を書き続ける。「韓国の首都はどこですか?」と入れると「そして日本の首都はどこですか? 中国の首都は…」というふうに、似た文をひたすら作り出す。
故障ではない。学んだとおりに正確に振る舞っているだけだ。このモデルが訓練されたのはただ一つ、前を見て次に来るトークンとして何が自然かということだった。質問のあとに答えが来るなどとは、一度も学んでいない。
この状態のモデルをベースモデルと呼び、ここまでの過程を事前学習という。「事前」と付くのは、まだ手前の段階だという意味だ。
ベースモデルに欠けているもの — 場を読む力
ベースモデルに欠けているものを一言でいえば、場を読む力だ。状況に合わせて振る舞う感覚がない。
コーディング用の道具として使うとしよう。すると次に来るコードの一片をうまく当てるだけでは足りない。エラーログを渡せば何が問題かを指摘し、直したコードを規格に沿って返し、説明が要る場面では説明しなければならない。
レポートを書かせるなら、また別の形式が必要になる。要約が先に来て、根拠がそれに続き、長さが依頼に合っていなければならない。
これらはすべて「自然な次のトークン」とは別の層にある要求だ。だから追加の訓練が必要になり、その段階を事後学習と呼ぶ。人でいえば社会化に近い。
ファインチューニング — コンソールを作り直さない
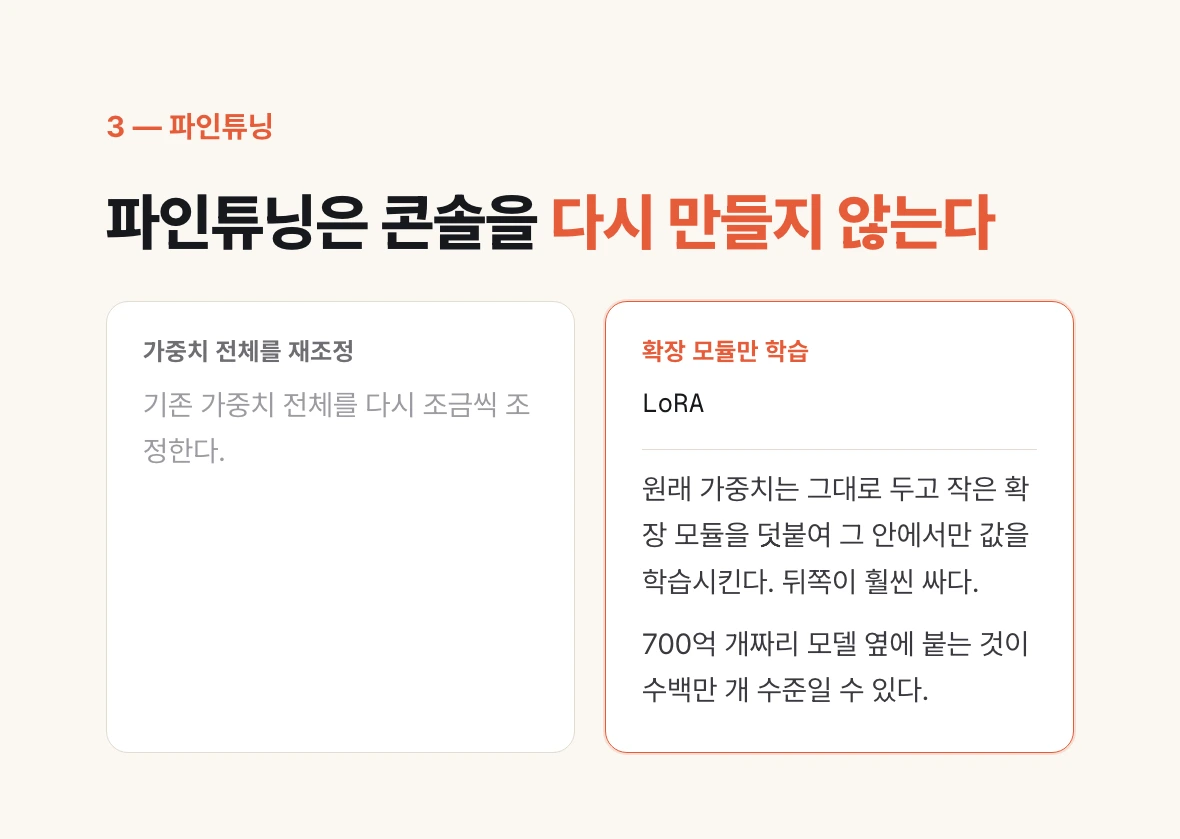
事後学習の代表的な方法がファインチューニングだ。ここで重要なのは、事前学習を最初からやり直すわけではないという点である。
前回のDJコンソールのたとえを続けよう。すでにうまく合わせてあるコンソールがある。ファインチューニングはそのコンソールを捨てて新しく作ることではなく、あるコンソールをもう少し手直しする作業だ。
手直しの仕方は大きく二つに分かれる。一つは既存の重み全体をもう一度少しずつ調整するやり方。もう一つは元の重みはそのまま置き、小さな拡張モジュールを付け足してその中でだけ値を学習させるやり方だ。後者のほうがはるかに安く、LoRAといった名前で呼ばれる。
付け足すモジュールの大きさは、元のモデルに比べればごく小さい。700億個規模のモデルの横に付くのが数百万個ほどということもある。図に描けば髪の毛の太さでも見えないような比率だ。それでもモデルの振る舞いは目に見えて変わる。
材料も規模が違う
ファインチューニングに使うデータは事前学習データと性格が違う。インターネット上の文章をかき集めるのではなく、「こう問えばこう答える」という問答セットを作る。
これは人手が多くかかる。良い答えとは何かを人が決めてやらなければならないからだ。そのため量は数十万から数百万件ほどになる。
大きな数字に聞こえるが、事前学習に投じた文章の量に比べればごく小さい。ここが要点だ。前の段階は規模で押し切り、後の段階は手をかけて整える。
ファインチューニングだけがあるわけでもない。良い答えと悪い答えを比べながら方向を定める強化学習系の方法も併せて使われる。そちらは問答セットの代わりに、何をうまくやったとみなすかを設計する。
loss — 学習は誤りの度合いを減らすゲーム
ここで学習全体を貫く概念を一つ押さえておこう。一度学習したときにどれだけ誤ったかを数値で表したものをlossという。
学習とは結局このlossを最小化するゲームだ。反復回数を横軸に、lossを縦軸に置いてグラフを描くと、はじめは急に下がり、次第に緩やかになり、ある時点からはそれ以上下がらなくなる。
学習を止める地点はたいていそこだ。「誤りが大きすぎるから最初からやり直し」ではなく、「これ以上やっても下がらない」が終了の合図になる。
そしてlossが0になることはない。正解を100%当てる状態は訪れず、近似として近づいていくだけだ。AIの結果に100%はないという話は、ここから出てくる。
よく混同されるもの — トークン数とパラメータ数は無関係
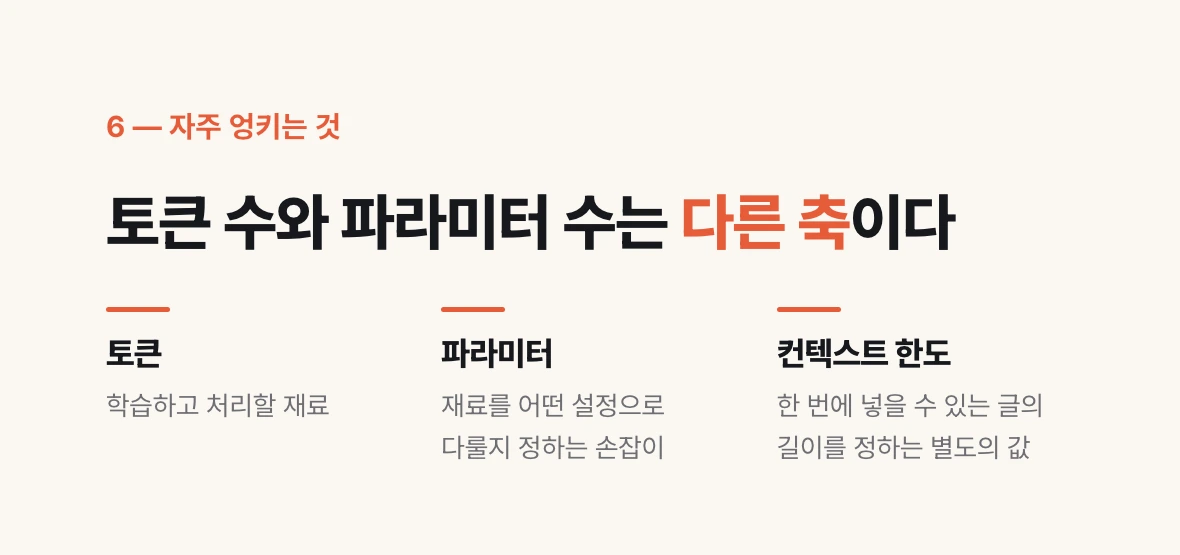
「パラメータが多ければトークンをもっと多く扱えるのですか」という質問をよく受ける。この二つは別々の軸だ。
洗濯機にたとえると、トークンは洗濯物でパラメータは洗濯コースだ。今日入れる衣類の量と、コース設定の種類の多さは別の話である。
トークンは学習し処理する材料であり、パラメータはその材料をどんな設定で扱うかを決めるつまみだ。パラメータが多いからといって一度に入れられる文章が長くなるわけではない。その長さはコンテキスト上限という別の値が決める。
付け加えると、ラベリングという言葉もよく混ざる。ラベリングは主に画像認識のように、人が正解を一つ一つ付けてデータセットを作るときに使う言葉だ。事前学習は文章そのものが正解を含んでいるので、その作業は要らない。
モデルがこれほど多い理由
事前学習は誰にでもできることではない。大規模な計算資源を数か月単位で回さねばならない仕事なので、実際に実行できるところは多くない。
ところが世の中にはモデルが非常に多い。この二つの事実は食い違って見えるが、答えは事後学習にある。
この段階はレシピの領域だ。どんな問答セットを使うか、何をうまくやったとみなすか、どんな順序で訓練するかによって結果が変わる。同じベースモデルから出発しても、ここが違えば性格の異なるモデルが出てくる。
ベンチマークの点数がモデルごとにばらつく理由もこれだ。コーディングで先行するモデルと文書要約で先行するモデルが分かれるのは、たいてい事前学習の規模ではなくこのレシピの違いによる。
実務でモデルを選ぶときにパラメータ数だけを見てはいけない理由がここにある。やろうとしている仕事に近い課題のベンチマークを見るべきだ。
ここまでが学習である
コーパスを集めてトークンに変え、次のトークン当てでパラメータを整え、事後学習で場を読む力を教えた。これでサービスに出せるモデルができ、チャット画面につなげば私たちが使うあの道具になる。
ところが、ここまで見てきたのはすべて学習だ。モデルを作る話だった。
次回からはまったく別の話が始まる。出来上がったモデルが私たちの質問を受け取って答えを作り出す過程、すなわち推論である。この二つを混ぜると話が食い違うので、はっきり分けておくのがよい。学習はモデルを変える作業であり、推論は変わったことのないモデルを使う作業だ。