前回で材料がそろった
前回、巨大な文章のかたまりをトークンに変えた。これでそのトークンを使って実際の学習が始まる。
目標は依然として一つである。「今日の昼ごはんは」の次に何が来るかを当てる機械を作ること。今回は、その機械がどうやって当てられるようになるのかを見る。
結論から言えば、学習とは間違えては直すことの繰り返しである。それ以上でも以下でもない。ただ、繰り返しの回数と直す対象の数が人の直感を超えているだけである。
当ててみるゲーム — 答えを隠して解かせる
学習データとは、正解をすでに知っているデータである。ここに一つのコツがある。文章そのものが正解を含んでいるということだ。
「우리 점심 메뉴는 김치찌개다」(今日の昼のメニューはキムチチゲだ)という文がコーパスにあるなら、最後のトークンを隠してニューラルネットワークに尋ねればよい。前の部分だけを見せて「次に何が来ると思う?」と問う。正解はすでに手元にあるので、採点はすぐにできる。
人がいちいち正解をつける必要がないという点が重要である。インターネット上のあらゆる文章が、それ自体で問題集になる。区切る位置をずらしながら、同じ文からいくらでも問題を作り出せる。学習材料が事実上無限である理由がここにある。
最初はすべて外れる
学習を始めたばかりのニューラルネットワークは何も知らない。隠された位置に何が来るかを尋ねると、語彙表にあるすべてのトークンについて確率の順位をつけて出してくるが、その順位はまったくでたらめである。
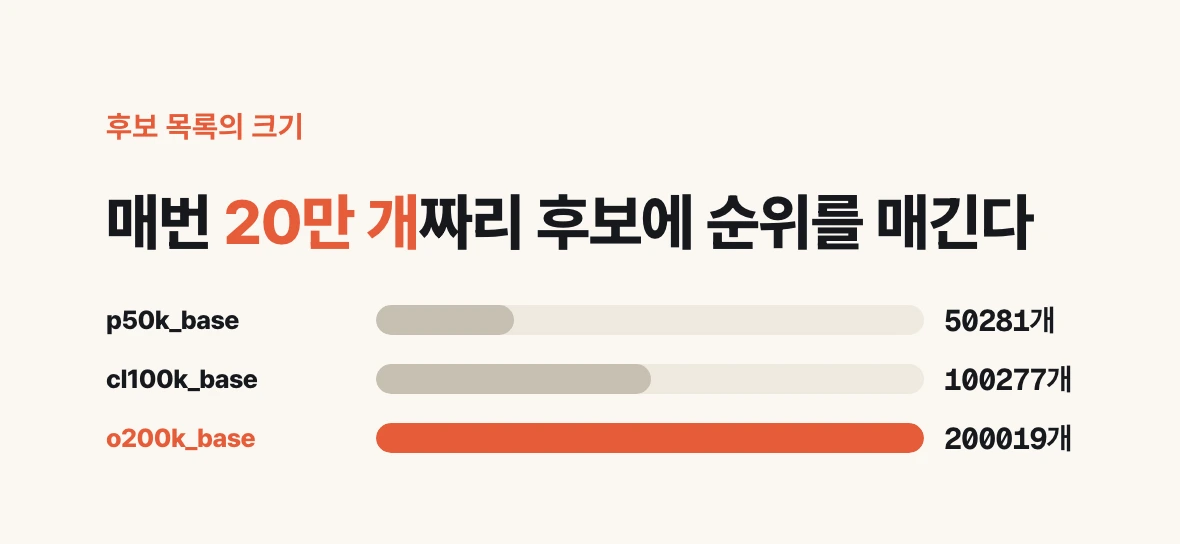
ここで規模を実感しておく必要がある。語彙表がいくつあるかを実際に数えてみると、p50k_baseは50,281個、cl100k_baseは100,277個、o200k_baseは200,019個である。つまりニューラルネットワークは、毎回20万個規模の候補リストに順位をつけていることになる。
最初は「점심」(昼食)の次に「자동차」(自動車)が1位に来るような具合である。日本語を知らない人が辞書を開いて適当に指さすのと変わらない。
ところが正解はわかっている。だから採点ができ、採点ができるから直せる。
外れた分だけ戻して直す
採点の結果が出たら、こう問う。「正解が1位に来るようにするには、何をどれだけ変えるべきだったのか」。
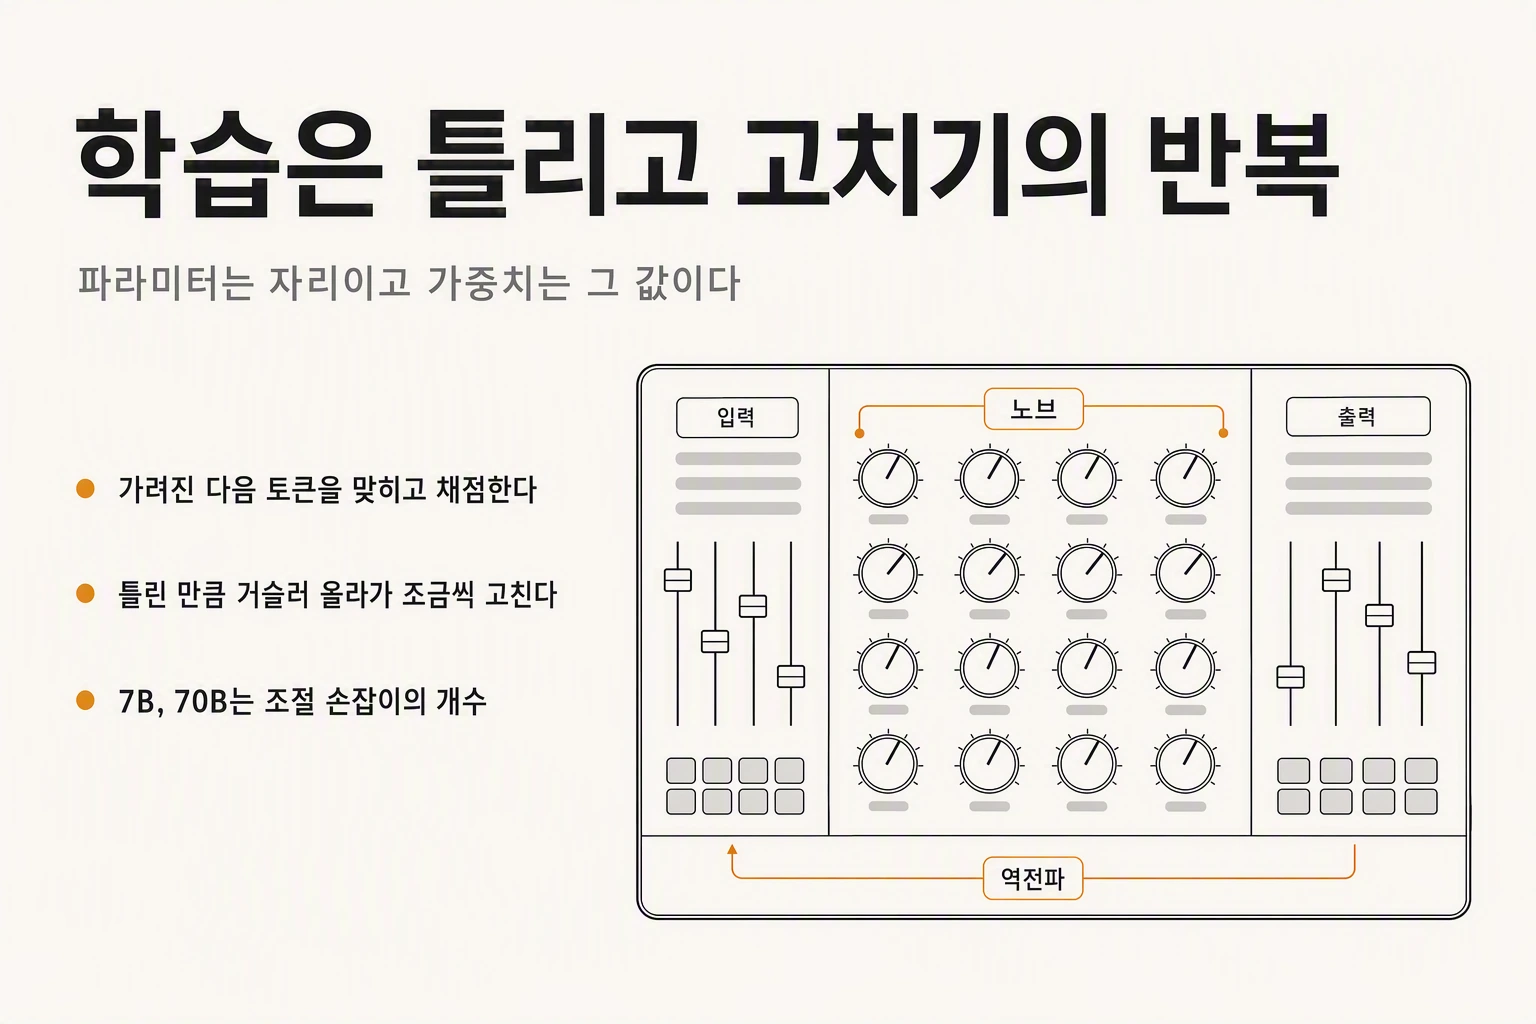
この問いに答える計算を誤差逆伝播と呼ぶ。名前は難しいが、やっていることは単純である。外れた度合いを出力側から入力側へさかのぼりながら分け与え、各設定値が誤差にどれだけ寄与したかを見積もって、その分だけ直す方向と大きさを決めるのである。
ここで一度に正解へ飛び移らないという点が重要である。毎回ごくわずかしか動かさない。一つの問題に合わせようと大きく動かすと、それまで当たっていた他の問題が崩れてしまうからだ。
だから少し直し、また外れ、さらに少し直す。この繰り返しが学習である。
直す対象 — DJコンソールのつまみ
では正確に何を直すのか。ニューラルネットワークの内部には、数値でできた調整つまみがびっしりと埋め込まれている。DJコンソールのノブを思い浮かべればよい。
入力が入ってくるとその値を通りながら計算が流れていき、つまみがどこに合わせられているかによって最終出力の確率分布が変わる。学習とは、このつまみを少しずつ回しながら、正解が1位に来る組み合わせを探す過程である。
このつまみをパラメータと呼び、それぞれのつまみに合わせられた値を重みと呼ぶ。この二つの言葉がほぼ一緒に使われる理由がこれである。パラメータは位置であり、重みはその位置に入った値である。
ディープラーニングで学習を終えたモデルファイルが、よくweightsという名前で出力されるのも同じ文脈である。学習の結果物が結局はその値の一覧だからだ。モデルを受け取るとは、実質的にこの重みのかたまりを受け取ることである。
7B、70Bが数えているもの
モデル名の横につく7B、70Bといった表記が、まさにこのつまみの個数である。Bはビリオン、10億である。7Bなら70億個、70Bなら700億個の調整値がそのモデルの中にあるという意味だ。
この数字に実感が湧かないのが普通である。ただ、方向さえつかんでおけばよい。つまみが多いほど、より細かく調整できるので表現力が大きくなり、その代わり計算量も一緒に大きくなる。
大きくなる場所は二か所ある。学習するときに一度大きくなり、学習が終わって実際に答えを作り出すときにもう一度大きくなる。二番目が実務で直接ぶつかる側である。
ハギングフェイスでモデルを検索するとき、左側にパラメータ数で絞り込むフィルタがある。それは性能フィルタのように見えるが、実際にはハードウェアの問いに近い。今持っている機材でこのモデルを動かせるのかを尋ねているのである。
なぜよりによってLargeなのか
Large Language ModelのLargeはマーケティング用の修飾語ではなく、このパラメータ規模を指している。そして規模が大きくなったのは、設計の意図というより観察の結果に近い。
ニューラルネットワーク自体は古いアイデアである。ところが小さく作ると、文法に合った文くらいは出せても、人が対話相手として感じられるほどの結果は出てこなかった。そのうち計算資源が安くなり、規模を大きく引き上げた実験が可能になると、ある地点を超えたところで結果の性質が変わった。少し良くなったのではなく、やっていることの種類が変わったように見える変化だった。
このパラメータと重みという構造は、LLMだけのものではない。画像認識でも音声でも、ほとんどすべてのディープラーニングモデルが同じ形をしている。扱う材料と規模が違うだけである。
ここでよく食い違うこと
実務で最もよく見かける混同は「自社のデータでLLMを学習させよう」という言葉である。そう言う人が実際に望んでいるのは、たいてい学習ではない。
学習とは、今見たとおりパラメータ数百億個を少しずつ直す作業であり、資源も時間も規模が違う。社内文書を回答に反映させたいという要求は、それとは別の方法で解くのが普通である。
何で解くかを分ける基準は、この連載の最終回で扱う。今つかんでおくことは一つである。学習とはモデル内部の値を変える作業であり、それはいつでも起きるものではない。
まだ使えるモデルではない
ここまでで、重みが最適化されたモデルが一つできあがった。ところがこのモデルは、まだ人々が使っているあのモデルではない。
ここまでで訓練したのはただ一つ、次に来るトークンとして何が自然かということだけである。質問に答える方法も、要求に従う方法も、危険な要求を断る方法も学んだことがない。
この状態のモデルをベースモデルと呼び、ここまでの過程を事前学習という。次回は、このベースモデルをなぜそのまま使えないのか、そして何を加えれば私たちが使っているチャットボットになるのかを見る。